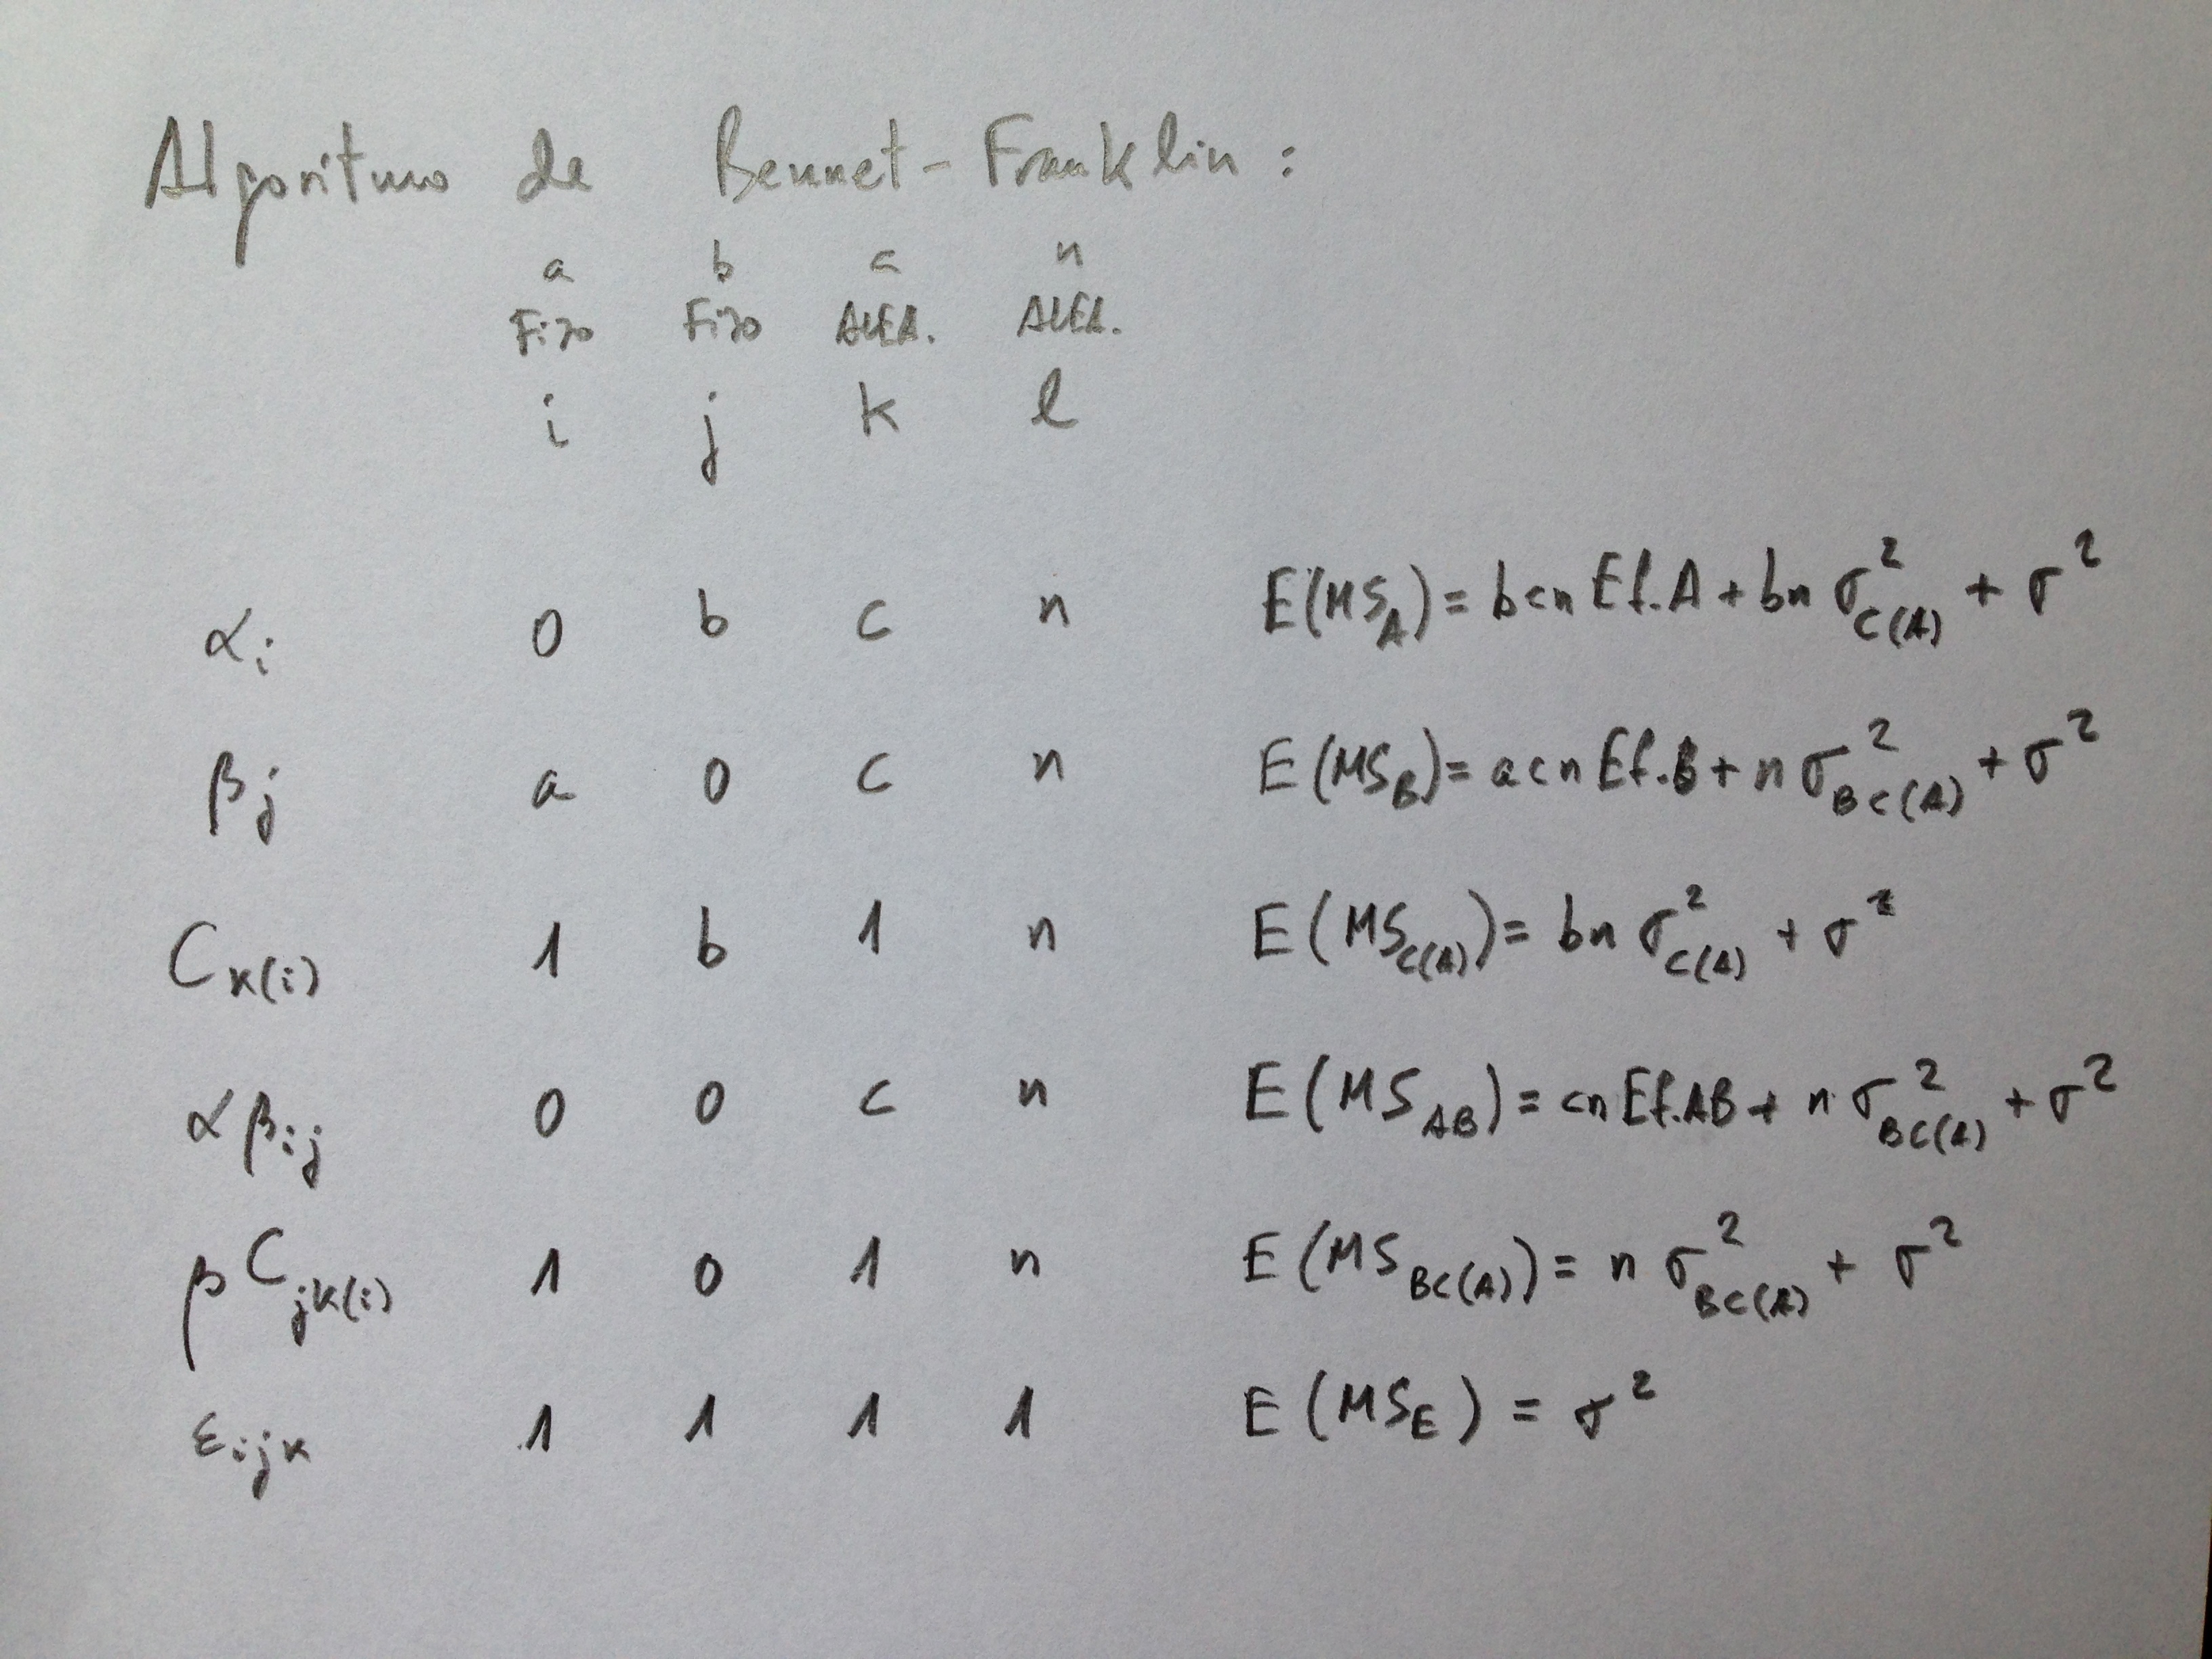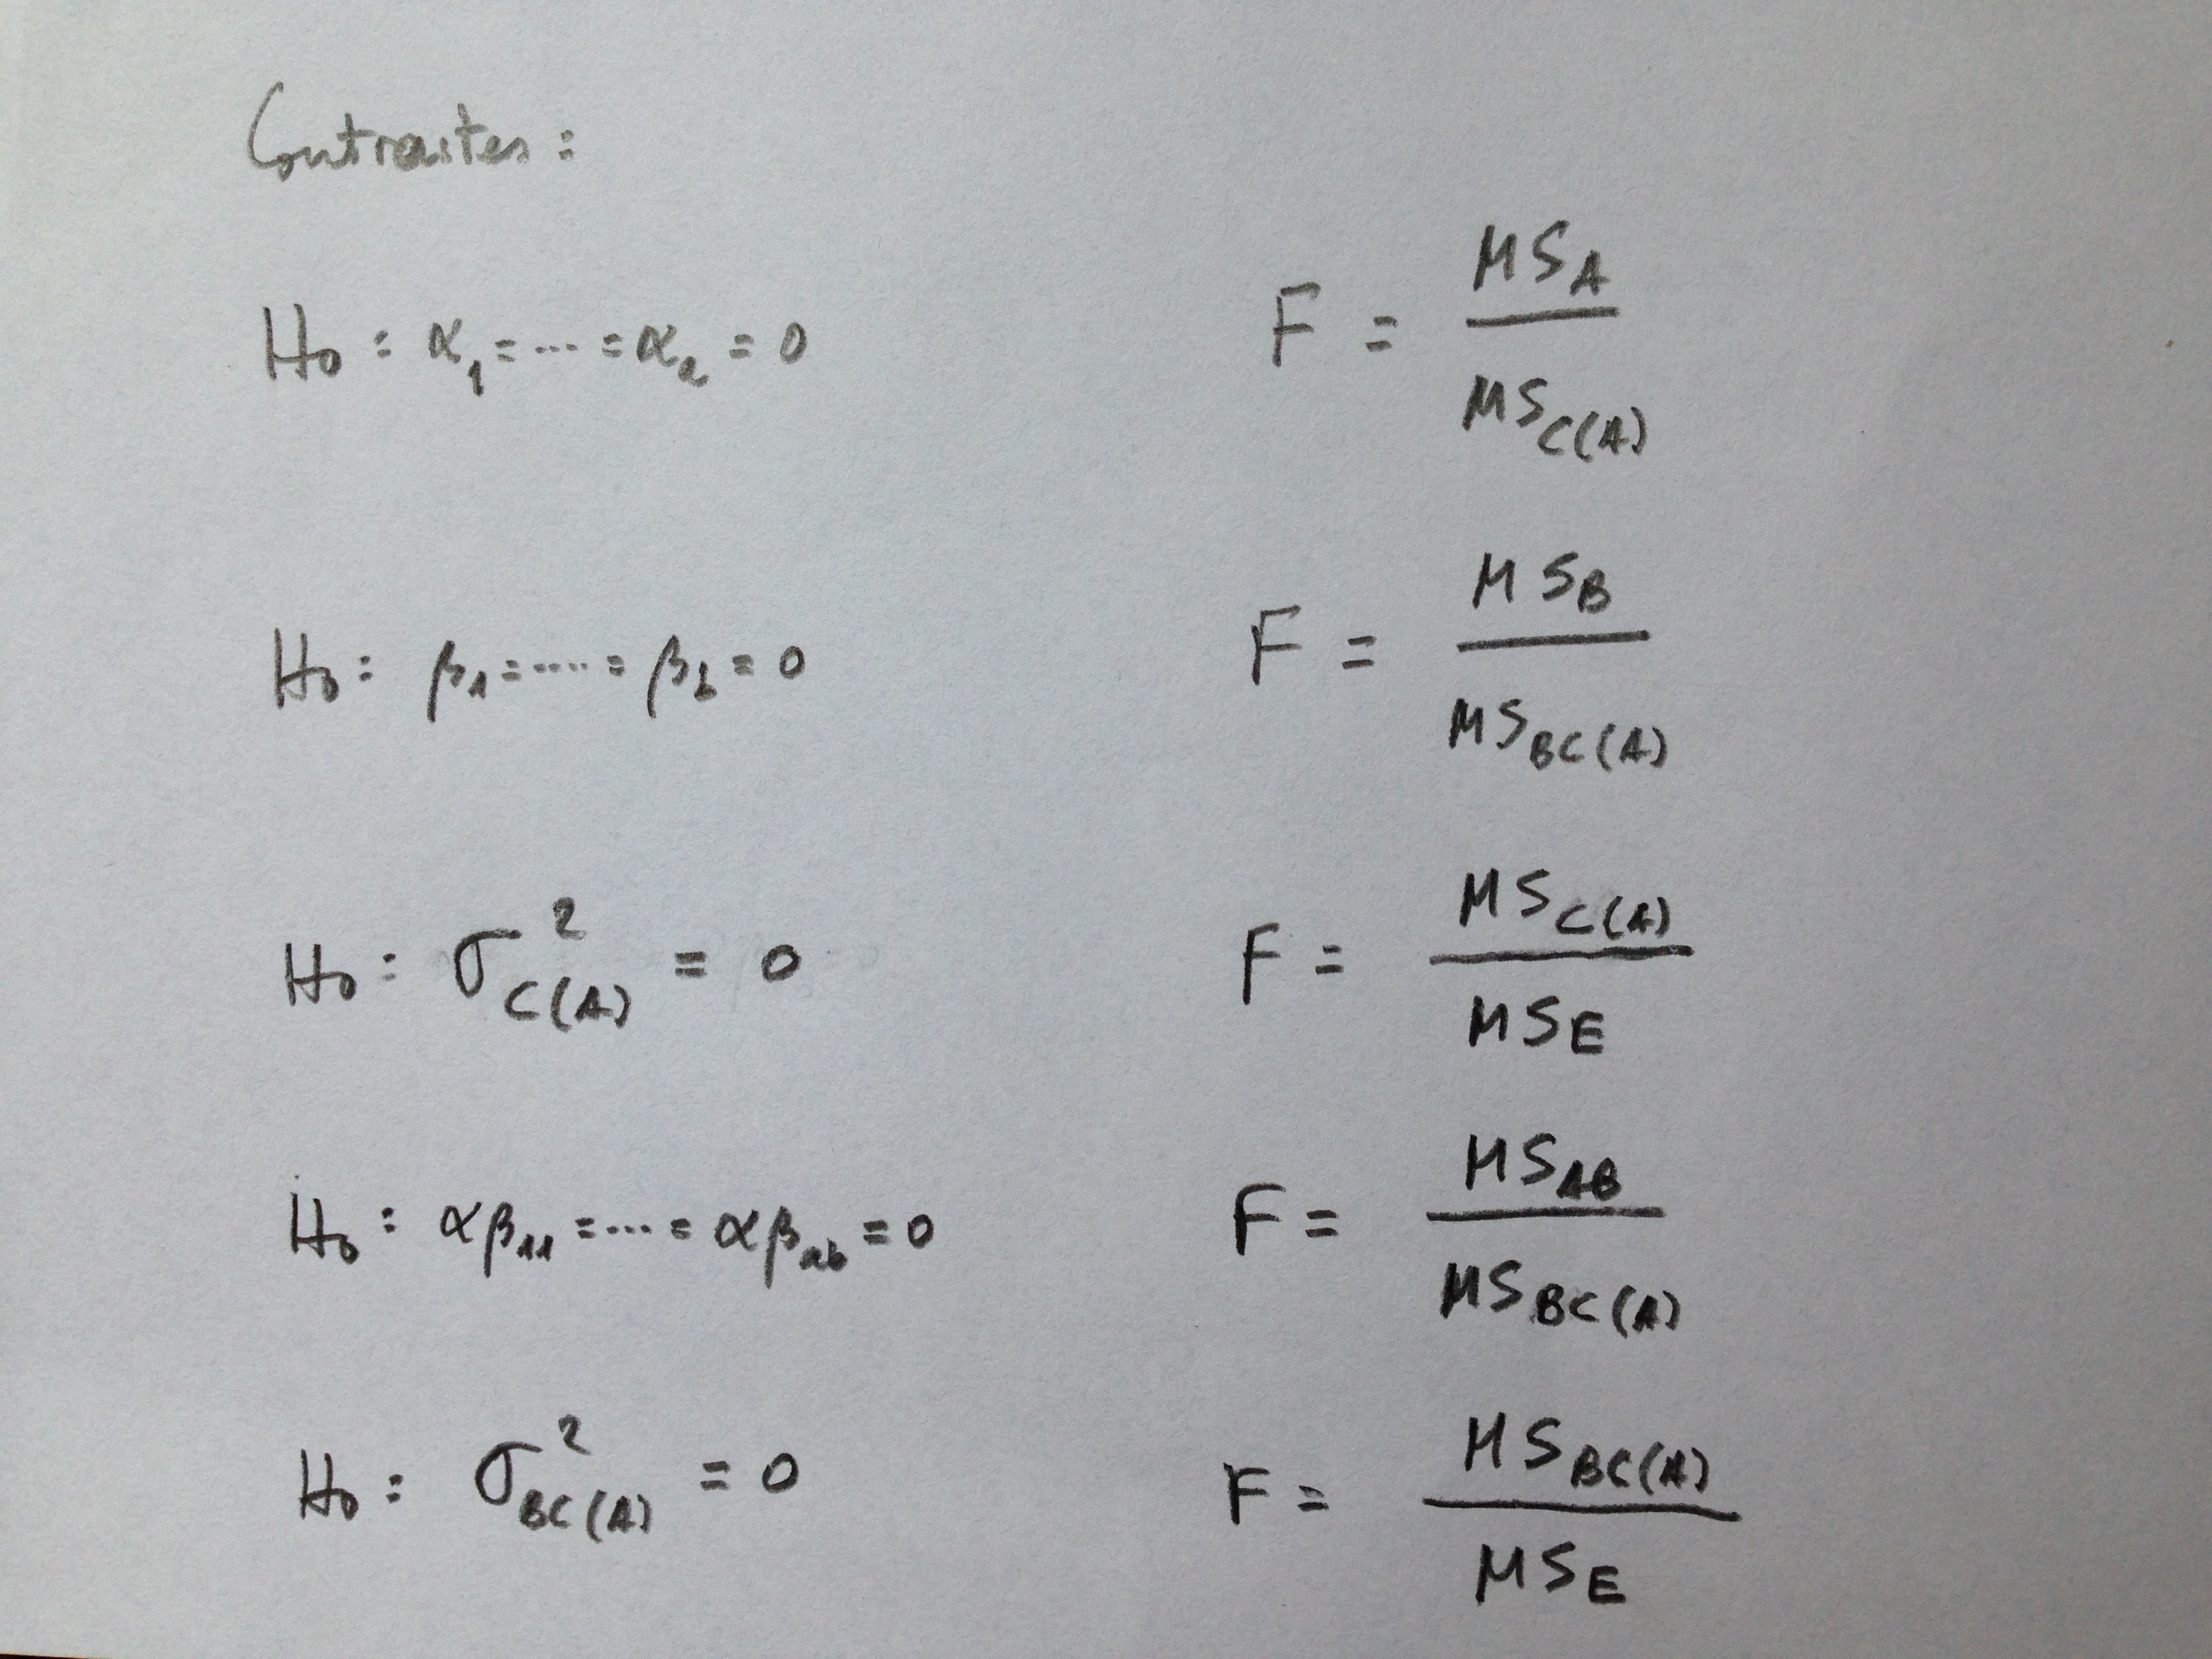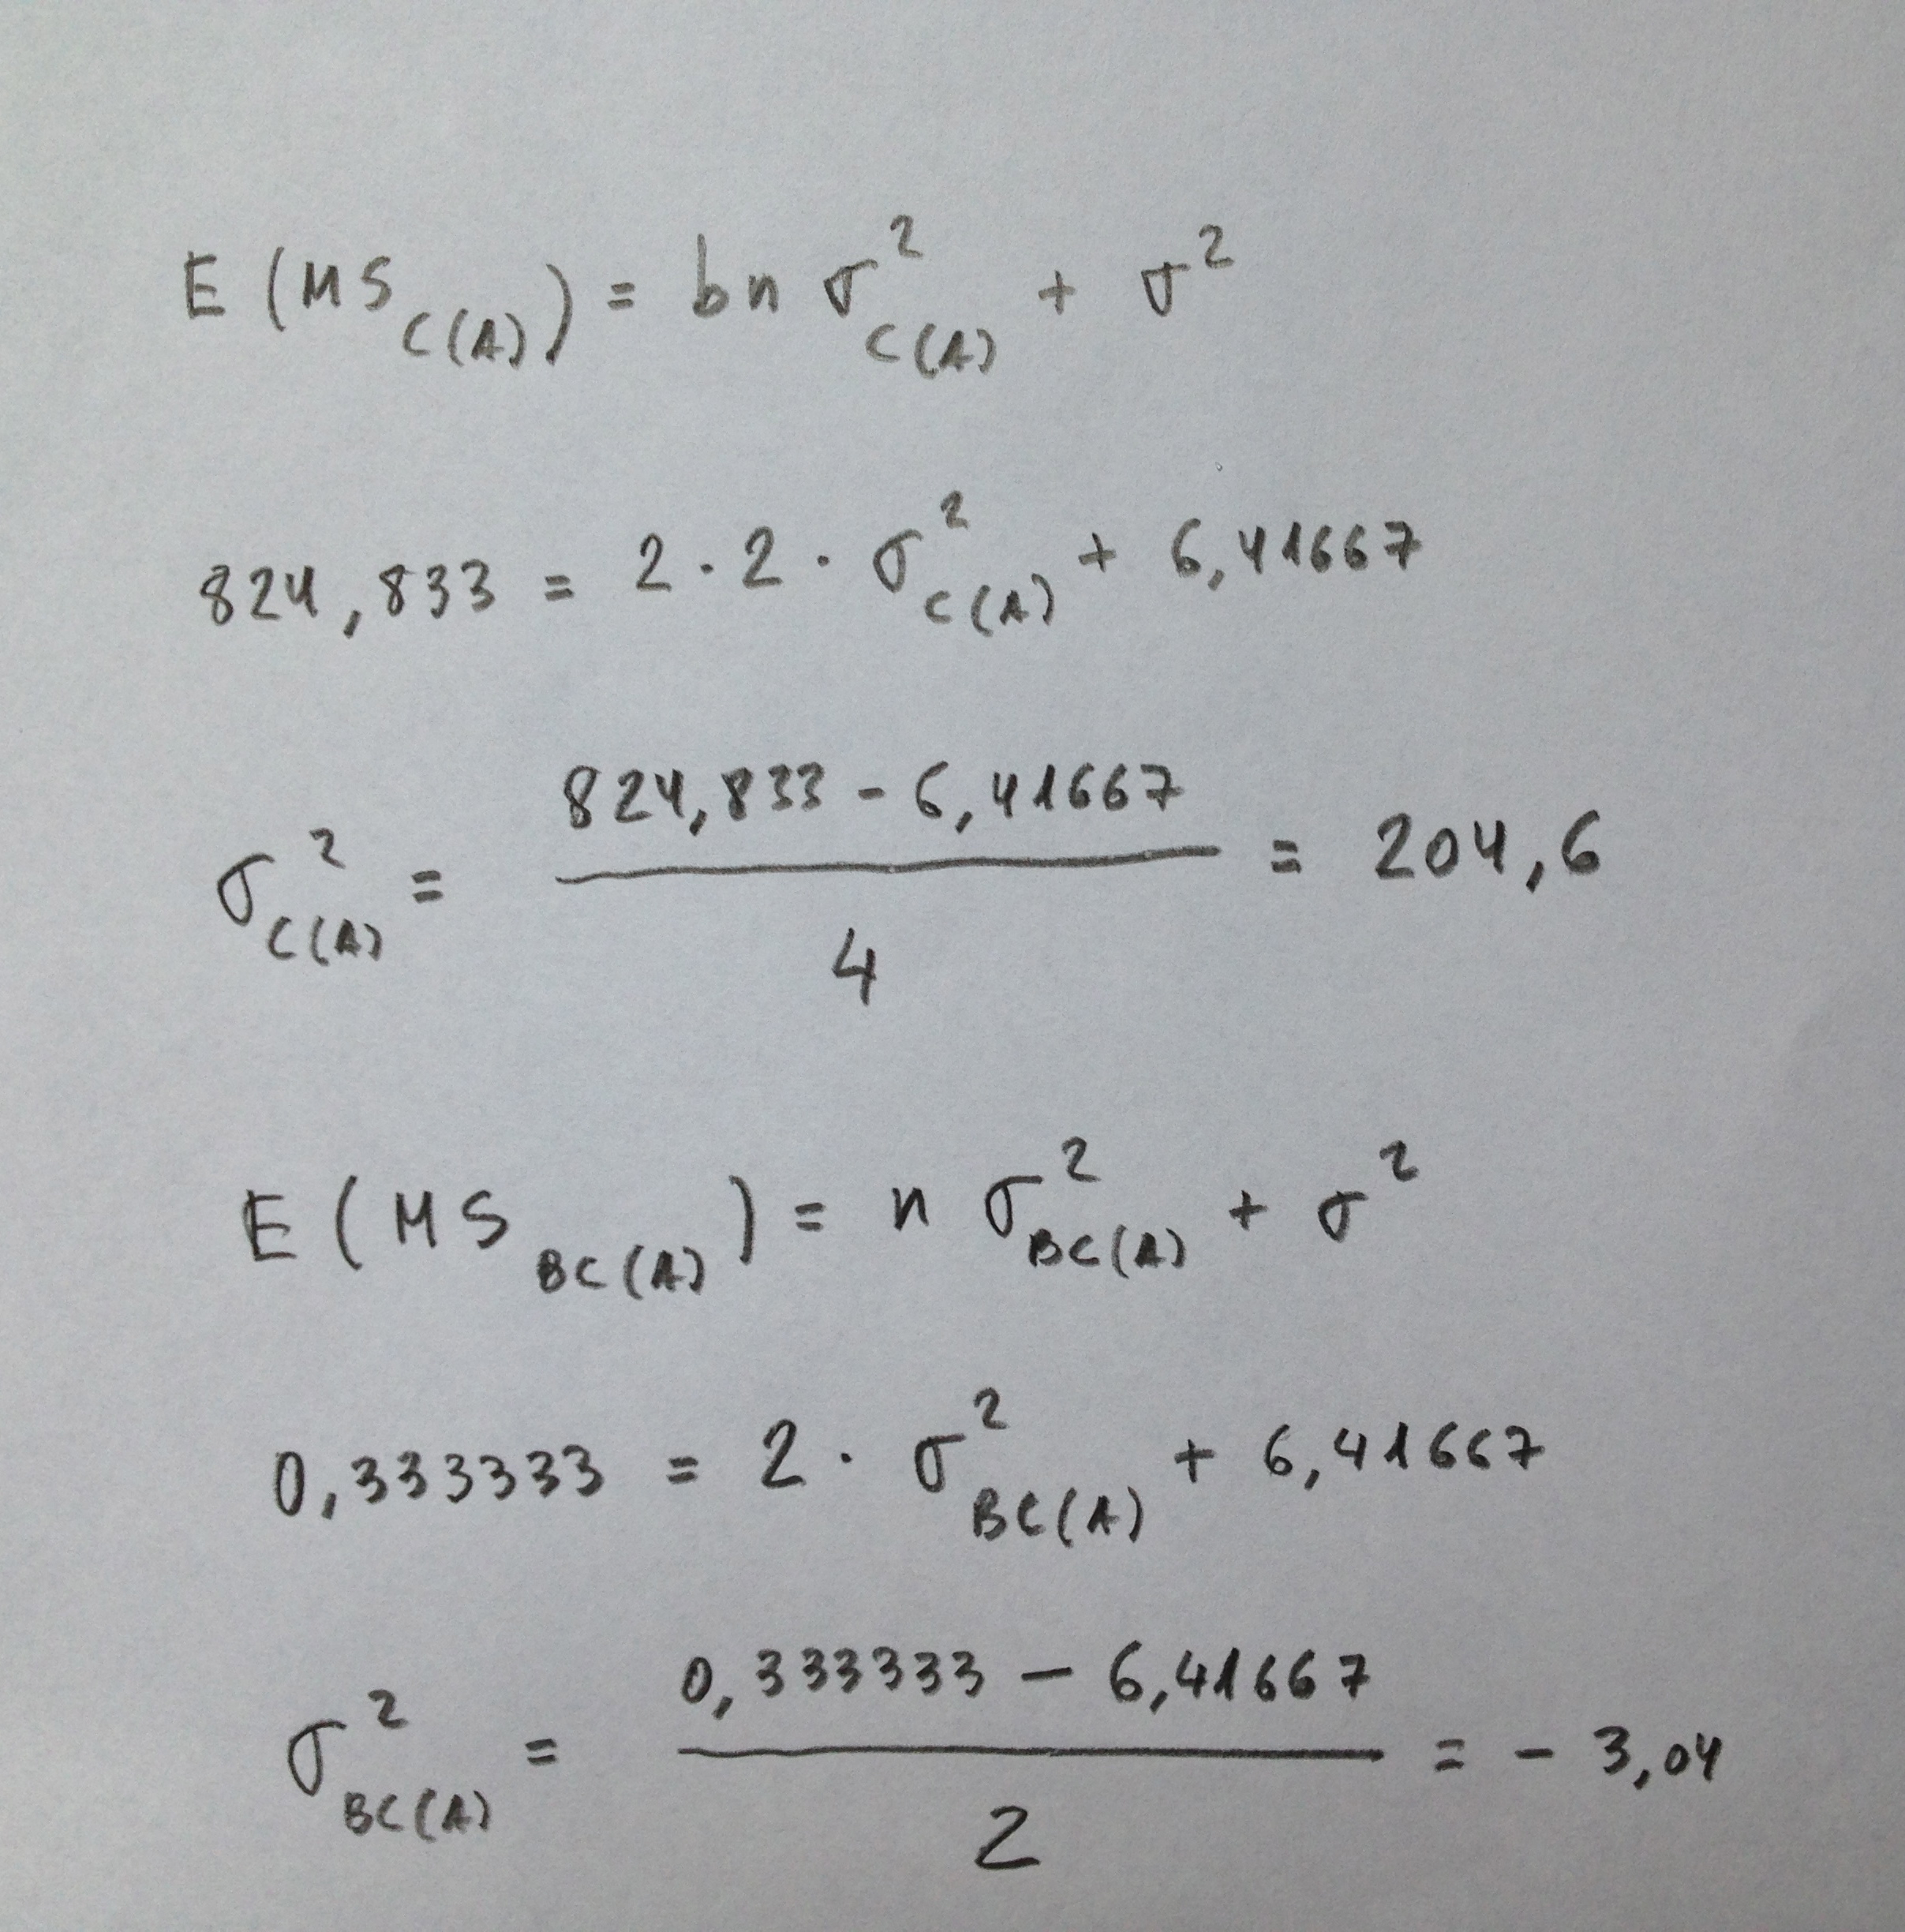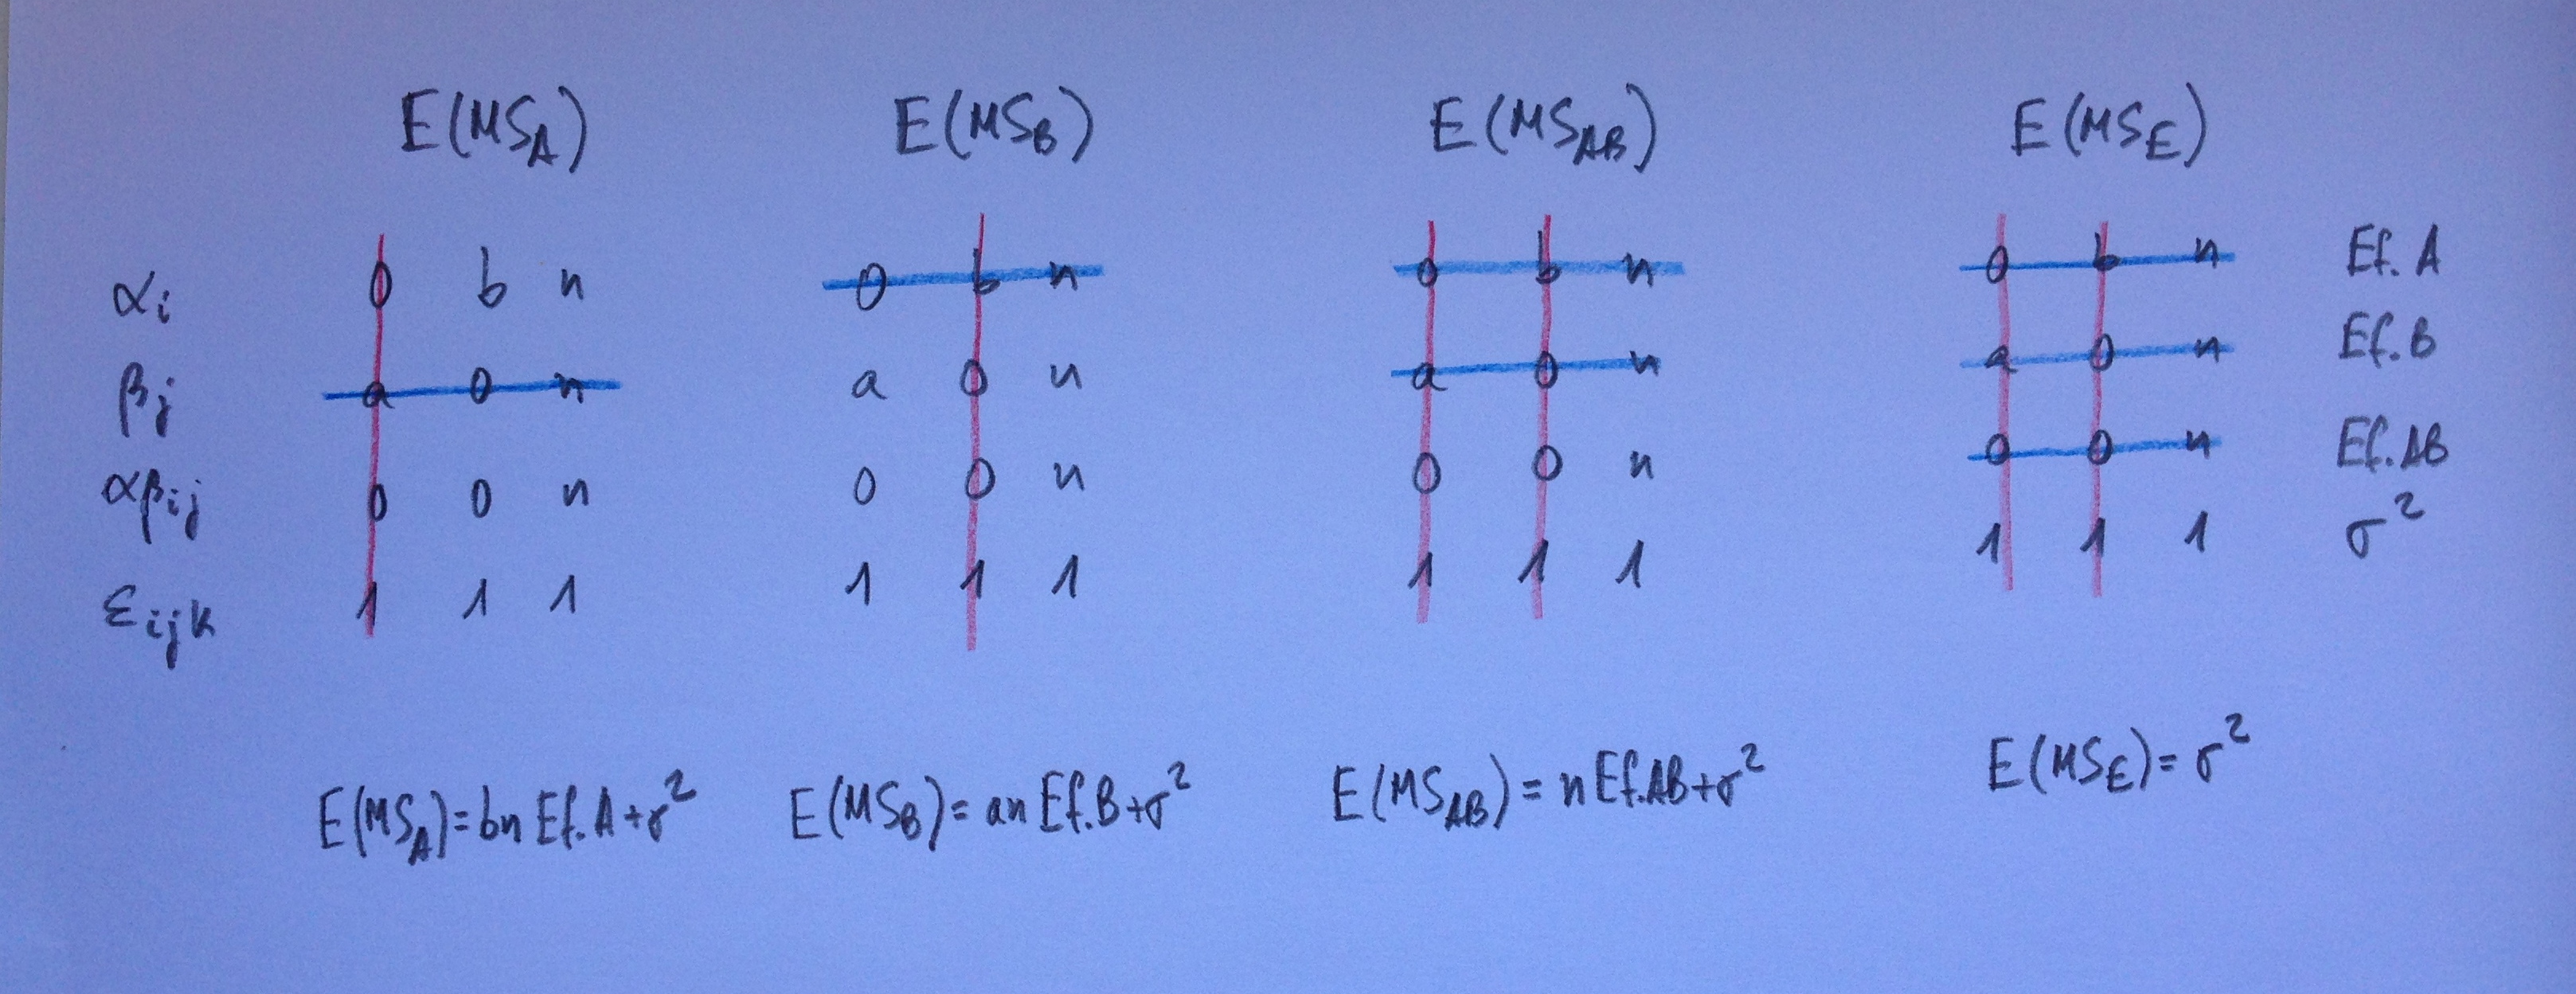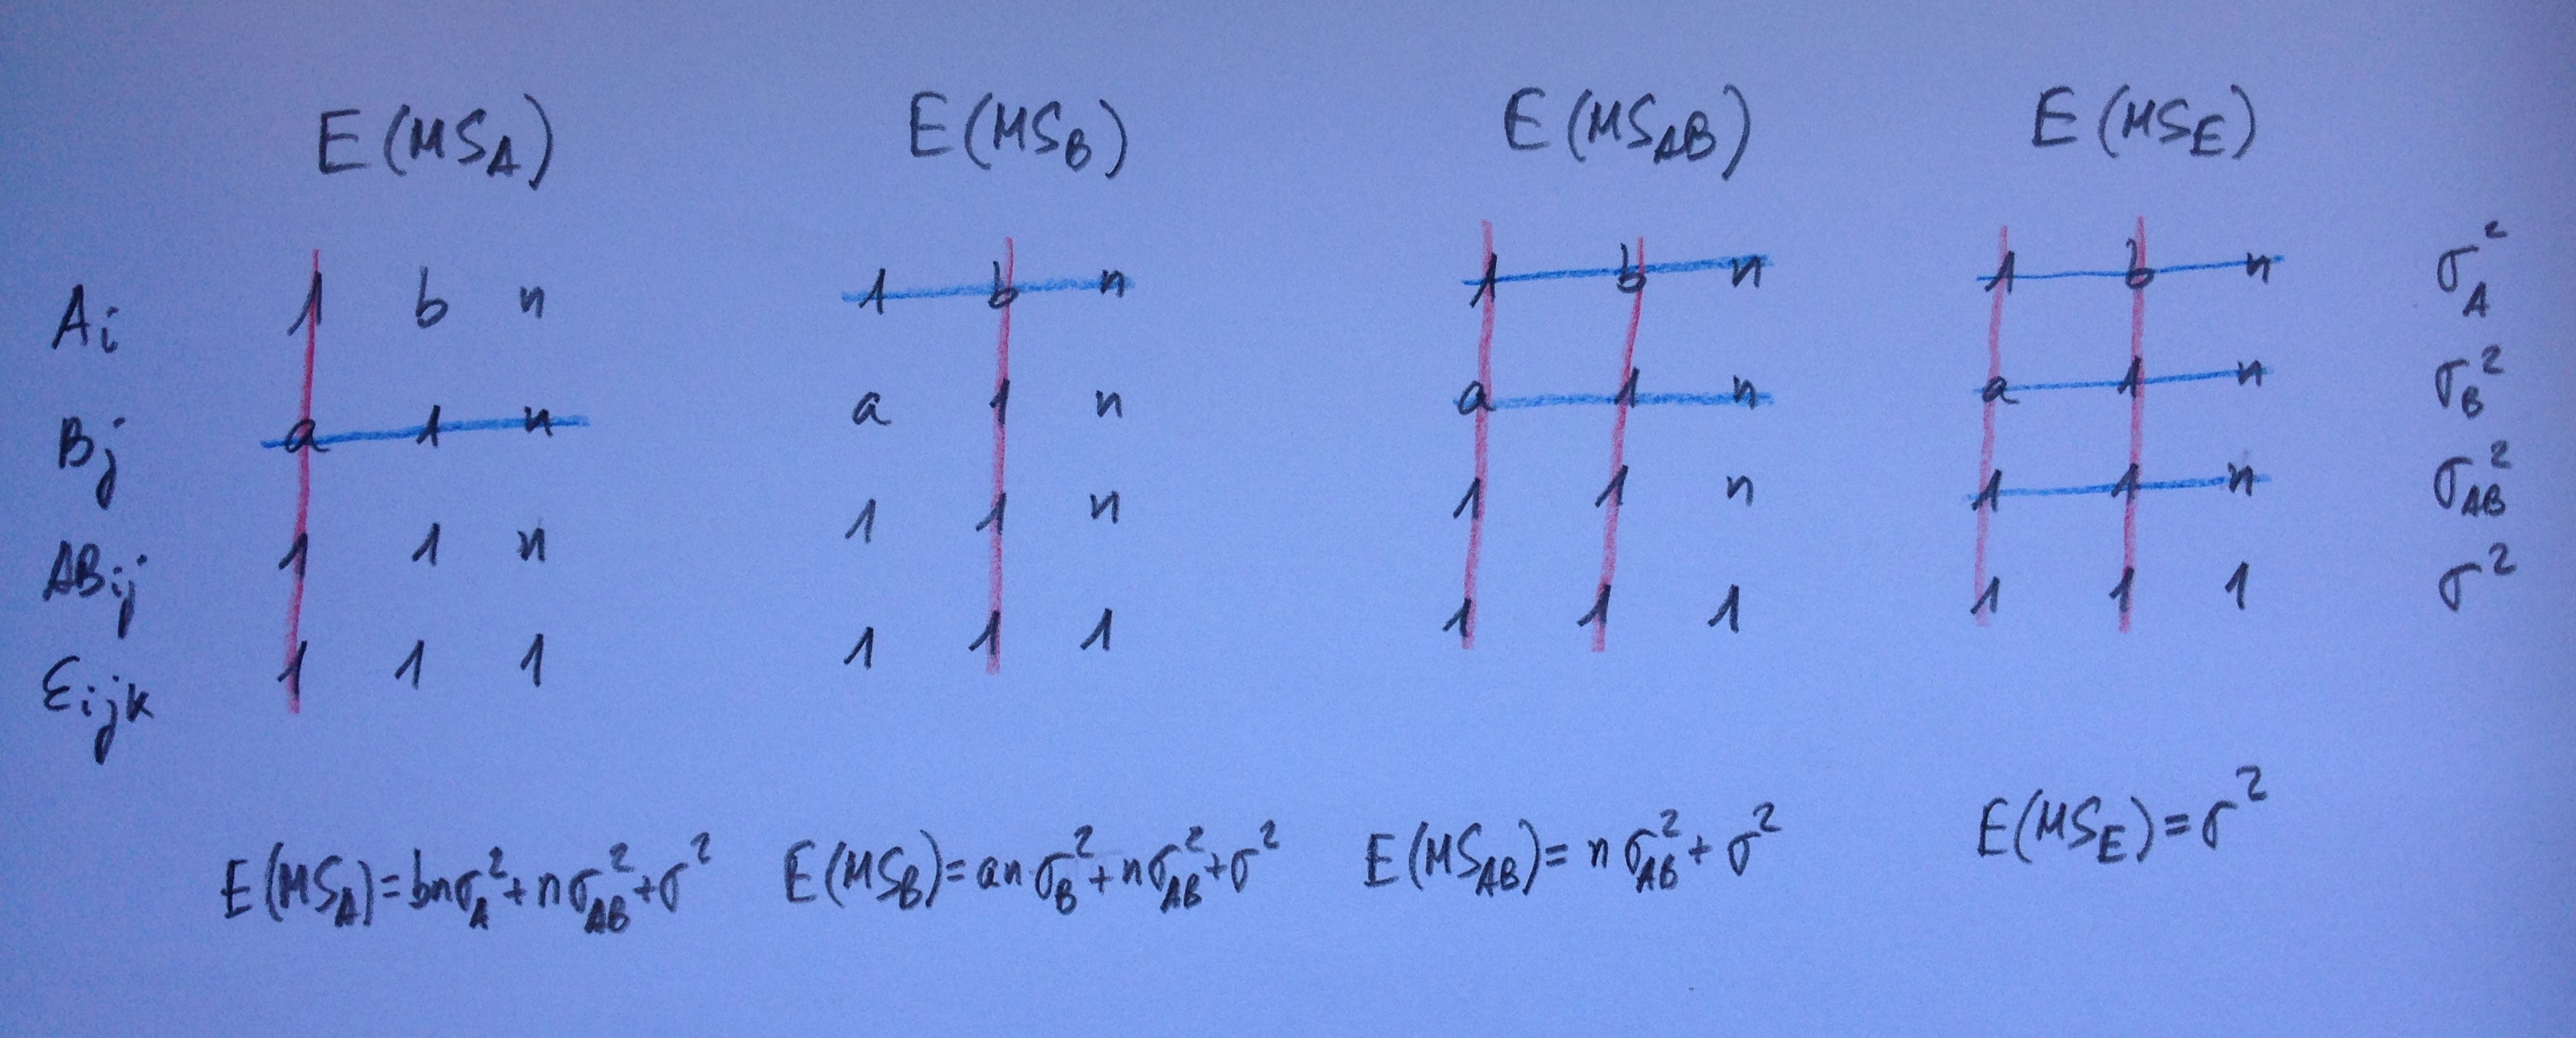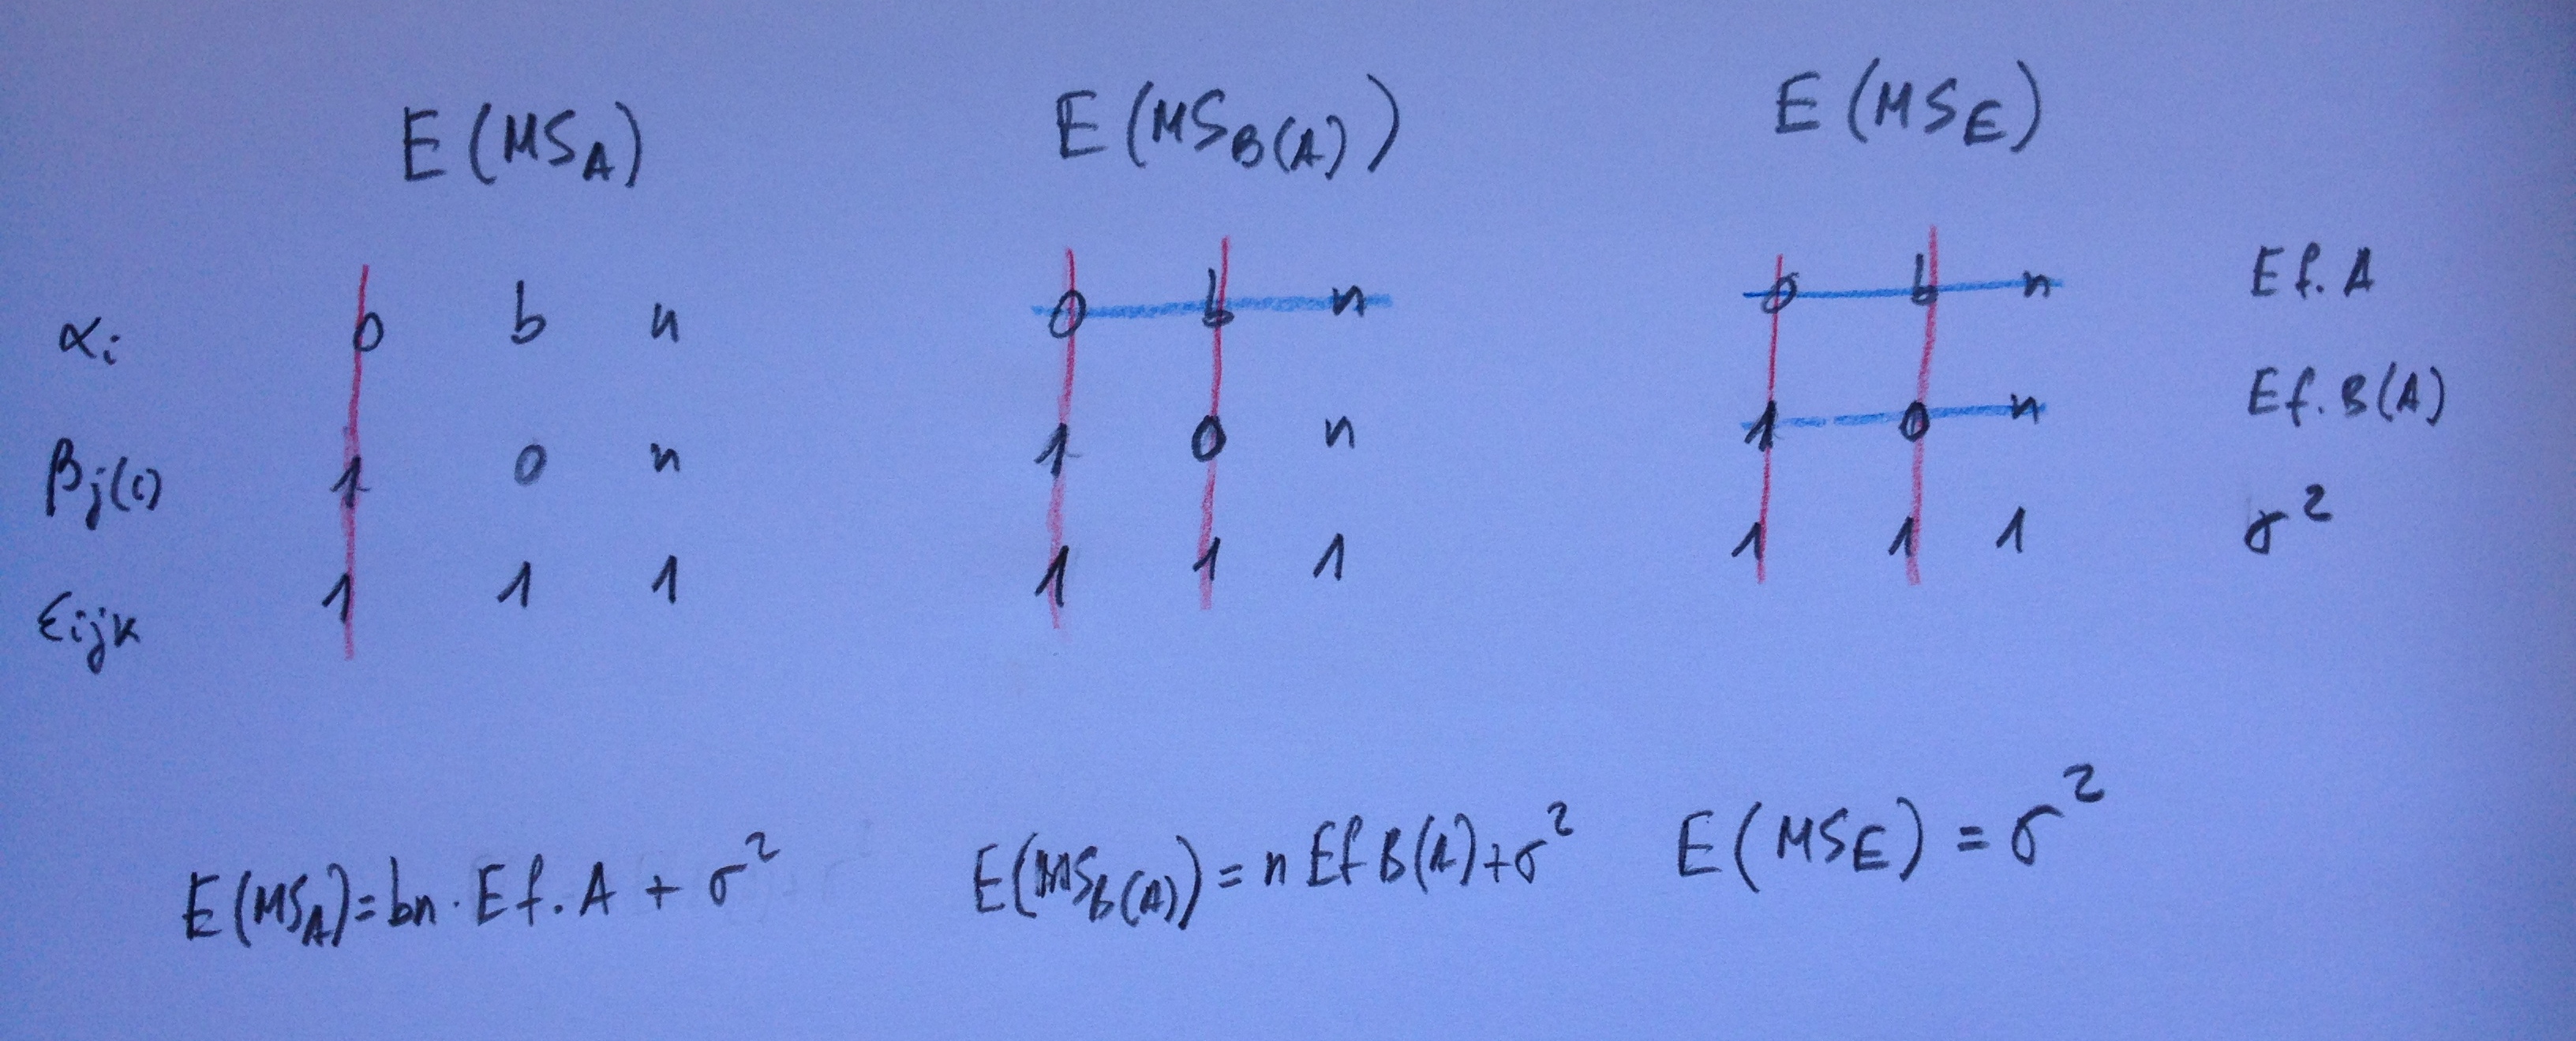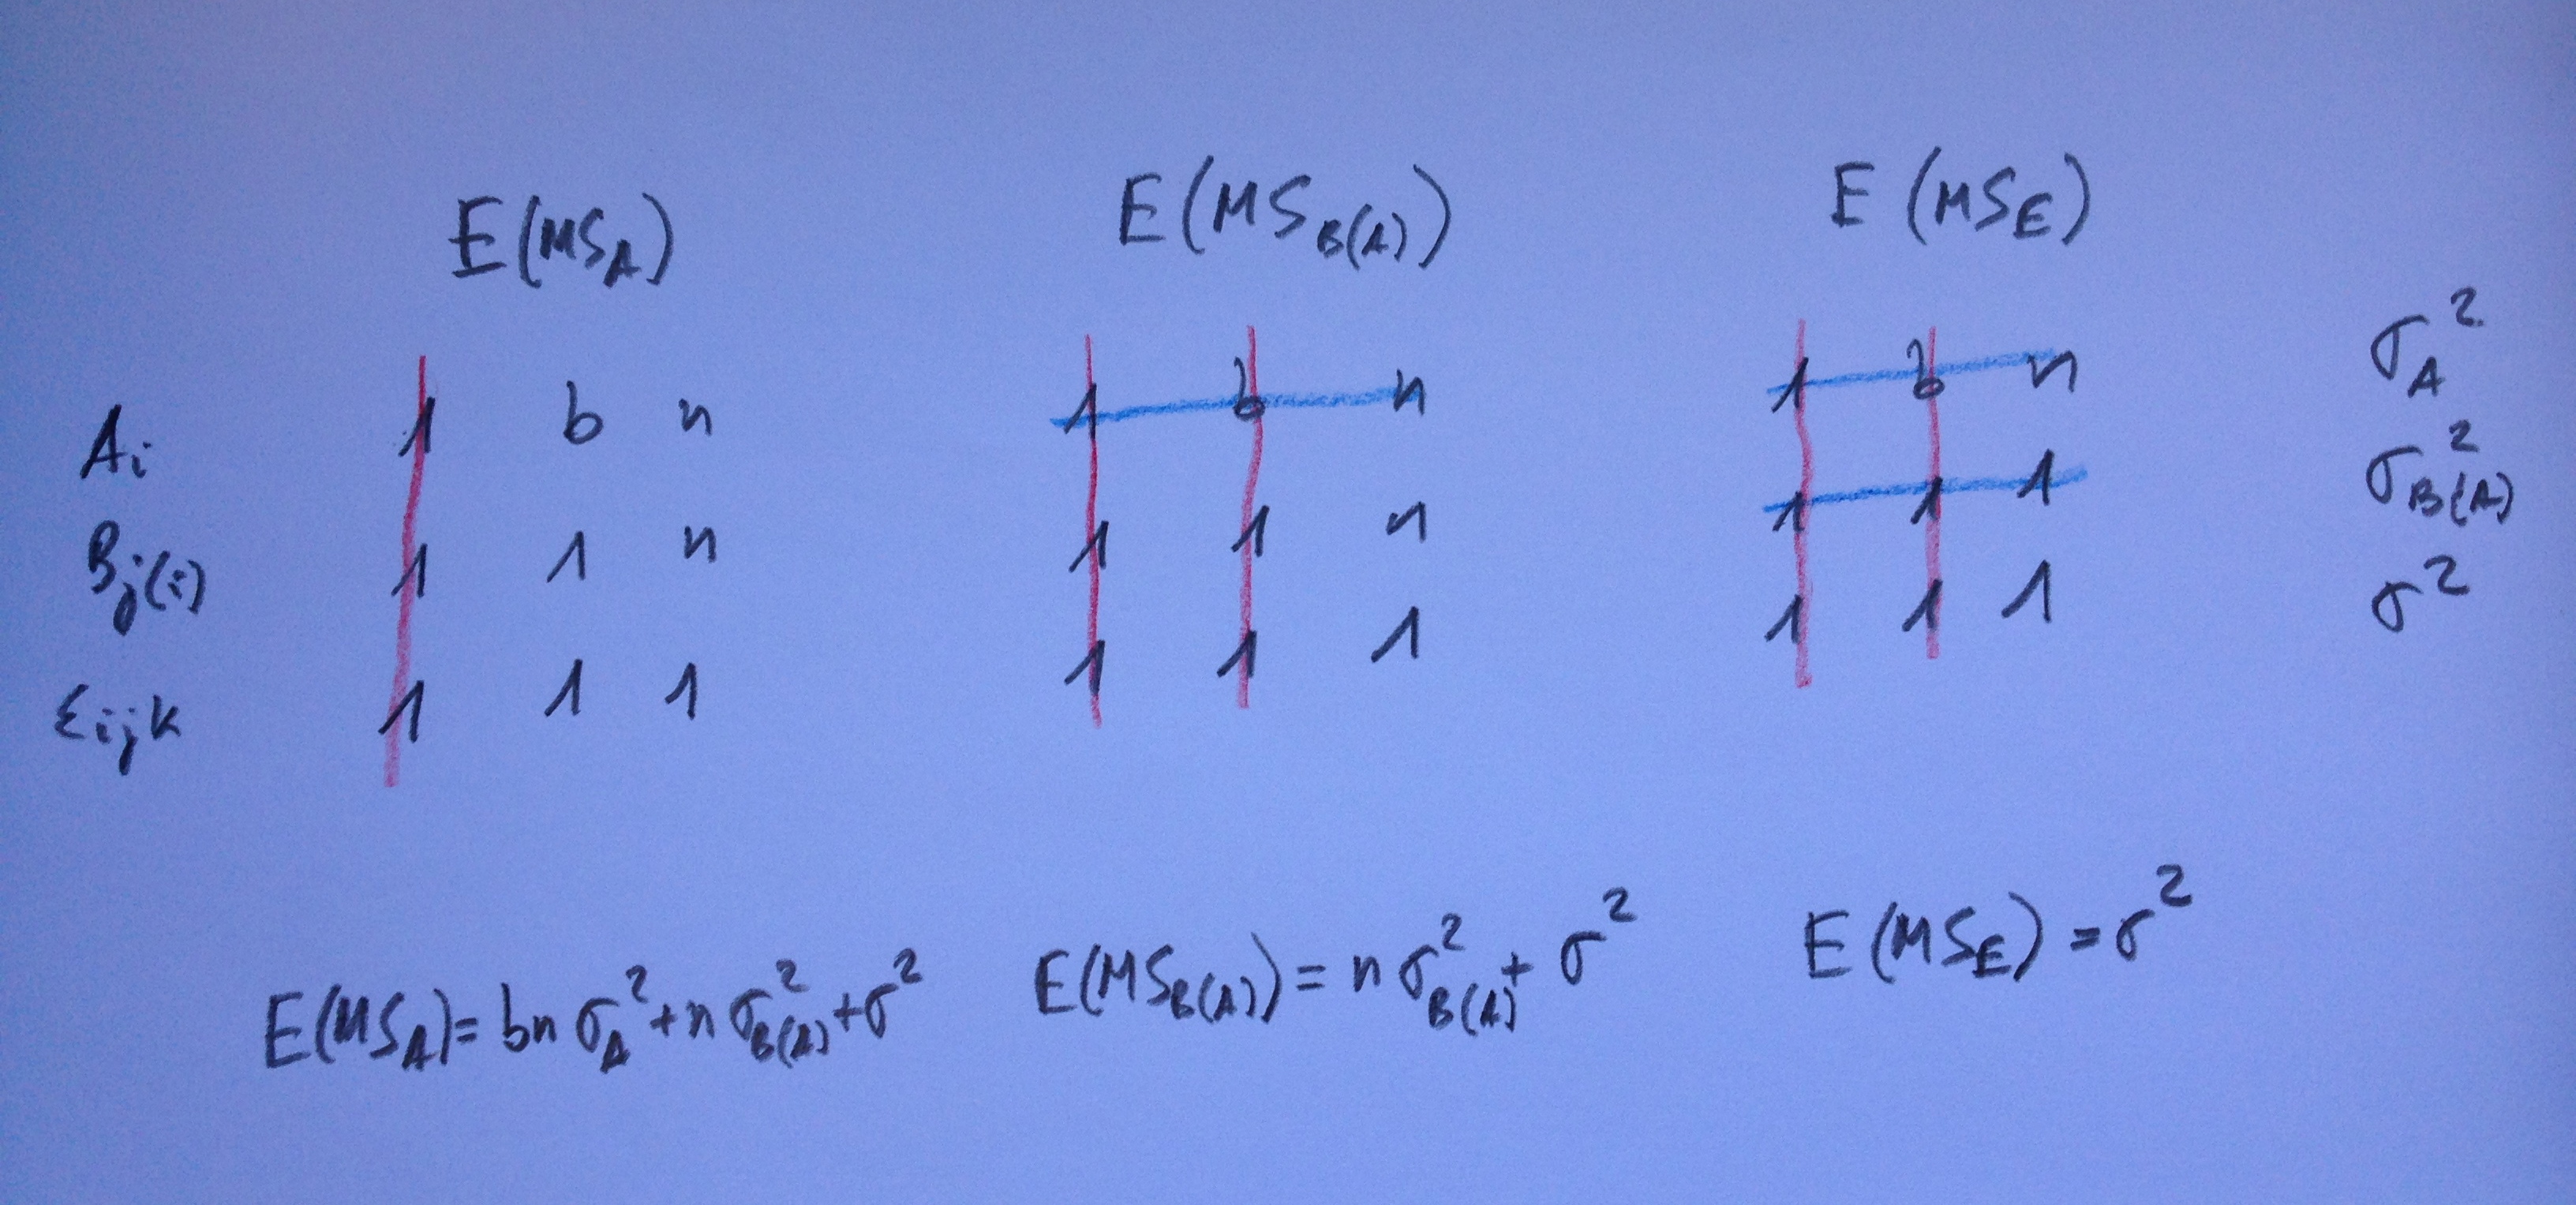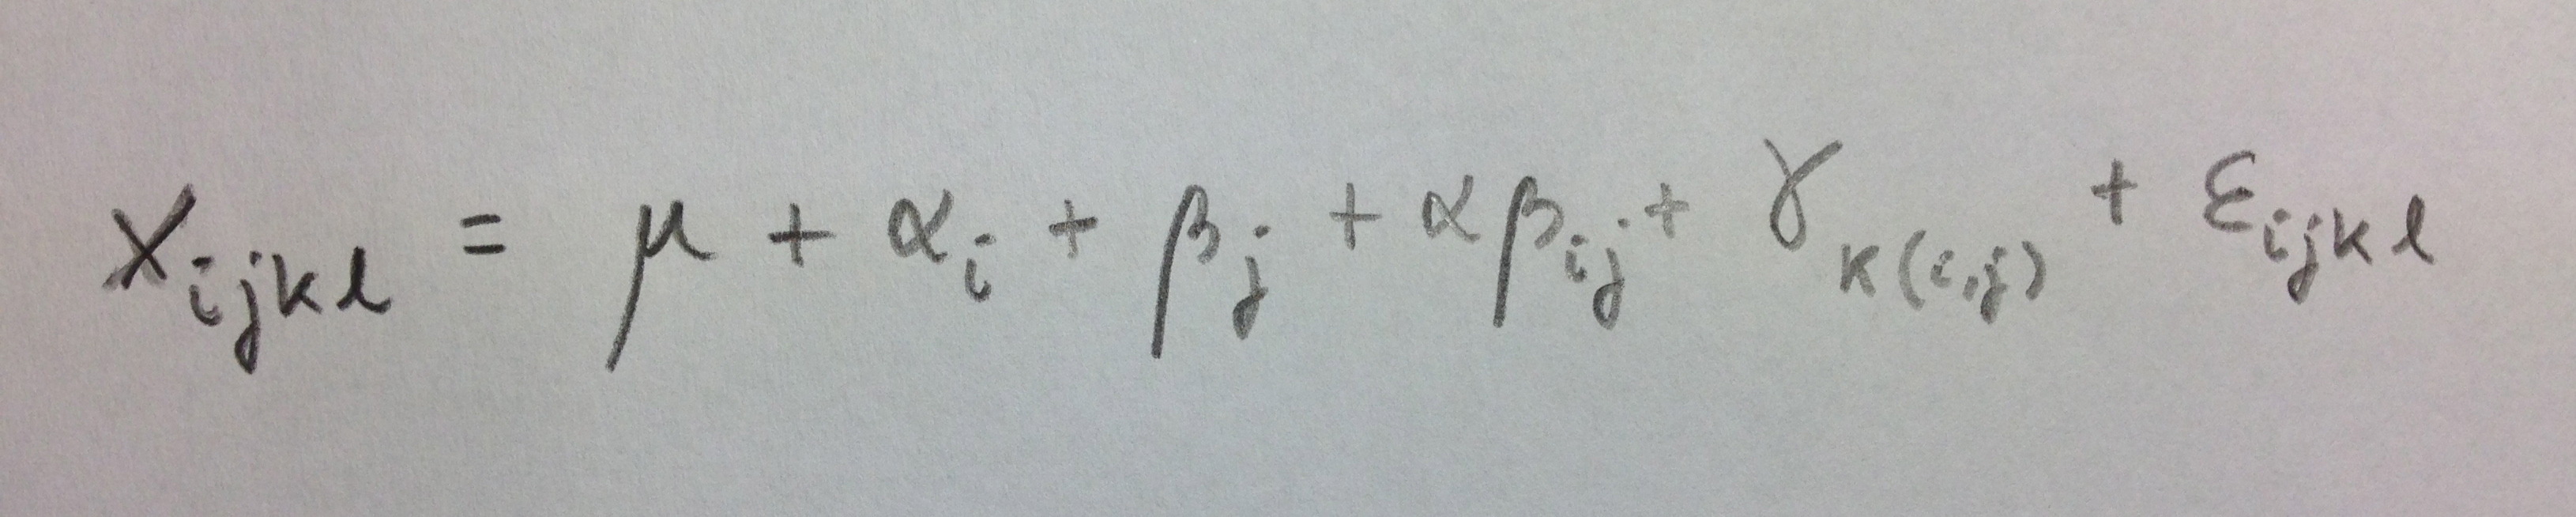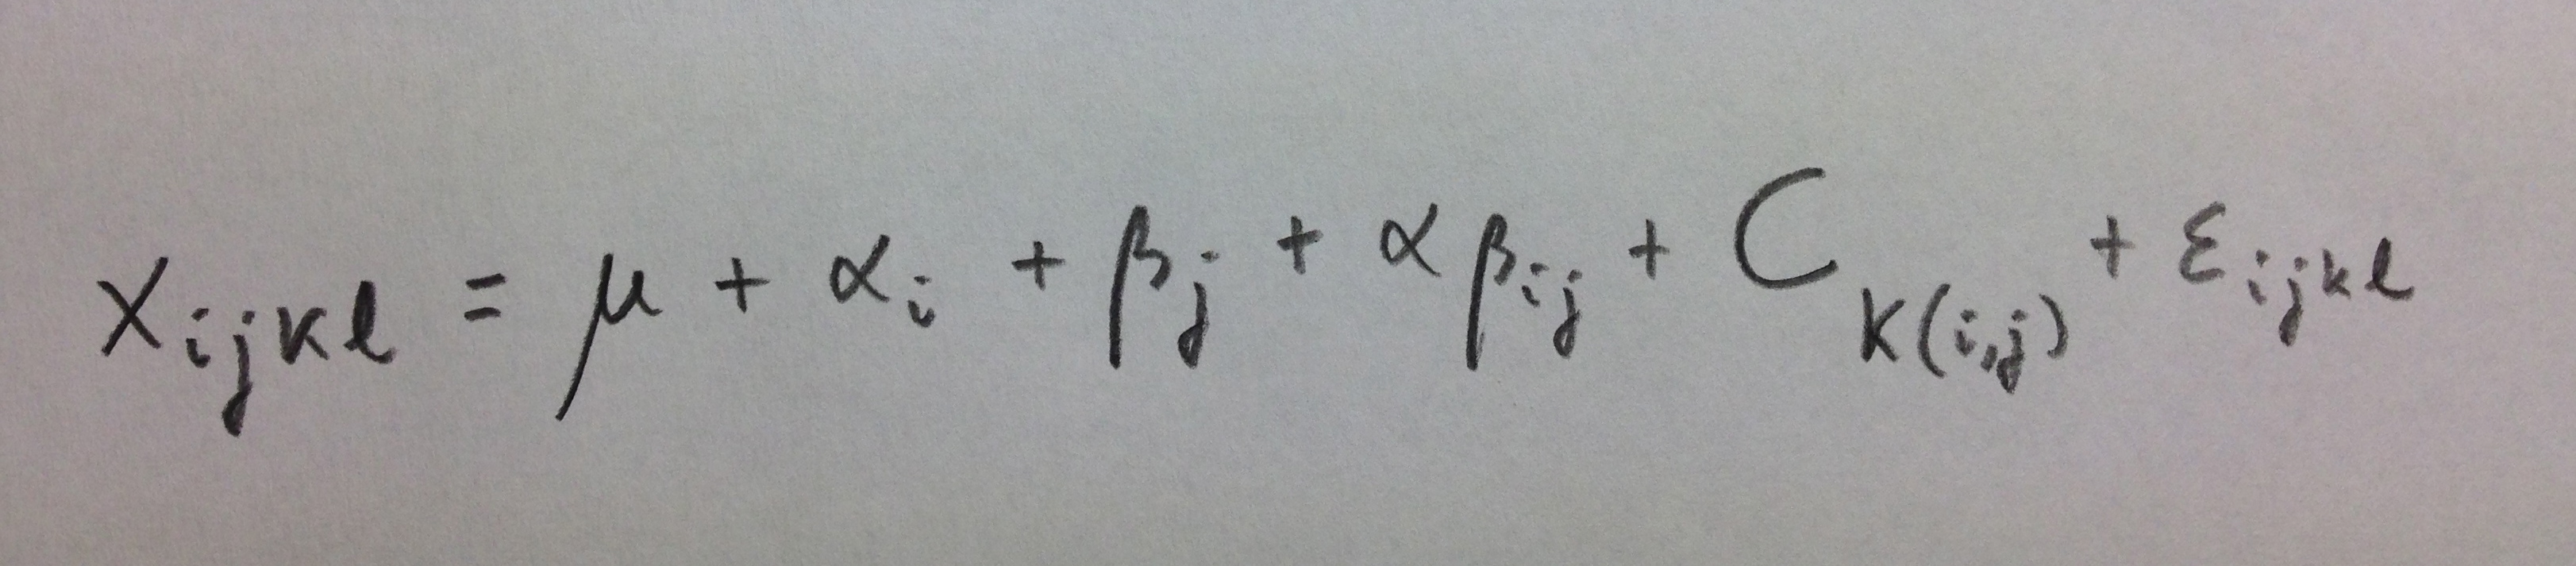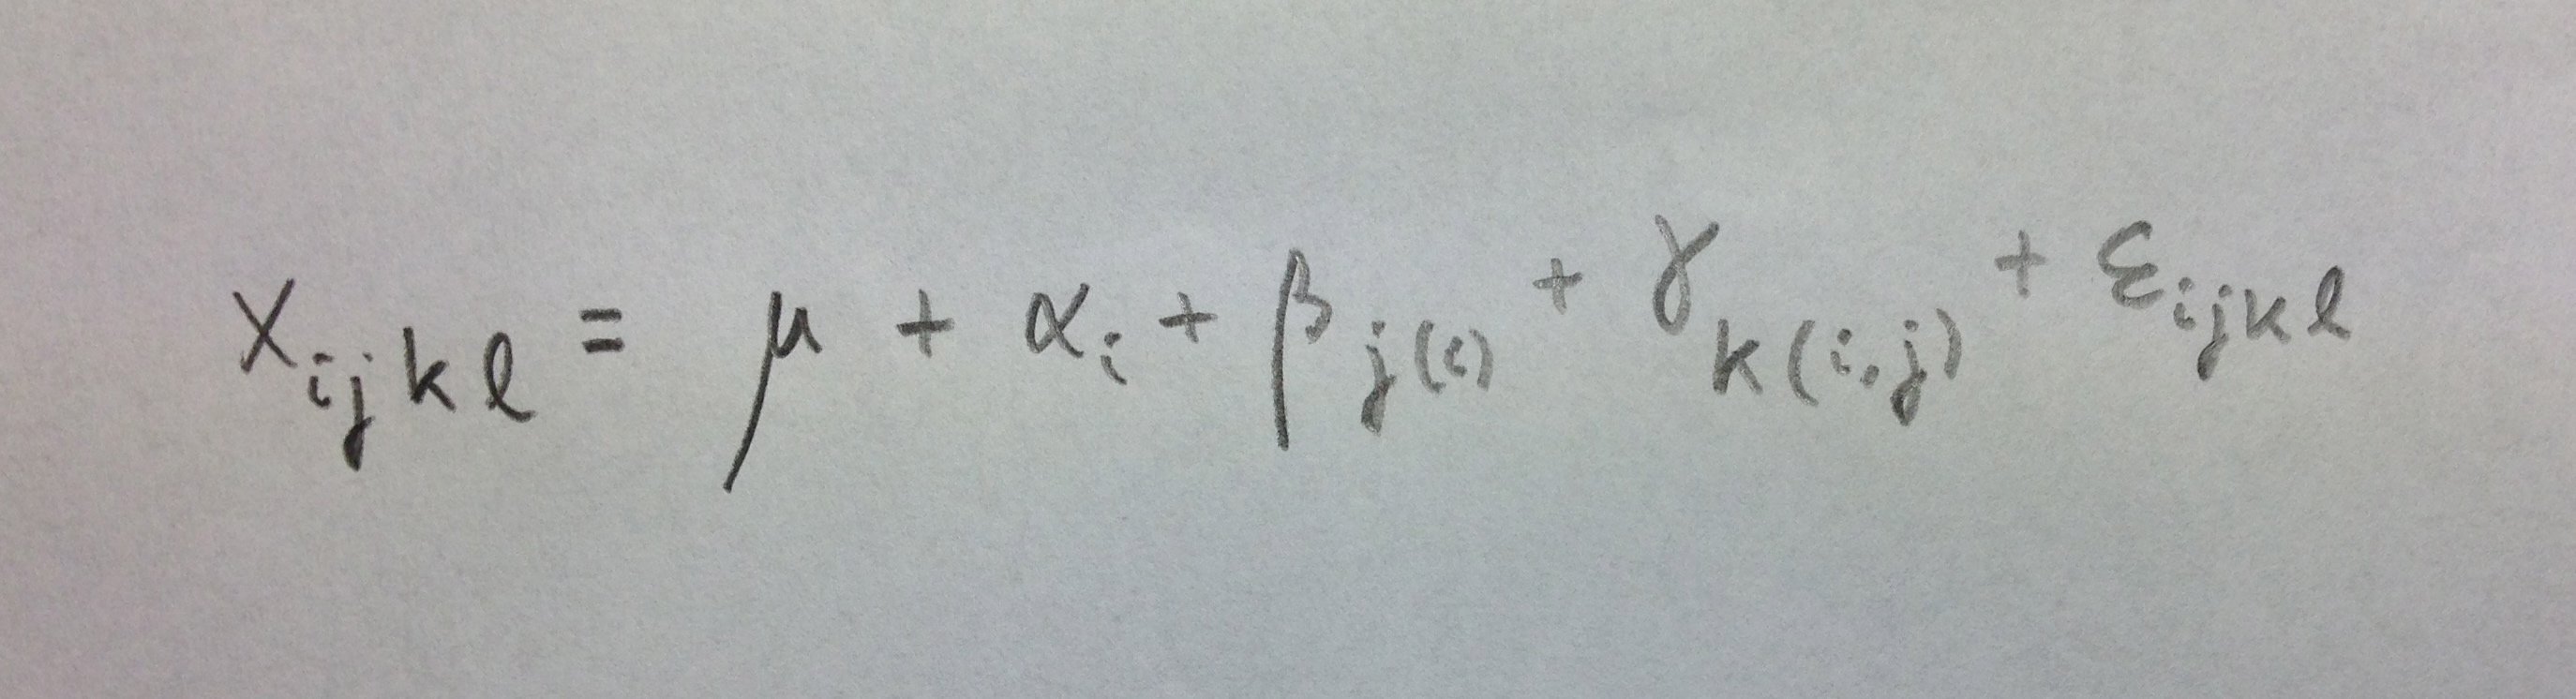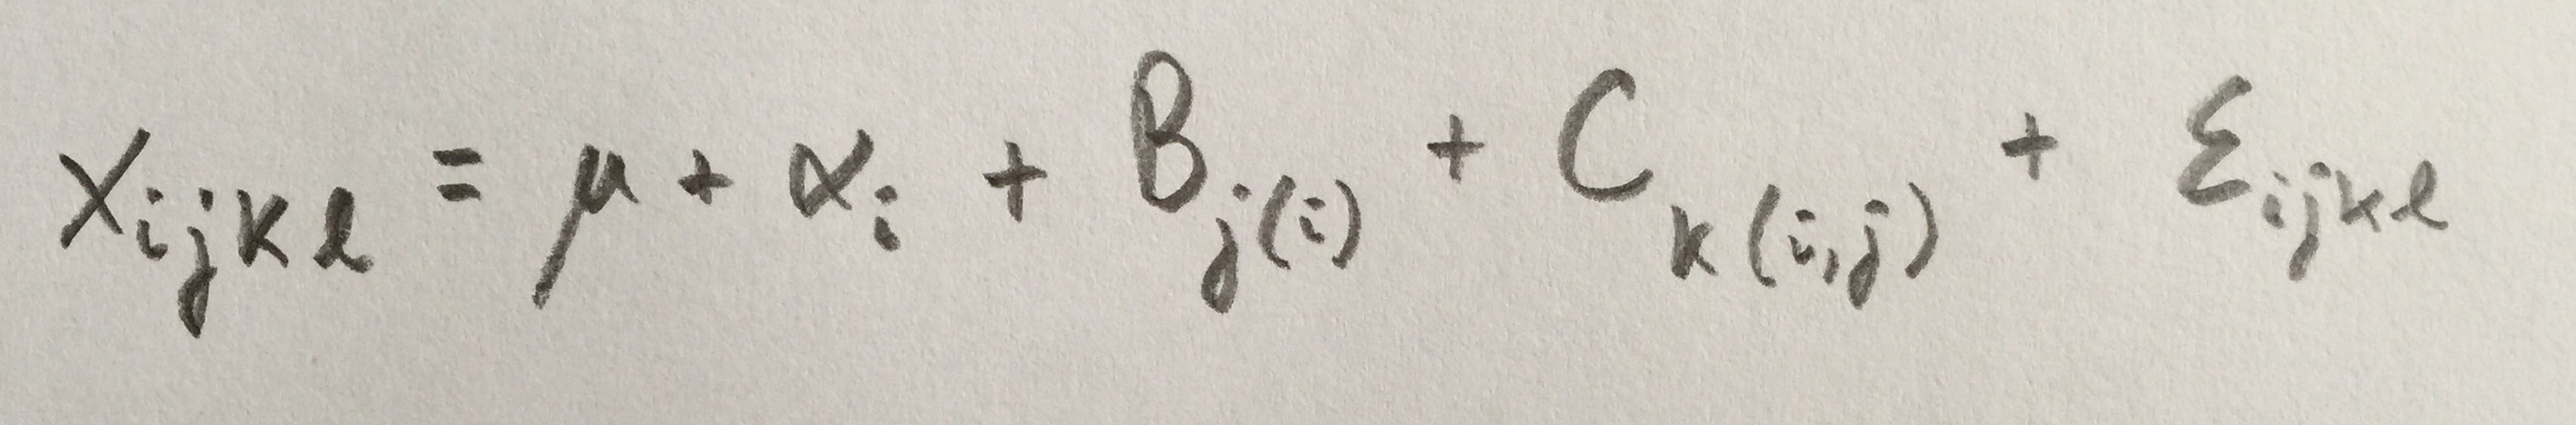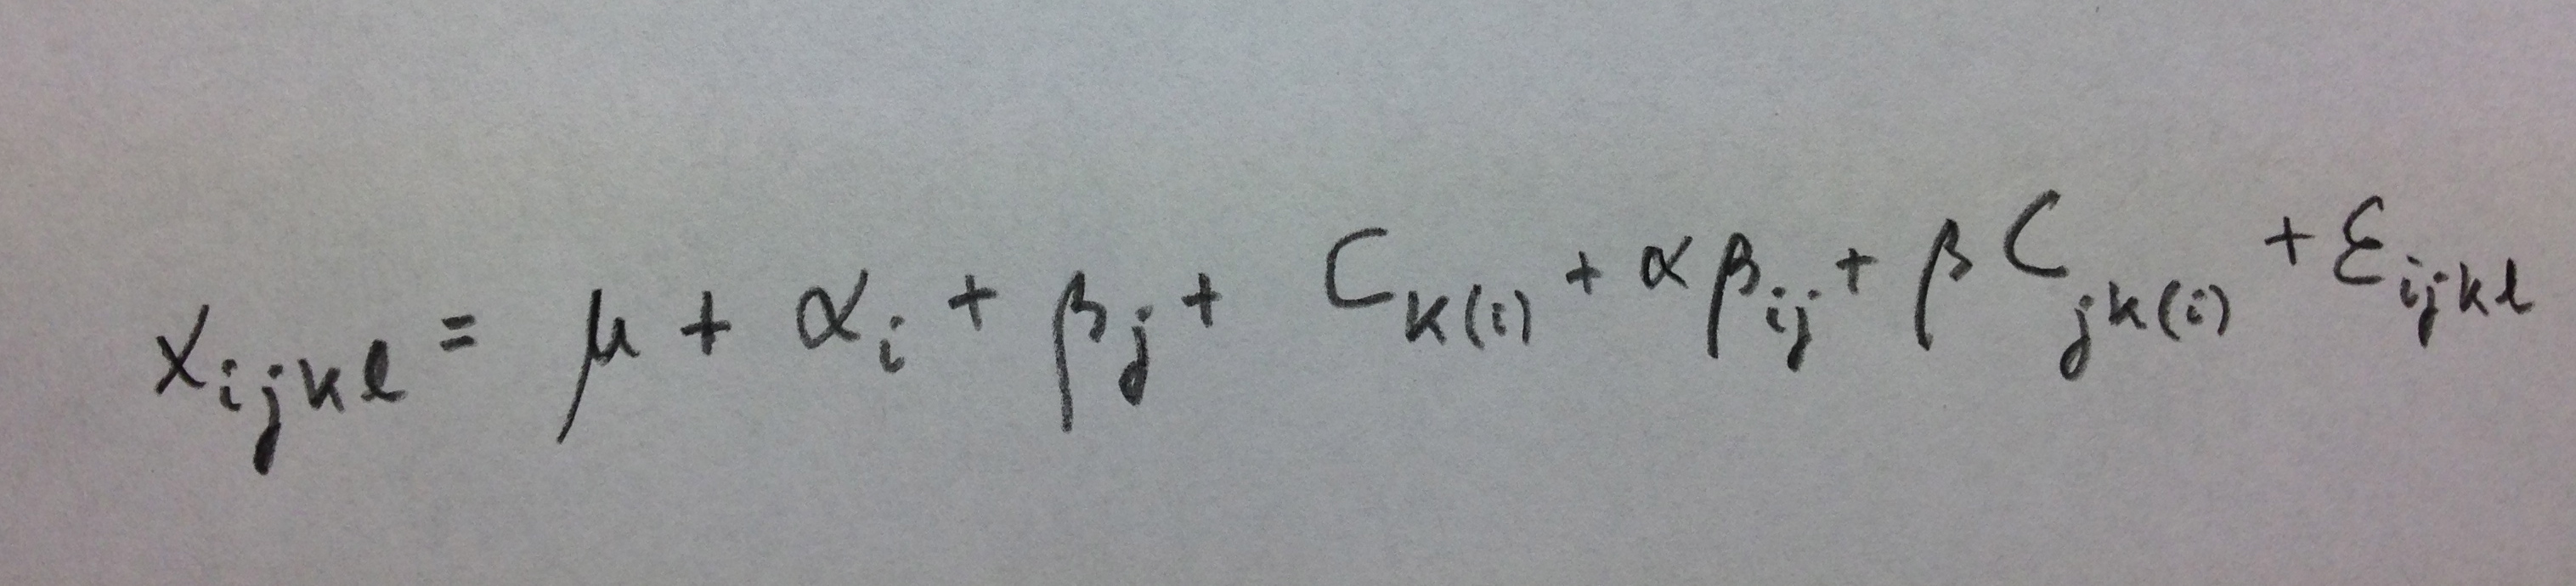Archivo del Autor: estadisticallopis

¿Media y Desviación estándar o Mediana y Rango intercuartílico?

En el Tema 2: Estadística descriptiva ya hemos visto que son muchos los estadísticos, los descriptores, que podemos calcular a una muestra de una variable cuantitativa. Pero es muy habitual resumir una muestra mediante sólo dos descriptores. Lo más habitual es hacerlo mediante la Media y la Desviación estándar. En estos casos se suele escribir mediante la estructura  Media±Desviación estándar. Es muy habitual en revistas científicas ver descripciones de una variable en términos, por ejemplo, como de 10±3, 134±23 ó 2345±123. Sin embargo, esta generalización que se viene usando es problemática. Veamos por qué.

Si una variable se ajusta bien a una distribución normal lo más conveniente es describir esa variable, efectivamente, mediante la Media y la Desviación estándar, porque con estos dos valores tenemos perfectamente caracterizada la distribución de la población que hay detrás de la muestra que tenemos.

Si una variable, por el contrario, no se ajusta a una distribución normal es muy problemático describirla en estos términos, de esta forma. Es mucho más razonable describirla mediante la Mediana y el Rango intercuartílico.

La tendencia habitual si se tiene una variable descrita en los términos de la Media±Desviación estándar es a hacer aquellas típicas inferencias que sólo son ciertas si la variable se ajusta bien a la distribución normal: M±1DE supone el 68.5% aproximadamente de la población, M±2DE supone el 95% aproximadamente de la población y M±3DE supone el 99.5% aproximadamente de la población. Si la variable no se ajusta a una distribución normal esas inferencias en absoluto son ciertas. Para evitar esta muy habitual inferencia inconsciente es mejor trabajar, evidentemente, en estos casos de no ajuste a la normalidad, con la Mediana y el Rango intercuartílico que son medidas que digamos están más próximas a la descripción propiamente dicha y no tienen tantas connotaciones inferenciales como las tienen la Media y la Desviación estándar.

No es un problema, como suele pensarse en ocasiones, de tamaño de muestra. Hay una creencia establecida, por parte de muchos usuarios de la Estadística, que si una muestra es pequeña deben usarse descriptores tipo mediana y percentiles y si la muestra es grande puede usarse y debe usarse la media y la desviación estándar. Esto no es así. El uso de unos u otros descriptores no depende del tamaño muestral, depende de la normalidad de la muestra, de su ajuste a la campana de Gauss.

Veamos dos ejemplos que nos pueden ayudar:

El primero es una muestra de tamaño 1000 de personas adultas a las que se les ha medido la variable Altura. Veamos unos cuantos descriptores calculados a esa muestra, el Box-Plot y un interesante gráfico donde simplemente se representan todos los valores de la muestra en su posición respecto a la recta de números de abajo. Los valores se elevan con la intención que se visualice mejor la distribución de valores. Observemos que en este caso dar la Media y la Desviación estándar es muy correcto. Los valores muestrales se ajustan bien a una normal. Vemos perfectamente que si a la media le sumamos y restamos 1DE ó 2DE vemos que efectivamente quedan, dentro de esos dos intervalos, el 68.5 y el 95% de valores. Vaya, que estos valores son factibles y razonables:

IMG_7100

La Asimetría estandarizada de esta muestra es -0.46 y la Curtosis estandarizada es 0.19. Esto es una forma más objetiva de valorar el ajuste a la distribución normal. Ambos valores están dentro del intervalo que va del -2 al 2.

El segundo ejemplo es una muestra de las edades de 1129 alumnos de la Universidad de Barcelona. Ahora observemos que si representamos esa muestra mediante la Media y la Desviación estándar corremos el peligro de que si hacemos esos intervalos nos encontremos con errores importantísimos. La media son 22.2 años y la DE es 3.89. Si ahora construimos los típicos intervalos nos encontramos con inferencias que no son reales. Simplemente por la no normalidad de los datos:

IMG_7101

La Asimetría estandarizada de esta muestra es 67.26 y la Curtosis estandarizada es 269.24. Esto es una forma más objetiva de valorar el ajuste a la distribución normal. Ambos valores están fuera claramente del intervalo que va del -2 al 2. Por lo tanto, claramente se trata de una variable que no se ajusta a la distribución normal.

La Desviación estándar es un magnífico descriptor, pero peligroso. Debe usarse con cuidado. Demasiadas veces el no introducido con los problemas que aquí comento comete errores de inferir a partir de ella cosas que sólo son ciertas si la variable se ajusta a una distribución normal. Es por eso que estos casos suele recomendarse el uso de la median y el rango intercuartílico. En este último caso podríamos describir la variable Edad mediante los valores: 22 (20-23). Observemos que aunque se habla en estos casos de Mediana y Rango intercuartílico, en realidad, más que darse el Rango intercuartílico propiamente, suele darse primer y tercer cuartil. De esta forma se está dando el rango intercuartílico y los dos valores concretos a partir de los cuales se calcula. Por lo tanto, se está dando más información.

Es por lo tanto muy importante saber en qué momentos tiene sentido usar uno u otro sistema descriptivo. Y es muy importante, también, saber usar bien la desviación estándar, saber qué papel juega, saber cuándo puede tener mucho protagonismo y cuándo debe quedar más en un segundo plano.

Resumiendo:

1. Si la variable se ajusta bien a la distribución normal el cálculo de la Media y la Desviación estándar es la mejor opción puesto que mediante ellos se tiene perfectamente caracterizada la distribución de la población de donde se ha tomado la muestra.

2. Si la variable no se ajusta bien a una distribución normal es conveniente dar la Mediana y el Rango intercuartílico. La media y la desviación estándar, en este caso, pueden llevar a inferencias rutinarias peligrosas. De hecho, la desviación estándar es muy buen descriptor pero peligroso. Bien usado perfecto, pero mal usado puede llevar a inferencias muy alejadas de la realidad.

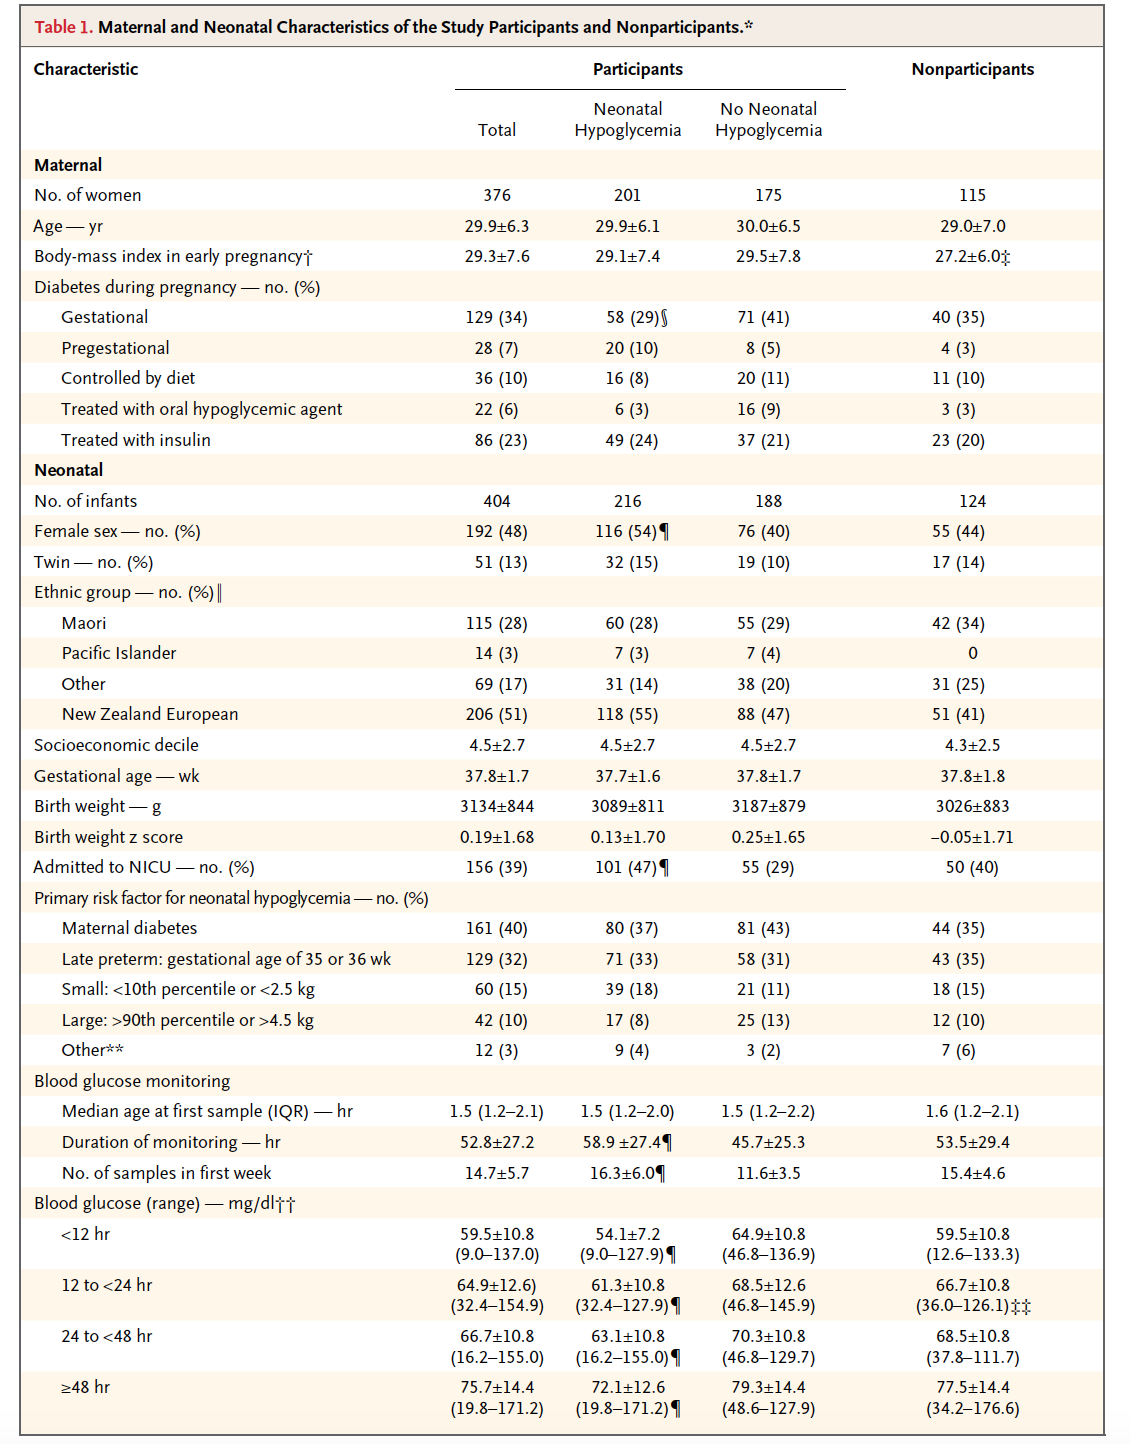
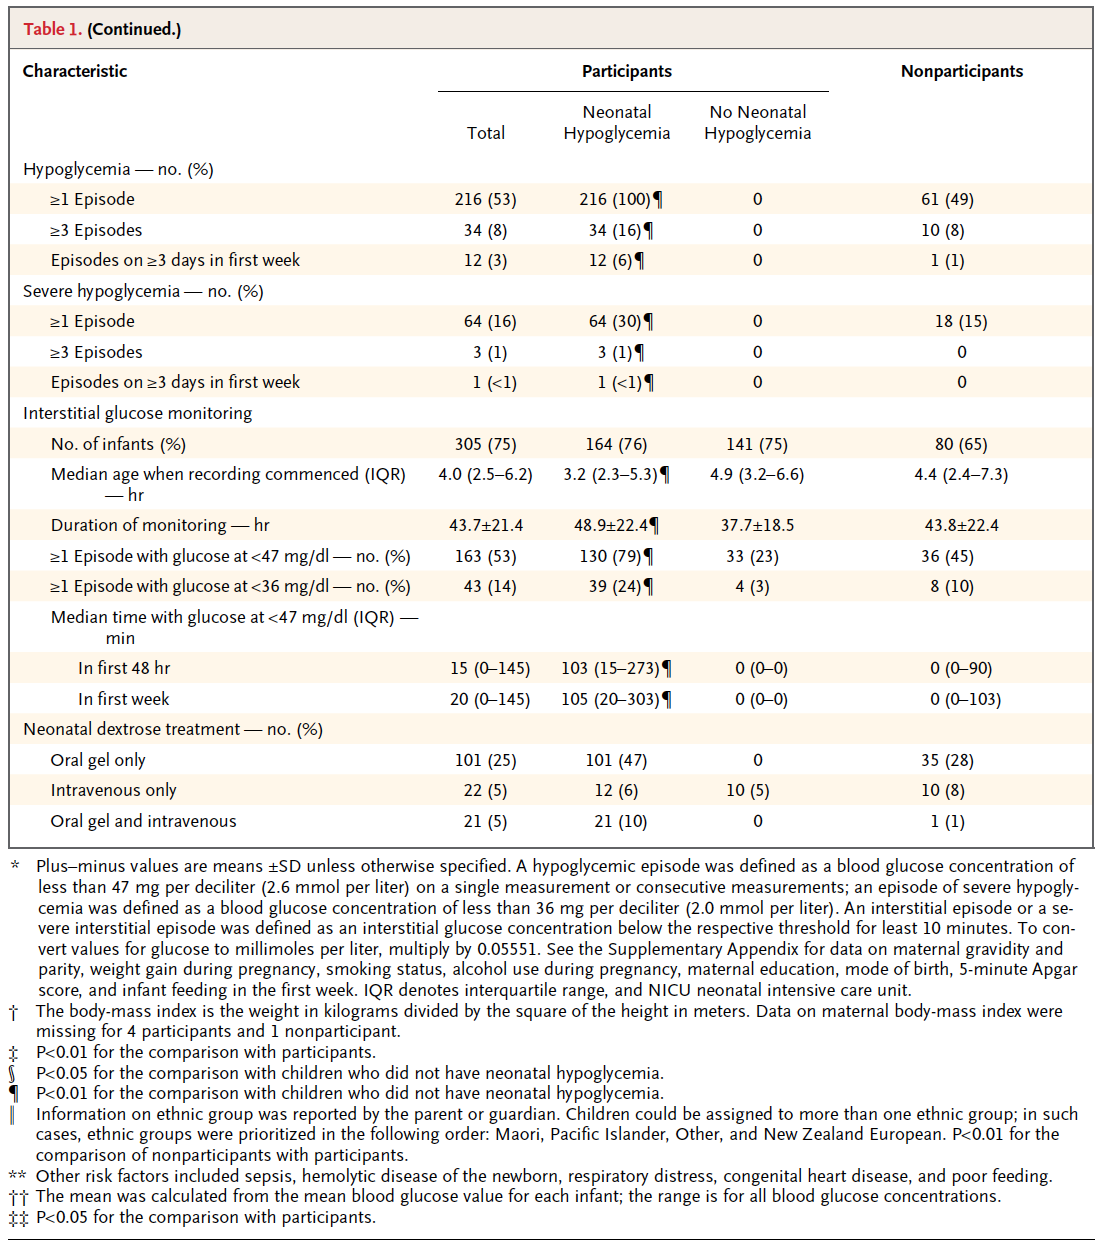
Observemos en la siguiente tabla de un artículo de medicina cómo se presenta la información en una Estadística descriptiva. Las variables cualitativas con la frecuencia absoluta y, entre paréntesis, la frecuencia relativa. Las variables cuantitativas cuando no se dice lo contrario se expresa la media más menos la desviación estándar y, en muchas ocasiones, indicándolo, se expresa con la mediana y el rango intercuartílico (IQR). Observemos, también, que, a veces, se presenta el rango, expresado mediante el mínimo y el máximo:
Captura de pantalla 2015-10-15 a las 10.11.53

Captura de pantalla 2015-10-15 a las 10.12.20

Solución Situación 41

El experimento está configurado por tres factores. El factor Tipo de Hospital, fijo, y a dos niveles. El factor Aparato o Sistema de desinfección, fijo, también, y a dos niveles. El factor Sala, aleatorio y anidado en Hospital. Por lo tanto, Hospital y Aparato están cruzados y Aparato y Sala también.

El modelo es el siguiente:

captura-de-pantalla-2016-12-23-a-las-11-06-13

Si aplicamos el Algoritmo de Bennet-Franklin tenemos las siguientes esperanzas de los cuadrados medios:

IMG_7091

A partir de estas esperanzas de los cuadrados medios debemos hacer los siguientes cocientes en los contrastes de hipótesis de este modelo:

IMG_7092

La tabla ANOVA es, pues, la siguiente:

IMG_7094

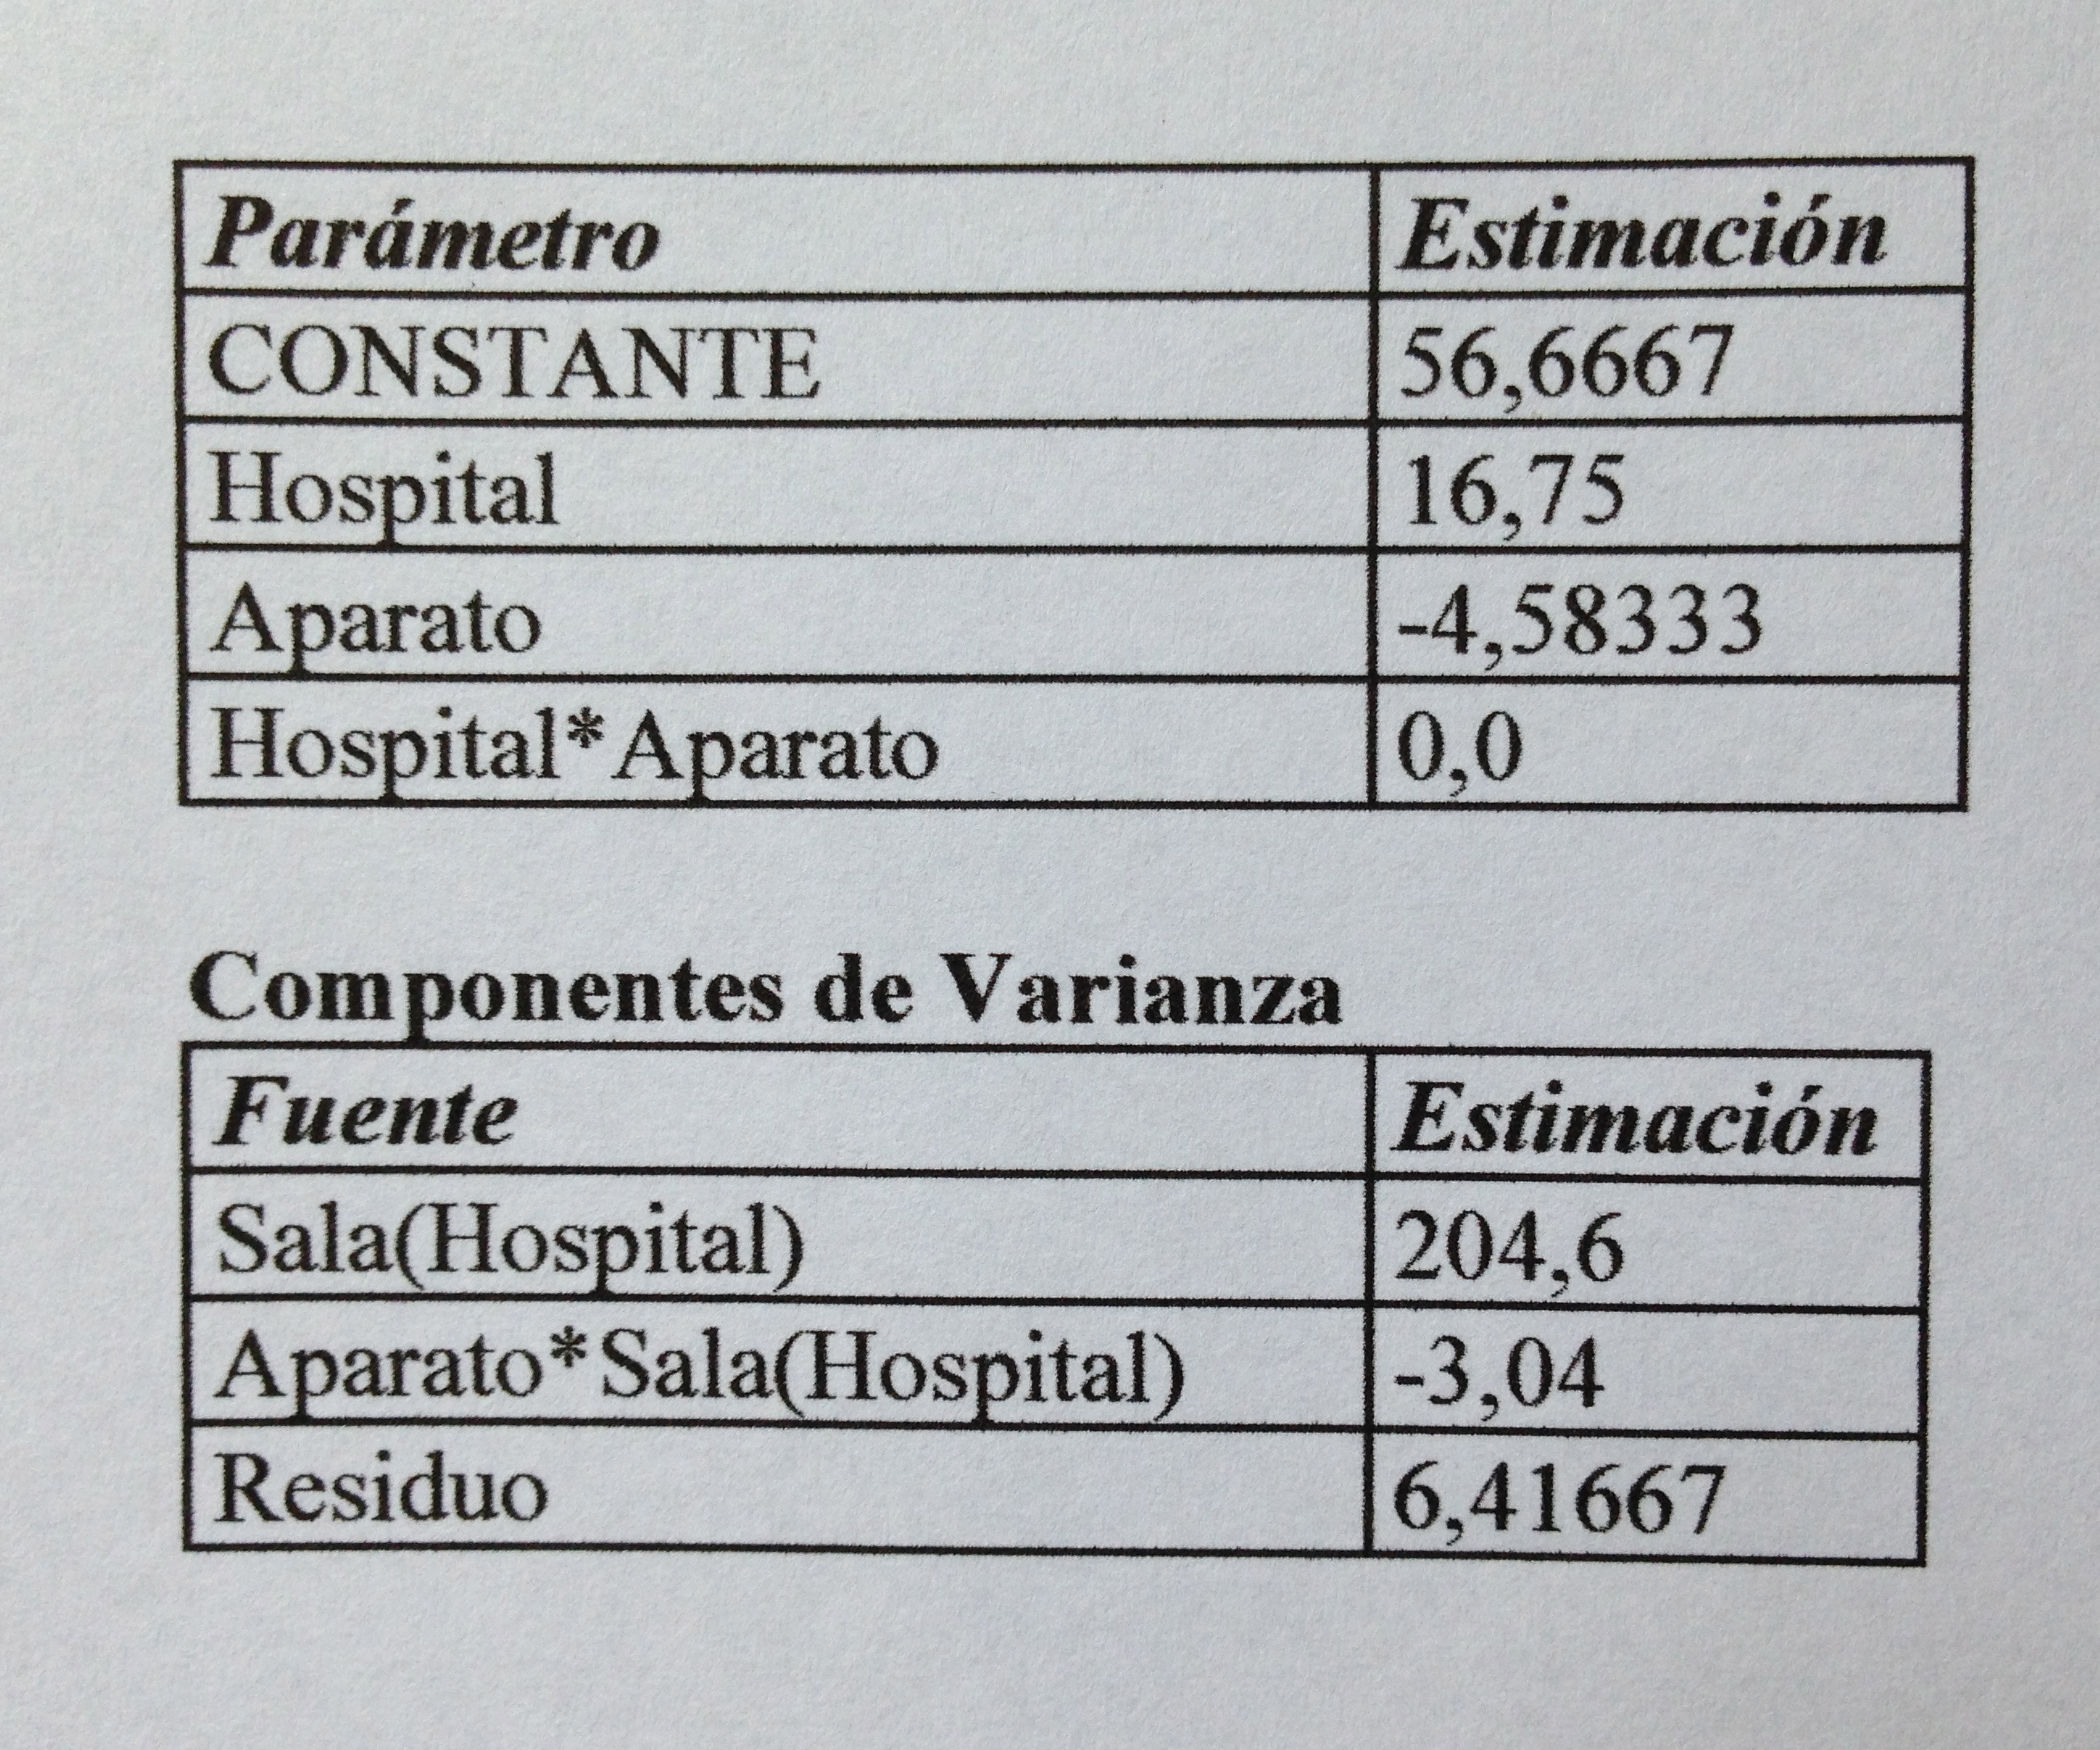
Esto nos da la siguiente estimación de los parámetros y de las componentes de la varianza:

IMG_7095

El cálculo de la componente de la varianza del residuo sale del valor de cuadrado medio del residuo en la tabla ANOVA. Las otras dos de los siguientes cálculos a partir de las esperanzas de los cuadrados medios:

IMG_7093

Evidentemente la componente de la varianza de la interacción entre Aparato y Sala, anidado dentro de Hospital, ya hemos visto que no era significativa, en la tabla ANOVA. La estimo para que se vea cómo se realiza. En ocasiones aunque no sea significativa es interesante estimarla y dar el valor de esa estimación. Evidentemente, si la estimación es negativa en ningún caso se dará tal estimación. Una varianza nunca puede ser negativa. Es un artefacto de la estimación. Al ser la componente tan insignificante, puede que por azar la estimación sea negativa. En este caso no se diría que la componente de la varianza estimada es -3,04 sino que se diría que es, simplemente, 0.

Situación 41: Un problema de ANOVA

Supongamos que se ha ensayado en dos Hospitales (Uno de segundo y otro de tercer nivel) dos aparatos (A y B) para eliminar, en las salas, la contaminación ambiental. Para ello se toman al azar tres salas en cada uno de esos dos Hospitales. Se ensaya un día (un viernes por la tarde) mediante un aparato. Antes de empezarse con el tratamiento se toma una muestra de un metro cúbico de aire y se inicia entonces el proceso que dura una hora. Una vez finalizado el proceso se espera tres horas y entonces se toman dos muestras de un metro cúbico cada una y se evalúa el porcentaje de reducción de las unidades formadoras de colonias (ufc)/m3 en cada una de ellas. La semana siguiente, también un viernes por la tarde, se sigue exactamente el mismo procedimiento con el otro aparato.

Los datos obtenidos son los siguientes:

IMG_7081

Se quiere saber si hay diferencias significativas en cuanto a la eficacia del tratamiento entre Hospitales de segundo y tercer nivel, entre los dos aparatos y entre salas. Se quiere saber, también, si hay alguna interacción destacable.

Solución Situación 40

La respuesta correcta es la «c». Cuando se comparan dos métodos diagnósticos mediante curvas de este tipo el criterio es que es mejor método el que tiene una mayor área bajo la curva. Y la VS tiene un área mayor que la VTD.

Las curvas COR o ROC (en el orden de palabras inglés) es un mecanismo globalizado para poder evaluar una variable como método diagnóstico. En el Tema 23: Análisis ROC se explica cómo es la confección de esas curvas. En resumen, dado un método diagnóstico, lo que se hace es ir cambiando el umbral, el punto de corte, del valor de una variable para clasificar a un paciente entre dos opciones (tener o no la patología que se pretende diagnosticar). De esta forma se establece una medida de calidad del método diagnóstico. El área bajo la curva creada es uno de esos criterios.

La opción «a» no es cierta porque no es cierto que sean similares porque el área bajo la curva sea superior al 50% (generalmente los valores de área bajo la curva se dan en tanto por 1; en este caso diríamos, pues, 0.5). El criterio es que el área bajo la curva sea lo más próximo a 1, lo que indica que el método consigue una mejor calidad diagnóstica.

La opción «b» no es cierta porque la curva se aproximará más al ángulo superior izquierdo si él área es mayor y quien tiene un área bajo la curva mayor es la VS y no la VTD.

La opción «d» no es cierta porque la prevalencia no afecta ni a la sensibilidad ni a la especificidad, que son los dos conceptos con los que se configuran las curvas ROC. Afecta, eso sí, al Valor predictivo positivo y al Valor predictivo negativo, como puede verse en el artículo Sensibilidad, Especificidad, Valor predictivo positivo y Valor predictivo negativo.

La opción «e» no es cierta, tampoco. Precisamente el principal uso de esas curvas es para valorar la calidad de alguna variable cuantitativa, como las dos propuestas, para establecer un mecanismo diagnóstico. La RMN aparece, aquí, como el Gold standard que actúa como referencia de calidad de las dos variables obtenidas mediante el eco-doppler. El mecanismo que nos dice si realmente hay o no estenosis. Estenosis que queremos diagnosticar mediante esas dos mediciones que estamos comparando. Hemos de tener en cuenta que para valorar la calidad de un método diagnóstico debemos basarnos en una muestra de pacientes con la patología y otra muestra sin ella, para evaluar la calidad de la variable estudiada como método diagnosticador.

Situación 40: Una pregunta del MIR sobre curvas ROC

Queremos validar el eco-doppler carotídeo como prueba de cribado de la estenosis carotídea asintomática. Para ello comparamos los parámetros velocimétricos del eco-doppler velocidad sistólica (VS) y velocidad telediastólica (VTD), frente al resultado de la RMN (estenosis sí/no). En una curva COR se obtiene un área bajo curva para la VS de 82% y para la VTD de 70%. Señale la correcta:

1) Estos resultados indican que ambos test son similares, ya que en ambos el área bajo la curva es superior al 50%.
2) La curva VTD se aproxima más al ángulo superior izquierdo de la gráfica COR.
3) La VS es un mejor test diagnóstico.
4) Nos falta conocer la prevalencia de la enfermedad para poder saber qué parámetro es mejor.
5) El empleo de curvas COR no es apropiado para valorar la validez de parámetros cuantitativos frente a la RMN.

Solución

Algoritmo de Bennet-Franklin

En los diferentes modelos de Análisis de la varianza (ANOVA), uno de los principales niveles de complejidad, cuando trabajamos con más de un factor, es saber cuáles son las F-ratio; o sea, los cocientes entre cuadrados medios que hay que hacer para realizar los contrastes de hipótesis necesarios para resolver del modelo. Elegir los cocientes adecuados es clave para que la decisión esté bien fundamentada.

El Algoritmo de Bennet-Franklin es un clásico mecanismo para encontrar las esperanzas de los cuadrados medios y así diseñar los cocientes necesarios para la realización de esos contrastes de hipótesis.

Evidentemente es muy recomendable leer el tema Tema 15: ANOVA para situar las nociones de factor, de nivel de un factor, de factor fijo o aleatorio, de factores cruzados o anidados, que irán apareciendo a continuación. También es importante ver los distintos modelos ANOVA que están descritos en el apartado HERBARIO DE TÉCNICAS de este Blog.

El objetivo de este Algoritmo de Bennet-Franklin es, como digo, la obtención de las esperanzas de los cuadrados medios calculados en cualquier tabla ANOVA y, por lo tanto, localizar los cocientes oportunos. Muchos software hacen cocientes incorrectos o bien dejan abierta la opcionalidad de los cocientes. El cálculo analítico de estas esperanzas es matemáticamente complejo. Por esto este sencillo algoritmo tuvo mucho éxito en su momento y continúa aplicándose hoy en día.

Veamos cómo es este Algoritmo.

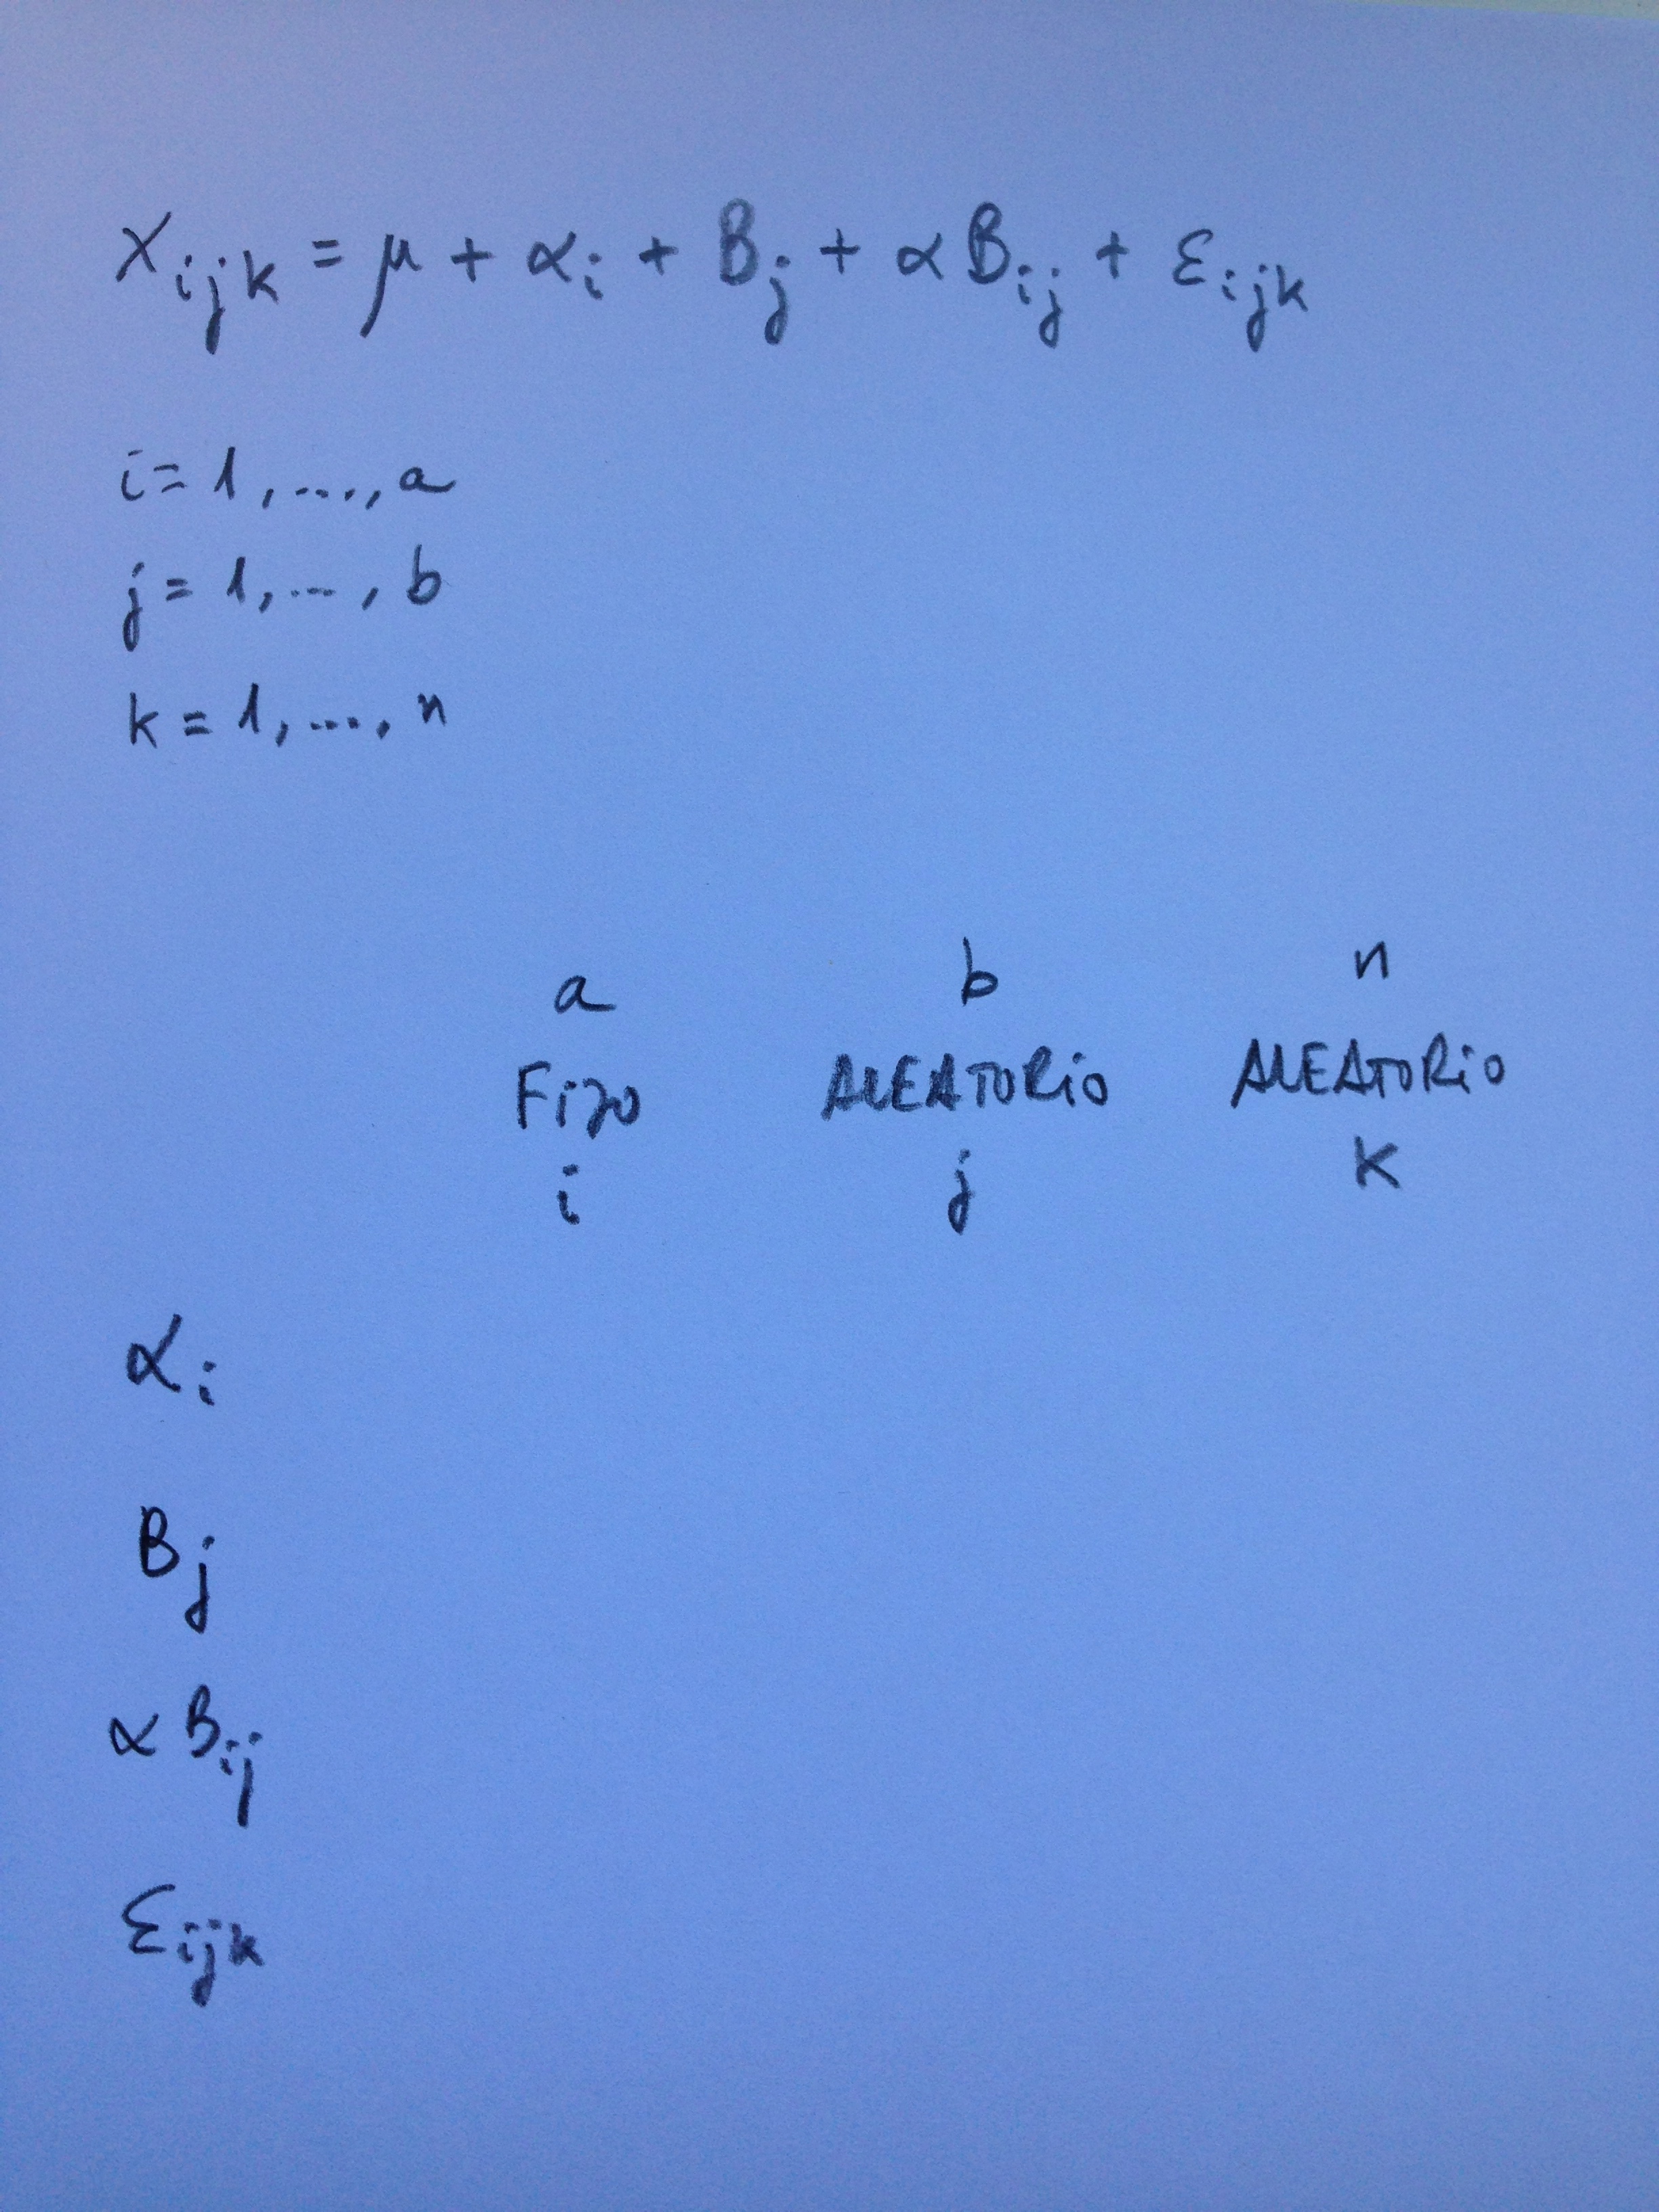
Cuando se tiene localizado el modelo se trata de crear, en primer lugar, una matriz con tantas filas como efectos (parámetros o combinaciones de los parámetros con subíndices) tenga el modelo y tantas columnas como subíndices utilizados en el modelo.

A continuación se siguen los siguientes pasos:

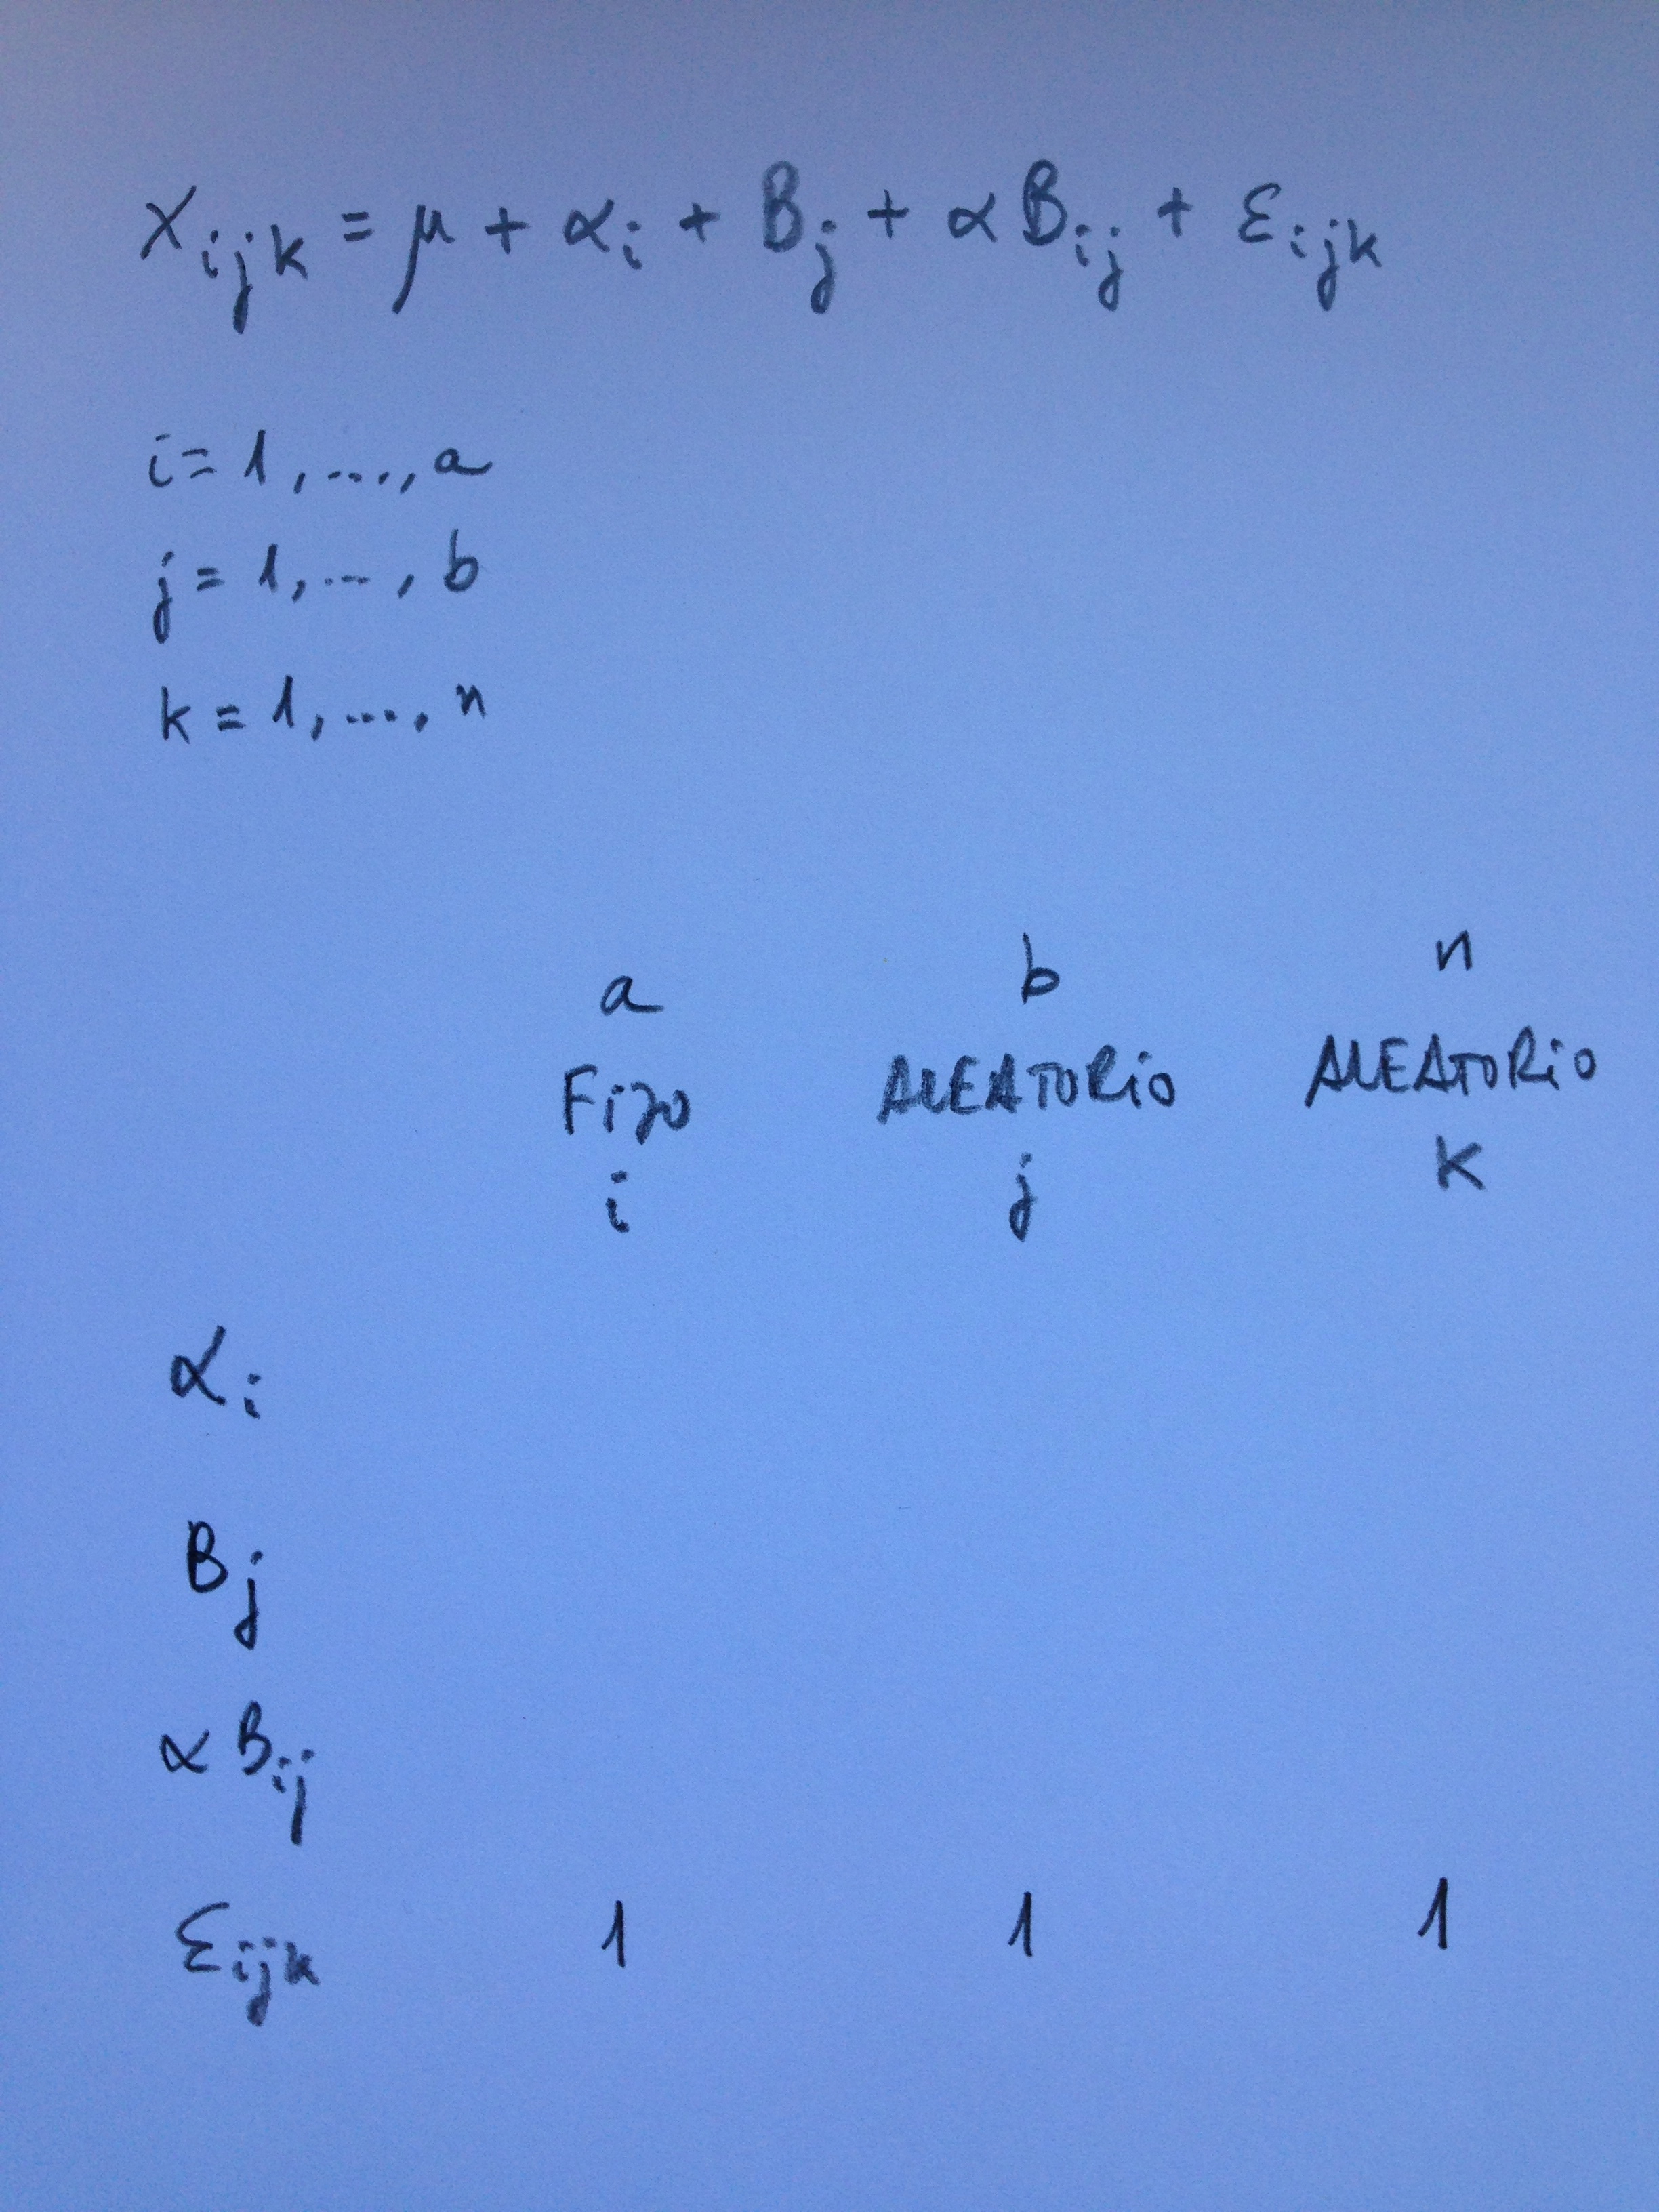
1. Se escribe 1 en toda la fila correspondiente al residuo.

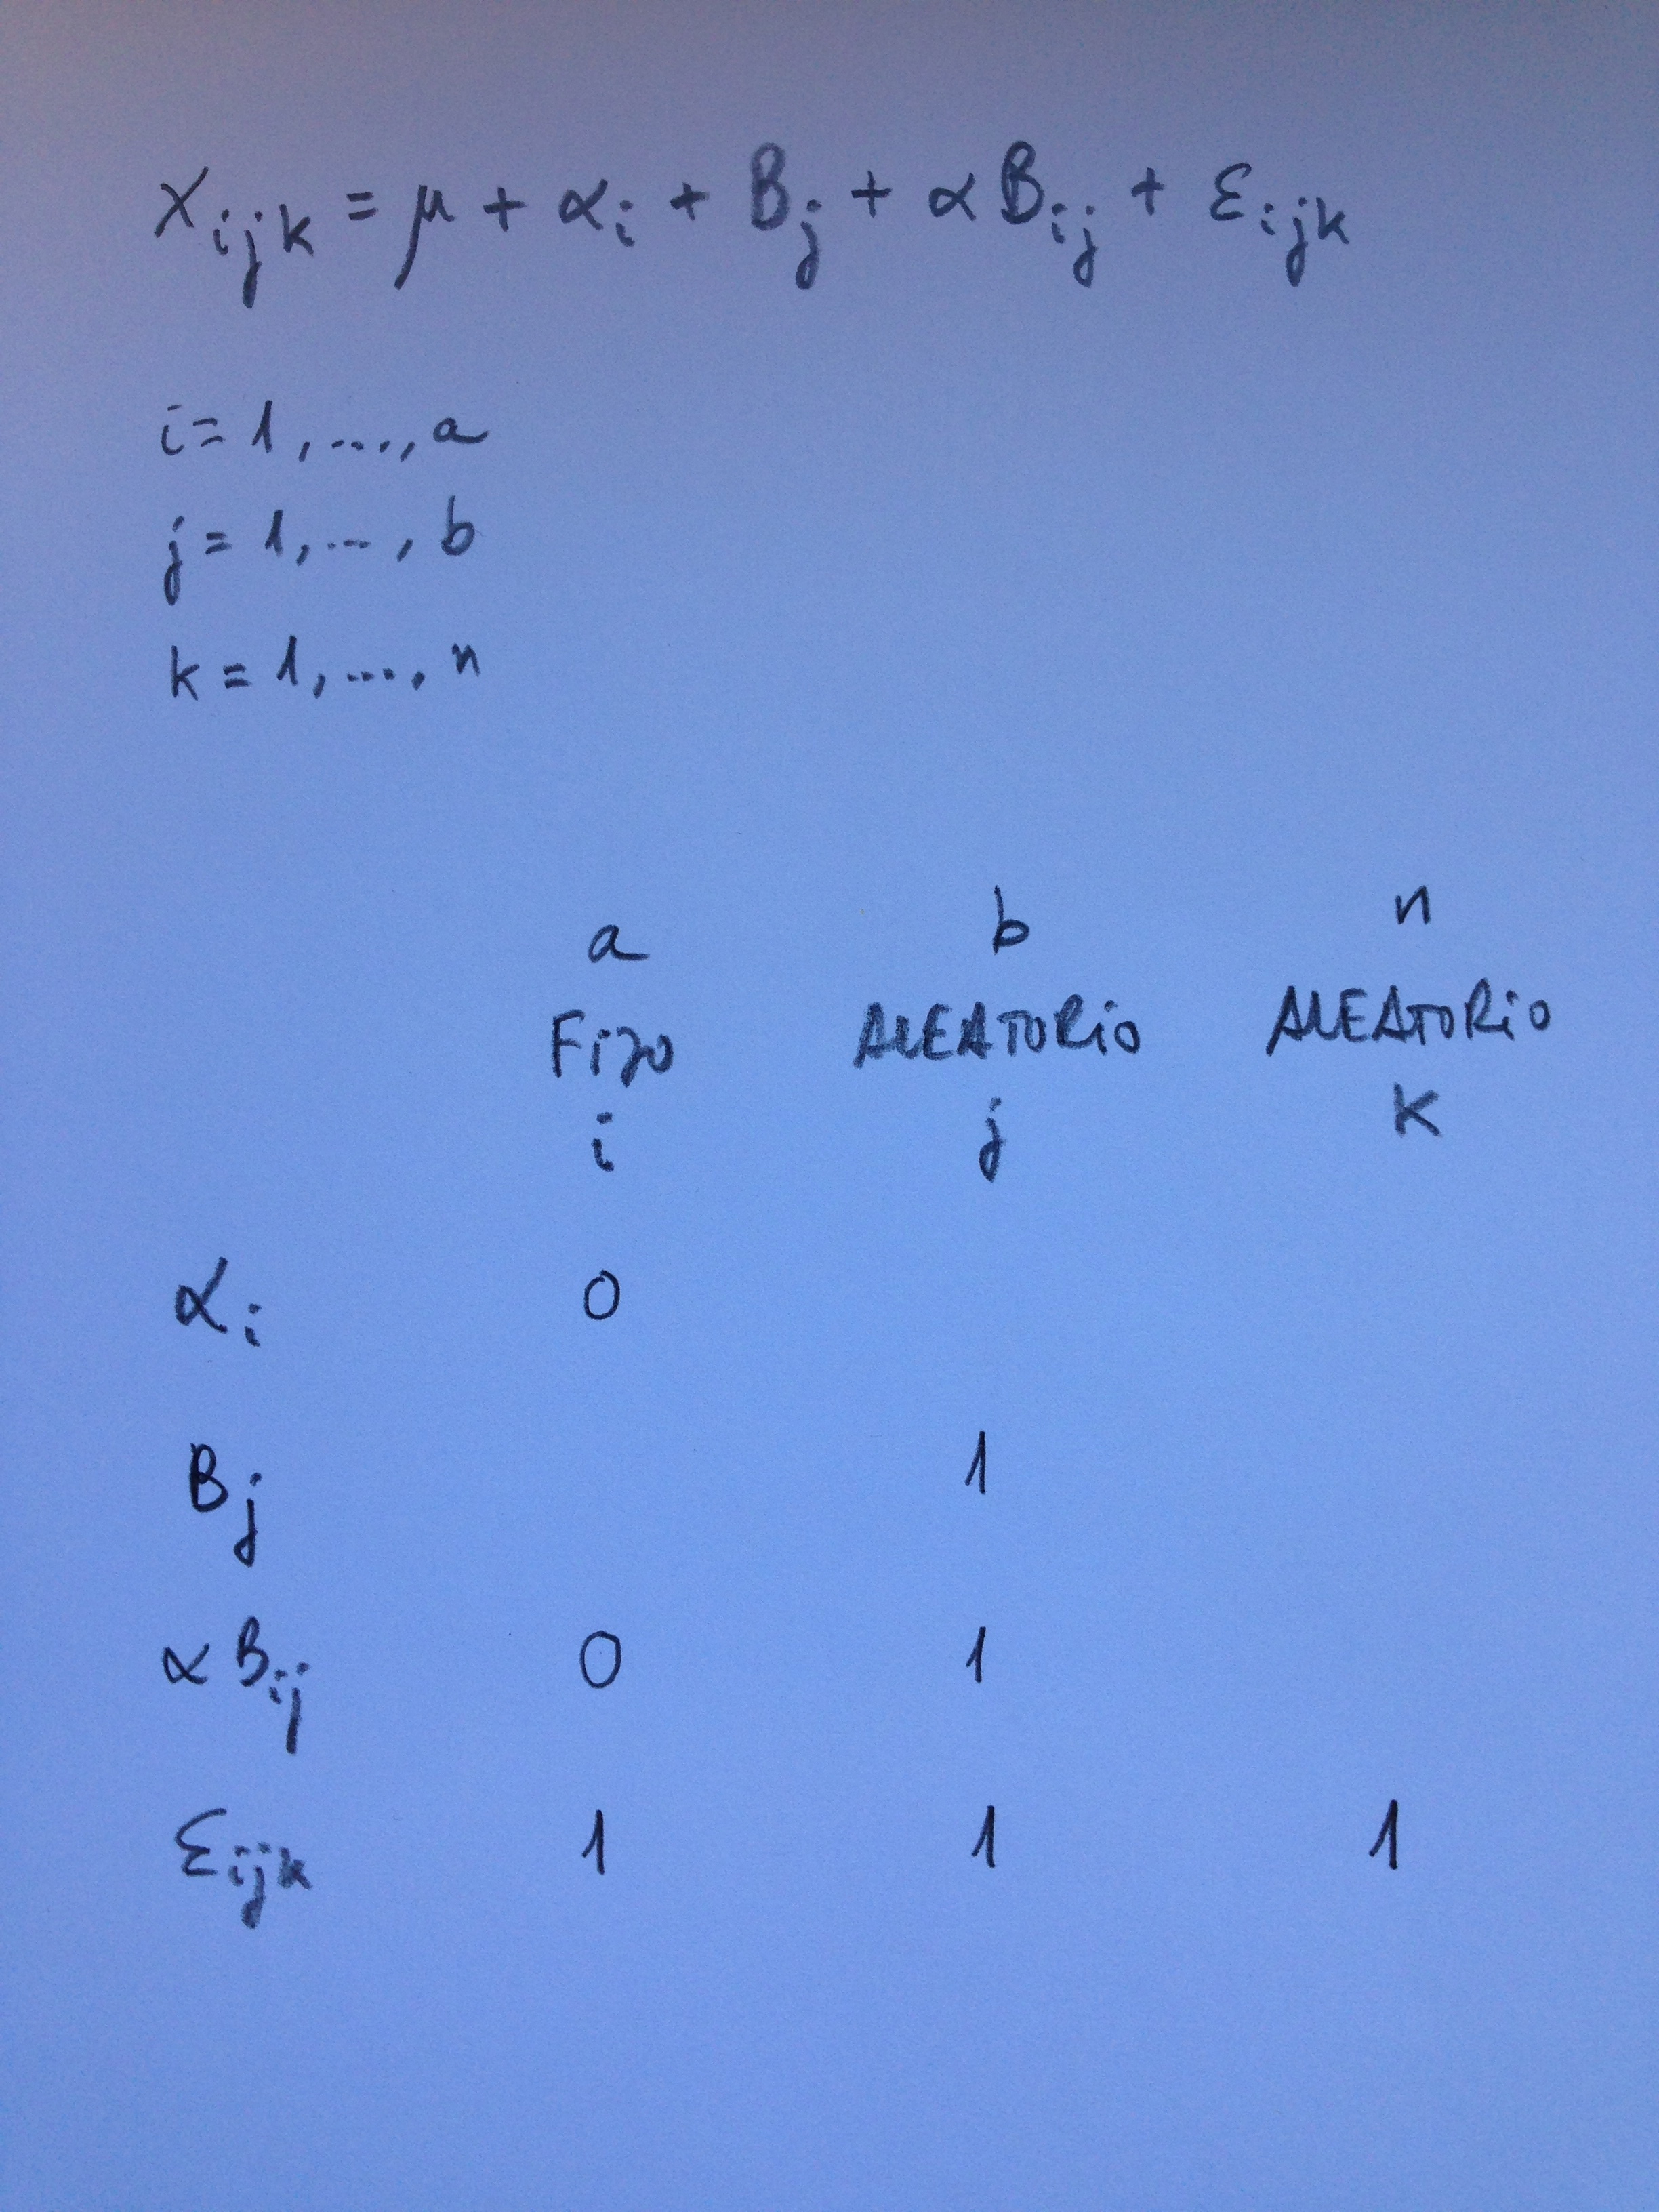
2. En todo cruce de fila con columna donde coincida un subíndice se escribe un 0 si el subíndice corresponde a un factor fijo que no corresponda a un subíndice que jerarquice a algún factor anidado en él. Se escribe, por el contrario, un 1 si el subíndice corresponde a un factor aleatorio o si forma parte de un subíndice que jerarquiza a algún factor anidado en él.

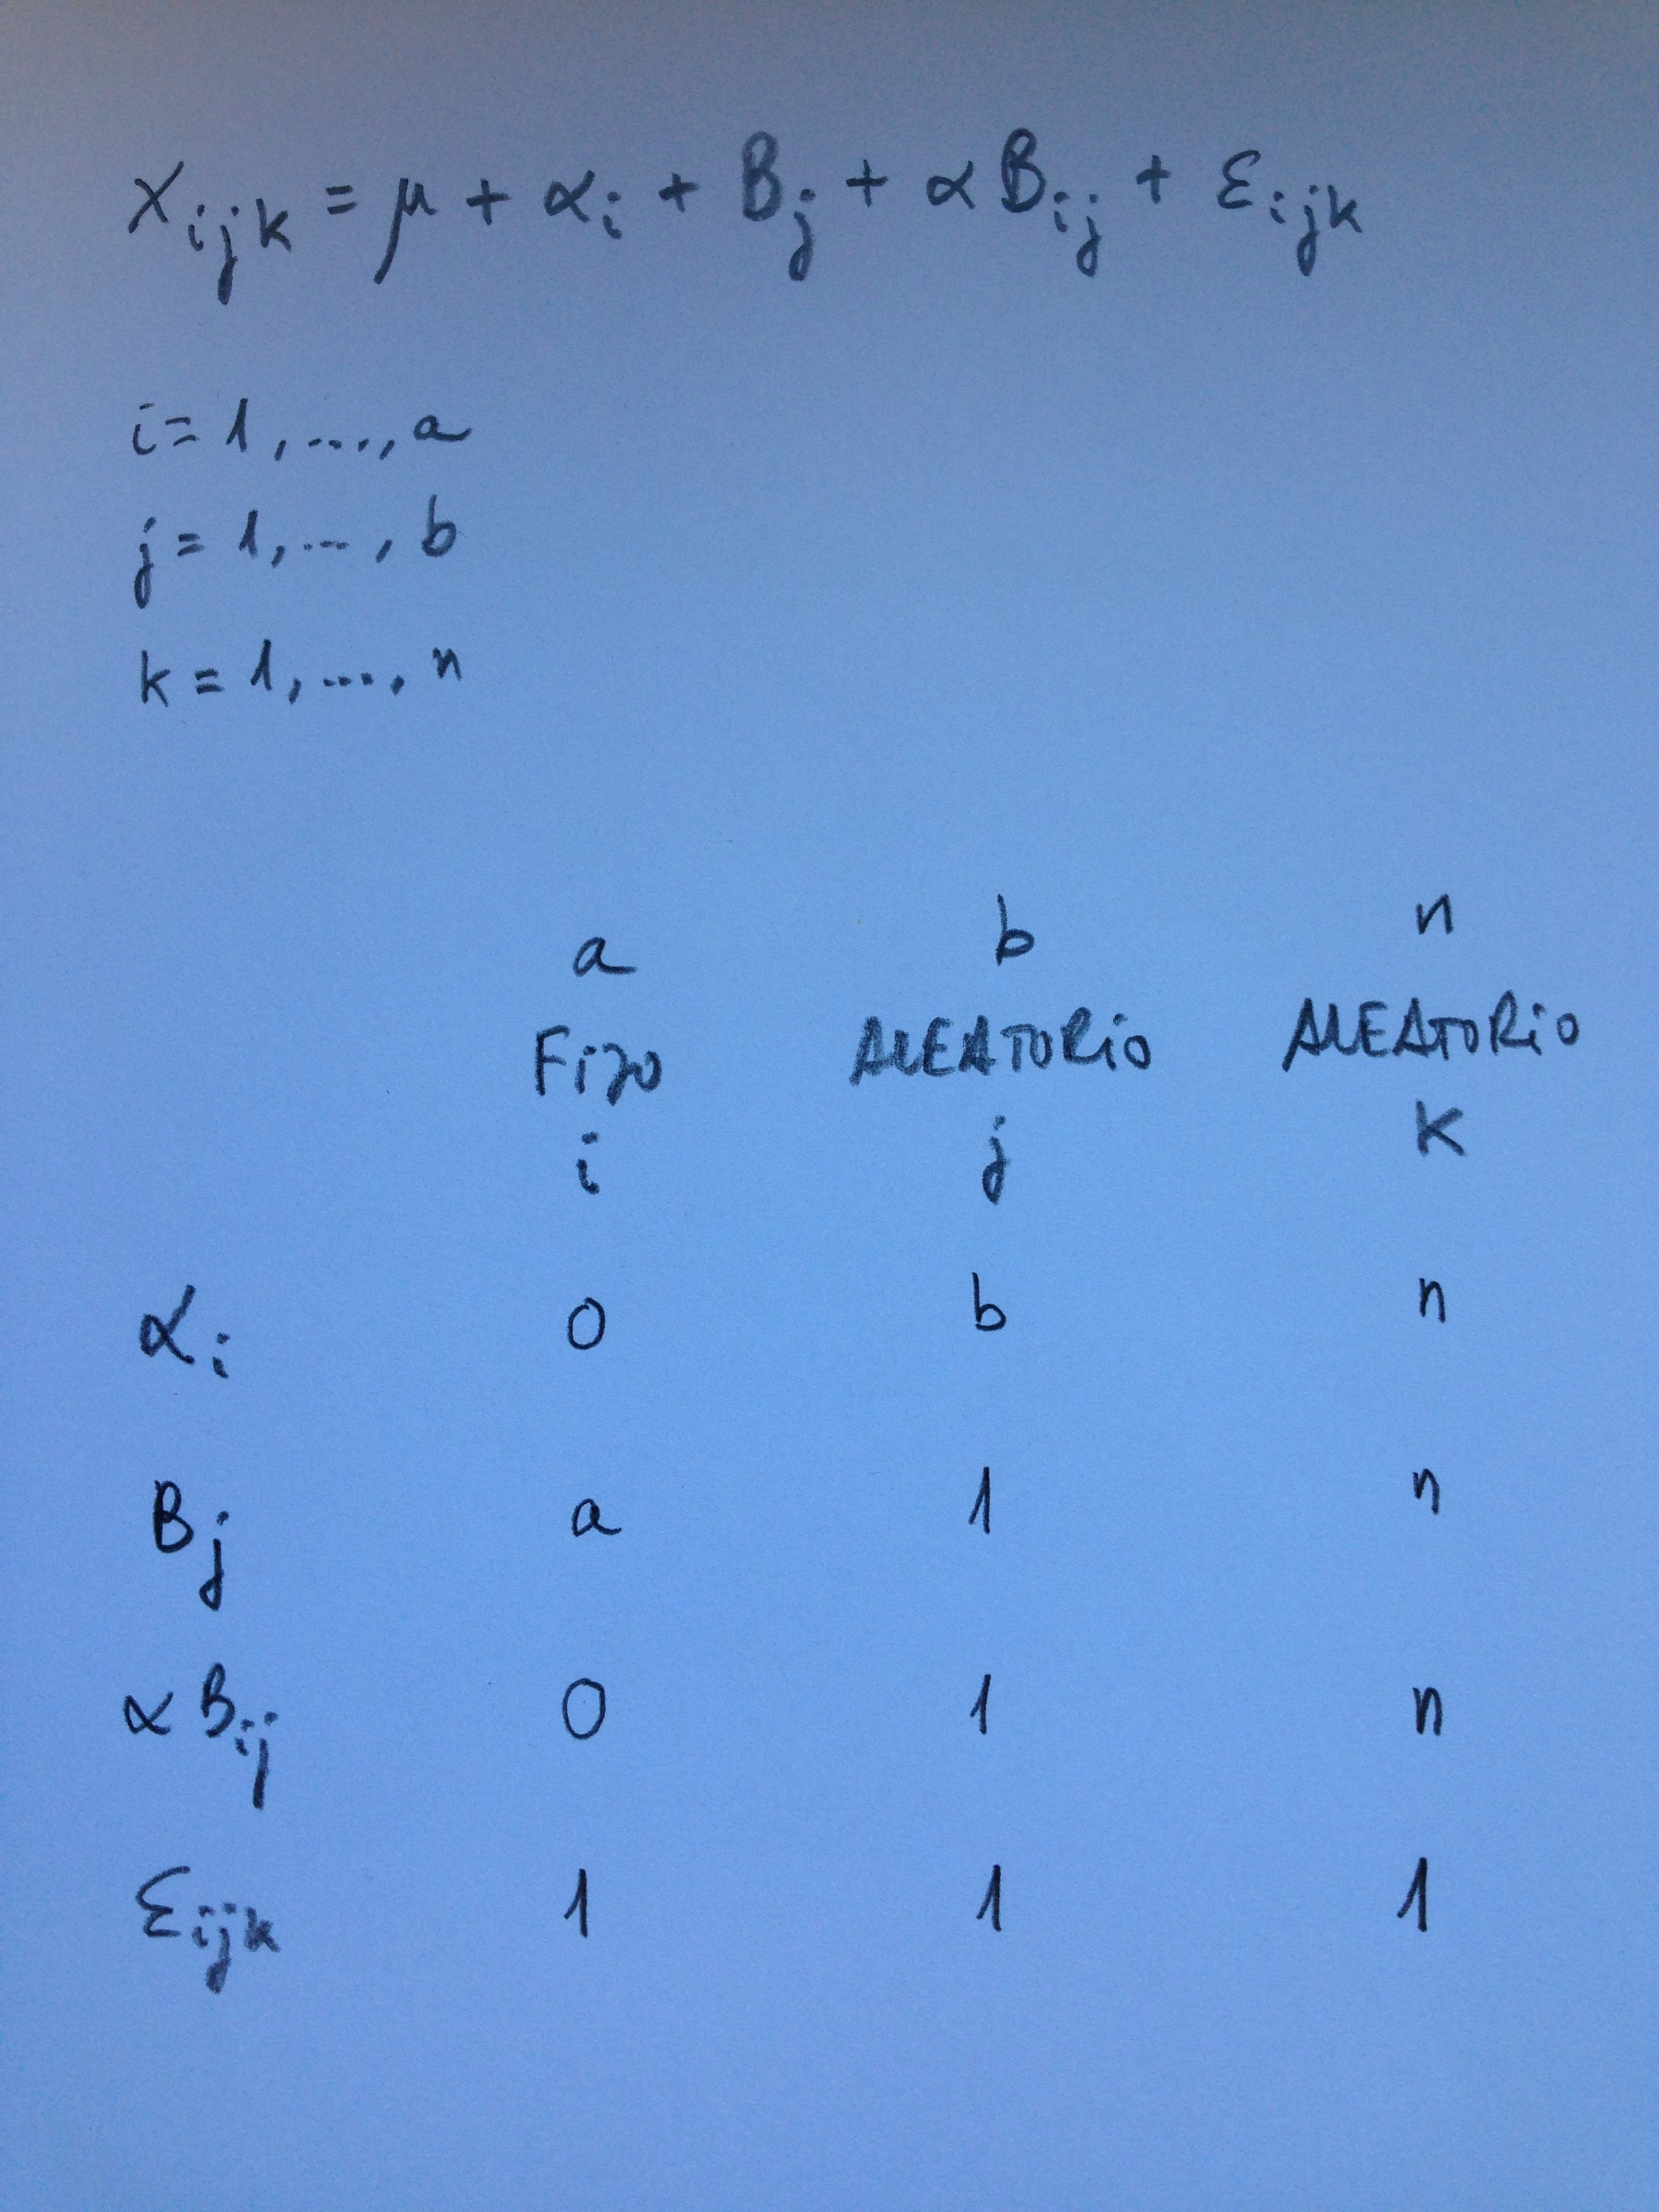
3. Los espacios vacíos se rellenan con el número de valores de cada uno de los subíndices de las diferentes filas de la matriz creada.

Veamos un ejemplo en un caso de dos factores cruzados y con un factor fijo y el otro aleatorio. Se trata del ANOVA de dos factores a efectos mixtos:

Primero se construye la siguiente matriz:

IMG_7020

Una fila por efecto y una columna por cada índice implicado. A continuación se ponen siempre, como he dicho en el apartado primero 1 en la última fila, la del residuo:

IMG_7021

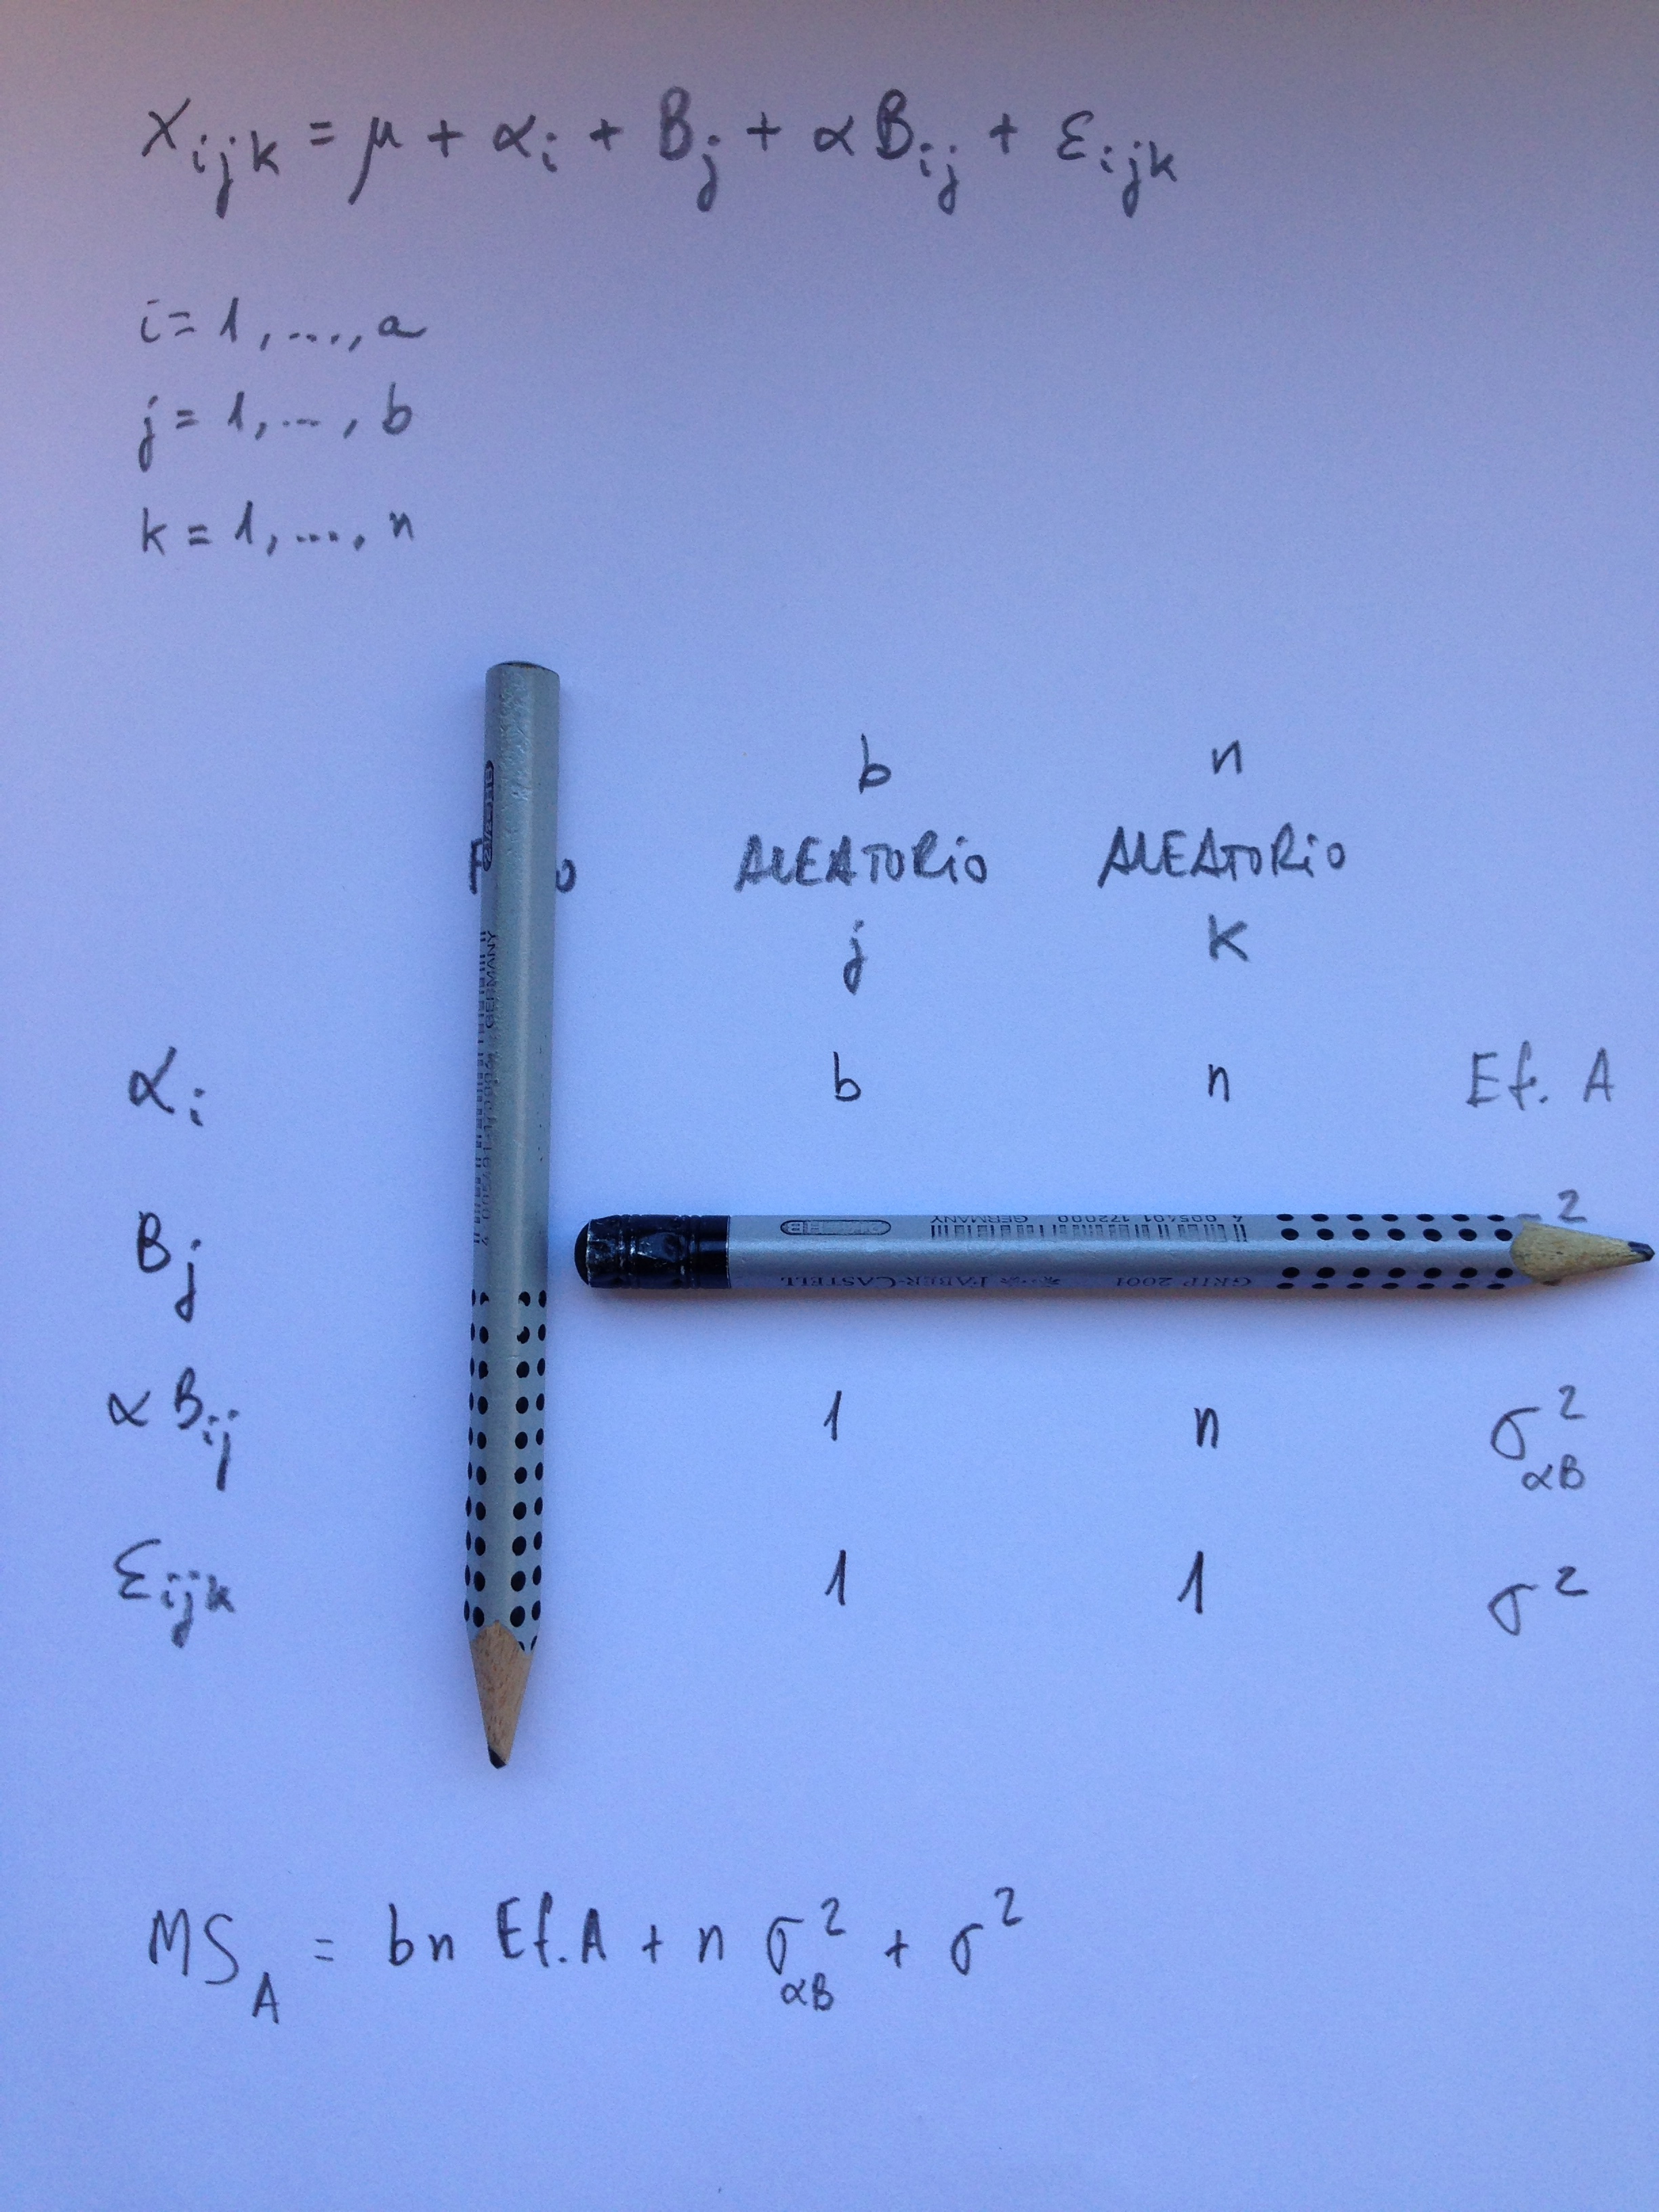
A continuación se mira cada fila por fila y cuando coincida un subíndice del efecto considerado en la fila con el subíndice de la columna se pone un 0 ó un 1 según el criterio especificado en el anterior punto 2. Lo repito: Se escribe un 0 si el subíndice corresponde a un factor fijo que no corresponda a un subíndice que jerarquice a algún factor anidado en él. Se escribe, por el contrario, un 1 si el subíndice corresponde a un factor aleatorio o si corresponde a un subíndice que jerarquiza a algún factor anidado en él.

Veámoslo en nuestro ejemplo:

IMG_7022

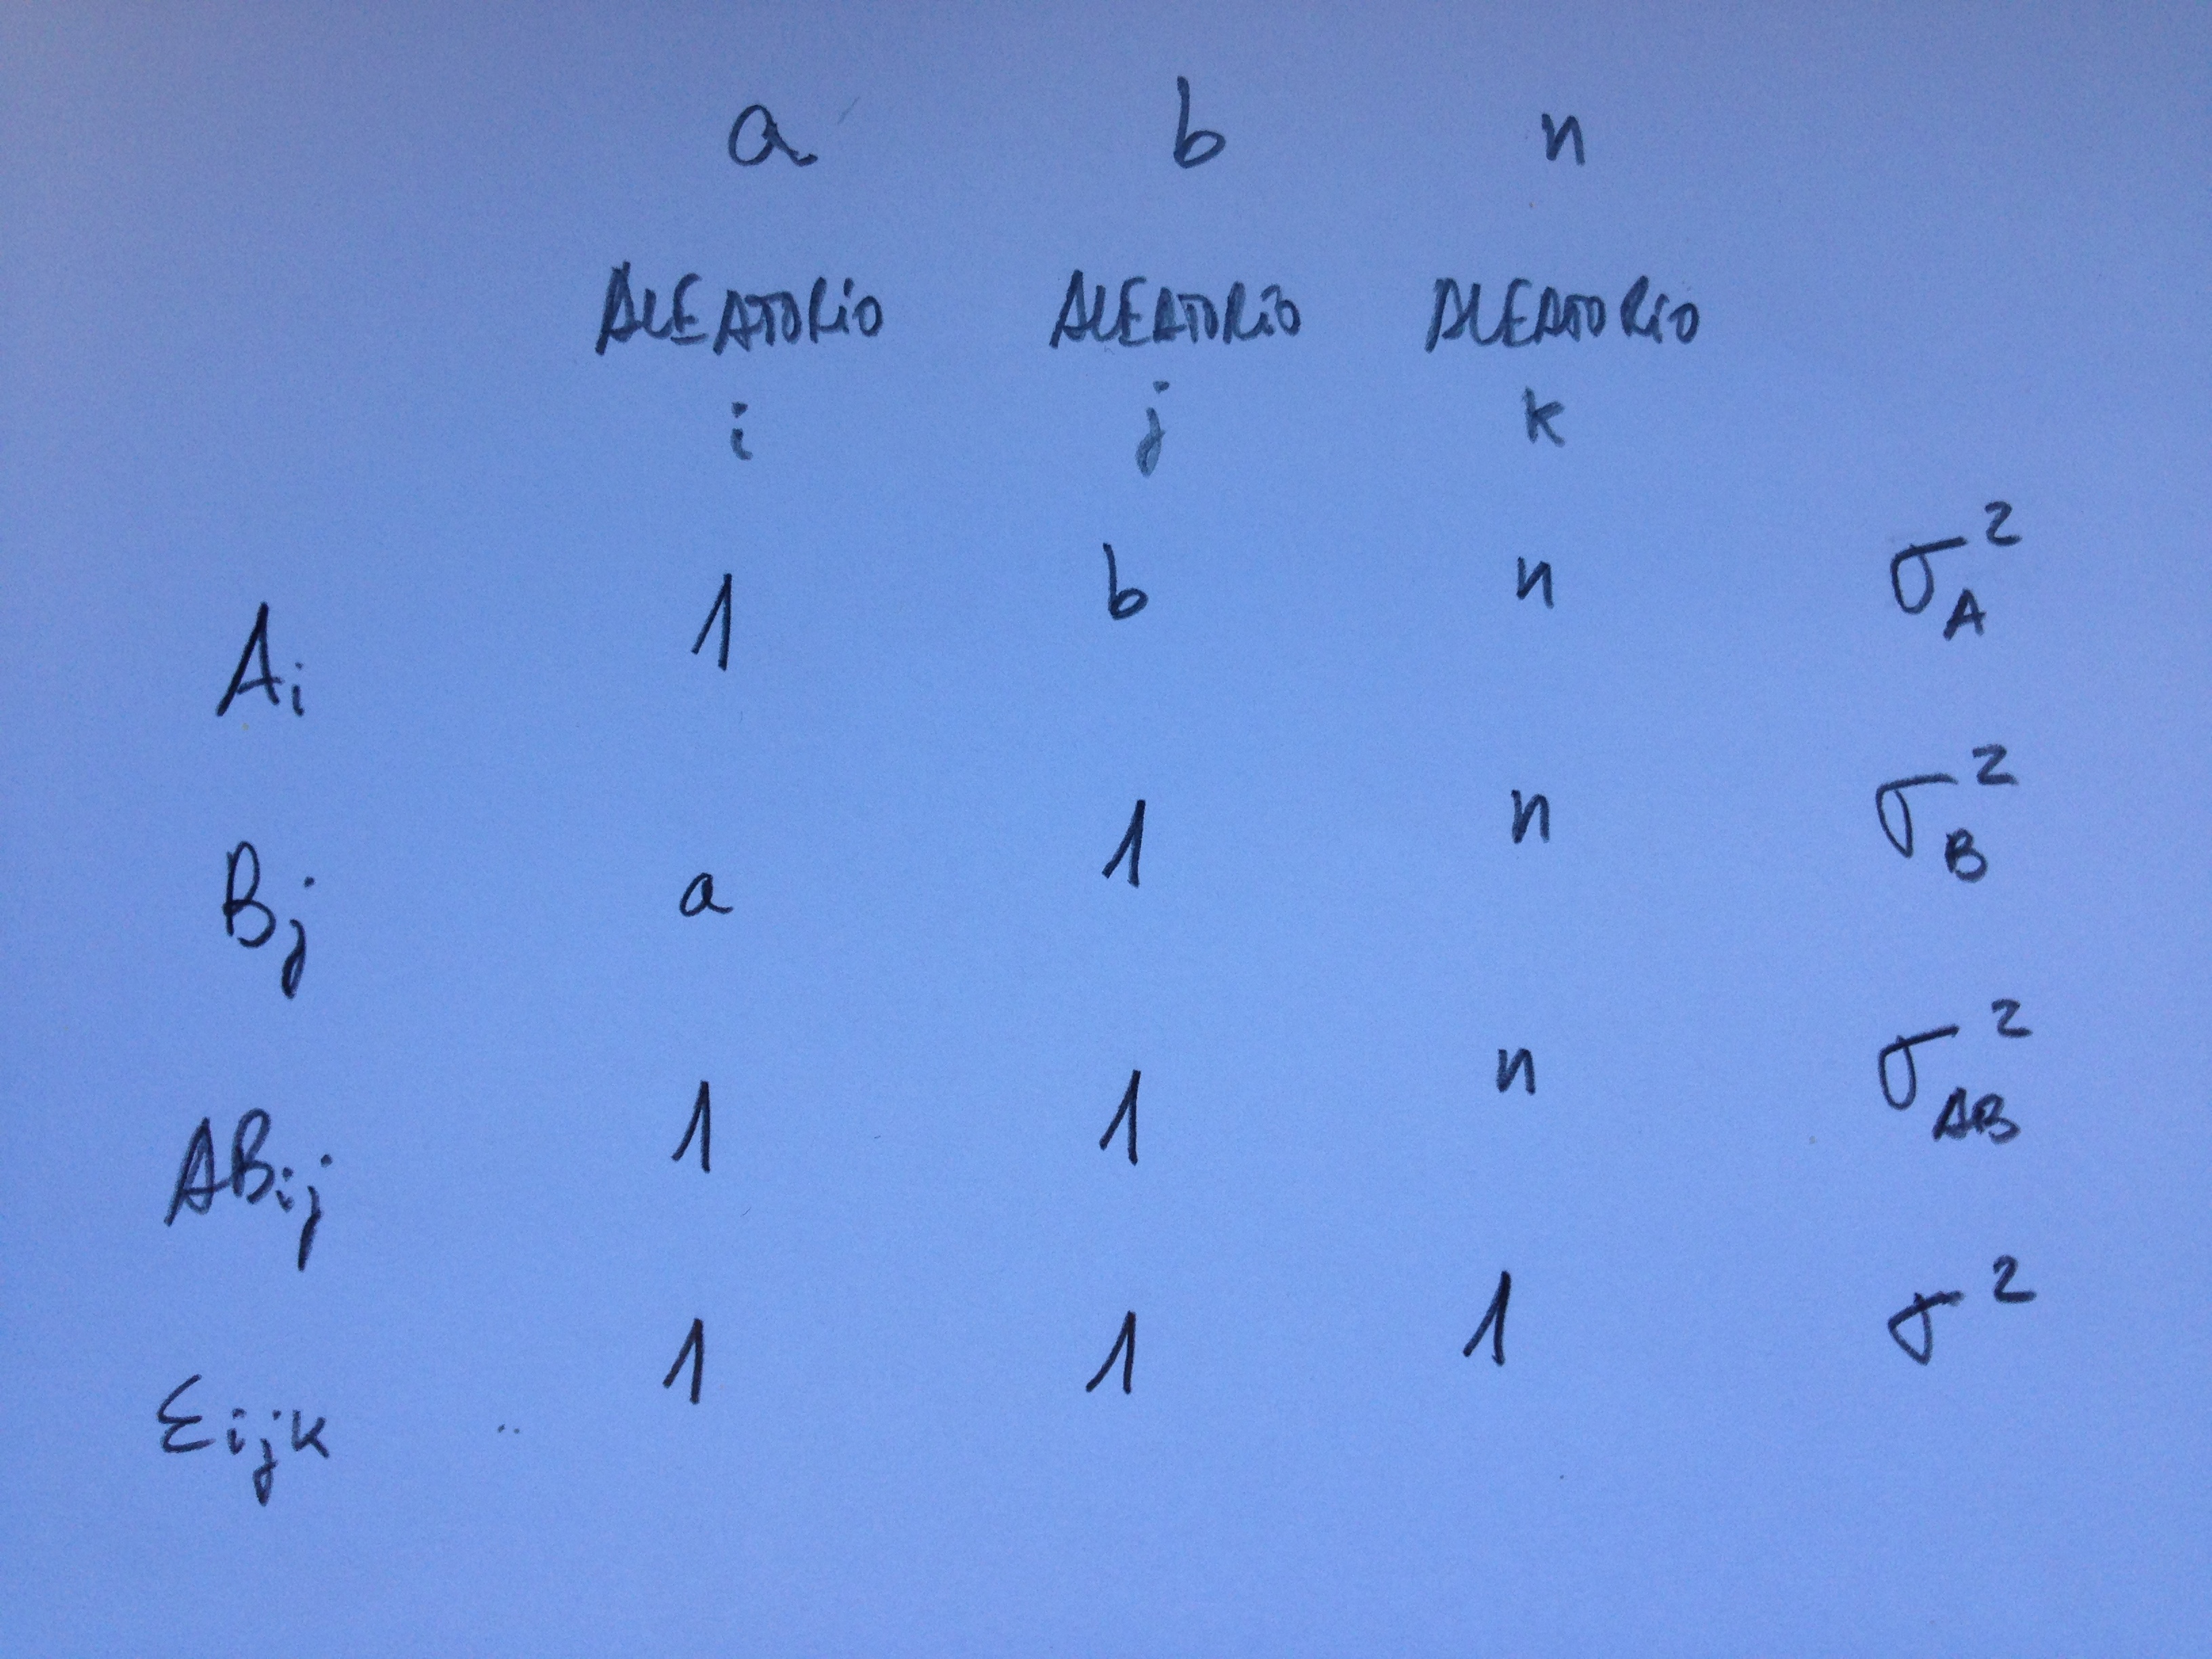
Ahora, siguiente el punto 3 anterior rellenamos las casillas vacías con los valores máximos de cada unos de los subíndices de las columnas:

IMG_7023

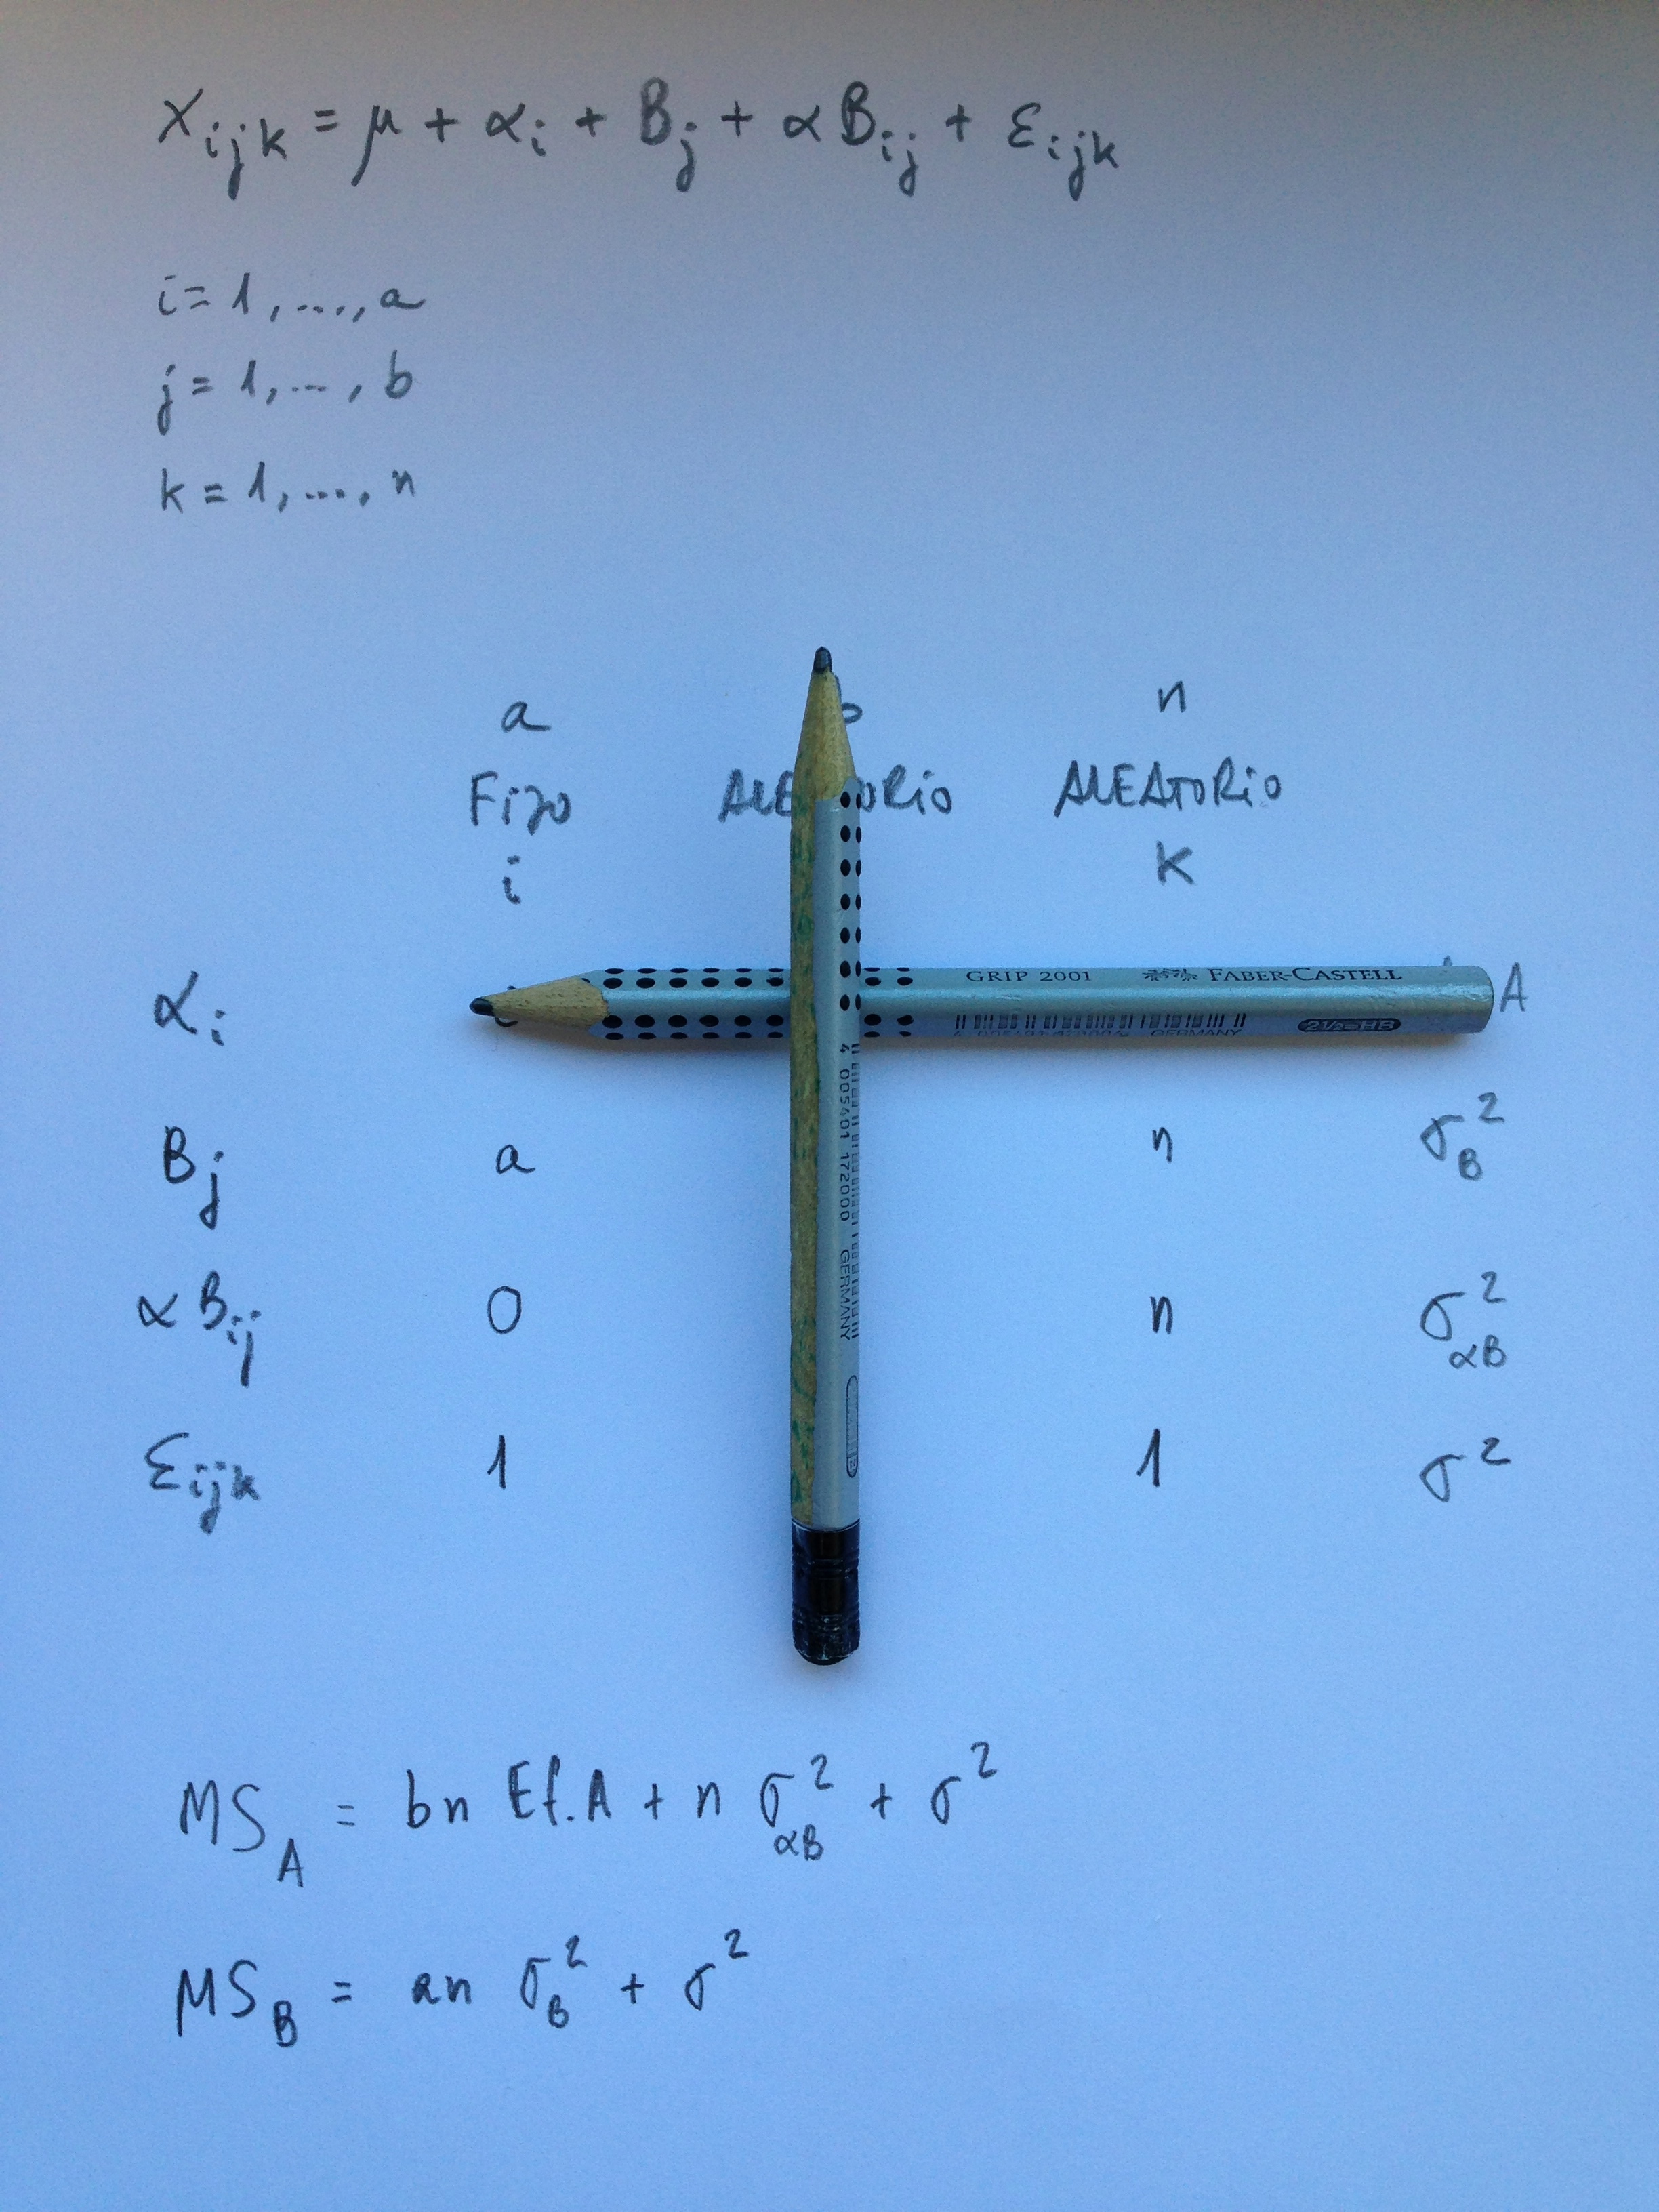
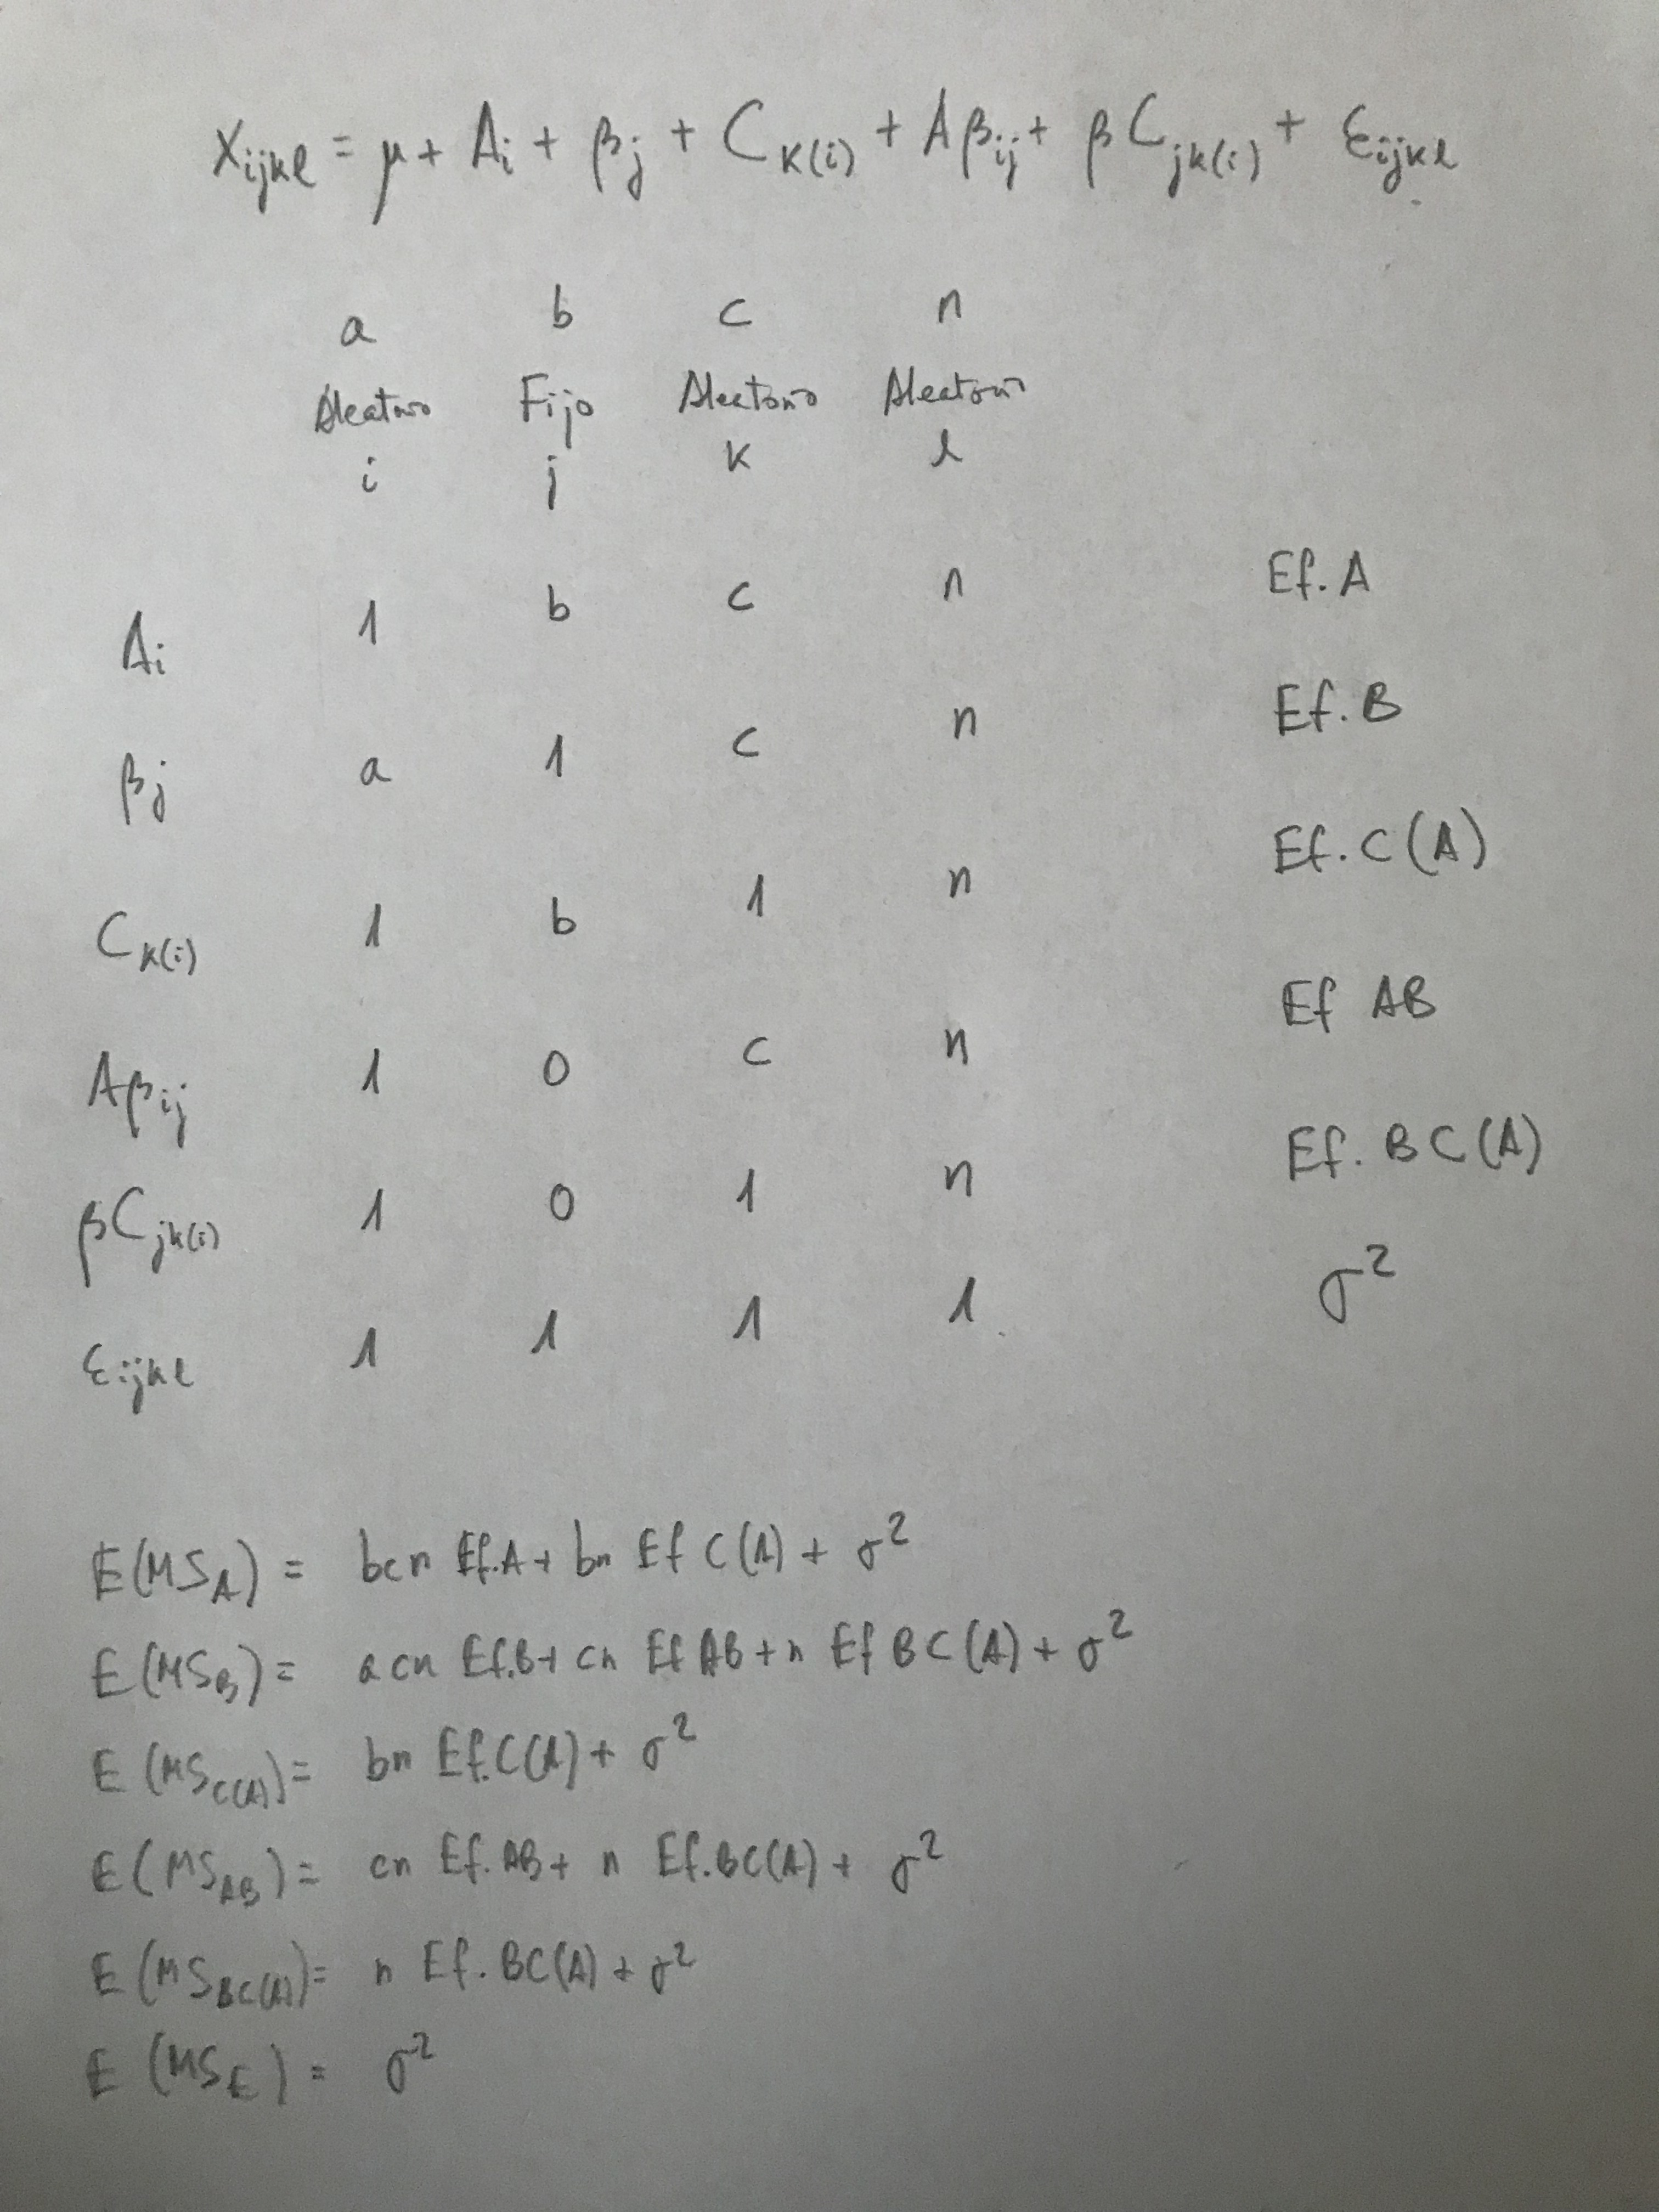
Una vez llegados aquí debemos proceder de la siguiente forma. Fila por fila (efecto por efecto) iremos calculando la esperanza de los cuadrados medios tachando siempre las columnas donde aparezcan individualmente cada uno de los subíndices implicados en el efecto y las filas que no contengan a todos los subíndices implicados en el efecto considerado en aquel momento. Veámoslo paso a paso en nuestro ejemplo inicial:

IMG_7025

Observemos que para evaluar la esperanza del primer efecto he tachado lo especificado: la primera columna, porque tiene la i y la segunda fila porque no contiene a la i. Al mismo tiempo he añadido los efectos en una columna a la derecha. Los efectos de un factor fijo pongo simplemente Efecto A o Efecto B o lo que sea (también pongo Ef.A como abreviación).

La esperanza del cuadrado medio consiste en ir multiplicando por filas lo que hay. Primera fila: bnEf.A, etc. Luego se suman estos productos por fila y acabas obteniendo la esperanza de aquel cuadrado medio.

Veamos la segunda esperanza:

IMG_7026

Observemos que ahora nos queda más simplificado porque en una de las filas hay un 0 y esto transforma el producto de toda la fila en 0.

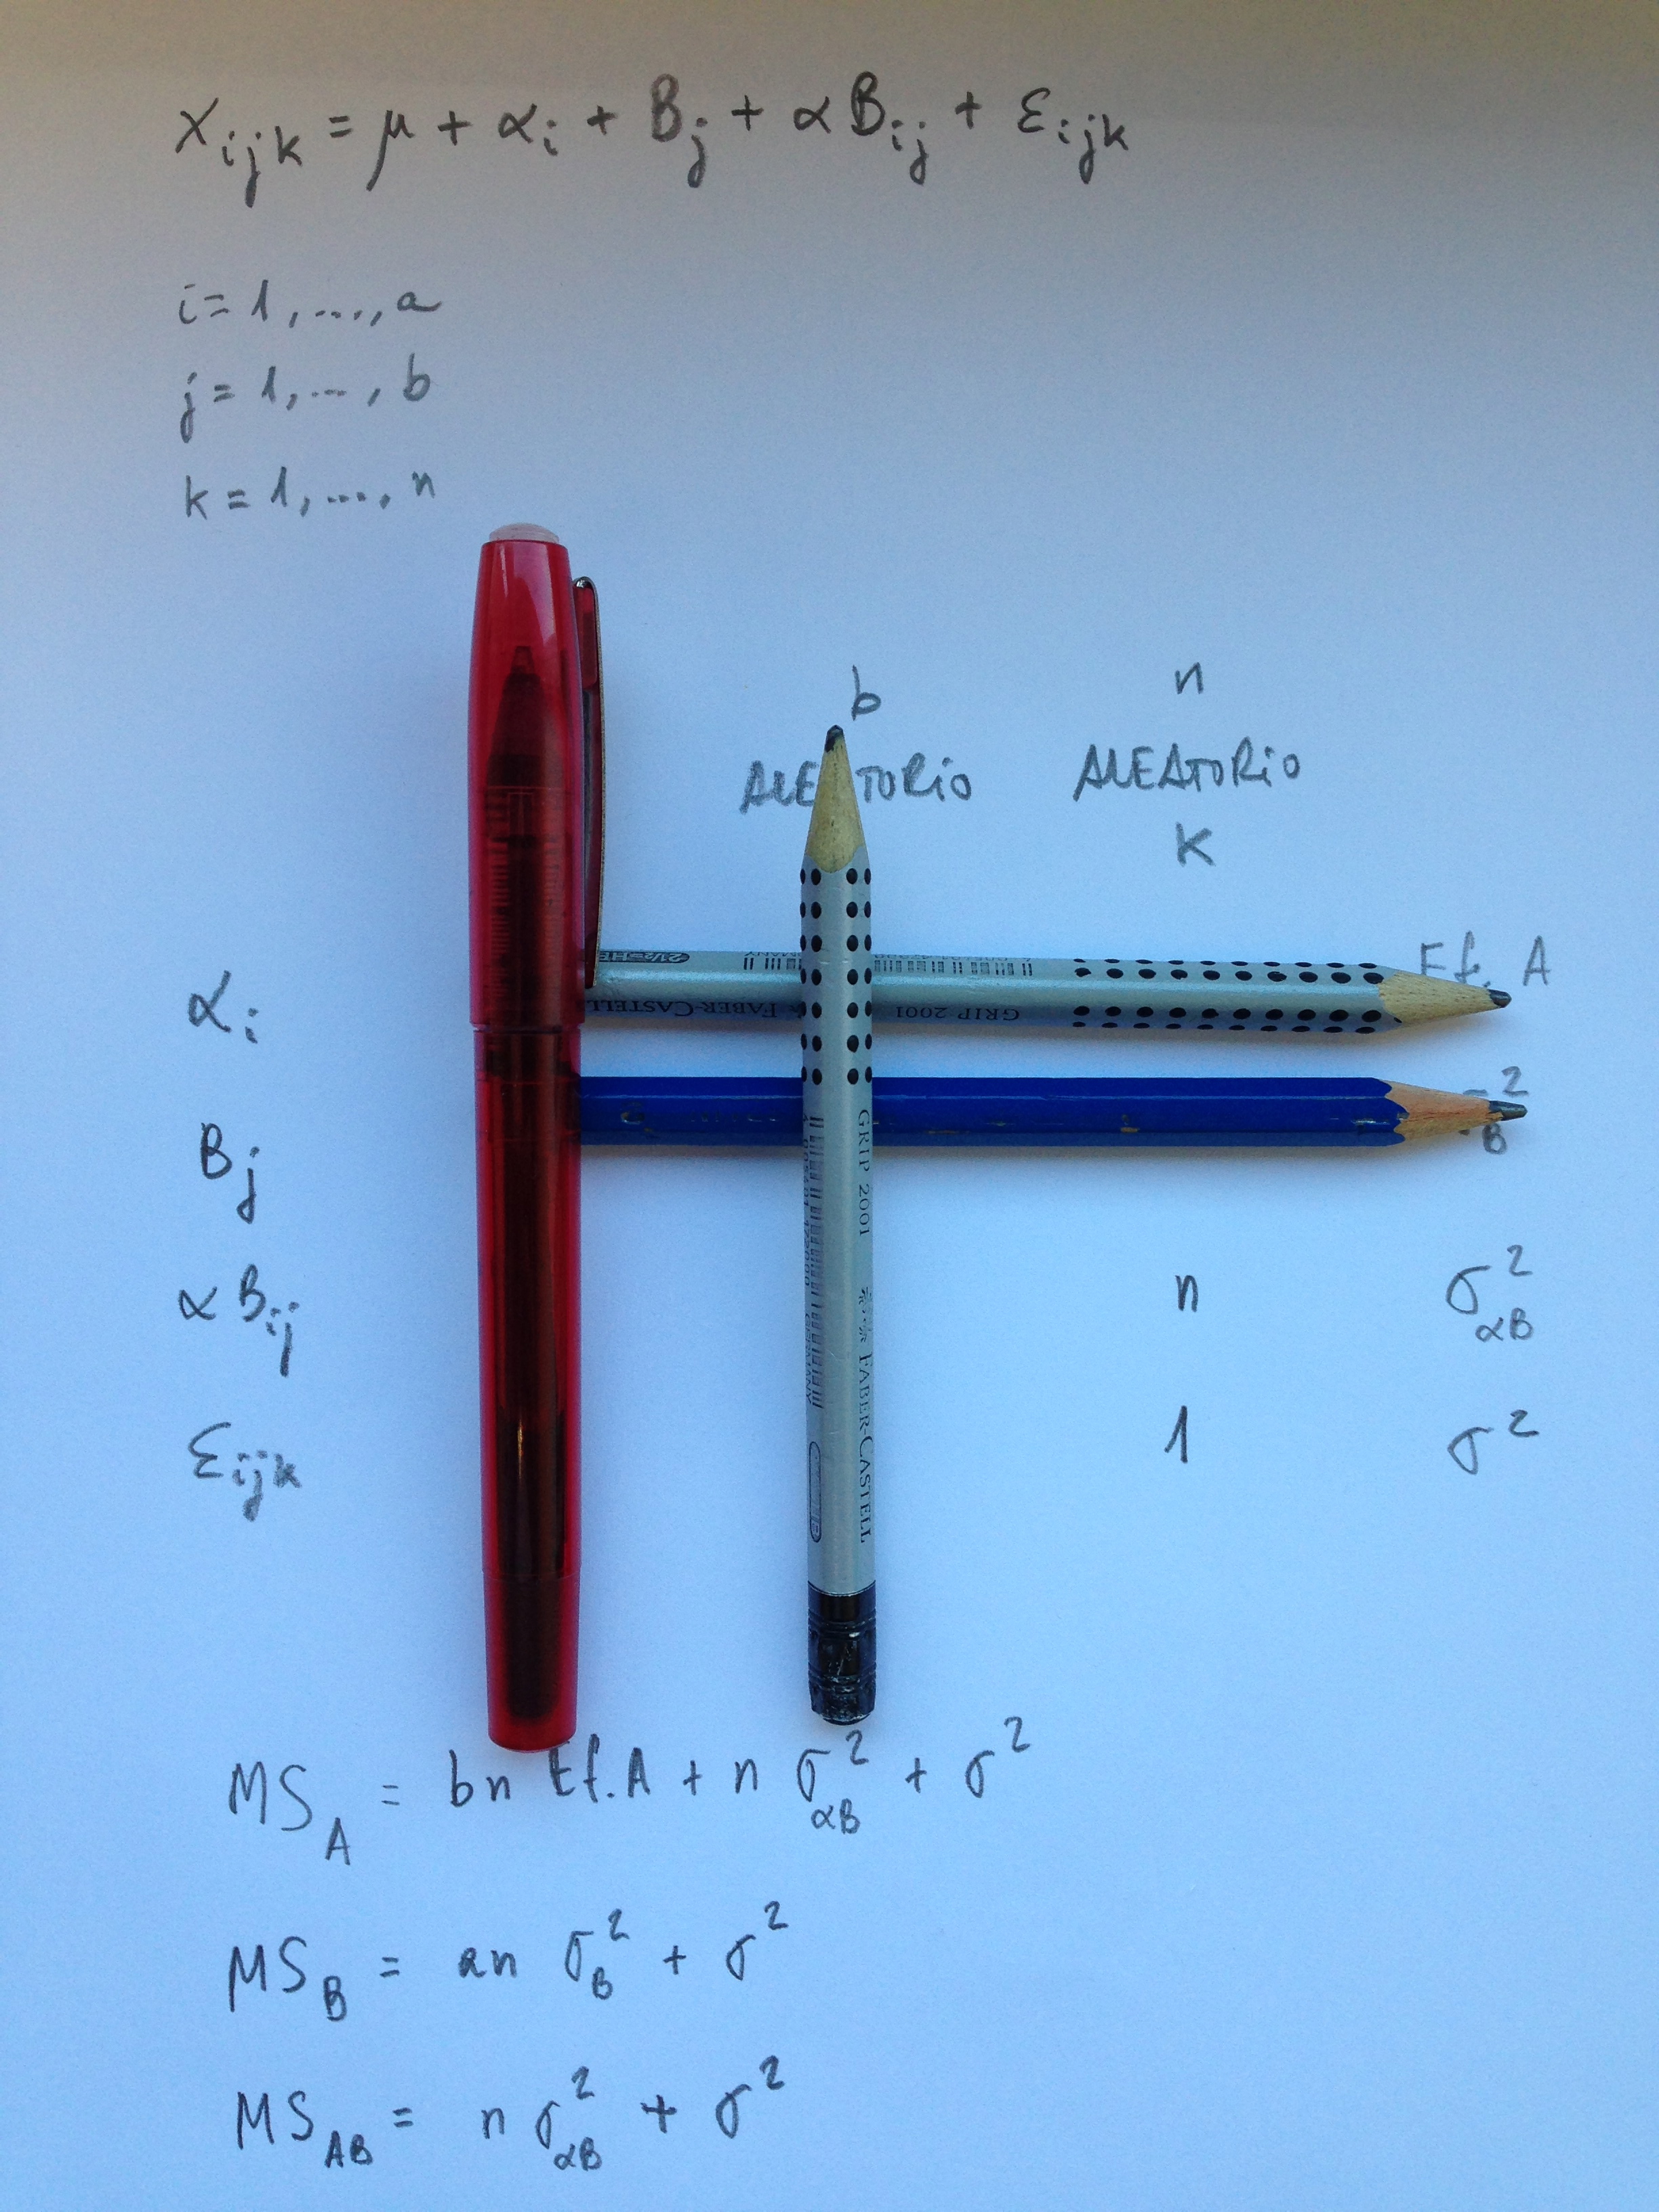
Siguiente esperanza de cuadrado medio:

IMG_7028

Y, finalmente, la esperanza del cuadrado medio residual: este siempre lo podemos poner directamente como la sigma al cuadrado del modelo: la varianza residual, la varianza de las condiciones experimentales que siempre suponemos que es igual en todas las condiciones, por eso no tiene subíndice.

Pues ya lo tenemos. Podemos ver que coincide con las esperanzas de los cuadrados medios expuestos en el modelo ANOVA de dos factores a efectos mixtos.

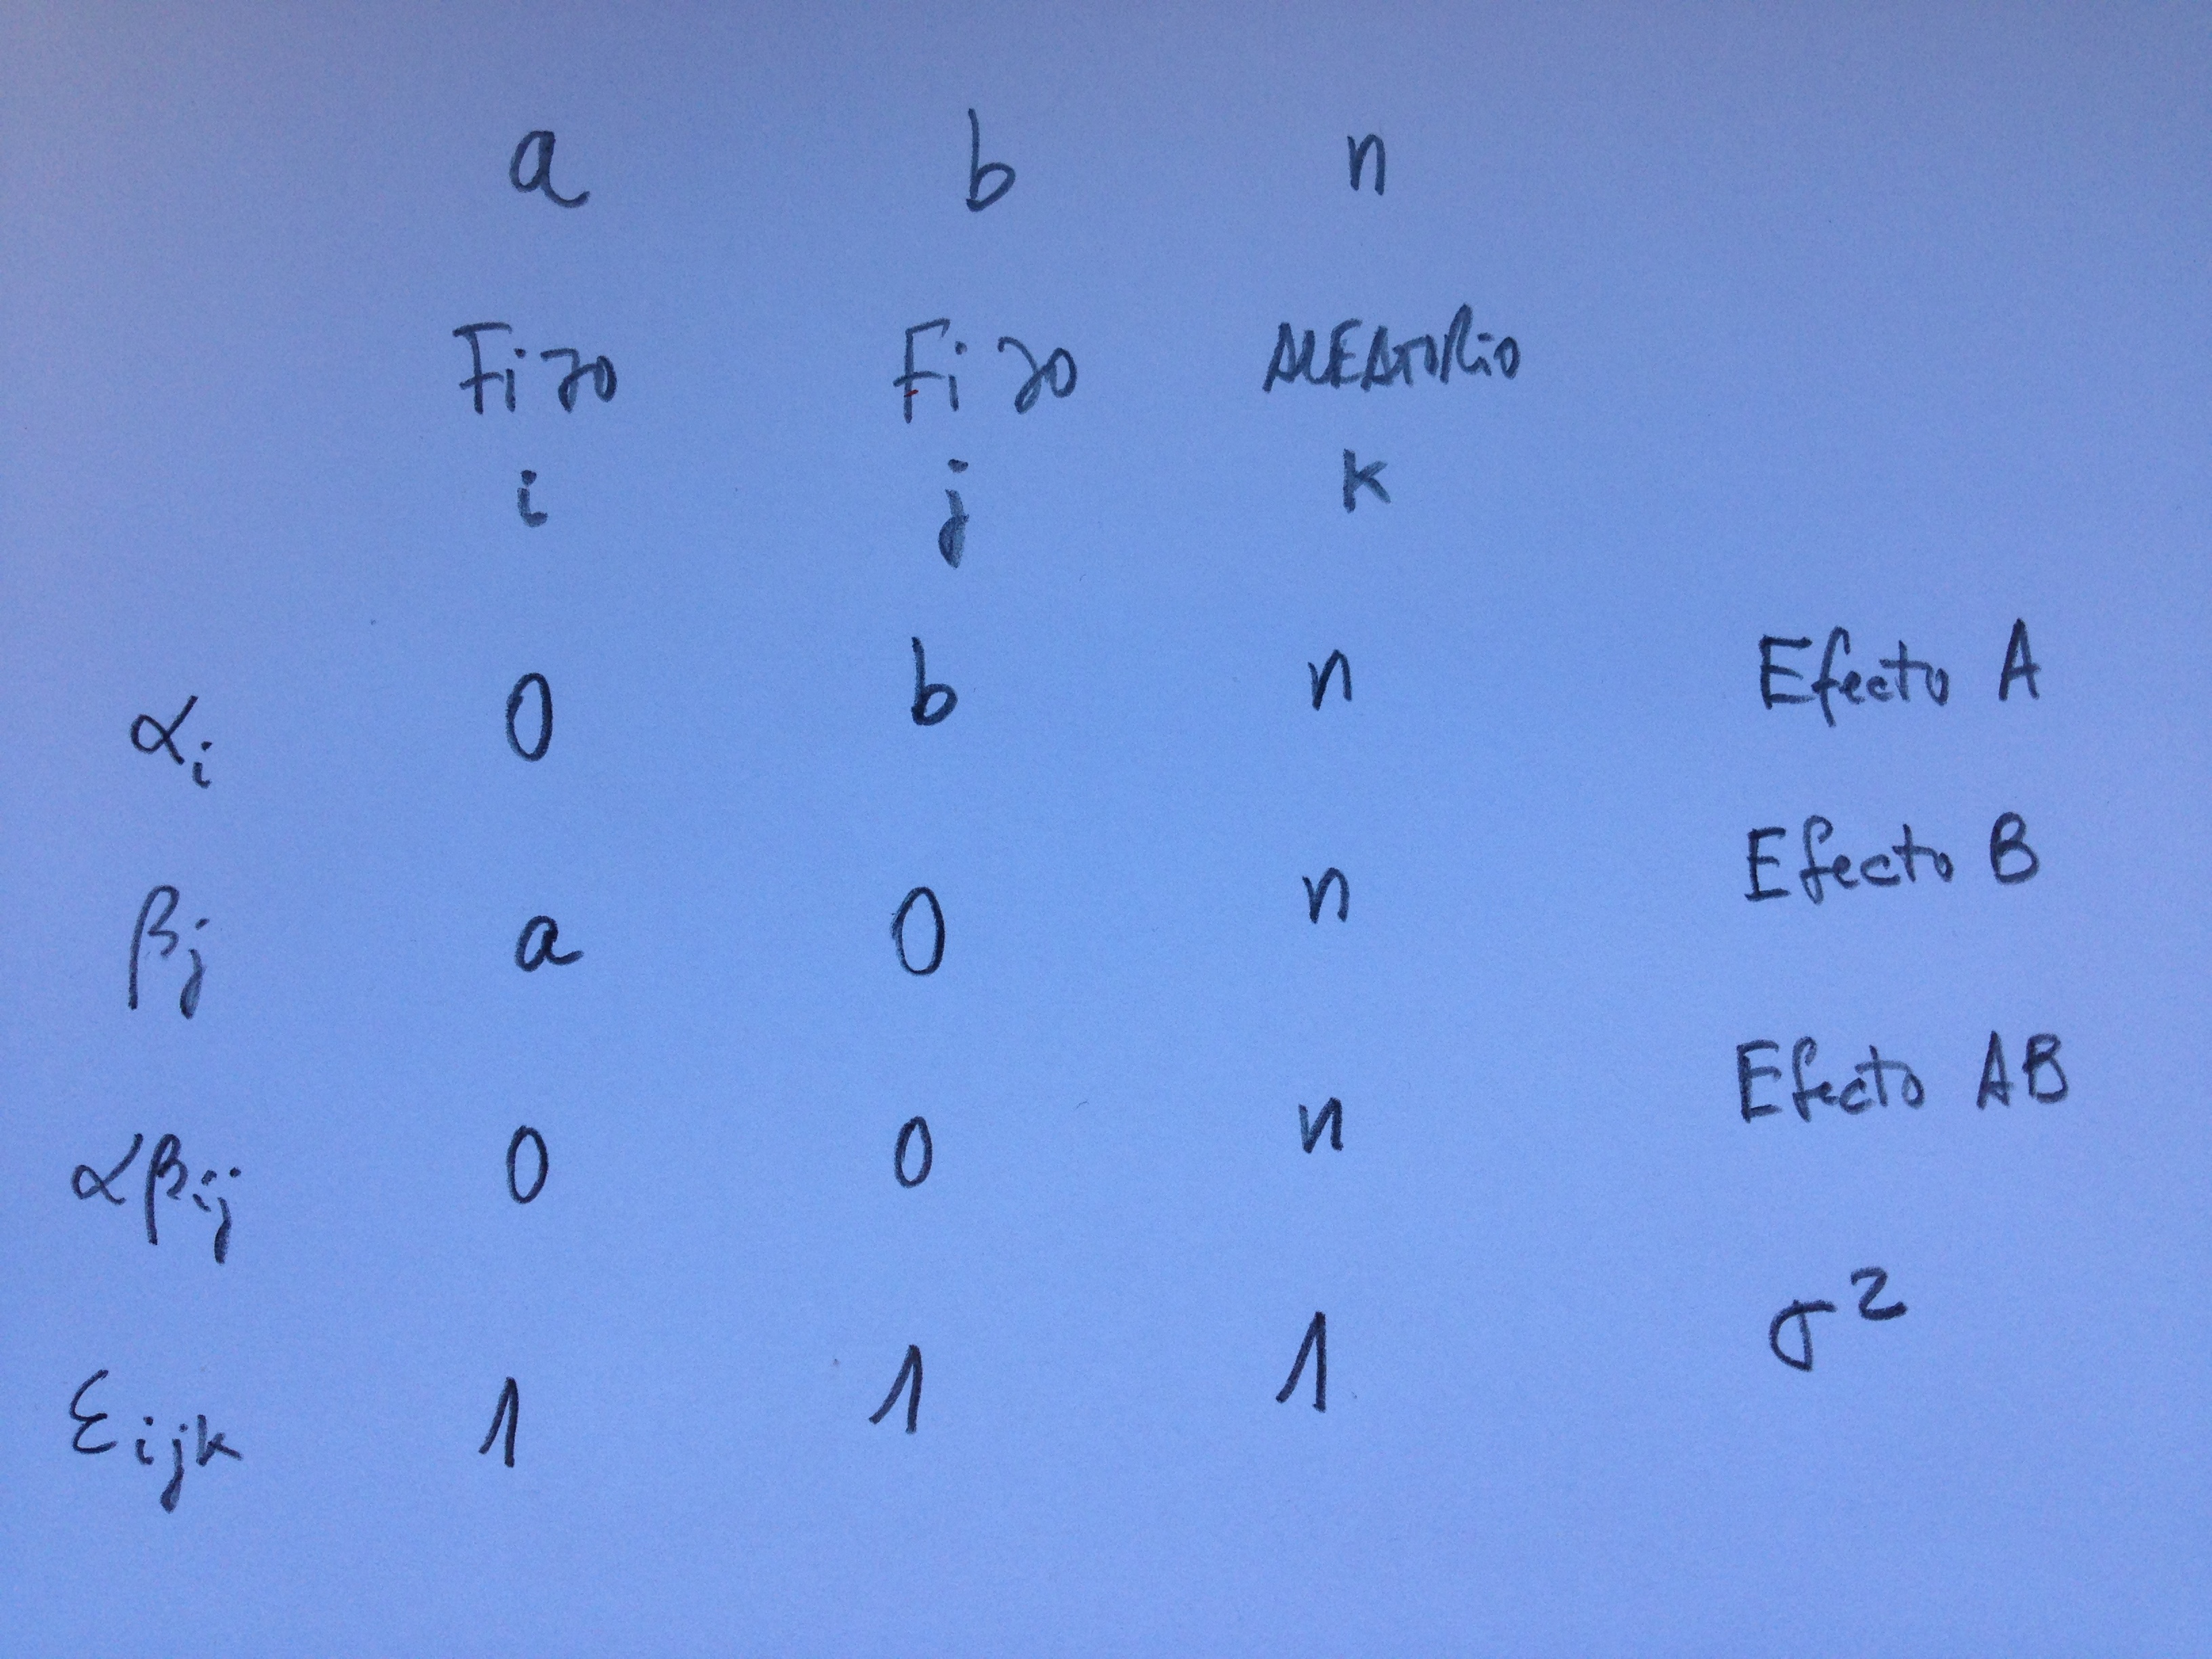
Pues vamos ahora a practicar. Vamos a calcular mediante este Algoritmo las esperanzas de los cuadrados medios del modelo ANOVA de dos factores a efectos fijos:

La matriz sería:

IMG_7029

Y el cálculo de las esperanzas medias es:

IMG_7030

Vayamos ahora con otro caso, el modelo ANOVA de dos factores a efectos aleatorios:

La matriz:

IMG_7031

Las esperanzas:

IMG_7032

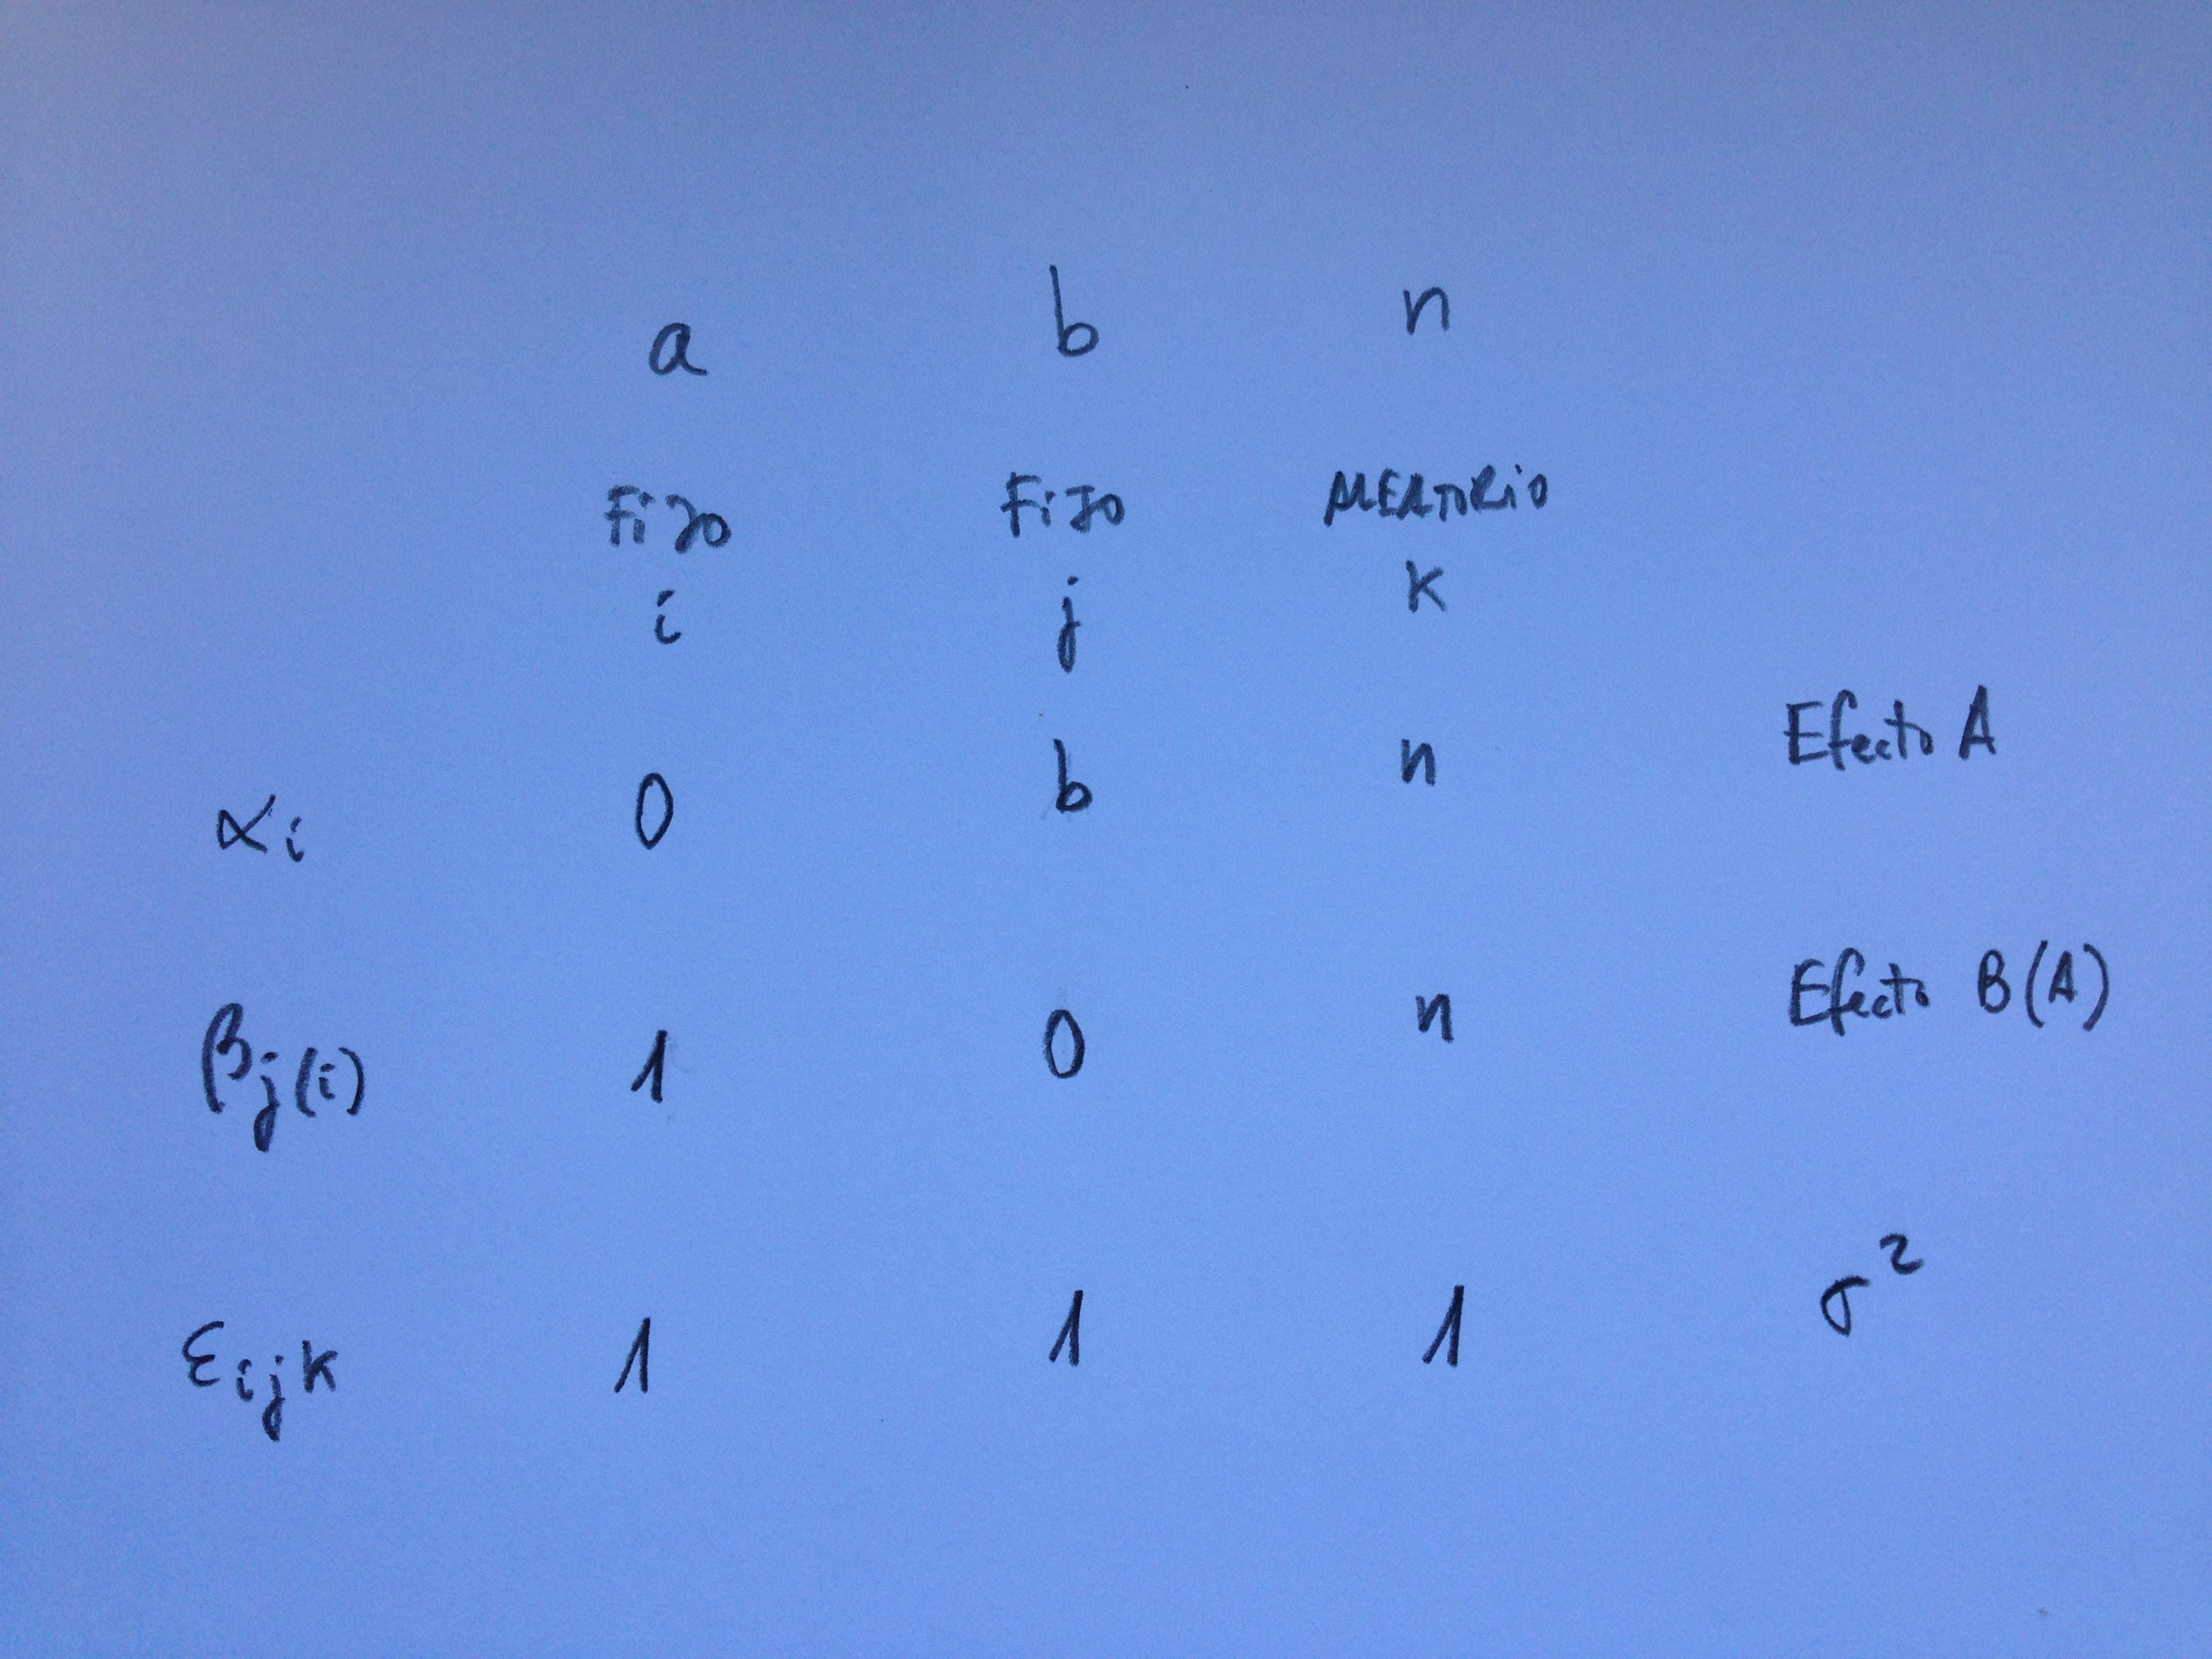
Otro ejemplo, ahora con factores anidados. El modelo ANOVA de dos factores anidados a efectos fijos:

La matriz es:

IMG_7039

Y las esperanzas son:

IMG_7040

Otro modelo, el ANOVA de dos factores anidados a efectos aleatorios:

La matriz es:

IMG_7041

Y las esperanzas de los cuadrado medios es:

IMG_7042

Y ahora casos un poco más complejos. Primero el modelo ANOVA con dos factores fijos cruzados y un tercer factor fijo anidado en ellos:

IMG_7048

Los cuadrados medios se calculan así:

IMG_7043

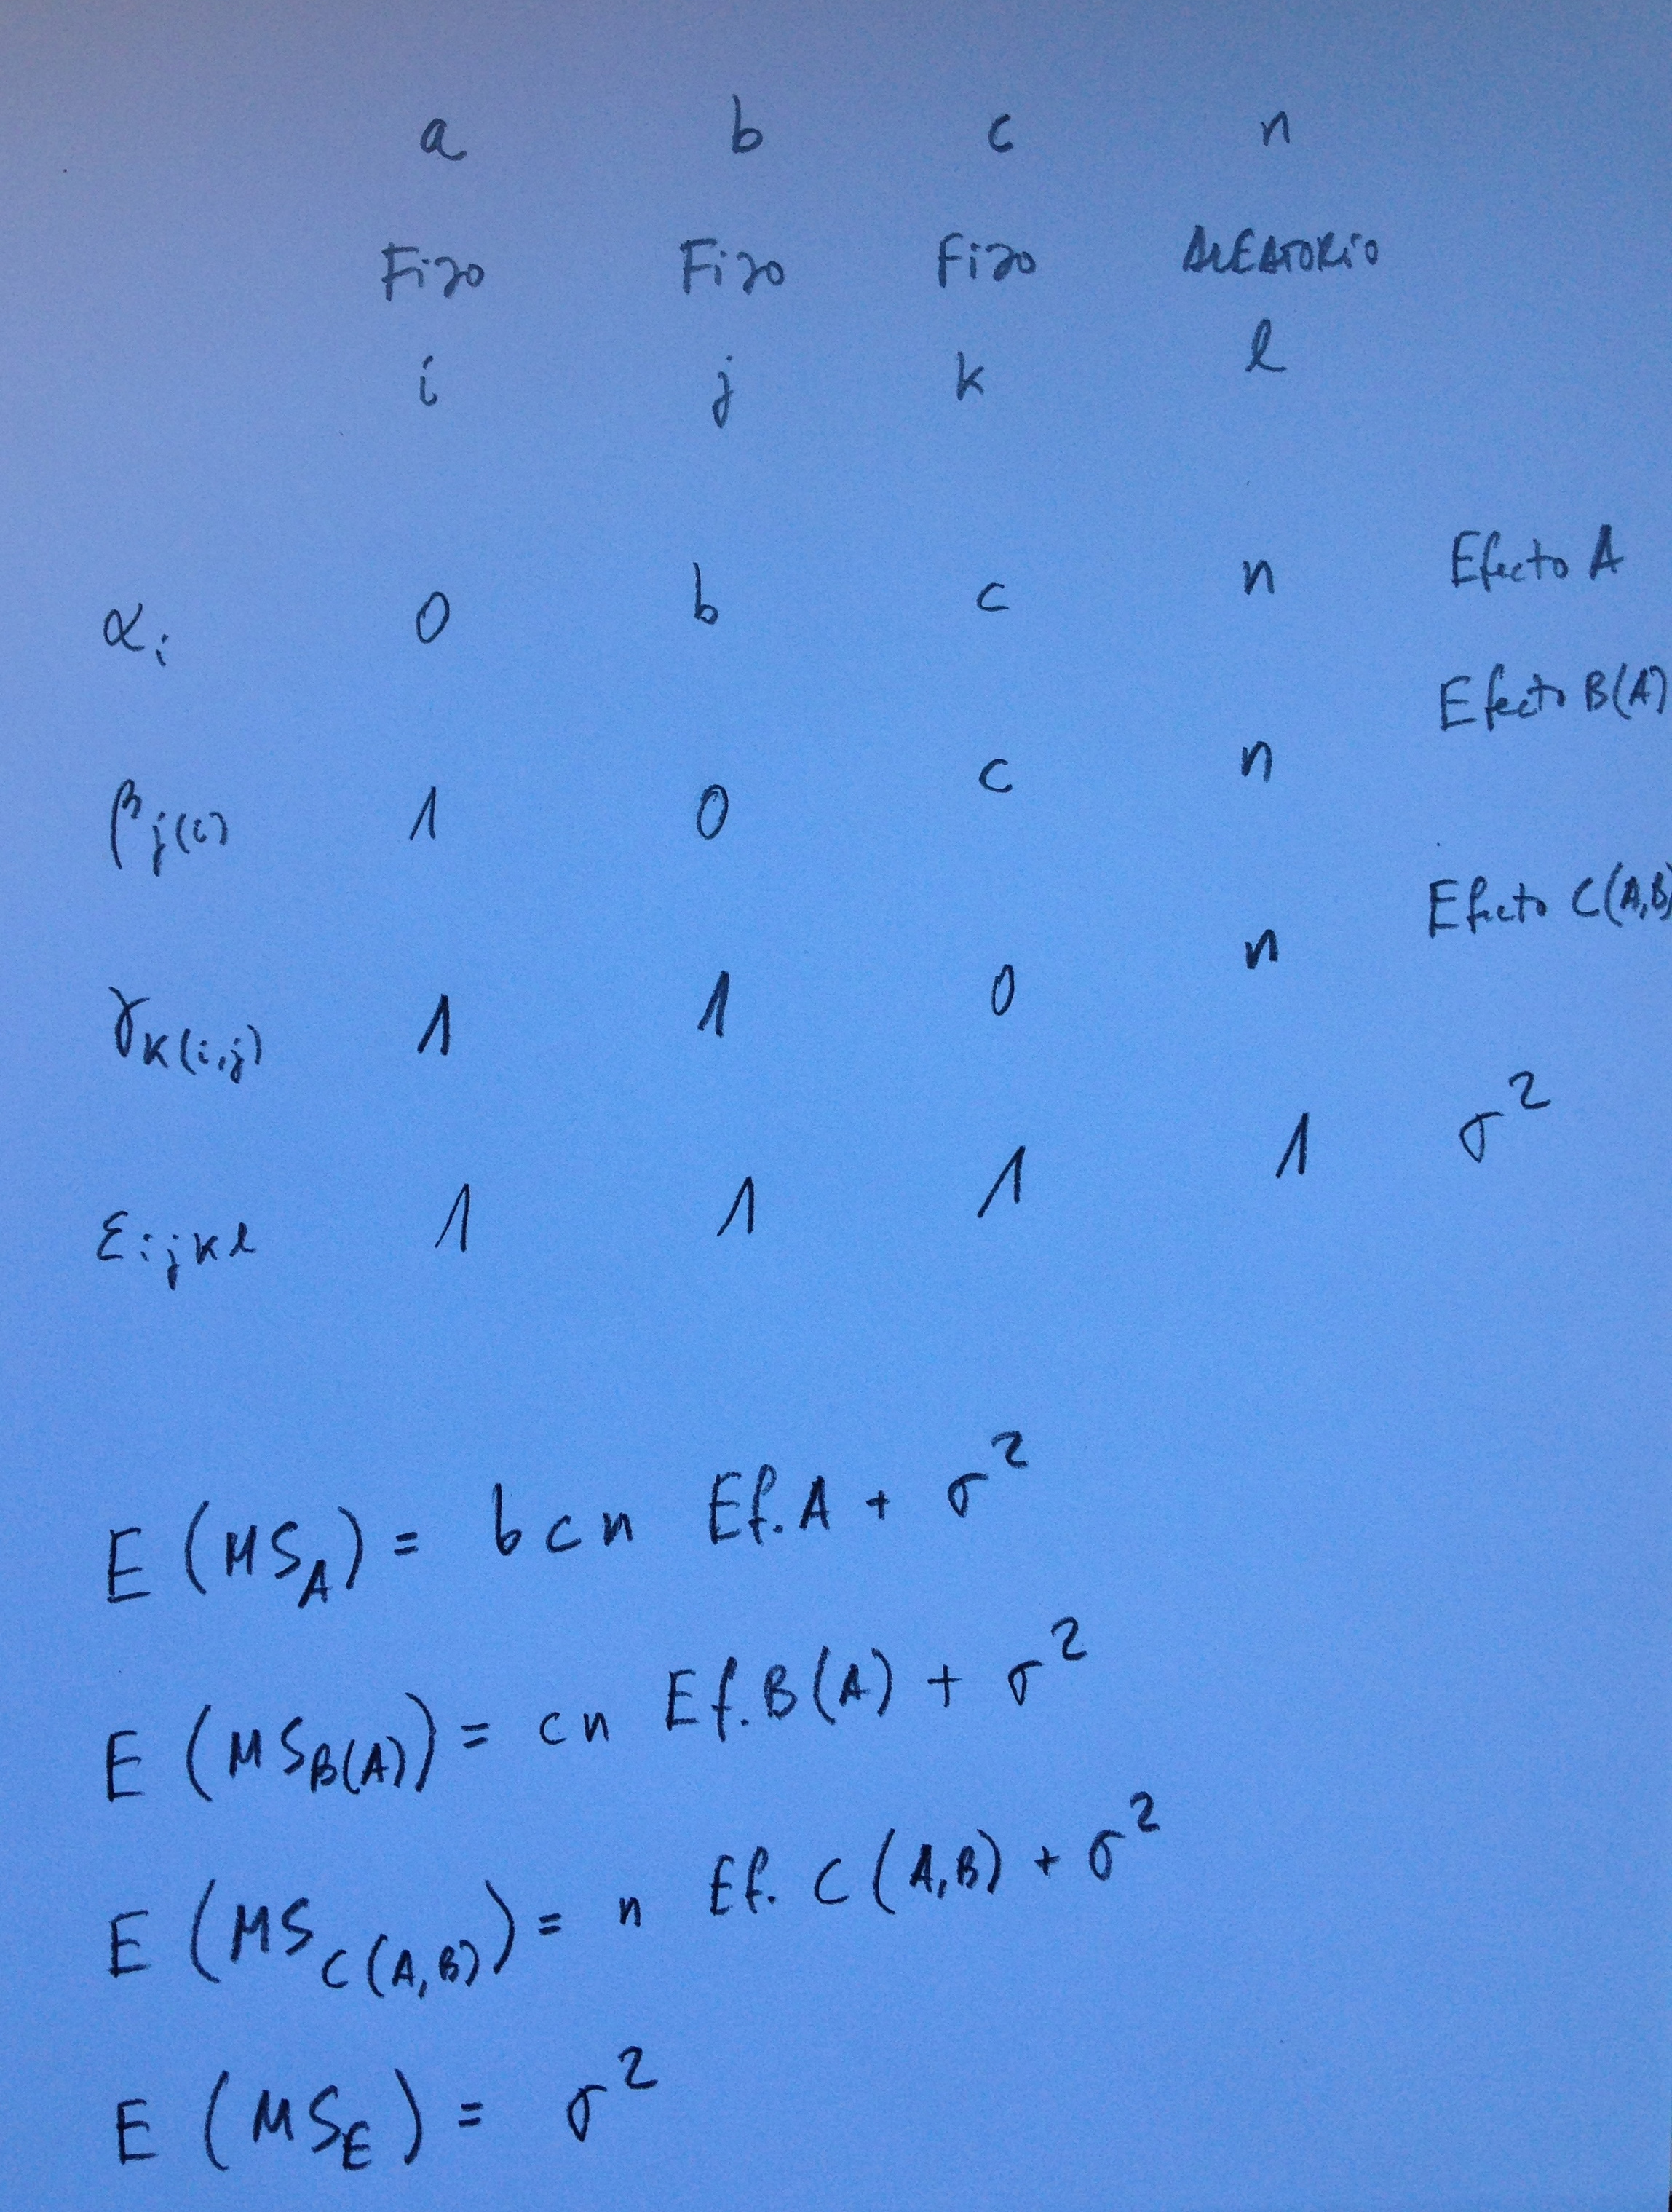
Otro modelo: ANOVA con dos factores fijos cruzados y un tercer factor aleatorio anidado en ellos:

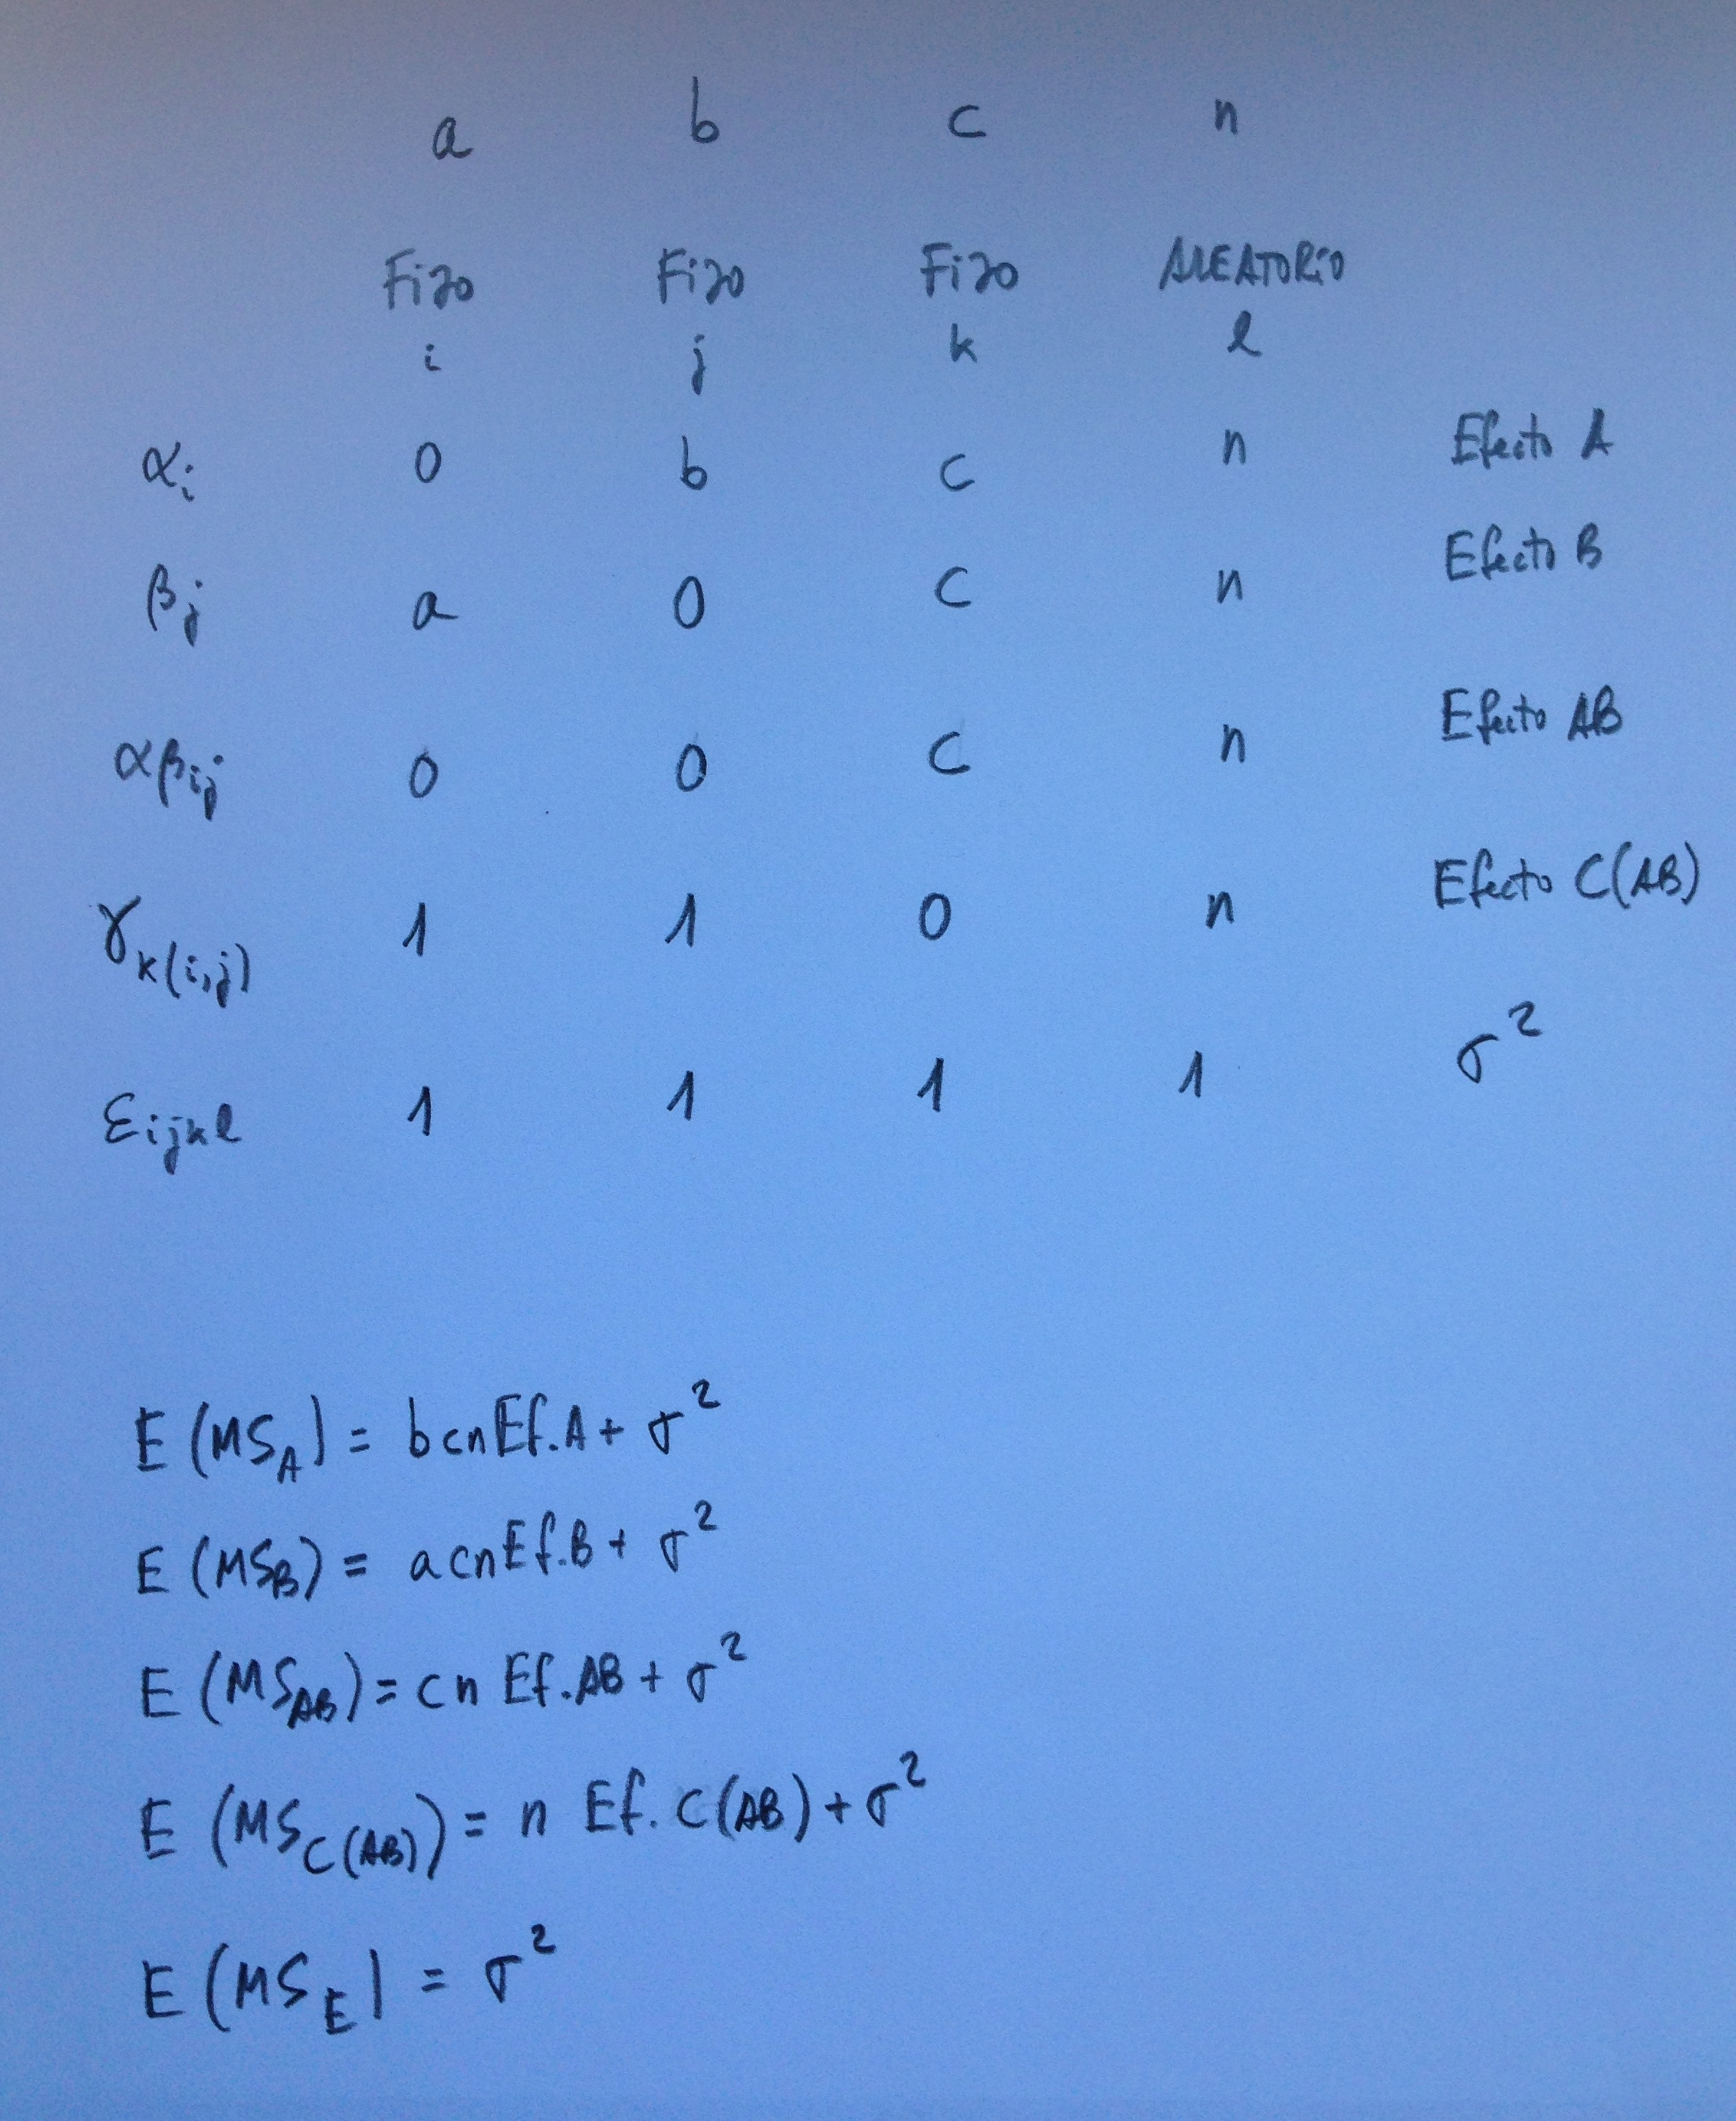
IMG_7048

Las esperanzas son:

IMG_7044

Otro modelo: ANOVA de tres factores fijos anidados sucesivamente:

IMG_7050

Esperanzas:

IMG_7045

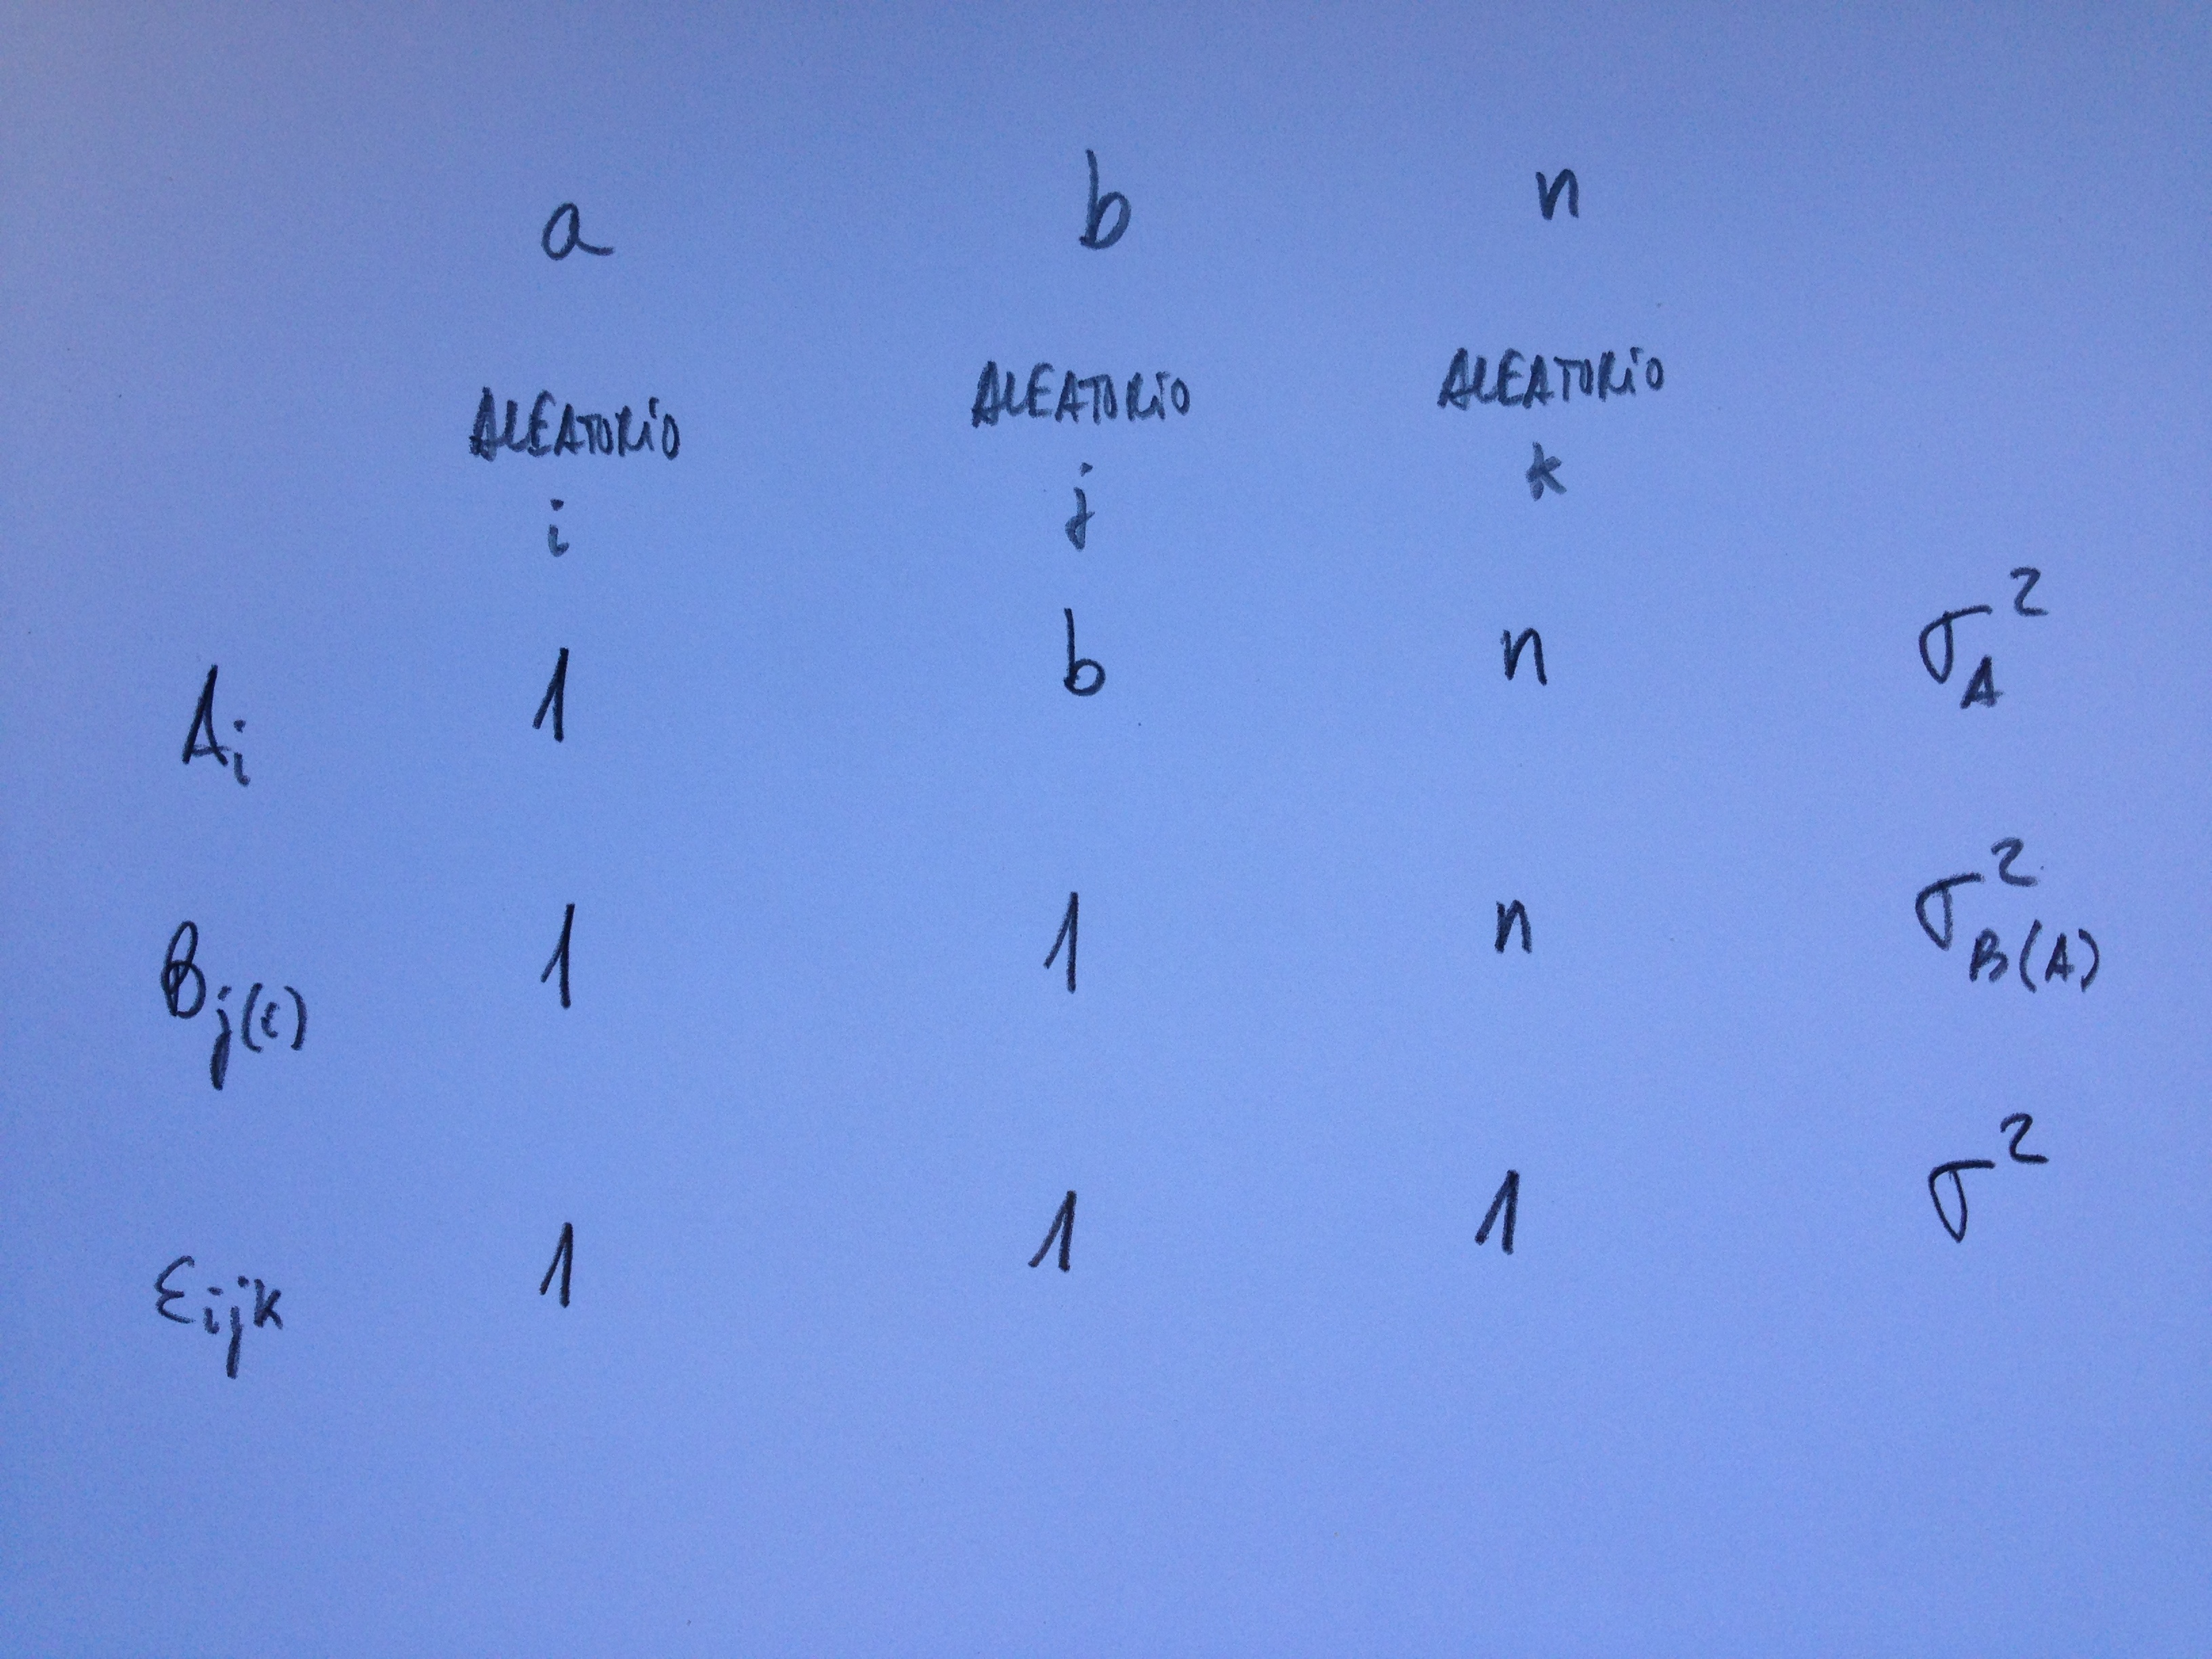
Veamos un modelo que es una variante del anterior. Tres factores anidados sucesivamente pero donde el primero es fijo y los otros dos son aleatorios. El modelo sería el siguiente:

captura-de-pantalla-2016-12-16-a-las-10-14-12

Y las esperanzas:

captura-de-pantalla-2016-12-16-a-las-10-14-24

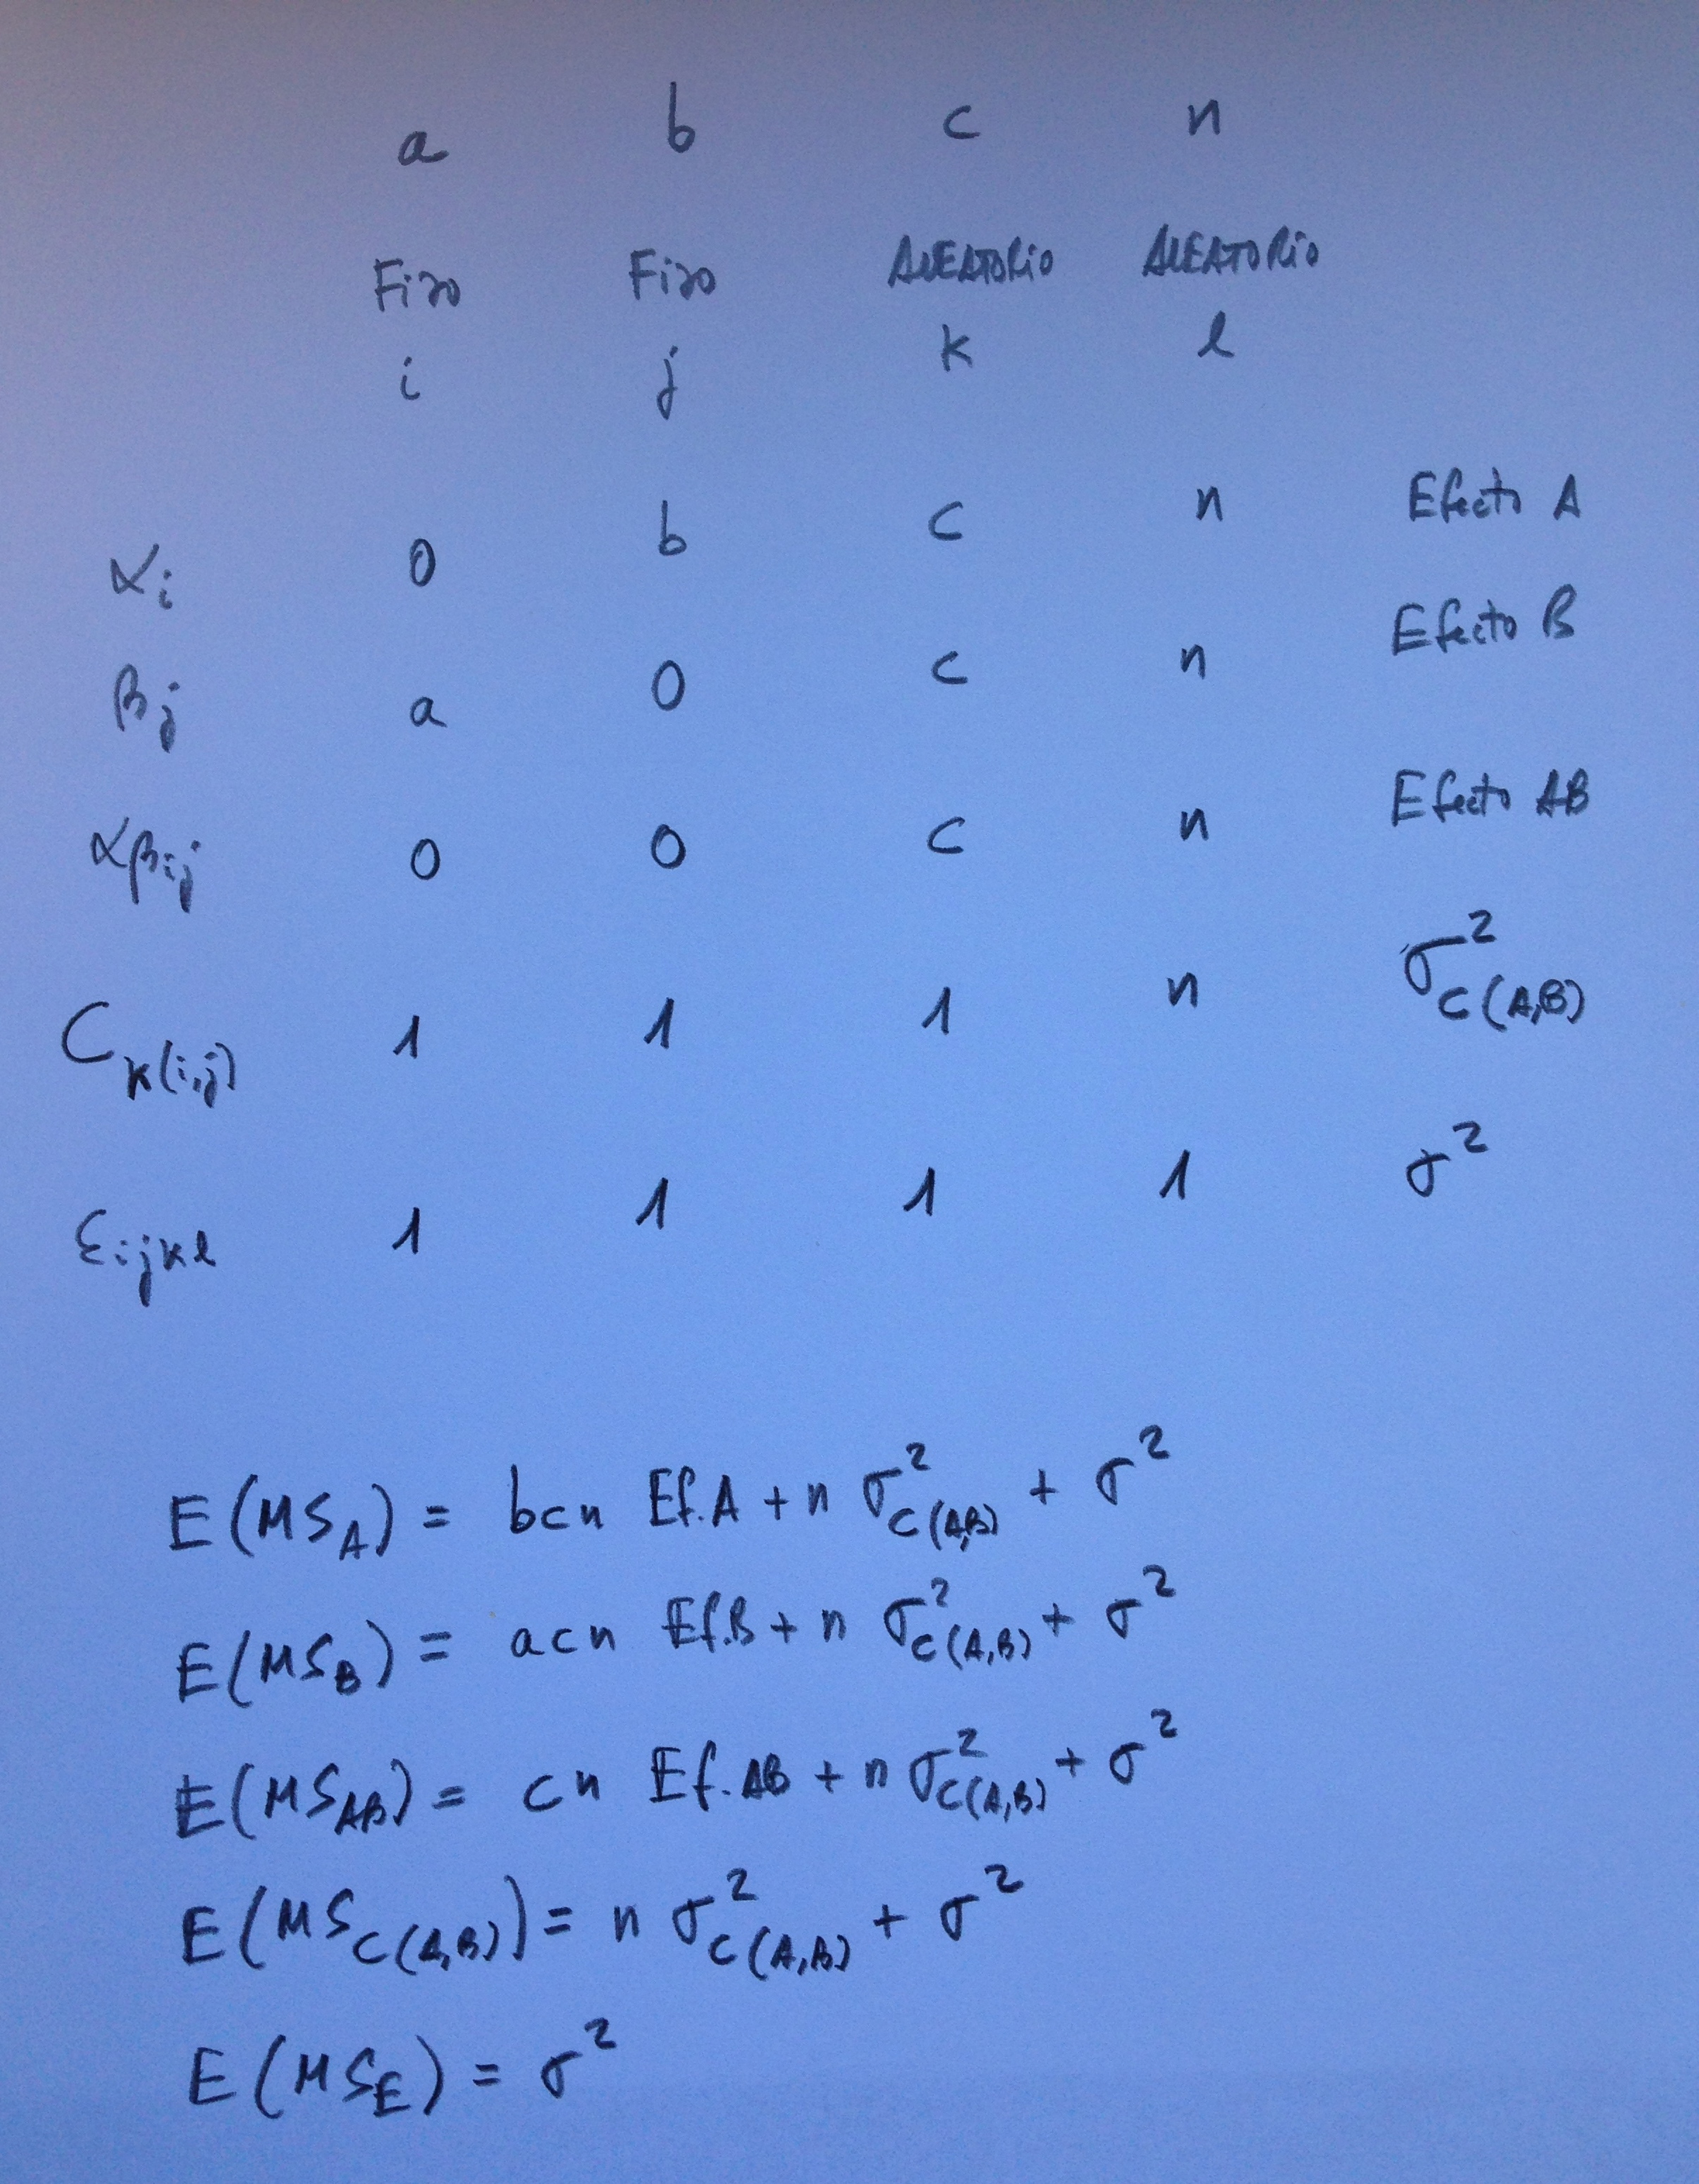
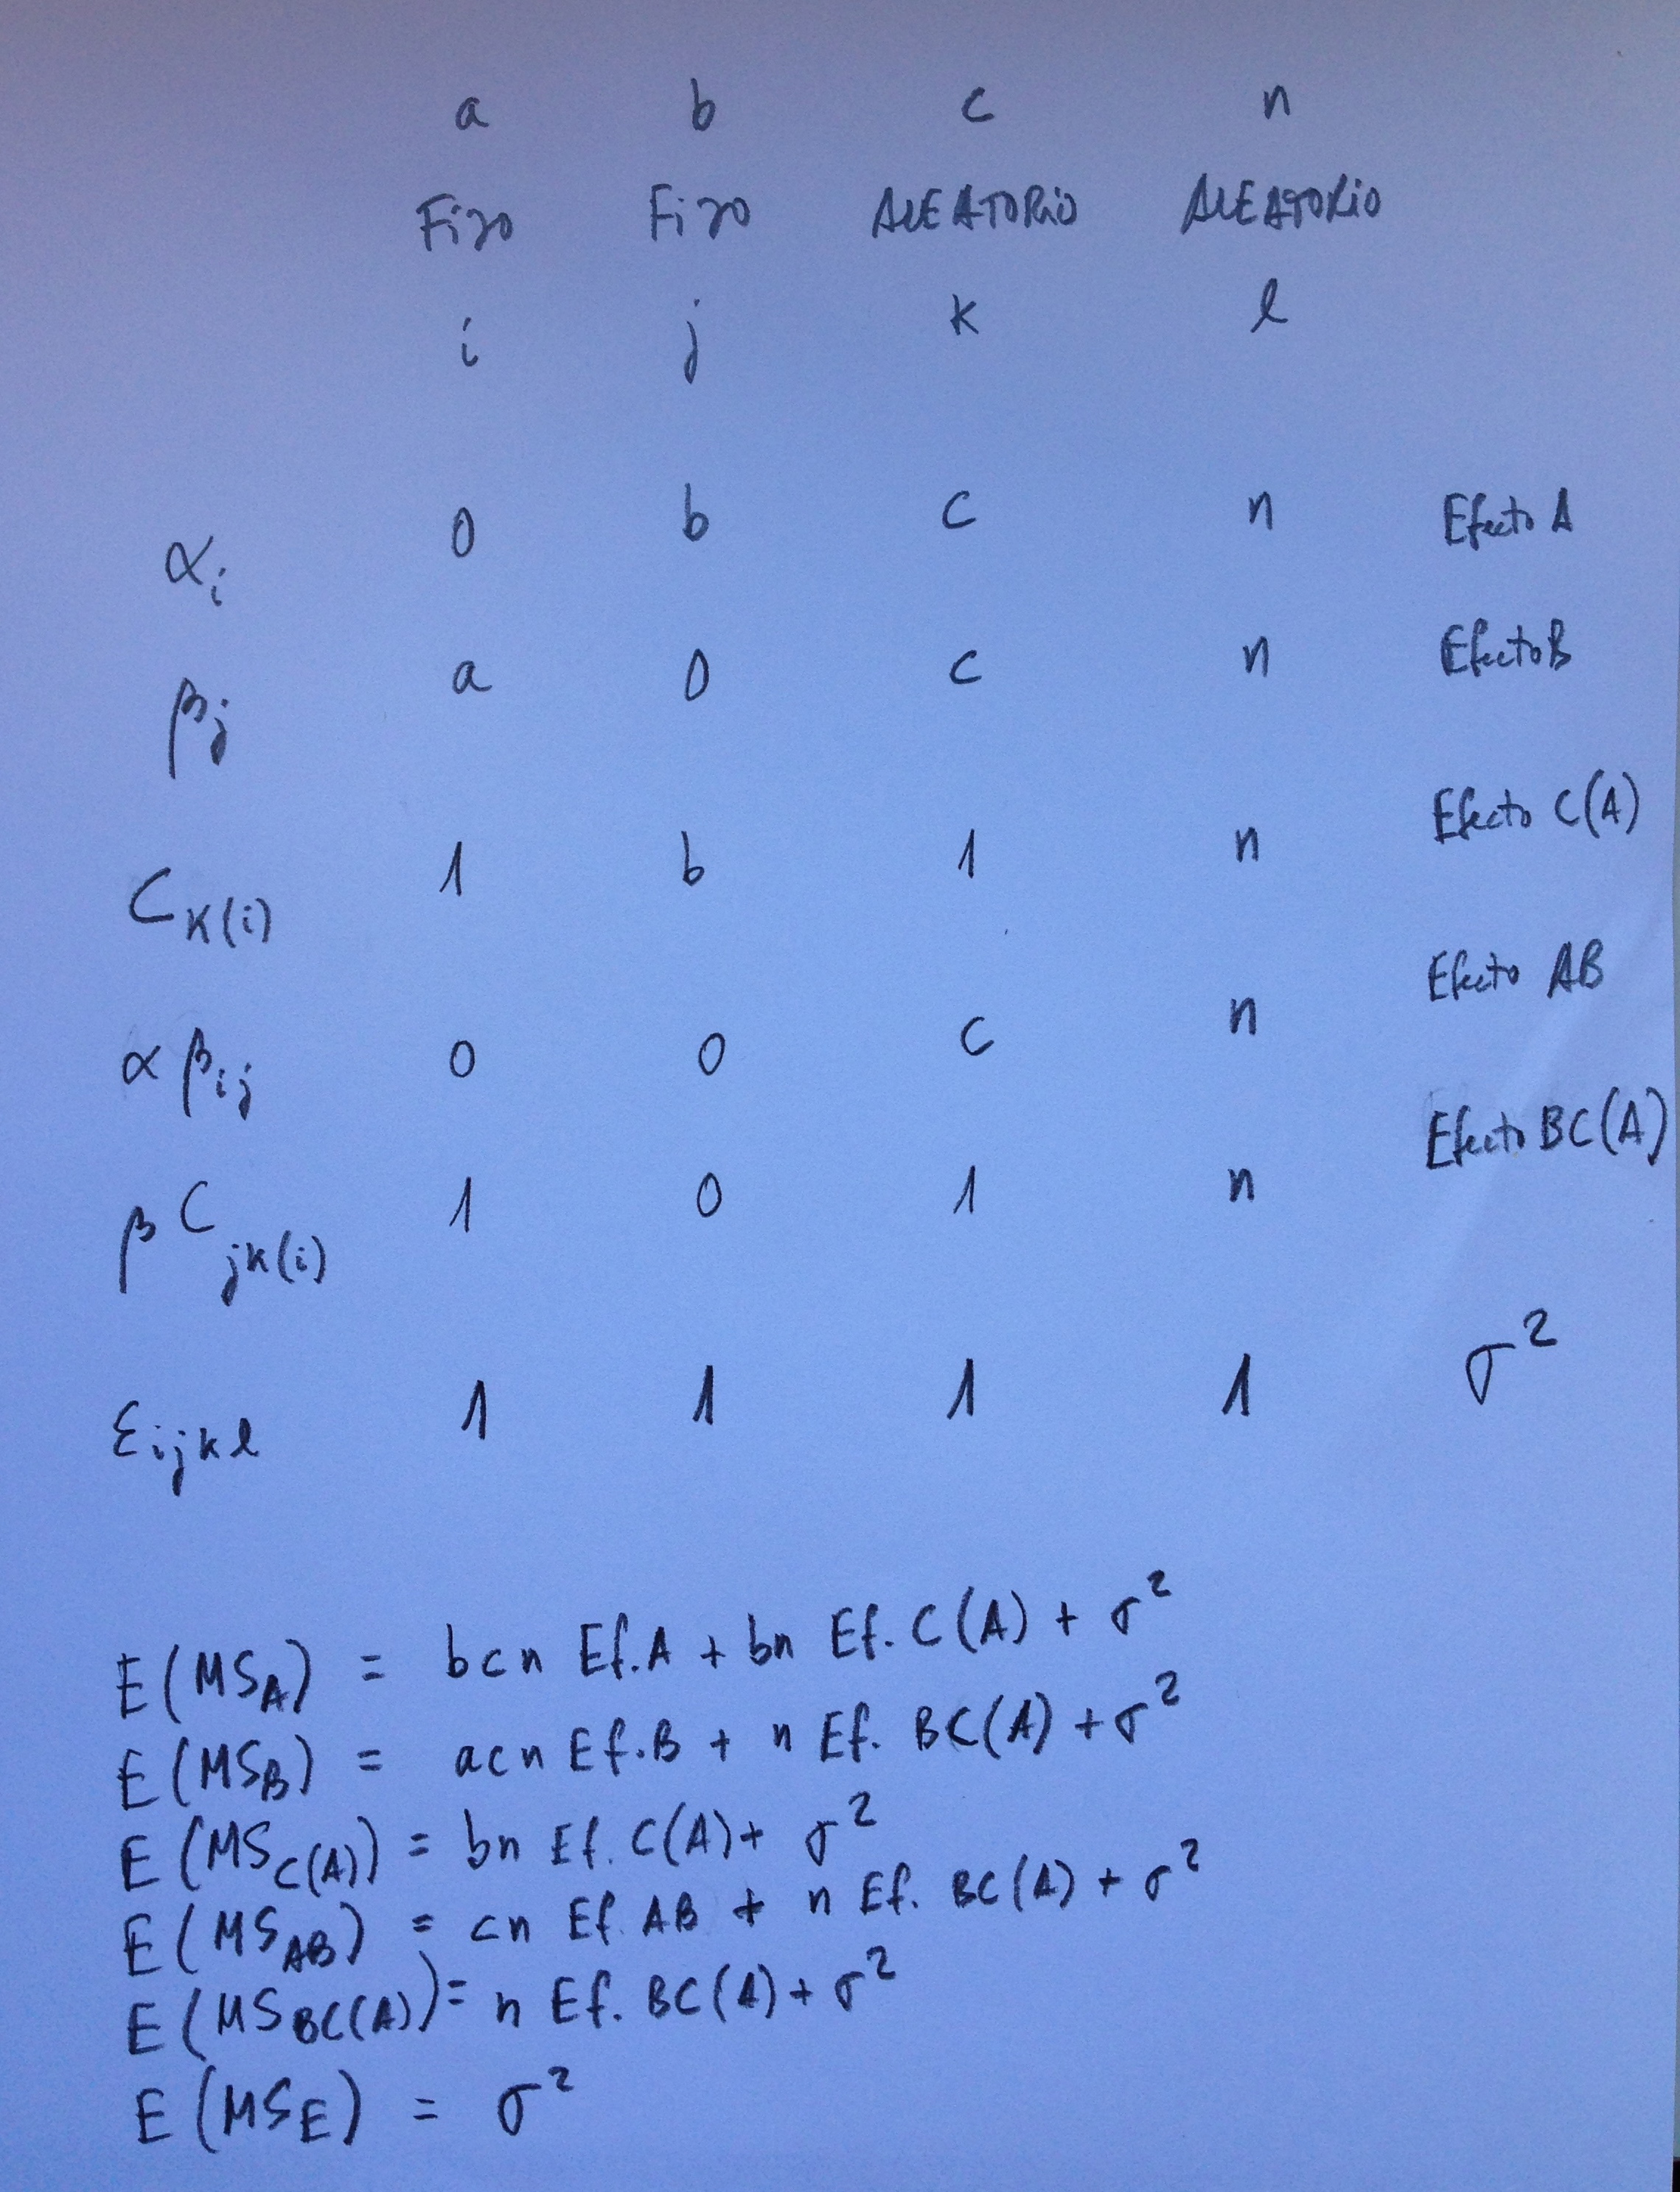
Otro modelo: ANOVA de dos factores fijos cruzados y un tercer factor aleatorio anidado en uno de esos dos factores fijos:

IMG_7050

Esperanzas:

IMG_7046

A partir de este cuadro ya podemos decidir cuáles son los cocientes que hay que hacer.

Un ejemplo más (una advertencia previa: en la segunda fila de la matriz, la del Ef. B, en su cruce con la segunda columna, debe haber un 0 y no un 1, porque se trata de un factor fijo. Sin embargo, como se puede comprobar, eso no altera el cálculo de las esperanzas de los cuadrados medios):

A partir de este cuadro ya podemos decidir cuáles son los cocientes que hay que hacer.

Con todo lo visto podemos apreciar que mediante este Algoritmo de Bennet-Franklin tenemos un poderoso instrumento para poder encontrar las esperanzas de los cuadrados medios. Esto es clave para saber cuáles son los concientes que hay que hacer para contrastar los diferentes contrastes de hipótesis en cada modelo.

Estos cocientes son claves porque de lo que se trata con ellos es que en el numerador y en el denominador del cociente se estime lo mismo en el caso de ser cierta la Hipótesis nula. Que en el numerados el único elemento diferencial con el denominador sea el efecto focalizado en el contraste implicado. De esta forma si la F-ratio calculada es un valor pequeño deberemos mantener la Hipótesis nula y si ese F-ratio es grande la rechazaremos. Y lo haremos con razón porque el único elemento diferencial, como digo, será el elemento del contraste en cuestión.

Solución Situación 38

Se trata de un análisis con dos factores. Uno fijo (la forma de medida) y otro aleatorio (el factor medidor). Es por lo tanto un caso de ANOVA de dos factores a efectos mixtos. Un factor fijo cruzado con un factor aleatorio.

Debemos comprobar la normalidad de los residuos (con el test de Shapiro-Wilk). Debemos comprobar la igualdad de varianzas (con el test de Bartlett). Supongamos que ha sido comprobado y estamos bajo estas condiciones. De hecho, si miramos los datos, podemos comprobar que con muchas posibilidades se cumplirán esas condiciones. No hay ni aspecto de no normalidad, ni de heterogeneidad de varianzas, en cada uno de las ocho condiciones experimentales. Otra cosa sería que en algún grupo se vieran valores mucho más dispersos que en los otros, o una asimetría clara que hiciera pensar en un alejamiento de la distribución normal.

Si miramos los datos con atención podemos comprobar que hay una variabilidad residual, la que hay en cada una de las ocho condiciones experimentales. Una variabilidad residual que no es muy grande respecto a la que se aprecia en el conjunto de los datos.

Si miramos los datos veremos que los dos niveles del factor fijo (tipo de medida: fotoeléctrica o con cinta métrica) no presentan diferencias que parezcan muy relevantes.

Si miramos con atención los datos también podemos ver que los medidores sí que aportan una variabilidad considerable.

Y, finalmente, podemos apreciar, también, a simple vista, que no hay interacción: no parece que los resultados de un medidor cambien mucho si la medición la hace mediante un método u otro. El medidor que tiene tendencia a dar valores bajos los da bajos con ambos métodos. Y el medidor que tiende a dar valores altos los da altos con ambos métodos.

Veamos que todo esto está en consonancia con el análisis:

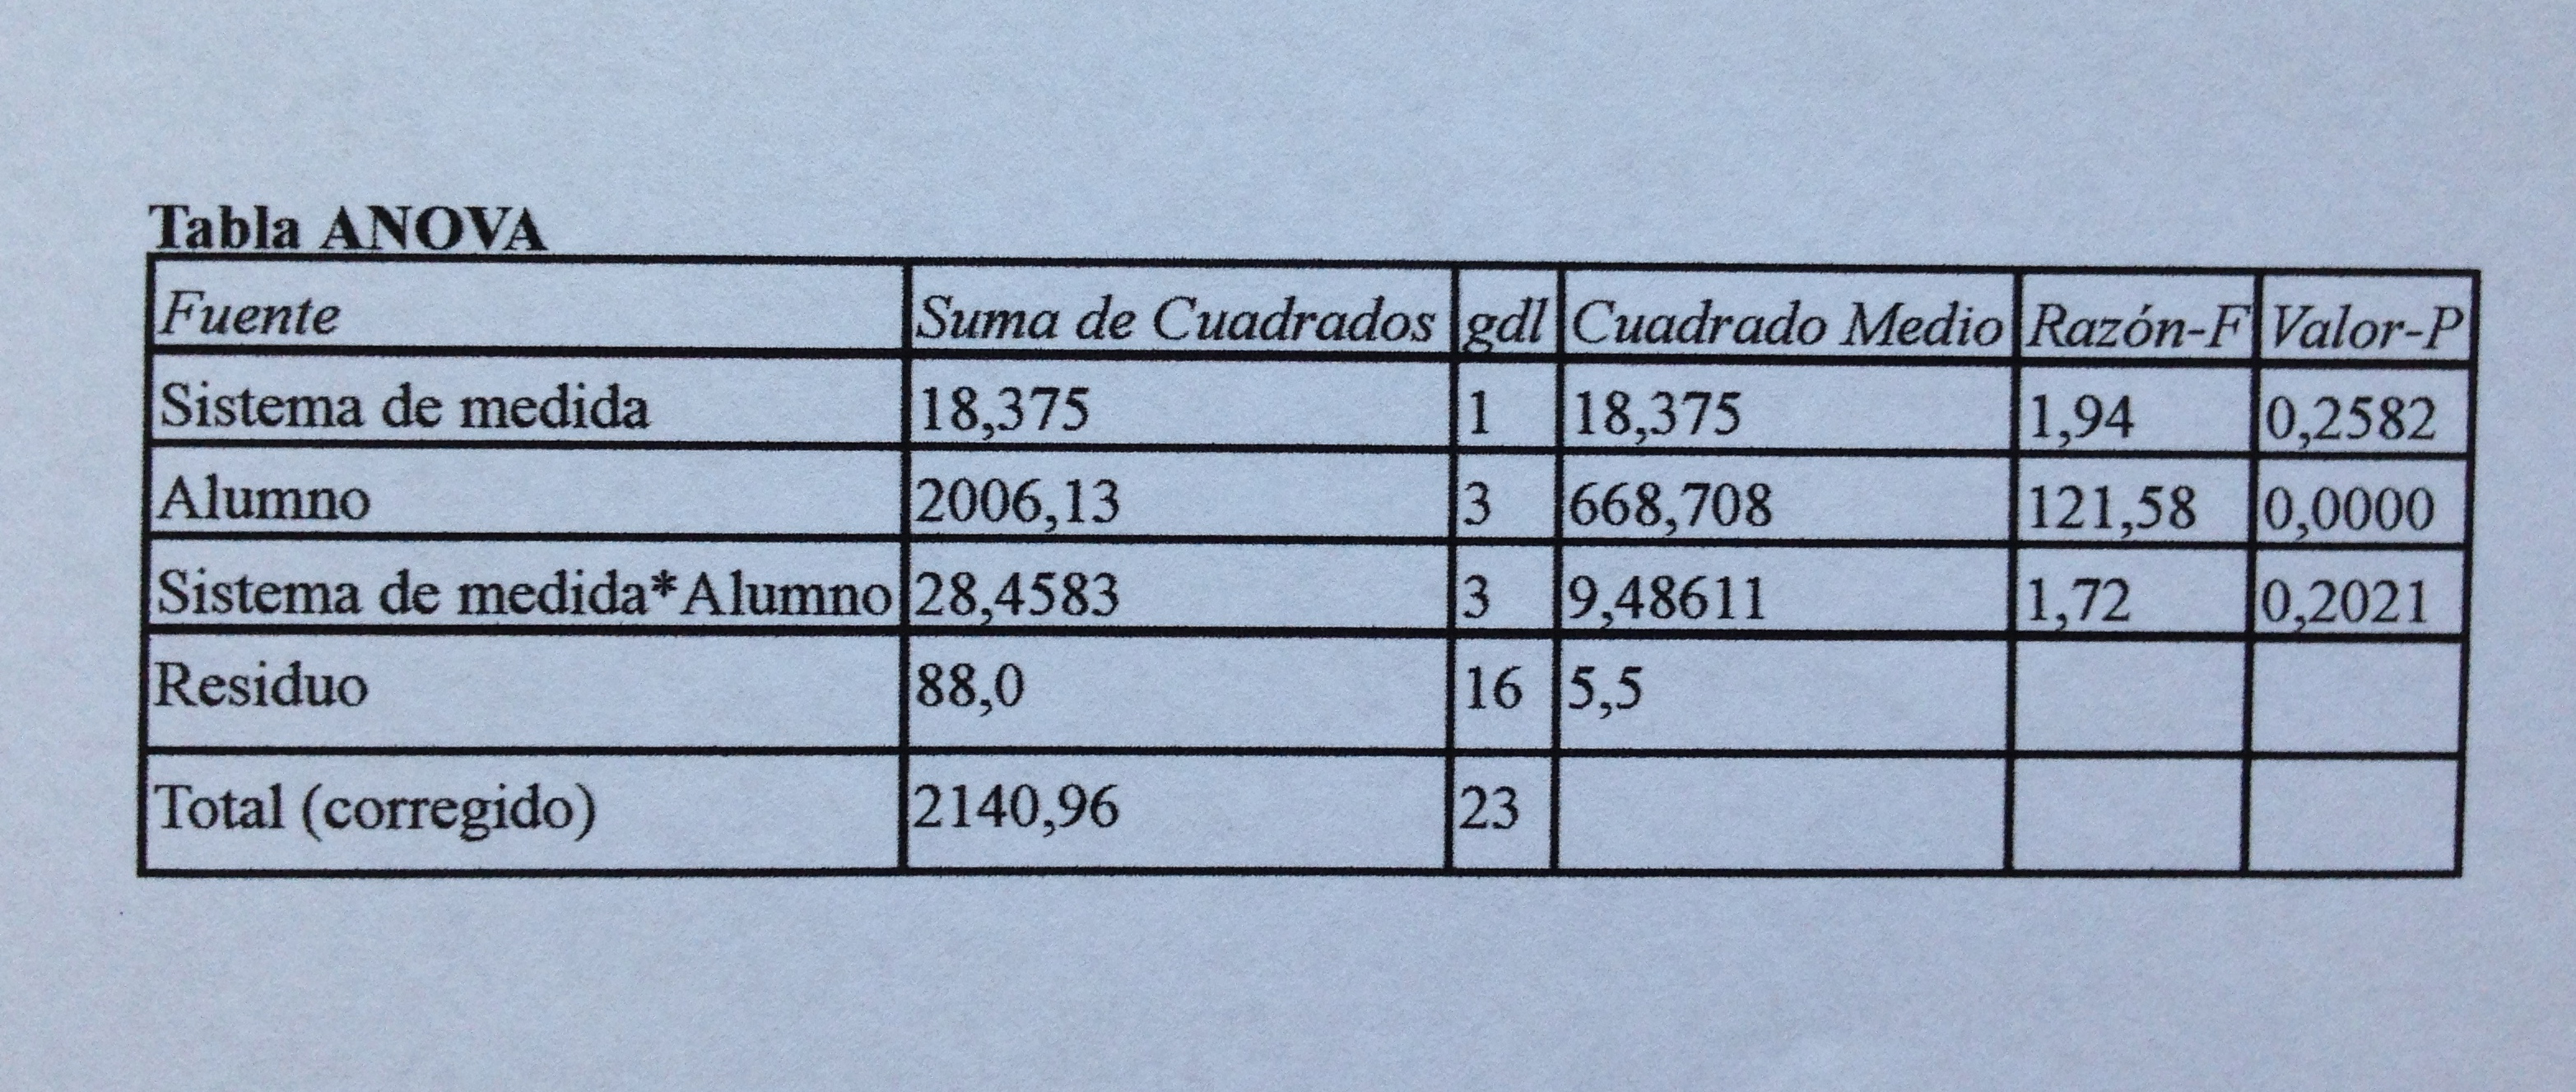
La tabla ANOVA es la siguiente:

IMG_6990

Comprobar que aquí los cocientes de cuadrados medios se han hecho tal como dispone el ANOVA de dos factores a efectos aleatorios. El factor fijo va dividido por la interacción y el factor aleatorio por el residuo.

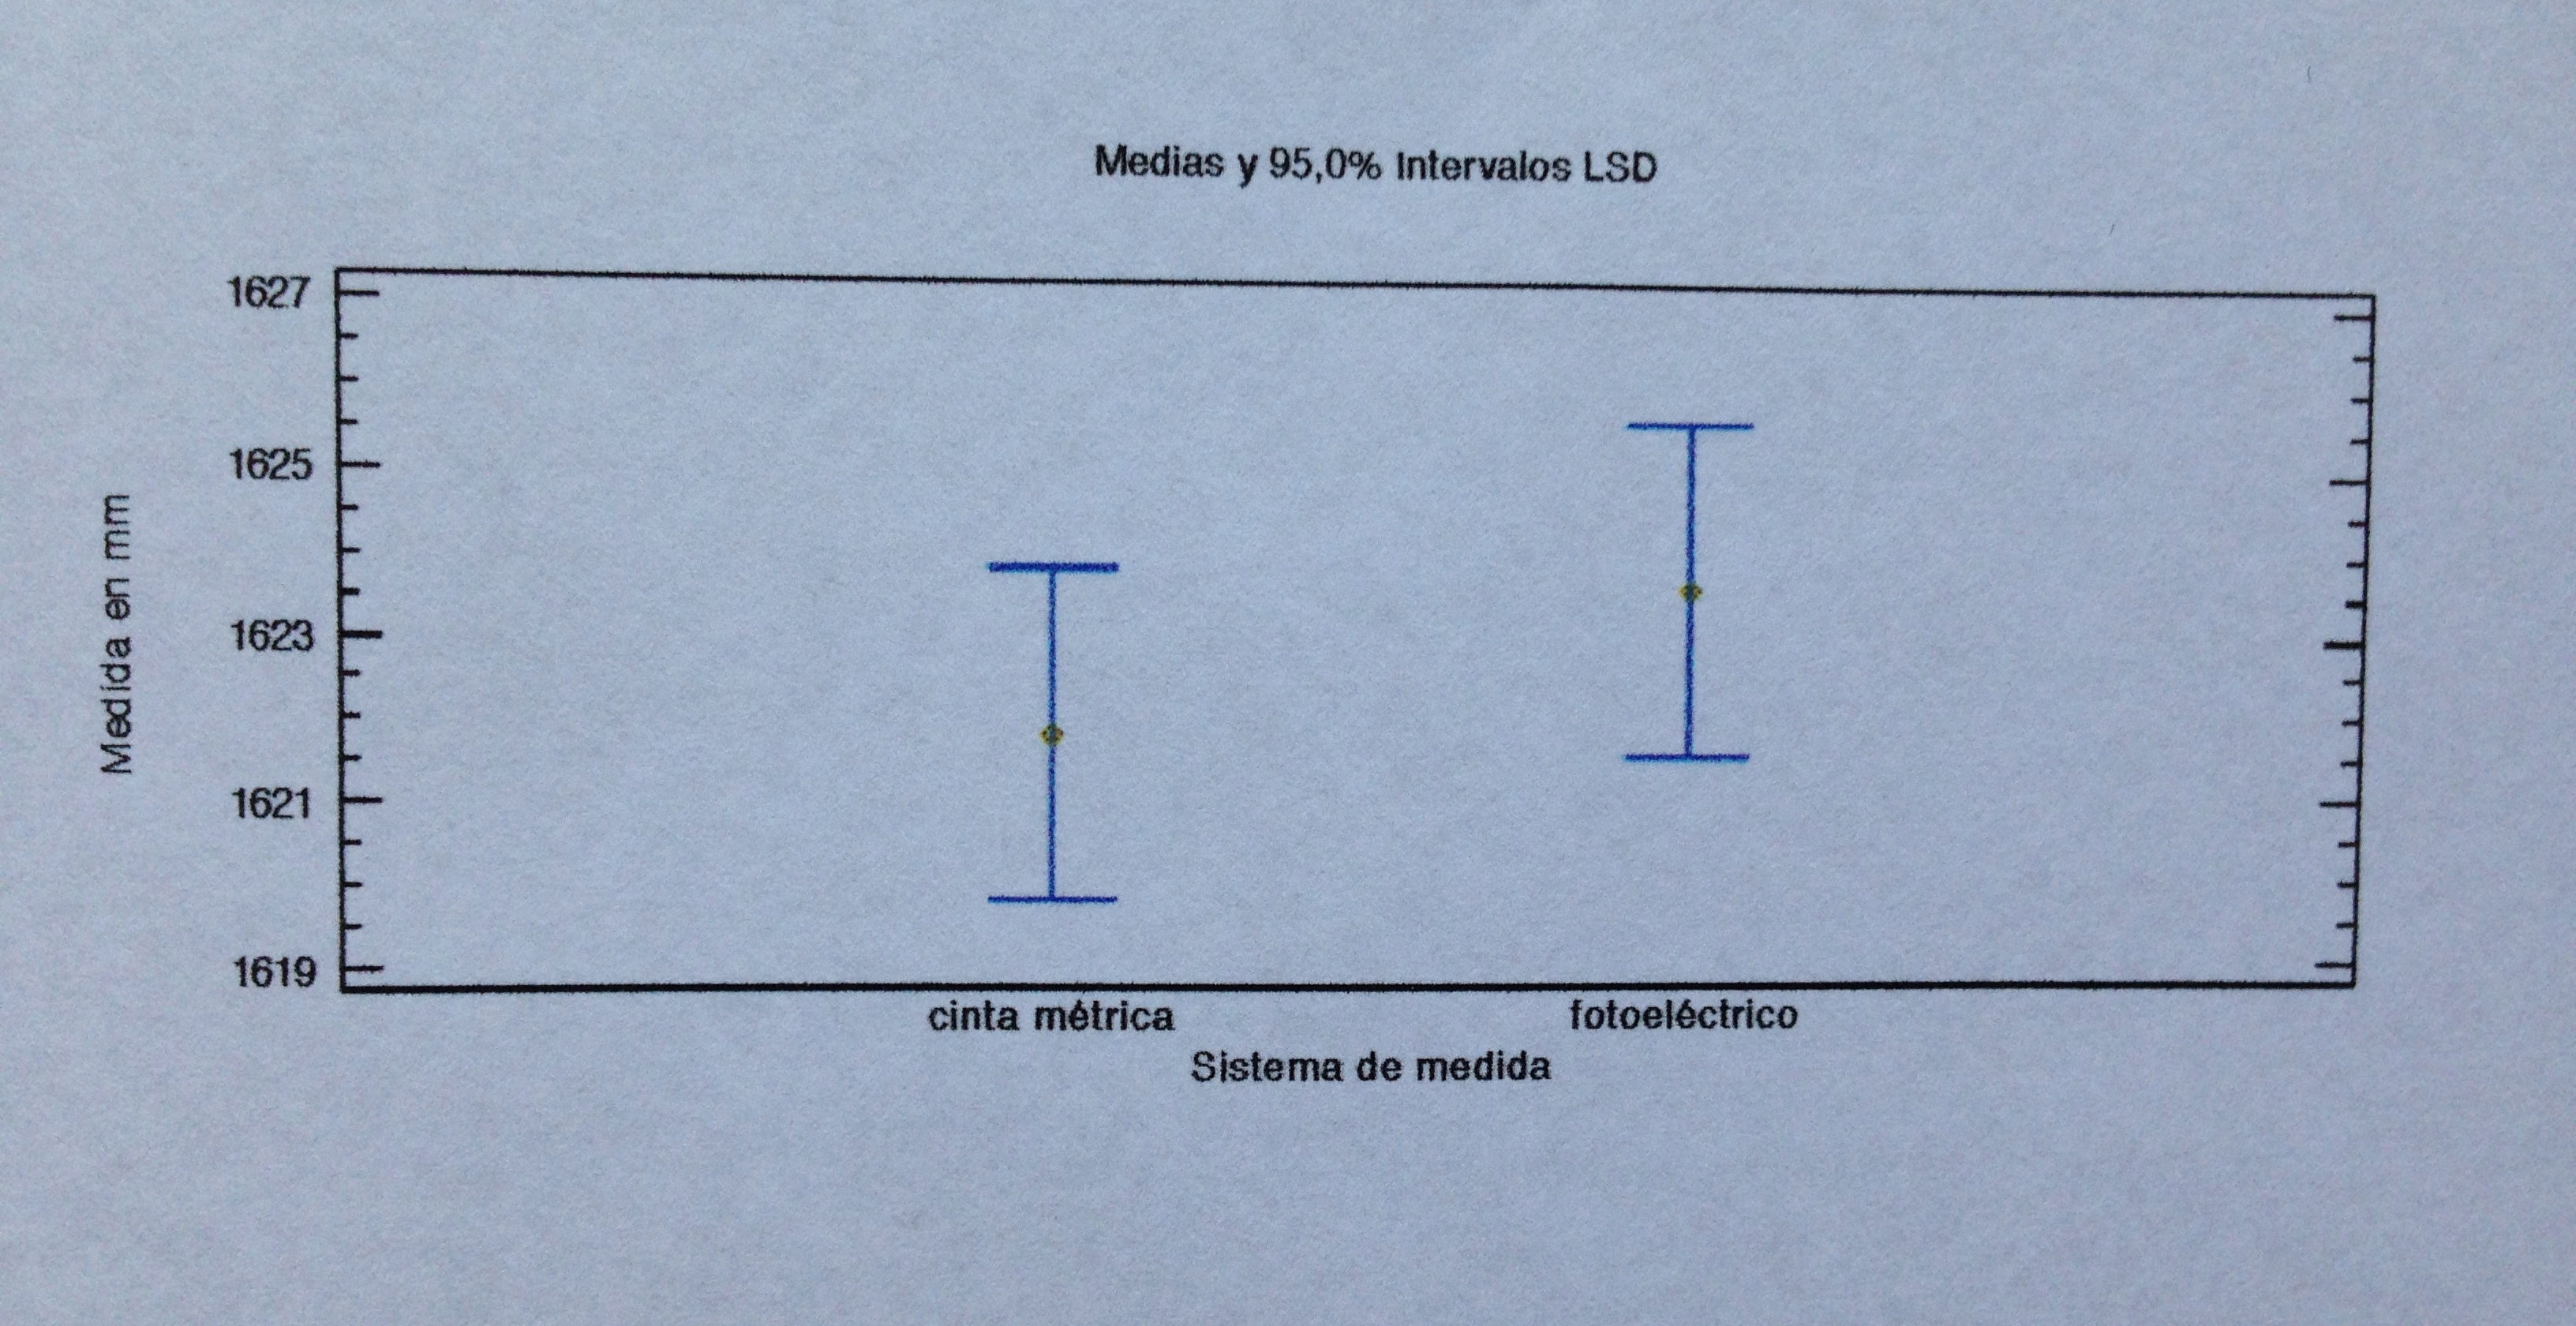
El factor fijo, tipo de medida, no presenta diferencias significativas (p-valor=0.2582), como puede apreciarse también en los intervalos de confianza del 95%:

IMG_6992

El factor medidor, que es aleatorio, porque hemos elegido una muestra de alumnos para ver si, en general, el medidor introduce variabilidad, sí que es un factor significativo. No hace falta representar sus intervalos de confianza porque, al tratarse de una muestra de niveles, lo que nos interesa de esos alumnos es estimar la componente de la varianza que introduce el medidor en general.

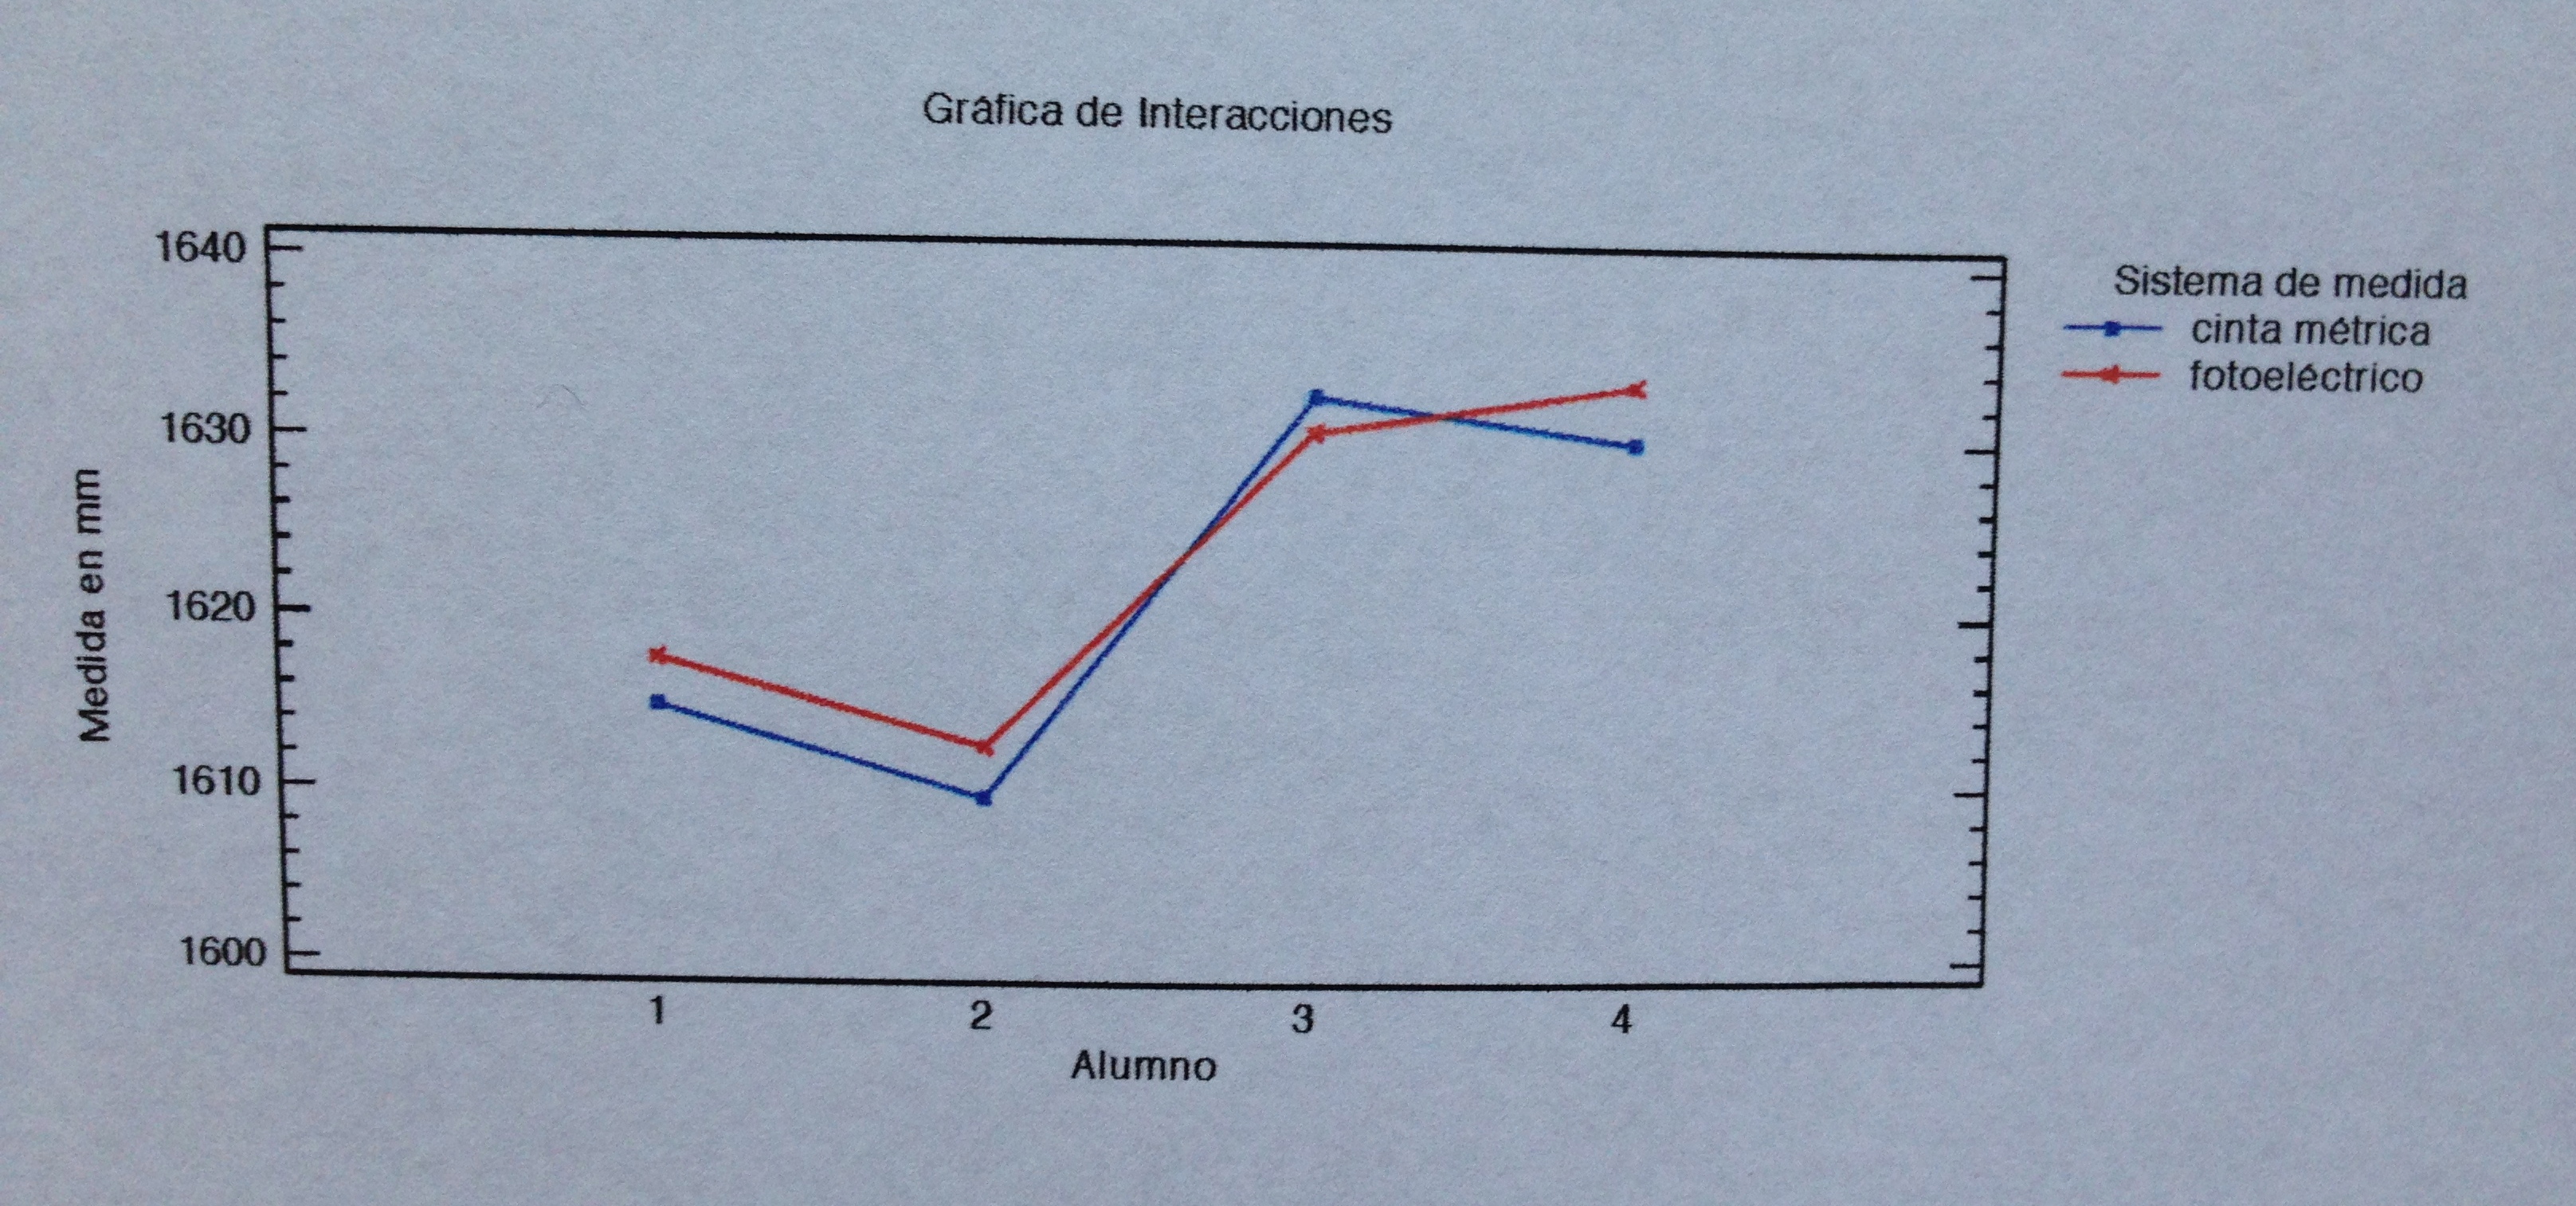
Tampoco hay interacción. El gráfico de interacción también lo muestra:

IMG_6994

Aunque hay un ligero cruce de líneas entre el alumno 3 y 4 no se trata de una interacción significativa, como muestra el p-valor de 0.2021.

Los parámetros del modelo son la constante, el efecto del factor fijo, que no es significativo, y las tres componentes de la varianza: la de medidor, la de la interacción, que tampoco es significativa, y la residual.

Los valores de estos parámetros son:

IMG_6995

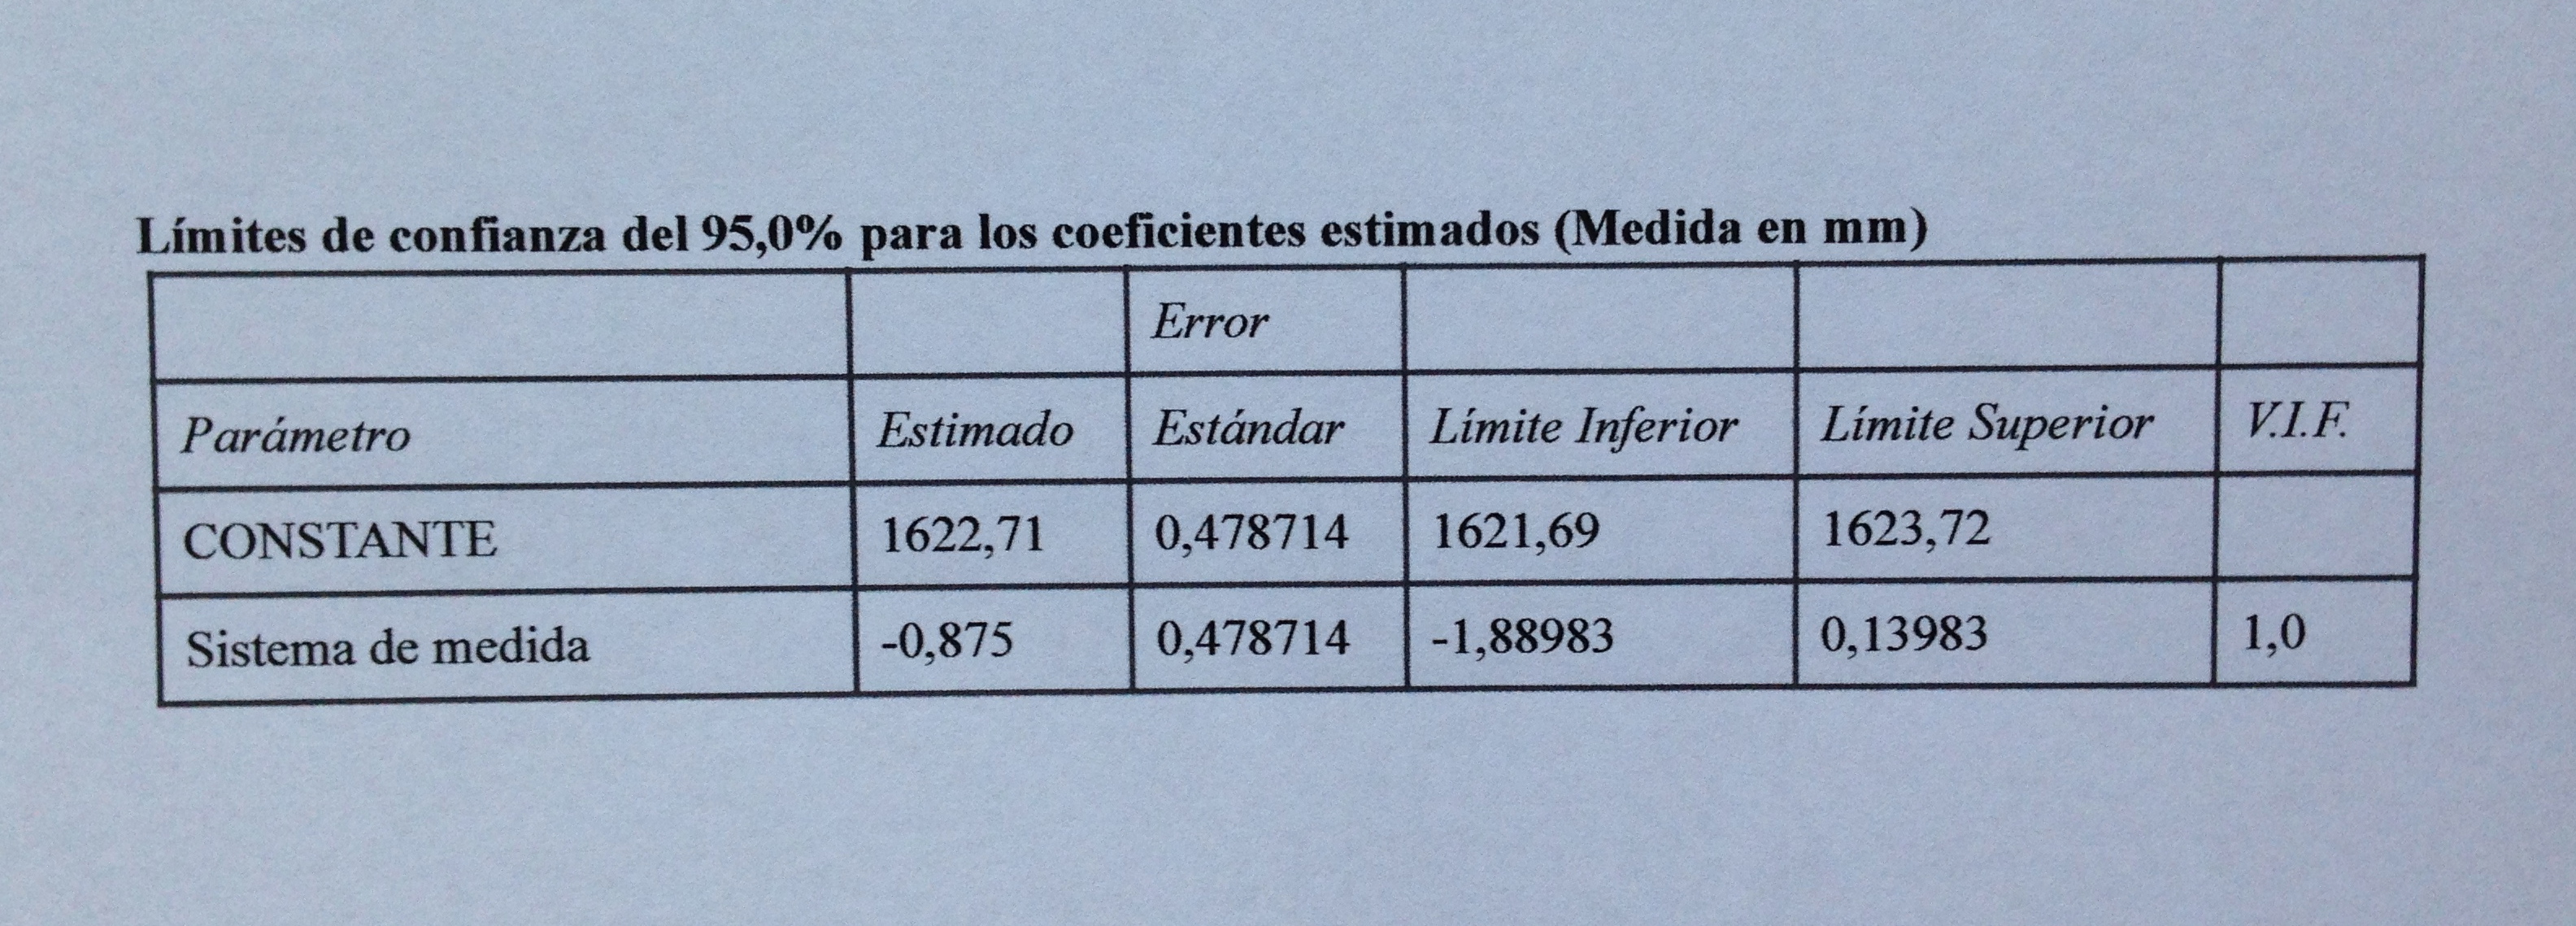
Este 1662.71 es el valor de la constante, la mu del modelo. La alfa1 sería -0.875 y la alfa2 sería 0.875. Pero esto es una estimación. Hemos de tener en cuenta que el contraste de hipótesis nos muestra que este efecto no es significativo.

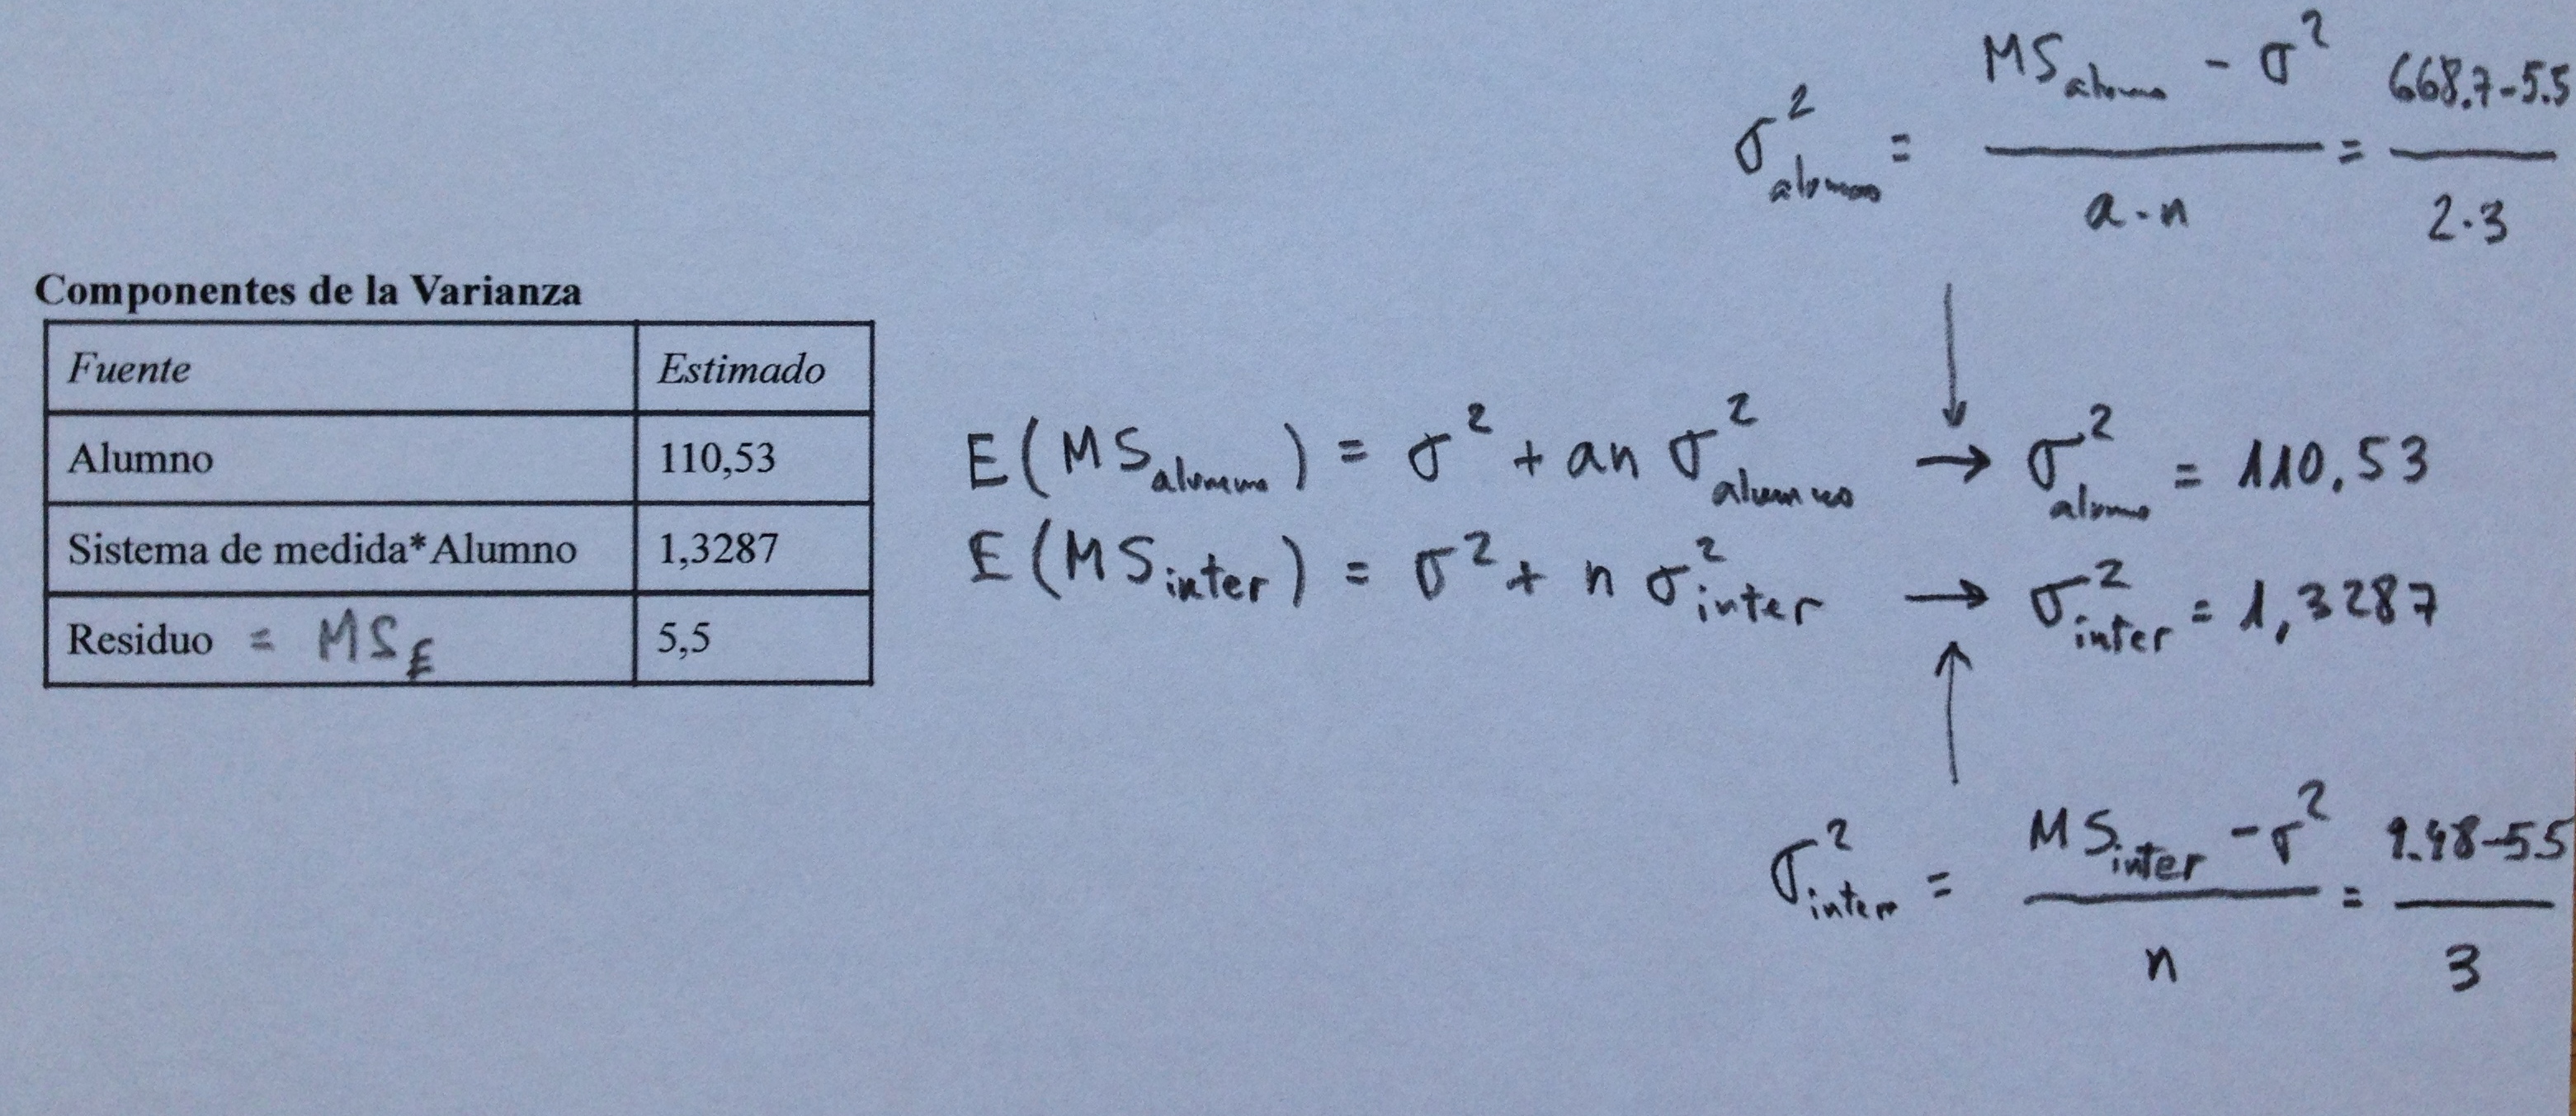
Finalmente las componentes de la varianza. La estimación es la siguiente:

IMG_6997

La componente de la varianza residual es el valor del cuadrado medio residual de la tabla ANOVA; o sea, 5.5. Las demás se calculan, como puede verse, a partir de la esperanza de los cuadrados medios del factor Alumno y de la esperanza de los cuadrados medios de la interacción. Ver de nuevo el fichero ANOVA de dos factores a efectos mixtos.

Se trata de estimaciones. El de la interacción, como hemos visto antes, no es una componente significativa.

Todo ello confirma que, realmente, a partir de estos datos del experimento, la variabilidad de la medición de la altura, es fundamentalmente una variabilidad introducida por el medidor. Que los dos sistemas de medida evaluados presentan diferentes importantes, ni las propias repeticiones del medidor. La variabilidad es entre medidores. Se maneja de forma muy distinta al paciente, por parte del medidor, a la hora de poner en posición al paciente para medirlo.

Solución Situación 39

1d: El primer cuartil es 4 y el tercer cuartil es 8.5. Por lo tanto, el rango intercuartílico es 4.5. La mediana no es 9. Es 6.5.

2d: Siempre que tenemos un p-valor es que hemos realizado un Contraste de hipótesis. En este apartado se muestra un p-valor menor que 0.05, por lo que rechazaremos la Hipótesis nula. En un contraste de hipótesis el mecanismo siempre es el mismo: Hipótesis nula versus Hipótesis alternativa. Si el p-valor es superior o igual a 0.05 mantenemos la Hipótesis nula. Si el p-valor es menor que 0.05 entonces rechazamos la Hipótesis nula y aceptamos la Hipótesis alternativa.
El p-valor muchas veces se da simplemente como mayor o menor que 0.05. En el fondo es lo que básicamente nos interesa: Saber si debemos mantener la Hipótesis nula, previamente tomada como cierta, o si, por el contrario, debemos pasarnos a la Hipótesis alternativa. Por eso, en absoluto es cierto el apartado a.
El apartado b tampoco es cierto. Cuando una correlación es significativa sabemos inmediatamente si es positiva o negativa.

El apartado c también es incorrecto. El criterio de decisión es justo el contrario del que se especifica ahí.

3b: Para que el índice de Gini sea 0 todos los valores de la muestra deben ser iguales. En este caso la curva de Lorenz coincide con la diagonal y, por eso, el índice de Gini es 0. Y esto representa que la desviación estándar es también 0.

El valor máximo del coeficiente de Gini es 1, no 0.5.

El apartado c es incorrecto. Esa muestra nos daría un índice de Gini próximo a 1, no a 0.

Ni en el índice de Gini ni en la desviación estándar pueden tener valores negativos.

4c: En este apartado c, la correlación 0.3 es mayor que la correlación 0.5, sencillamente porque esta última no es significativa y, por lo tanto, debemos pensar que no tenemos argumentos para descartar que poblacionalmente la correlación no sea 0.

El apartado a es incorrecto porque una r=0.9 es una correlación con más magnitud que una r=0.5 pero para decir que sea más significativa deberíamos tener los p-valores, cosa que no tenemos.

La cantidad de correlación lo marca la magnitud. Por lo tanto, 0.5 no es mayor que -0.6.

El apartado d es incorrecto, también. Como ninguna de esas dos correlaciones es significativa, ambas correlaciones son 0 y, por lo tanto, ninguna es mayor que la otra. No tenemos información muestral suficiente, de momento, para decir cuál es mayor.

5d: Al tratarse de un intervalo de confianza de la media debemos calcular el Error estándar, que es 10/raíz(100); o sea, 1. Por lo tanto, un intervalo de confianza del 99.5 sería la media más menos 3 errores estándar; o sea, (47, 53).

Situación 39: Examen (Temas 1-5)

1. En la muestra (8, 9, 5, 3), ¿qué afirmación es cierta?

a) El primer cuartil es 8.5.

b) El tercer cuartil es 4.5.

c) La mediana es 9.

d) El rango intercuartílico es 4.5.

2. Si la correlación entre dos variables es r=0.56 (p<0.05), ¿qué afirmación es cierta?

a) No sabemos si la correlación es significativa porque no tenemos el valor exacto del p-valor.

b) La correlación es significa pero no sabemos si es positiva o negativa.

c) La correlación no es significativa porque el p-valor es menor que 0.05.

d) En este contraste de hipótesis hemos rechazado la Hipótesis nula y hemos aceptado la Hipótesis alternativa, por ser el p-valor inferior a 0.05.

3. ¿Qué afirmación entre las siguientes es cierta?

a) El índice de Gini es máximo cuando es 0.5.

b) Un índice de Gini de 0 equivale a una Desviación estándar también de 0.

c) La curva de Lorenz de la muestra (1, 1, 1, 1000) nos daría un índice de Gini muy próximo a 0.

d) En el índice de Gini, contrariamente a lo que sucede con la desviación estándar, podemos tener valores negativos.

4. ¿Qué afirmación es cierta?

a) r=0.9 es una correlación más significativa que una correlación r=0.5.

b) r=0.5 es una correlación mayor que r= – 0.6.

c) r=0.3 (p=0.003) es una correlación mayor que una r=0.5 (p=0.56).

d) r=0.6 (p=0.48) es una correlación menor que una r=0.7 (p=0.45)

5. Tenemos una muestra de tamaño 100 de una variable que se ajusta bien a una distribución normal. La media muestral es 50 y la desviación estándar es 10. ¿Qué afirmación es cierta?

a) Un Intervalo de confianza del 95% de la media sería: (49, 51).

b) Un intervalo de confianza del 95% de valores individuales de la variable sería: (40, 60).

c) Un intervalo de confianza del 95% de la media sería: (30, 70).

d) Un intervalo de confianza del 99.5% de la media sería: (47, 53).

Solución

Situación 38: Un problema de ANOVA

Estamos estudiando qué elementos introducen más variación a la hora de medir la altura de pacientes ancianos con problemas de osteoporosis. Para ello cogemos una anciana voluntaria predispuesta a ser medida en muchas ocasiones. Usamos dos sistemas de medida: un sistema fotoeléctrico y el de la típica cinta métrica. También escogemos al azar a cuatro alumnos de la asignatura de Reumatología en la facultad de Medicina para que hagan las medidas. Con ello queremos valorar la contribución a la variabilidad de la medida que aporta la persona que la haga. Estos alumnos no saben que forman parte de este experimento. En tres semanas sucesivas se les pide, durante las prácticas, que midan a muchos y muchas ancianas en las consultas externas. Lo que no saben es que han medido de las dos formas distintas a la misma anciana tres veces. Esto se hace para que no puedan recordar la medida dada en una semana anterior. La medida se pedía que se diera en milímetros. Los resultados obtenidos fueron los siguientes:

IMG_6967

Hacer un ANOVA. Primero un ANOVA intuitivo, pensándolo, intentando ver en los datos qué nos podría dar un ANOVA calculado con un software estadística. Luego, hacer un ANOVA mediante un software y mediante el modelo adecuado.