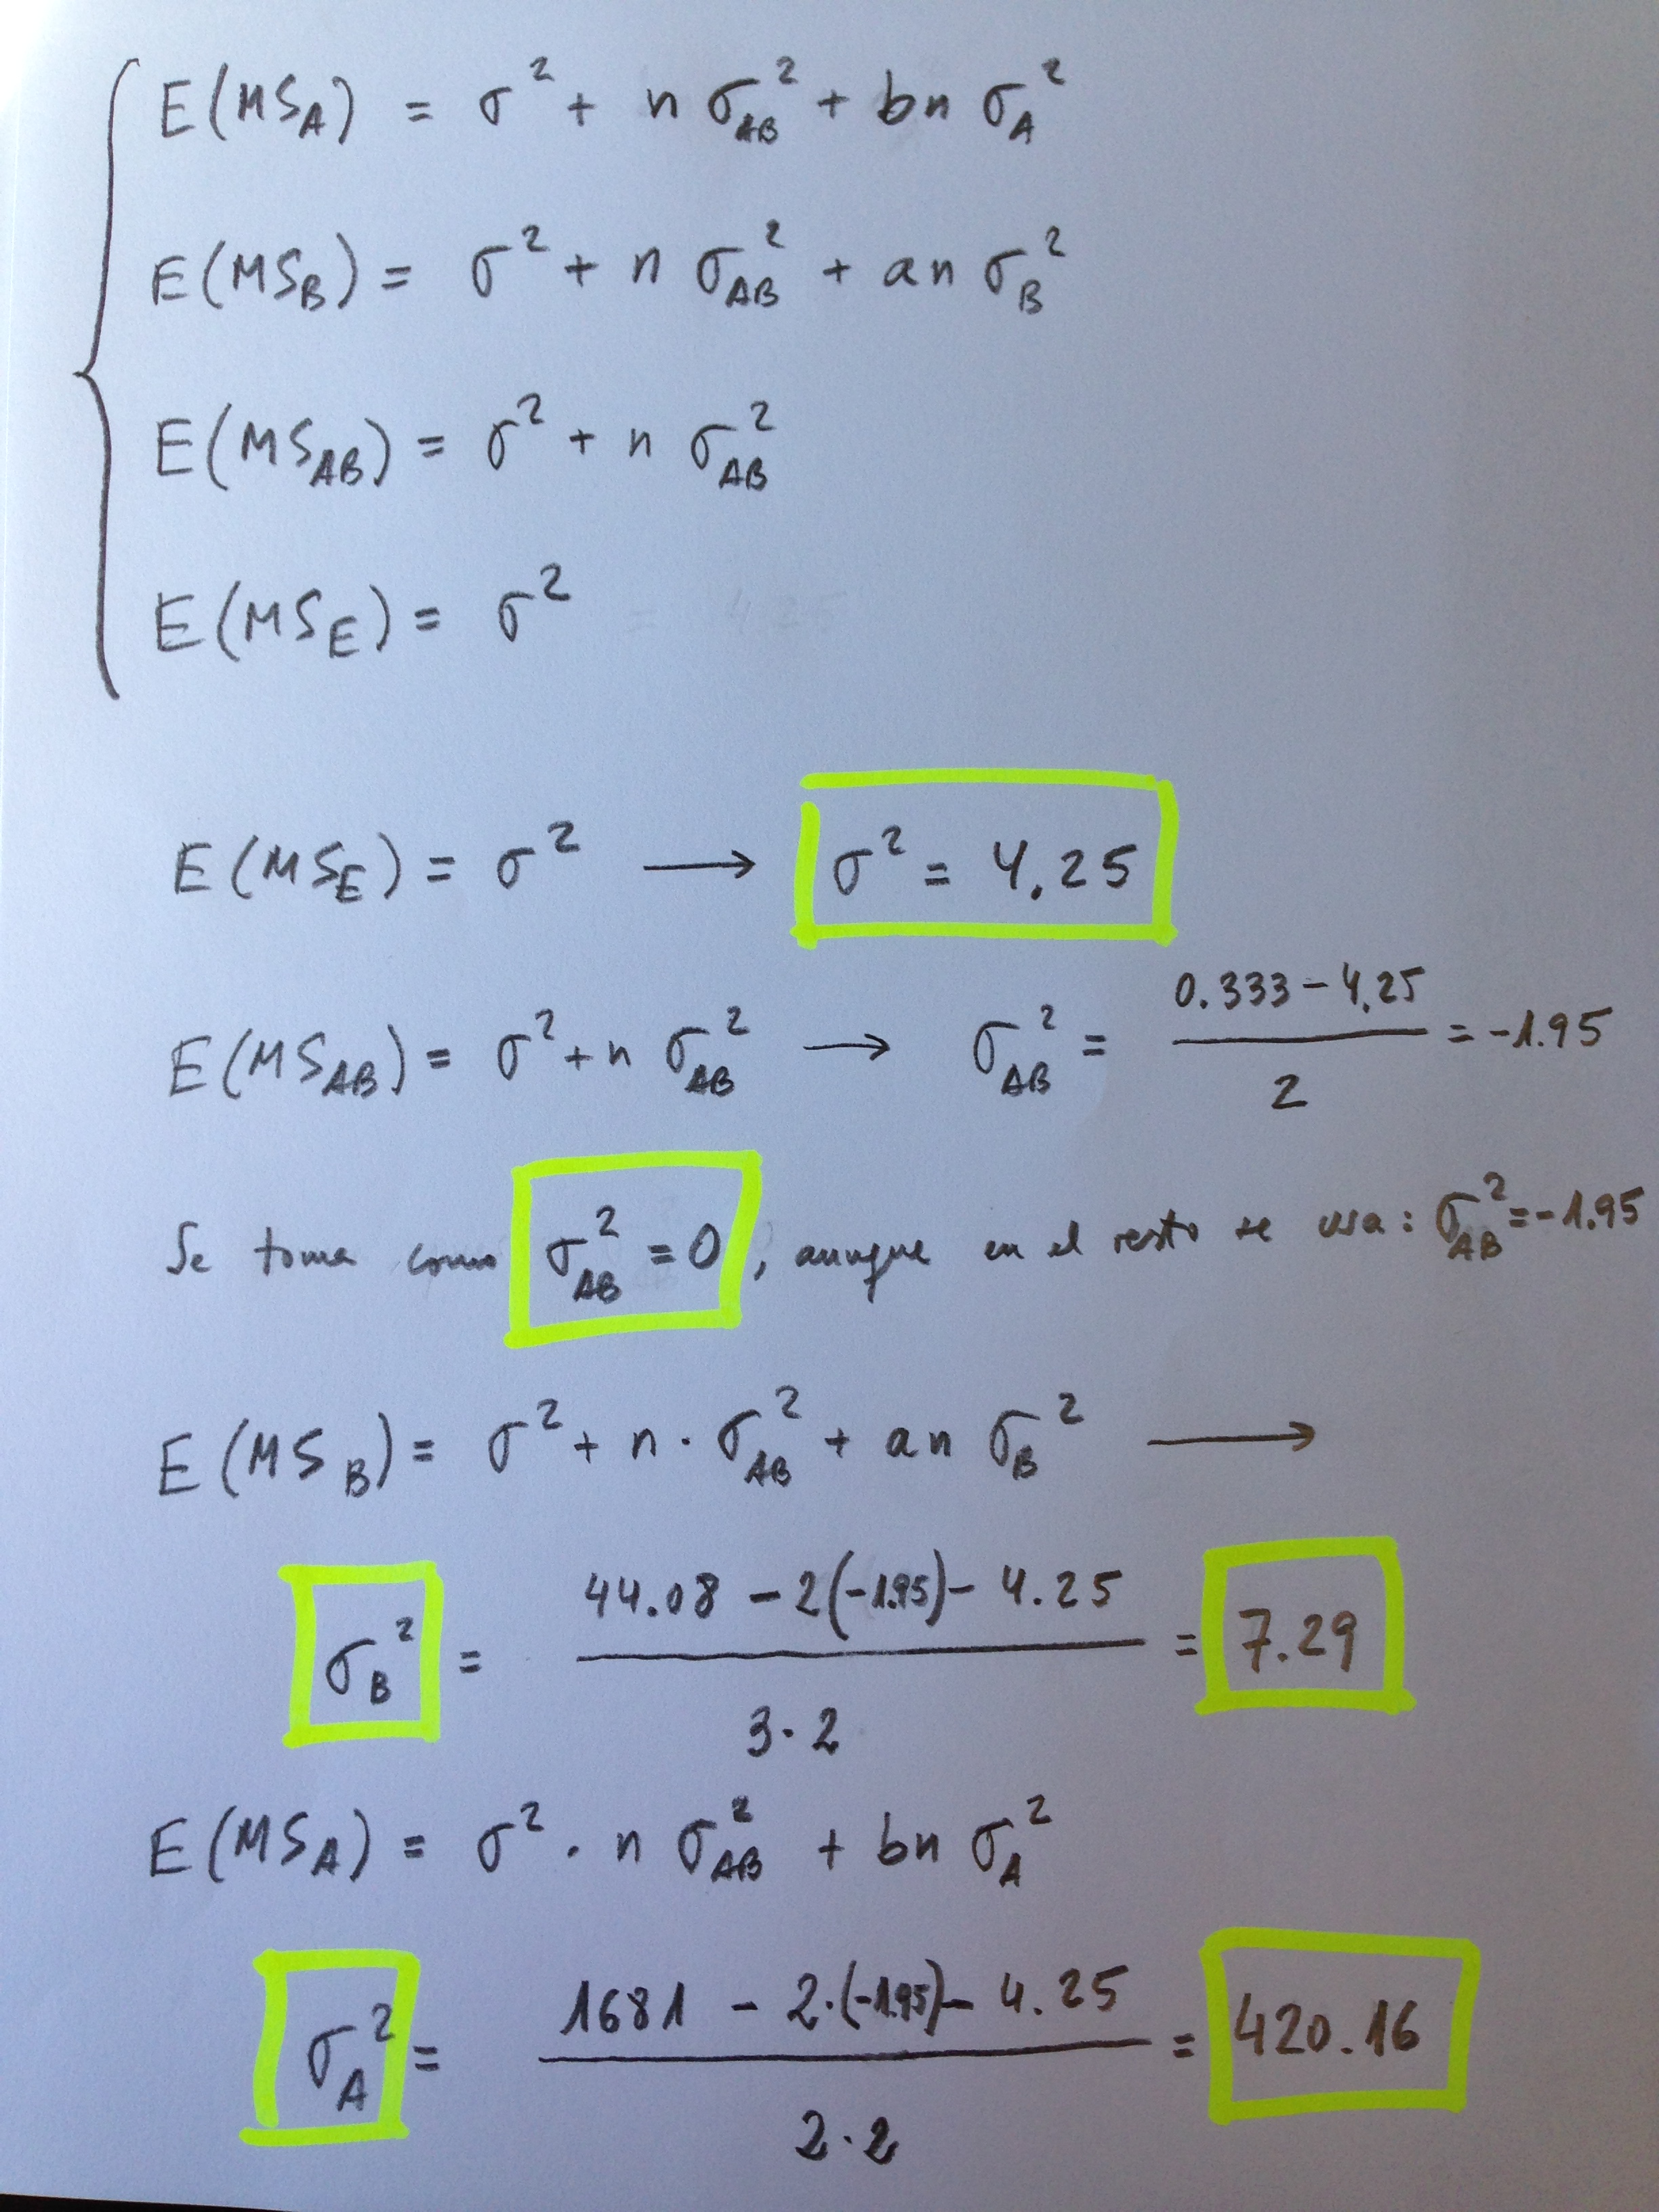Archivo del Autor: estadisticallopis

L’estadística com a ciència del que és SIGNIFICATIU (Una introducció a l’Estadística per a estudiants d’ESO)

Cada ciència s’acostuma a definir delimitant el seu àmbit d’estudi. Així, per exemple, diem que la Biologia és la ciència de la vida, la Lingüística és la ciència de les llengües, la medicina és la ciència que estudia i tracta les malalties humanes, la Psicologia és la ciència del comportament humà, etc.

S’han donat diferents definicions d’Estadística. Una que pot ser apropiada i que està expressada en aquests termes de «la ciència de …» és la següent: l’Estadística és la ciència del que és SIGNIFICATIU.

Bé, com a mínim la definició sorprèn, no? No sembla, almenys a primera vista, que la noció de SIGNIFICATIU mereixi tanta atenció. Doncs no és així. Mereix atenció i molta. S’ha muntat tota una ciència al voltant d’aquesta noció degut a la importància que al llarg dels darrers dos-cents anys se li ha anat donant. I aquí tenim a l’Estadística.

«SIGNIFICATIU» no és, per cert, una paraula estranya en el nostre llenguatge quotidià. Realment no és que sigui de les paraules més habituals del nostre dia a dia, però és una paraula a la que tots seríem capaços d’assignar un significat. Segurament sense una gran precisió, és cert, però tots seríem capaços d’explicar què volem dir quan diem que alguna cosa és SIGNIFICATIVA.

En Estadística, però, és l’objecte fonamental. Pràcticament tot en Estadística està canalitzat per a poder posar l’etiqueta de SIGNIFICATIU o de NO SIGNIFICATIU al que veiem en uns resultats d’un estudi determinat.

Per tant, delimitar el que entenem per SIGNIFICATIU en Estadística és molt important. I delimitar, també, quan unes dades ens permeten dir que el que veiem és o no SIGNIFICATIU, és també nuclear en Estadística.

Vaig a tractar, a continuació, d’explicar quin és el significat de la noció SIGNIFICATIU en el llenguatge de l’Estadística. Vegem-ho, primer, mitjançant metàfores, que és un mètode de comunicar, especialment en Ciències.

Suposem un professor que després d’un llarg curs convoca els seus alumnes per a l’examen final i aquest consisteix en una única pregunta molt concreta, que es respon mitjançant una única línia. Davant d’un examen així un bon alumne, un alumne que ha estudiat molt i que té molts coneixements, pot treure perfectament un 0. Ha tingut mala sort. Li han preguntat just un detall concret que no aconsegueix recordar. I, per contra, un pèssim alumne, un alumne que no ha estudiat res, pot treure un 10. Ha tingut la sort que li han preguntat just una cosa que era del poc que recordava. Això pot passar perfectament. A més, si, davant d’una situació com aquesta, repetíssim l’examen, i ho féssim mitjançant un examen del mateix tipus, mitjançant una pregunta molt concreta que es respon en una simple línia, però, això sí, ara una pregunta diferent a l’anterior, podria passar perfectament que el que abans ha tret un 10 ara tregui un 0 i el que abans ha tret un 0 ara tregui un 10.

En termes estadístics diríem que exàmens d’aquest tipus, exàmens tan concrets, no proporcionen notes SIGNIFICATIVES dels alumnes examinats. Són notes poc fiables, que estan sotmeses massa a l’atzar del que es pregunta. Són notes que no reflecteixen el nivell de coneixements de l’alumne.

Ara suposem que l’examen és de 50 preguntes curtes que cobreixen tot el temari de l’assignatura. La nota que obté un alumne molt poc canviaria si repetíssim l’examen amb altres 50 preguntes. Ara sí que podem parlar d’una nota SIGNIFICATIVA, una nota que tornaria a ser del mateix ordre si tornéssim a fer un examen del mateix tipus.

Un altre exemple: Si un equip de bàsquet està guanyant de 10 punts a la mitja part del partit, cap aficionat al bàsquet diria que aquest partit ja està guanyat. Si miréssim en una base de dades centenars de milers de partits de bàsquet i busquéssim tots els partits en què un equip guanyava de 10 faltant encara 20 minuts de partit per jugar segur que veuríem que més del 5% de vegades aquest equip ha acabat perdent . En termes estadístics diríem que es tracta d’un resultat estadísticament NO SIGNIFICATIU.

Aquest número, el 5%, és molt important en Estadística. És un valor frontera molt important, com veurem després.

Per contra, si faltant un minut un equip està guanyant de 10 punts. Ara, si busquéssim en aquesta mateixa base de dades partits que un equip, faltant un minut per acabar el partit, anava guanyant de 10 punts, segurament veuríem que menys del 5% de vegades aquest equip ha acabat perdent. Si fos així, diríem, en termes estadístics, que aquest resultat és estadísticament SIGNIFICATIU.

Una qüestió molt important: En ciència sempre estudiem mostres però la finalitat és poblacional. Volem parlar de tots a partir de l’estudi d’una part, d’una mostra. En termes de bàsquet: pronosticar el final del partit, però, evidentment, durant el partit. Un cop acabat el partit només és possible descriure el que ha passat però no hi ha pronòstics possibles.

La significació és una paraula nuclear en Ciència. La Ciència tracta de donar resultats SIGNIFICATIUS. Intenta dir coses amb fiabilitat, amb poques possibilitats d’equivocar-se. Els instruments que aporta l’Estadística per delimitar resultats SIGNIFICATIUS de resultats NO SIGNIFICATIVES és un instrument essencial en la Ciència. Vegem alguns exemples on està present la noció de estadísticament SIGNIFICATIU. Els tres exemples estan presos de la revista més prestigiosa en Medicina, el New England Journal of Medicine.

El primer cas consisteix en un estudi publicat recentment on es compara l’eficàcia d’un pàncrees artificial automatitzat, que controla la glucèmia i subministra insulina en continu, respecte a un sistema de control estàndard en pacients amb Diabetis tipus 1. Es comparen dos sistemes de control en un mateix grup de pacients amb aquest tipus de Diabetis. En dues nits diferents s’assagen cadascun d’aquests mètodes en tots els pacients. La variable resposta és si en algun moment els pacients han patit una hipoglucèmia durant la nit. La hipoglucèmia és la situació de màxima gravetat en la qual pot situar-se un diabètic.

Les dades que s’obtenen són les següents:
IMG_0133

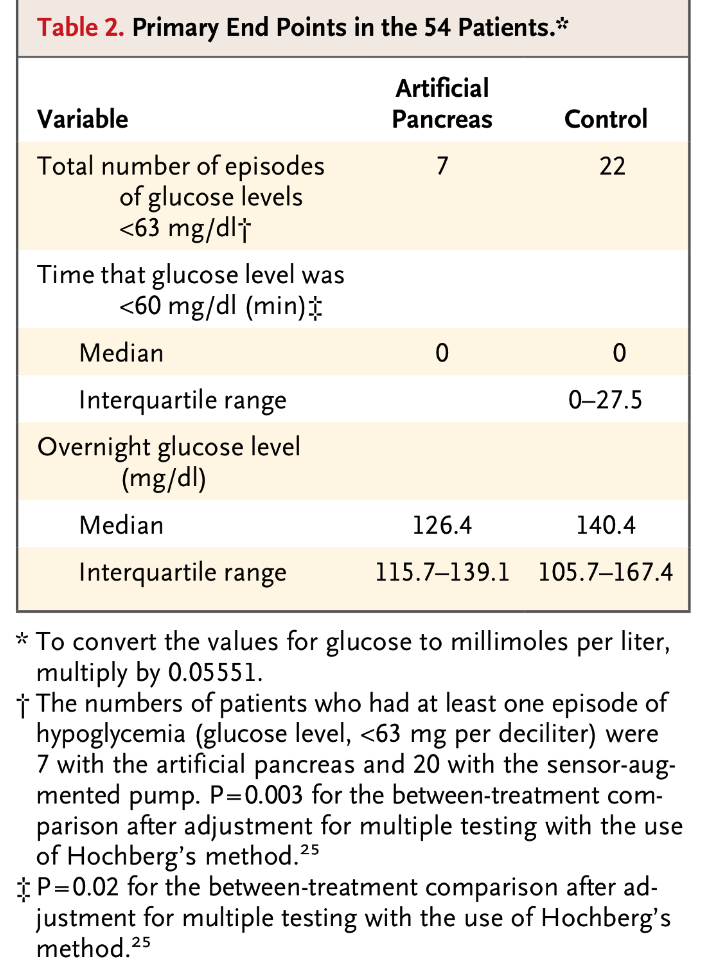
Observem que amb el pàncrees artificial 7 vegades s’ha produït una hipoglucèmia entre els 54 nens amb diabetis participants en l’estudi. Amb el control (el mètode habitual de control nocturn de la diabetis) s’han produït 22 casos d’hipoglucèmia entre 54 nens. Evidentment que 7 és menys que 22. El problema és si aquesta diferència és, o no, estadísticament SIGNIFICATIVA. I això ens ho ha de proporcionar una tècnica estadística. En aquest cas concret ens ho resoldria una tècnica estadística anomenada Test de McNemar. La tècnica ens dóna un valor que és aquest valor que veiem en el gràfic: p = 0.003, que és el valor que marca que estem davant d’un resultat estadísticament SIGNIFICATIU.

Aquesta p, l’anomenat p-valor, és un valor que va de 0 a 1 i si és un valor menor que 0.05 indica que la diferència que veiem és SIGNIFICATIVA, indica que la diferència és fiable. Que no és fruit de l’atzar. Observem que 0.05 sobre 1 és com 5 sobre 100 (un 5%), que és la frontera que abans he citat quan parlava del partit de bàsquet. Aquest 5% o 0.05 per 1 és una frontera molt important en Estadística i en Ciències.

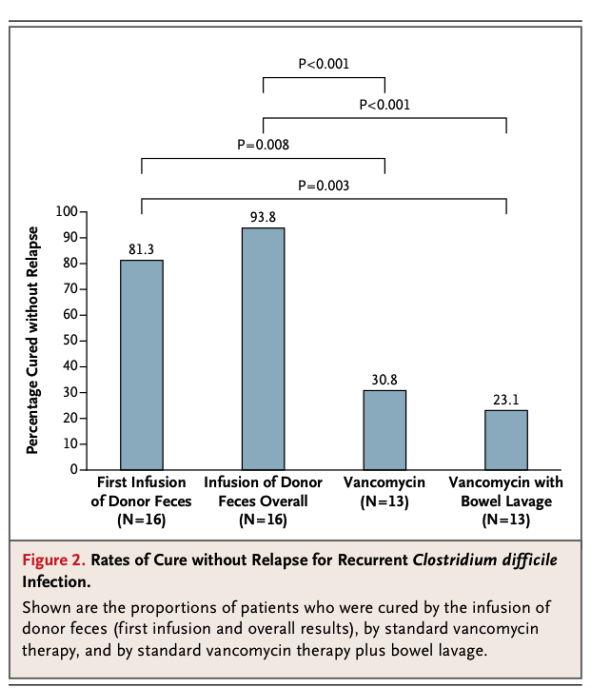
Un altre exemple: A principis d’aquest any un article va generar un veritable impacte entre els especialistes en malalties infeccioses. En un estudi amb persones infectades per Clostridium difficile s’aconseguien millors resultats, un major percentatge de curacions sense recaigudes, si el tractament es feia amb infusions, per sonda oro-gàstrica, de femta de pacients amb infecció crònica d’aquesta espècie bacteriana, que mitjançant un tractament amb antibiòtic. Vegem els resultats:
IMG_4962

Observem les dades dels resultats dels pacients tractats amb la infusió comparats amb els resultats obtinguts amb el tractament amb l’antibiòtic més eficaç usat en aquests casos, que és la vancomicina. Com es pot observar els nivells de curació sense recaigudes són superiors en els tractaments amb les infusions que en els tractaments antibiòtics. Les quatre comparacions possibles entre els tractaments amb infusió i els tractaments amb la vancomicina són SIGNIFICATIVES (p <0.05).

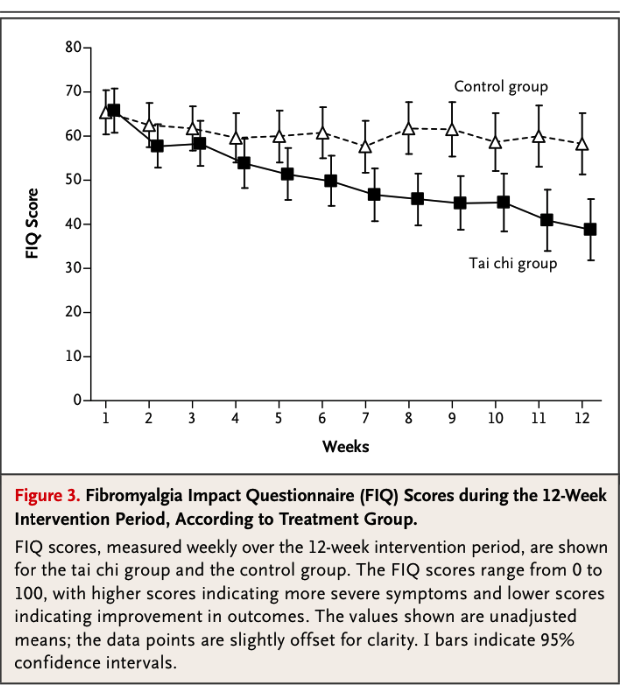
Un altre exemple: La fibromiàlgia és una malaltia molt freqüent en la nostra societat. S’han assajat molts mètodes per intentar buscar remei a aquesta malaltia. Recentment s’ha publicat un original estudi que demostra que el tai-txi és un mètode que aconsegueix resultats positius a l’hora d’abordar aquesta malaltia. Vegem el quadre següent:
IMG_0136

Com es pot observar els dos grups de pacients estudiats, un seguint un mètode control mitjançant fisioteràpia i l’altre seguint unes sessions de tai-txi, parteixen d’un mateix nivell de gravetat i podem veure, en el gràfic, perfectament, quina és l’evolució al llarg de les setmanes. Veiem com el grup control es manté dins d’un nivell estable i, pel contrari, els pacients que segueixen aquestes sessions de tai-txi aconsegueixen reduir significativament els nivells de dolor que tenen. Aquí el p-valor també és inferior a 0.05. La gràfica no ens el dóna, però ens dóna una cosa equivalent. Ens dóna intervals de confiança del 95%. Observem que els intervals de confiança dels dos grups en les primeres setmanes se solapen (el que indica que la diferència no és SIGNIFICATIVA) i, en canvi, a partir de la setmana 8 aquests intervals ja no es solapen. El que indica que aquesta diferència ja és SIGNIFICATIVA, és fiable.

Al final tota aquesta diversitat de situacions s’analitzen mitjançant mecanismes diferents (Tècniques estadístiques diferents) però sempre sota un mateix principi. El següent: El que es veu és una cosa que és molt probable veure-ho en el cas que els grups comparats fossin realment iguals o, pel contrari, seria molt poc probable veure-ho en aquest cas? Les tècniques estadístiques sempre funcionen fent una comparació entre el que veuen en la mostra i el que haurien de veure si els grups comparats fossin iguals.

Si els dos mecanismes de control de la diabetis són iguals, si el tractament amb infusions de femtes de malalts infectats crònicament per Clostridium difficile i el tractament amb antibiòtics donessin resultats idèntics o si fer tai-txi o fer fisioteràpia estàndard donessin resultats idèntics en pacients amb fibromiàlgia, esperaríem veure en una mostra uns certs valors. Aquests valors esperats, en el supòsit que fos cert el cas hipotètic d’igualtat entre els grups comparats, són els que les tècniques estadístiques comparen amb el que realment veuen en les mostres d’aquests estudis. En funció d’aquesta comparació, en funció de la distància entre el que s’esperava i l’observat, acaben dictaminant si això que veiem és coherent o no amb la igualtat suposada d’aquests grups comparats.

Per veure com opera una tècnica estadística per comparar el que s’esperava, sota el supòsit que els grups comparats són iguals, amb el que s’observa, ens centrarem en dos d’aquests tres casos i veurem com raona la tècnica estadística.

Recordem que el primer cas analitzat era l’estudi del pàncrees artificial. Dels 54 pacients 7 tenien problemes amb el pàncrees artificial i amb el control habitual el nombre de problemes era de 22.

7 de 54 i 22 de 54 són diferents, evidentment. Són matemàticament diferents. Però, aquesta diferència, és estadísticament SIGNIFICATIVA? Aquest és el problema. L’anàlisi estadística és qui ho dirà, és el que determinarà si aquesta diferència entre 7 i 22 és, en realitat, una diferència estadísticament SIGNIFICATIVA.

Per començar l’anàlisi anem a suposar, anem a partir de la suposició, que els dos mètodes, els dos tractaments, tenen la mateixa eficàcia. Per tant, elaborarem un món fictici on els dos mètodes que estem comparant fossin, en realitat, idèntics.

Si els dos mètodes fossin idèntics, que donessin el mateix nombre de problemes, el mateix nombre de situacions d’hipoglucèmia, esperaríem una probabilitat d’hipoglucèmia, durant una nit, del 26,8%, perquè tenim, en un mètode, un 12,9 % d’hipoglucèmies i, en l’altre, un 40,7%. El 26,8% és la mitjana d’aquests dos percentatges. Per tant, construïm un món fictici adoptant un valor que, en global, reflecteix la realitat. Pel que hem vist, en l’estudi, en total, es produeix un 26,8% d’hipoglucèmies (si ajuntem les d’un mètode i les de l’altre).

Farem una simulació, anem a construir experiments possibles. Això actualment no és gens estrany. Vivim envoltats de simulació: d’una carrera de motos, d’un partit de futbol, ​​etc. Això que ens proposem fer, ara, és possible gràcies a la informàtica. Generarem experiments possibles però sota el supòsit que els dos mètodes tenen el mateix percentatge de problemes, sota el supòsit d’aquesta ficció que hem creat. Generarem 100.000 experiments equivalents al de l’estudi, però sota el supòsit que els dos mètodes són igual d’eficaços, o sigui, amb una probabilitat d’hipoglucèmia, en ambdós mètodes, del 26,8%.

Fent això estarem veient quines variacions possibles veuríem en experiments on fos cert que els dos mètodes són iguals. D’aquesta manera podrem situar el nostre experiment real, que només tenim un, dins d’aquest immens conjunt d’experiments simulats sota el supòsit d’igualtat. Serà aquesta la manera d’avaluar la posició relativa del que veiem en el conjunt del que hauríem de veure si fos cert que els dos mètodes són iguals.

Si fem aquests 100.000 experiments obtindrem parelles de valors com, per exemple: (15, 17), (14, 15), (17, 13), (16, 16), etc, que seran valors possibles a veure d’hipoglucèmies entre 54 pacients en cada un dels dos mètodes, però, sempre, sota el supòsit que la probabilitat d’hipoglucèmia és la mateixa en cada un dels dos sistemes: 26,8%.

En l’estudi real la parella de valors que hem obtingut era (7, 22). Una diferència de 15. Anem a restar nosaltres les 100.000 parelles de valors del nombre d’hipoglucèmies simulades amb un tractament i amb l’altre. Els valors d’aquestes 100.000 restes que obtenim són els presentats en el següent gràfic:

IMG_7199

Com es pot veure, el més habitual, el més freqüent, és que la diferència sigui petita. Diferències de 0, 1, -1, 2, -2, 3, -3, 4 i -4 són les més freqüents. Les restes més grans són d’una freqüència molt petita. Però és molt important veure aquí que la diferència de 15, que és just la diferència entre 22 i 7 que nosaltres veiem en l’estudi, és extraordinàriament improbable. Apareix en poquíssimes ocasions. Això és el que fa dubtar que el que veiem procedeixi de dos mètodes equivalents. Davant d’aquesta poca probabilitat és raonable pensar que la diferència observada es tracta realment d’una diferència real. Que si el portéssim a milions i milions de persones, no només a 54 persones, acabaríem veient un resultat equivalent al que estem veient en aquest estudi.

Això és com quan diem que un partit de bàsquet ja està guanyat quan, faltant 1 minut, el nostre equip guanya de 10. La probabilitat de perdre és prou baixa com per pensar que aquest partit ja està guanyat.

Per això parlem d’un resultat SIGNIFICATIU, perquè és molt poc probable veure el que estem veient en el cas que els grups comparats realment es comportessin poblacionalment de forma equivalent i, a la mostra, veiéssim el que estem veient.

Anem al segon cas, el del Clostridium difficile. Agafem de les quatre situacions experimentals les dades de les dues situacions descrites en el centre de la taula: el cas de tractament amb infusió que té un 93,8% d’èxit i el de la vancomicina, que té un 30,8% d’èxit . Es tracta ara de simular experiments dels que suposem que la probabilitat d’èxit dels dos mètodes comparats és la mateixa. Per això podem pensar en un valor mitjà dels dos vistos: una mitjana entre 93,8% i 30,8%, o sigui, 62,3%.

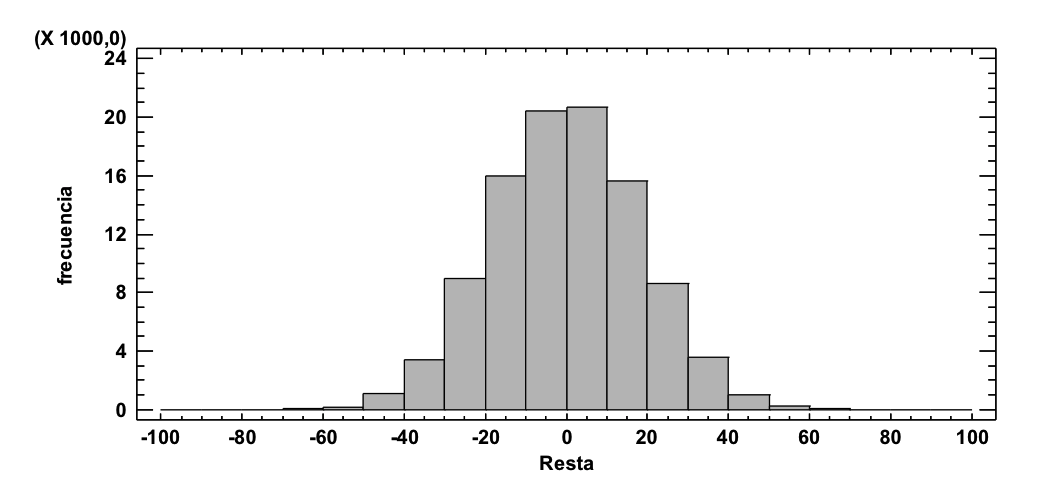
Podem ara simular 100.000 experiments equivalents però sota el supòsit que siguin iguals les probabilitats d’èxit mitjançant els dos procediments. Generar, per tant, parelles de valors basats en mostres de grandària 16 i 13, en cada experiment, cadascú amb una probabilitat d’èxit del 62,3%. Així tindríem parelles de valors com: (10, 7), (11, 6), (9, 7), etc. Ara les 100.000 parelles les transformem a percentatges d’èxit, relatiu sempre als 16 i 13 de mida mostral de cada un dels dos experiments: el primer sempre respecte a 16 i el segon respecte a 13. Així tindríem, en els casos exemplificats abans: (62.5, 53.8), (68.7, 46.1), (56.2, 53.8), etc. Si ara fem les 100.000 restes d’aquestes parelles de percentatges tindrem el següent histograma:
IMG_7213

Com es pot apreciar, sota el supòsit que els dos mètodes tinguin la mateixa probabilitat d’èxit els valors de les restes obtingudes a l’atzar se situen majoritàriament entre -40 i 40 . En els valors observats: (93.8, 30.8) tenim una resta de 63. Una resta, per cert, amb un valor molt estrany, un valor que és molt poc probable veure si els dos tractaments són iguals. Per tant, hem de decantar-nos per pensar que realment no han de ser iguals SIGNIFICATIVAMENT les probabilitats d’èxit d’aquests dos tractaments, perquè de ser-ho hauríem de veure, en un experiment, més proximitat de valors de la que veiem.

De nou això és com quan en un partit de bàsquet, en què falta 1 minut per acabar i el nostre equip guanya de 10 punts, diem que el partit està guanyat. La probabilitat de perdre és prou baixa com per pensar que el partit està guanyat.

Per això parlem de que estem davant d’un resultat SIGNIFICATIU, perquè és molt poc probable veure el que estem veient i que sigui cert que els dos tractaments siguin iguals.

Pot semblar sorprenent però el cert és que l’Estadística i totes les Ciències es basen, es recolzen, en anàlisis estadístiques com aquestes que acabem de veure. L’Estadística elabora i aplica mètodes per diagnosticar el que és o no SIGNIFICATIU i tots ells tenen com a principi bàsic aquestes idees que hem intentat explicar aquí.
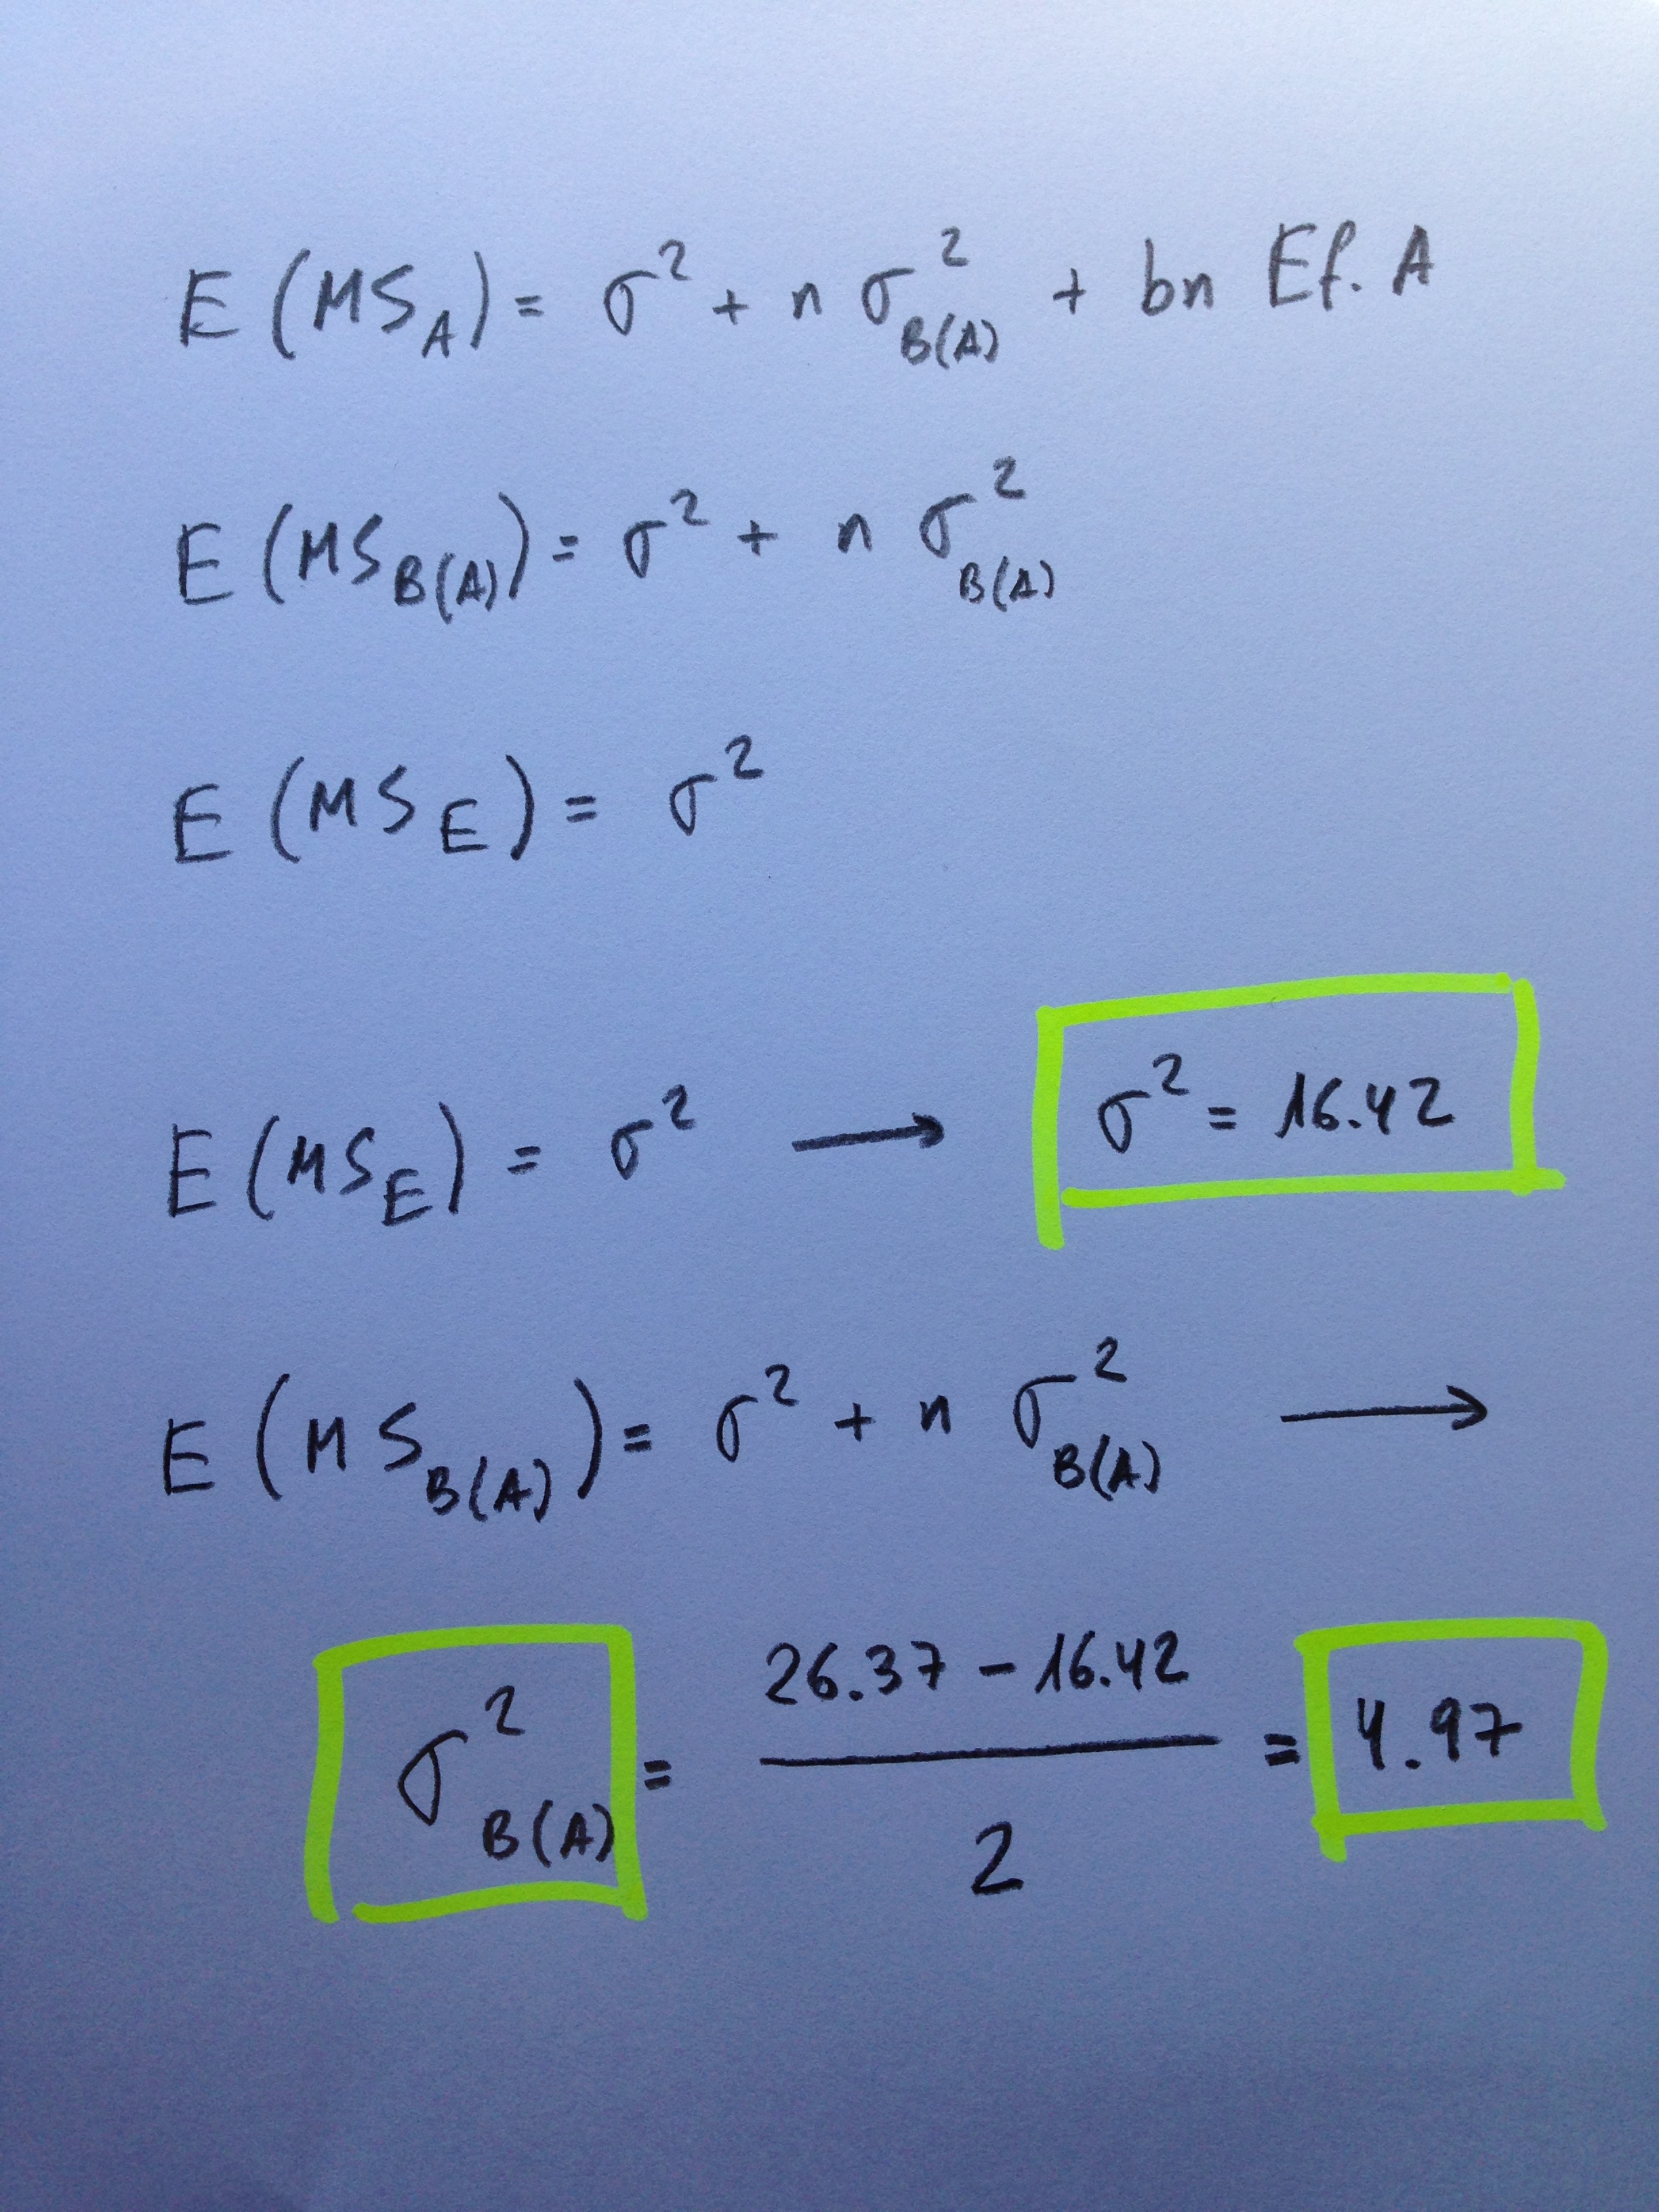
La Estadística como ciencia de lo SIGNIFICATIVO (Una introducción a la Estadística para estudiantes de ESO)

Cada ciencia suele definirse delimitando su ámbito de estudio. Así, por ejemplo, decimos que  la Biología es la ciencia de la vida, la Lingüística es la ciencia de las lenguas, la Medicina es la ciencia que estudia y trata las enfermedades humanas, la Psicología es la ciencia del comportamiento humano, etc.

Se han dado diferentes definiciones de Estadística. Una que puede ser apropiada y que está expresada en estos términos de “la ciencia de …” es la siguiente: la Estadística es la ciencia de lo SIGNIFICATIVO.

Bueno, como mínimo la definición sorprende, ¿no? No parece, al menos a primera vista, que lo SIGNIFICATIVO merezca tanta atención. Pues no es así. Merece atención y mucha. Se ha montado toda una ciencia en torno a esa noción debido a la importancia que a lo largo de los últimos doscientos años se le ha ido dando. Y ahí tenemos a la Estadística.

«SIGNIFICATIVO» no es, por cierto, una palabra extraña en nuestro lenguaje cotidiano. Realmente no es que sea de las palabras más habituales de nuestro día a día, pero es una palabra que todos seríamos capaces de asignarle un significado. Seguramente sin una gran precisión, es cierto, pero todos seríamos capaces de explicar qué queremos decir cuando decimos que algo es SIGNIFICATIVO.

En Estadística, sin embargo, es el objeto fundamental. Prácticamente todo en Estadística está canalizado para poder poner la etiqueta de SIGNIFICATIVO o de NO SIGNIFICATIVO a lo que vemos en unos resultados de un estudio determinado.

Por lo tanto, delimitar lo que entendemos por SIGNIFICATIVO en Estadística es crucial. Y delimitar, también, cuándo unos datos nos permiten decir que lo que vemos es o no SIGNIFICATIVO, es también nuclear en Estadística.

Voy a tratar, a continuación, de explicar cuál es el significado de la noción SIGNIFICATIVO en el lenguaje de la Estadística. Veámoslo, primero, mediante metáforas, que es una excelente forma de comunicar, especialmente en Ciencias.

Supongamos un profesor que después de un largo curso convoca a sus alumnos para el examen final y éste consiste en una única pregunta muy concreta, que se responde mediante una única línea. Ante un examen así un buen alumno, un alumno que ha estudiado mucho y que tiene muchos conocimientos, puede sacar perfectamente un 0. Ha tenido mala suerte. Le han preguntado justo un detalle concreto que no consigue recordar. Y, por el contrario, un pésimo alumno, un alumno que no ha estudiado nada, puede sacar un 10. Ha tenido la suerte de que le han preguntado justo algo que era de lo poco que sabía. Esto puede pasar perfectamente. Además, si, ante una situación como esta, repitiésemos el examen, y lo hiciésemos mediante un examen del mismo tipo, mediante una pregunta muy concreta que se responde en una simple línea, pero, eso sí, ahora una pregunta distinta a la anterior, podría pasar perfectamente que el que antes ha sacado un 10 ahora saque un 0 y el que antes ha sacado un 0 ahora saque un 10.

En términos estadísticos diríamos que exámenes de este tipo, exámenes tan concretos, no proporcionan notas SIGNIFICATIVAS de los alumnos examinados. Son notas poco fiables, que están sometidas demasiado al azar de lo que se pregunta. Son notas que reflejan poco el nivel de conocimientos del alumno.

Sin embargo, supongamos ahora que el examen es de 50 preguntas cortas que cubren todo el temario de la asignatura. La nota que obtiene un alumno muy poco cambiaría si repitiéramos el examen con otras 50 preguntas. Ahora sí podemos hablar de una nota SIGNIFICATIVA, una nota que volvería a ser del mismo orden si volviéramos a hacer un examen del mismo tipo aunque distinto.

Otro ejemplo: Si un equipo de baloncesto está ganando de 10 puntos en la media parte del partido, ningún aficionado al baloncesto diría que este partido ya está ganado. Si miráramos en una base de datos cientos de miles de partidos de baloncesto y buscáramos todos los partidos en los que un equipo ganaba de 10 faltando todavía 20 minutos de partido por jugar seguro que veríamos que más del 5% de veces ese equipo ha acabado perdiendo. En términos estadísticos diríamos que se trata de un resultado estadísticamente NO SIGNIFICATIVO.

Este número, el 5%, es muy importante en Estadística. Es un valor frontera muy importante, como veremos más tarde.

Por el contrario, si faltando un minuto un equipo está ganando de 10 puntos. Ahora  si buscásemos en esa misma base de datos partidos que un equipo, faltando un minuto para acabar el partido, iba ganando de 10 puntos, seguramente veríamos que menos del 5% de veces ese equipo ha acabado perdiendo. Si fuera así, diríamos, en términos estadísticos, que este resultado es estadísticamente SIGNIFICATIVO.

Una cuestión muy importante: En ciencia siempre estudiamos muestras pero la finalidad es poblacional. Queremos hablar de todos a partir del estudio de una parte, de una muestra. En términos de baloncesto: Pronosticamos el final del partido, pero, evidentemente, durante el partido. Una vez acabado el partido sólo es posible describir lo que ha sucedido pero no hay pronósticos posibles.

La significación es una palabra nuclear en la Ciencia. La ciencia persigue dar resultados SIGNIFICATIVOS. Persigue decir cosas con fiabilidad, con pocas posibilidades de equivocarse. Los instrumentos que aporta la Estadística para delimitar resultados SIGNIFICATIVOS de  resultados NO SIGNIFICATIVOS es un instrumento esencial en la Ciencia. Veamos algunos ejemplos donde está presente la noción de estadísticamente SIGNIFICATIVO. Los tres ejemplos están tomados de la revista más prestigiosa en Medicina, el New England Journal of Medicine.

El primer caso consiste en un estudio publicado recientemente donde se compara la eficacia de un páncreas artificial automatizado, que controla la glucemia y suministra insulina en continuo, respecto a un sistema de control estándar en pacientes con Diabetes tipo 1. Se usan los dos sistemas de control en un mismo grupo de pacientes con este tipo de Diabetes. En dos noches distintas se ensayan cada uno de estos métodos en todos los pacientes. La variable respuesta es si en algún momento han sufrido una hipoglucemia durante la noche. La hipoglucemia es la situación de máxima gravedad en la que puede situarse un diabético.

Los datos que se obtienen son los siguientes:

IMG_0133

Observemos que con el páncreas artificial 7 veces se han producido una hipoglucemia entre los 54 niños con diabetes participantes en el estudio. Con el control (el método habitual de control nocturno de la diabetes) se han producido 22 casos de hipoglucemia entre 54 niños. Evidentemente que 7 es menos que 22. El problema es si esta diferencia es, o no, estadísticamente SIGNIFICATIVA. Y esto nos lo debe proporcionar una técnica estadística. En este caso concreto nos lo resolvería una técnica estadística llamada Test de McNemar. La técnica nos da un valor que es este valor que vemos: p=0.003, que es el valor que marca que estamos ante un resultado estadísticamente SIGNIFICATIVO.

Esta p, el denominado p-valor, es un valor que va de 0 a 1 y si es un valor menor que 0.05 indica que la diferencia que vemos es SIGNIFICATIVA, indica que la diferencia es fiable. Que no es fruto del azar. Observemos que 0.05 sobre 1 es como 5 sobre 100 (un 5%), que es la frontera que antes he citado cuando hablaba del partido de baloncesto. Este 5% ó 0.05 por 1 es una frontera muy importante en Estadística y en Ciencias.

Otro ejemplo: A principios de este año un artículo creó un verdadero impacto entre los especialistas en enfermedades infecciosas. En un estudio con personas infectadas por Clostridium difficile conseguían mejores resultados, un mayor porcentaje de curaciones sin recaídas, si el tratamiento se hacía con infusiones, por sonda orogástrica, de heces de pacientes con infección crónica de esta especie bacteriana, que mediante un tratamiento con antibiótico. Veamos los resultados:

IMG_4962

Observemos los datos de los resultados de los pacientes tratados con la infusión comparados con los resultados obtenidos con el tratamiento con el antibiótico más eficaz usado en estos casos, que es la vancomicina. Como puede observarse los niveles de curación sin recaídas son superiores en los tratamiento con infusiones con heces que en los tratamientos antibióticos. Las cuatro comparaciones posibles entre los tratamientos con infusión y los tratamientos con la vancomicina son SIGNIFICATIVAS (p<0.05).

Otro ejemplo: La fibromialgia es una enfermedad muy frecuente en nuestra sociedad. Se han ensayado muchos métodos para intentar buscar remedio a esta dolencia. Recientemente se ha publicado un original estudio que demuestra que el Tai-chi es un método que consigue resultados positivos a la hora de abordar esta enfermedad. Veamos el cuadro siguiente:

IMG_0136

Como puede observarse los dos grupos de pacientes estudiados, uno siguiendo un método control mediante fisioterapia y el otro siguiendo unas sesiones de tai-chi, parten de una mismo nivel de gravedad y podemos ver en el gráfico, perfectamente, cuál es la evolución a lo largo de las semanas. Vemos cómo el grupo control se mantiene dentro de un nivel estable y, sin embargo, los pacientes que siguen esas sesiones de tai-chi consiguen reducir significativamente los niveles de dolor que tienen. Aquí el p-valor también es inferior a 0.05. La gráfica no nos lo da, pero nos da algo equivalente. Nos da intervalos de confianza del 95%. Observemos que los intervalos de confianza de los dos grupos en las primeras semanas se solapan (lo que indica que la diferencia no es SIGNIFICATIVA) y, sin embargo, a partir de la semana 8 esos intervalos ya no se solapan. Lo que indica que esa diferencia ya es SIGNIFICATIVA, es fiable.

Al final toda esta diversidad de situaciones se analizan mediante mecanismos diferentes (Técnicas estadísticas distintas) pero siempre bajo un mismo principio. El siguiente: ¿Lo que se ve es algo que es muy probable verlo en el caso que los grupos comparados fueran realmente iguales o, por el contrario, sería muy poco probable verlo en ese caso? Las técnicas estadísticas siempre funcionan haciendo una comparación entre lo que ven en la muestra y lo que deberían ver si los grupos comparados fueran iguales.

Si los dos mecanismos de control de la diabetes fueran iguales, si el tratamiento con infusiones de heces y el tratamiento con antibióticos dieran resultados idénticos o si hacer tai-chi o hacer fisioterapia estándar dieran resultados idénticos en pacientes con fibromialgia, esperaríamos ver en una muestra unos ciertos valores. Estos valores esperados, en el supuesto de que fuera cierto el caso hipotético de igualdad entre lo comparado, son los que las técnicas estadísticas comparan con lo que realmente ven en las muestras de esos estudios. En función de esta comparación, en función de la distancia entre lo esperado y lo observado, acaban dictaminando si eso que vemos es coherente o no con la igualdad presupuesta de esos grupos comparados.

Para ver cómo opera una técnica estadística para comparar lo esperado, bajo el supuesto de que los grupos comparados son iguales, con lo observado, vamos a centrarnos en dos de esos tres casos y vamos a ver, en ellos, cómo opera la técnica estadística.

Recordemos que el primer caso analizado era el estudio del páncreas artificial. De los 54 pacientes 7 tenían problemas con el páncreas artificial y con el control habitual el número de problemas ascendía a 22.

7 de 54 y 22 de 54 son distintos, evidentemente. Son matemáticamente distintos. Pero, esta diferencia, ¿es estadísticamente SIGNIFICATIVA? Este es el problema. El análisis estadístico es quien lo dirá, es el que determinará si esa diferencia entre 7 y 22 es una diferencia estadísticamente SIGNIFICATIVA.

Para empezar el análisis vamos a suponer, vamos a partir de la suposición, de que los dos métodos, los dos tratamientos, tienen la misma eficacia. Por lo tanto, elaboraremos un mundo ficticio donde los dos métodos que estamos comparando fueran, en realidad, idénticos.

Si los dos métodos fueran idénticos, que dieran el mismo número de problemas, el mismo número de situaciones de hipoglucemia, esperaríamos una probabilidad de hipoglucemia, durante una noche, del 26,8%, porque tenemos, en un método, un 12,9% de hipoglucemias y, en el otro, un 40,7%. El 26,8% es el promedio de estos dos porcentajes. Por lo tanto, este mundo ficticio que construimos lo hacemos adoptando un valor que, en global, refleja la realidad. En lo que hemos visto, en el estudio, en total, se produce un 26,8% de hipoglucemias (si juntamos las de un método y las del otro).

Vamos a hacer una simulación, vamos a construir experimentos posibles. Esto actualmente no es nada extraño. Vivimos rodeados de simulación: de una carrera de motos, de un partido de fútbol, etc. Esto que nos proponemos hacer, ahora, es posible gracias a la informática. Generaremos experimentos posibles pero bajo el supuesto de que los dos métodos tienen el mismo porcentaje de problemas, bajo el supuesto de esta ficción que hemos creado. Generaremos 100.000 experimentos equivalentes al del estudio, pero bajo el supuesto de que los dos métodos son igual de eficaces; o sea, con una probabilidad de hipoglucemia, en ambos métodos, del 26,8%.

Haciendo esto estaremos viendo qué variaciones posibles veríamos en experimentos donde fuera cierto que los dos métodos son iguales. De esta forma podremos situar nuestro experimento real, que sólo tenemos uno, dentro de este inmenso conjunto de experimentos simulados bajo el supuesto de igualdad. Será ésta la forma de evaluar la posición relativa de lo que vemos en el conjunto de lo que deberíamos ver si fuera cierto que los dos métodos son iguales.

Si hacemos estos 100.000 experimentos obtendremos parejas de valores como, por ejemplo: (15, 17), (14, 15), (17, 13), (16, 16), etc, que serán valores posibles a ver de hipoglucemias entre 54 pacientes en cada uno de los dos métodos, pero, siempre, bajo el supuesto que la probabilidad de hipoglucemia es la misma en cada uno de los dos sistemas: 26,8%.

En el estudio real la pareja de valores que hemos obtenido era (7, 22). Una diferencia de 15. Vamos a restar nosotros las 100.000 parejas de valores del número de hipoglucemias simuladas con un tratamiento y con el otro. Los valores de esas 100.000 resta que obtenemos son los presentados en el siguiente gráfico:

IMG_7199

Como puede verse lo habitual, lo más frecuente, es que la diferencia sea pequeña. Diferencias de 0, 1, -1, 2, -2, 3, -3, 4 y -4 son las más frecuentes. Conforme buscamos restas mayores vamos viendo que la frecuencia va decreciendo. Pero lo trascendente aquí es ver que la diferencia de 15, que es justo la diferencia entre 22 y 7 que nosotros vemos en el estudio, es extraordinariamente improbable. Aparece en poquísimas ocasiones. Esto es lo que hace dudar de que lo que vemos sea algo procedente de dos métodos equivalentes. Ante esta poca probabilidad es razonable pensar que la diferencia observada obedezca a una diferencia real. Que si lo lleváramos a millones y millones de personas, no sólo a 54 personas, acabaríamos viendo un resultado equivalente al que estamos viendo en este estudio.

Esto es como cuando decimos que un partido de baloncesto ya está ganado cuando, faltando 1 minuto, nuestro equipo gana de 10. La probabilidad de perder es lo suficientemente baja como para pensar que este partido ya está ganado. Por eso hablamos de un resultado SIGNIFICATIVO, porque es muy poco probable ver lo que estamos viendo en el caso de que los grupos comparados realmente se comportaran poblacionalmente de forma equivalente y, muestralmente, viéramos lo que estamos viendo.

Veamos el segundo caso, el del Clostridium difficile. Cojamos de las cuatro situaciones experimentadas los datos de las dos situaciones descritas en el centro de la tabla: el caso de tratamiento con infusión que tiene un 93,8% de éxito y el de la vancomicina, que tiene un 30,8% de éxito. Se trata ahora de simular experimentos de los que supusiésemos que la probabilidad de éxito es la misma entre entre ellos. Para ello podemos pensar en un valor promedio de los dos vistos: un promedio entre 93,8 y 30,8; o sea, 62,3%.

Podemos ahora simular 100.000 experimentos equivalentes pero bajo el supuesto que sean iguales las probabilidades de éxito mediante los dos procedimientos. Generar, por lo tanto, parejas de valores basados en muestras de tamaño 16 y 13 cada experimento con una probabilidad de éxito del 62,3%. Así tendríamos parejas de valores como: (10, 7), (11, 6), (9, 7), etc. Ahora las 100.000 parejas las transformamos a porcentajes de éxito de porcentaje, relativo siempre a los 16 y 13 de tamaño muestral de cada uno de los dos experimentos: el primero siempre respecto a 16 y el segundo respecto a 13. Así tendríamos, en los casos ejemplificados antes: (62.5, 53.8), (68.7, 46.1), (56.2, 53.8), etc. Si ahora hacemos las 100.000 restas de estas parejas de porcentajes tendremos el siguiente histograma:

IMG_7213

Como puede apreciarse, bajo el supuesto de que los dos métodos tengan la misma probabilidad de éxito los valores de las restas obtenidas al azar se sitúan mayoritariamente entre -40 y 40. Luego, los valores observados: (93.8, 30.8) que tienen una resta de 63 se trata de un valor muy extraño, muy poco probable verlo. Por lo tanto, debemos decantarnos por pensar que realmente no deben ser iguales SIGNIFICATIVAMENTE las probabilidades de éxito de estos dos tratamientos, porque de serlo deberíamos, en un experimento, ver mayor proximidad.

De nuevo esto es como cuando en un partido de baloncesto, en el que falta 1 minuto para acabar y nuestro equipo gana de 10 puntos, decimos que el partido está ganado. La probabilidad de perder es lo suficientemente baja como para pensar que el partido está ganado.

Por eso hablamos de que estamos ante un resultado SIGNIFICATIVO, porque es muy poco probable ver lo que estamos viendo y que sea cierto que los dos tratamientos sean iguales.

Puede parecer sorprendente pero lo cierto es que la Estadística y todas las Ciencias se basan, se apoyan, en análisis estadísticos como estos que acabamos de ver. La Estadística elabora y aplica métodos para diagnosticar lo SIGNIFICATIVO y todos ellos tienen como principio básico estas ideas de hemos intentado explicar aquí.

Solución Situación 44

1c:

Si se calcula la V de Cramer, resulta ser, efectivamente, 0.6.

La «a» es incorrecta. La correlación de Pearson no puede usarse para variables cualitativas.

La «b» también es incorrecta. La V de Cramer no puede dar valores negativos.

La «d» es también incorrecta. Estos datos no son de independencia de las variables. Todo lo contrario, parece haber una clara relación, una clara asociación, entre el sexo y estos dos tipos de estudios.

2c:

La «c» es la incorrecta. La ji-cuadrado es una técnica para valorar la relación entre variables cualitativas, no cuantitativas. Y nos dicen que para evaluar la significación de una correlación de Pearson realizamos una ji-cuadrado. Esto no es cierto.

La «a» es cierta. El p-valor es el valor que proporciona la significación de la correlación de Pearson.

También es cierta la «b». Tenemos una correlación de elevada magnitud pero no significativa. Lo que indica que tenemos una tamaño muestral pequeño.

La «d» también es cierta. Tenemos una V de Cramer de elevada magnitud (0.9). Recordemos que va del 0 al 1. Además, ciertamente, es significativa. El p-valor es menor que 0.05. En este caso se suele dar el p-valor de la ji-cuadrado calculada a la tabla de contingencias.

3c:

La «a» es cierta. Tenemos dos únicas variables. Aquí sólo cabe una Regresión simple.

La «b» también es cierta. Como nos dicen que la relación es lineal la Regresión que haremos será una Regresión lineal simple.

La «d» también es cierta. Si la correlación es positiva la pendiente de la recta de regresión será positiva. Y si la correlación es negativa la pendiente de la recta será negativa.

La «c», sin embargo, es incorrecta. No puede darse contradicción entre la significación de la correlación y de la pendiente. Si una es significativa la otra también. Si una no lo es la otra tampoco. Van de la mano. Es lógico que sea así. Sólo tiene sentido hacer una regresión si hay correlación significativa.

4d:

La «a» no es cierta. Siempre hay un elemento de imprecisión en una regresión.

La «b» tampoco es correcta. Lo que se le suma a la predicción son valores positivos o negativos, dependiendo de cada caso, de cada observación.

La «c» tampoco es correcta. Ni mucho menos la predicción dará eso necesariamente.

La correcta es ahora la «d». Las imprecisiones serán valores que girarán en torno a cero. Y esas imprecisiones serán, en valor absoluto, tanto más grandes cuanto menor sea la correlación entre esas variables.

5d:

La «a» es incorrecta. En absoluto tenemos una buena R2. Ésta tiene una valor del 36%. Esto es muy bajo. Es menor del 50%, que suele ser el límite aceptable.

La «b» es incorrecta.La correlación no es significativa, efectivamente, pero no por ser menor que 0.7, sino por tener un p-valor inferior a 0.05.

La «c» también es incorrecta. La utilidad de una correlación no la marca el p-valor. Lo marca la R2. Esta correlación es poco útil para predecir porque tiene bajo coeficiente de determinación: 36%.

La «d» es la correcta. La correlación es, efectivamente, significativa, el p-valor es inferior a 0.05, pero la capacidad predictiva es baja. Tiene una capacidad de determinación del 36%, que es bajo.

Situación 44: Examen (Temas 5-9)

1. Los datos de una muestra obtenidos se resumen de la siguiente forma: 200 mujeres en facultades de Medicina, 50 mujeres en escuelas de Ingeniería. 50 hombres en facultades de Medicina y 200 hombres en escuelas de Ingeniería. ¿Qué afirmación es la más coherente hacer, sobre la relación entre la variable sexo y la variable ser estudiante de Medicina o Ingeniería, con la información que tenemos?

a) La correlación de Pearson es 0.75 (p=0.07).

b) La V de Cramer es -0.6.

c) La V de Cramer es 0.6.

d) La V de Cramer es 0 porque no hay ningún tipo de asociación entre estas variables.

2. ¿Qué afirmación, entre las siguientes, no es cierta?

a) El p-valor es el elemento que le proporciona la significación a una correlación de Pearson.

b) r=0.89 (p>0.05) indica que se trata de una correlación de elevada magnitud pero no significativa.

c) Para valorar la significación de una correlación de Pearson es necesario aplicar un test de la ji-cuadrado.

d) V=0.90 (p<0.05) indica que estamos ante dos variables cualitativas con relación de elevada magnitud y significativa.

3. Si estamos construyendo una fórmula matemática que nos concrete la relación entre la variable “Cantidad total de lluvia anual” y la variable “Humedad relativa media anual” en una estación metereológica, ¿cuál de las siguientes afirmaciones no es cierta?

a) Si queremos construir tal función aplicaremos una Regresión simple.

b) Si la relación entre esas dos variables queda concretada por una recta aplicaremos una Regresión lineal simple.

c) Si la correlación de Pearson es significativa la pendiente de la Regresión lineal simple podría no ser significativamente distinta de cero.

d) Si la correlación de Pearson es positiva, la pendiente de la Regresión lineal simple también será positiva.

4. Si tenemos una Regresión lineal simple como la siguiente y=3x+5+e, podemos decir lo siguiente:

a) Si un individuo tiene el valor x=5 tendrá el valor y=20.

b) Si un individuo tiene el valor x=5 tendrá el valor y=20 más un valor que irá desde 0 hasta 1.

c) Si un individuo tiene el valor x=5 tendrá el valor y=15.

d) Si un individuo tiene el valor x=5 tendrá el valor y=20 más un valor que girará en torno a 0 y que será tanto mayor, en valor absoluto, como menor sea la correlación entre esas dos variables.

5. Si nos dicen que tenemos entre dos variables una r=0.60 (p<0.05) podemos decir:

a) Tenemos un buen coeficiente de determinación R2, por lo que podemos hacer un buen pronóstico de una variable a partir de la otra.

b) La correlación no es significativa porque es menor que 0.7.

c) Esta correlación es poco útil por ser el p-valor inferior a 0.05.

d) La correlación es significativa y la Res del 36%, por lo que al tratarse de un coeficiente de determinación bajo (inferior al 50%) no podemos hacer un buen pronóstico de una variable a partir del conocimiento de la otra.

Solución Situación 43

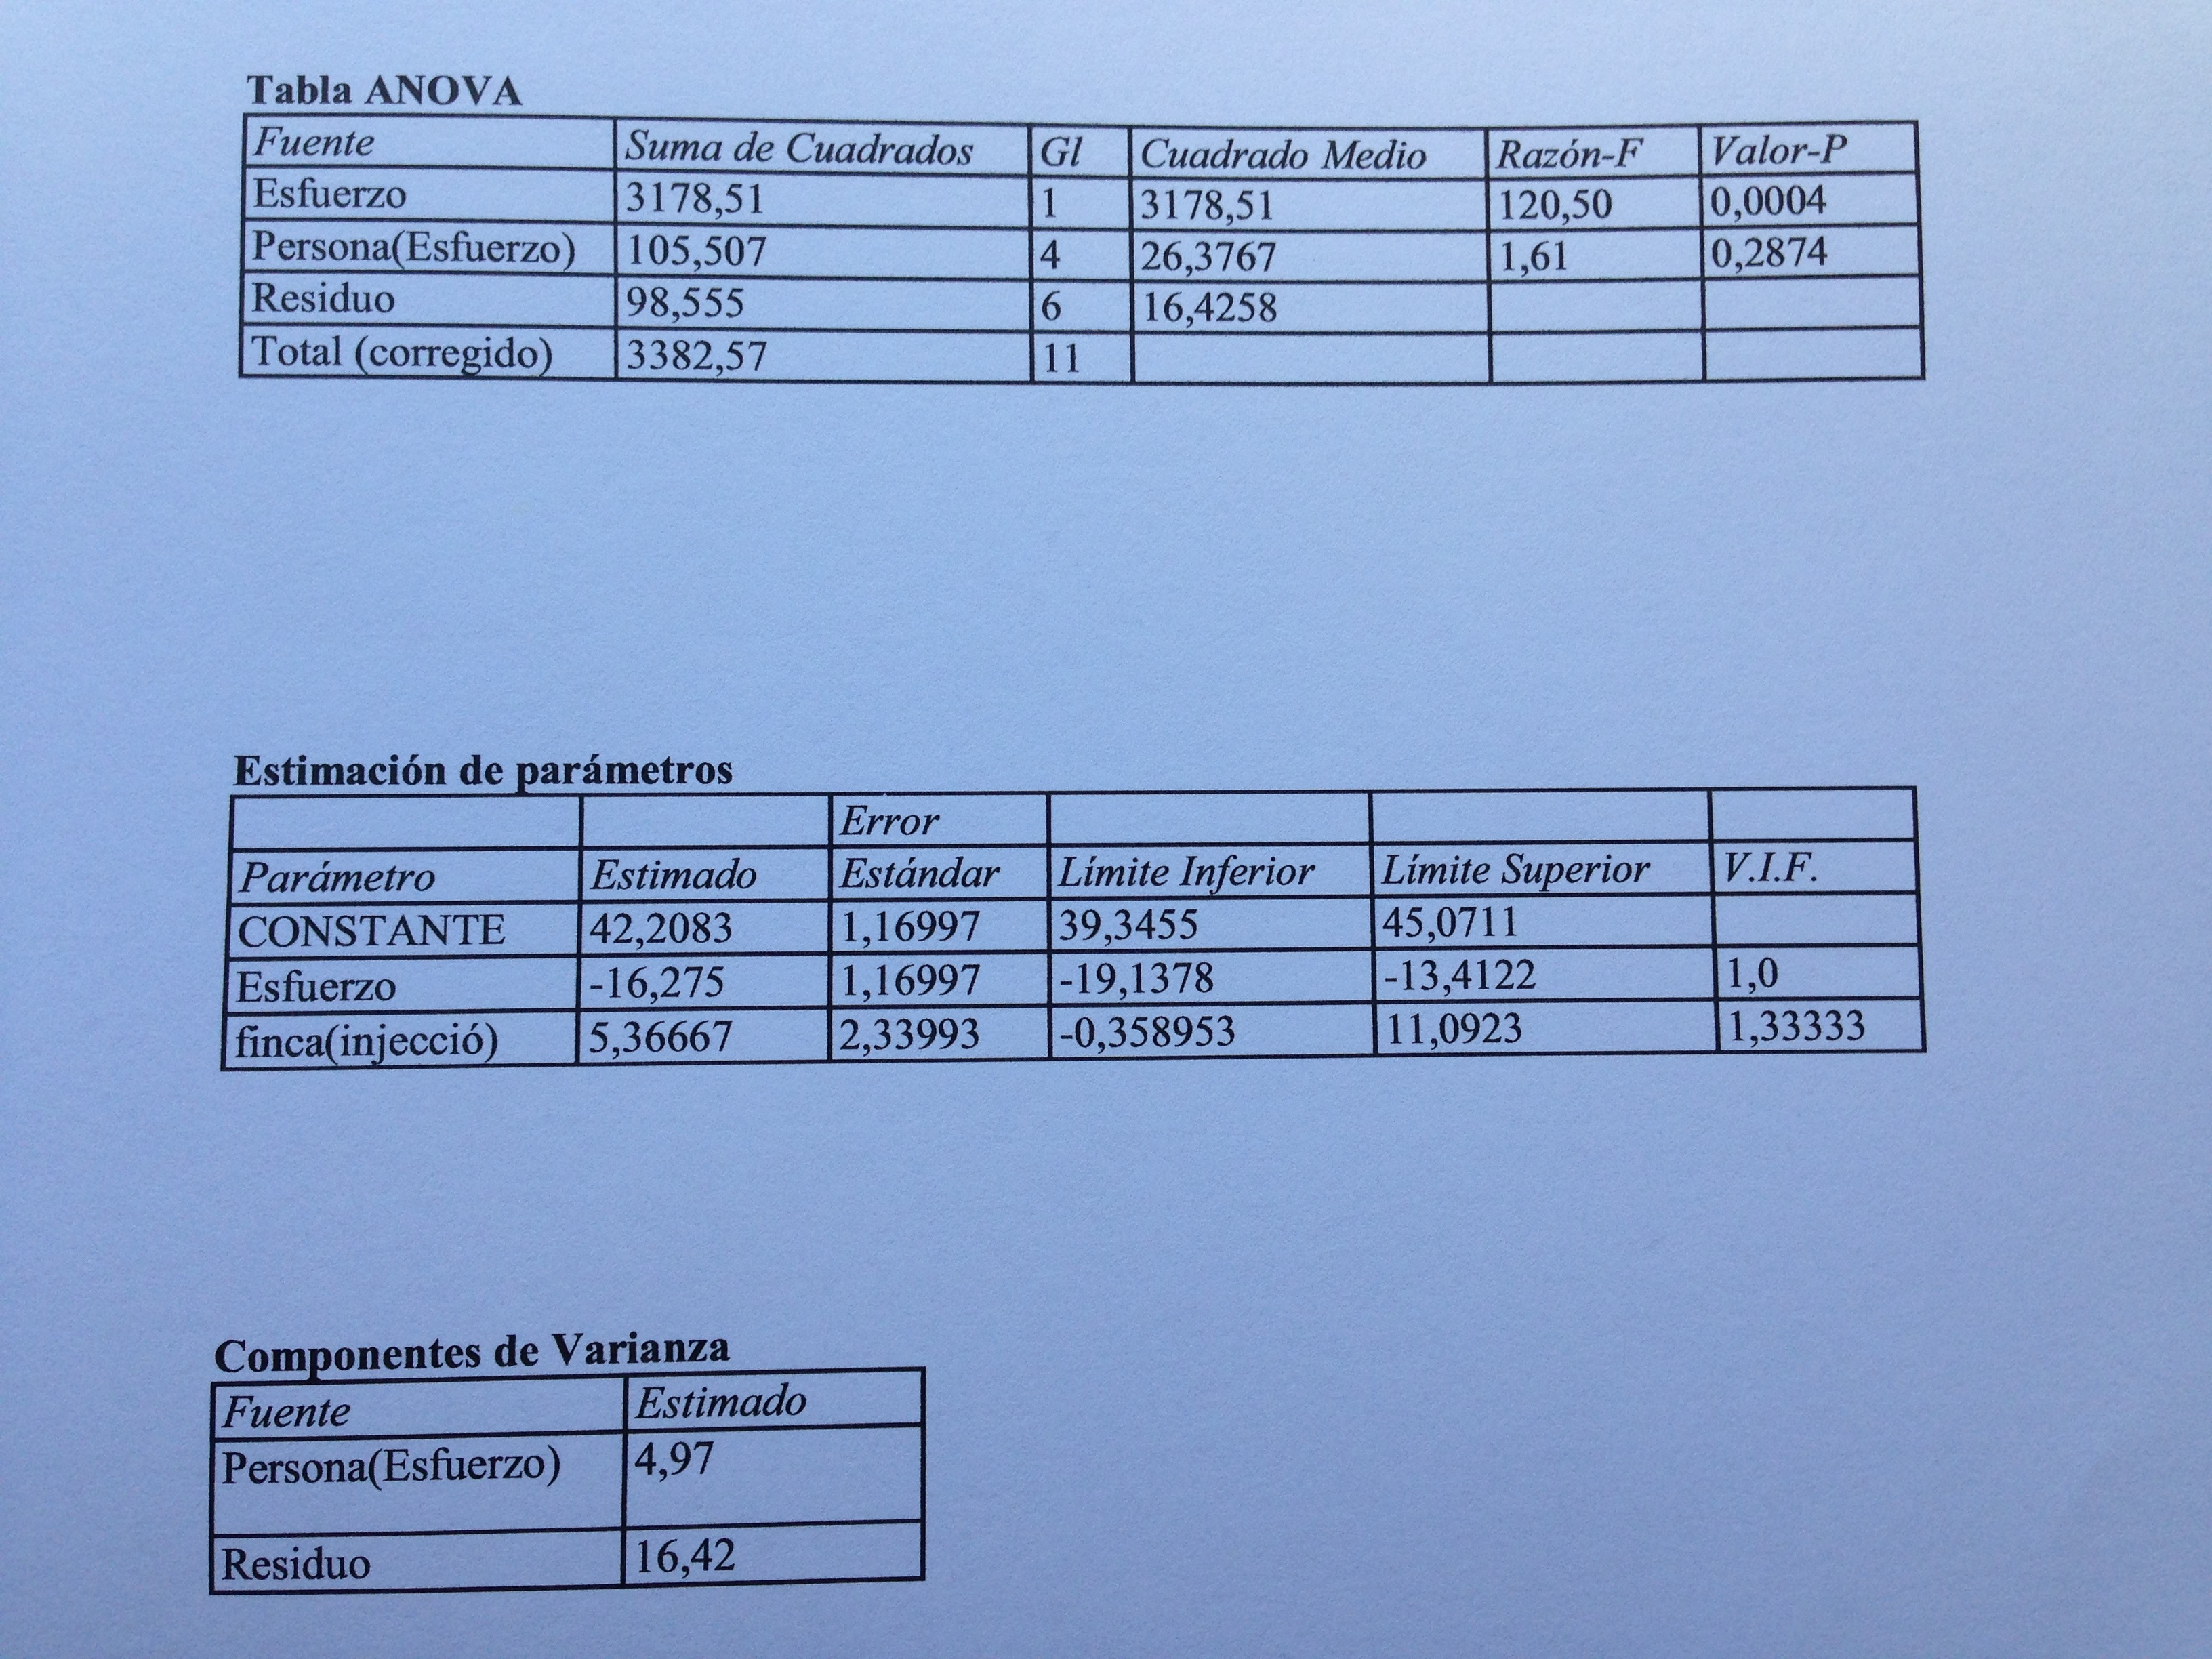
Se trata de un ANOVA de dos factores. Uno fijo a dos niveles (Esfuerzo No y SI) y otro aleatorio que es la persona. Observemos también que se trata de factores anidados. El factor Persona está anidado dentro del factor Esfuerzo. El modelo es, pues, un ANOVA de factores anidados a efectos mixtos.

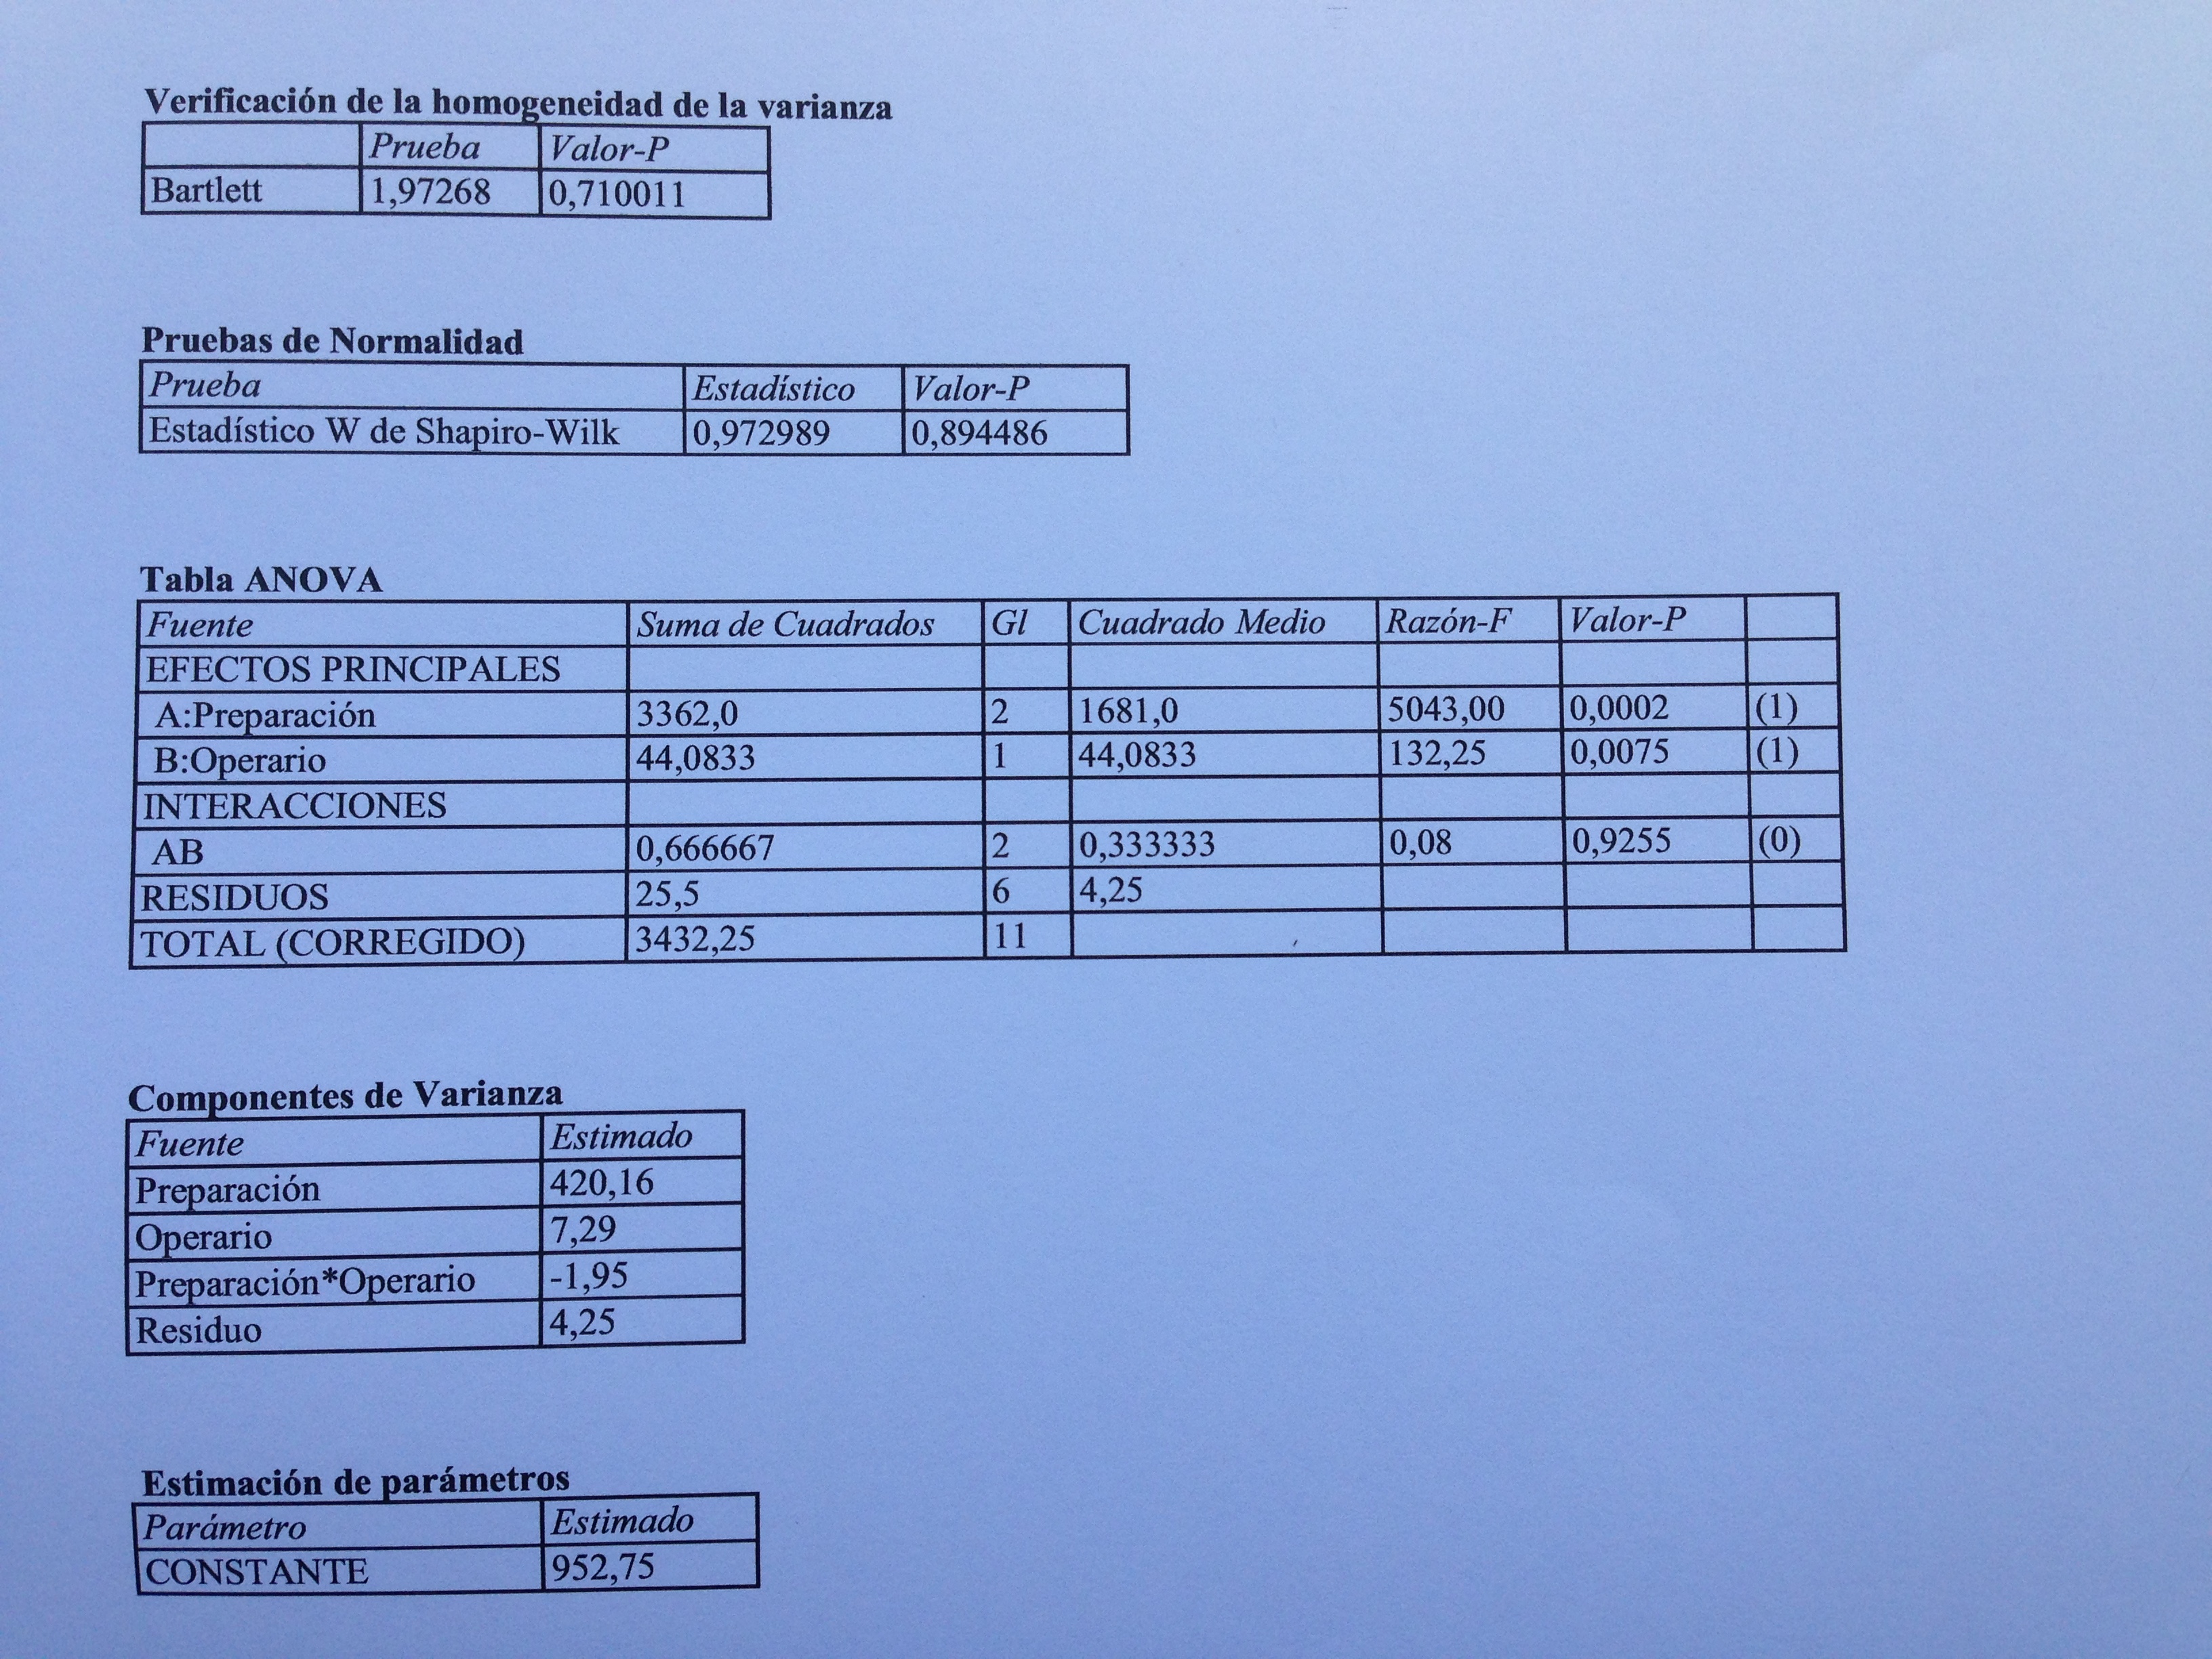
La tabla ANOVA y las estimaciones de los parámetros son los siguientes:

IMG_7177

Viendo estos datos, viendo la tabla ANOVA, podemos decir que en esta variable tiene valor significativamente distintos según se haya o no hecho un esfuerzo. Vemos que no depende de las personas. A pesar, podríamos decir, también de que el residuo es bastante elevado. Pensemos que hay ocasiones donde distintas medidas presentan valores bastante distintos. Esto nos podría hacer pensar que posiblemente no estemos bajo las condiciones necesarias para aplicar el ANOVA. No hemos aplicado el test de Barlett ni el de Shapiro-Wilk.

El cálculo de las componentes de la varianza sería, en este caso:

IMG_7178

Respecto a la pregunta que se hace al final: la probabilidad de que una persona de estas características sometida a este tipo de esfuerce dé un valor por encima de 59 una posibilidad poco fina es mirar la proporción que cumplen esto en la muestra: 4 de 6. Por lo tanto, una respuesta posible es decir que una probabilidad del 0.66 ó un 66.6%, aproximadamente. Pero es más fino hacerlo aprovechando la información obtenida y la propia modelización utilizada. Veamos que el grupo del esfuerzo tendría una media que sería sumar la media general (42.2083) con lo aportado por el esfuerzo SÍ (16.275): 42.2083+16.275=58.4833. La desviación varianza sería 16.42+4.97=21.39. Aquí es cuestionable si usar este 4.97 como estimación de las diferencias entre personas o tomarlo como 0, puesto que en el contraste de hipótesis no hemos rechazado la Hipótesis nula de que la varianza aportada por las personas es 0.

Por lo tanto, si tomamos la varianza como 21.39, deberíamos hacer la raíz cuadrada para obtener la desviación estándar. La raíz cuadrada de 21.39 es 4.62.

Por lo tanto, la respuesta a esta última pregunta es el área que hay a la derecha de 59 en una distribución normal de media 58.48 y de desviación estándar 4.62; o sea, en una N(58.48, 4.62). Esto se puede calcular mirando el área que hay en una distribución N(0, 1) a la derecha del valor que sale de la operación (59-58.48)/4.62; o sea, el área que hay a la derecha del valor 0.11 en una N(0, 1). El área buscada es 0.4562. Basta mirar en las tablas de esa distribución. Por lo tanto, la estimación sería de un 45.62%. Para ver cómo se hacen estos cálculos conviene ver el artículo dedicado a la distribución normal.

Situación 43: Problema de ANOVA

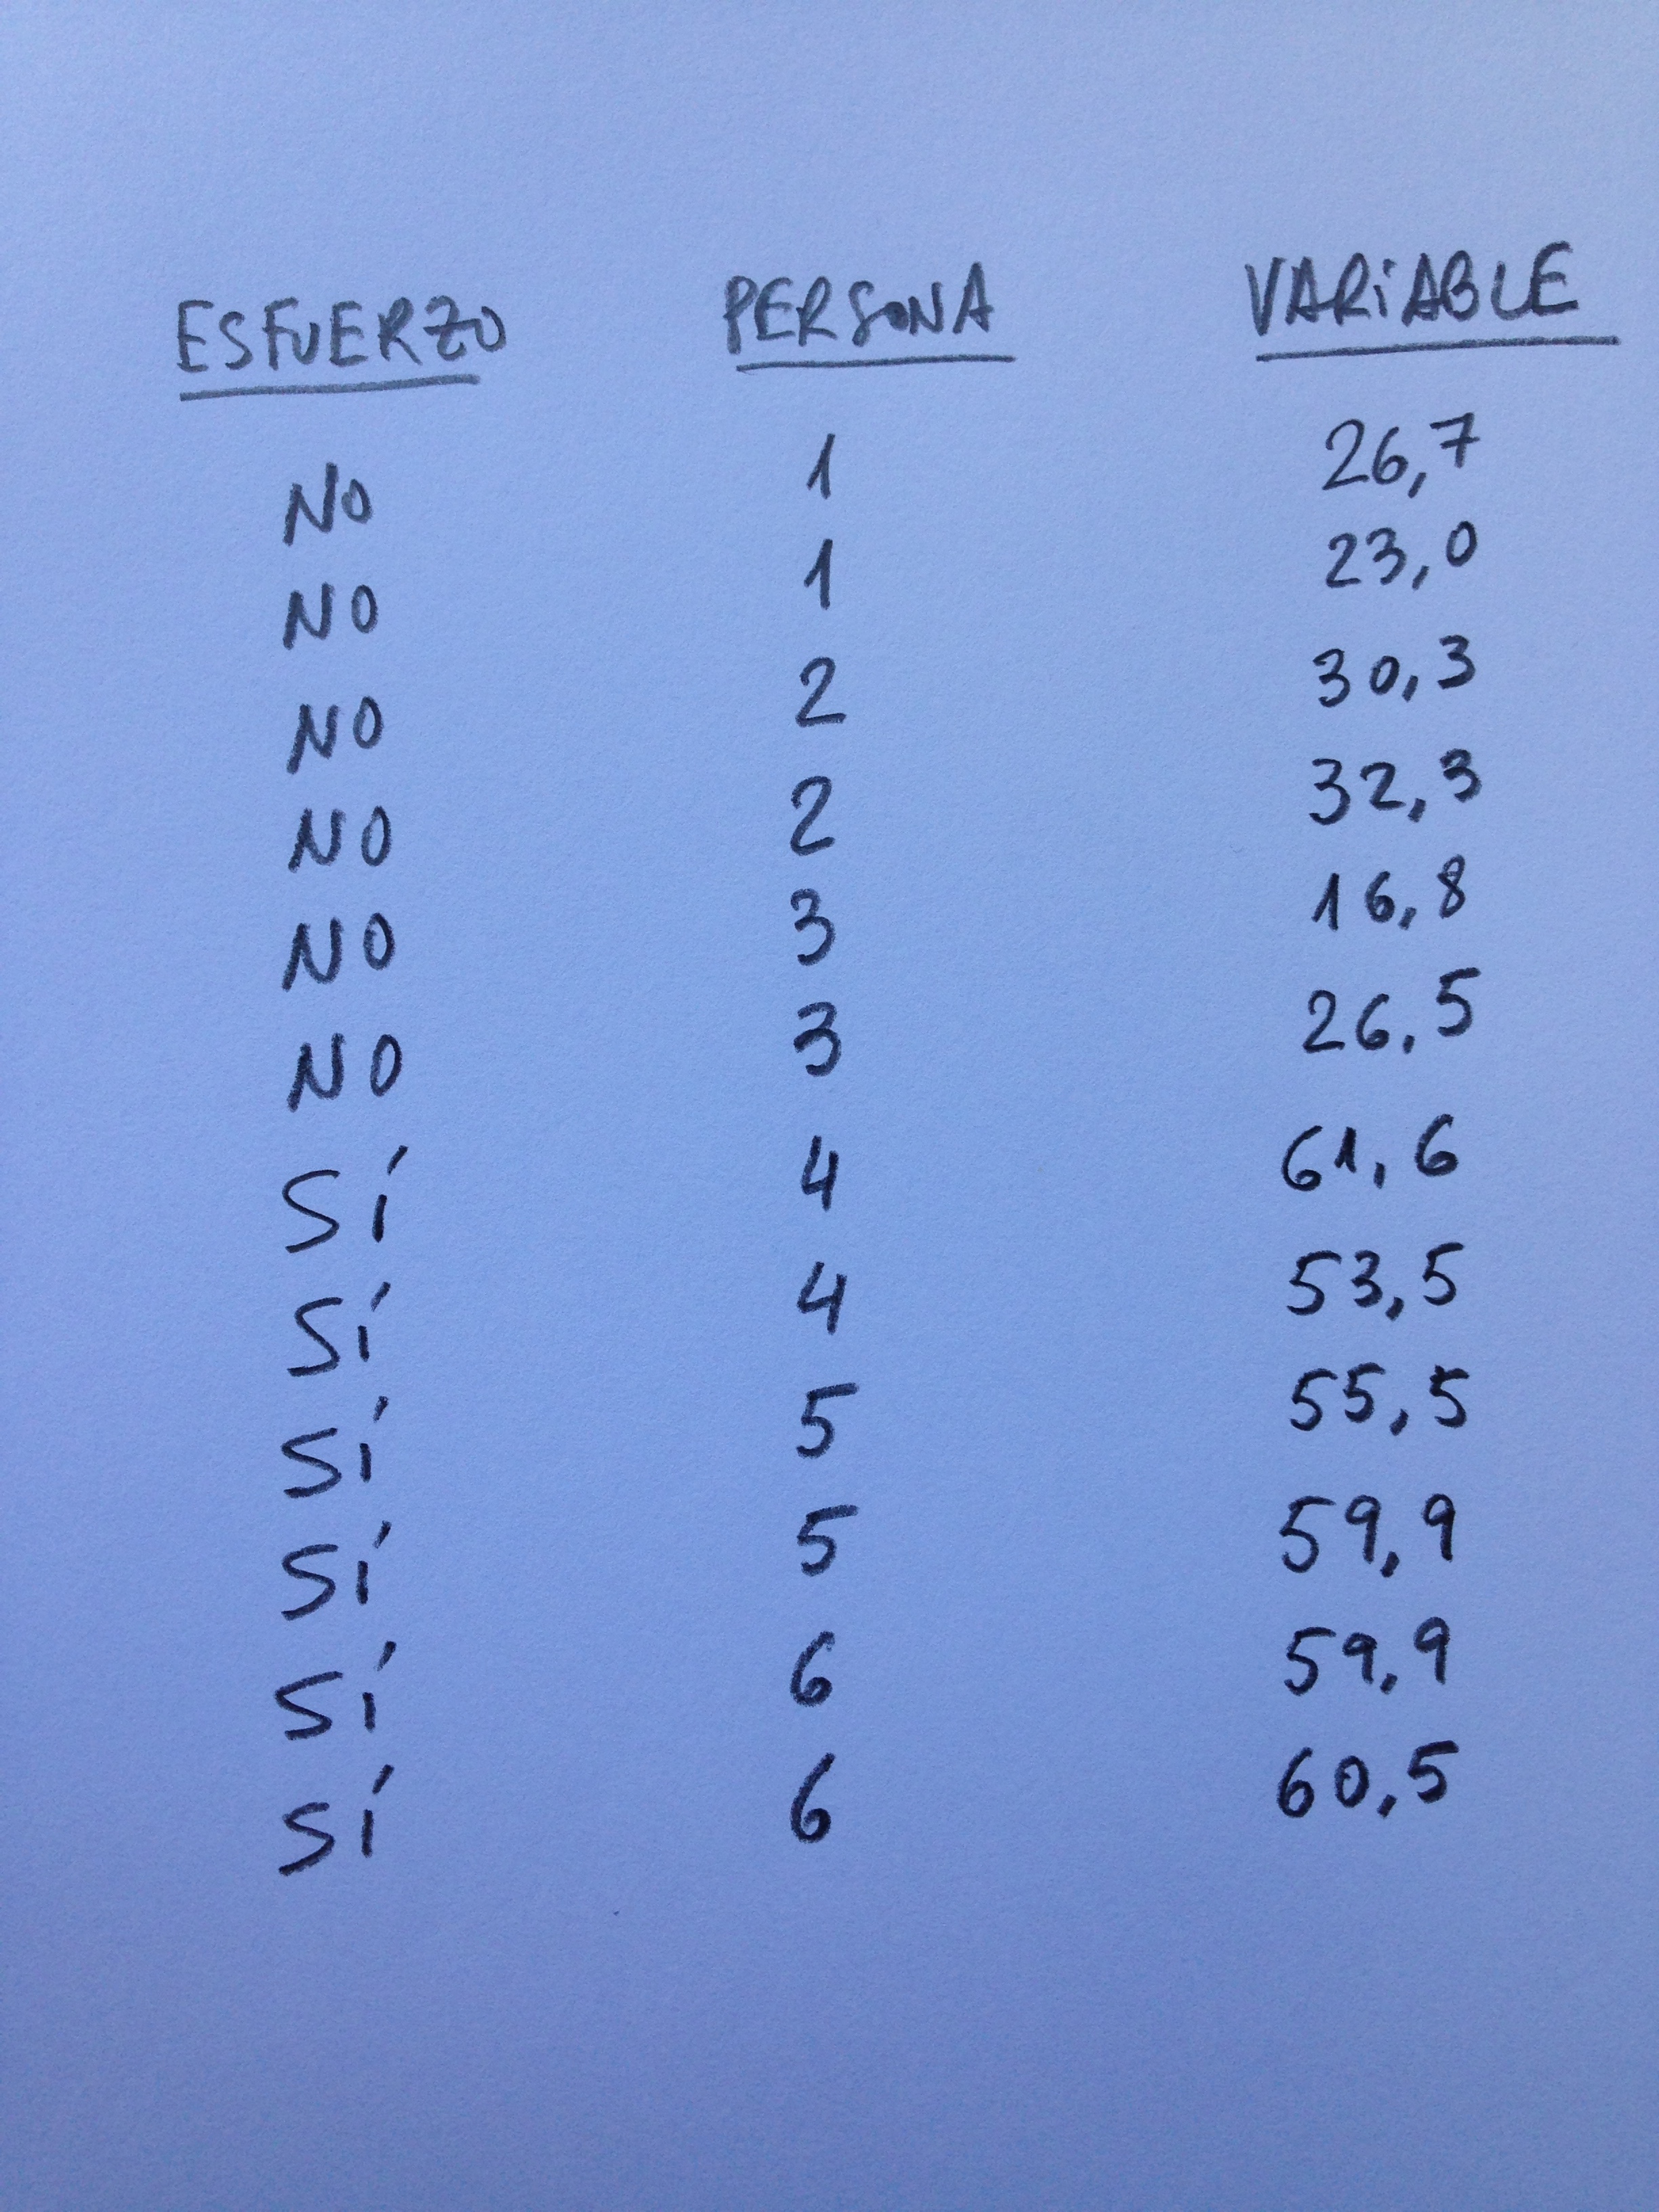
Se quiere evaluar cómo afecta a una variable sanguínea el nivel de ejercicio continuado durante una hora. Para ello se toman 6 varones muy similares en cuanto a edad e historia clínica. Se trata de 6 personas que en un análisis previo han dado valores muy similares de la variable que se quiere estudiar.

Después de toda una mañana de reposo a tres de esos participantes en el estudio se les ha medido esta variable y se ha analizado la variable dos veces en cada una de las muestras de sangre porque se quiere saber la dispersión residual de esta técnica analítica.

A los otros tres participantes en el estudio se les ha sometido a un ejercicio de una hora de duración en una bicicleta estática. Después se les ha tomando muestra de sangre y se ha realizado en cada una de ellas un análisis por duplicado de la variable estudiada.

Los resultados obtenidos son los siguientes:

IMG_7171

Resolver el diseño.

Y supongamos, también, que estuviéramos interesados en saber cuál es la probabilidad de que el valor de esta variable sea superior a 59, en un individuo de estas características, y después de haber hecho un esfuerzo del orden del estudiado en este experimento.

Solución Situación 42

La primera parte del problema es un caso de dos factores aleatorios cruzados. Ver el modelo ANOVA de dos factores a efectos aleatorios.

Si se comprueba la normalidad con el Test de Shapiro-Wilk y la homogeneidad de las varianzas con el Test de Barlett se comprueba que estamos bajo las condiciones exigidas para la aplicación de los contrastes de hipótesis asociados a un modelo ANOVA.

La tabla ANOVA con los cocientes de cuadrados medios adecuados y la estimación de los parámetros son los siguientes:

IMG_7172

Tanto el factor Preparación como el factor Operario son factores significativos. La interacción no lo es.

El cálculo de las componentes de la varianza será esencial a la hora de ver cuál es el elemento que introduce más variación. La interacción ya vemos que la variación que introduce no es significativa. La variación residual es 4.25. Ahora lo que hace falta ver es las otras dos. Por eso se estiman. El -1.95 de la interacción es un artefacto de la forma de estimación. En realidad, se considera 0. Veamos cómo se realiza, a partir de las esperanzas de los cuadrados medios, la estimación de estas componentes de la varianza:

IMG_7174

Como puede apreciarse la principal componente de la varianza es la aportada por la preparación. La forma en la que hacemos la preparación es realmente lo que hay que plantearse porque es lo que realmente introduce una variación enorme. Si queremos reducir la variabilidad debemos focalizar en el método seguido en las preparaciones.

Veamos, ahora, la segunda parte del problema. Ahora, al trabajar con 6 operarios que analizan dos a dos para preparación, el modelo para a ser de dos factores anidados. Ver el modelo ANOVA de dos factores anidados a efectos aleatorios.

La tabla ANOVA y las componentes de la varianza son, ahora:

IMG_7175

El factor significativo es, ahora, únicamente la Preparación. Operario ya no lo es. Podemos estimar las componentes de la varianza. Incluso la de Operario dentro de Preparación, aunque no sea significativa y seguimos viendo que la principal componentes de la varianza se la lleva la preparación, como antes.

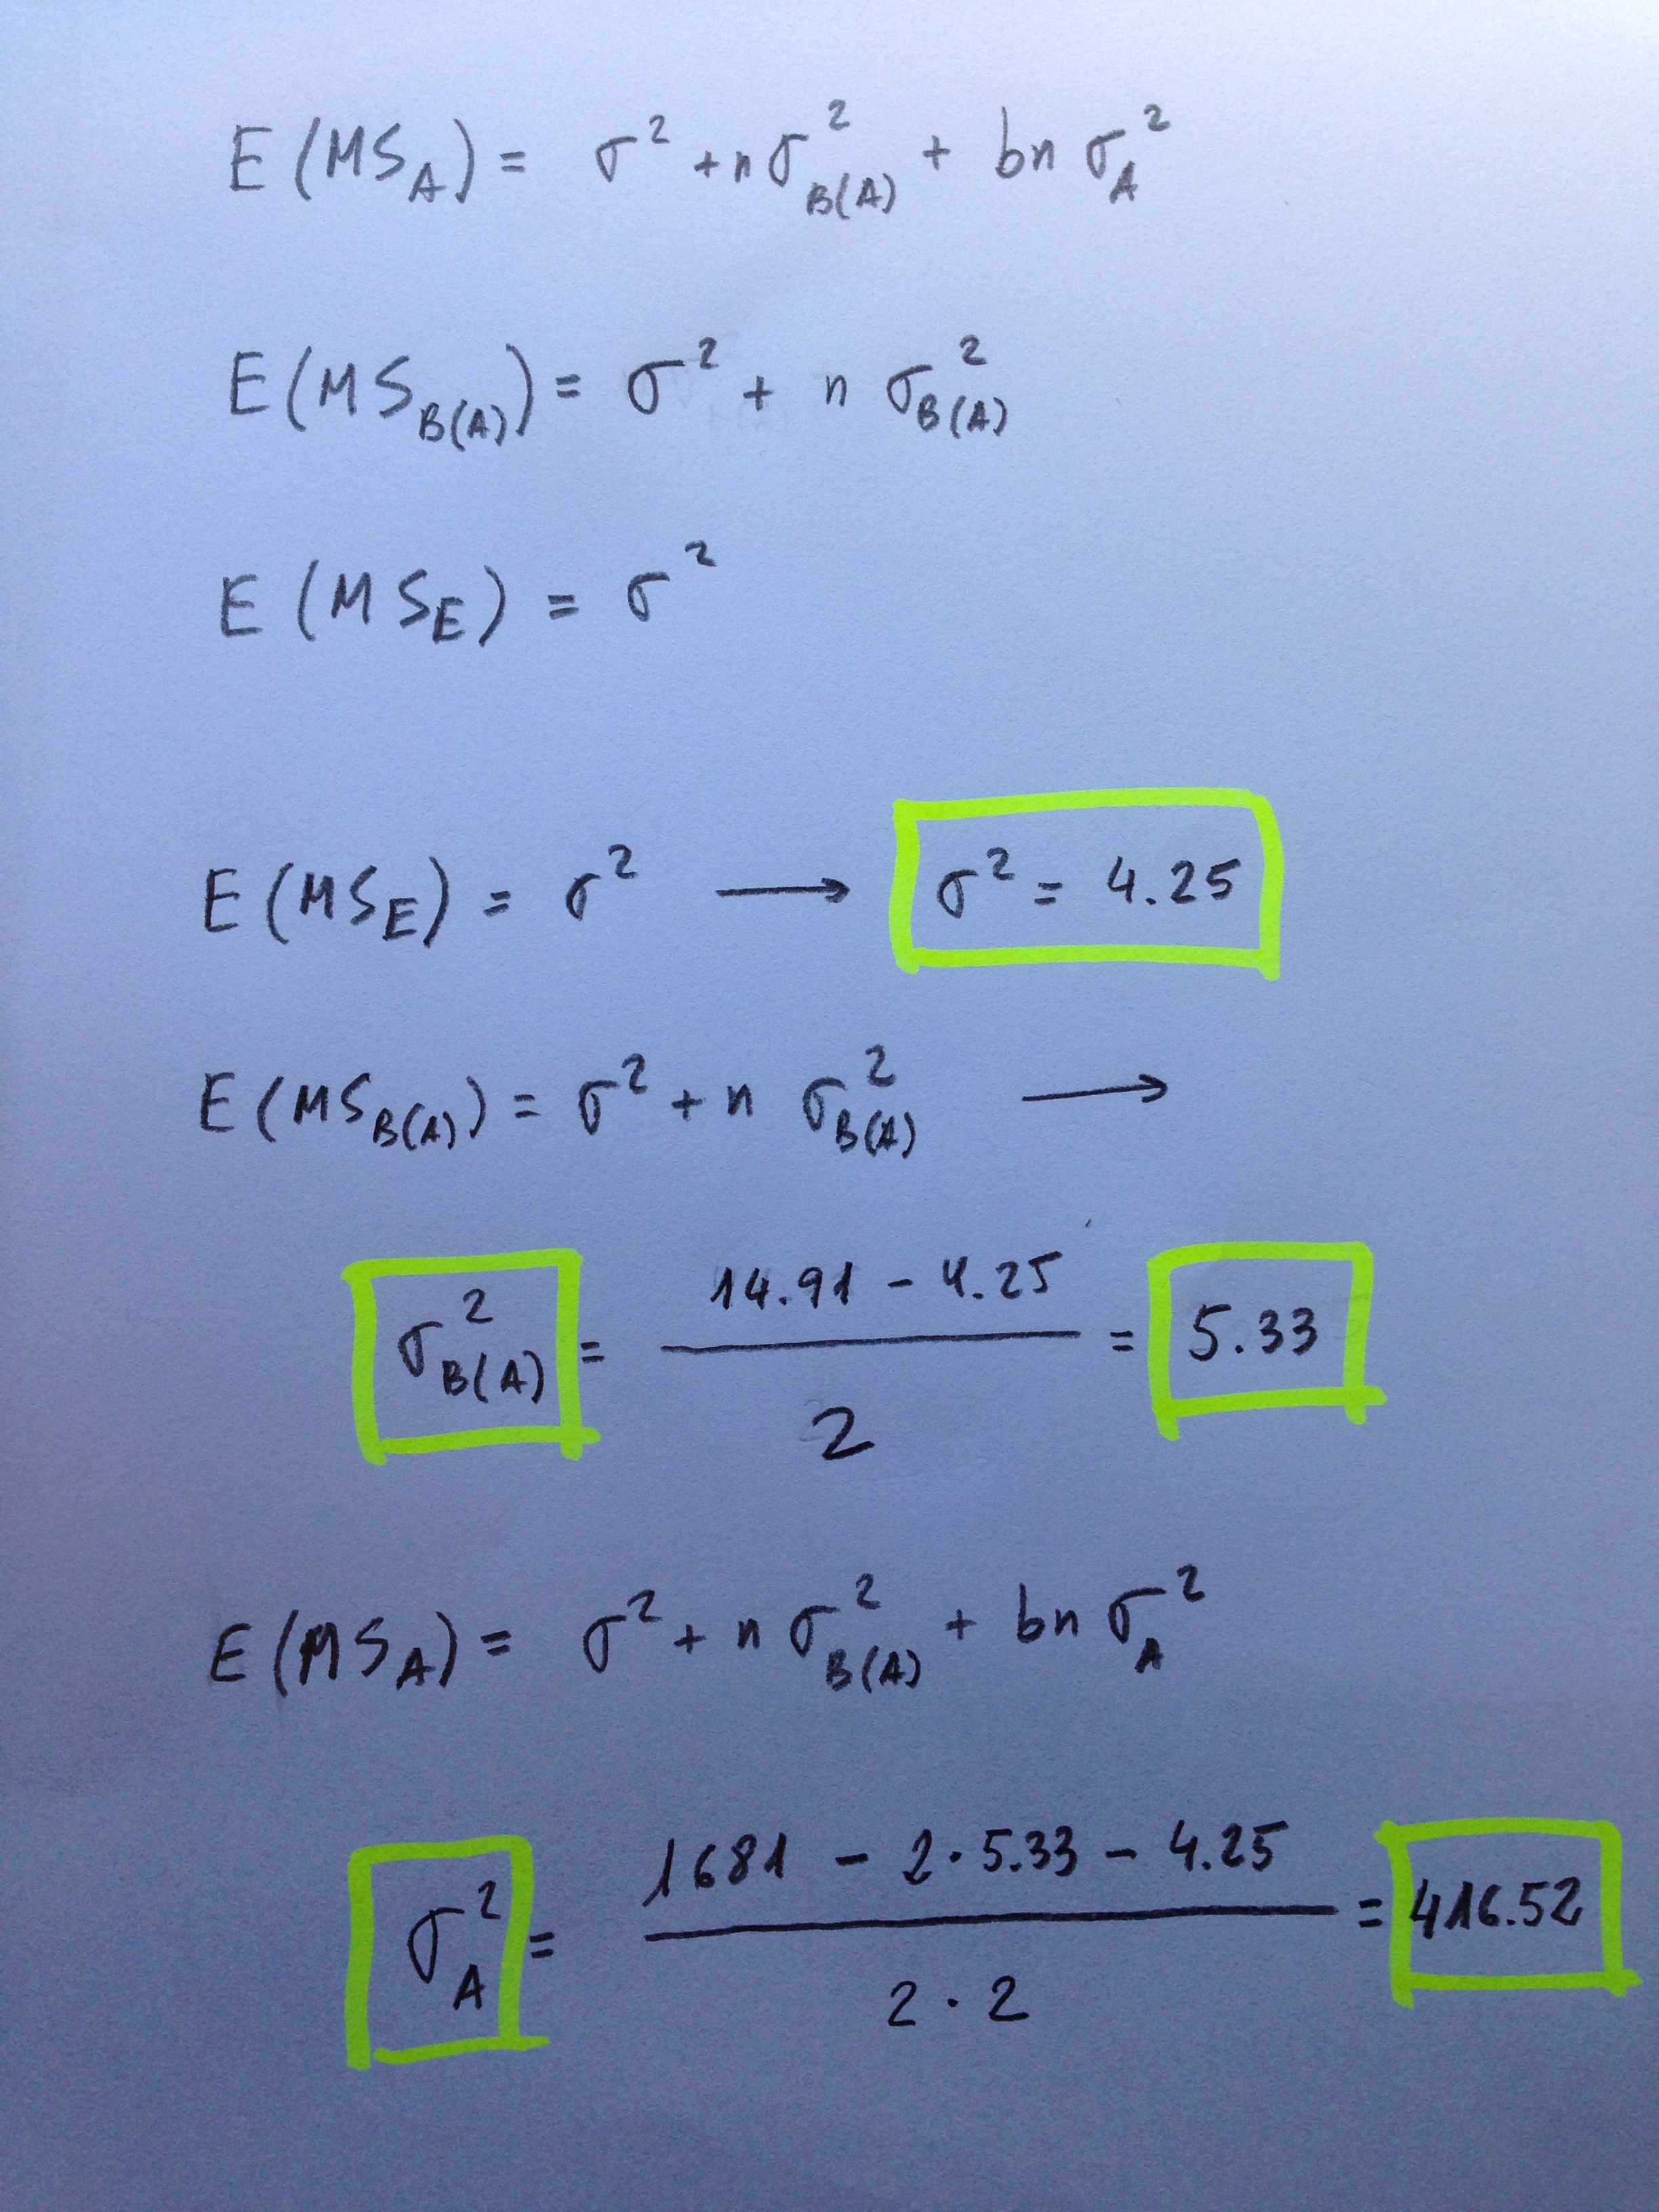
A continuación puede verse cómo se calculan estas estimaciones de las componentes de la varianza:

IMG_7176

Situación 42: Problema de ANOVA

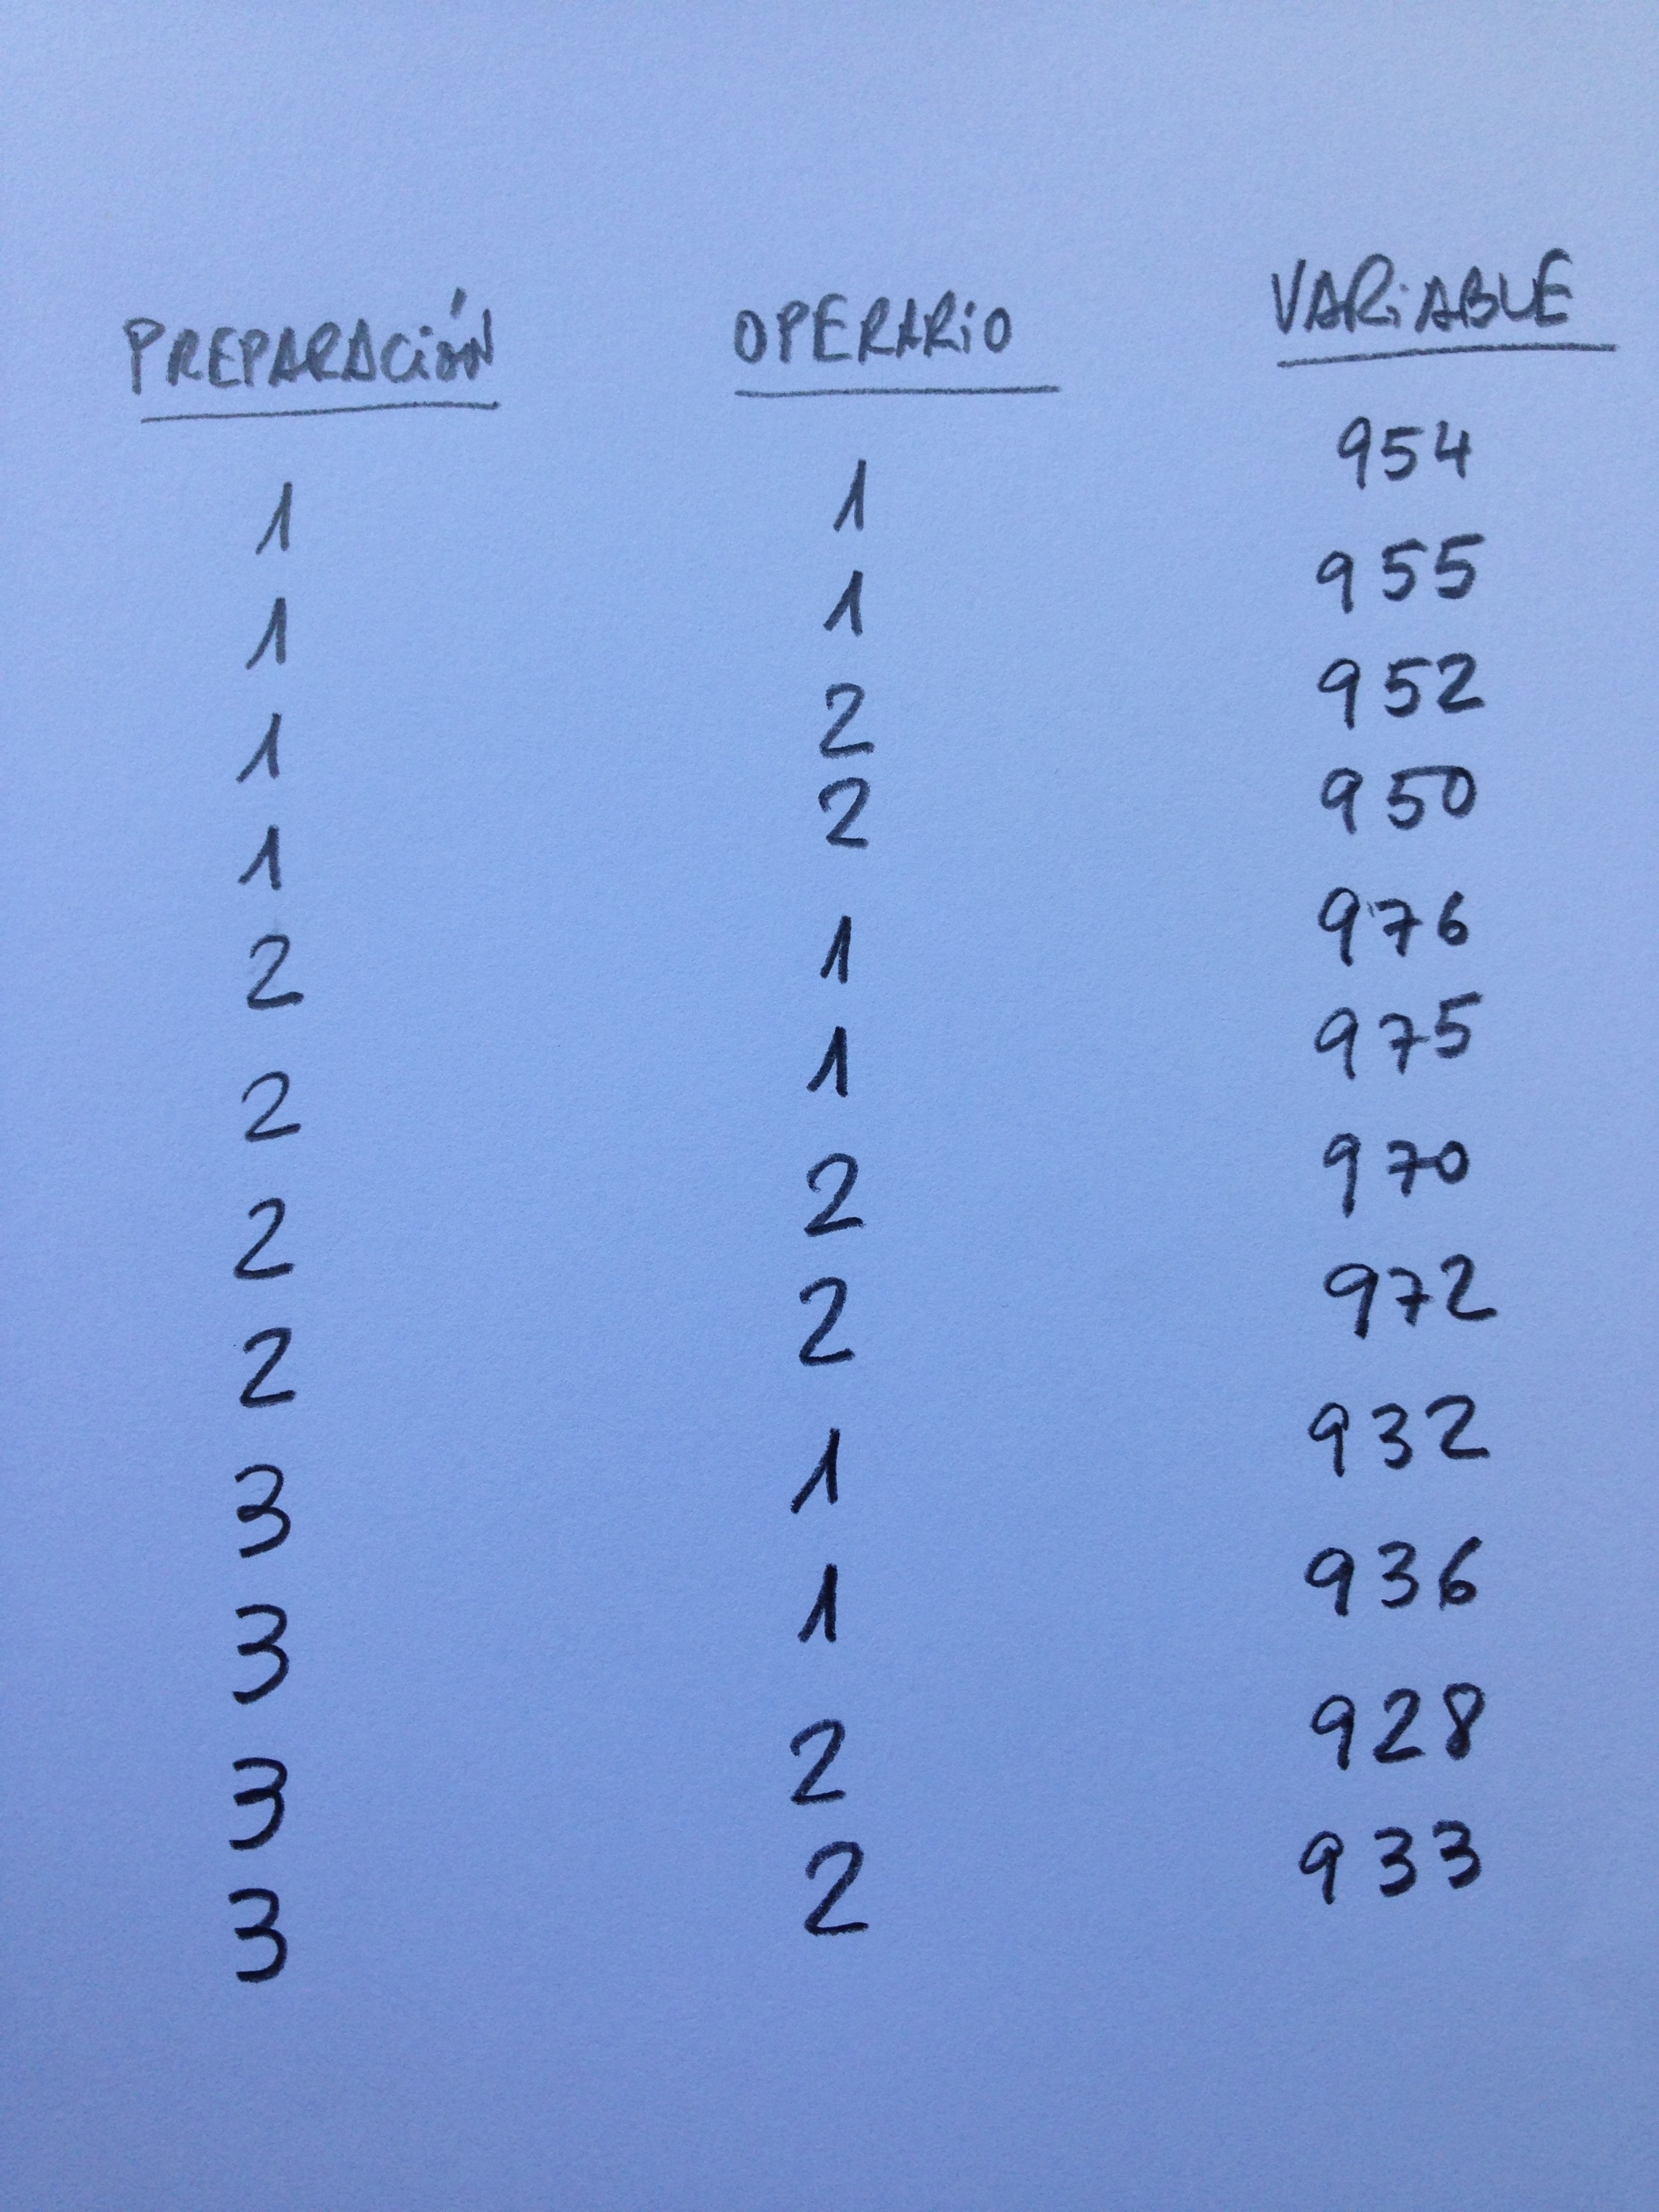
Se quiere evaluar la variabilidad introducida en una medida en base a la preparación de la muestra y en base al operario que acaba realizando la medida. Se quiere saber cuál es la contribución de cada uno de esos dos factores en la variabilidad final de los resultados. Para ello se elaboran tres preparaciones y se toman dos operarios al azar. Los resultados obtenidos son los siguientes:

IMG_7170

Resolver el diseño.

Supongamos ahora que el problema es el mismo pero ahora en lugar de tomar dos operarios, tomamos seis, pero dos de ellos evalúan el primer preparado, otros dos el segundo preparado y los dos últimos evalúan el tercer preparado.

Resolver el nuevo diseño.

Test de la Q de Cochran

El Test de la Q de Cochran es un test para comprobar la igualdad de varias muestras relacionadas en una variable dicotómica. Es un test equivalente al test de McNemar pero para más de dos poblaciones.

El contraste de hipótesis tiene como hipótesis nula la igualdad de proporciones.

El estadístico de test usado en este contraste de hipótesis es el siguiente:

 IMG_7167

Como puede apreciarse, para que el test funcione bien se necesita un determinado valor de tratamientos y de muestra.

Veamos dos casos de aplicación de este test.

La tabla de datos consta de cinco filas porque son cinco los individuos usados y de cuatro columnas, porque vamos a suponer que hemos ensayado cuatro tratamientos distintos a esos cinco individuos. En la tabla consta un 1 ó un 0 dependiendo si hay o no respuesta a la variable dicotómica que estamos estudiando.

Veamos, en primer lugar, un caso de no diferencias:

IMG_7168

En el siguiente caso, sí que hay diferencias entre los cuatro tratamientos:

IMG_7169

Observemos que en las condiciones de aplicación se pide que k sea mayor o igual a 4 (esto se cumple), pero también se pide que nk sea mayor o igual que 24 y en este ejemplo nk=20. Aquí la distribución ji-cuadrado supuesta es dudosa. Pero lo he hecho así para que sea más fácil entender los cálculos.

Test de Friedman

El Test de Friedman es un test para comprobar la igualdad de tratamientos en medidas repetidas. Es un test que no necesita de la normalidad de los datos. Es un test, pues, no paramétrico.

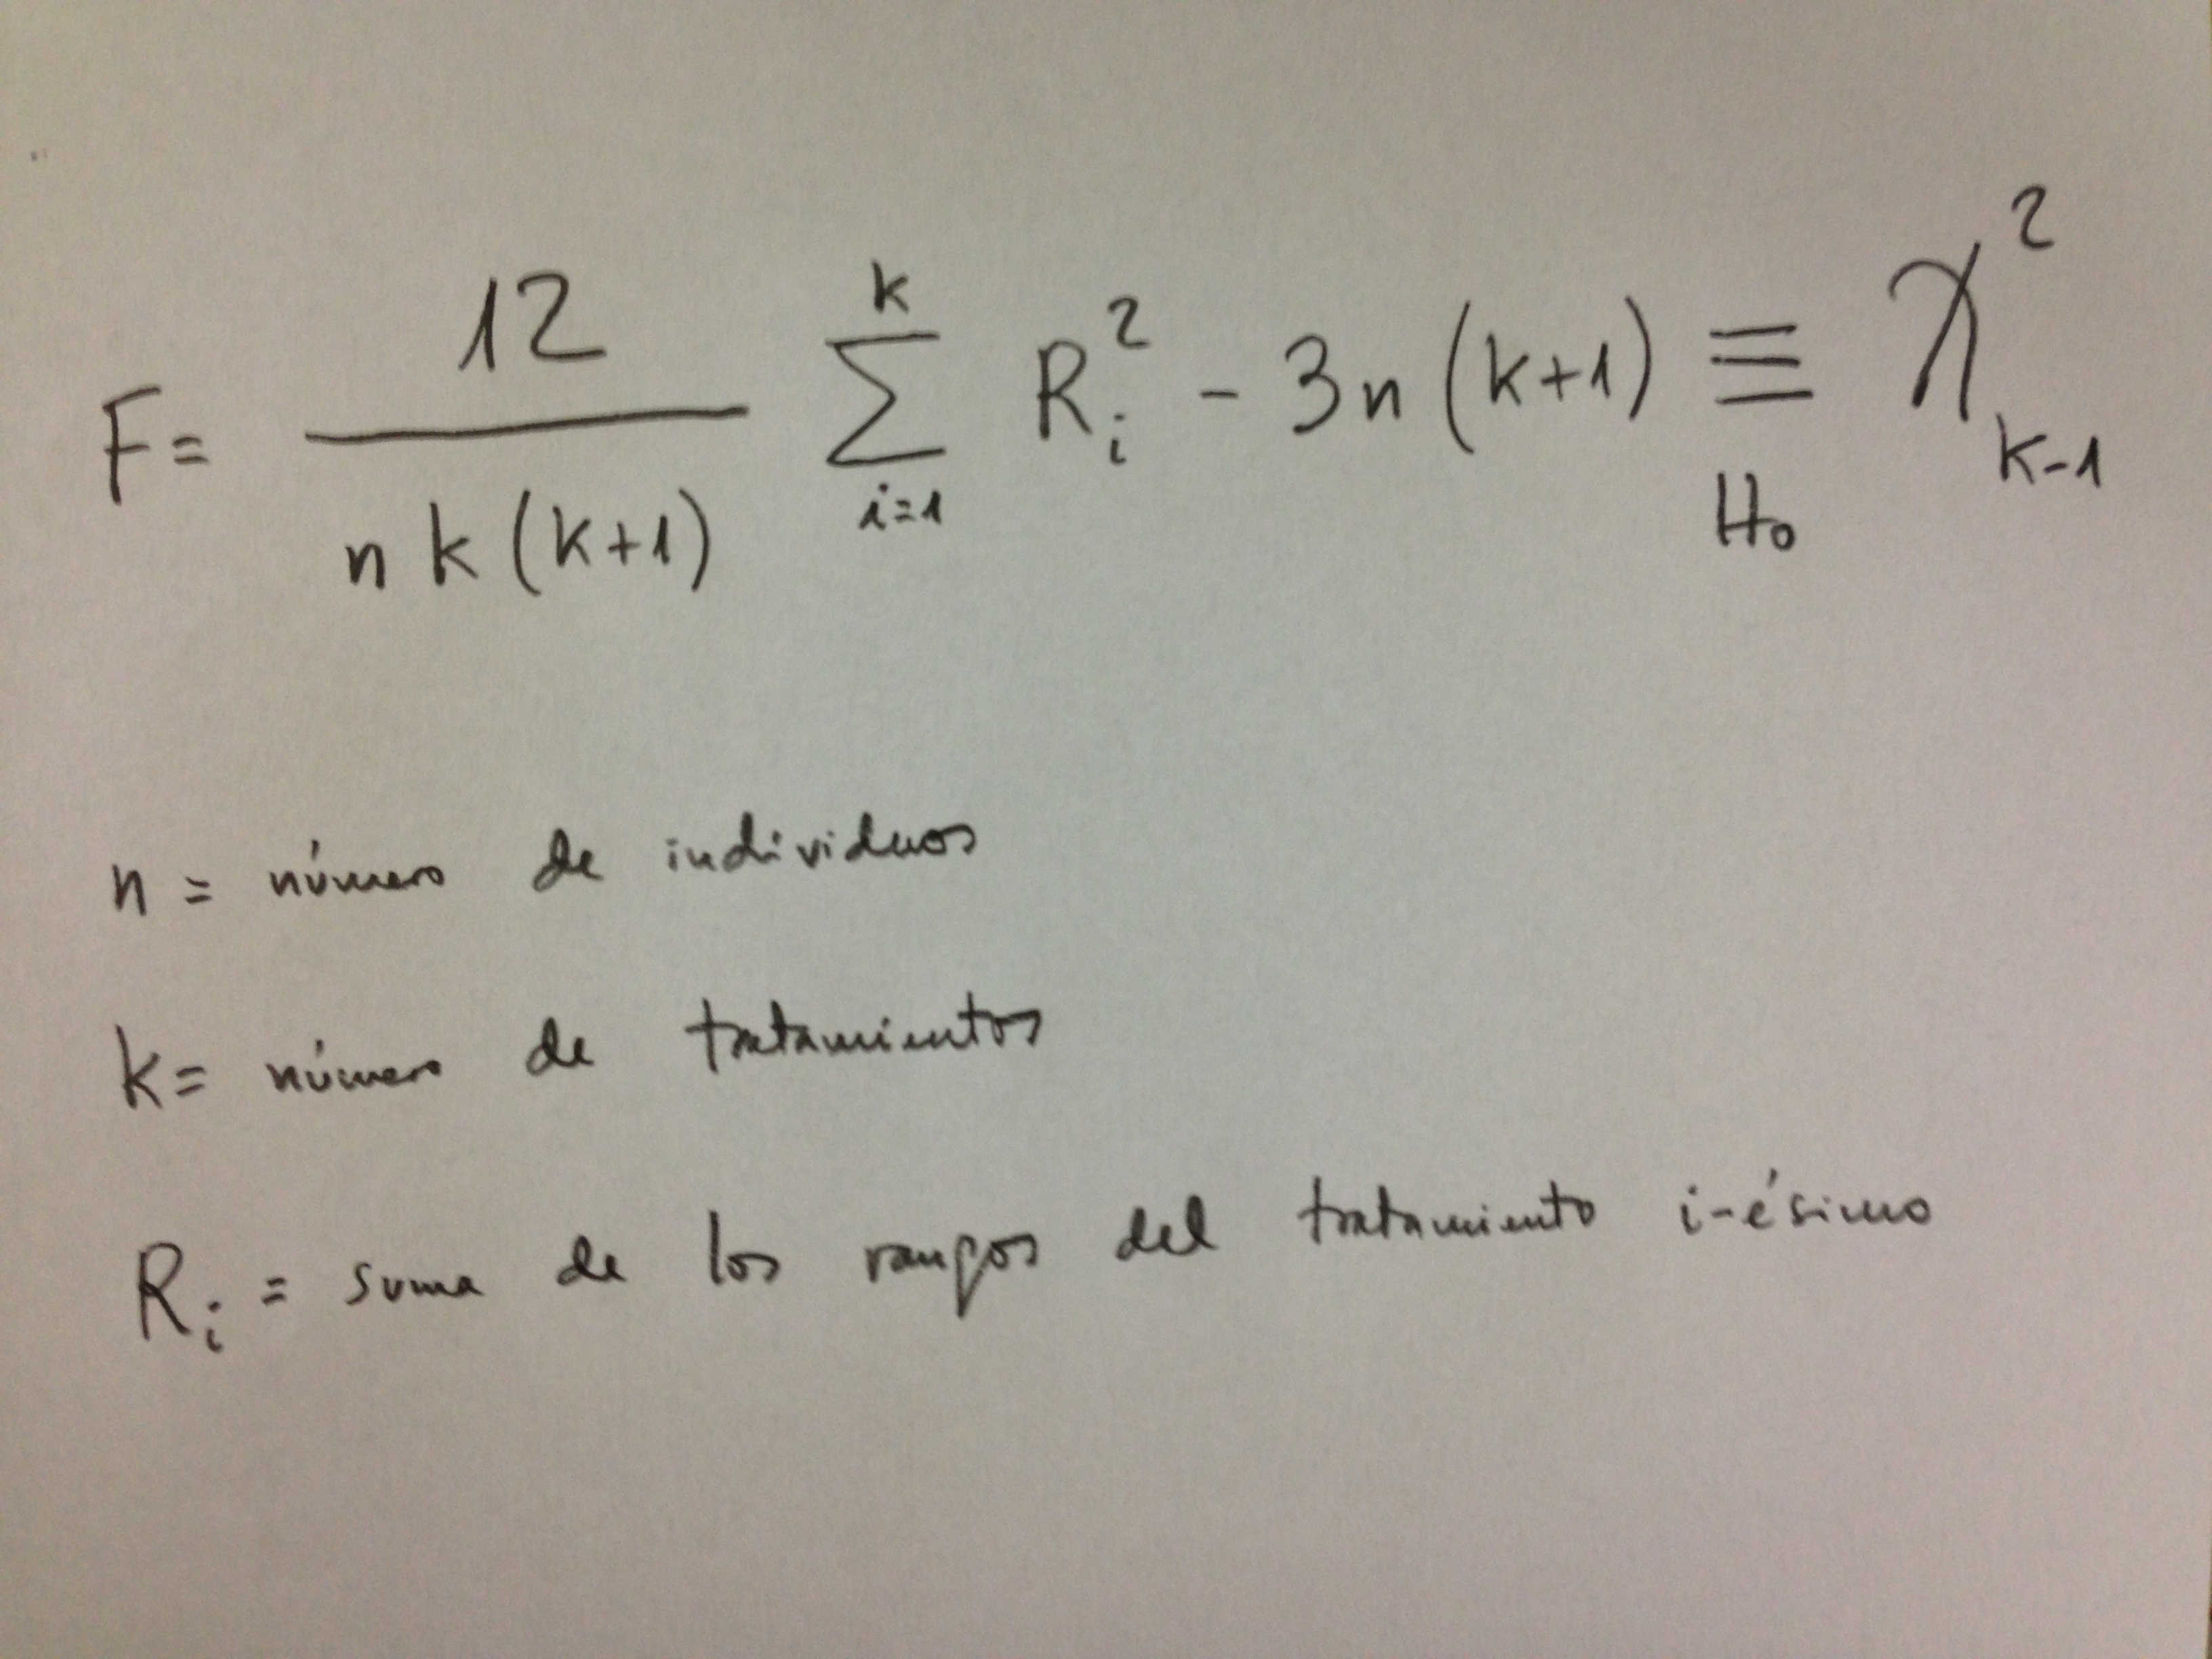
Supongamos que aplicamos a un grupo de n individuos k tratamientos diferentes, en distintos momentos. Y lo que queremos es contrastar la Hipótesis nula de igualdad entre esos tratamientos. Ahora la igualdad no será de medias, como en el ANOVA paramétrico, sino que será igualdad de medianas o de distribuciones.

El estadístico usado en este test de Fridman es el siguiente:

IMG_7166

Este test se usa,en ocasiones, para casos de dos factores cruzados donde no hay ajuste a las suposiciones habituales del ANOVA.