Archivo del Autor: estadisticallopis

El Box-Plot en Medicina

Hemos visto en el Tema 2: Estadística descriptiva, un excelente gráfico que resume en poco espacio una información muy valiosa. Pongo a continuación unos ejemplos de aplicación de este tipo de gráfico, en Medicina. Es muy importante familiarizarse con él porque proporciona una información descriptiva muy valiosa.

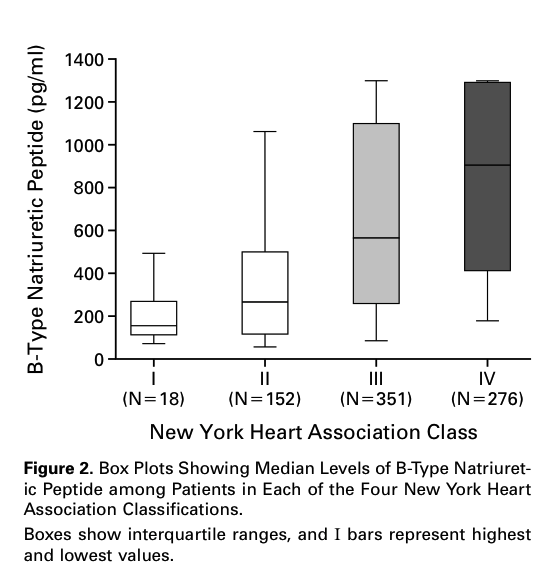
Veamos el gráfico siguiente donde se muestran cuatro Box-Plot, uno por cada tipo funcional de insuficiencia cardíaca, usando como variable analizada la concentración del Péptido natriurético tipo B, el conocido por las siglas BNP:

IMG_6929

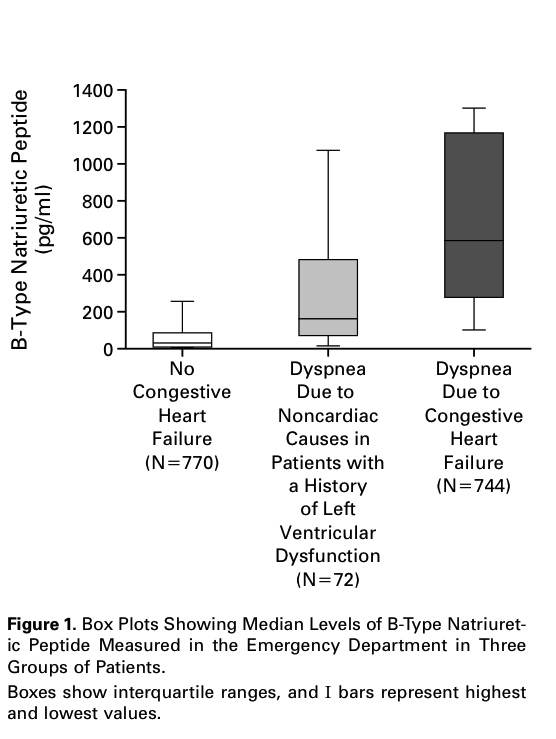
El siguiente es un análisis de la misma variable (BNP) pero ahora comparando una diferente agrupación de pacientes, según tengan una insuficiencia cardíaca no congestiva, una dísnea no cardiogénica pero con disfunción ventricular izquierda y, finalmente, un grupo con dísnea originada por una insuficiencia cardíaca congestiva:

IMG_6926

El objetivo de esta última tabla es mostrar que cuando se combina afectación pulmonar y cardíaca el nivel de BNP aumenta.

Pero lo que quiero destacar aquí es el uso de estos interesantes gráficos (los Box-Plot) que de una tacada permiten visualizar el mínimo, el máximo, el primer cuartil, la mediana, el tercer cuartil, el rango, el rango intercuartílico de una muestra, y, habitualmente, la media muestral, aunque en este caso no aparece.

Un ejemplo de determinación del tamaño de muestra en Medicina

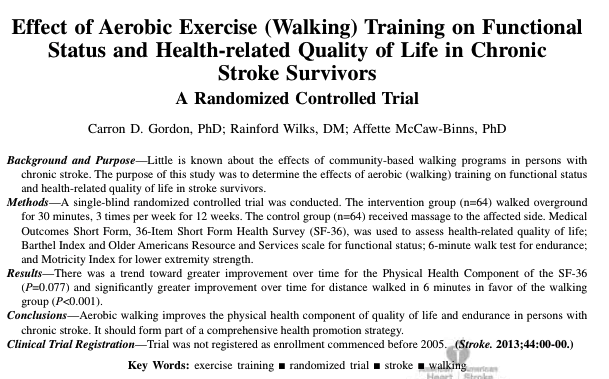
A continuación voy a comentar el proceso de elección del tamaño de muestra en el estudio del artículo siguiente:

IMG_6860

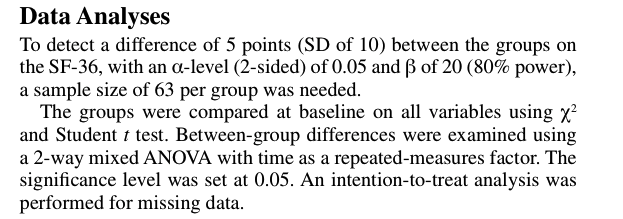
En este artículo se evalúa el efecto de una determinada acción rehabilitadora sobre enfermos que han padecido un ictus. Se comparan dos grupos: el control y el tratado. Para la elección del tamaño de muestra se escribe lo siguiente en el artículo (incluyo toda la parte del análisis de datos, aunque lo que nos interesa ahora es únicamente el primer párrafo):

IMG_6857

Observemos que en la descripción de la elección del tamaño de muestra elegido incluye todos los elementos que hay que tener en cuenta y que hemos visto en el Tema 16: DETERMINACIÓN DEL TAMAÑO DE MUESTRA: el error de tipo I (0.05), el error de tipo II (0.20 ó 20%) y su equivalente: la potencia (80%). Que el test sea bilateral; o sea, que interesa ver tanto si va bien como si va mal, el tratamiento. La Desviación estándar supuesta que se tendrá (10), que puede haberse conseguido o por estudios previos o por una premuestra, y, finalmente, qué diferencia mínima interesa detectar (una diferencia de 5 puntos en el índice SF-36). Una diferencia por debajo de la cual se consideraría que médicamente no tendría relevancia.

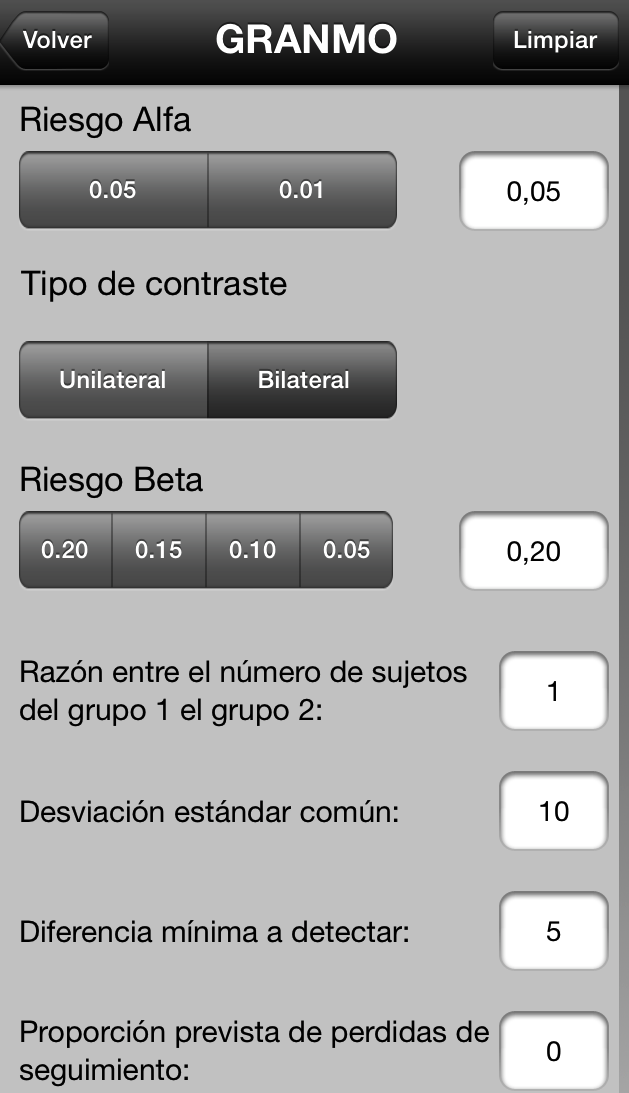
Es muy importante entender bien todos estos elementos. Porque siempre están presentes en la elección. A continuación, usando el GRANMO ( Ver, de nuevo, el Tema 16), se trata de buscar la opción de comparación de dos variables independientes y hemos de especificar los siguientes

parámetros (Uso ahora la opción del GRANMO como aplicación, pero es lo mismo que se puede conseguir en la página web):

IMG_6859

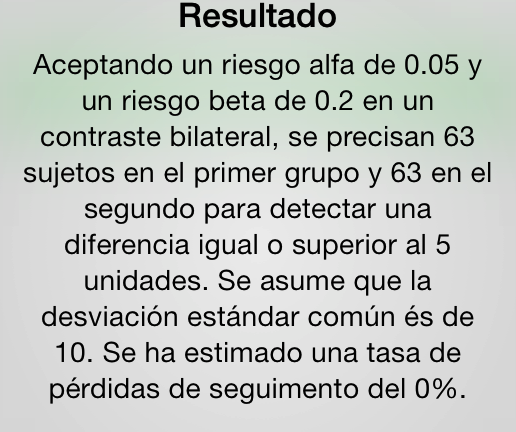
El programa nos devuelve la siguiente especificación:

IMG_6858

Nos dice que hemos de usar 63 pacientes por grupo que es lo que han hecho los que han planteado el estudio comentado. Esto significa que si la diferencia es mayor de 5 unidades del índice SF-36 lo detectaremos como estadísticamente significativo.

Solución Situación 37

1. La respuesta correcta es la “d”. Porque no es cierto que la mediana siempre sea mayor que el primer cuartil. Un ejemplo: (1, 1, 1, 5). En esta muestra la mediana es 1 y el primer cuartil es también 1. Por lo tanto, puede que la mediana no sea mayor que el primer cuartil. Puede ser, en ciertas muestras, valores iguales, como sucede en ésta.

La respuesta “a” es correcta. Un ejemplo: (1, 1, 5, 5). Aquí rango y rango intercuartílico son iguales: 4.

La respuesta “b” también es correcta. Si la varianza es 1, la desviación estándar, que es la raíz cuadrada de la varianza, también es 1.

La respuesta “c” también es correcta. Un ejemplo: (1, 2, 2, 2, 2, 2, 2, 3). En esta muestra el primer cuartil y el tercer cuartil son iguales: 2.

2. Si ordenamos la muestra de menor a mayor tenemos: (-1, -1, -1, -1, 1, 1, 1, 1). Como no todos los valores muestrales son iguales la desviación estándar no es cero. Desviación estándar sólo es 0 en las muestras cuyos todos sus valores son iguales.

El rango es 2, no 1. Porque el máximo de la muestra es 1 y el mínimo es -1. Y 1-(-1)=1+1=2.

La media muestral y la mediana muestral son iguales porque valen 0 los dos descriptores muestrales.

La respuesta correcta es, pues, la respuesta “c” porque el primer cuartil vale -1 y el tercer cuartil vale 1 y, por lo tanto, el rango intercuartílico, que es tercer cuartil menos primer cuartil es igual al rango: 2.

3. Nuestra muestra tiene los siguientes descriptores: La media es 25. La mediana es 1.5. El rango es 97. Y la Desviación estándar no es cero porque para ser cero todos los valores de la muestra deberían ser iguales y esto no sucede. Por lo tanto, la respuesta correcta es  la “c”.

4. La respuesta correcta es la “d”.

La desviación estándar no puede ser negativa. Surge de un promedio de cuadrados, por lo que nunca puede ser negativa. El valor más bajo posible es 0, cuando todos los valores sean iguales.

La media no tiene por qué ser mayor que la mediana en toda muestra. Veamos una muestra en la que no esto no sucede: (1, 30, 30, 39). En esta muestra la media es 25 y la mediana es 30. Luego n ella la media no es mayor que la mediana, sino que es menor.

El rango no siempre es mayor que el rango intercuartílico. Lo que no puede es ser menor pero puede ser igual a él. Por esto la respuesta correcta es la “d” porque en ella se especifica que el rango es siempre mayor o igual al rango intercuartílico, cosa que es cierta por definición de rango y de rango intercuartílico.

5. La respuesta correcta es la “c”.

Las medias no son iguales. En la primera muestra es 2.5 y en la segunda es 6.5. Las medianas tampoco son iguales porque son los mismos valores que las medias: 2.5 y 6.5. Los percentiles 25 también son distintos. En la primera muestra es 1.5 y en la segunda es 5.5.

Las desviaciones estándar de ambas muestras son iguales. Esto sí. Observemos que tienen la misma dispersión. Respecto a sus respectivas medias muestrales (2.5 y 6.5) los valores de las dos muestras ocupan una posición relativa exactamente igual. Es esto lo que marca la dispersión de la muestra.

Situación 37: Preguntas de Estadística descriptiva

1. ¿Cuál es la afirmación incorrecta?

a. En una muestra el rango y el rango intercuartílico pueden coincidir.

b. En una muestra podría coincidir la varianza y la desviación estándar.

c. En una muestra el primer cuartil y tercer cuartil pueden ser iguales.

d. La mediana siempre es un valor mayor que el primer cuartil.

2. En la muestra (1, -1, 1, -1, 1, -1, 1, -1),

a. La desviación estándar es cero.

b. El rango es 1.

c. El rango intercuartílico es 2.

d. La media muestral y la mediana son diferentes.

3. En la muestra (0, 1, 2, 97)

a. La media es 1.5.

b. La mediana es 25.

c. El rango es 97.

d. La desviación estándar es 0.

4. ¿Cuál de las siguientes afirmaciones es cierta?

a. La desviación estándar puede ser negativa.

b. La media muestral siempre es mayor que la mediana.

c. El rango siempre es mayor que el rango intercuartílico.

d. El rango es siempre mayor o igual al rango intercuartílico.

5. En las muestras: (1, 2, 3, 4) y (5, 6, 7, 8):

a. Las medias son iguales.

b. Las medianas son iguales.

c. Las desviaciones estándar son iguales.

d. Los percentiles 25 son iguales.

Solución

Solución Situación 36

Se trata de una pregunta que creo debería estar mejor planteada, porque tal como está formulada puede llevar a dudar incluso a los propios profesionales de la Estadística. Voy a continuación a explicar el porqué. Creo, además, que seguir esta argumentación puede ayudar a solidificar conceptos esenciales en Estadística.

La respuesta correcta, a mi modo de ver, es la 2 (ANOVA). De hecho, si se entiende que se quiere comparar los cuatro grupos de pacientes que se han establecido es, de las cinco respuestas posibles, la única opción realmente factible porque las otras cuatro técnicas son técnicas de comparación de dos poblaciones y nosotros tenemos aquí cuatro poblaciones, cuatro grupos. La pO2 de los dos momentos temporales puede hacer pensar que estamos ante datos apareados pero si los valores de antes y después se restan estamos, entonces, ante una única variable: la variable resta, la variable cambio de pO2 entre antes y después del tratamiento con NO. Por lo tanto, visto así, tenemos cuatro grupos a comparar con muestras independientes. Si es que lo que se pretende en este estudio es comparar los cuatro tipos de pacientes para ver si el cambio de pO2 es el mismo o no entre ellos.

A veces, puede llevar a engaño, en estos tests, el problema del tamaño de muestra. Es éste un tema que suele llevar a muchas confusiones. Es verdad que se acostumbra a simplificar estableciendo una frontera habitualmente en un tamaño de muestra de 30, pero esto no es correcto.

Hay tests estadísticos que no dependen del tamaño de muestra porque si la muestra sigue una distribución normal ya podemos aplicar el test: es el caso de la t de Student o del ANOVA. Si no sigue la normalidad sí que aplicaremos tests no paramétricos: el test de Mann-Whitney o el test Kruskal-Wallis, pero no si el tamaño de muestra es menor de 30. Esto del tamaño de muestra es aplicable a tests donde la distribución del estadístico en el caso de ser cierta la Hipótesis nula es asintóticamente conocida y este asintóticamente quiere decir para tamaños de muestra grandes. Es el caso, por ejemplo, del test de la ji-cuadrado, por ejemplo, o del propio test Kruskal-Wallis. Cada test tiene, además, un tamaño de muestra a partir del cual se considera suficientemente grande como para considerar que ya se cumple la distribución teórica supuesta. El 30 es un número que funciona bastantes veces i por eso se toma muchas veces como frontera, pero no siempre es así.

Por lo tanto, en el caso que se plantea la única opción factible es el ANOVA y para aplicarse debería comprobarse la normalidad de la variable resta de la pO2 de cada una de las cuatro poblaciones y la homogeneidad (la igualdad) de varianzas de las cuatro poblaciones. Si se cumplen ambas condiciones se puede aplicar con tranquilidad el ANOVA, sino debería aplicarse el test de Kruskal-Wallis. Como no se da esta última opción la técnica a aplicar es el ANOVA.

Todo esto que digo es lo que a mí me parece más lógico a argumentar ante esta pregunta. Sin embargo, me cabe una duda. En ningún momento se está diciendo que se quiere comparar estos cuatro grupos. Se dice que se quiere comparar si ante el tratamiento con NO hay diferencias, no si esas diferencias son distintas según el grupo de pacientes considerados. Esto me hace pensar que tal vez quien ha puesto esta pregunta lo que pretende es decir que se han tomado cuatro grupos de pacientes con HTP de UCI tratados con NO porque esa es la realidad hospitalaria con la que se han encontrado, y que se quiere mirar el efecto de ese tratamiento a esos pacientes, pero en ningún caso se pretende evaluar la diferencia que pueda darse entre esos cuatro grupos. De hecho, puede ayudar a llevar a esta conclusión el que en ningún momento se diga que se quiere comparar esos cuatro grupos. Y, por el contrario, se dice que lo que se quiere ver es si hay diferencia en la pO2 entre antes y después del tratamiento.

Si esto fuera lo que pretendía el que ha puesto esta pregunta estamos ante datos apareados pero tenemos un problema: entonces hay dos respuestas posibles. El Test de Wilcoxon y el test de la t de Student de datos apareados son posibles. Deberíamos saber si la variable resta de pO2 en los 24 pacientes sigue o no la distribución normal. En absoluto debe pensarse que el ser la muestra de tamaño 24 (que es menor que 30) impide la aplicación de la técnica paramétrica (la t de Student de datos apareados), como he comentado antes. El test de la t de Student es un test exacto, no asintótico. Es exacto si se sigue la distribución normal. Por lo tanto, si el que ha puesto la pregunta está pensando en esto falta información para elegir entre estas dos opciones posibles.

Por lo tanto, para mí la pregunta necesitaría formularse mejor mediante dos opciones: 1) Dejar claro que se quiere ver si hay diferencias significativas entre la respuesta al NO según se pertenezca a un grupo u otro de esos cuatro pacientes. 2) Si lo que se quiere es ver únicamente si hay un cambio significativo en el pO2 después del tratamiento con NO en los pacientes con HTP en UCI, especificándose los cuatro tipos de pacientes únicamente a nivel informativo, debería concretarse si la variable resta se ajusta o no a la distribución normal porque si no se especifica tal cosa hay dos respuestas posibles.

Para leer cosas que complementen a lo visto aquí ver el Tema 14: Comparación de dos poblaciones.

Para ver otro ámbito en el que suele llevar a confusiones el tener un determinado tamaño de muestra en Estadística ver el artículo: La Estadística descriptiva en Medicina.

Situación 36: Una pregunta del MIR

En un ensayo clínico se pretende evaluar la respuesta al Óxido nítrico (NO) en niños con Hipertensión pulmonar (HTP). Se incluyeron 24 pacientes de la UCI, entre 1996 y 1997, que recibieron NO inhalado. Las indicaciones se categorizaron en 4 grupos: 1) Tratamiento con monitorización directa de la Presión arterial pulmonar (PAP). 2) Tratamiento sin monitorización directa. 3)  Con un nivel de presión mayor de 15 mmHg. 4) En uso preventivo. Se controlaron TA, PAP, gases en sangre antes y después, meta Hb, control ambiental NO cada 4h y ecocardio pre y post NO. En el análisis estadístico se compararon pO2 antes y después del NO. ¿Qué test se utilizó?

1. t de Student de muestras independientes

2. ANOVA

3. Wilcoxon

4. t de Student apareados

5. Mann Whitney

Solución

Solución Situación 33

Si se hace una selección entre las variables originales (las distintas asignaturas) y las dos componentes principales observamos que la que consigue una mejor relación con la variables sexo es la Historia. Es la que separa mejor ambas poblaciones.

Incluso si se hace un Stepwise con todas estas variables se acaba seleccionado la variable Historia, también, como mejor pronosticador.

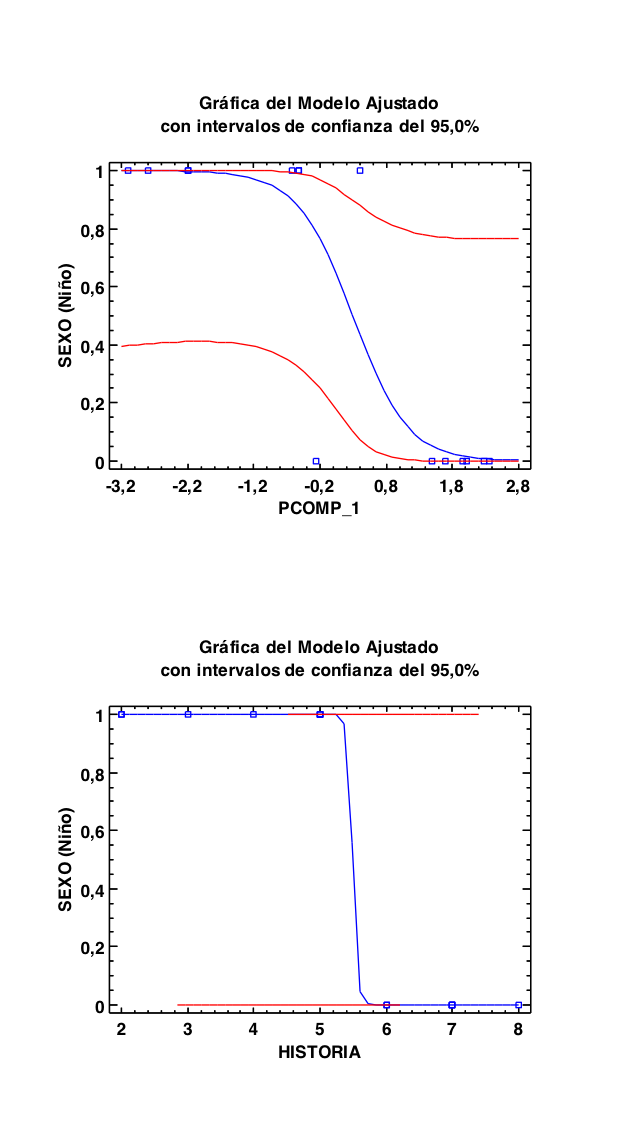
En el siguiente gráfico aparece la relación del Sexo con la primera componente principal (la que agrupa las notas de letras) y la Historia. Como puede observarse la Historia consigue una relación con mayor pendiente, lo que indica que se segregan mejor los valores de un sexo y otro respecto a las notas de Historia.

IMG_6129

Observemos que viendo tanto la primera componente, como la variable Historia, las notas bajas de letras o de Historia son buenas pronosticadoras de Sexo Hombre. En cambio, notas altas de letras o de Historia son buenas pronosticadores de Sexo Mujer.

Tema 28: REGRESIÓN DE POISSON

1. La Regresión de Poisson es un tipo especial de Regresión donde la particularidad es que la variable dependiente se ajusta bien a una distribución Poisson para cualquier combinación de valores de la variable independiente (en una Regresión de Poisson simple) o de las variables independientes (en una Regresión de Poisson múltiple).

2. Existen múltiples tipos de Regresión. La Regresión de Poisson es un caso más entre el amplísimo ámbitos de tipos de Regresión que se han definido. A lo largo del tiempo se han ido ajustando nuevos modelos de Regresión con la finalidad de conseguir representar mejor determinadas relaciones entre las cosas. Este tipo de Regresión es un ejemplo de este progreso de construcción de modelos matemáticos cada vez más ajustados a la realidad.

3. La distribución de Poisson es una distribución que modeliza bien situaciones de conteo. Por ejemplo: números de accidentes, número de personas que tienen un infarto, número de personas que llaman a una centralita de teléfono, etc, siempre todo esto evaluado en unidad de tiempo determinada.

4. La distribución de Poisson tiene un único parámetro, la lambda, que coincide con la Esperanza y la Varianza de la distribución. O sea, es una distribución que cuanto más grande es el valor esperado más dispersión tienen los valores que puede tomar la variable que se distribuya así.

5. La distribución de Poisson toma, pues, valores enteros no negativos: 0, 1, 2, 3, 4, … Una peculiaridad especial de esta distribución es, como he dicho en el apartado anterior, que su esperanza y su varianza es la misma. Este es un buen criterio, pues, para comprobar si unos datos se ajustan a una distribución Poisson. Por ejemplo, la muestra (2, 4, 3, 4, 4, 5, 3, 4, 1, 4, 3, 5) se ajusta bien porque tiene la media muestral y la varianza muestral muy similares. Sin embargo, la muestra (1, 1, 2, 3, 50, 4, 55, 3) no se ajusta porque tiene una media muestral mucho más pequeña que la varianza muestral.

6. En el artículo Funciones de distribución pueden verse algunas peculiaridades de esta función de distribución: la función matemática, la forma que tiene, algunas peculiaridades y algunas aplicaciones. Ahora lo que sí nos puede ser útil, para poder entender lo que pretendemos captar y representar, mediante la Regresión de Poisson, es mostrar el siguiente dibujo de los cambios que se visualizan en la distribución Poisson cuando el valor de su parámetro, la lambda va aumentando:

IMG_5817

7. La lambda puede ser cualquier valor real positivo. Observemos cómo al ir aumentando el valor de la lambda los valores con más probabilidad se van desplazando hacia la derecha y, al mismo tiempo, los valores posibles se van diversificando.

8. Si recordamos regresiones vistas en otros temas podremos situar mejor ésta. En la Regresión lineal la variable dependiente, la que solemos representar por una «y», es una variable continua, una variable que potencialmente puede tomar cualquier valor real dentro de un intervalo. En la Regresión logística hemos visto que esa variable dependiente era dicotómica: era una variable que tomaba dos valores posibles que normalmente codificamos como 0 y 1. Pues, ahora, con la Regresión de Poisson tenemos una situación en cierta forma intermedia: Potencialmente son infinitos los valores posibles de la variable dependiente pero con limitaciones. Son enteros no negativos, porque son recuentos, y los valores tienen la peculiaridad de tener media muestral y varianza muestral similar.

9. Veamos en el siguiente gráfico el dibujo de los tres tipos de regresión comentados, para situarnos:

IMG_5819

10. Y observemos ahora más en concreto lo que pretende representar la Regresión de Poisson. Observemos que se trata de, a partir de unos datos como podrían ser los del tercer esquema del gráfico anterior, construir un modelo como podría ser el siguiente:

IMG_5818

11. Para poder evitar el problema de dar valores negativos en este tipo de regresión se realiza una transformación de los datos que nos evita estos problemas: una transformación logarítmica.

12. El modelo básico con una única variable independiente es el siguiente:

IMG_5497

13. El modelo para varias variables independientes es:

IMG_5498

14. Veamos tres ejemplos de cómo sería una Regresión de Poisson con una única variable independiente. En el primer caso no funciona el modelo porque el coeficiente «a» no es significativo. Pensemos que el coeficiente «a» es el que multiplica a la variable independiente x, por lo tanto, si su valor es cero significa que no hay relación entre la variable «y» y la la variable «x», como se puede ver visualizando el gráfico de valores:

IMG_5544

15. En el segundo caso:

IMG_5545

16. En el tercer caso:

IMG_5546

17. En Regresión de Poisson se puede trabajar con los valores brutos (valores absolutos) o con tasas (valores relativos).

18. Como puede observarse se trata de un caso un tanto especial, por las peculiaridades del tipo de variables y de relaciones entre ellas, pero estamos hablando de conceptos que ya han ido saliendo en temas anteriores: conceptos de Regresión, conceptos que preparan el terreno para el establecimiento de un modelo matemático de la relación entre variables.

Tema 27: ANÁLISIS DE CORRESPONDENCIAS

1. El Análisis de correspondencias es una técnica de reducción de dimensiones, una técnica para visualizar una nube de puntos multidimensional en dos dimensiones. Consiste, como las demás técnicas de reducción de dimensiones, en un procedimiento de traslado de una nube de puntos definida en un espacio de muchas dimensiones a un espacio de dos dimensiones donde poder visualizar la posición relativa de unos puntos. Este traslado se hará respetando al máximo las posiciones relativas de los puntos en la nube de puntos original.

2. Se trata, pues, en definitiva, como sucede con las demás técnicas de reducción de dimensiones (Análisis de componentes principales, Análisis factorial o Análisis discriminante) de una técnica que trata de hacer una fotografía, en dos dimensiones, de una realidad multidimensional.

3. El Análisis de correspondencias es, en realidad, un análisis equivalente al Análisis de componentes principales y al Análisis factorial pero con variables cualitativas.

4. Cuando estudiamos dos o más variables cualitativas cada una de ellas tiene una serie de valores posibles, de valores que en realidad son categorías, son valores nominales (es por esto que a las variables cualitativas se les denomina también categóricas o nominales). Por ejemplo, la variable sexo: Hombre y Mujer, la variable fumar: Fuma y No fuma, etc.

5. El objetivo del Análisis de correspondencias crear un mapa de la posición relativa de las variables cualitativas estudiadas con cada uno de sus valores posibles. Una posición que refelje el grado de asociación entre ellas. Es una técnica que, aunque está basada en unos métodos algebraicos complejos, es muy intuitiva, como se verá a continuación. Básicamente el objetivo es representar cada uno de los valores posibles de cada una de las variables estudiadas en un plano donde la posición relativa de los puntos refleje el grado de asociación entre cada uno de los conceptos representados.

6. Se distingue habitualmente el Análisis de correspondencias simples del Análisis de correspondencias múltiples, según sean dos variables cualitativas estudiadas (Análisis de correspondencias simple) o más de dos (Análisis de correspondencias múltiple).

7. El procedimiento del análisis es muy similar al del Análisis de componentes principales. Se trata de buscar qué combinaciones de los valores nominales de las variables cualitativas originales permiten una representación más fiel, en dos dimensiones, de la nube de puntos original que es en más dimensiones.

8. Aparecerán, como en el Análisis de componentes principales, unos valores propios (cantidad de varianza explicada) y unos coeficientes asociados a cada valor de cada variable cuatitativa que representan el peso que cada uno de ellos tiene en esa nueva dimensión que me permitirá una representación en menos dimensiones.

9. Habrá, por lo tanto, una proporción de varianza explicada por las dos dimensiones de la nueva representación que nos dará la fiabilidad, que nos dará el grado de aproximación que hay entre lo que vemos, que es una aproximación, y la verdadera realidad que pretendemos representar. Observemos que la forma de hablar en este tema es paralelo a la forma empleada en el tema dedicado al Análisis de componentes principales.

10. Veamos un ejemplo que puede ilustrar lo que estamos diciendo: Tomamos 100 seguidores del Barça, del R. Madrid, del At. Madrid, del At. Bilbao y del Valencia. Y les pedimos que elijan de entre esos cinco equipos dos preferentes. Uno, evidentemente será el propio equipo del que es seguidor pero el segundo debe ser el que más les simpático les caiga o el que por el que menos antipatía sientan. Esto nos permitirá analizar la posición relativa de  los seguidores de esos equipos respecto a esos equipos.

11. Observemos que tenemos dos variables cualitativas. El equipo del que es seguidor y la elección de los dos equipos preferidos. Al final el cuadro de resultados es el siguiente:

IMG_6073

12. Observemos que es un ejemplo muy claro. Vemos unas proximidades y unas lejanías que todos los aficionados al fútbol conocemos. Veamos que de los 100 seguidores del Barça los 100 eligen al Barça pero como deben también elegir a otro equipo 30 eligen al At. Madrid, 60 al At. Bilbao y 10 al Valencia. De los 100 seguidores del R. Madrid los 100 eligen al propio R. Madrid pero la segunda opción se reparte distinto: 20 para el At. Bilbao y 80 para el Valencia. Y así sucesivamente.

13. El primer cuadro de resultados fundamental de este análisis es el siguiente:

IMG_6074

14. Observemos que aquí lo que nos marca es la calidad de la representación que veremos luego. Fijémonos especialmente en la llamada Proporción de la Incercia explicada. Vemos que la primera dimensión, el primer eje (podríamos decir la primera componente principal, en términos del Análisis de componentes principales) explica el 0.663 por uno o el 66.3% de la inercia. La inercia es un sinónimo de varianza. Este análisis está muy ligado a la tradición estadística francesa donde a la varianza se le denomina inercia. La segunda dimensión explica el 22%. En total con las dos dimensiones que veremos explicamos el 88.3%. Está muy bien.

15. El siguiente paso son cuales son las coordenadas. El análisis siempre da unas coordenadas de los puntos fila y unas coordenadas de los puntos columna:

IMG_6075

IMG_6076

16. Esto es porque, en realidad, los que hace la técnica es hacer dos análisis de reducción de dimensiones: uno según filas y otro según columnas y luego los solapa. Solapa los puntos, solapa las dos representaciones. En realidad, se hacen dos Análisis de componentes principales a la matriz de datos mostrada anteriormente: una en la que las filas son variables y las columnas individuos y otra en la que las filas son los individuos y las columnas variables. Esta es, en sí, la esencia de la técnica.

17. Finalmente el gráfico es el siguiente:

 IMG_6077

18. Como puede observarse el punto que hace referencia a los seguidores está muy cerca, en todos los casos, del punto de las preferencias. Pero observemos más cosas: Los seguidores del Barça eligen con frecuencia al At. Bilbao, y lo mismo al revés. Son equipos próximos. Tanto Barça respecto al R. Madrid como el At. Madrid respecto al R. Madrid están muy alejados. El Valencia está más próximo al R. Madrid, pero en realidad está bastante en el centro del gráfico, lo que significa que las distancias con todos los equipos está bastante repartida. Si se observa con detenimiento este gráfico y los datos de la matriz de resultados, de la tabla de correspondencias, vemos que ese gráfico es una representación gráfica fiel de lo que se desprende de aquellos datos.

19. Cuando tenemos más de dos variables cualitativas lo que hace la técnica es construir una matriz de doble entrada donde va añadiendo en las filas todas las categorías de cada una de las variables cualitativas del estudio y en las columnas hace lo mismo. Es la llamada Matriz de Hurt. En el interior de la matriz, como en el caso de dos variables cualitativas, tenemos las frecuencias de cada uno de los cruces. A partir de ella es donde se realiza el análisis de reducción de dimensiones y la representación en un plano de todas las categorías respetando la posición relativa de unos conceptos respecto a los otros.

20. Veamos un ejemplo de Análisis de correspondencias múltiples. Supongamos que estamos analizando las variables sexo (hombre, mujer), edad (joven, adulto) y fumar (sí, no).

21. En el siguiente gráfico muestro unos datos que tal vez podrían encajar con lo que sucedía hace 40 años y el plano resultado del análisis:

IMG_6083

22. Y veamos ahora otro gráfico con otros datos y con otro análisis que tal vez encaja más con datos de hace unos pocos años:

IMG_6081

23. Es muy importante comparar ambas matrices de datos y, en cada caso, en cada estudio, comparar los datos con el diseño del plano con los valores de las tres variables cualitativas que nos proporciona el análisis.

24. En el primer caso el fumar o no fumar está más próximo a Hombre o Mujer, respectivamente y, también en este caso, el perfil de jóvenes y adultos es muy distinto y más o menos equidistante de fumar o no.

25. En cambio, en el segundo caso, el fumar o no fumar está más ligado a Joven o Adulto y el perfil de Hombre y mujer están alejados y equidistantes más o menos de fumar o no fumar aunque un poco más cerca Hombre de fumar y Mujer de no fumar.

26. Sin lugar a dudas que si se practica un poco interpretando las dos matrices de datos y los dos gráficos de salida del Análisis de correspondencias múltiple se captará la esencia de esta técnica: la búsqueda de una representación bidimensional que refleje la posición relativa de las asociaciones entre las diferentes opciones nominales de las variables cualitativas incluidas en el análisis.

27. Hemos comentado antes que el Análisis de correspondencias múltiples trabaja con la llamada Matriz de Hurt. Esta matriz se obtiene a partir de las frecuencias para cada caso y consiste en un recuento de las frecuencias de los cruces de todos los valores nominales posibles de las diferentes variables cualitativas analizadas.

28. A partir de los datos del segundo de los casos analizados anteriormente podemos ver, a continuación, cuál sería la Matriz de Hurt:

IMG_6082

29. El Análsis de correspondendias, por lo tanto, lo que hace es aproximar lo próximo, los perfiles próximos, busca las asociaciones, trata de dibujarnos las relaciones entre los valores de las variables cualitativas.

30. Un último ejemplo, basado en unos datos y un análisis hecho por Bernat Llopis: son datos de un estudio de algunas características evaluadas en diferentes dragones de la literatura universal. La tabla de datos recoge cuatro variables: La naturaleza (Malvada, Salvaje o Bondadosa), el mundo al que pertenece (Fantástico o Real), si habla o no y si exhala fuego o no.

31. Una vez hecho el análisis de correspondencias tenemos las siguientes asociaciones de las variables categóricas estudiadas:

IMG_0819

32. Hay una tendencia a asociarse, en un dragón, el hablar, la naturaleza bondadosa, el exhalar fuego y el pertenecer a un mundo fantástico. Por el contrario, el no hablar, el pertenecer a un mundo real, el ser de naturaleza malvada y el no exhalar fuego también parecen asociados, aunque no tan intensamente como el otro grupo de características.

33. Los datos en los que se basa este estudio son los siguientes:

Nombre propio Naturaleza Mundo Habla ExhalarFuego
Smaug Malvada Fantástico Si Si
Drogon Salvaje Fantástico No Si
Xèron Bondadosa Real Si No
Saphira Bondadosa Fantástico Si Si
Yandrak Bondadosa Fantástico No Si
Sin nombre Bondadosa Real No No
Sin nombre Salvaje Fantástico No Si
Fújur Bondadosa Fantástico Si No
Sin nombre Salvaje Real No Si
Sin nombre Malvada Real No Si
Kalecgos Bondadosa Fantástico Si No
Ferno Bondadosa Fantástico No Si
Sin nombre Malvada Real No no
Fafnir Malvada Real Si No
Lung Bondadosa Real Si Si
Sin nombre Malvada Real No Si
Kai Bondadosa Fantástico Si Si
Glaedr Bondadosa Fantástico Si Si
Shruikan Malvada Fantástico Si Si
(Sin nombre. Se le denomina
«Dragón Dorado» o «Emperador Dragón»)
Malvada Fantástico Si Si
Norberto Salvaje Real No Si

La eta cuadrada y la eta cuadrada parcial

La eta cuadrada y la eta cuadrada parcial son dos medias del tamaño del efecto (Effect size) en ANOVA. Observemos qué calculo es cada una de ellas:

IMG_5983

Suele considerarse que una eta cuadrada en torno a 0,01 es poco efecto, que una eta cuadrada en torno a 0,06 indica un efecto medio y que una eta cuadrada superior a 0,14 es ya un efecto grande.

Son cálculos hechos, todos ellos, a partir de la tabla ANOVA, pero con una particularidad: como sucede en toda medida del tamaño del efecto, no depende del tamaño de muestra, porque no es una medida de Significación formal, es una medida de Significación material. Sería recomendable leer el artículo dedicado a la Significación formal y material.

Digo que no dependen del tamaño muestral porque los cálculos están hemos con las sumas de cuadrados, no con los cuadrados medios. El cálculo del p-valor depende de concientes de cuadrados medios, como podemos ver en las técnicas ANOVA (Ver el Tema dedicado al ANOVA.