Archivo del Autor: estadisticallopis

Explotación de una base de datos 1: Base de datos

En este artículo veremos la base de datos con la que vamos a trabajar en este conjunto de ficheros con el nombre «Explotación de una base de datos», mediante los cuales iremos aplicando diferentes técnicas estadísticas, es la siguiente.

Los códigos de las etiquetas son los siguientes:

Etiqueta Contenido Tipo
S Sexo Cualitativa (h-m)
E Edad Cuantitativa
DI Días de ingreso Cuantitativa
C Cirugía Cualitativa (Sí o No)
D 1:Medicina interna
2:Traumatología
3:Urología
4:Oftalmología
P1 Estado de las habitaciones Likert
P2 Comida Likert
P3 Atención del personal no sanitario Likert
P4 Atención del personal auxiliar sanitario Likert
P5 Atención del personal de enfermeria Likert
P6 Atención del personal médico Likert
P7 Información recibida Likert
P8 Solución del problema Cualitativa (Sí o No)
VG Valoración general Cuantitativa (0-10)

Las variables Likert han sido etiquetadas de la siguiente forma:

1 Totalmente en desacuerdo
2 En desacuerdo
3 Ni de acuerdo ni en desacuerdo
4 De acuerdo
5 Totalmente de acuerdo

La base de datos es la siguiente:

S E DI C D P1 P2 P3 P4 P5 P6 P7 P8 VG
h 52 2 NO 1 3 4 4 4 4 2 1 SI 7
h 78 4 NO 2 2 3 3 4 4 5 4 SI 8
h 34 3 NO 3 2 2 4 4 4 1 2 NO 6
h 45 6 SI 4 4 3 3 3 3 4 4 SI 6
h 47 8 SI 1 5 5 2 2 2 3 3 SI 5
h 59 2 NO 4 4 3 3 3 3 3 2 NO 6
h 67 2 SI 4 4 4 4 4 4 5 4 NO 8
h 32 3 SI 3 3 2 2 2 3 2 1 NO 4
h 56 34 SI 2 5 5 5 5 5 2 2 SI 9
h 78 45 SI 1 5 4 1 2 2 5 4 SI 6
m 43 3 NO 3 2 2 2 3 2 3 4 NO 4
m 42 4 NO 1 2 2 2 2 2 2 2 NO 4
m 38 5 SI 1 4 5 5 5 5 5 4 SI 10
m 75 5 NO 2 3 3 3 4 4 3 2 SI 7
m 27 2 NO 4 3 3 3 3 3 4 3 SI 6
m 34 8 SI 2 5 4 1 1 2 5 4 SI 5
m 32 23 SI 1 5 4 1 2 2 1 2 SI 4
m 43 2 NO 3 3 4 4 3 3 3 4 SI 7
m 45 2 SI 4 2 2 4 4 4 2 2 SI 6
m 55 5 NO 2 2 2 4 5 5 4 3 NO 8
h 59 2 NO 2 4 3 4 3 3 3 2 NO 6
h 67 2 SI 4 4 4 5 4 4 5 4 NO 8
h 32 3 SI 3 3 2 2 3 3 2 1 NO 4
h 56 34 SI 1 5 5 5 4 5 2 2 SI 9
h 78 45 SI 2 5 4 1 1 2 5 4 SI 6
m 43 3 NO 3 2 2 2 3 4 4 4 NO 6
m 42 4 NO 2 2 2 2 2 2 2 2 NO 4
m 38 5 SI 2 4 5 5 5 5 5 4 SI 9
m 77 5 NO 2 3 3 3 4 4 4 2 SI 7
m 29 2 NO 4 3 3 3 3 3 4 3 SI 6
m 36 8 SI 2 5 4 1 1 2 4 4 SI 5
m 64 23 SI 1 5 4 1 2 2 2 2 SI 4
m 29 2 NO 4 3 3 3 3 3 4 3 SI 6
m 36 8 SI 2 5 4 1 1 2 5 4 SI 5
m 71 21 SI 1 5 4 1 2 2 1 2 SI 6
m 45 2 NO 3 3 4 4 3 3 3 4 SI 6
m 47 4 NO 4 2 2 4 4 4 2 2 SI 6
m 57 5 NO 2 2 2 5 5 5 4 3 SI 8
h 61 2 NO 4 4 3 3 3 3 3 2 NO 6
h 69 2 NO 4 4 4 4 4 4 5 4 SI 8
h 34 3 NO 3 3 2 2 2 3 2 1 NO 4
h 61 2 NO 2 4 3 3 3 3 3 2 NO 6
h 69 2 NO 4 4 4 4 4 4 5 4 SI 8
h 34 3 NO 3 3 2 2 2 3 2 1 NO 4
h 68 23 SI 2 5 5 4 5 4 2 2 SI 7
h 80 30 SI 1 5 4 1 2 2 5 4 SI 6
m 45 3 NO 3 2 2 2 3 4 4 4 NO 6
m 44 4 NO 2 2 2 2 2 2 2 2 NO 4
m 40 5 SI 1 4 5 5 5 5 5 4 SI 10
m 77 5 NO 1 3 3 3 4 4 3 2 SI 7
m 27 2 NO 4 3 3 3 3 3 4 3 SI 6
m 35 8 SI 2 5 4 1 1 2 5 4 SI 5
m 64 21 SI 1 5 4 1 2 2 1 2 SI 5
m 25 2 NO 3 3 4 4 5 5 3 4 SI 7
m 66 4 SI 4 2 2 4 4 4 2 2 SI 6
m 57 5 NO 2 2 2 5 5 5 4 3 NO 8
h 71 2 NO 4 4 3 3 3 3 3 2 NO 6
h 69 2 SI 4 4 4 4 4 4 5 4 SI 8
h 22 3 NO 3 3 2 2 2 3 2 1 NO 4
h 78 78 SI 2 5 5 5 5 5 2 2 SI 9
h 80 4 NO 2 2 3 3 4 4 5 4 SI 8
h 36 3 NO 2 2 2 4 4 4 2 2 NO 7
h 47 6 SI 1 4 3 3 3 3 4 4 SI 6
h 46 8 SI 1 5 5 2 2 2 3 3 SI 5
h 61 2 NO 4 4 3 3 3 3 3 2 NO 5
h 69 2 NO 4 4 4 4 4 4 5 4 NO 8
h 34 3 NO 3 3 2 2 3 3 2 1 NO 4
h 58 34 SI 1 5 5 5 4 5 2 2 SI 9
h 80 45 SI 1 5 4 1 2 2 5 4 SI 6
m 45 3 NO 2 2 2 2 3 4 4 4 NO 6
m 44 4 NO 3 2 2 2 2 2 2 2 NO 3
h 61 2 NO 4 4 3 3 3 3 3 2 NO 6
h 69 2 NO 4 4 4 4 4 4 5 4 NO 8
h 75 3 NO 3 3 2 2 2 3 2 1 NO 4
h 68 34 SI 1 5 5 5 5 5 2 2 SI 9
h 73 45 SI 1 5 4 1 2 2 5 4 SI 6
m 45 3 NO 3 2 2 2 3 4 4 4 NO 6
m 44 4 NO 2 2 2 2 2 2 2 2 NO 4
m 40 5 SI 1 4 5 5 5 5 5 4 SI 9
m 77 6 NO 1 3 3 3 4 4 3 2 SI 7
m 29 3 NO 4 3 3 3 3 3 4 3 SI 6
m 76 9 SI 2 5 4 1 1 2 5 4 SI 5
m 66 31 SI 1 5 4 1 2 2 1 2 SI 6
m 45 2 NO 3 3 4 4 5 4 3 4 SI 8
m 47 4 NO 4 2 2 4 4 4 2 2 SI 6
h 69 2 NO 4 4 4 4 4 4 5 4 NO 8
h 34 3 NO 3 3 2 2 2 3 2 1 NO 4
h 58 21 SI 1 5 5 5 5 5 2 2 SI 9
h 80 24 SI 1 5 4 1 2 2 5 4 SI 6
m 45 3 NO 3 2 2 2 3 4 4 4 NO 6
m 44 3 NO 2 2 2 2 3 2 2 3 NO 4
m 40 4 SI 2 4 5 5 5 5 5 4 SI 9
m 77 4 NO 1 3 3 3 4 4 3 3 SI 7
h 34 4 NO 3 3 2 2 2 3 2 2 NO 4
h 78 33 SI 1 5 5 4 5 5 2 1 SI 8
h 84 40 SI 1 5 4 1 2 2 5 4 SI 6
m 45 2 NO 3 2 2 2 3 4 4 3 NO 6
m 44 3 NO 2 2 2 2 2 2 2 2 NO 4
m 40 4 SI 2 4 5 4 5 4 5 4 SI 9
m 28 3 NO 3 1 2 2 4 3 4 4 NO 6

Solución Situación 52

1.La respuesta correcta es la “c”. Es correcta porque se pide lo que no es cierto. Evidentemente un p-valor de 0.67 indica no significación, lo que implica que un intervalo de confianza de la Odds ratio debe incluir al 1, cosa que no sucede en esta opción. Las demás afirmaciones son ciertas, por lo tanto no las debemos elegir.

La opción “a” muestra un intervalo que incluye al 1 y por lo tanto no es significativa. La “b” no incluye al 1 y por lo tanto, es significativa. La “d” indica un p-valor no significativo y el intervalo incluye al 1.

2.La respuesta correcta es, ahora, la “a”. Ahora para que una correlación de Pearson sea significativa no debe contener al 0. En esta afirmación el intervalo no contiene al 0, por lo tanto se trata de una correlación significativa y, por el contrario, nos dicen que es no significativa.

Las demás respuestas son correctas. Siguen la regla de que una correlación de Pearson es significativa si el intervalo de confianza no contiene al 0. Y no es significativa si lo contiene.

3.La respuesta correcta aquí es la “d”. De nuevo nos piden la sentencia no correcta. En esta pregunta la clave es ver la relación entre correlación de Pearson y la pendiente de la recta de la Regresión lineal simple. Si la correlación de Pearson es significativa también lo será la pendiente. Además, una correlación positiva irá asociada de una pendiente positiva y una correlación negativa de una pendiente negativa. Observemos que en esta opción “d” nos afirman que la correlación es negativa y significativa y, sin embargo, no dicen que la pendiente no lo es. Esto no es correcto.

4.La correcta es la “b”. La “a” y la “d” son Regresiones simples. En concreto la «d» es, en realidad, y=10x. Y la “c” no es una Regresión.

5. La respuesta correcta es la “c”. Es la definición del coeficiente de determinación.

6. La respuesta correcta es la “b”. Evidentemente el Stepwise sólo es aplicable a Regresiones múltiples. En una Regresión simple no tiene sentido. Las otras afirmaciones son ciertas.

7. La correcta es la opción “b”: Observemos que e0.6=1.82 y e0.8=2.22. En las otras opciones no coinciden los valores extremos del intervalo con los valores del coeficiente con los de la Odds ratio.

Además, en la opción “a” el coeficiente no es significativo y la Odds ratio sí, cosa que no es posible. En la “c” el coeficiente es negativo y la Odds ratio es mayor que 1, cosa que no es posible. En la “d” el coeficiente es positivo y la Odds ratio es menor que 1, cosa que tampoco es posible.

8. La correcta es la opción “b”. Como la Odds ratio es el número e elevado al valor del coeficiente, si el coeficiente es positivo la Odds ratio será claramente mayor que 1. Será significativa porque el intervalo de confianza del coeficiente no incluye al cero. Y una Odds ratio nunca será negativa.

9.La respuesta correcta es la “c”. Es correcta porque se pide lo que no es cierto. Lo que aquí se indica es el criterio de interpretación del p-valor, no el de la V de Cramer.

10. La respuesta correcta es la “c”. Claramente tenemos un caso de una relación entre una variable dicotómica y una variable continua. En una Regresión logística simple el coeficiente será menor que 0 y, por lo tanto, la Odds ratio será menor que 1.

No debemos calcular una correlación de Pearson. Y la Odds ratio, evidentemente, no será 0.

Situación 52: Examen (Temas 5-12)

1. ¿Cuál de las siguientes afirmaciones no es cierta?

             a. Una Odds ratio con un intervalo de confianza (0.23, 2.45) no es significativa.

             b. Una Odds ratio con un intervalo de confianza (2.33, 3.75) es significativa.

         c. Una Odds ratio con un p-valor de 0.67 es compatible con un intervalo de confianza como el siguiente: (1.23, 1.98).

          d. Una Odds ratio con un p-valor de 0.34 es compatible con un intervalo de confianza como el siguiente: (0.63, 2.34).

2. ¿Cuál de las siguientes afirmaciones no es cierta?

          a. Una correlación de Pearson con un intervalo de confianza (0.23, 0.78) no es significativa.

           b. Una correlación de Pearson con un intervalo de confianza (-0.83, -0.15) es significativa.

         c. Una correlación de Pearson con un p-valor de 0.37 es compatible con un intervalo de confianza como el siguiente: (-0.23, 0.98).

         d. Una correlación de Pearson con un p-valor de 0.02 es compatible con un intervalo de confianza como el siguiente: (0.63, 0.78).

3. En la Regresión lineal simple, no es cierto:

          a. Una correlación de Pearson con un intervalo de confianza (0.63, 0.88) irá asociada de una pendiente positiva y significativa.

            b. Una correlación de Pearson con un intervalo de confianza (-0.73, -0.55) irá asociada a una pendiente negativa y significativa.

            c. Una correlación de Pearson con un intervalo de confianza (-0.23, 0.18) irá asociada a una pendiente no significativa.

            d. Una correlación de Pearson con un intervalo de confianza (-0.93, -0.48) irá asociada a una pendiente negativa pero no significativa.

4. ¿Cuál de los siguientes modelos es una Regresión lineal múltiple?:

            a. y=2x+7

            b. y=3x+5z-3

            c. y=7

            d. y=x+2x+3x+4x

5. La R2 significa:

            a. Que tenemos una Regresión lineal simple.

            b. Que si el valor es superior al 5% tenemos una Regresión significativa.

      c. El grado de determinación que hay entre la variable dependiente y las variables independientes.

            d. Que podemos hacer una Regresión logística.

6.En una Regresión logística simple no es cierto:

            a. La variable dependiente es dicotómica.

      b. Debemos aplicar un Stepwise para seleccionar qué variables independientes son relevantes.

            c. La Odds ratio es un elemento muy importante para evaluar su calidad.

         d. Una Odds ratio con un intervalo de confianza (1.45, 2.26) indica que se trata de una relación significativa.

7. En una Regresión logística simple es cierto:

            a. Un coeficiente que multiplica a la variable independiente con un intervalo de confianza (-0.6, 0.7) es compatible con un intervalo de confianza de la Odds ratio de (1.15, 2.33).

            b. Un coeficiente que multiplica a la variable independiente con un intervalo de confianza (0.6, 0.8) es compatible con un intervalo de confianza de la Odds ratio de (1.82, 2.22).

           c. Un coeficiente que multiplica a la variable independiente con un intervalo de confianza (-0.6, -0.4) es compatible con un intervalo de confianza de la Odds ratio de (1.45, 3.33).

           d. Un coeficiente que multiplica a la variable independiente con un intervalo de confianza (0.8, 0.9) es compatible con un intervalo de confianza de la Odds ratio de (0.15, 0.33).

8. En una Regresión logística simple si tenemos un coeficiente que multiplica a la variable independiente con un intervalo de confianza como el siguiente (0.34, 1.66), podemos afirmar:

            a. Que la Odds ratio no será significativa.

            b. Que la Odds ratio será significativa y mayor que 1.

            c. Que la Odds ratio será significativa y menor que 1.

            d. Que la Odds ratio será negativa.

9. En una V de Cramer no es cierto:

            a. Es un valor entre el 0 y el 1.

            b. Es una medida del grado de relación entre variables cualitativas.

            c. Es un valor que será significativo si es menor que 0.05.

            d. Cuanto mayor es indica más relación entre las variables cualitativas.

10. En los datos siguientes:

y

x

1

2

1

3

1

5

1

6

1

8

0

7

0

9

0

11

0

13

0

15

Podemos afirmar lo siguiente:

        a. La correlación de Pearson será negativa.

       b. En una Regresión logística simple el coeficiente que multiplica a la variable independiente será positivo.

         c. En una Regresión logística simple la Odds ratio será menor que 1.

         d. En una Regresión logística simple la Odds ratio será 0.

La Odds ratio en lingüística

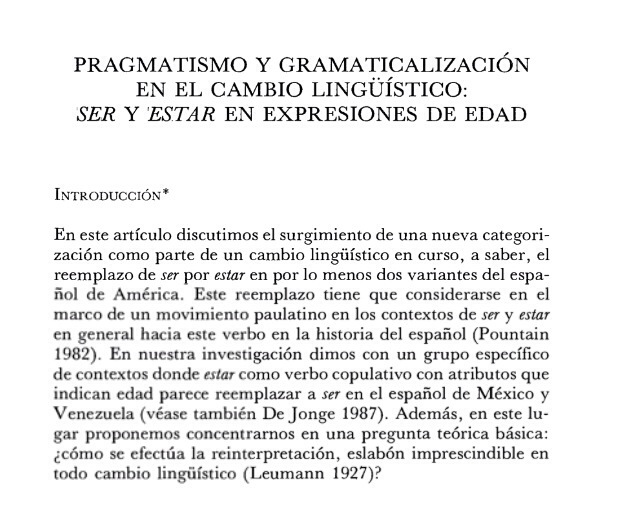
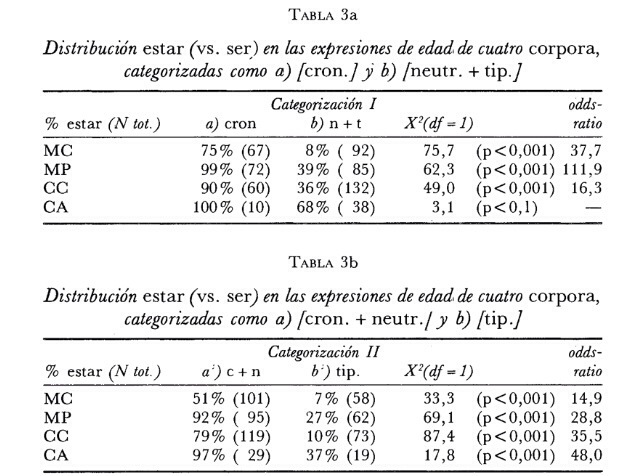
Como puede verse en los siguientes artículos, en Lingüística se usa la Odds ratio. Y estoy convencido que se usaría más si se conociera más.

20140110-075428.jpg

20140110-075442.jpg

Captura de pantalla 2015-10-30 a las 8.25.50

Captura de pantalla 2015-10-30 a las 8.29.26Captura de pantalla 2015-10-30 a las 8.30.15

Para una explicación de la Odds ratio y sus posibilidades ver el Terma 9 y los artículos Factores de riesgo de accidente de automóvilLa Odds ratio, el riesgo relativo y sus intervalos de confianza y La Odds ratio como medida del riesgo o la protección ante la violencia de género.

La Odds ratio como medida del riesgo o de la protección ante la violencia de género

En Medicina es muy usual el uso de la Odds ratio. Sin embargo, es sorprendente ver que en ciertos ámbitos no se usa en absoluto.
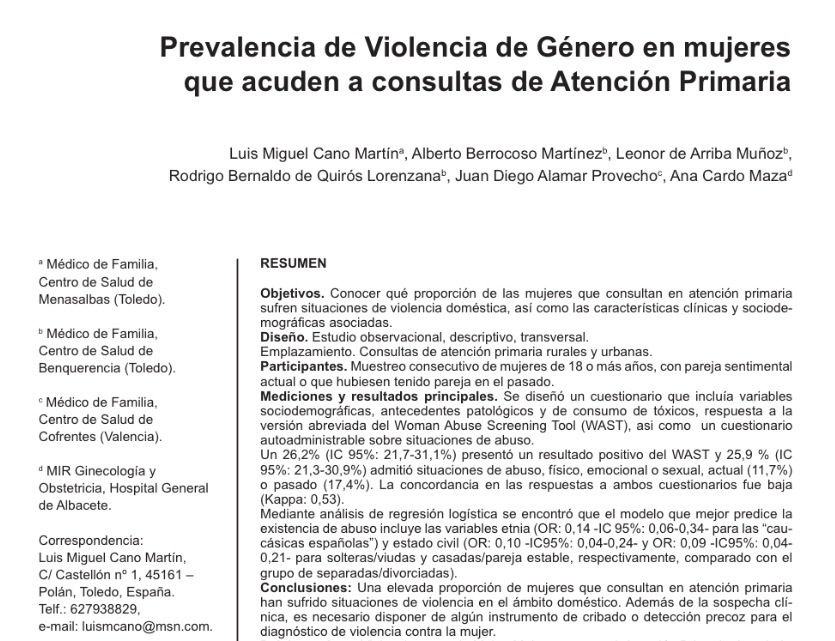
El artículo del que a continuación muestro el abstract es una interesante muestra para ver que estamos ante un concepto general con una utilidad amplísima.

20140109-174838.jpg

Observemos especialmente los valores siguientes:

OR=0.14 (IC 95%=(0.06, 0.34)). Esta Odds ratio cuantifica y estima la asociación entre ser caucásica y sufrir violencia de género. Respecto a no ser caucásica. Al ser una Odds ratio menor que 1 y significativa (el intervalo de confianza no incluye al 1), podemos decir que ser caucásica relativamente a no serlo es un factor de protección. Evidentemente, no serlo es un factor de riesgo, claro.

OR=0.10 (IC 95%=(0.04, 0.24)). Esta Odds ratio cuantifica la asociación entre ser soltera o viuda respecto a ser separada o divorciada. Se trata de un factor de protección, lo primero. Además, como es 0.1 podemos decir que se estima que estar separada o divorciada es un riesgo 10 veces mayor de sufrir violencia de género, respecto a ser soltera o viuda.

OR=0.09 (IC 95%=(0.04, 0.21)). Esta Odds ratio cuantifica la asociación entre ser casada o tener pareja estable respecto a ser separada o divorciada. Se trata de un factor de protección, también, lo primero. Además, como es 0.09, que es casi 0.1, como antes, podemos decir que se estima que estar separada o divorciada es, también, un riesgo 10 veces mayor de sufrir violencia de género, respecto a estar casada o con pareja estable. O, dicho de otro modo, que estar casada o en pareja estable es un factor de protección 10 veces mayor que estar separada o divorciada.

Para ver el cálculo de la Odds ratio, ver el tema Tema 9 de esta blog, o ver el tema La Odds ratio y el Riesgo relativo y sus intervalos de confianza.

Factores de riesgo de accidente de automóvil

Se ha publicado un muy interesante estudio, en Enero de 2014, sobre los factores de riesgo asociados a un accidente de automóvil.

El estudio lo ha publicado la revista «The New England Journal of Medicine». Y es un estudio ciertamente original. La metodología seguida es muy interesante.

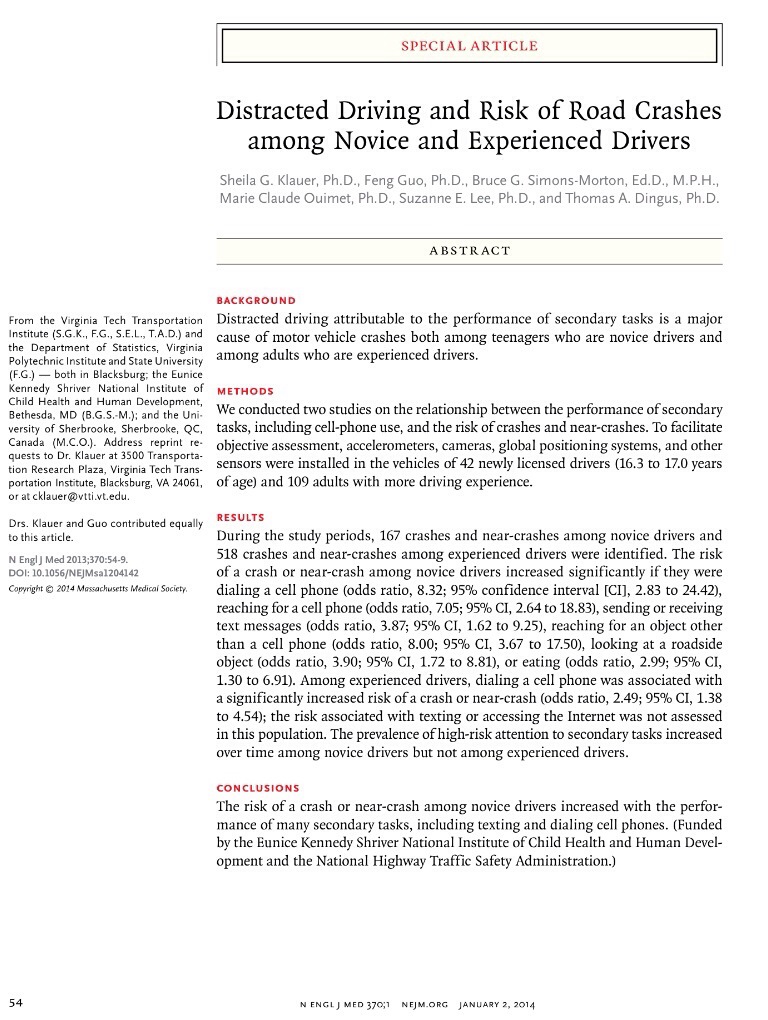
El abstract del artículo es el siguiente:

20140102-232723.jpg

Se ha puesto cámaras en el automóvil de conductores expertos y de conductores con poca experiencia. Cámaras que registraban comportamientos en el interior del vehículo. De esta forma se ha podido analizar diferentes factores y su asociación con el accidente.

Es sorprendente y didácticamente muy útil este artículo. En primer lugar por ser una forma de analizar una situación importante y hacerlo de una forma que realmente permite cuantificar un riesgo en su medida real. Todos sabemos que buscar el móvil conduciendo es un riesgo de accidente. La ventaja es que ahora lo tenemos cuantificado. Pero, por otro lado, este artículo es un paradigma de lo que es la investigación médica en el ámbito clínico. En clínica buscamos factores de riesgo tratando de cuantificarlos. Buscamos si hay asociación, y, si la hay, cuánta, entre un determinado factor y tener o no una determinada enfermedad. Buscamos también asociación, en personas que tengan una determinada enfermedad, entre dos tratamientos distintos y morir o no antes de salir del Hospital, o morir o no al año.

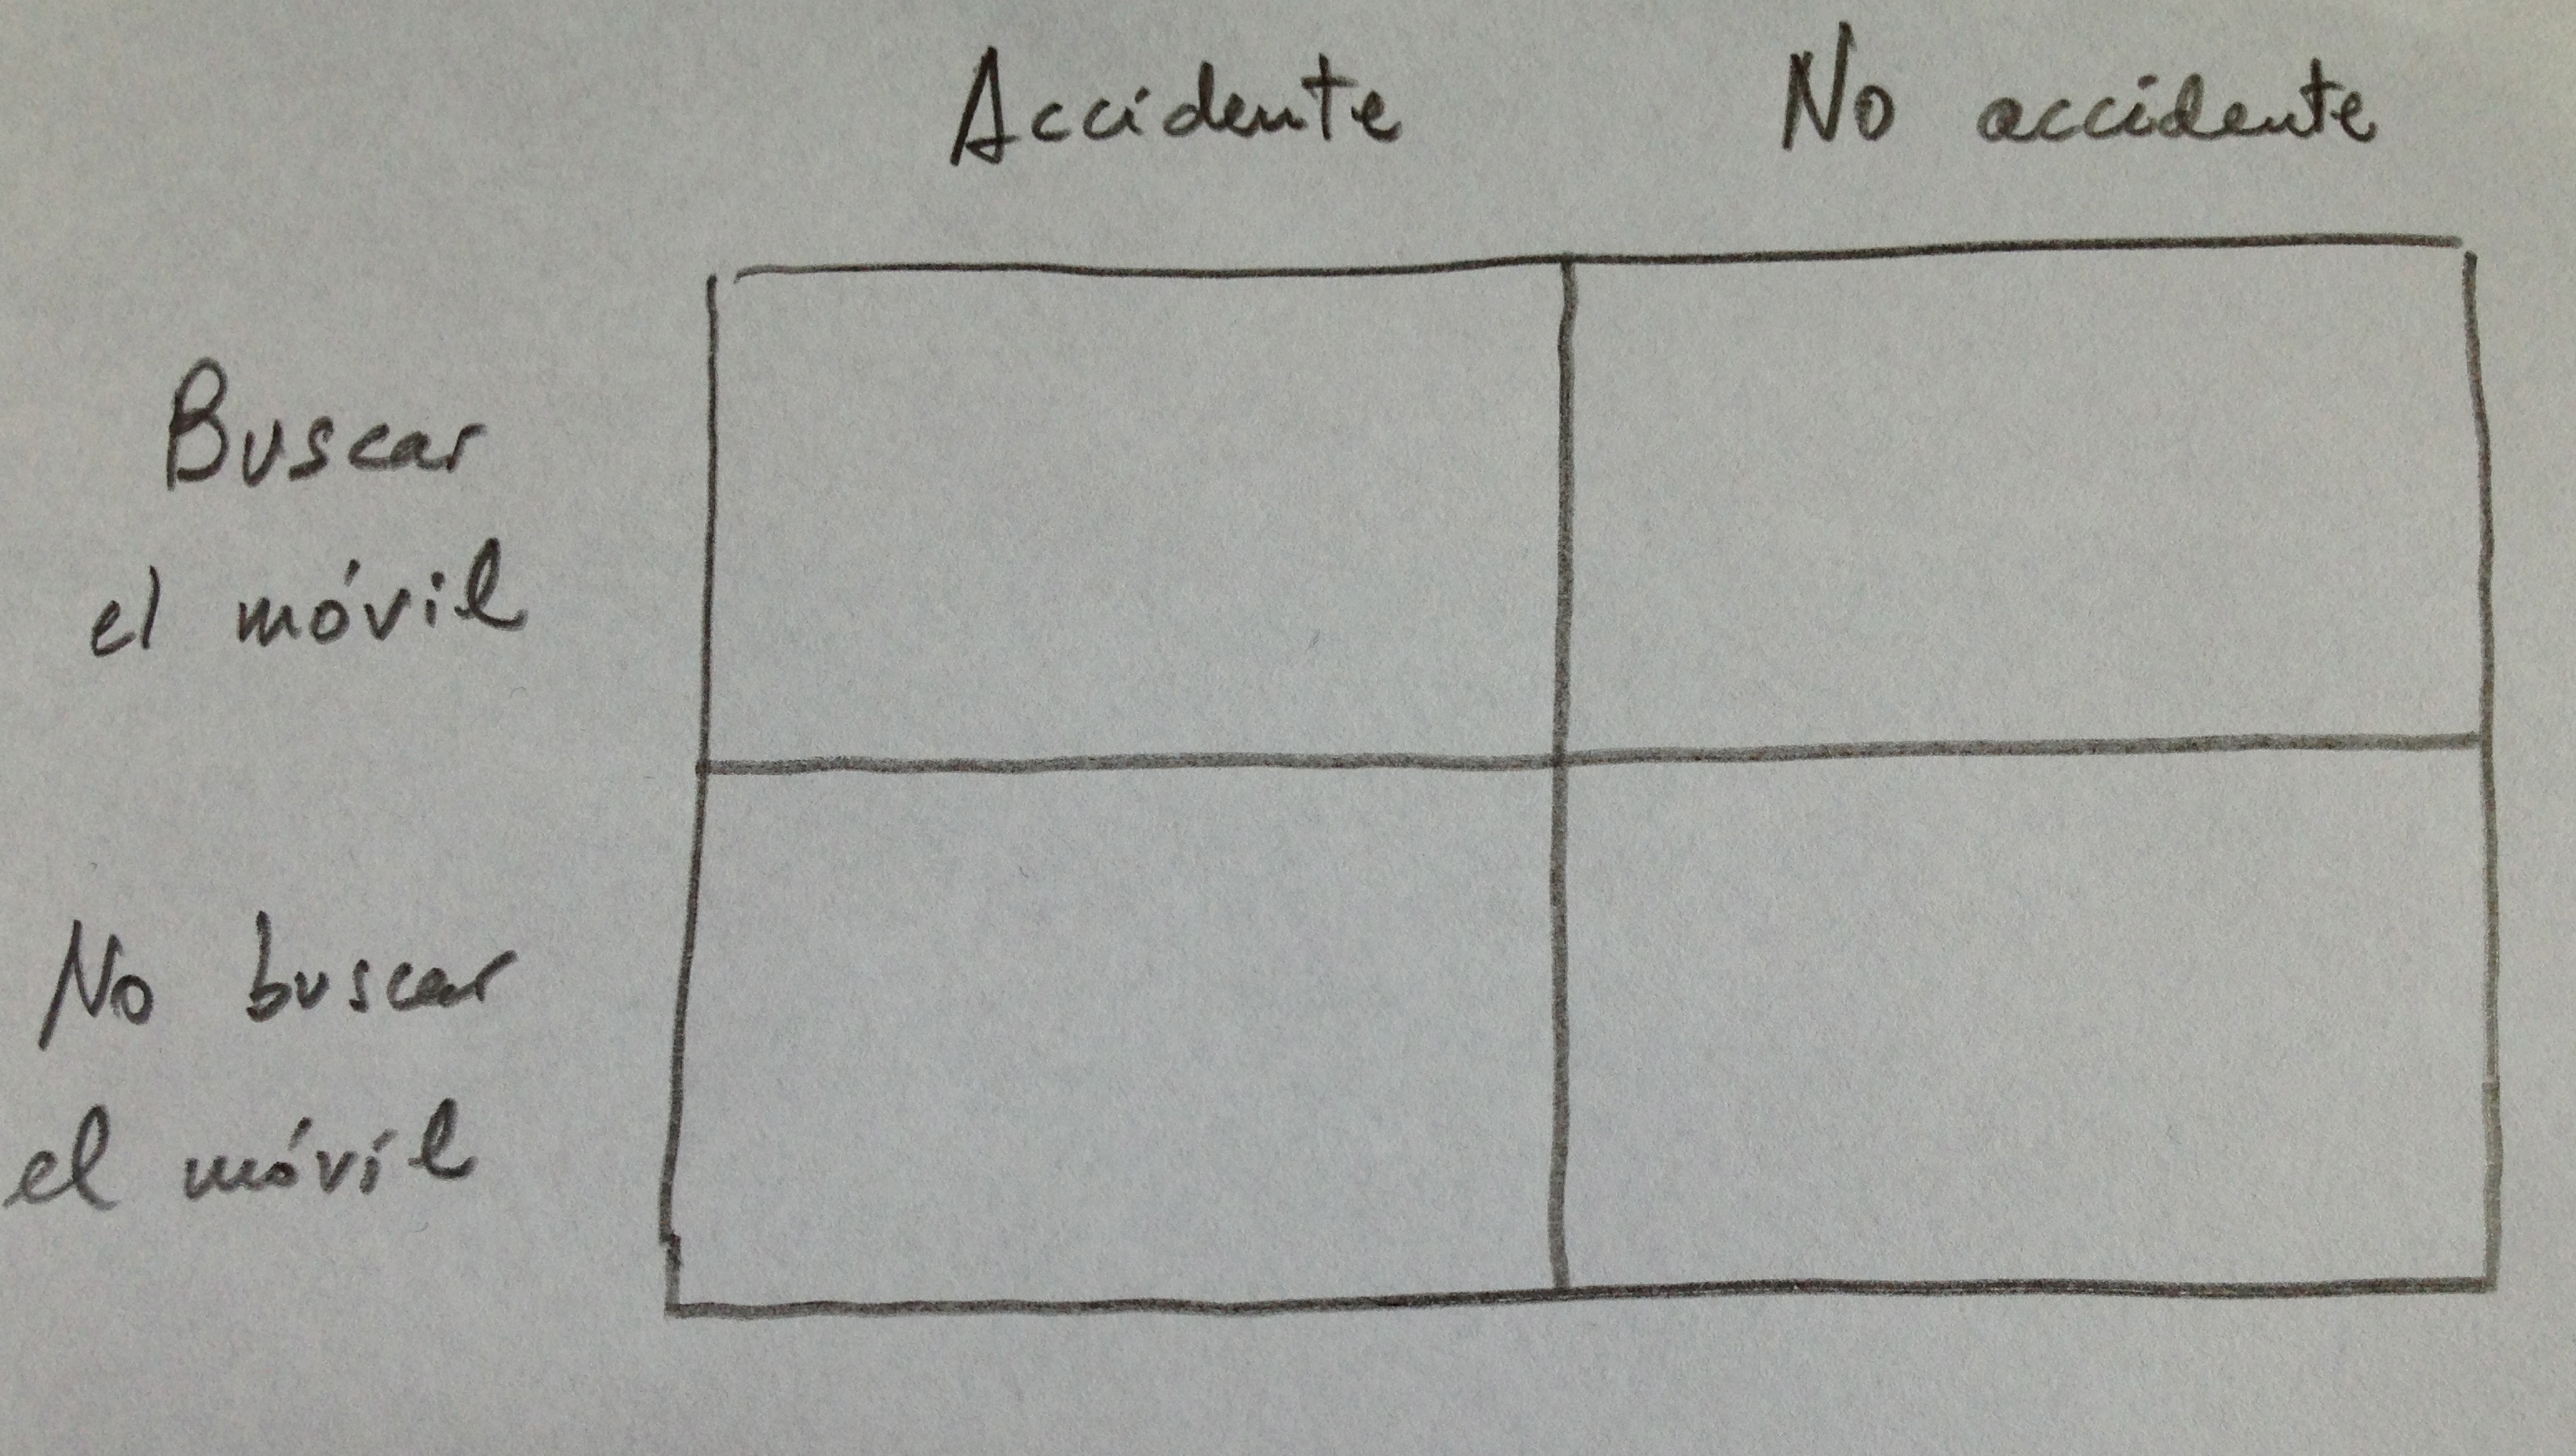
Pues aquí se hace lo mismo pero los factores de riesgo analizados son buscar el móvil, comer, hablar por el móvil, etc, y el tener un accidente. Y necesitamos tener datos, para cada uno de estos factores, datos de las cuatro situaciones posibles. Por ejemplo, en el caso de la búsqueda de la relación entre la búsqueda del móvil en el interior del coche y un accidente se pueden dar las siguientes situaciones posibles: Buscar el móvil con accidente asociado. Buscar el móvil sin accidente. No buscar el móvil con accidente. No buscar el móvil sin accidente. Esquemáticamente tendríamos esto:

IMG_7616

Obsérvese que esto es como cuando buscamos la asociación entre fumar y cáncer de pulmón. Tenemos también estas mismas cuatro situaciones. Ahora serían: Fumar y tener cáncer de pulmón. Fumar y no tener cáncer de pulmón. No fumar y tener cáncer de pulmón. No fumar y no tener cáncer de pulmón.

En este sentido este artículo puede ser una forma extraordinaria de explicar lo que se hace habitualmente en la investigación clínica a personas que trabajan en ámbitos muy diferentes.

Es interesante, también, que este artículo se haya publicado en la más prestigiosa revista de Medicina, siendo un tema -entiendo- no materialmente médico, pero sí formalmente. Es un artículo que no siendo de Medicina se ha trabajado con mirada y con los procedimientos estadísticos habituales de la Medicina.

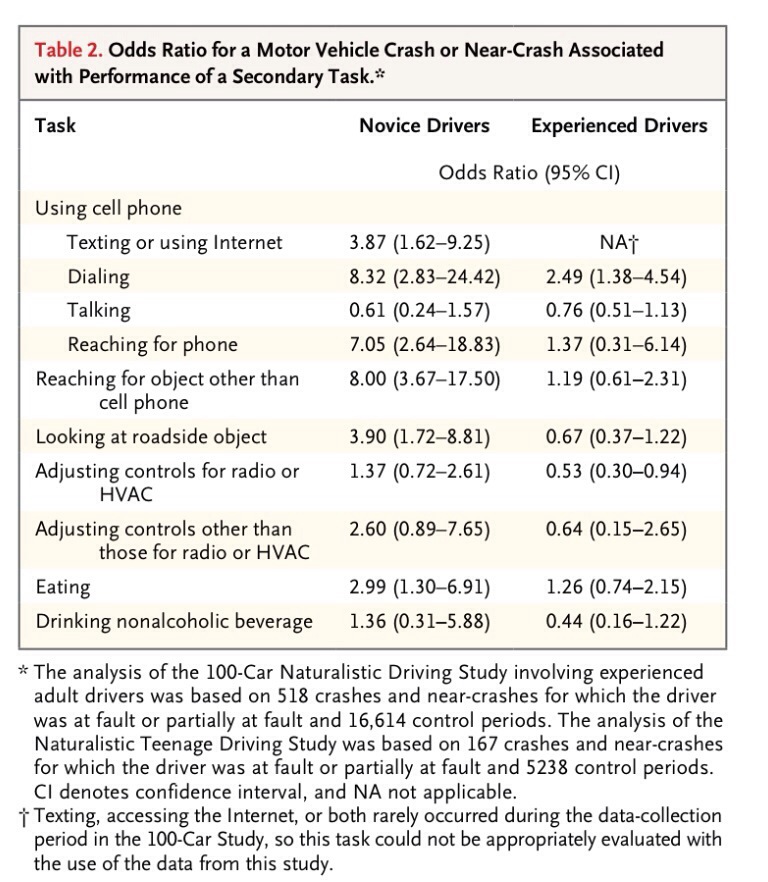
En el estudio la tabla principal de resultados es la siguiente:

20140102-232739.jpg

Puede verse en esta tabla las Odds ratio y los intervalos de confianza obtenidos para cada uno de los factores de riesgo estudiados.

Para ver cómo se calculan estas Odds ratio y sus intervalos de confianza se puede consultar el artículo La Odds ratio y el Riesgo relativo y sus intervalos.

Por ejemplo, si tomamos el caso de buscar un móvil mientras se conduce, para el que han encontrado una Odds ratio de 7.05, podríamos tener unos datos como los siguientes:

IMG_7617

Con estos datos, si vamos al artículo citado donde se ve cómo se realiza el cálculo de la Odds ratio, podremos comprobar que la Odds ratio sería 7. Lo que significa que se tiene 7 veces más accidentes buscando móvil que sin buscarlo: 1 respecto a 2 es 7 veces mayor que 10 respecto a 140; o sea: (1/2)/(10/140) es 7.

Sin embargo, en este caso, si calculamos el intervalo de confianza del 95% nos da un intervalo que es el siguiente: (0.58, 83.98). Como el 1 está dentro del intervalo se entiende que se trata de una Odds ratio no significativa.

Si, por el contrario, nuestros datos fueran los siguientes:

IMG_7618

Seguiríamos teniendo una Odds ratio de 7, porque la relación es la misma porque he añadido un cero en cada celdilla, pero ahora el intervalo de confianza del 95% sería uno bien diferente: (3.19, 15.36). Ahora al no contener el 1 podemos hablar de una Odds ratio significativa y, si observamos los datos de la tabla del artículo, vemos que la amplitud del intervalo es similar a éste.

Solución Situación 50

1. Las correlaciones entre las tres variables cuantitativas que tenemos son las siguientes:

IMG_7580

Como puede observarse se trata de tres correlaciones significativas. El p-valor, en los tres casos, es menor que 0.05. Hay una correlación positiva (entre el Tiempo de visualización y el Número de paradas) y hay dos correlaciones negativas (entre Tiempo de visualización y Velocidad y entre Velocidad y Número de paradas). Correlaciones que, si las pensamos un poco, son lógicas.

2. La regresión lineal simple entre la variable Número de paradas y la variable Tiempo de visualización nos proporciona un gráfico como el siguiente:

IMG_7581

La estimación de los parámetros del modelo (La pendiente y la ordenada en el origen) son los siguientes:

IMG_7582

Con este modelo podemos predecir el número de paradas en función del tiempo de visualización. Con una R cuadrado del 71.44%, que es bastante buena.

3. Al relacionar las variables cualitativas Sexo y Relacionado con el mundo del Arte obtenemos la siguiente tabla de contingencias:

IMG_7584

La ji-cuadrado aplicada a esta tabla de contingencias es la siguiente:

IMG_7583

Por lo tanto, como el p-valor es superior a 0.05 no podemos decir que haya relación entre ambas variables.

4. Para resolver este problema debemos hacer una Regresión logística simple de la variable dicotómica «Relacionado con el mundo del Arte» con cada una de las variables cuantitativas que tenemos. Evidentemente se podría hacer también una Regresión logística múltiple y ver con un Stepwise cuál es el modelo final elegido. Pero vamos a hacer aquí, porque nos irá bien a efectos didácticos, tres regresiones logísticas simples y seleccionaremos la que nos ajuste un modelo más predictivo.

Veamos primero la relación con la variable Tiempo de visualización:

IMG_7585

Y hecho con otro software que nos dibuja la Regresión logística obtenemos esta salida de ordenador:

IMG_7589

Es interesante comprobar que, aunque los resultados fundamentales son paralelos, son los mismos, la salida de ordenador que nos proporciona cada software tiene su singularidad. Por ejemplo, la del primer software (El G-Stat 2.0) nos da una algo peculiar: una prueba de clasificación. Aplica el criterio creado con esta muestra para establecer una clasificación entre los dos tipos de variable dependiente dicotómica a la muestra que, en realidad, ya sabe qué valor tiene cada individuo de esa variable respuesta. De esta forma puede comparar lo que haría con lo verdadero y, así, establecer una calidad de clasificación. En este caso nos da una buena clasificación del 85%.

El segundo software (El Statgrafics) nos ofrece algo muy visual: el gráfico. El gráfico donde se ven donde quedan los valores muestrales y cuál sería la curva construida como probabilidad de predicción de cada uno de los dos estados posibles de la variable dependiente dicotómica.

Es bueno combinar diferentes softwares, si es posible, porque cada uno tiene sus elementos de interés que nos ayuda a perfilar las conclusiones finales.

Veamos ahora la relación con la variable Velocidad media del ojo:

IMG_7586

Y con el otro software:

IMG_7590

Y, finalmente, veamos la relación con la variable Número de paradas:

IMG_7588

Y con el otro software:

IMG_7591

Es interesante comprobar que se trata de una elección no clara. Las tres variables pueden ser usadas como predictoras. Las tres tienen una relación significativa con la variable dicotómica «Relacionado con el Arte».

Si elegimos por la calidad de la clasificación debemos elegir la variable independiente «Velocidad media del ojo». Si elegimos por la prueba de la verosimilitud debemos elegir, en este caso, la variable «Tiempo de visualización».

En todo caso estamos en una situación difícil donde ambas variables podrían ser elegidas. Están en una posición muy paralela. De hecho, es lógico que sea así, el que la correlación entre ellas sea tan grande lo que indica es que en gran parte son variables intercambiables.

Solución Situación 51

1d:

Antes de la aplicación de un test estadístico no podemos decir si la diferencia que vemos es o no significativa. El test es el que nos dará el p-valor, la significación, no los valores de porcentajes que hemos calculado a las muestras.

2d:

La «a» no puede ser porque si nos dicen que la ji.cuadrado ha dado resultado significativo el p-valor debe ser menor que 0.05, no mayor.

La «b» tampoco lo es porque hemos hablado de dos variables cualitativas no de que cada variable cualitativa tenga dos valores posibles, que es lo que nos llevaría a tener una tabla de contingencias de 2×2.

La «c» también es incorrecta. El concepto de relación positiva y negativa es exclusivo de la relación entre variables cuantitativas. Nunca se usa en variables cualitativas.

Lo que dice la «d» efectivamente es cierto: El valor de la V de Cramer sólo tiene sentido evaluarlo, considerarlo, si la ji-cuadrado

3a:

La «b» es absurda, evidentemente.

La «d» también es fácilmente descartable porque es evidente que no estamos ante una variable dicotómica, sino que estamos ante una variable continua.

Respecto a la «a» y la «c». Observemos que nos piden cuál es la respuesta más razonable. La «a» es más razonable que la «c». Por lo siguiente: En la «c» se afirma categóricamente que las notas son una distribución normal, cosa que no es verdad, en general. Y menos si uno observa los datos que nos da el problema de la muestra de estudiantes franceses donde se observa claramente la distribución no normal, no de campana de Gauss. Es cierto que esto debe comprobarse con un test de ajuste a la distribución normal, pero parece claro lo que nos dará un test como este (por ejemplo, el Test de Shapiro-Wilk). La respuesta «a» es, pues, más razonable. Nos dice que aplicaremos un Mann-Whitney porque se aprecia una no normalidad de una de las dos muestras. Es verdad que esta no normalidad la debemos comprobar siempre pero es cierto que aquí parece muy claro lo que nos dará.

4b:

Una pista no nos debe hacer dudar de cuál es la respuesta correcta: Correlación positiva va siempre asociado a una regresión con pendiente positiva. Correlación negativa va siempre asociada a una regresión con pendiente negativa. La única regresión con pendiente negativa que tenemos aquí es la que nos da la respuesta «b».

5b:

No tenemos ninguna información que nos permita decir que el rango es 5.

Como 14 es el primer cuartil por debajo de este valor tenemos el 25% de los valores, no el 50%.

Entre 15 y 35 tenemos el mismo porcentaje de valores que entre 14 y 15: un 25%.

La más razonable es la b: la muestra parece no seguir una distribución normal. El hecho de que la mediana esté tan próxima al primer cuartil y tal alejada, relativamente, al tercer cuartil, muestra una enorme asimetría que romperá la distribución normal de la variable en esta muestra.

Situación 51: Examen (Temas 5-14)

1) Si tenemos una muestra de una población donde hay un 50% de mujeres y una muestra de otra población donde hay un 30% de mujeres, ¿qué afirmación es cierta?

a) Como hay una diferencia superior al 5% tenemos un p-valor inferior a 0.05.

b ) La diferencia no es estadísticamente significativa.

c) La diferencia es estadísticamente significativa pero de baja magnitud.

d) Deberíamos aplicar un test estadístico para comprobar la significación de esta diferencia.

2) Si nos dicen que hemos estudiado dos variables cualitativas y que mediante un test de la ji-cuadrado hemos comprobado la relación entre ellas y tenemos una V de Cramer de 0.9, ¿qué afirmación es cierta?

a) El p-valor de la ji-cuadrado es mayor que 0.05.

b) La tabla de contingencias con la que se ha trabajado es una tabla 2×2.

c) La relación entre estas dos variables es positiva.

d) El valor calculado por la V de Cramer sólo tiene sentido valorarlo si el p-valor de la ji-cuadrado es menor que 0.05.

3) Tenemos que comparar el nivel de conocimientos de castellano de 100 estudiantes de secundaria franceses con 100 estudiantes también de secundaria alemanes, evaluado en un examen común mediante una nota entre el 0 y el 10. Sabemos que en la muestra francesa el percentil 25 es un 0, el 50 es un 1 y el 75 es un 3 y la nota máxima un 9.95. ¿Qué respuesta parece más razonable?

a) Aplicaremos un test de Mann-Withney para comparar el nivel de conocimientos de castellano de ambas poblaciones porque la muestra de la que tenemos información (la muestra de los estudiantes franceses) no parece ajustarse, ni mucho menos, a una distribución normal.

b) El nivel de conocimientos de los estudiantes franceses es superior porque Francia está más cerca de España.

c) Aplicaremos un test de la t de Student porque las notas del 0 al 10 es una variable continua y siempre con distribución normal.

d) Aplicaremos un test de comparación de proporciones.

4) Si dos variables tienen una correlación de Pearson r=-0.8 (p<0.05), ¿cuál es el único modelo de regresión simple compatible con esta información?

a) y=7x+12

b) y=-5x+3

c) y=2x-12

d) Ninguno de los tres anteriores porque al ser la correlación no significativa no tiene sentido hacer una regresión.

5) Nos dicen que una variable cuantitativa queda descrita mediante los siguientes números: 15(14, 35), representando la mediana y el rango intercuartílico, expresado éste mediante el primer y tercer cuartil. ¿Qué respuesta es la más razonable?

a) El rango es 50.

b) La muestra no sigue una distribución normal.

c) En la muestra el 50% de individuos tienen un valor por debajo de 14.

d) Entre los valores de 15 y 35 tenemos el doble de individuos que entre 14 y 15.

Test de Hosmer y Lemeshow

El Test de Hosmer y Lemeshow es un test muy utilizado en Regresión logística. Se trata de un   test de bondad de ajuste al modelo propuesto. Un Test de bondad de ajuste lo que hace es comprobar si el modelo propuesto puede explicar lo que se observa. Es un Test donde se evalúa la distancia entre un observado y un esperado.

El Test básicamente consiste en dividir el recorrido de valores de la variable dependiente (0,1) en una serie de intervalos. Intervalos que contengan un número de observaciones suficientemente grande (5 ó más). Se trata, entonces, de contar intervalo por intervalo el esperado y el observado para cada uno de los dos resultados posibles de la variable dependiente dicotómica (tiene la enfermedad o no la tiene, es hombre o mujer, etc). El observado es lo que se tiene y el esperado es el valor esperado teórico calculado mediante el modelo construido. El estadístico es un estadístico de la ji-cuadrado, como el visto en el tema dedicado a la relación entre variables cualitativas. De hecho, buena parte de los test de bondad de ajuste a un modelo parten de esta idea de comparar lo observado con lo esperado.

Para ver cómo se aplica este importante test ver el artículo Aplicación del Test de Hosmer-Lemeshow en Medicina.