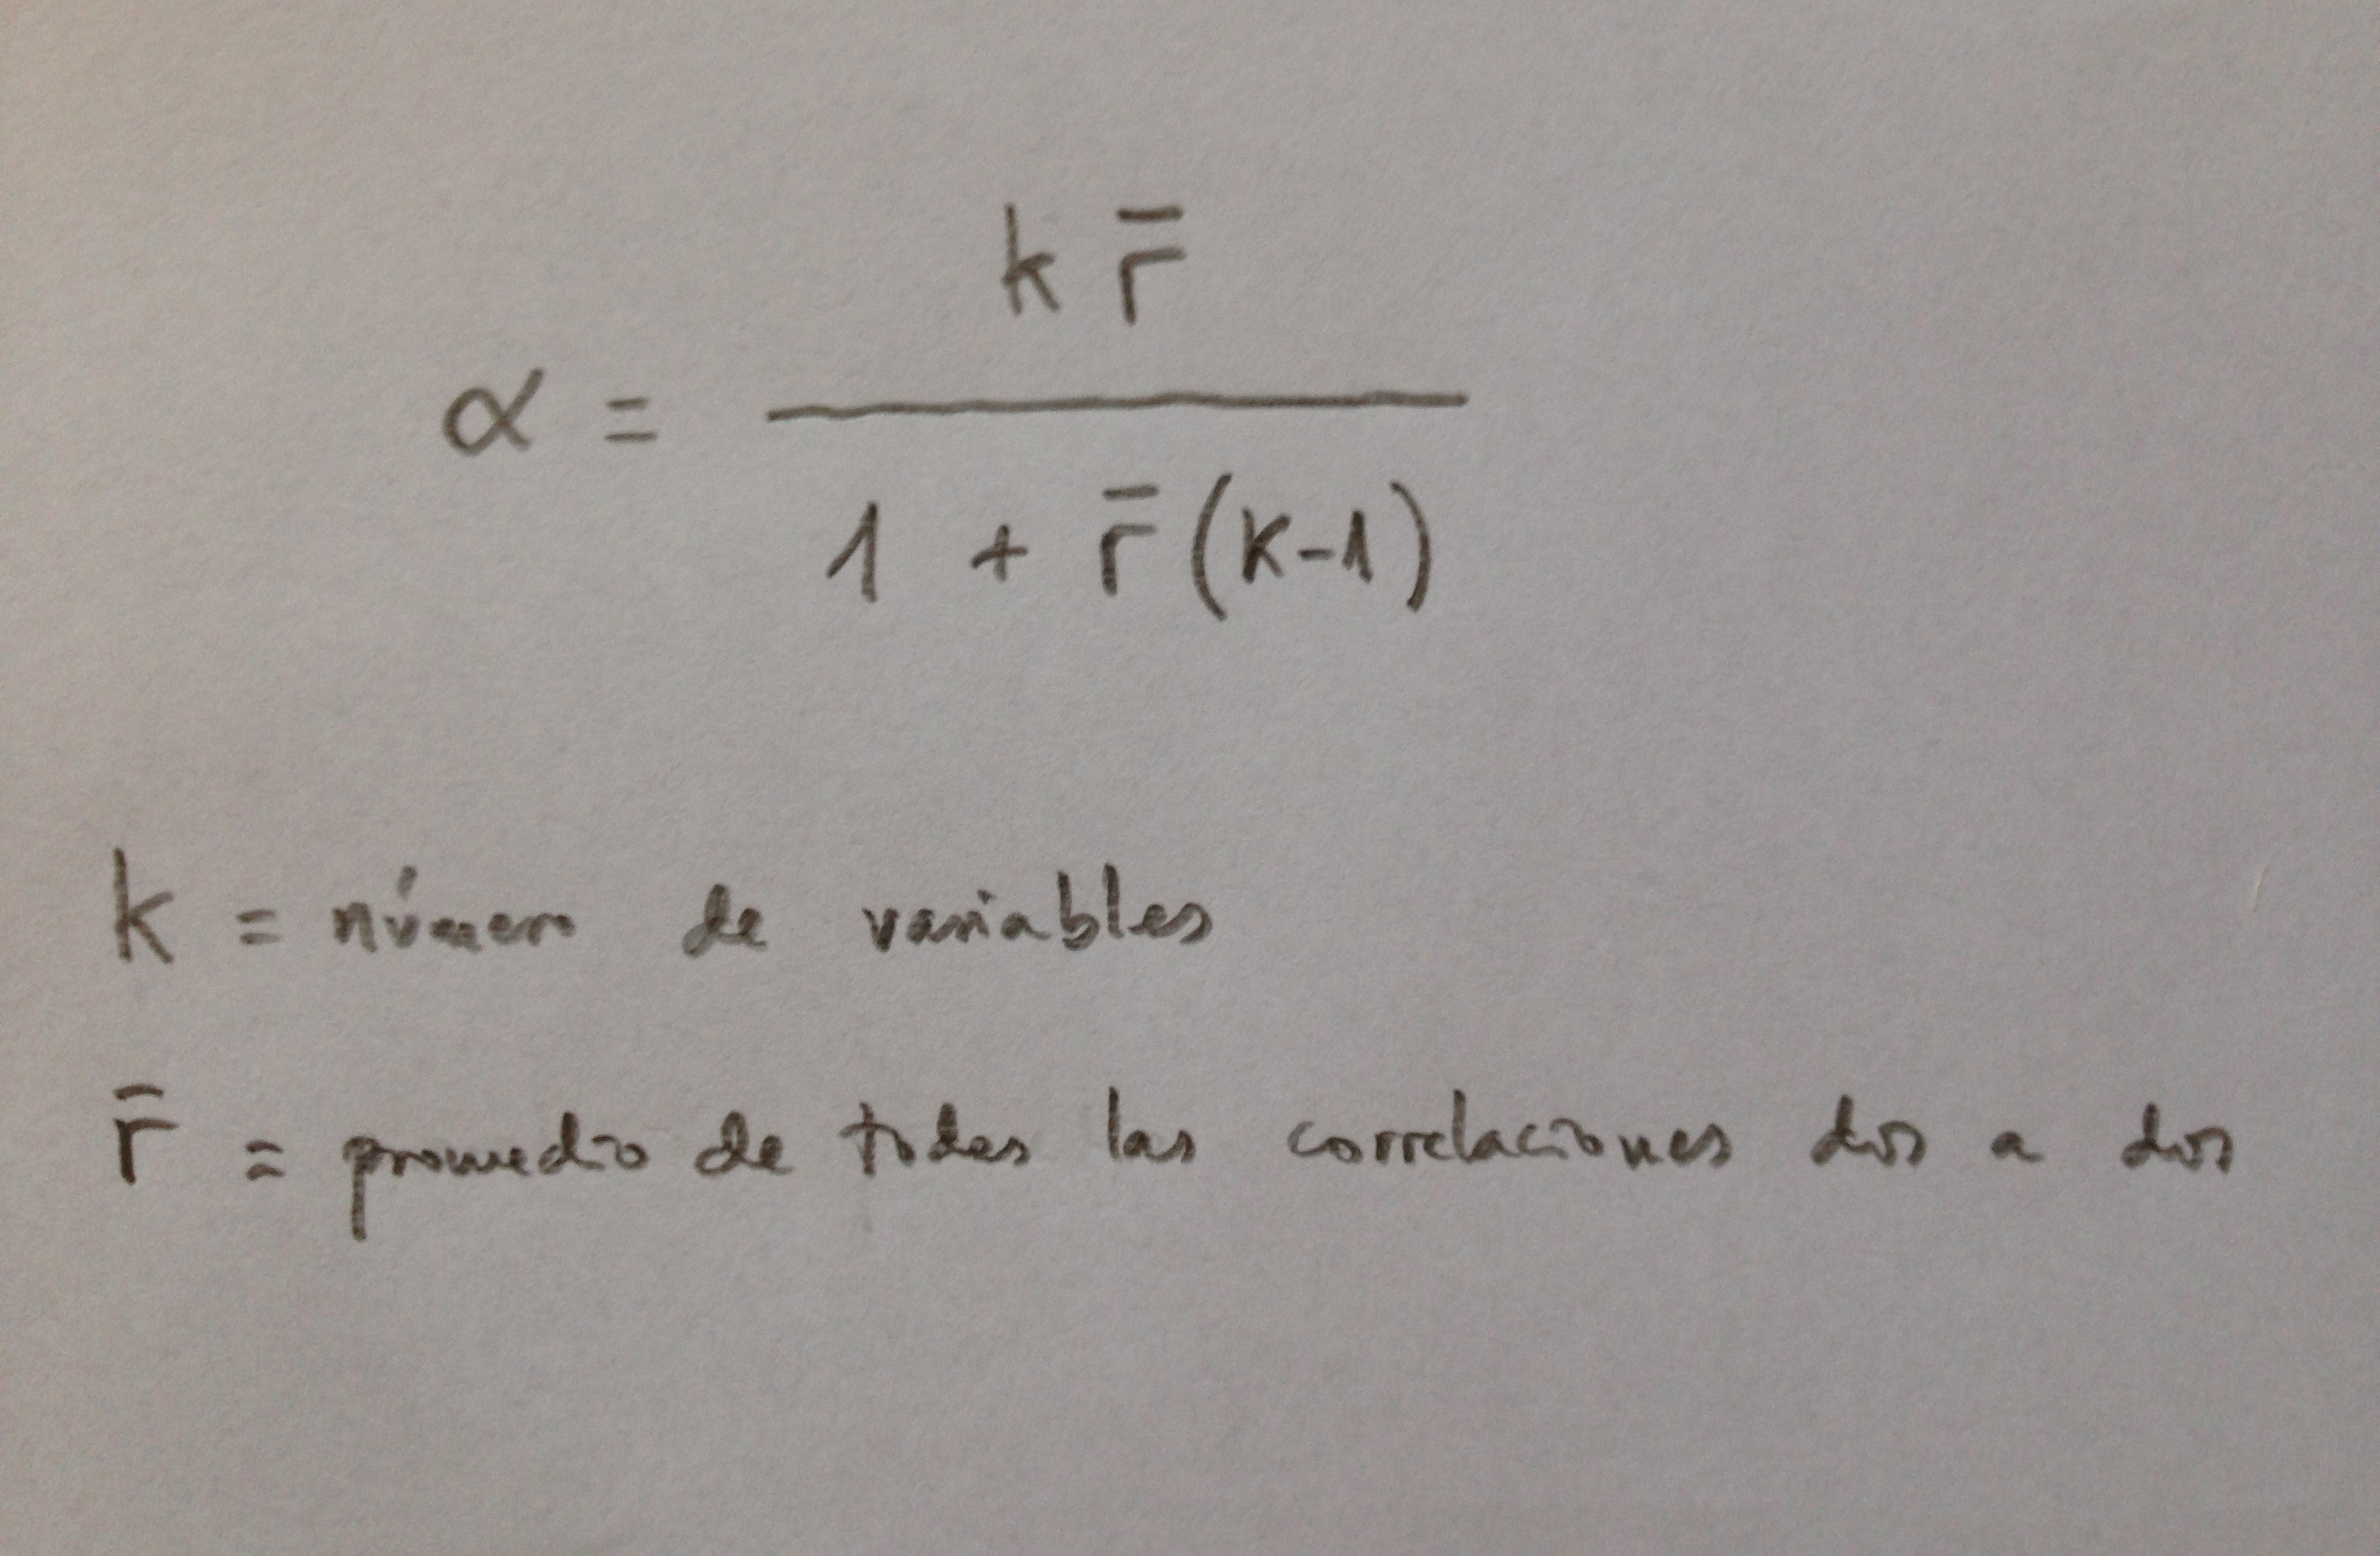Archivo del Autor: estadisticallopis

Exploración de una base de datos 9: Análisis factorial

A partir de nuestra base de datos adjunta del artículo Explotación de una base de datos 1: Base de datos podemos realizar Análisis factorial. Veamos algunos ejemplos:

1. Hacer un Análisis factorial con las variables P1, P2, P3, P4, P5, P6 y P7. Ver cuánta variabilidad explican los factores.

2. Hacer un giro de los ejes que consiga la máxima capacidad explicativa de los factores.

3. Representar los cien pacientes en ejes formados por los factores encontrados.

4. Proyectar en la representación de los ejes de los factores la variable P8.

5. Proyectar en la representación de los ejes de los factores la variable Cirugía.

6. Proyectar en la representación de los ejes de los factores la variable Sexo.

7. Proyectar en la representación de los ejes de los factores la variable Departamento.

SOLUCIONES

1. Hacer un Análisis factorial con las variables P1, P2, P3, P4, P5, P6 y P7. Ver cuánta variabilidad explican los factores:
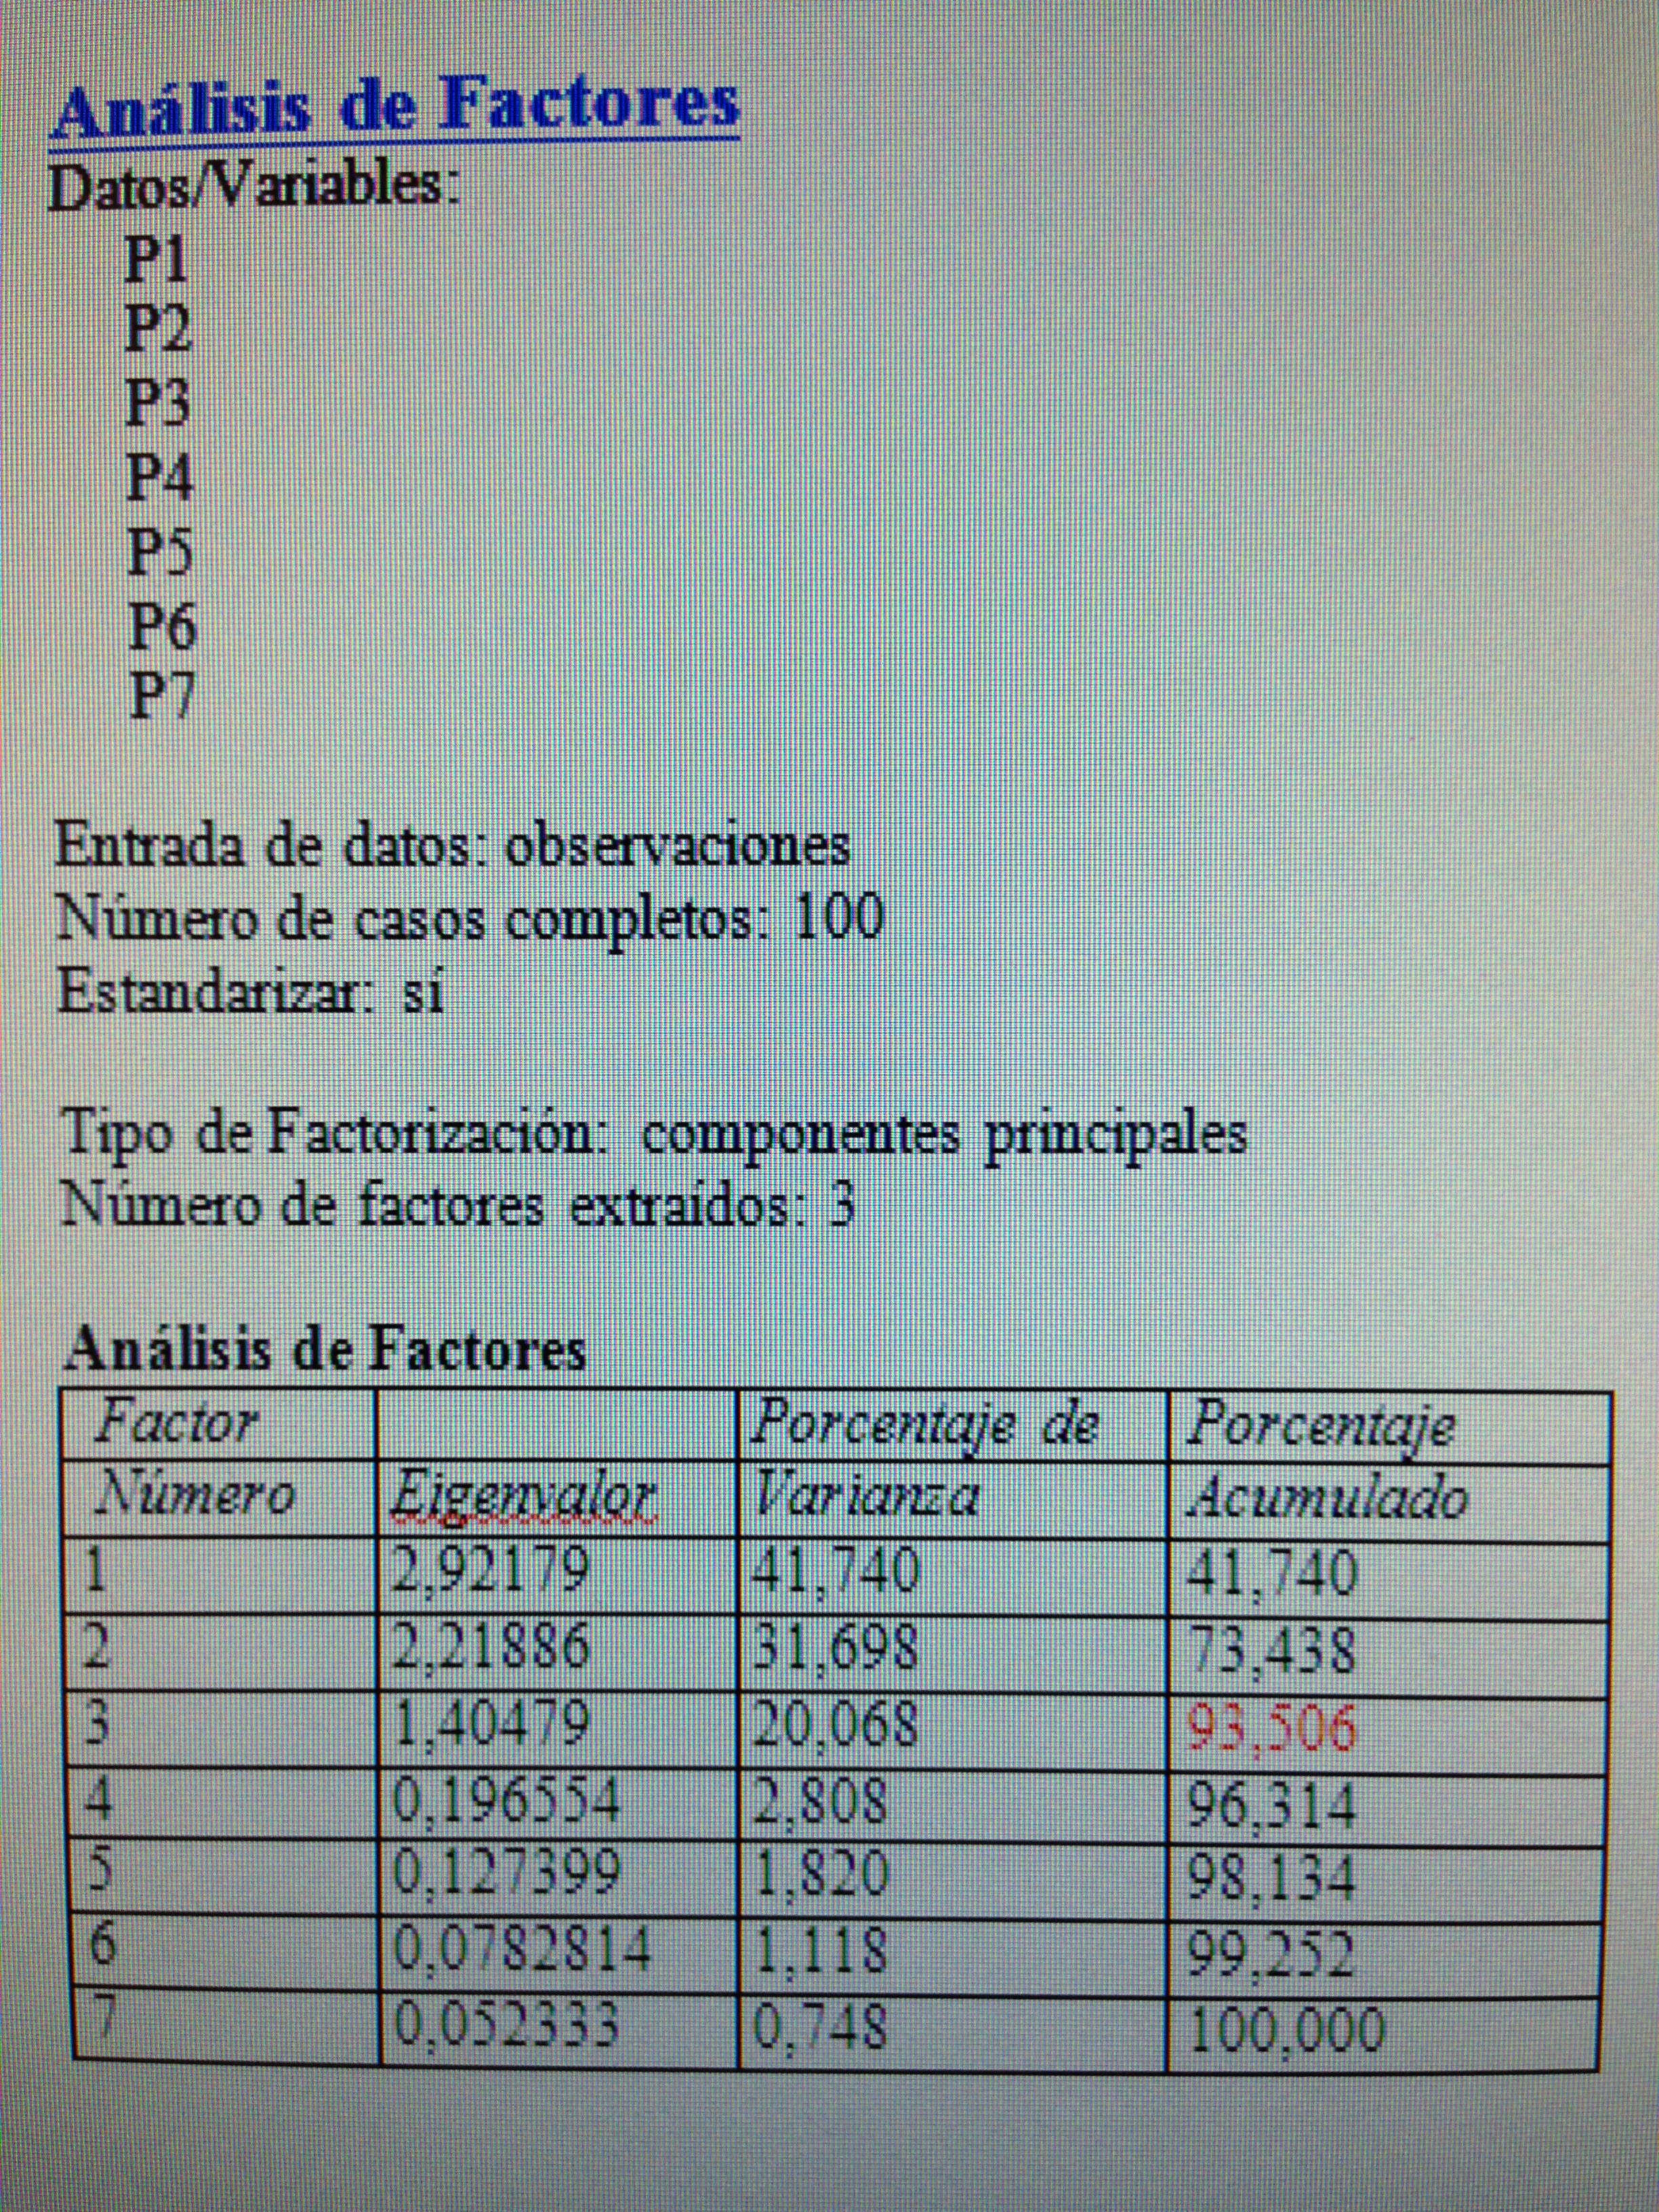
IMG_7739

Obsérvese que con tres factores explicamos un 93,5% de la información. Esto es mucho, realmente.

2. Hacer un giro de los ejes que consiga la máxima capacidad explicativa de los factores:
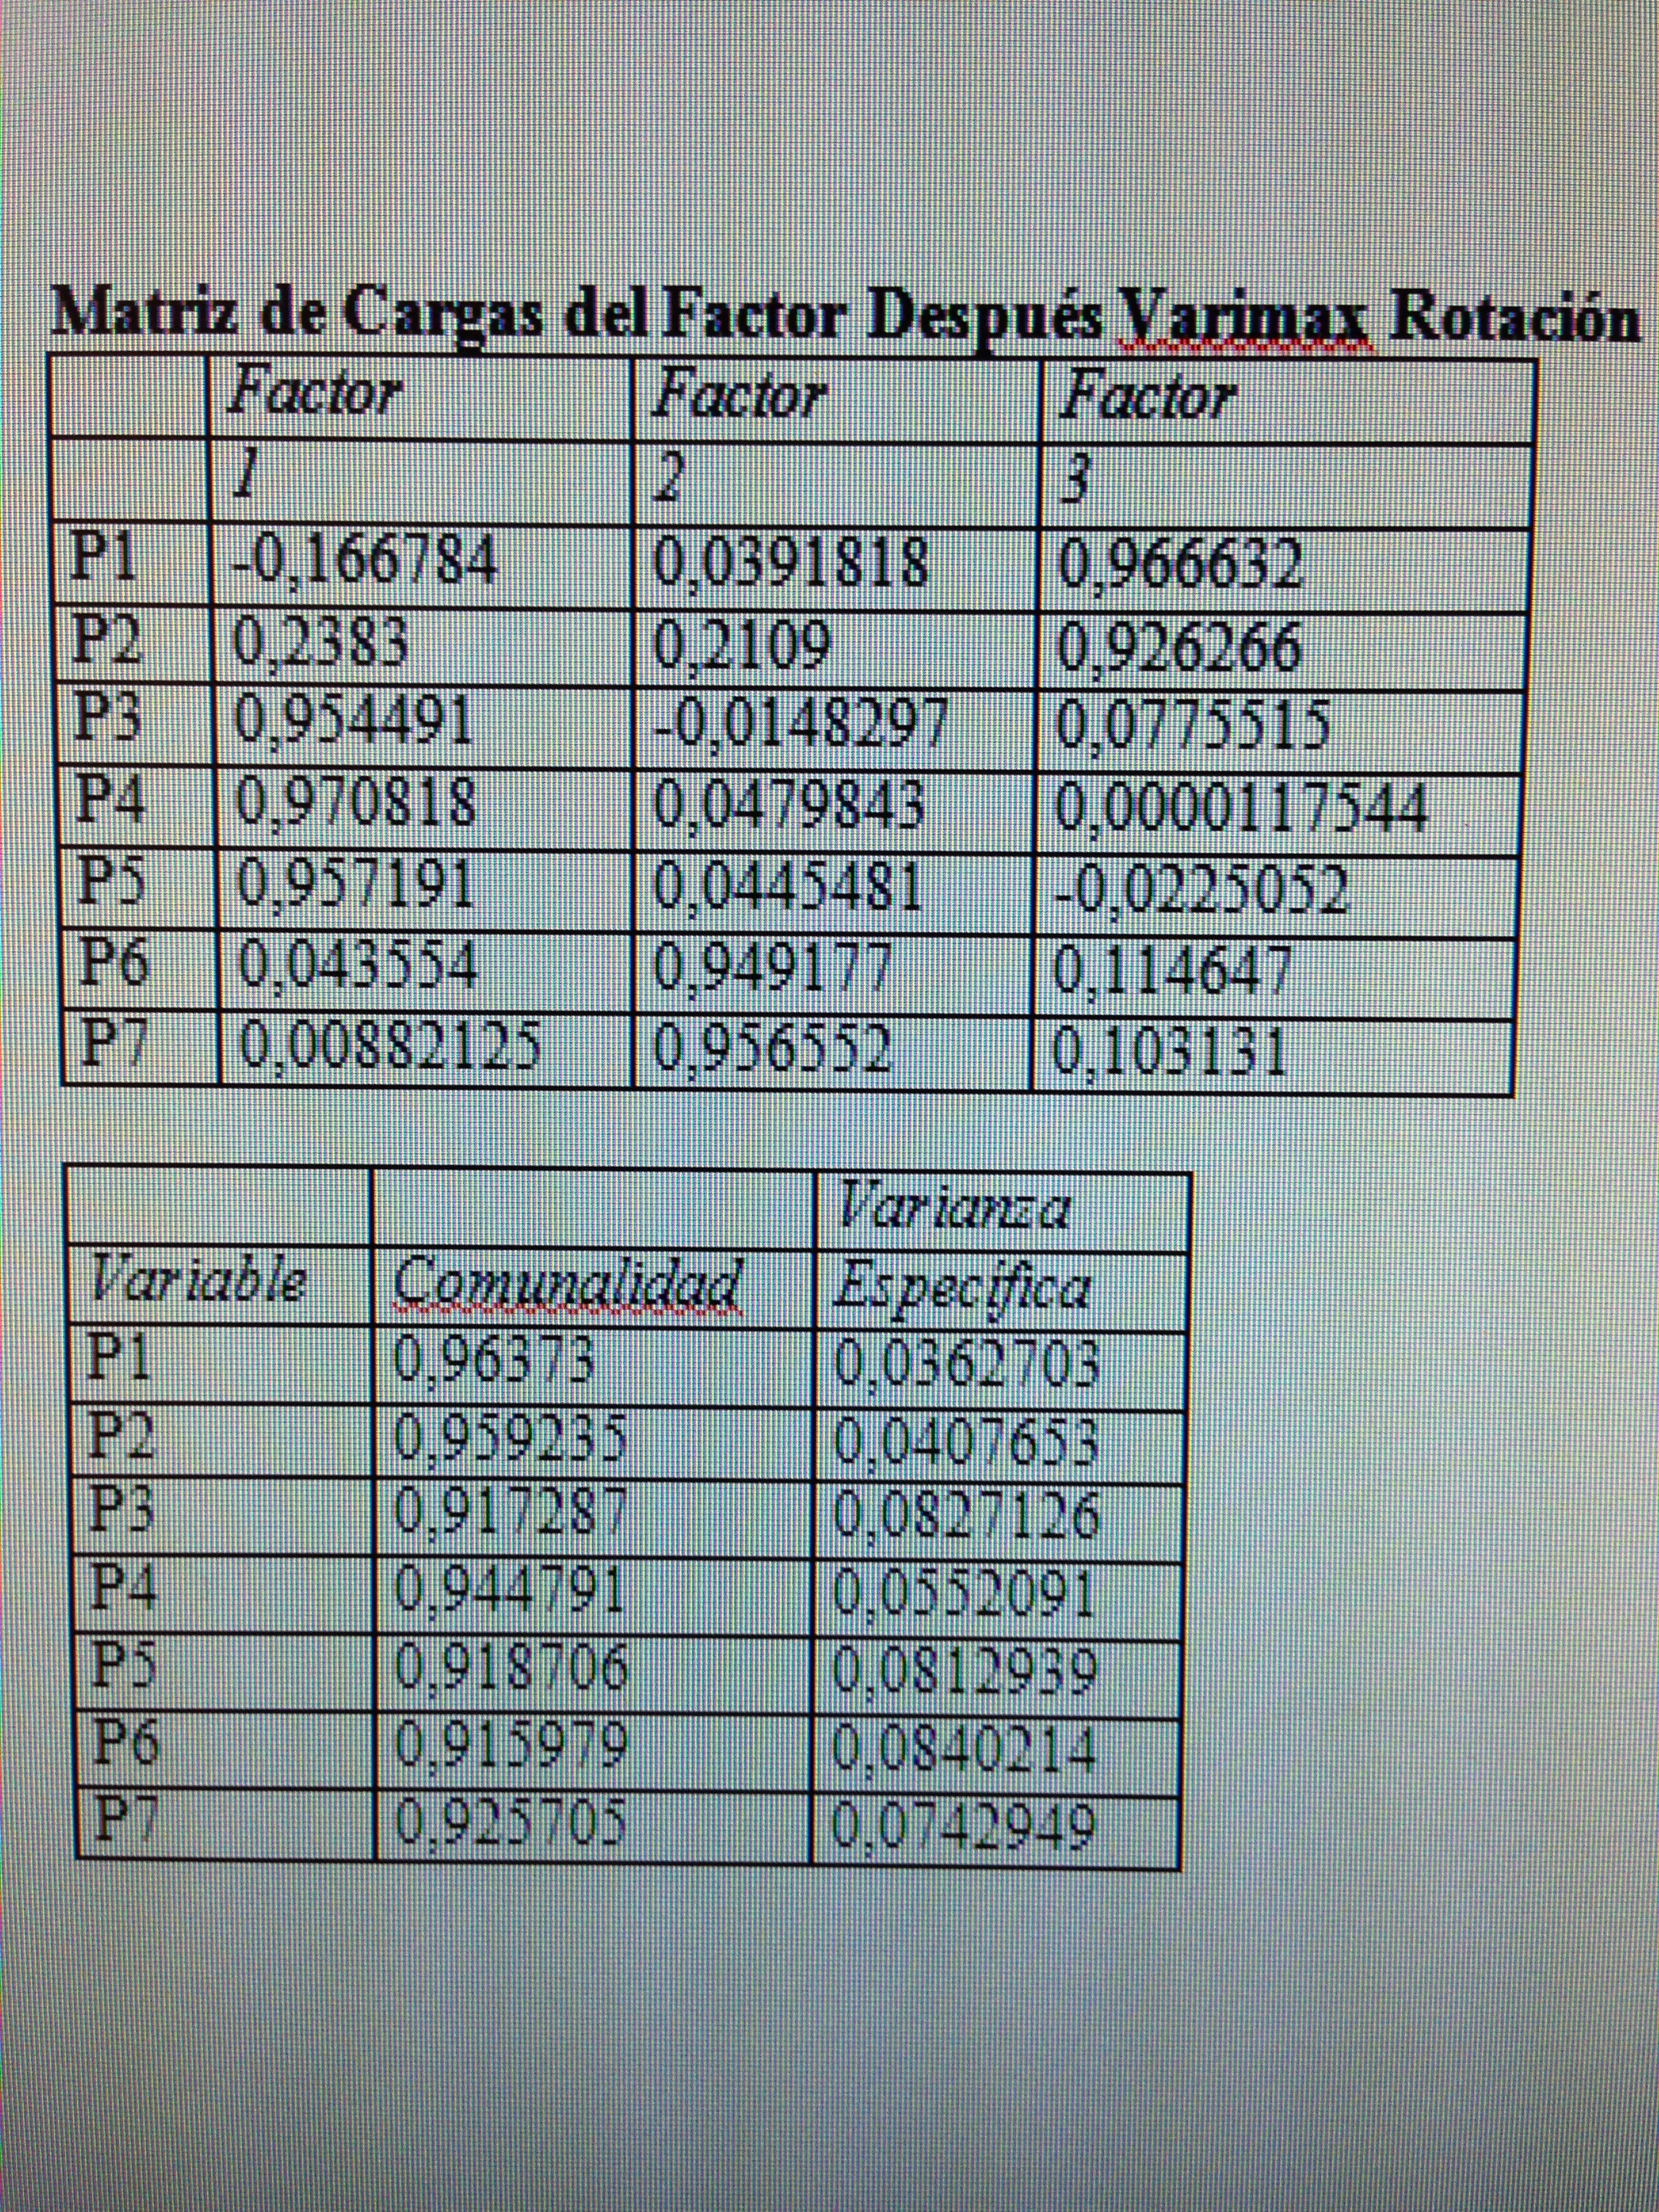
IMG_7740

Con la rotación variamax conseguimos realmente tres factores claramente delimitados. Observemos que en el primer factor las variables con peso son la P3, P4 y P5. En el segundo son P6 y P7. En el tercer factor son P1 y P2 las que tienen el protagonismo. Esto cuadra con lo que hemos visto al analizar las correlaciones en el fichero 3 de esta serie.

3. Representar los cien pacientes en ejes formados por los factores encontrados:

IMG_7741

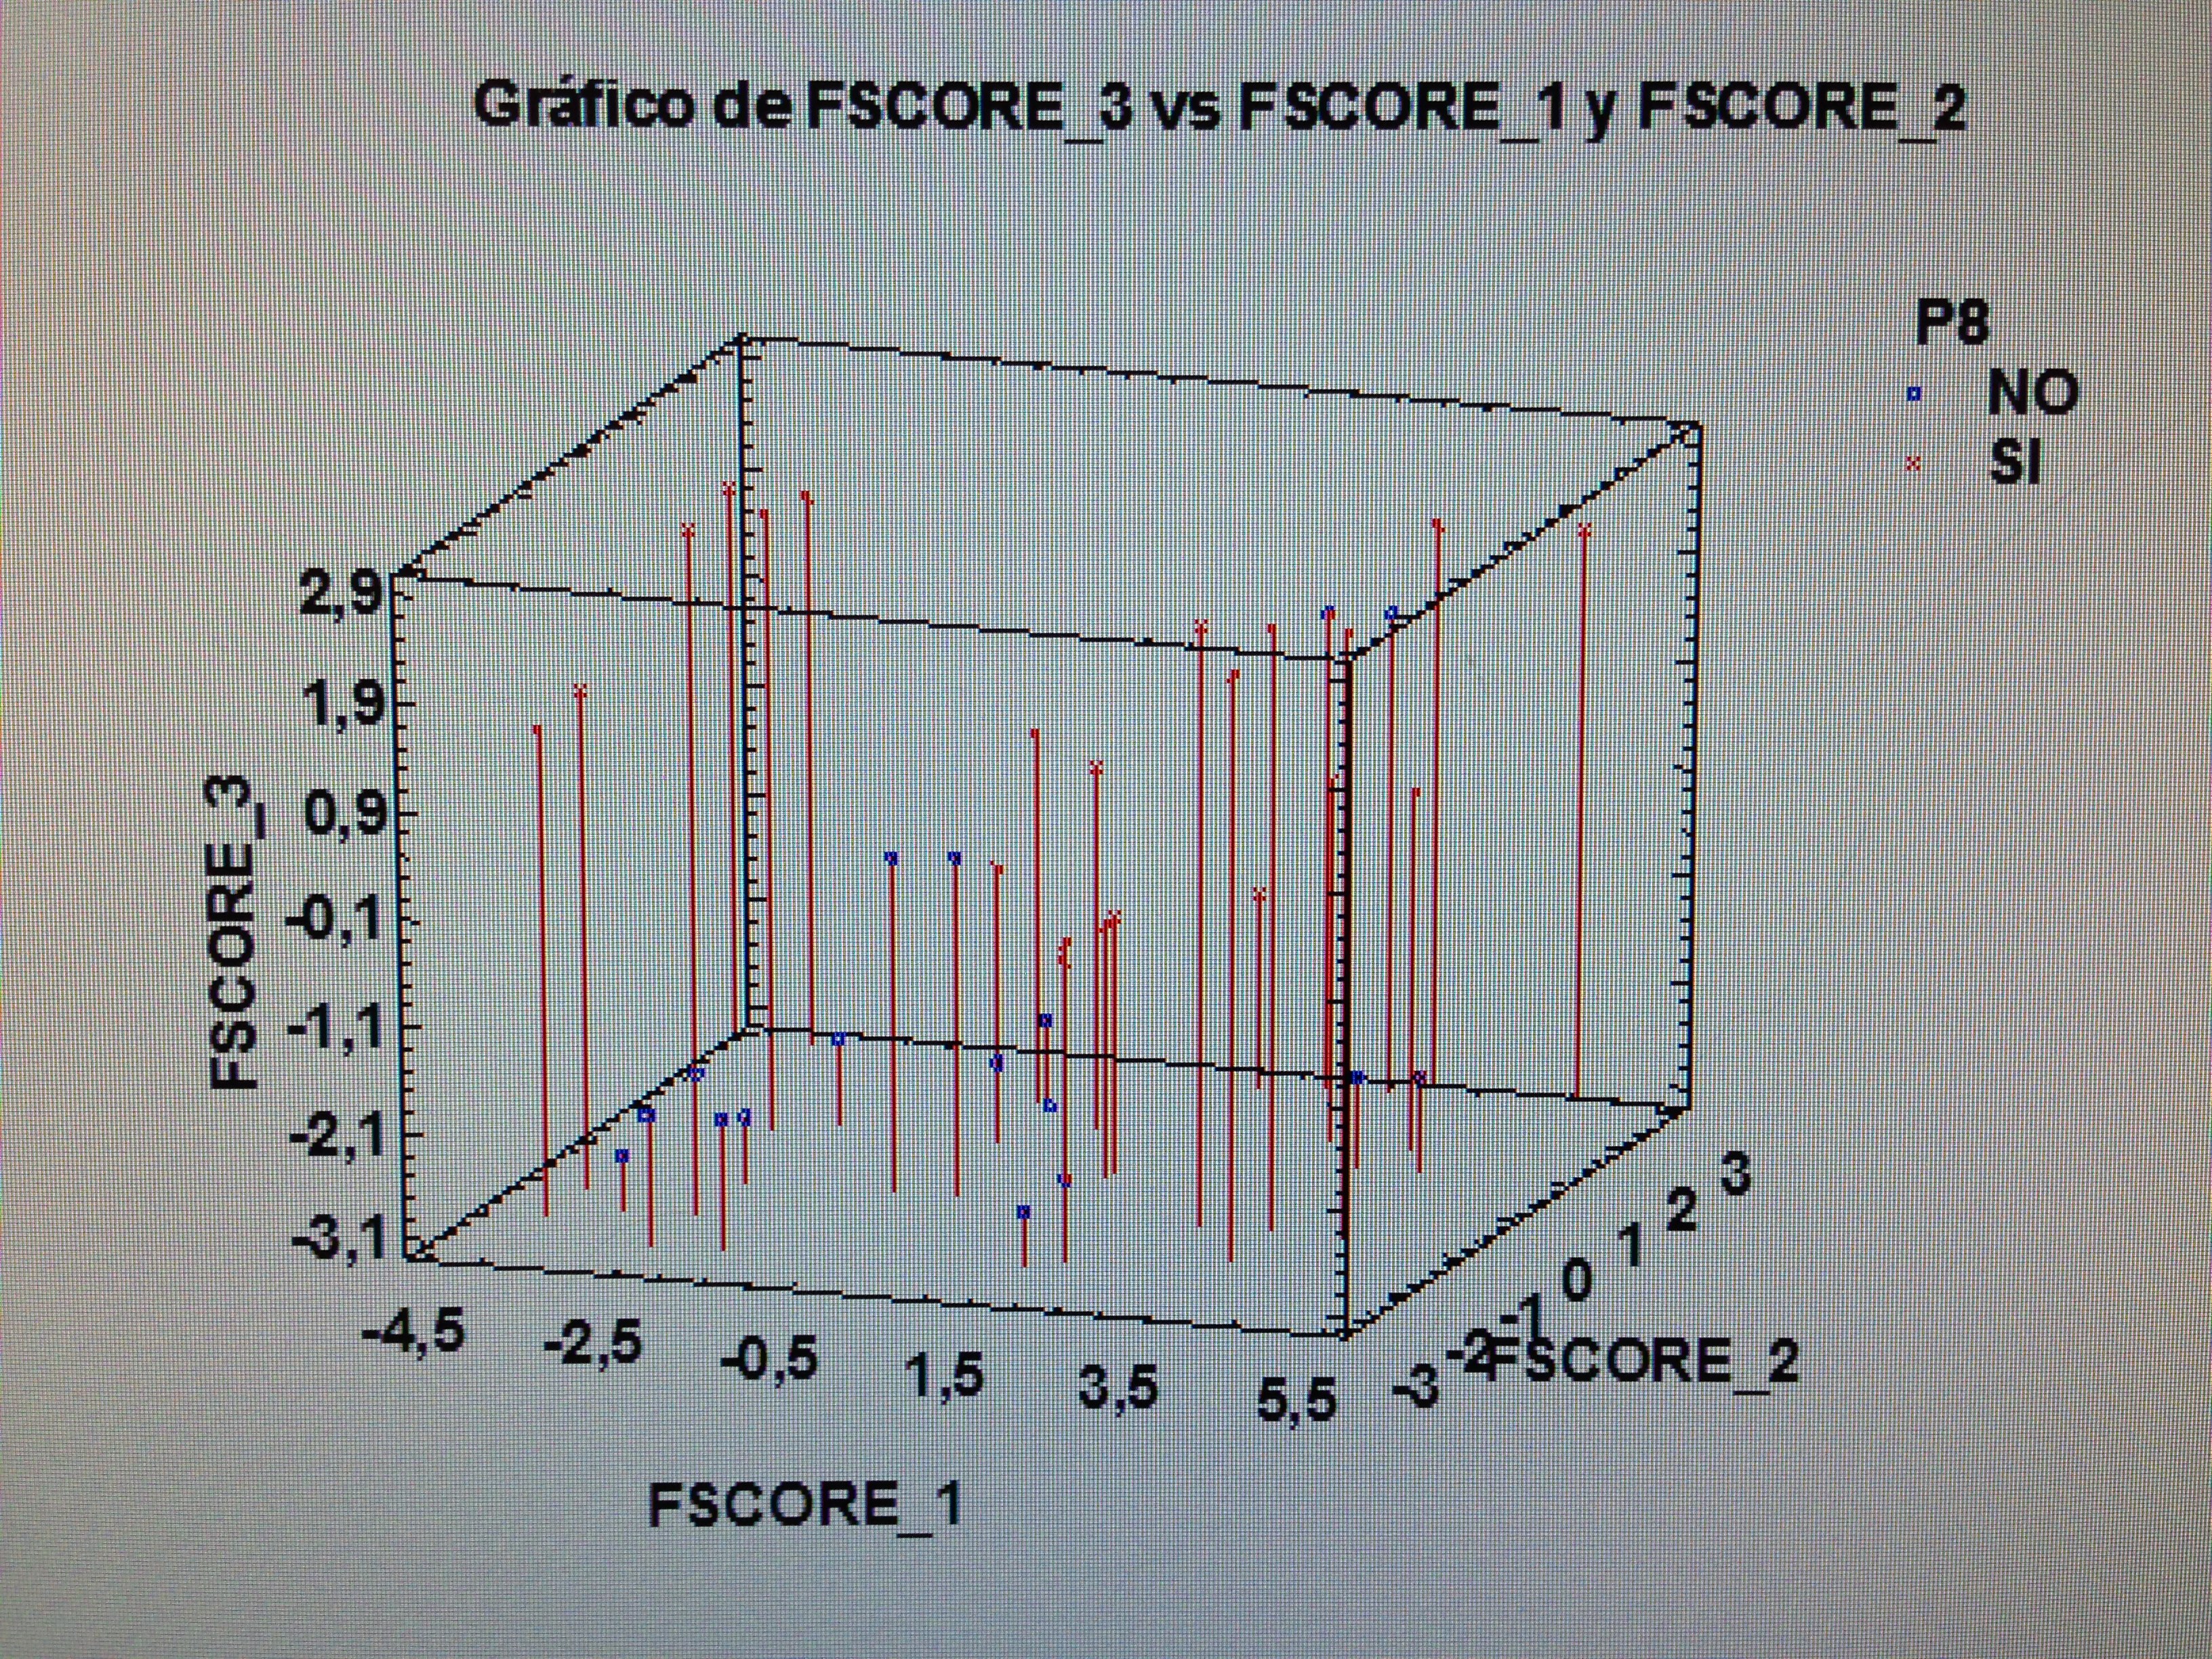
4. Proyectar en la representación de los ejes de los factores la variable P8:
IMG_7742

Observemos que los pacientes que consideran su problema resuelto tienen mucho de todos los factores, pero hay un grupo que tienen valor bajo del primer factor, pero nunca de los otros dos. Los que consideran que su problema no ha quedado resuelto estos están mayoritariamente próximo al vértice donde los tres factores tienen valores bajos.

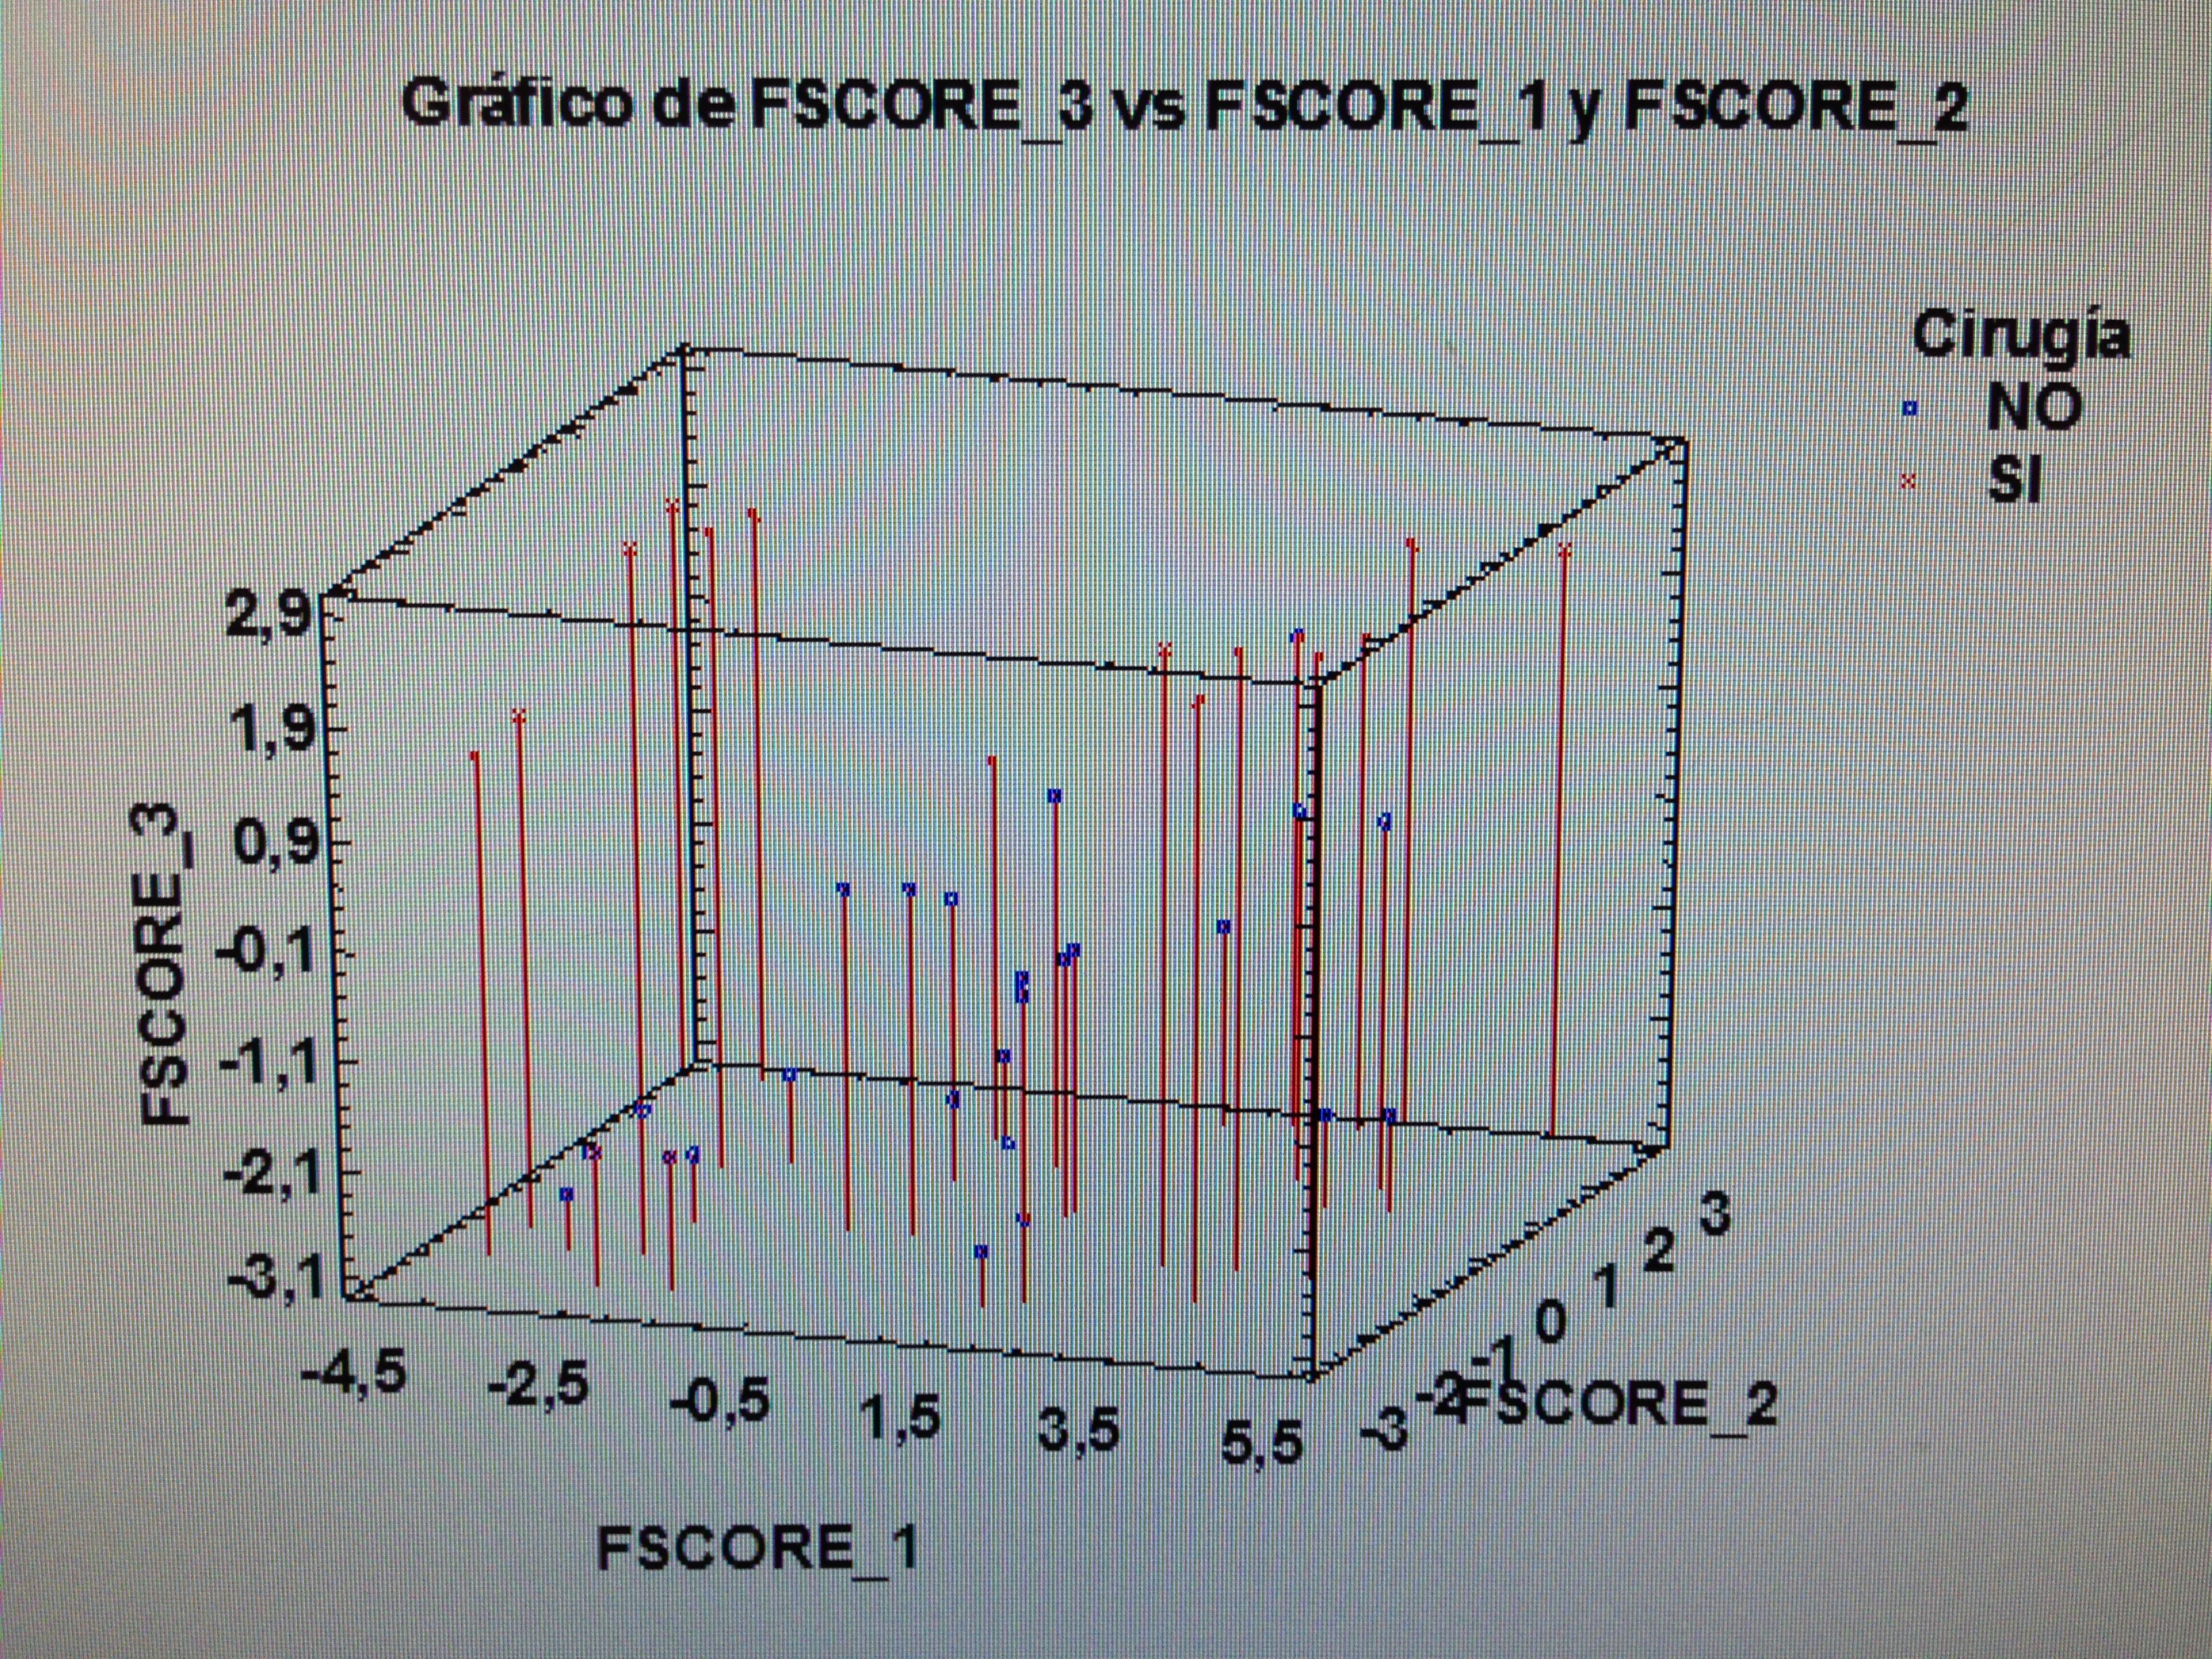
5. Proyectar en la representación de los ejes de los factores la variable Cirugía:
IMG_7743

A los que se ha aplicado Cirugía siguen un patrón similar al seguido con la P8.

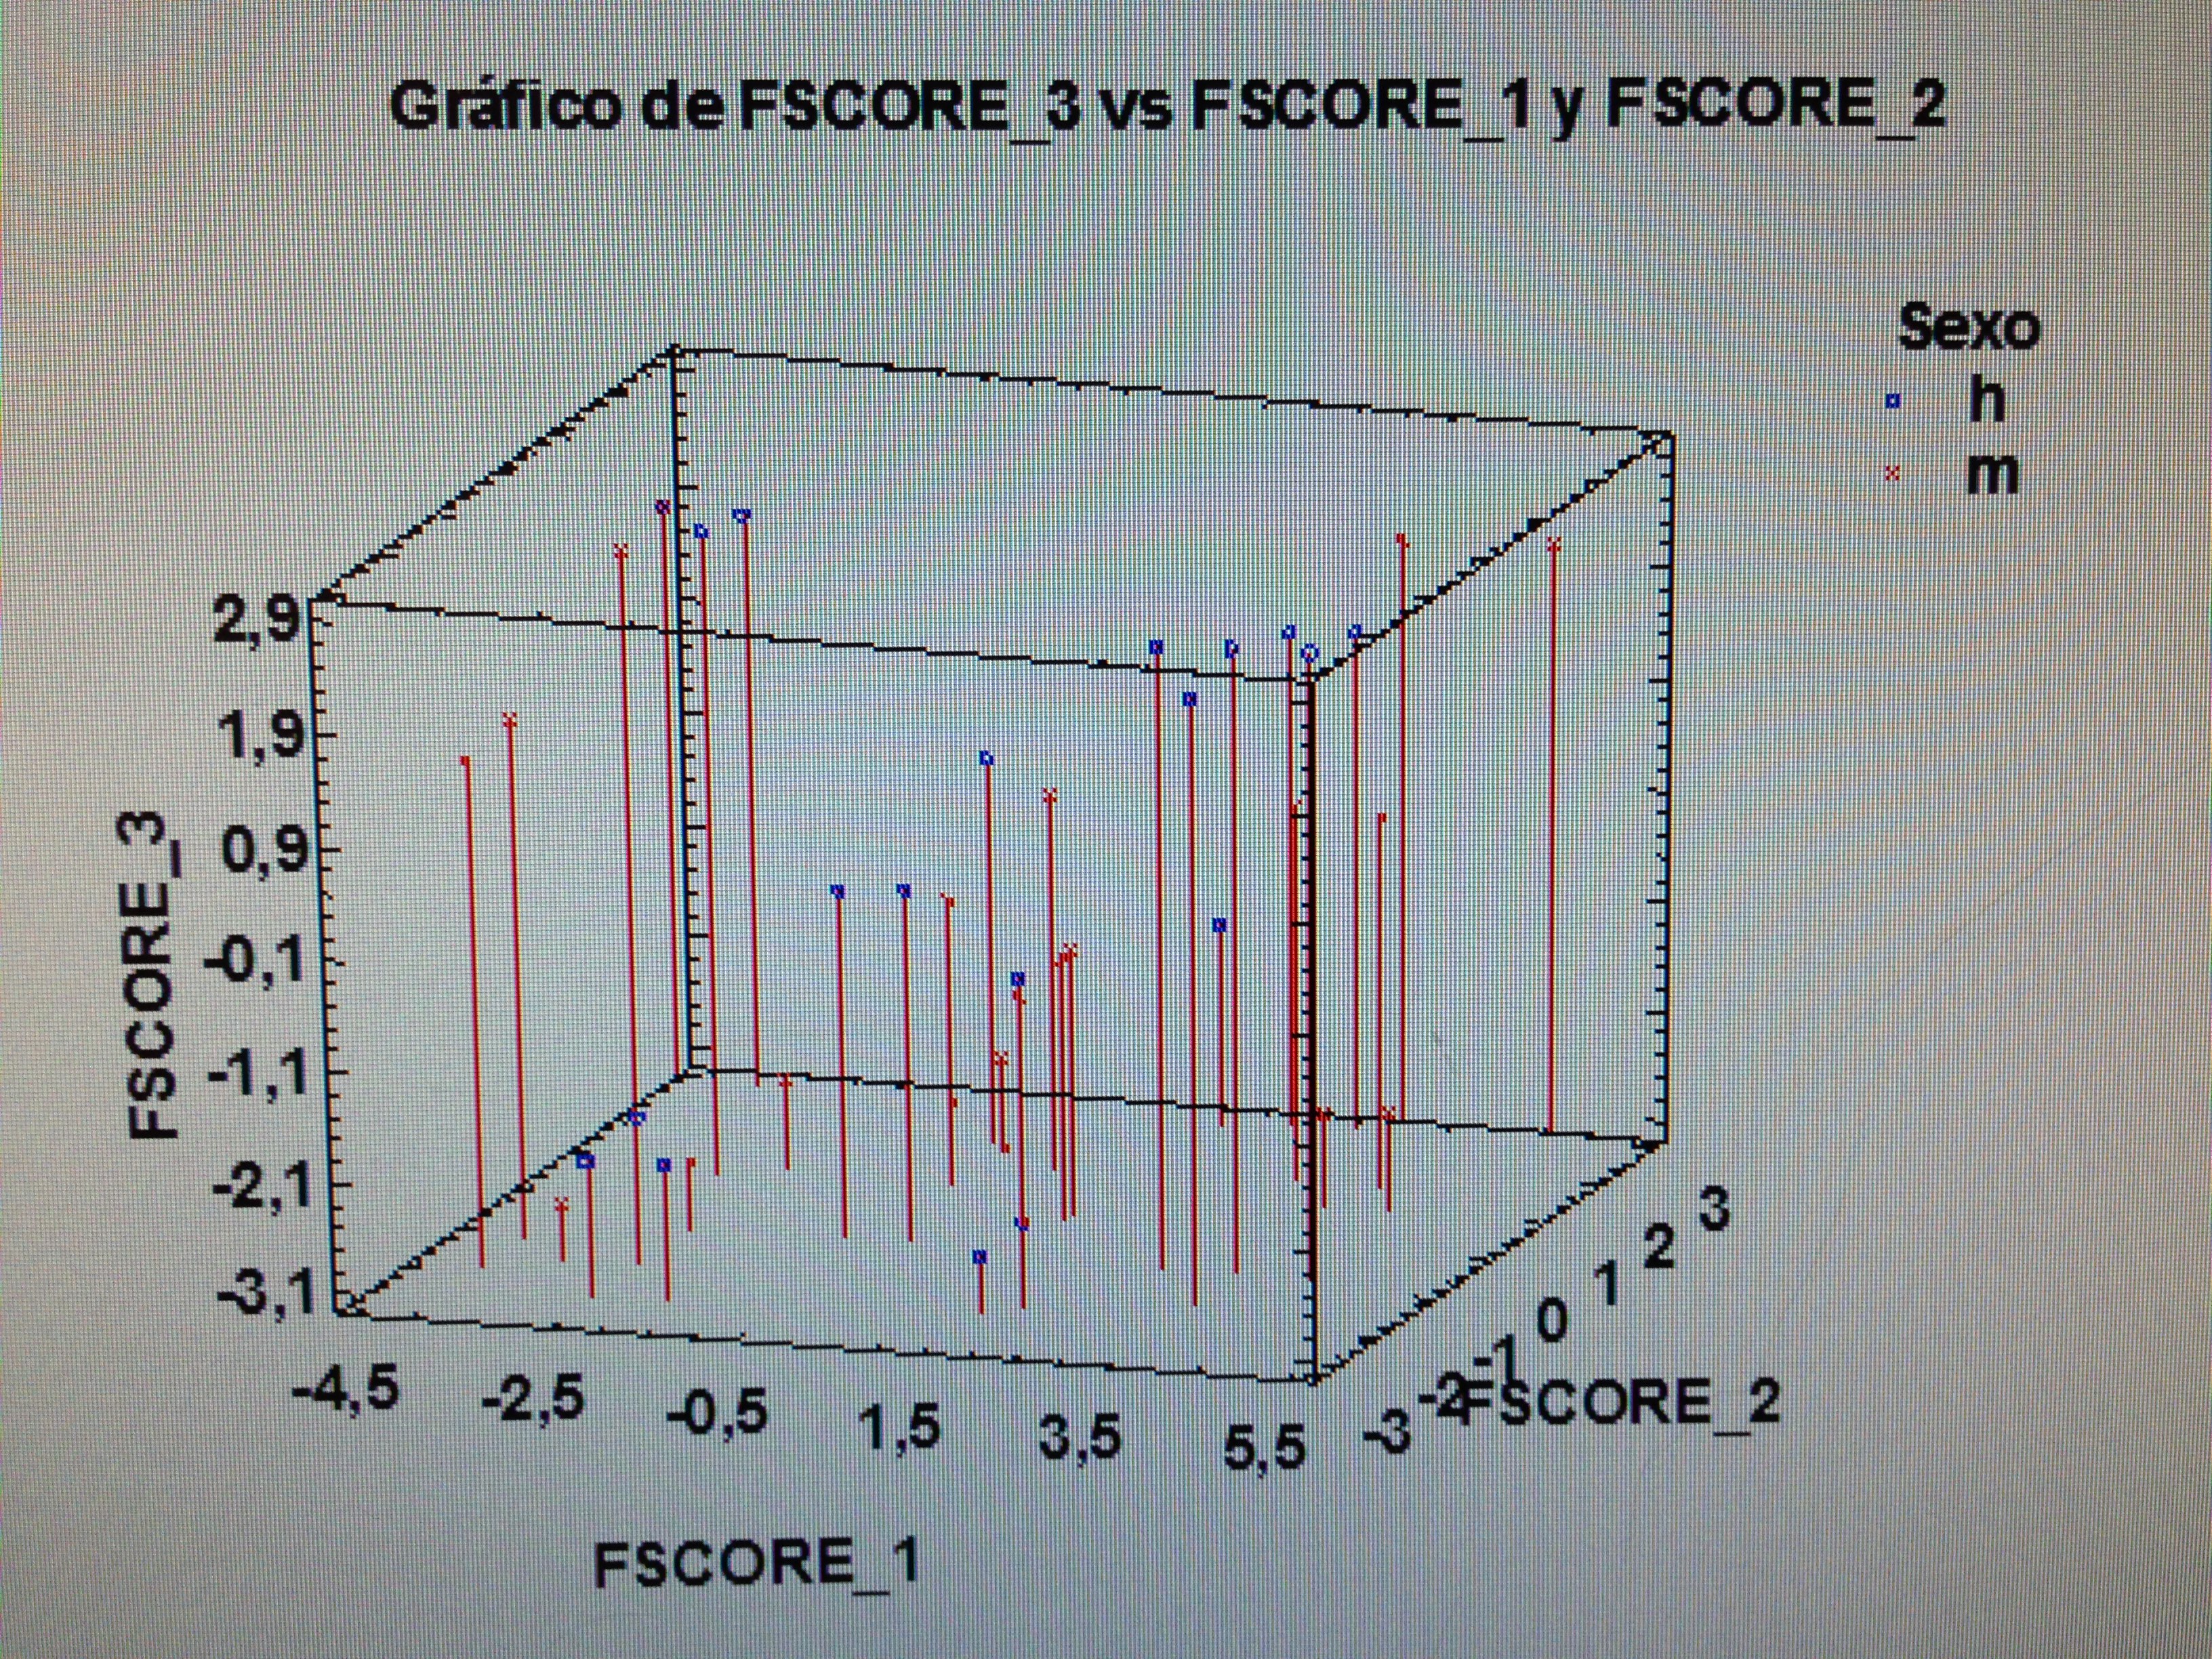
6. Proyectar en la representación de los ejes de los factores la variable Sexo:
IMG_7744

Aquí no parece haber un patrón determinado. Todo está muy disperso.

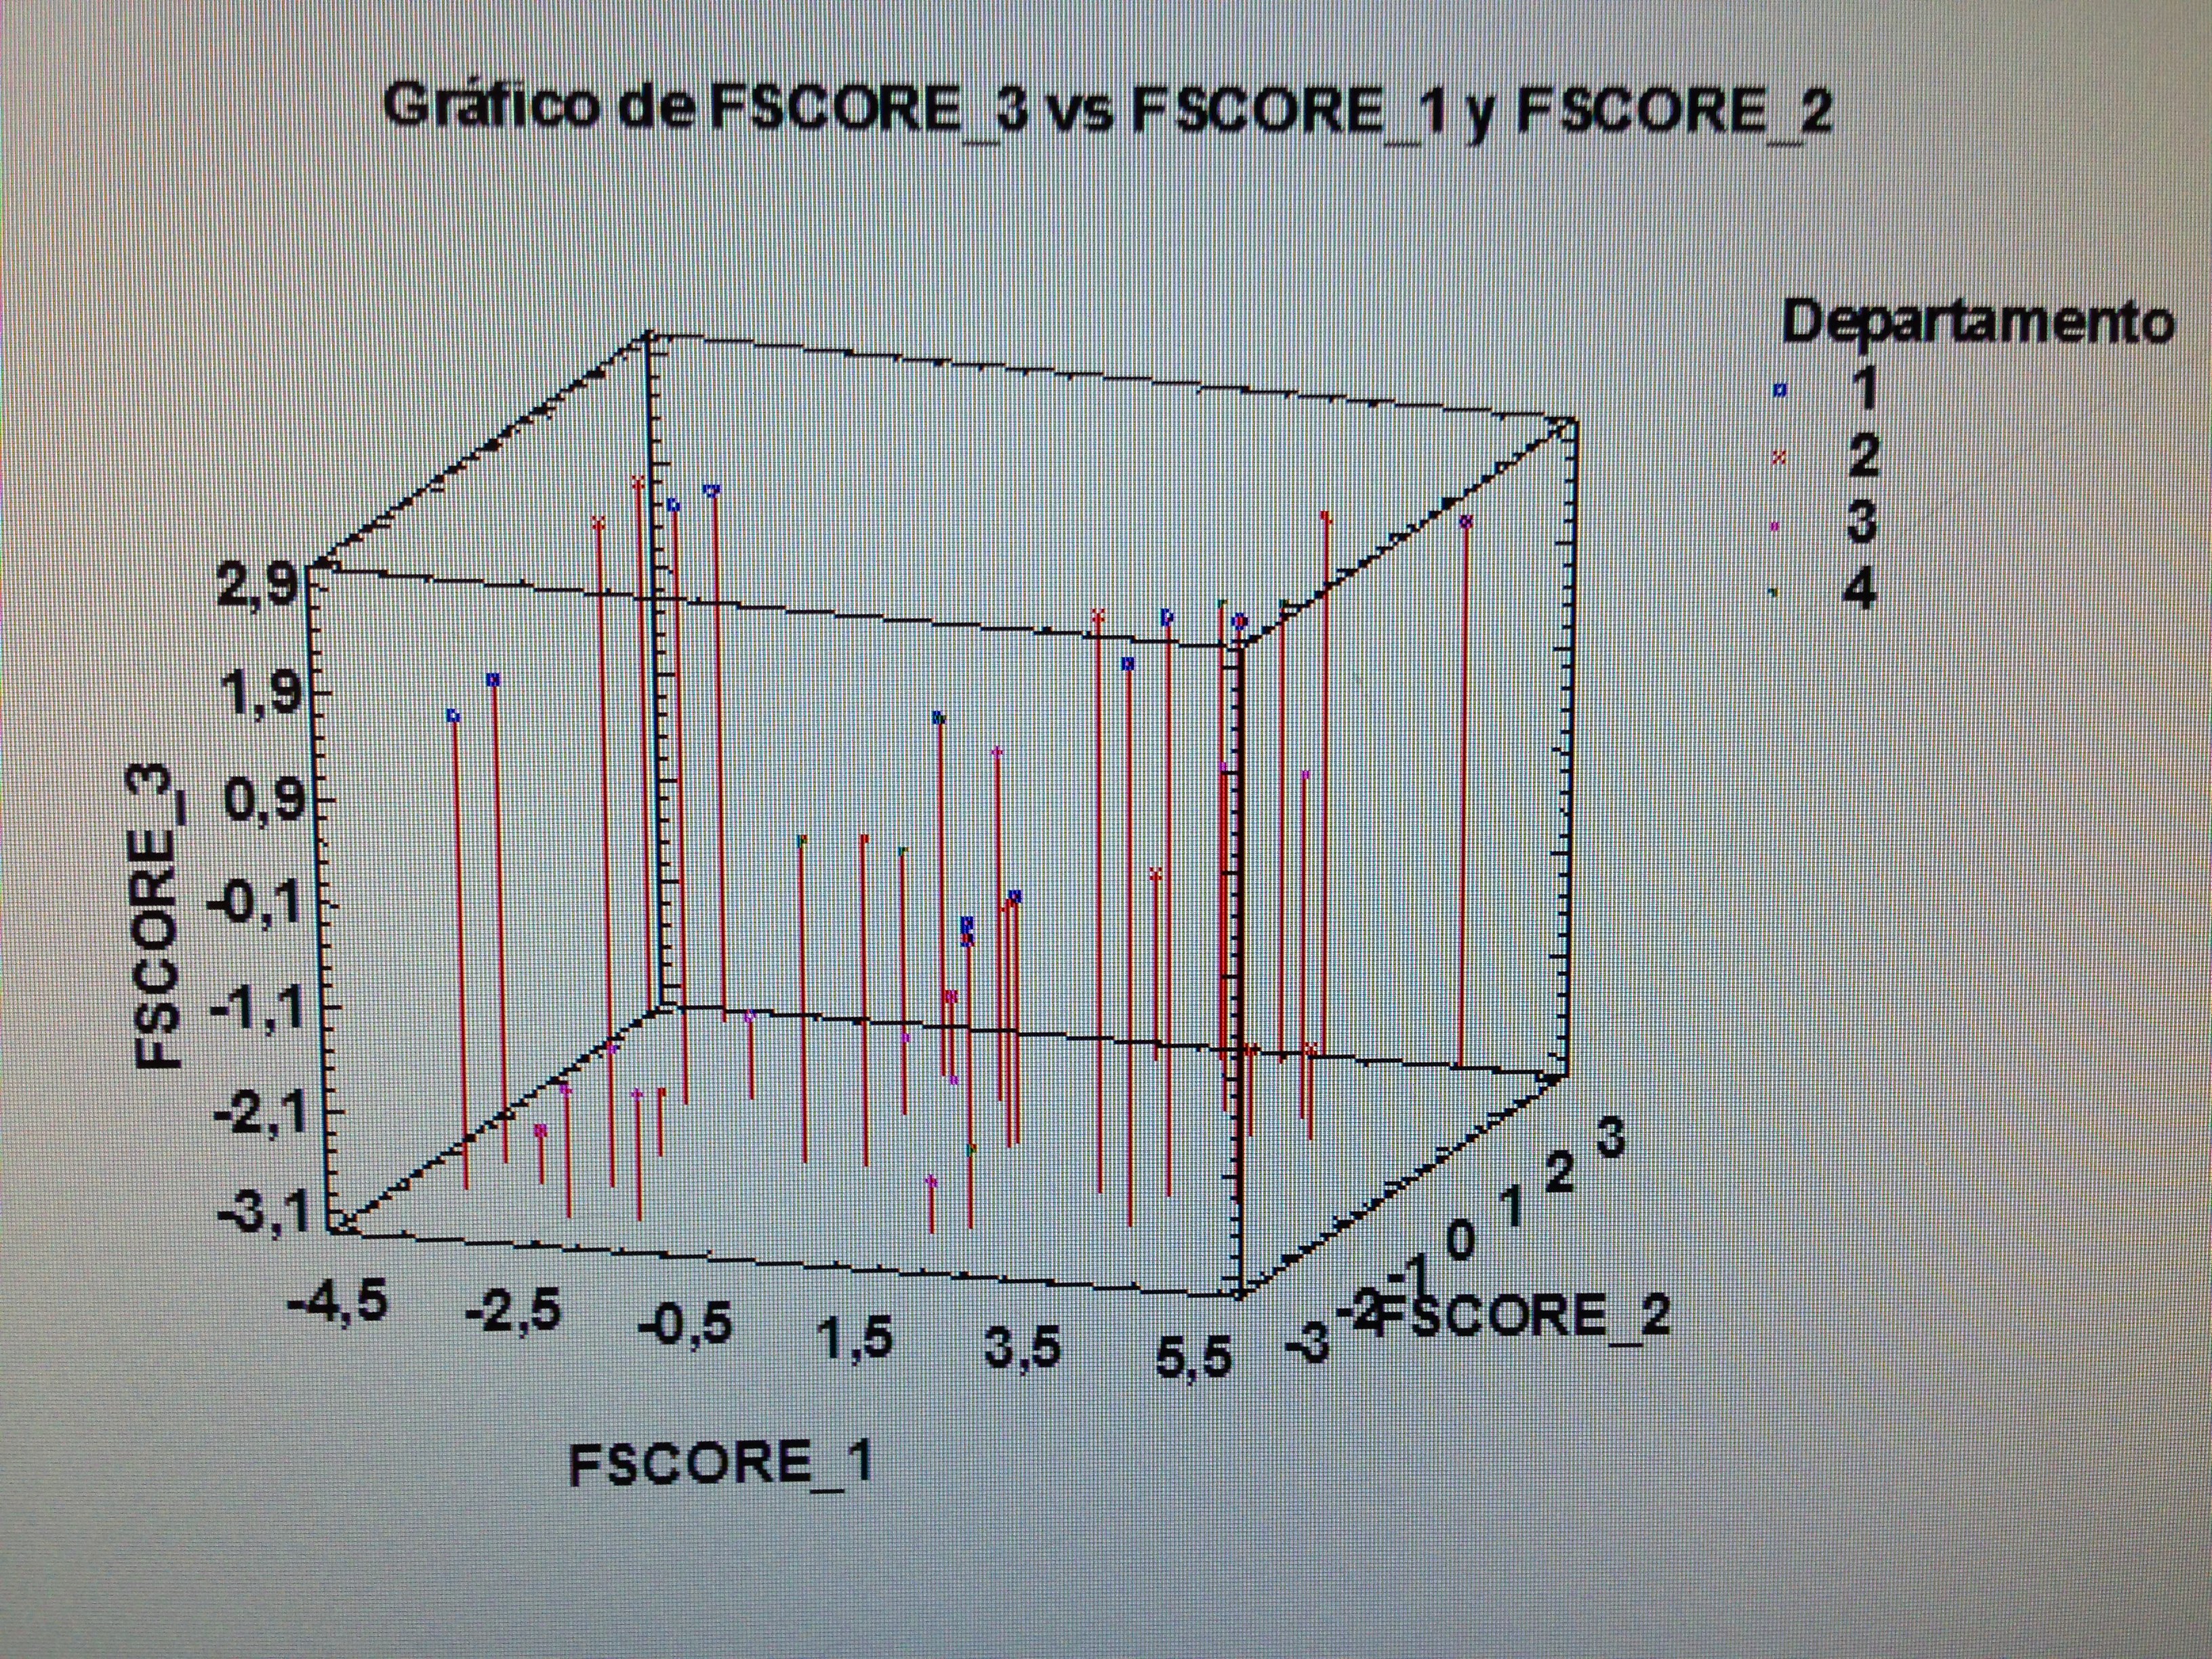
7. Proyectar en la representación de los ejes de los factores la variable Departamento:
IMG_7745

Si se observa con detalle el gráfico puede apreciarse que el departamento 3, que es Urología, es el departamento que tiene valoraciones más bajas. Sus valores están preferentemente en el extremo de los valores bajos de los tres factores.
Solución Situación 53

1a: Variable es dicotómica, son muestras independientes y como el tamaño de muestra es inferior a 30 deberemos aplicar el Test exacto de Fisher.

2b: El error estándar será 400, porque 4000/raiz(100) es 400. Por lo tanto, un intervalo de confianza de la media del 95% de cada una de las dos poblaciones es el que nos da esta opción «b». Como estos intervalos no se tocan la diferencia es significativa.

Los intervalos de la opción «a» son de valores individuales, no de la media.

La «c» no es correcta. Trabajar con intervalos de confianza de la media y valorar si se tocan o no es equivalente a obtener un p-valor. Es otra forma de evaluar, estadísticamente, la significación de las diferencias.

Por lo dicho en el párrafo anterior, la «d» tampoco es correcta.

3b: La distribución de esta variable claramente no sigue la distribución normal, por lo tanto a la hora de describirla hay que hacerlo con la mediana y el rango intercuartílico.

4b: Variable continua, muestras independiente y no normales, porque el p-valor del Shapiro-Wilk es inferior a 0.05. Por lo tanto, hay que aplicar el Test de Mann-Whitney.

5d: Realmente el coeficiente de determinación es algo (80%), pero sin tener el p-valor de la correlación no podemos decir nada sobre la calidad de la Regresión lineal simple que podamos hacer entre esas dos variables.

Situación 53: Examen (Temas 1-14)

1. Si queremos comparar la diferencia que hay de hipertensos en Barcelona y Nueva York y lo hacemos tomando una muestra de 20 personas adultas en cada una de estas ciudades, el test estadístico que deberemos aplicar es:

a. El Test exacto de Fisher.

b. El Test de la t de Student de datos apareados.

c. El Test de proporciones.

d. El Test de McNemar.

2. Nos dicen que han comparado la media de rentas de dos poblaciones con una muestra de tamaño 100 en cada población. Ambas muestras siguen bien una distribución normal y una estadística básica de cada una de ellas es: Población A: 15000±4000 y Población B: 13000±4000, podemos afirmar lo siguiente:

a. La diferencia no es significativa porque si hacemos los intervalos de confianza del 95% de la media los intervalos se tocan porque son: (7000, 23000) y (5000, 21000).

b. La diferencia sí que es significativa porque si hacemos los intervalos de confianza del 95% de la media los intervalos no se tocan porque son: (14200, 15800 ) y (12.200, 13800).

c. Necesitamos tener un p-valor para poder afirmar tal cosa. De otra forma no tiene relevancia estadística.

d. Estadísticamente lo único que podemos decir es que las medias de las rentas son distintas.

3. Si se quiere hacer un resumen descriptivo de una muestra de la variable cantidad de agua caída en diferentes días del año mediante una muestra como la siguiente:

(0, 0, 0, 0, 0, 0, 0, 0, 1, 2, 2, 3, 3, 4, 5, 5, 7, 8, 25, 120), la forma más coherente sería:

a. 9.25±26.6, que son la media y la desviación estándar.

b. 2(0, 5), que son la mediana y el rango intercuartílico expresado con el primer y tercer cuartil.

c. N(9.25, 26.6), que es la expresión de la distribución normal con parámetros 9.25 y 26.6.

d. (2, 9.25), que son la mediana y la media.

4. Se quiere comparar la humedad relativa entre dos muestras de dos zonas que se quiere comparar. Se ha aplicado el Test de Shapiro-Wilk a las dos muestras y el p-valor en ambas es menor que 0.05. Para comparar las medias o las medianas de ambas poblaciones el test más adecuado al caso será:

a. Test de la t de Student de varianzas iguales si se comprueba previamente, mediante el test de Fisher, que no son distintas significativamente.

b. Test de Mann-Whitney.

c. El Test de proporciones.

d. El Test de la t de Student de datos apareados.

5. Si en una Regresión lineal simple entre dos variables tenemos una R2 del 80% podemos afirmar:

a. Que la pendiente es significativa.

b. Que existe una buena determinación.

c. Que la correlación es 0.8.

d. Poco podemos decir sin comprobar previamente que la correlación sea significativa.

Explotación de una base de datos 8: ANOVA

A nuestra base de datos adjunta en el artículo Explotación de una base de datos 1: Base de datos le podemos aplicar también el ANOVA. Veamos algunos ejemplos:

1. Comparar la variable Valoración general según el Departamento.

2. Comparar la variable P6 según el Departamento.

SOLUCIONES

1. Comparar la variable Valoración general según el Departamento:

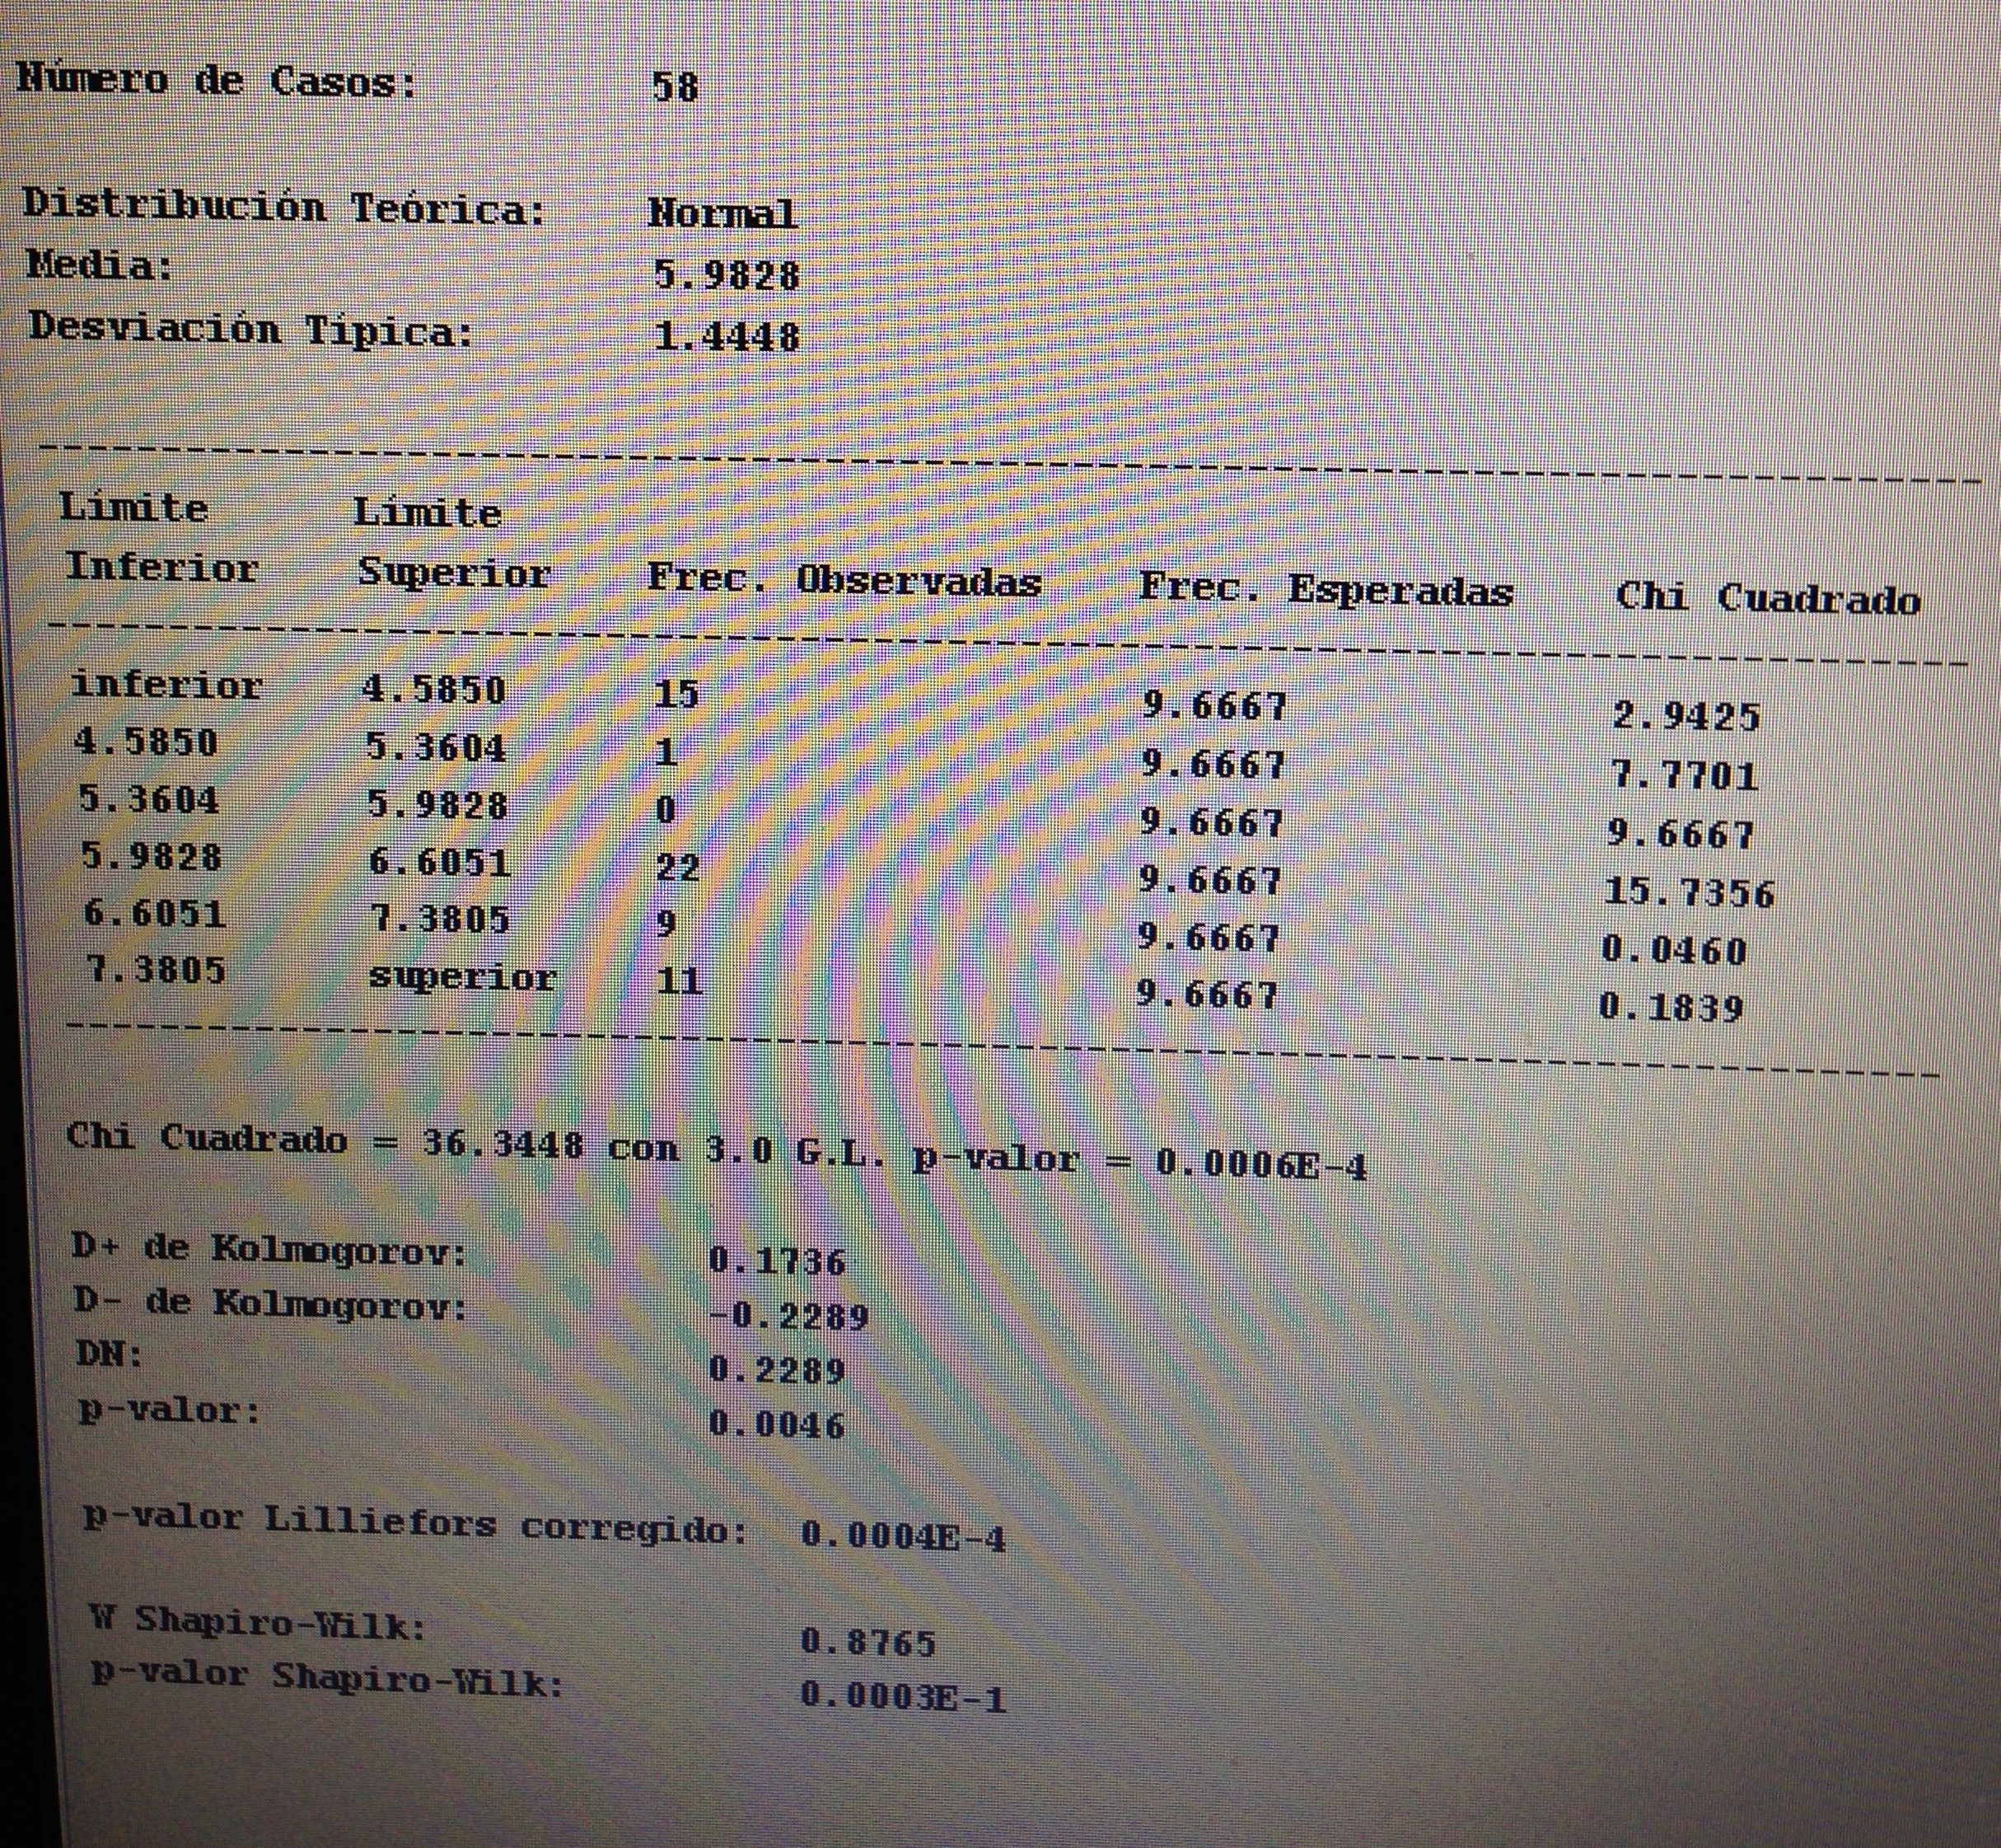
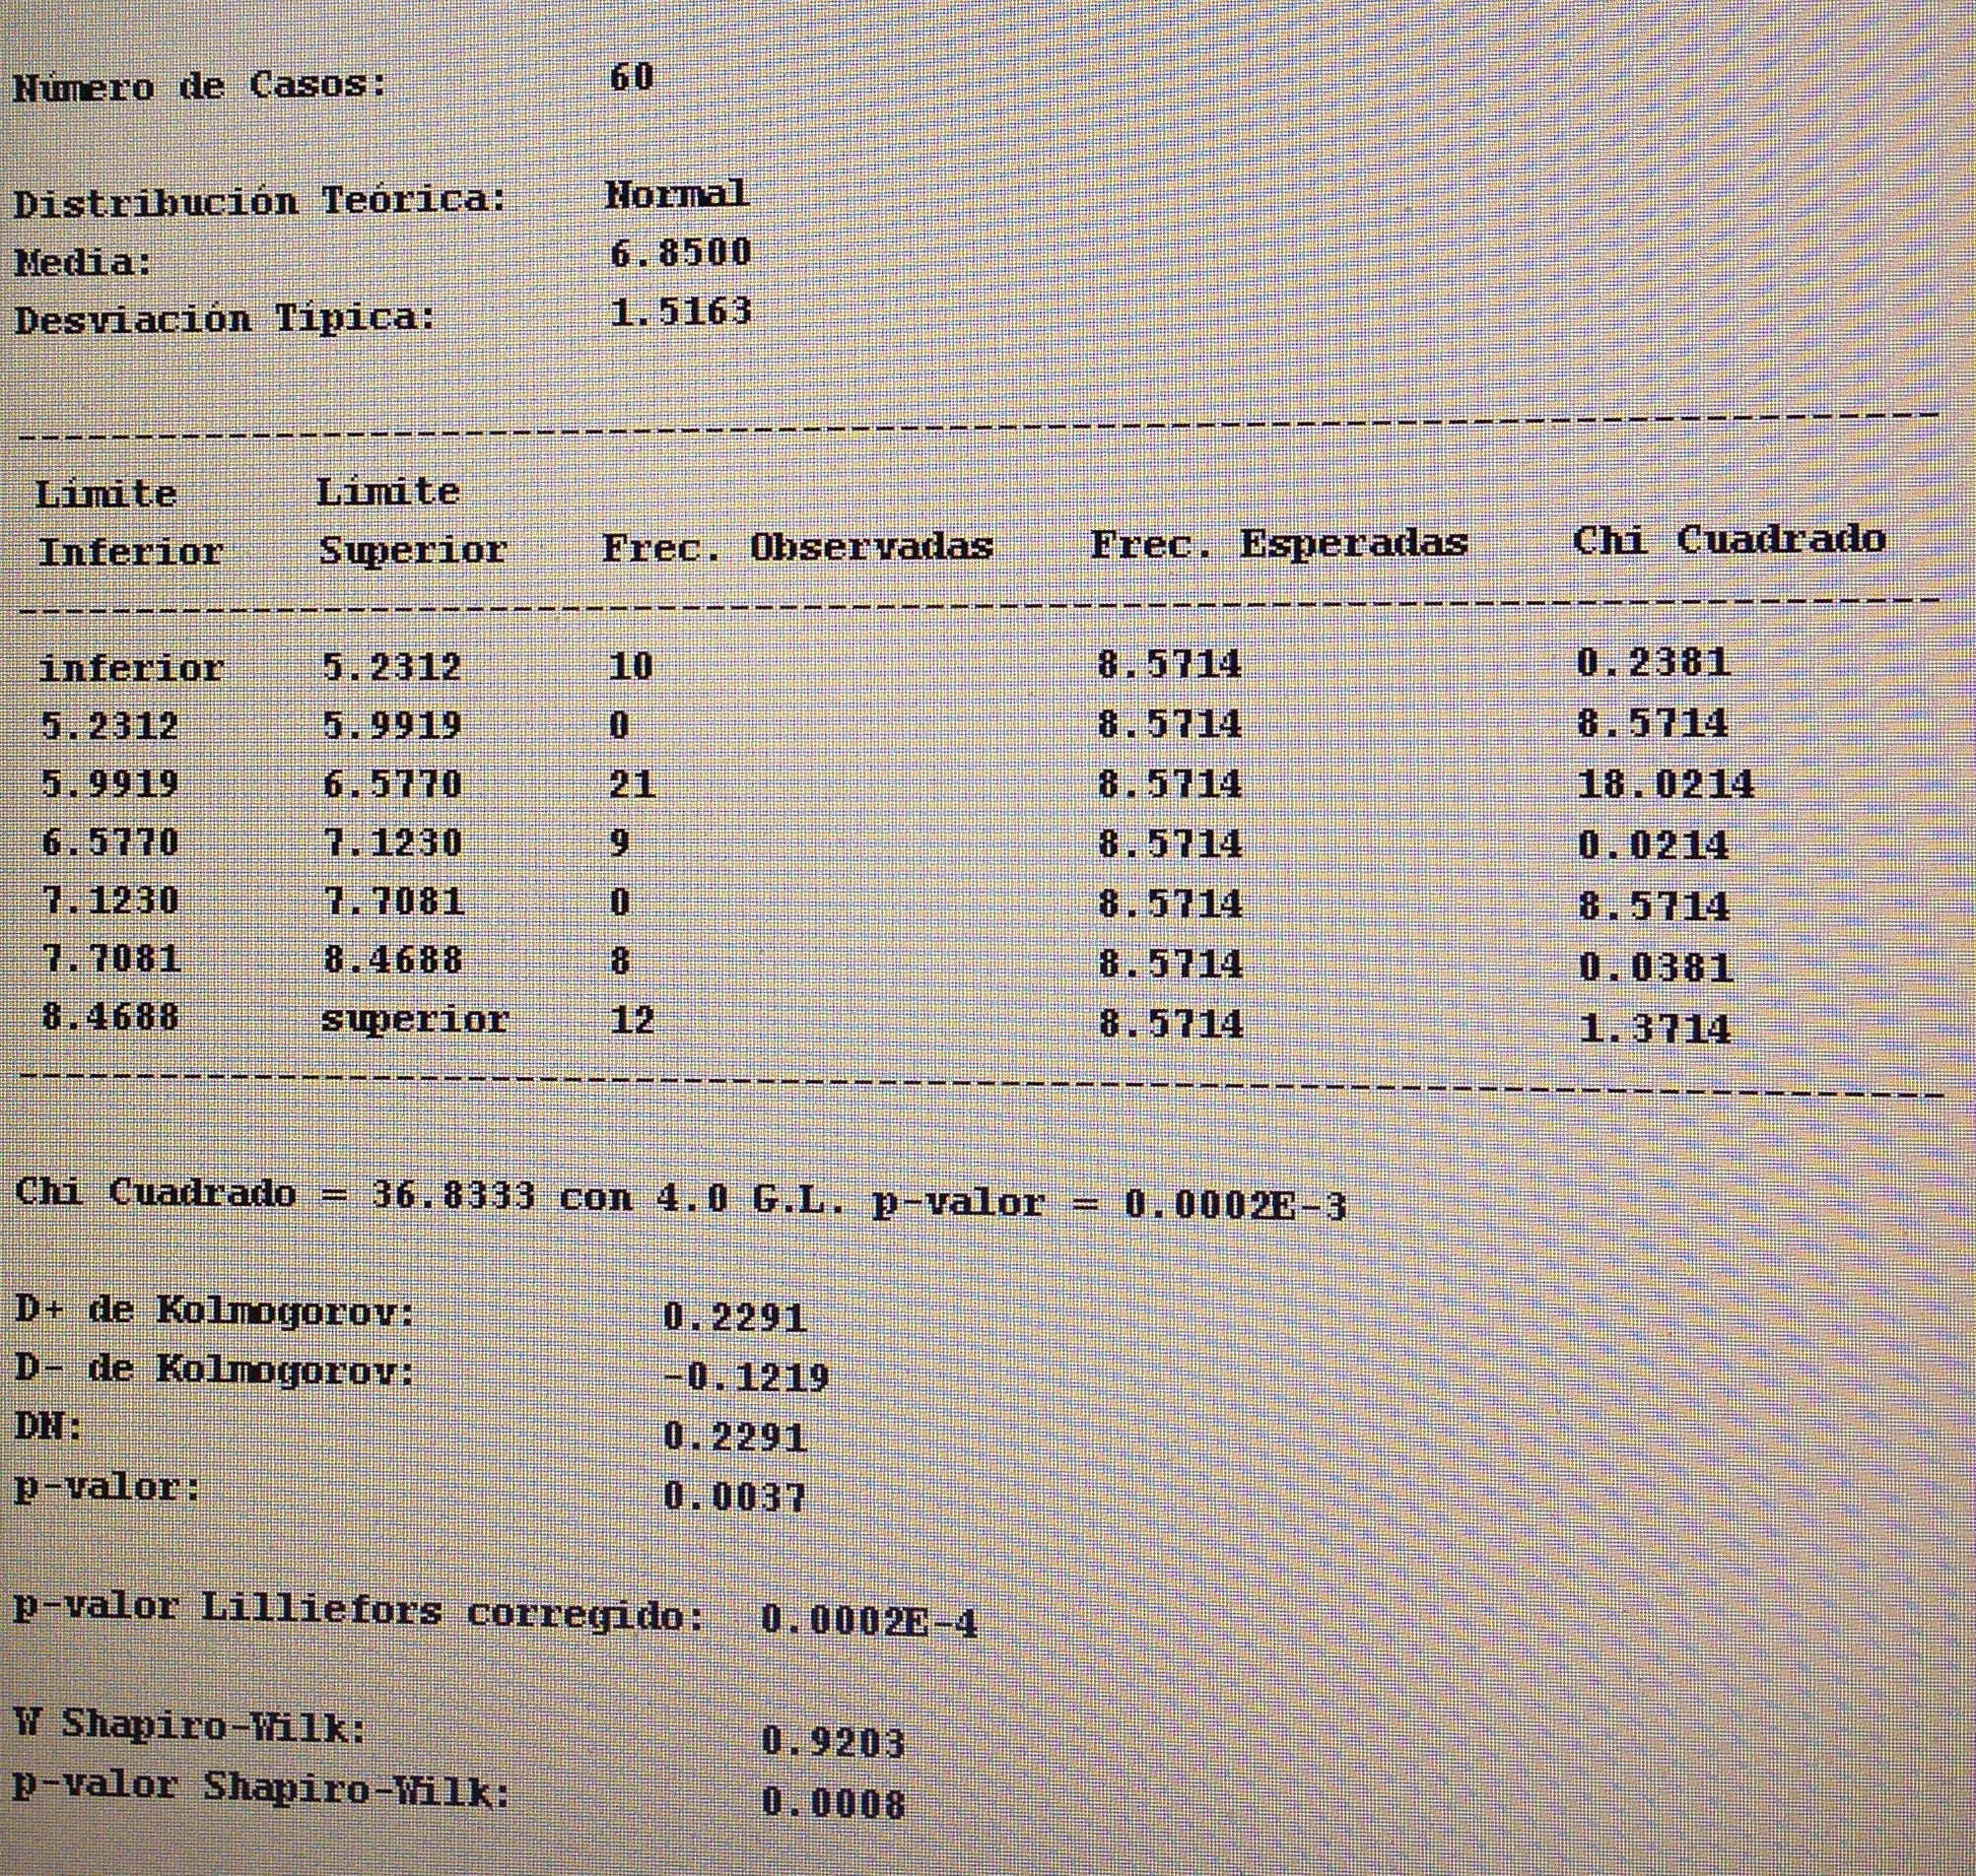
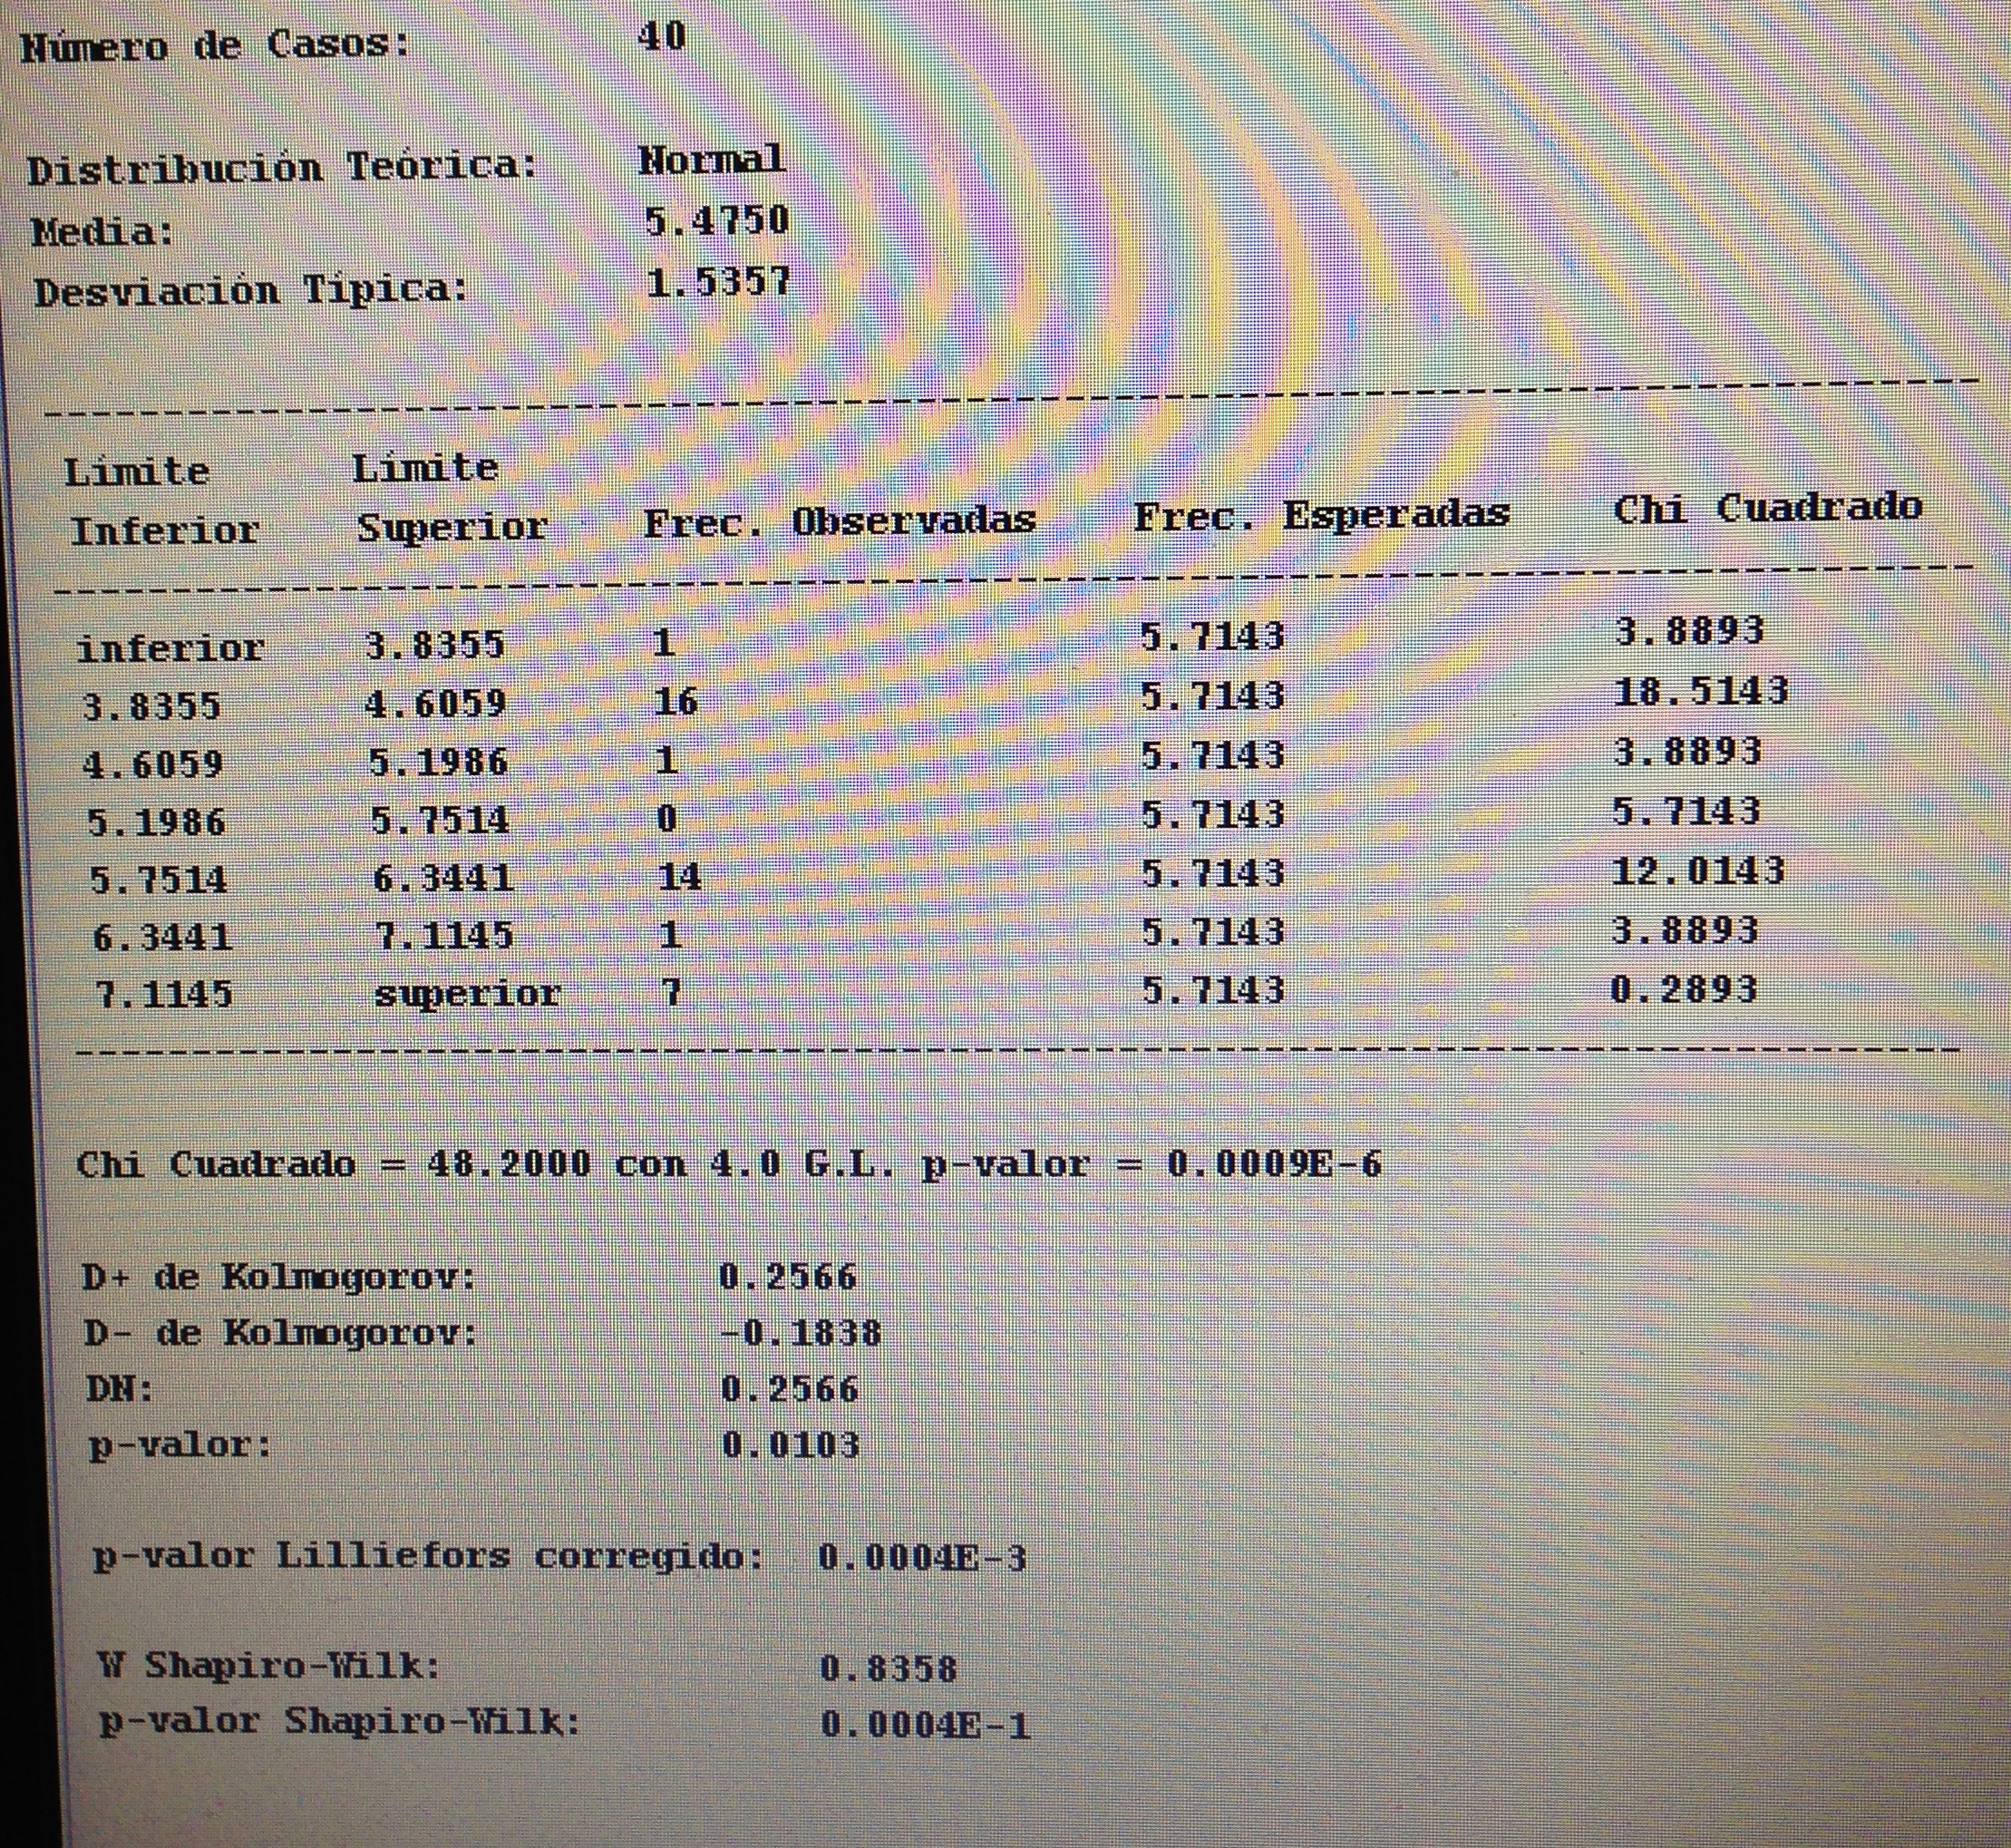
Como hay cuatro departamentos en nuestro estudio deberemos aplicar un ANOVA. Para ello vamos a comprobar, en primer lugar, la normalidad de cada uno de los cuatro grupos a comparar.

IMG_7812

IMG_7813

IMG_7814

IMG_7815

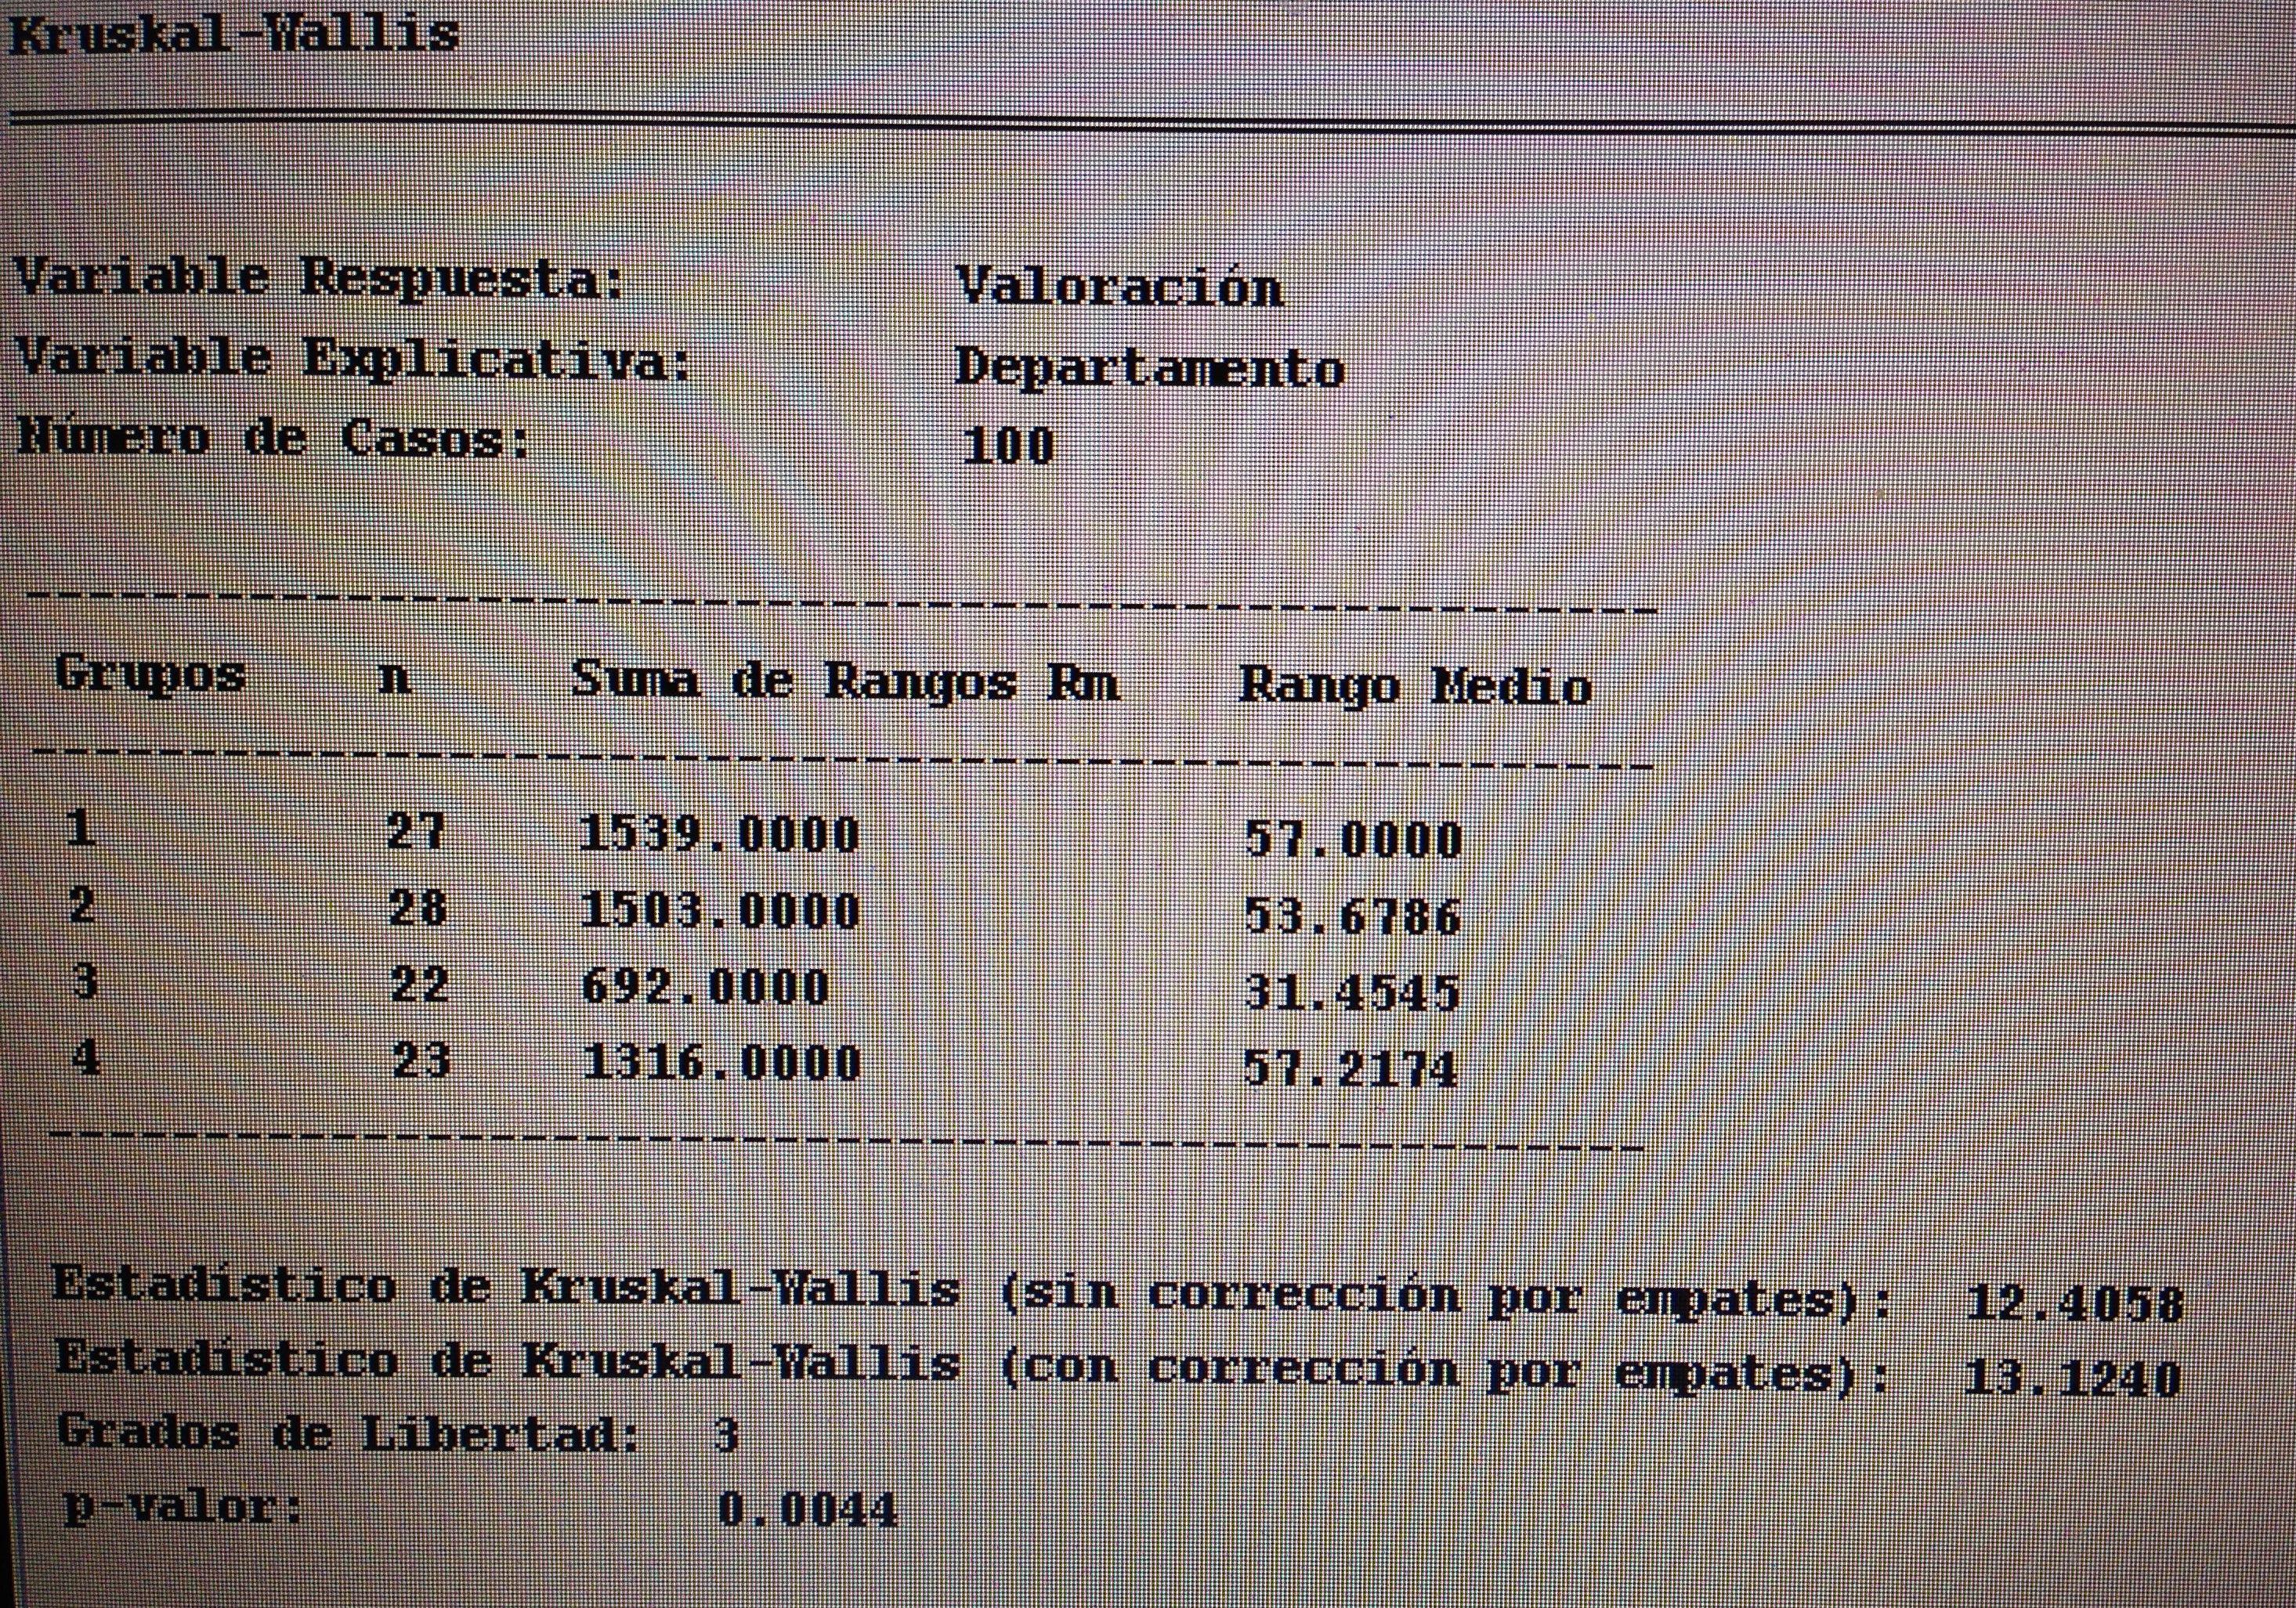
Si observamos el Shapiro-Wilk observamos que ninguno de los cuatro grupos se ajusta a la distribución normal. Por lo tanto, vamos a aplicar el Test de Kruskal-Wallis:

IMG_7798

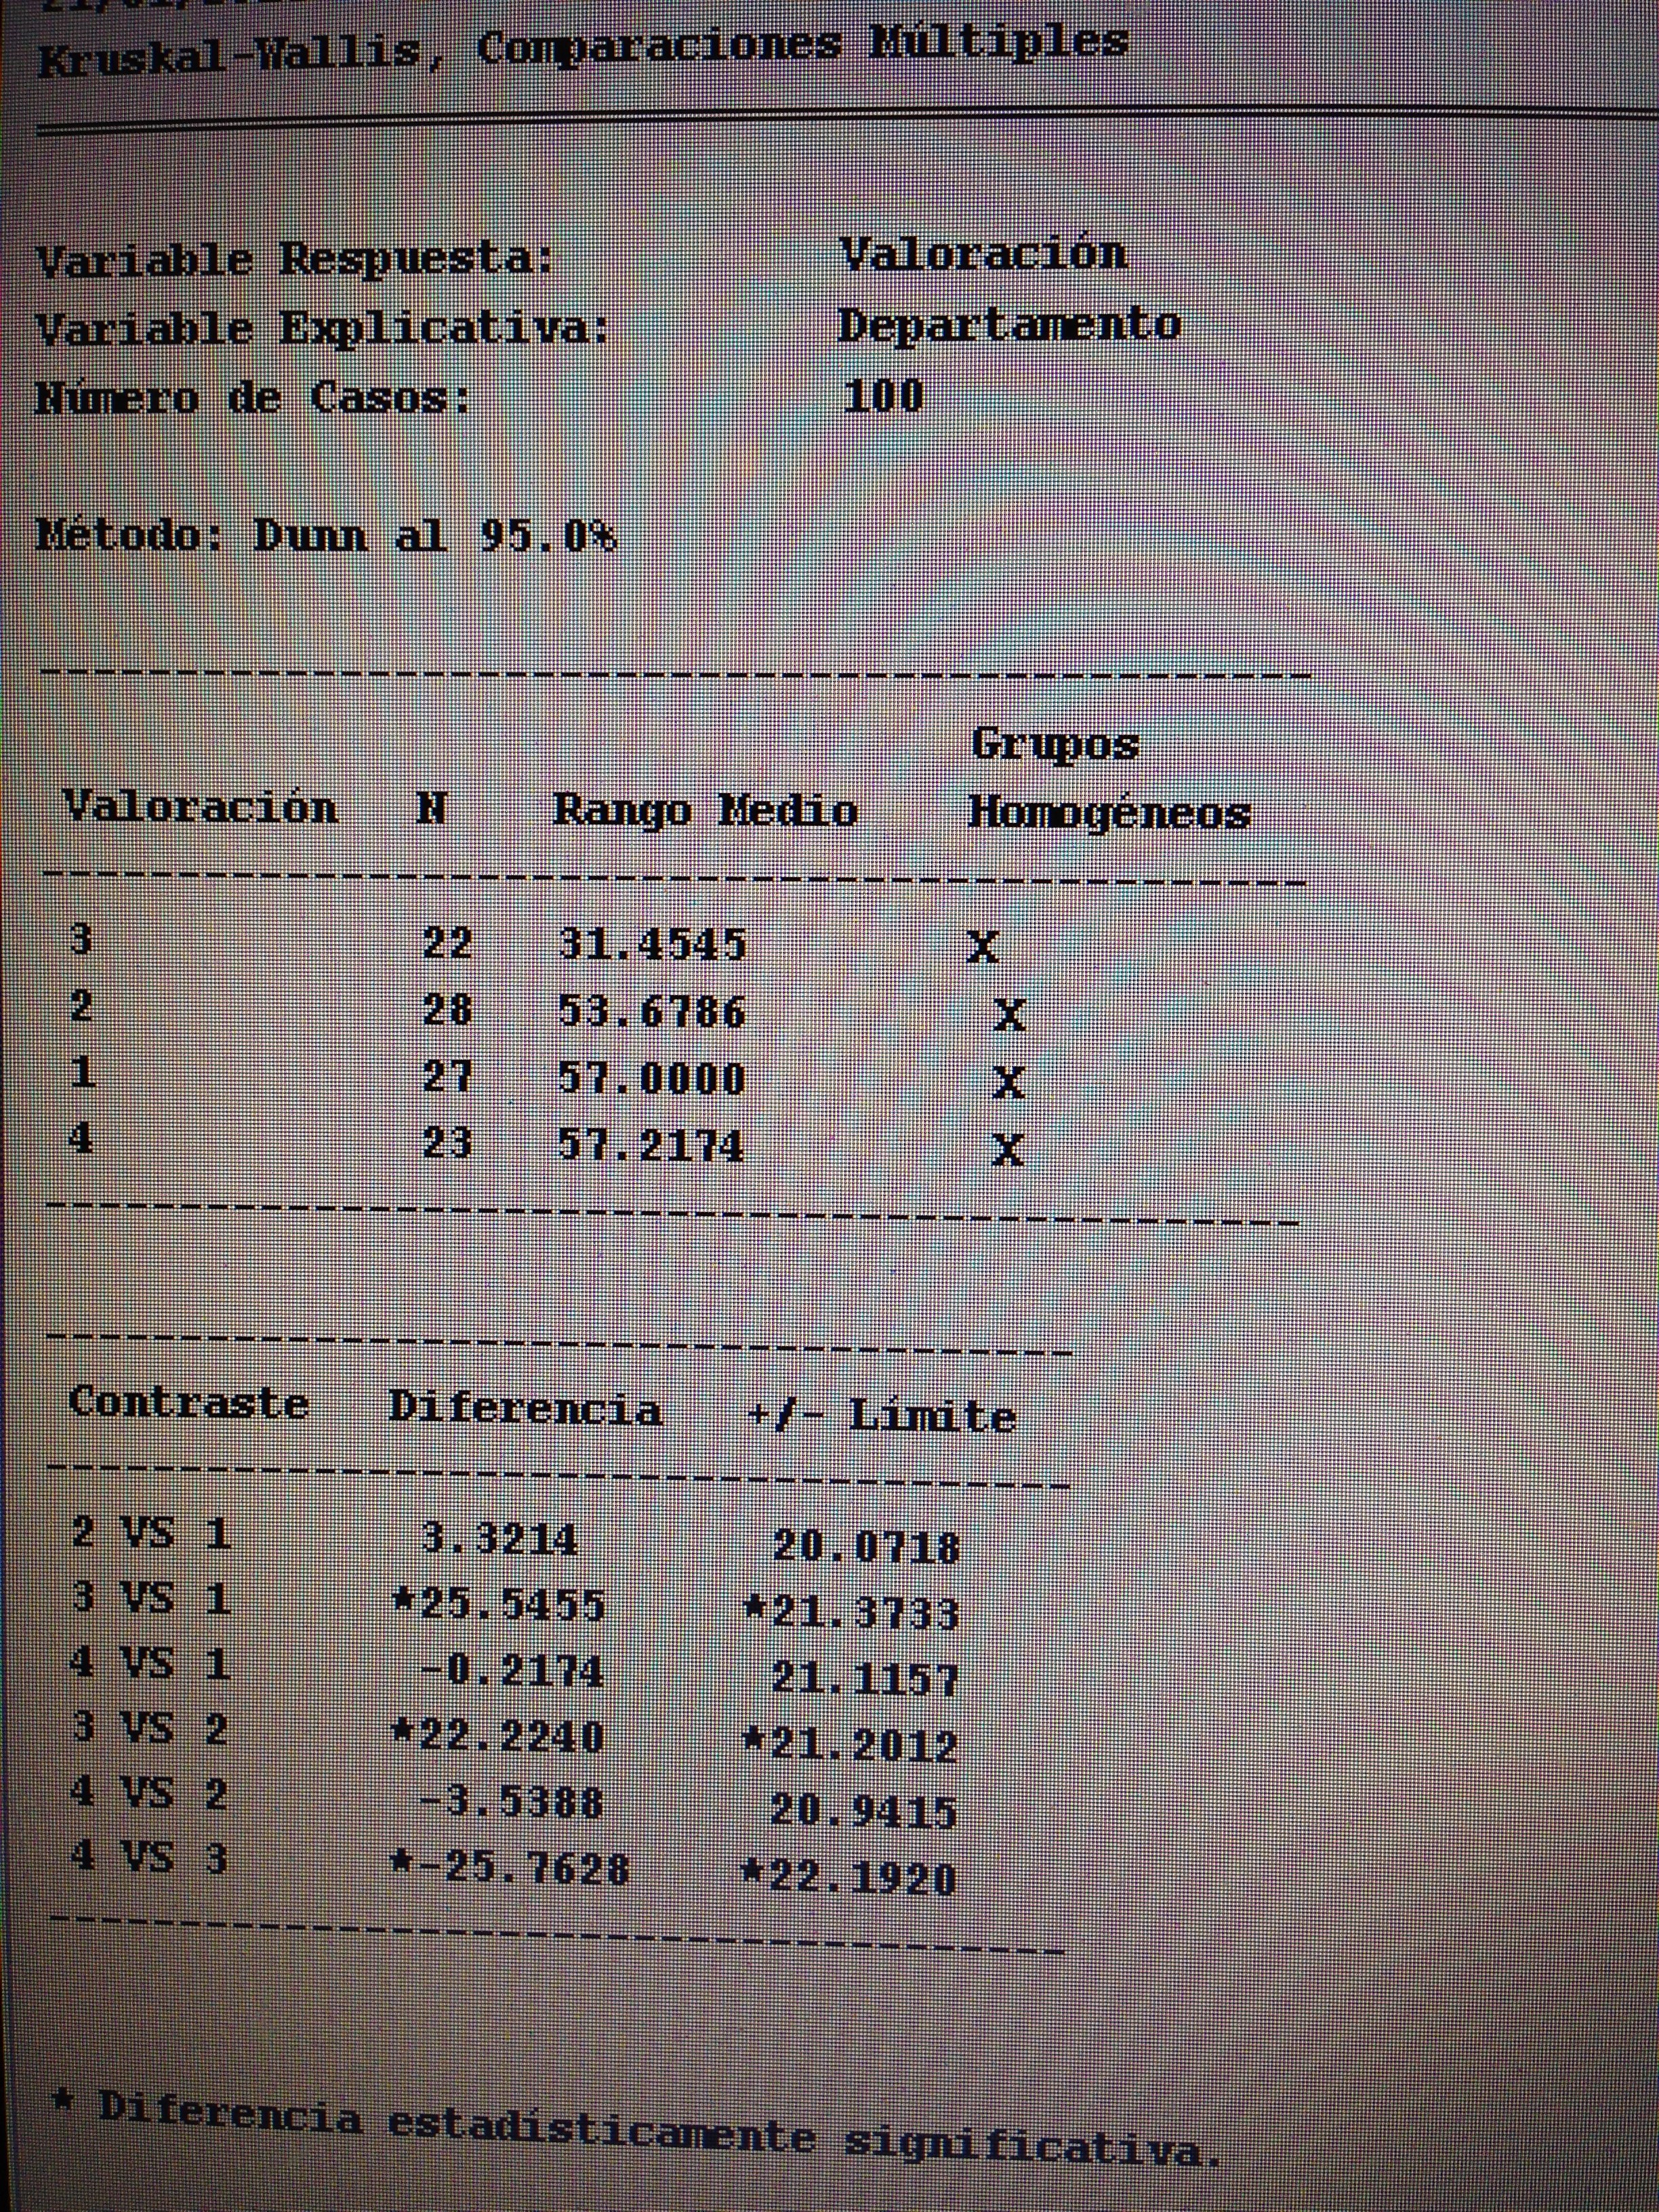
Las comparaciones múltiples (en este caso mediante el método Bonferroni-Dunn):

IMG_7809


Por lo tanto, el causante de las diferencias entre los cuatro departamentos es el 3, el departamento de Urología.

2. Comparar la variable P6 según el Departamento:

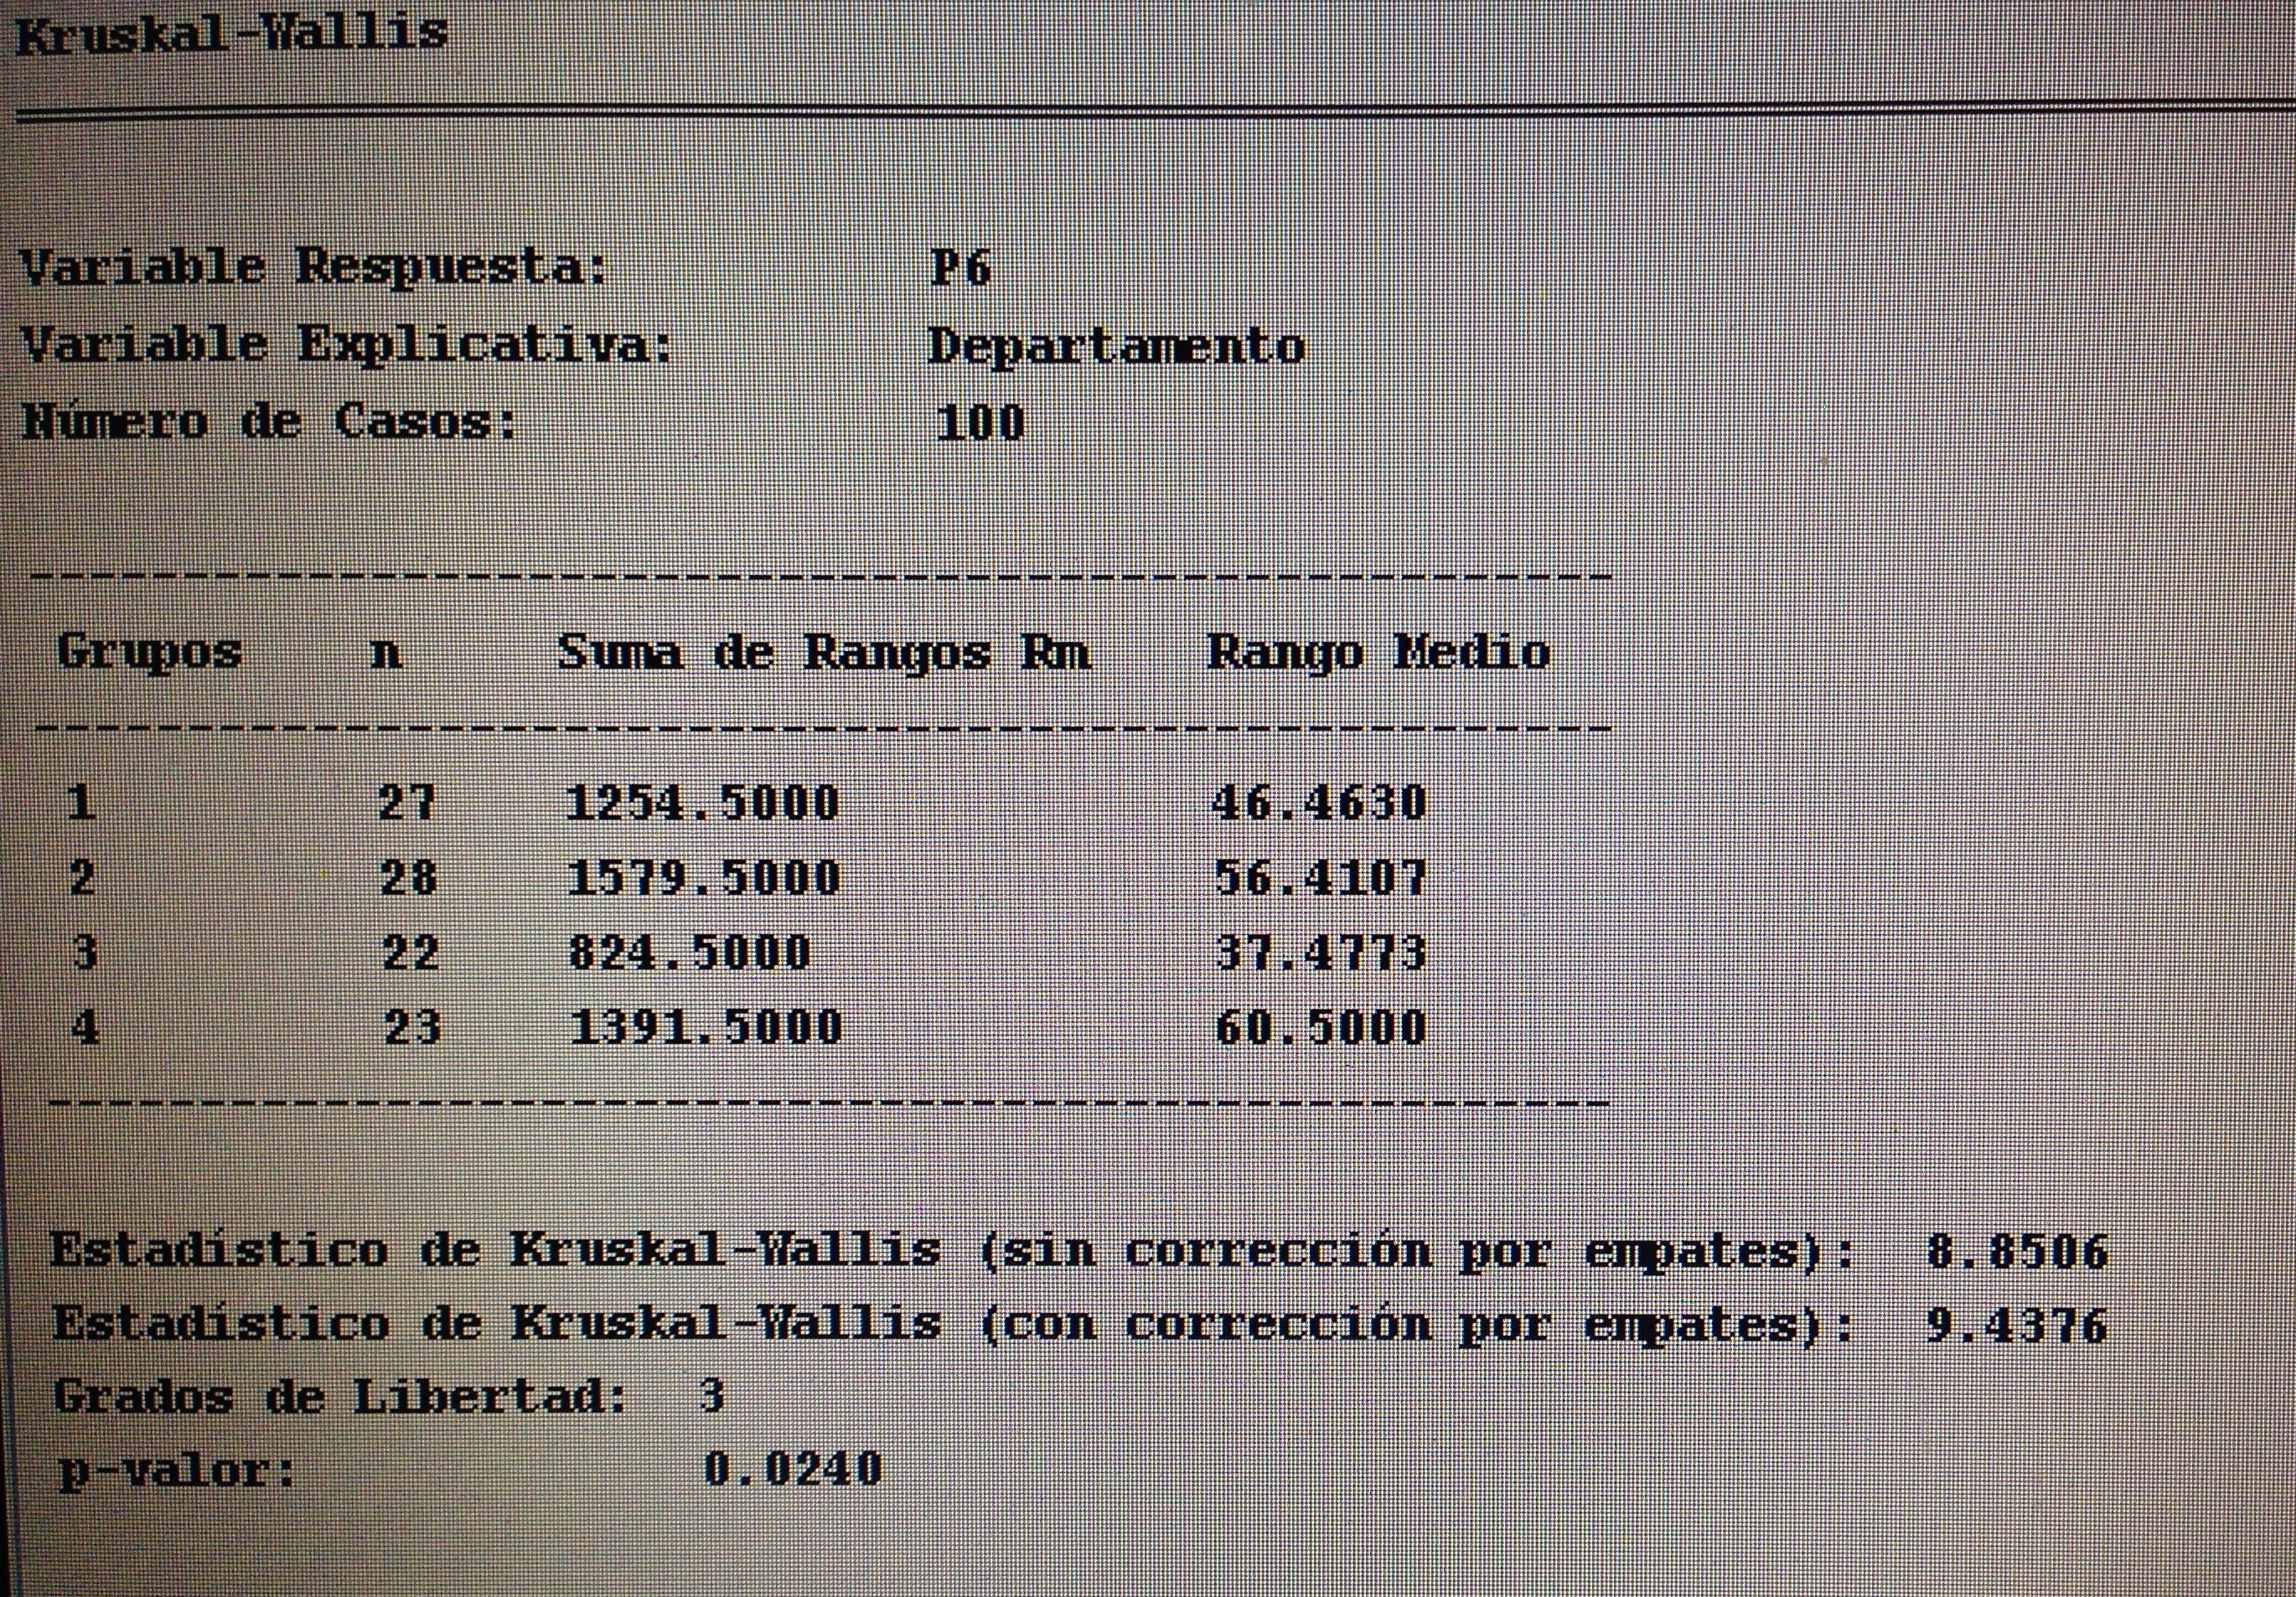
Como la variable respuesta ahora, la variable P6, es una variable tipo Likert, podemos ya directamente aplicar un Test de Kruskal-Wallis. Conceptualmente este tipo de variables no se ajusta bien nunca a una distribución normal. Son muy pocos los valores que contempla. Es verdad que tampoco es continua, pero es más oportuno, en este caso, aplicar este Test por la mucha mayor versatilidad que tiene.

IMG_7797


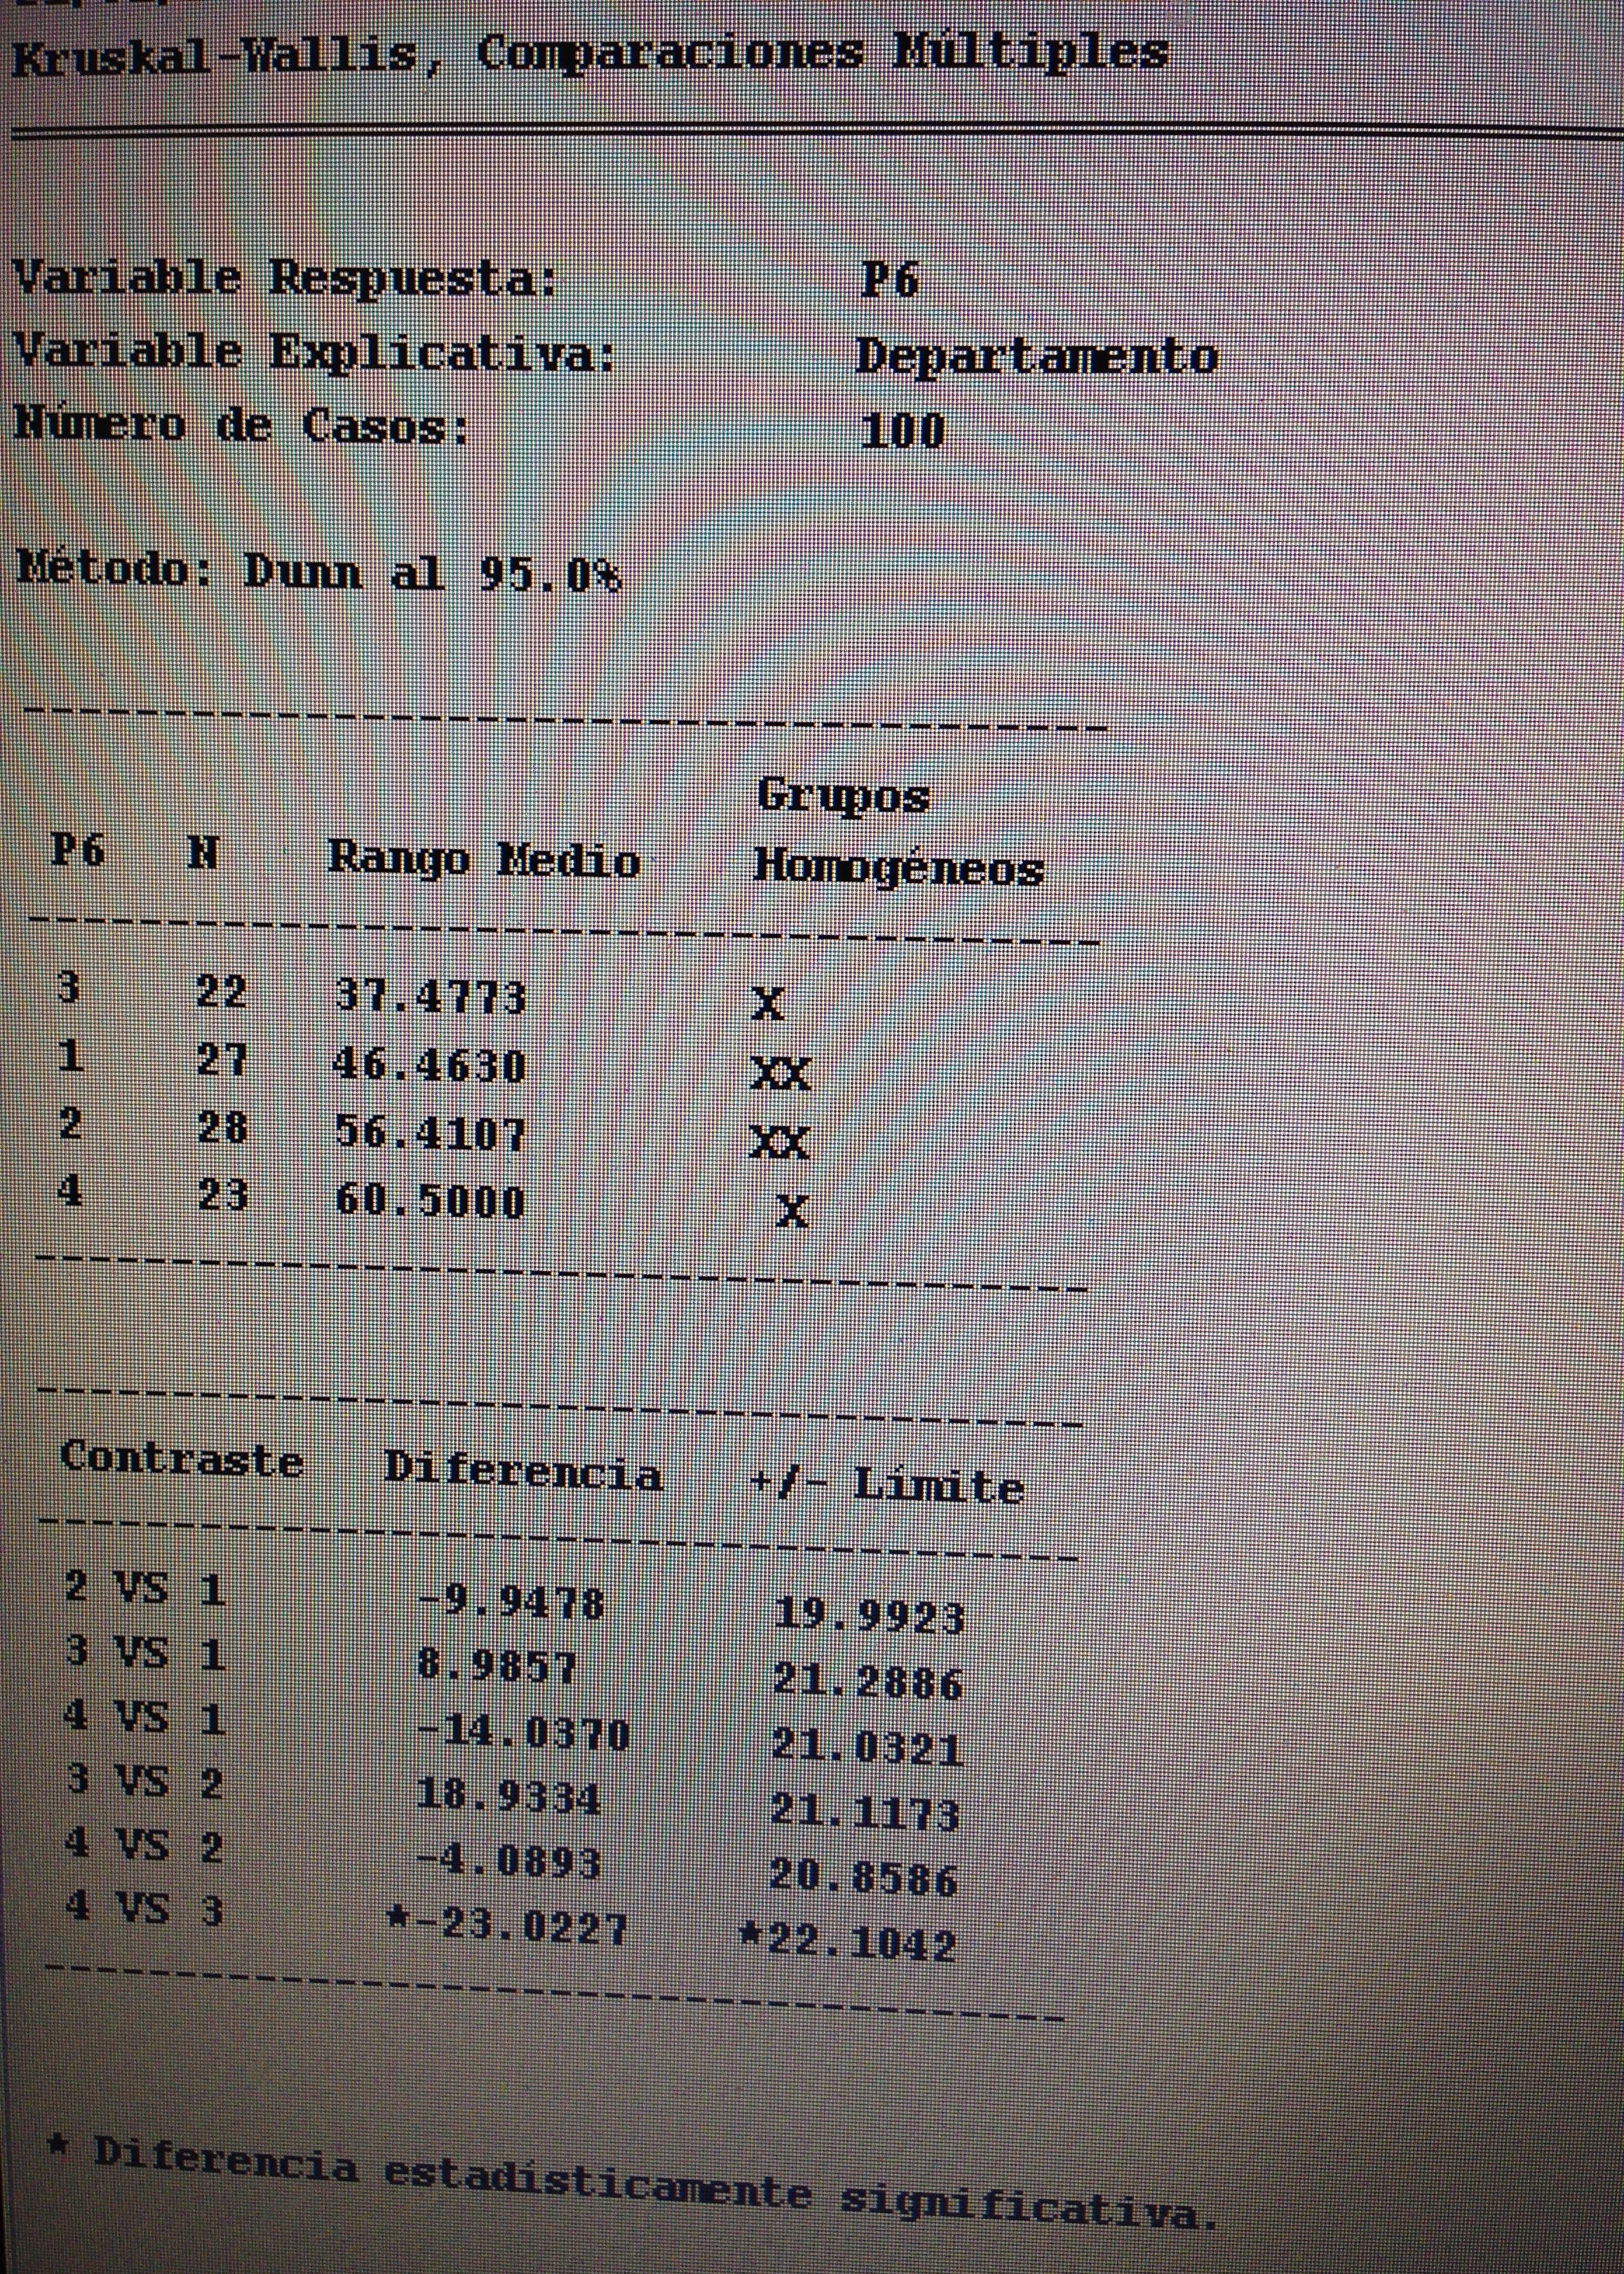
Como rechazamos la Hipótesis nula de igualdad de grupos, debemos aplicar unas comparaciones múltiples:

IMG_7811


Como puede verse, la única diferencia apreciable es la que hay entre los departamentos 3 y 4. Las otras comparaciones no muestran diferencias significativas.

Explotación de una base de datos 7: Comparación de dos poblaciones

A nuestra base de datos adjunta en el artículo Explotación de una base de datos 1: Base de datos le podemos aplicar diferentes comparaciones de dos poblaciones. Veamos algunos ejemplos:

1. Compobar si hay diferencias significativas en cuanto a la Valoración general entre los hombres y mujeres. Calcular la d de Cohen si es que antes se comprueba que la diferencia es estadísticamente significativa.
2. Comparar la Valoración general entre los operados y no operados. Calcular la d de Cohen si es que antes se comprueba que la diferencia es estadísticamente significativa.

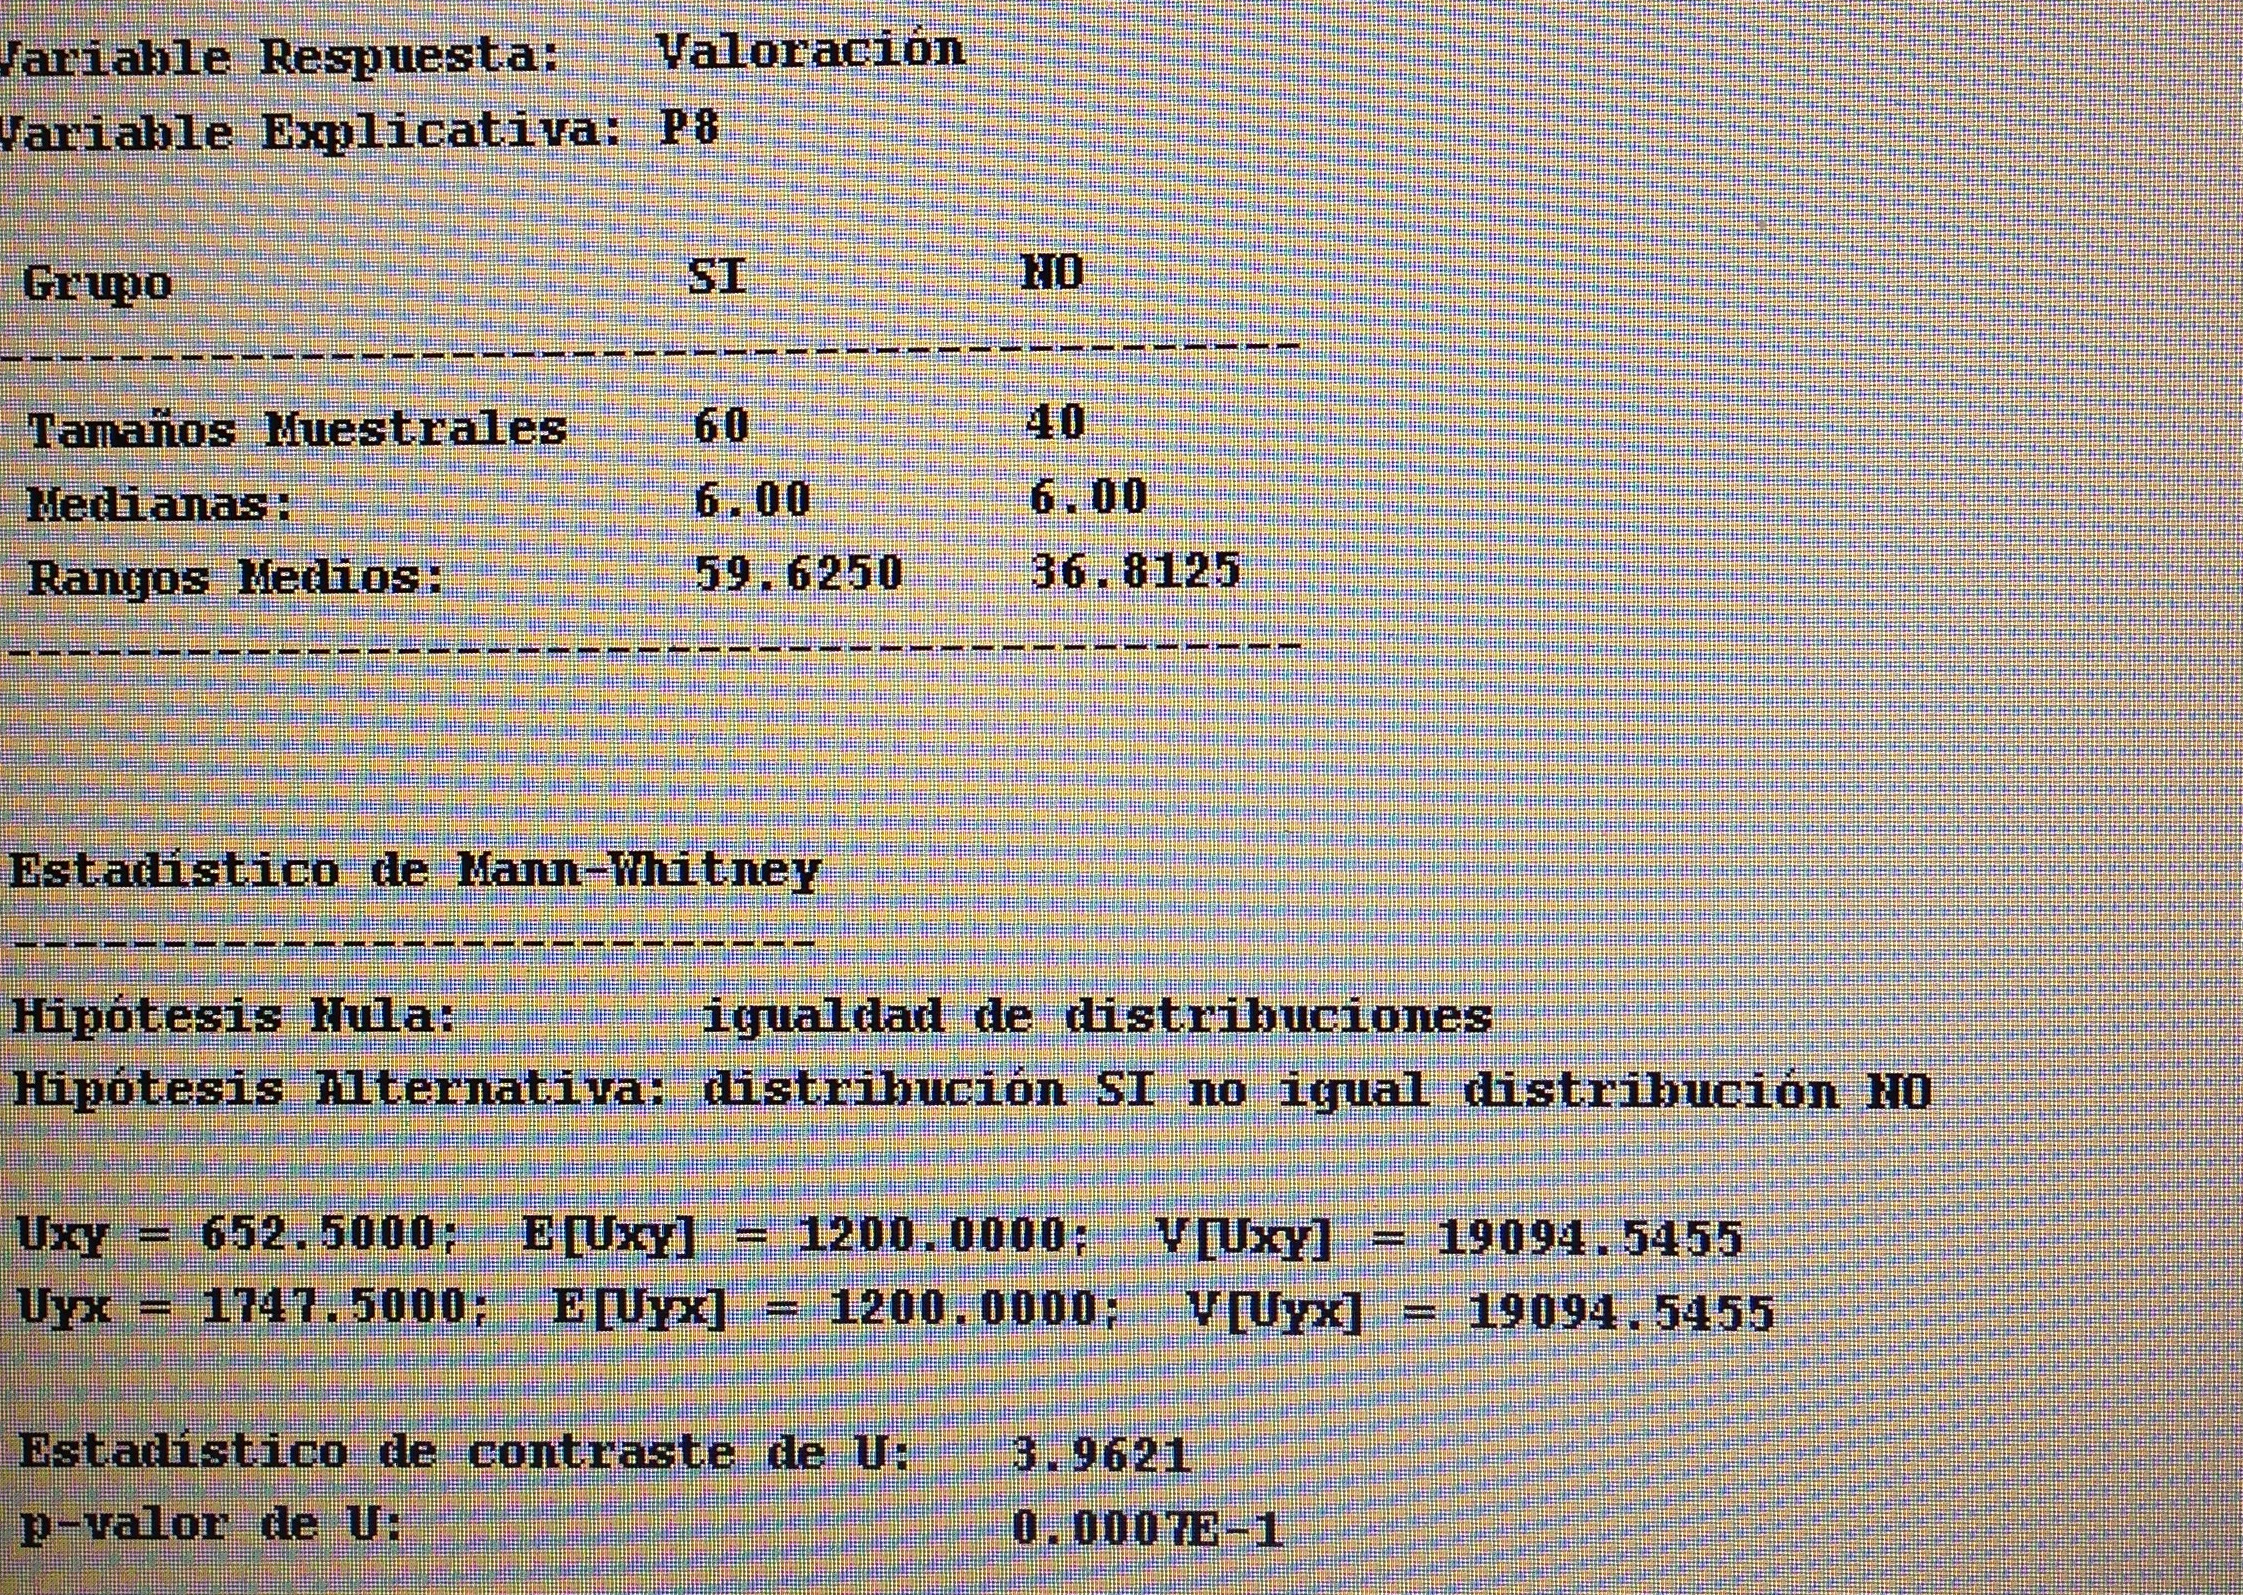
3. Comparar si los dos grupos formados por la variable P8 tienen valores diferentes, significativamente, en cuanto a la variable Valoración. Calcular la d de Cohen si es que antes se comprueba que la diferencia es estadísticamente significativa.

SOLUCIONES:

1. Compobar si hay diferencias significativas en cuanto a la Valoración general entre los hombres y mujeres. Calcular la d de Cohen si es que antes se comprueba que la diferencia es estadísticamente significativa:
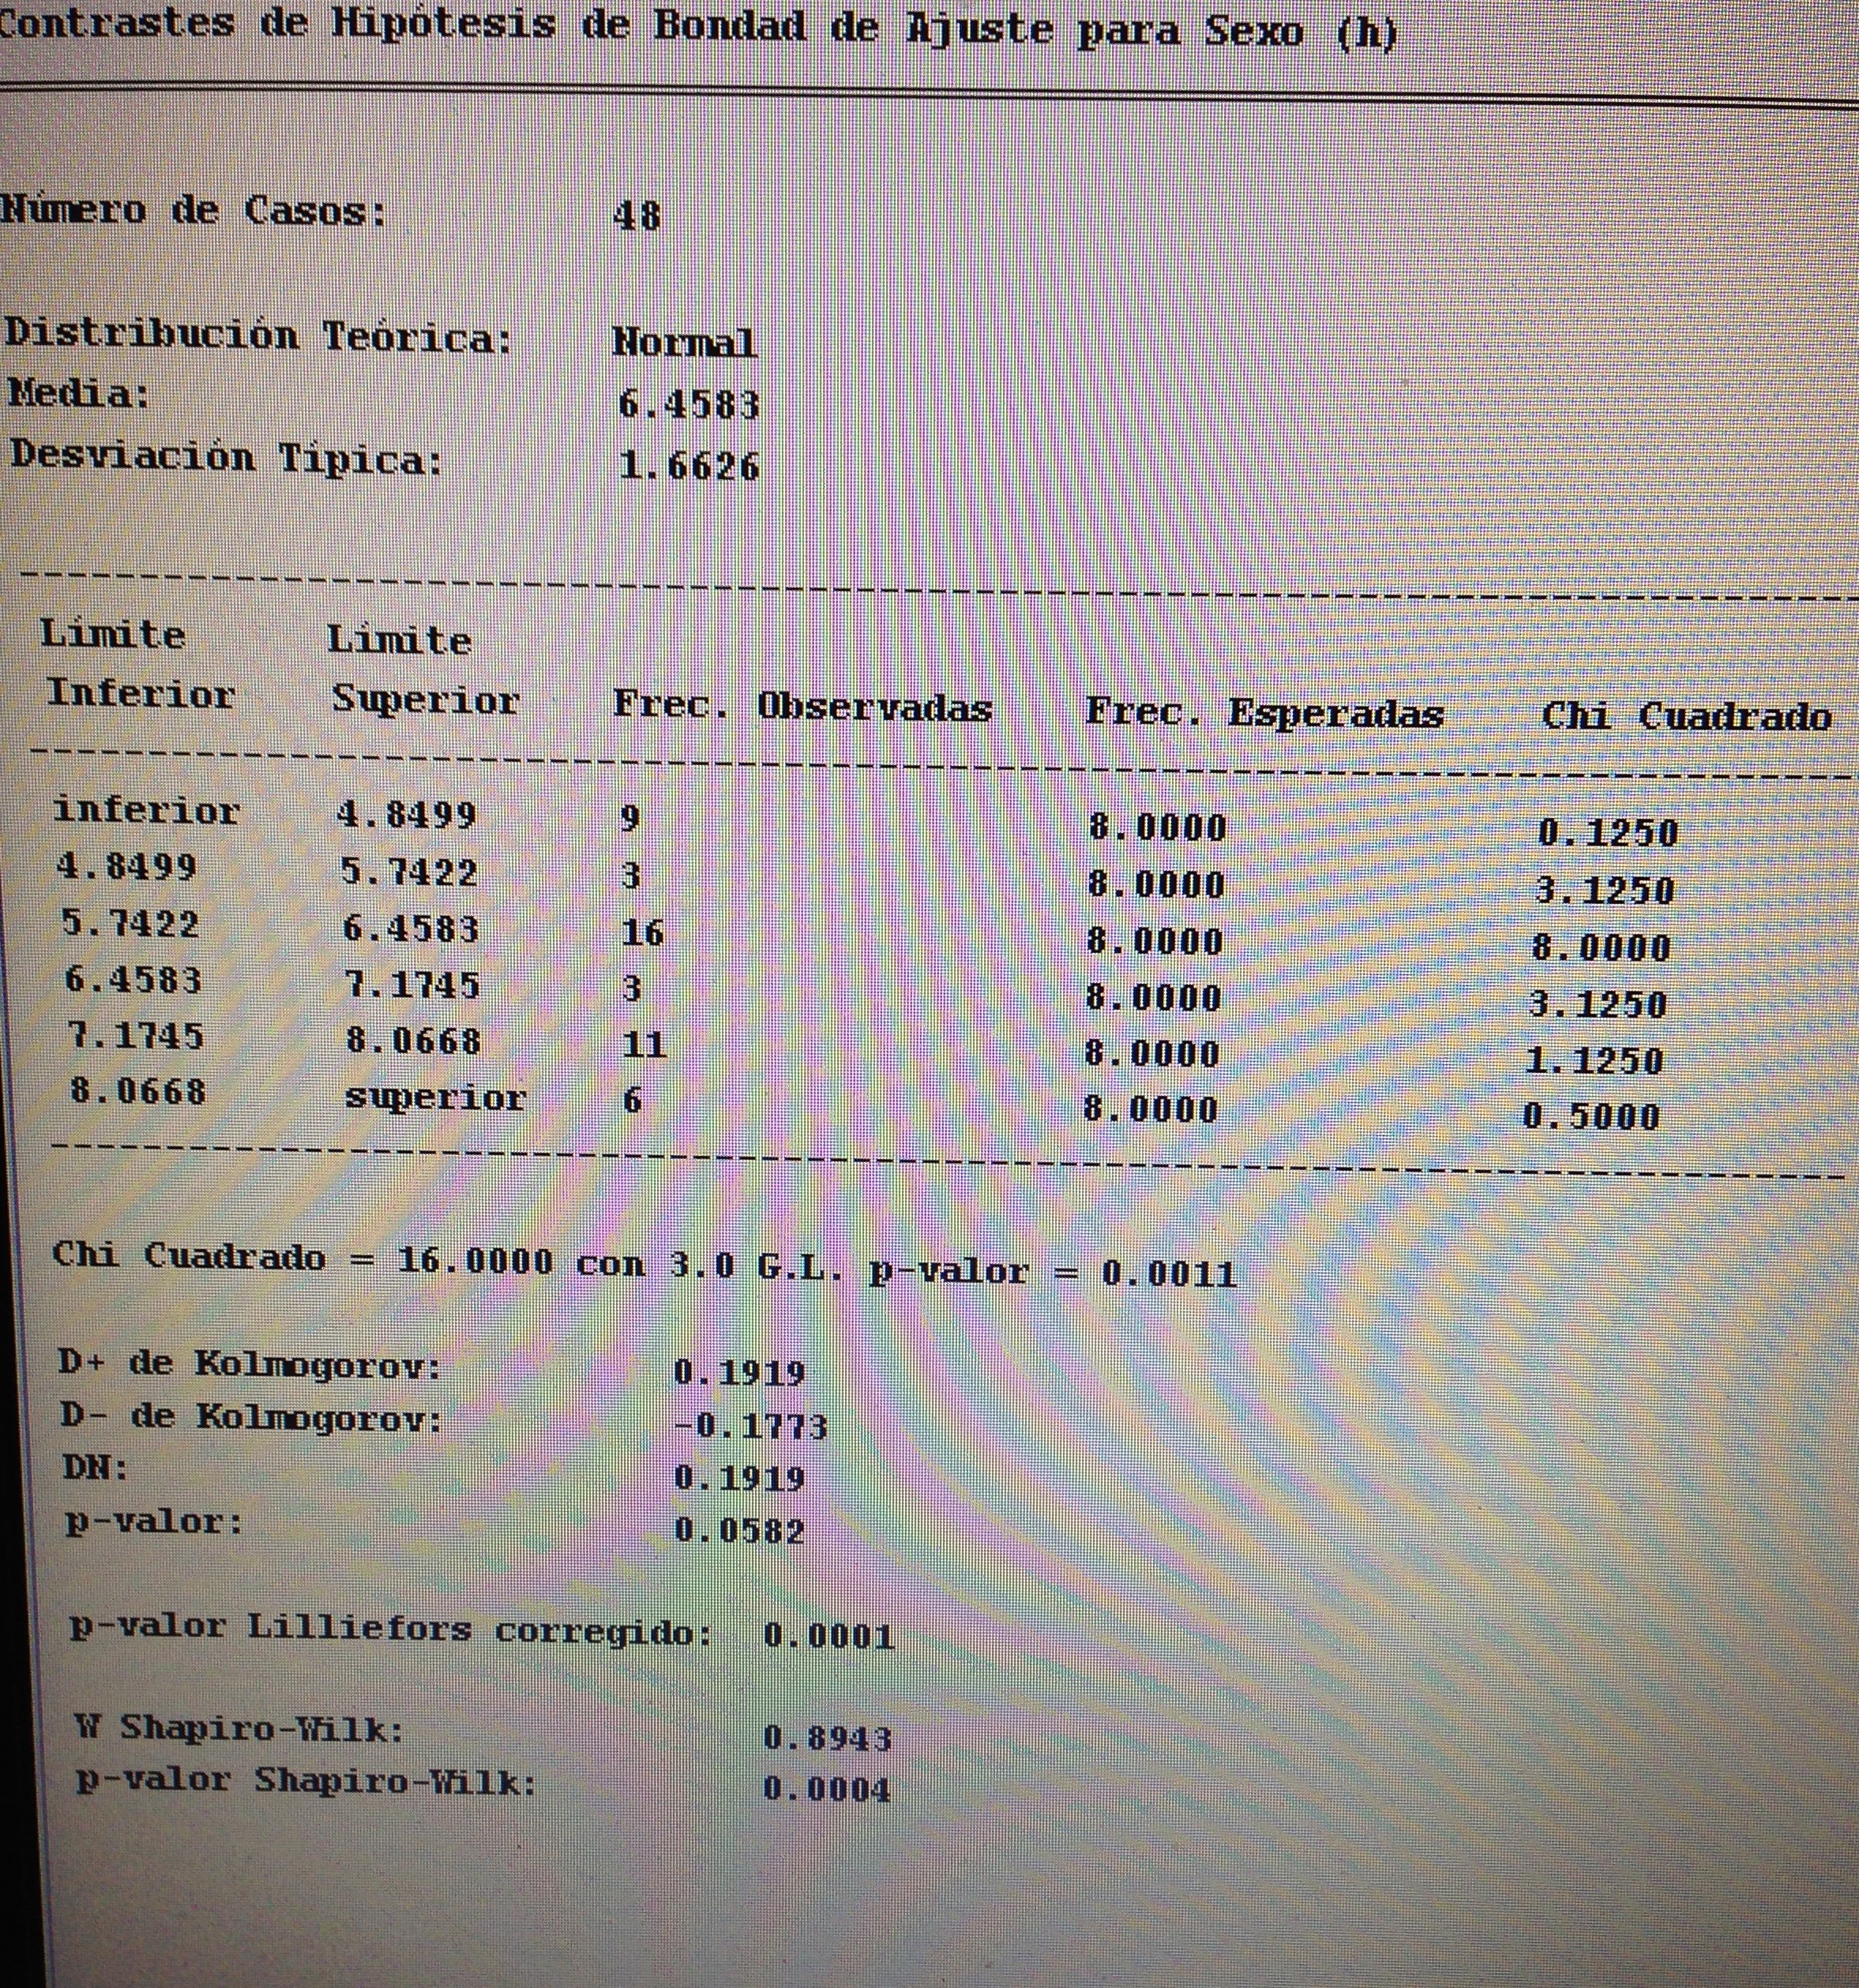
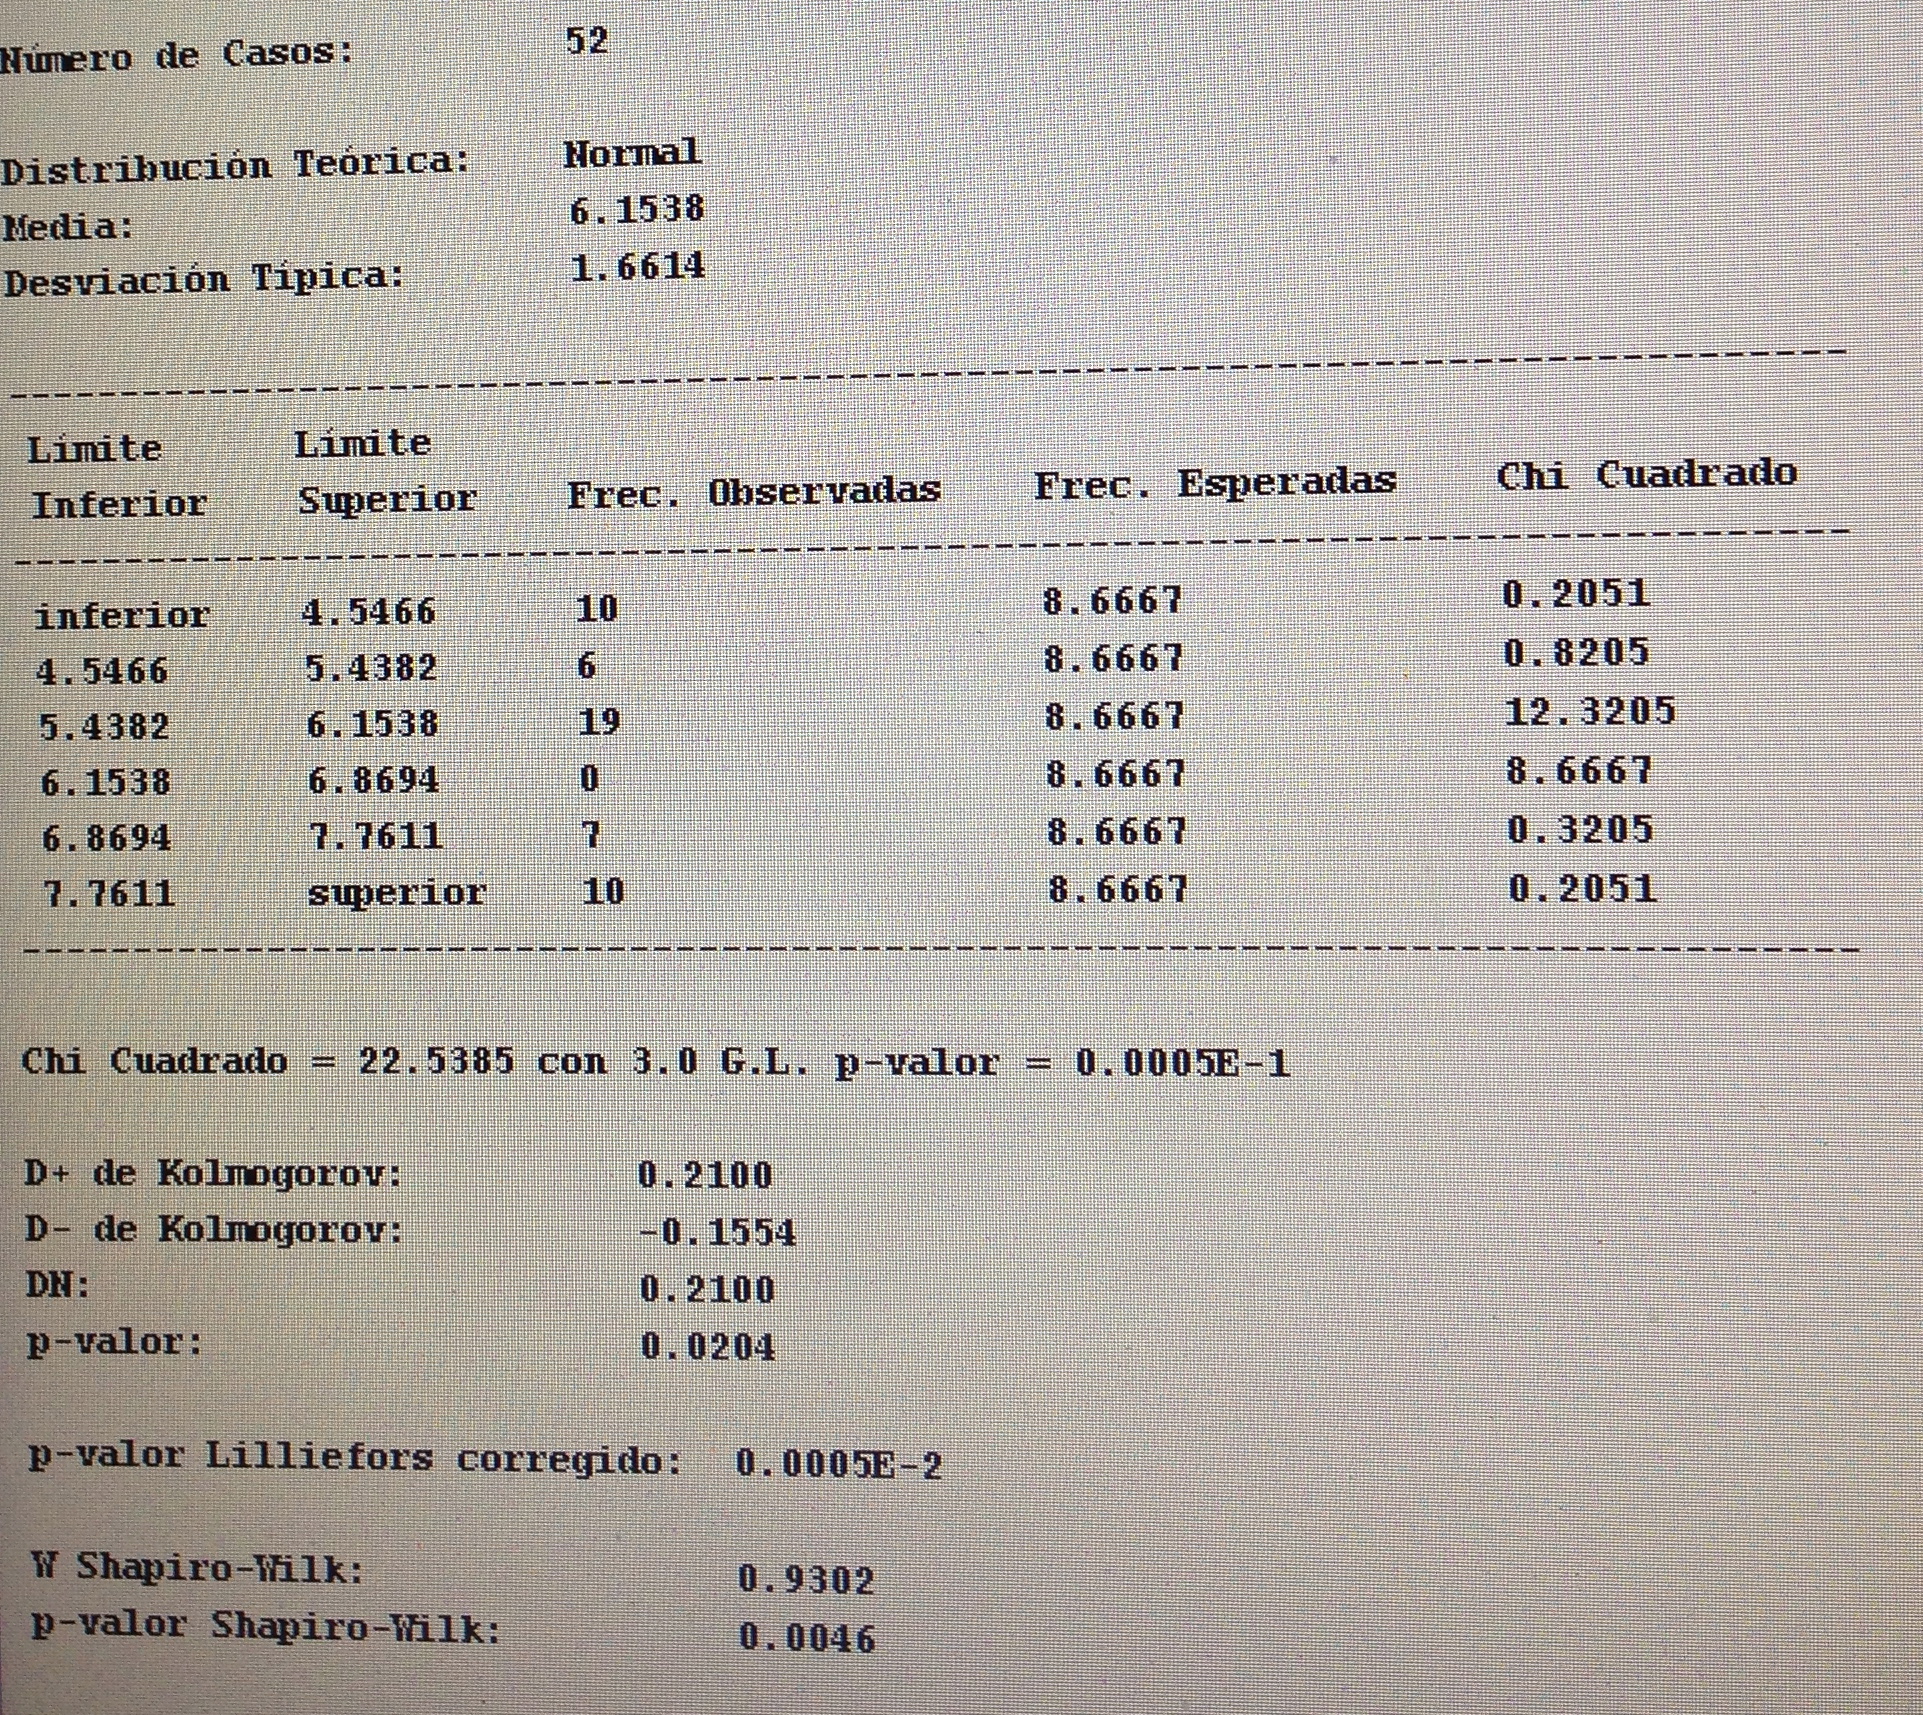
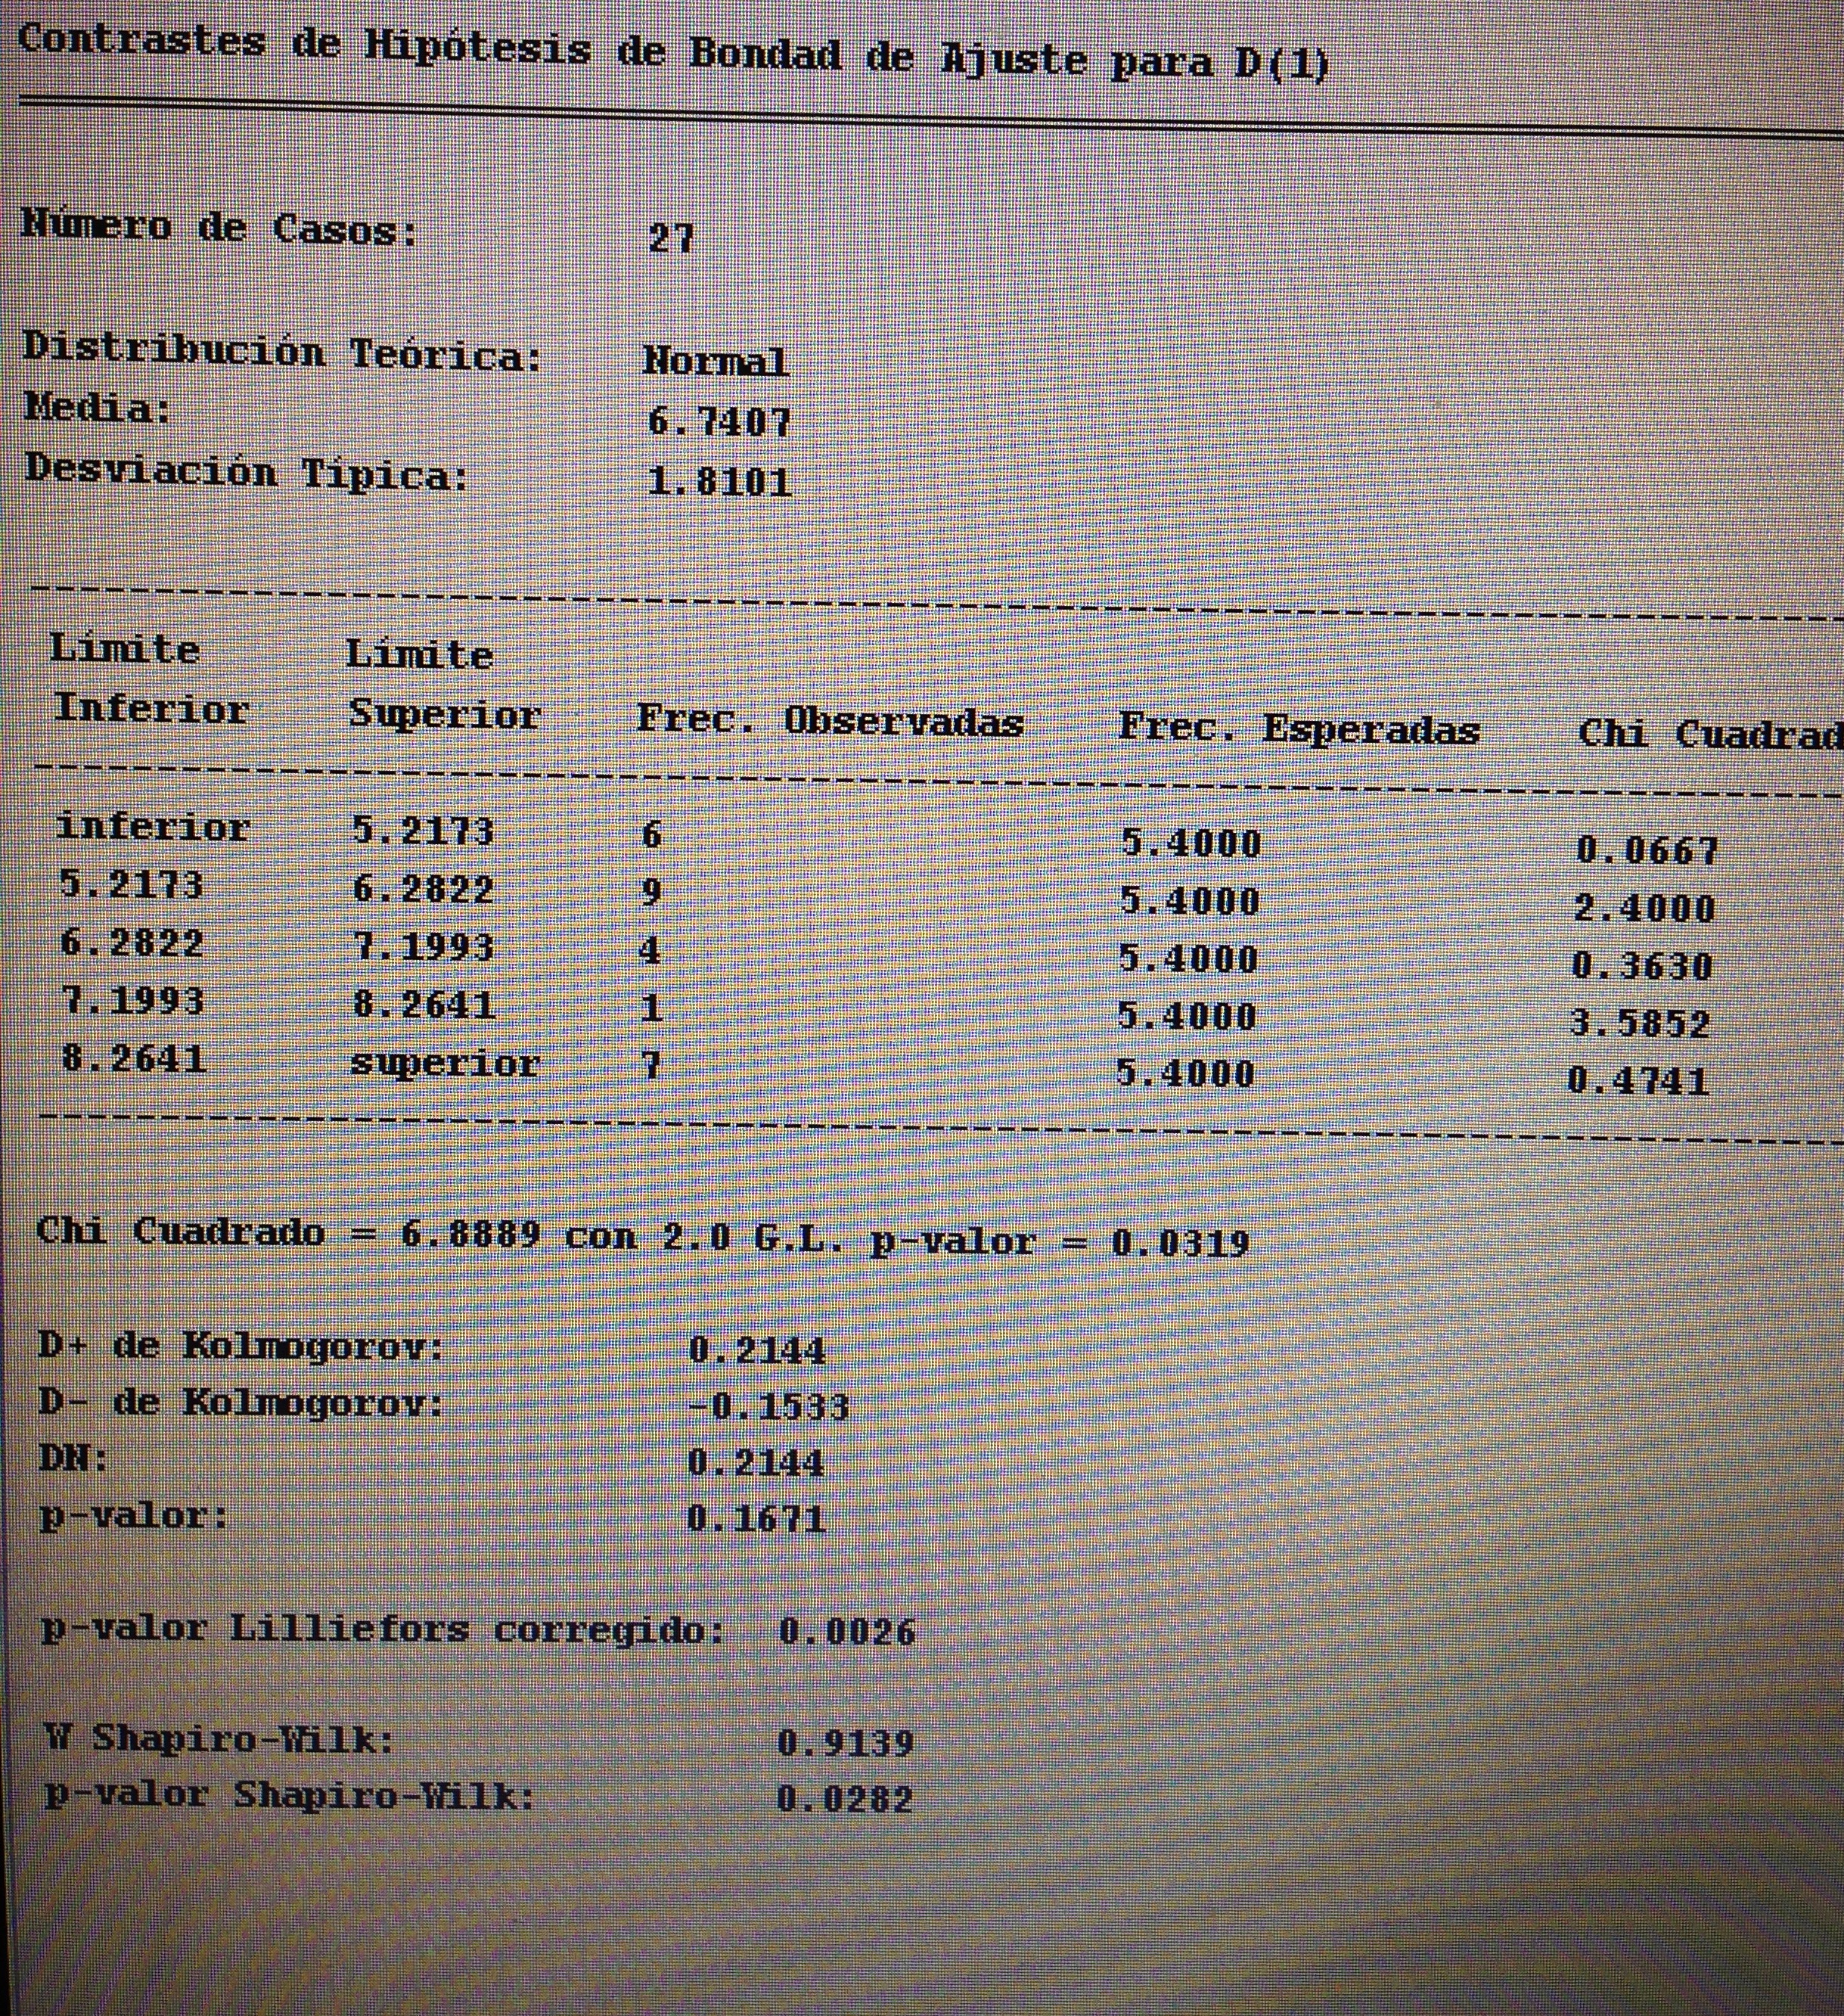
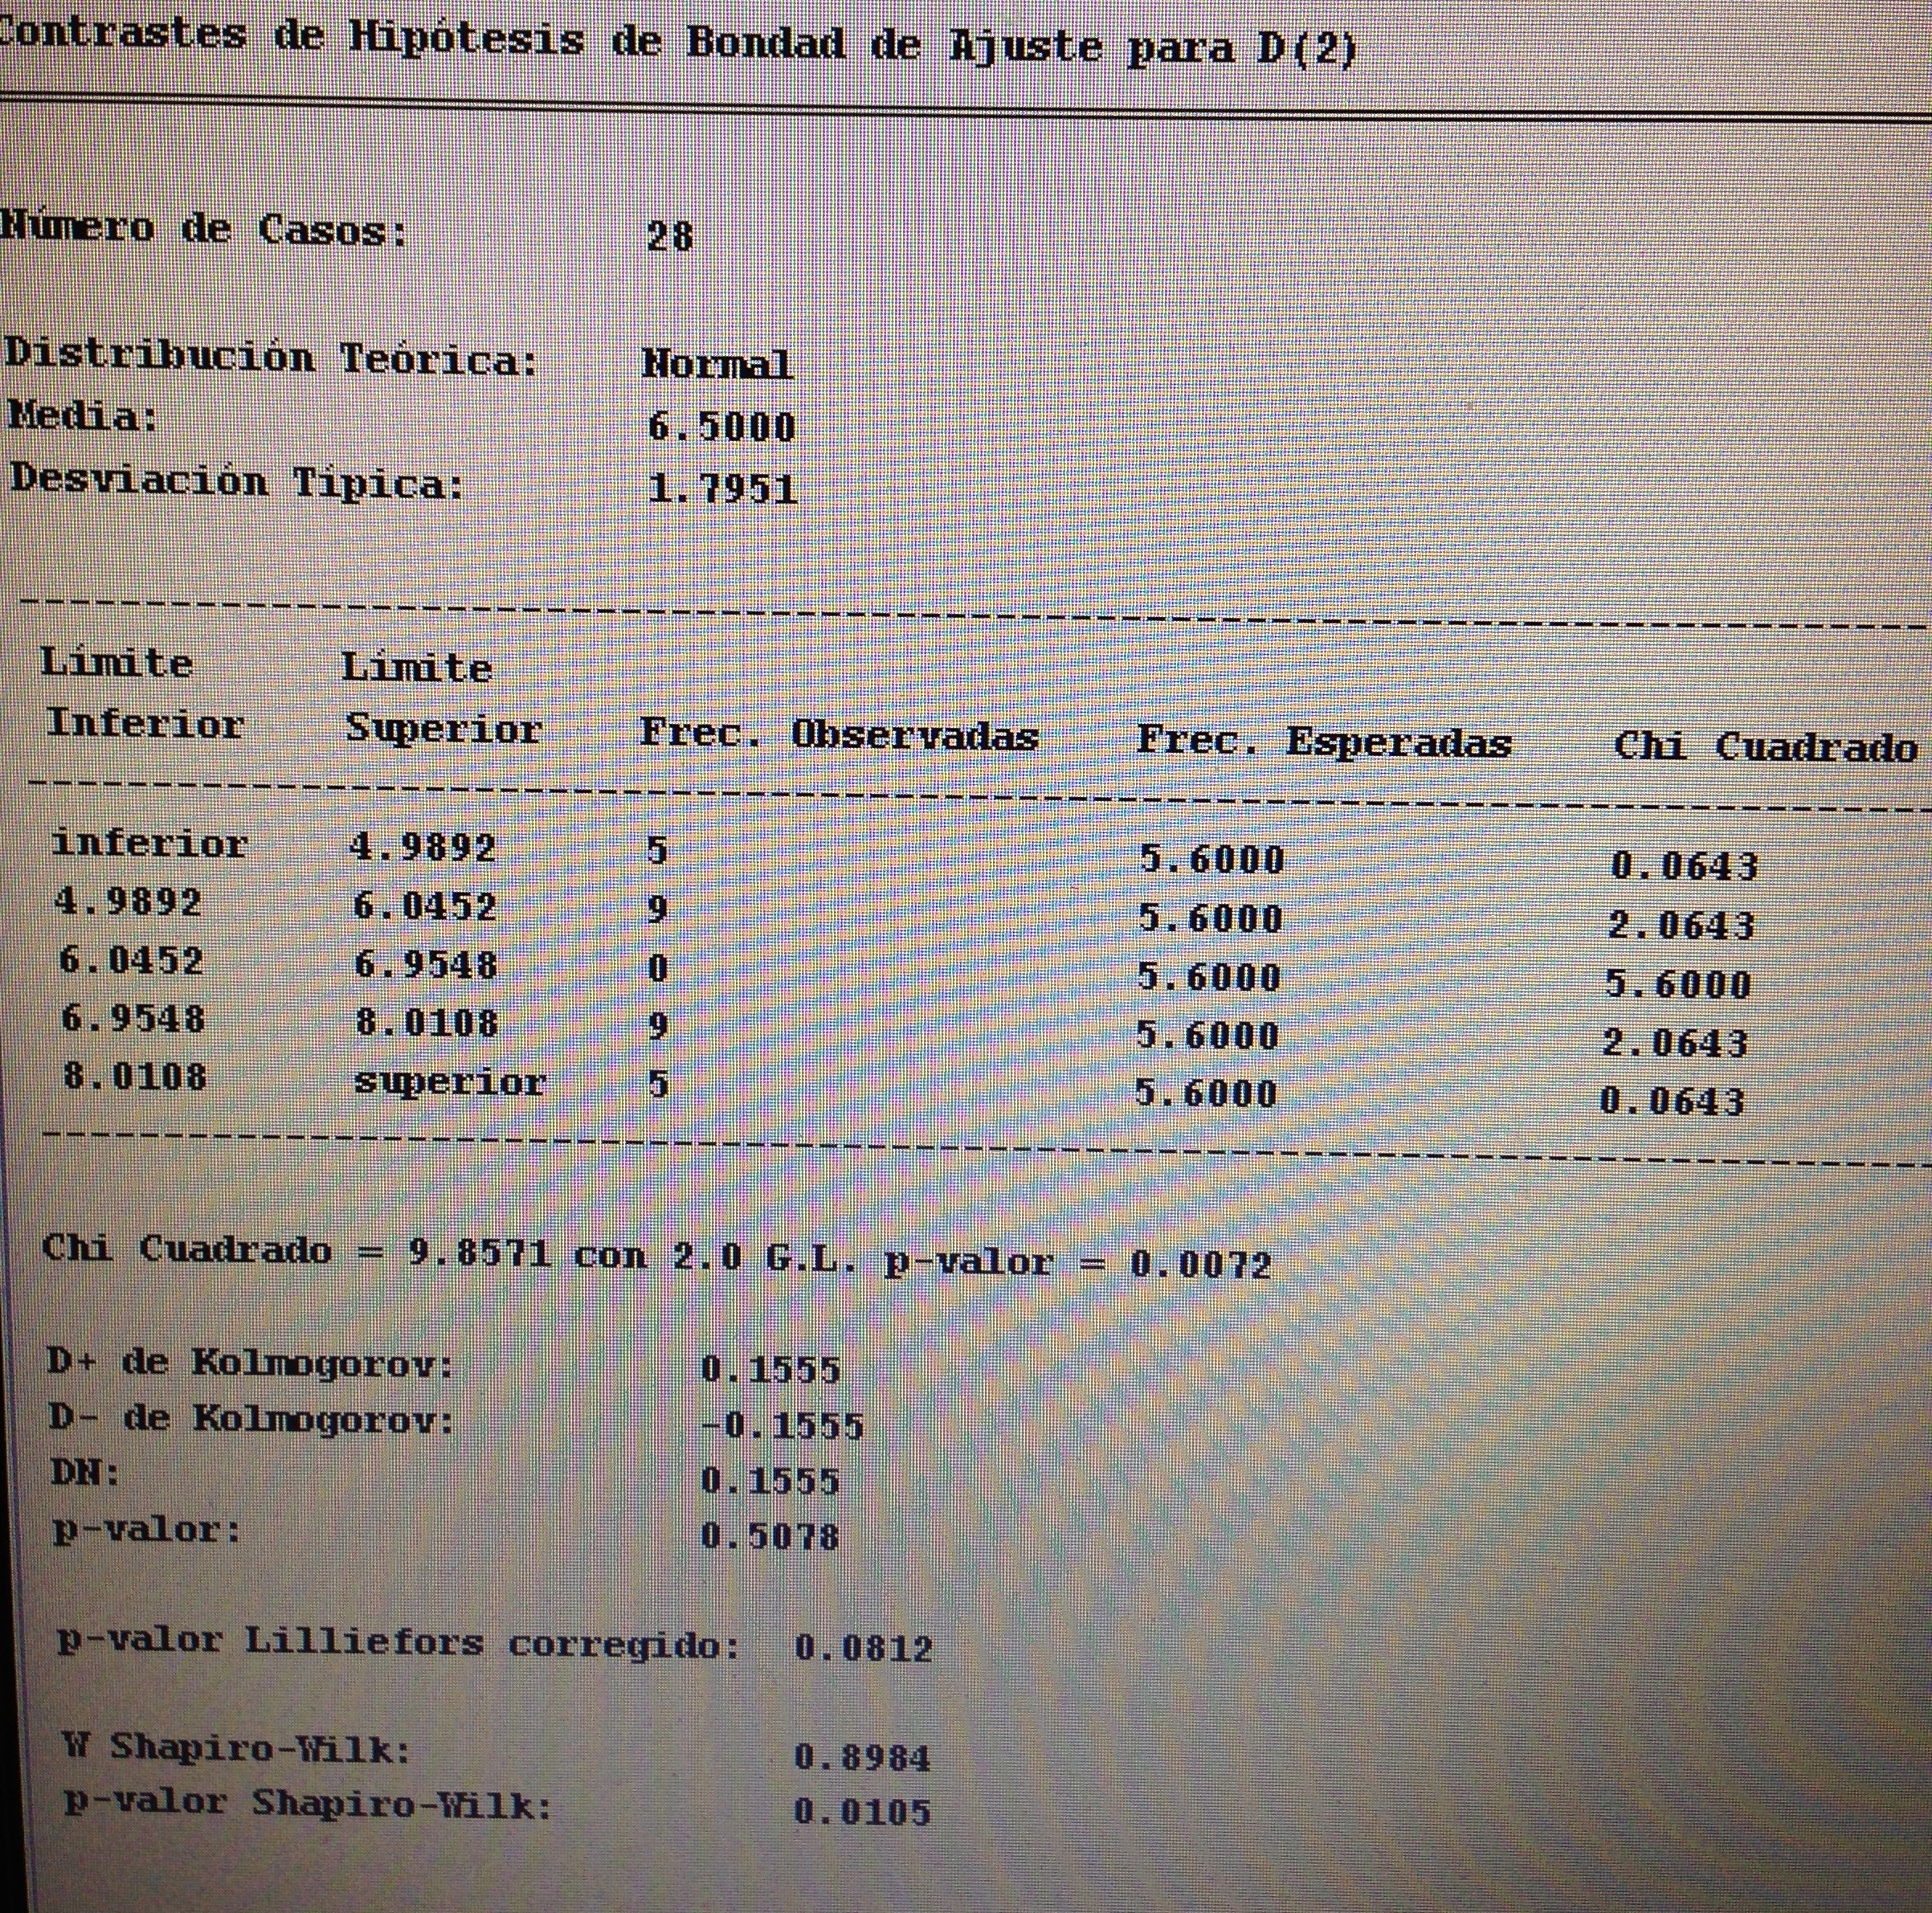
Se trata de variables continuas, muestras independientes, por lo tanto, hace falta comprobar la normalidad de cada una de las dos muestras:

IMG_7799

IMG_7800

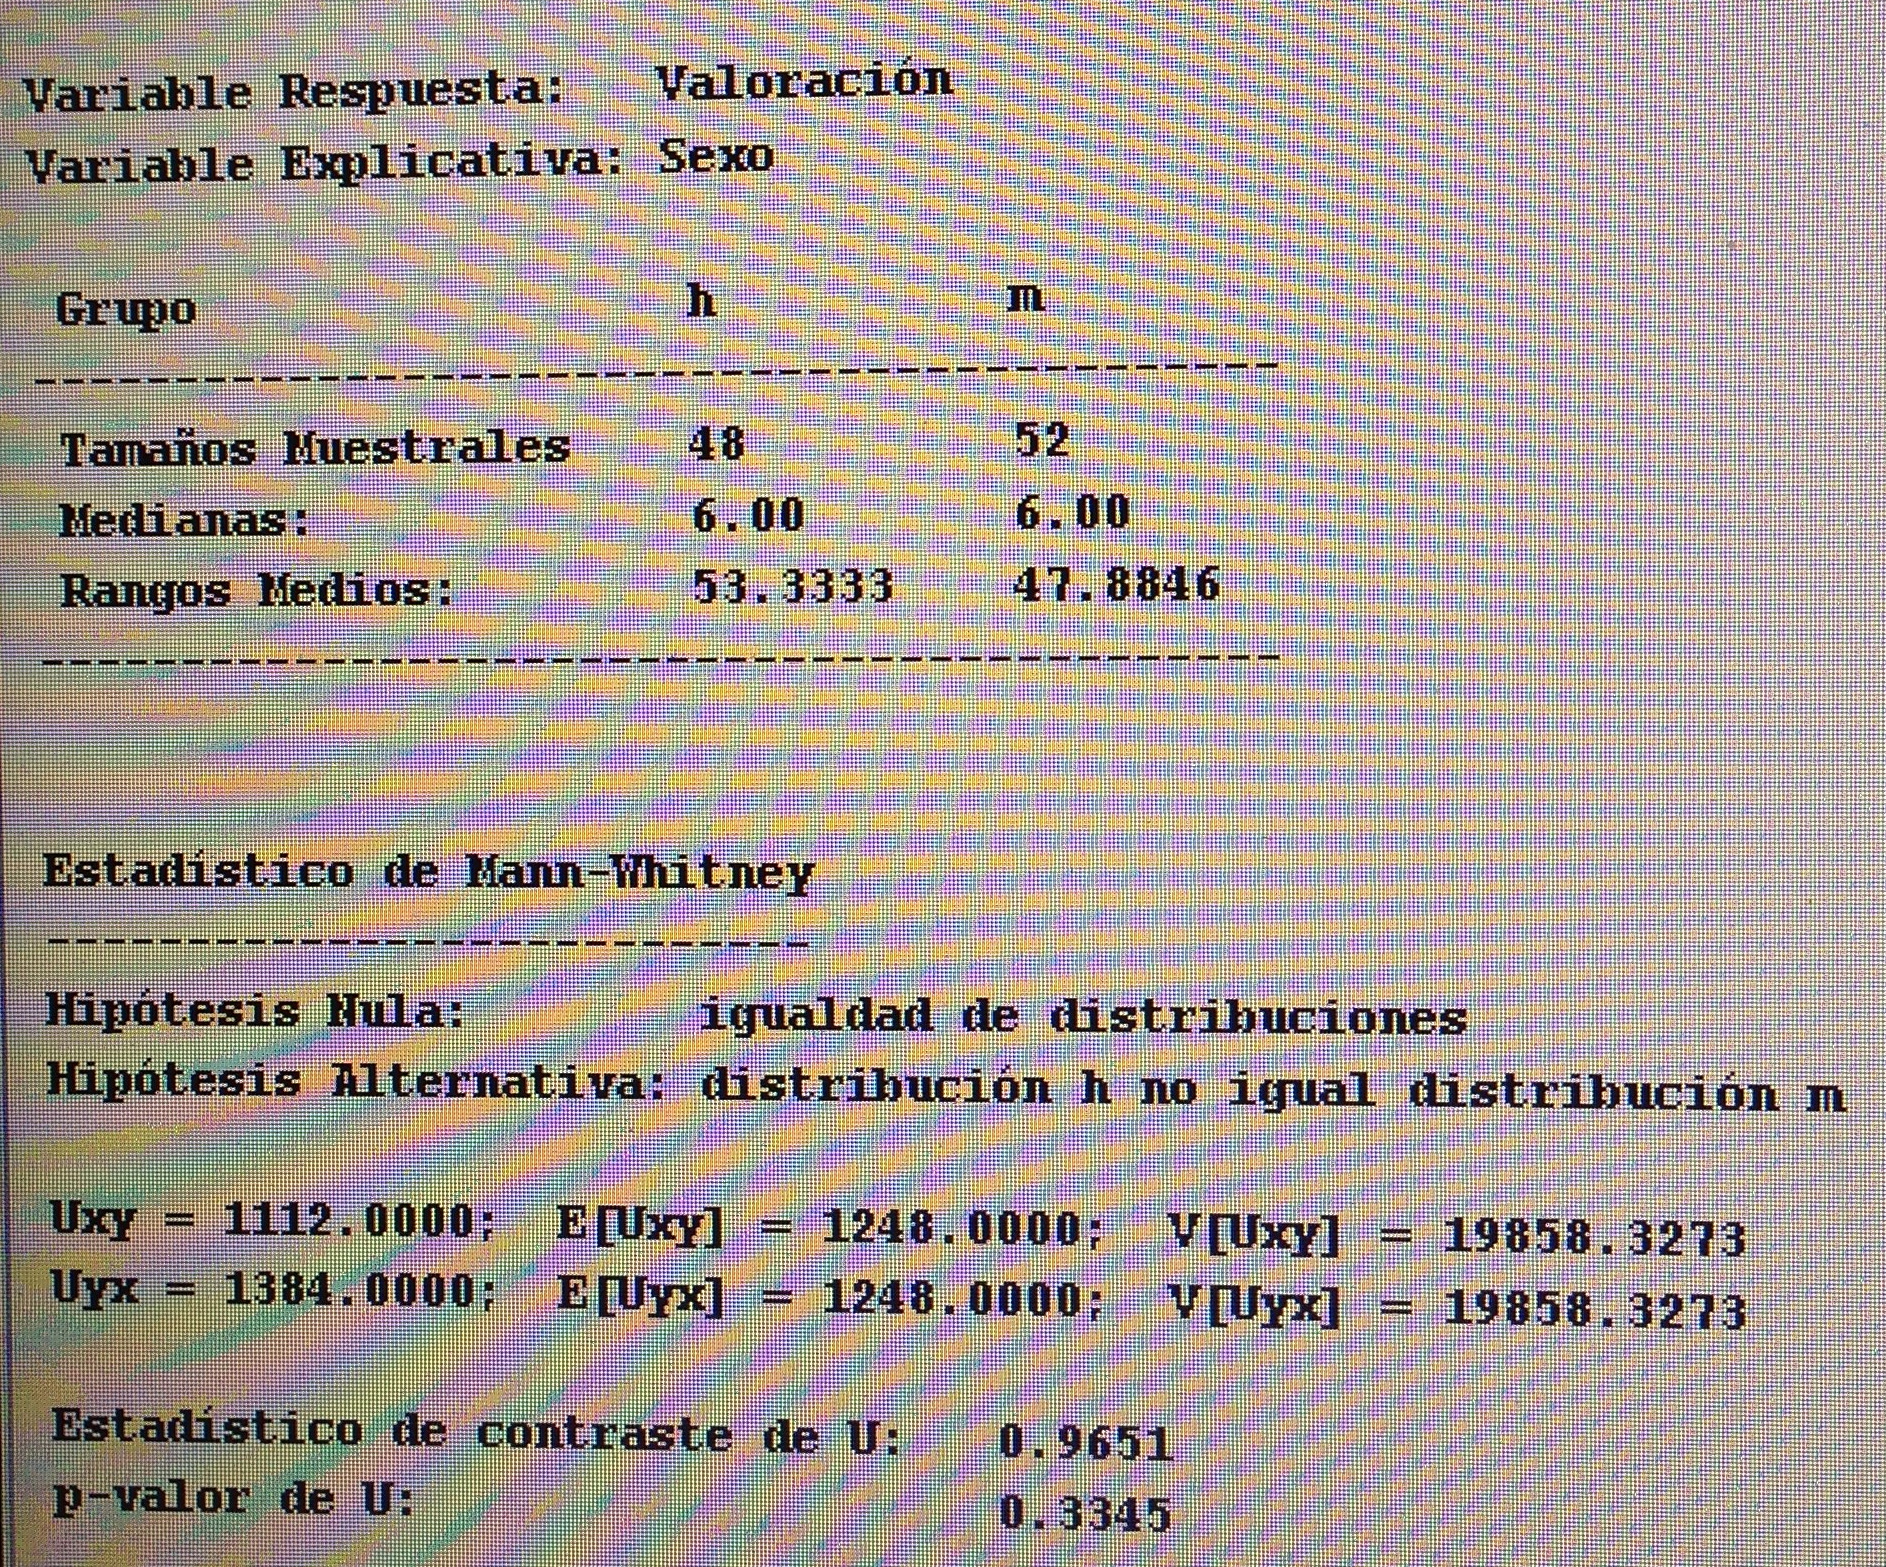
Debemos, pues, aplicar el Test de Mann-Whitney:

IMG_7803


No hay diferencias significativas entre los dos sexos, por lo tanto no tiene sentido aplicar aquí la d de Cohen.

2. Comparar la Valoración general entre los operados y no operados. Calcular la d de Cohen si es que antes se comprueba que la diferencia es estadísticamente significativa:

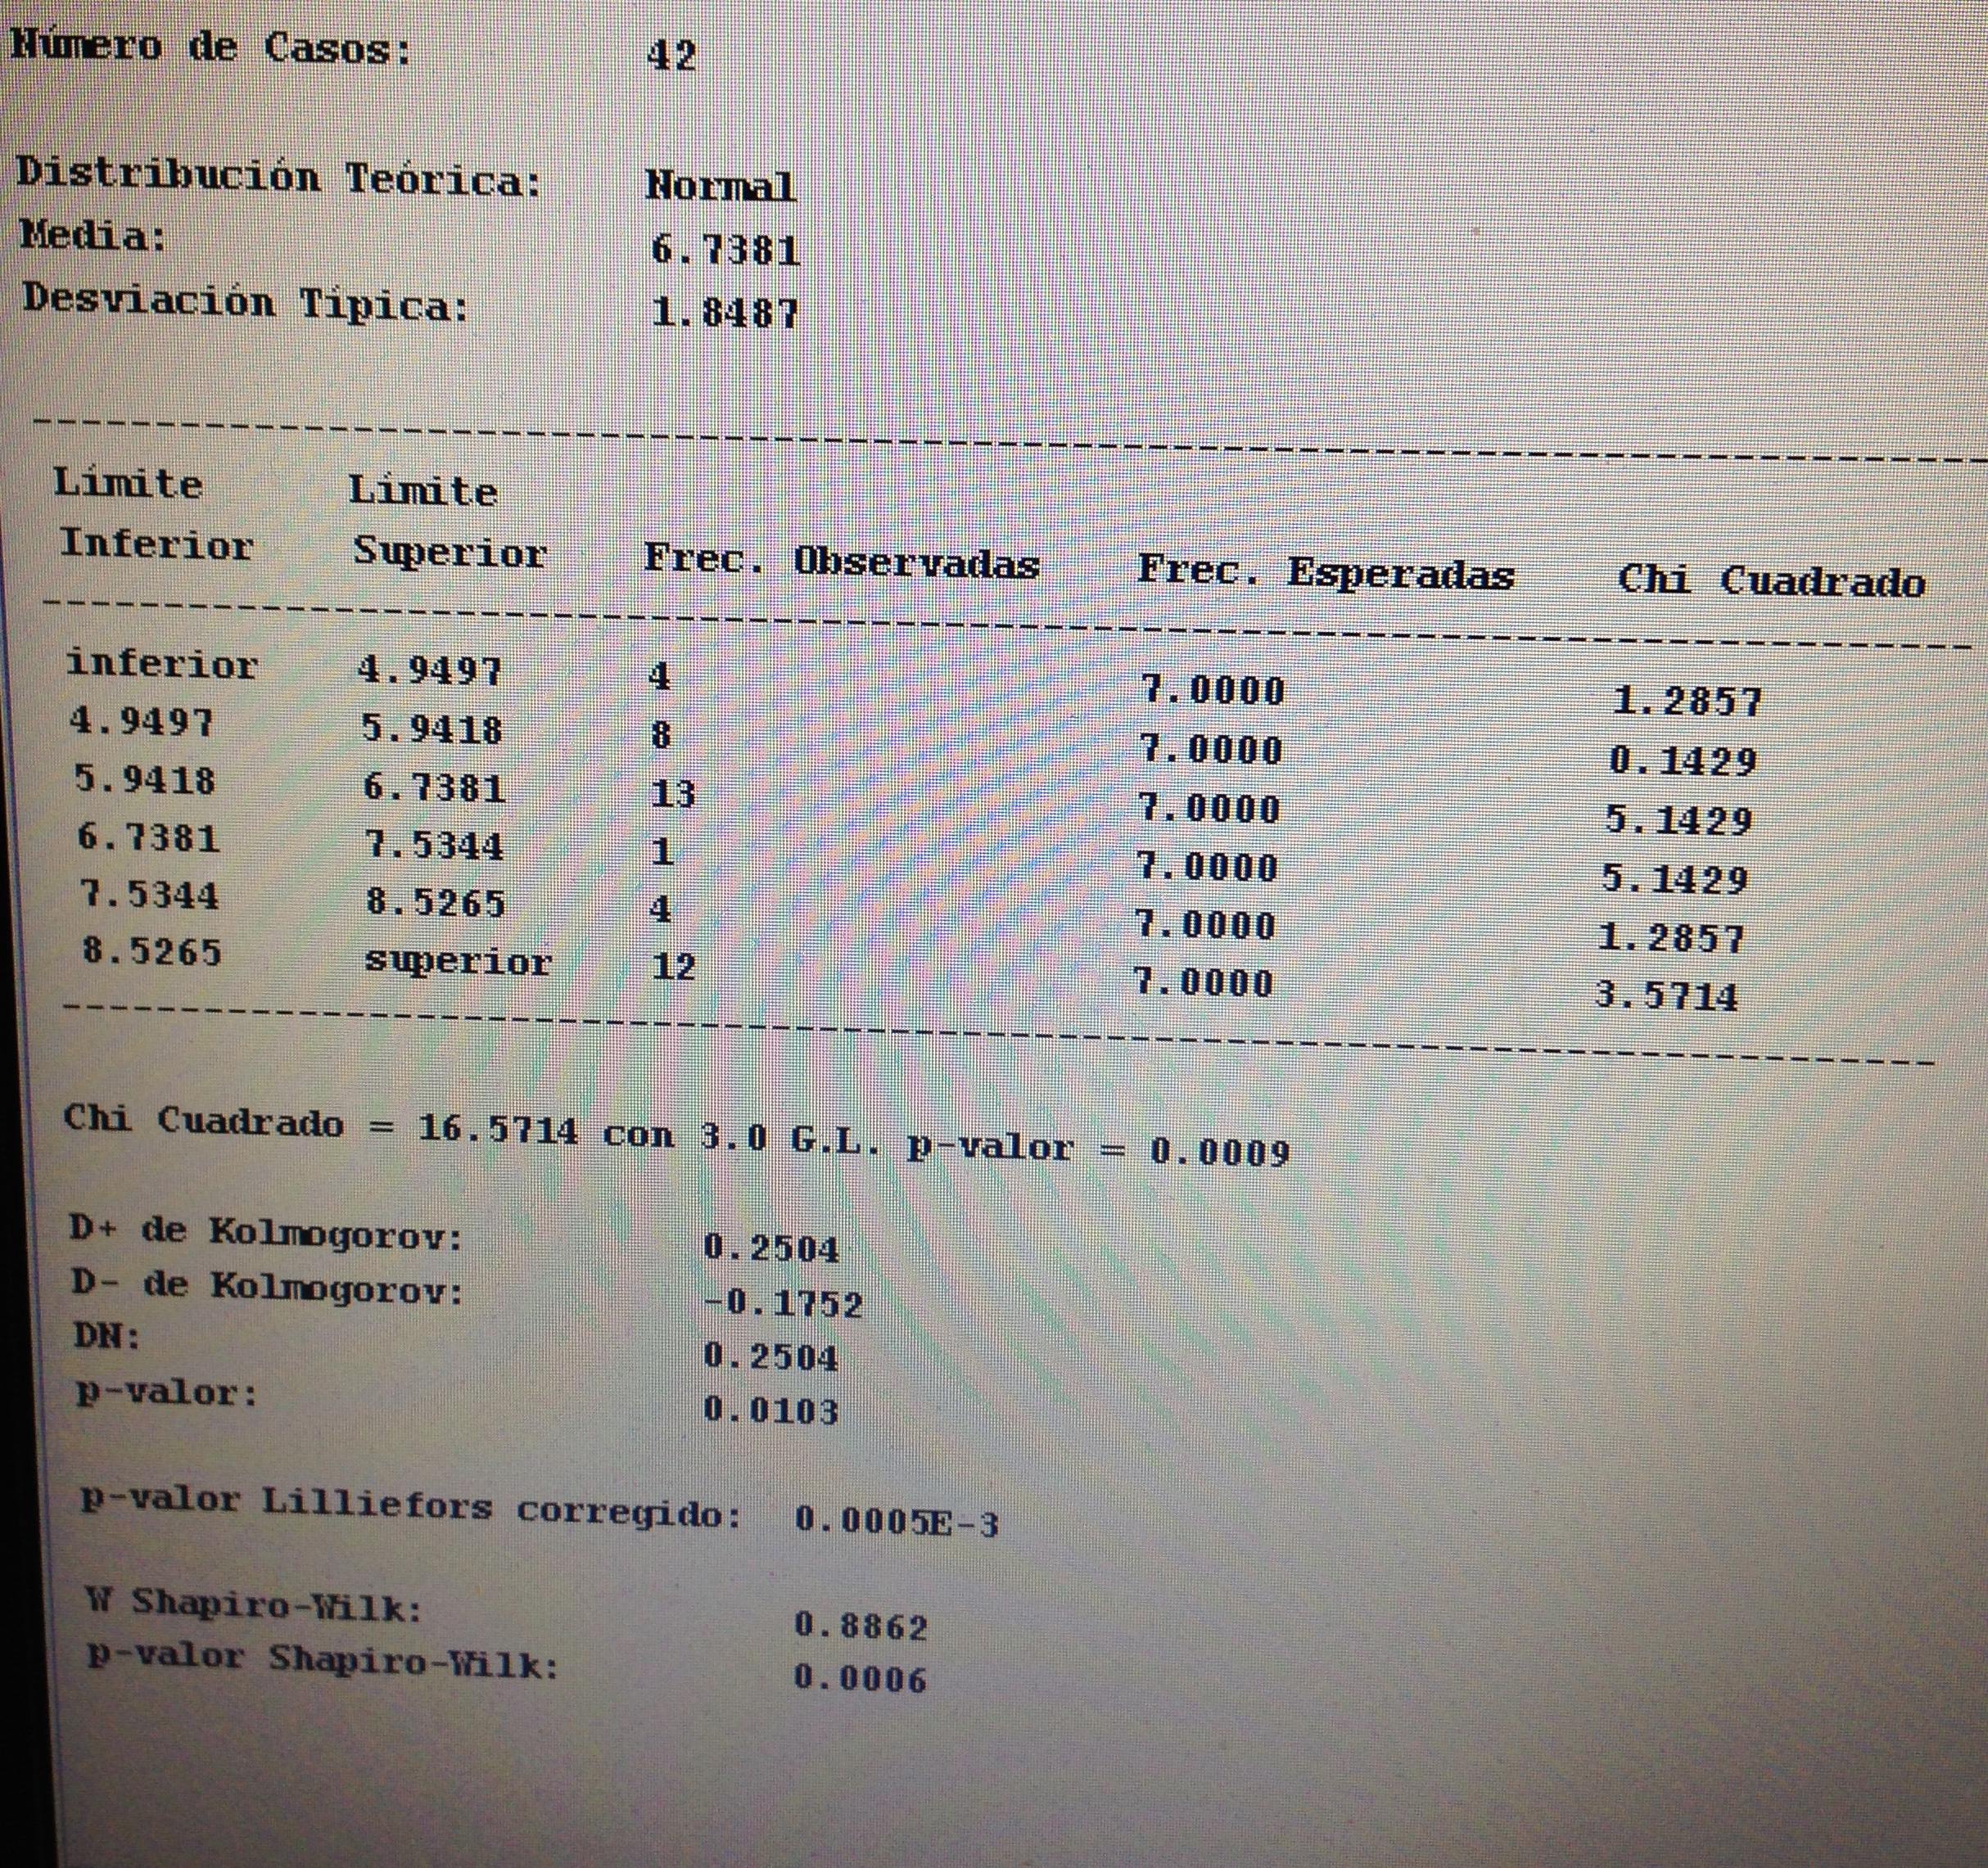
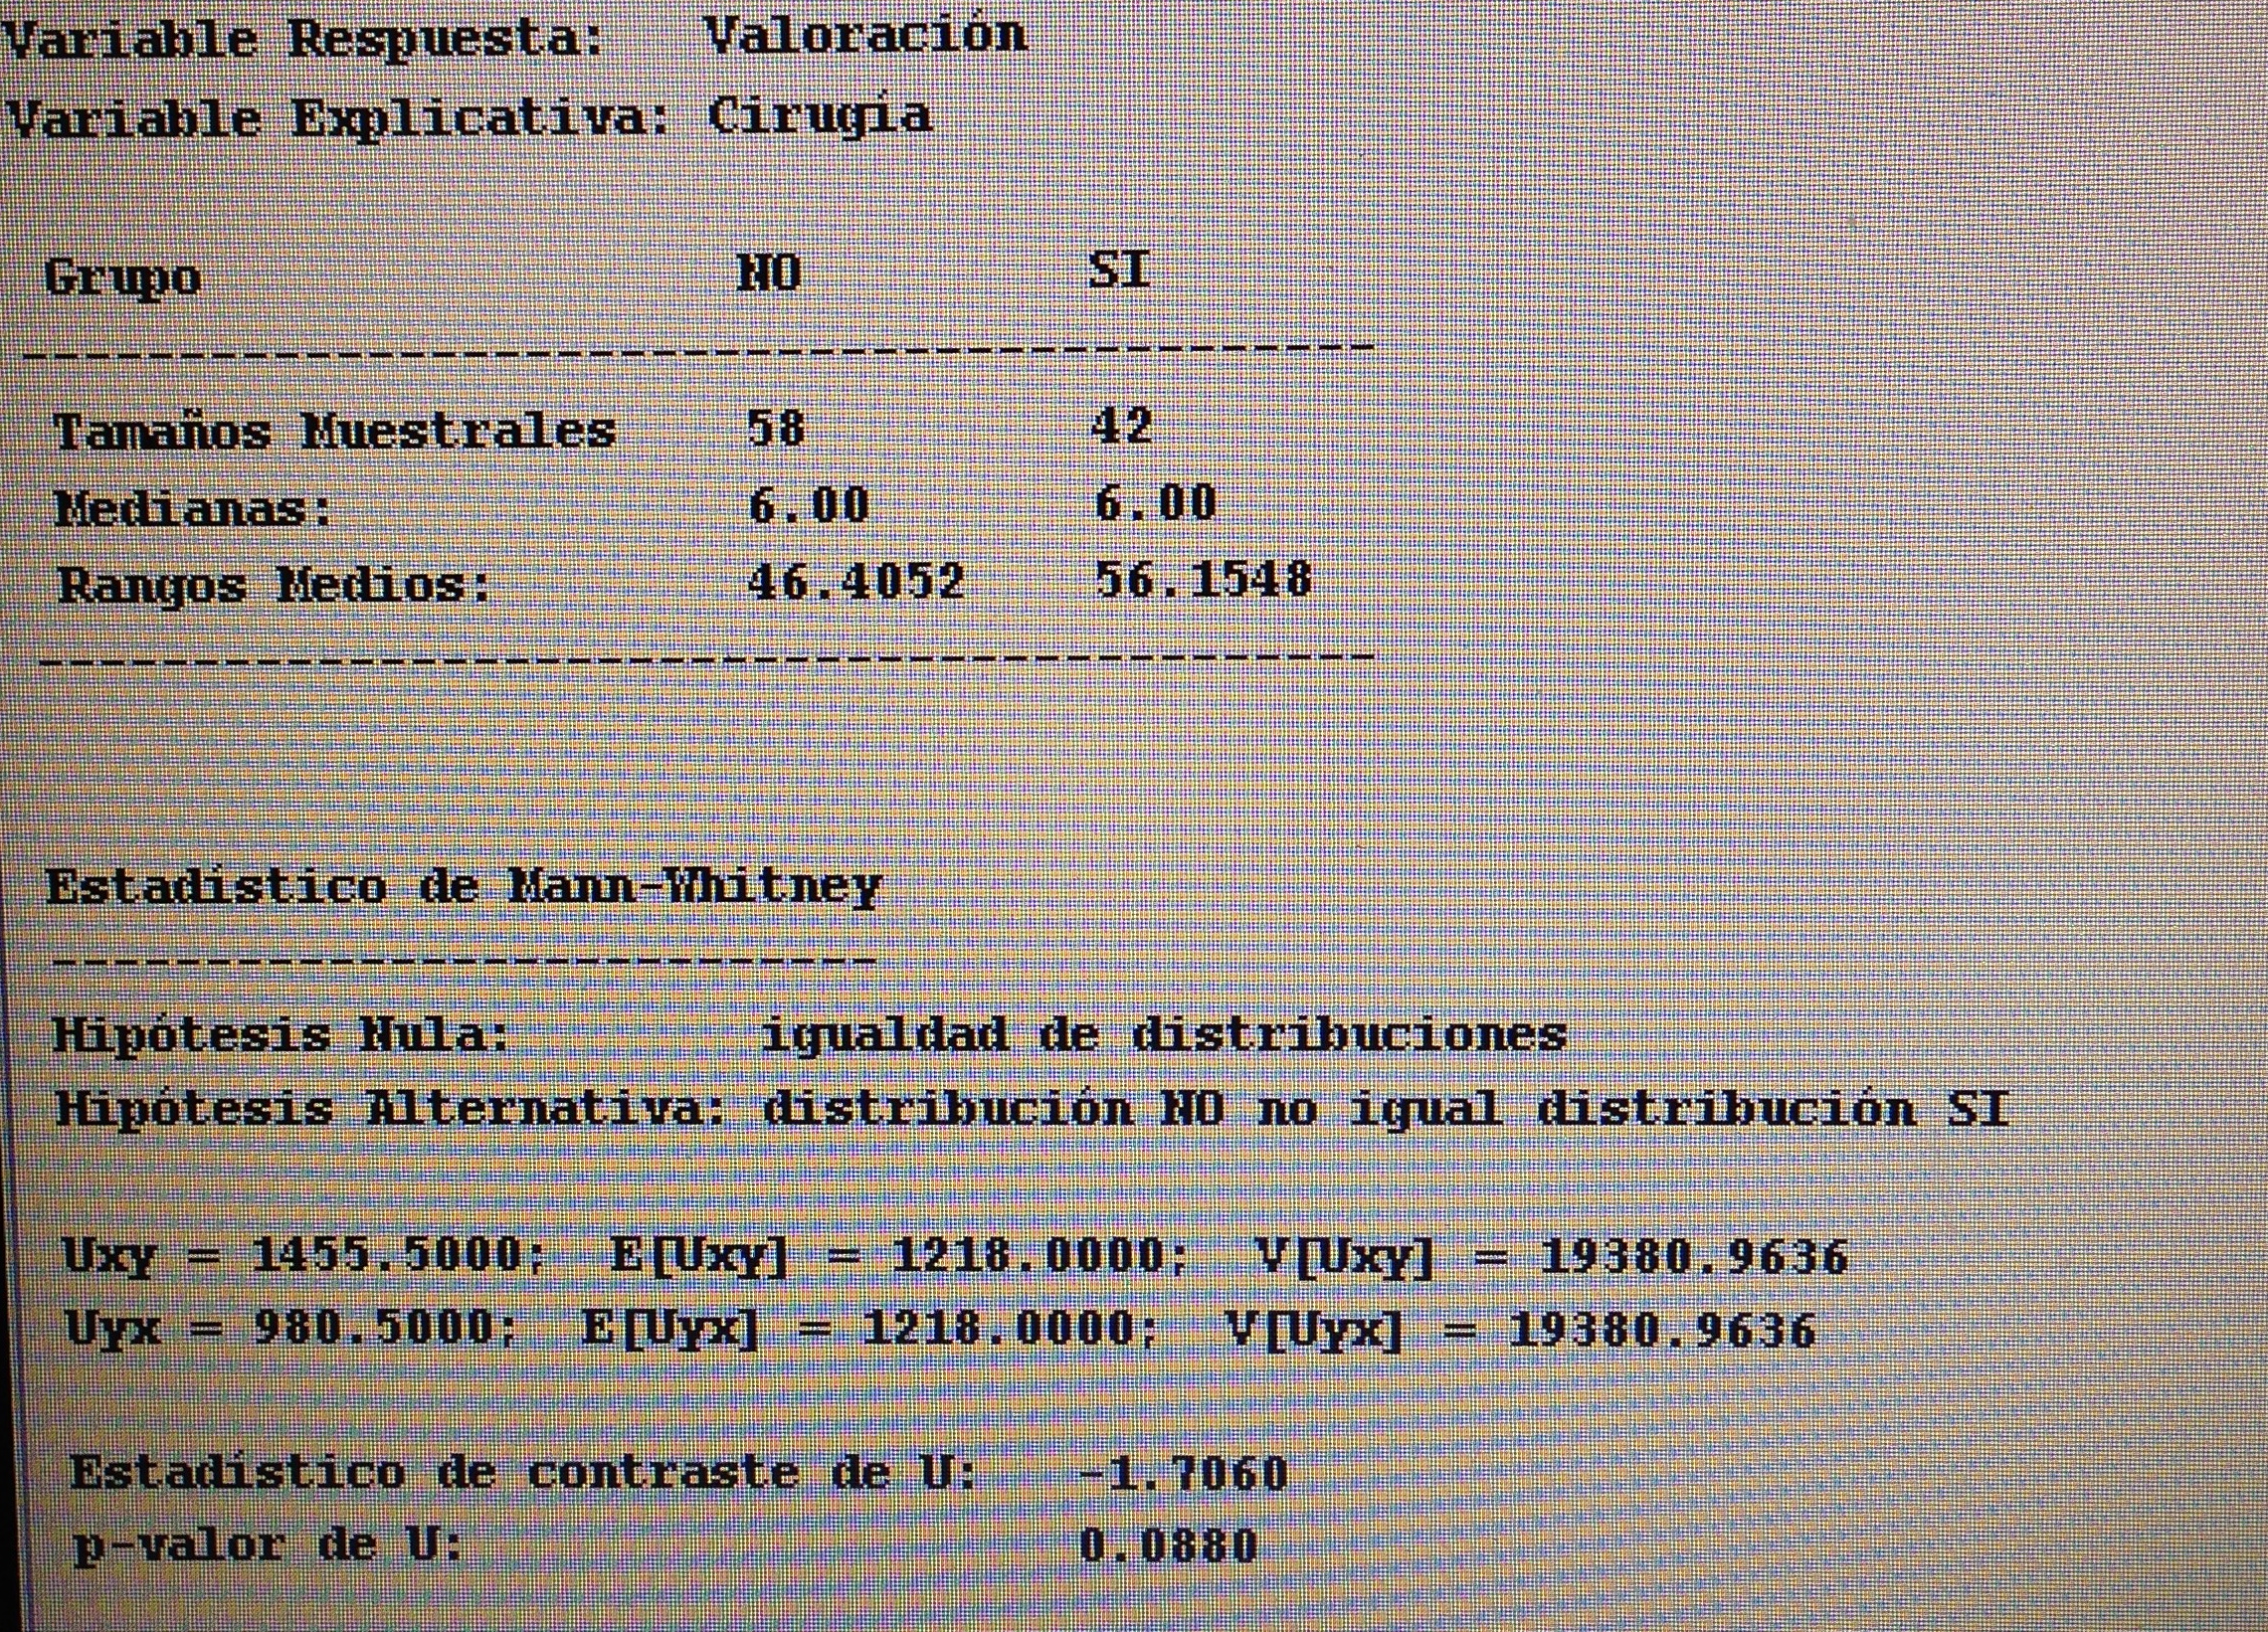
Se trata de variables continuas, muestras independientes y, por lo tanto, hemos de comprobar la normalidad de cada una de las dos muestras:

IMG_7801

IMG_7802

Como no hay normalidad debemos aplicar el Test de Mann-Whitney:

IMG_7804


No hay diferencias significativas entre los dos grupos, por lo tanto, no debemos aplicar la d de Cohen.
3. Comparar si los dos grupos formados por la variable P8 tienen valores diferentes, significativamente, en cuanto a la variable Valoración. Calcular la d de Cohen si es que antes se comprueba que la diferencia es estadísticamente significativa:

Se trata de variables continuas, muestras independientes y hace falta, pues, ahora comprobar la normalidad de cada una de las dos muestras:

IMG_7805

IMG_7806

Como no hay normalidad aplicamos el Test de Mann-Whitney:

IMG_7807


Ahora sí que vemos diferencias significativas entre los dos grupos. Ahora sí tiene sentido aplicar la d de Cohen.

Explotación de una base de datos 6: Regresión múltiple

A partir de nuestra base de datos adjunta del artículo Explotación de una base de datos 1: Base de datos podemos realizar regresiones múltiples. Veamos algunos ejemplos:

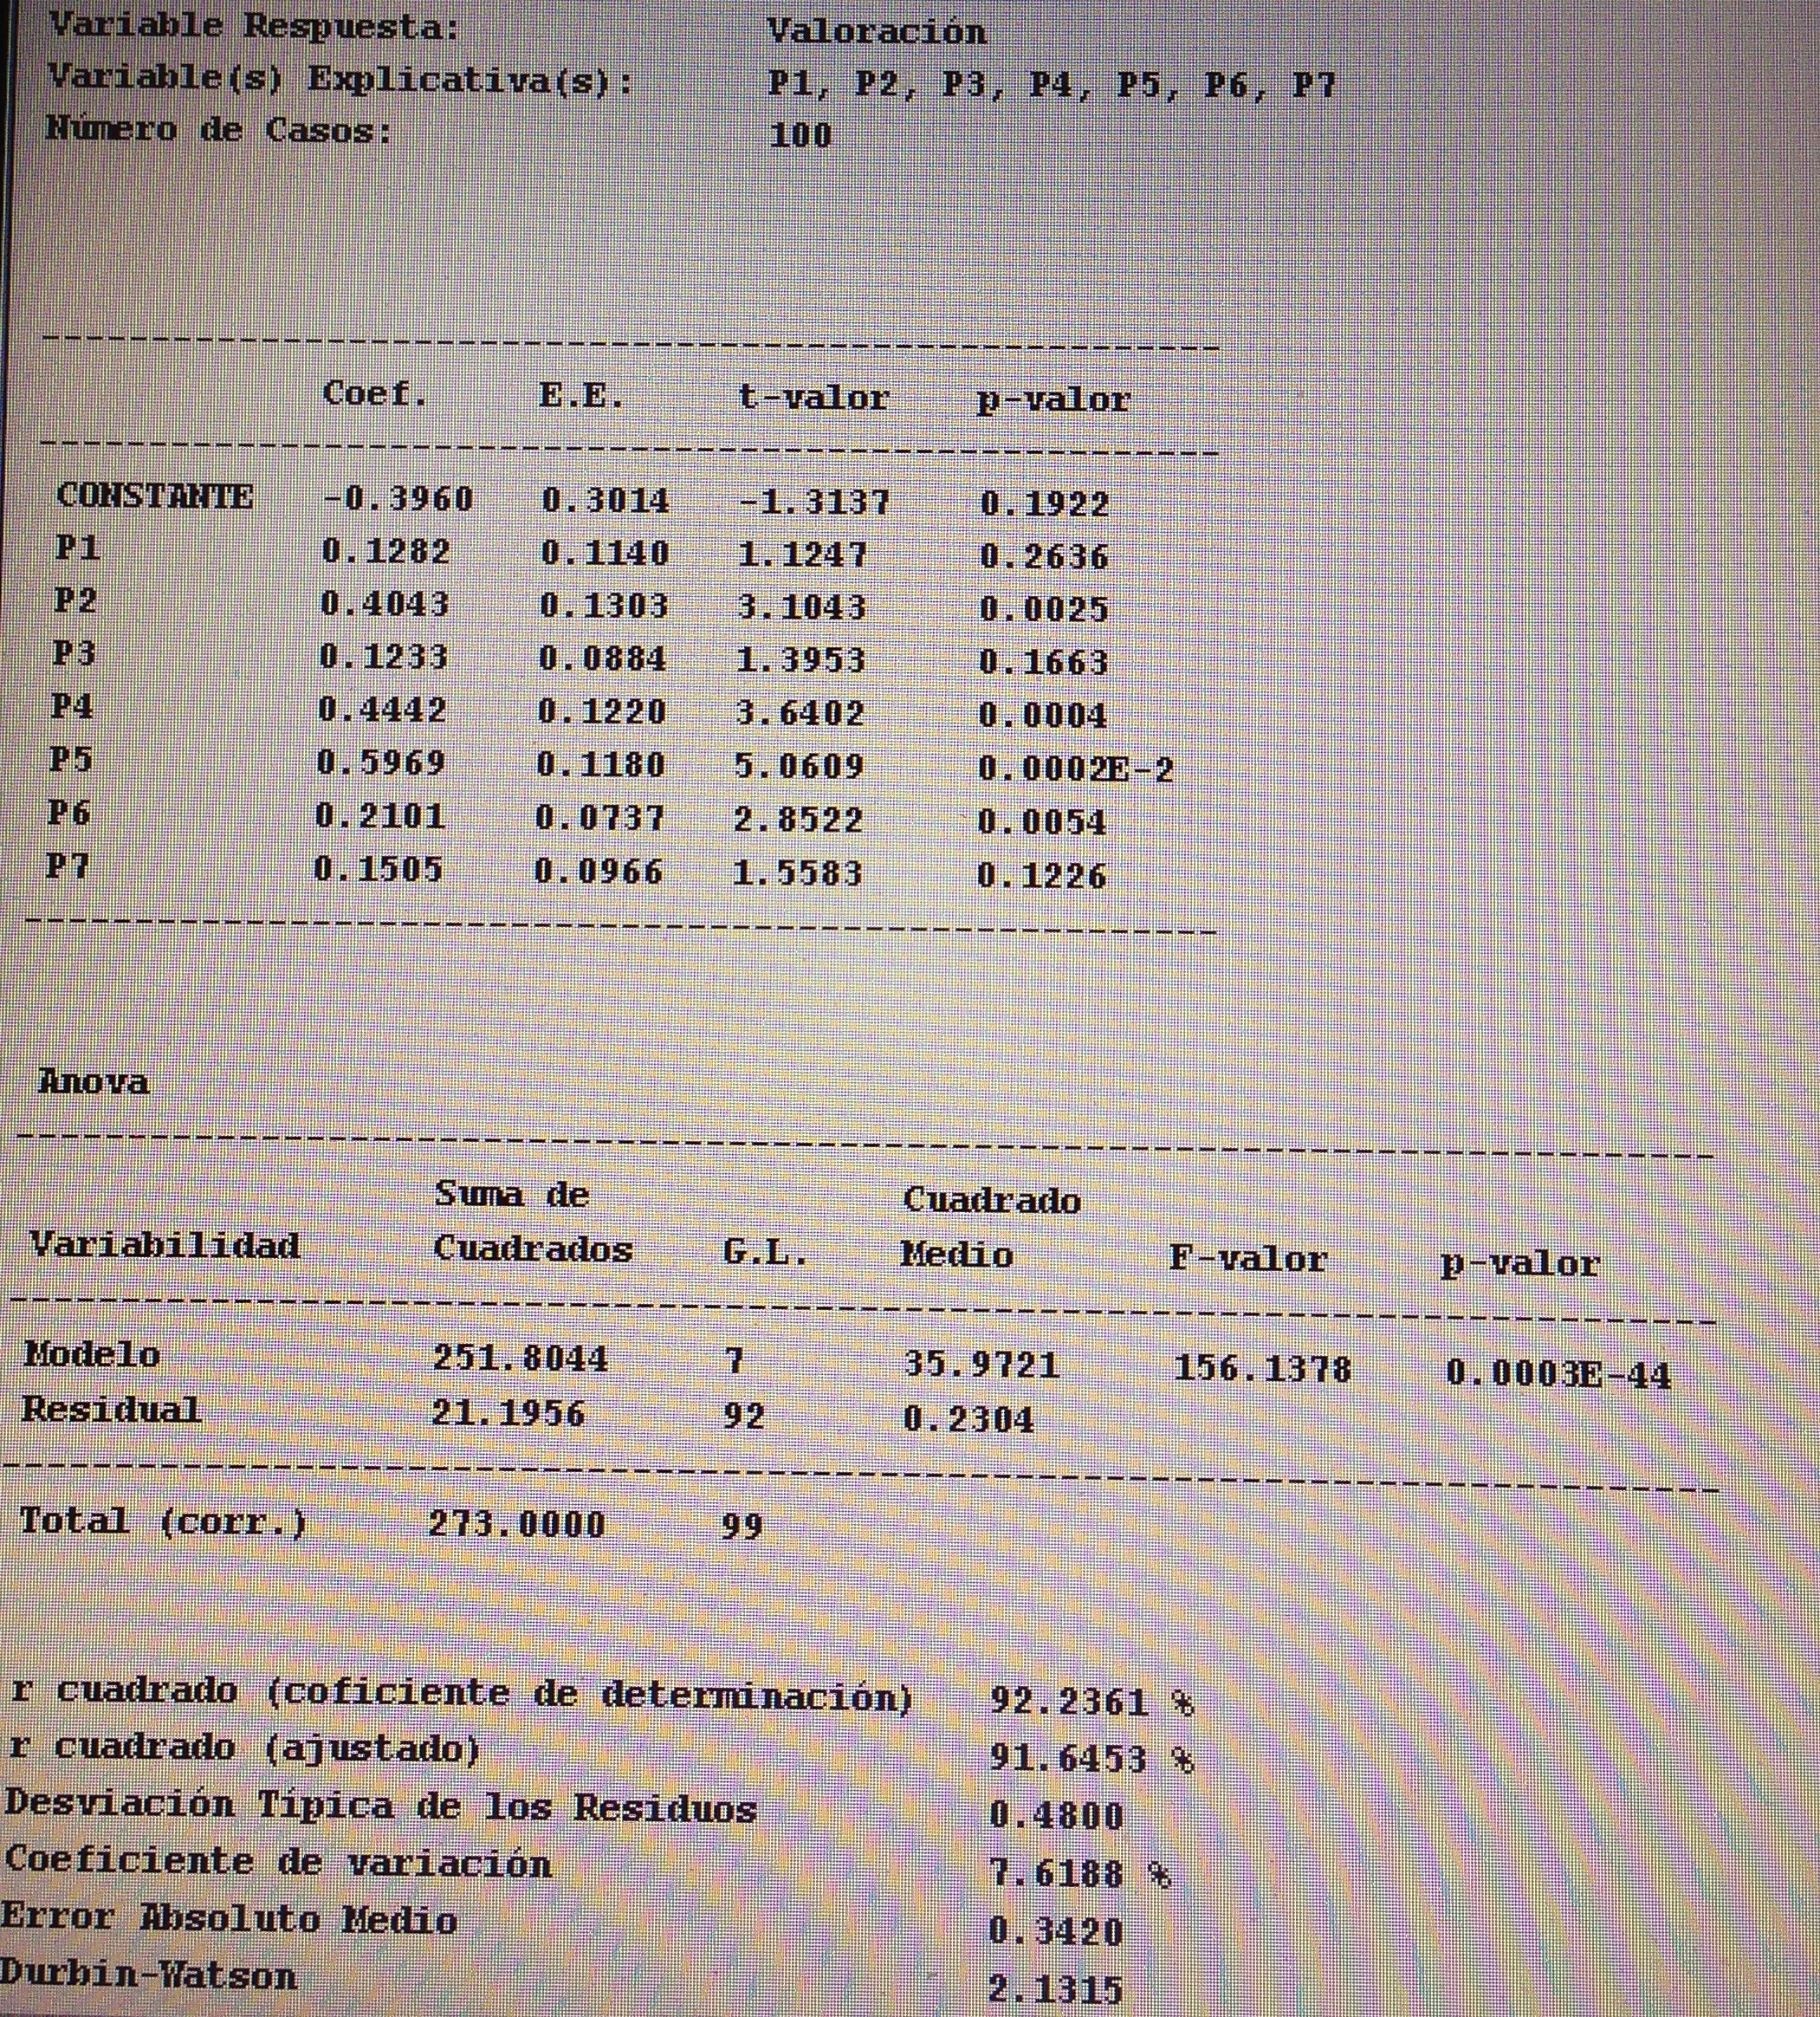
1. Realizar una Regresión lineal múltiple entre la variable Valoración general y P1, P2, P3, P4, P5, P6 y P7. Se pretende pronosticar la Valoración general que daría un paciente a partir de los valores de los 7 primeros ítems de la encuesta.

 2. Realizar un Regresión lineal múltiple entre la variable Valoración general y las variables Edad y Días de ingreso.

SOLUCIONES:

1. Realizar una Regresión lineal múltiple entre la variable Valoración general y P1, P2, P3, P4, P5, P6 y P7. Se pretende pronosticar la Valoración general que daría un paciente a partir de los valores de los 7 primeros ítems de la encuesta:

Las correlaciones entre todas estas variables son las siguientes:

IMG_7780

Viendo cuáles son las correlaciones entre la variable respuesta o dependiente y las variables explicativas o independientes ya podemos intuir por dónde irá el modelo elegido finalmente. Veamos cuál es:

IMG_7781

Ya vemos cuáles son los coeficientes significativos. Vemos también que la r cuadrado es muy buena.

Apliquemos un Stepwise:

IMG_7782

2. Realizar un Regresión lineal múltiple entre la variable Valoración general y las variables Edad y Días de ingreso:

Las correlaciones entre la variable respuesta y las dos variables explicativas son las siguientes:

IMG_7783

El modelo es:

IMG_7784

Y al aplicar un Stepwise:

IMG_7787

Y si nos fijamos bien veremos que al final hemos acabado en un modelo de Regresión lineal simple que es el que hemos estimado en cuando estábamos aplicando esa técnica a nuestra base de datos.

Explotación de una base de datos 5: Regresión lineal simple

A partir de nuestra base de datos adjunta del artículo Explotación de una base de datos 1: Base de datos podemos hacer distintas regresiones lineales simple. Veamos algunos ejemplos:

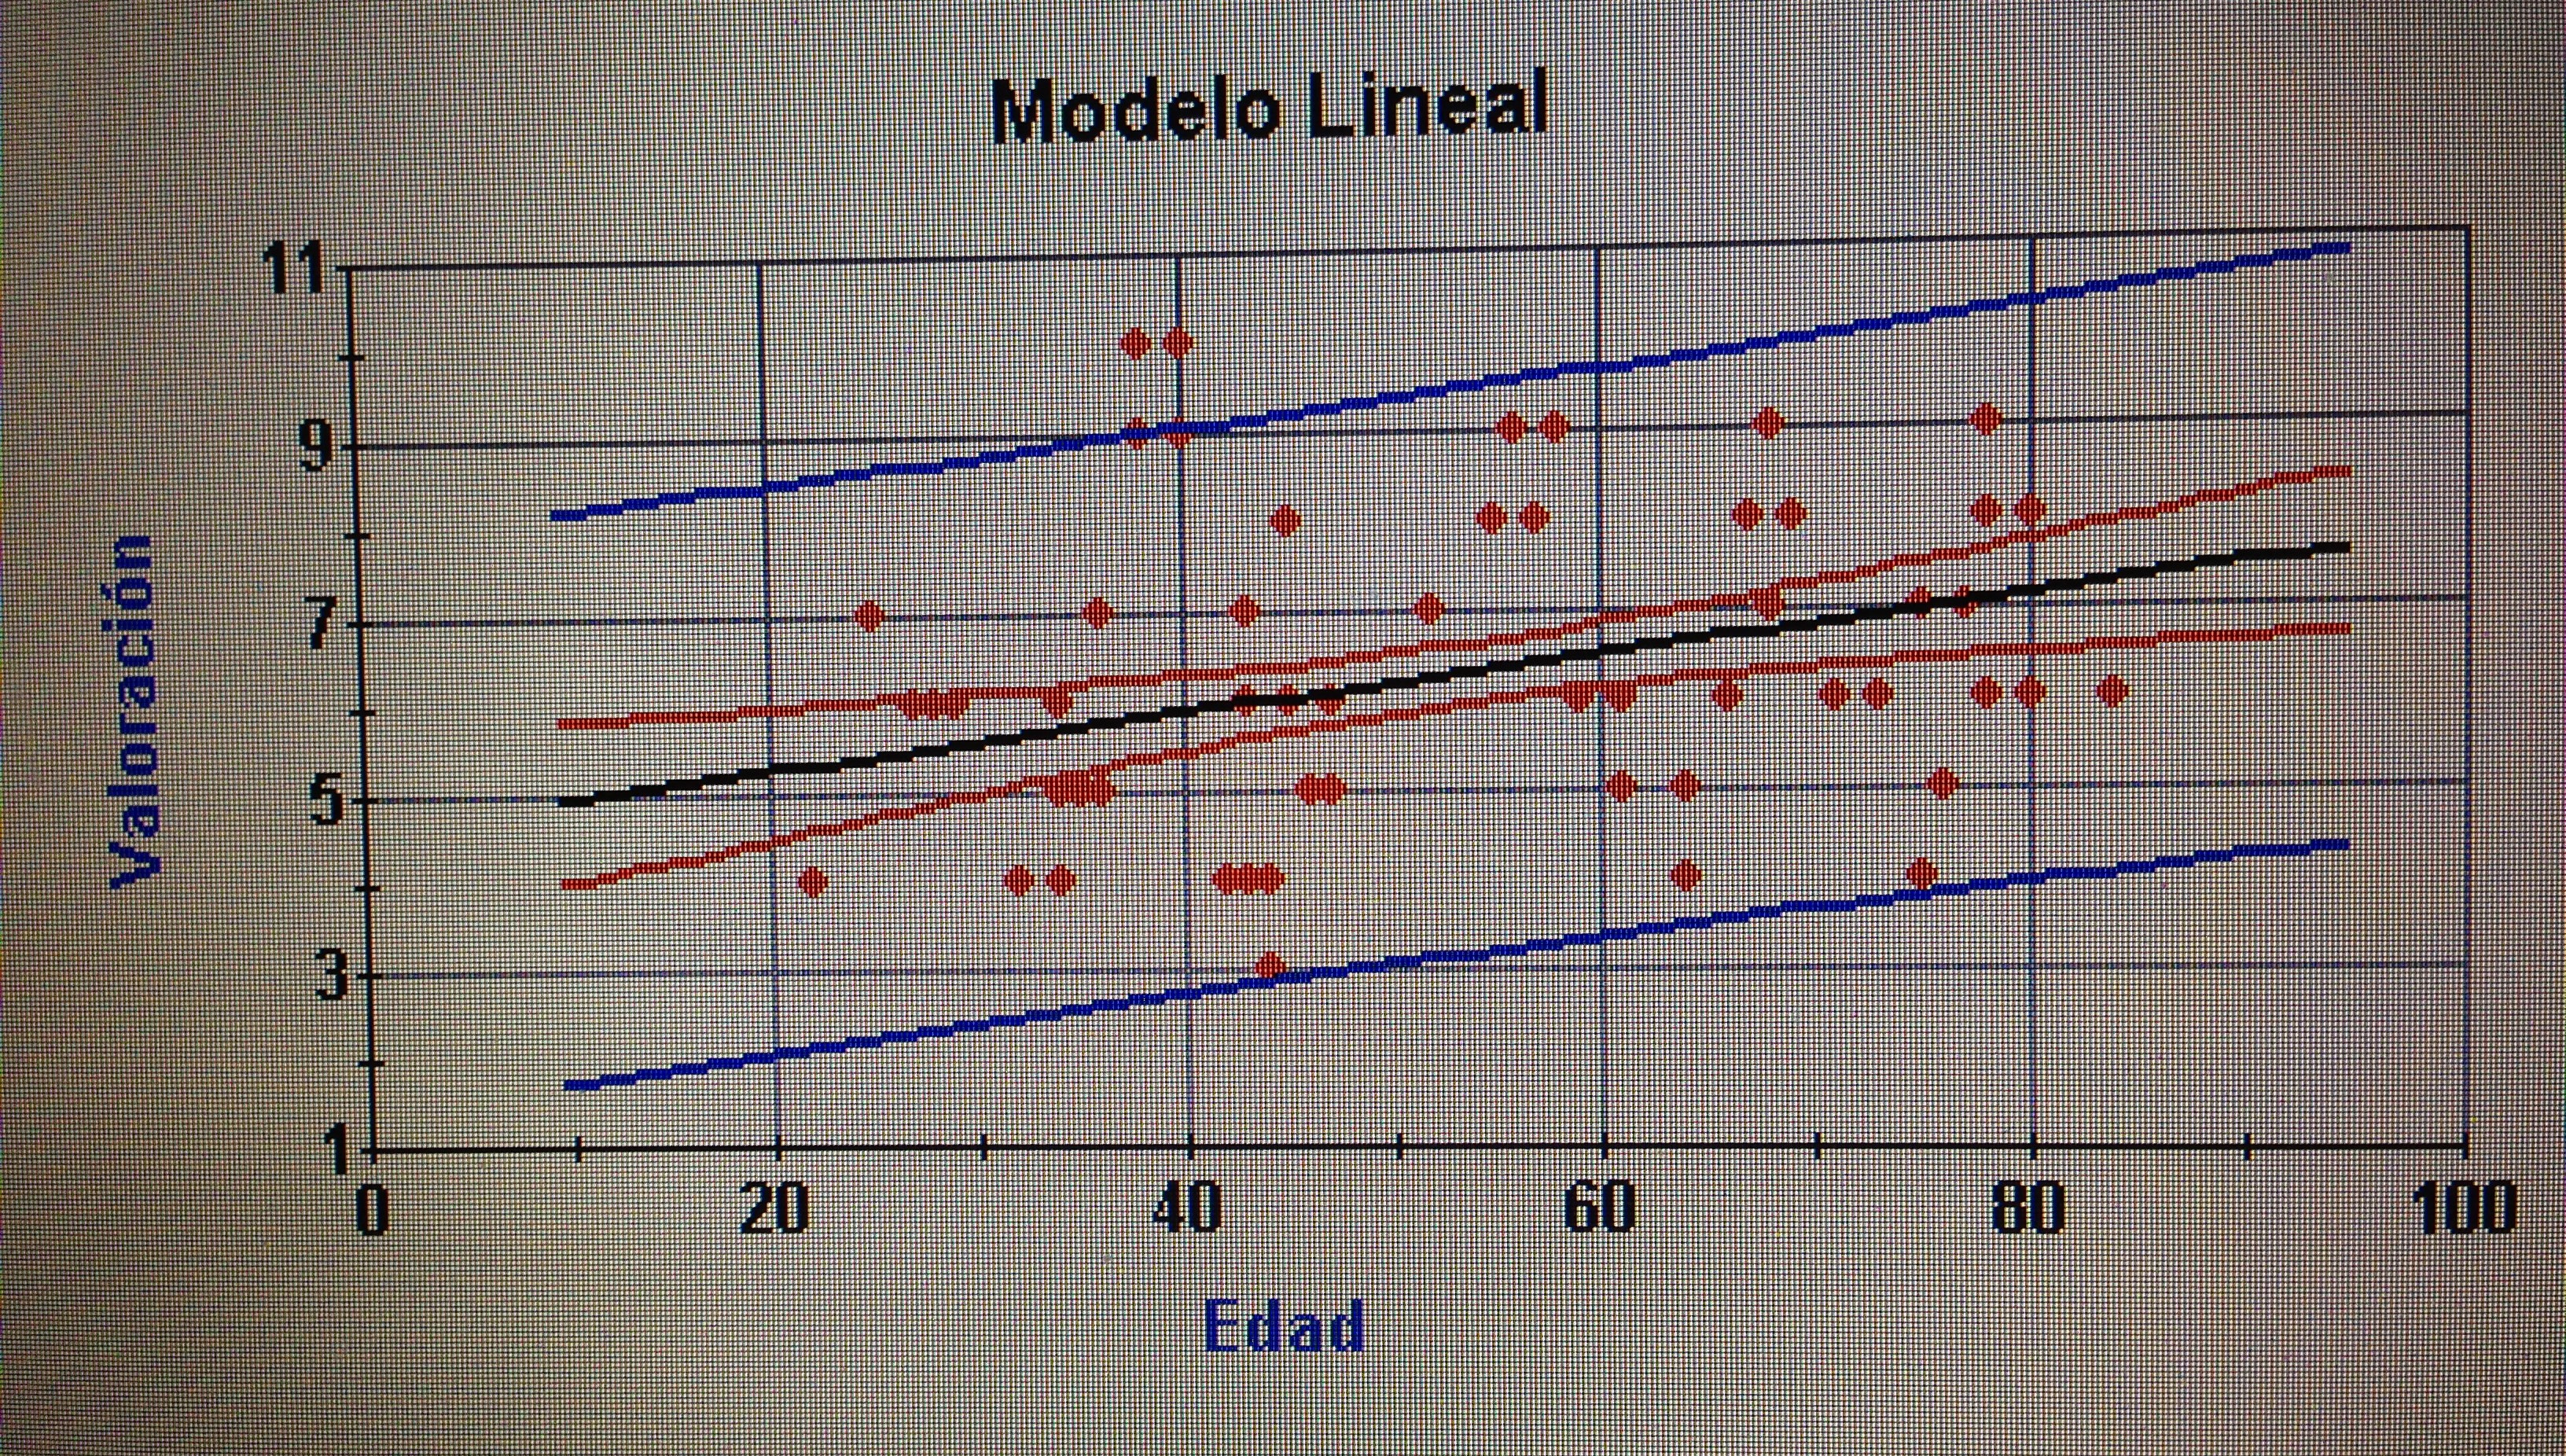
1. Hacer una Regresión lineal simple entre las variables Edad y Valoración general. Se pretende pronosticar en el futuro la variable Valoración general a partir de la variable Edad.

2. Hacer una Regresión lineal simple entre P6 y P7. Se pretende pronosticar en el futuro el valor de la variable P7 a partir del conocimiento del valor de la variable P6. O sea, se pretende pronosticar cómo siente el paciente el nivel de información recibido a partir de su valoración acerca del personal médico.

SOLUCIONES:

1. Hacer una Regresión lineal simple entre las variables Edad y Valoración general. Se pretende pronosticar en el futuro la variable Valoración general a partir de la variable Edad:

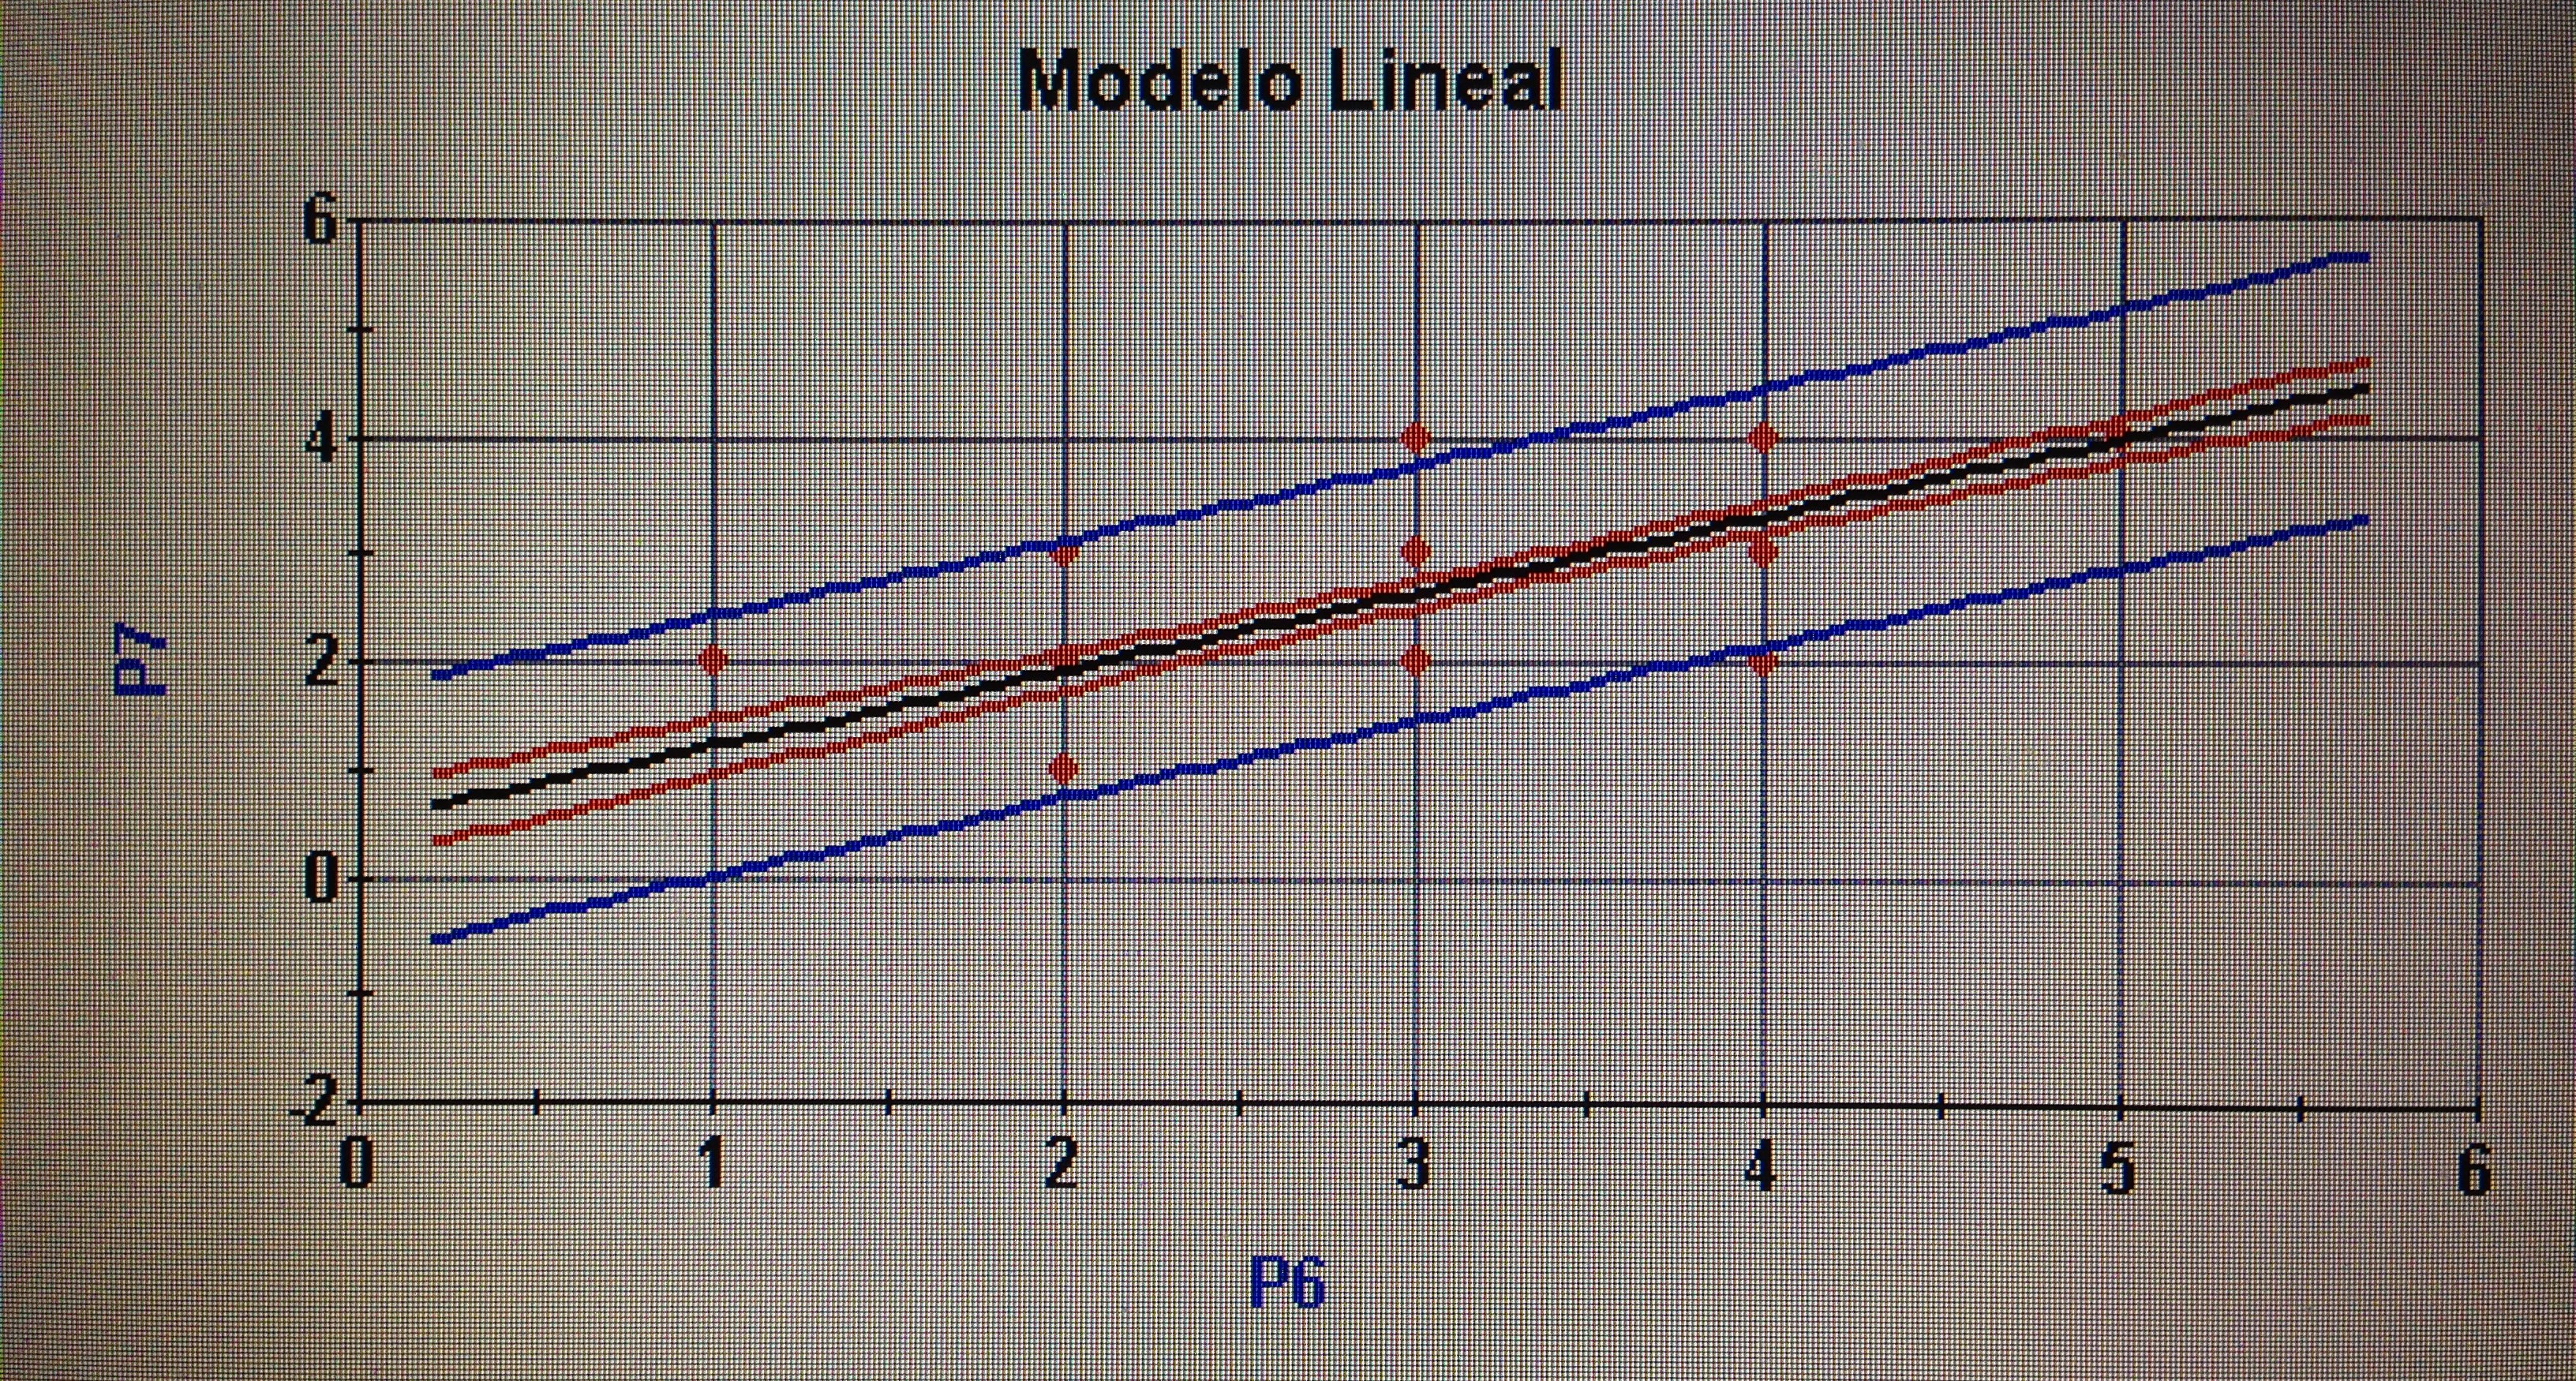
La recta de regresión es la siguiente:

IMG_7776

La recta es la negra. Las dos rectas rojas y las dos azules son intervalos de confianza del 95% de la media de una predicción (las rojas) y de un valor individual (las azules).

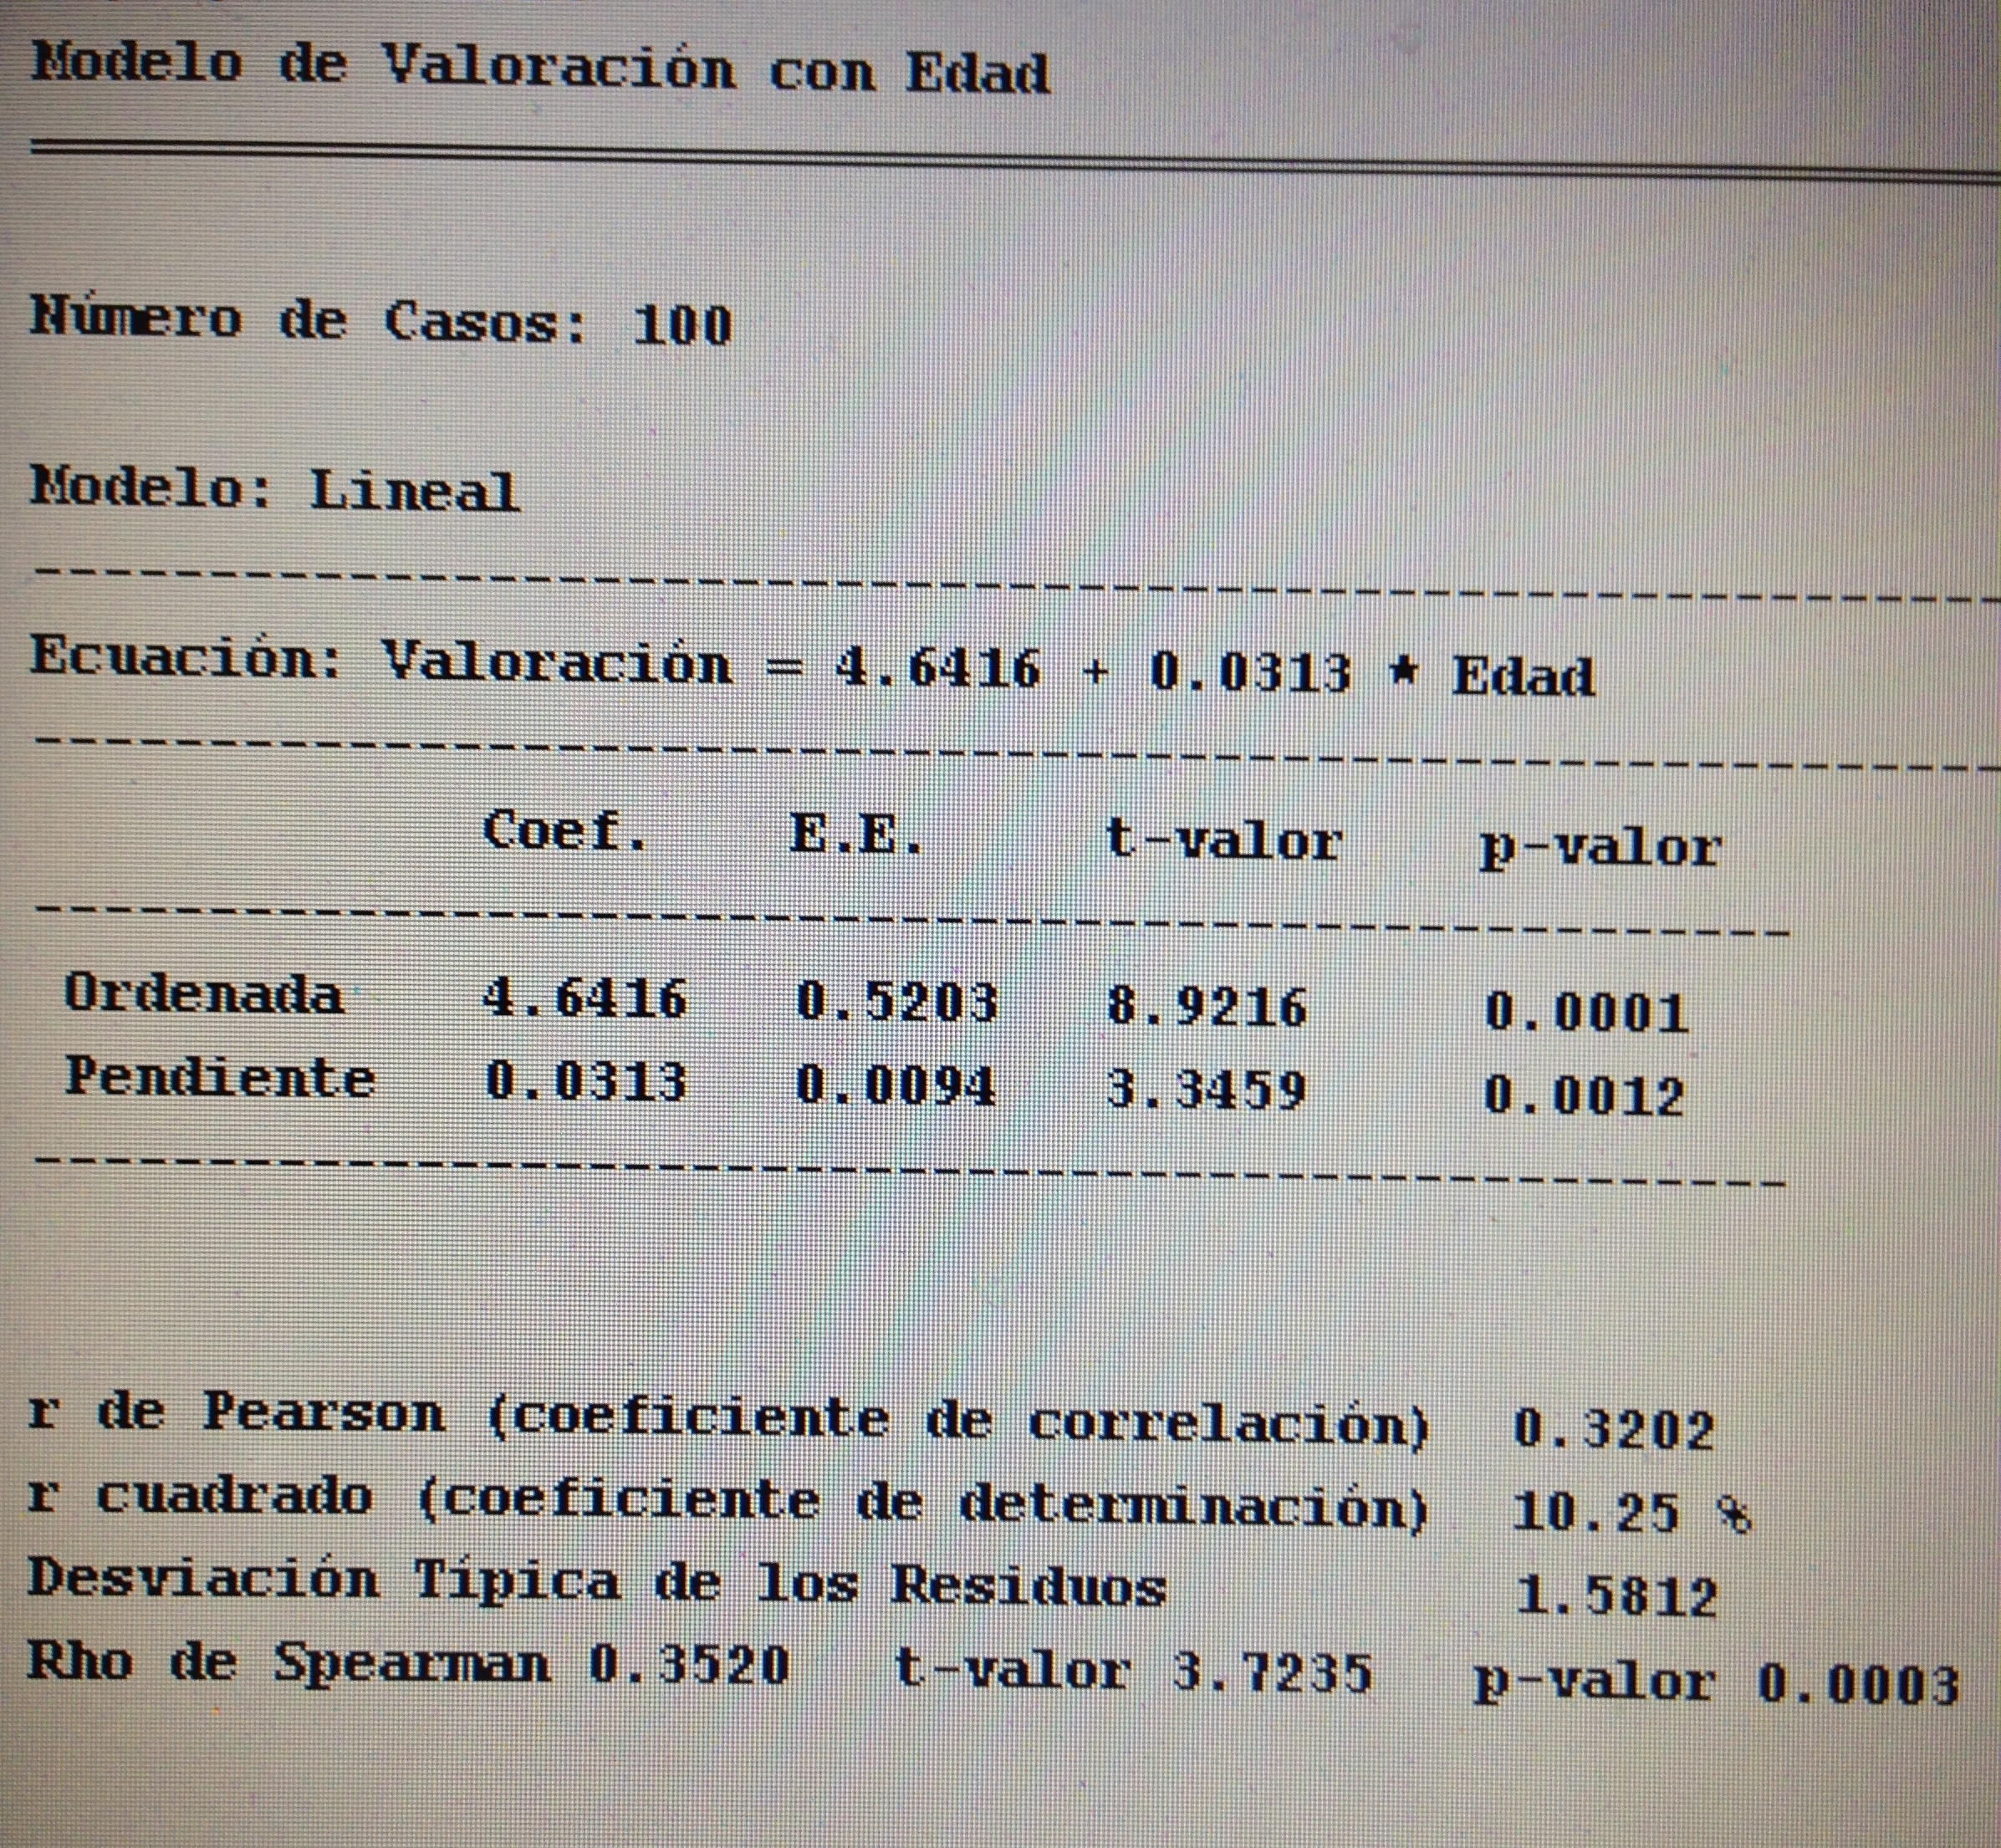
Los coeficientes del modelo son los siguientes:

IMG_7777

Se trata, pues, de una regresión con coeficientes significativos pero con un coeficiente de determinación muy bajo, con una r cuadrado sólo de un 10.25%. Menos de un 50% se considera una muy mala capacidad predictiva de un valor individual de la variable respuesta o dependiente.

2. Hacer una Regresión lineal simple entre P6 y P7. Se pretende pronosticar en el futuro el valor de la variable P7 a partir del conocimiento del valor de la variable P6. O sea, se pretende pronosticar cómo siente el paciente el nivel de información recibido a partir de su valoración acerca del personal médico:

La recta de regresión es, ahora:

IMG_7778

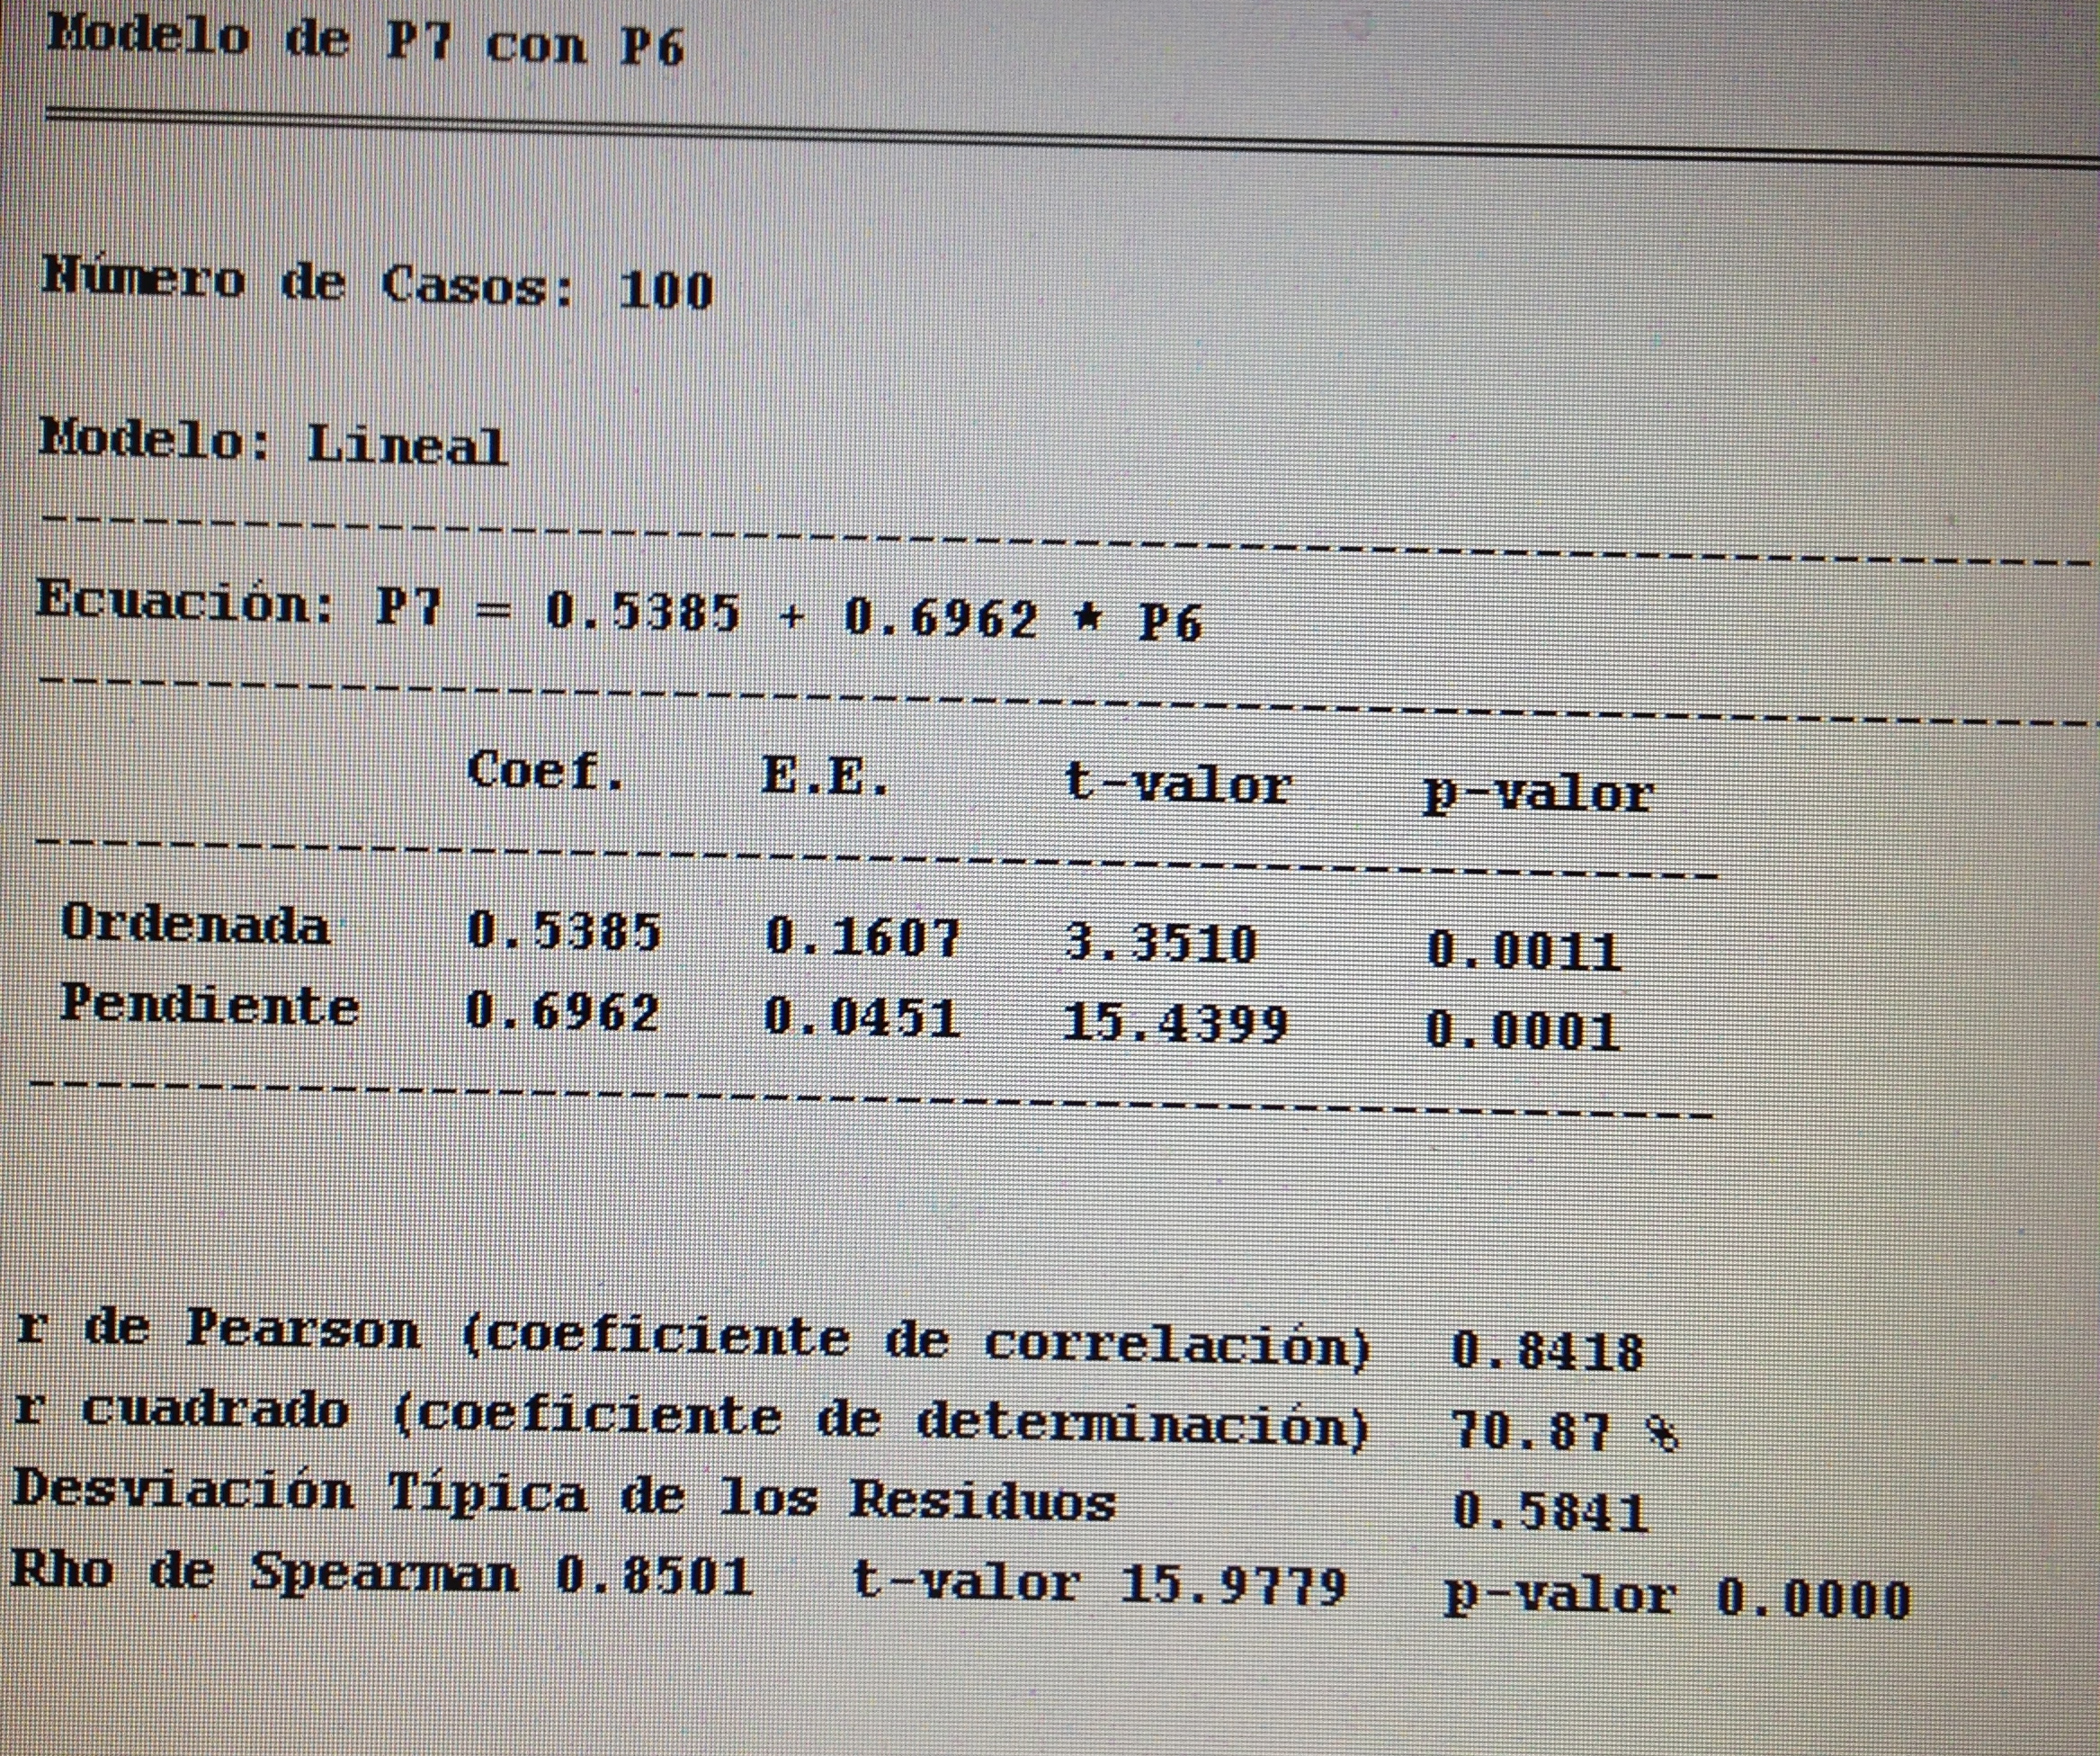
Los coeficientes del modelo:

IMG_7779


Ahora tenemos una mejor capacidad de determinación, un 70.87%.


Explotación de una base de datos 4: La relación entre variables cualitativas

A nuestra base de datos adjunta en el artículo Explotación de una base de datos 1: Base de datos le podemos analizar la relación entre variables cualitativas. Veamos algunos ejemplos:

1. Analizar la relación entre la variable Sexo y Cirugía.

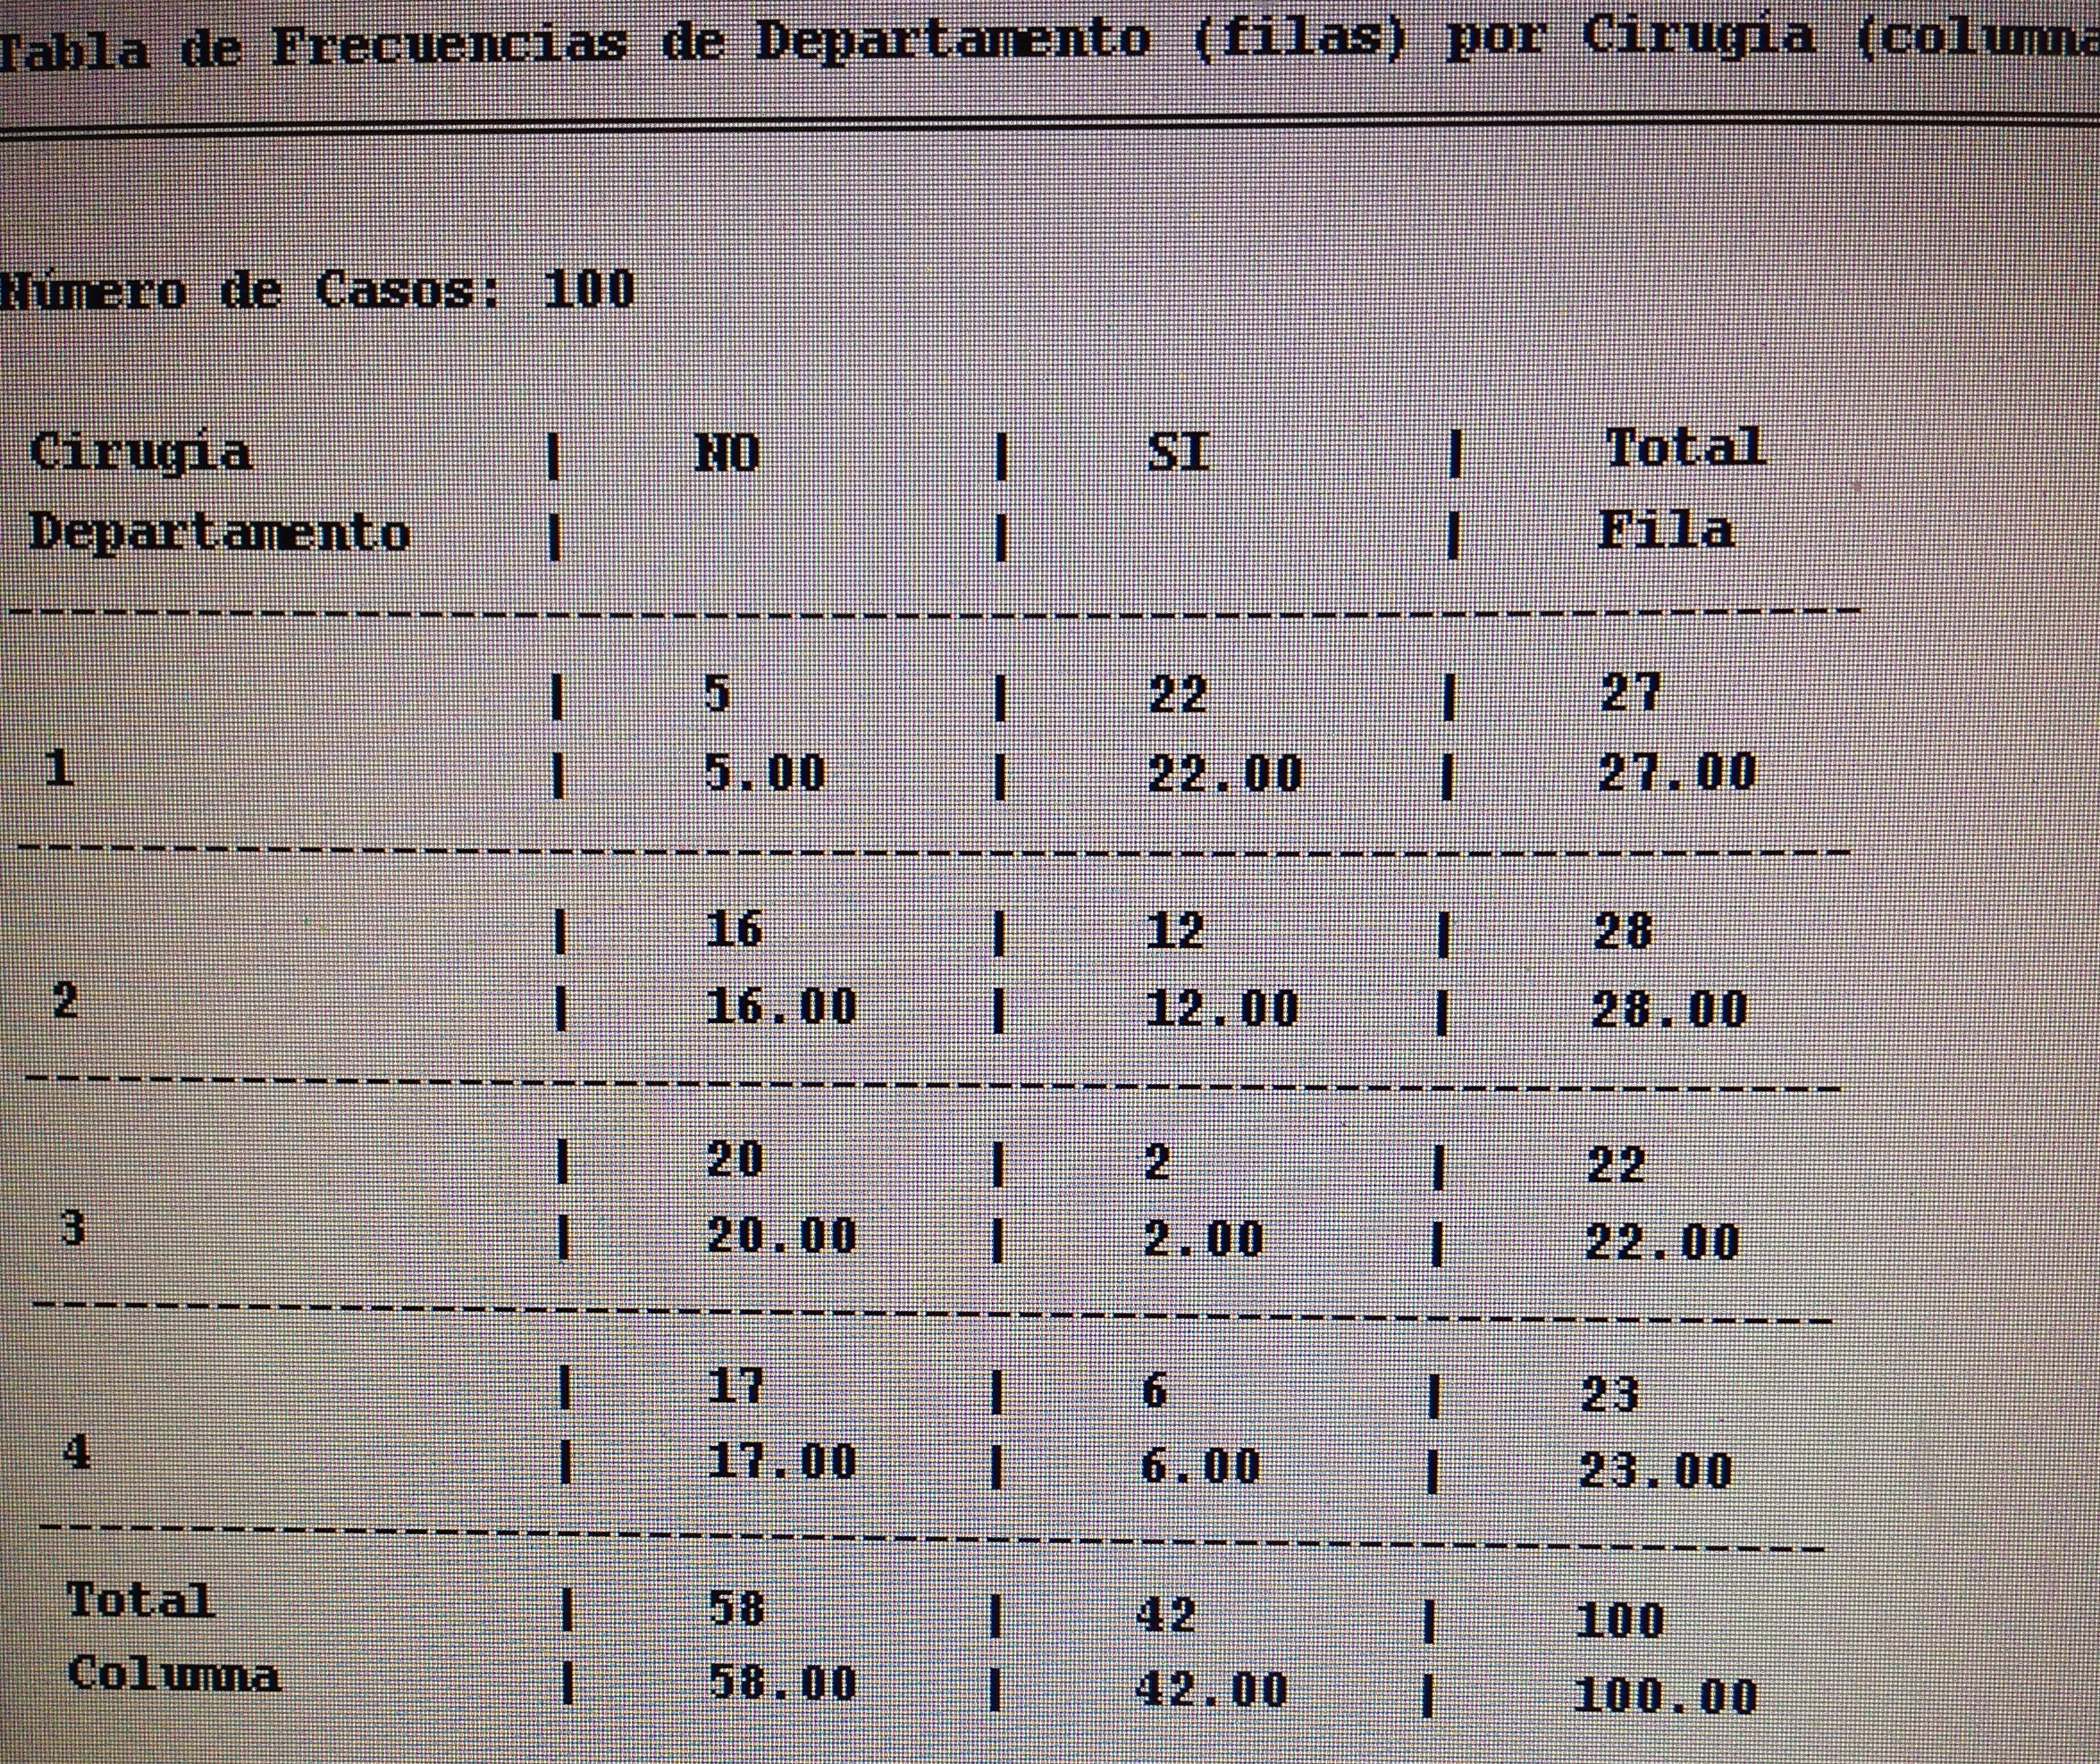
2. Analizar la relación entre la variable Cirugía y Departamento.

3. Analizar la relación entre la variable Departamento y P8.

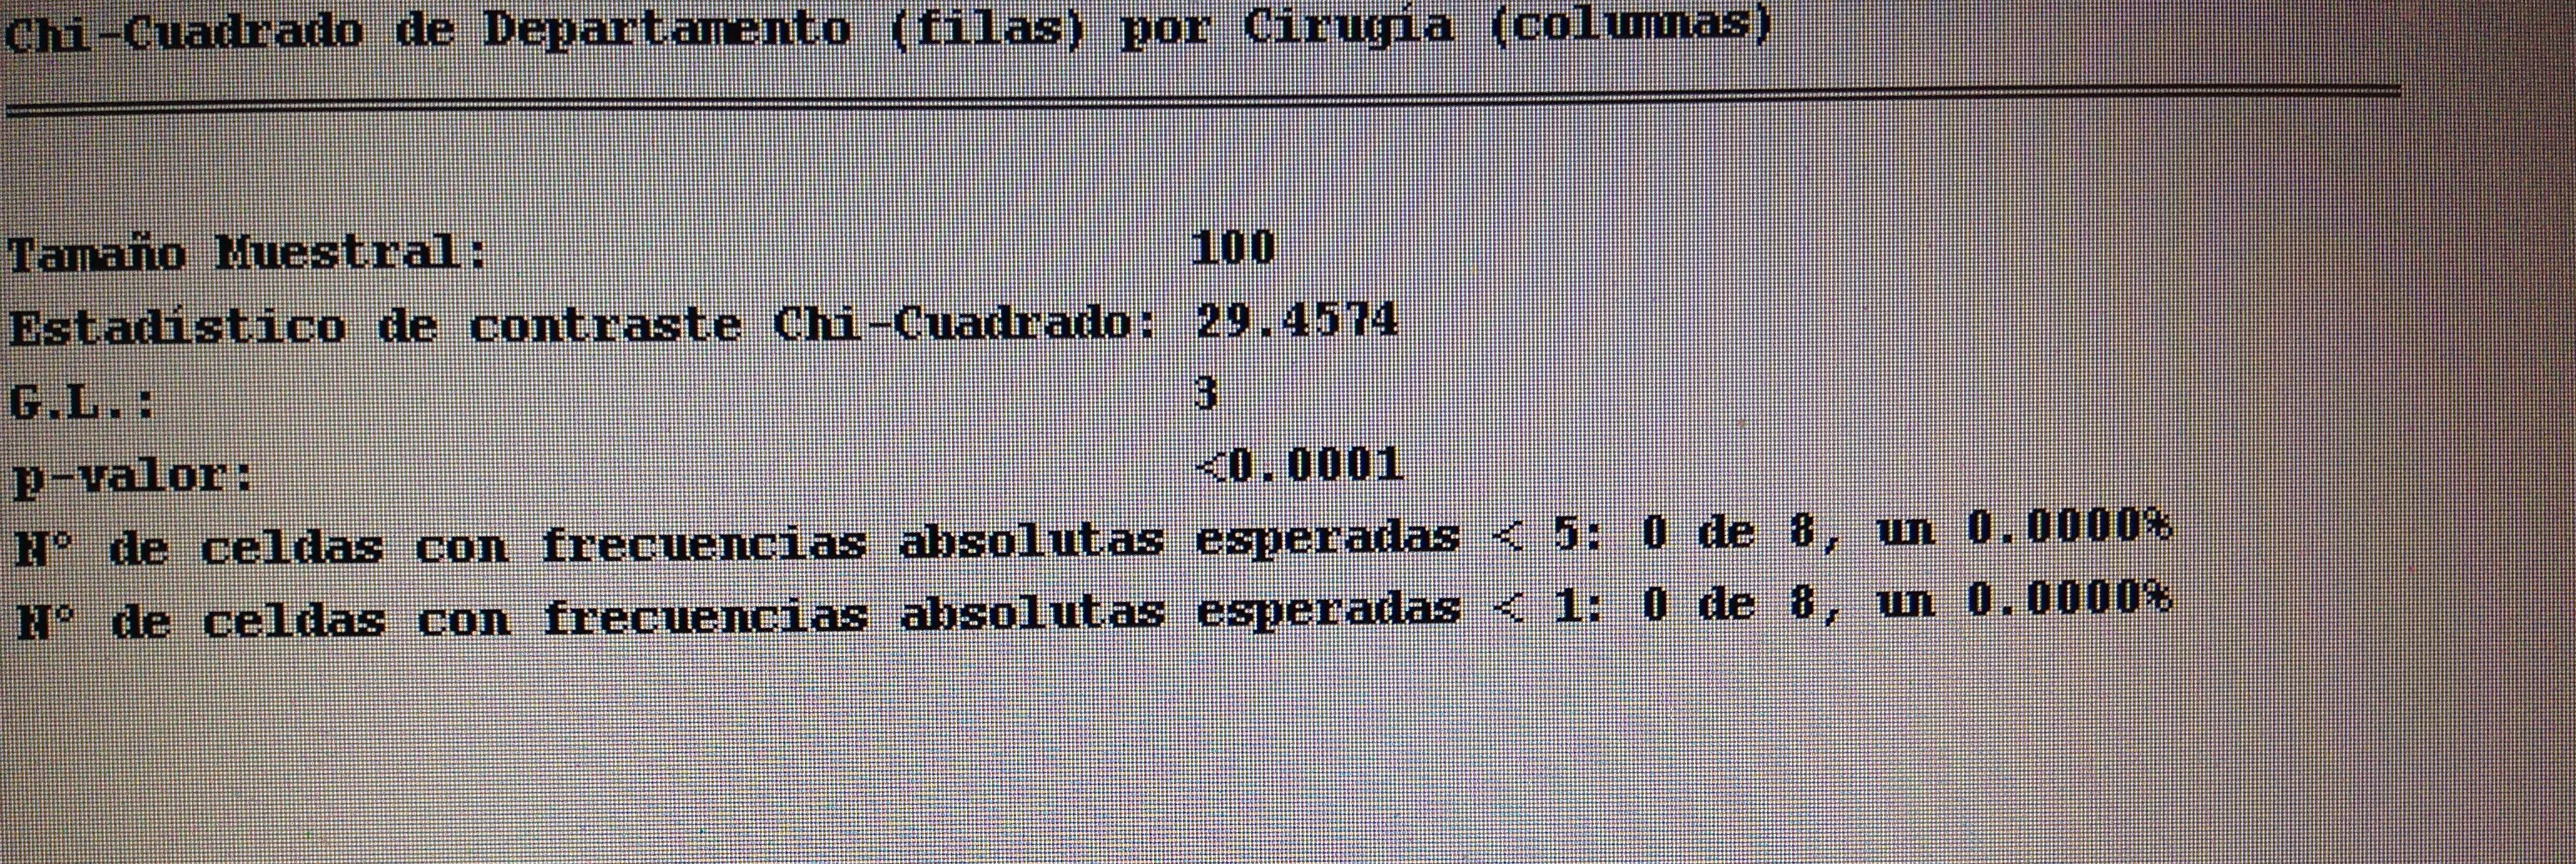
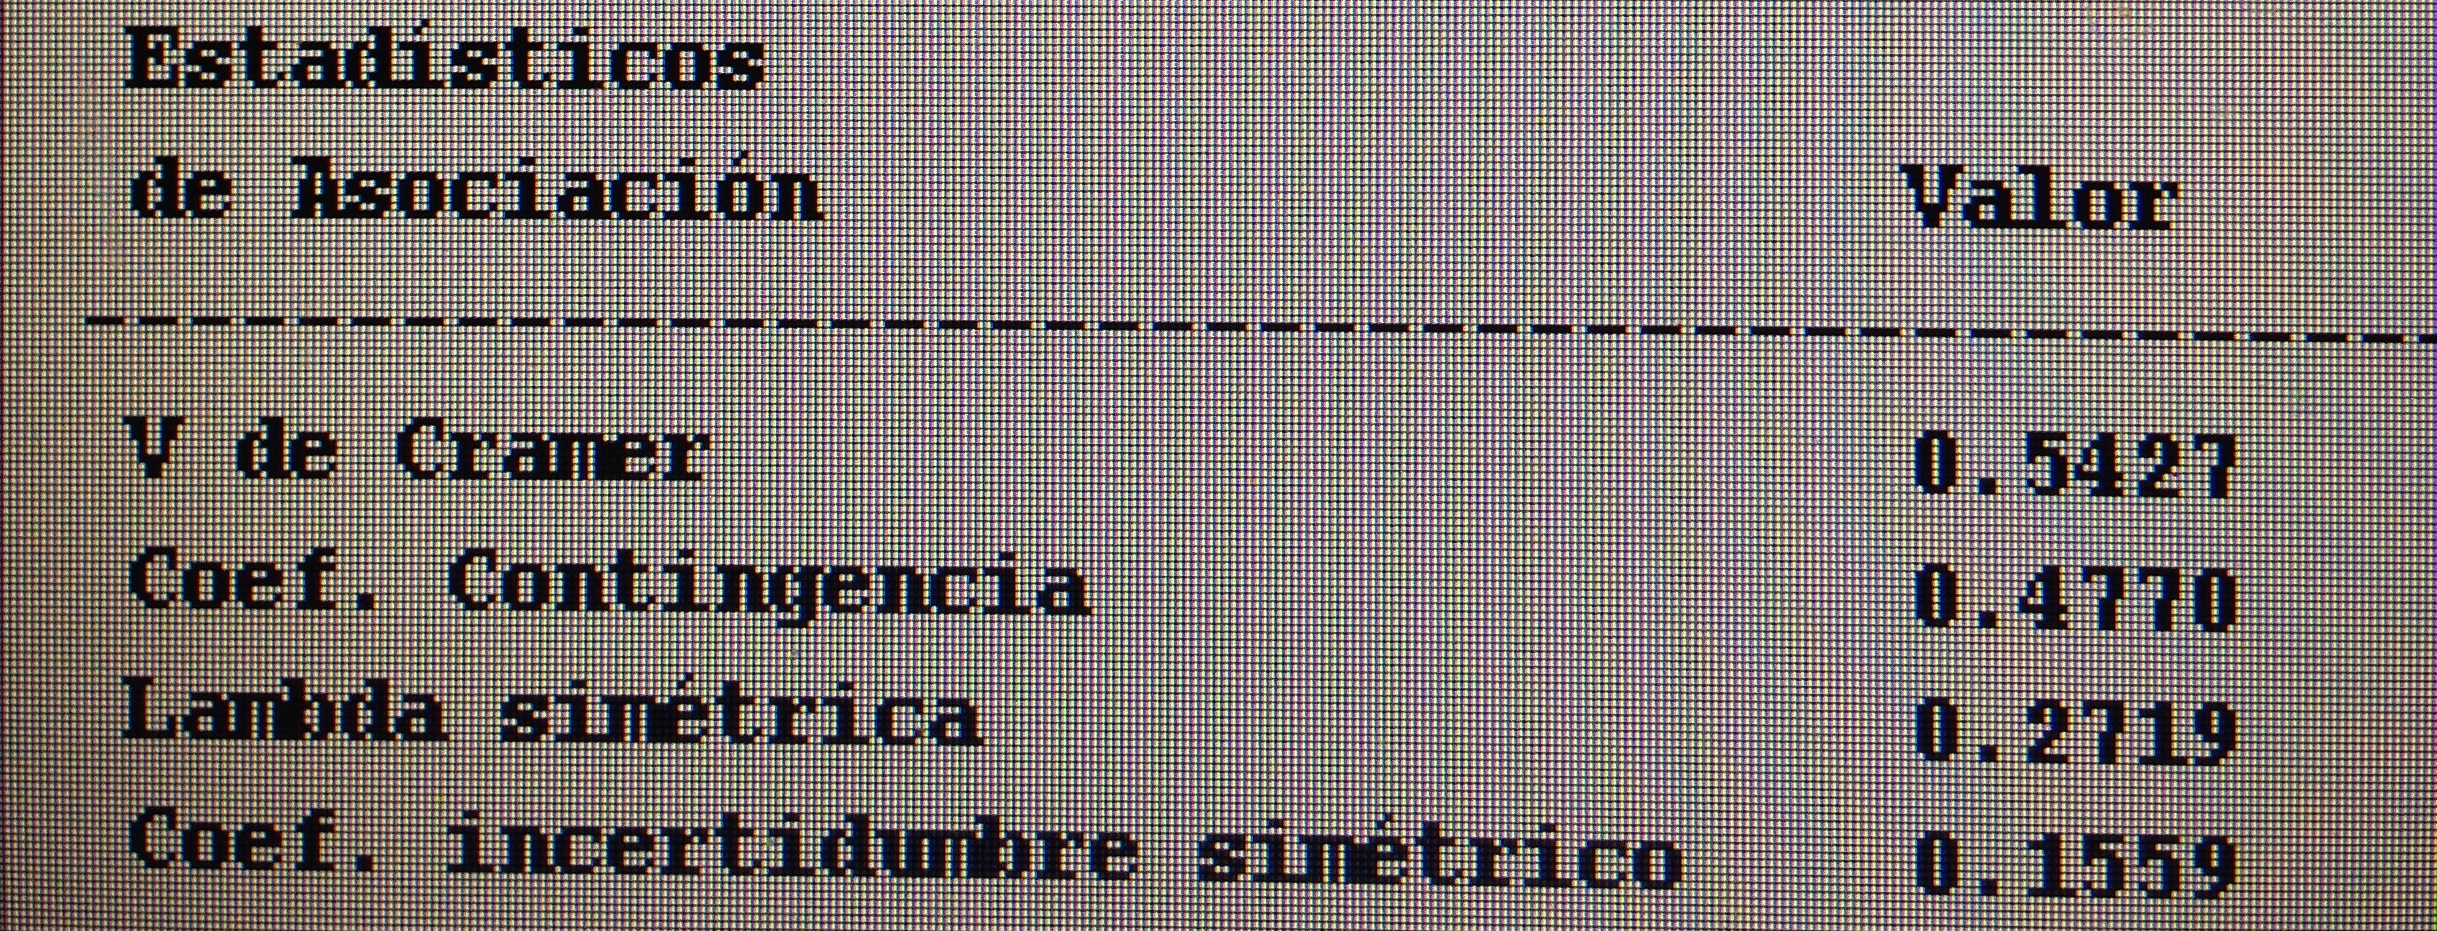
4. Analizar la relación entre la variable Departamento y Cirugía, calculando la V de Cramer si existe relación significativa.

SOLUCIONES

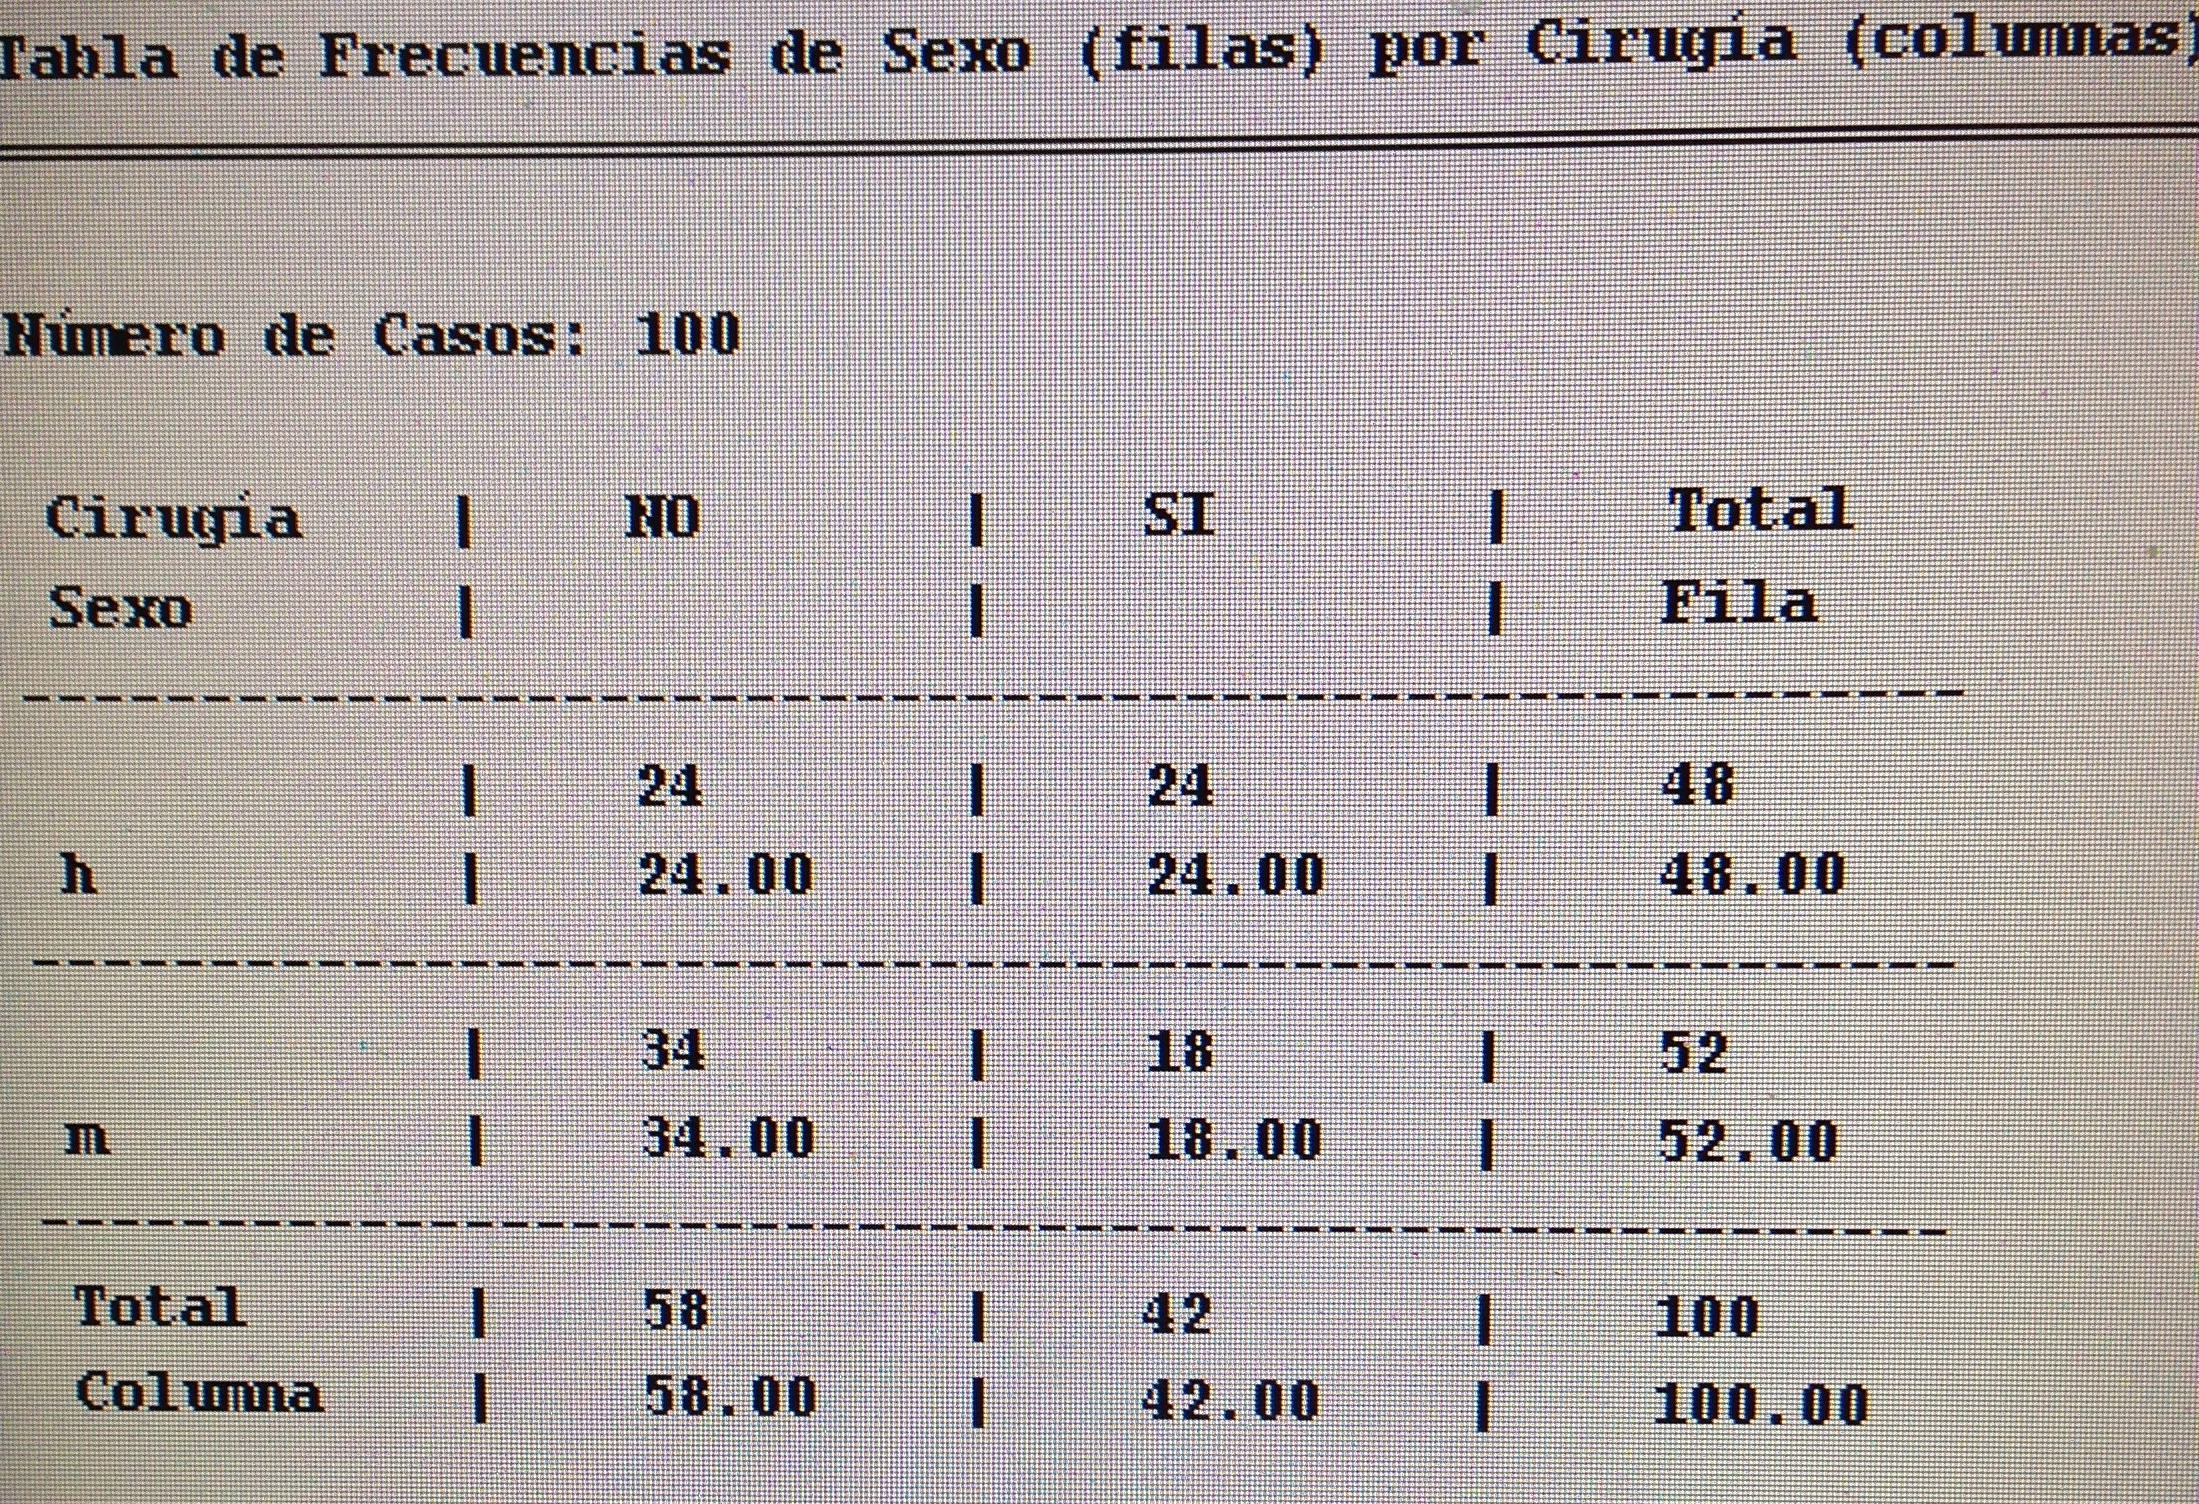
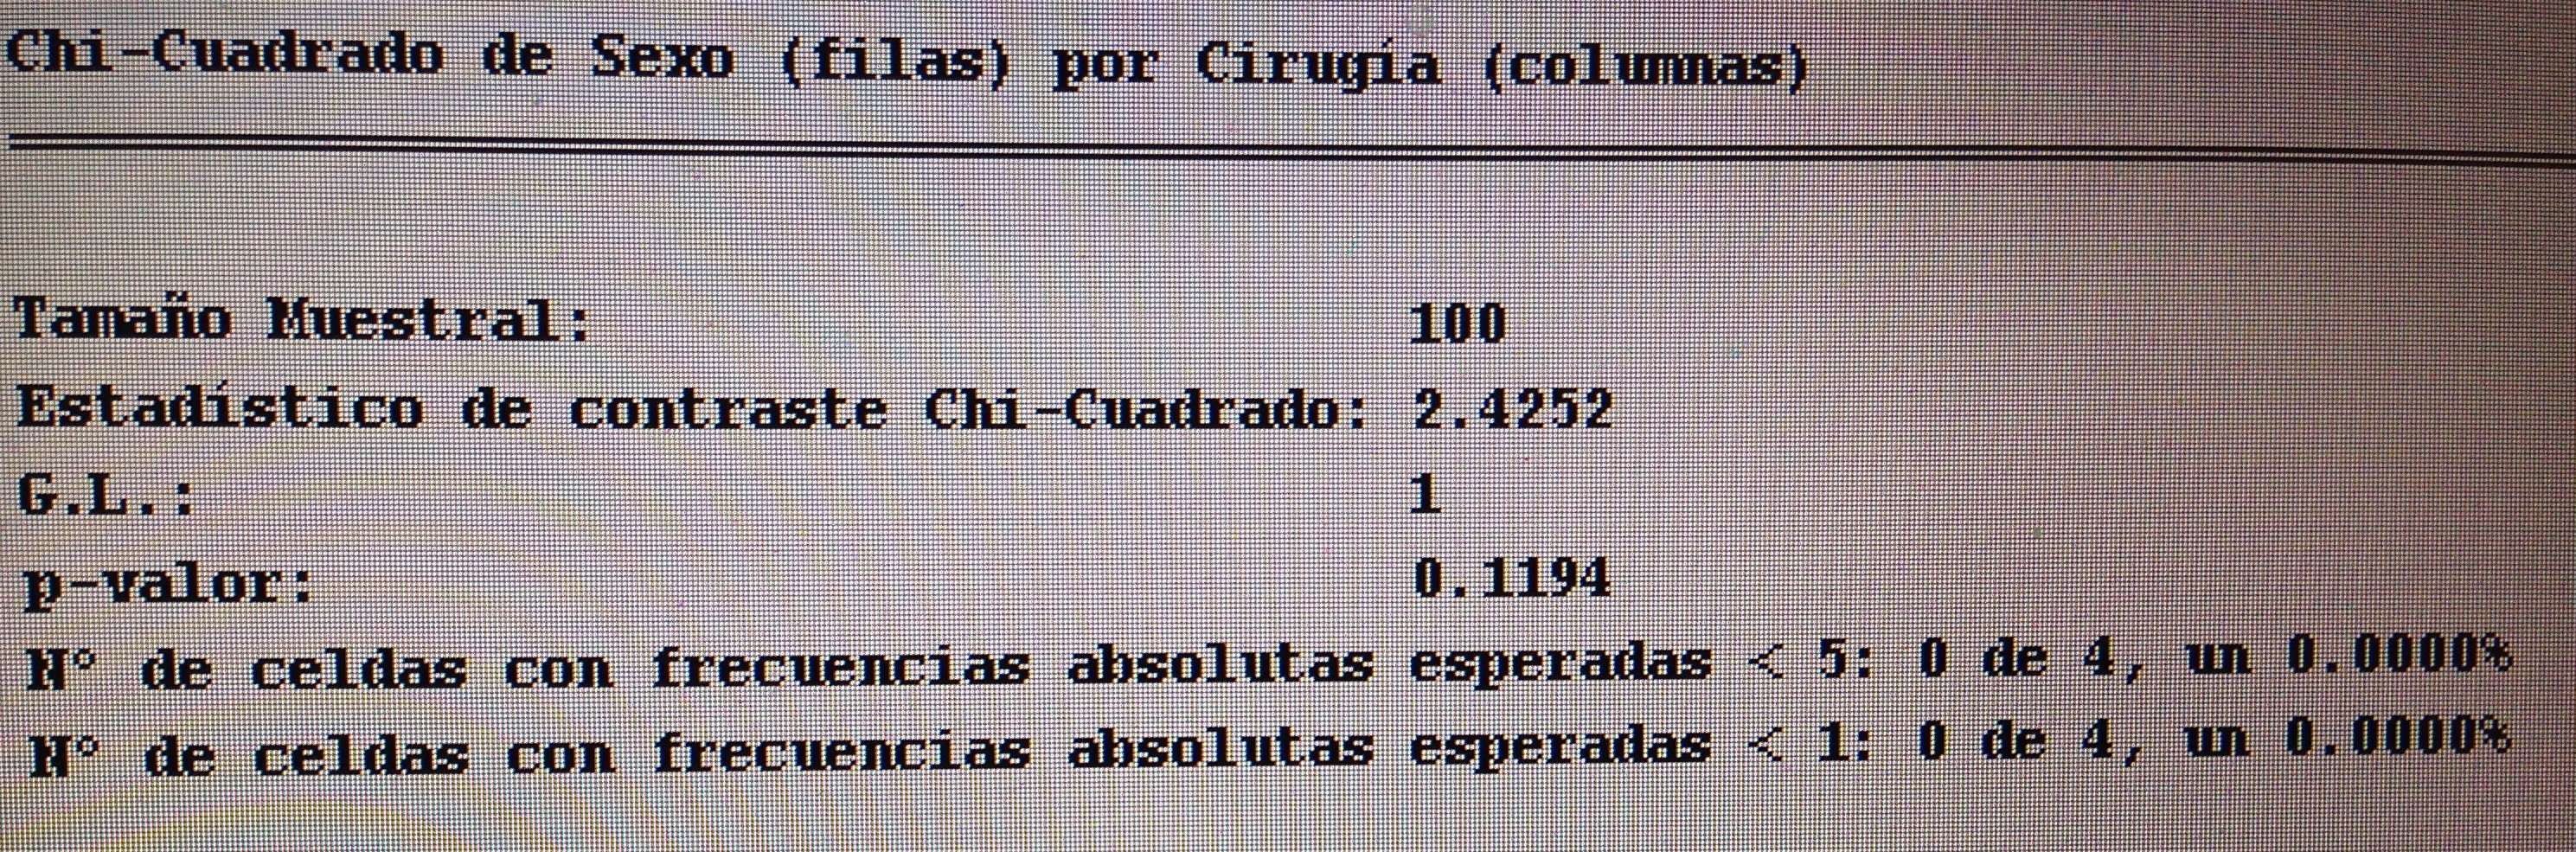
1. Analizar la relación entre la variable Sexo y Cirugía:

IMG_7717


IMG_7721

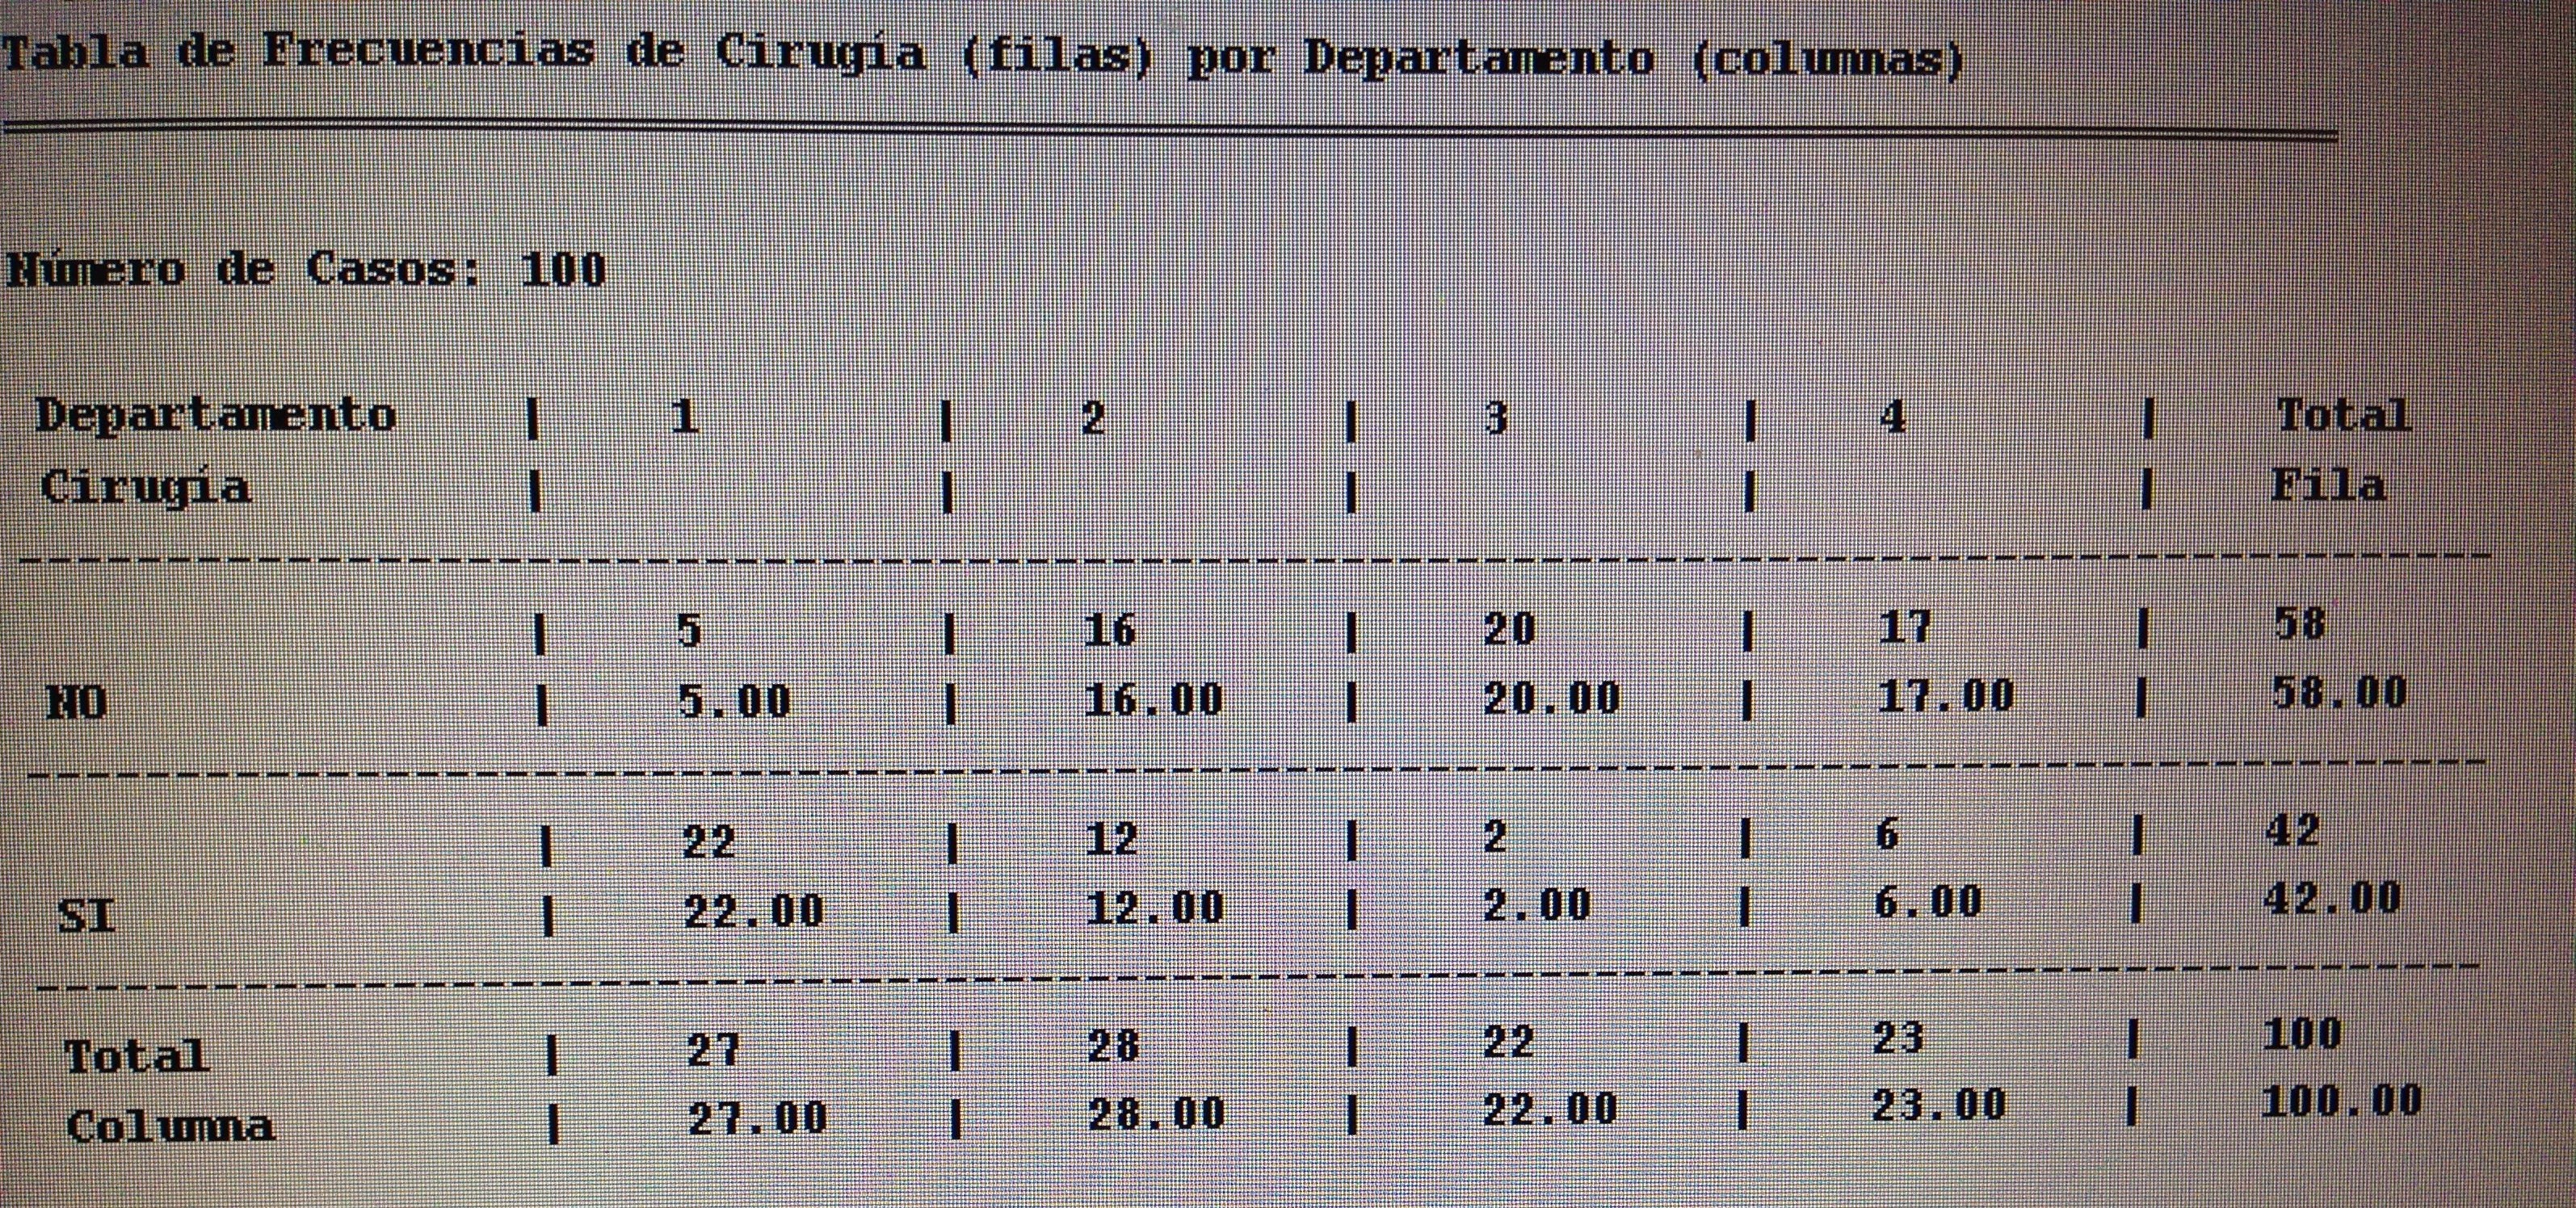
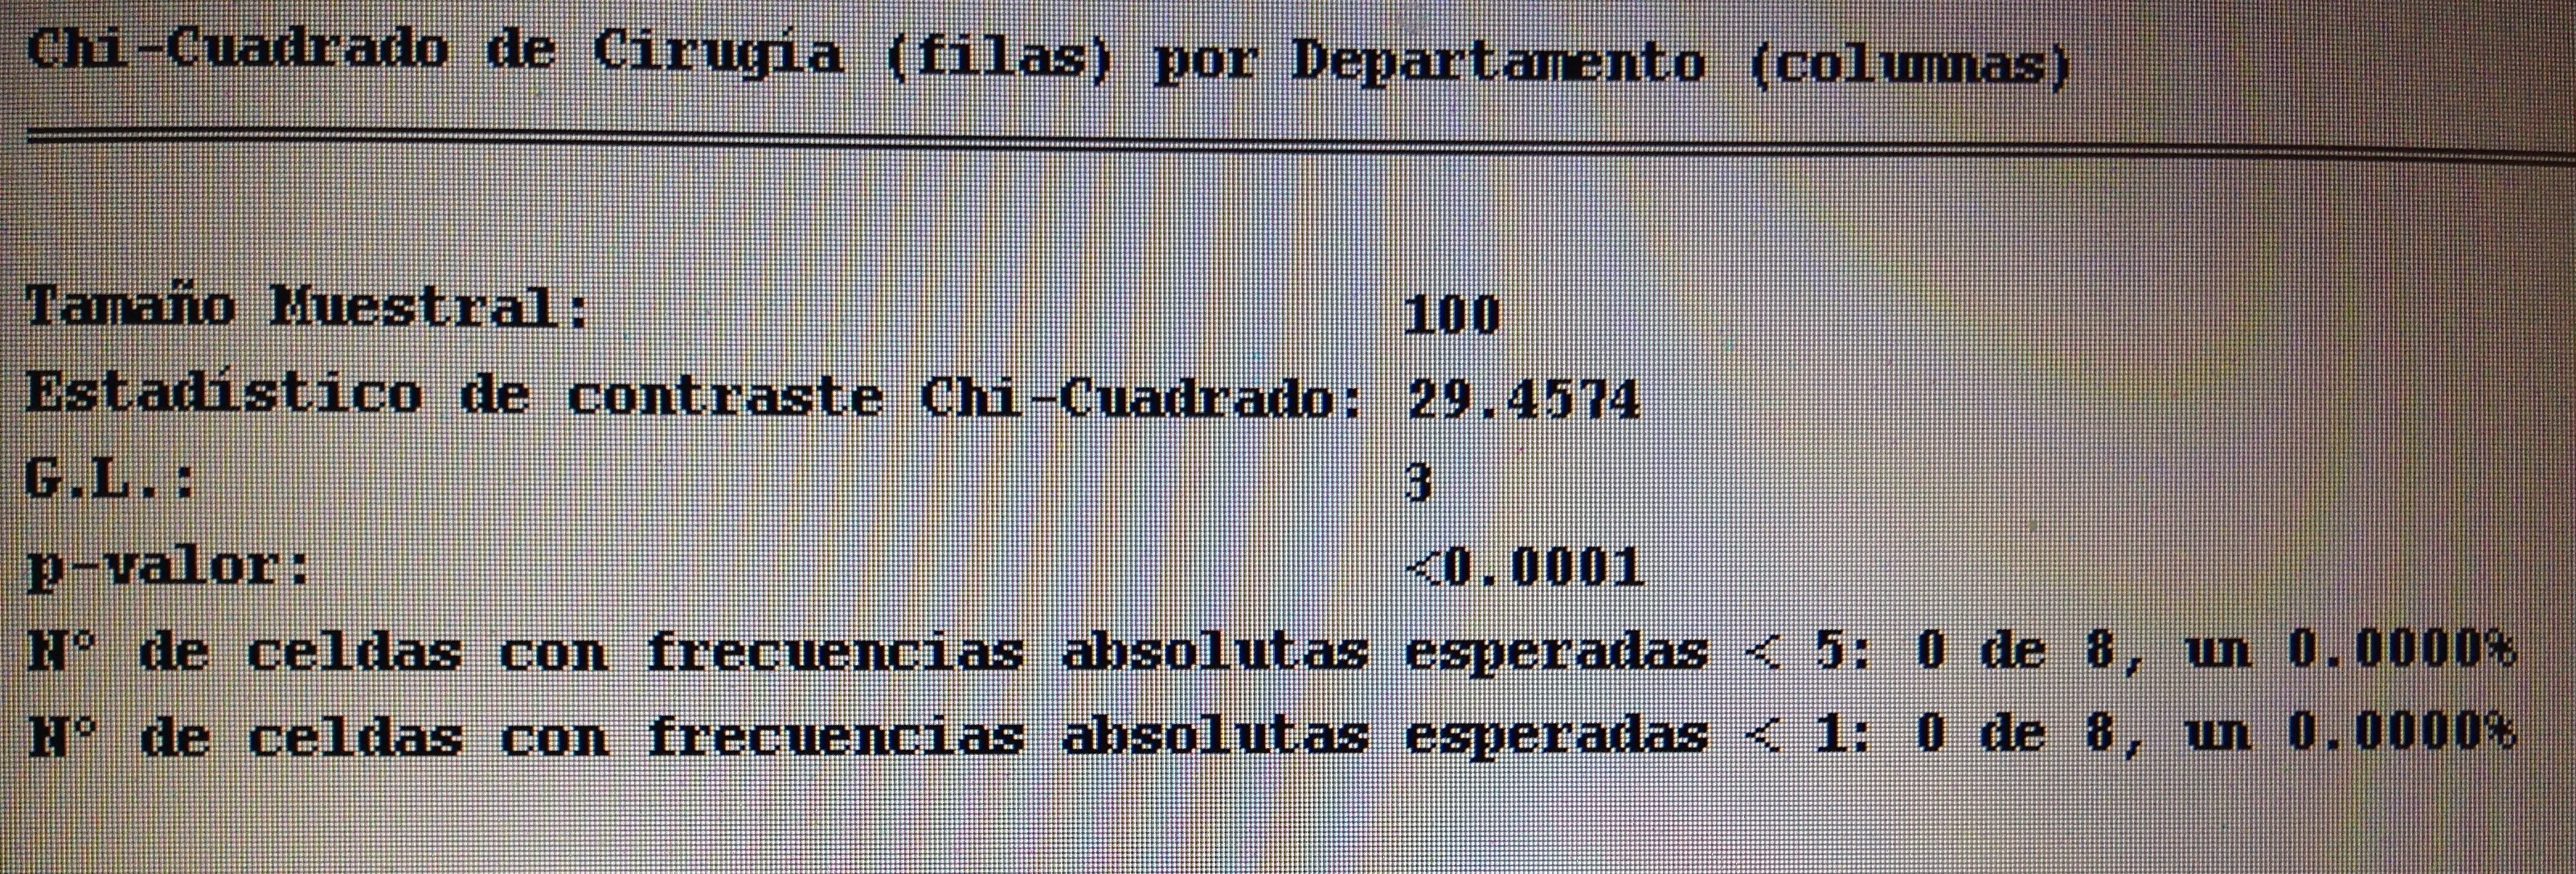
2. Analizar la relación entre la variable Cirugía y Departamento:

IMG_7722


IMG_7723

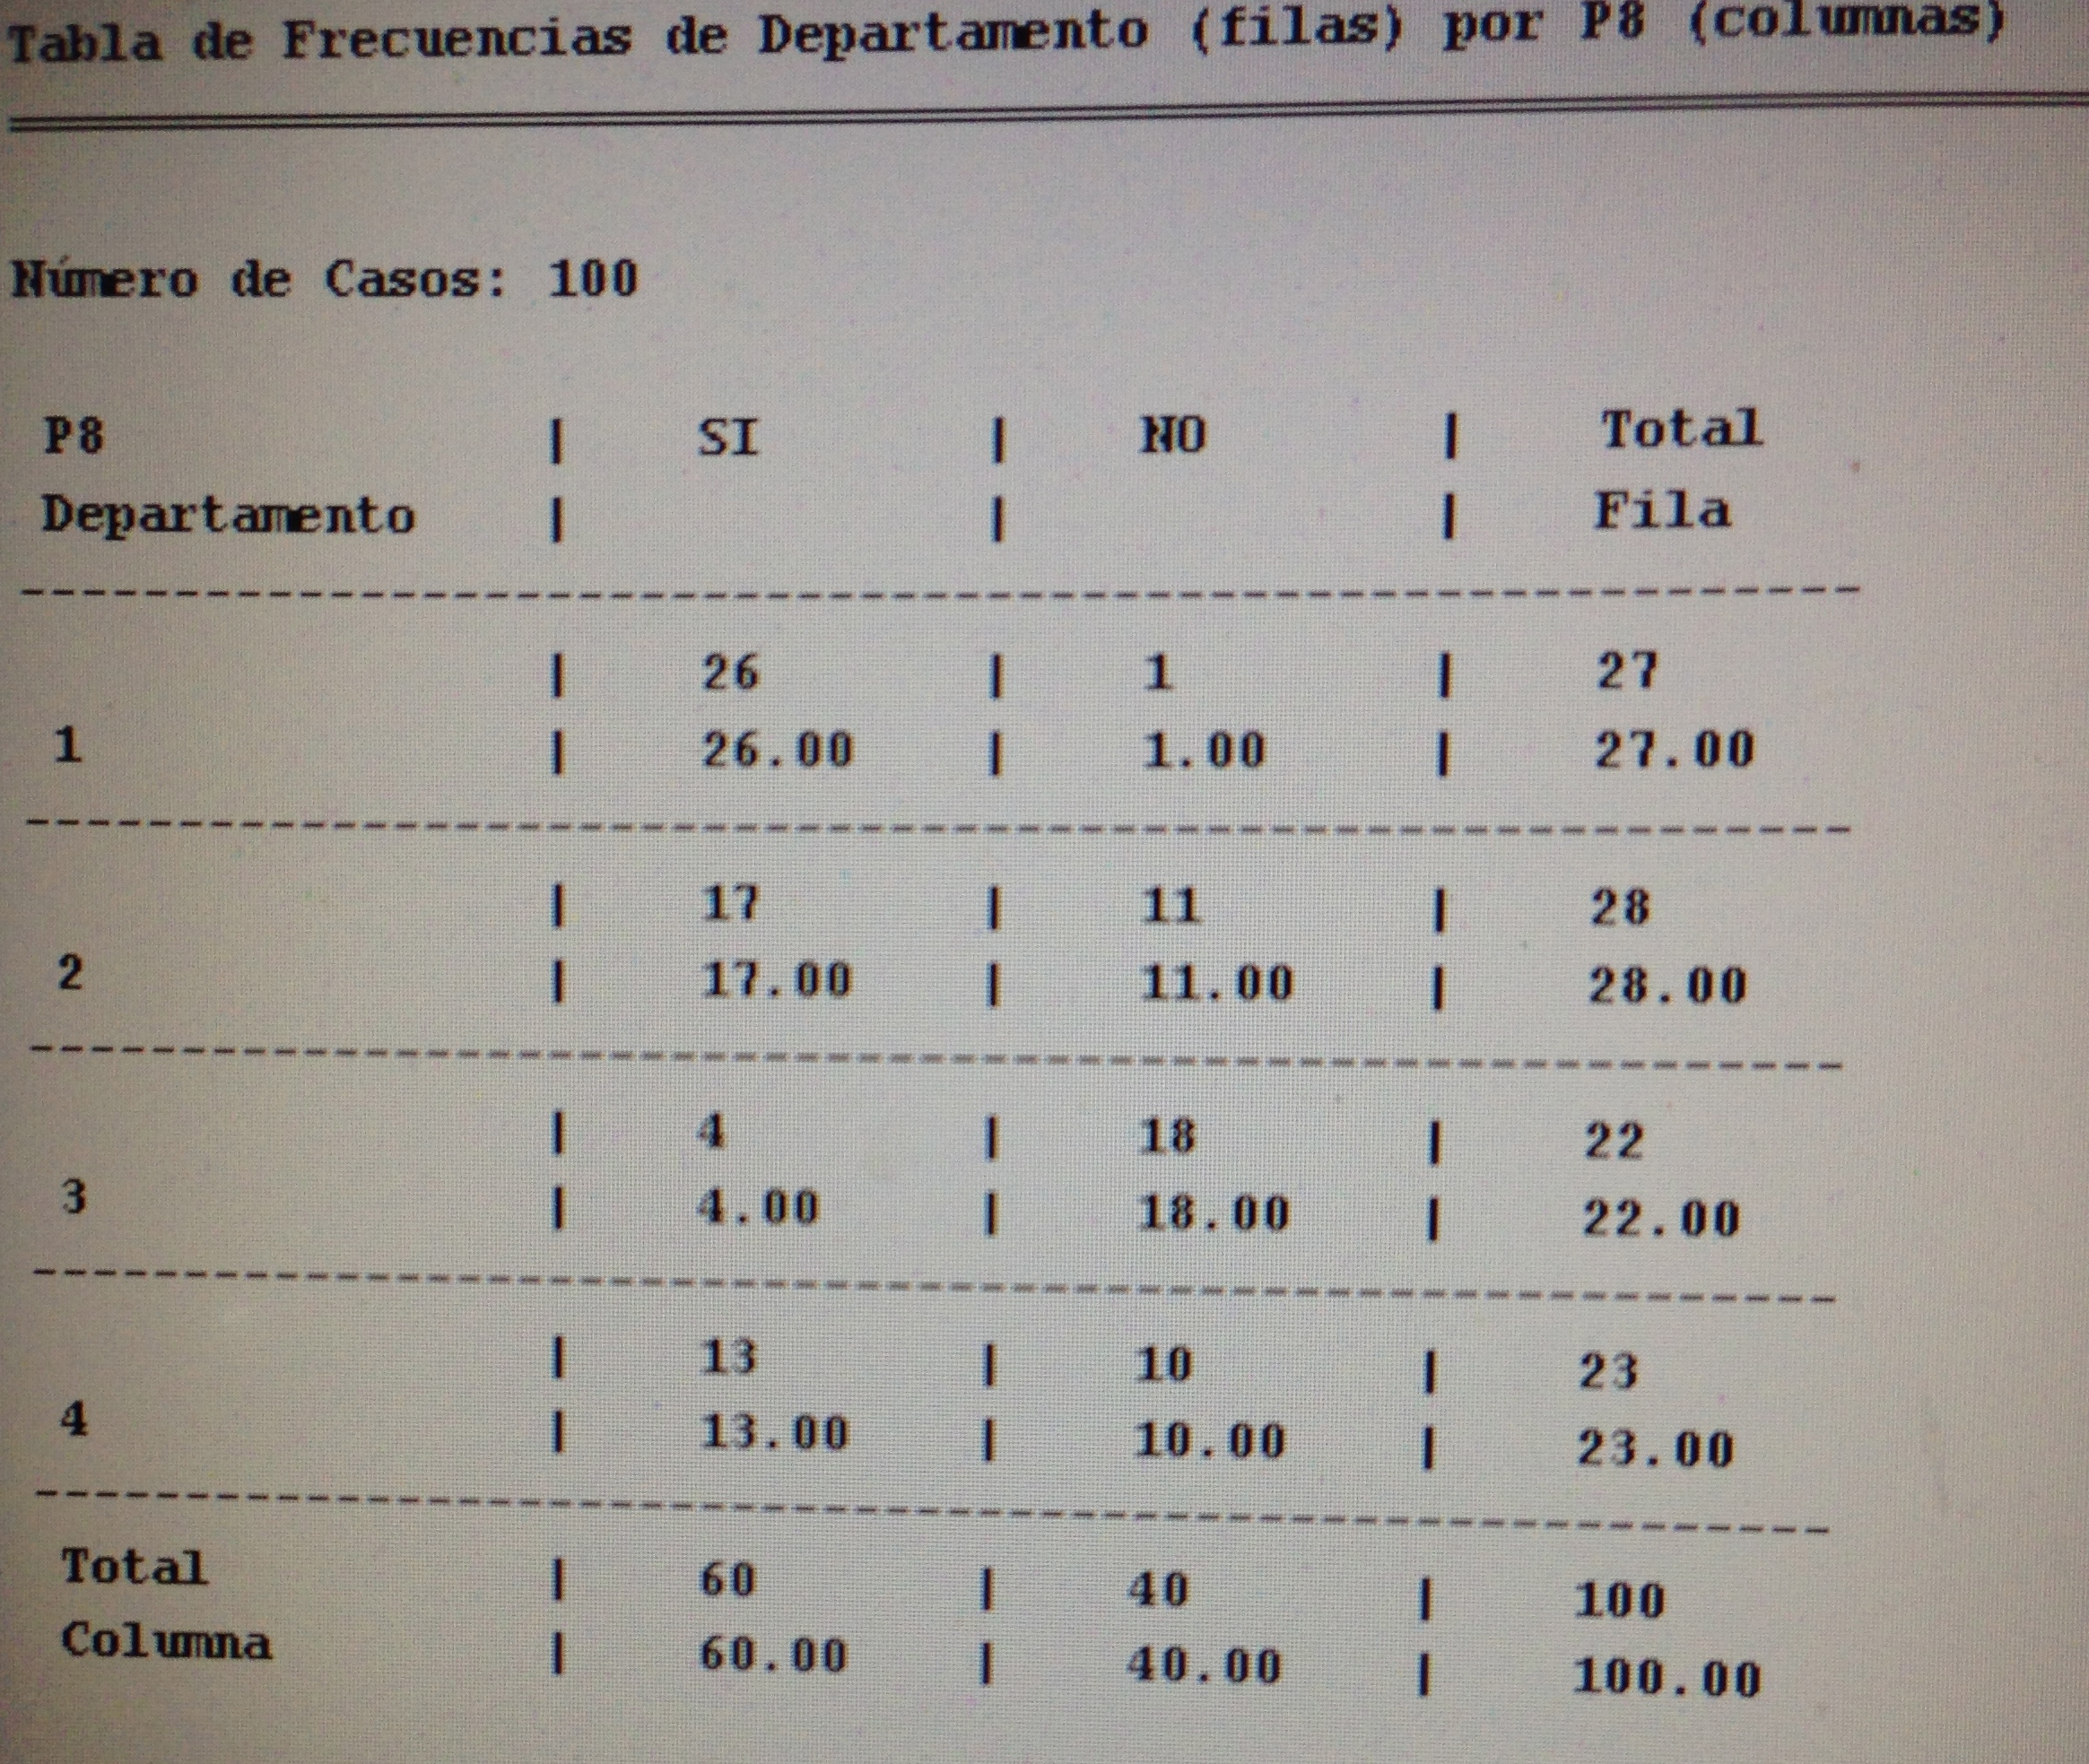
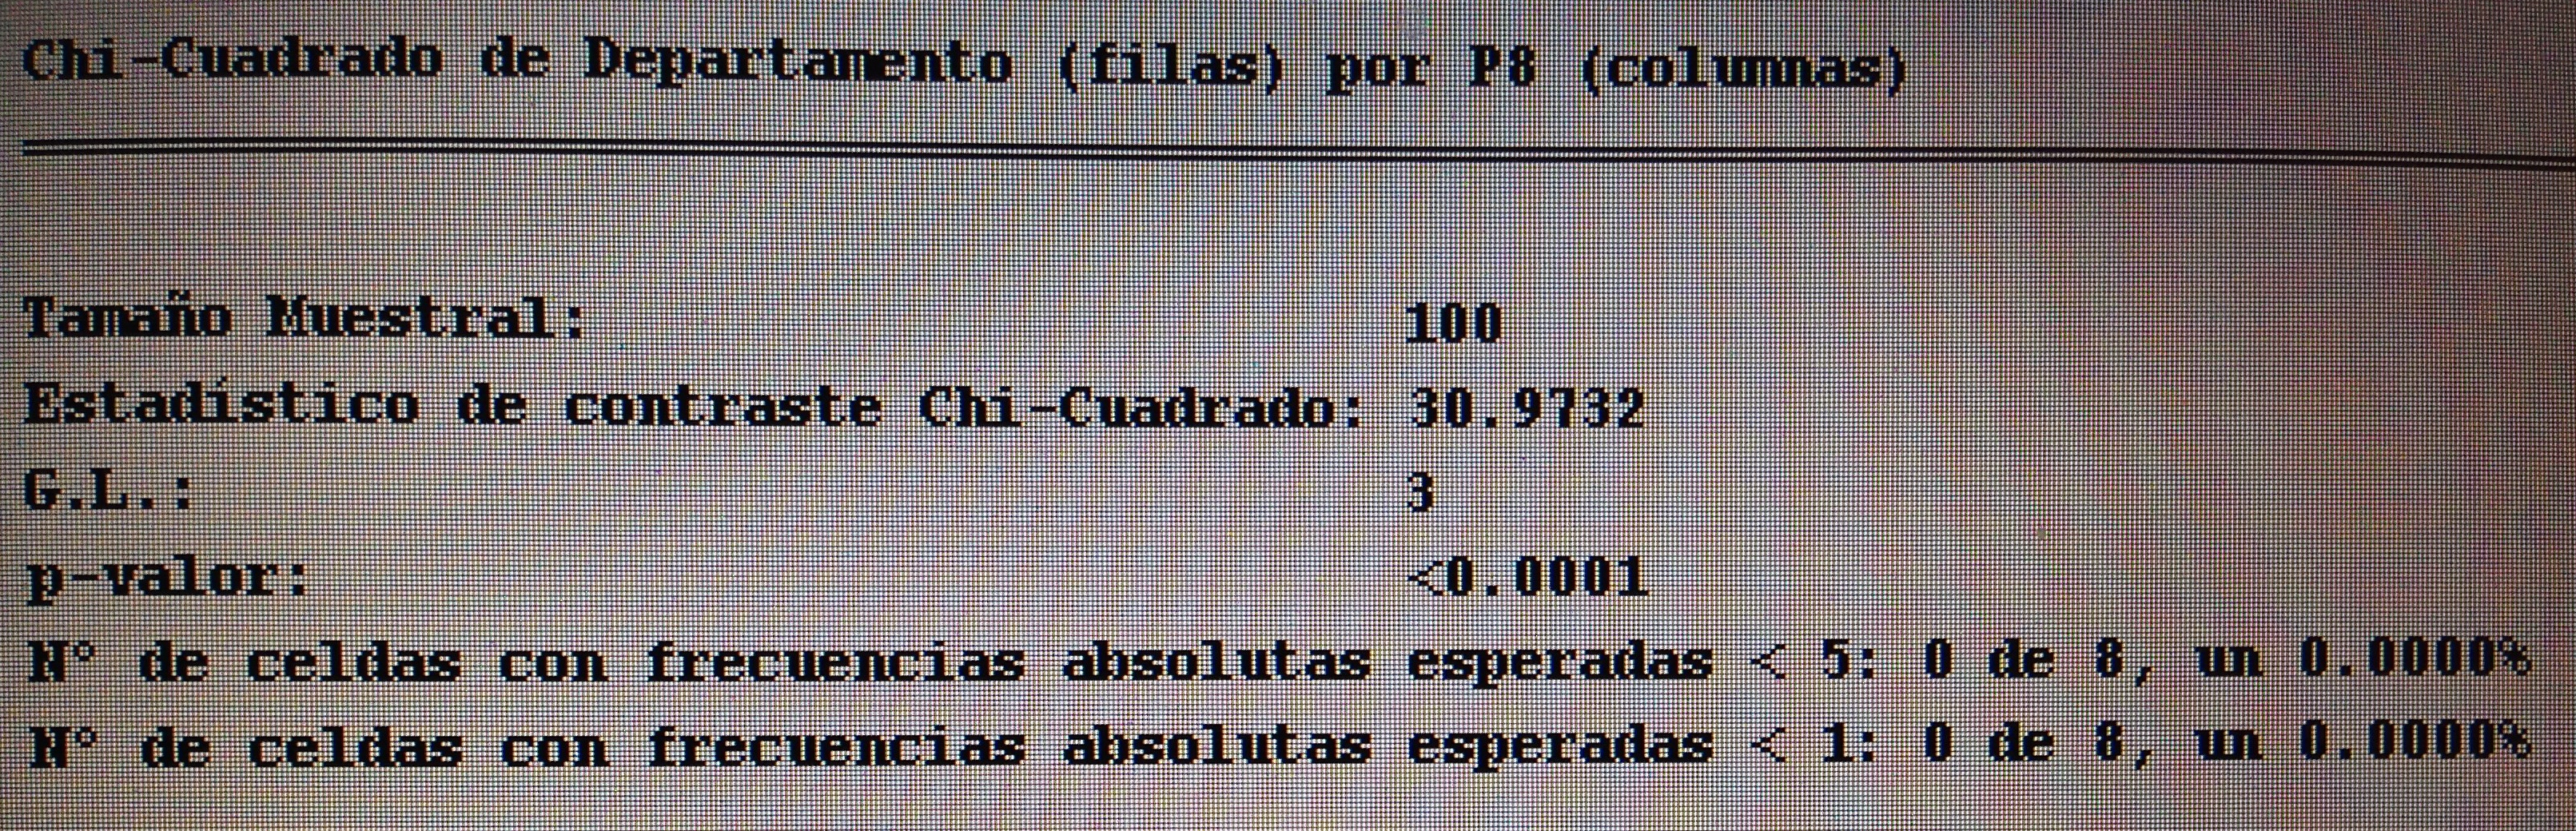
3. Analizar la relación entre la variable Departamento y P8:

IMG_7724


IMG_7725

4. Analizar la relación entre la variable Departamento y Cirugía, calculando la V de Cramer si existe relación significativa:

IMG_7726


IMG_7727


IMG_7728


Explotación de una base de datos 3: Correlaciones

A nuestra base de datos adjunta en el artículo Explotación de una base de datos 1: Base de datos le podemos calcular correlaciones entre variables cuantitativas. Veamos algunos ejemplos:

1. Calcular la correlación de Pearson entre las variables cuantitativas Edad, Días de ingreso y Valoración general.

2. Calcular la correlación de Spearman entre esas mismas variables.

3. Calcular la correlación de Spearman entre las variables P1, P2, P3, P4, P5, P6 y P7.

4. A partir de lo visto en el apartado anterior crear grupos con buena consistencia interna, con alto valor de alfa de Cronbach.

SOLUCIONES

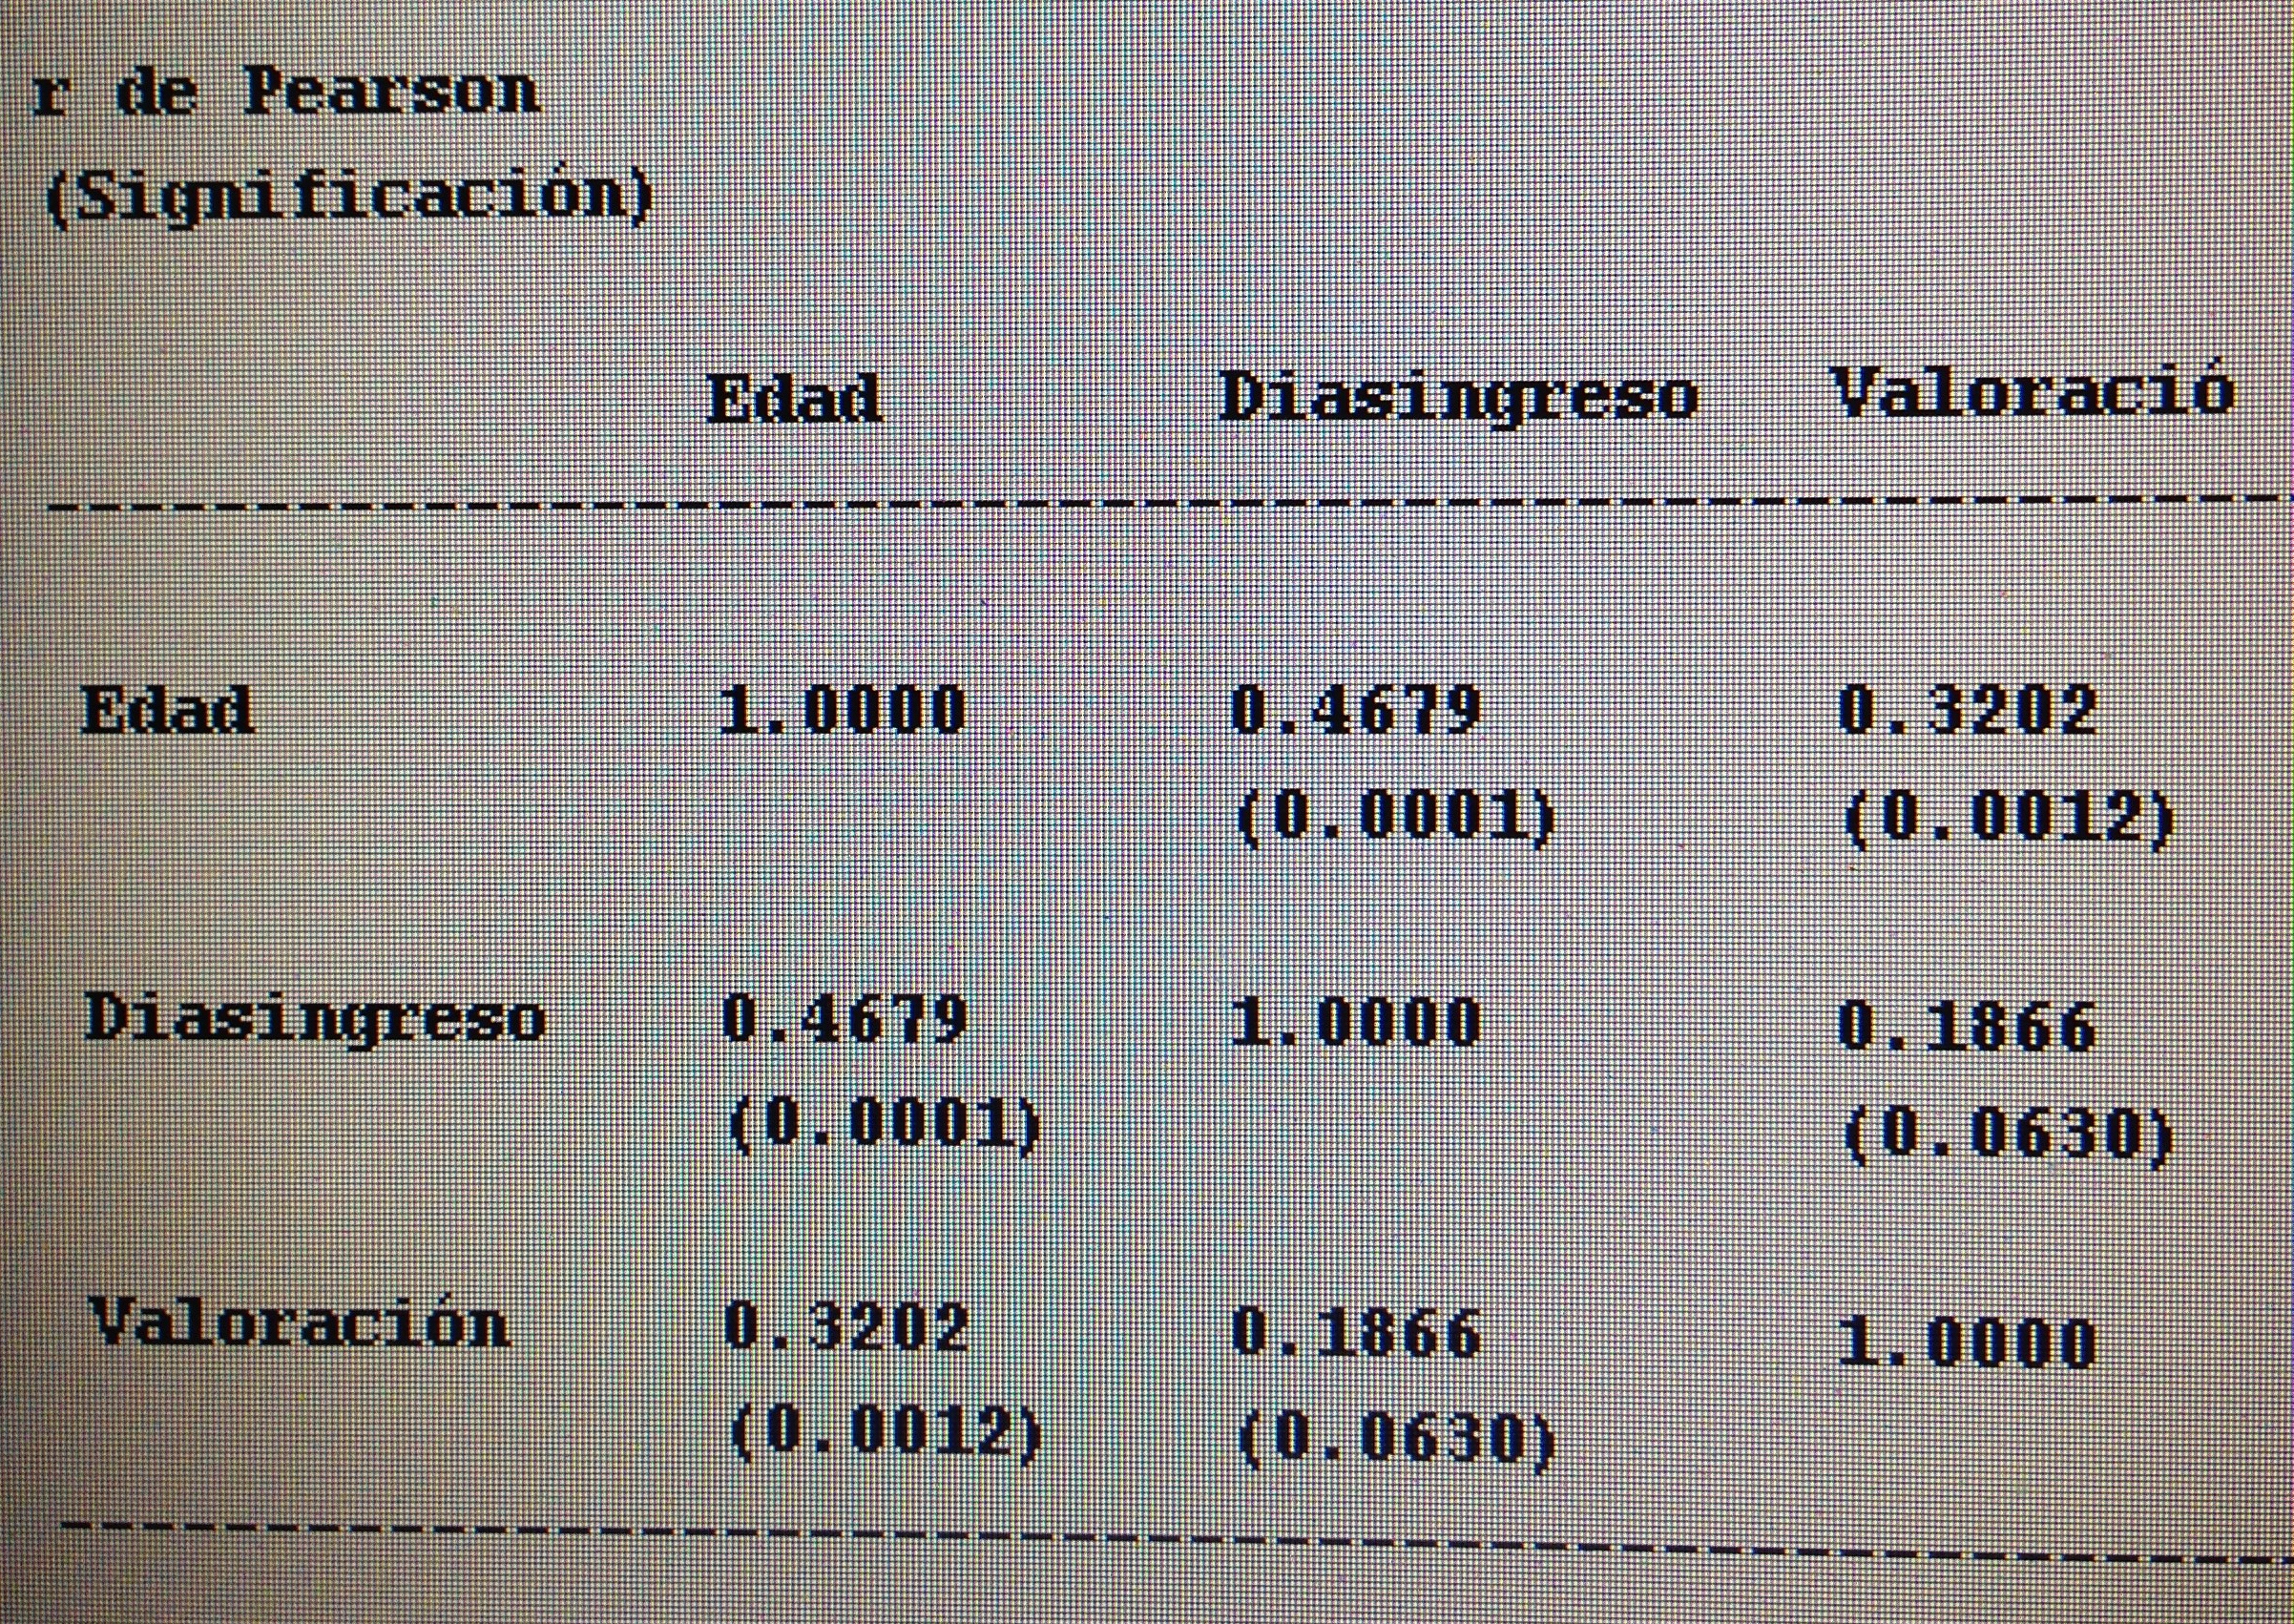
1. Calcular la correlación de Pearson entre las variables cuantitativas Edad, Días de ingreso y Valoración general:

IMG_7709

2. Calcular la correlación de Spearman entre esas mismas variables:

IMG_7711

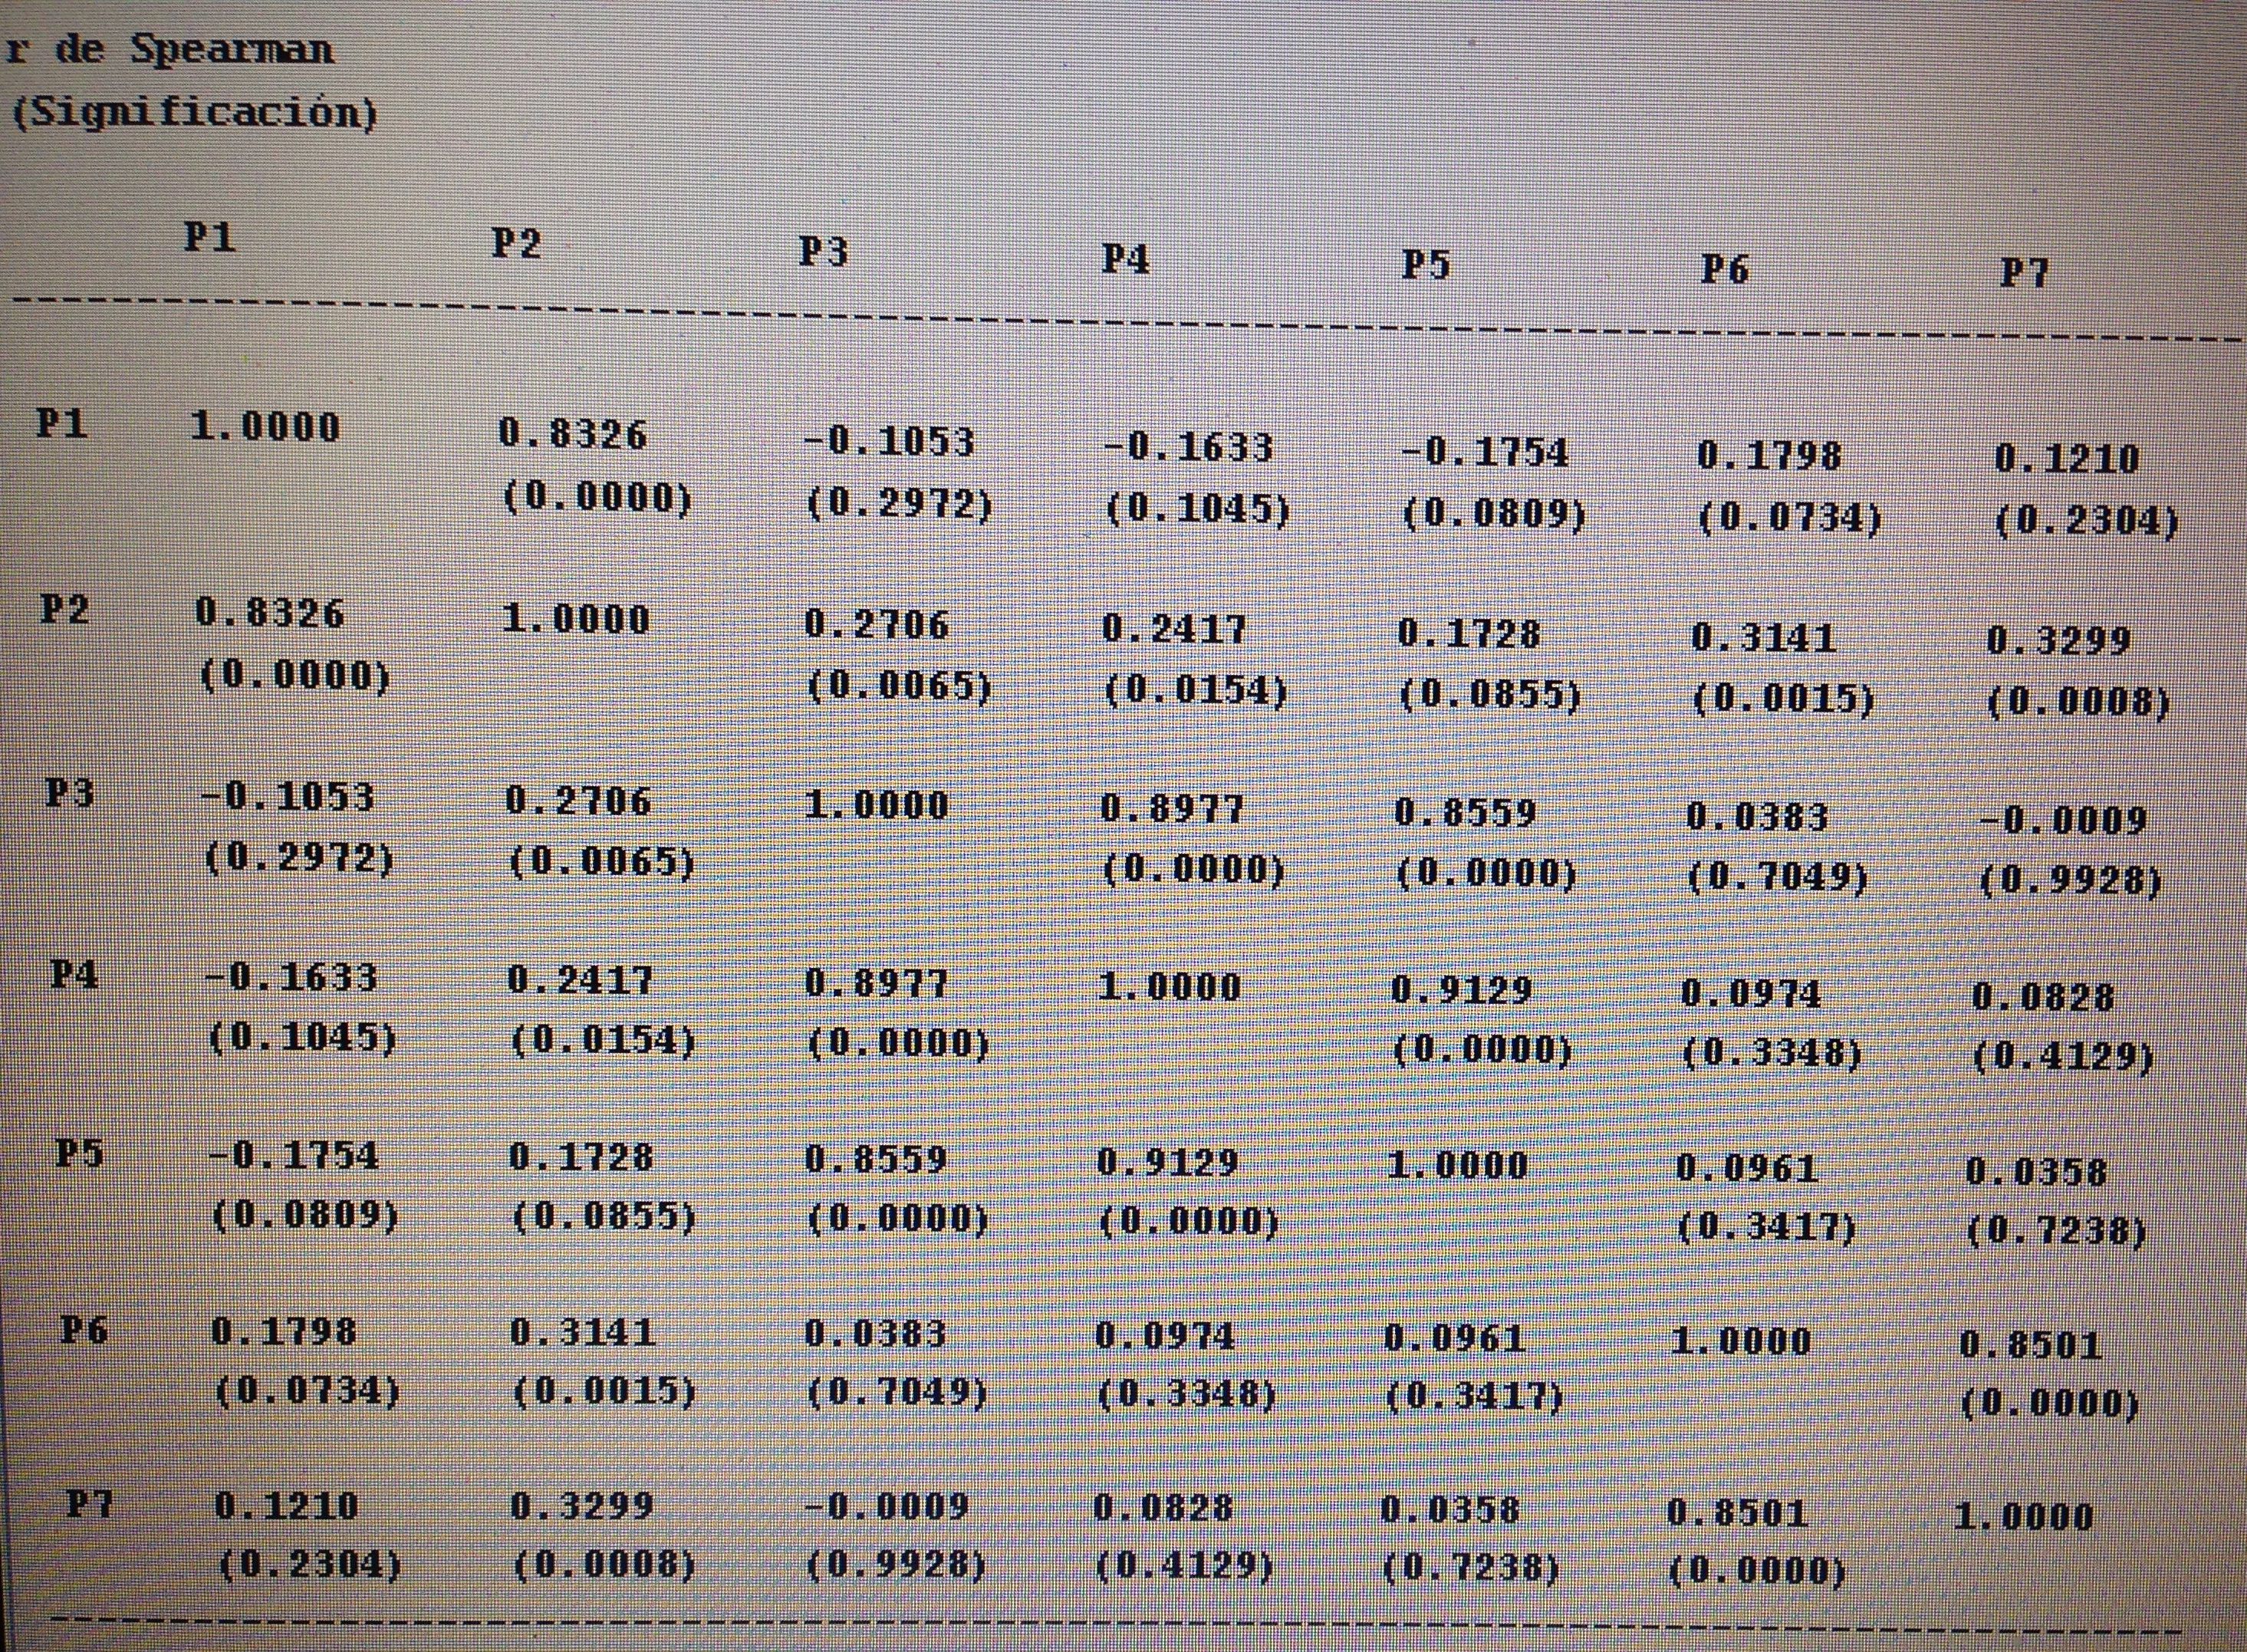
3. Calcular la correlación de Spearman entre las variables P1, P2, P3, P4, P5, P6 y P7:

IMG_7714

4. A partir de lo visto en el apartado anterior crear grupos con buena consistencia interna, con alto valor de alfa de Cronbach:

Observemos que las combinaciones que tienen alta correlación son los grupos:

P1-P2

P3-P4-P5

P6-P7

Sólo tiene sentido calcular la alfa de Cronbach en estos tres grupos. Para ver cómo se calcula este índice ver el artículo Alfa de Cronbach. La forma más cómoda de cálculo es a partir de la correlación:

IMG_5934


Con P1 y P2 el valor es:

2×0,8326/(1+0,8325)=0,9086.

Con P6 y P7:

2×0,8501/(1+0,8501)=0,9189

Con P3, P4 y P5, como el promedio de las tres correlaciones dos a dos entre estas variables es 0,8888:

3×0,8888/(1+2×0,8888)=0,9599

Como podemos ver consistencias internas muy elevadas.

Explotación de una base de datos 2: Estadística descriptiva

A nuestra base de datos adjunta en el artículo Explotación de una base de datos 1: Base de datos le podemos calcular muchas cosas de Estadística descriptiva. Veamos algunos ejemplos:

1. Hacer una Estadística descriptiva de las variables cuantitativas: Edad, Días de ingreso y Valoración general.

2. Hacer una Estadística descriptiva de las variables cualitativas: Sexo, Cirugía, Departamento y P8.

3. Hacer una Estadística descriptiva de las variables P1 y P6 como ejemplos de dos de las siete variables Likert.

4. Representar de la forma más apropiada y resumida, con Media y Desviación estándar o Mediana y Rango intercuartílico, las variables Edad, Días de ingreso y Valoración general.

SOLUCIONES:

1. Hacer una Estadística descriptiva de las variables cuantitativas: Edad, Días de ingreso y Valoración general:

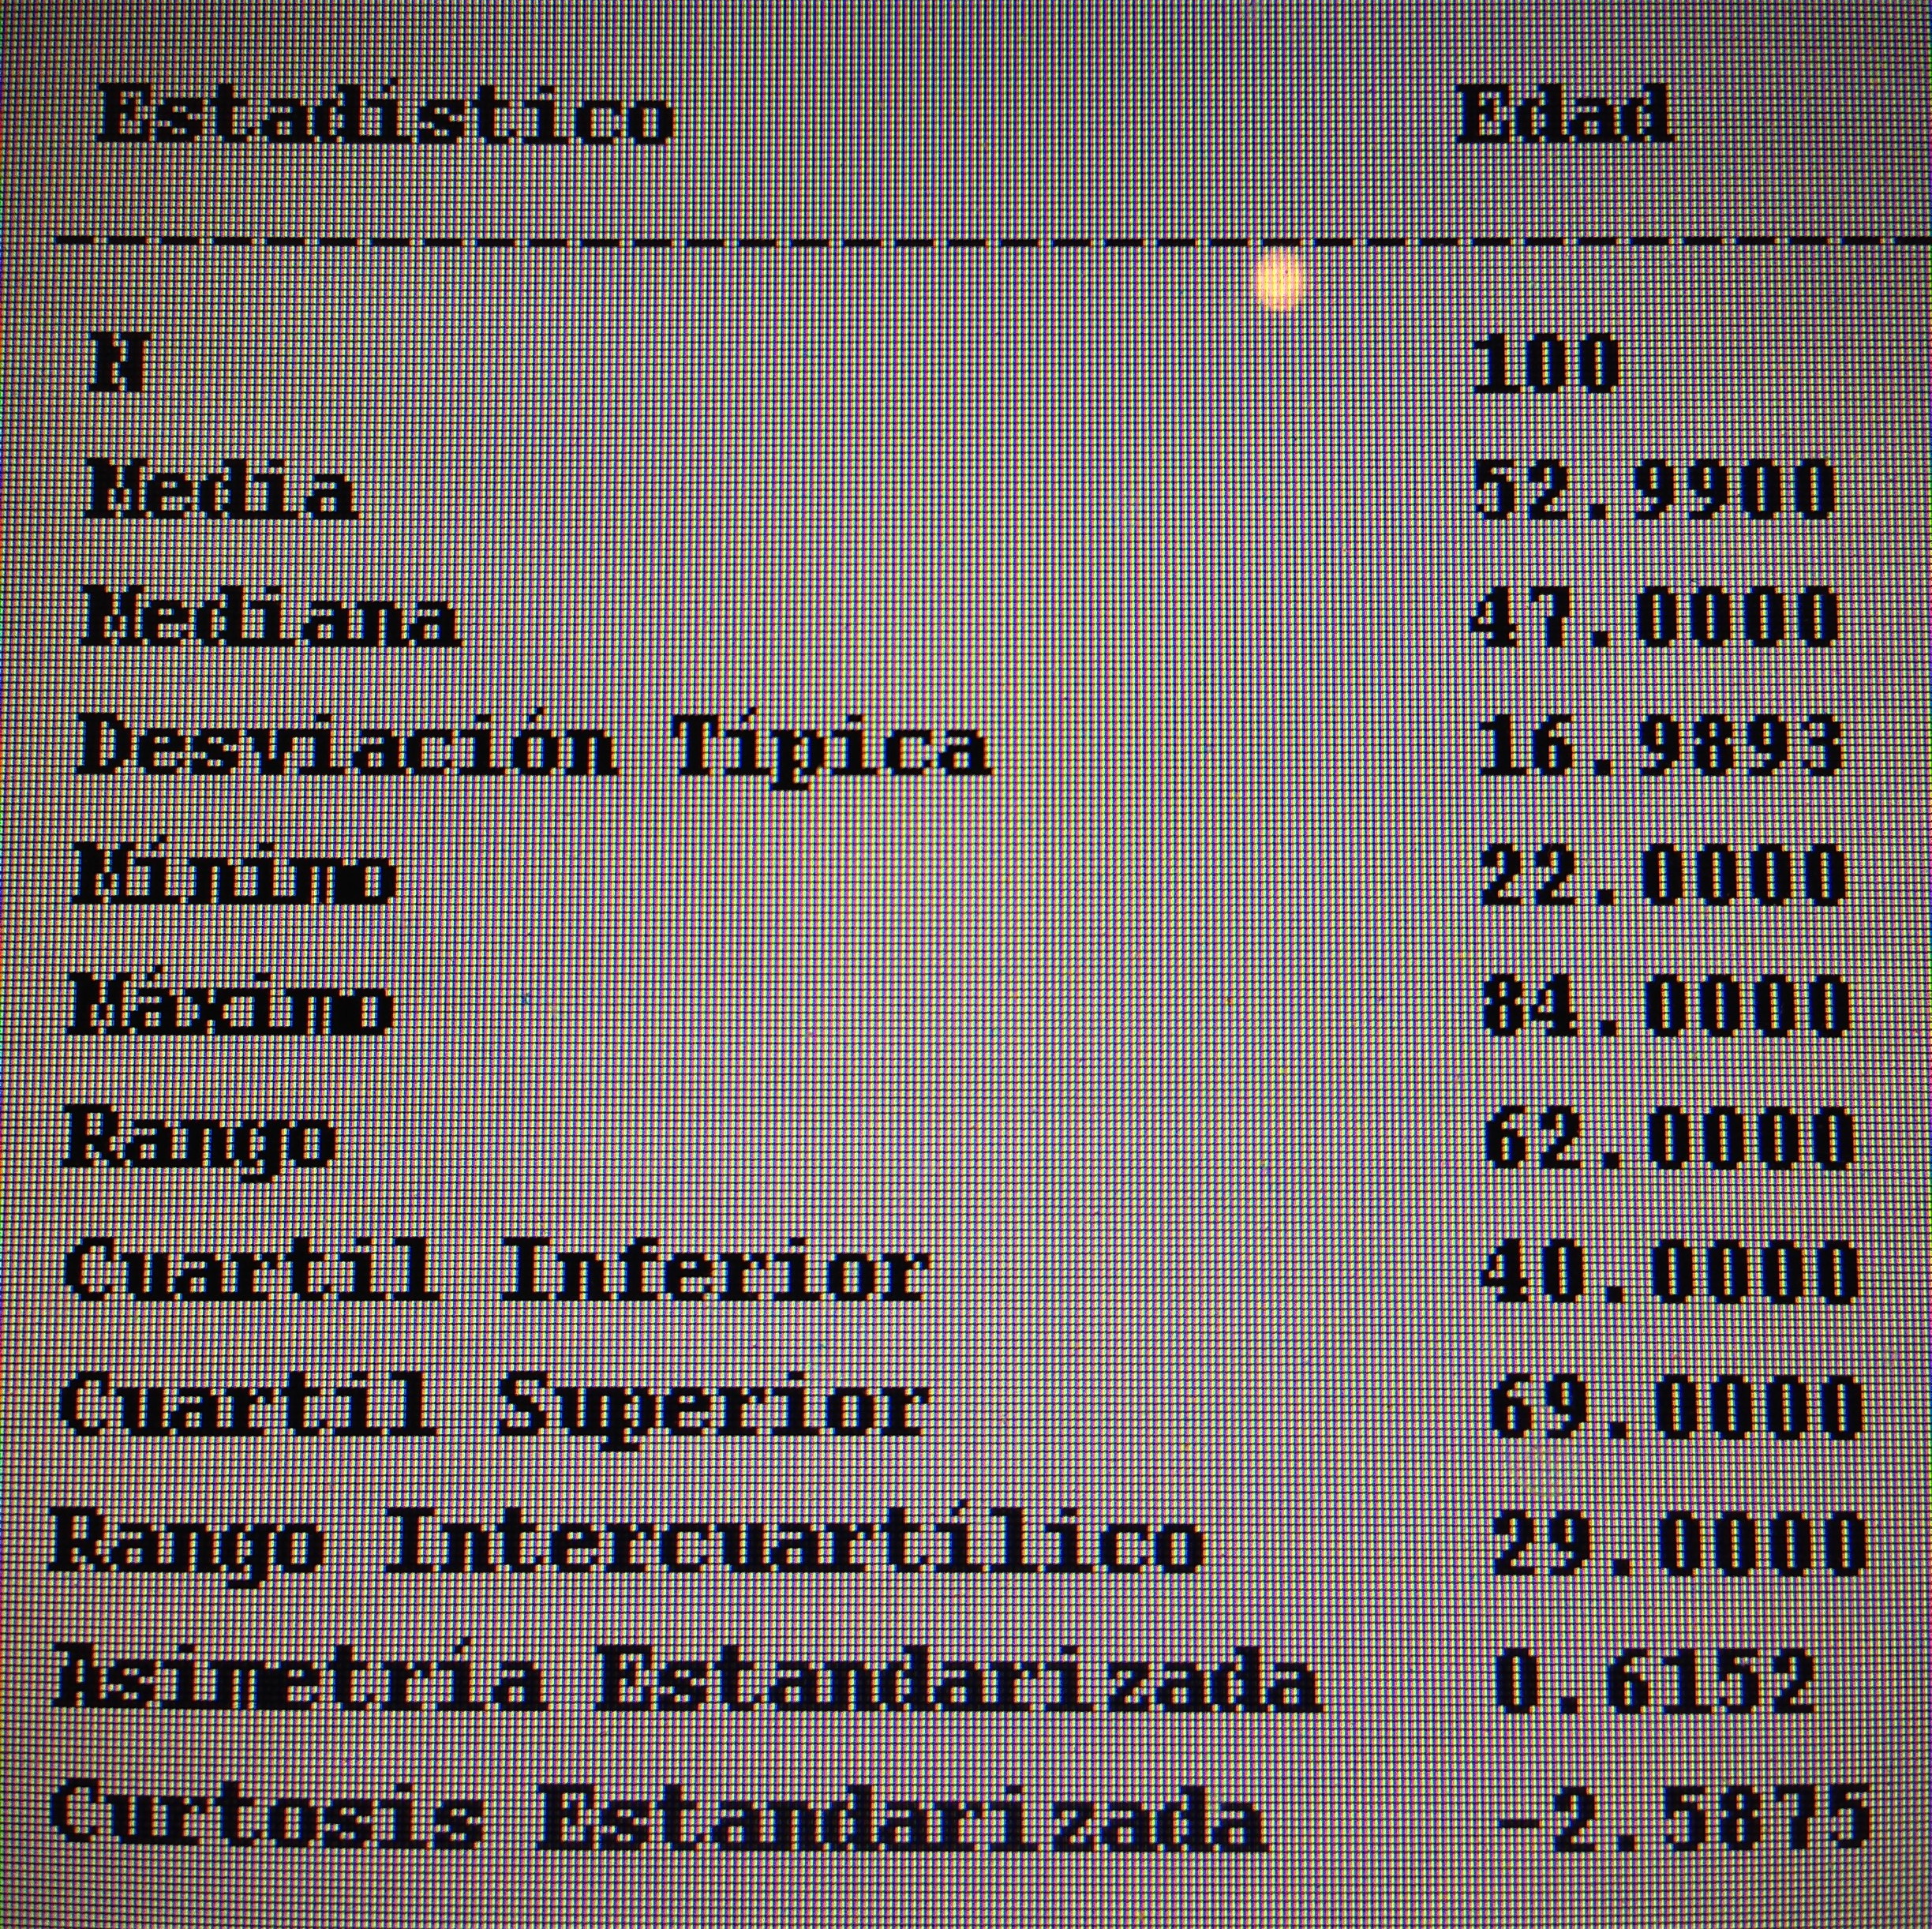
La variable Edad tiene los siguientes valores de los más importantes estadísticos descriptores:

IMG_7674

El Box-Plot:

IMG_7675

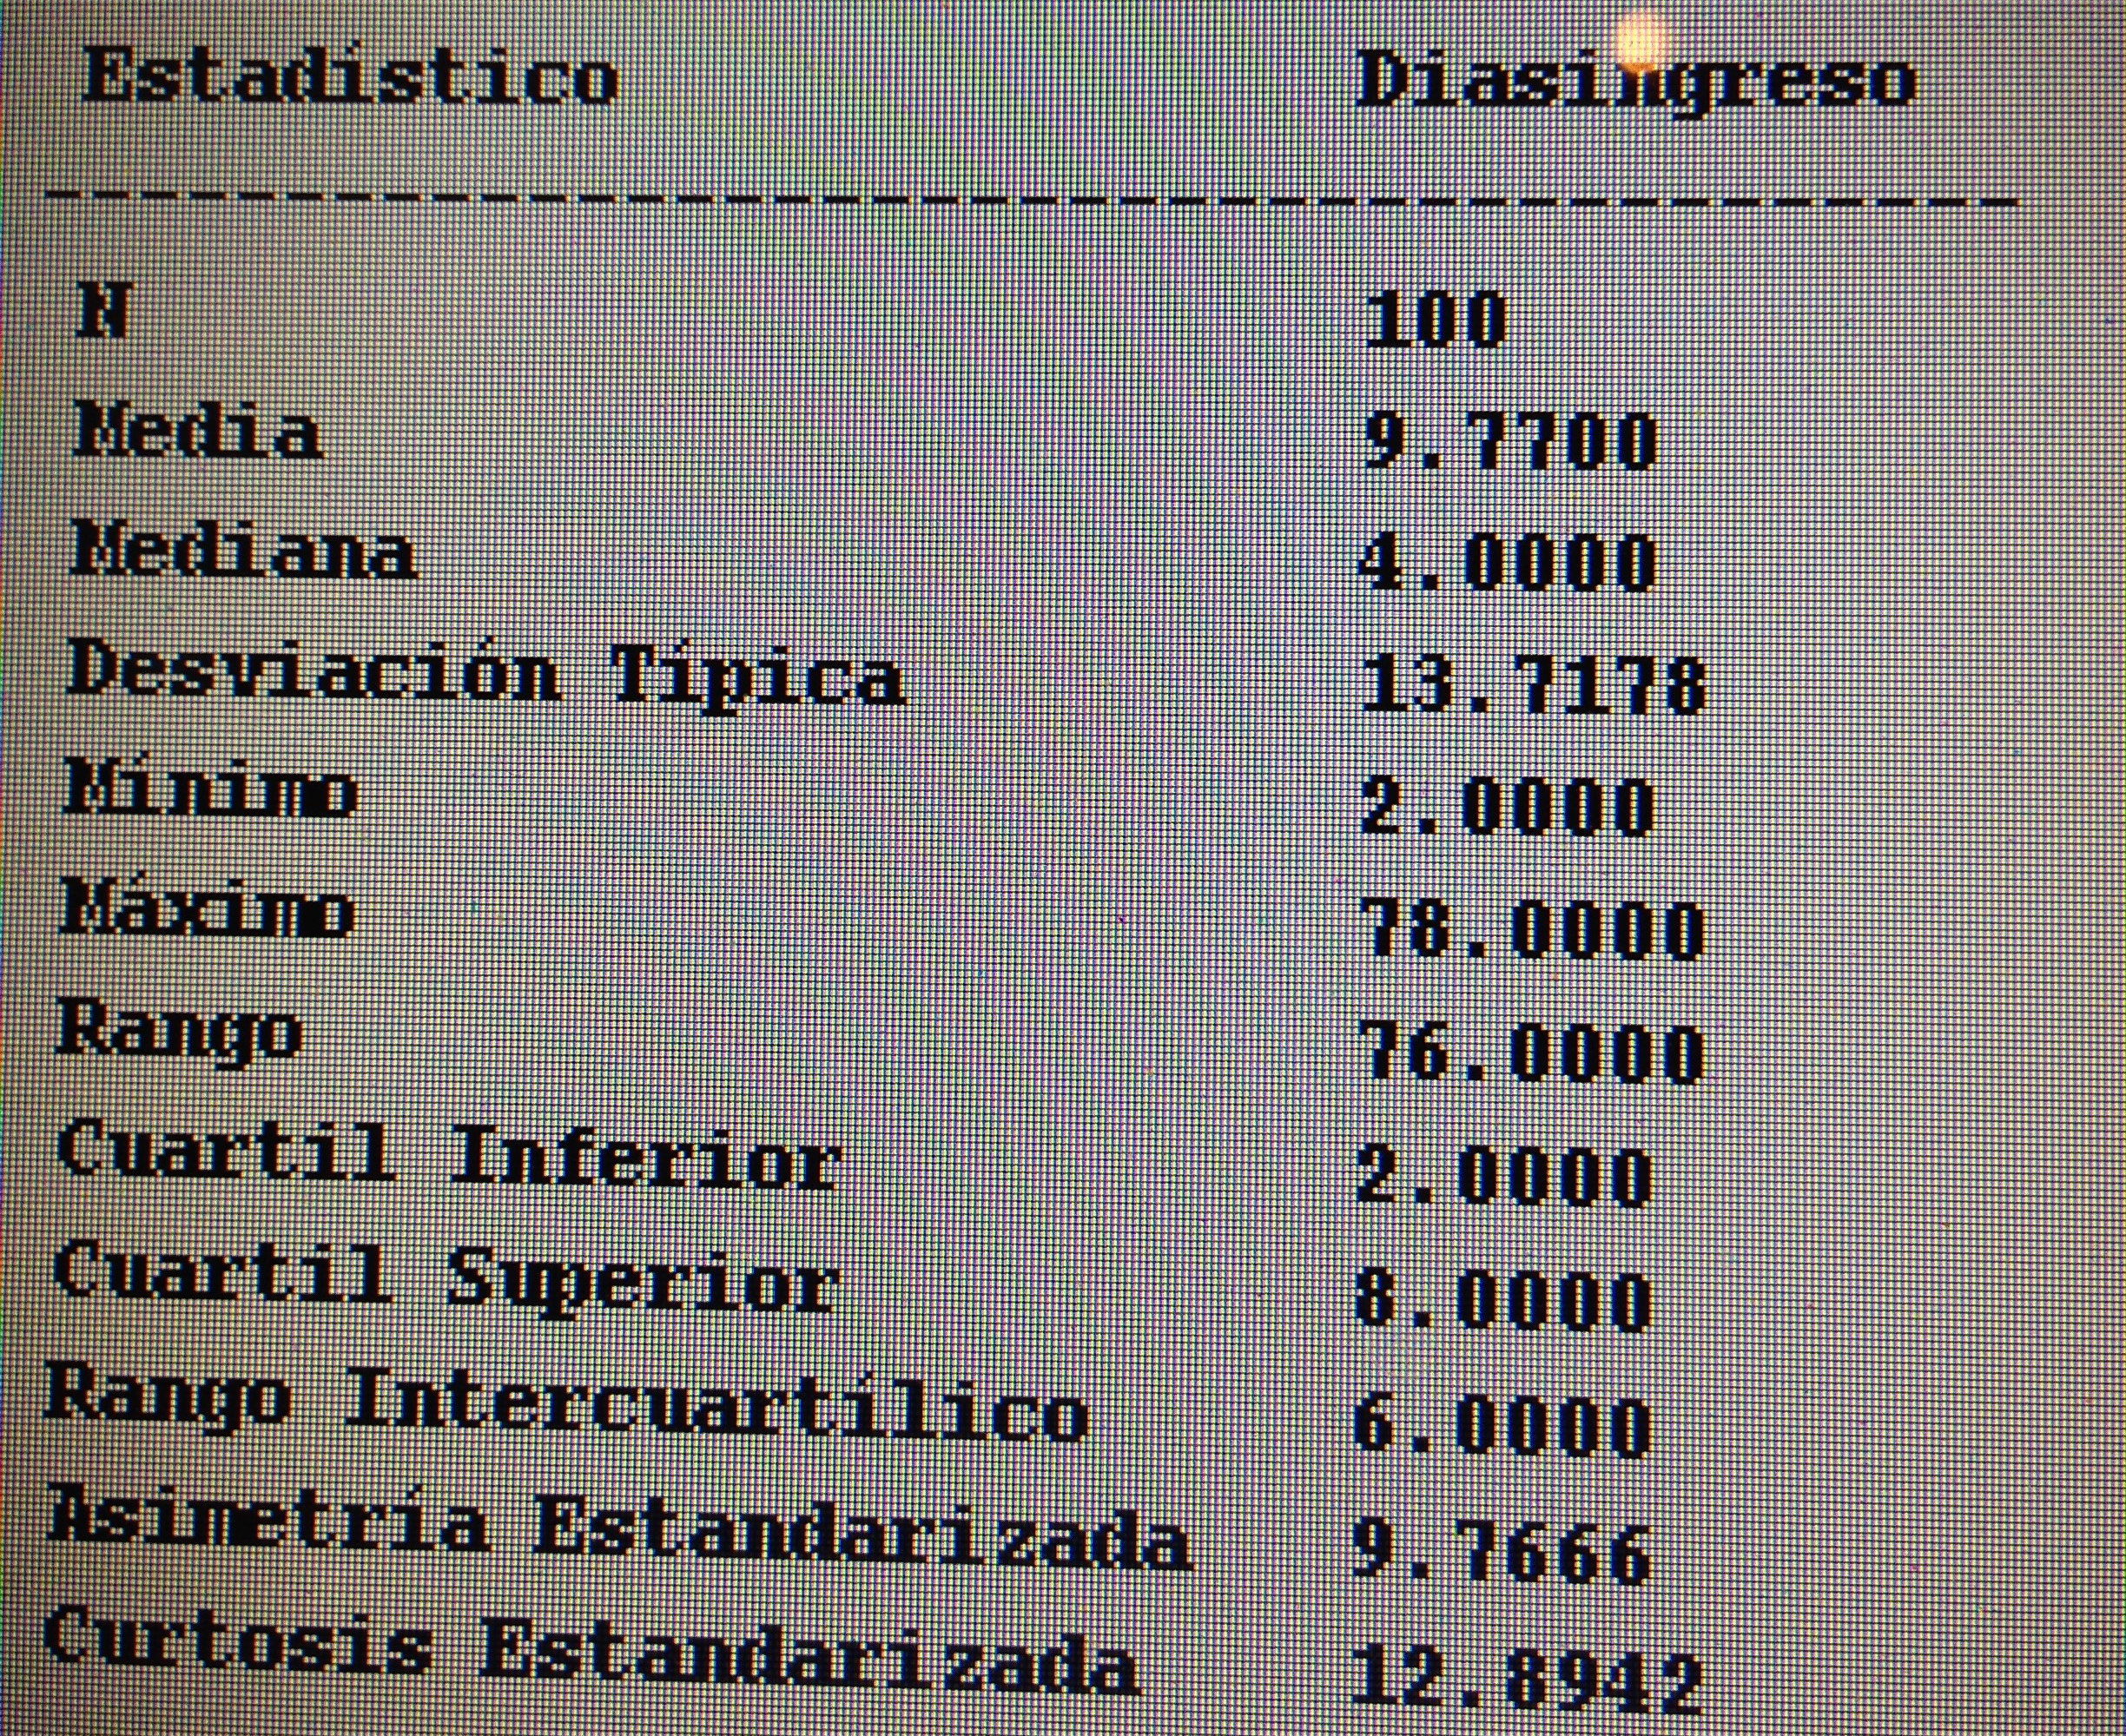
La variable Días de ingreso tiene los siguientes valores de los más importantes estadísticos descriptores:

IMG_7676

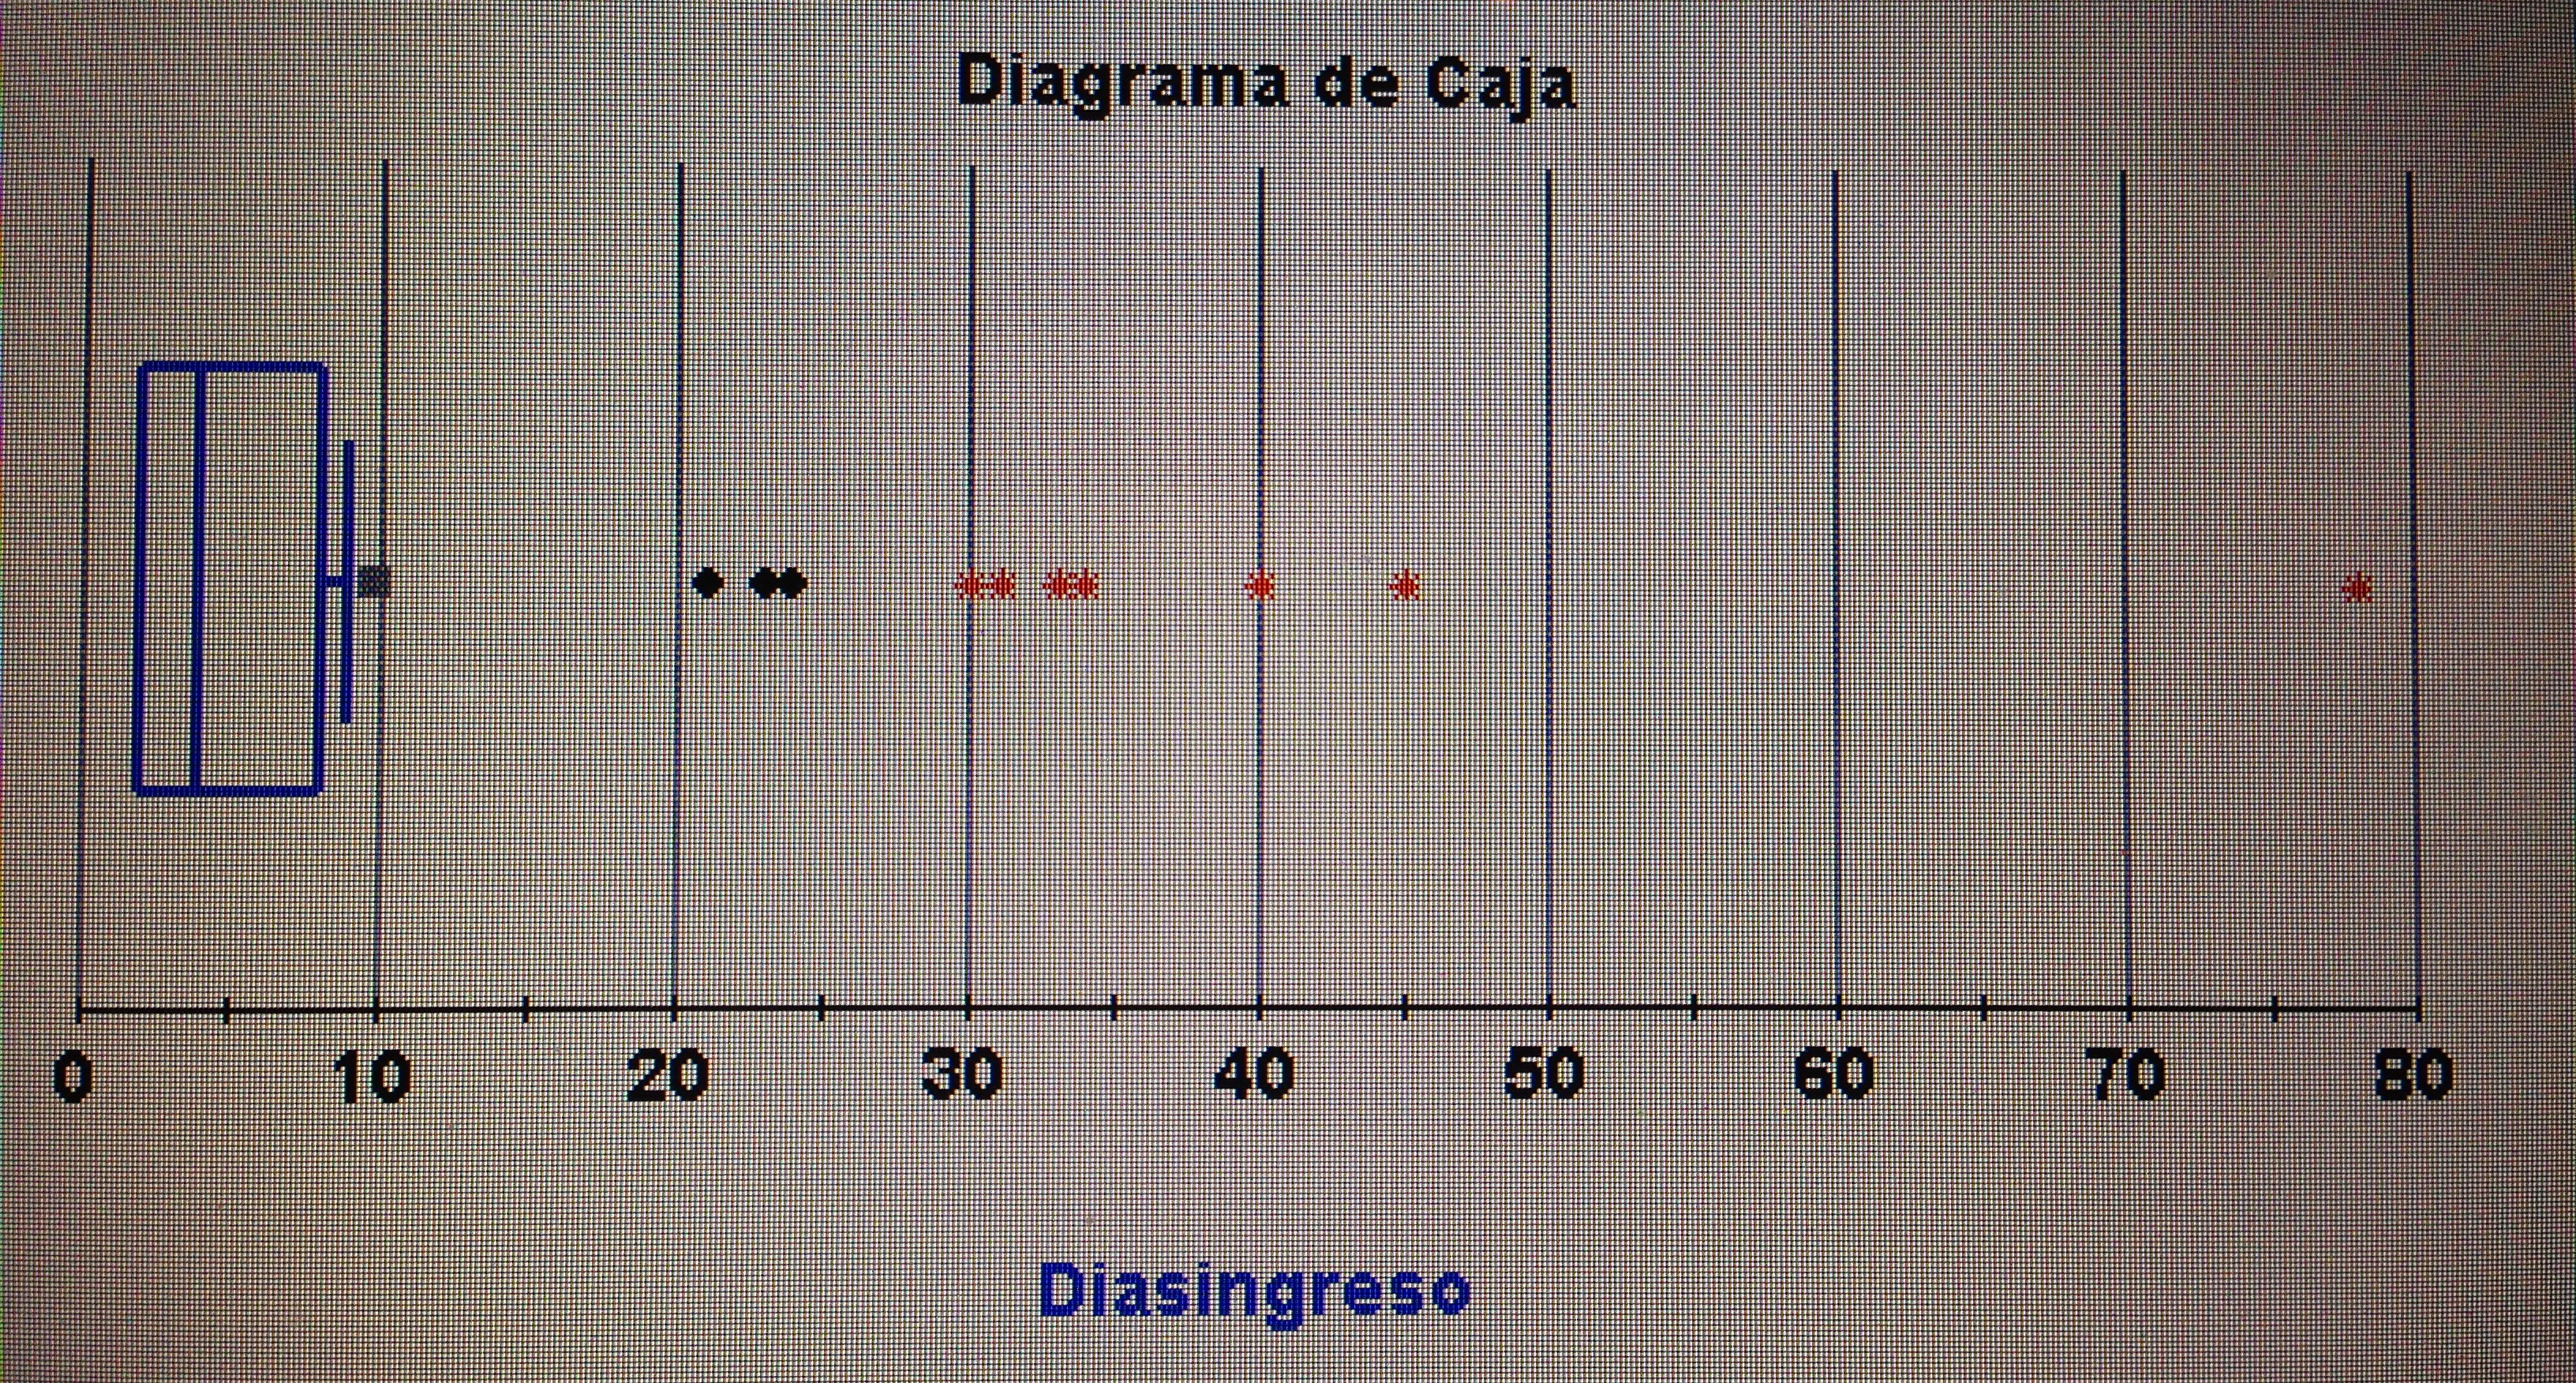
Y el Box-Plot:

IMG_7678

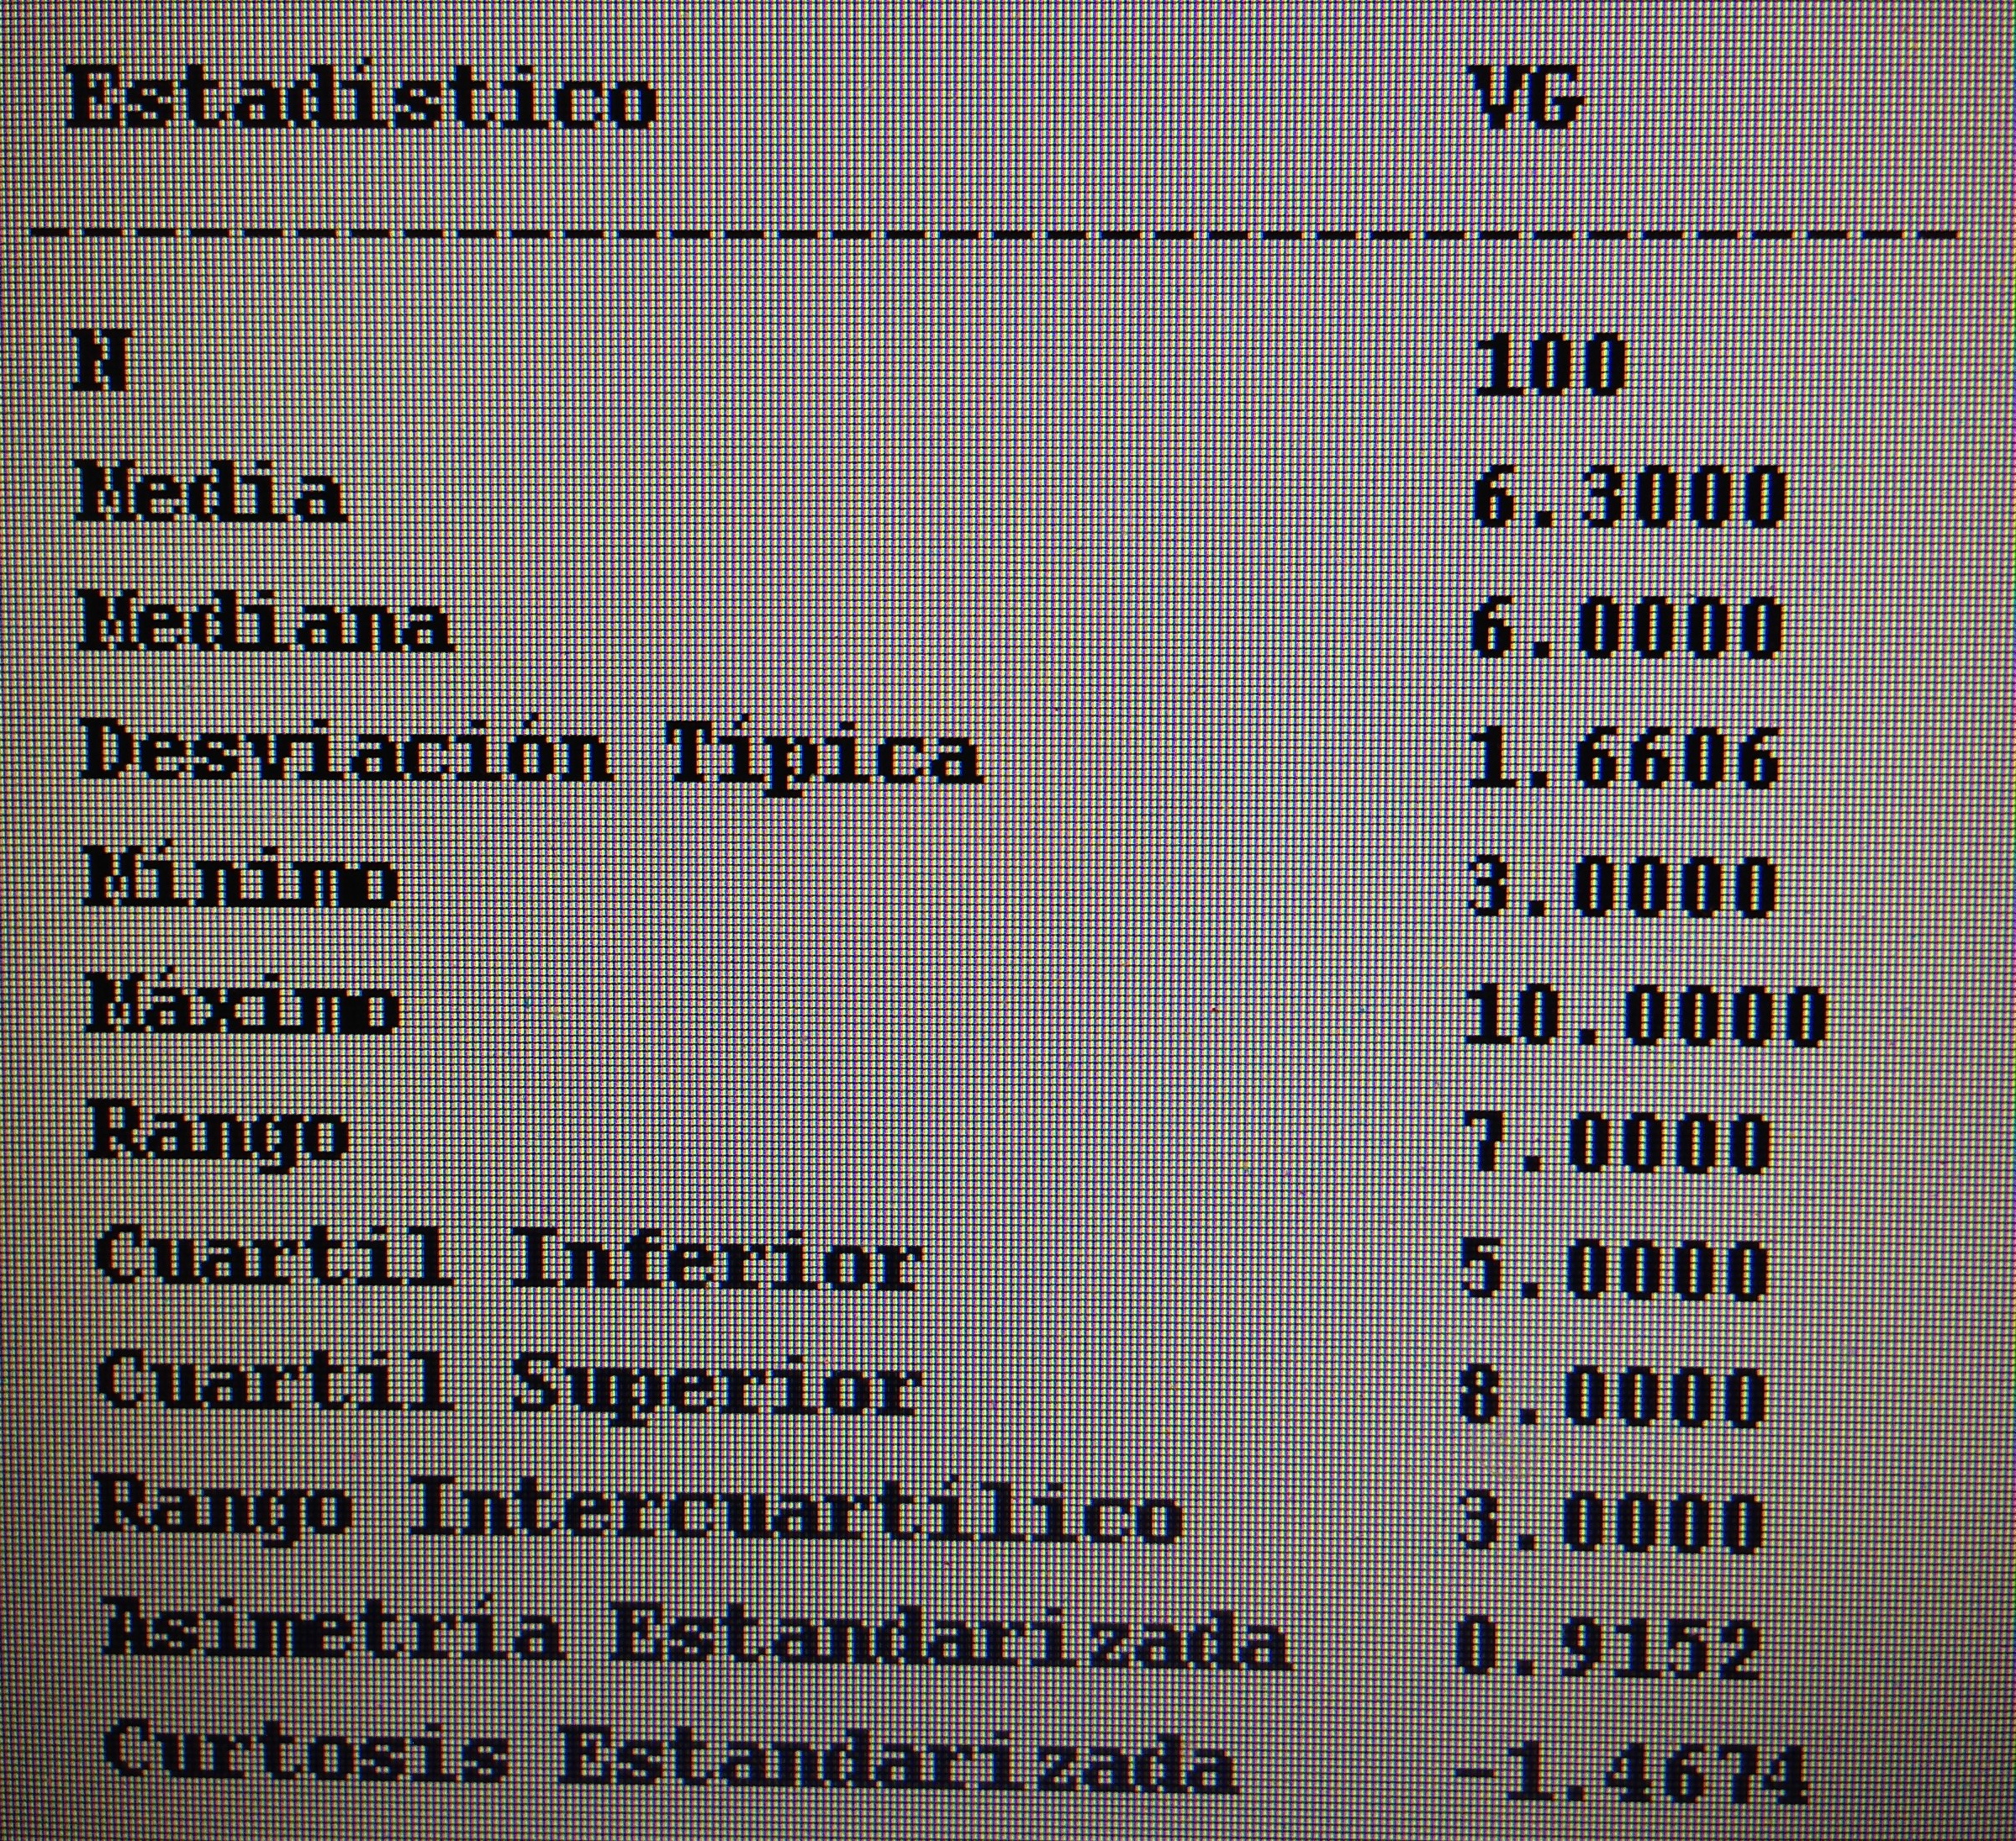
La variable «Valoración general» tiene los siguientes valores de los más importantes estadísticos descriptores:

IMG_7680

Y el Box-Plot:

IMG_7681

2. Hacer una Estadística descriptiva de las variables cualitativas: Sexo, Cirugía, Departamento y P8:

Para la variable cualitativa «Sexo» la tabla de frecuencias es:

IMG_7682

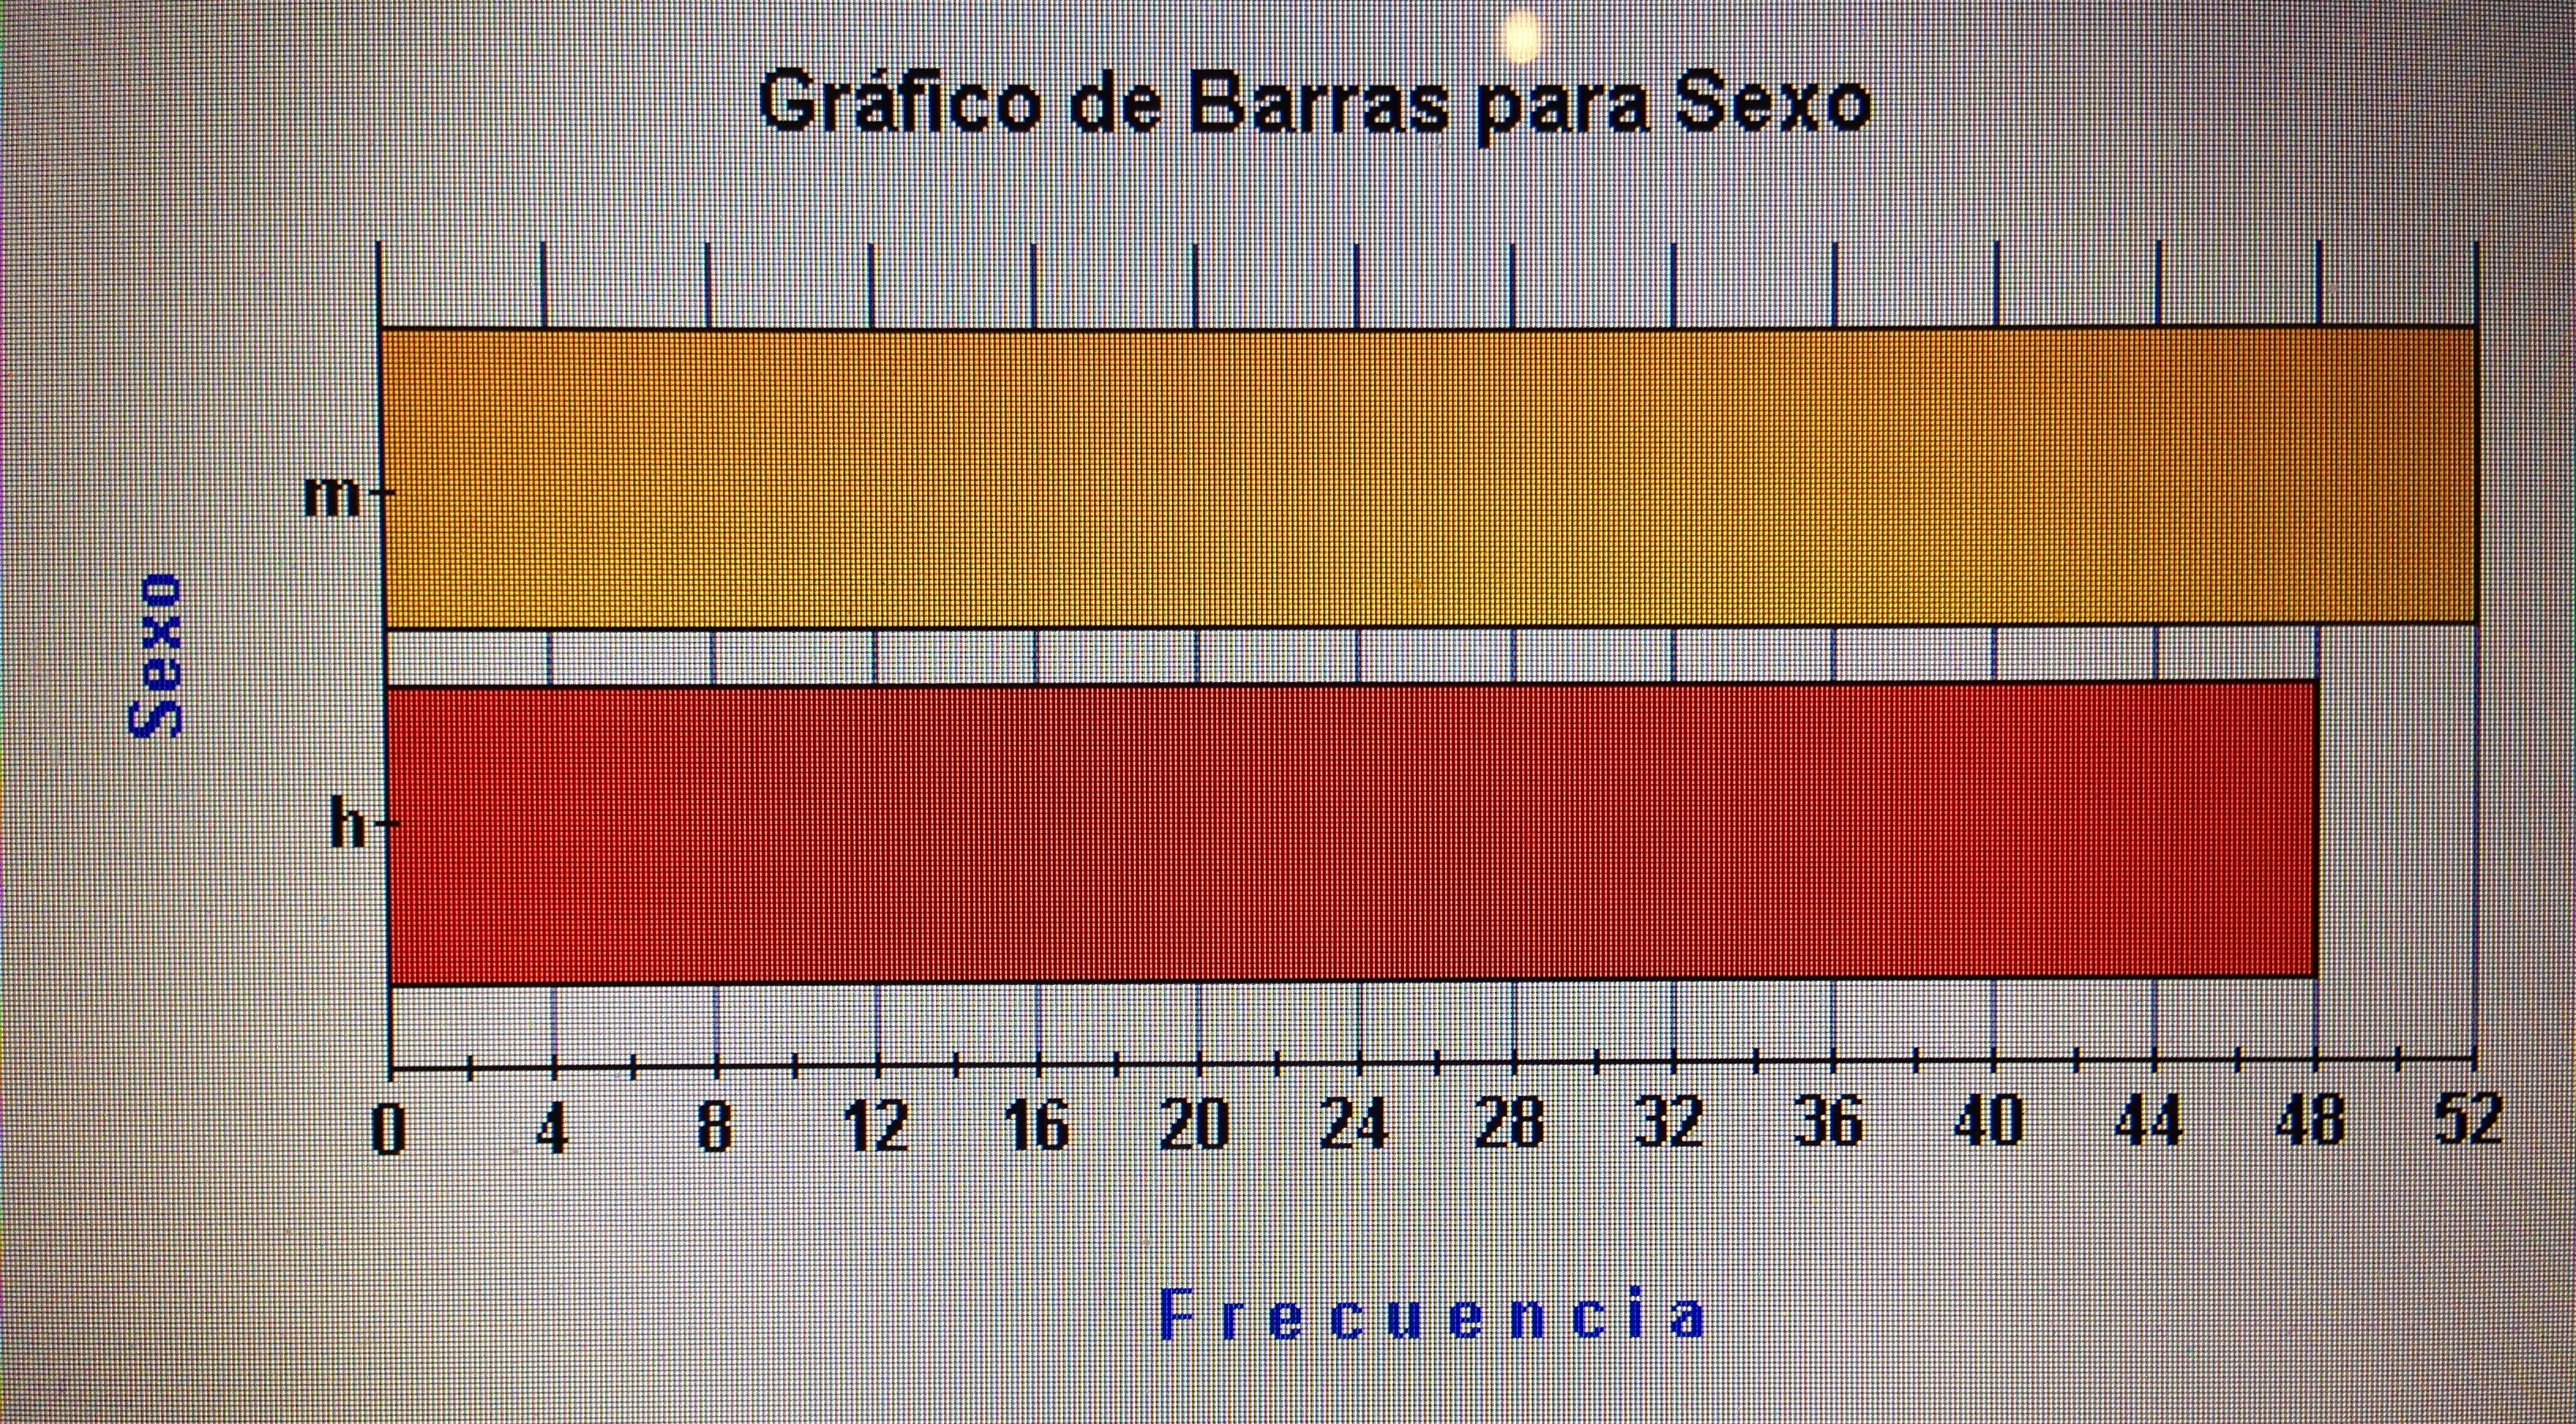
Y el diagrama de frecuencias:

IMG_7683

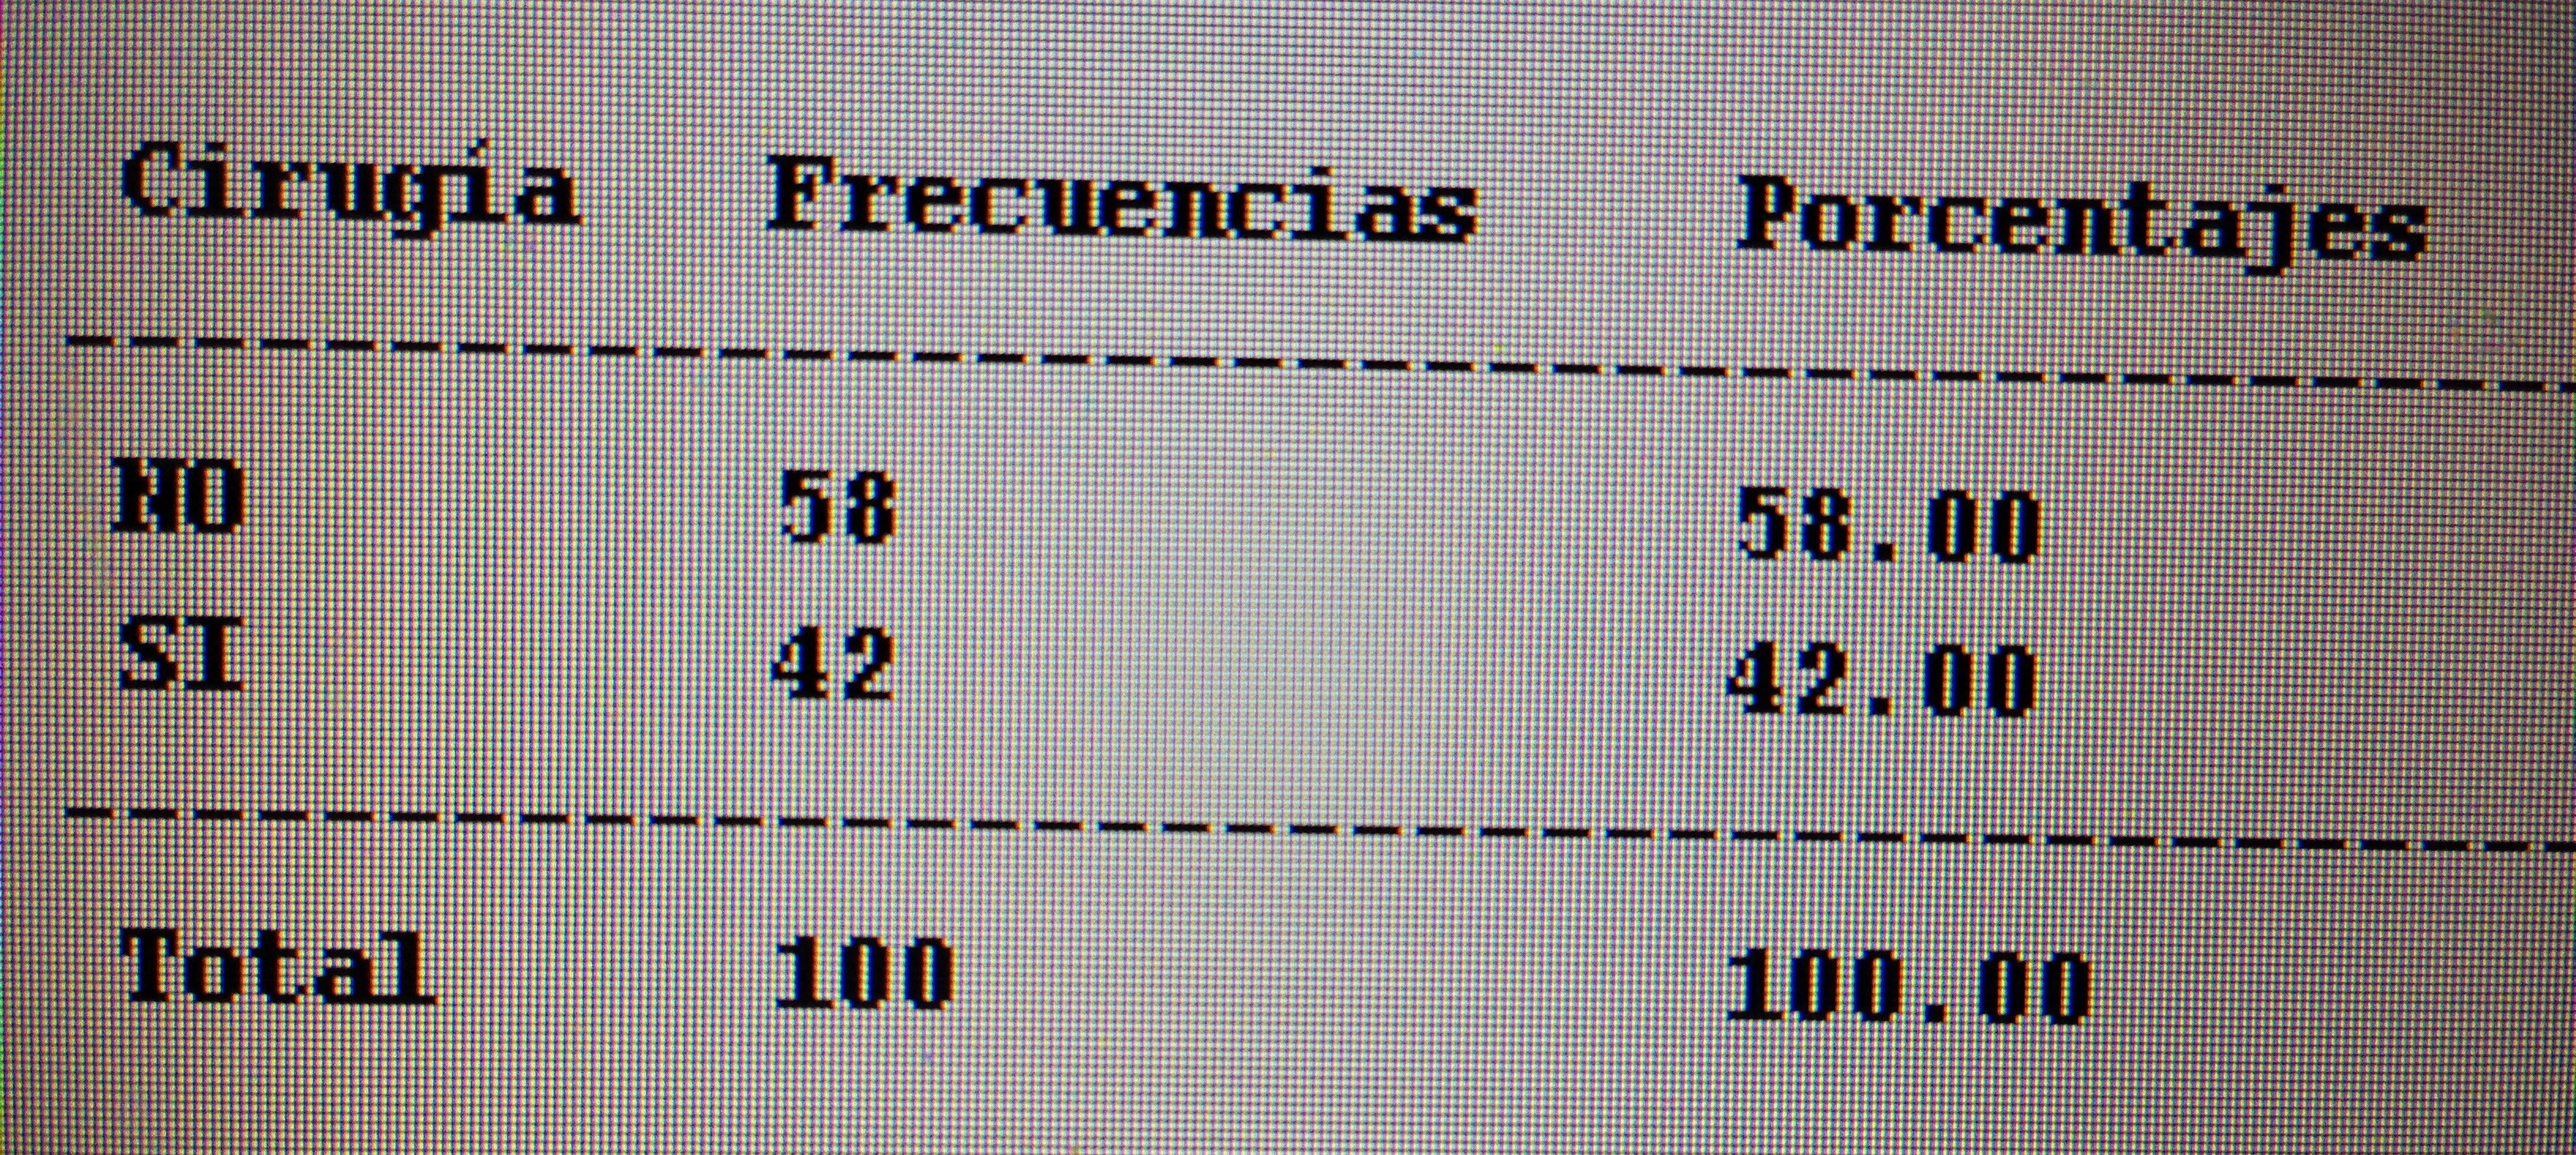
Para la variable cualitativa «Cirugía» la tabla de frecuencias es:

IMG_7684

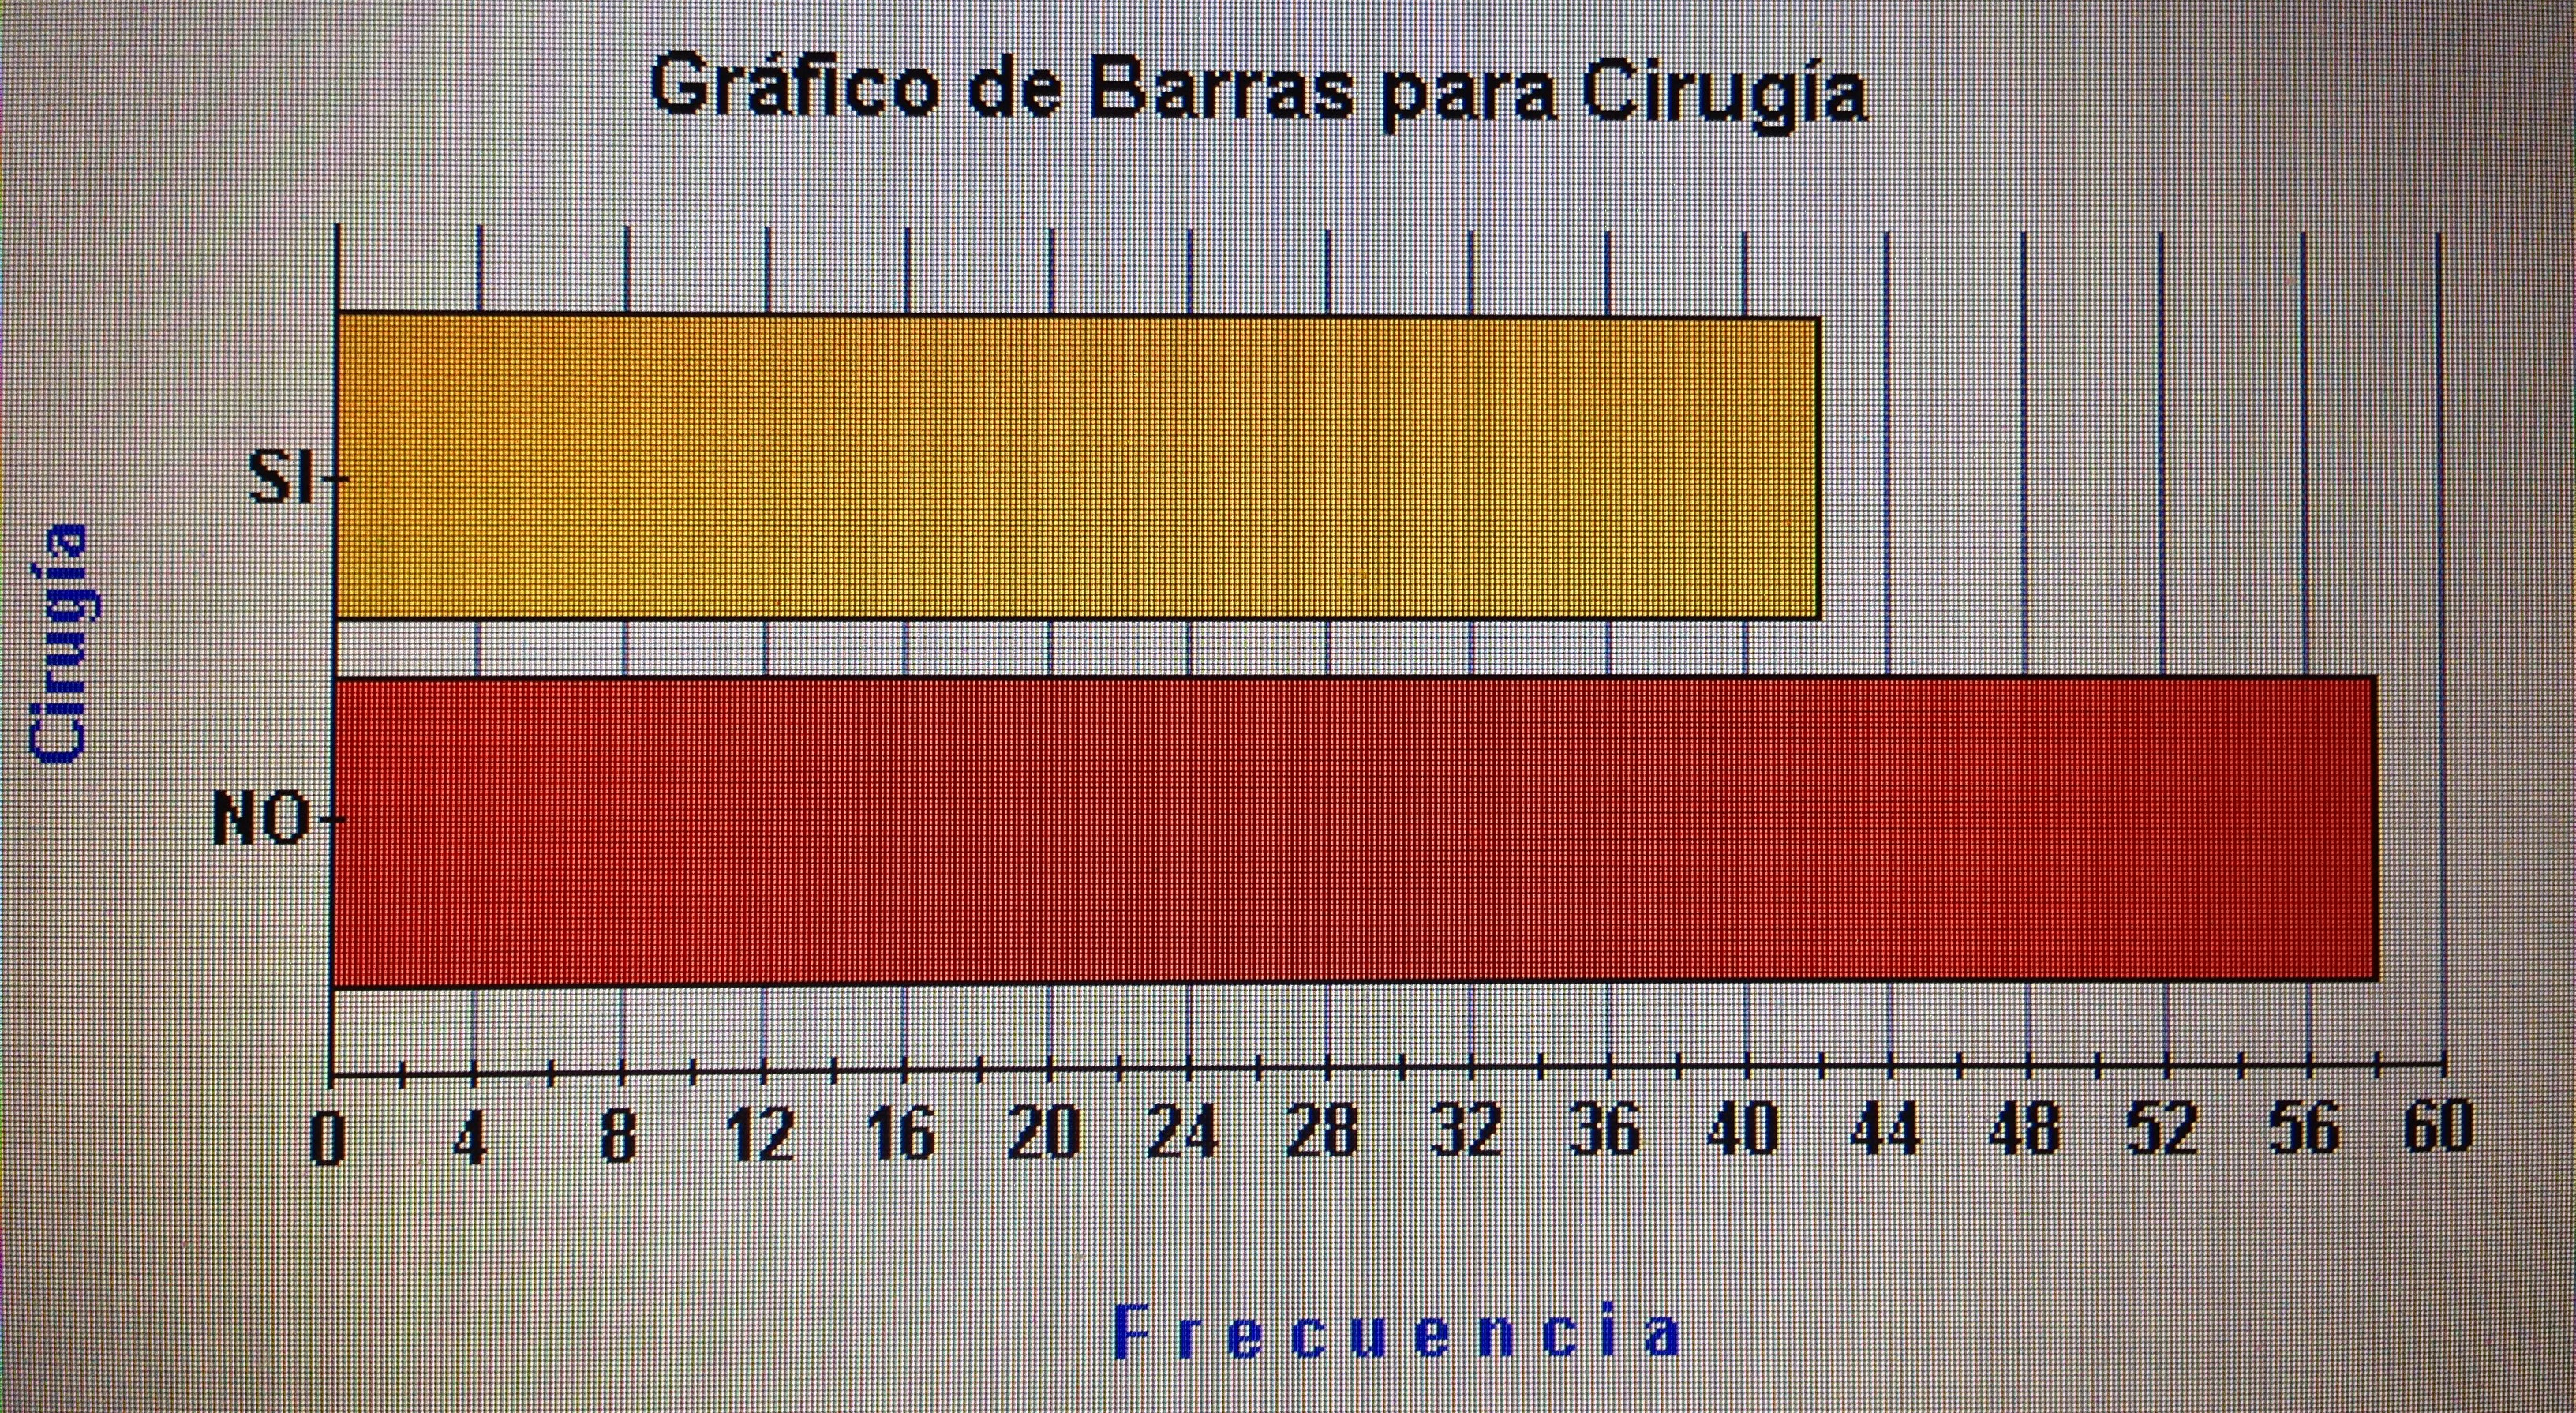
Y el diagrama de frecuencias:

IMG_7685

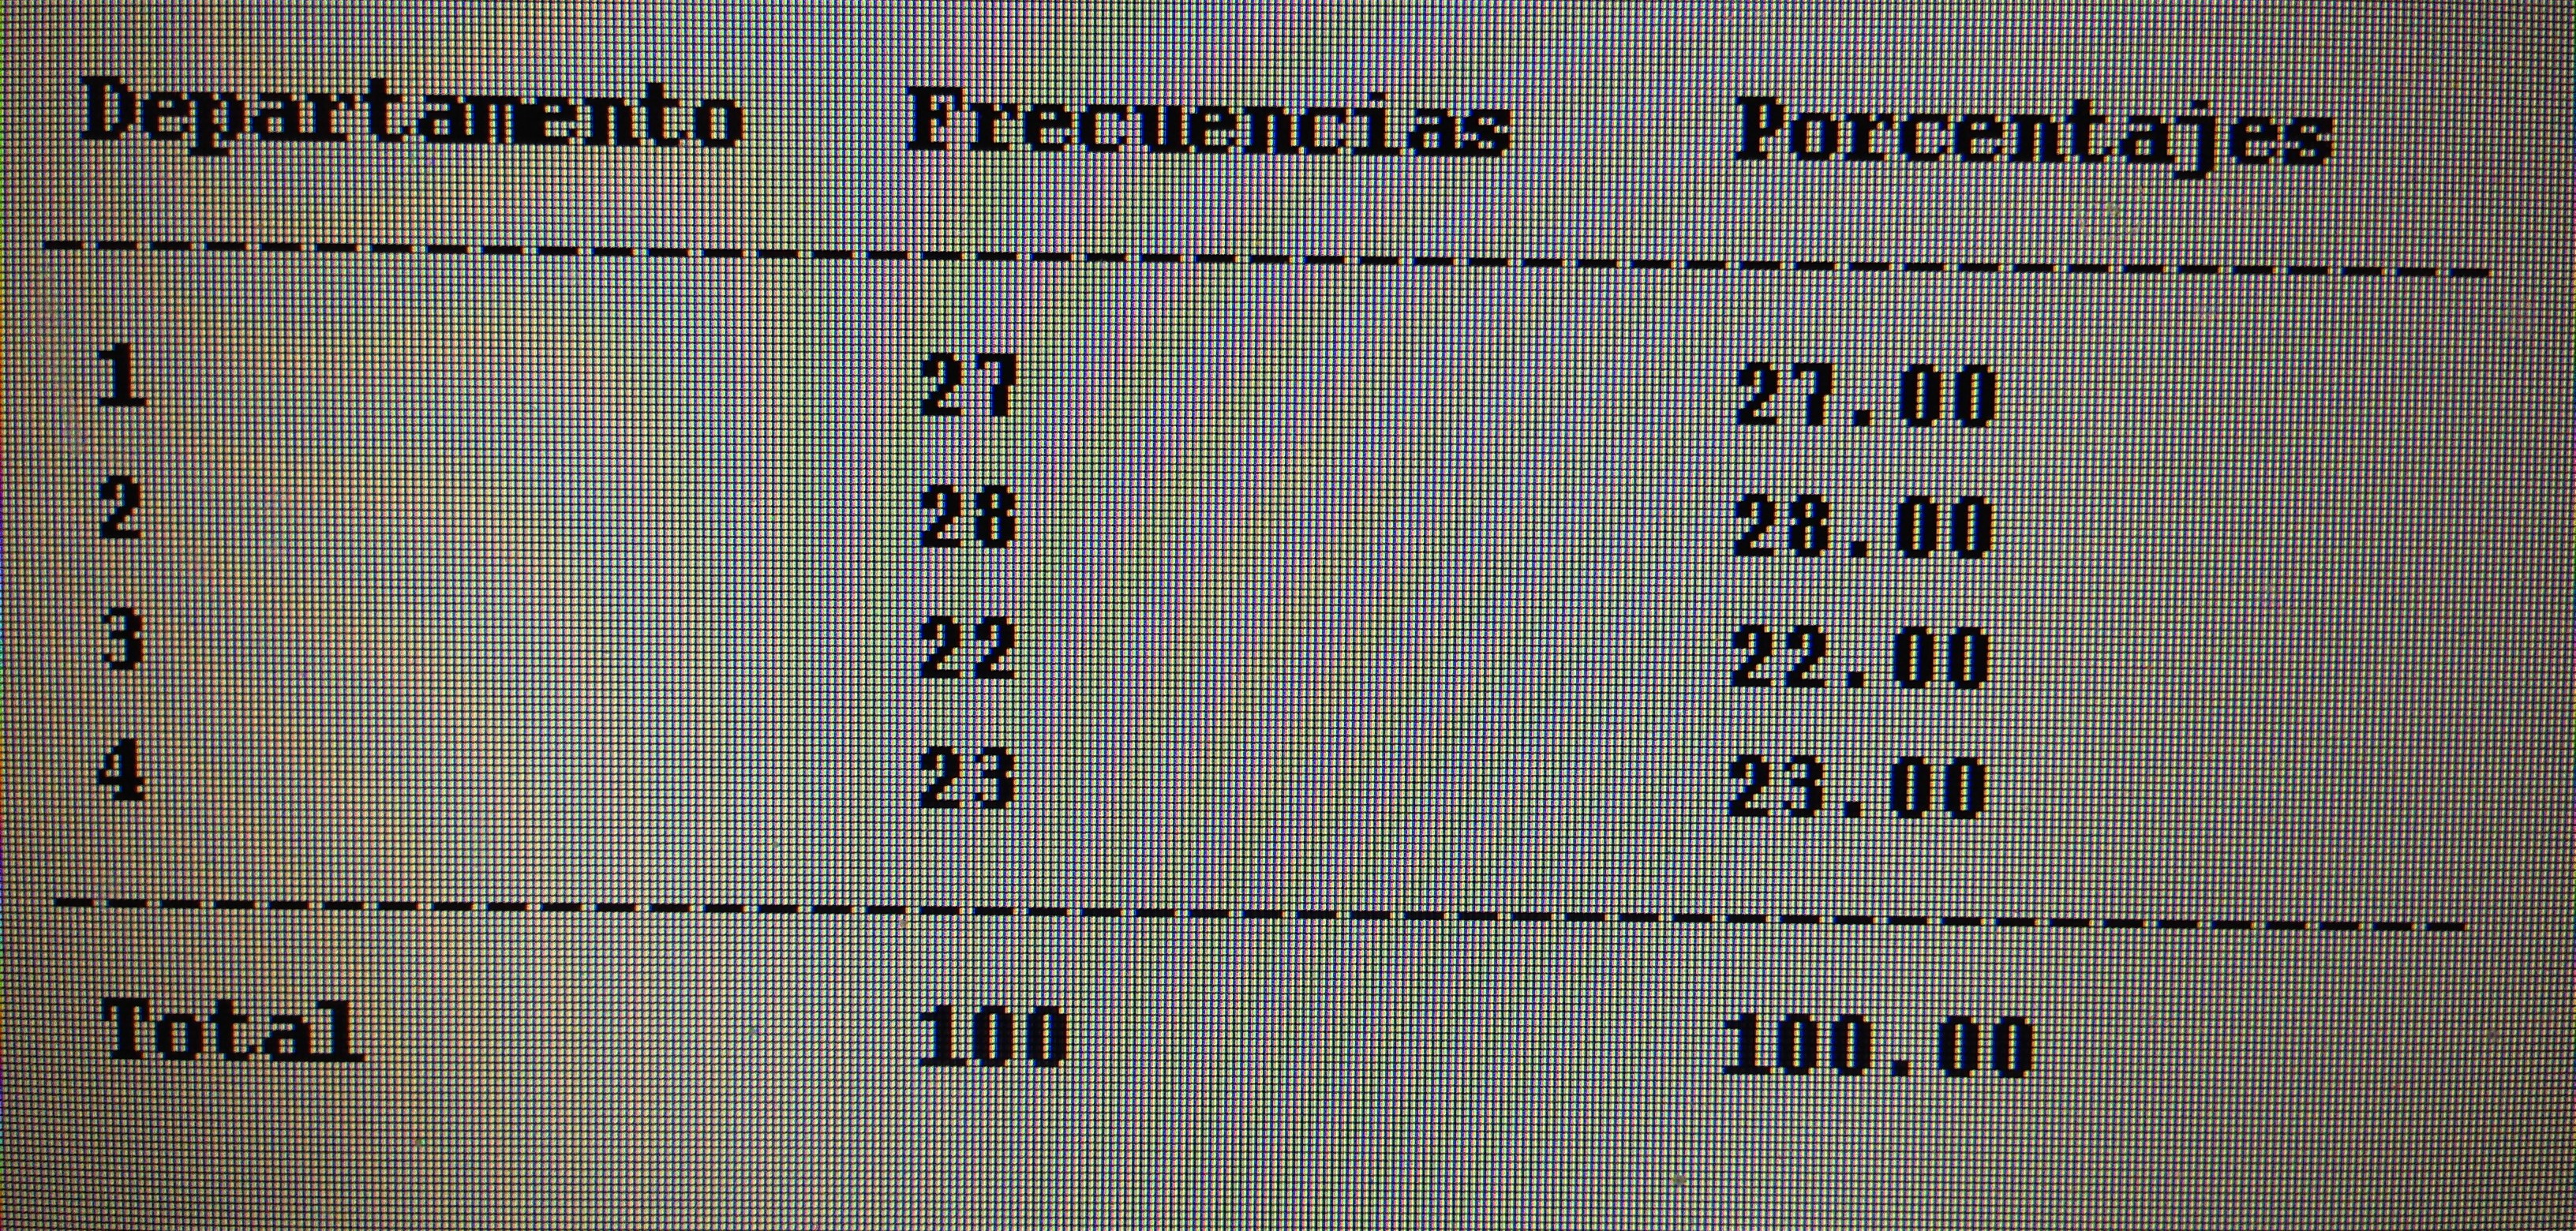
Para la variable «Departamento»:

IMG_7686

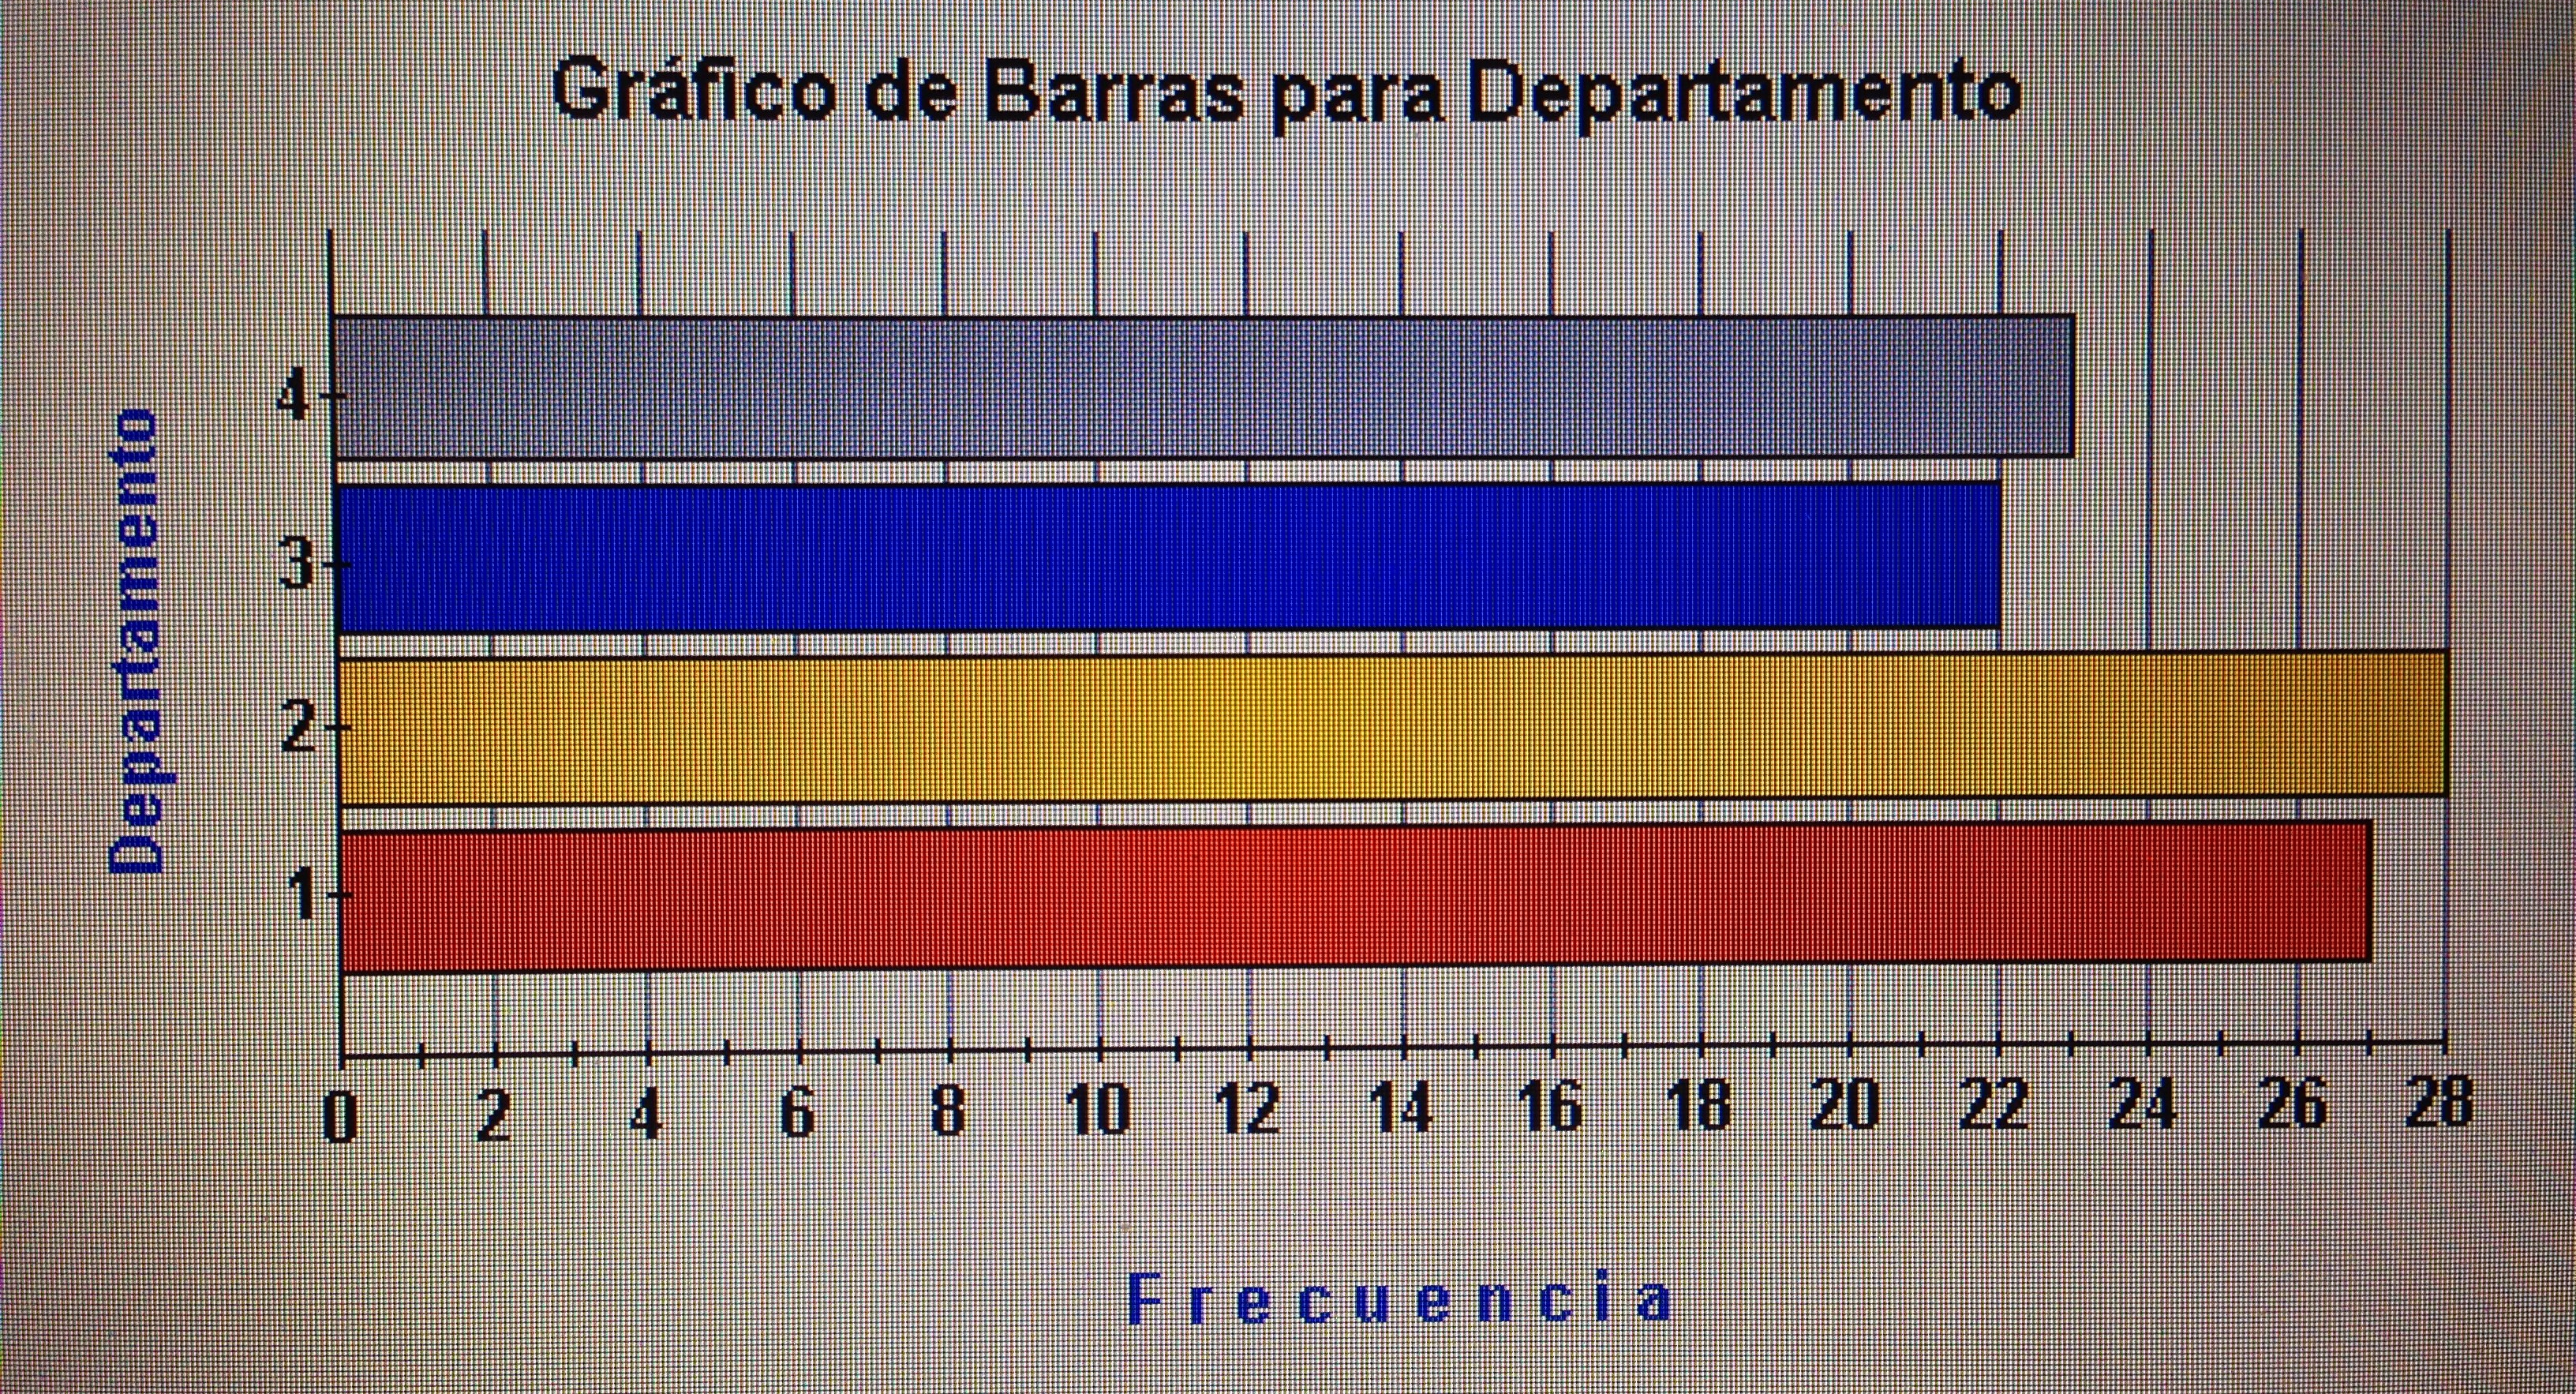
Y el diagrama de frecuencias:

IMG_7687

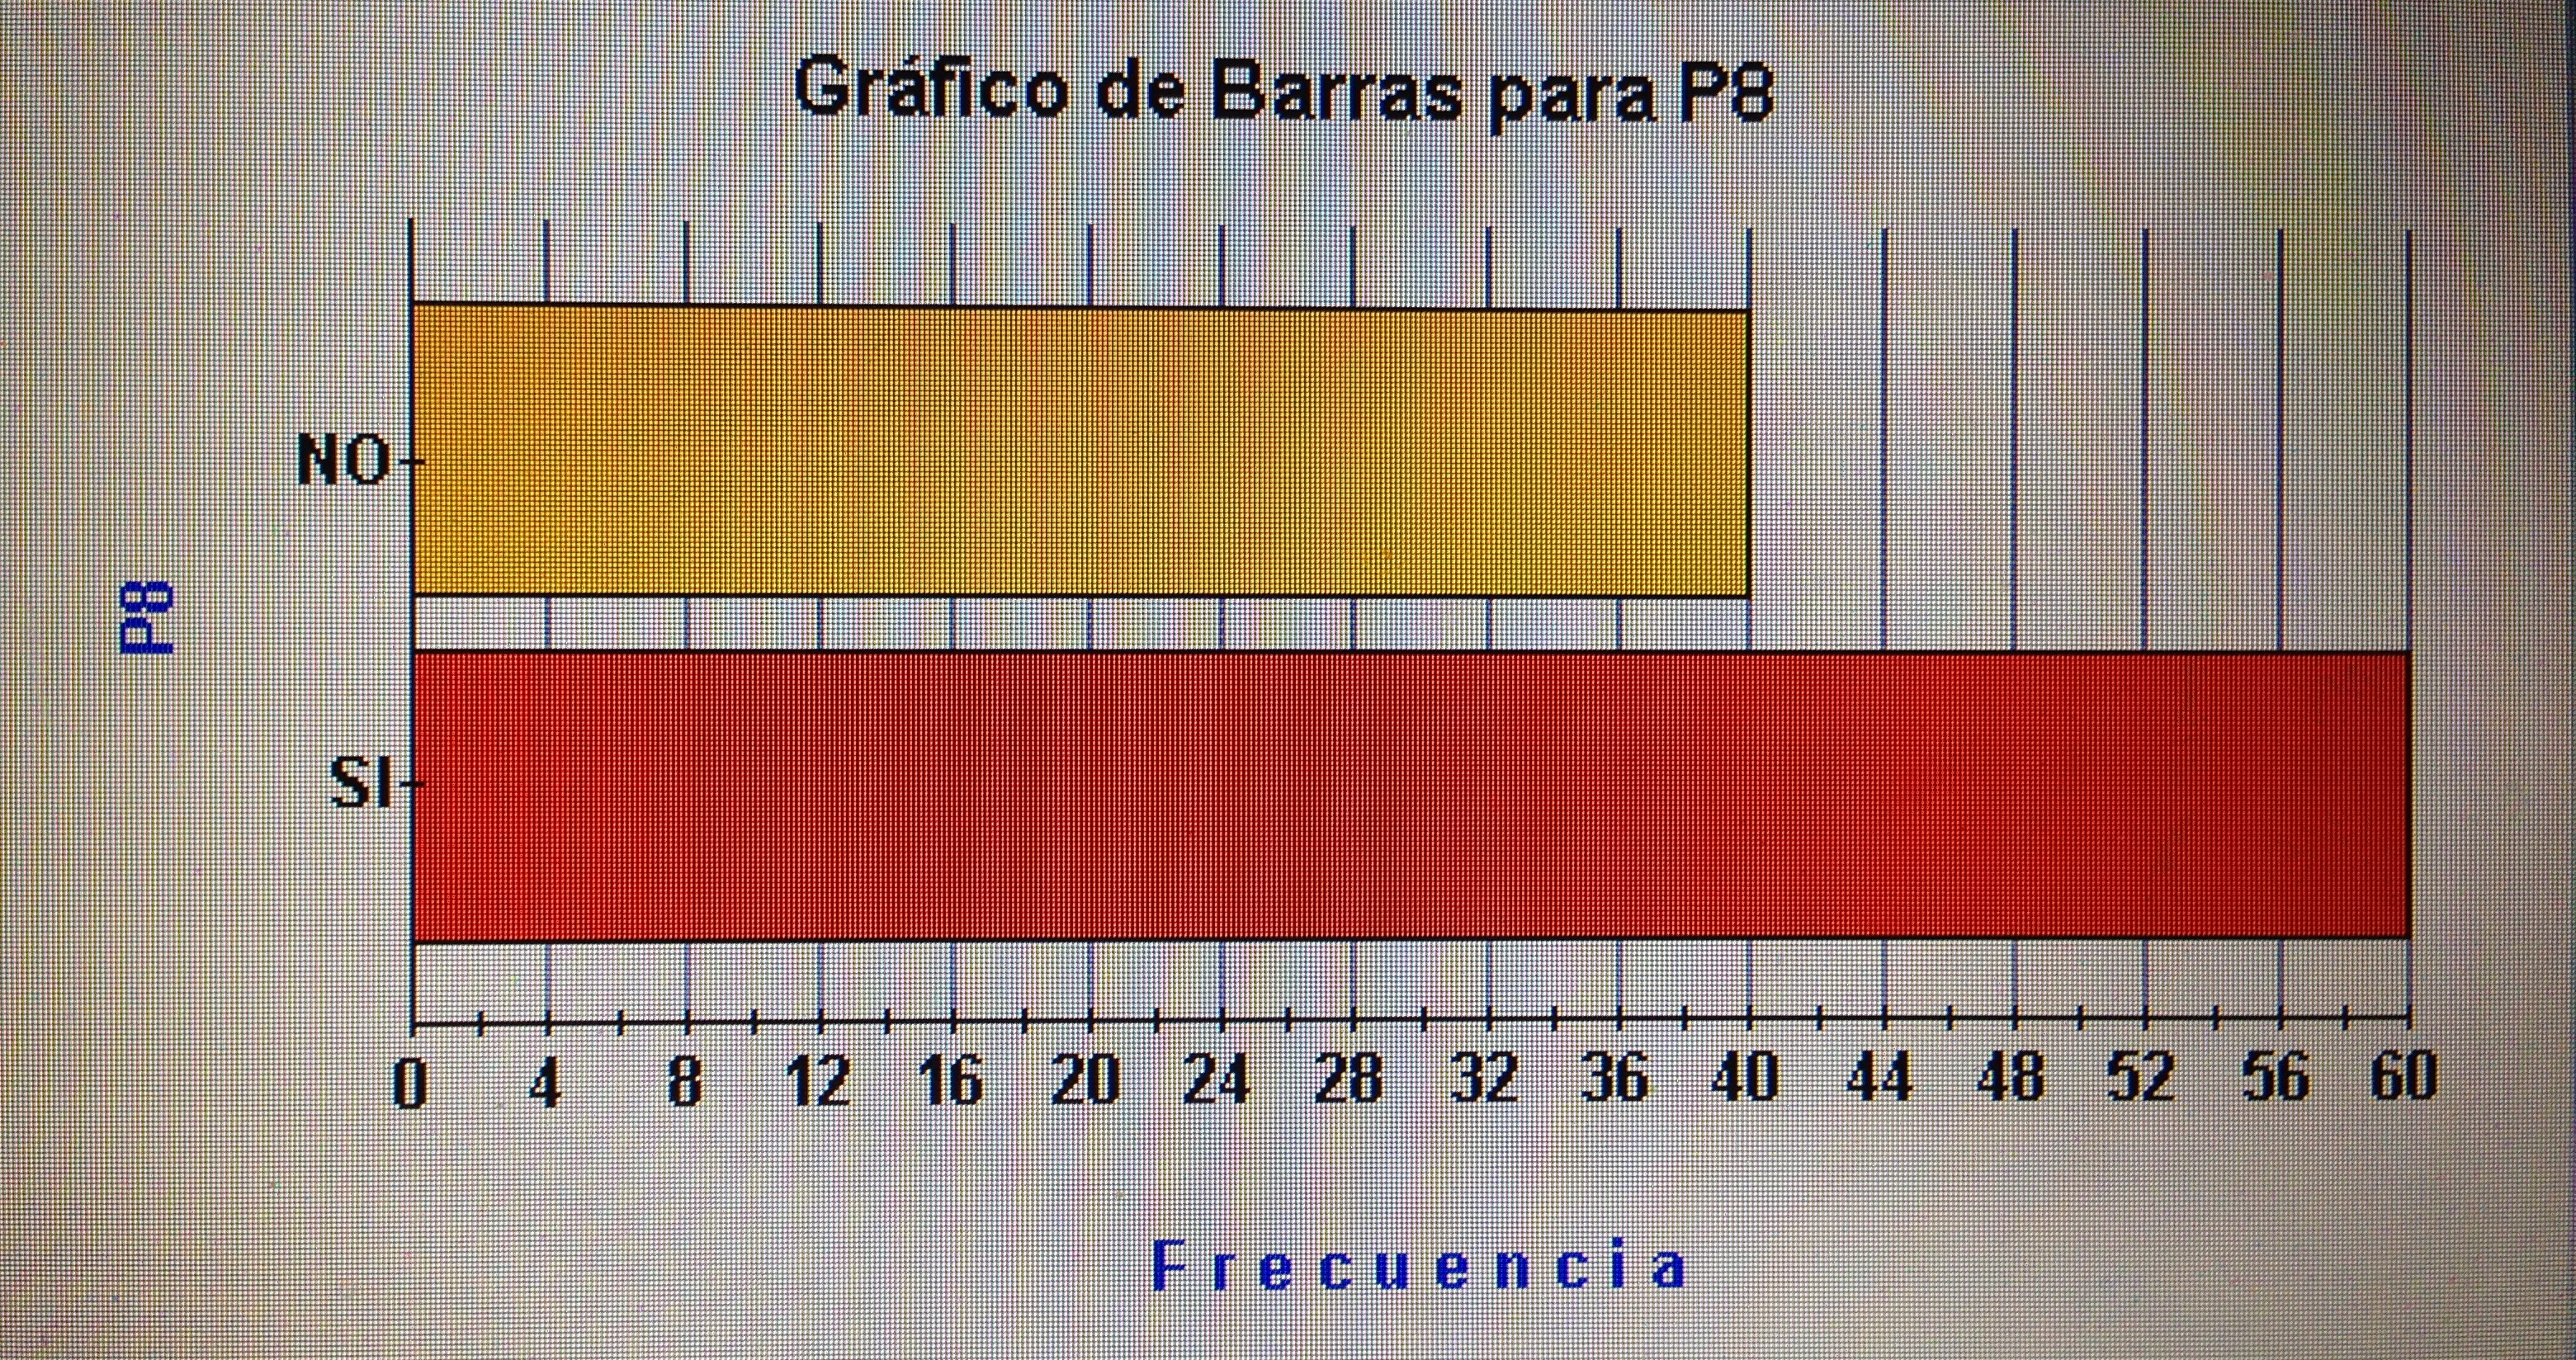
Para la variable P8:

IMG_7688

Y el diagrama de frecuencias:

IMG_7689

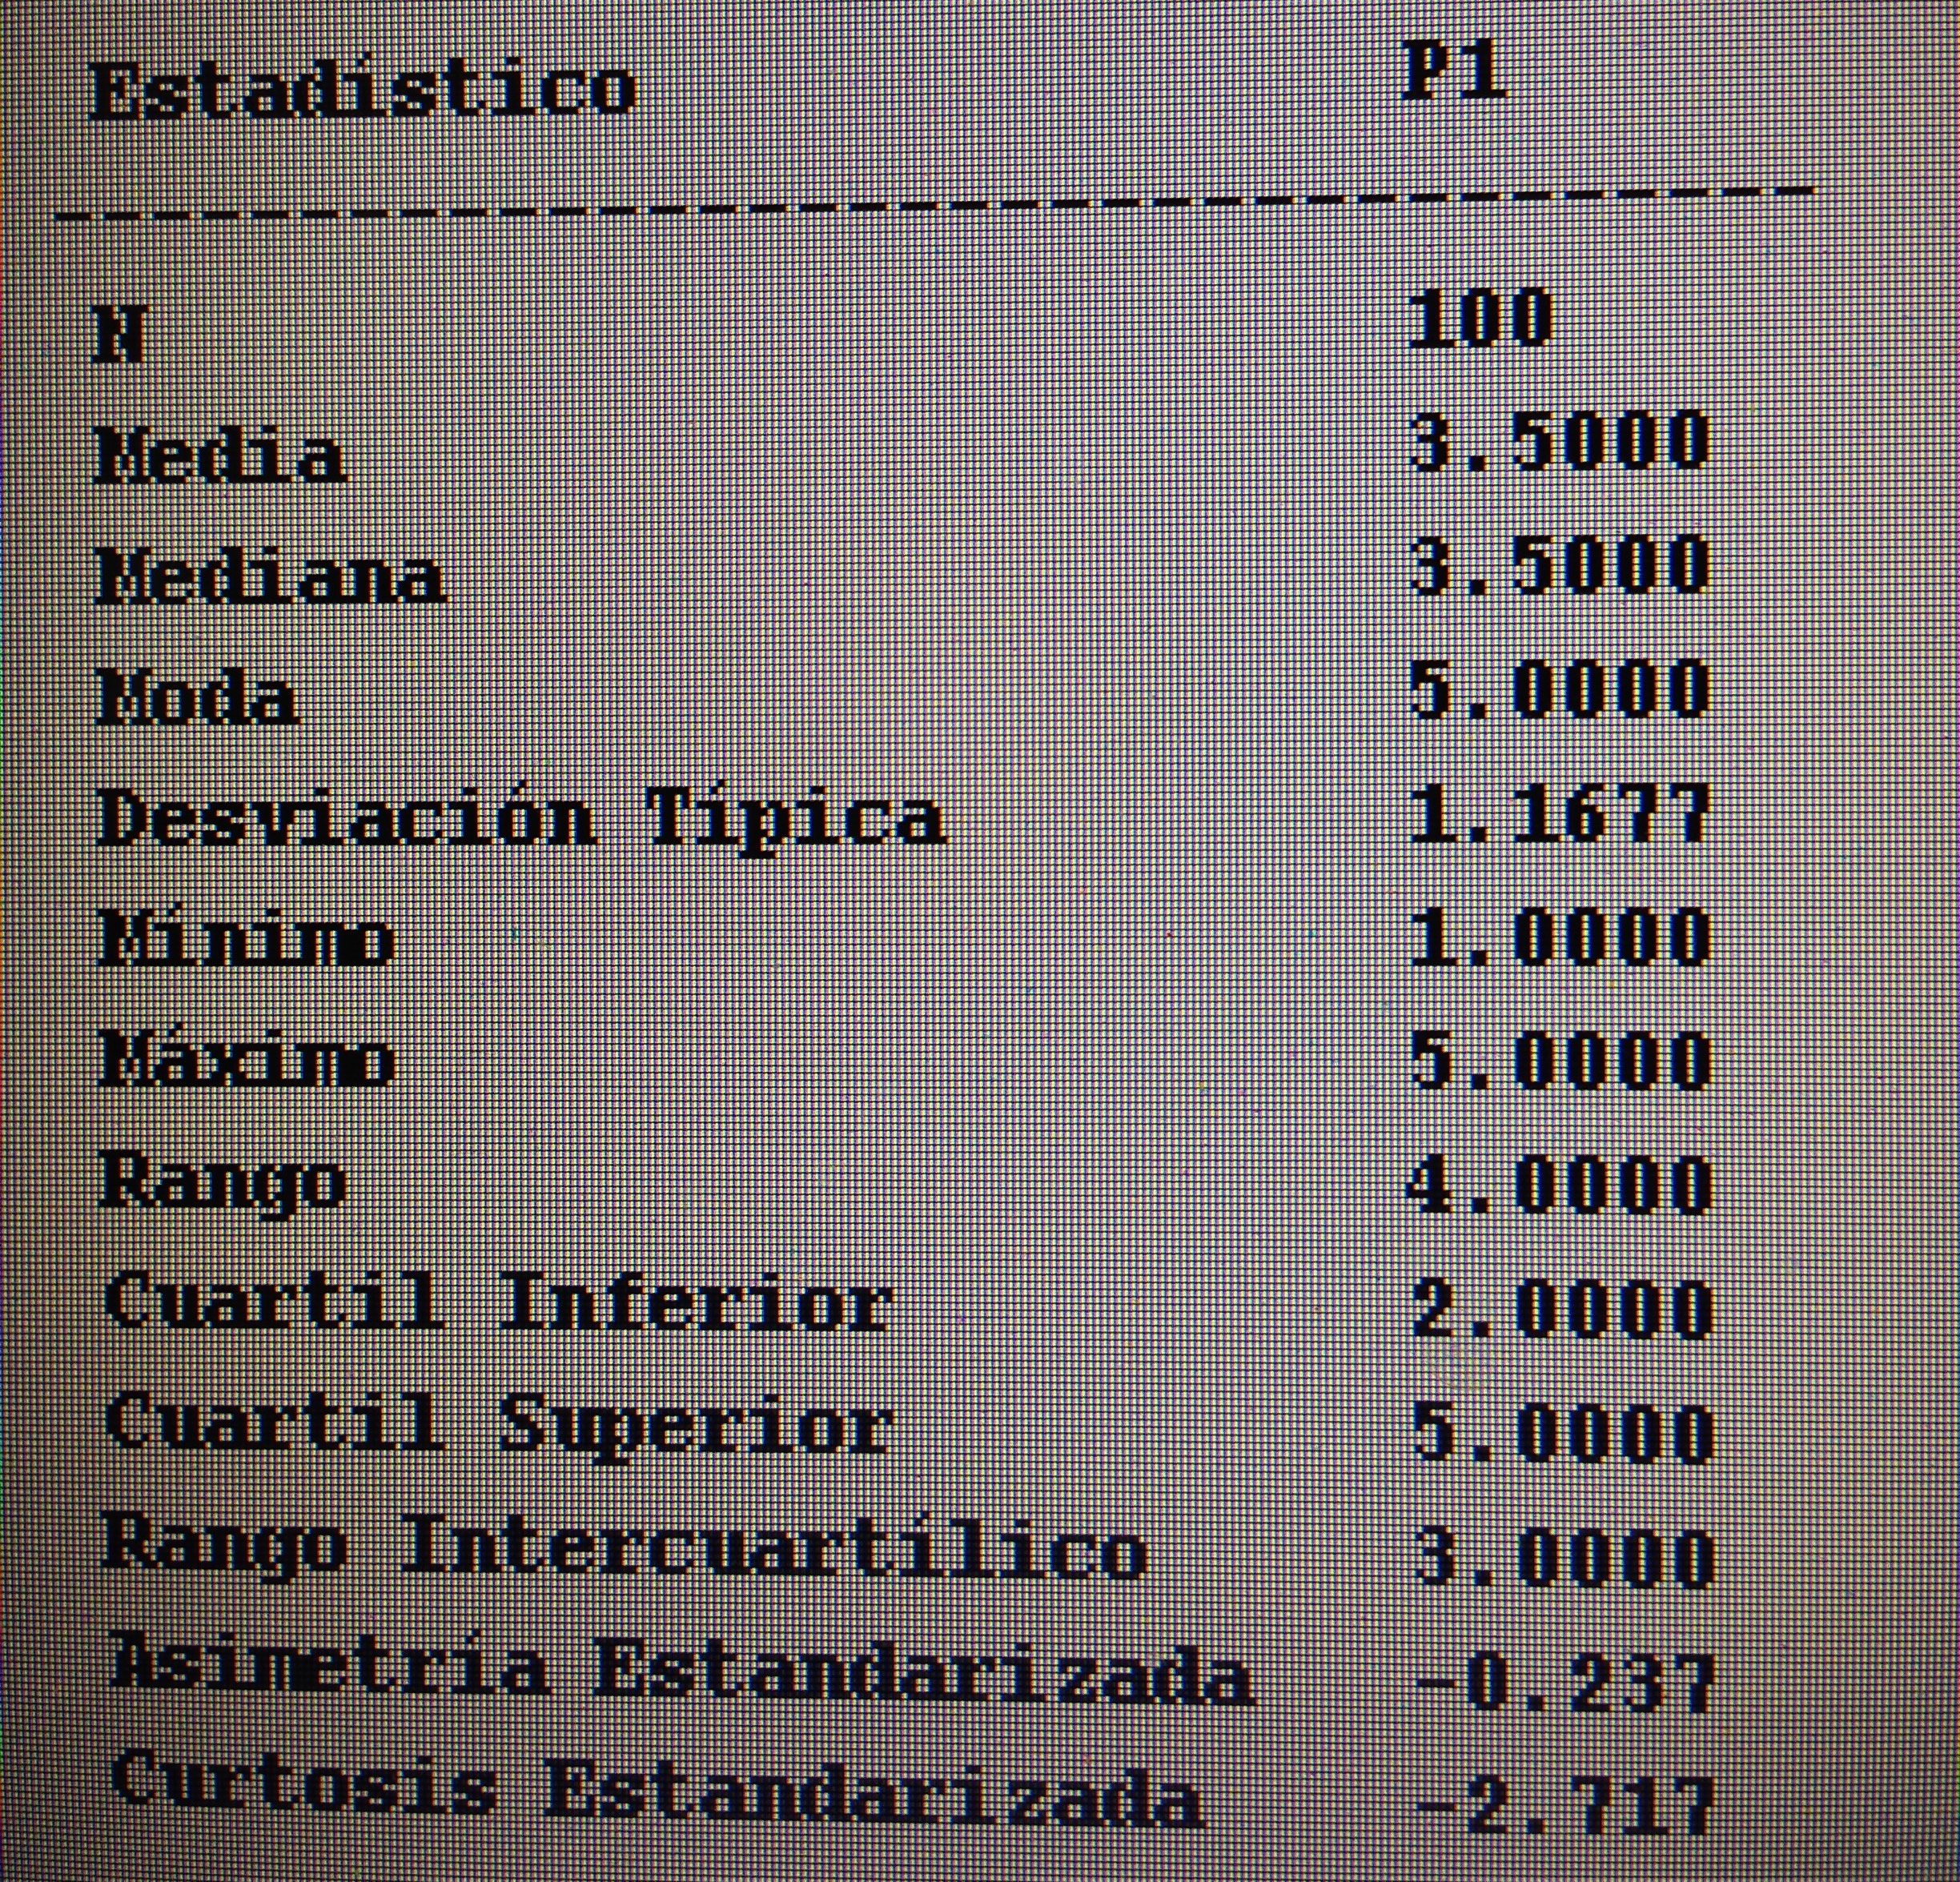
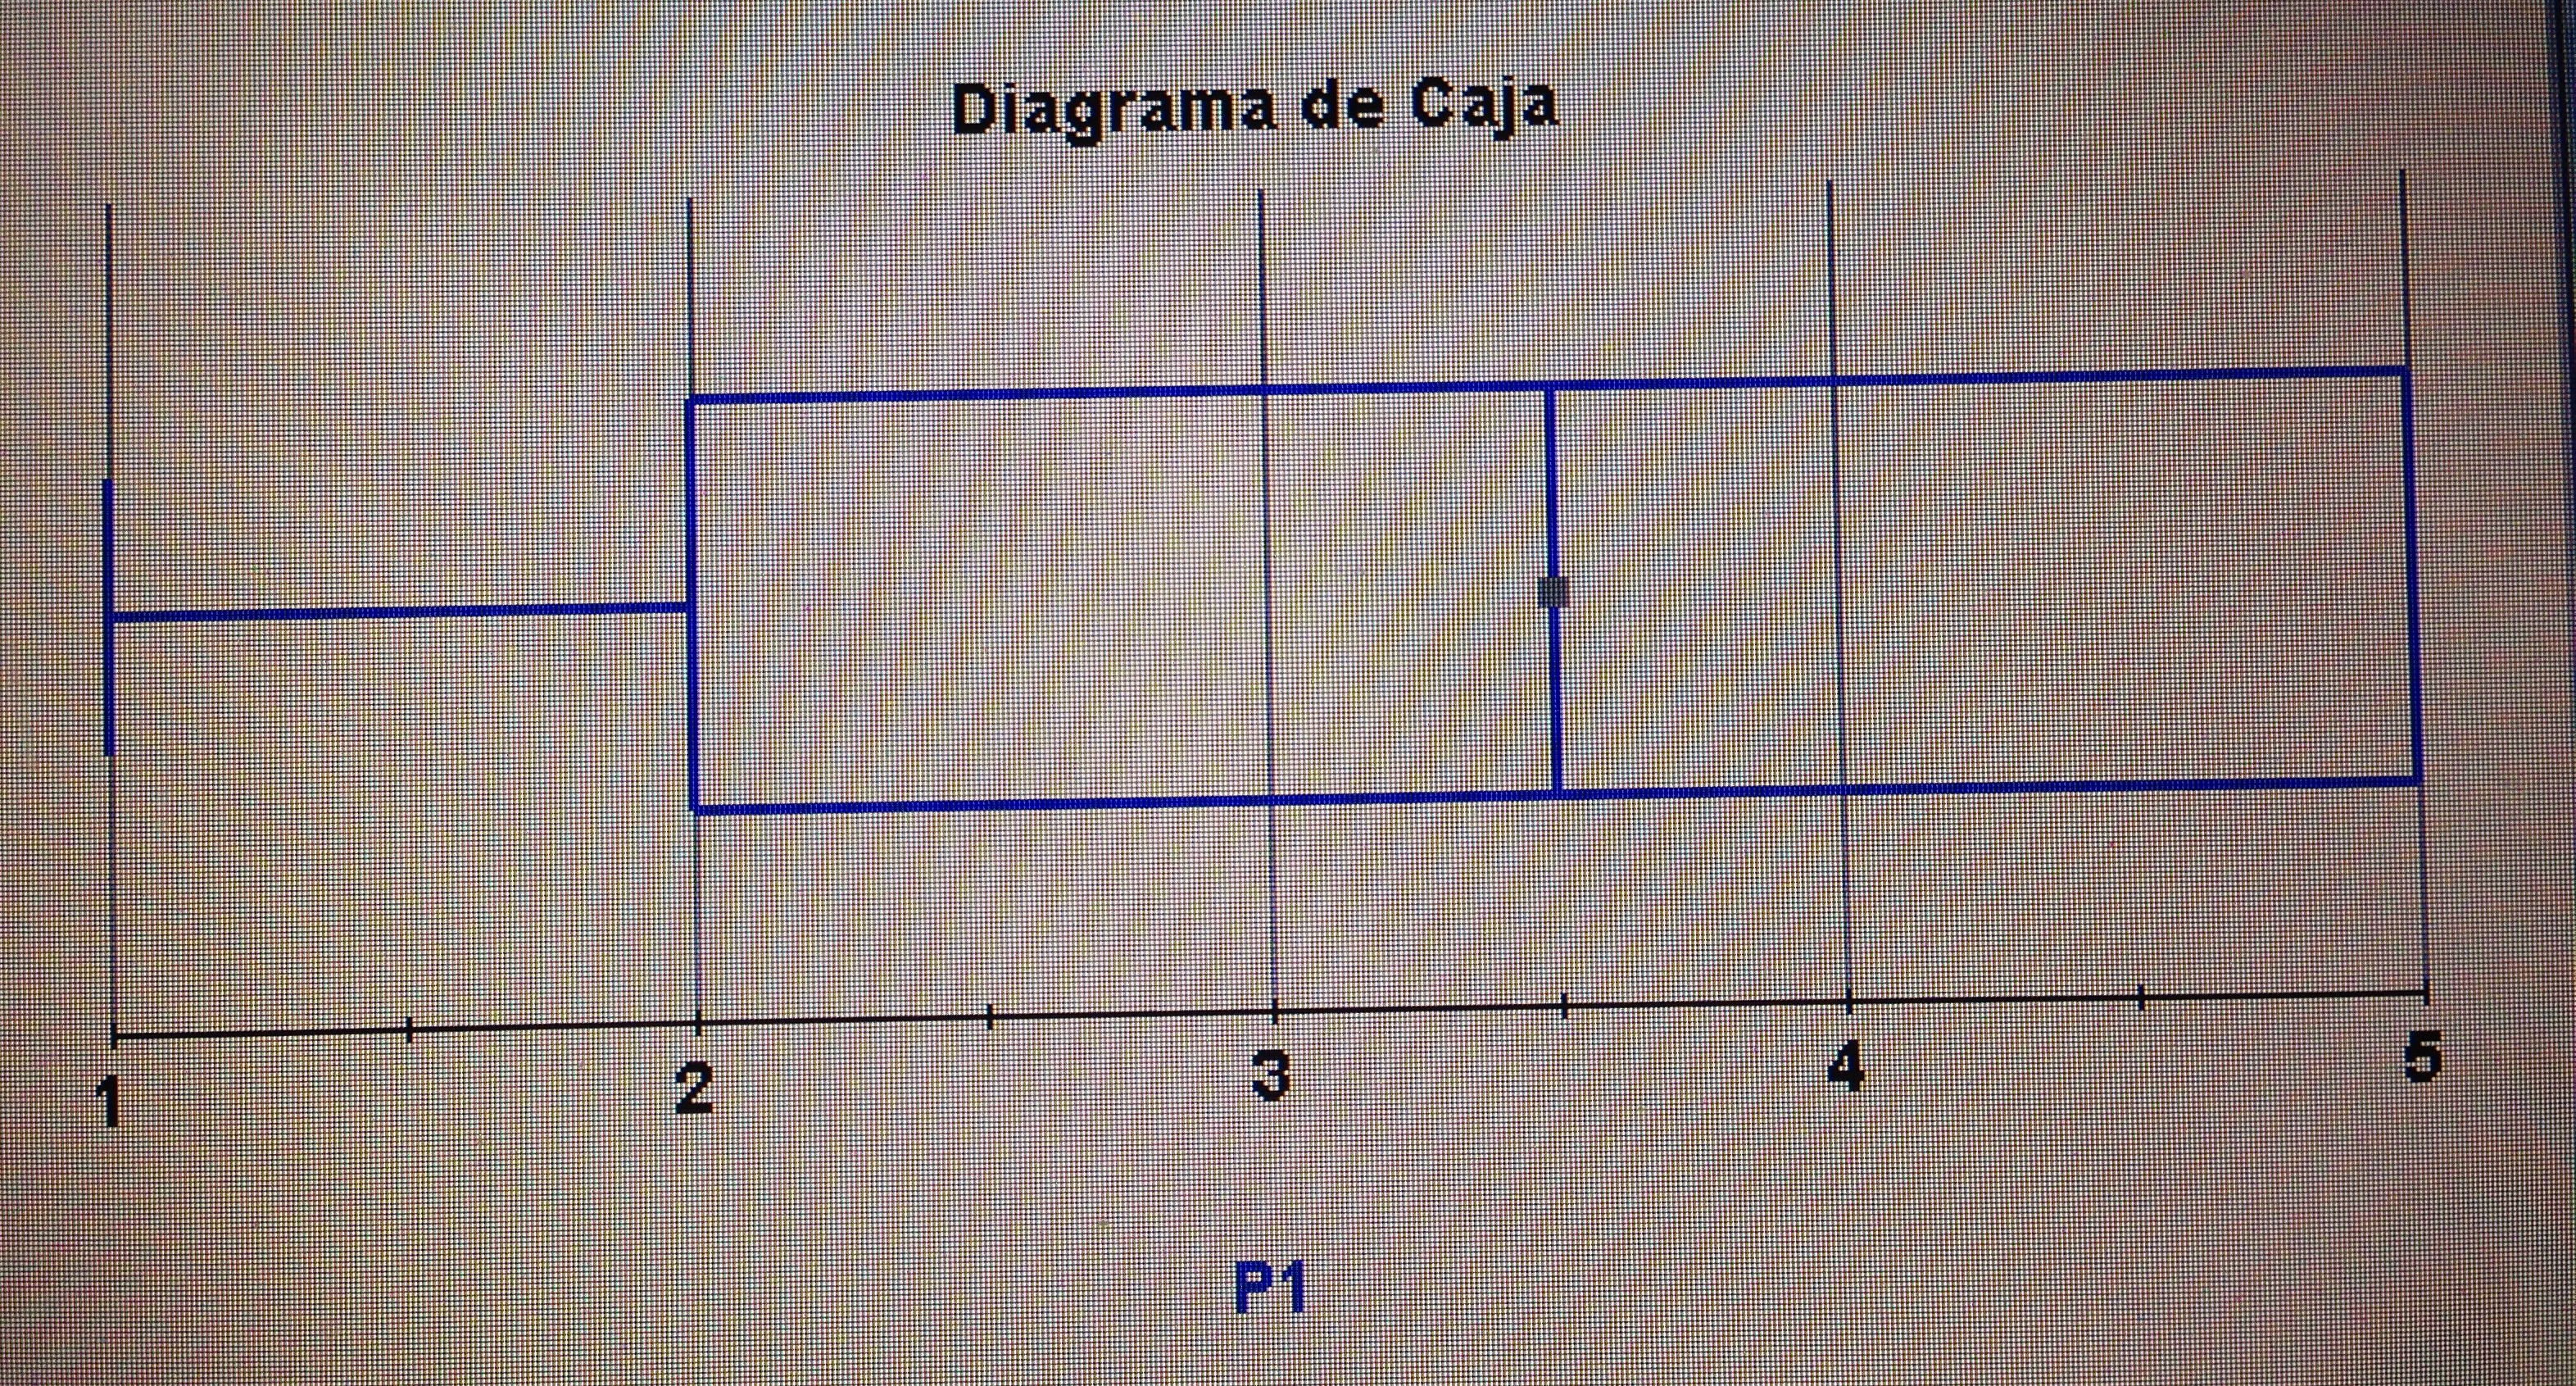
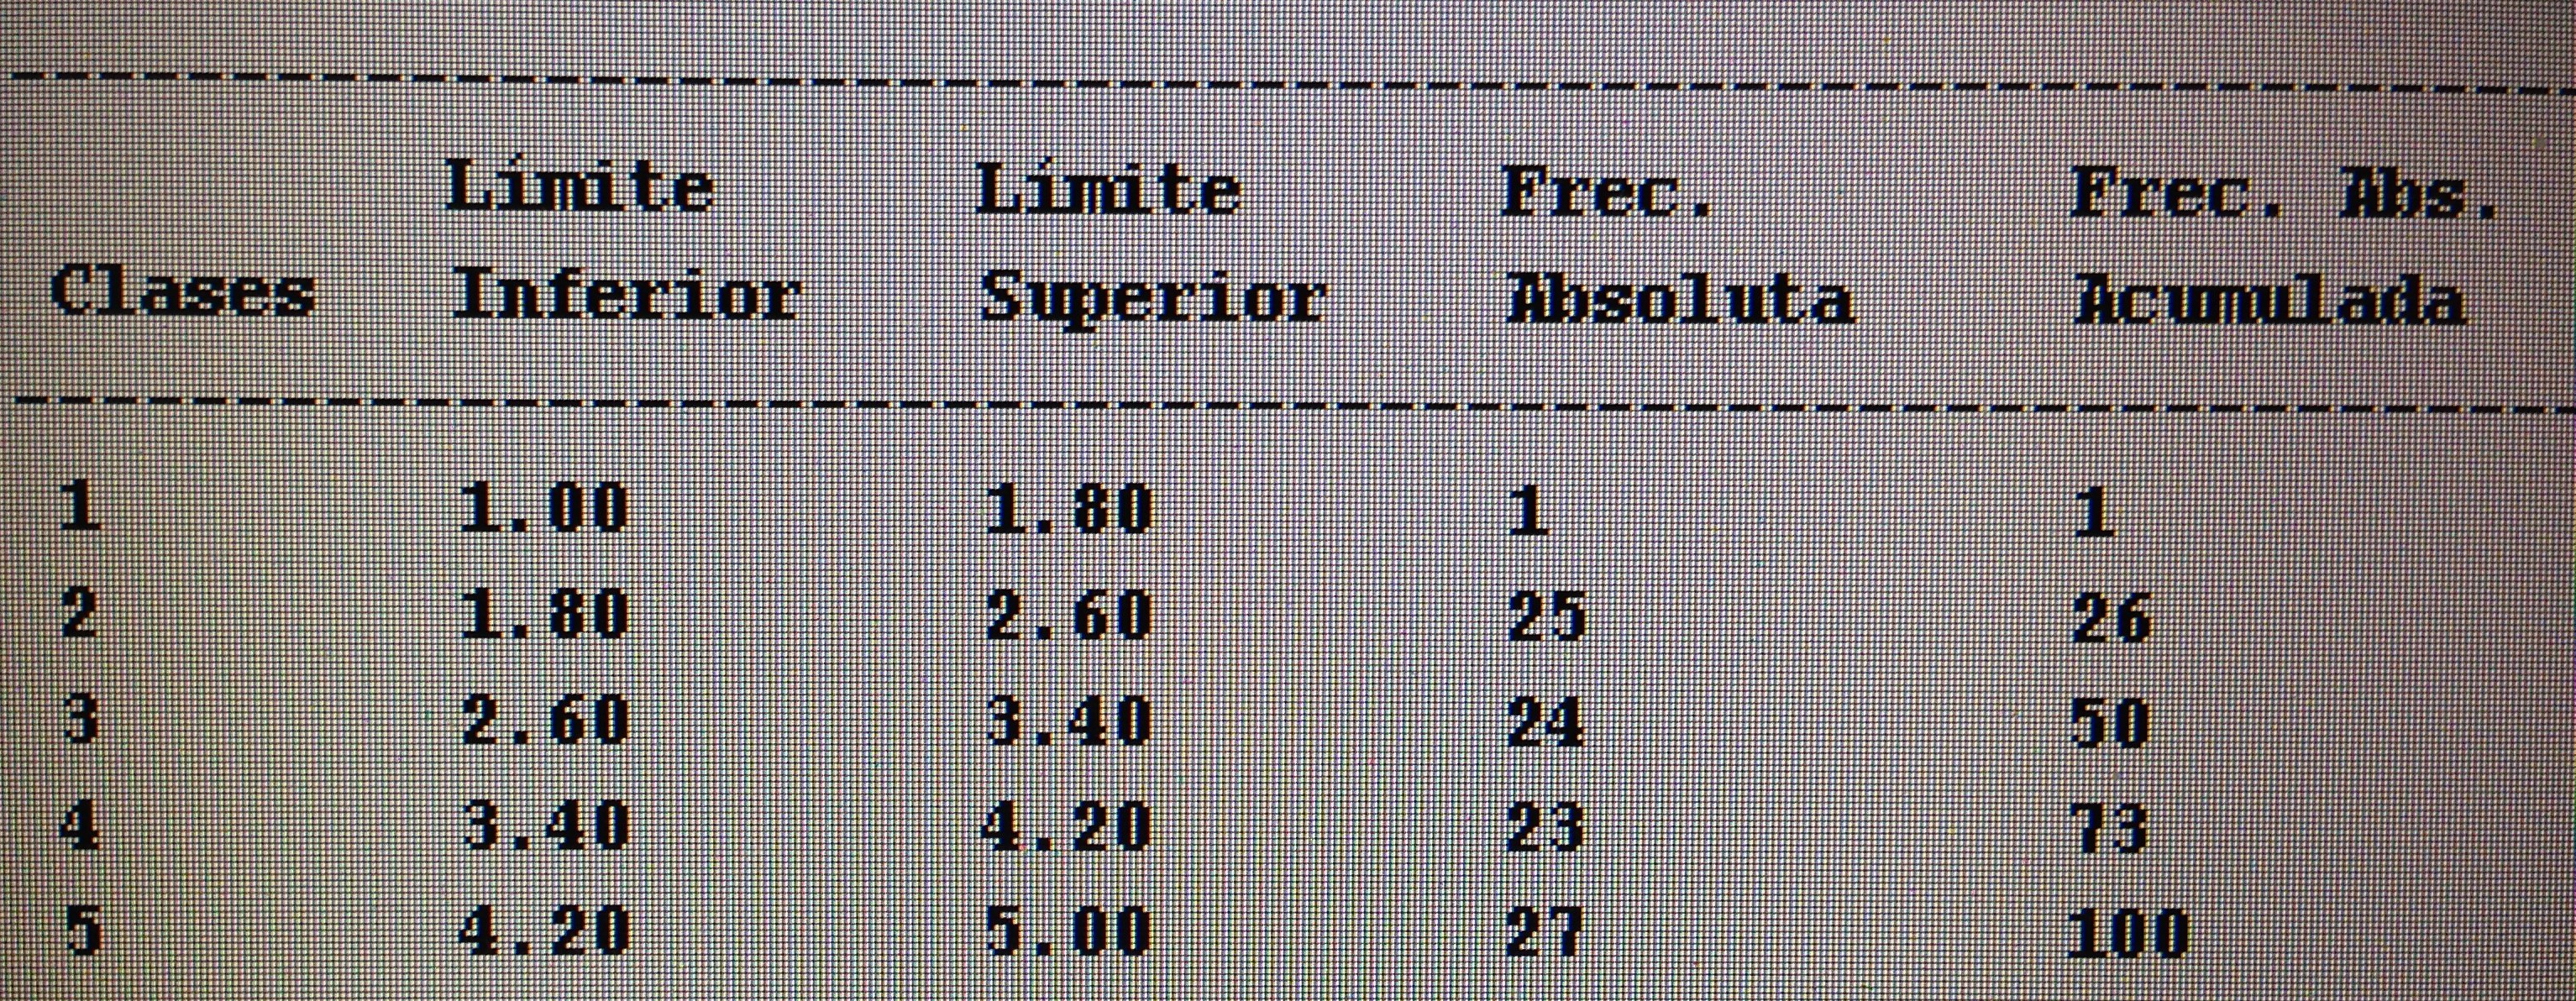
3. Hacer una Estadística descriptiva de las variables P1 y P6 como ejemplos de dos de las siete variables Likert:

Para la variable P1:

IMG_7694

IMG_7695

IMG_7696

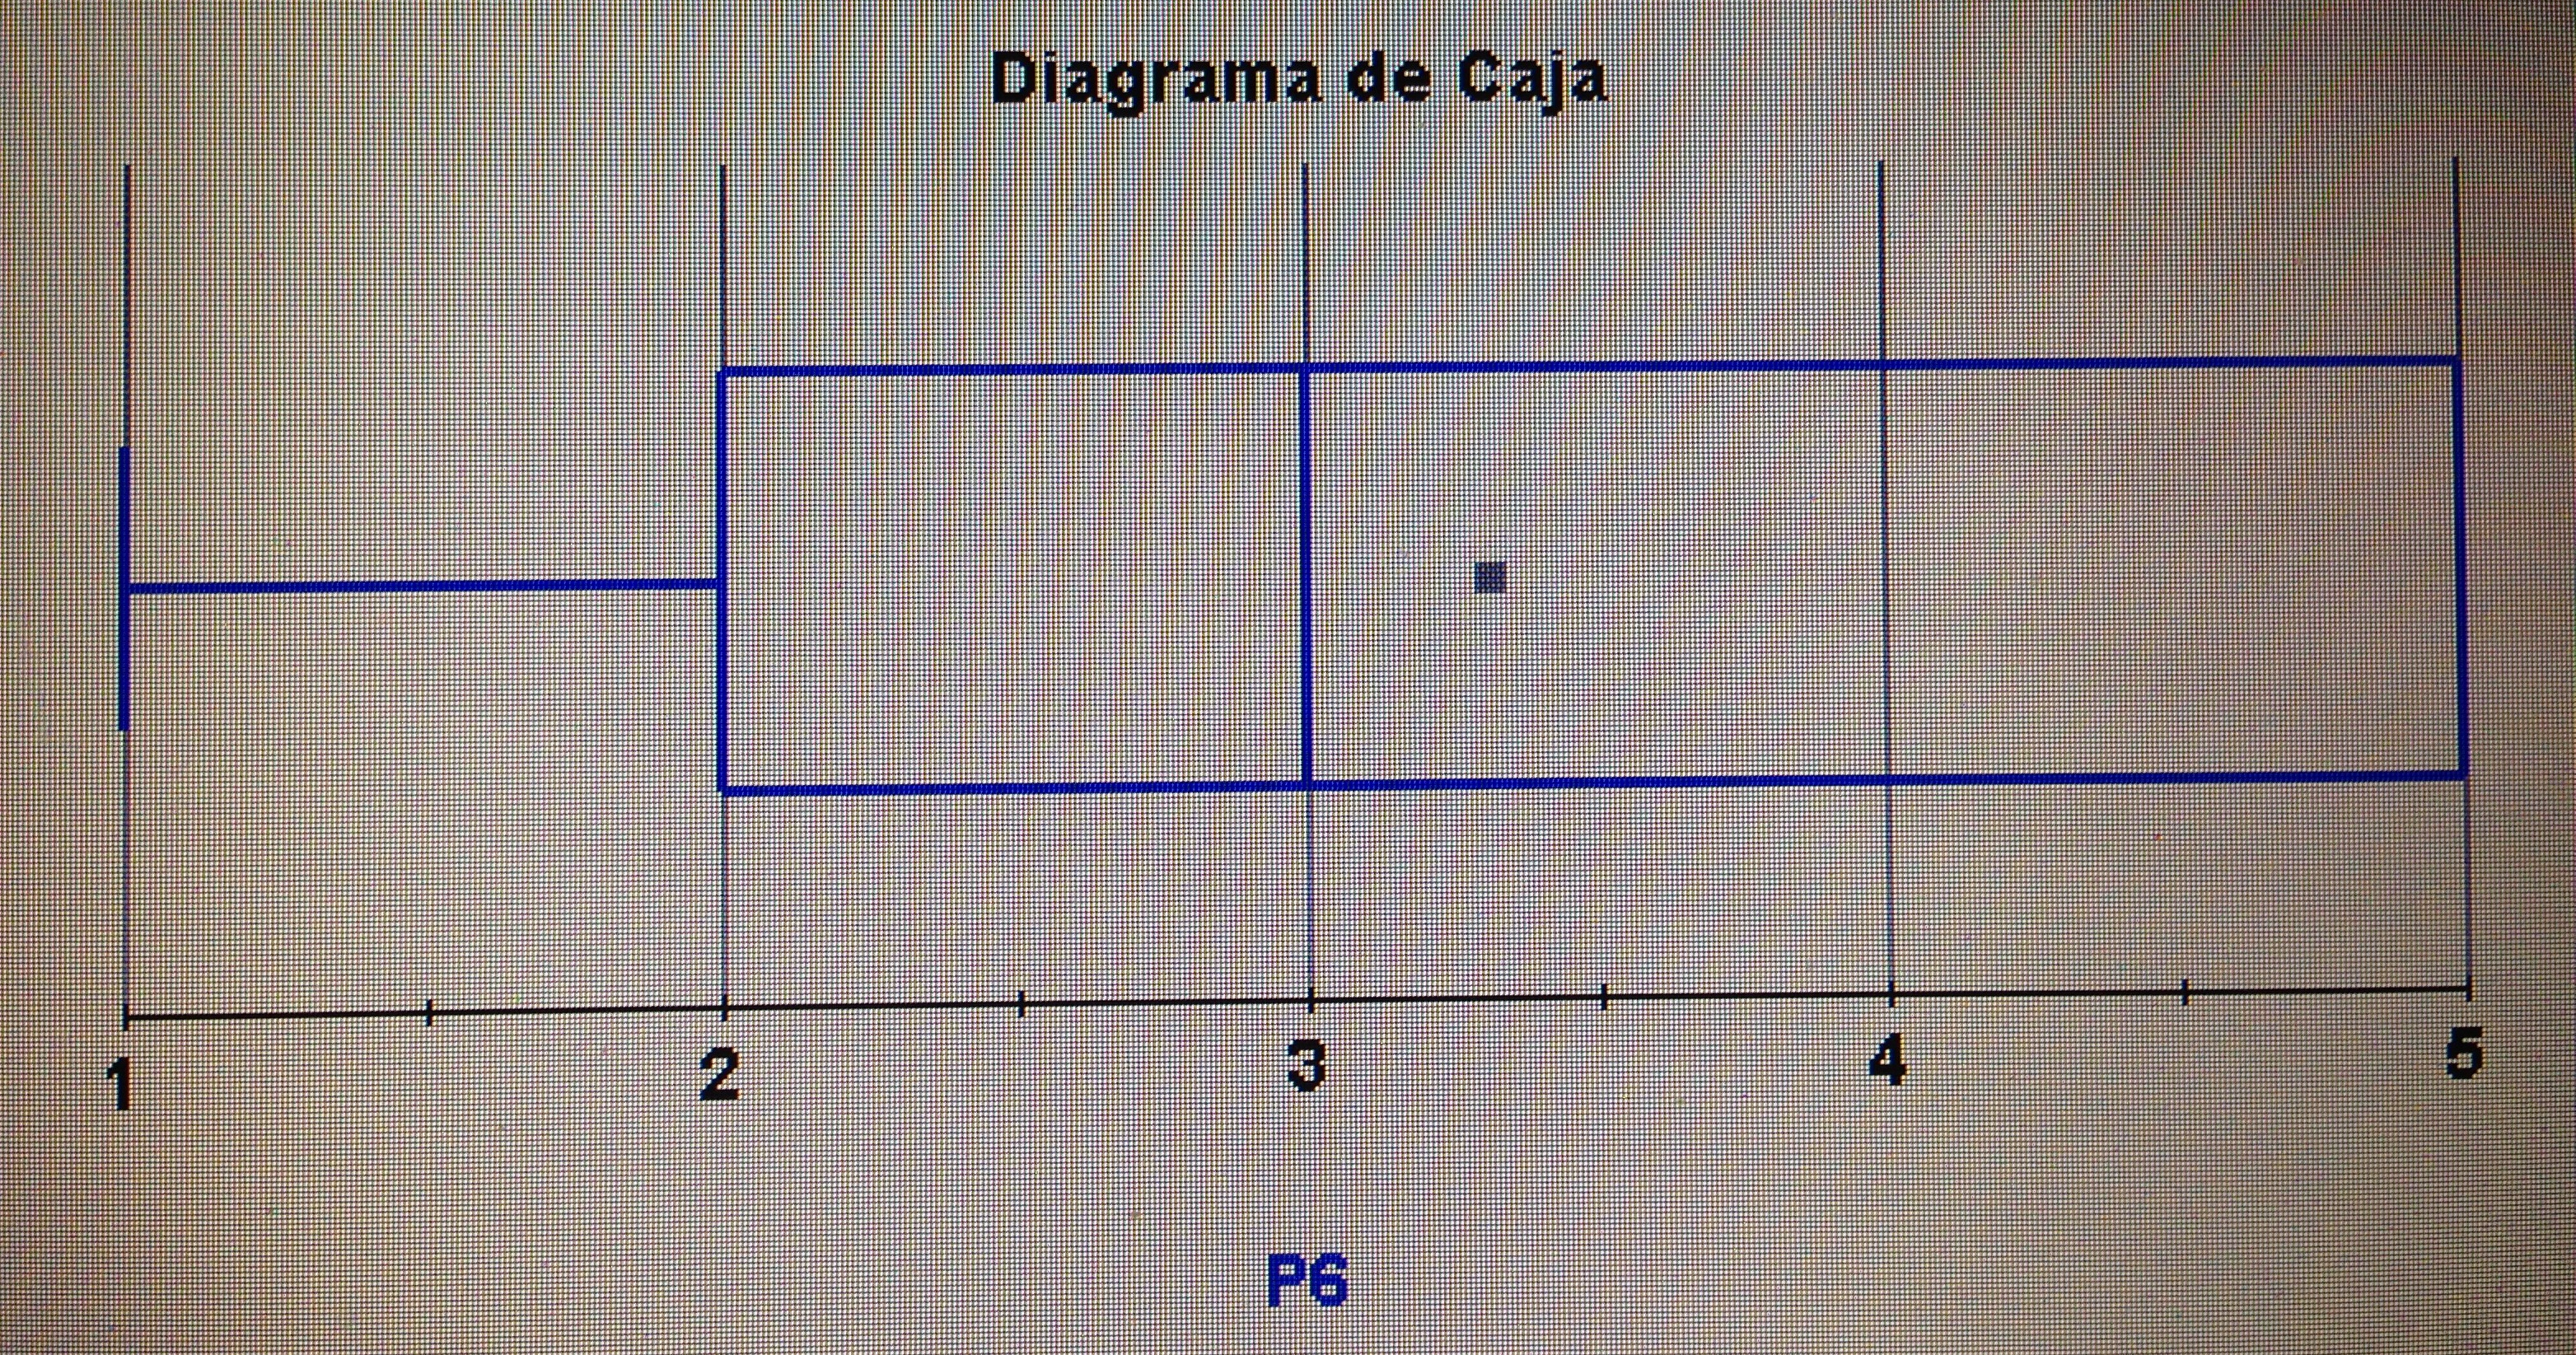
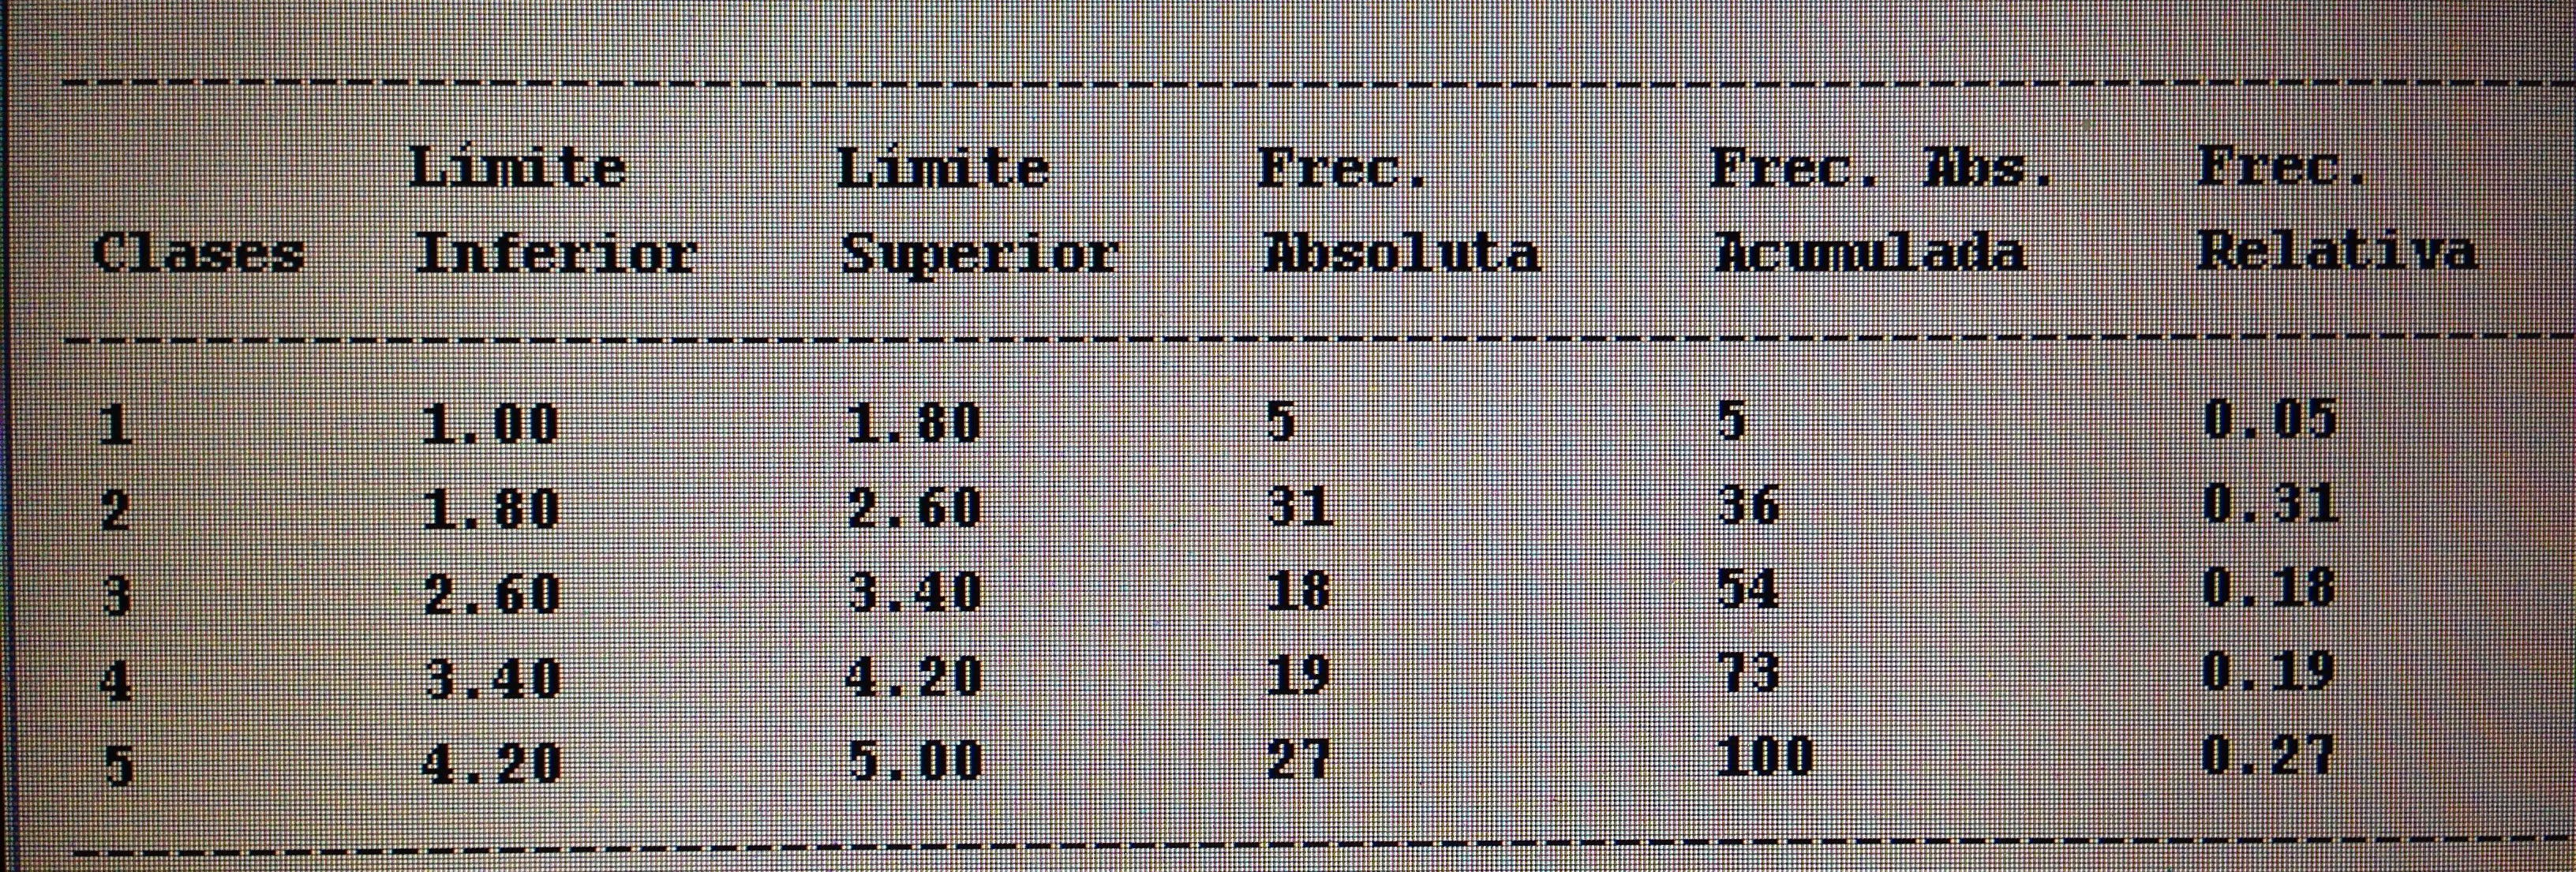
Para la variable P6:

IMG_7697

IMG_7698

IMG_7699

4. Representar de la forma más apropiada y resumida, con Media y Desviación estándar o Mediana y Rango intercuartílico, las variables Edad, Días de ingreso y Valoración general:

De las tres variables la única que tiene una suficiente aproximación a la normalidad (Asimetría estandarizada y Curtosis estandarizada entre -2 y 2) es la variable «Valoración general», por lo tanto esta sería la única que se podría representar mediante la Media y la Desviación estándar. Las otras dos sería más apropiado hacerlo mediante la Mediana y el Rango intercuartílico. O sea, sería de esta forma:

Edad: 47 (40, 69)

Días de ingreso: 4 (2, 8)

Valoración general:  6,3 ± 1,66