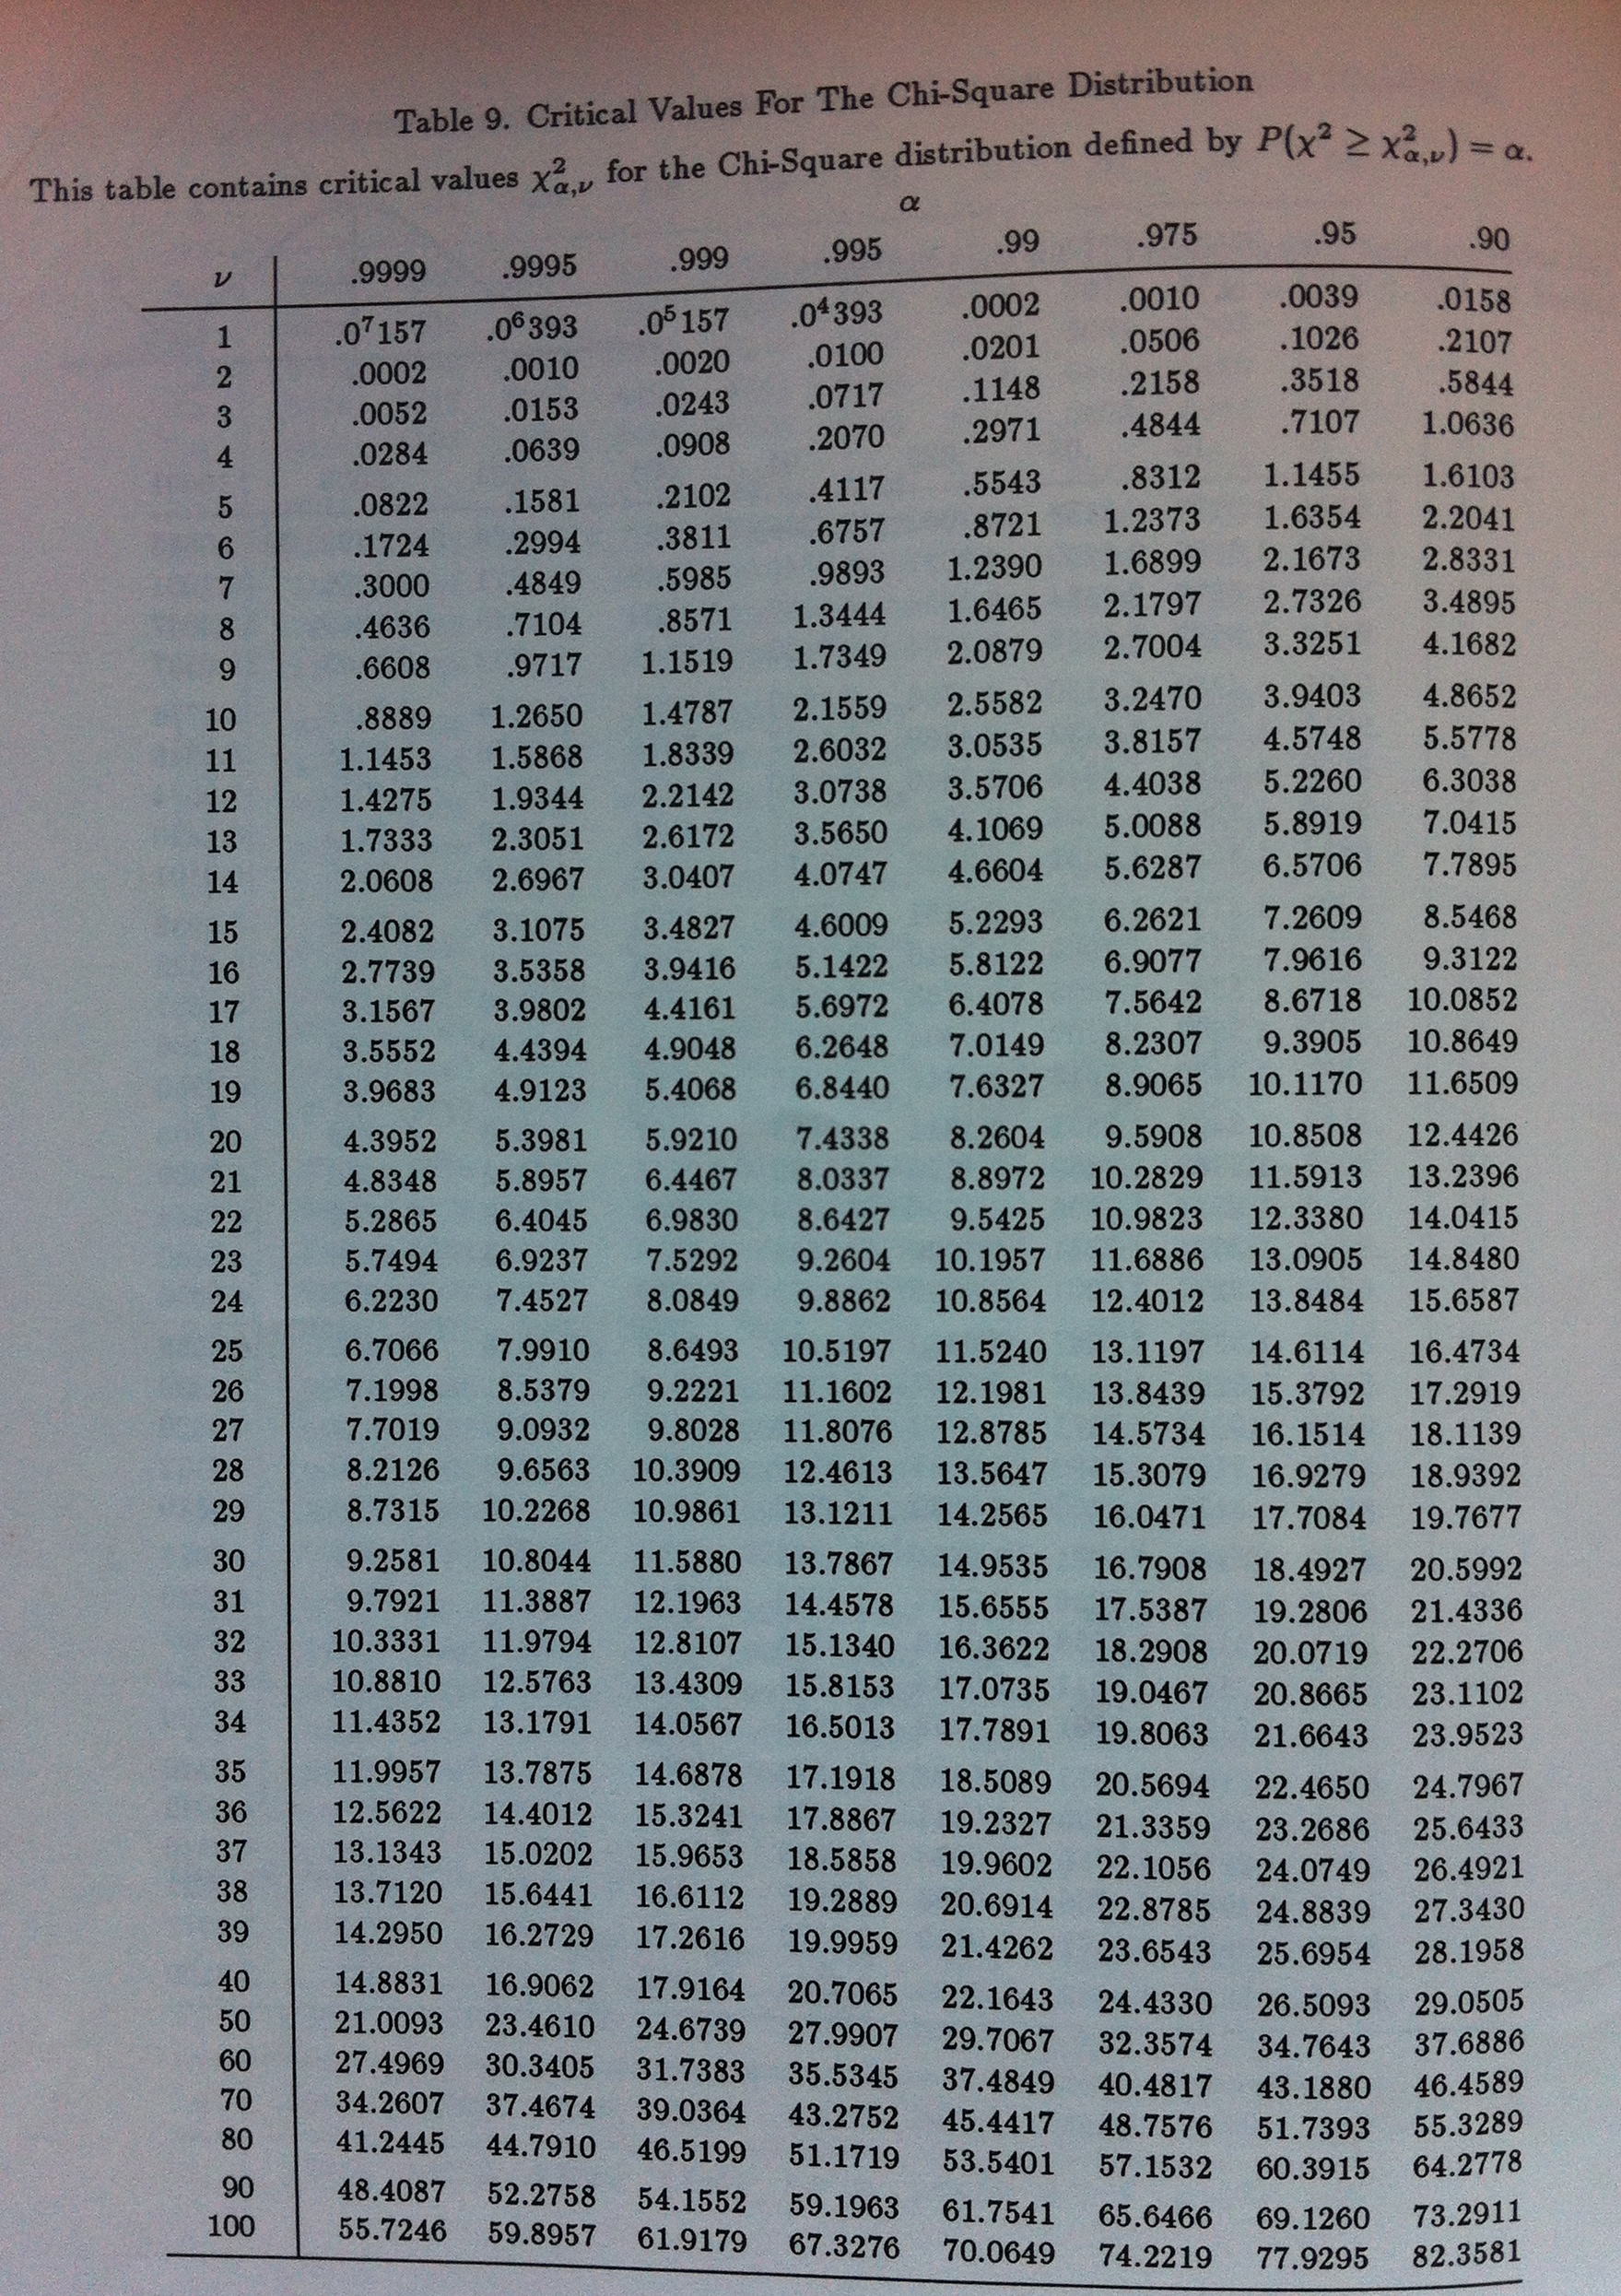
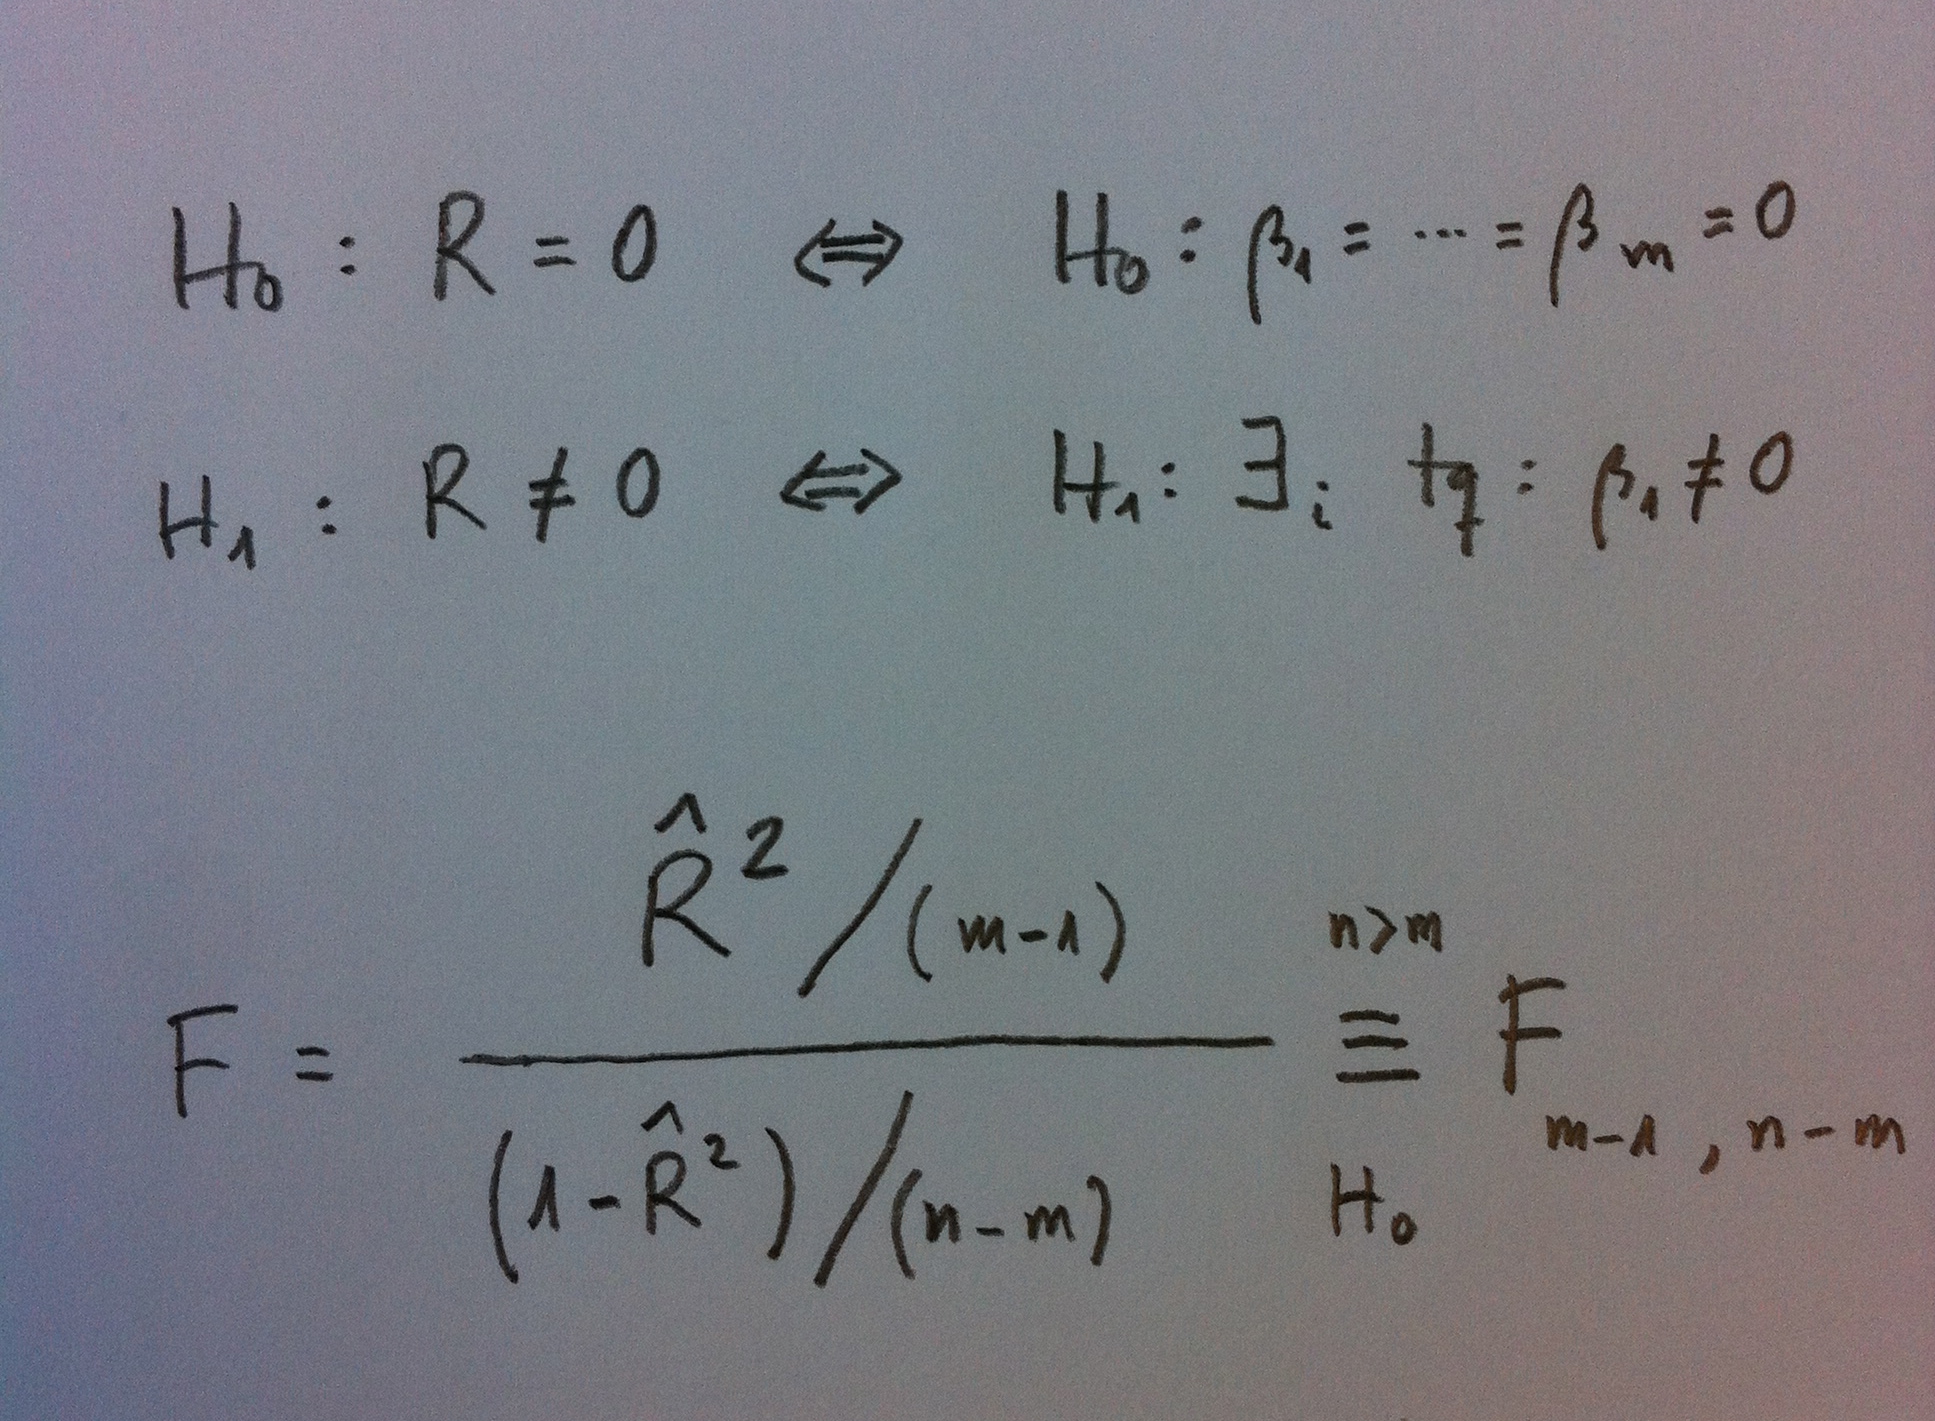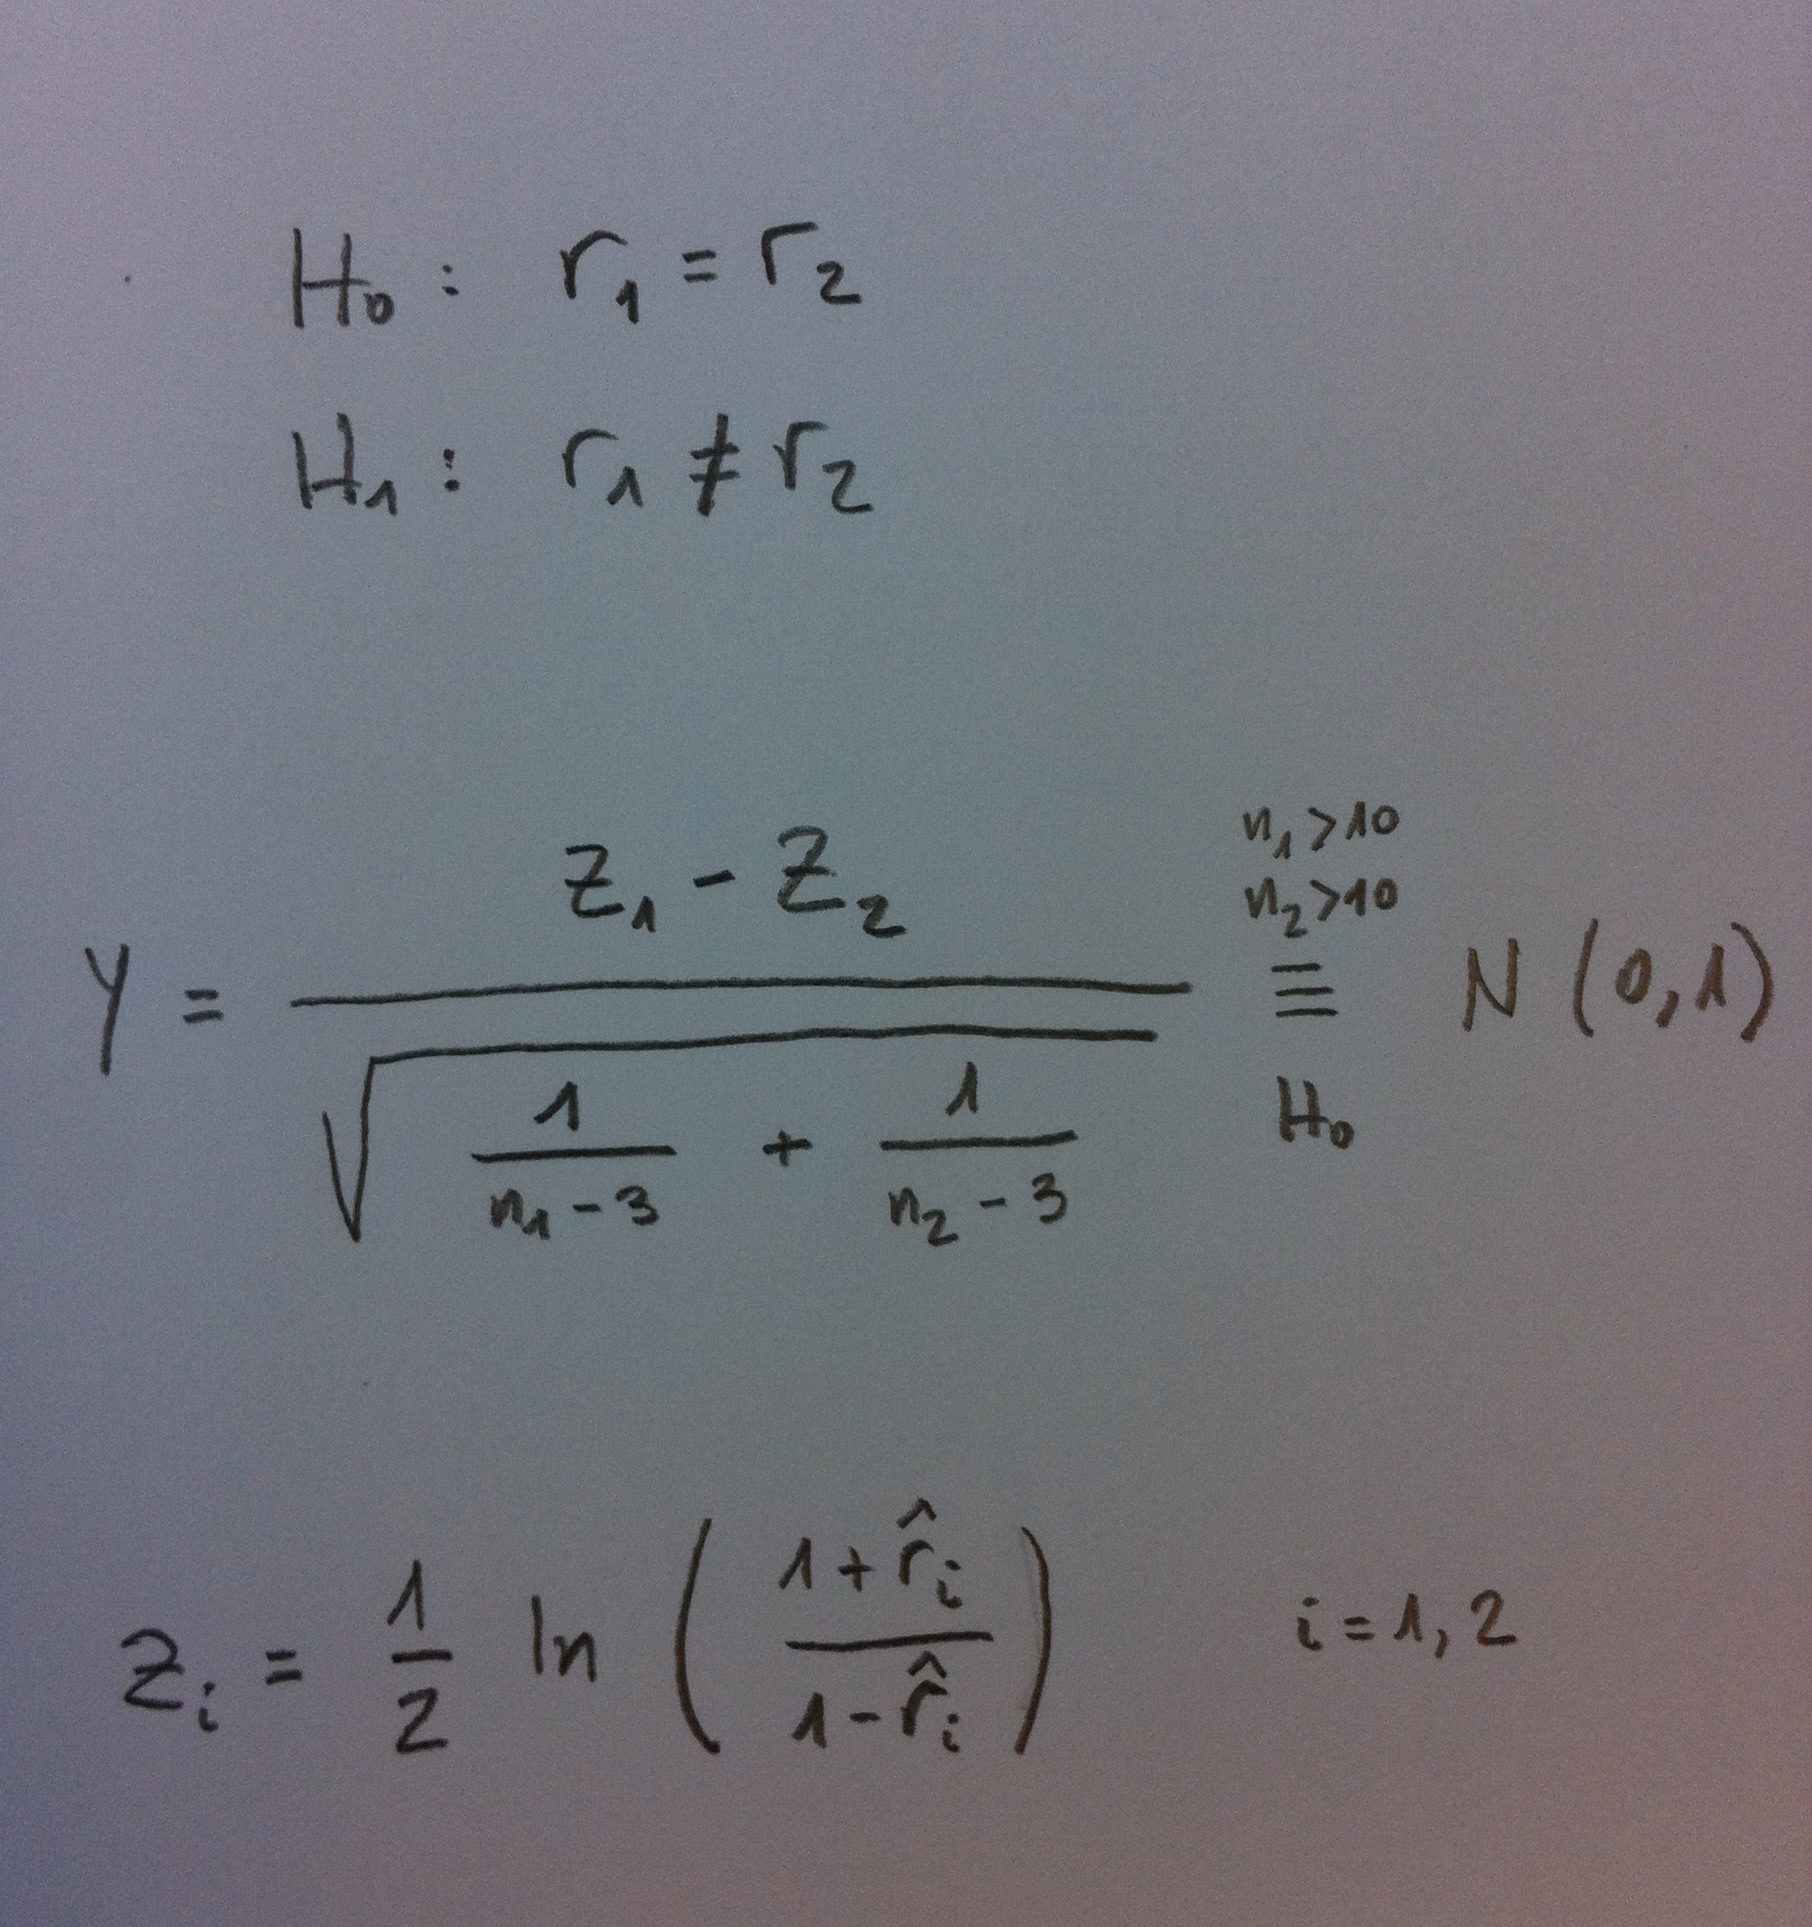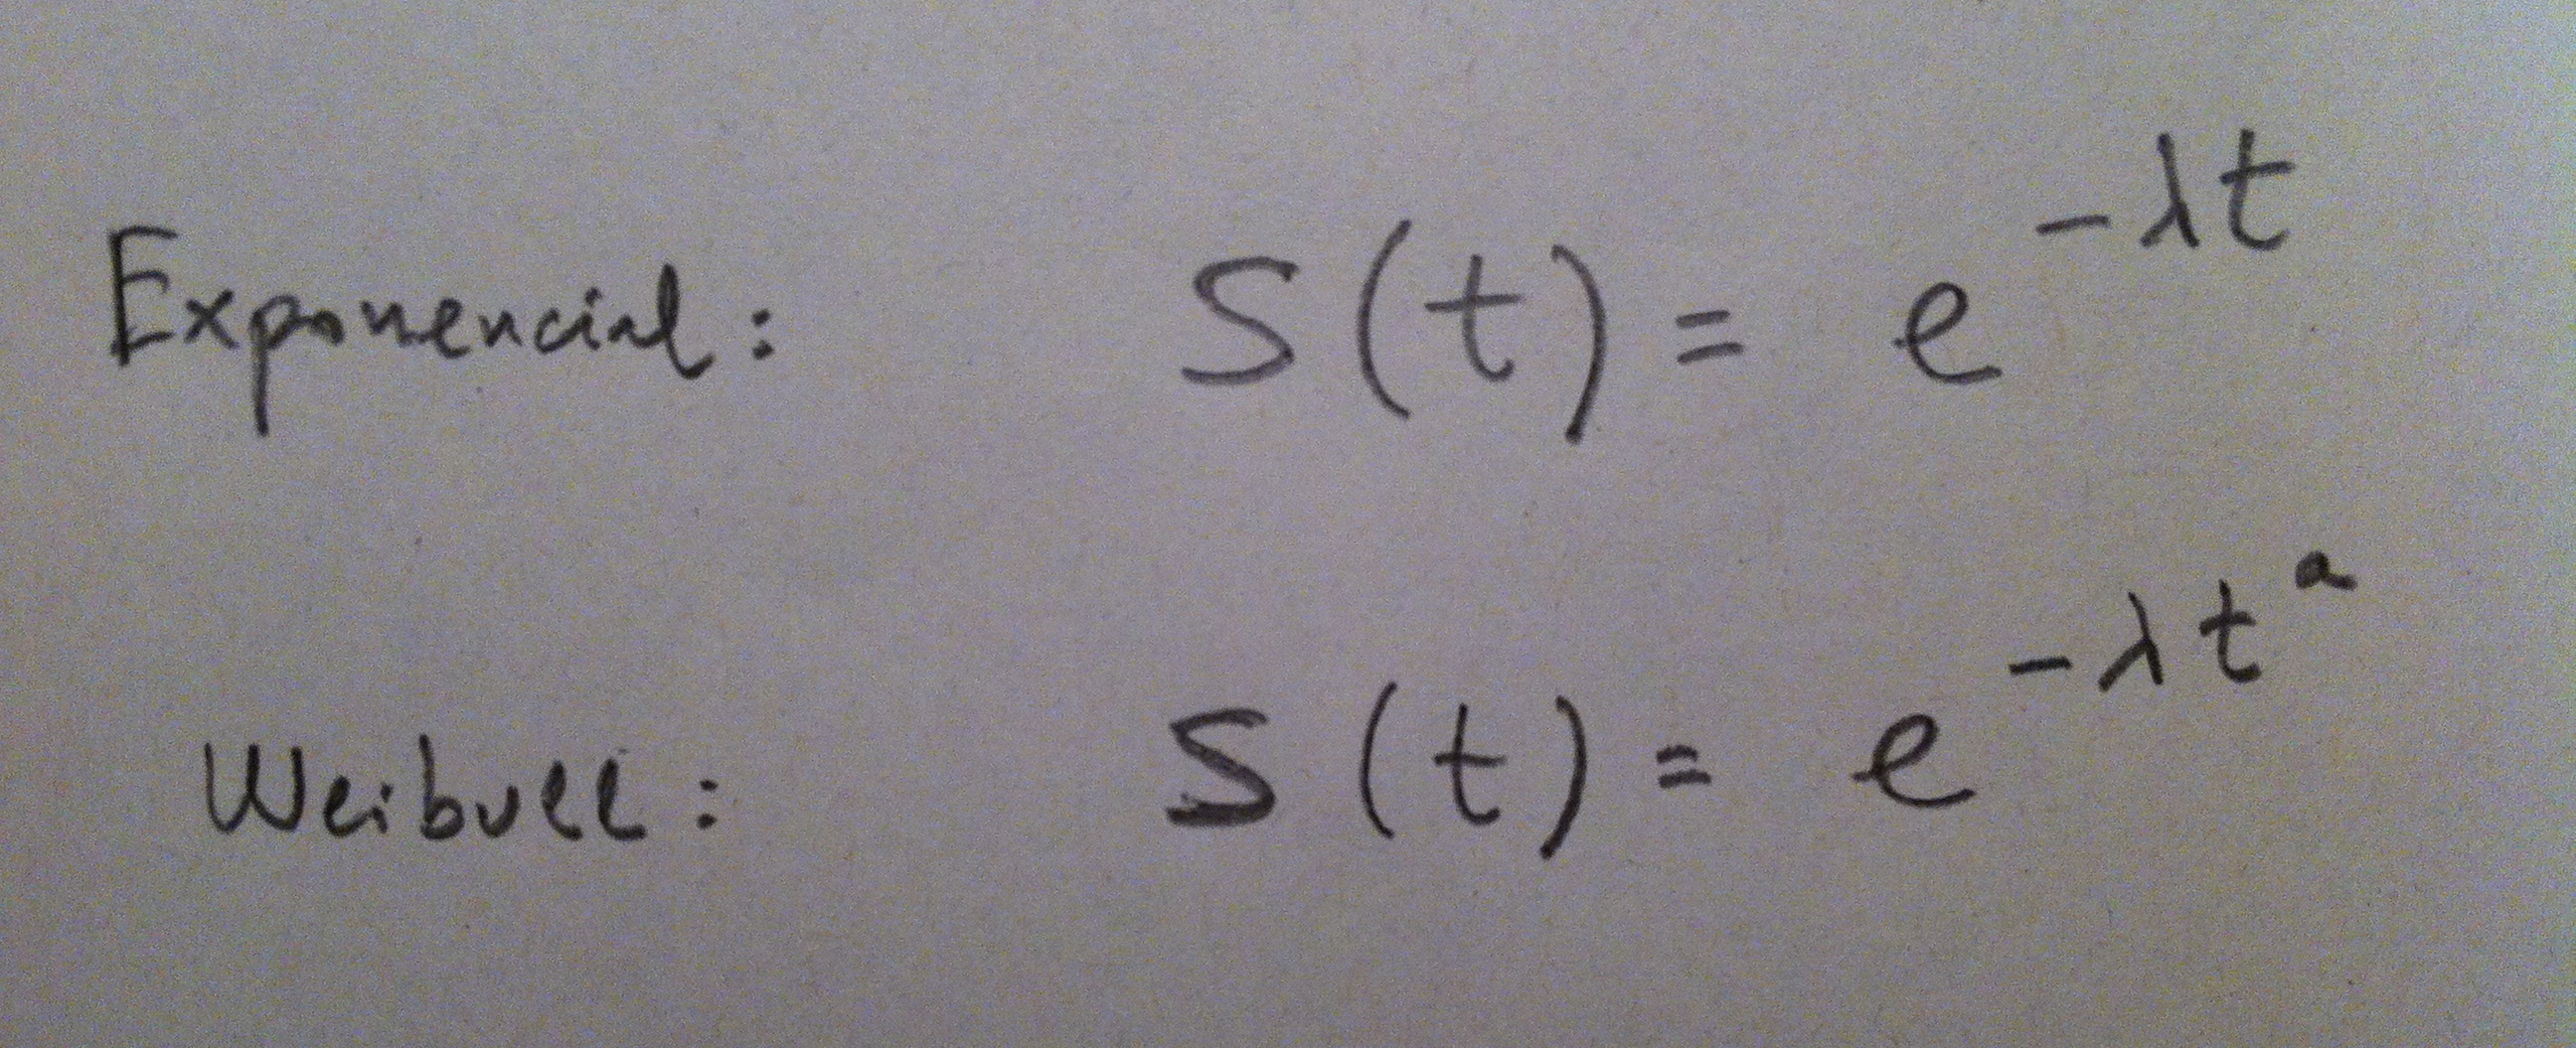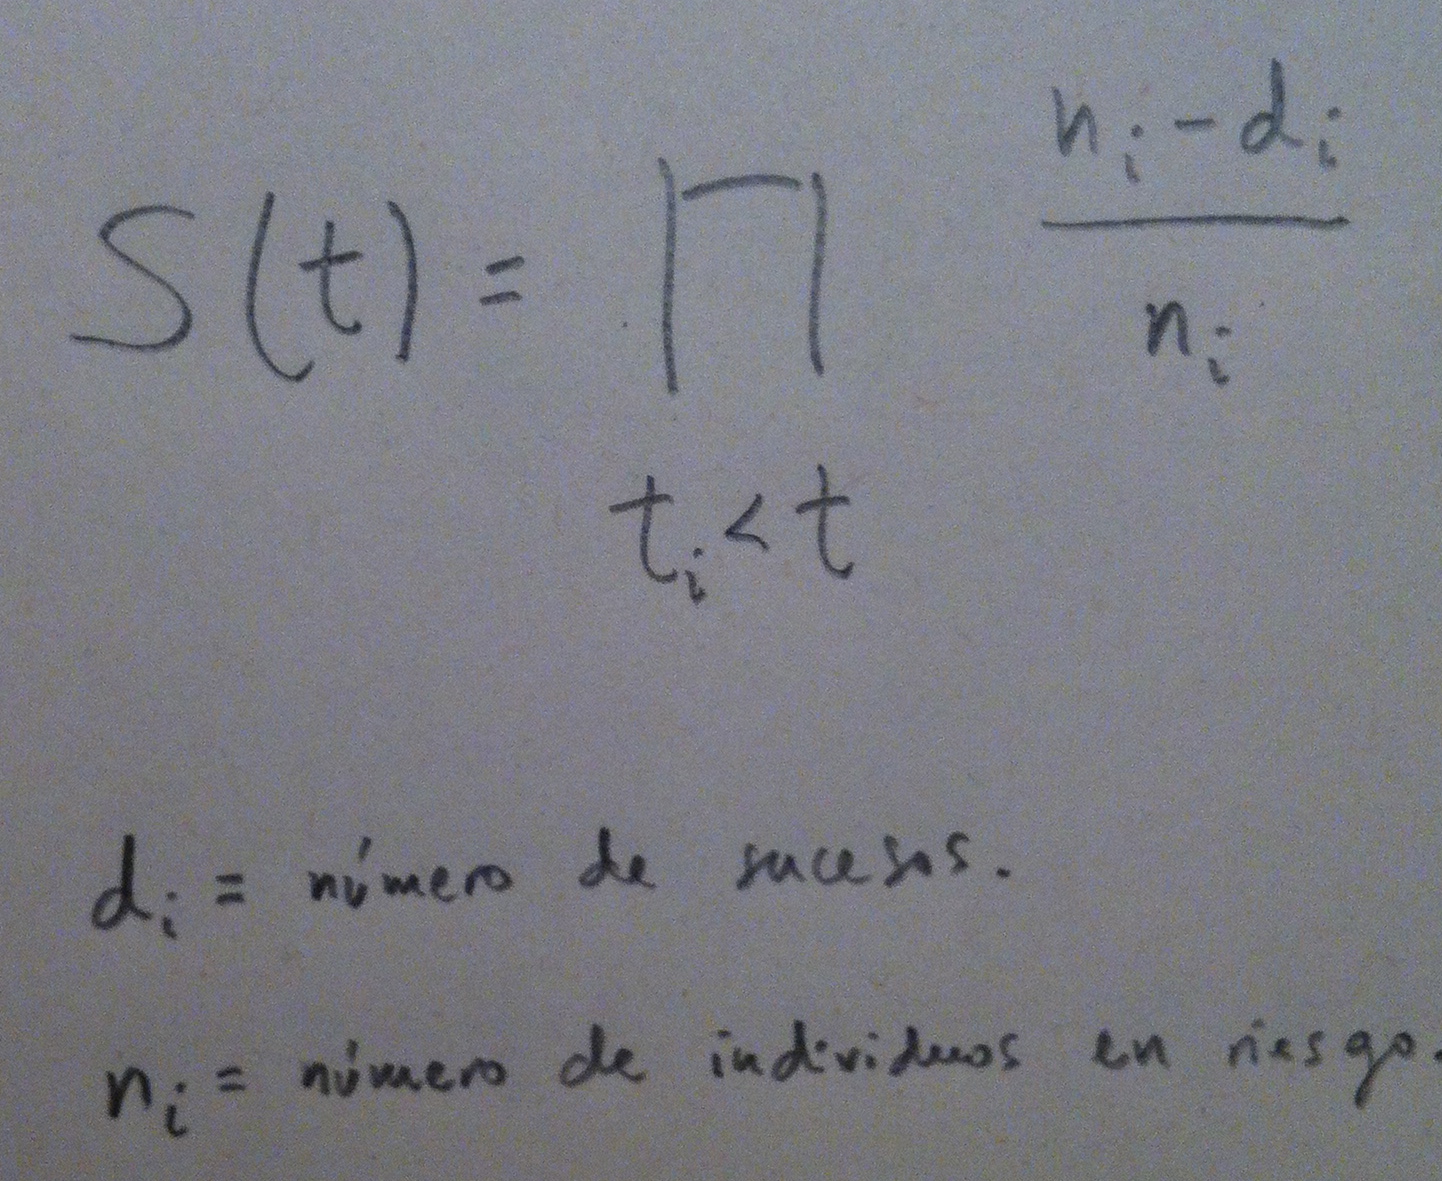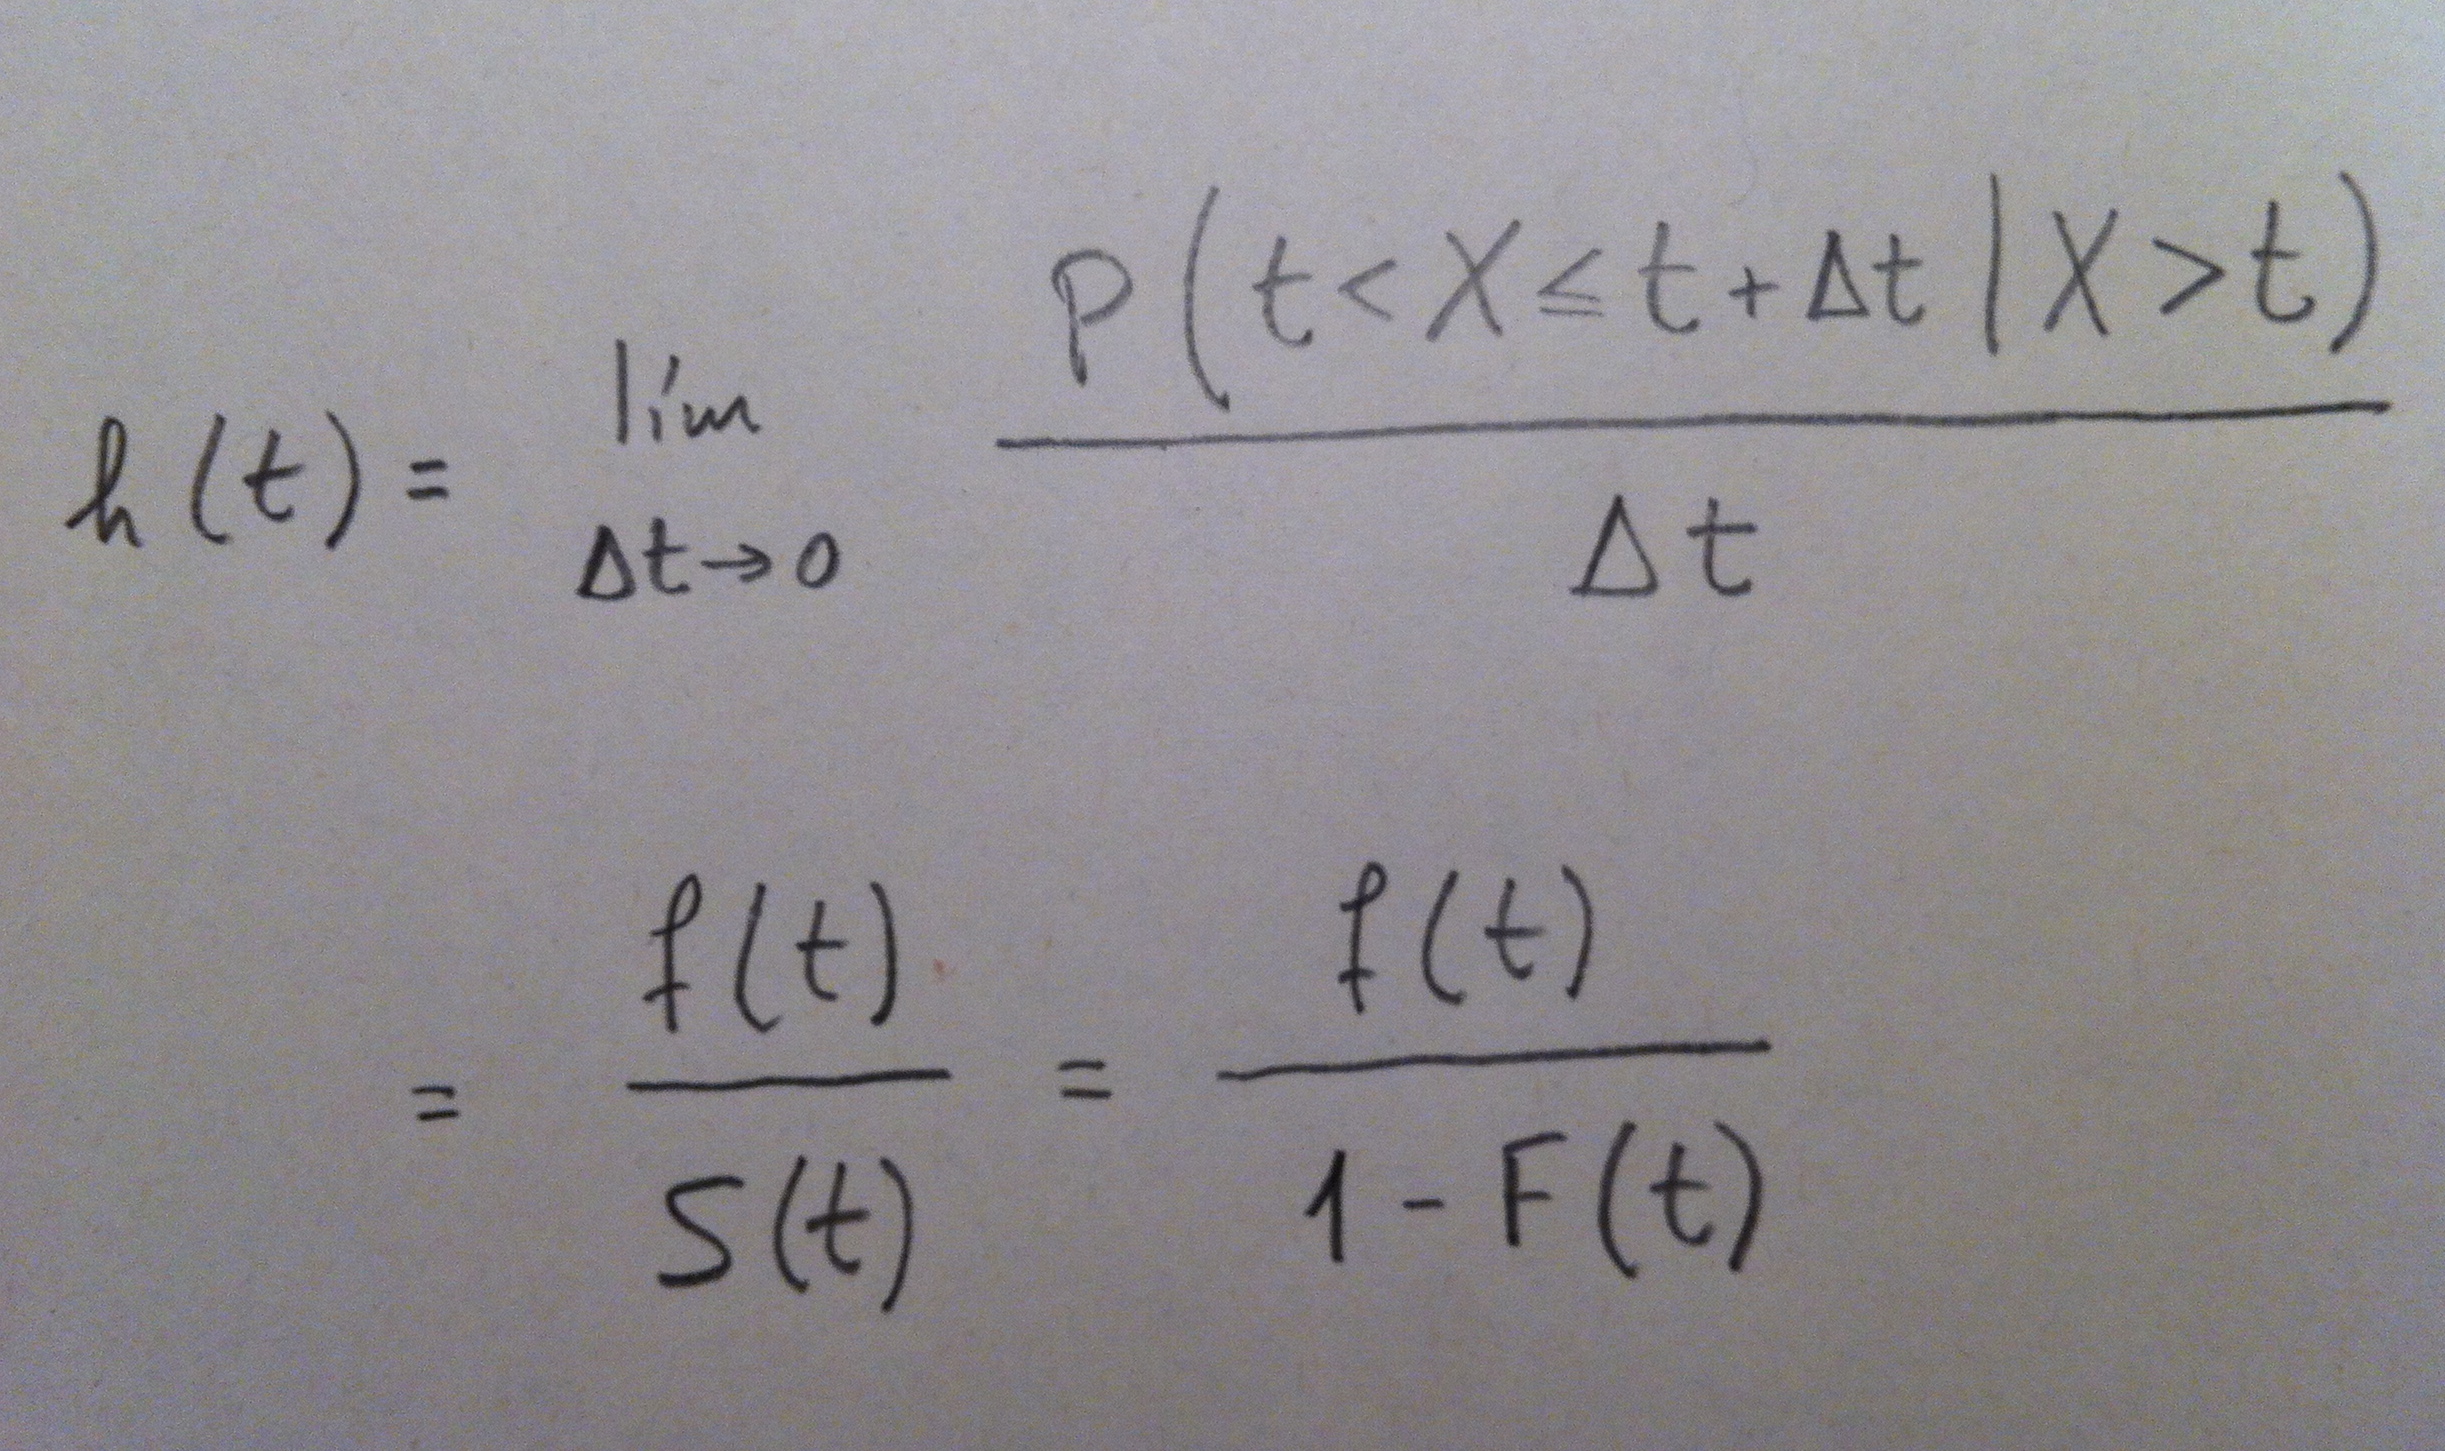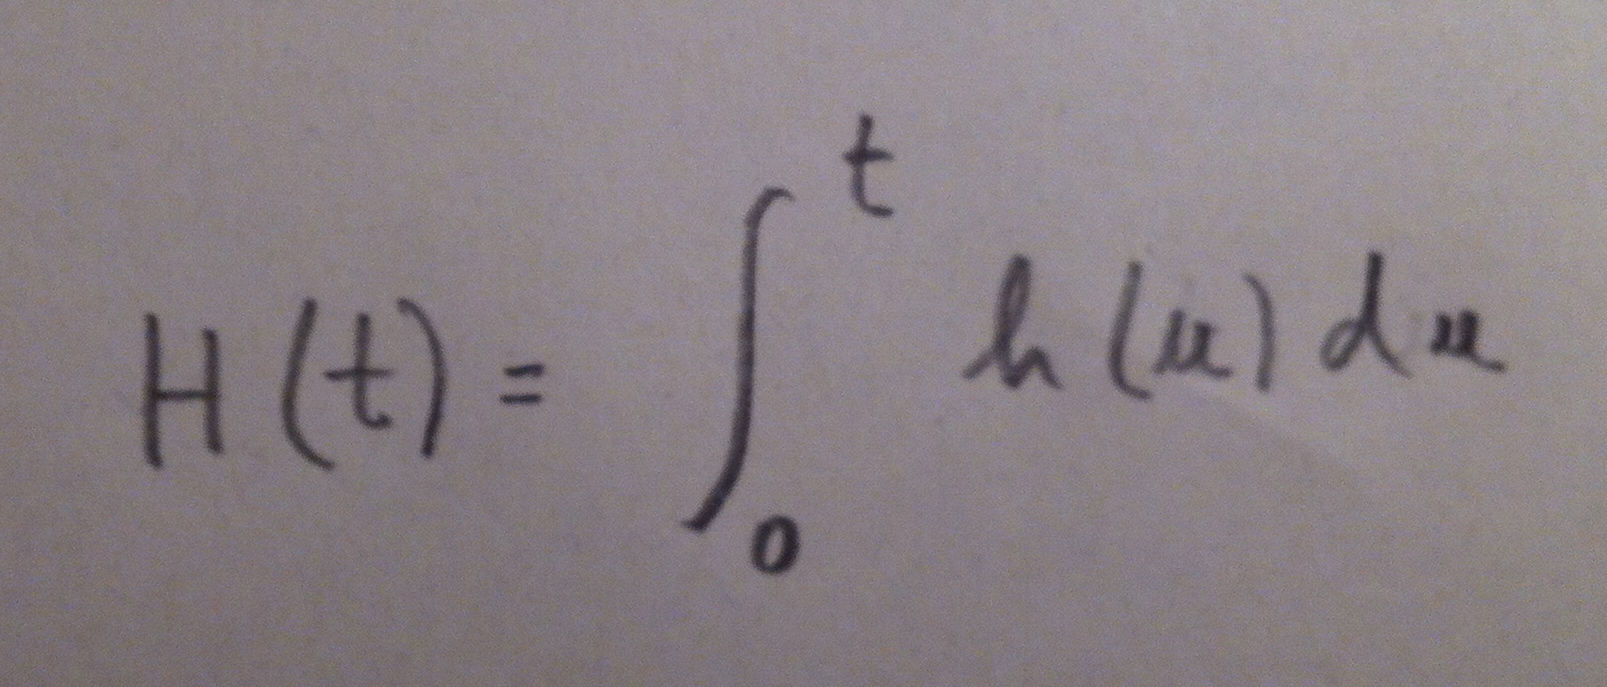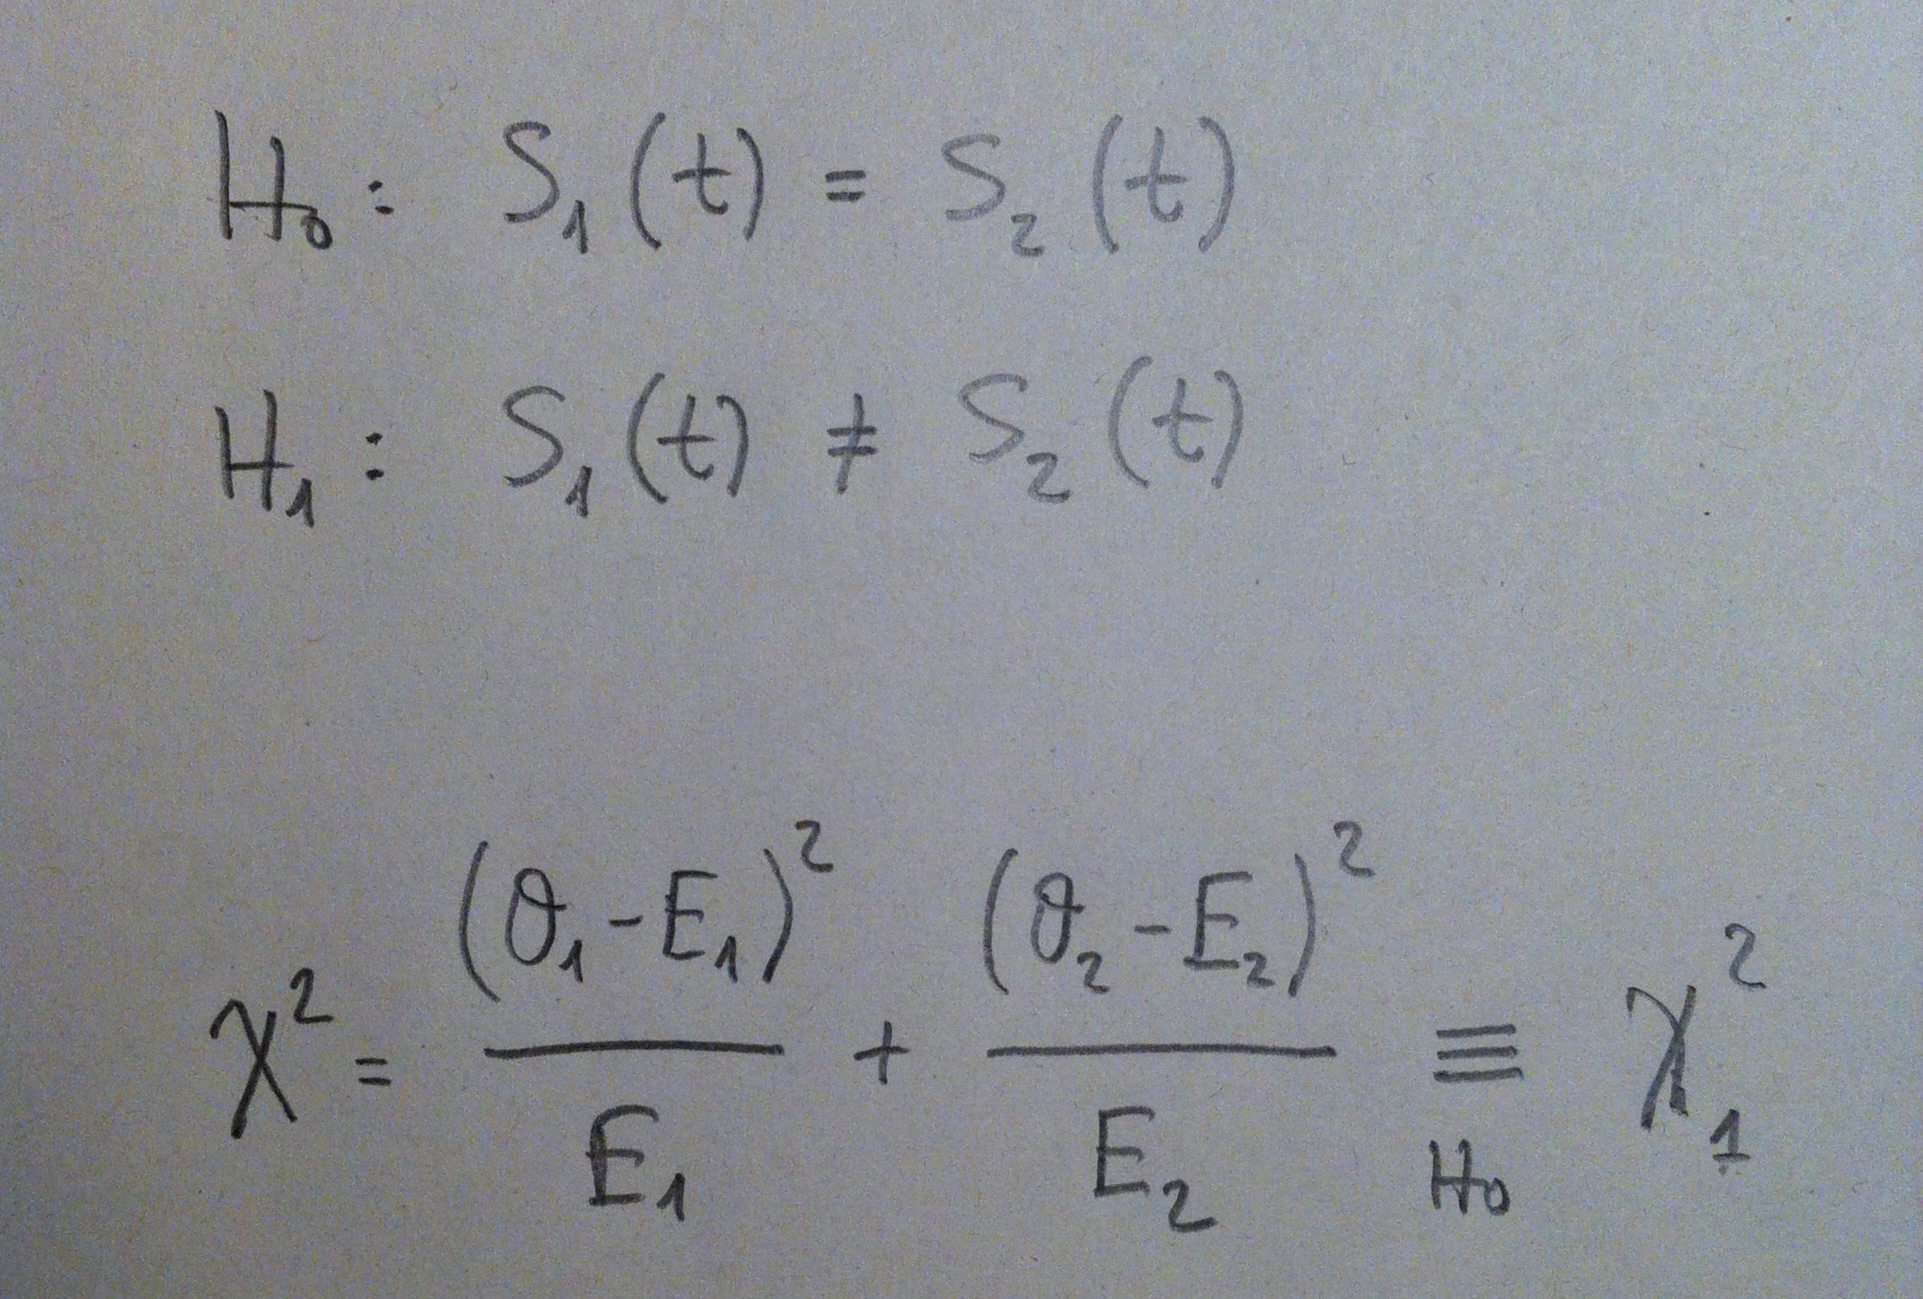La distribución ji-cuadrado tiene un único parámetro. Es una distribución muy importante en muchos ámbitos de la Estadística. Es una distribución muy usada en muchos test estadísticos. Además, es habitual tanto en tests paramétricos como en tests no paramétricos. Es muy importante saber manejarla con soltura.
Veamos la tabla de esa distribución en función de los valores de su parámetro que aparecen en la primera columna encabezados por la letra v. Veremos dos tablas. En la primera se nos muestra valores a partir de los cuales tenemos las áreas señaladas en la primera columna: 0.9999, 0.9995, etc. El valor de la intersección de fila con columna es el valor a partir del cual hay una área señalada en el valor de arriba en una distribución ji-cuadrado con valor del parámetro el valor que hay en la izquierda. Por ejemplo, en una ji cuadrado de parámetro 5, a la derecha de 1.1455 hay un área de 0.95:
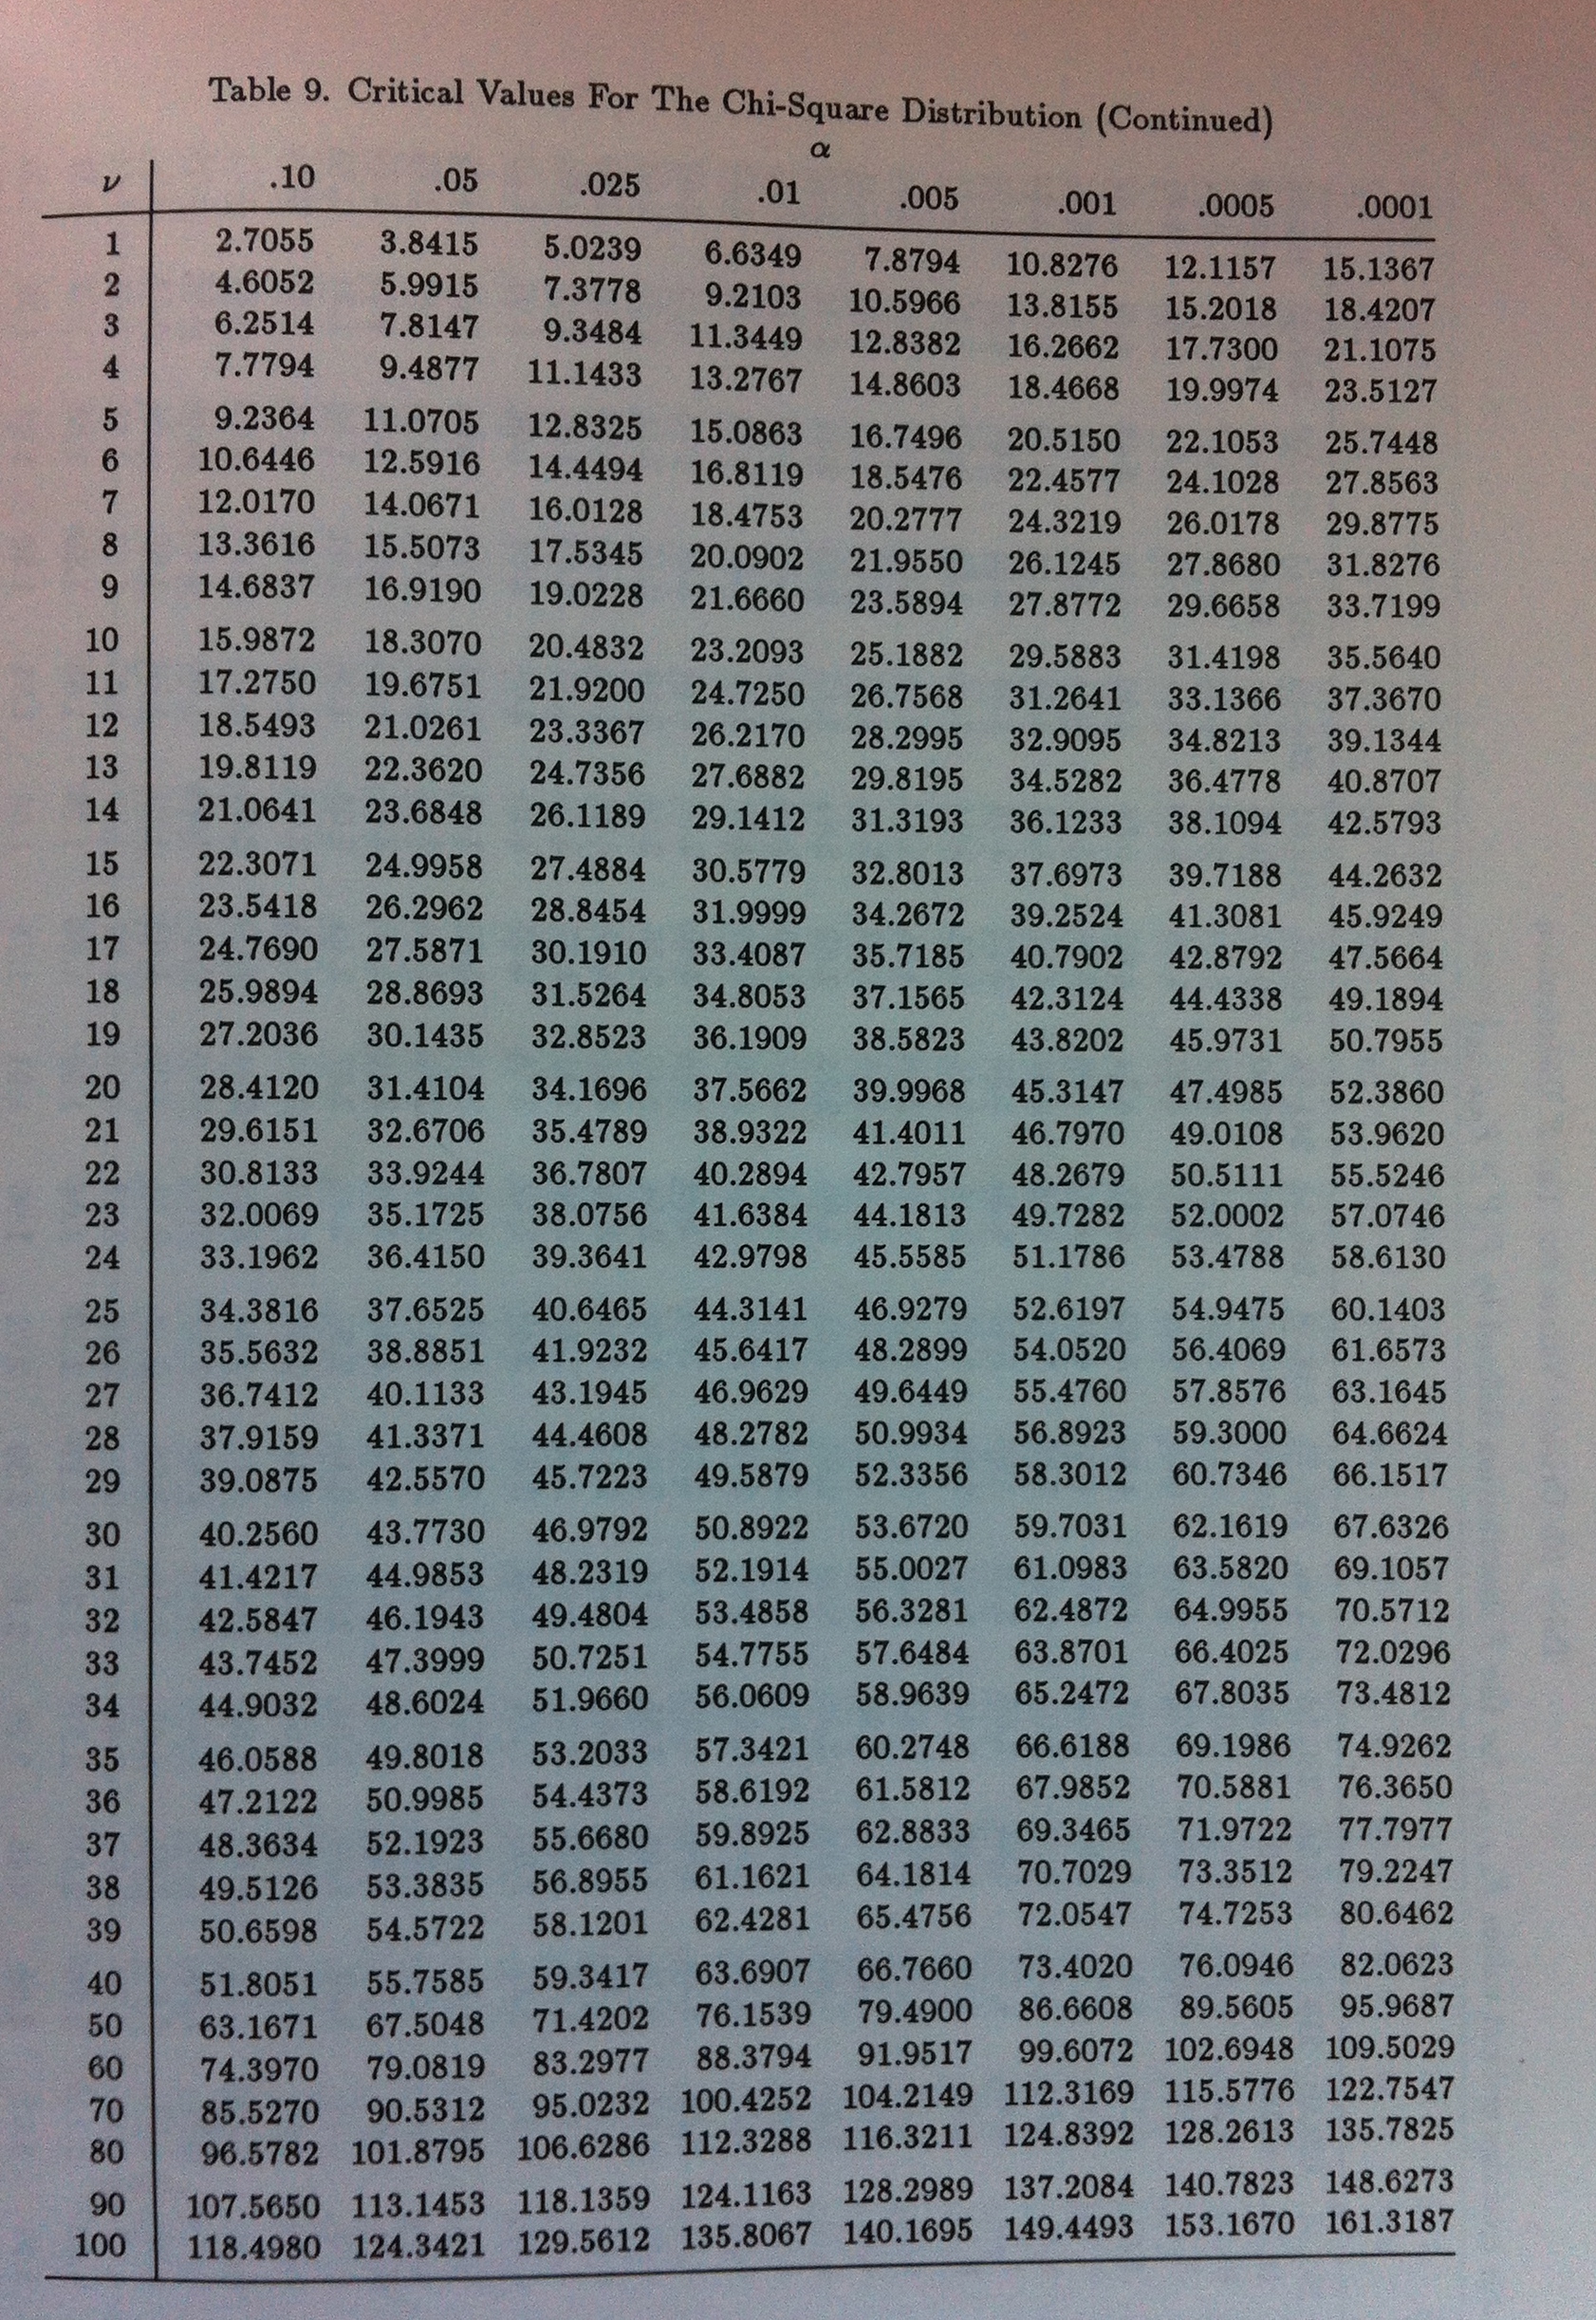
Esta primera parte de la tabla es importante para controlar el lado izquierdo de la distribución ji-cuadrado, la zona próxima a cero. Y la siguiente parte es para controlar el lado derecho de la distribución. La lectura es la misma. Un ejemplo: En una distribución ji-cuadrado de parámetro 5 a la derecha del valor 11.0705 hay un área de 0.05:
Ejemplos de uso de esta tabla en casos concretos pueden verse en el Tema 8: Relación entre variables cualitatitcas. Y también en el artículo «Un ejemplo de Test de McNemar en Medicina» en la sección Estadística y Medicina.
La distribución t de Student tiene un único parámetro. Recuerda su forma mucho a la de una campana de Gauss, sin serlo. Siempre está centrada en el cero y lo que cambia es la dispersión. Es muy importante saber manejar las tablas de esa distribución porque en muchos contrastes de hipótesis en Estadística la distribución del estadístico de test utilizado sigue esta distribución.
Veamos las tablas de esta fundamental distribución:
1. El Análisis de supervivencia es una técnica inferencial que tiene como objetivo esencial modelizar el tiempo que se tarda en que ocurra un determinado suceso. Por el nombre de la técnica parecería que se analizara el tiempo hasta la muerte (Análisis de supervivencia) pero, en realidad, puede analizarse cualquier otro suceso.
2. En Análisis de supervivencia la muestra consiste en el seguimiento de una serie de individuos desde el inicio del estudio hasta su final y, ante una situación de este tipo, es frecuente que se produzca la desaparición de alguno de esos individuos que entran en el estudio. También es posible que al entrar un individuo en el estudio, éste termine antes de que en ese individuo se produzca el suceso que se pretende detectar. Aunque son dos hechos distintos en realidad a efectos prácticos suponen lo mismo. A estos individuos, en el ámbito de la Estadística, se le denomina censurados.
3. Un dato censurado representa, pues, un individuo que desaparece, que lo hemos tenido pero que, antes de haberse producido el suceso que analizamos, ha desaparecido, sea porque lo perdemos del estudio o sea porque el estudio ha terminado y no se ha producido el suceso. Un dato censurado no es un dato que no nos dé información. De hecho, nos la da pero parcial, como veremos. Hay que saberlo aprovechar. Prescindir de él, sin más, sería desaprovechar información y eso, en Estadística, no es bueno.
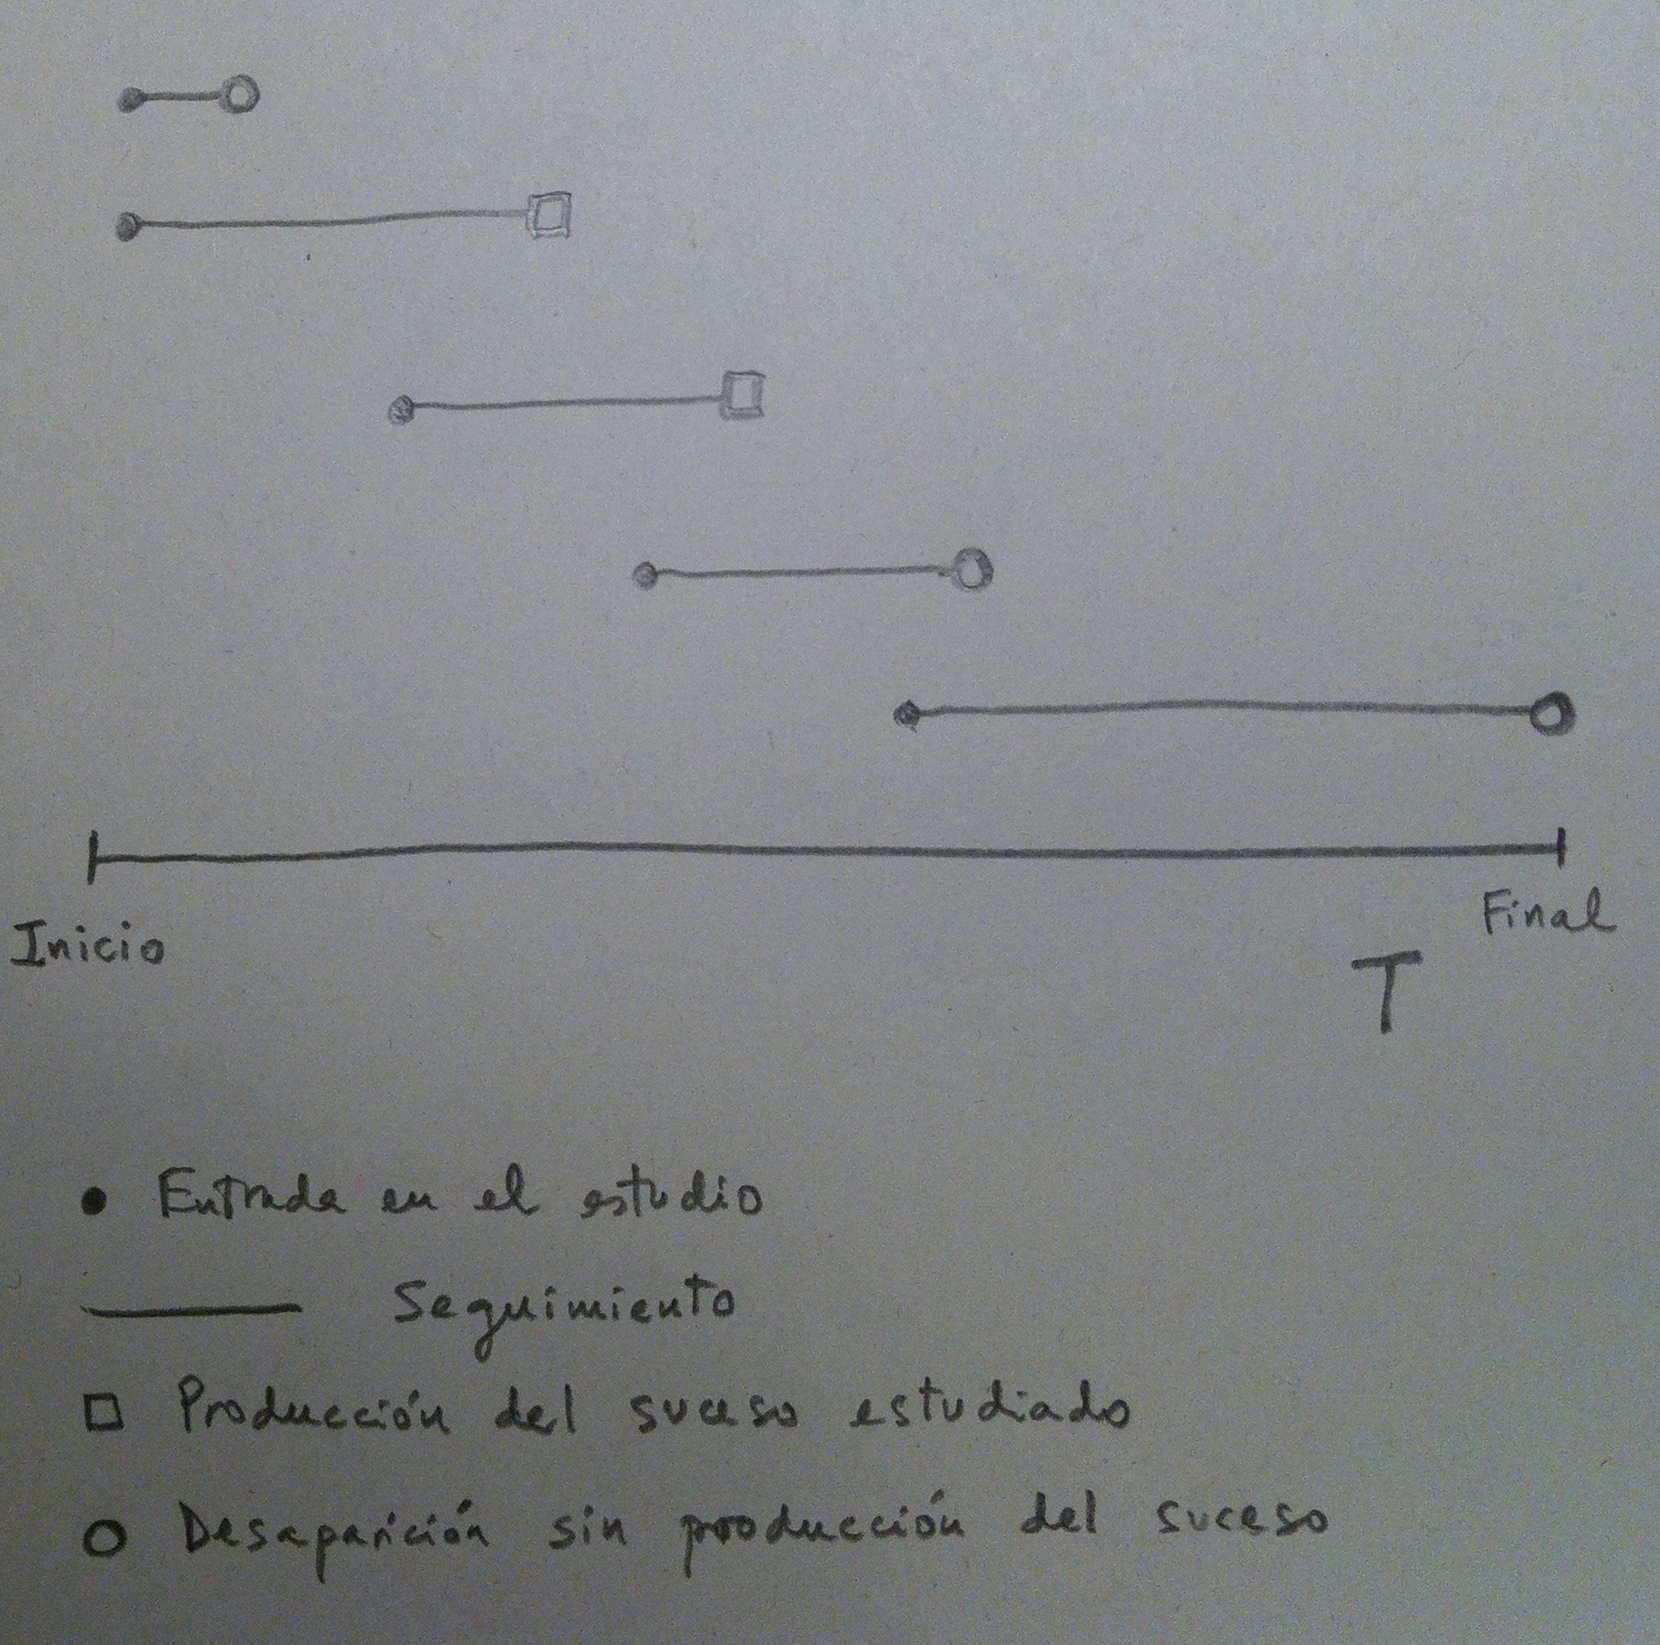
4. Veamos en el siguiente gráfico el tipo de datos que nos podemos encontrar en un estudio de supervivencia:
5. Observemos que un estudio de supervivencia tiene un inicio y un final, desde ese inicio al final van introduciéndose en el estudio una serie de individuos (Entrada en el estudio), se va realizando un seguimiento y puede, durante ese seguimiento, que se produzca el suceso estudiado (muerte, recidiva, etc), pero también puede ser que el individuo desaparezca del estudio por algún motivo que no sea el estudiado. También puede que acabe nuestro estudio y que a algún individuo tampoco le haya sucedido el suceso estudiado. A efectos prácticos es algo similar a los casos de desaparición.
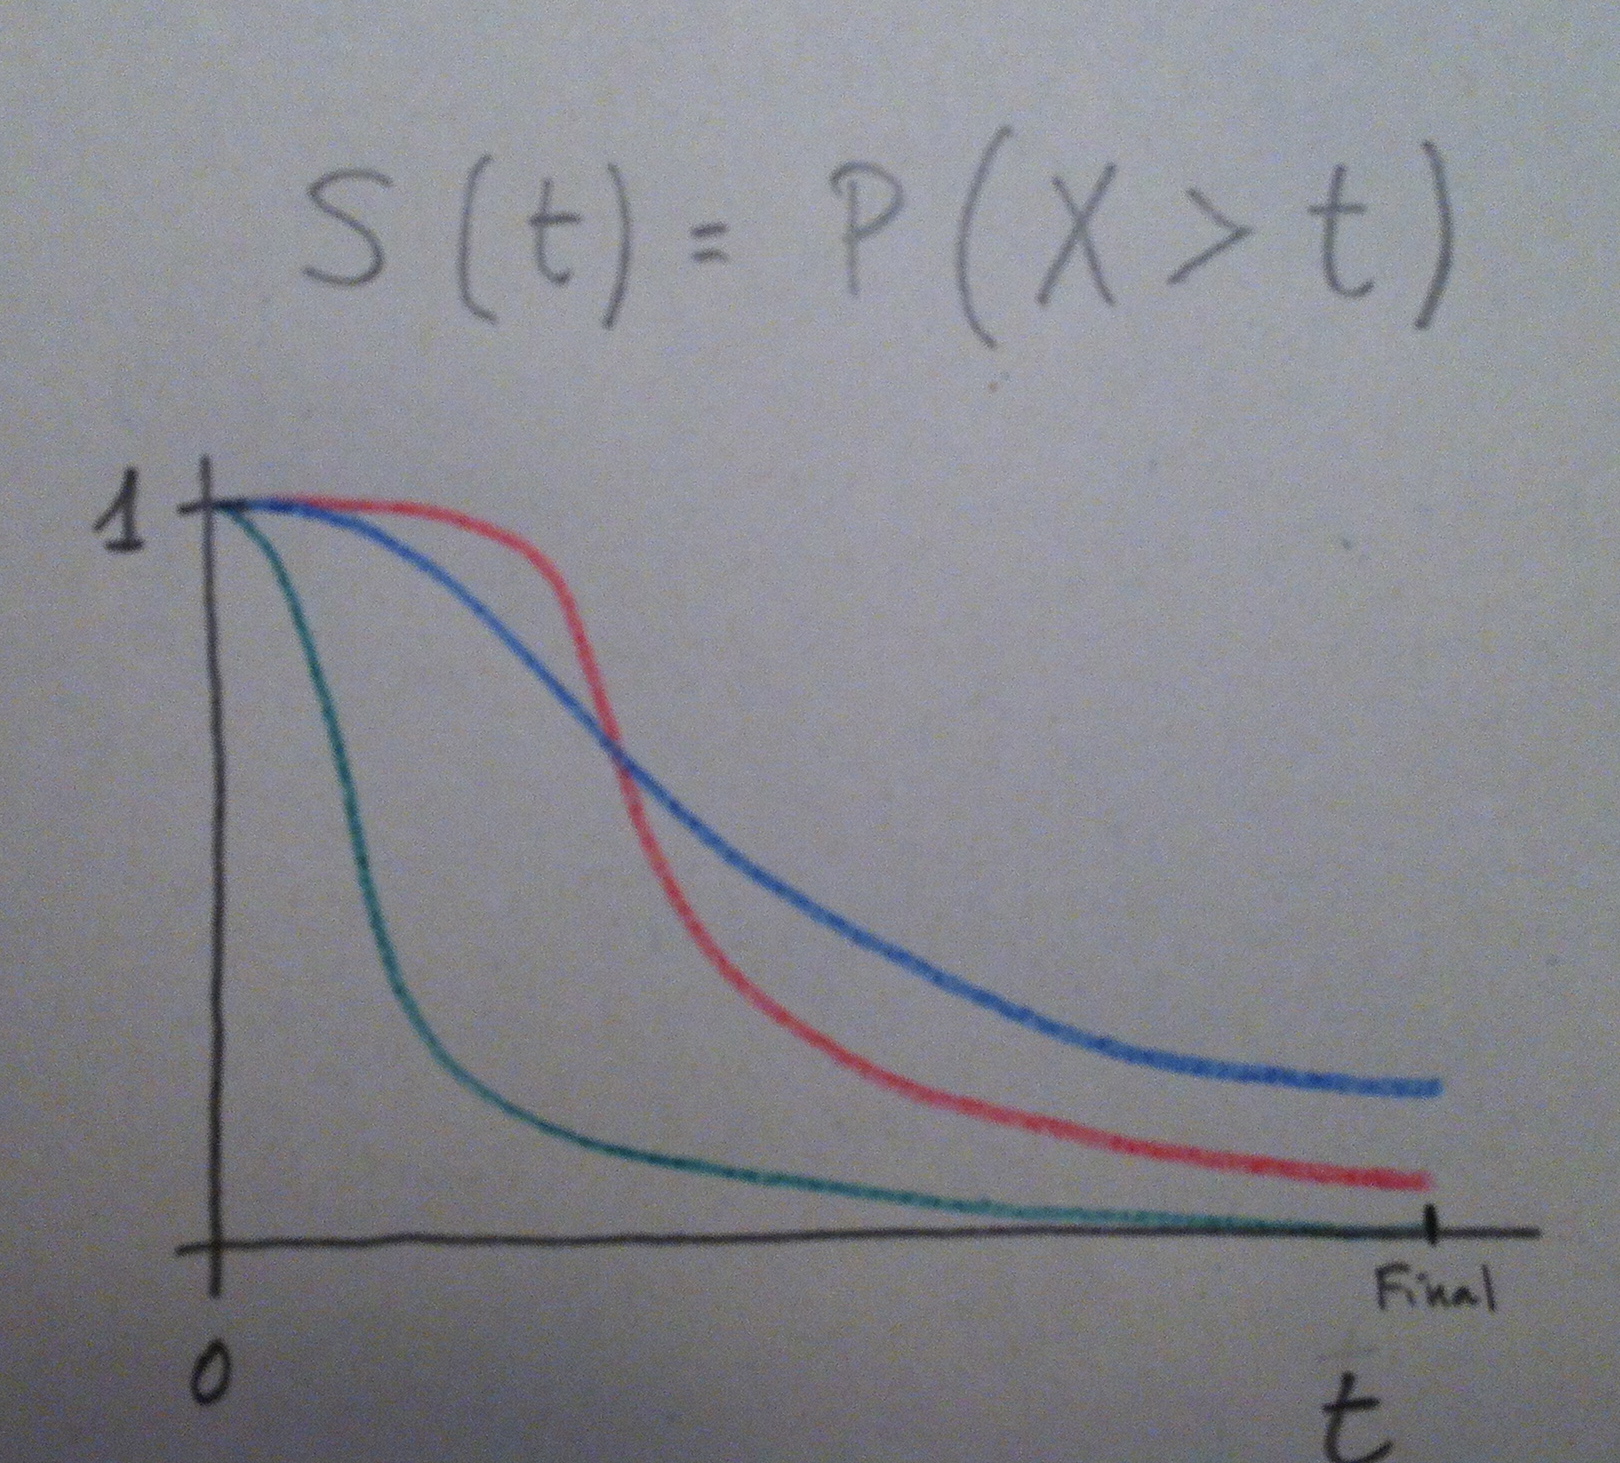
6. Se define y se dibuja la denominada función de supervivencia de la siguiente forma:
7. Hay en Análisis de supervivencia un enfoque paramétrico. Consiste en aceptar que un determinado tipo de función de distribución paramétrico nos sirve como modelo de esta evolución. Las funciones de distribución más habituales son la Exponencial y la Weibull:
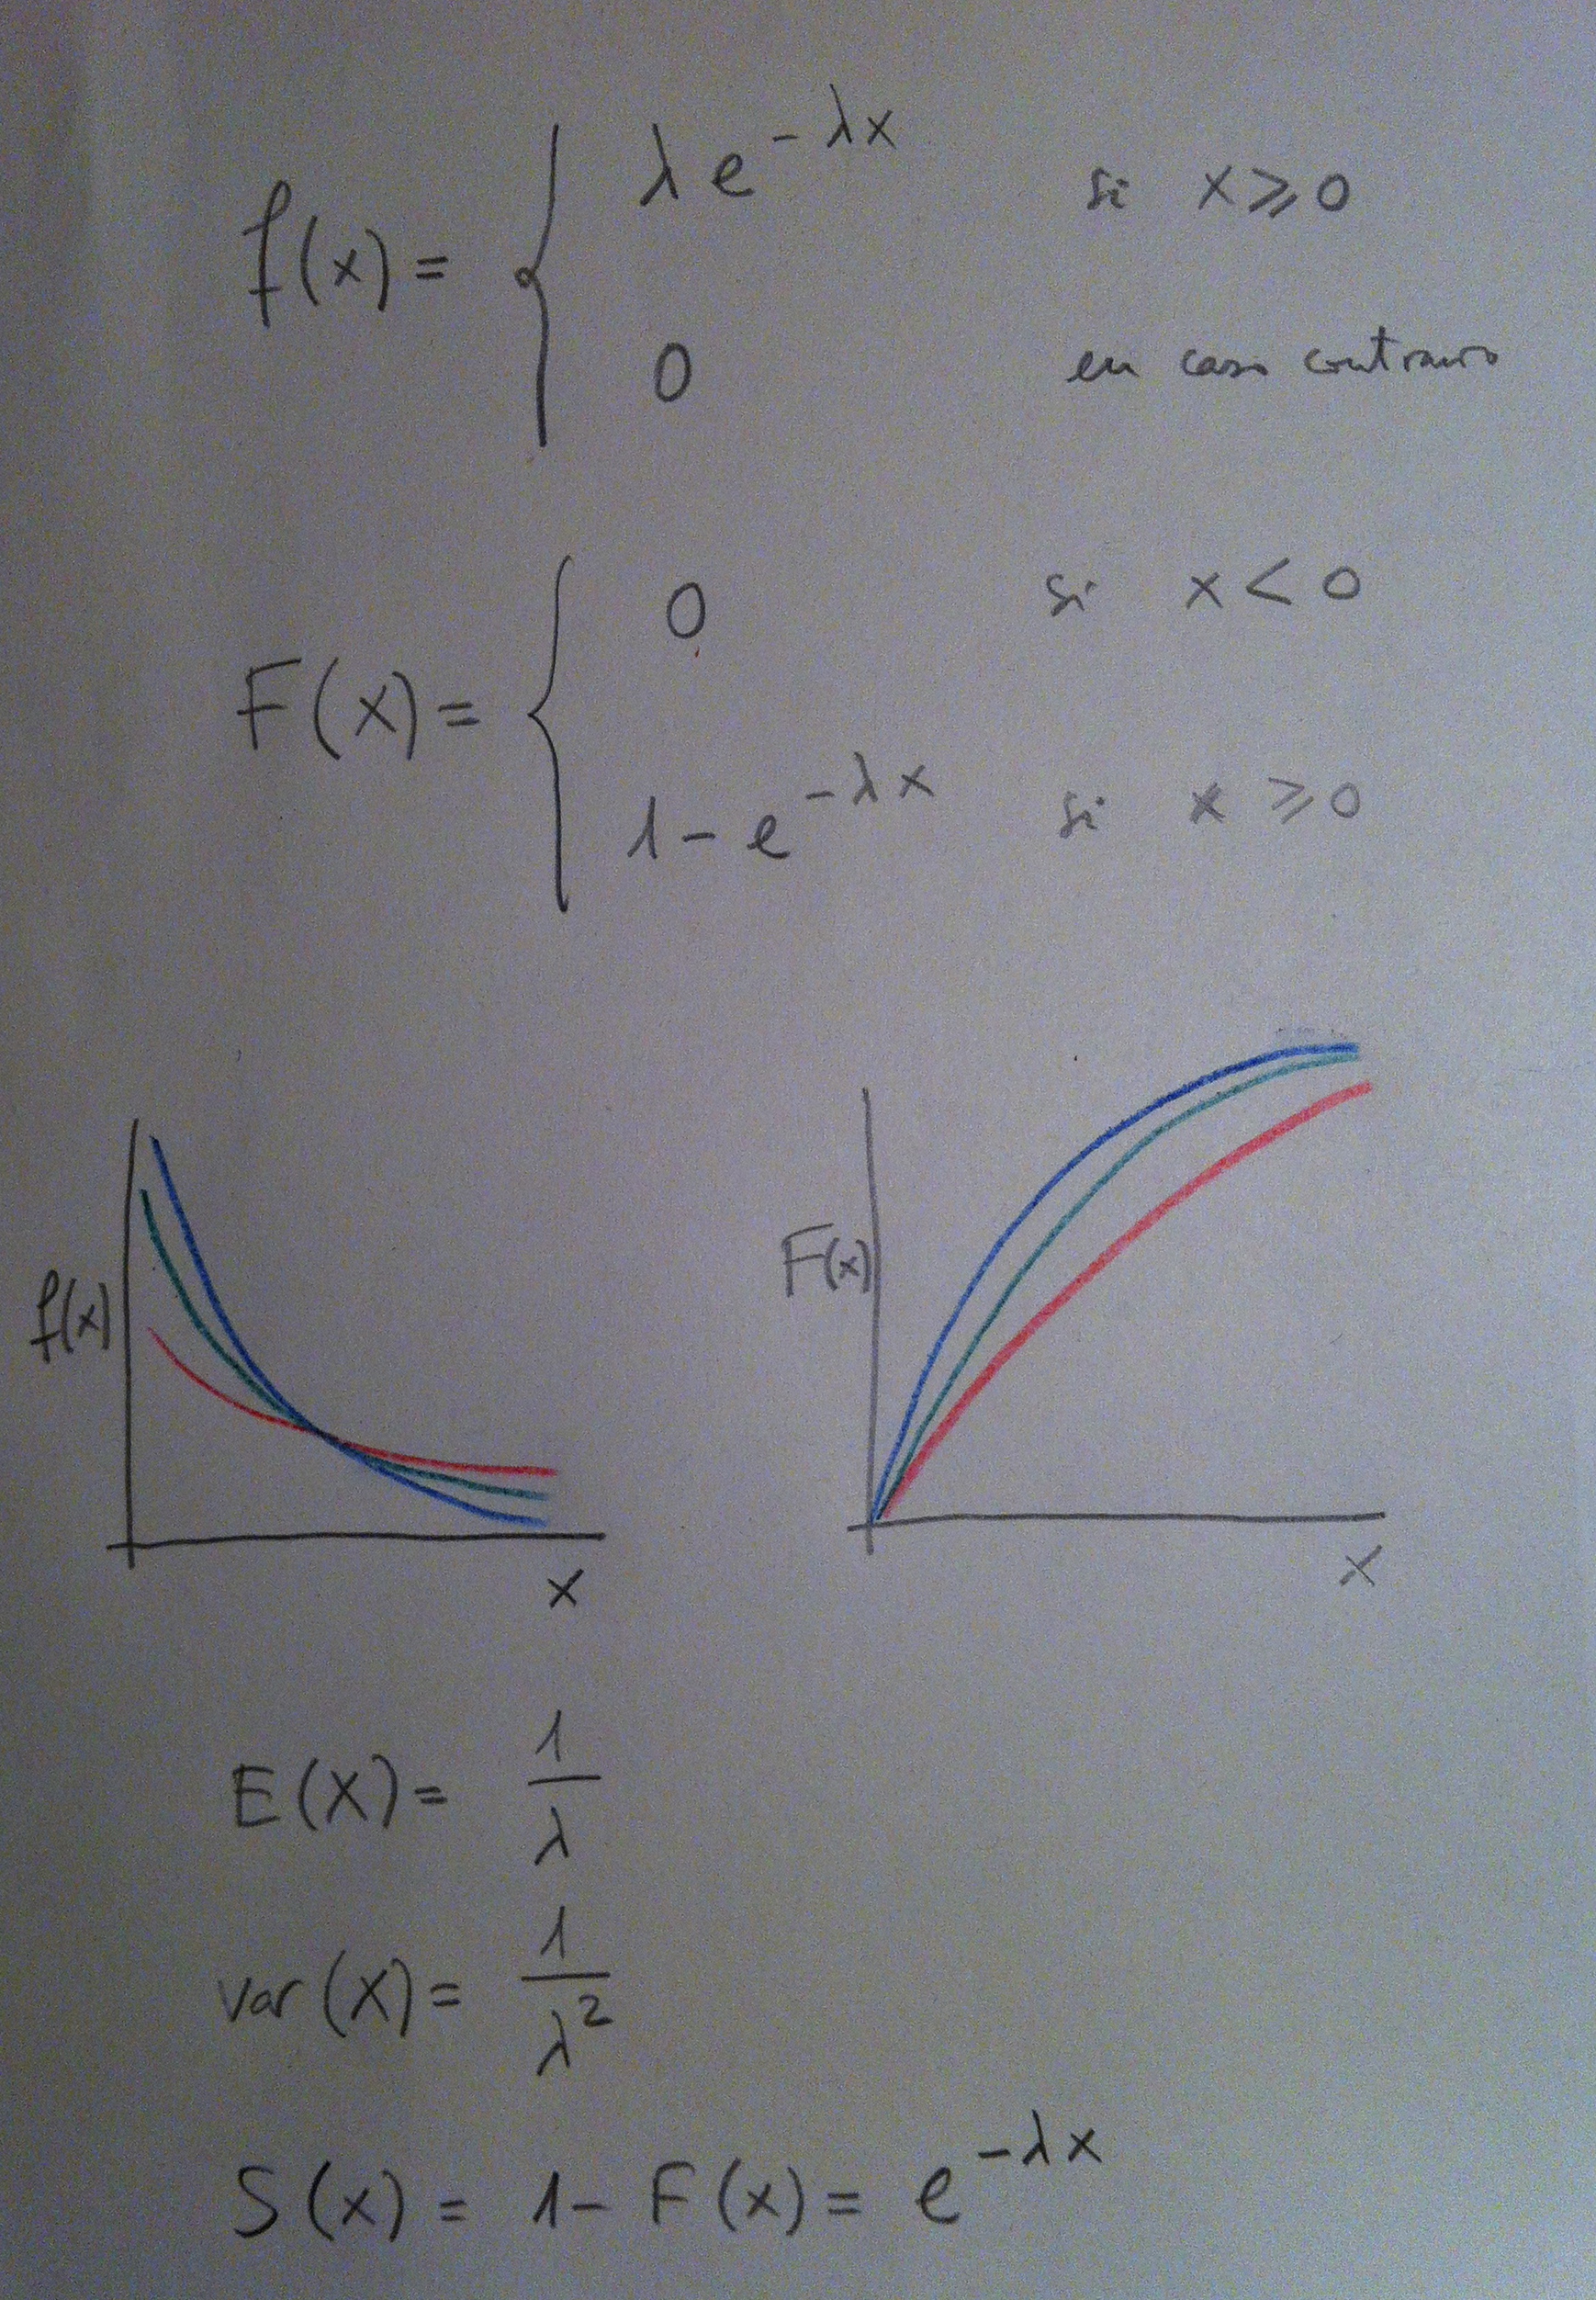
8. Una vez aceptado el modelo se trata, para una muestra determinada, de estimar el valor del parámetro único en la Exponencial o de los dos parámetros en la Weibull. Más en concreto, el modelo basado en la función de distribución exponencial, tiene las propiedades siguientes:
9. El Análisis de supervivencia paramétrico tiene la rigidez de tener que ajustarse los datos al modelo y esto con frecuencia no es así. Por eso, en la práctica, en Análisis de supervivencia, no es la opción más usada.
10. En Análisis de supervivencia han triunfado sin precedentes las técnicas no paramétricas. Posiblemente porque estamos ante un tipo de técnicas y de problemas que aparecen muchas más recientemente que otras técnicas clásicas en Estadística y esto ha provocado que ya se hayan desarrollado y utilizado mayoritariamente los procedimientos no paramétricos que tienen validez mucho más general.
11. De las técnicas de Análisis de supervivencia no paramétricas la más usada y popular es, sin lugar a dudas, el Estimador de Kaplan-Meier de la función de supervivencia.
12. El Estimador de Kaplan-Meier tiene la siguiente formulación:
13. Los gráficos que aparecen tras calcular su fórmula a una muestra tienen el aspecto siguiente:
14. En el artículo Estimador de Kaplan-Meier puede verse cómo, a partir de una muestra, se puede construir una curva de supervivencia como ésta.
15. En Análisis de supervivencia uno de los problemas estadísticos más frecuentes e interesantes es la comparación de curvas de supervivencia. El problema surge cuando tenemos dos o más grupos, cada uno con su muestra, y queremos ver si tenemos igualdad de curvas de supervivencia. El problema, pues, es comprobar si el Estimador de Kaplan-Meier aplicado a cada una de esas muestras nos permite deducir que las diferencias que vemos entre ellas son estadísticamente significativas o, por el contrario, pueden ser atribuibles al azar.
16. La Hipótesis nula será, en este caso, igualdad de curvas. En Estadística siempre se presupone la igualdad. También de curvas de supervivencia, que es lo que ahora nos ocupa. La Hipótesis alternativa será que hay diferencia entre esas curvas y que, por lo tanto, el suceso analizado se produce con ritmo distinto a lo largo del tiempo en los diferentes grupos analizados.
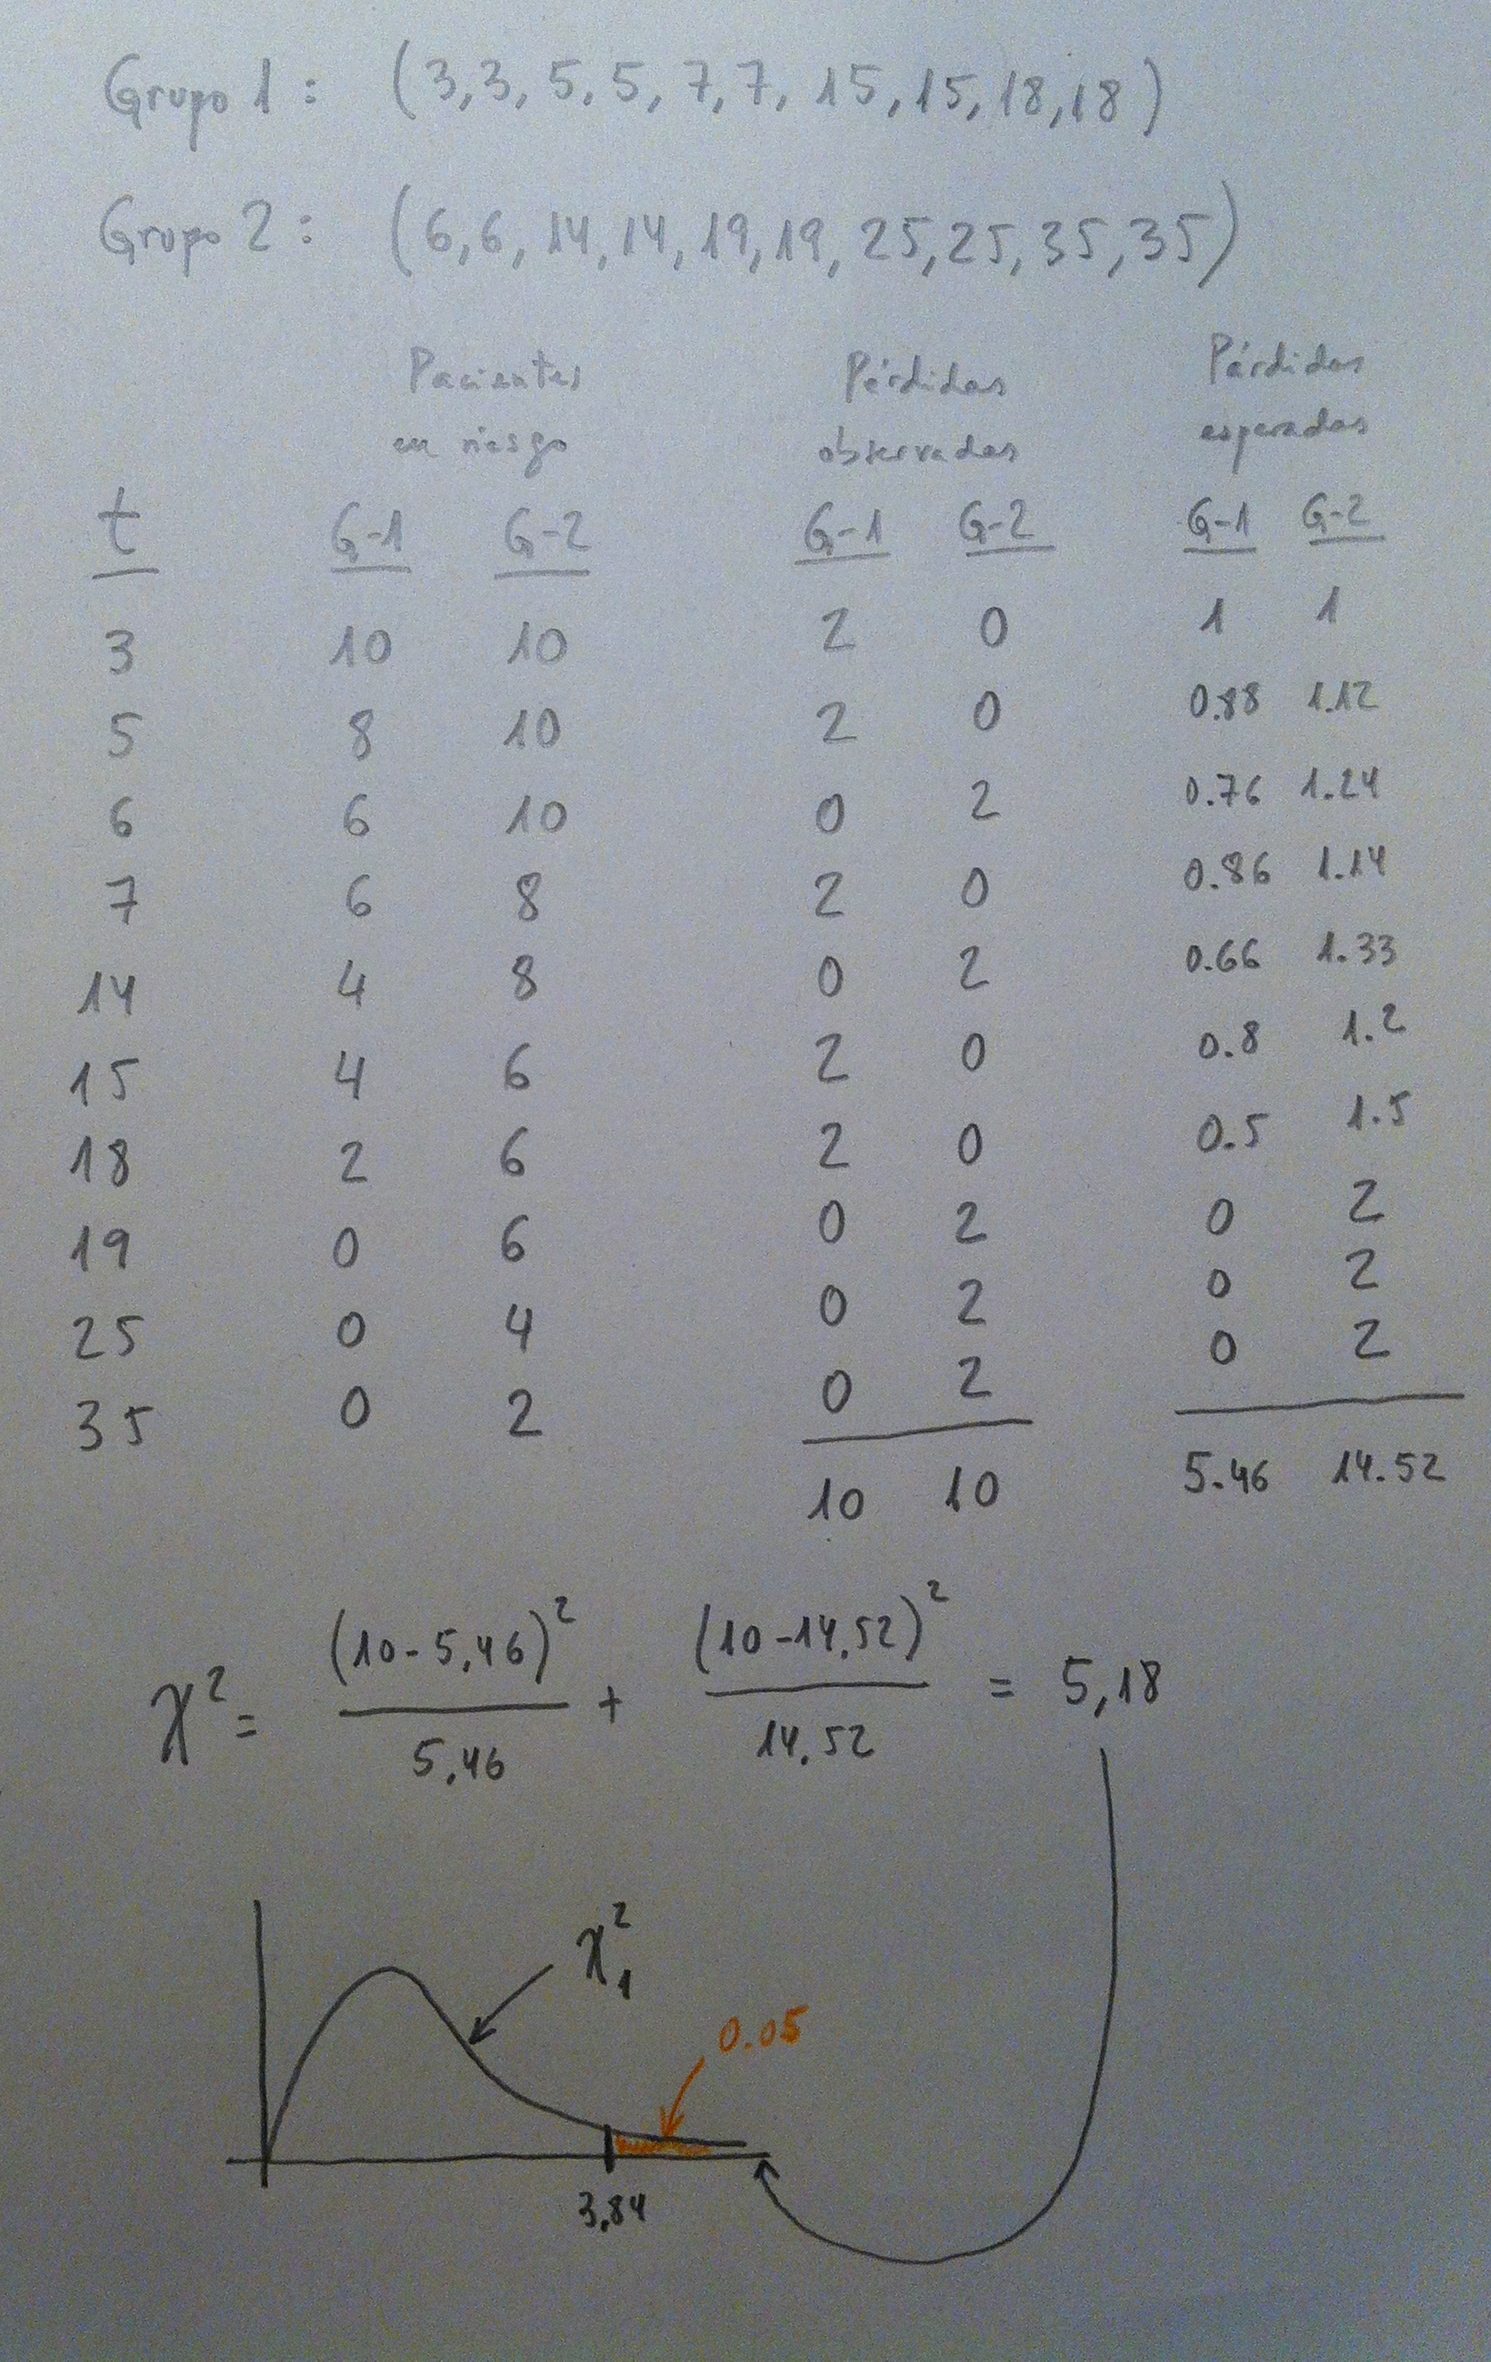
17. La técnica más usual para realizar esta comparación de curvas de supervivencia es el Test Log-Rank (Ver Herbario de técnicas). Es, de hecho, una técnica ji-cuadrado, donde se realiza una comparación entre un observado (las curvas de supervivencia muestrales) y un esperado (reuniendo todos los valores en una única muestra).
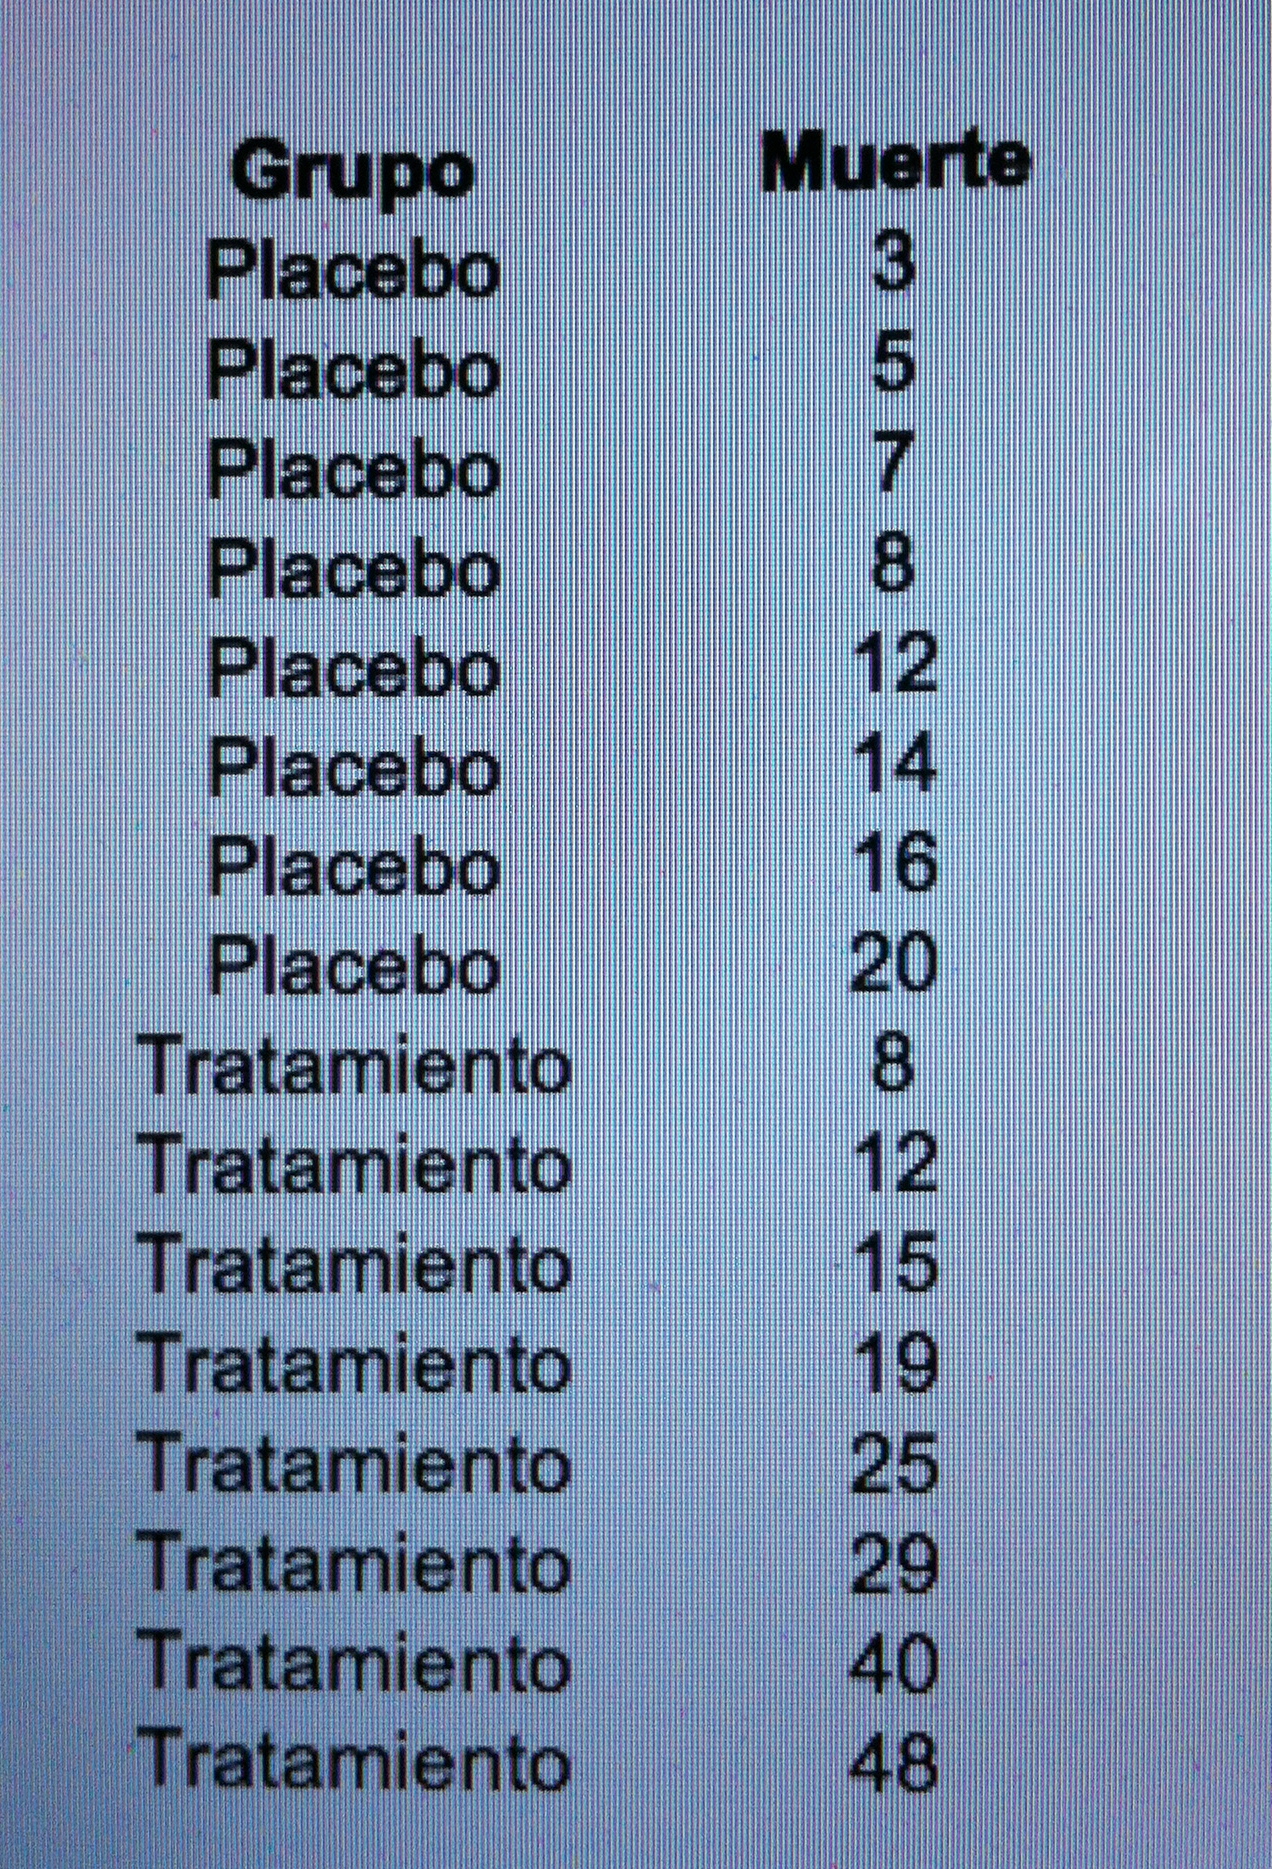
18. Vamos a ver una aplicación concreta de Análisis de supervivencia y de comparación de curvas de supervivencia. Supongamos un caso donde, pacientes con una misma patología, un grupo de ellos son tratados con placebo y otro grupo con un determinado tratamiento que se quiere evaluar. Y obtenemos los siguientes tiempos (en las unidades temporales que se sean, aquí es lo de menos):
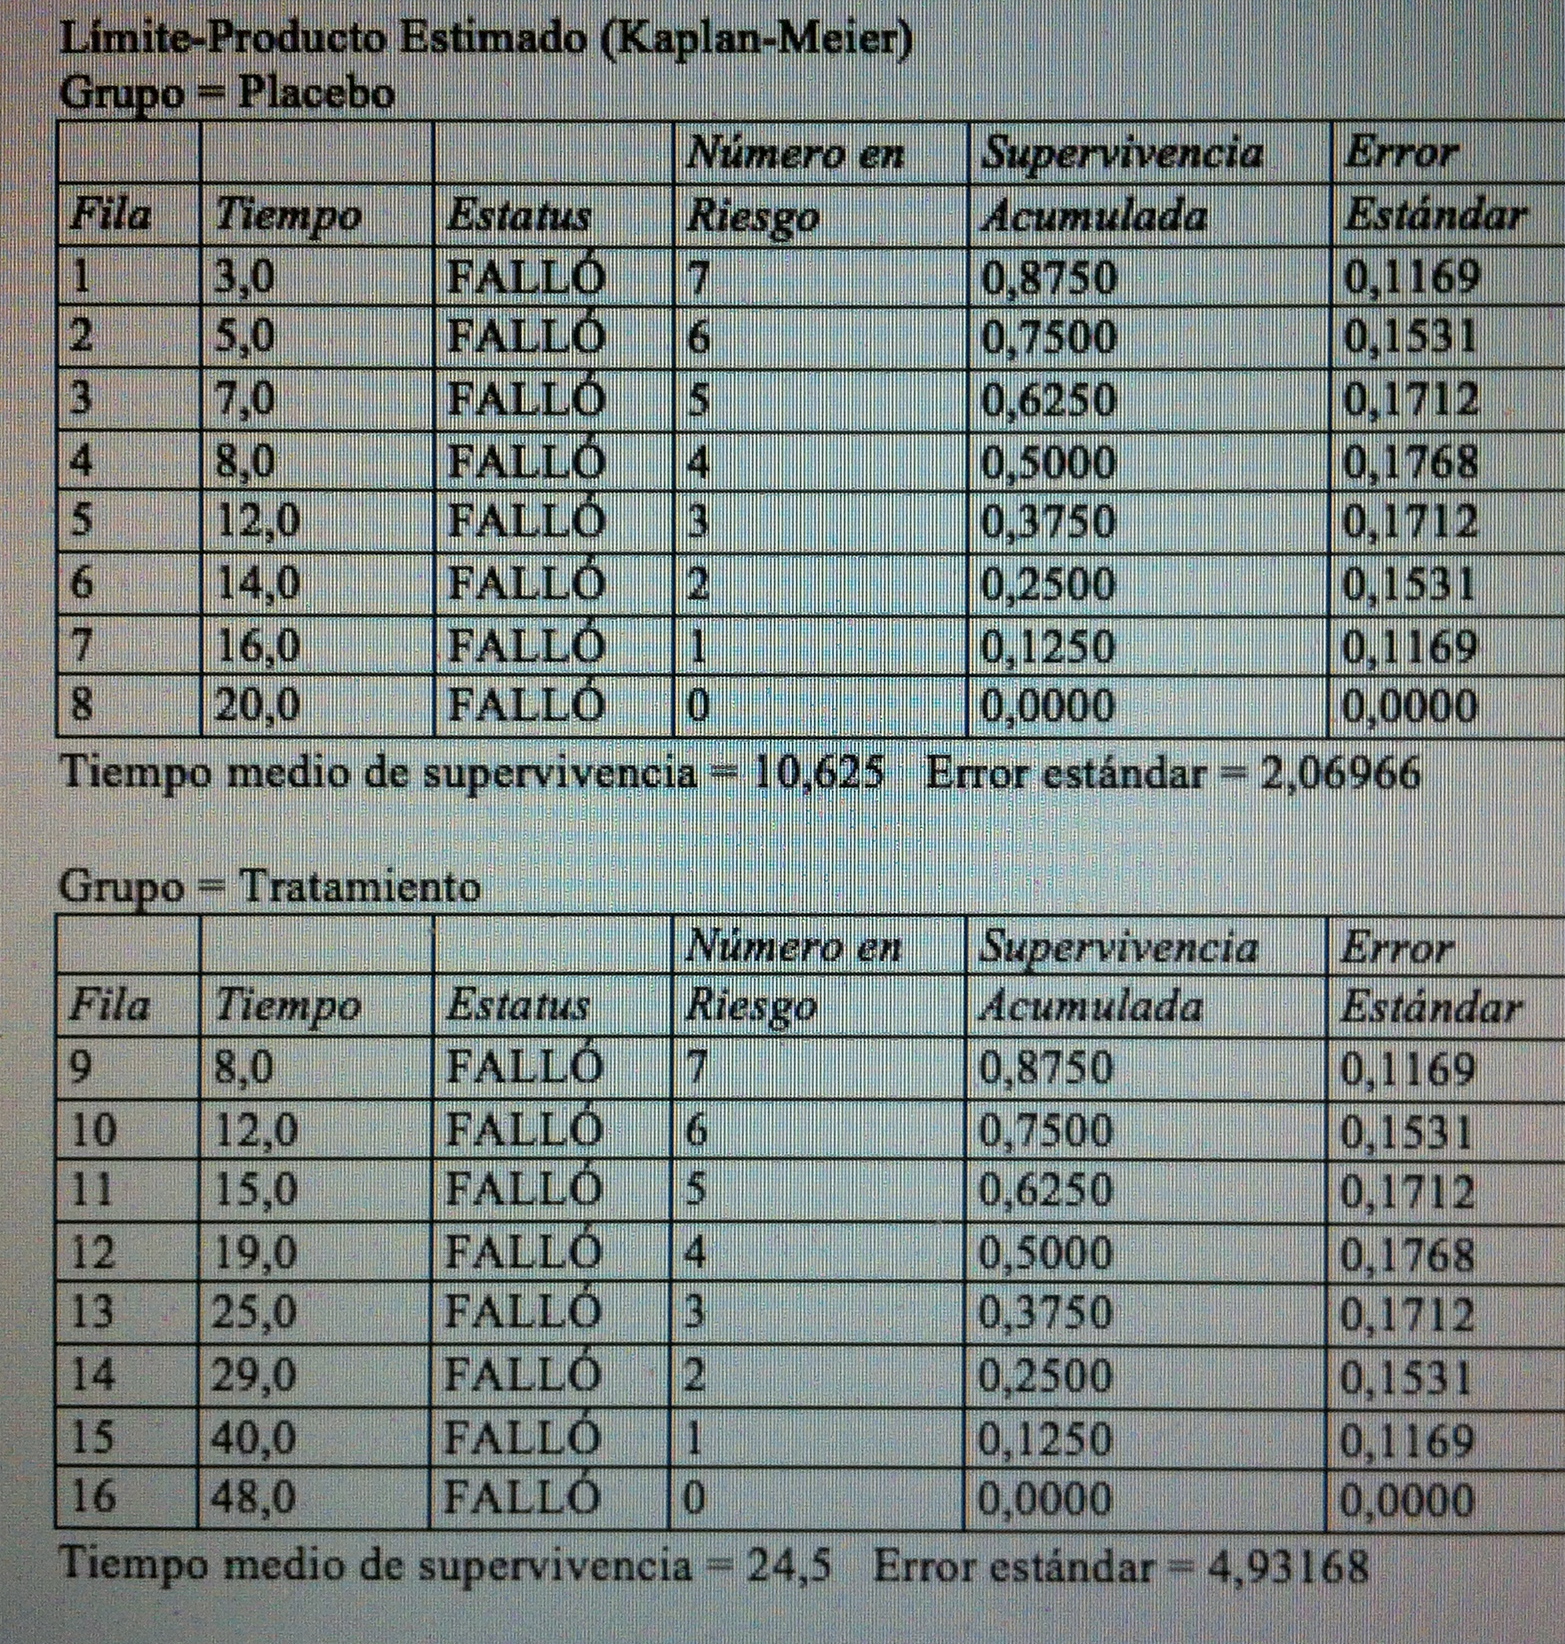
19. Si calculamos el Estimador de Kaplan-Meier a estos dos grupos tenemos los siguientes valores:
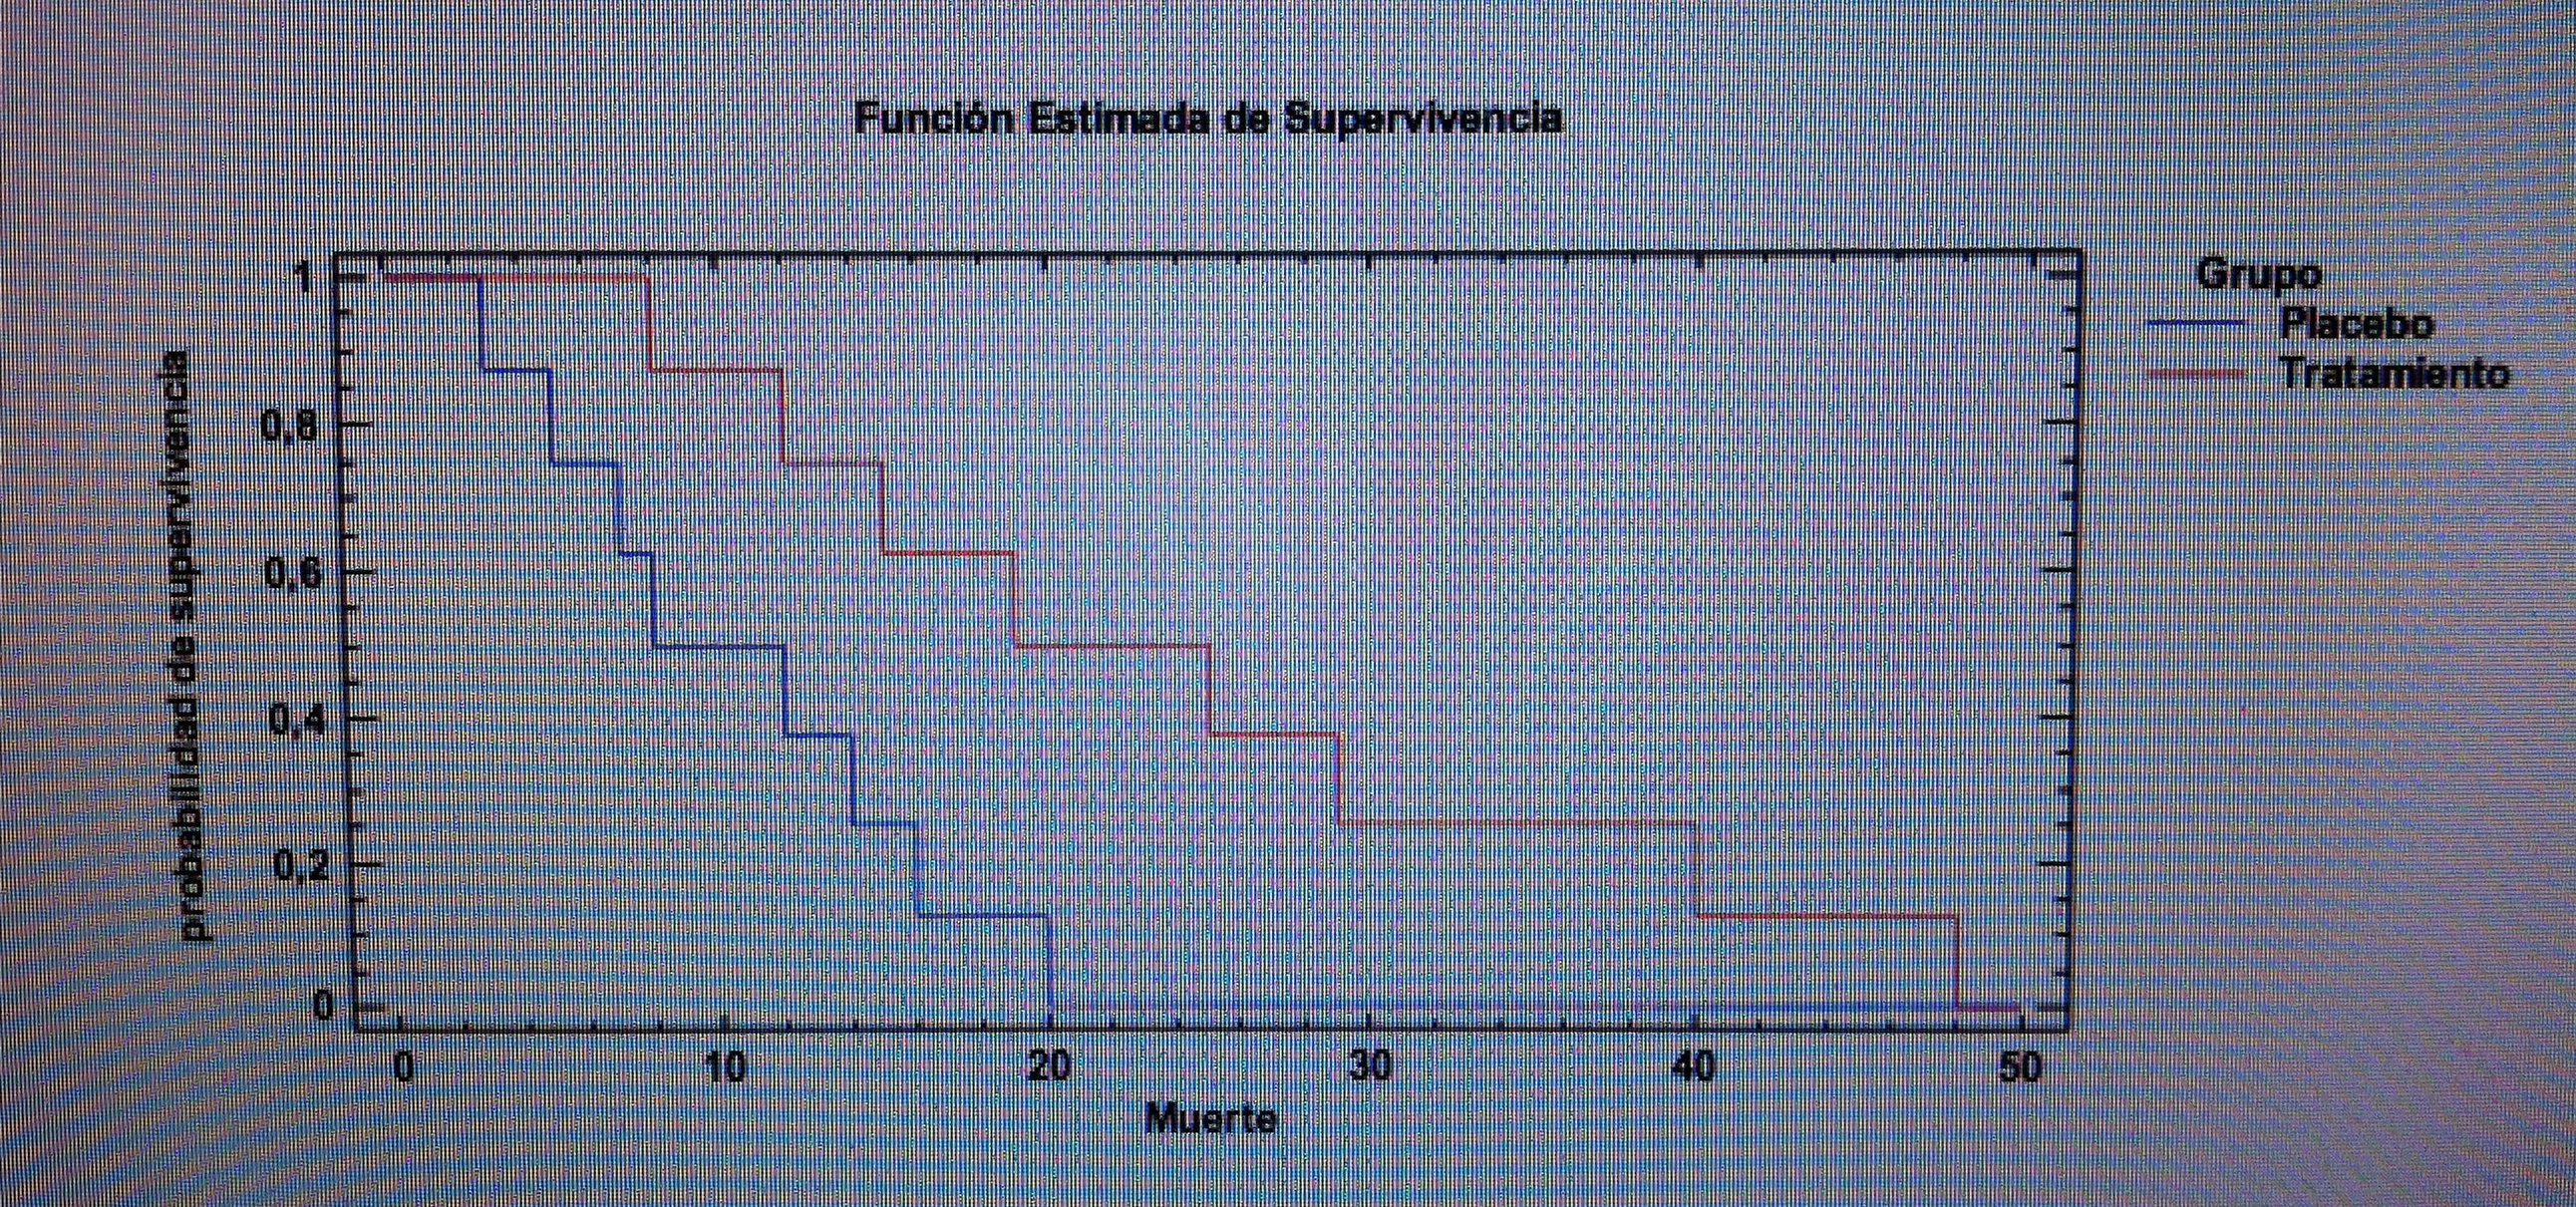
20. Y estos valores se materializan en las siguientes curvas de supervivencia:
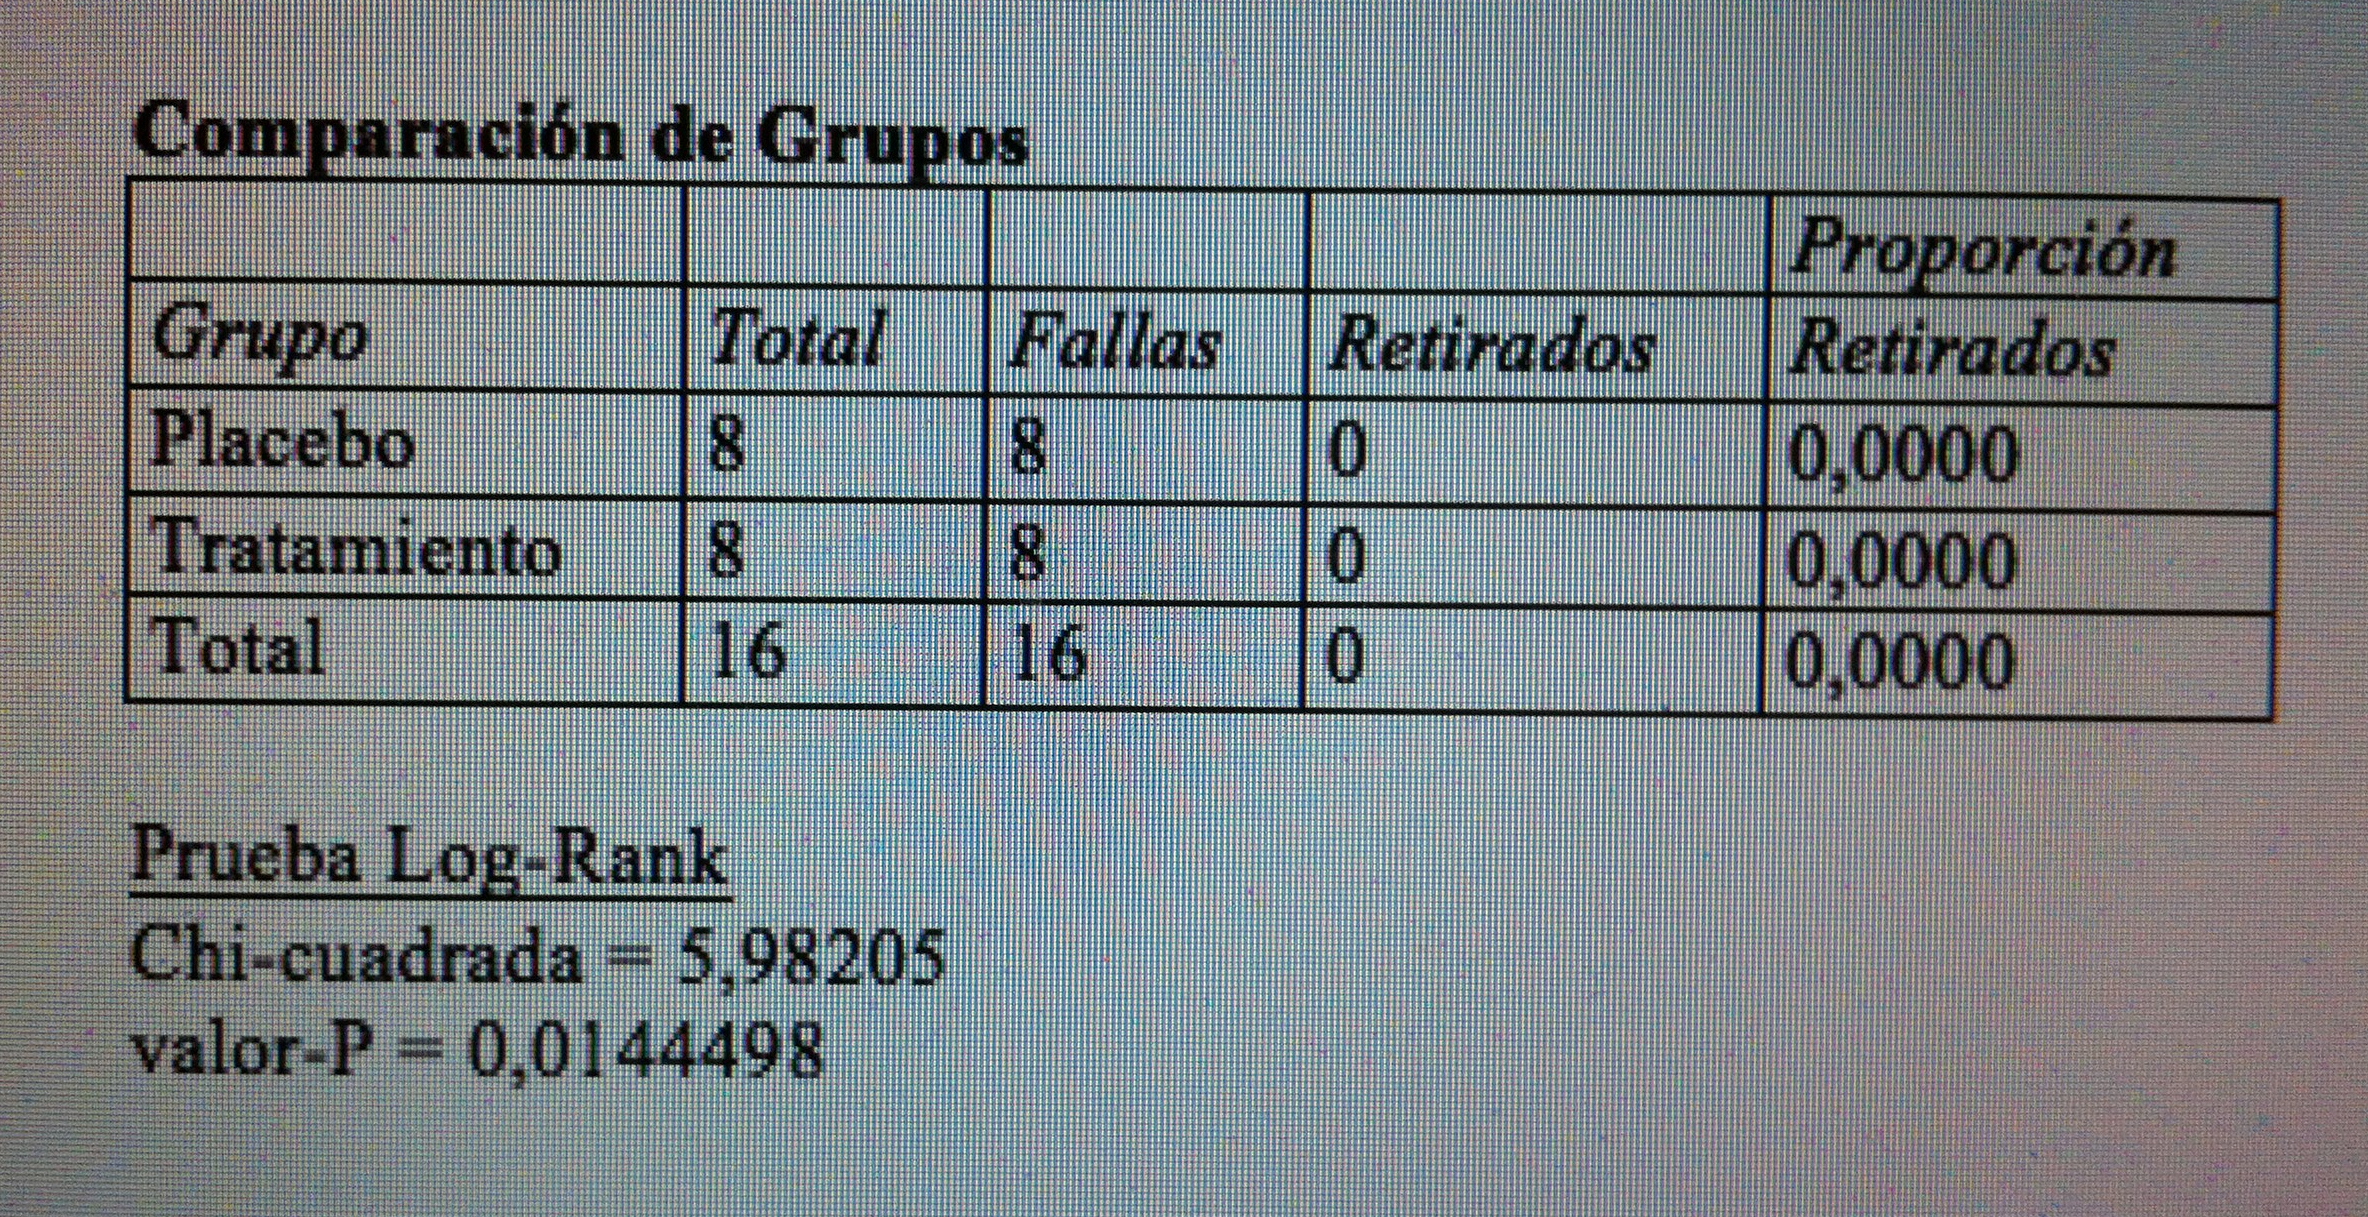
21. Si ahora aplicamos el Test Log-Rank para comprobar si estas diferencias muestrales son diferencias significativas obtenemos el resultado siguiente:
22. Este test nos indica que las diferencias entre ambas curvas no son debidas al azar, son significativas. El p-valor del test es 0.0144 y como es menor que 0.05 rechazamos la Hipótesis nula de igualdad de curvas. Lo que indica que la supervivencia se alarga como consecuencia del tratamiento.
23. En el contexto del Análisis de supervivencia es muy usual trabajar con la función de riesgo (Hazard function). La definición de esta función es la siguiente:
24. Observemos que la función de riesgo h(t) es una medida de la probabilidad de que se produzca el suceso estudiado entre los que quedan sin haber sufrido todavía tal suceso. Es realmente una función que evalúa, puntualmente, en un período de tiempo determinado, la probabilidad de que un individuo de los que todavía no han sufrido tal suceso lo sufra precisamente en ese período de tiempo. Es, por lo tanto, realmente, una función que mide el riesgo en un período de tiempo concreto.
25. Supongamos que estamos evaluando, como sucede muchas veces, el tiempo de vida de una serie de personas que están bajo ciertas condiciones. En estas circunstancias, la función de riesgo cuantifica puntualmente la probabilidad de muerte entre los que quedan en vida. Si se analiza con un poco de detenimiento su formulación esto es lo que realmente mide la función de riesgo h(t).
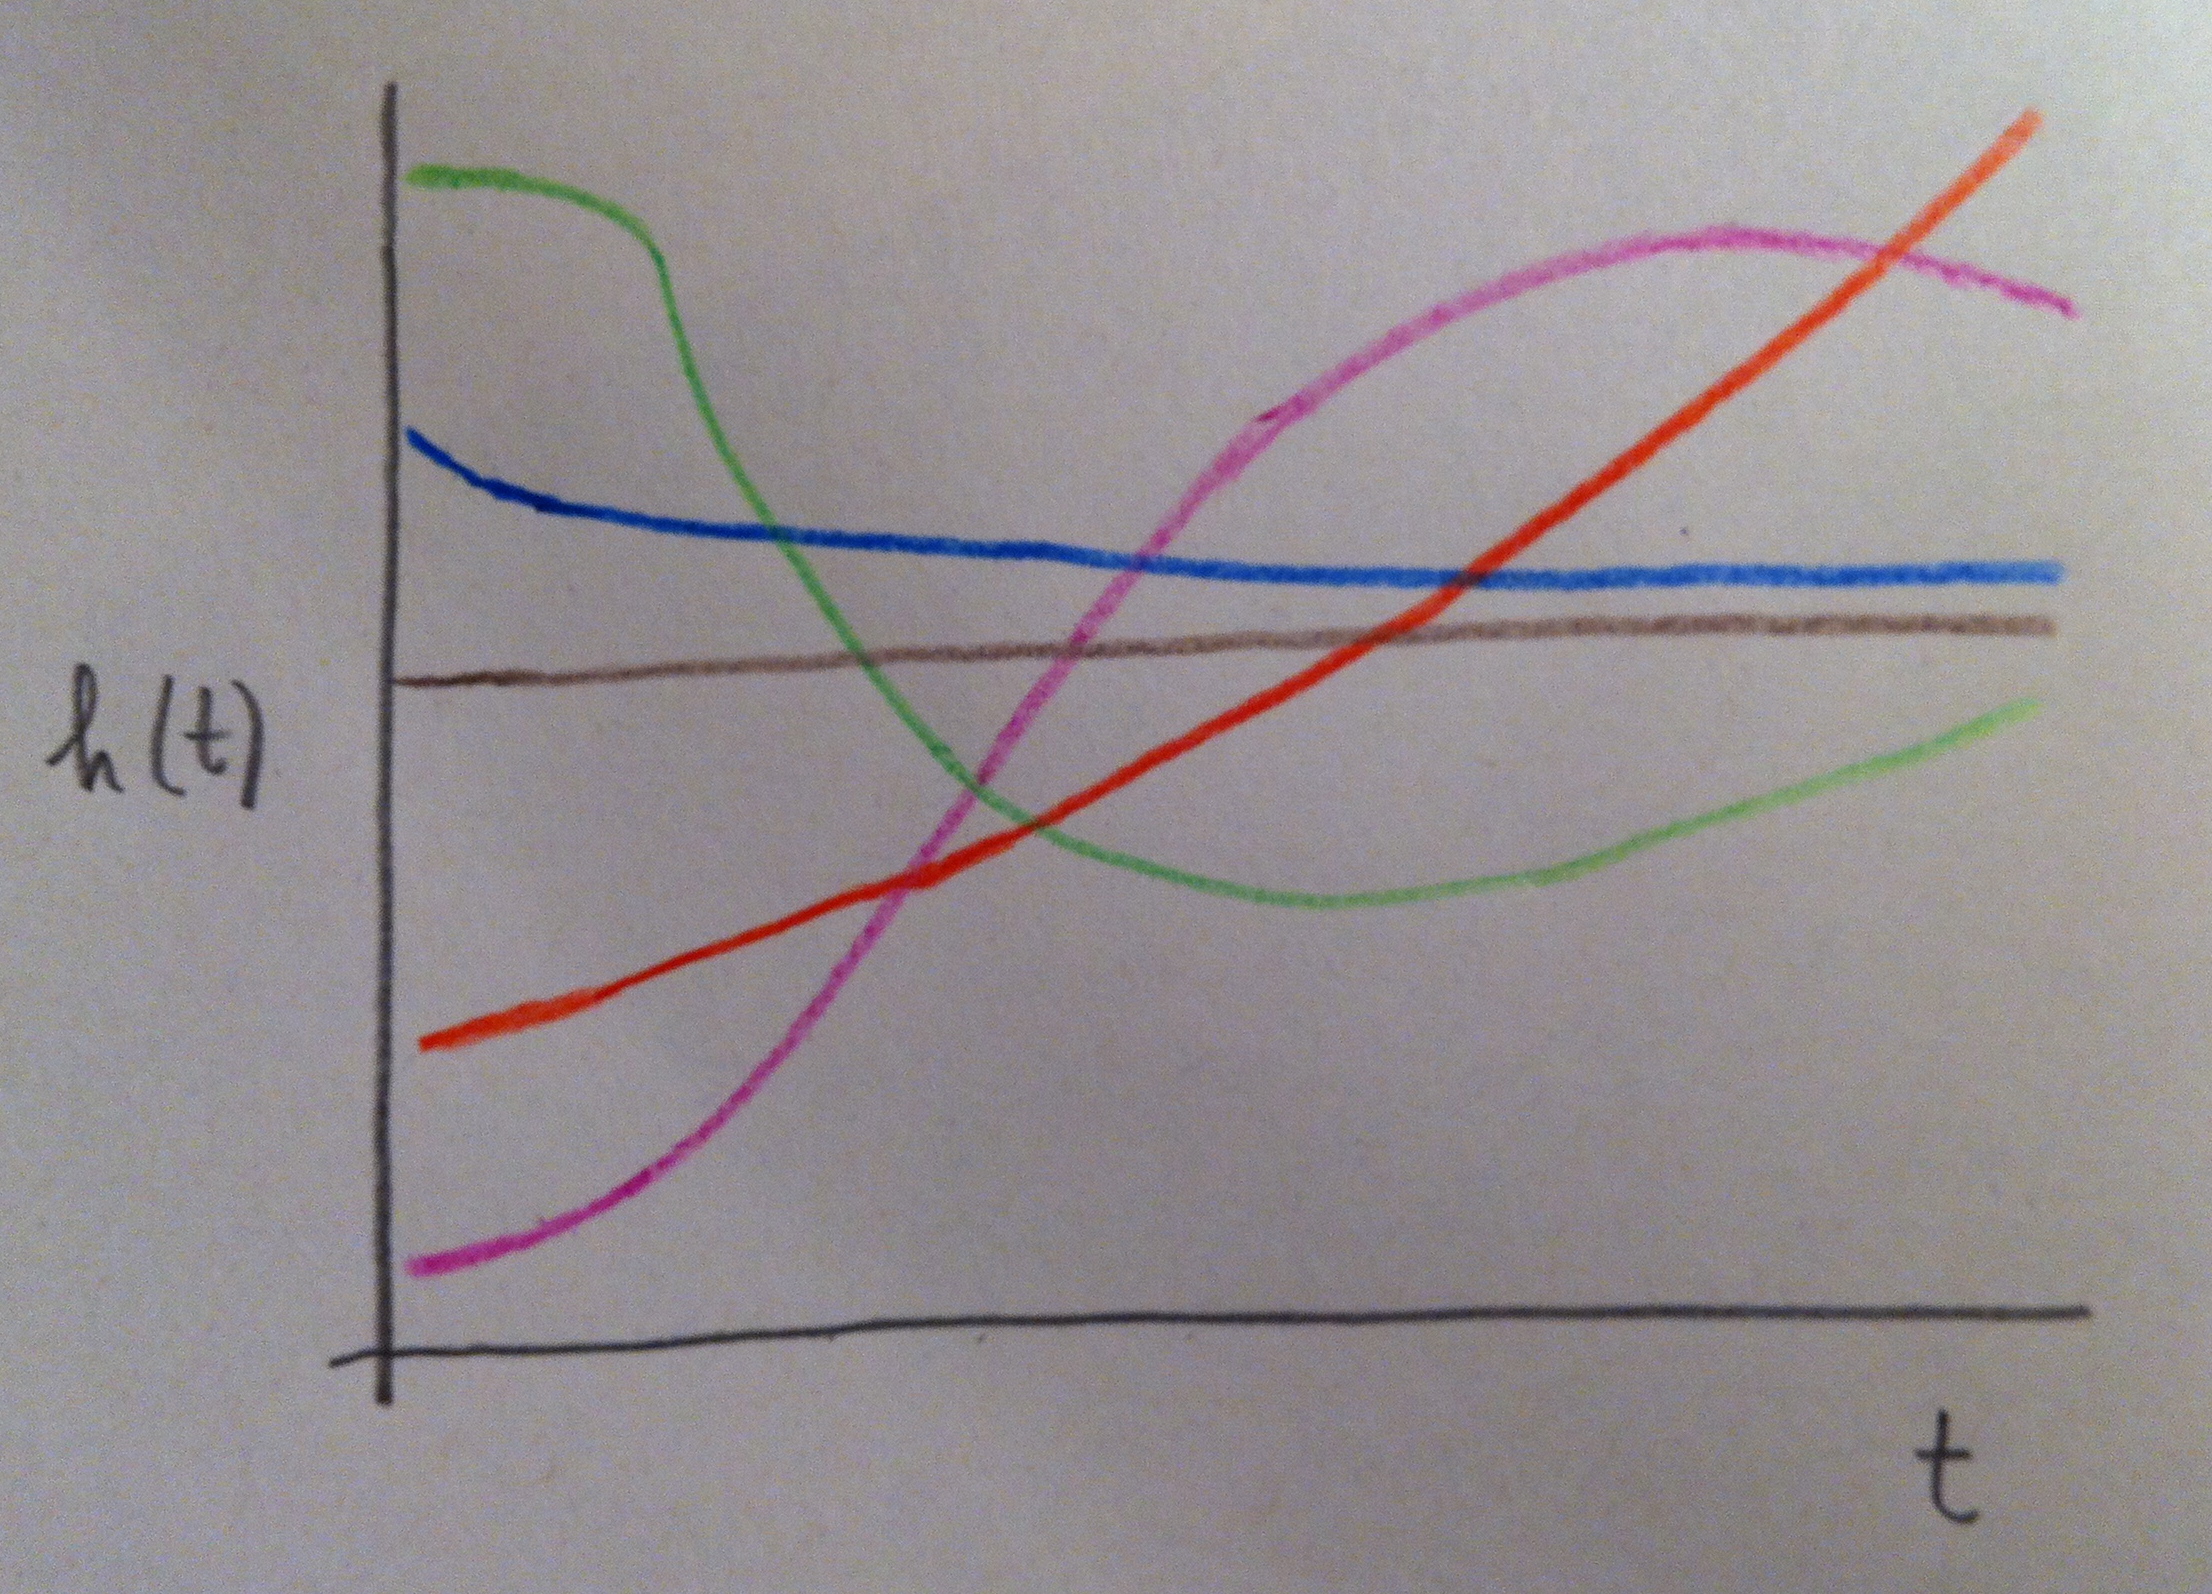
26. La forma de la función de riesgo puede ser muy distinta según los datos que estemos analizando. Nos podemos encontrar con funciones de riesgo tan distintas como las siguientes:
27. La función de riesgo puede ser creciente, decreciente, constante, y cualquier combinación de estas últimas a trozos dentro del dominio t.
28. Por ejemplo, la función exponencial, como modelo paramétrico, cuya función ya hemos visto antes, nos aporta un modelo con función de riesgo constante. Veamos por qué:
29. Observemos las tres curvas de supervivencia asociadas a las tres distintas funciones exponenciales. El hecho de que la función de riesgo sea constante indica que la altura de la curva respecto al área que queda a la derecha del punto temporal en el que estemos es siempre el mismo valor: lambda, que es el parámetro de esta función de distribución.
30. Muchas veces además de la función de riesgo se usa también la función acumulada del riesgo, que es la siguiente función:
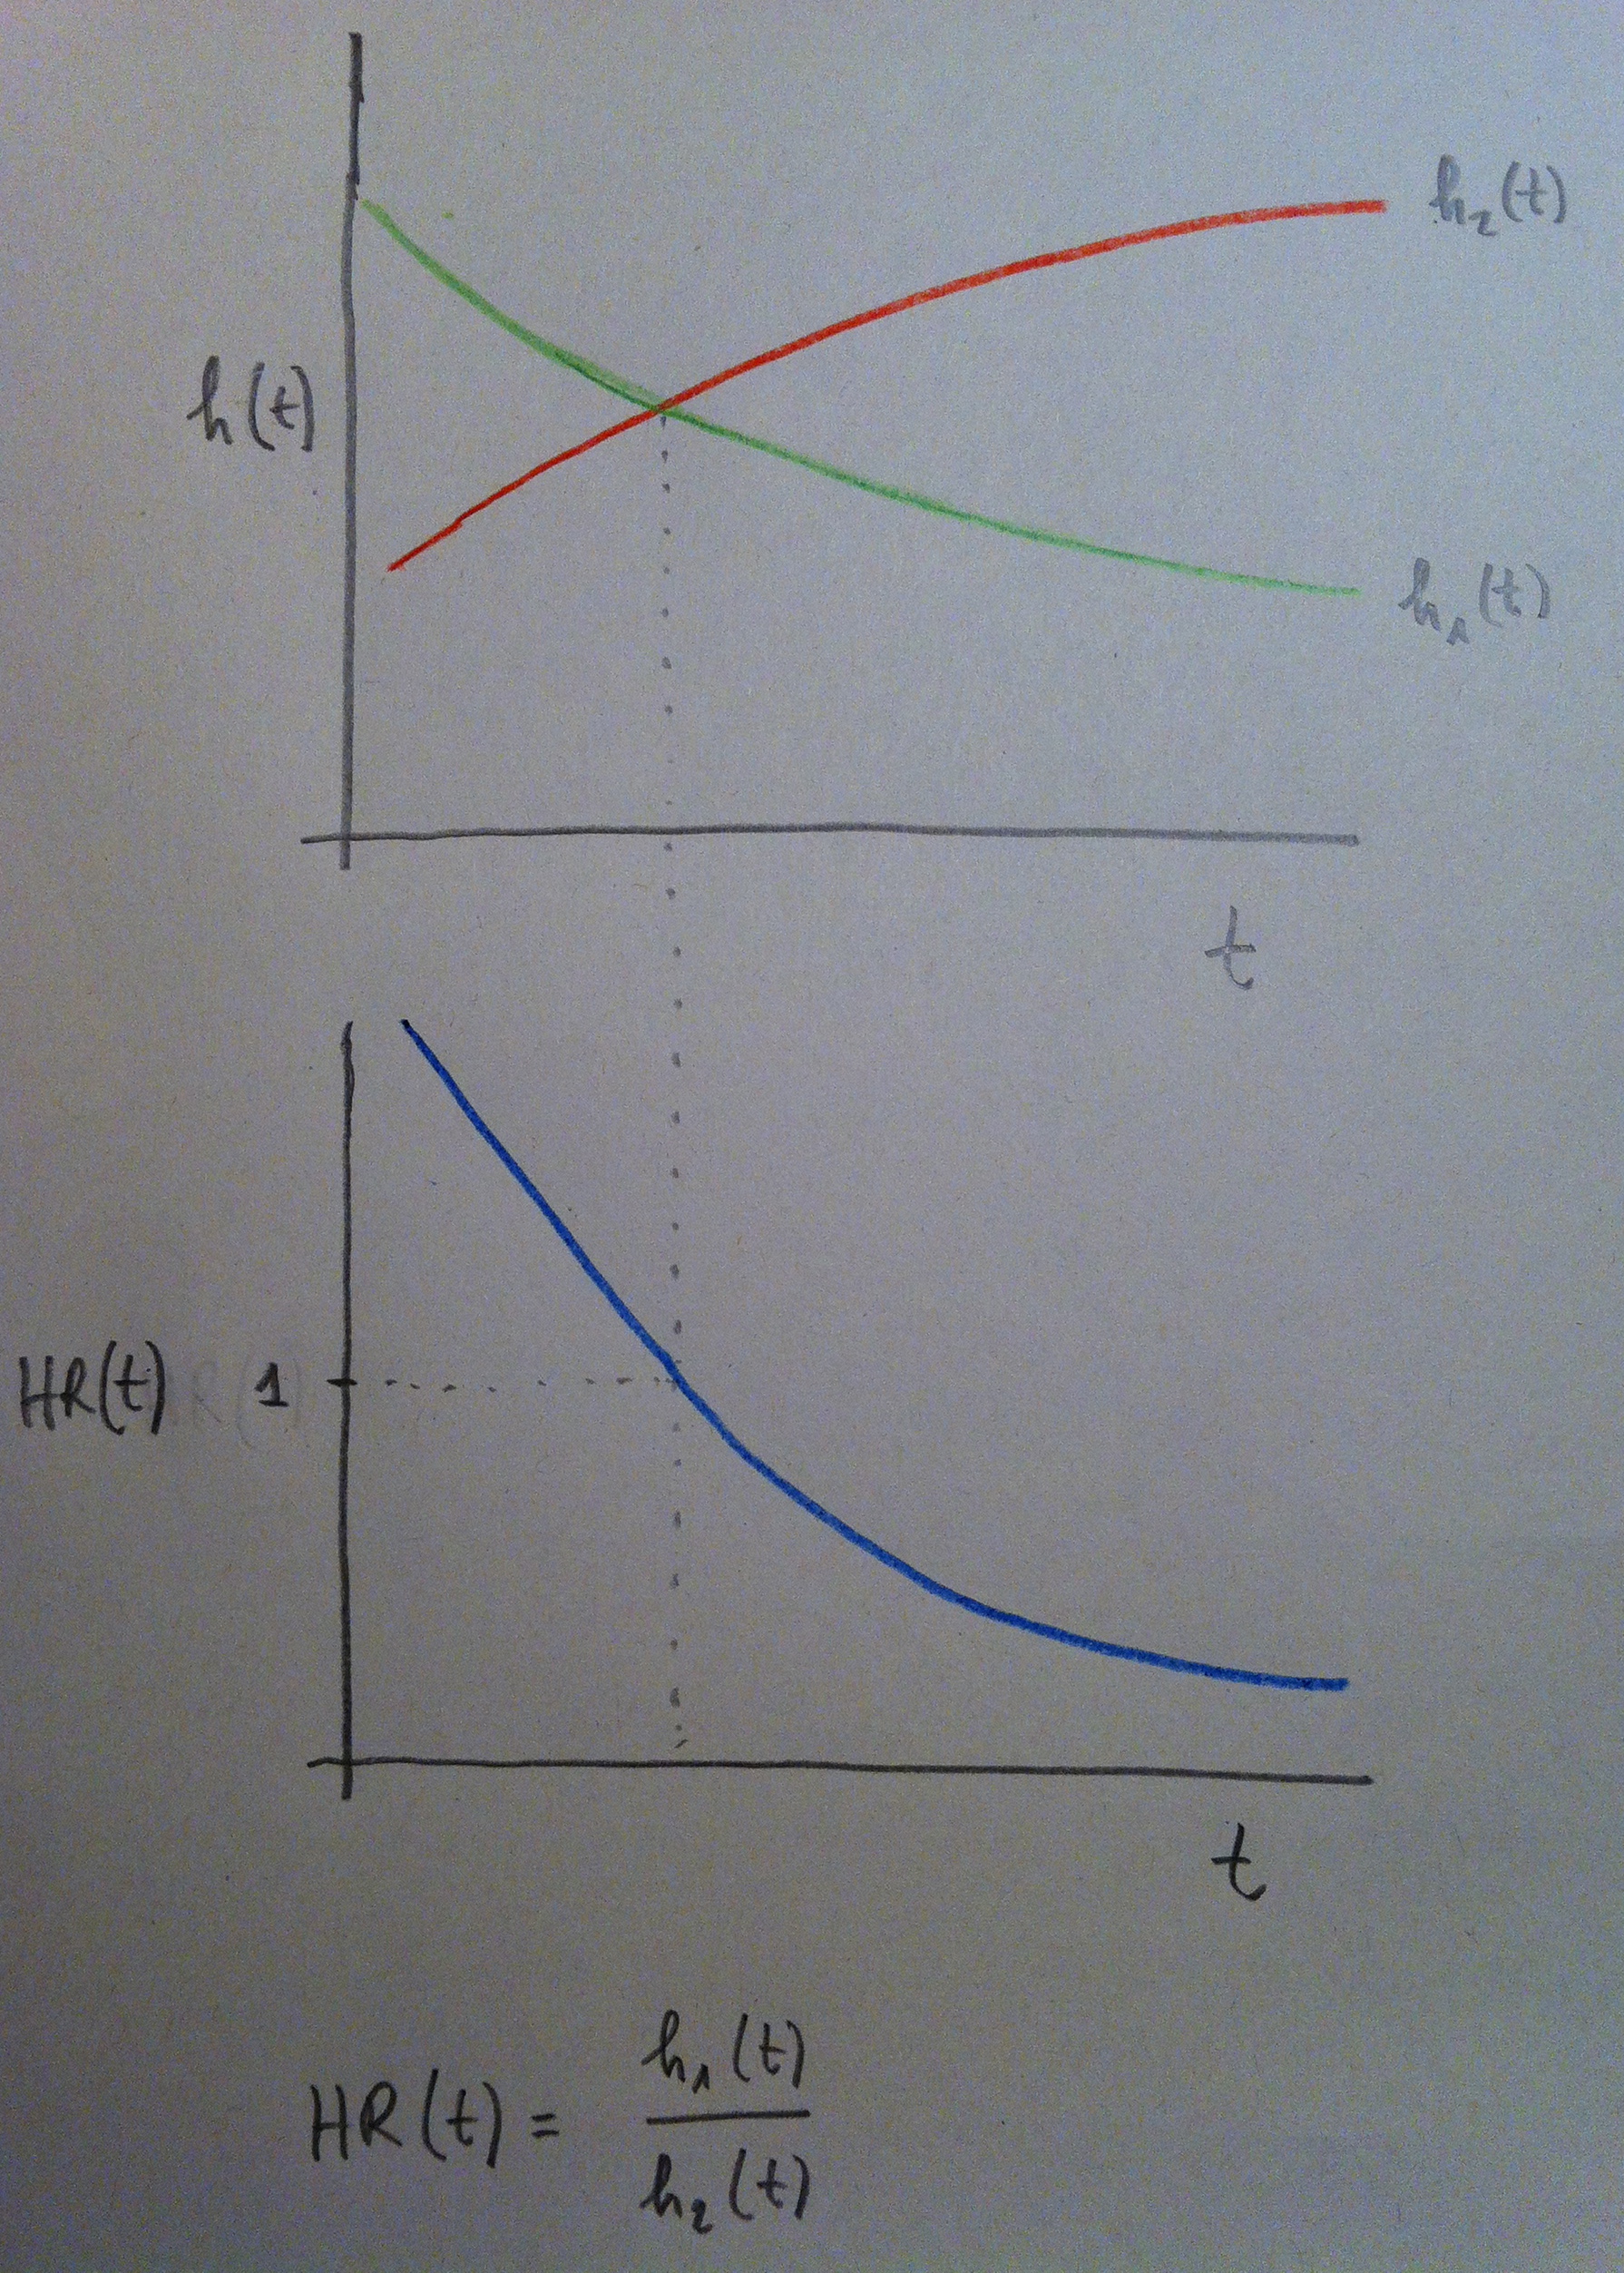
31. Otro concepto importante en Análisis de supervivencia es el de Hazard ratio que es una razón de riesgos. El Hazard ratio no es más que el cociente entre dos funciones de riesgo.
32. El Hazard ratio es una función que toma valores que van de cero a infinito, como la Odds ratio. Cuando toma valores por encima de 1 significa que una de las funciones de riesgo va por encima y si es menor que 1 que las posiciones de las curvas es la contraria. Si toma el valor de 1 las dos curvas están a la misma altura. Se construyen, evidentemente, intervalos de confianza de estos Hazard ratios, para ver si se solapan o no. Se realizan, también, por supuesto, contrastes de hipótesis, donde la Hipótesis nula es que el Hazard ratio es 1.
33. El Hazard ratio, como decimos, es, en realidad, una función, porque la posición relativa de ambas funciones de riesgo puede cambiar a lo largo del tiempo. Sin embargo, en muchos ocasiones, se supone una función constante y, por esto, en muchas ocasiones, el Hazard ratio, se maneja como un número, pero, esencialmente, es una función: la función cociente de las dos funciones de riesgo.
34. El siguiente gráfico aclarará posiblemente la noción de Hazard ratio (HR):
34. Como puede apreciarse el HR es una función del tiempo. Es una relación temporal entre funciones de riesgo. Puede ser constante, pero en general no lo será.
35. Observemos, pues, que en Análisis de supervivencia la finalidad básica es estimar la función de supervivencia, función que en ocasiones se expresa en forma de función de riesgo. Y una vez dibujada esta estimación de la función de supervivencia uno de los objetivos más frecuentes es compararla con otra y valorar si la diferencia muestral que vemos es una diferencia estadísticamente significativa.
El Estimador de Kaplan-Meier es un estimador no paramétrico de la función de supervivencia. Se basa en la fórmula siguiente:
Veamos un ejemplo, basado en la siguiente muestra de valores de supervivencia expresados en unidades de tiempo:
(4, 6, 7c, 8, 10, 10, 10, 15c, 20, 25)
donde la c añadida a un valor indica que el valor es censurado, que significa que o bien ha salido del estudio o que el estudio ha terminado y todavía este individuo no le había sufrido el suceso estudiado.
Veamos a continuación cómo se calcularía con estos valores la información necesaria para construir la función de Kaplan-Meier:
Cuando un valor es censurado se salta, lo que significa que su información se asocia a valores próximos. Por lo tanto, es una información que se utiliza. Lo mismo sucede con valores repetidos, se calculan valores sólo del último. Pero, evidentemente, los demás quedan asociados a este último valor.
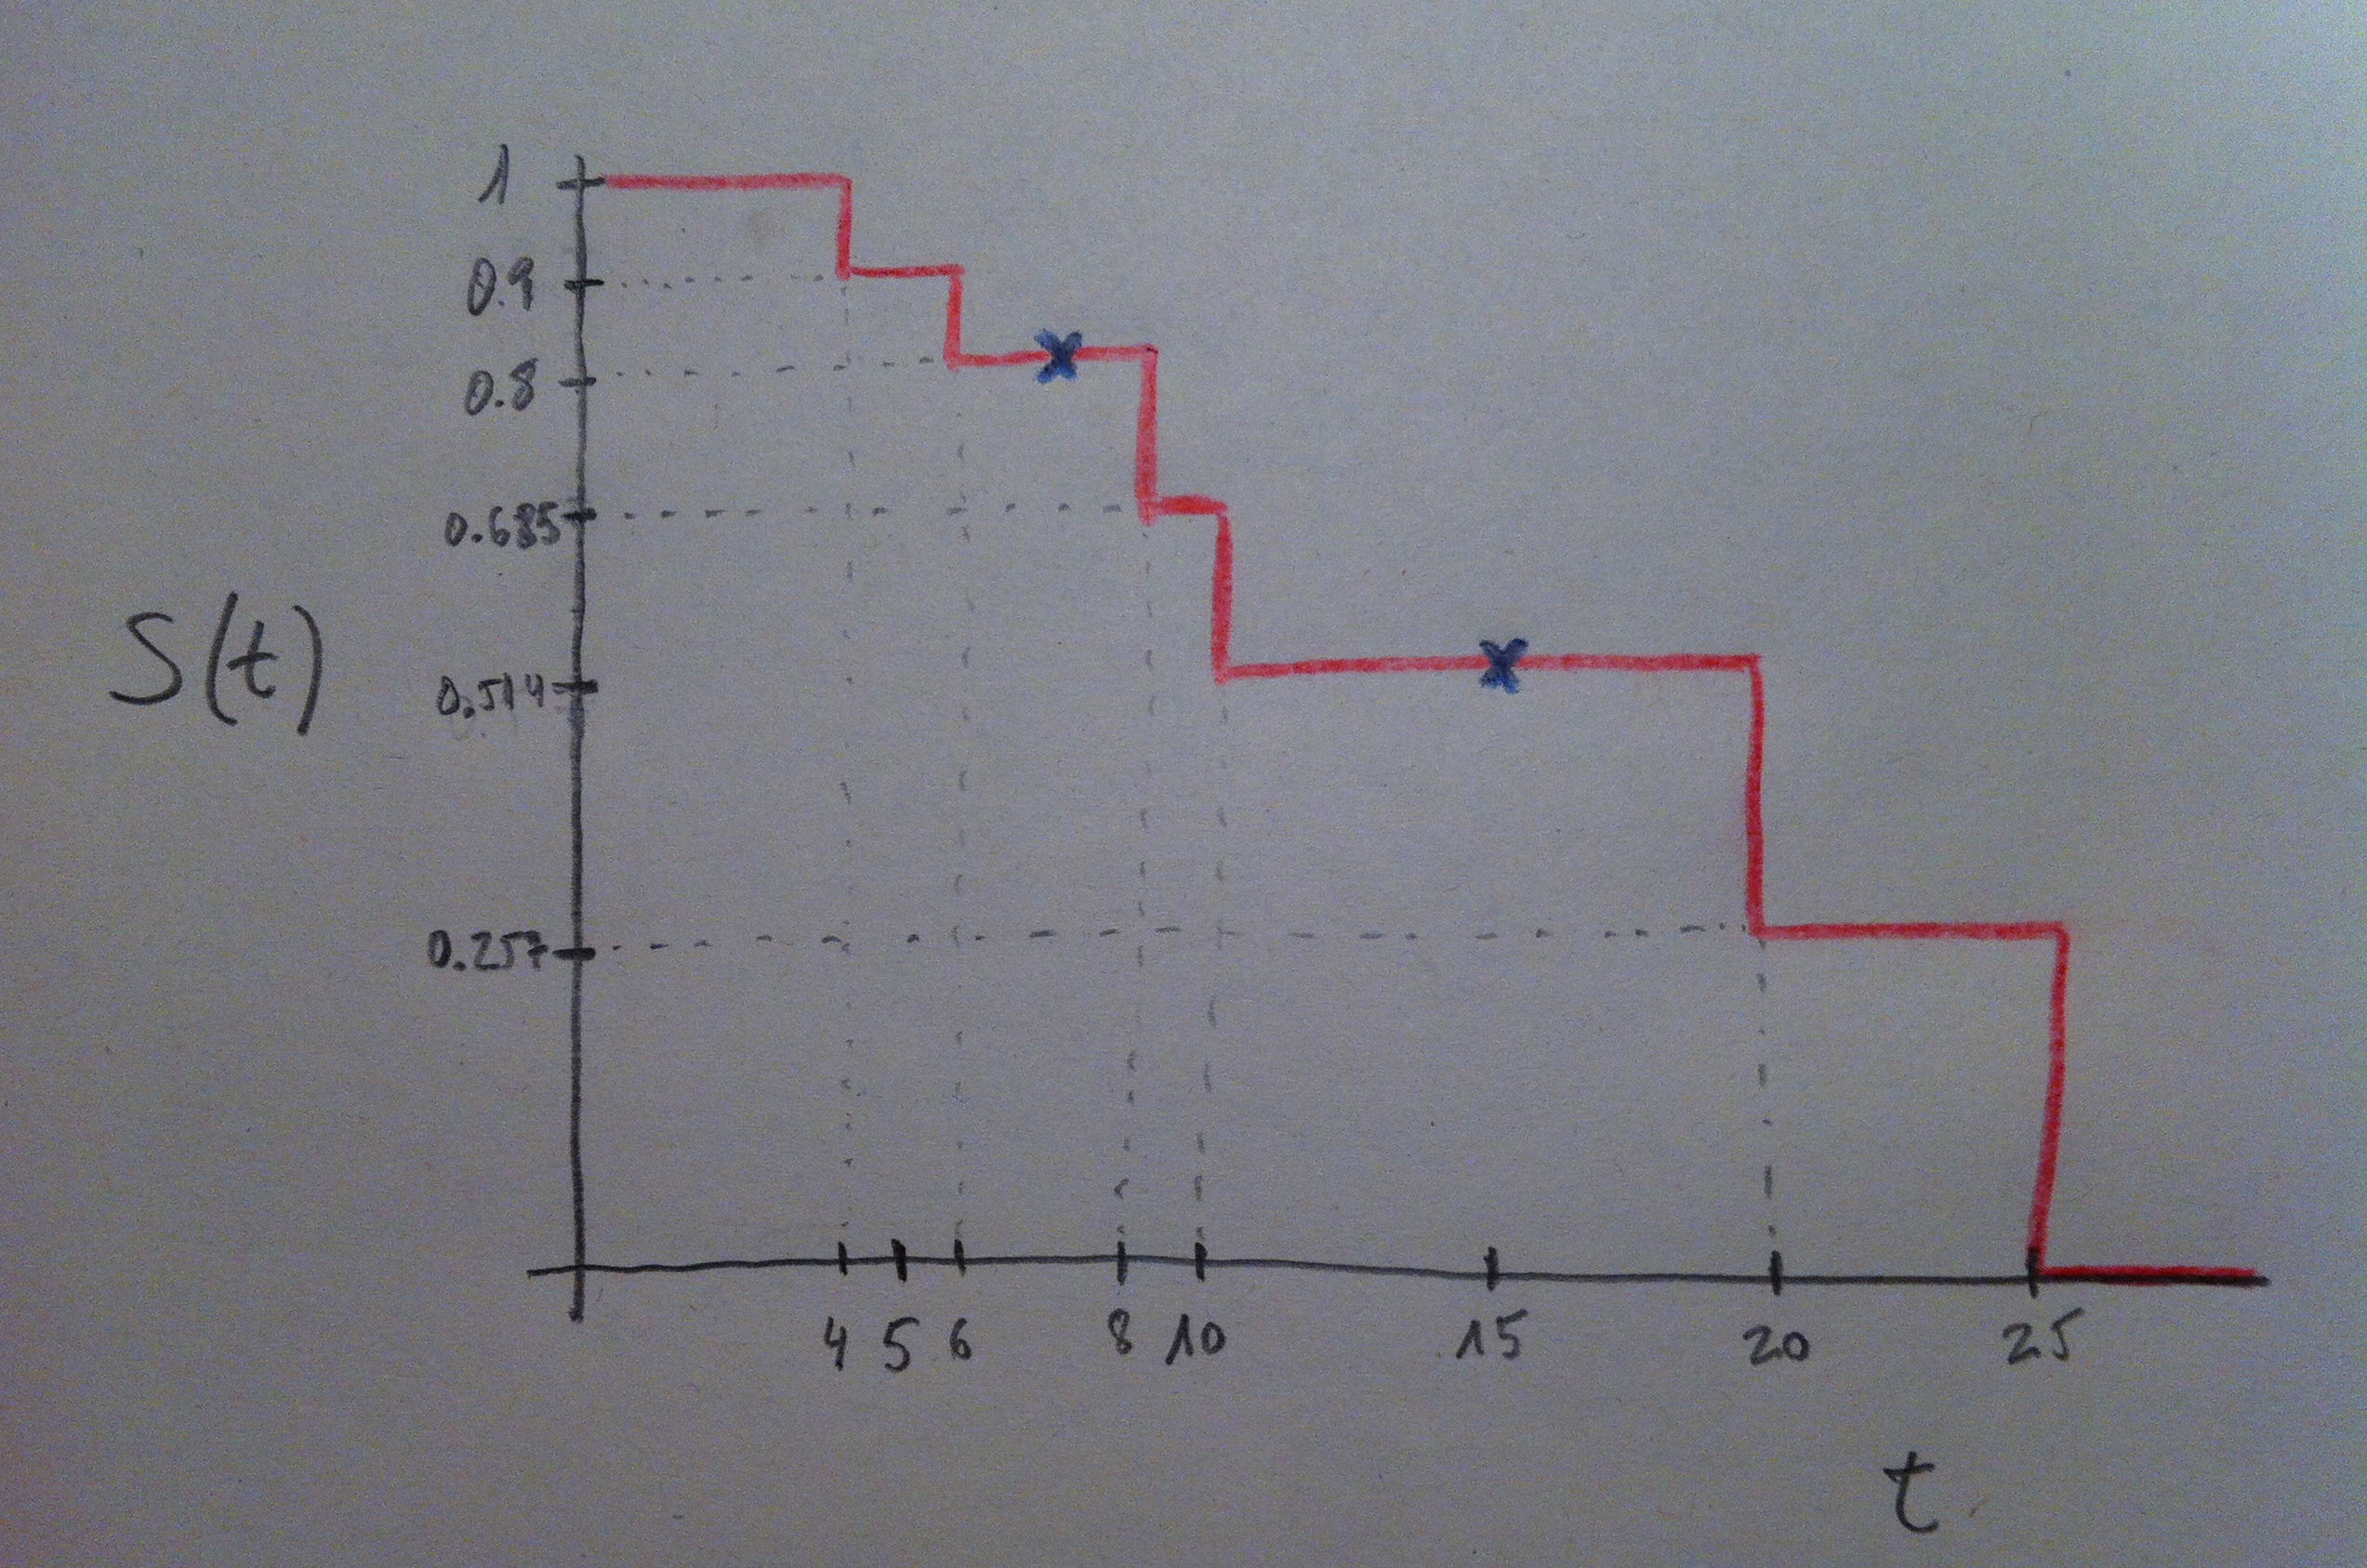
A partir de estos valores la curva de supervivencia es la siguiente:
Cuando un valor es censurado se señala en el momento que ha salido del estudio. Si estuviera al final del estudio se marcaría también.
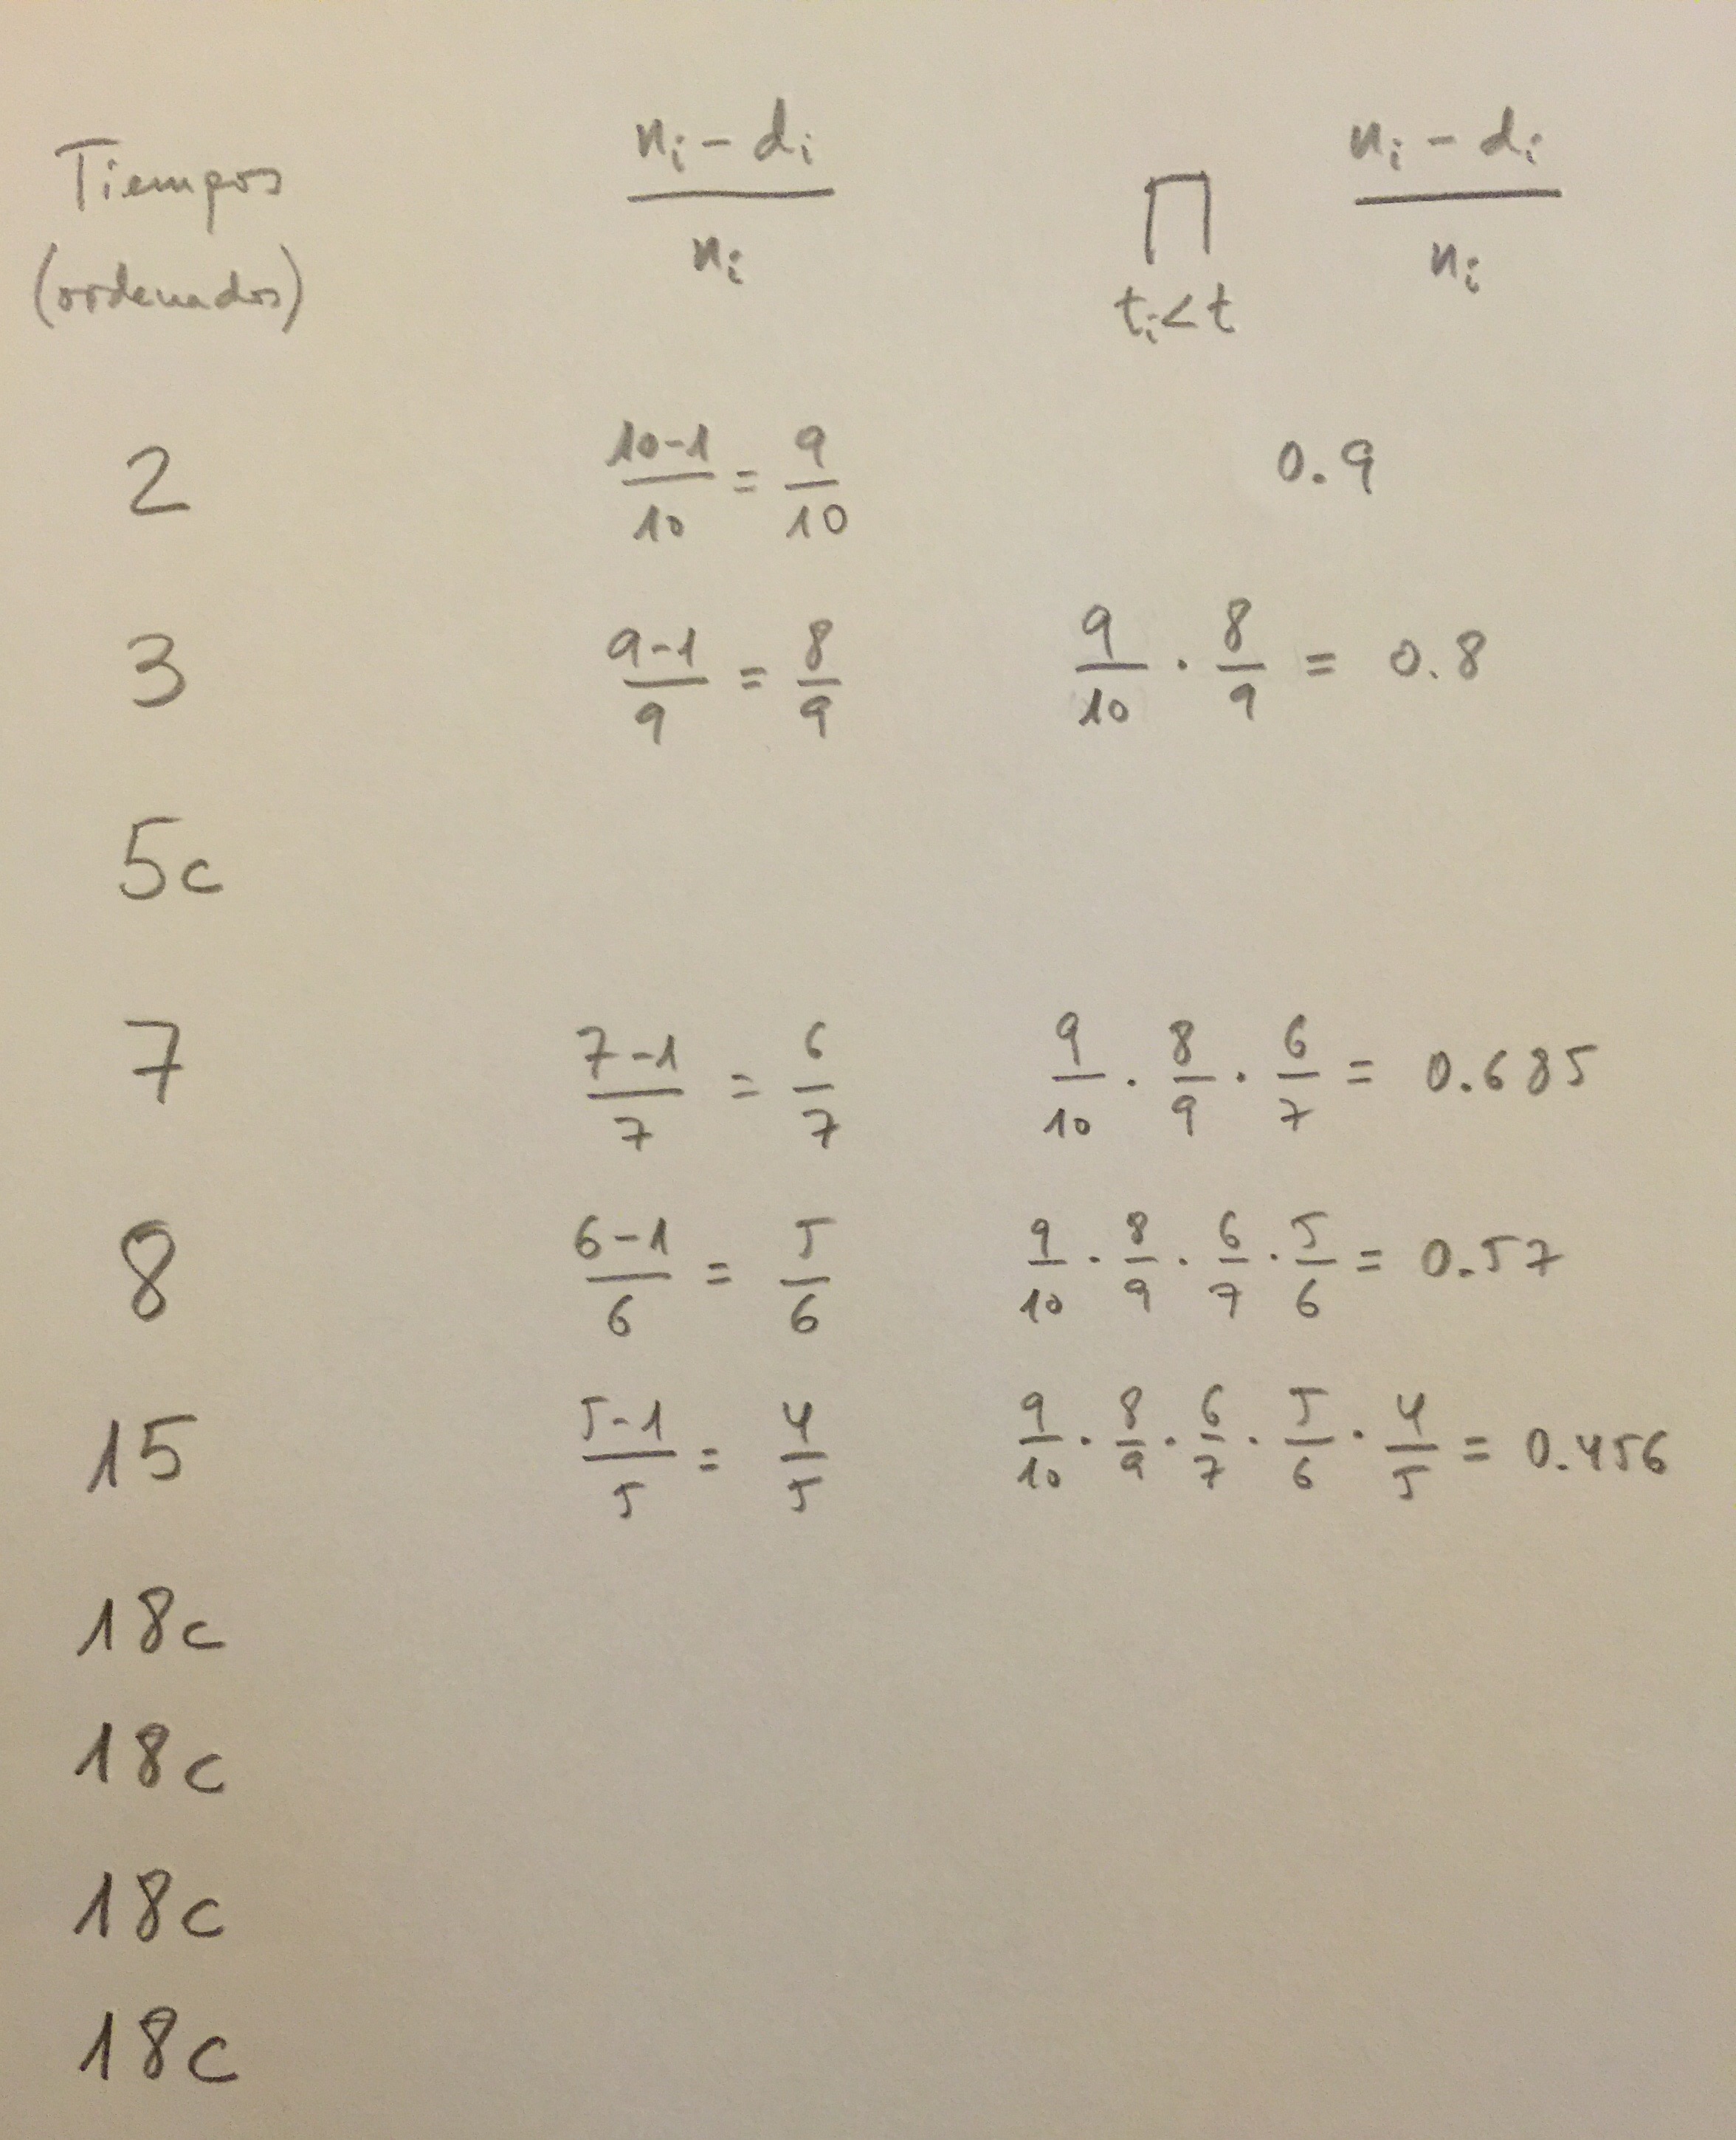
Otro ejemplo. Supongamos ahora la muestra de las siguientes unidades de tiempo:
(2, 3, 5c, 7, 8, 15, 18c, 18c, 18c, 18c)
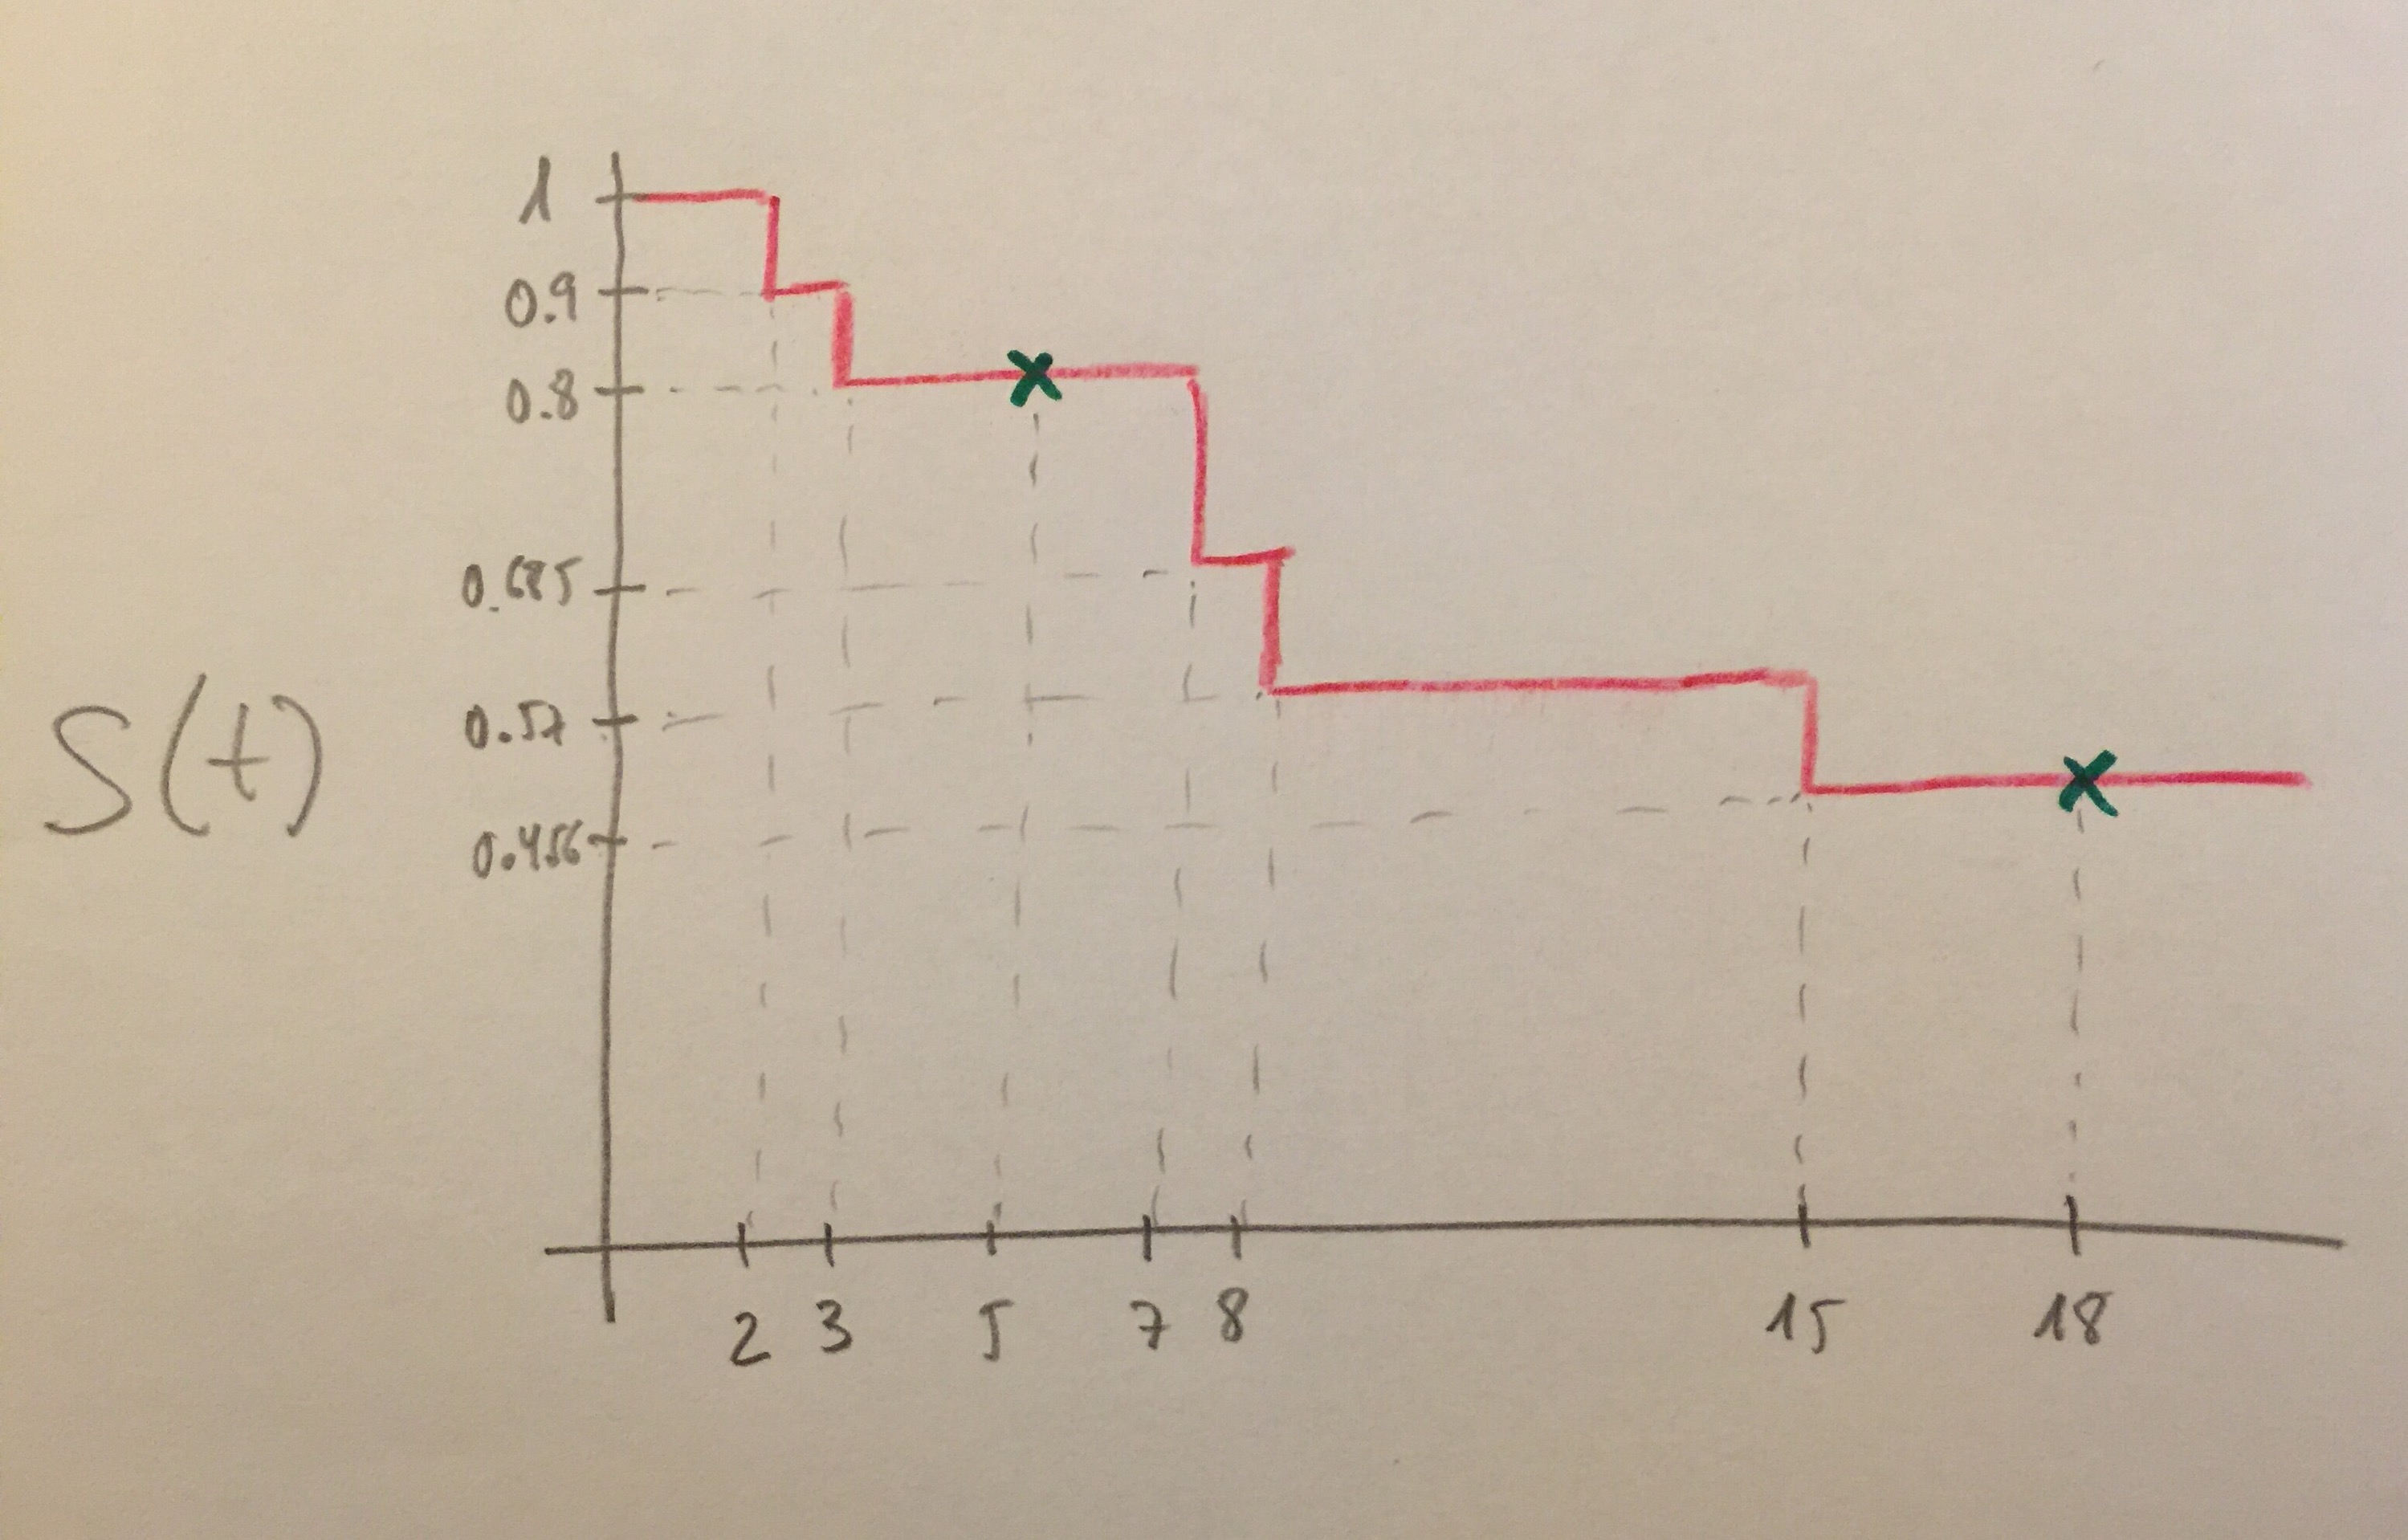
Obsérvese que en este caso el valor 18, que podría representar 18 meses de seguimiento, podríamos considerar el final del seguimiento. Por lo tanto, tenemos 4 individuos en los que no ha sucedido el acontecimiento estudiado en las 18 unidades temporales del seguimiento.
El cálculo del Estimador de Kaplan-Meier es el siguiente:
La curva de supervivencia de Kaplan-Meier es, pues, la siguiente:
El Test Log-Rank es un contraste de hipótesis que comparar curvas de supervivencia. Se pueden comparar dos o más de dos.
Para comparar dos curvas de supervivencia el Test es el siguiente:
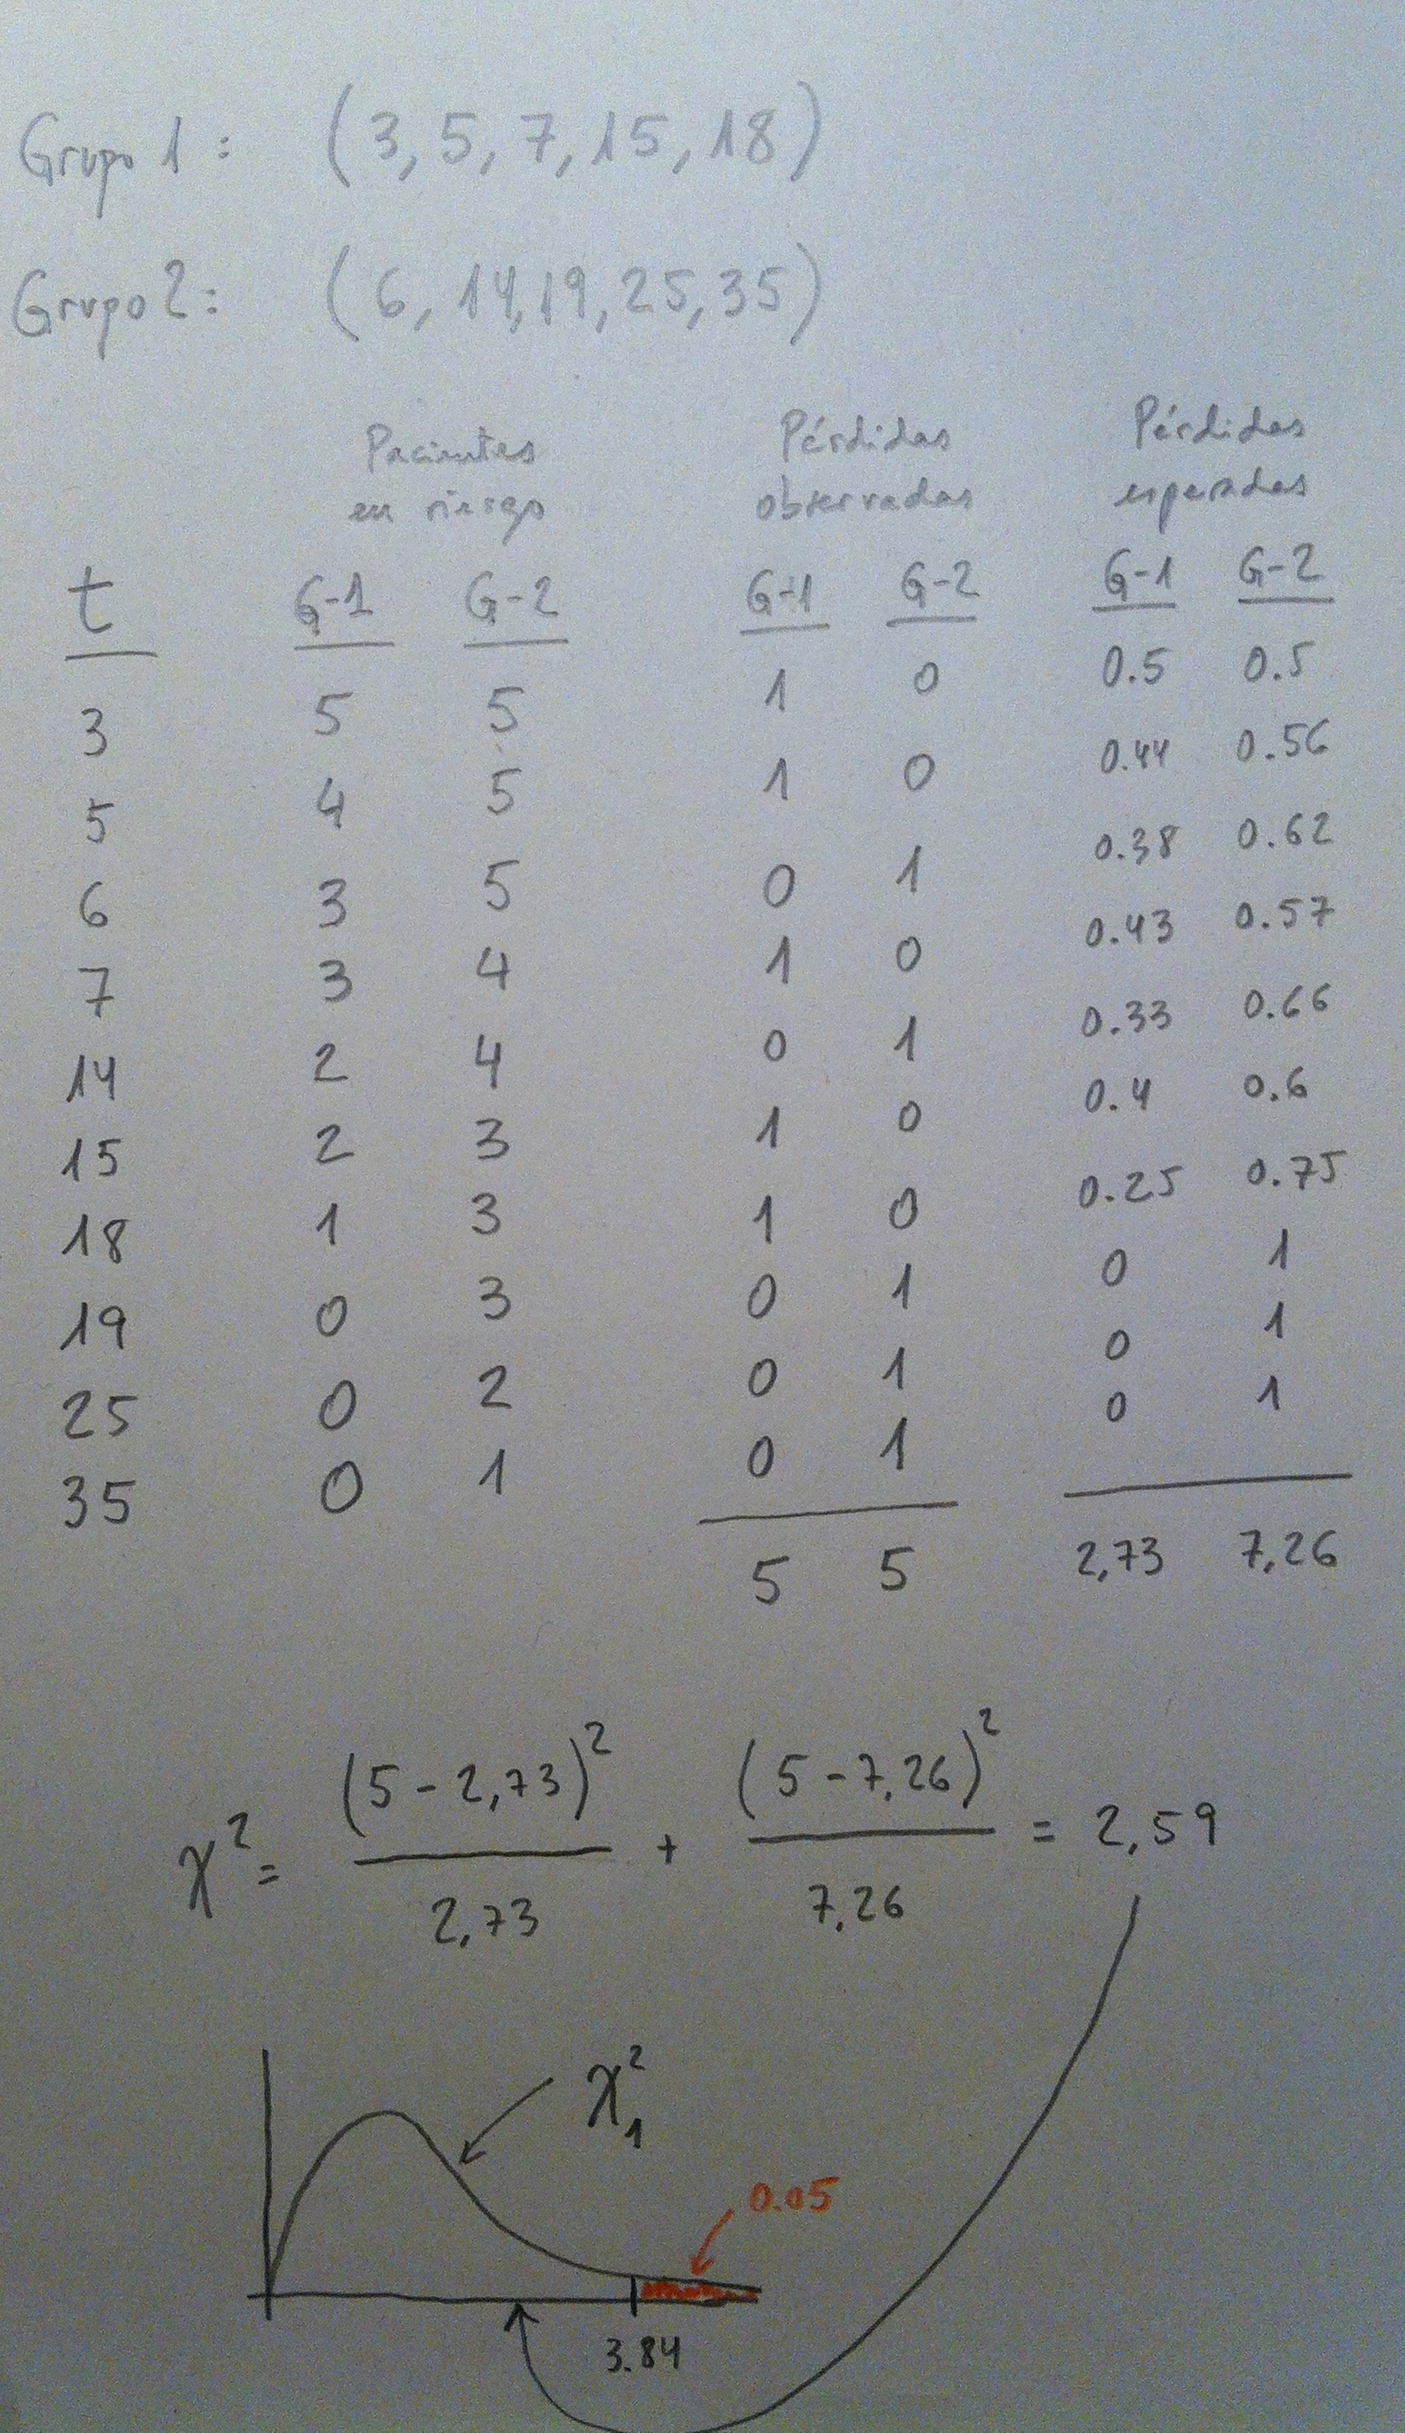
Veámoslo en un ejemplo. Supongamos estos dos grupos, cada uno con su curva de supervivencia que es evidentemente distinta muestralmente. El problema es ver si esta diferencia es estadísticamente significativa. Apliquemos el Test:
Como puede verse, a pesar de que las diferencias muestrales son sustanciales esa diferencia no es significativa. Veamos el siguiente cambio. He creados dos grupos que repiten cada uno de los cinco valores anteriores. Por lo tanto, las diferencias entre curvas se mantienen pero ahora con un tamaño muestral mayor. Recordemos que el tamaño muestral es determinante a la hora de detectar diferencias estadísticamente significativas. Veamos cómo van a cambiar las cosas. Calculemos el Test para estos nuevos datos:
Como puede verse ahora sí tenemos un resultado significativo. Ahora las diferencias son estadísticamente significativas. Ahora sí que ya podemos afirmar que las dos curvas de supervivencia poblacionales son distintas.
Por lo tanto, antes el tamaño muestral jugaba en contra de la significación estadística. Ahora el tamaño muestral es lo suficientemente grande como para que podamos decir que las diferencias que antes veíamos no pueden ser atribuibles al azar del muestreo.
1. El Análisis discriminante es una técnica inferencial. Es una técnica típicamente multivariante porque suele usarse en contextos donde tenemos varias variables, pero evidentemente puede aplicarse con pocas variables, incluso con una sola variable, pero no es lo habitual.
2. Una característica esencial de esta técnica es que tenemos previamente definidas dos o más poblaciones; o sea, tenemos dos o más muestras de esas poblaciones con una serie de individuos de cada una de ellas de los que tenemos medidas una serie de variables.
3. Su finalidad básica es preparar esa información, seleccionarla, trabajarla, con una finalidad clasificadora. Futuros individuos, a los que les podremos medir esas variables, deberemos clasificarlos como miembros de alguna de esas poblaciones.
4. Evidentemente partimos del supuesto de que esos nuevos individuos a clasificar pertenecen a una de esas poblaciones.
5. El Análisis discriminante tiene un nombre muy apropiado para lo que es su procedimiento. Porque lo que hace es iniciar, a partir de toda la información de que se dispone sobre las poblaciones y las variables, un proceso de discriminación, un proceso de separación lo mayor posible de esas poblaciones.
6. Por lo tanto, a partir de un conjunto de individuos que sabemos ciertamente a qué población pertenecen cada uno de ellos y a partir de los valores de todas las variables que disponemos mediante el Análisis discriminante tratamos de buscar qué combinaciones de esas variables nos permitirán discriminar lo más posible entre los grupos que tenemos.
7. Pongamos un ejemplo previo sencillo que puede ayudarnos a clarificar el camino de la explicación de esta técnica: Supongamos que queremos encontrar variables que nos permitan clasificar a una persona entre hombre o mujer teniendo únicamente la información de la medida de esa variable.
8. La variable edad no discrimina entre hombres y mujeres, no separa bien esos dos grupos. La variable altura ya discrimina más. La variable pie que calza discrimina más aún. Veámoslo en unos datos posibles: En rojo tendríamos una muestra de mujeres y en azul una de hombres:
9. Elegir la edad para pronosticar el sexo nos llevaría a mucho error. La mitad de las veces nos equivocaríamos. Elegiendo la altura ya cometeríamos menos errores porque las poblaciones están más discriminadas, más separadas, respecto a esta variable. Eligiendo el pie que calza cometeríamos menos errores aún porque de las tres variable es la que discrimina mejor, es la que separa mejor a los dos grupos, como puede apreciarse en este gráfico. Esto es así en la realidad: en mujeres y hombres con la misma altura los hombres tienen el pie más grande que las mujeres.
10. Si se entiende bien esta idea simple se entenderá perfectamente lo que persigue el Análisis discriminante. Porque esto es lo que hace la técnica: entre las variables de que disponemos y con las muestras que tenemos de las poblaciones en estudio debemos buscar qué variables y qué combinación de ellas es la que consigue separar más, discriminar más, esos grupos. La finalidad es usarlo como mecanismo para clasificar a un individuo futuro del que tendremos los valores que tiene de esas variables pero del que no sabremos a qué población pertenece.
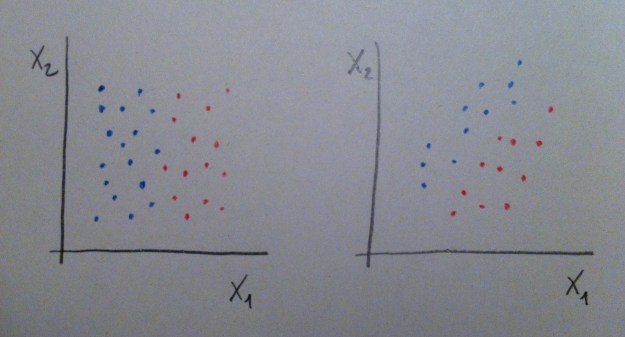
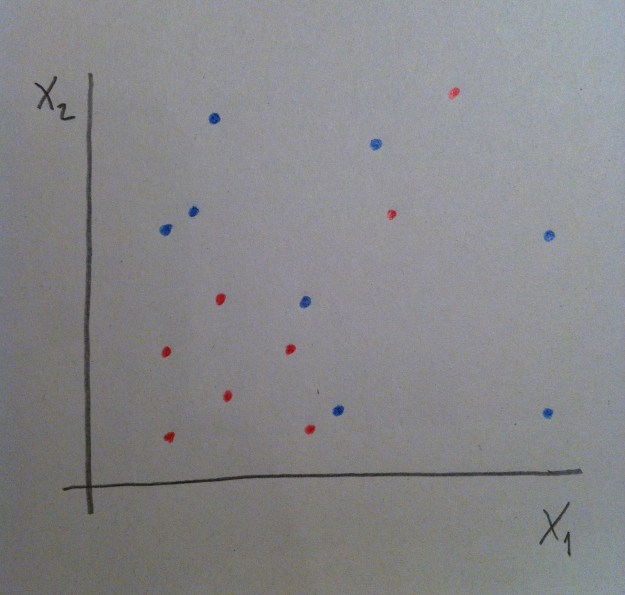
11. A veces si tenemos más de una variable con una de esas variables nos bastará para conseguir una buena discriminación, pero a veces ninguna de ellas individualmente nos irá bien y sí, en cambio, una combinación de ellas. Miremos el siguiente gráfico:
12. Puede observarse que en el caso de la izquierda la variable X1 es muy buena discriminadora de las dos poblaciones: la roja y la azul. Desde X1 las dos poblaciones se visualizan bien separadas. Tener el valor de X1 de un individuo que no sabemos si pertenece a la población roja o a la azul nos permitiría, con cierta tranquilidad, clasificarlo de una u otra población y parece que la probabilidad de error sería bajo. En cambio la X2 no discrimina, no nos separa las dos poblaciones. Esa variable es, pues, un mal referente para clasificar entre esas dos poblaciones.
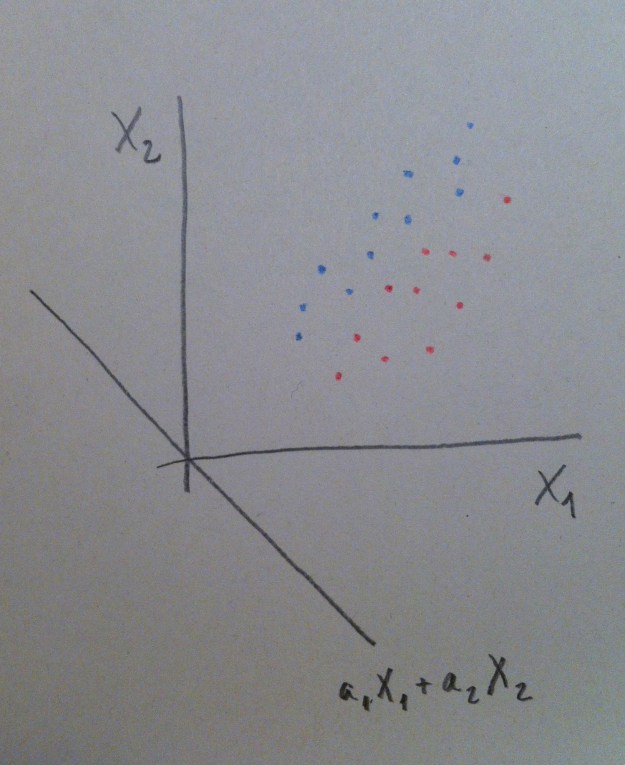
13. En el caso de la derecha del gráfico anterior la situación nos permite decir que ni X1 ni X2 son buenos discriminadores por separado. Si miramos la nube de puntos tanto desde X1 como desde X2 las dos poblaciones se ven mezcladas, no están discriminadas. Pero si hacemos un giro de los ejes, si hacemos una combinación de esas dos variables, podremos discriminar bien. Miremos el giro que hacemos en el gráfico siguiente:
14. Ahora la variable a1X1+a2X2 sí que discrimina bien. Ver la nube de puntos desde este nuevo eje nos permite visualizar las dos poblaciones bien separadas. Por lo tanto, el valor que tengamos de un nuevo individuo de esta combinación de las dos variables originales nos permitirá establecer un criterio de clasificación con pocas probabilidades de error. Y no olvidemos que hacer este giro va asociado de una fórmula como ésta, una fórmula que combina de una forma peculiar y lineal esos dos ejes originales.
15. De hecho, lo que acabamos de hacer no nos debe extrañar, lo hemos hecho ya en el Análisis de componentes principales y en el Análisis factorial. Hemos hecho combinaciones de las variables originales, hemos hecho giros de los ejes, hemos creado componentes, factores. Ahora, en el contexto del Análisis discriminante estas combinaciones de las variables originales las llamamos funciones discriminantes. Pero, en abstracto, es como una componente o un factor: una combinación lineal de las variables originales.
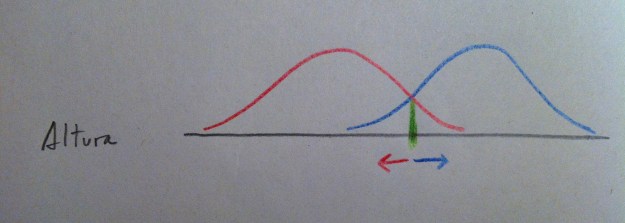
16. Y sea el tipo que sea de Análisis discriminante el que realicemos, de entre los que veremos a continuación, el procedimiento siempre es el mismo: se trata de crear un mecanismo de decisión a través del cuál al nuevo individuo se lo clasifica según el peso que tenga respecto a las densidades de las diferentes poblaciones. Lo veremos mejor con un ejemplo: Supongamos uno de los casos vistos antes: la altura como variable que discrimine entre hombres y mujeres. Lo que haremos es crear una función de densidad a partir de la muestra de hombres, otra a partir de la muestra de mujeres y entonces al nuevo individuo clasificarlo de la población que le tocaría más densidad; o sea, en el gráfico establecemos una frontera (en color verde) justo donde cambia la zona de mayor influencia de una u otra población. Si cae el nuevo valor a la derecha de esa frontera lo clasificamos de azul, si cae a la izquierda lo clasificamos de rojo:
17. Hay diferentes técnicas de Análisis discriminante. Hay el Análisis discriminante lineal, el Análisis discriminante cuadrático y hay, también, todo un repertorio de técnicas que se suelen encajar bajo la denominación de Análisis discriminante no paramétrico.
18. La creación de funciones discriminantes, combinaciones de las variables originales desde donde establecer buenos mecanismos de discriminación, tal como lo hemos planteado antes, es una idea ligada al Análisis discriminante lineal, pero es cierto que aunque los mecanismos usados por los diferentes tipos de Análisis discriminante son distintos, todos comparten la atmósfera general que he intentado transmitir hasta ahora.
19. El Análisis discriminante lineal y el cuadrático parten de una serie de suposiciones que no siempre se cumplen, por eso se han desarrollado una serie de técnicas que son válidas sin el cumplimiento de las suposiciones rígidas que exigen las técnicas paramétricas. La discriminación lineal y la cuadrática requieren que cada una de las poblaciones siga la distribución Normal multivariante. Además, la discriminación lineal requiere que la matriz de varianzas-covarianzas sea la misma en todas las poblaciones. La discriminación cuadrática, de hecho, está diseñada para no tener que soportar esta suposición.
20. Las técnicas no paramétricas en Análisis discriminante tratan, mediante métodos diferentes y muy imaginativos, establecer procedimientos de clasificación de los nuevos individuos dentro del conjunto de poblaciones candidatas.
21. Uno de esos métodos no paramétricos de Análisis discriminante es el basado en la Estimación no paramétrica de funciones de densidad. Veamos un poco la operatividad de este método porque es conceptualmente muy sencillo e interesante. Supongamos los siguientes datos:
22. Tenemos dos muestras de dos poblaciones distintas: la roja y la azul. El método construye, entonces, para cada muestra, una función de densidad mediante el método Kernel y clasifica al nuevo individuo simplemente asignándolo a la población donde haya más valor de densidad, que querrá decir que por allí hay más influencia de esa población, hay más valores muestrales y, por lo tanto, parece lógico arriesgarse a clasificarlo de la población que tenga más representantes por la zona. Es la misma idea que la mostrada antes con la variable Altura pero en lugar de mediante una campana de Gauss, mediante una función de densidad estimada a partir de la propia muestra.
23. Como hemos dicho al principio del tema, y se ha podido comprobar a lo largo de su explicación, el Análisis discriminante es una técnica inferencial, una técnica que hace inferencias, que va más allá de lo que tenemos, que usa la muestra como medio para decir cosas que no sabemos. En este caso, para clasificar a individuos dentro de dos o más poblaciones.
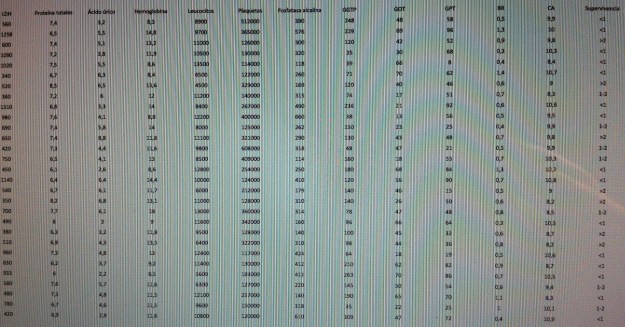
24. Veamos un ejemplo de Análisis discriminante lineal. Vamos a trabajar unos datos de años de supervivencia después del diagnóstico de cáncer de pulmón de células pequeñas. Los datos son los siguientes:
25. No vamos a entrar en detalles sobre cada una de las variables. Sólo decir que son típicas variables bioquímica y citológicas en una analítica sanguínea. La última columna es la Supervivencia, catalogada con tres valores: <1, 1-2 y >2, que representan: menos de un años, entre 1 y 2 años y más de 2 años. Esta es la columna que nos distingue las poblaciones. Son datos de enfermos que al diagnóstico tenían esta analítica y que acabaron sobreviviendo este tiempo especificado en la última columna.
26. El objetivo es, pues, aplicar el Análisis discriminante para establecer un mecanismo de clasificación, de pronóstico en este caso. Tenemos tres poblaciones definidas: Supervivencia de <1, de 1-2 y de >2 años. Tenemos tres muestras y 12 variables. Se trata de discriminar esas tres poblaciones, mediante esas 12 variables, con la finalidad de que a un nuevo paciente diagnosticado de esa enfermedad le podamos hacer un pronóstico con bastantes posibilidades de acertar.
27. En primer lugar deberíamos comprobar la normalidad de los datos y la igualdad de la matriz de varianzas-covarianzas. La normalidad multivariante es de compleja comprobación. Aunque la normalidad de cada variable individual no representa normalidad multivariante los software estadísticos acostumbran a comprobar esta normalidad univariante con cualquiera de las técnicas de bondad de ajuste a la normal, como el Test de Kolmogorov o el de la ji-cuadrado. Respecto a la homogeneidad de las matrices de varianzas-covarianzas una prueba habitual es el Test M de Box, que es una generalización del Test de Barlett univariante.
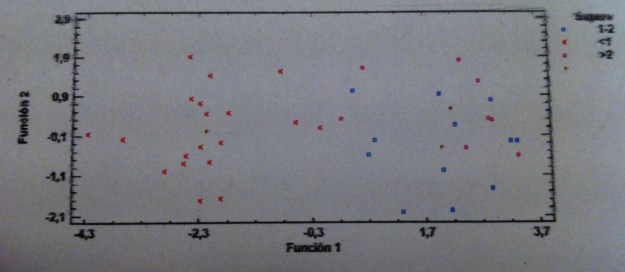
28. Una vez comprobadas estas suposiciones pasamos a la realización de un Análisis discriminante lineal. Dibujamos los datos mediante un gráfico en tres dimensiones con las dos funciones discriminantes que nos calcula el programa:
29. Las tres cruces que tienen forma de suma corresponden a los valores promedios de cada una de las tres poblaciones, de cada uno de los tres grupos de supervivencia.
30. De entrada, ya sólo viendo este gráfico y recordando lo que hemos dicho antes, parece claro que la Función discriminante 1 parece discriminar bien pero la Función discriminante 2 no parece que nos discrimine nada.
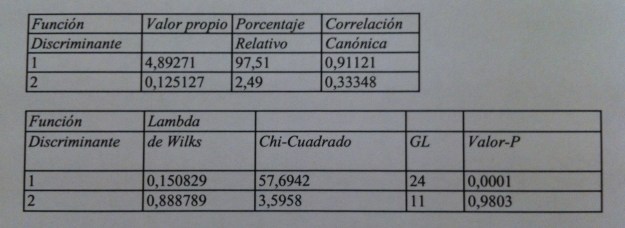
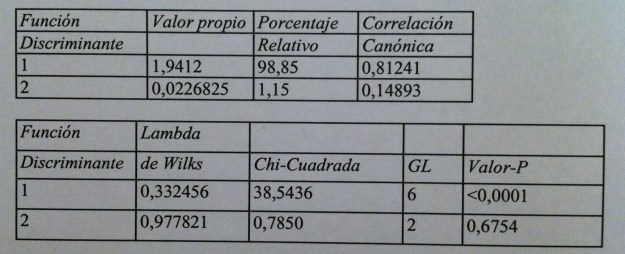
31. Veamos la siguiente tabla:
32.Los dos valores propios muestran que la primera función discriminante está mucho más relacionada que la segunda con los grupos de supervivencia. La correlación canónica así lo muestra también. Pero, además, gracias a la Lambda de Wilks podemos comprobar que, además, la primera función discriminante separa significativamente grupos, discrimina. Sin embargo, la segunda función discriminante no consigue una separación significativa. El Test de la Lambda de Wilks es básico en muchos ámbitos inferenciales multivariantes. Es un test que básicamente trata de establecer una relación entre la dispersión dentro de los grupos respecto a la dispersión total, sin tener en cuenta los grupos. Si
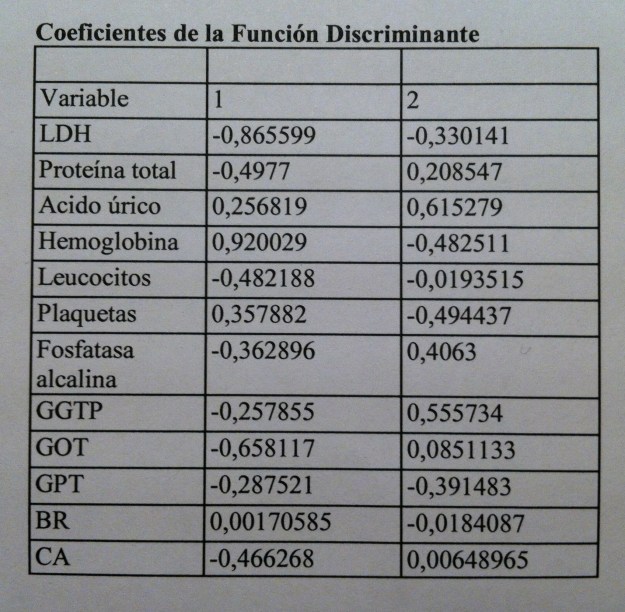
33. Veamos cuáles son esas funciones discriminantes:
34. Tenemos las dos pero en realidad sólo debemos mirar la primera porque la segunda no nos discrimina. Como puede verse se trata de macrovariables, como las componentes o los factores. Pero ahora, debido al contexto donde las hemos creado las llamamos funciones discriminantes. El programa estadístico nos da dos pero sólo una es significativa.
35. En Análisis discriminante no suele haber una preocupación por la interpretación de esas macrovariables, de las funciones discriminantes. De hecho, el análisis está canalizado a la creación de un método que funciones, que sea útil, no suele haber un interés en ponerle nombre a esas funciones como sí ocurre, por el contrario, en Análisis de componentes principales o en Análisis factorial.
36. Para clasificar a un nuevo individuo diagnosticado de cáncer de pulmón de células pequeñas después de hacerle una analítica con todos estos parámetros deberíamos aplicar los valores de la siguiente tabla con las llamadas funciones de clasificación:
37. Estas funciones de clasificación de los nuevos individuos es creada a partir de las muestras que tenemos de los tres grupos de supervivencia. La operatividad es la siguiente: Se calculan los tres valores correspondientes para cada columna con los valores del individuo. El valor más alto es el valor más probable. Digamos que es una forma de calcular bajo qué distribución de las tres tiene más probabilidad.
38. Observemos que el procedimiento liga mucho con la idea del uso de Estimadores no paramédicos de la función de densidad con el método Kernel, comentado antes. Y, de hecho, liga con la idea nuclear que guía todo lo visto en este tema: hay que clasificar allá donde haya más influencia entre las muestras previamente establecidas.
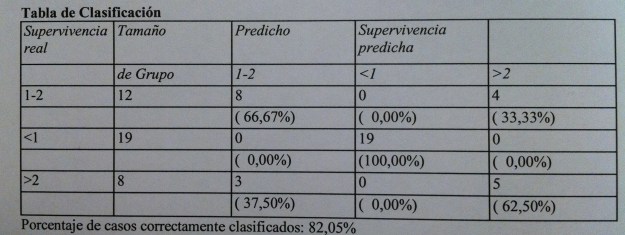
39. ¿Cómo podemos cuantificar la eficacia del método de discriminación? ¿Cuál será su eficacia? ¿Podemos predecirla? Miremos este interesante método para hacer esta previsión:
40. Se trata de un método ingenioso de estimación de la eficacia clasificatoria. Consiste en ir tomando uno a uno cada uno de los individuos de la muestra. Individuos de los que ya sabemos su supervivencia. Pues bien, aplicamos la tabla de clasificación establecida a partir de estos datos que hemos visto antes y miramos dónde quedaría clasificado este individuo si no supiéramos su supervivencia. Y esto lo hacemos con todos los individuos de la muestra. De esta forma tenemos de cada uno de los individuos dos valores de supervivencia: el real y el pronosticado. Construimos, entonces, esta tabla de clasificación donde vemos es las filas la supervivencia real (porque es nuestra muestra y la sabemos) y la supervivencia prevista aplicando nuestro método de clasificación. Así vemos si acertamos o no. Lo bueno es que los valores estén en la diagonal principal que es la que hace coincidir grupo real con grupo predicho. De esta forma se acaba calculando un porcentaje de casos correctamente clasificados, que, en nuestro caso, es del 82.05%. Que no es malo debido a la complejidad de los que estamos hablando.
41. Observemos que hemos trabajado con todas las variables del estudio. Pero aquí, en Análisis discriminante lineal también podemos hacer una Selección de variables hacia adelante o hacia atrás, como en la Regresión múltiple. Si hiciésemos esto a estos datos obtendríamos, en primer lugar, la siguiente representación de los individuos según las dos funciones discriminantes:
42. Los valores de significación siguen marcando la primera función discriminante como única función que discrimina realmente:
43. El proceso de selección del modelo encuentra que con tres variables basta. Con las variables LDH, Hemoglobina y GPT ya es suficiente. Las funciones discriminantes son:
44. La tabla de funciones de clasificación es ahora la siguiente:
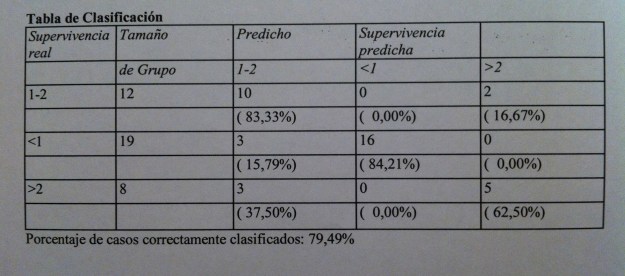
45. Y la tabla de clasificación que nos mide la calidad de la clasificación con los valores muestrales es la siguiente:
46. Tenemos un 79.49% de aciertos, un poco menor que el 82.05% de antes, pero con muchas menos variables.
47. Un breve comentario para acabar: Es interesante establecer conexiones entre el Análisis discriminante y la Regresión logística. De hecho, tienen profundas similaridades. De hecho, se trata de dos formas de enfrentarse a lo mismo. Observemos que las poblaciones en las que queremos clasificar a un nuevo individuo se puede ver, en realidad, como una variable cualitativa. Y el procedimiento de discriminación es como la búsqueda del modelo de regresión.
48. Cuando la variable es dicotómica y se pretende modelizar la situación y establecer relaciones entre la variable dicotómica y un conjunto de variables predictoras mediante Odds ratio, entonces es más habitual usar la Regresión logística. Cuando hay más de dos poblaciones y además hay especialmente una voluntad práctica clasificatoria suele usarse el Análisis discriminante. También para el uso de una u otra técnica juegan cuestiones de tradición, culturales. Por ejemplo, en Medicina es más usual la Regresión logística por tradición y por el papel tan destacado que en ese campo juega la Odds ratio. Sin embargo, en ámbitos como la Biología, la Ecología, la Sociología y otros es más habitual el uso del Análisis discriminante.