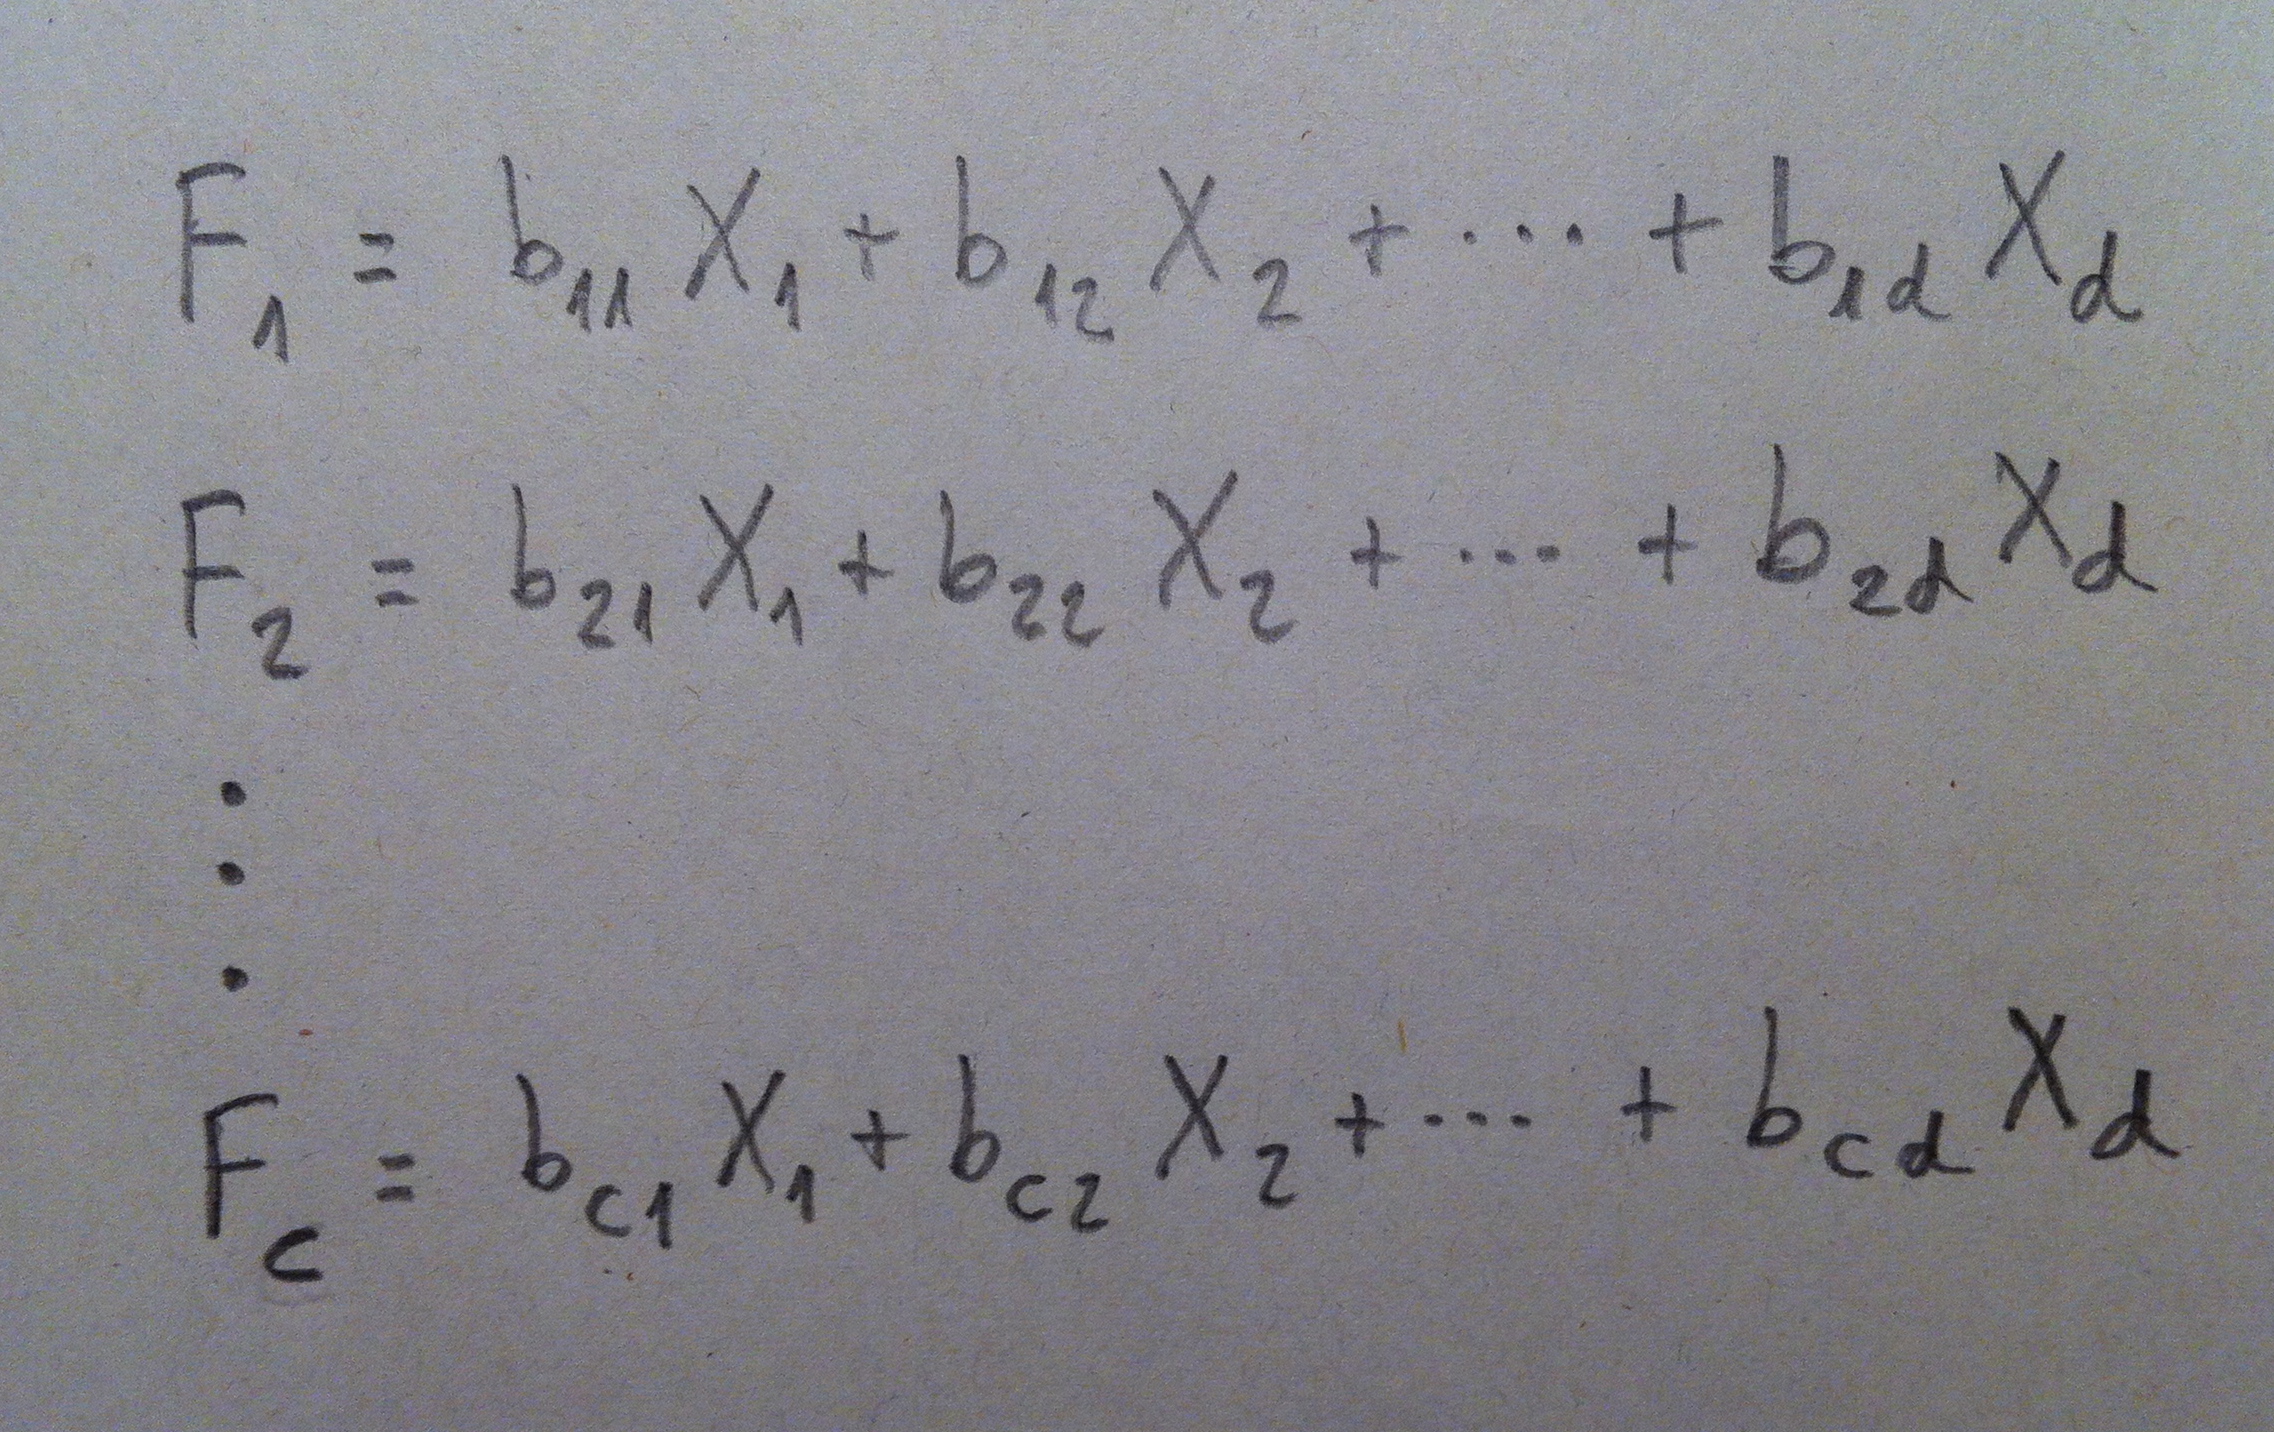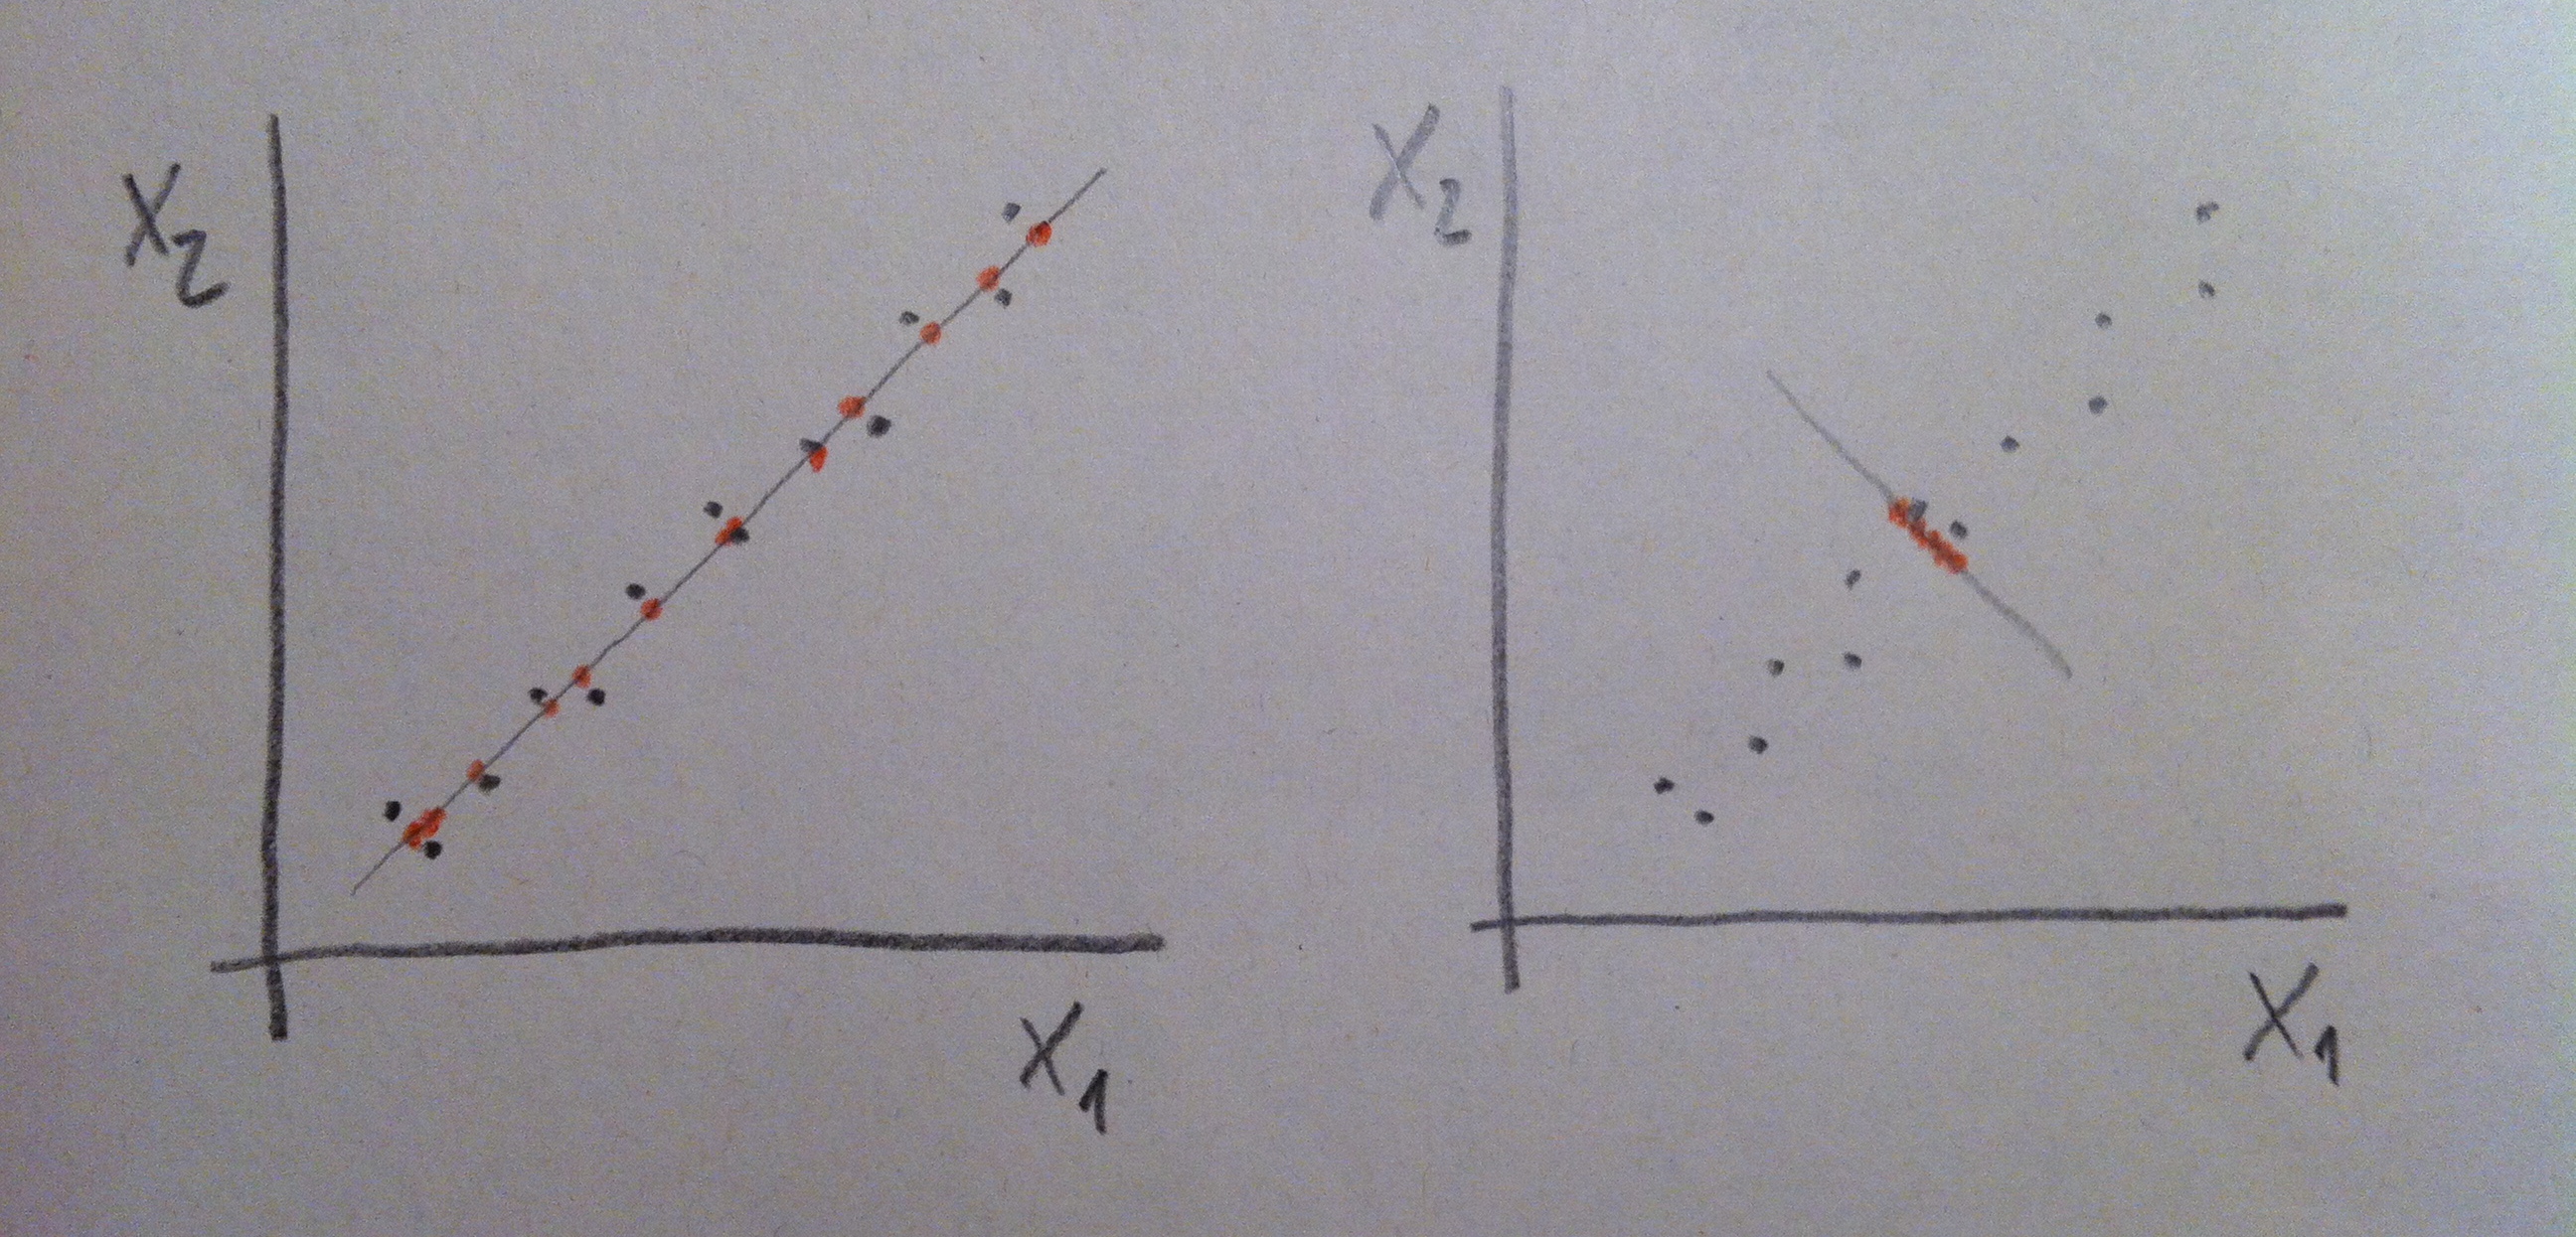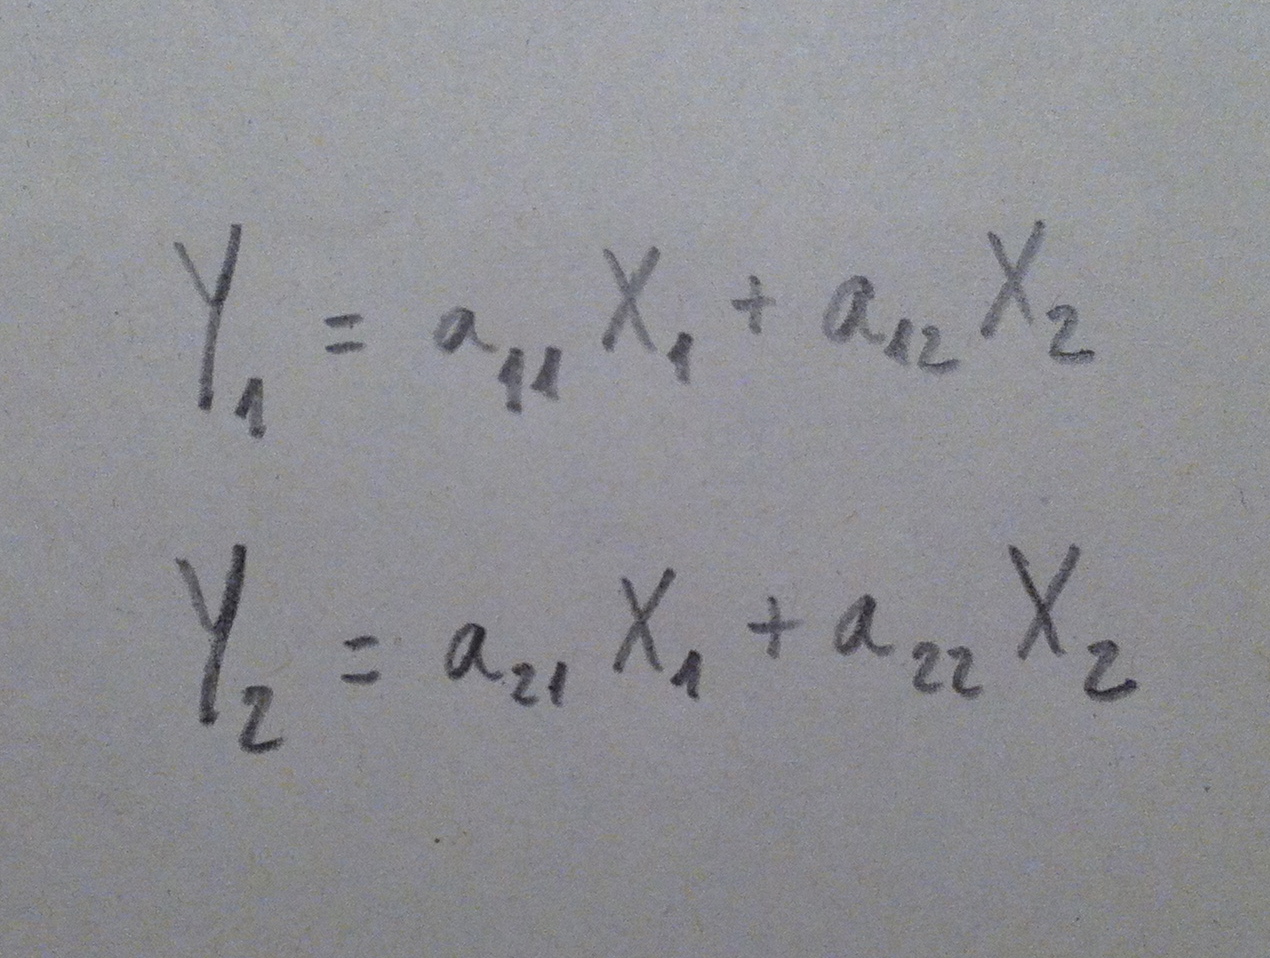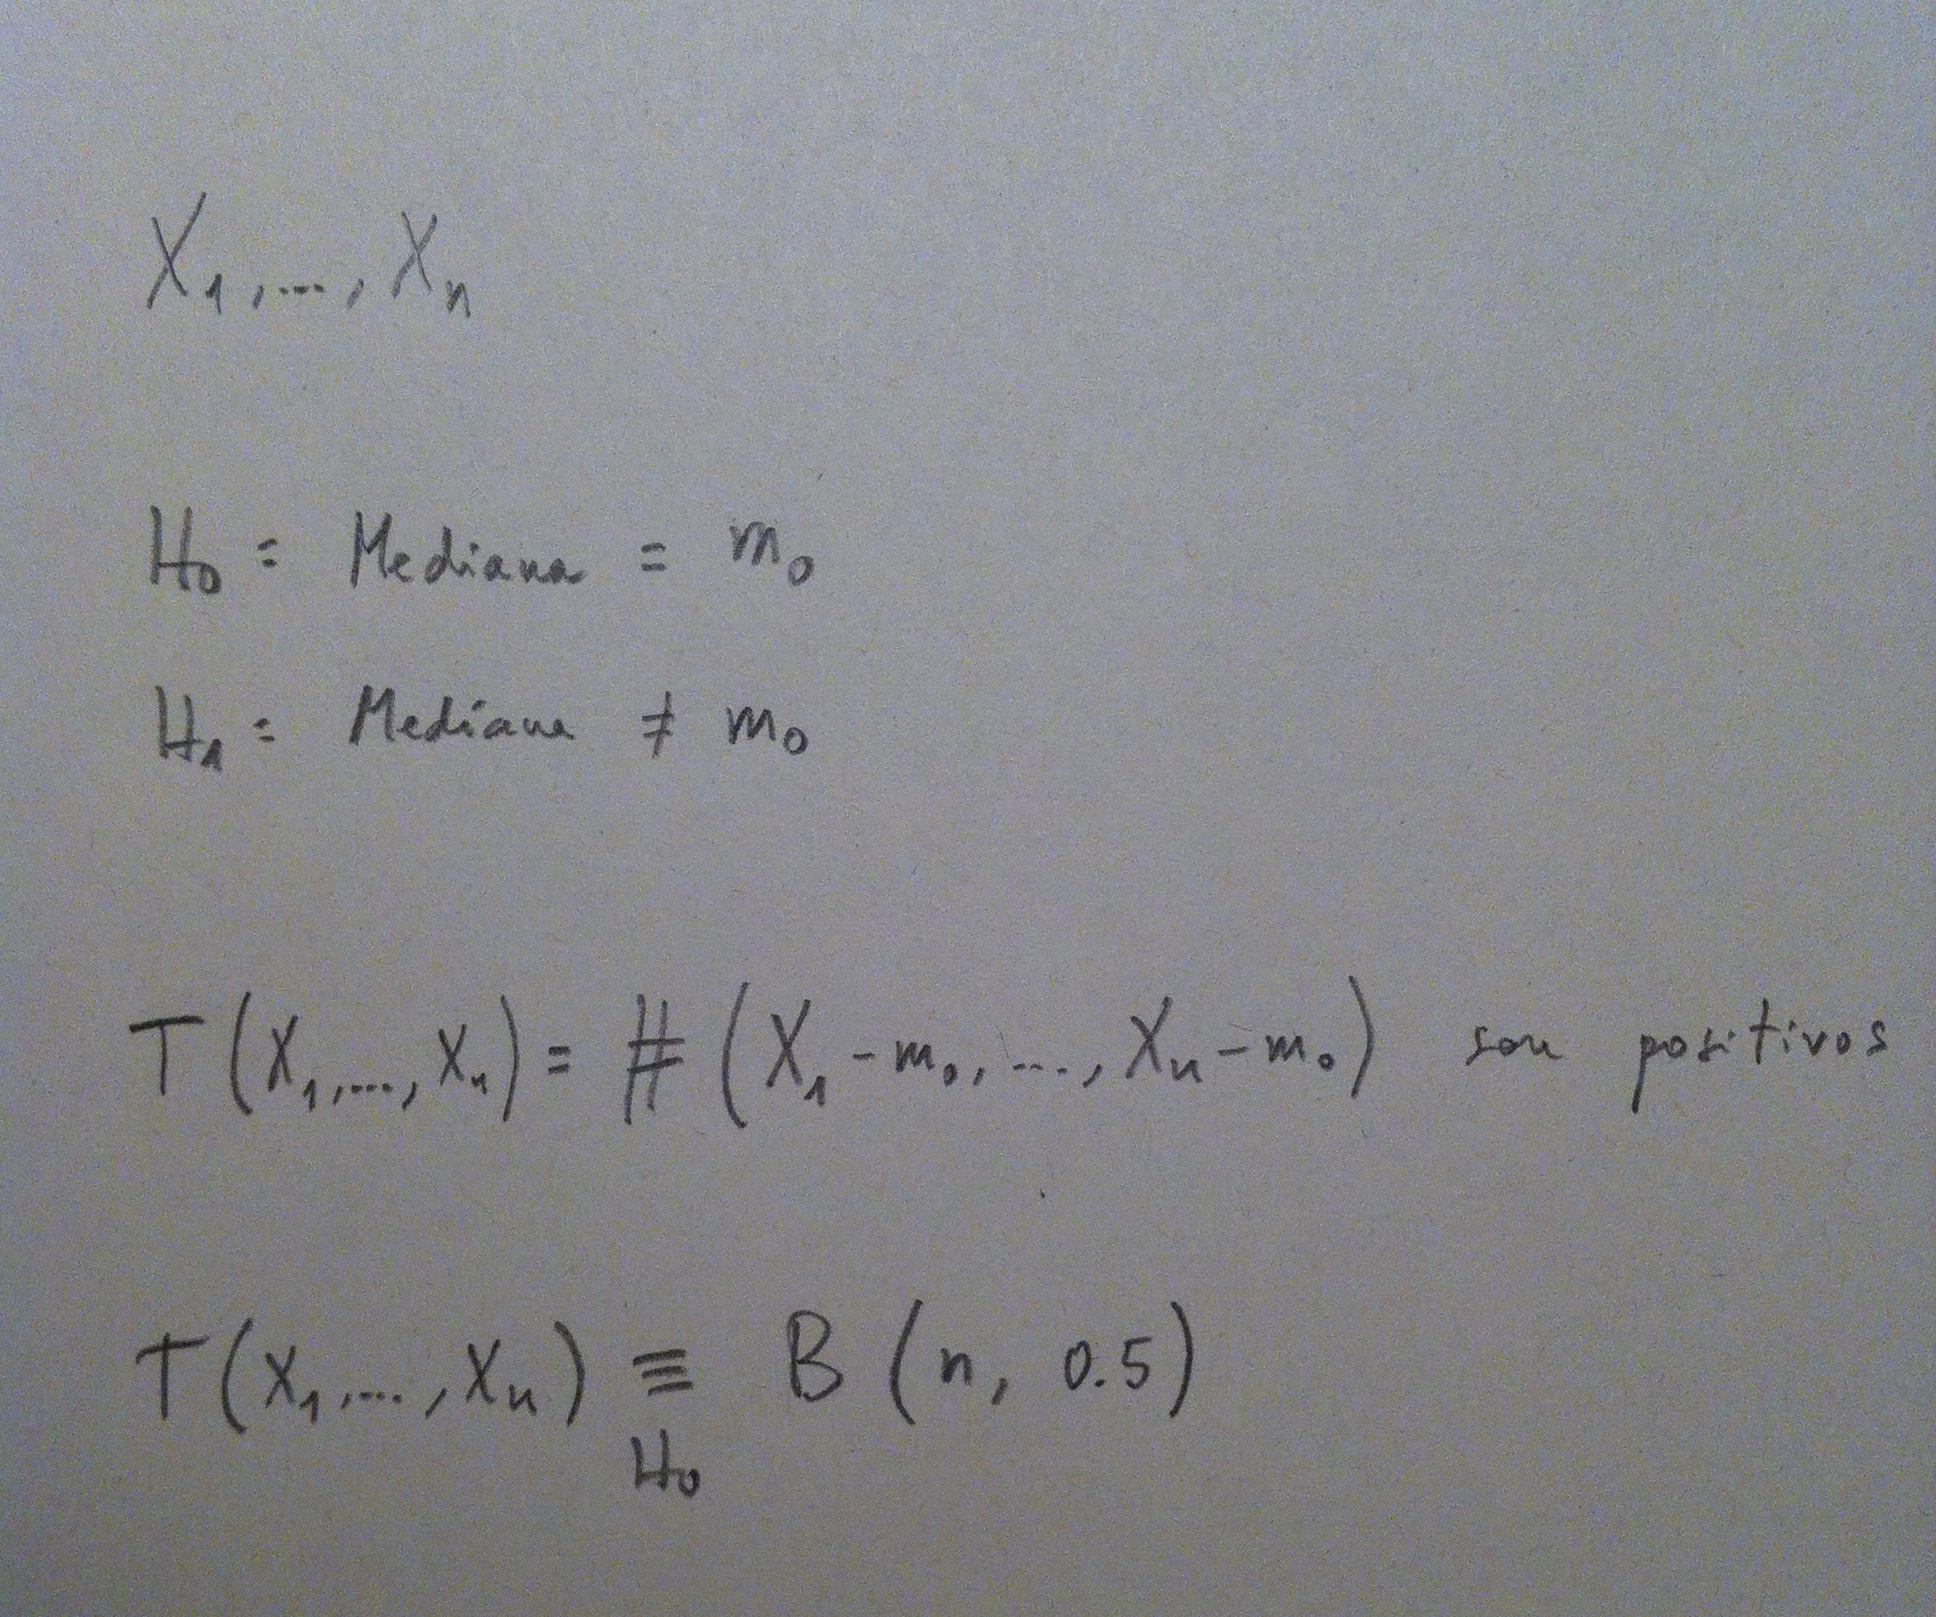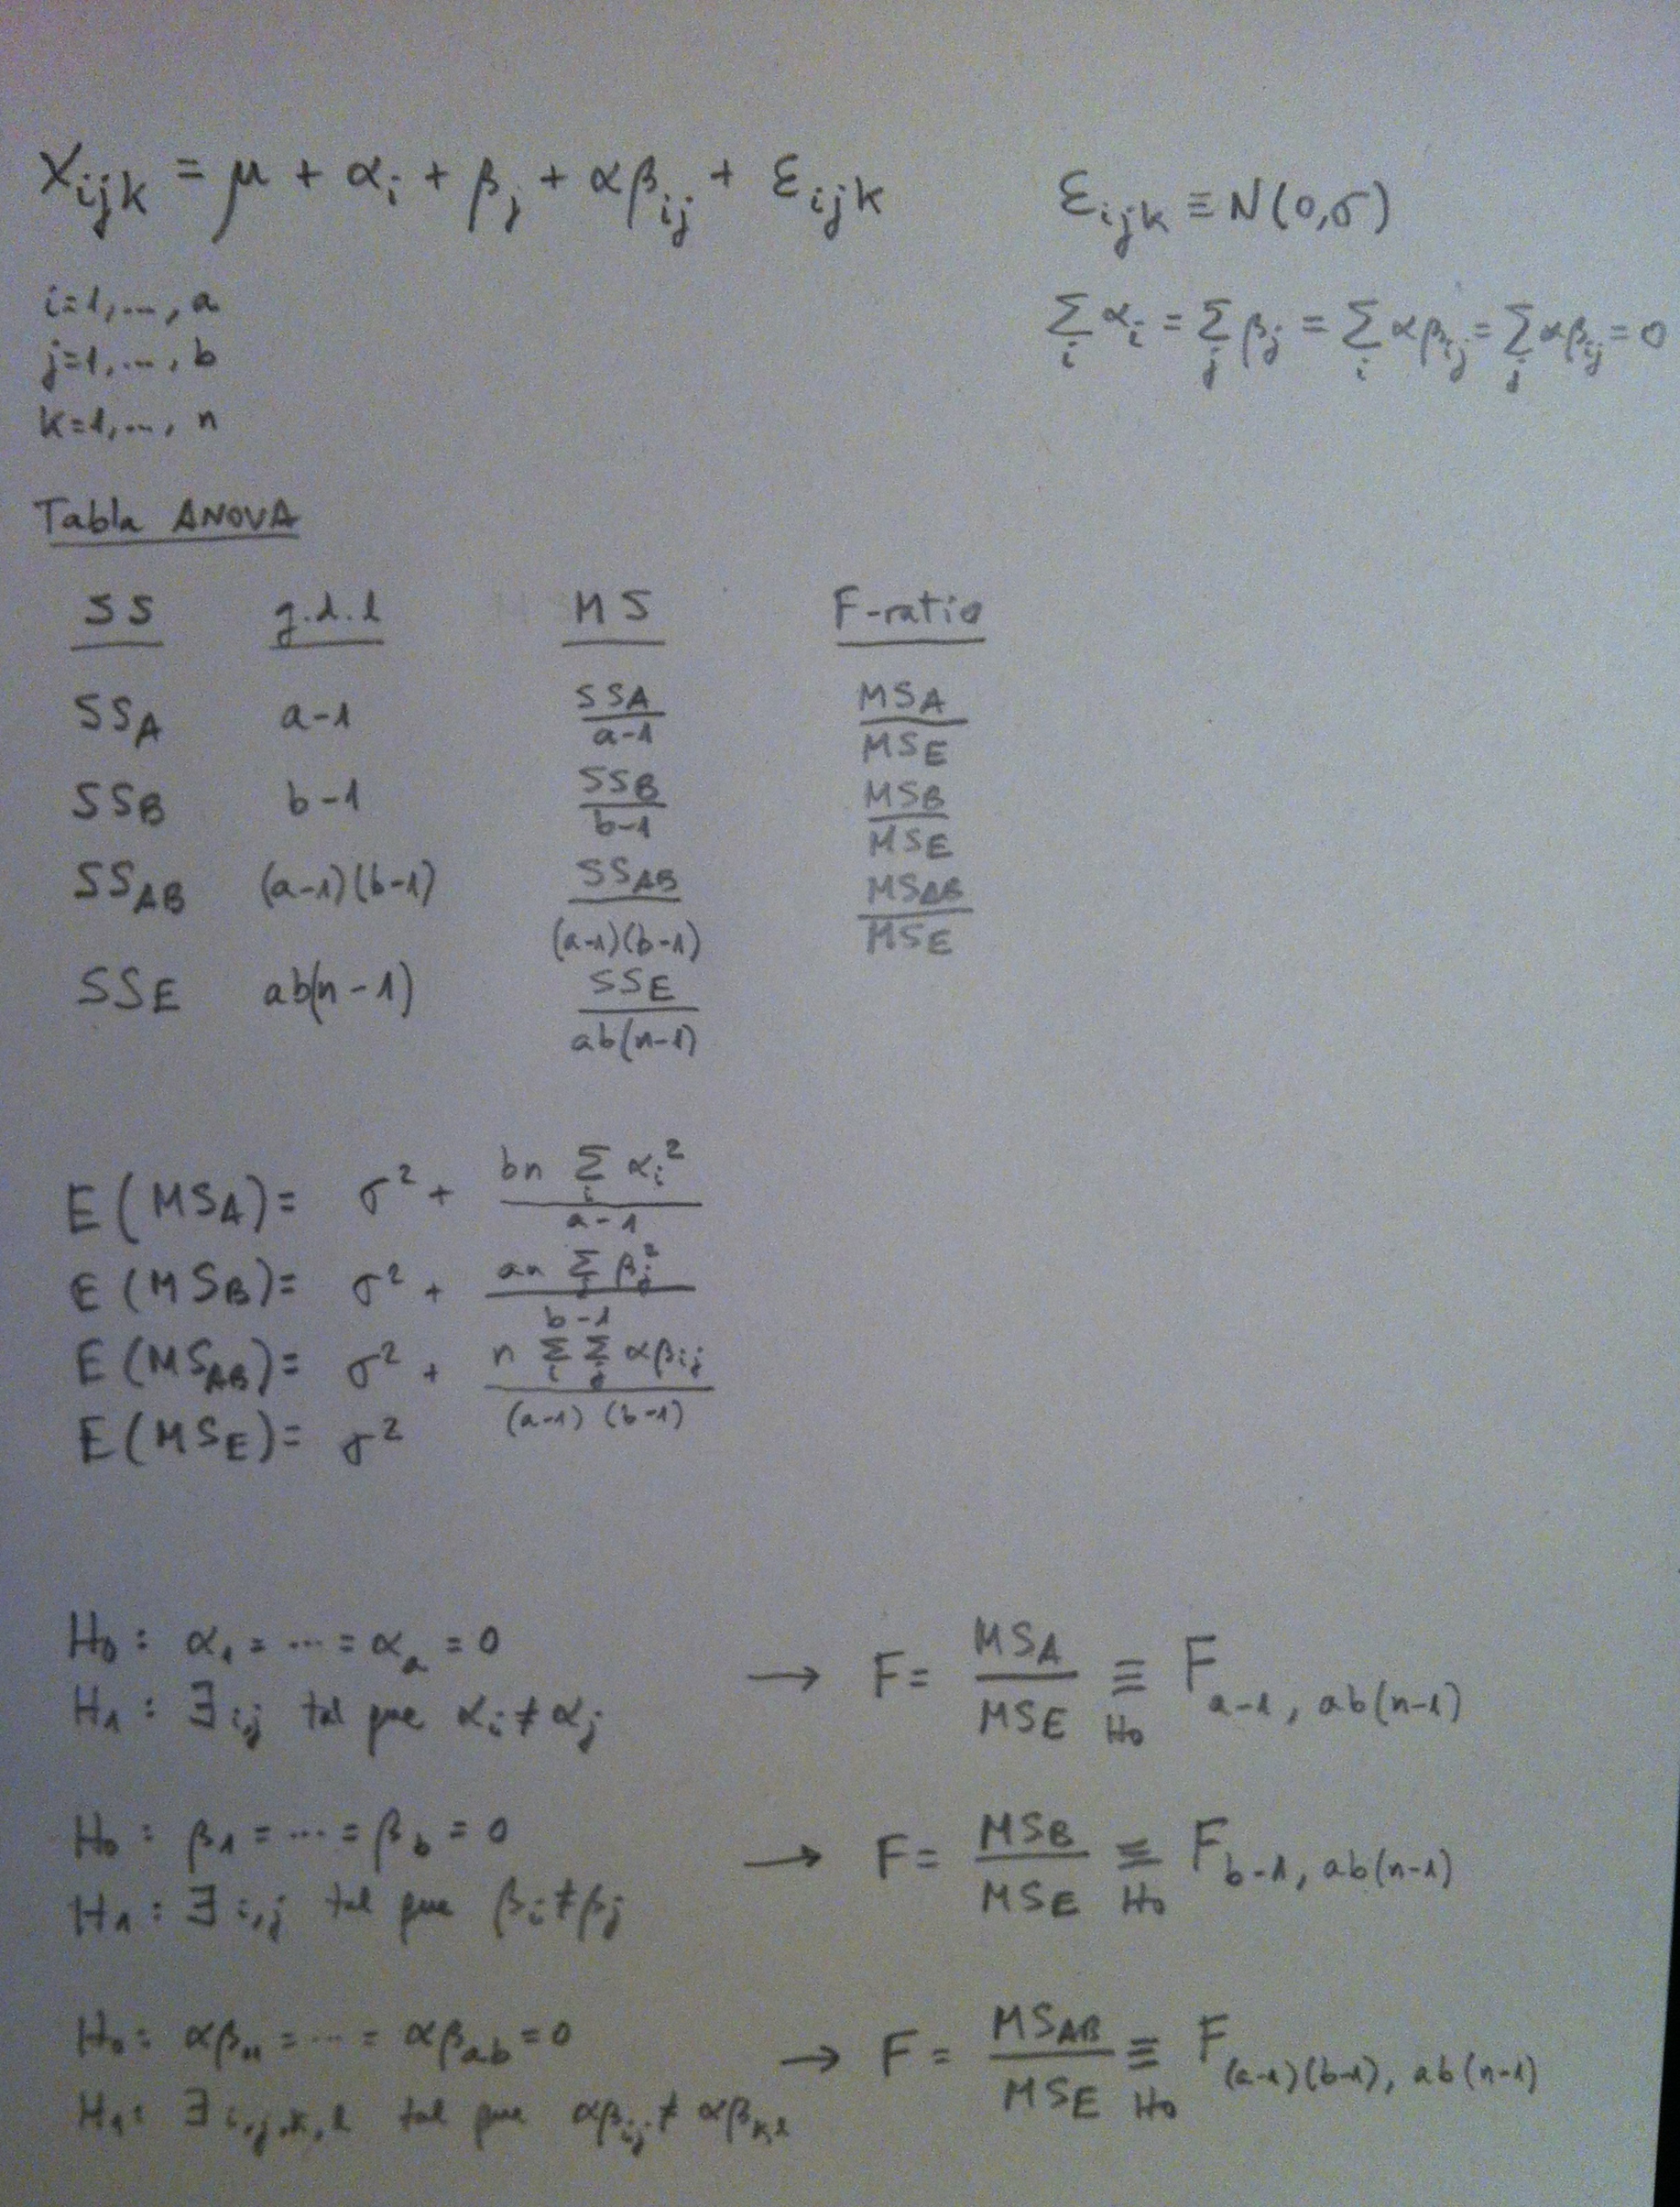Archivo del Autor: estadisticallopis

Tema 19: ANÁLISIS CLÚSTER

1. El Análsis clúster (AC), también llamado en ocasiones Análisis de conglomerados, se dice habitualmente que es una técnica estadística clasificadora, pero, en realidad, es una técnica que, como el Análisis de componentes principales (ACP) o como el Análisis factorial (AF), pretende representar una realidad que no conseguimos visualizar, una realidad cuya representación original es multidimensional y es imposible que la podamos ver en su estado puro.

2. En el fondo tanto ACP, como AF, como AC son técnicas que tratan de representan una nube de puntos original situada en un espacio de tantas dimensiones que es imposible visualizar. Y cada una de ellas, también, en el fondo, puede ser usada como método clasificatorio, como método para crear subpoblaciones, subgrupos.

3. La diferencia fundamental entre ellas es la forma de presentación que utilizan, la forma de resolver el problema de no visualización de la nube de puntos originales. El ACP y el AF lo hacen construyendo una nube de puntos de la misma naturaleza pero de menor número de dimensiones  perdiendo una parte de la información original. Sin embargo, el AC lo que hace es crear una representación distinta a la de la nube de puntos. Crea otro tipo de representación. Cambia la forma: no lo hace mediante una nube de puntos, lo hace mediante un dendrograma.

4. Cada una de las opciones tiene sus ventajas y sus desventajas, como iremos viendo a continuación.

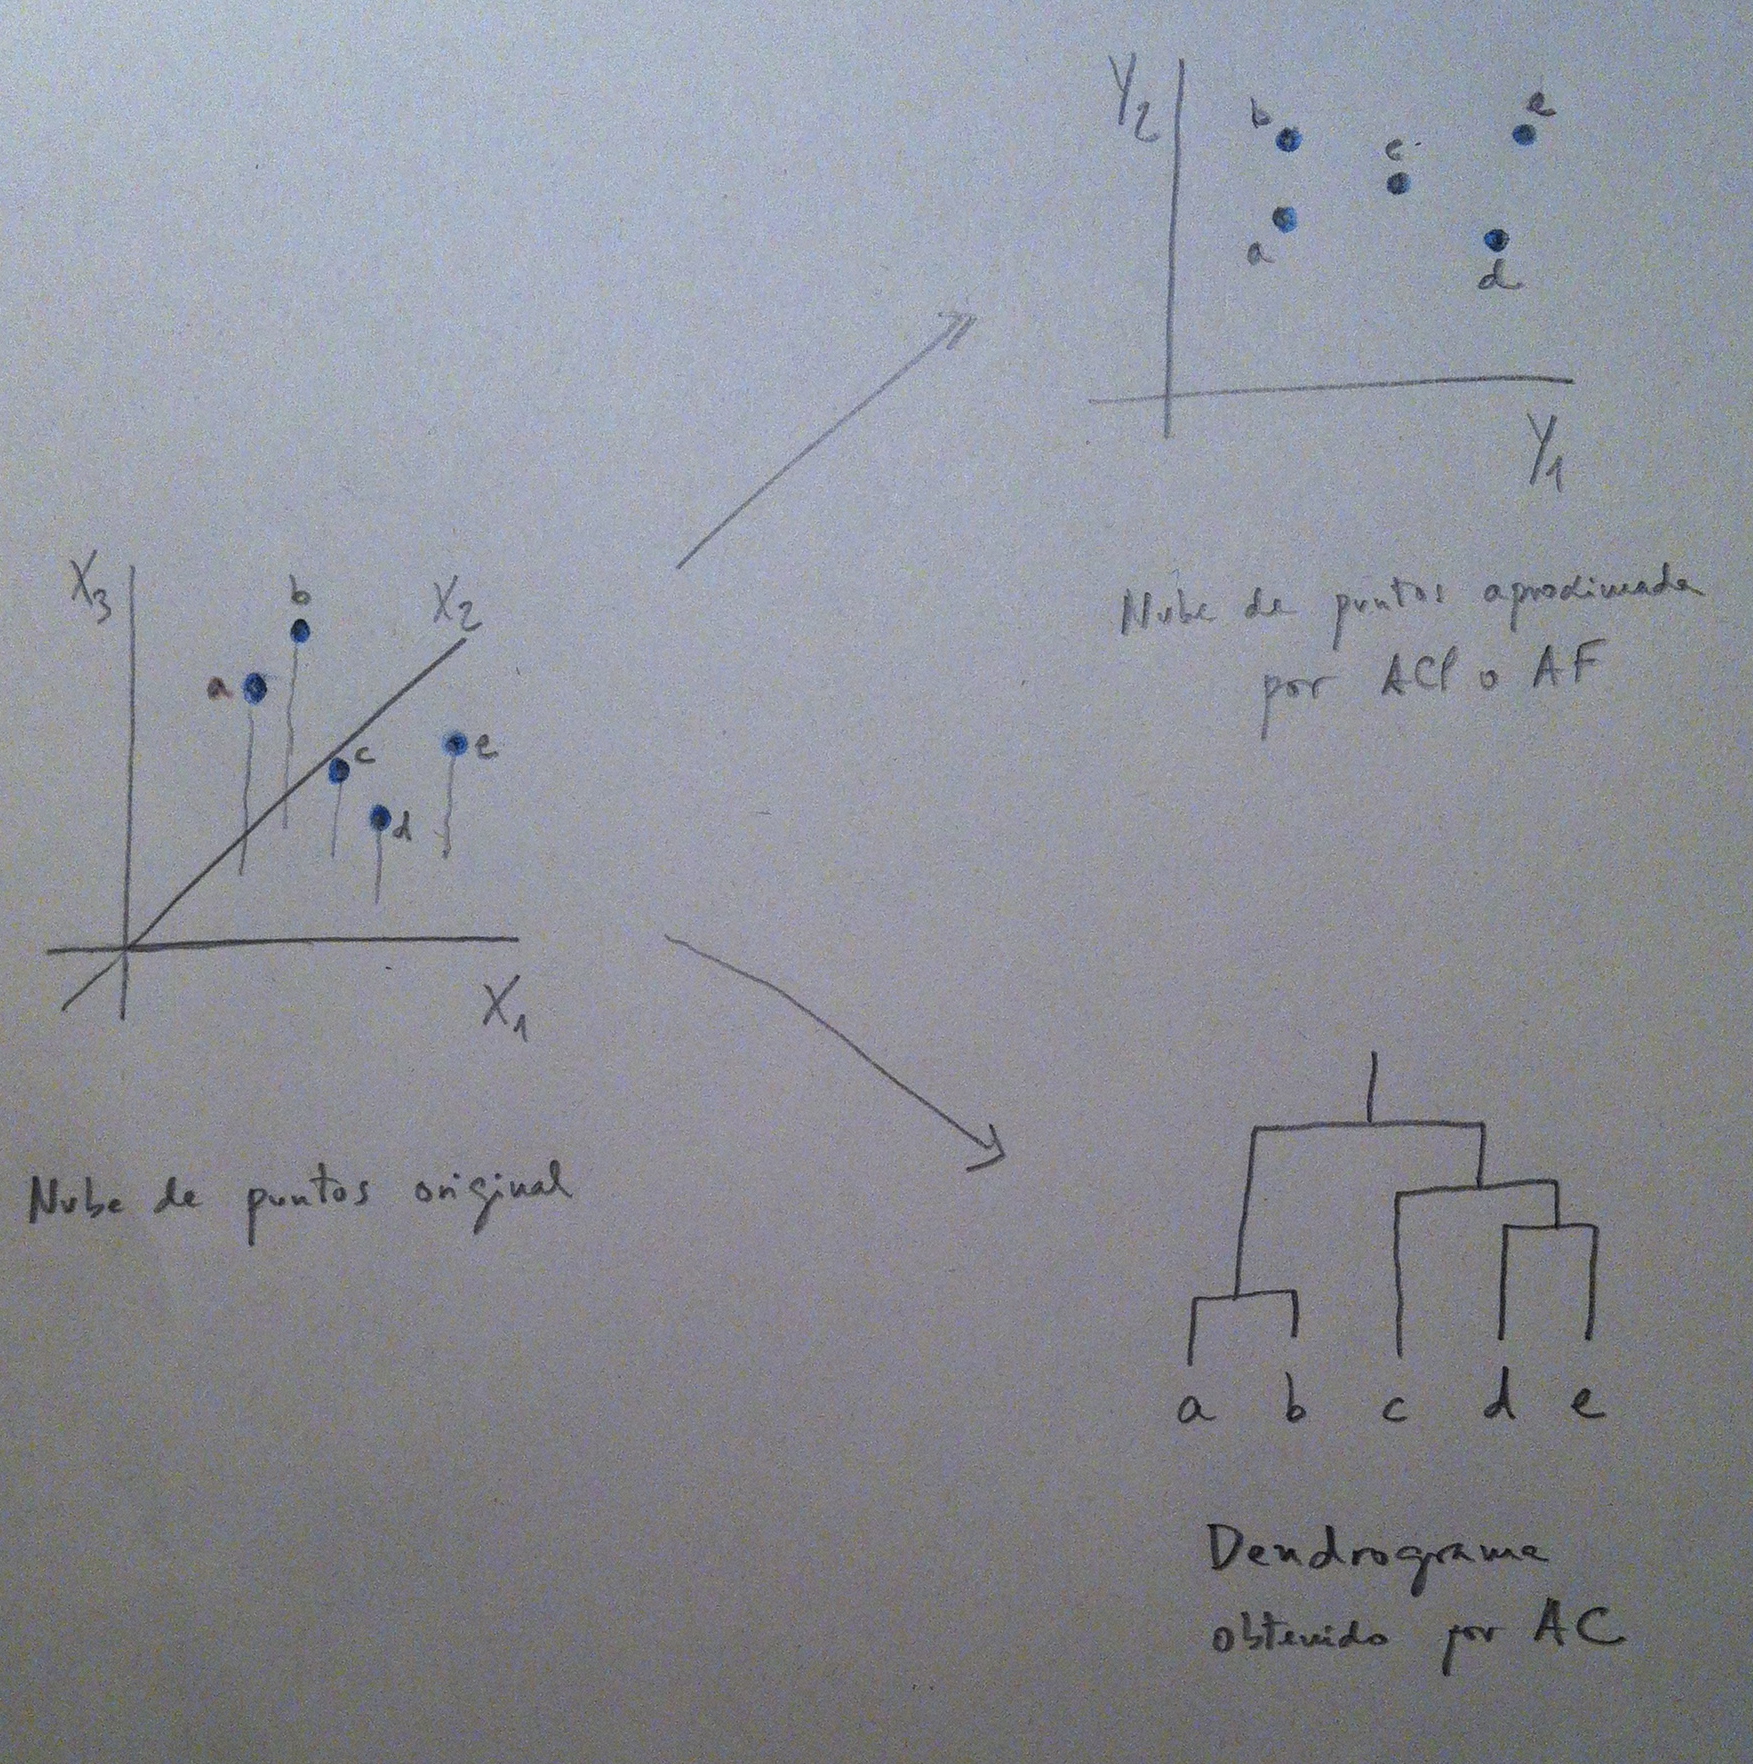
5. El ACP y el AF respetan el tipo de representación: una nube de puntos, pero al reducir dimensiones se pierde información y esto es un problema, especialmente si la pérdida es importante. El AC respeta la nube de puntos original, no reduce dimensiones y, por lo tanto, no se pierde información, pero, eso sí, se cambia el mecanismo de representación, se cambia el estilo de representación. Representamos la nube de puntos mediante un dendrograma. Digamos que en el ACP y el AF se hace una representación figurativa y en el AC se hace una representación abstracta. Veamos un gráfico que nos ilustra la comparación:
IMG_4660

6. A la izquierda de este gráfico tenemos una supuesta nube de puntos original. En este caso con tres dimensiones para que lo visualicemos, pero normalmente esta nube de puntos no la veremos, será una nube de puntos de muchas más dimensiones. A la derecha vemos las dos estrategias gráficas: Arriba una representación mediante una nube de puntos también, aunque en dos dimensiones que pueden ser las diseñadas por dos componentes principales o por dos factores, según la técnica utilizada. Abajo una representación bien distinta: un dendrograma, que, como a continuación veremos, se construye a partir de la nube de puntos original mediante unos procedimientos que conviene explicar con detalle.

7. Visto así parecería que el AC tiene ventajas: cambiamos la forma de representación pero no perdemos información. Parece mejor opción, pero sólo lo parece. Porque ahora veremos que en el AC hay dos momentos de decisión en la técnica que nos lleva a procedimientos que nos pueden generar realmente representaciones muy diferentes.

8. Veamos el procedo seguido por el AC para construir un dendrograma a partir de una nube de puntos original constituida por una serie de individuos de los que tienes los valores de varias variables.

9. El primer momento en el AC es definir una noción de distancia entre puntos. Necesitamos elegir una distancia, una medida que nos cuantifique distancias entre los individuos dentro de la nube de puntos original. Y aquí aparece de repente el primer problema del AC: que hay muchas distancias propuestas.

10. Ejemplos de distancias: La distancia euclídea es la más intuitiva y la más utilizada, de largo. Es la que calcula la distancia en línea recta entre los puntos en el espacio o en el hiperespacio de la nube de puntos original. Esta distancia en realidad es una aplicación del Teorema de Pitágoras:
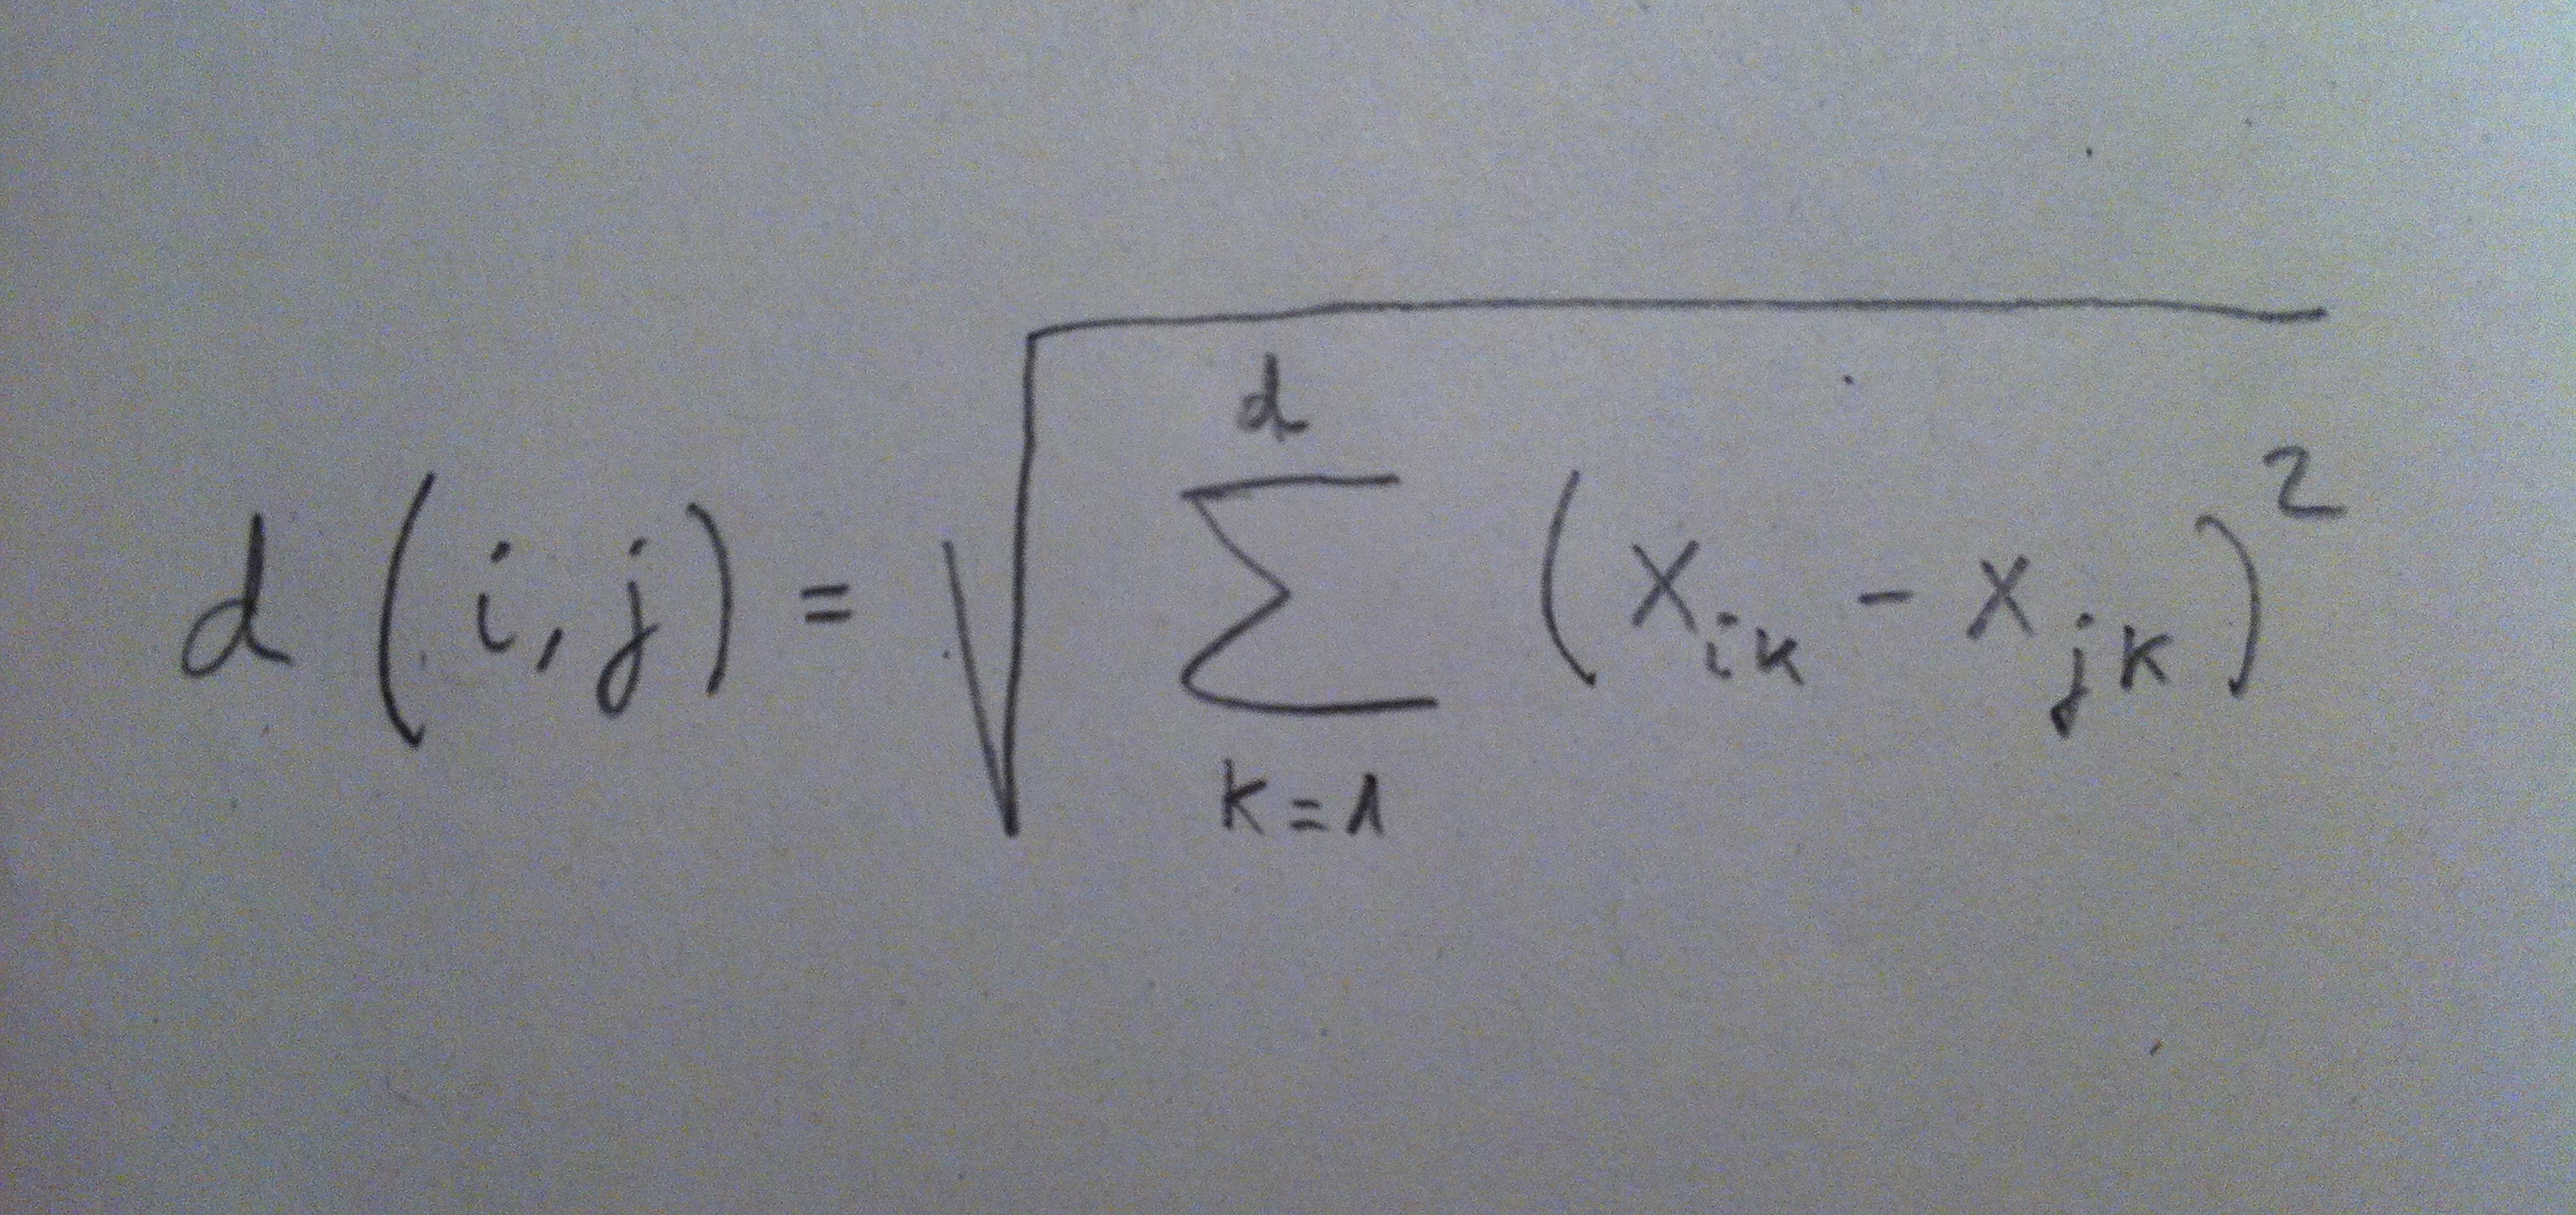
IMG_4632

Otra distancia muy utilizada es la denominada distancia Ciudad, que también se la llama distancia Taxi:
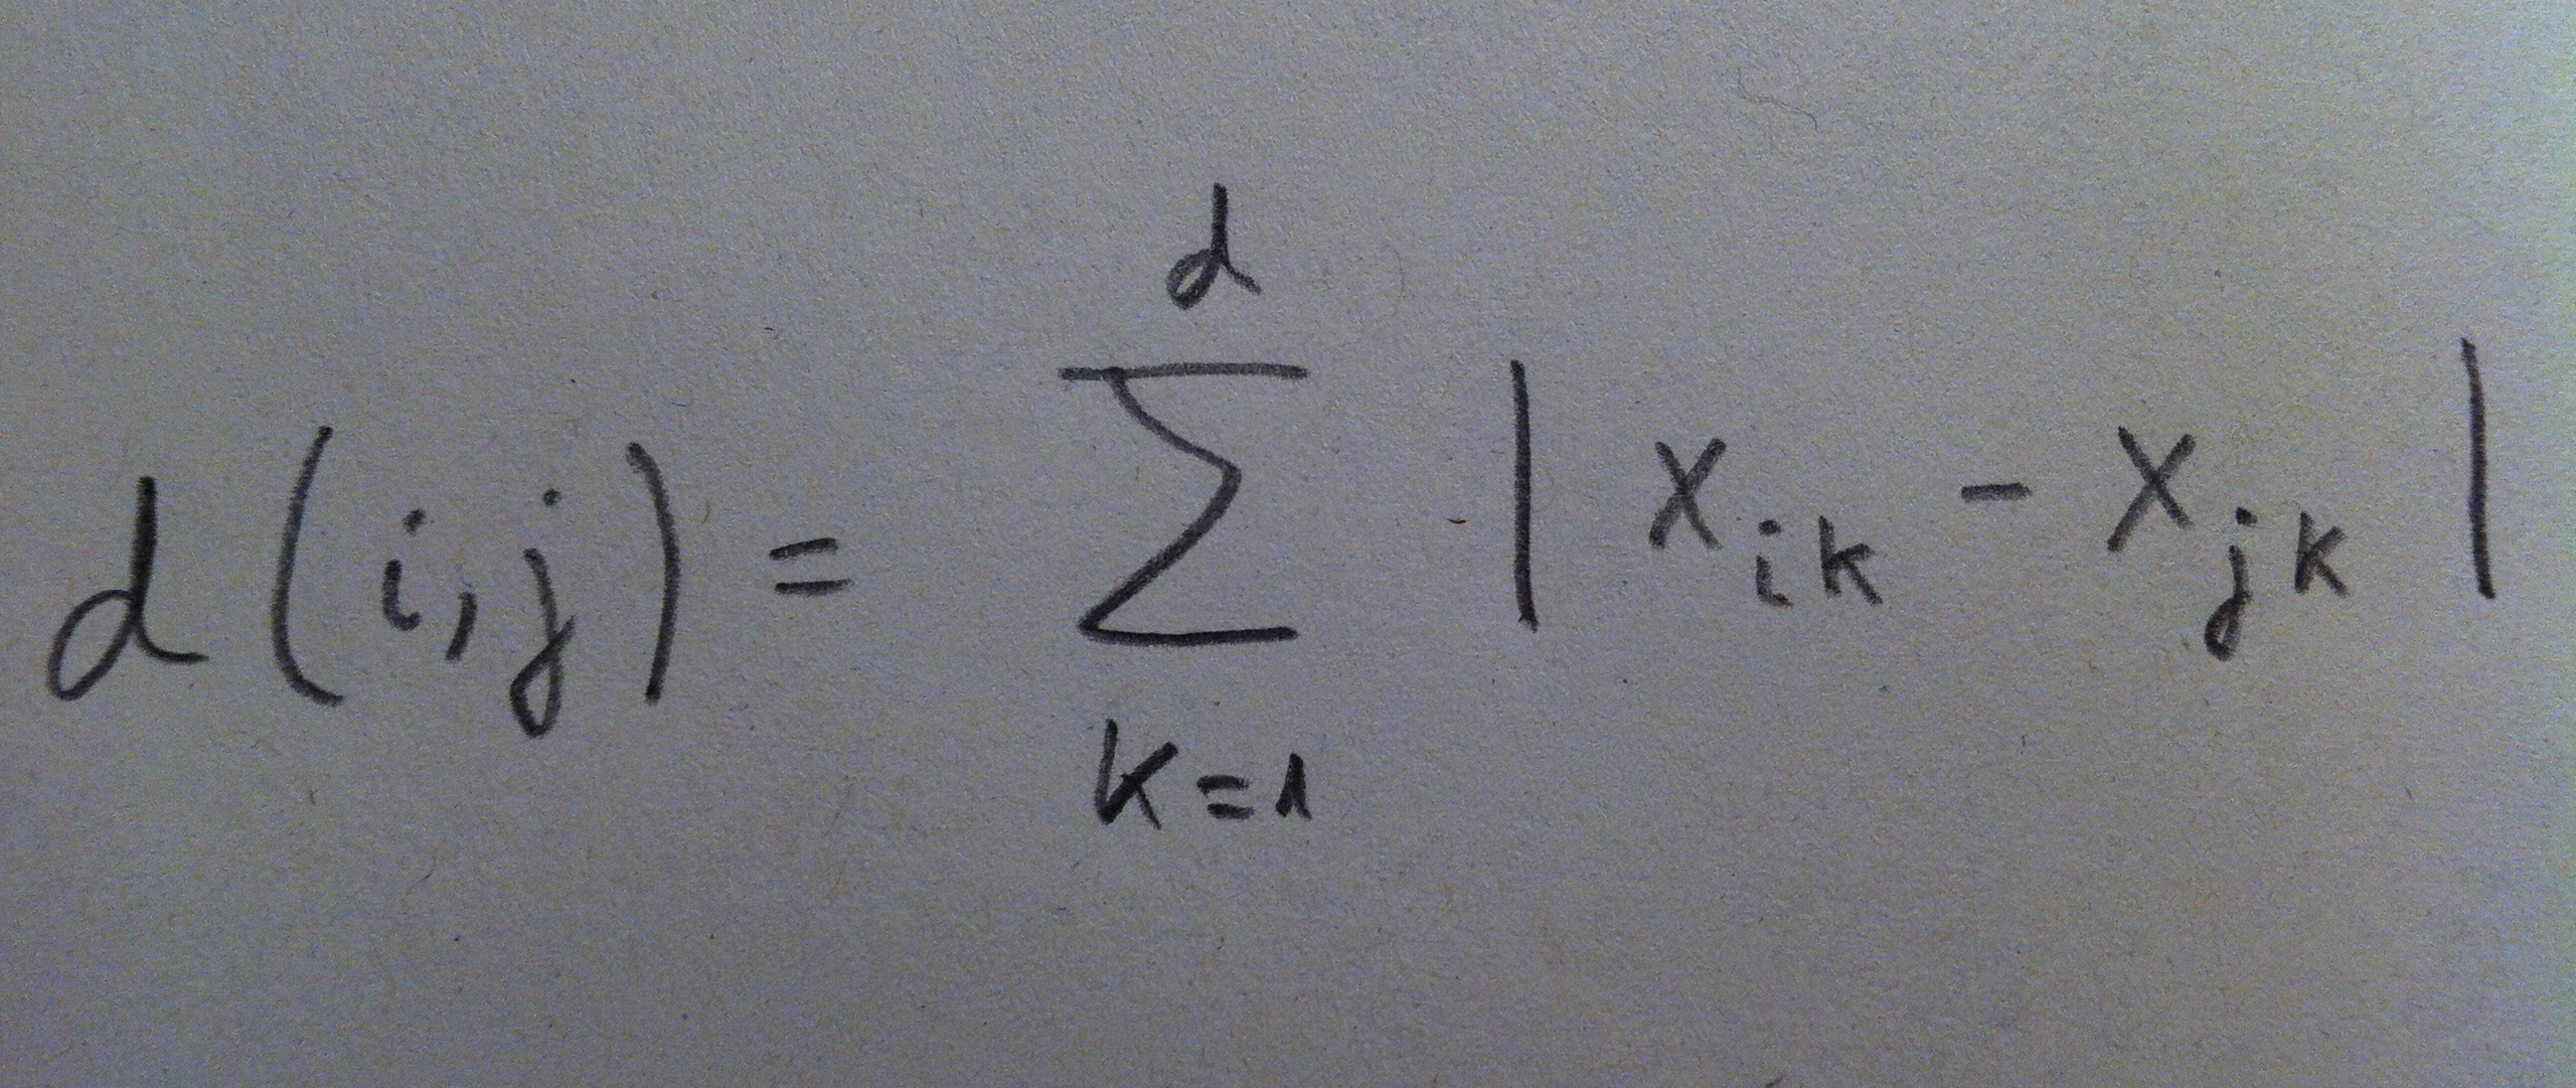
IMG_4633

Otra distancia utilizada frecuentemente es la denominada distancia del máximo:
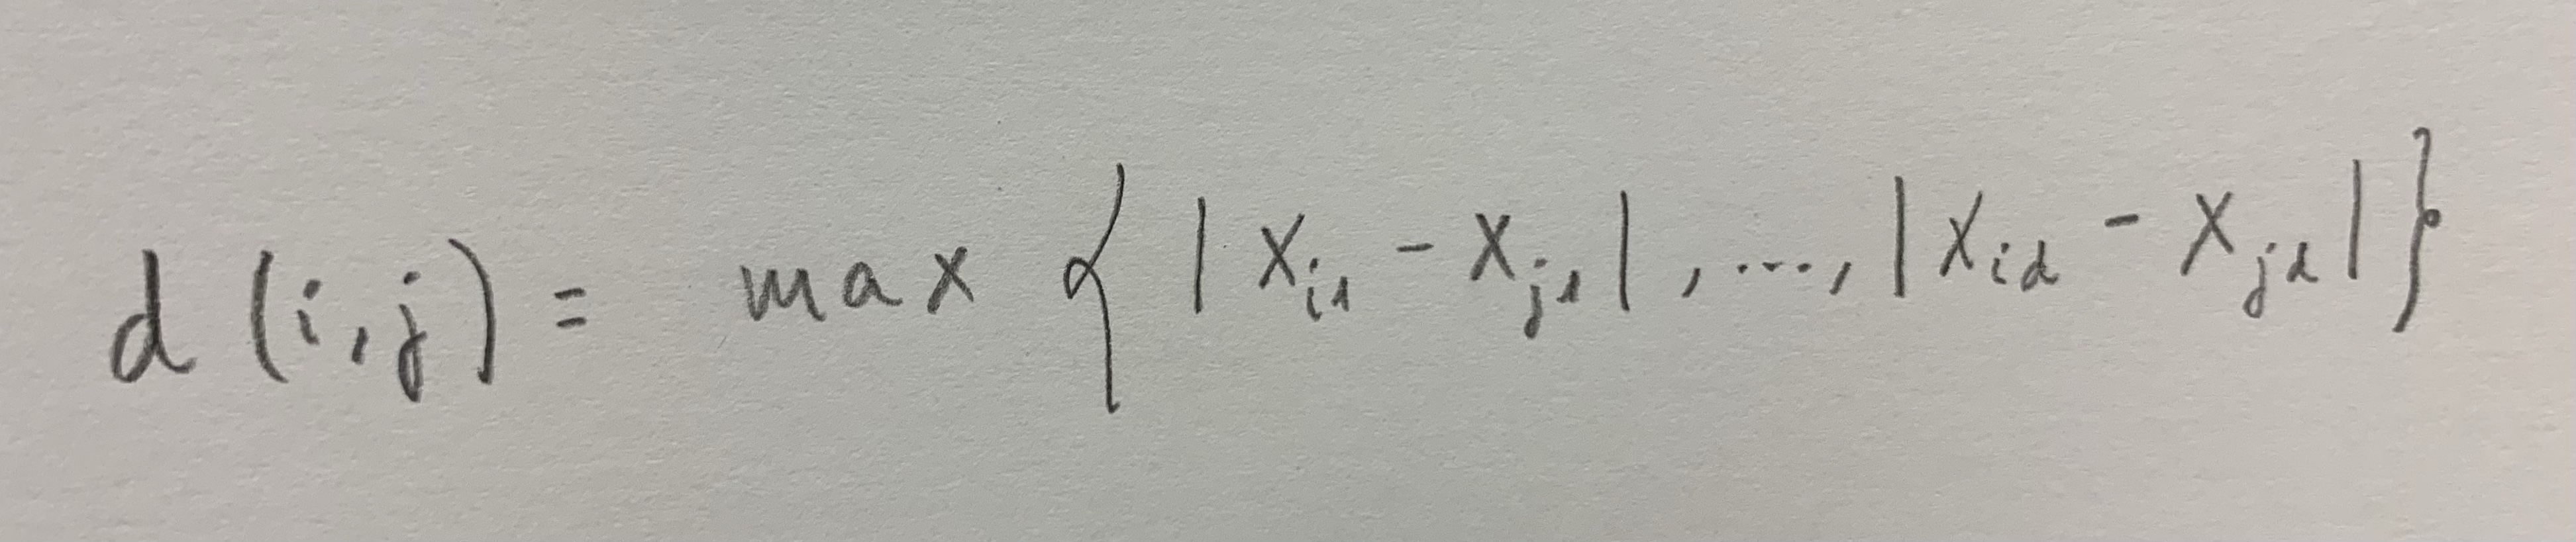
img_6384

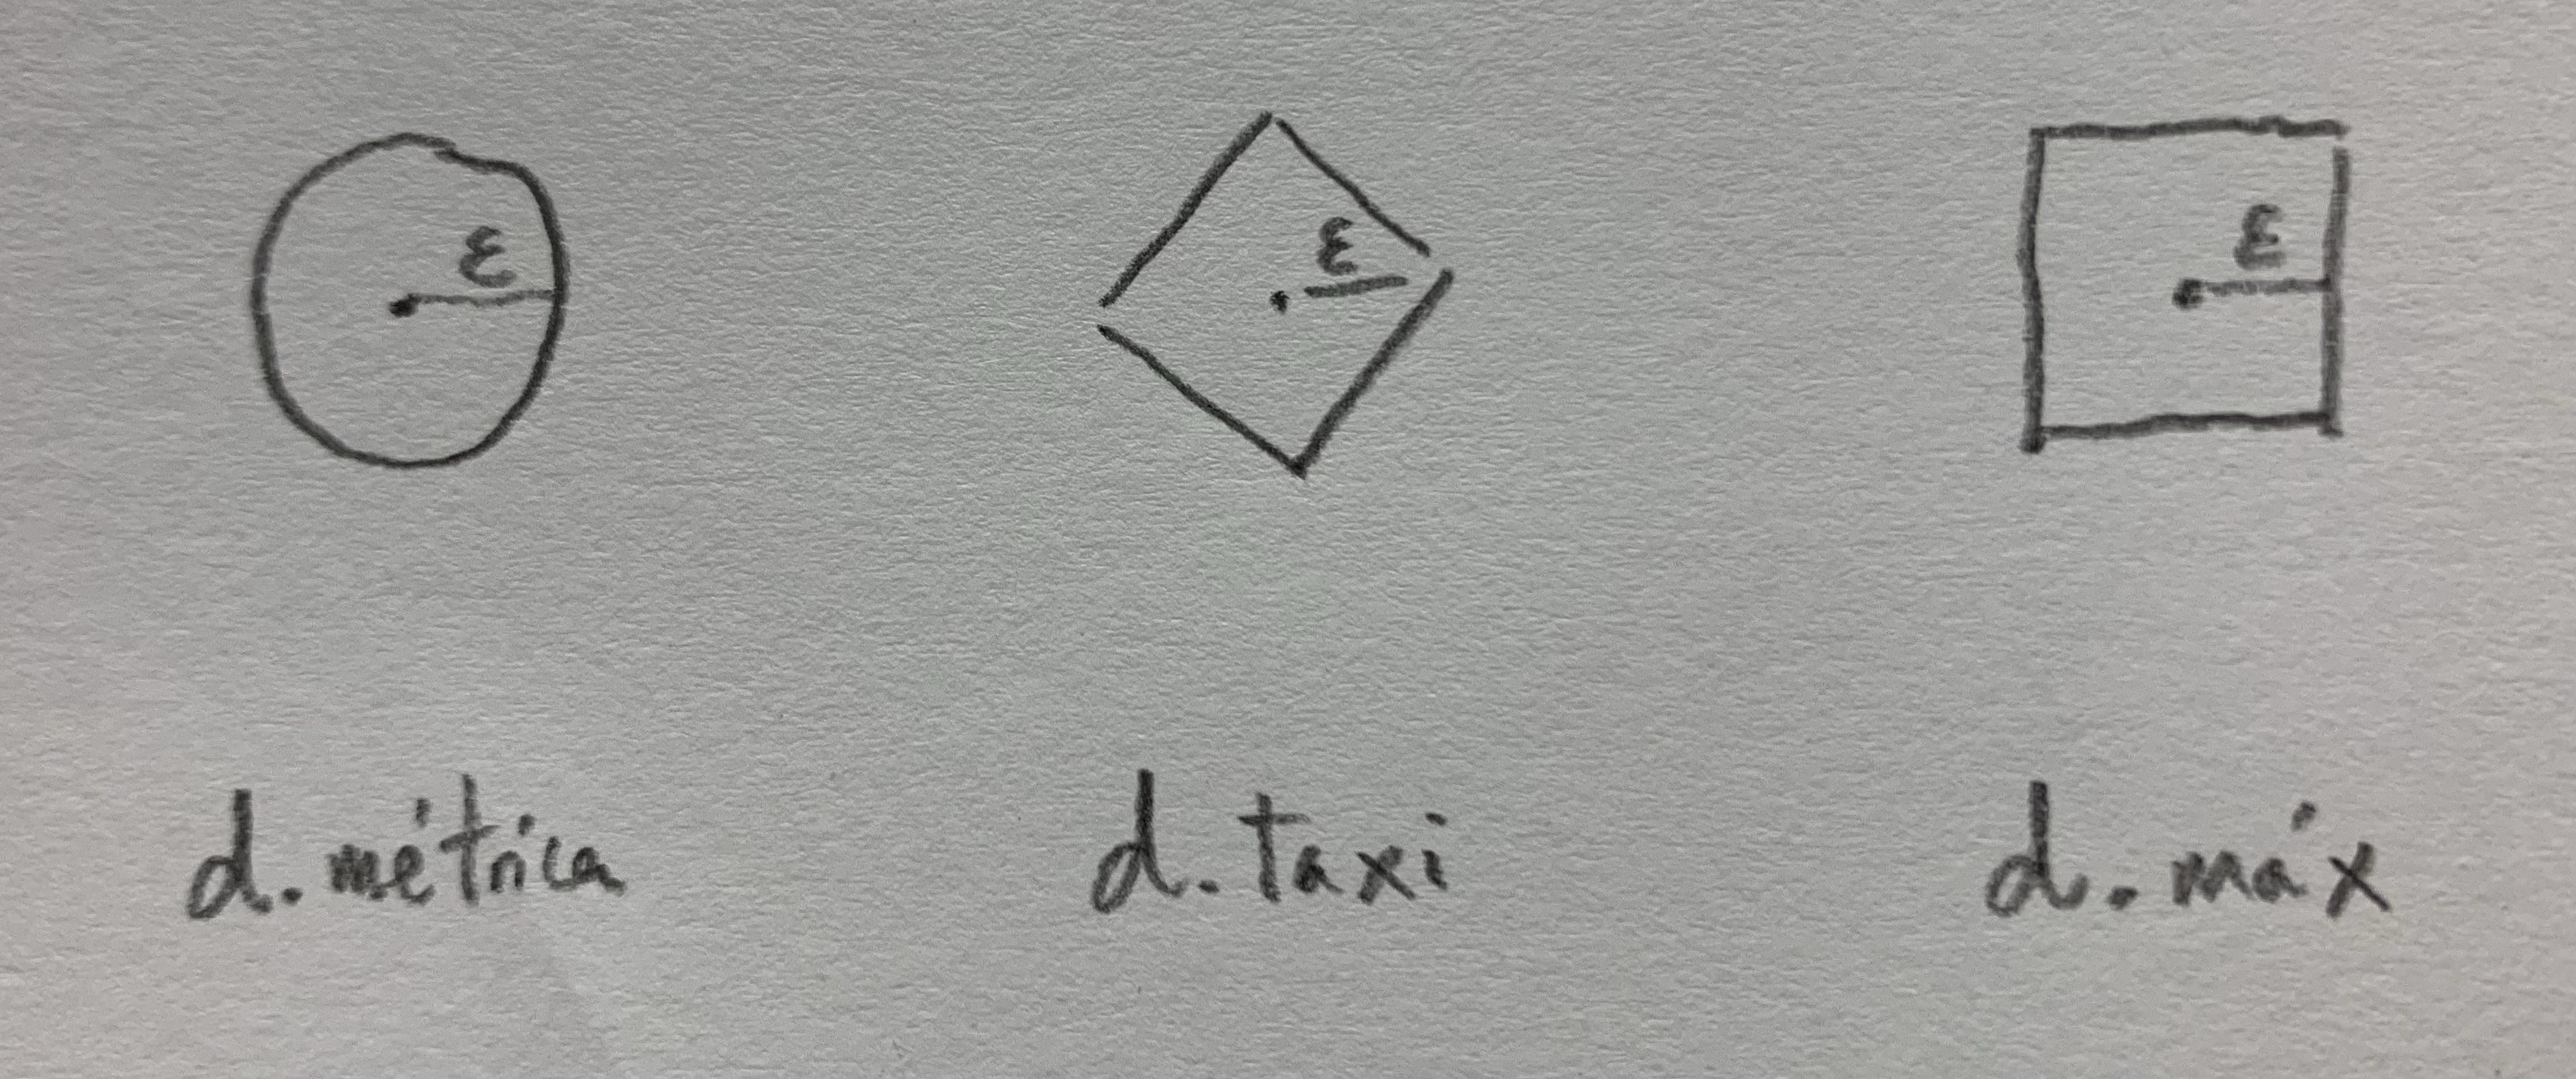
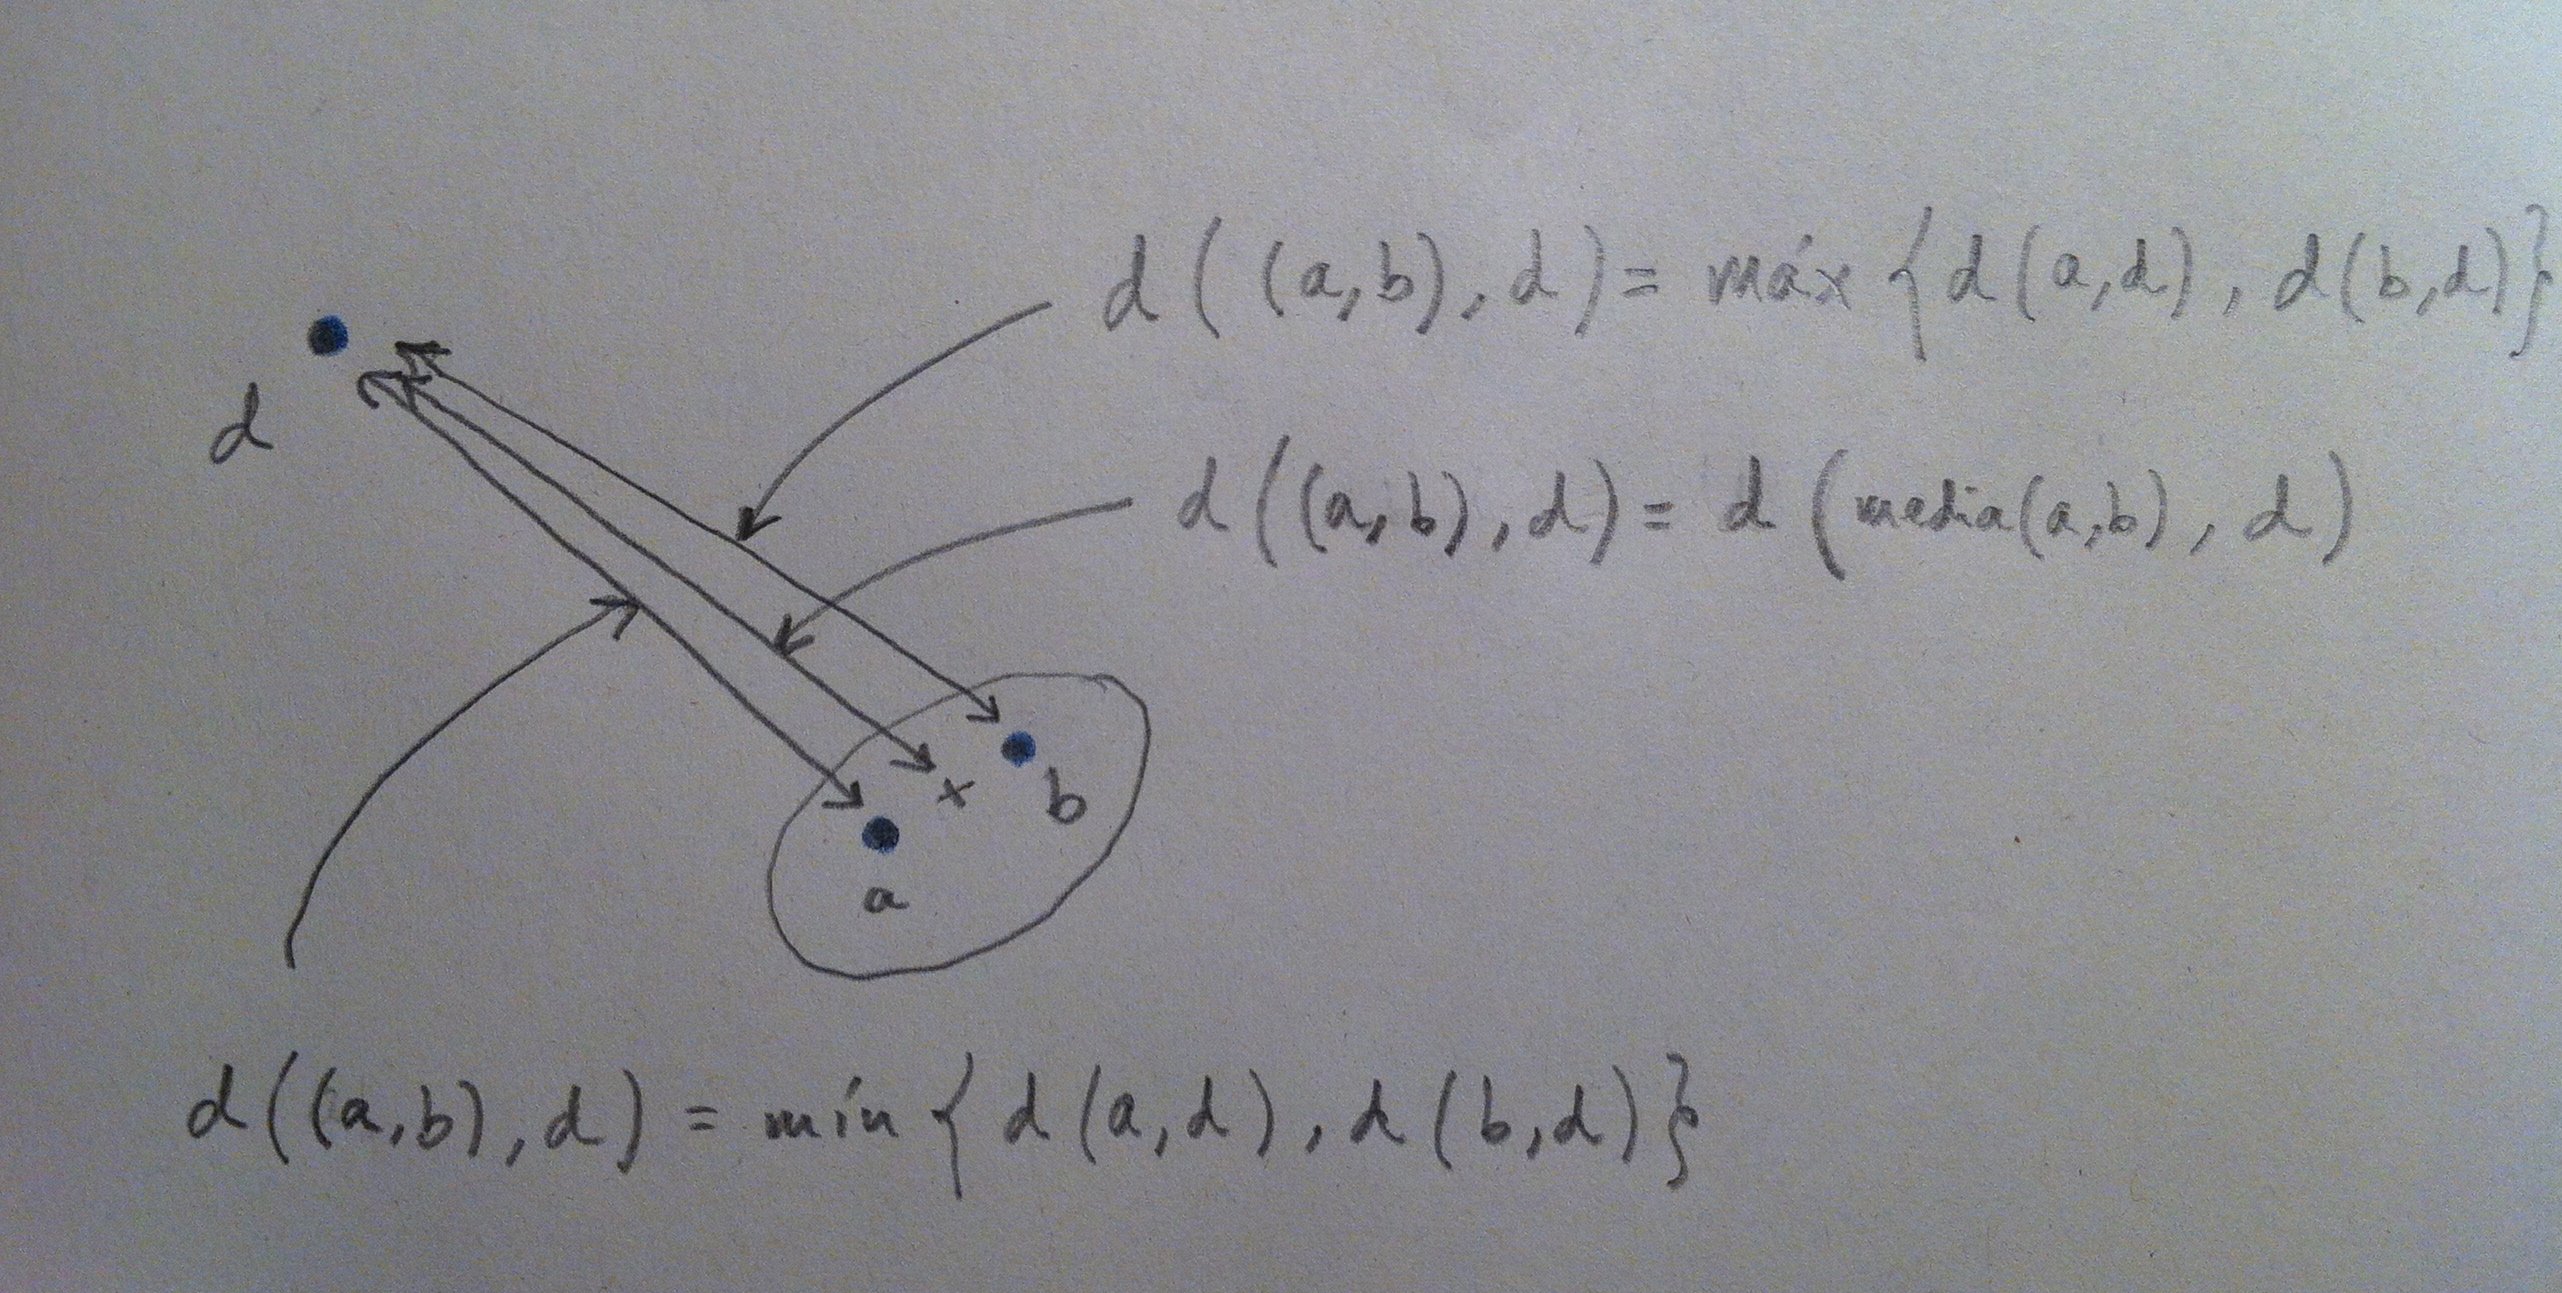
11. Veamos una comparación entre estas tres distancias:
img_6385

El círculo en la métrica, el rombo en la distancia taxi y el cuadrado en la distancia del máximo delimitan puntos que están a una distanacia Épsilon del centro.

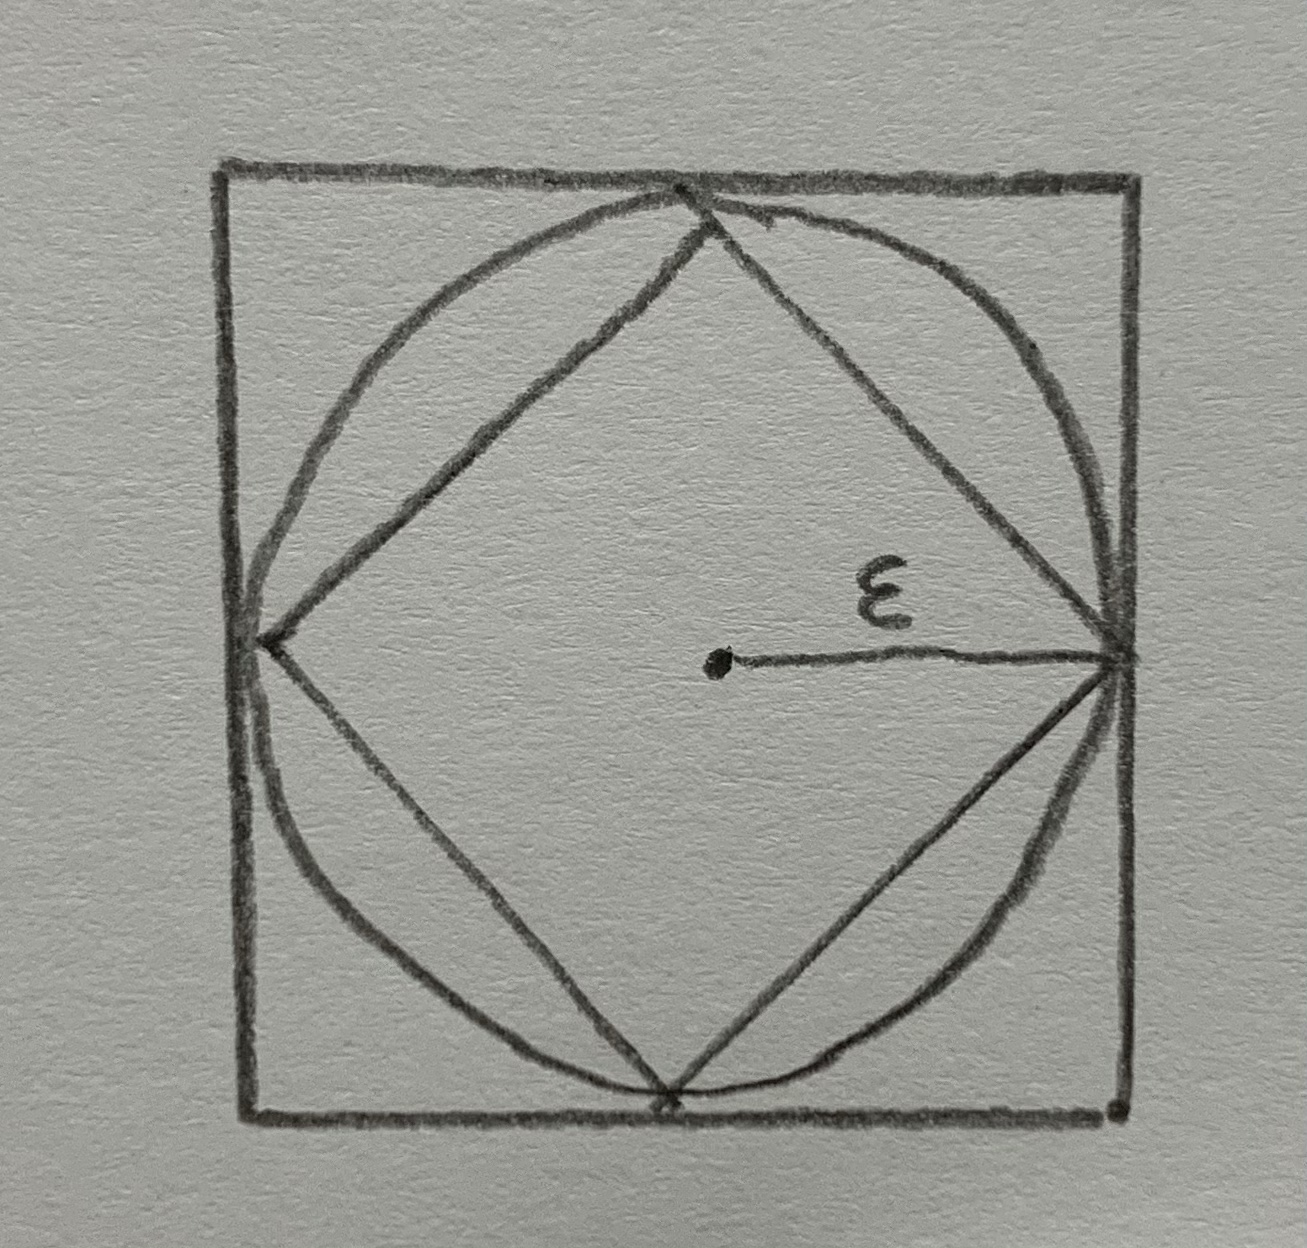
Se pueden superponer y ver cómo asignan valores diferentes de distancia a un mismo punto, o, por el contrario, asignan la misma distancia a puntos que no ocupan la misma posición; o sea, que no tienen las mismas coordenadas:
img_6388

12. La distancia Mahalanobis es una distancia de mucho prestigio en Estadística Se trata de una distancia que tiene en cuenta no sólo las distancias que hay en cada una de las variables sino que cada una de estas distancias la relativiza respecto a la dispersión que tiene cada una de esas variables originales:
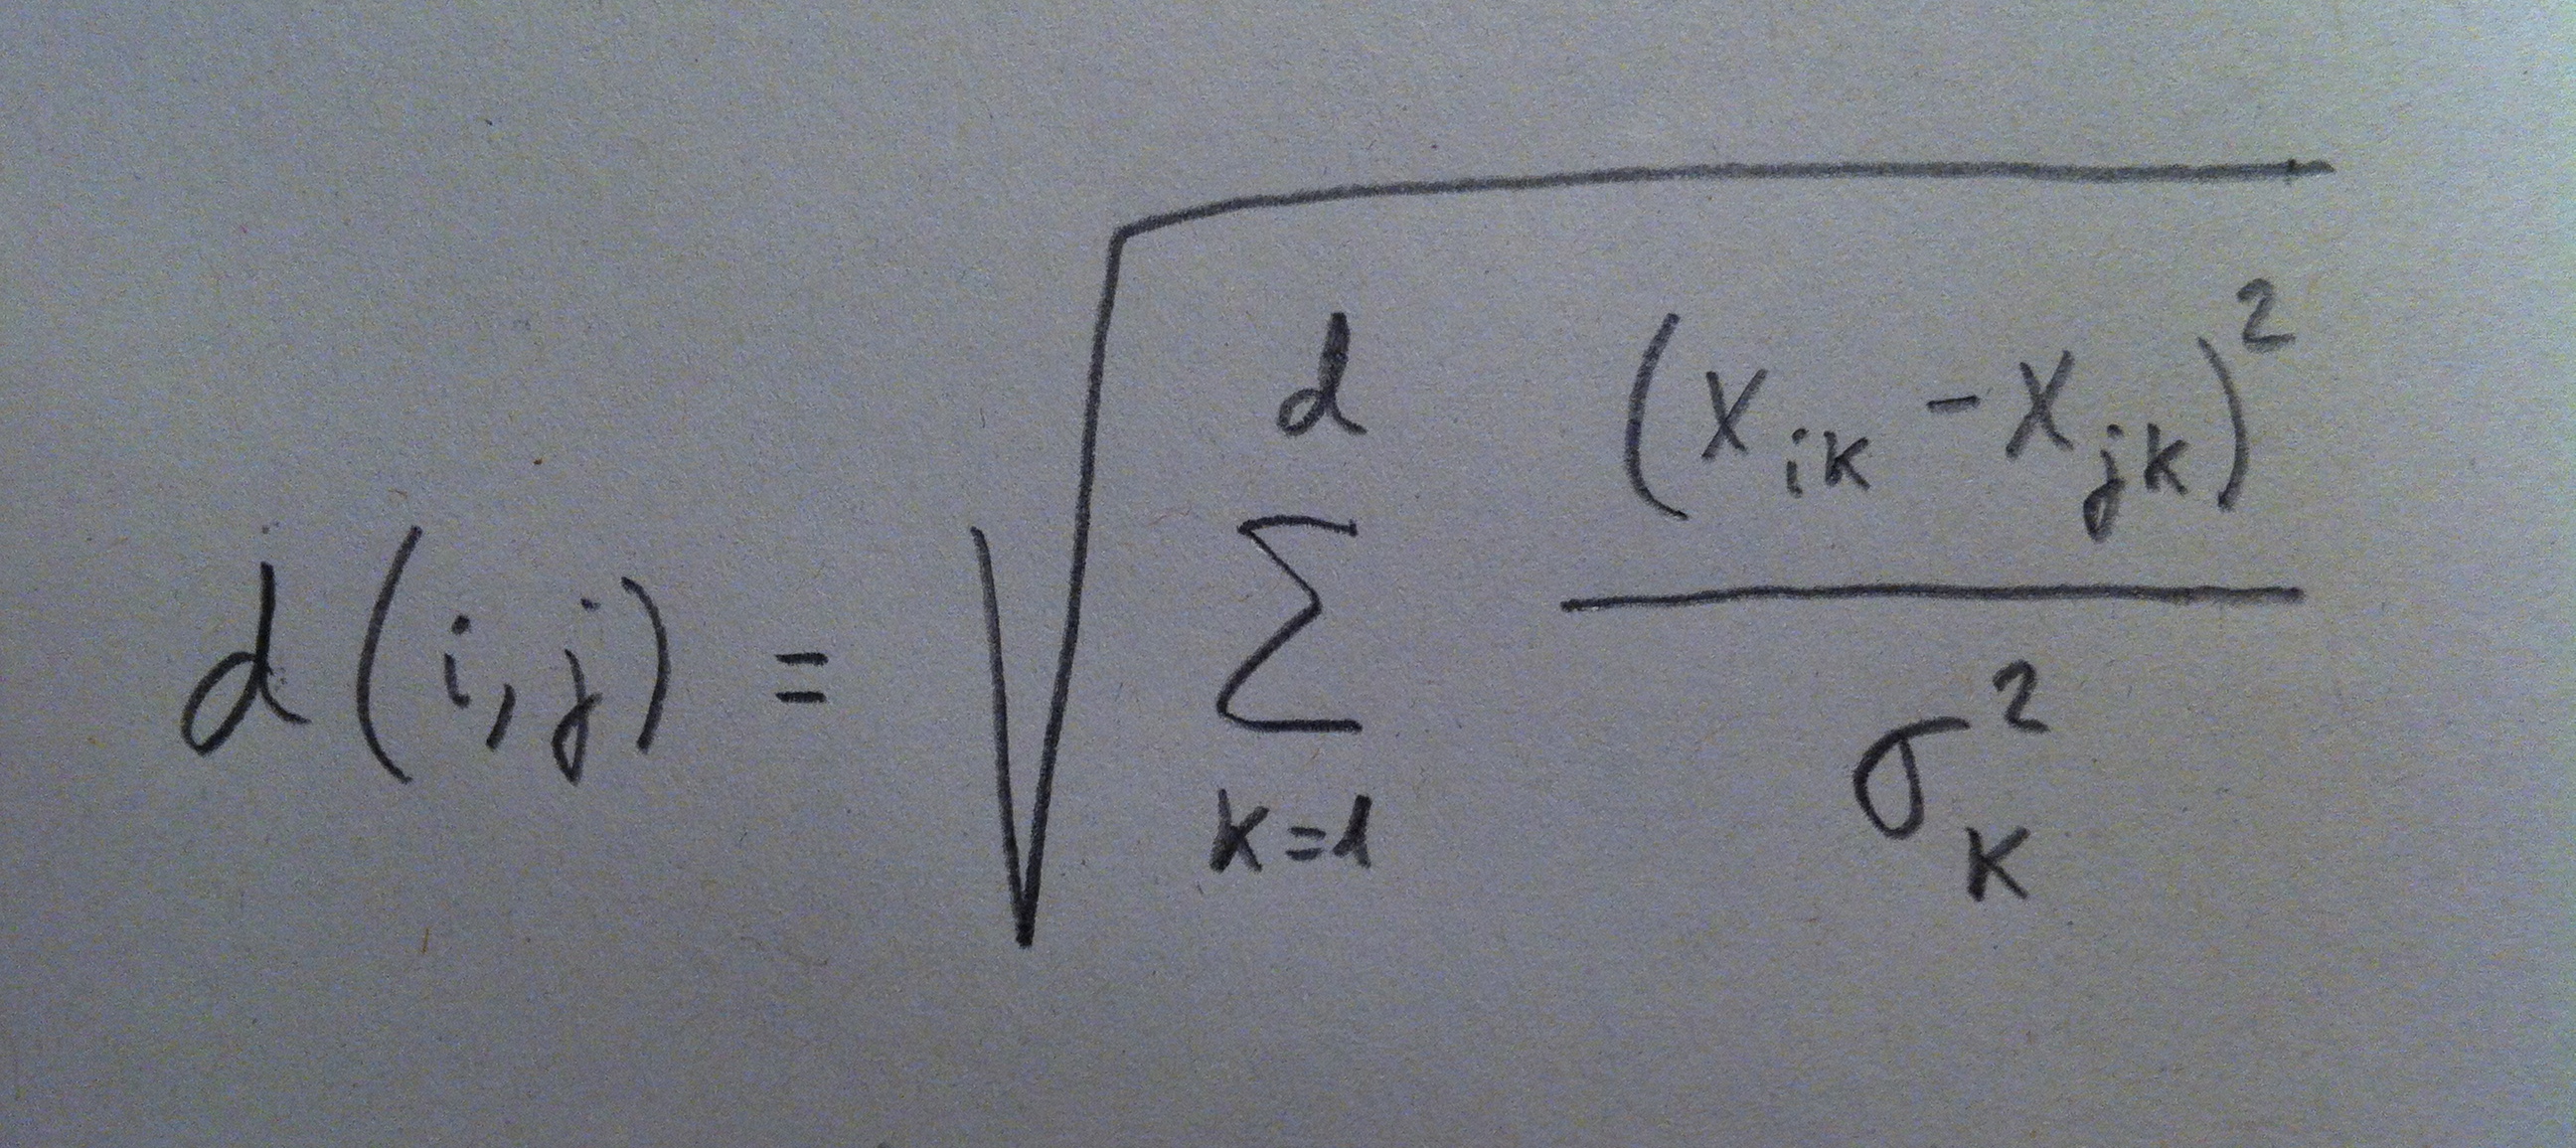
IMG_4634

13. Hay muchas más distancias definidas y utilizadas. De hecho, para ser distancia una función debe cumplir las siguientes propiedades:
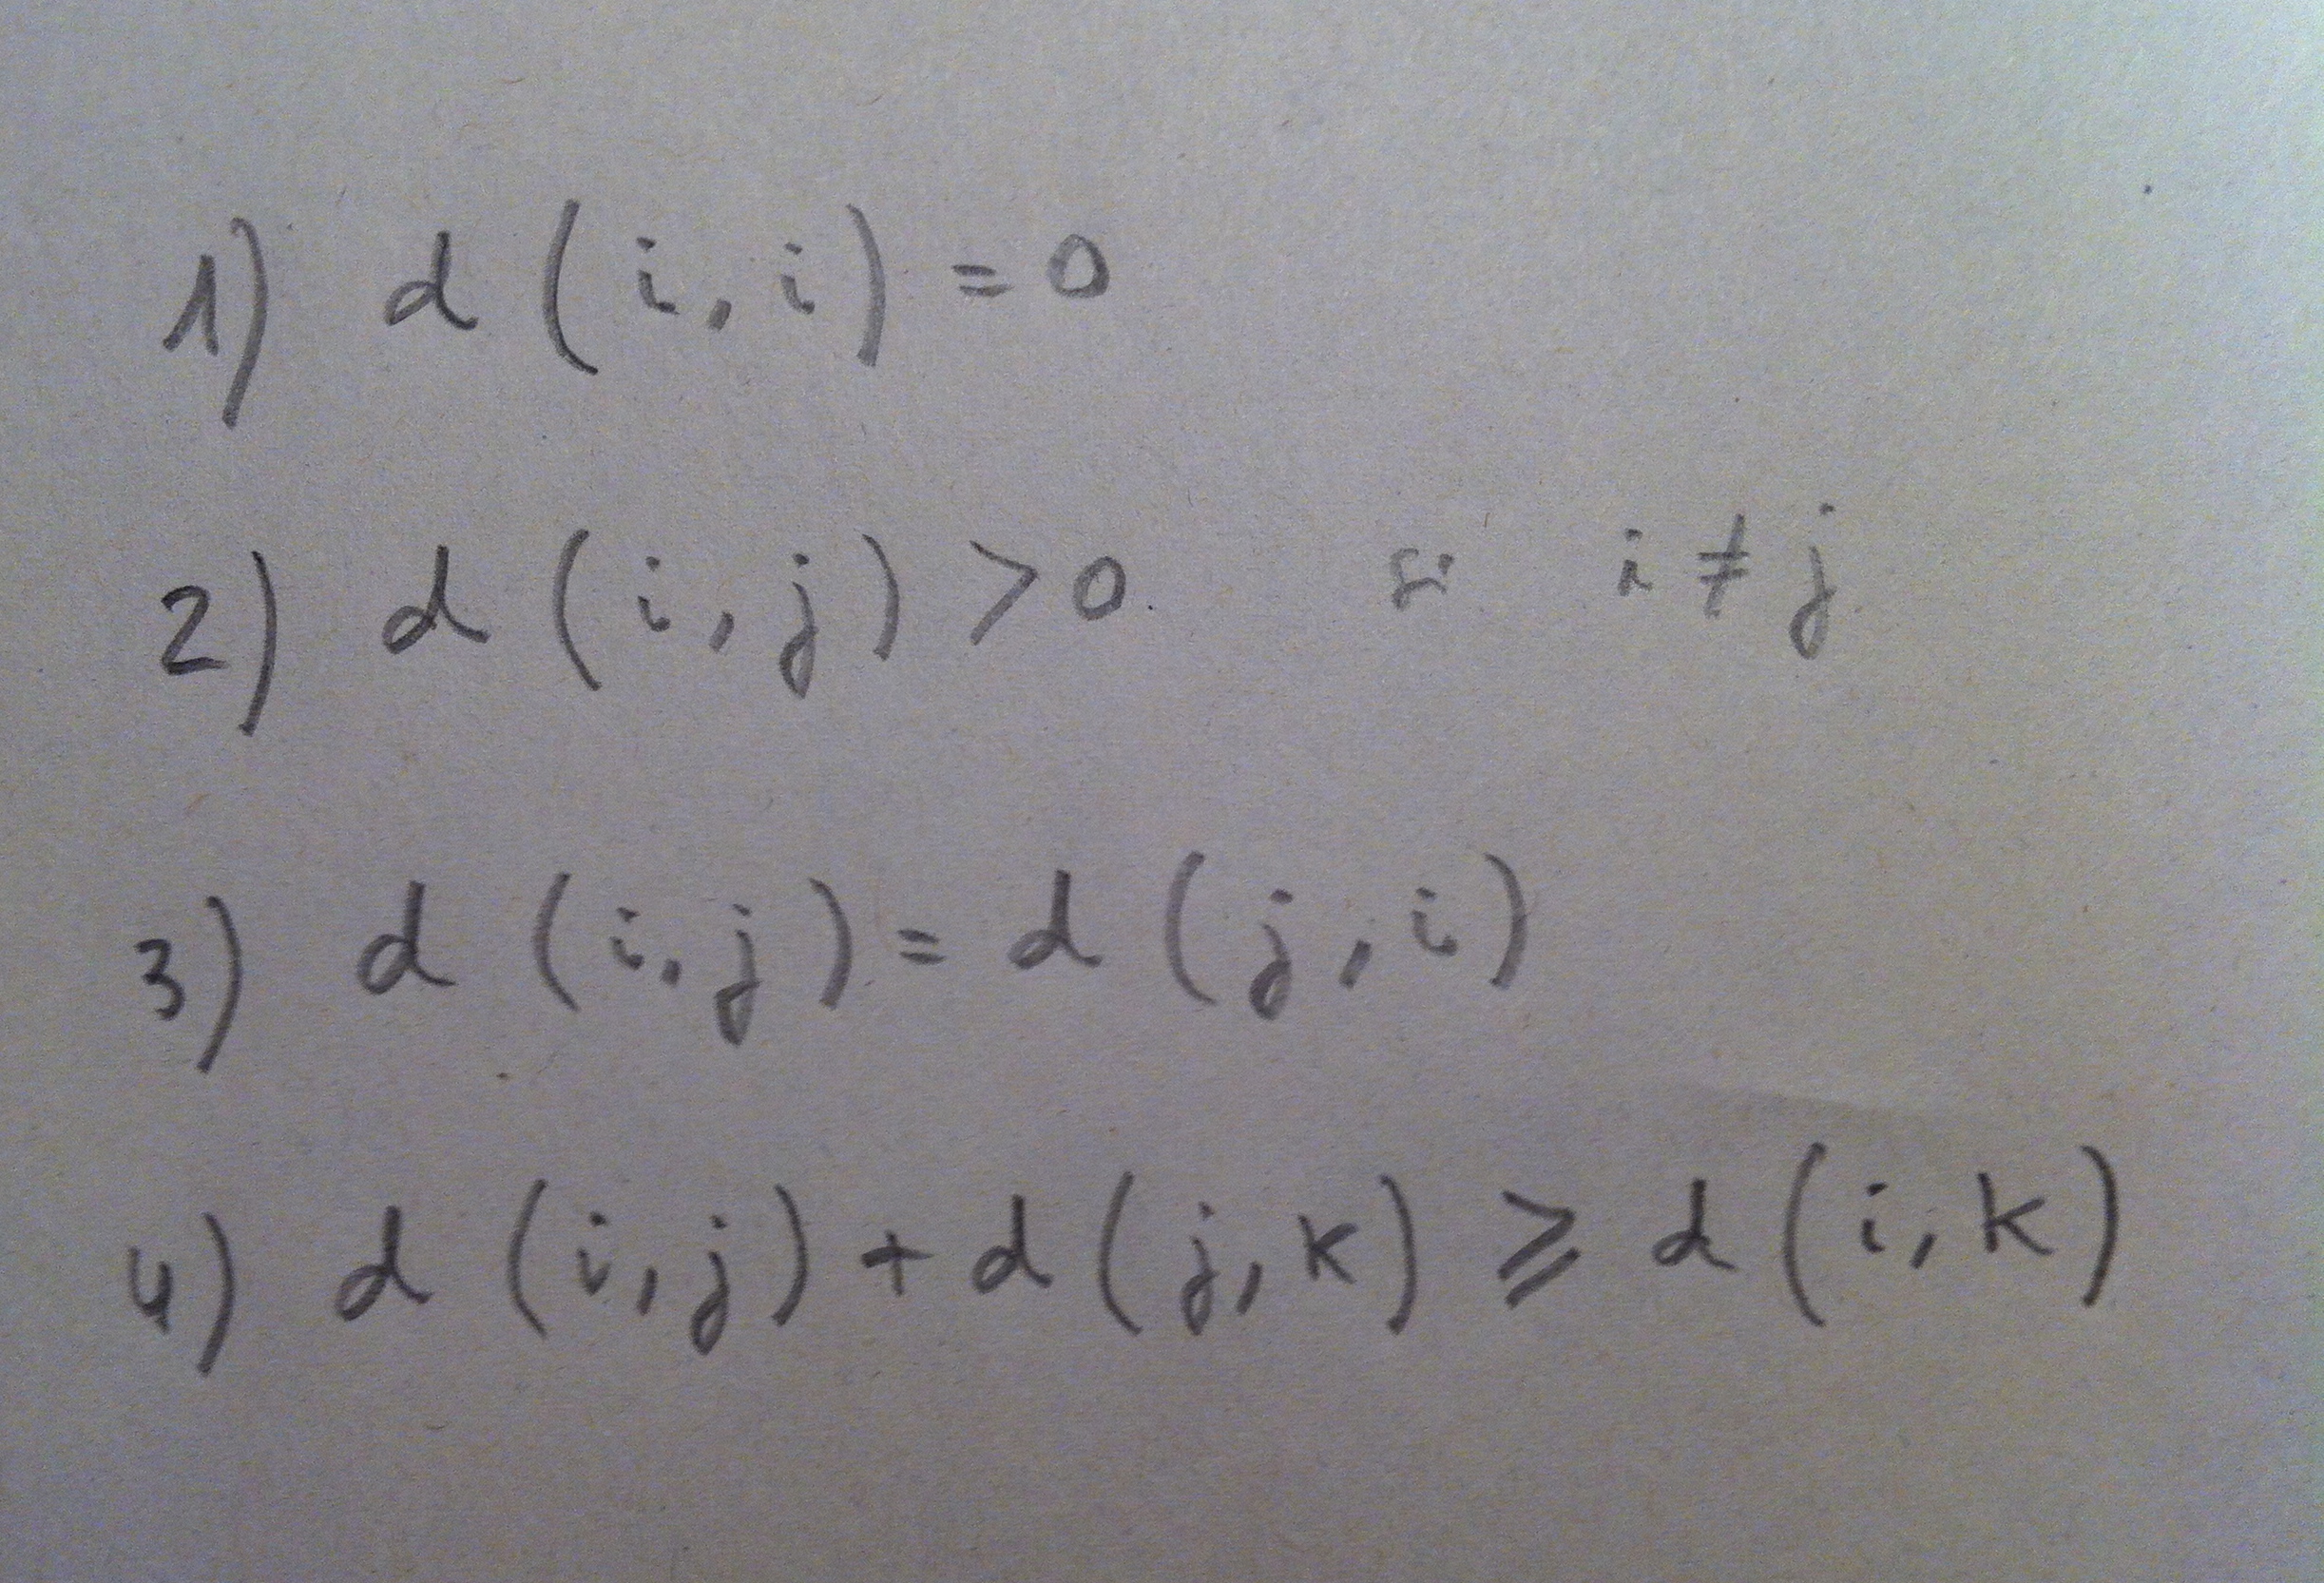
IMG_4640

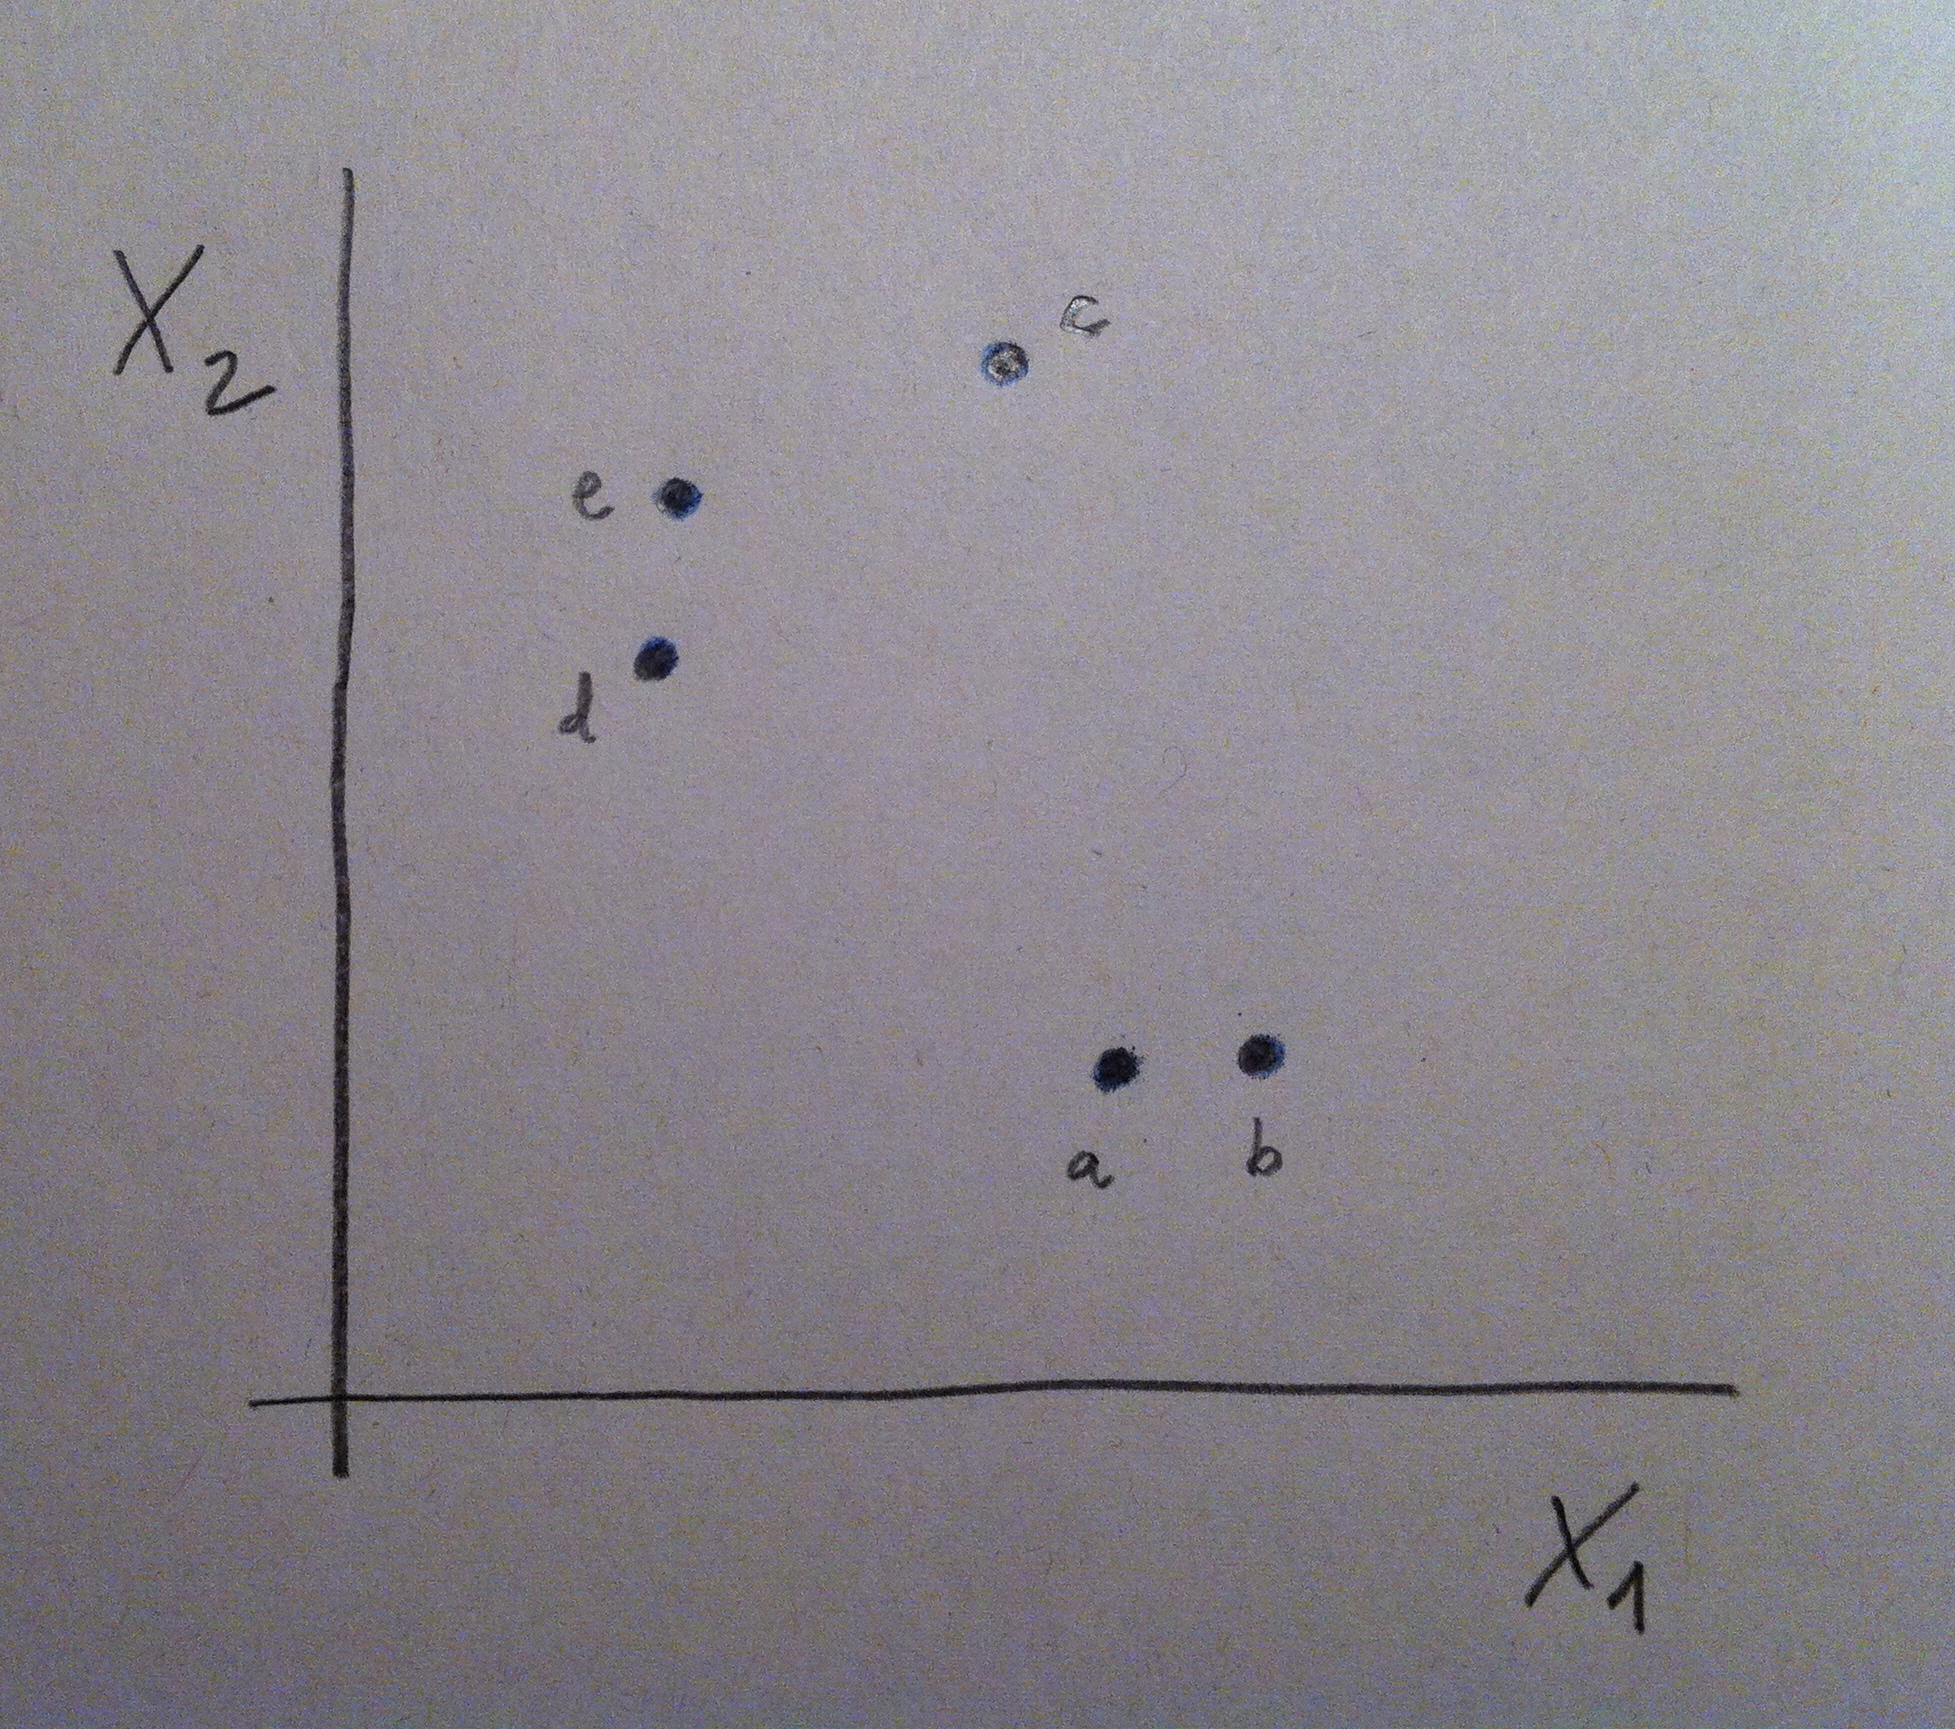
14. Veamos un ejemplo, en miniatura, para ver así qué pasos se siguen a la hora de hacer un AC. Vamos a ver un caso con sólo dos variables para visualizar con detalle microscópicamente todo lo que se hace, pero pensemos que lo que diga es perfectamente extrapolable al número de variables que sean. Supongamos los siguientes cinco individuos: a, b, c, d y e:
IMG_4641

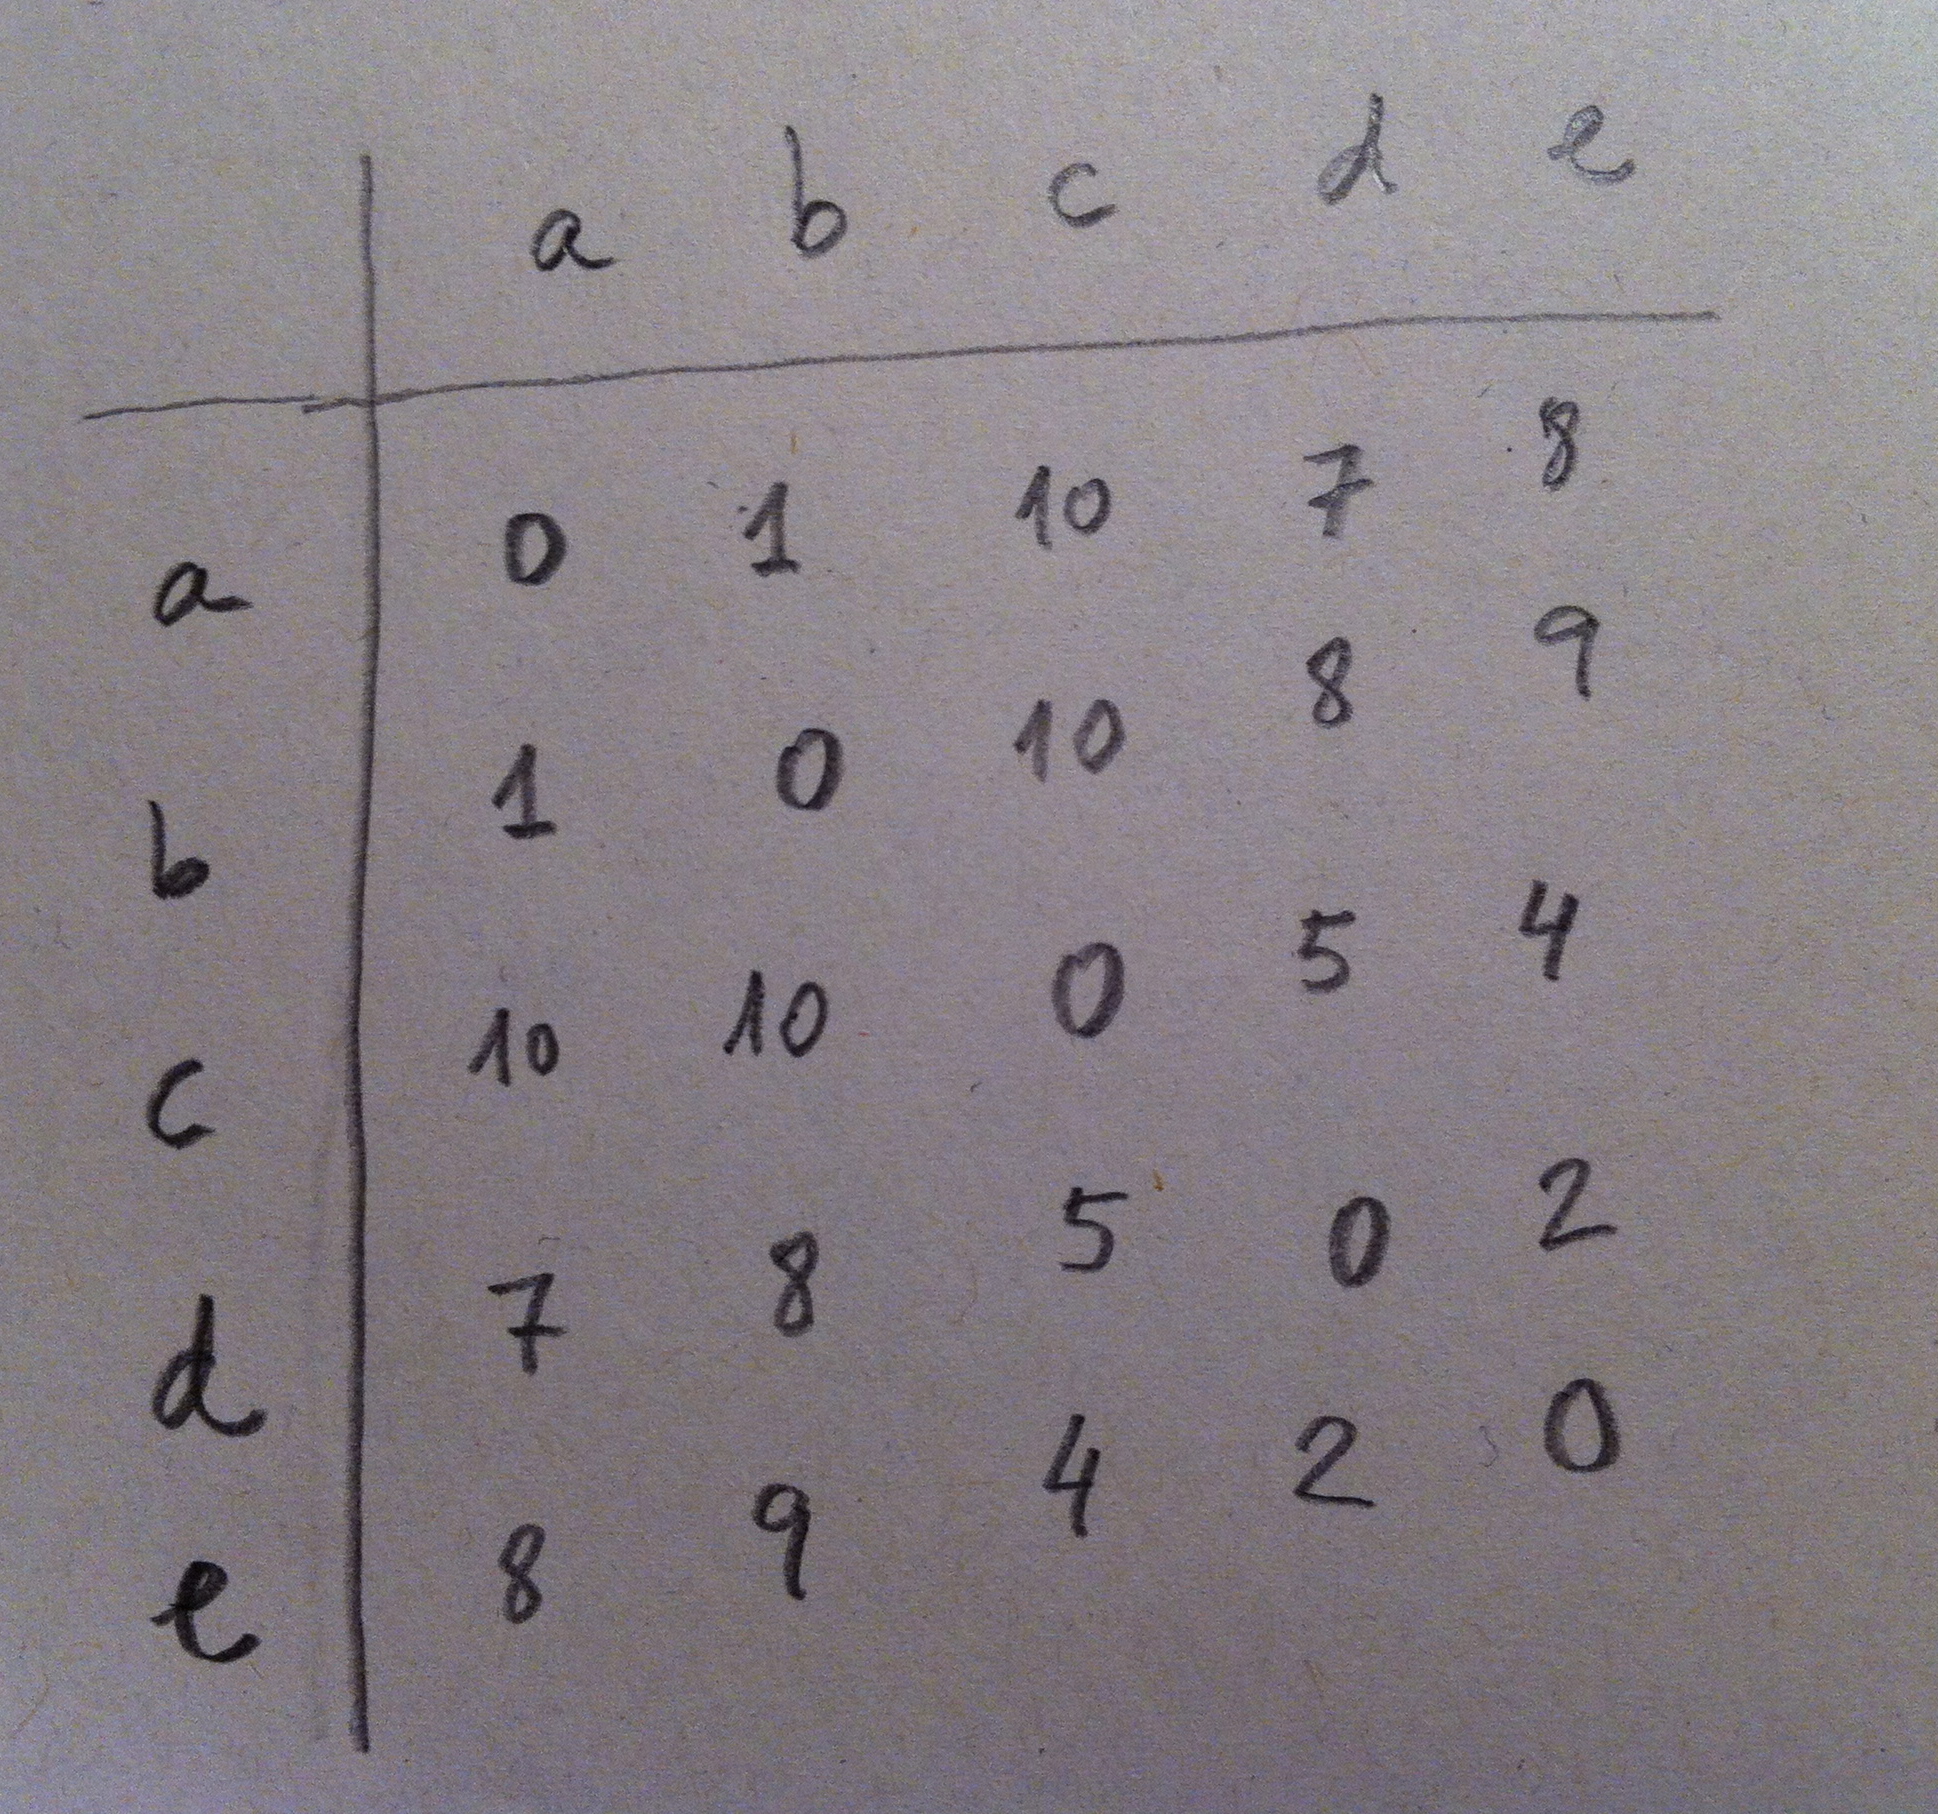
15. Vamos a construir, paso a paso, el dendrograma. Lo primero es elegir una distancia, como ya hemos dicho. Una vez elegida calcularíamos todas las distancias entre los puntos mediante esa distancia elegida. Obtendríamos, así, una matriz de distancias. Una matriz de distancias es una matriz cuadrada, simétrica y con la diagonal principal con ceros. Un ejemplo, en nuestro caso, sería la siguiente matriz:
IMG_4642

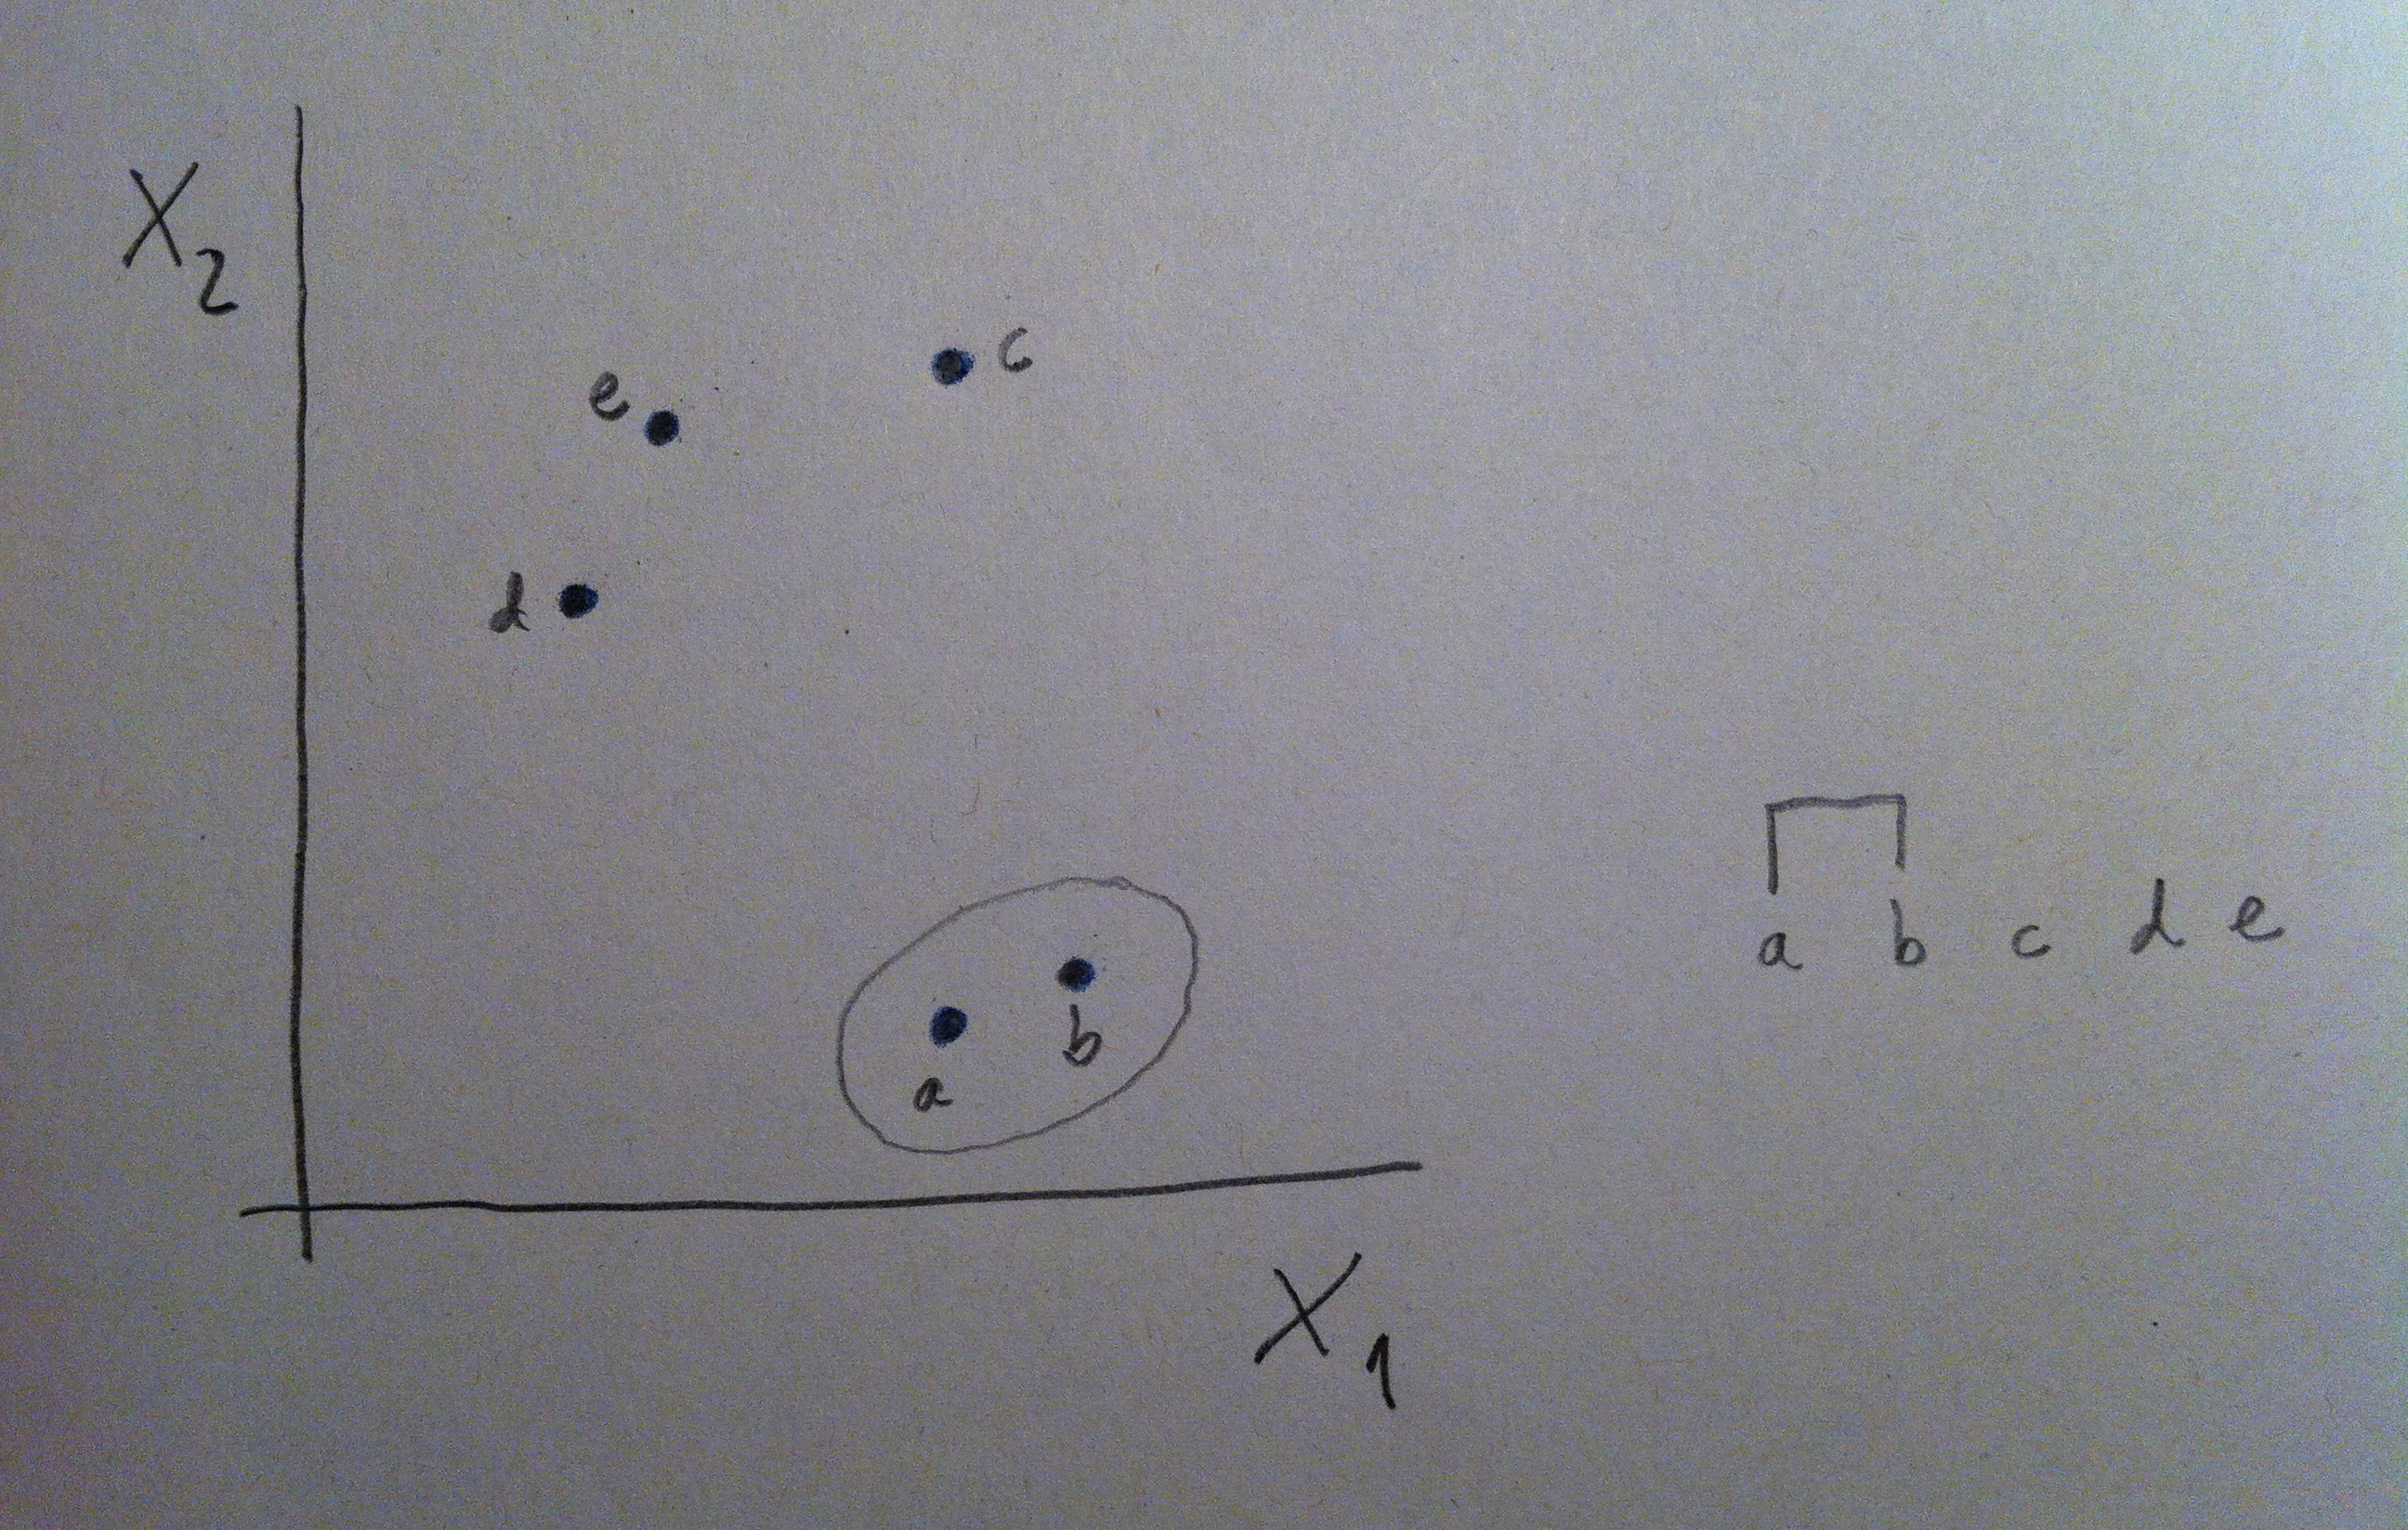
15. La primera agrupación de puntos se hace en base a la matriz de distancias. Se agrupan los dos puntos diferentes de distancia menor. En nuestro caso serían los puntos a y b:
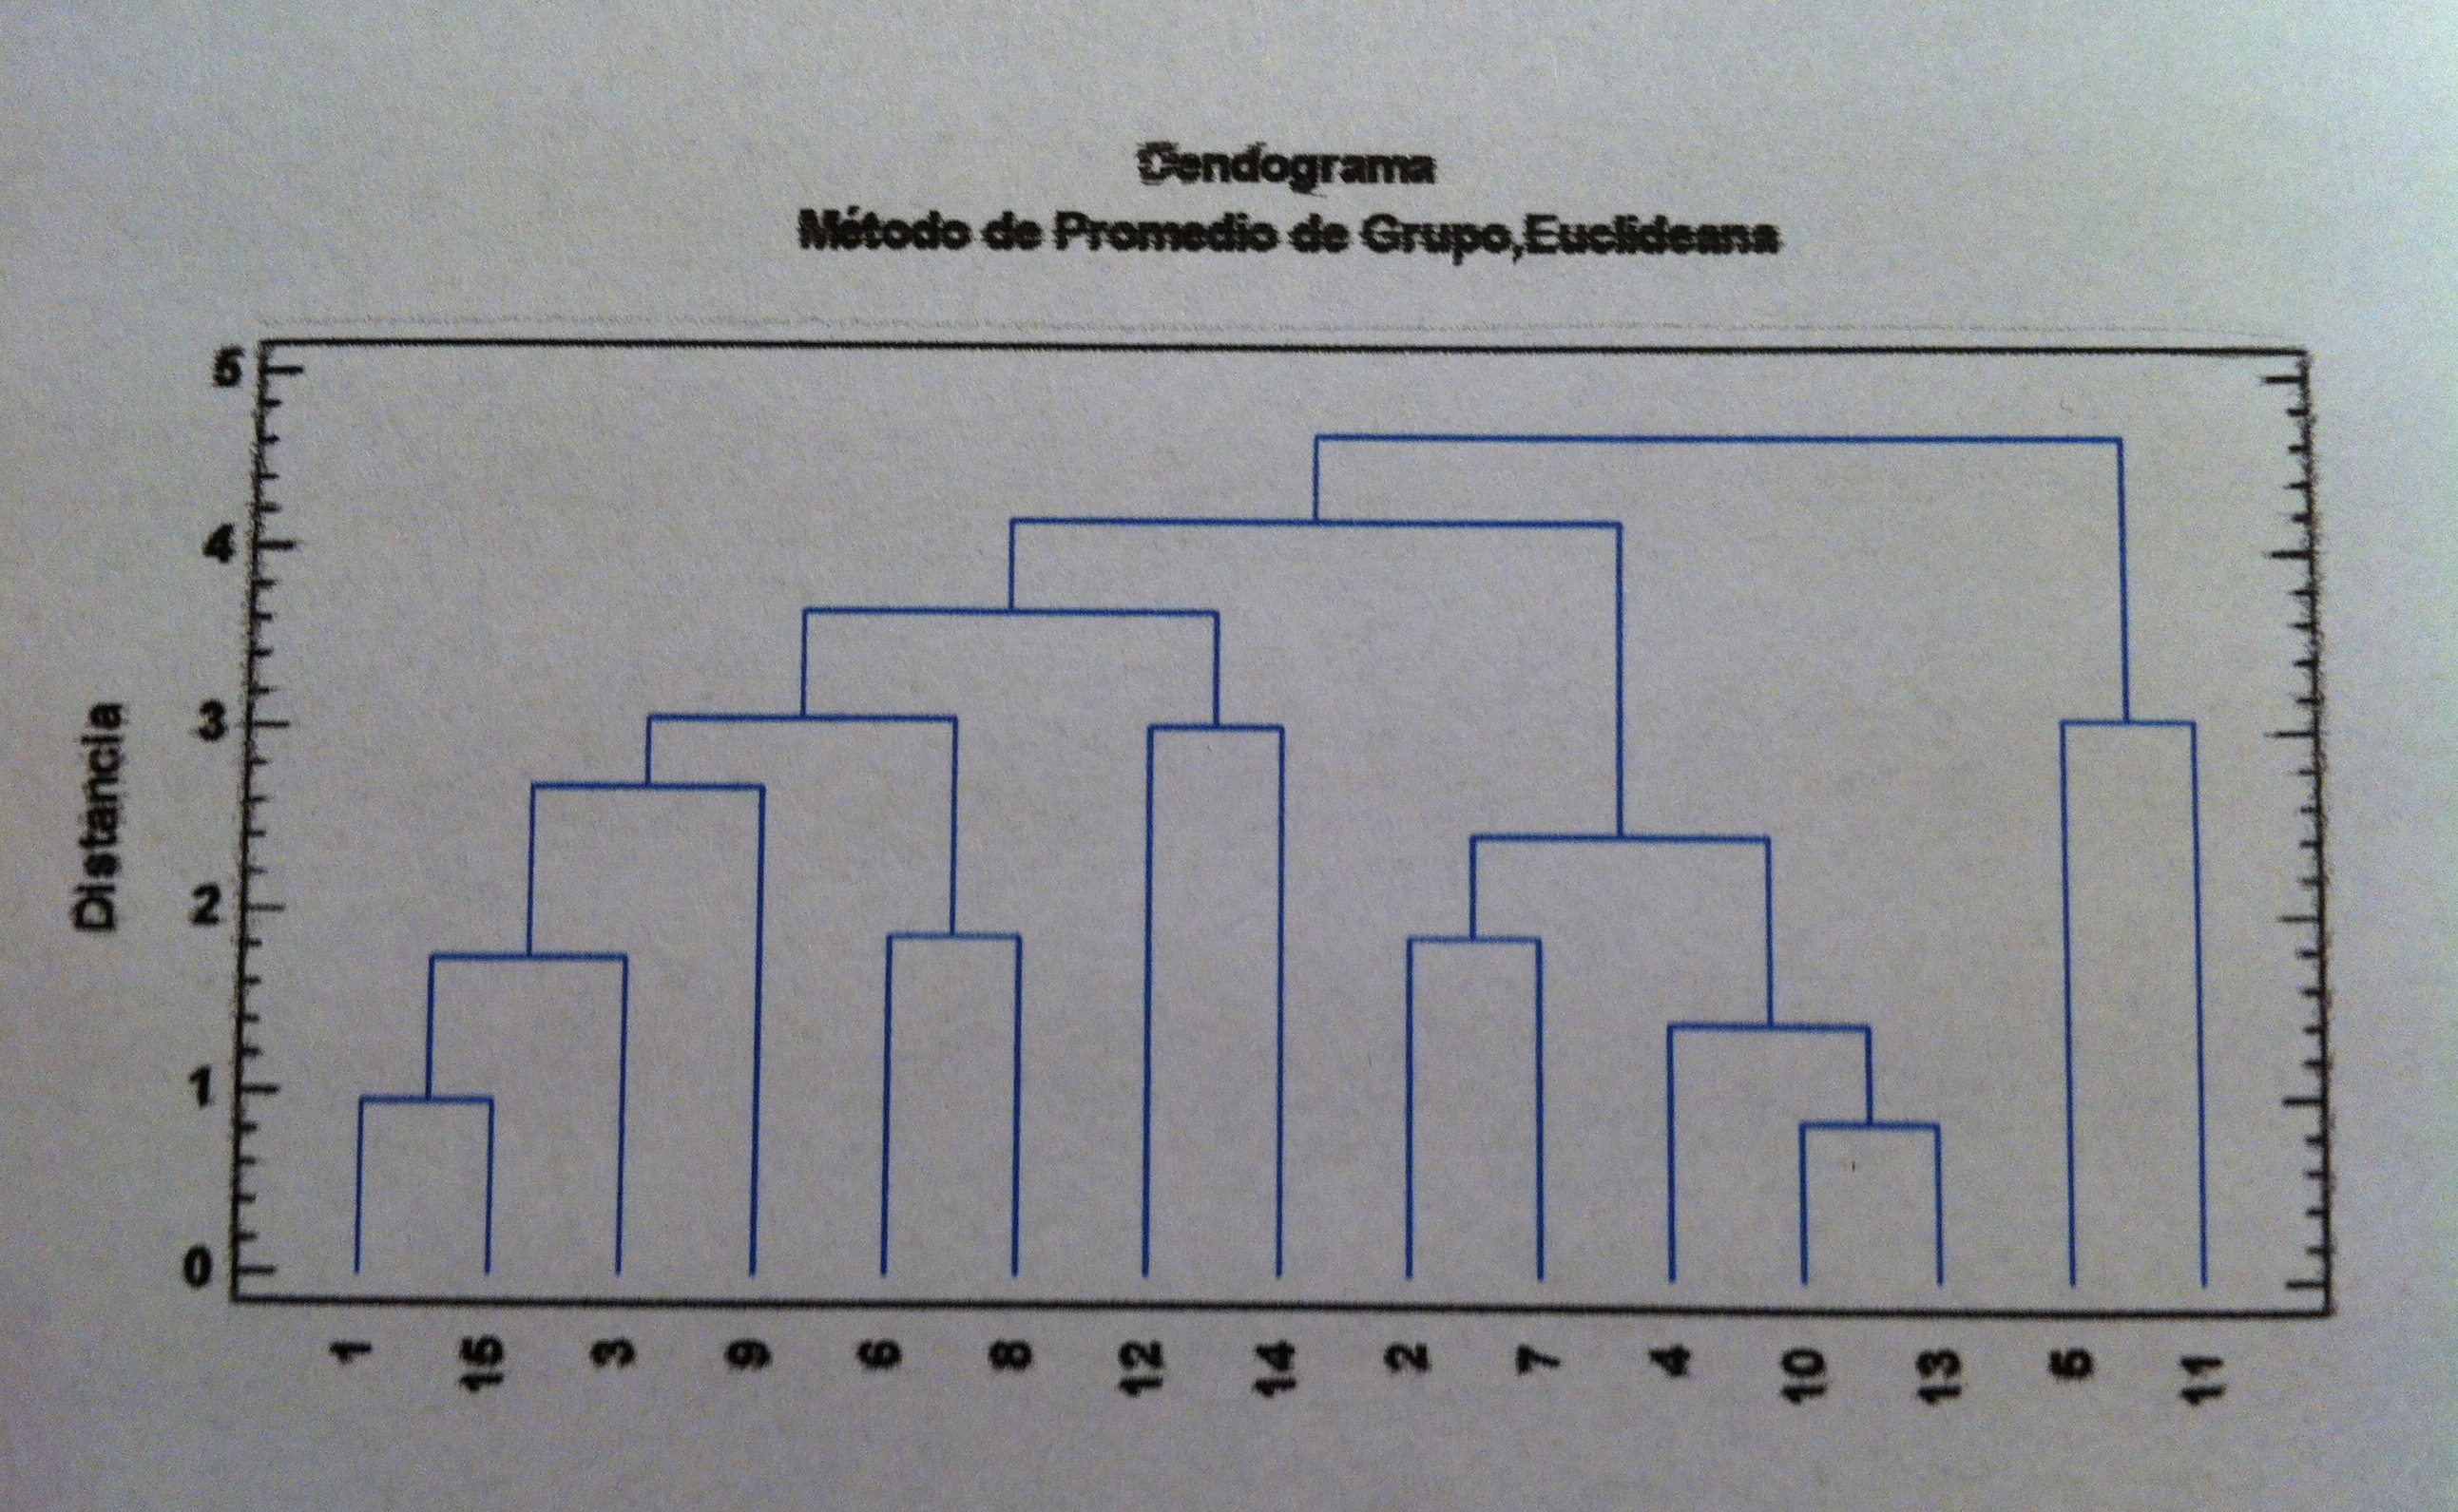
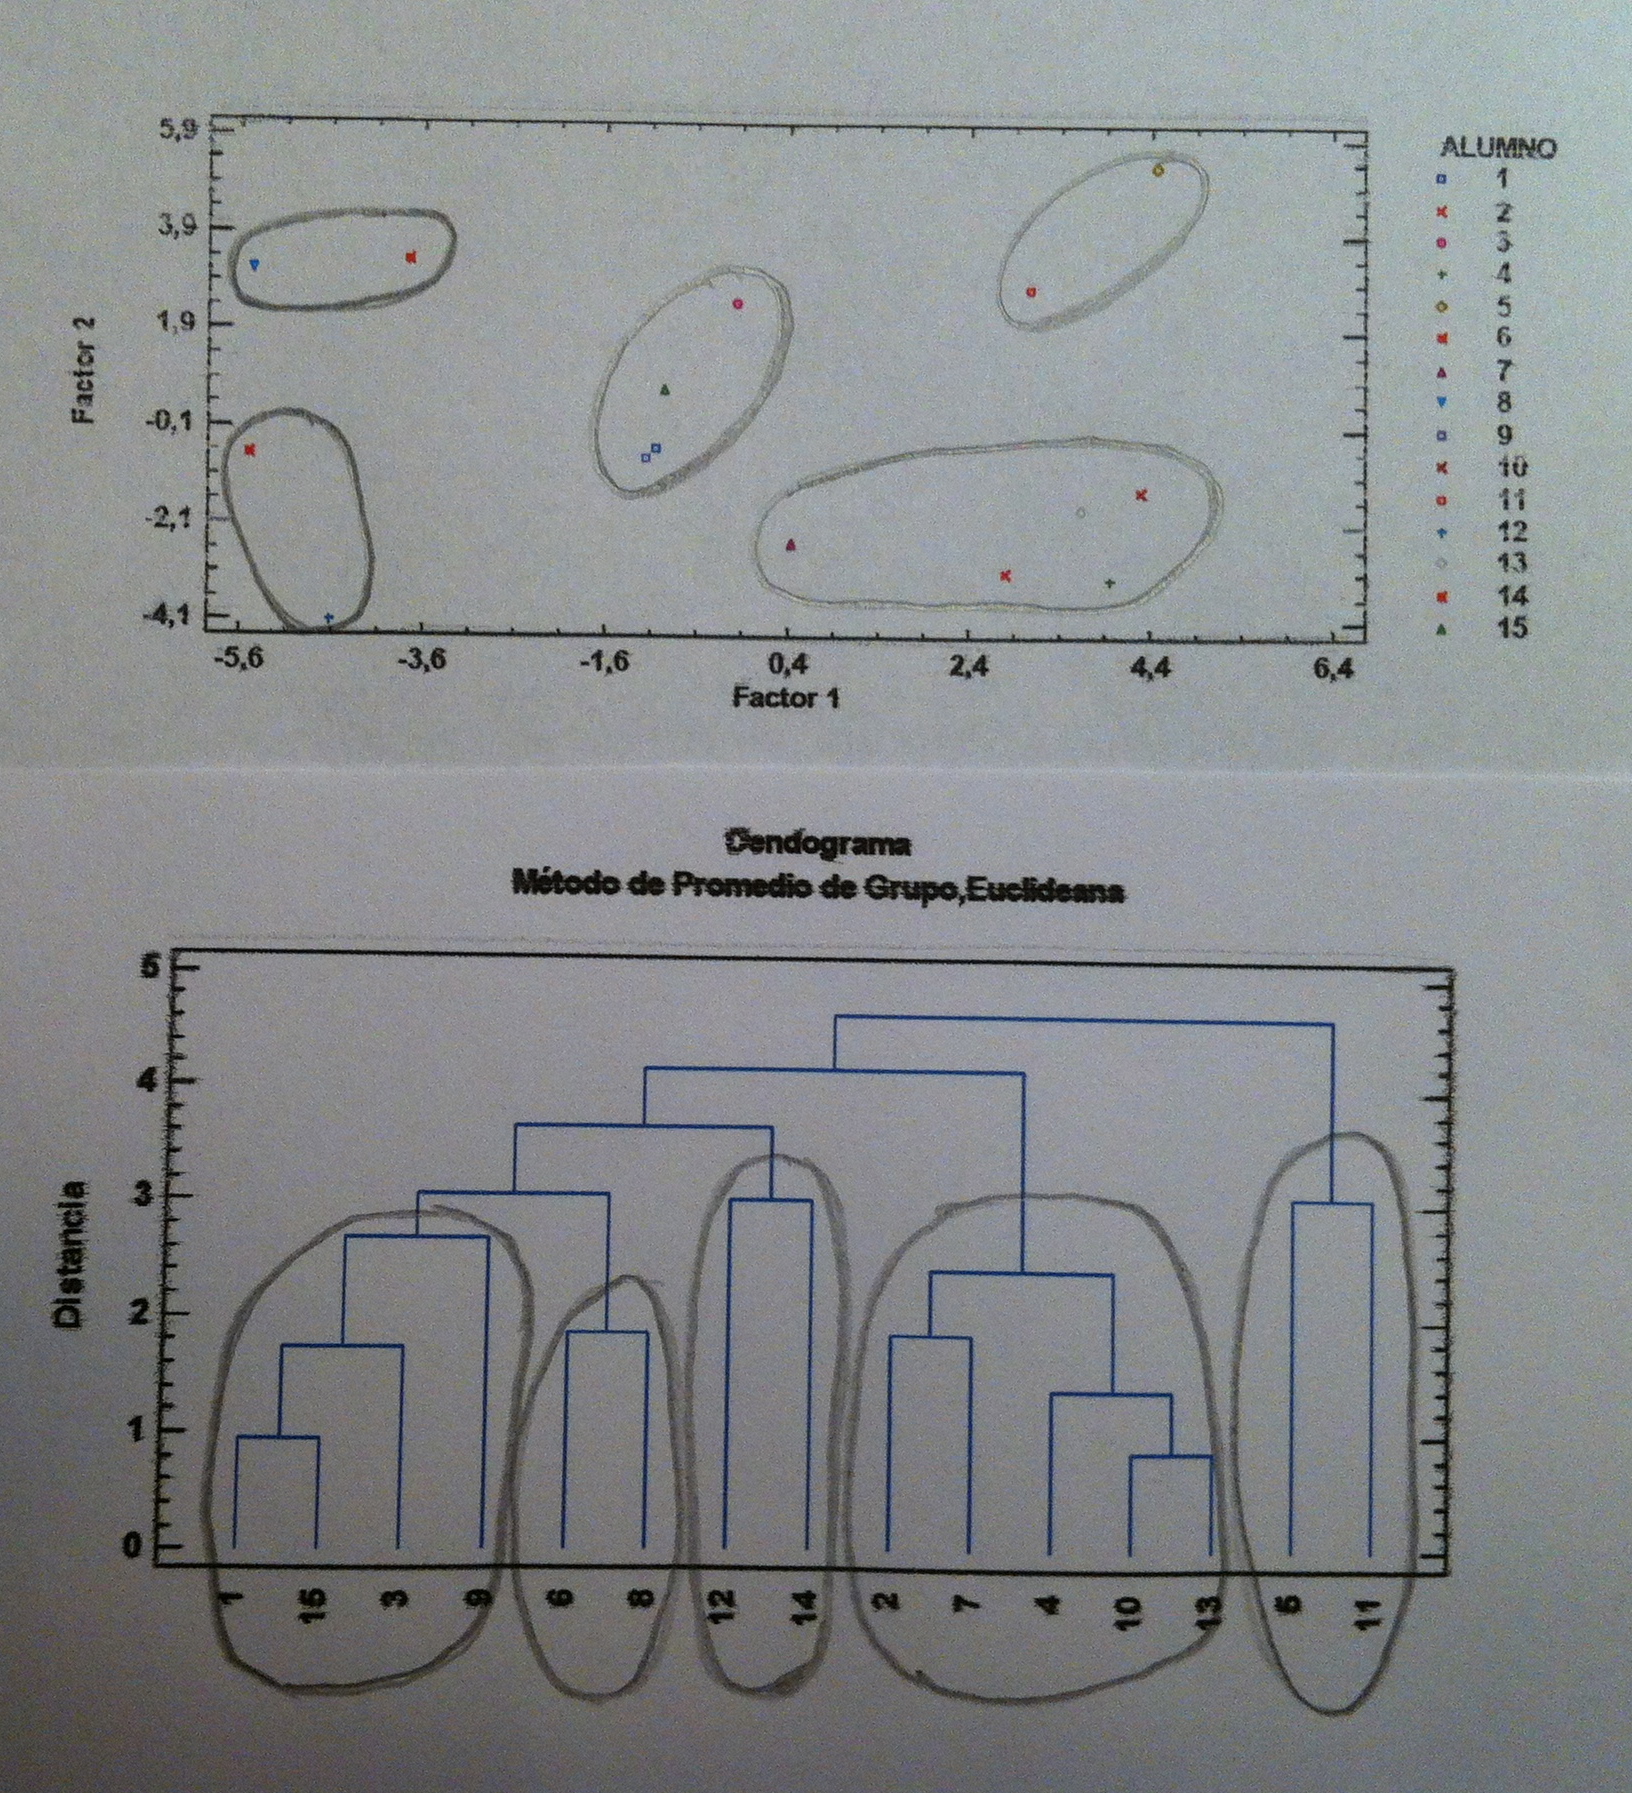
IMG_4643

17. Y, por lo tanto, realizamos la primera unión en el dendrograma, la unión entre a y b.

18. A continuación nos encontramos con un problema. Ahora tenemos, en realidad, cuatro entidades para medir distancias y continuar, pero el problema es que ahora tenemos que una de esas entidades, y así será ya continuamente, son un grupo de individuos. Por lo tanto, debemos definir cómo calcularemos la distancia entre un punto y un grupo de puntos que sea, también, un criterio que nos sirva para establecer la distancia entre dos grupos de puntos, porque esto también nos aparecerá a la que tengamos en un análisis un mínimo de dos grupos.

19. Se han establecido diferentes criterios para definir la distancia entre un punto y un grupo o la distancia entre dos grupos. Veamos tres ejemplos de esos criterios: 1) El criterio del mínimo. 2) El criterio del máximo. 3) El criterio de la media. Veamos un gráfico que ejemplifica en nuestro caso cómo calcularíamos estos tres criterios:
IMG_4644

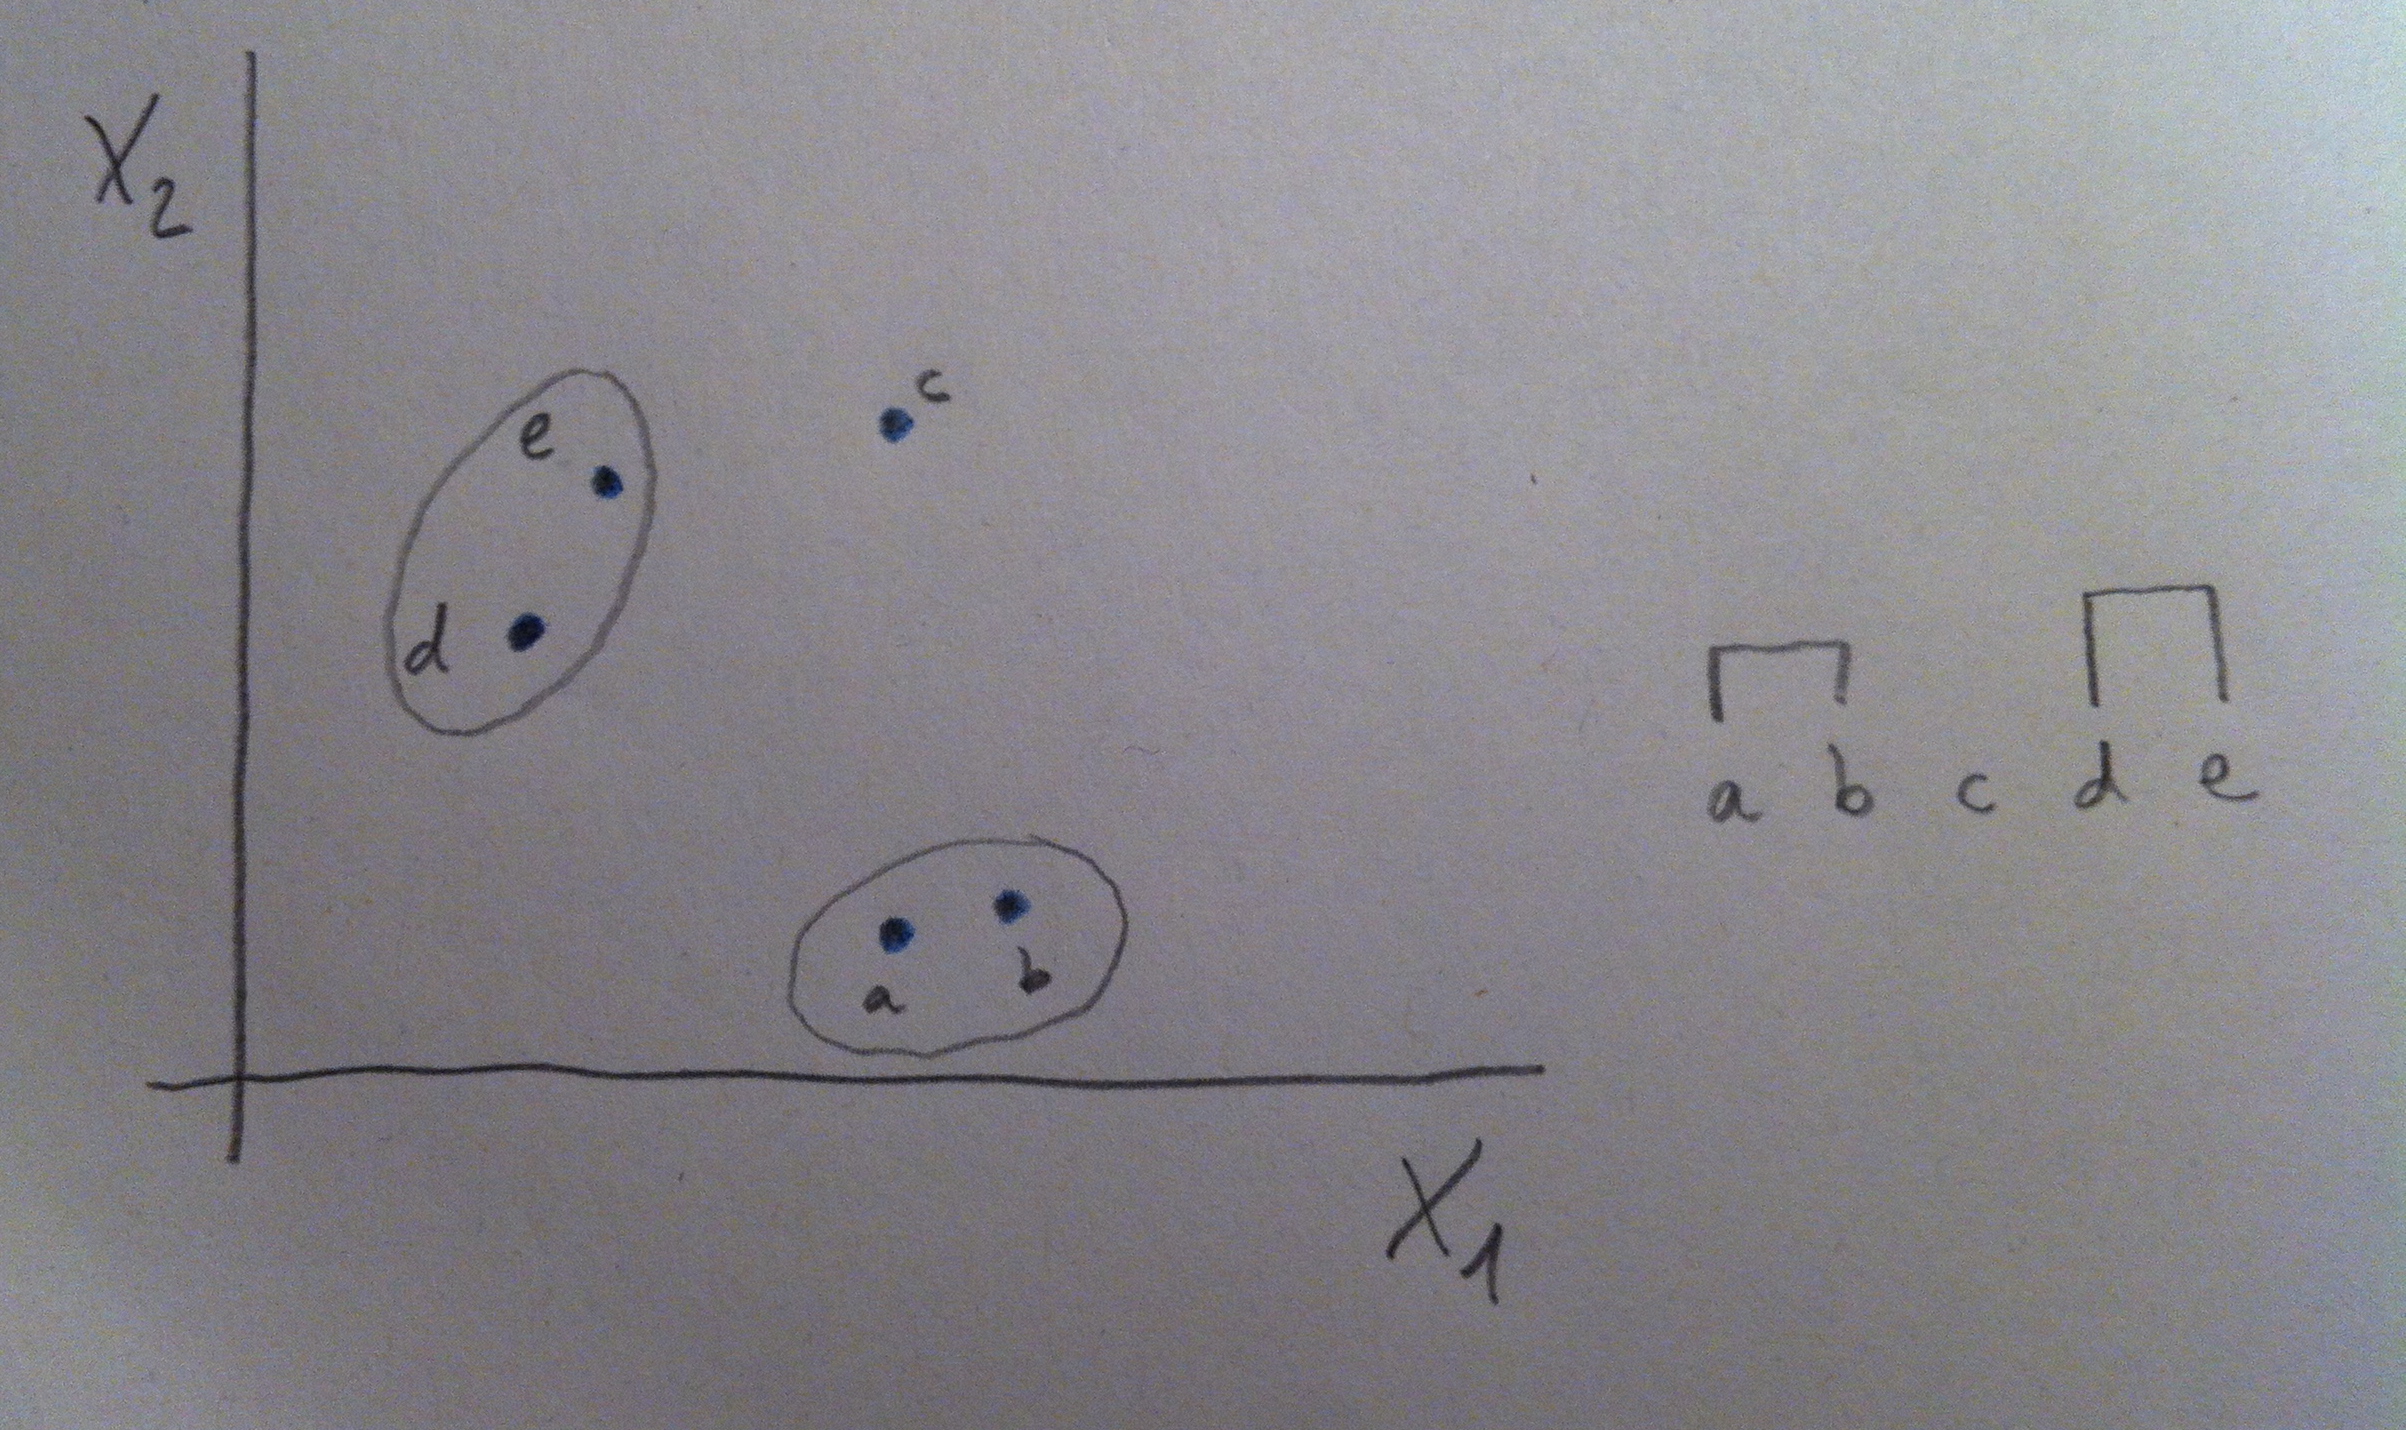
20. Según apliquemos un criterio u otro nos podemos a encontrar con agrupaciones diferentes. Si aplicamos uno de estos criterios, por ejemplo el de la media, nos encontraríamos que, en nuestro ejemplo, la distancia menor es la que hay entre los puntos d y e:
IMG_4646

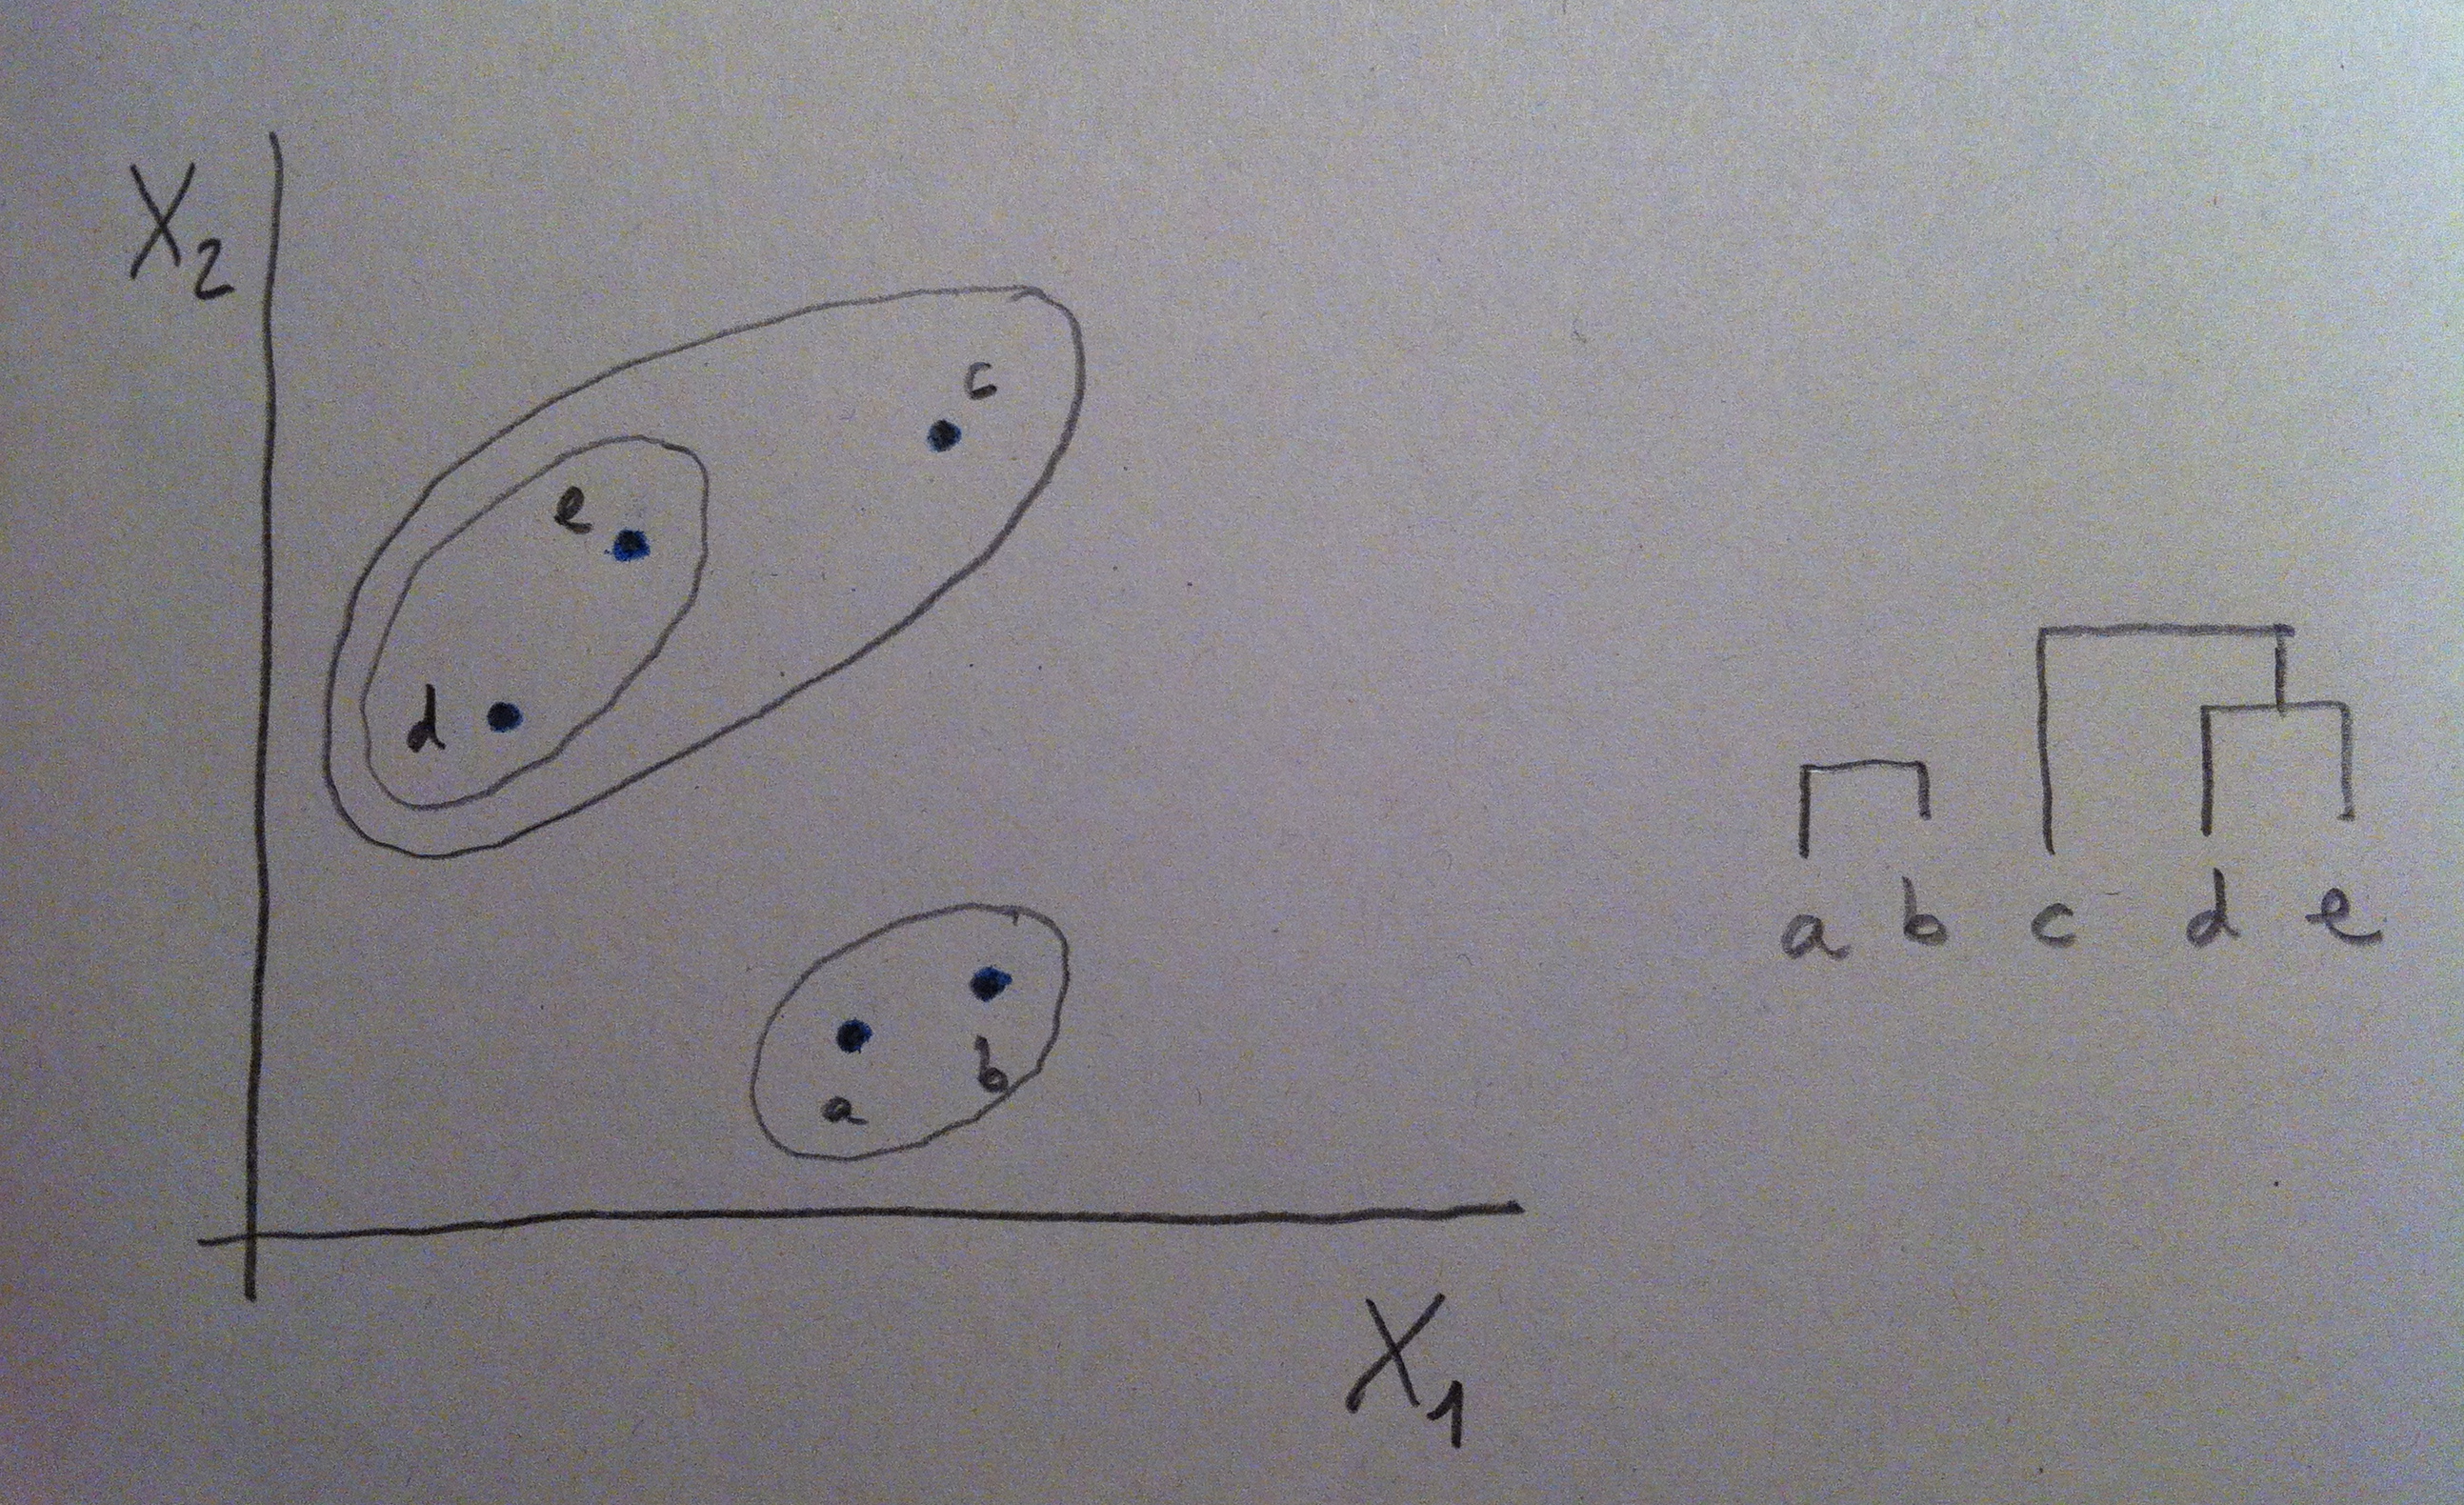
21. Y, si continuamos con el mismo procedimiento, ahora la distancia menor entre las tres entidades que nos quedan (el grupo (a, b), el grupo (d, e) y el punto c) será la que hay entre el grupo (d, e) y el punto c:
IMG_4647

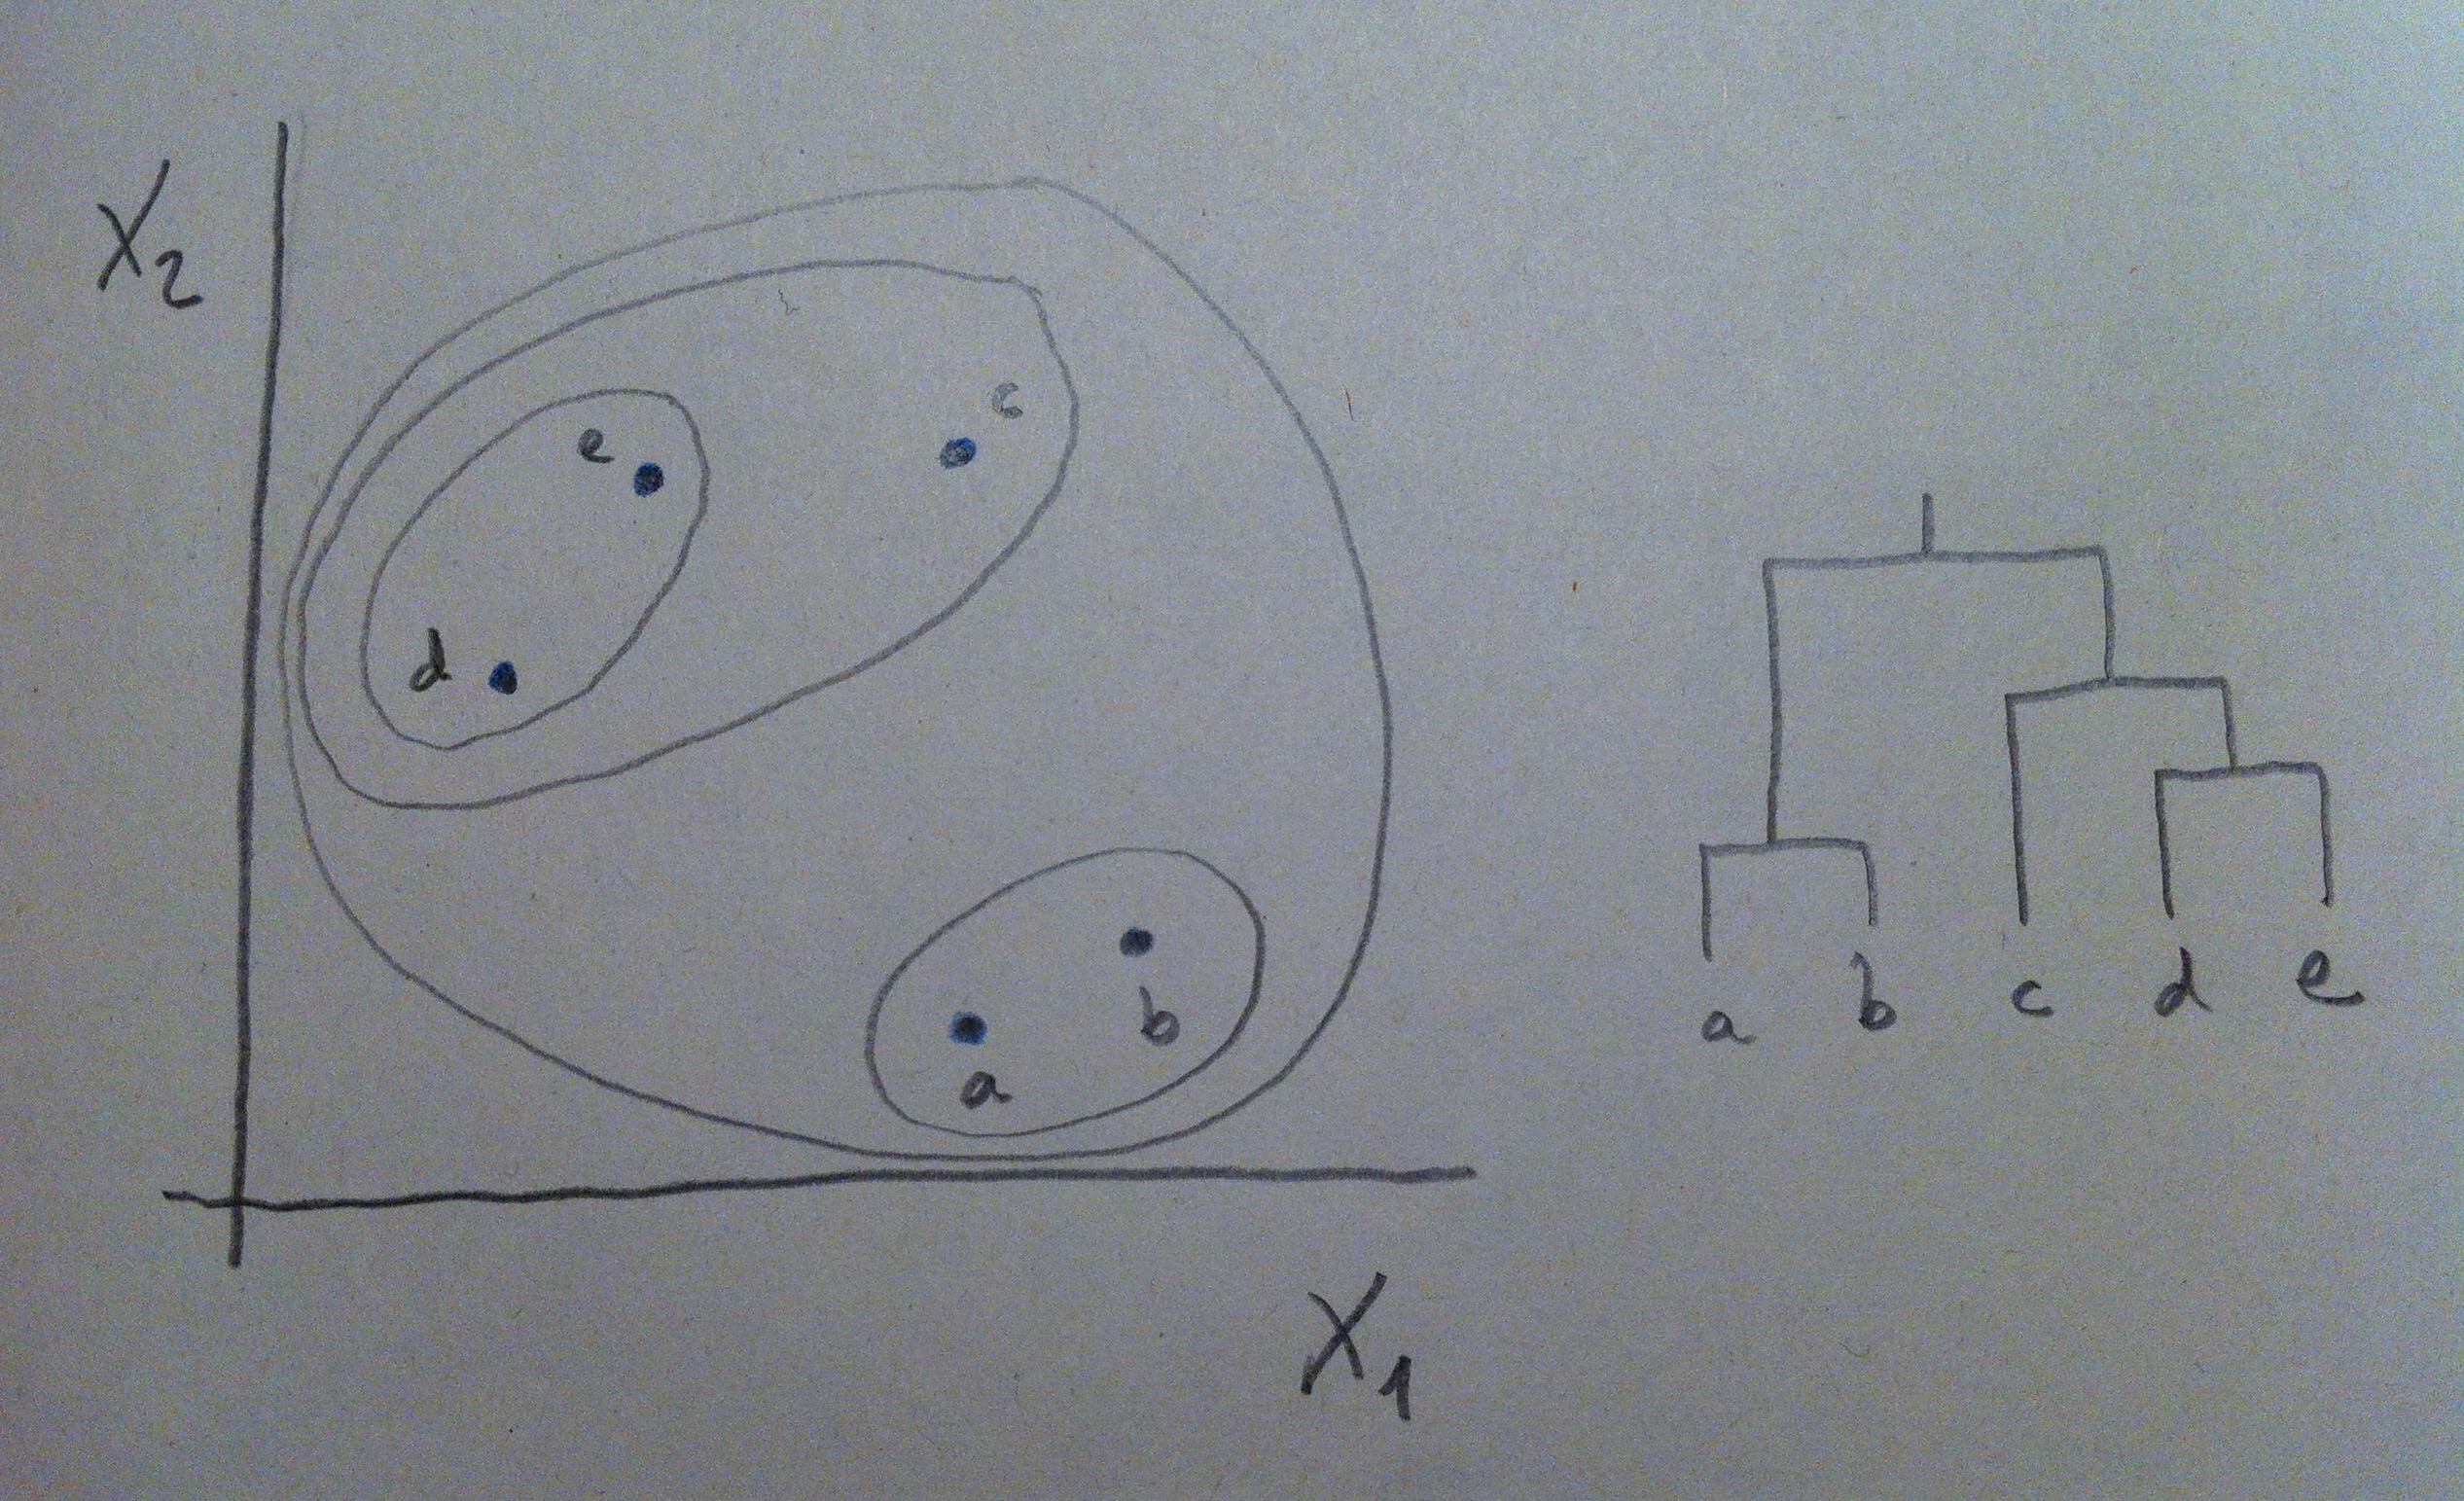
22. Y, finalmente ya, lo último es agrupar lo que queda:
IMG_4684

23. Y tenemos, así, el dendrograma completo. Este es el procedimiento que sigue un software estadístico para construir el dendrograma, que es la forma de representación que persigue el Análisis clúster.

24. Pero observemos cómo hemos tenido que establecer dos decisiones claves que cambian el transcurso del proceso: La distancia con la que trabajar y el criterio de cálculo de distancia entre punto y grupo o entre grupo y grupo. Y según sea la elección el resultado puede cambiar, las agrupaciones pueden ser distintas. Es cierto que si las cosas son muy claras los resultados son prácticamente los mismos, sigamos el procedimiento que sigamos, pero no siempre sucede así.

25. Una opción que suele ser también interesante es hacer el Análisis clúster girando la matriz de datos; o sea, viendo las variables como individuos y los individuos como variables. Entonces agrupamos no individuos sino variables. Vemos la proximidad de unas respecto a otras, qué agrupaciones tendría sentido hacer, etc.

26. De hecho, si hacemos un AC, de una matriz de datos, primero con los individuos y luego con las variables, estamos cubriendo aquellas dos finalidades que persiguen tanto el ACP como el AF, que son: 1) Representar los puntos, visualizarlos. 2) Ver relaciones entre las variables, agrupaciones, conexiones entre ellas.

27. Veamos la aplicación del AC a los datos de los estudiantes que hemos visto en los temas dedicados al ACP y al AF. Al aplicar a los 15 alumnos para todas las variables; o sea, a la nube de puntos original, el AC con la distancia euclídea y el criterio de distancia entre punto y grupo o entre grupo y grupo el de la media del grupo, el dendrograma que se construye es el siguiente:
IMG_4649

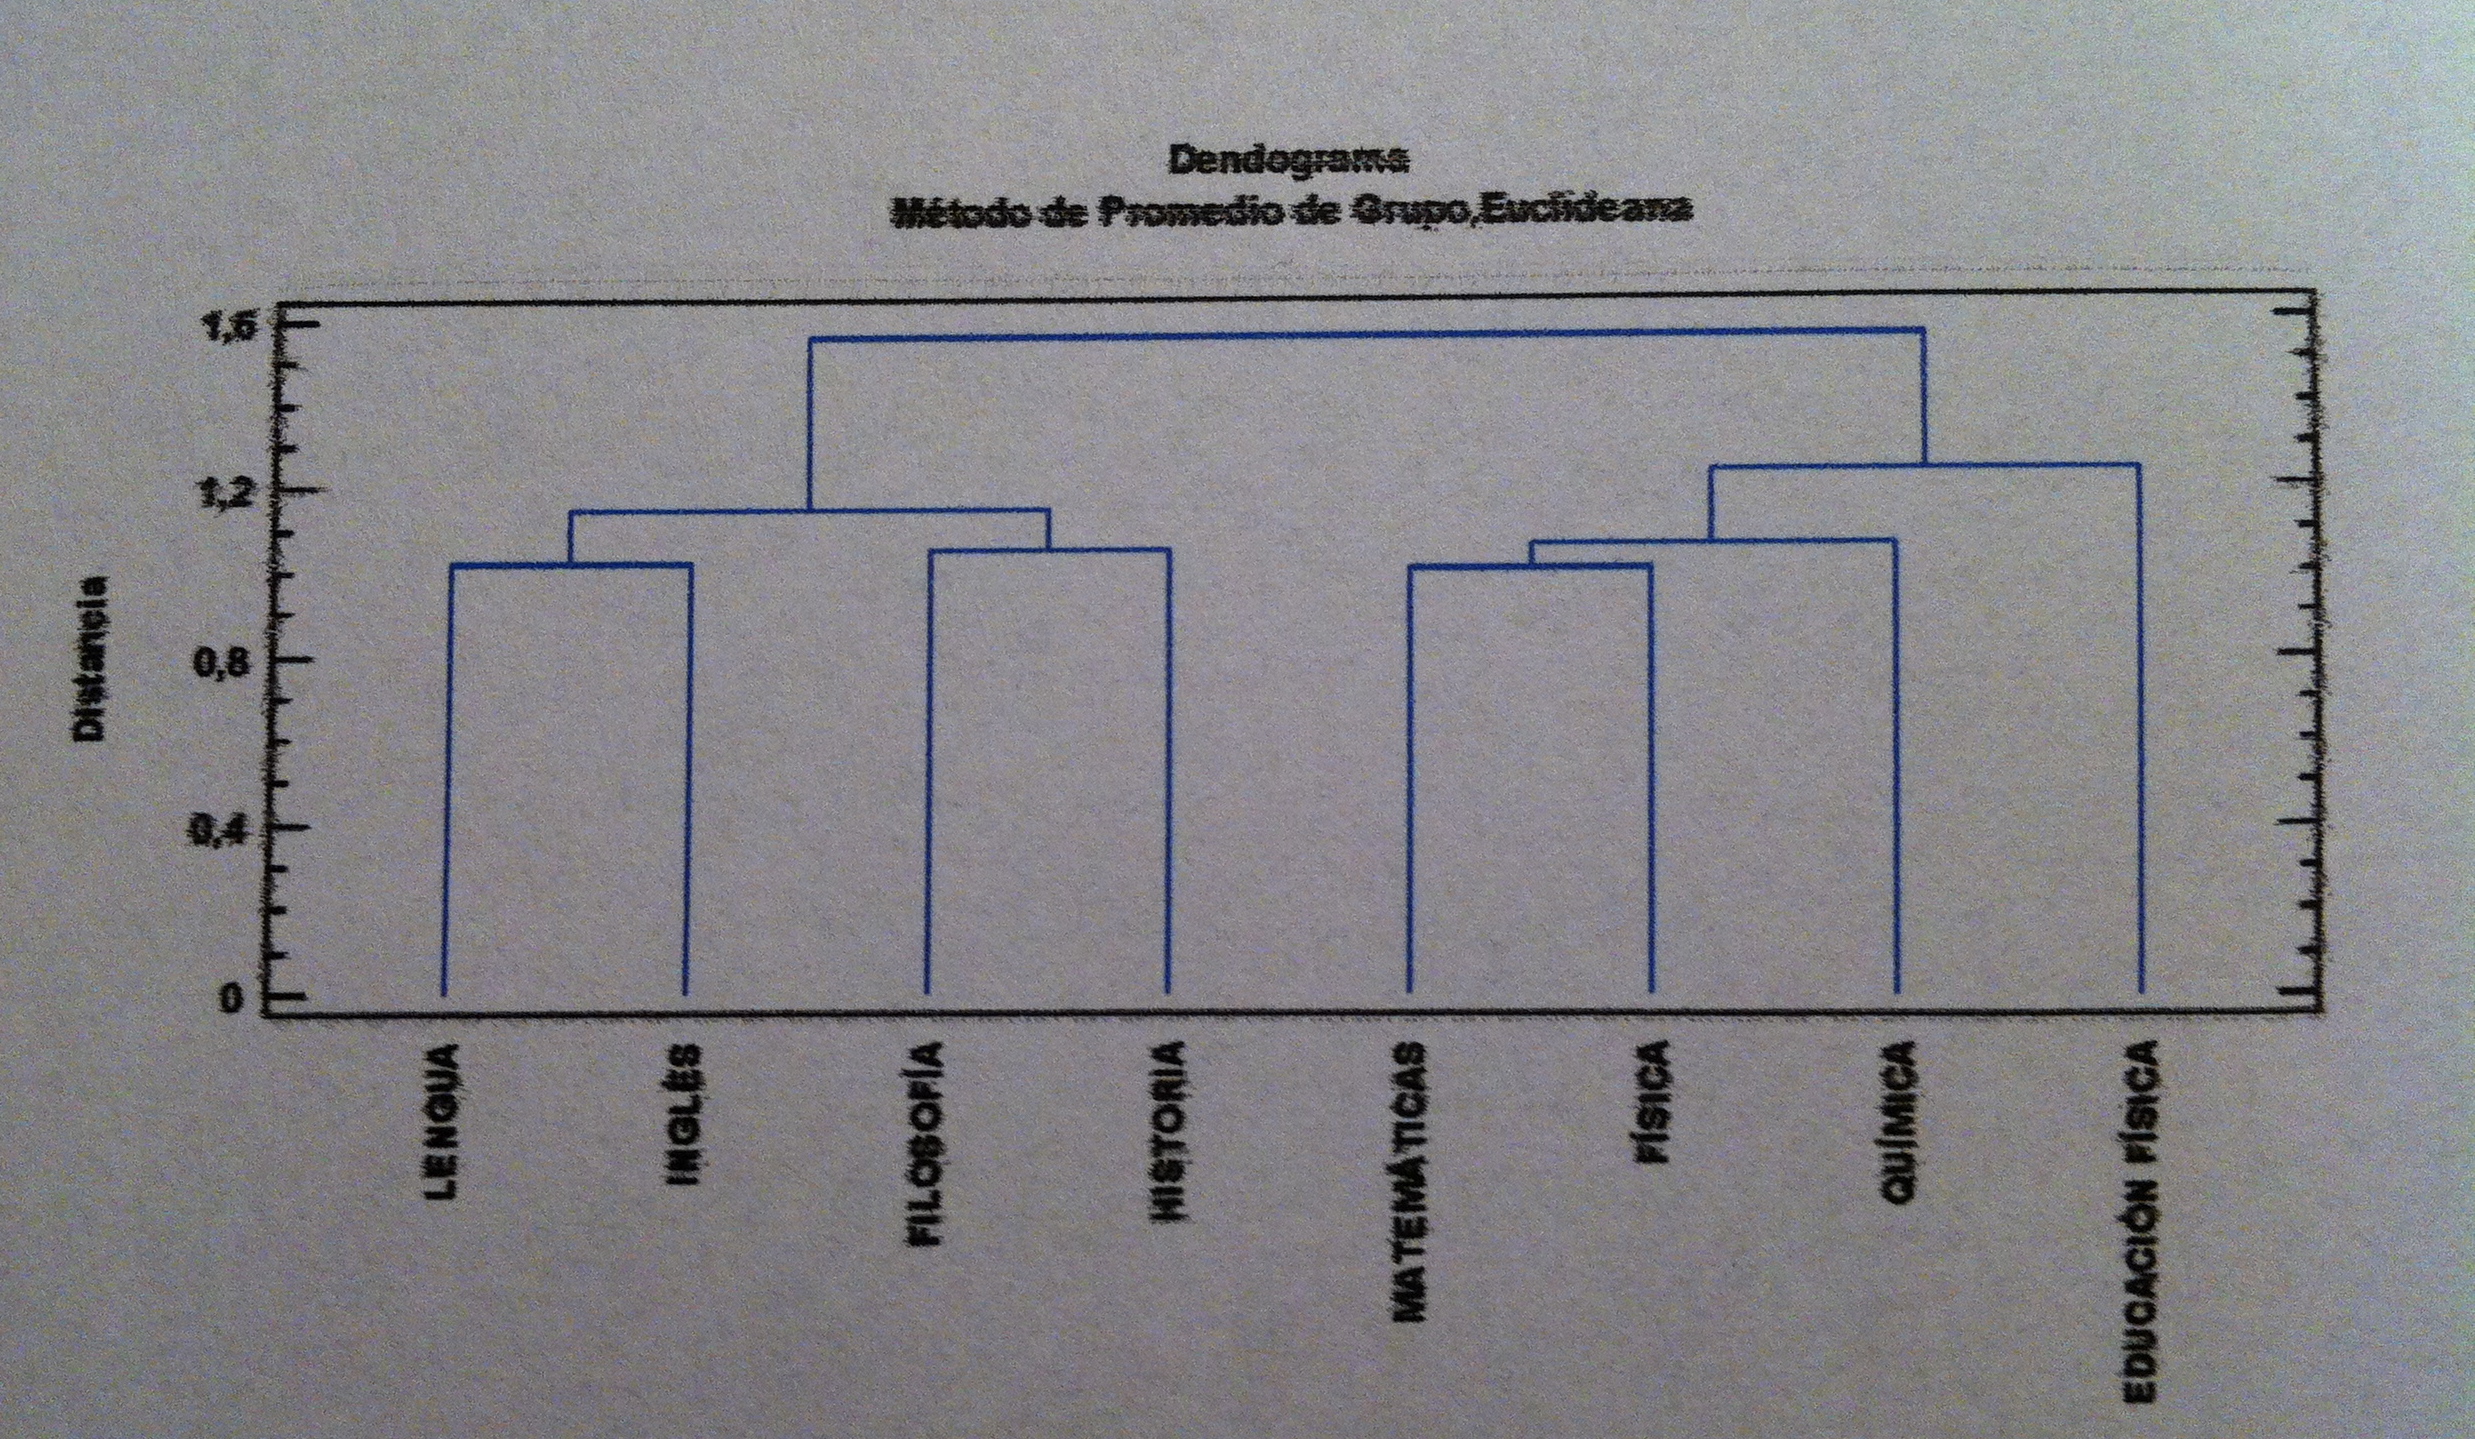
28. Si hacemos lo mismo pero ahora con las variables obtenemos el siguiente dendrograma:
IMG_4651

29. Lo que muestra realmente lo que decíamos de la agrupación que se produce entre variables: Letras por un lado y Ciencias por otro. Aquí Educación acaba agrupándose primero con las ciencias que con las letras, pero es la última agrupación, si quisiéramos crear tres grupos de variables y cortáramos el dendrograma a nivel de obtención de tres grupos de variables tendríamos: Letras, Ciencias y Educación física.

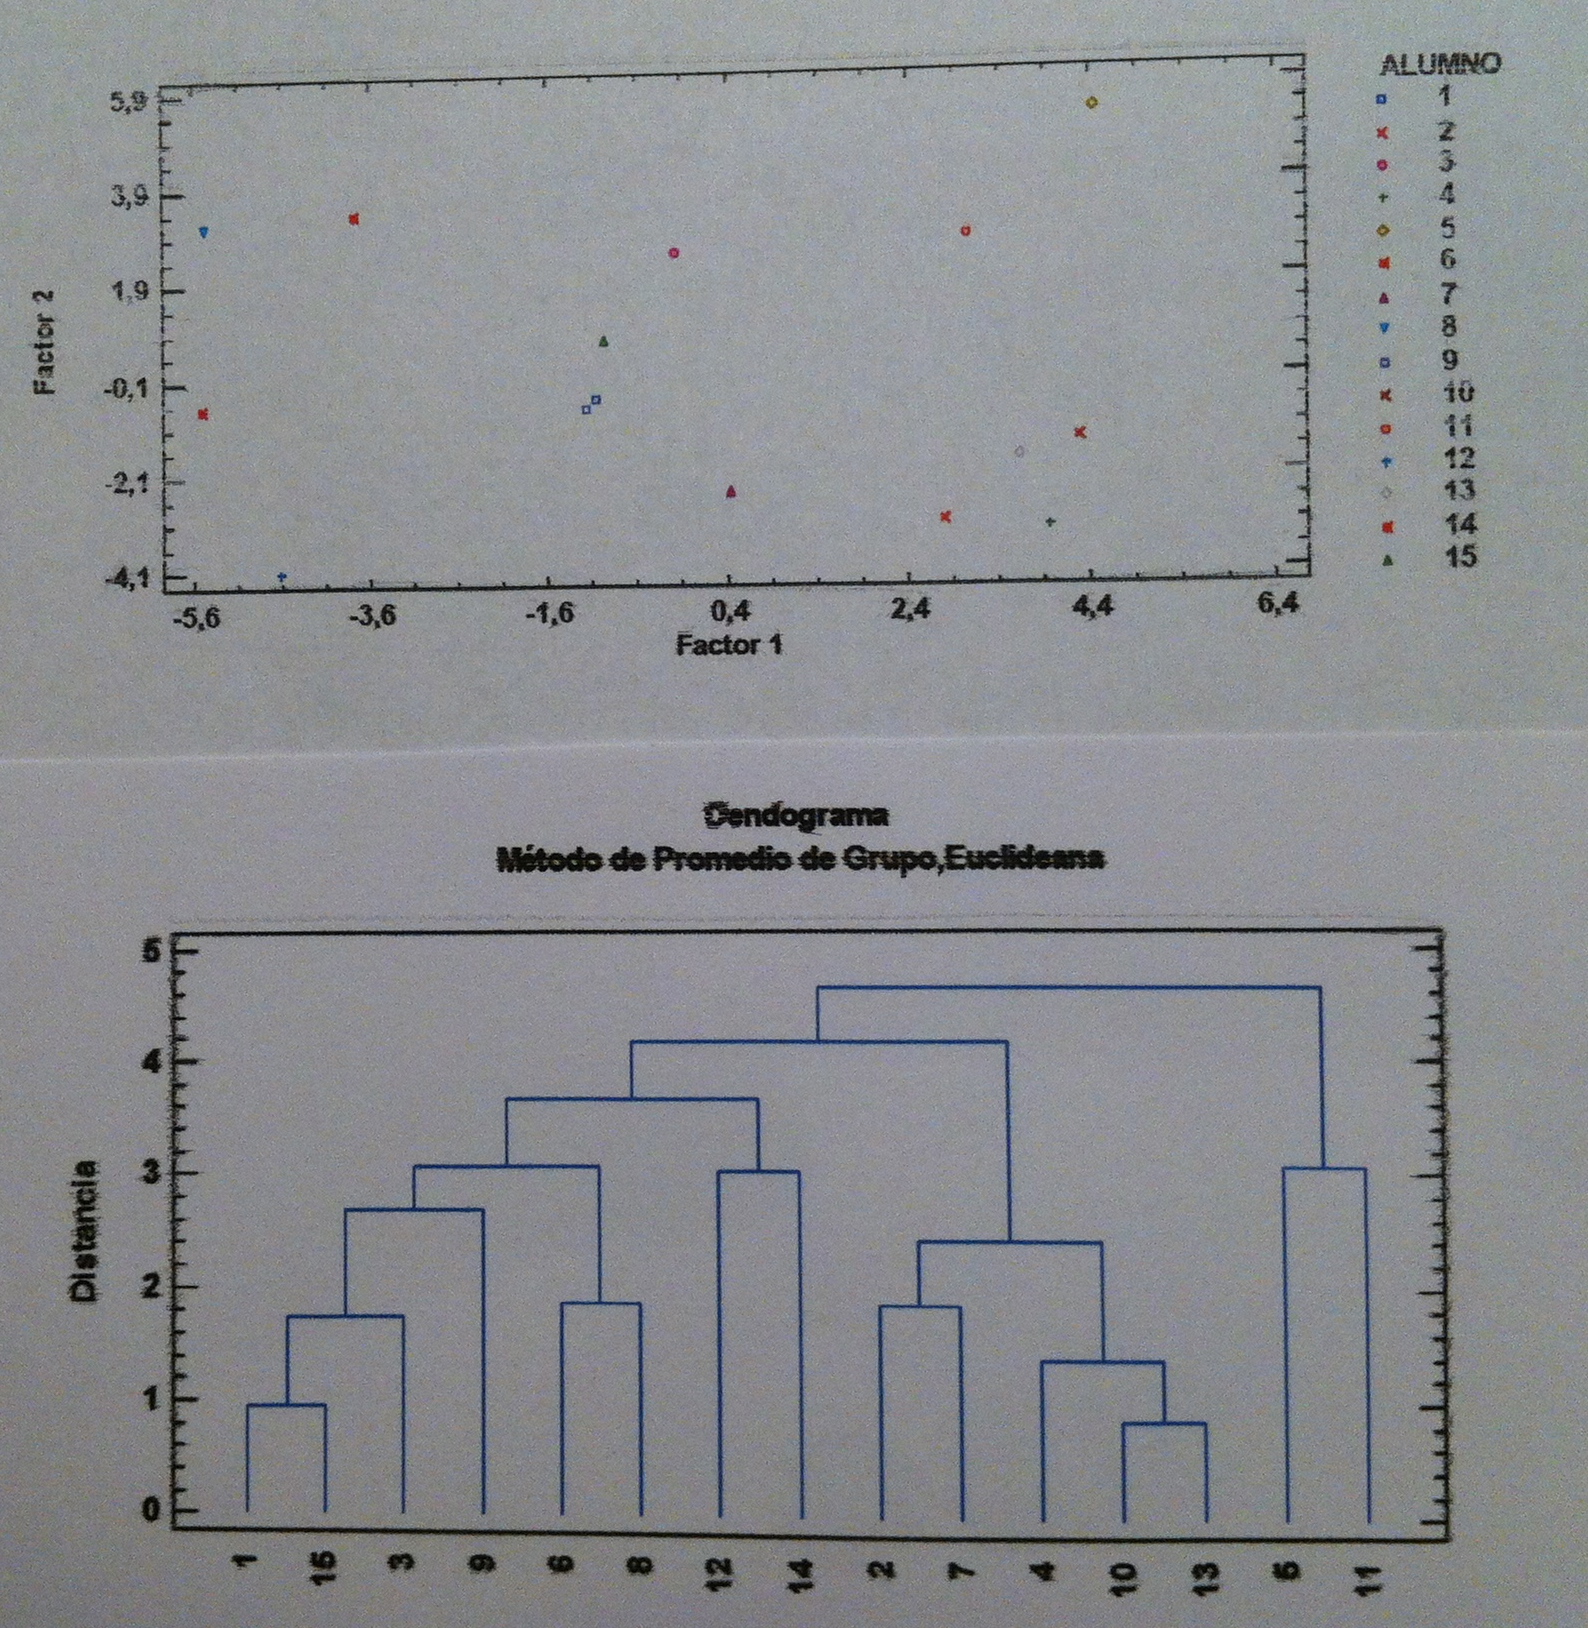
30. Es interesante comparar los resultados obtenidos, las representaciones dibujadas, con las tres técnicas: ACP, AF y AC a los mismos datos. Al final tenemos, como ya hemos dicho, dos formas muy distintas de hacer lo misma: la del ACP y AF, por un lado, y la del AC, por otro. Dos formas de representación muy distinta. Pero la finalidad fundamental de ambas es descriptiva: representar lo que no podemos visualizar en su estado original, hacer una representación aproximada, crear un modelo de aquella realidad que no tenemos. Y junto ahora las dos formas tan distintas de hacer lo mismo en un mismo gráfico. Pongo sólo el AF en representación de la opción generada por AF o por ACP:
IMG_4685

31. Lo primero que vemos si comparamos ambos gráficos es que son dos representaciones muy distintas: como cuando vemos un cuadro de Picasso o de Velazquez. A lo mejor los dos intentan pintar lo mismo: las meninas, por ejemplo, pero lo hacen mediante técnicas pictóricas bien distintas. Una figurativa, la otra más abstracta. Pero con un poco de paciencia pueden irse estableciendo paralelismos entre ambos gráficos igual que con las merinas de Velazaquez y de Picasso.

32. El 5 y el 11 forman un grupo: son los alumnos que son buenos tanto en ciencias como en letras. El 2, 7, 4, 10 y 13 forman otro grupo: son los alumnos buenos en letras pero malos en ciencias. El 6 y 8 otro grupo: son los alumnos buenos en ciencias pero malos en letras. El 12 y 14: el grupo de los malos en ciencias y en letras. Finalmente, hay un grupo formado por el 1, 15, 3 y 9 que están en medio, que les va todo justo, están en la frontera entre el aprobado y el suspenso tanto en ciencias como en letras. Veámoslo en el siguiente gráfico que es el mismo de antes pero con estos grupos marcados tanto en una como en la otra representación:
IMG_4686

32. Como puede verse estamos haciendo cosas similares aunque a través de procedimentos bien distintos.
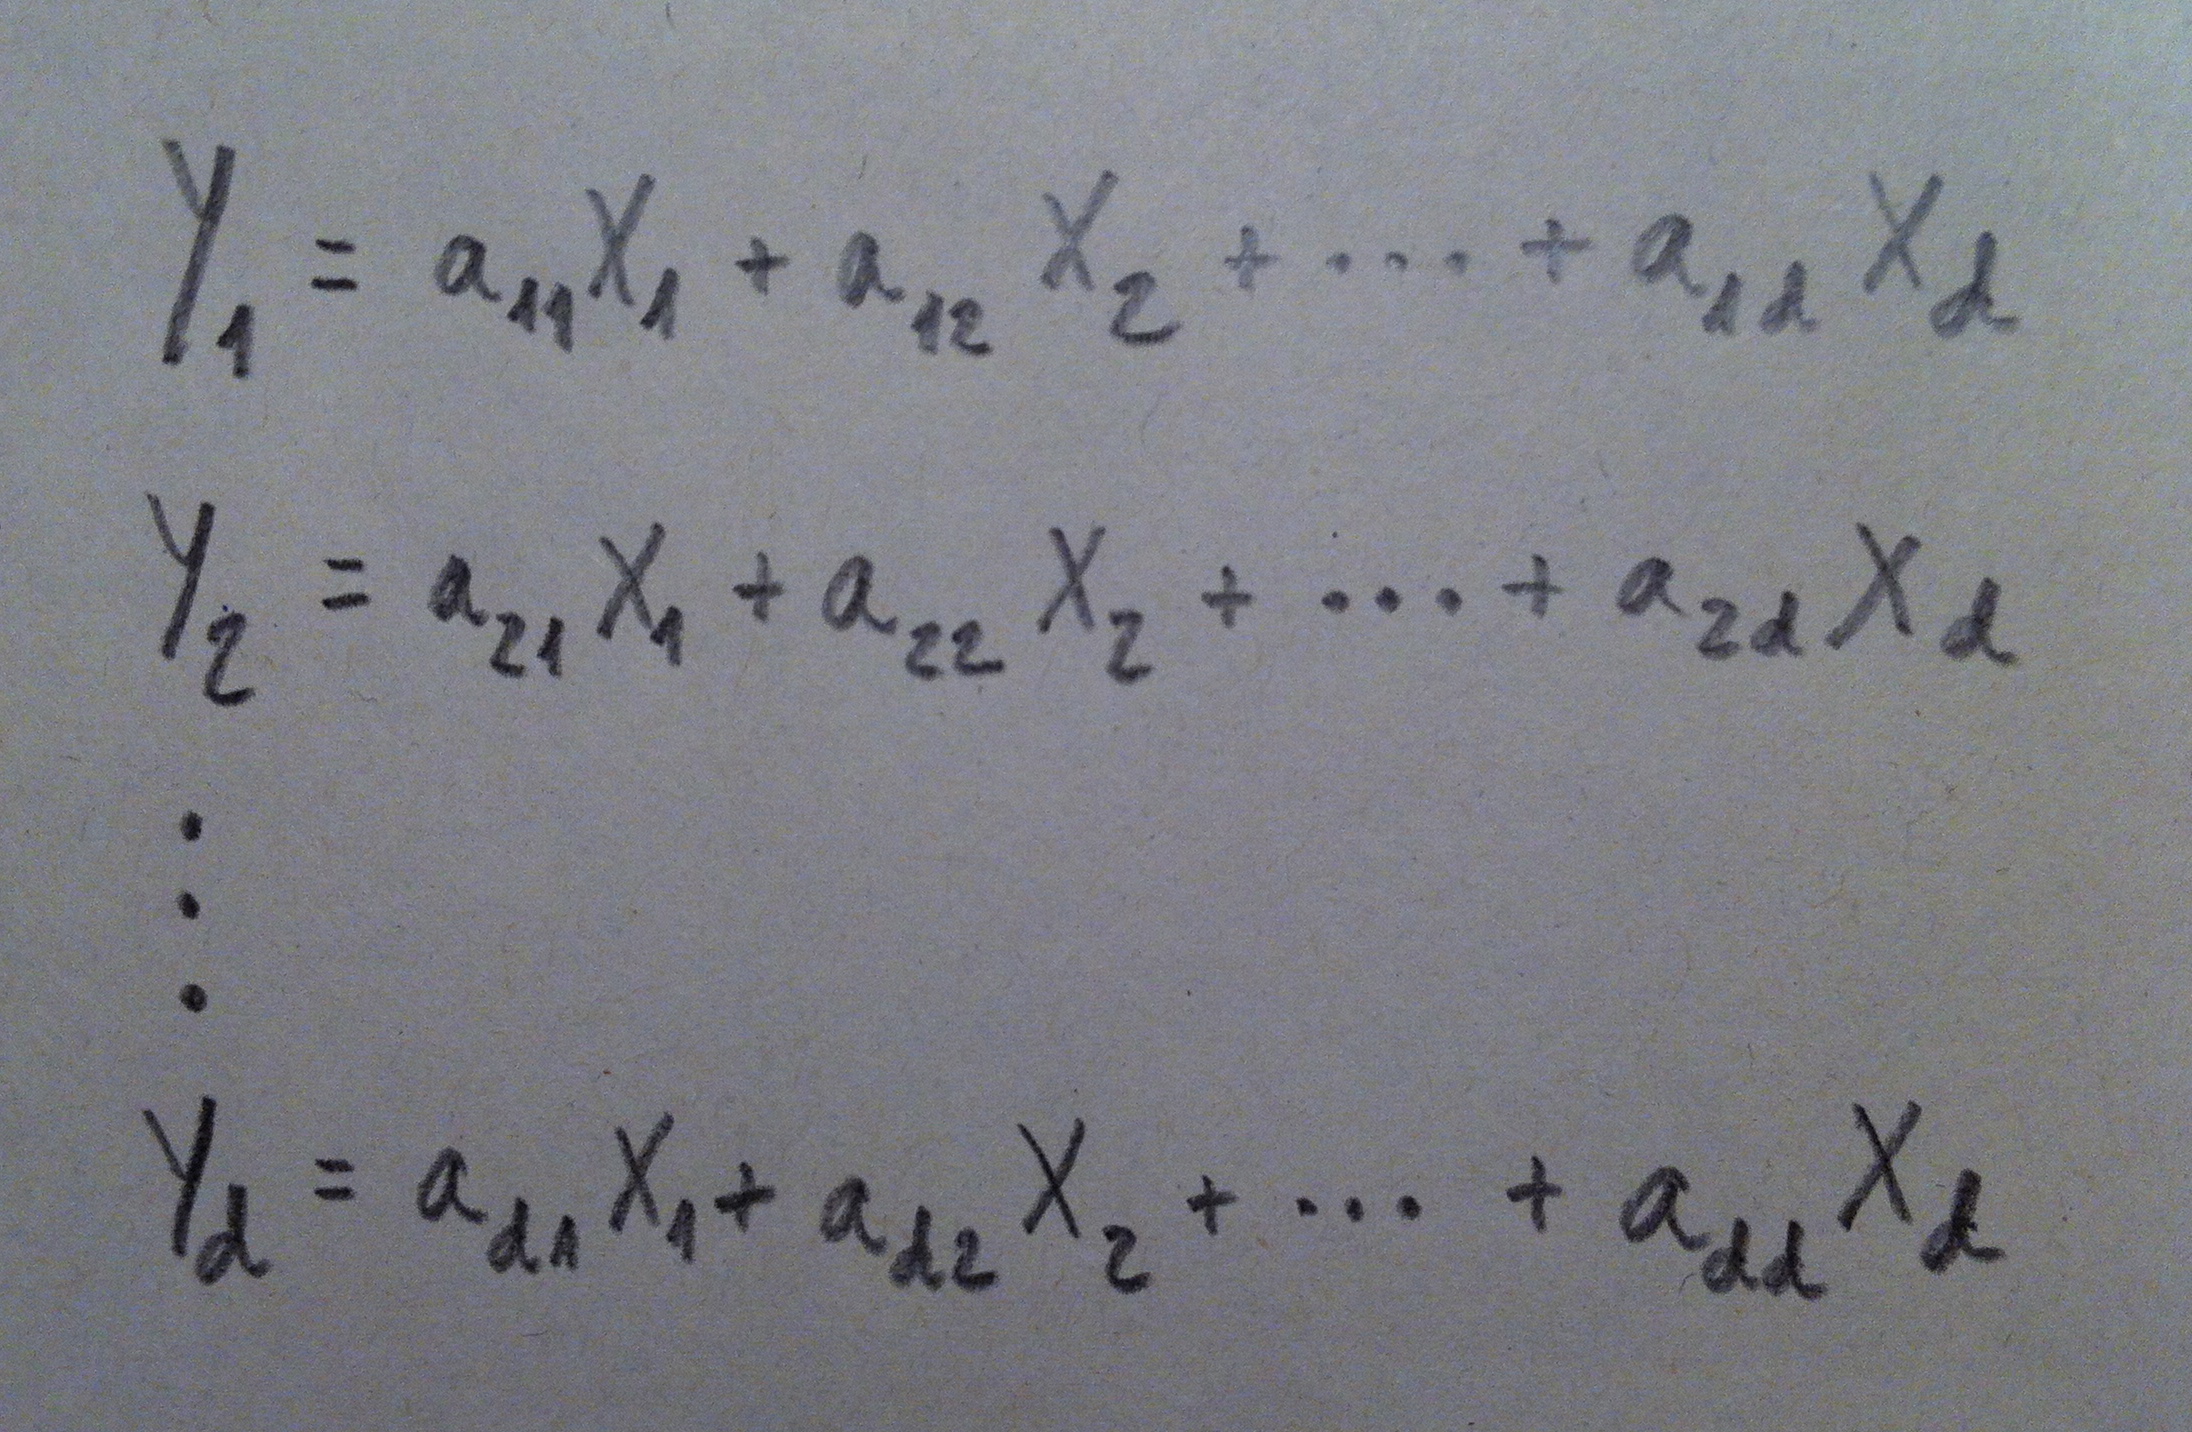
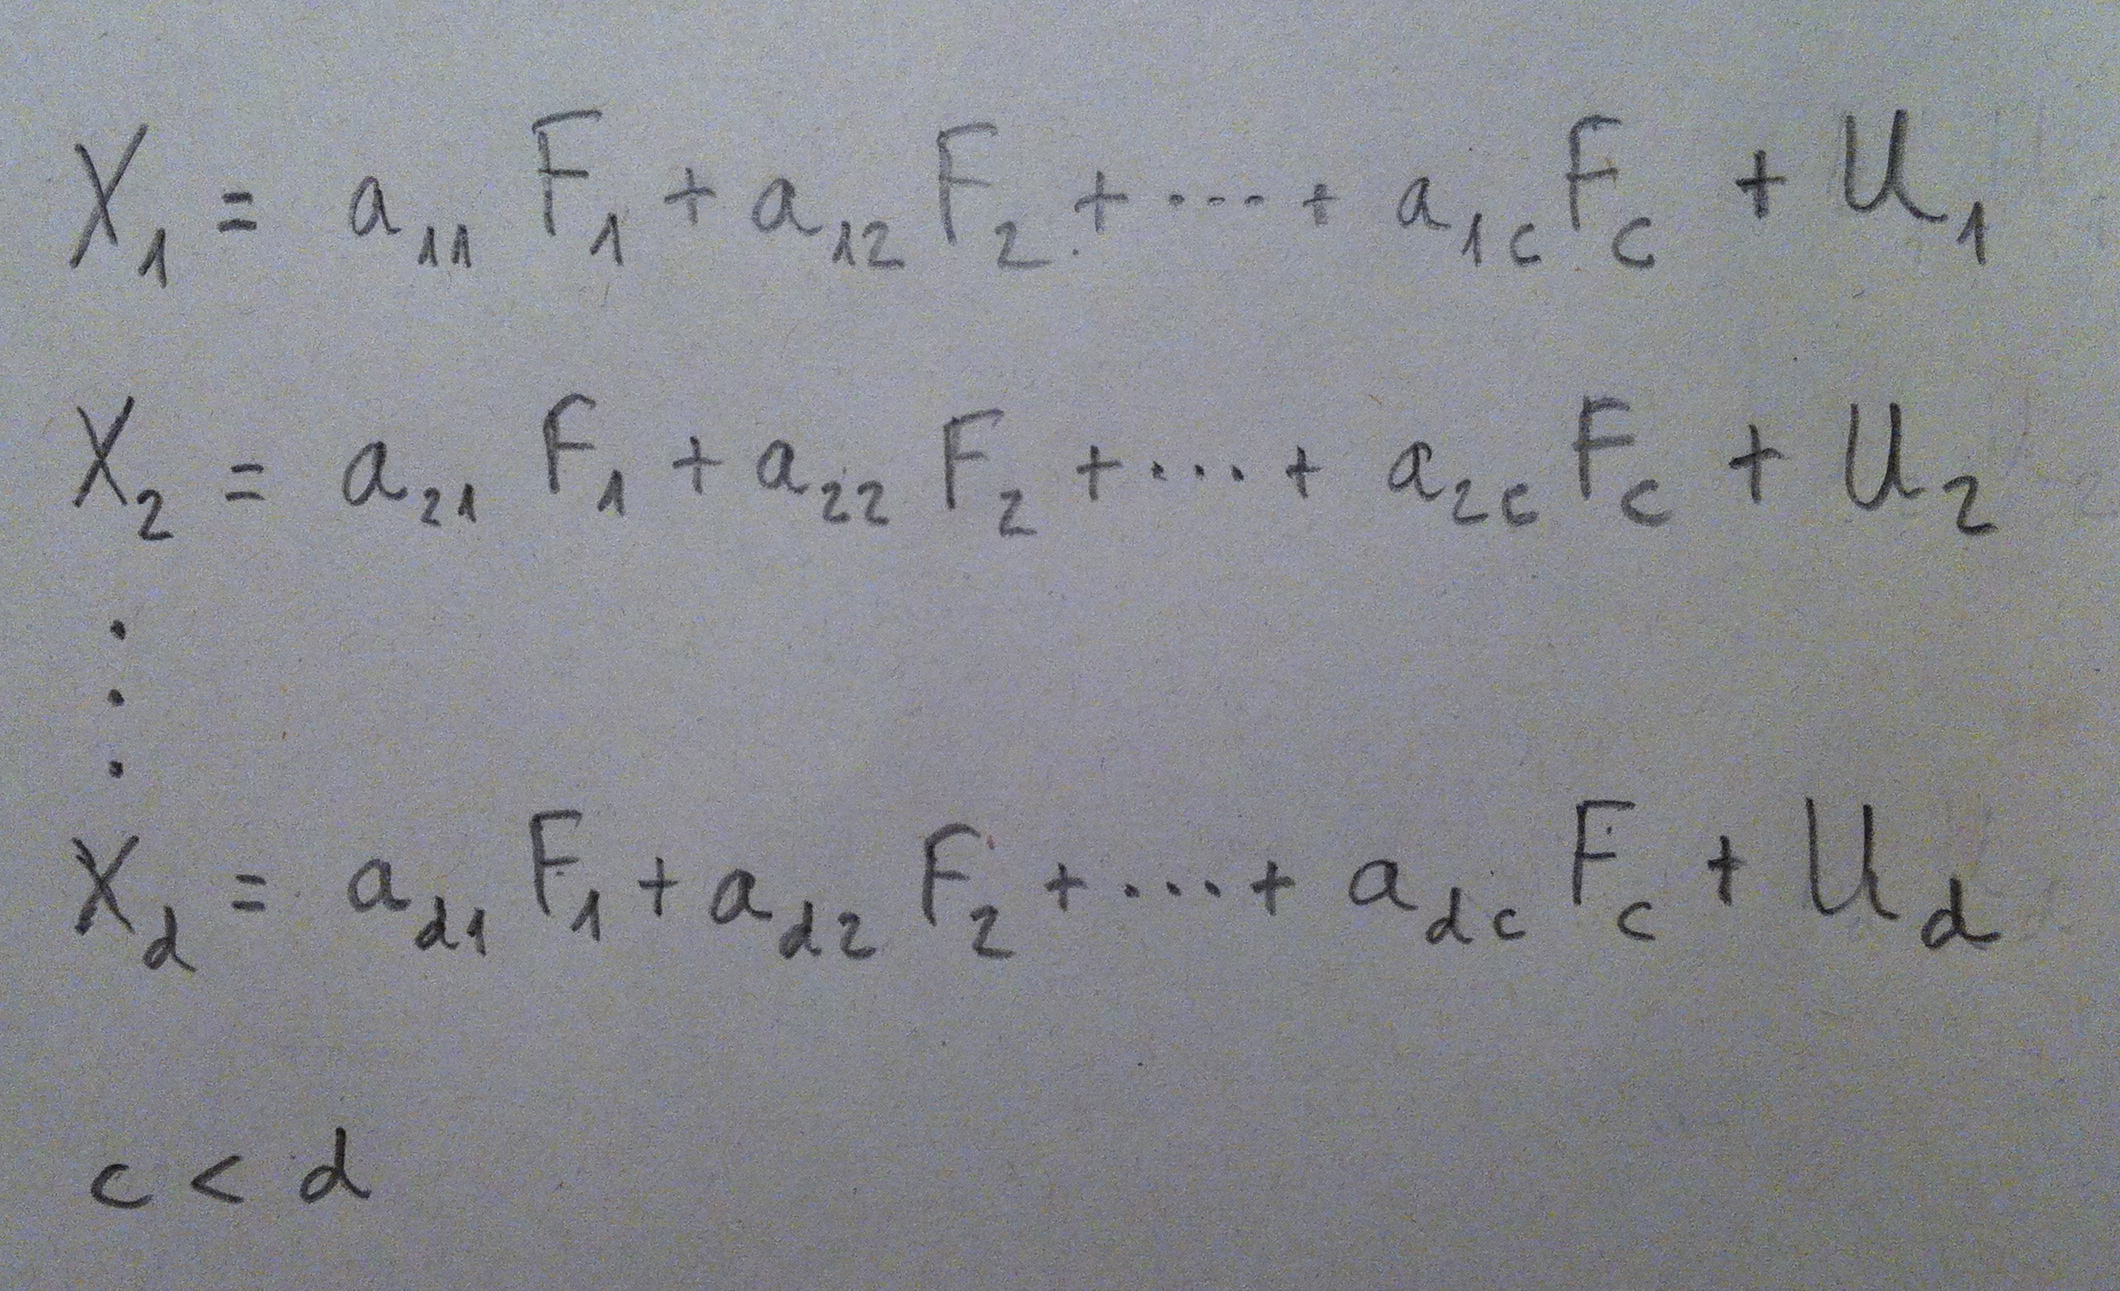
Tema 18: ANÁLISIS FACTORIAL

1. El punto de partida del Análisis factorial (AF) es el mismo que el del Análisis de componentes principales (ACP). De hecho, como explicaré más adelante, en realidad, el ACP es un AF que, debido a su simplicidad y su aplicabilidad, se ha independizado y ha adquirido vida propia. Hemos visto primero el ACP porque es más sencillo en cuanto a maquinaria y, por razones, didácticas es mejor empezar por él.

2. La finalidades del AF son, pues, las mismas que teníamos en el ACP: 1) Conseguir una representación gráfica de una realidad que es imposible representar en toda su extensión, visualizar una visión aproximada de una nube de puntos original que es imposible visualizar por exceso de dimensiones. 2) Conseguir combinaciones de las variables originales que nos ayuden a discernir tipos de relaciones que se establecen entre las variables del estudio.

3. Recordemos, en primer lugar, en formato matemático, cuál era el procedimiento del ACP. Se trataba de crear unas nuevas variable (la componentes) que tuvieran una gran diferencia entre la variabilidad explicada y que, cada una de ellas fuera combinación lineal de las variables originales:

IMG_4601

4. De d variables originales obtenemos d componentes, pero nos quedamos únicamente con las primeras, las principales, por almacenar en su interior mucha más información de la nube de puntos original. El formato matemático del AF es este otro:

IMG_4629

5. A las variables F1, F2, …, Fc, las llamamos factores. Importante que c sea menor que d. En realidad, interesa que sea mucho menor, que con dos o tres factores tengamos suficiente, como con la componentes principales: interesa que unas pocas acumulen mucha información, mucha varianza de la nube de puntos original. Cada uno de los factores es, también, como las componentes, una combinación lineal de todas las variables originales:

IMG_4630

6. Como puede apreciarse estos factores son como las componentes. Los factores son independientes entre ellos, también, como las componentes. Pero no se crean d factores sino que se crean un número c que es siempre menor que d, como ya hemos dicho antes.

7. El conjunto de estos factores constituyen la llamada comunalidad. Esto es muy interesante. Observemos aquí la diferencia con el planteamiento del ACP. En el AF escribimos cada una de las variables originales como una combinación de esos factores comunes. Los factores son, por lo tanto, elementos que están en el interior de esas variables, como sus elementos indisociables. Los factores son como si fueran las piezas profundas de lo que está hecha la diversidad de las variables que vemos y cuantificamos. Los factores serían, pues, como los átomos que se combinan, en proporciones distintas, en las moléculas (que serían las variables del estudio).

8. Las variables U1, U2, …, Ud son las llamadas unicidades, porque cada una de ellas es única y distinta en cada una de las variables originales. La comunalidad capta lo común, las unicidades suman lo diverso.

9. Las unicidades son una especie de Residuo, un elemento individual de cada una de las d variables originales y que es lo que queda por explicar de cada una de ellas después de haber sumado una combinación peculiar y única de los factores en cada una de ellas, después de haber introducido en ellas lo que tienen de la comunalidad, de lo común, de lo que se explica por los factores comunes elegidos.

10. Es muy importante comparar el AF con el ACP, porque en esa comparación está el elemento diferencial entre esas dos técnicas y será precisamente esta comparación la que nos ayudará a encontrar la singularidad del Análisis que ahora nos ocupa.

11. Lo primero a distinguir es que en el ACP tiene solución única, lo que significa que, cuando se pone en marcha la maquinaria de la técnica frente a unos datos, hay una única solución, la que proporciona, como hemos visto, los valores propios y los vectores propios. La única opcionalidad que tenemos es, como ya hemos dicho en el tema dedicada al ACP, trabajar con la matriz de correlaciones o la de varianzas-covarianzas. Sin embargo, en el AF, no hay una única solución, hay distintas formas de extracción de los factores y cada una de ellas da lugar a un resultado distinto. Al separar una parte común (la comunalidad: los factores) y una parte única (las unicidades) de cada una de las variables originales, estamos creando las condiciones para generar formas distintas de llegar a esa situación y, por lo tanto, que haya soluciones distintas.

12. Al no haber una solución única, como sucede con el ACP, se han diseñado muchas formas de extracción de los factores. Posiblemente el sistema de extracción de los mínimos cuadrados sea el más usual, pero hay otros, por ejemplo: Método del centroide, Método de Jacobi, Método de la máxima verosimilitud. De hecho, el propio sistema de las componentes principales es también un método de extracción de factores: mediante ese método se seleccionan las dos o tres primeras componentes conviertiéndolas en los factores. Observemos que entonces las componentes Y las convertimos en factores F. Hay que decir que, aunque sean muchos los métodos de extracción, en realidad son pocos los que han sido implementados en los principales software estadísticos.

13. El sistema de los mínimos cuadrados, que es uno de los métodos más usado, se basa en la búsqueda de la recta, del plano o del hiperplano (dependiendo del número de factores elegidos) que minimice las unicidades, que actuarían aquí como el residuo de la Regresión. Es un planteamiento derivado, evidentemente, de la Regresión lineal.

14. Gráficamente esto que estoy diciendo se puede ilustrar de la siguiente forma: Dada una nube de puntos según el criterio que sigamos puede ser que el factor generado sea ligeramente diferentes. Por ejemplo, en el siguiente caso la recta roja podría seguir el criterio de las componentes (la búsqueda de la máxima variabilidad en el primer eje) y la recta verde podría seguir el criterio de los mínimos cuadrados:

IMG_2712

15. La segunda diferencia entre el ACP y el AF está en la idea de rotaciones presente en el AF y que no lo está en el ACP. Una vez se han extraído los factores, cada uno de ellos es, como hemos visto, una determinada combinación de las variables originales, combinación caracterizada por una serie de coeficientes que multiplican a esas variables y que están asociados a cada factor. Pues bien, esos factores se pueden rotar según criterios distintos. Se trata de pequeños giros de los nuevos ejes de coordenadas con la finalidad de mejorar algún aspecto prefijado.
16. Rotar implica que cambien los coeficientes. Cualquier cambio de los ejes supone un cambio de los coeficientes. Si con ligeros cambios de los ejes, y, por lo tanto, de los coeficientes, se pierde poca capacidad de representación y se gana en algún criterio prefijado, entonces vale la pena la rotación.

17. El método de rotación más usual es el Varimax que minimiza el número de variables, en cada factor, con coeficientes elevados en valor absoluto.

18. Pensemos que el juego de muchos coeficientes actuando en un factor, en el AF, o en una componente principal, en el ACP, puede dificultar mucho su interpretación. Es difícil ponerle  entonces nombre a esa macrovariable. La rotación Varimax realiza una rotación que simplifica, lo más posible, el repertorio de coeficientes. Se consigue que haya menos coeficientes con valores absolutos grandes pero que esos valores absolutos sean más grandes que sin la rotación. Esto aclara la interpretación, generalmente.

19. Existen otros criterios de rotación: Quartimax, Equamax, etc, pero son de largo mucho menos utilizados que el Varimax. Evidentemente la rotación es una opción, no una obligación. Puede hacerse un Análsis factorial sin rotación.

20. Por lo tanto, ante un AF debe decidirse el método de extracción y, luego, si se hace o no rotación. Si se hace rotación debe decidirse con qué criterio, con qué método de rotación.

21. Visto todo esto podemos situar ahora el ACP como un AF especial, tan especial que ha conseguido independizarse, como ya hemos dicho antes. El ACP es un AF al que se le aplica como método de extracción el de las componentes principales y al que no se le aplica ninguna rotación.

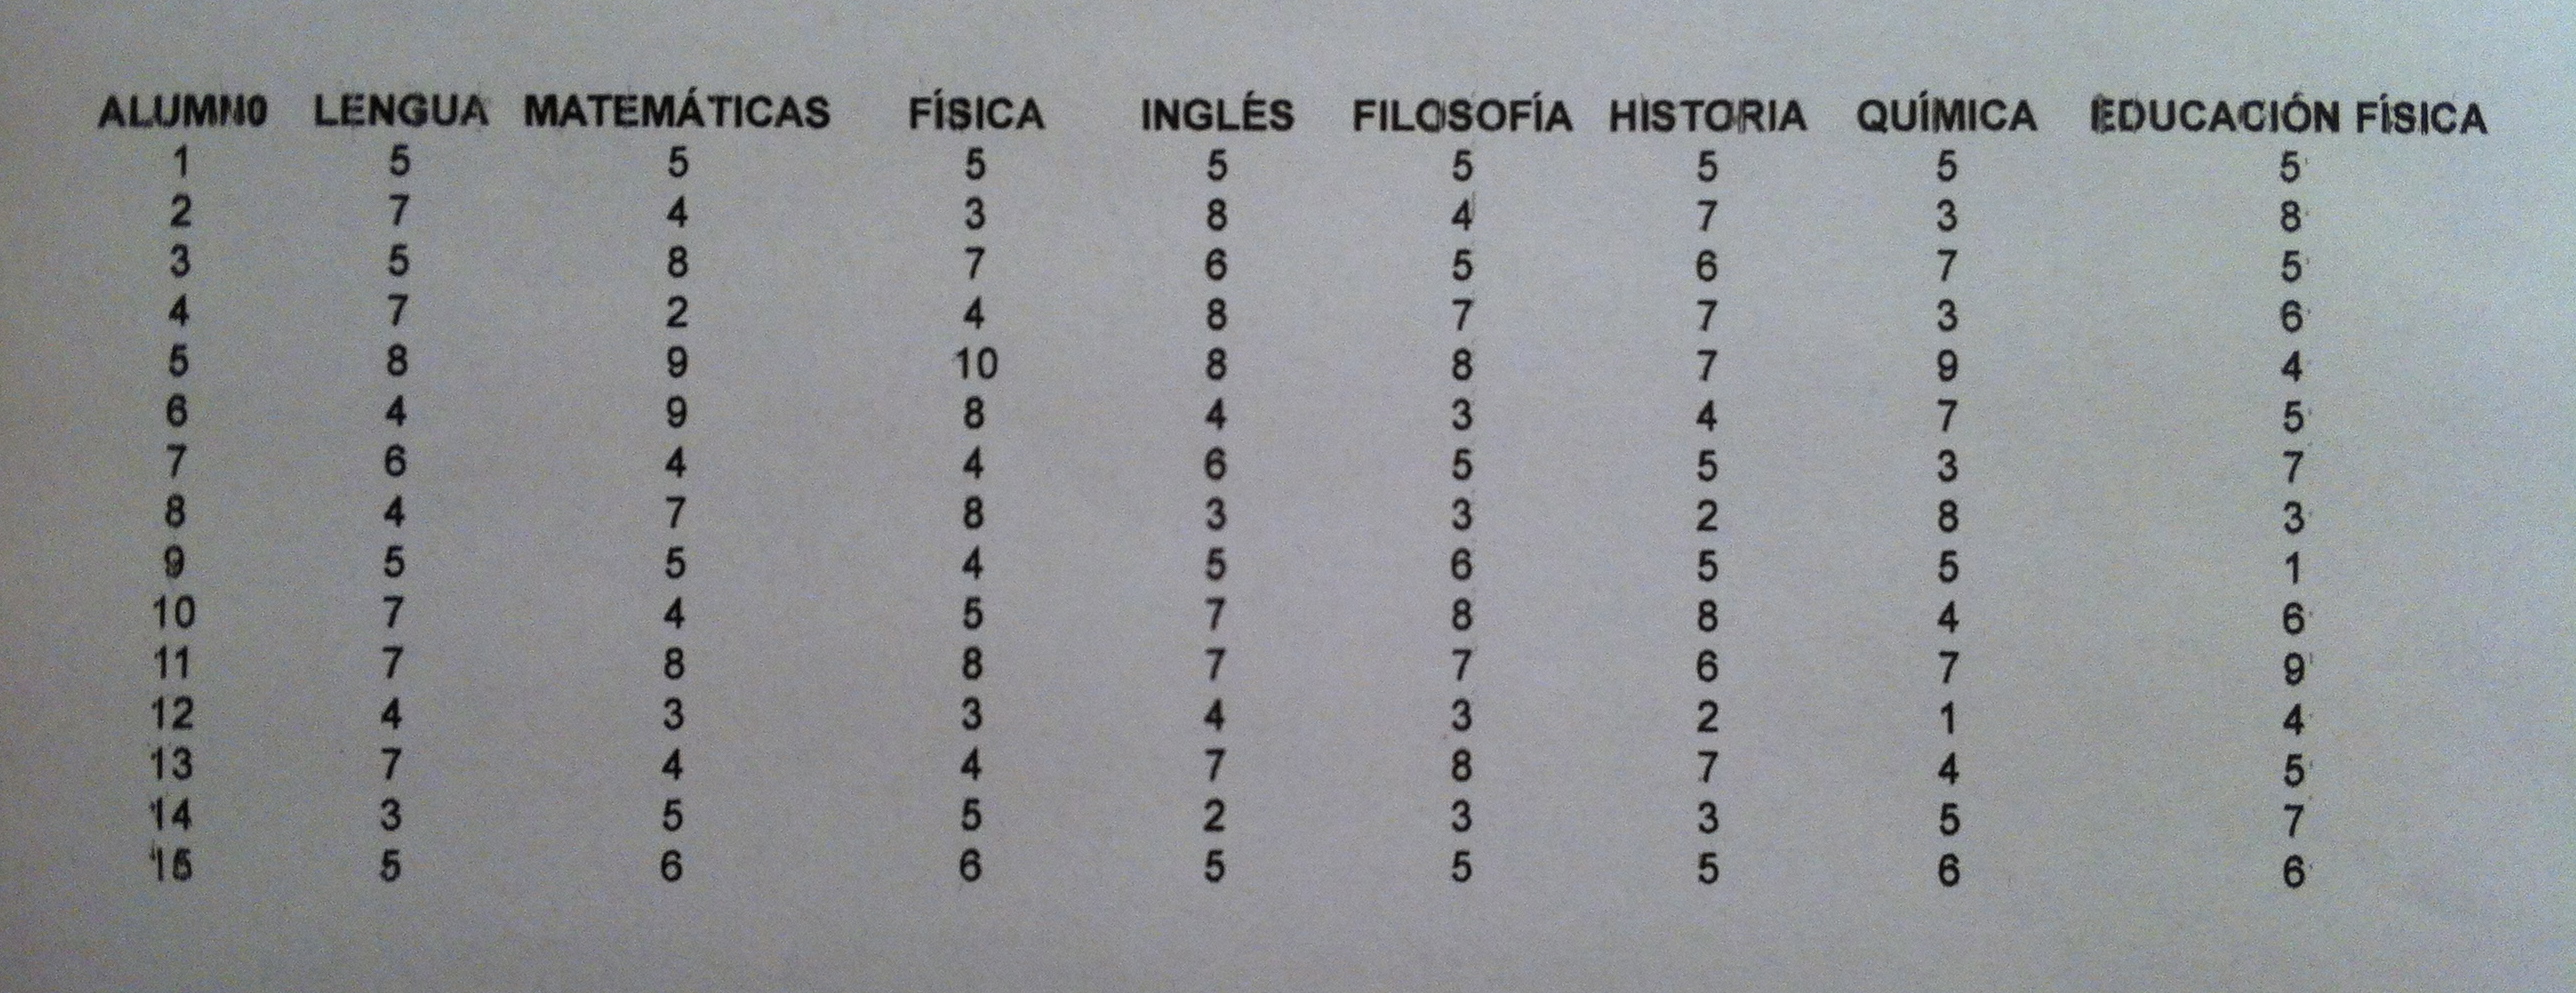
22. Vamos a aplicar el AF a los datos de las notas de 15 estudiantes en ocho materias diferentes que usamos para aplicar el ACP. Recordemos la matriz de datos:

IMG_4596

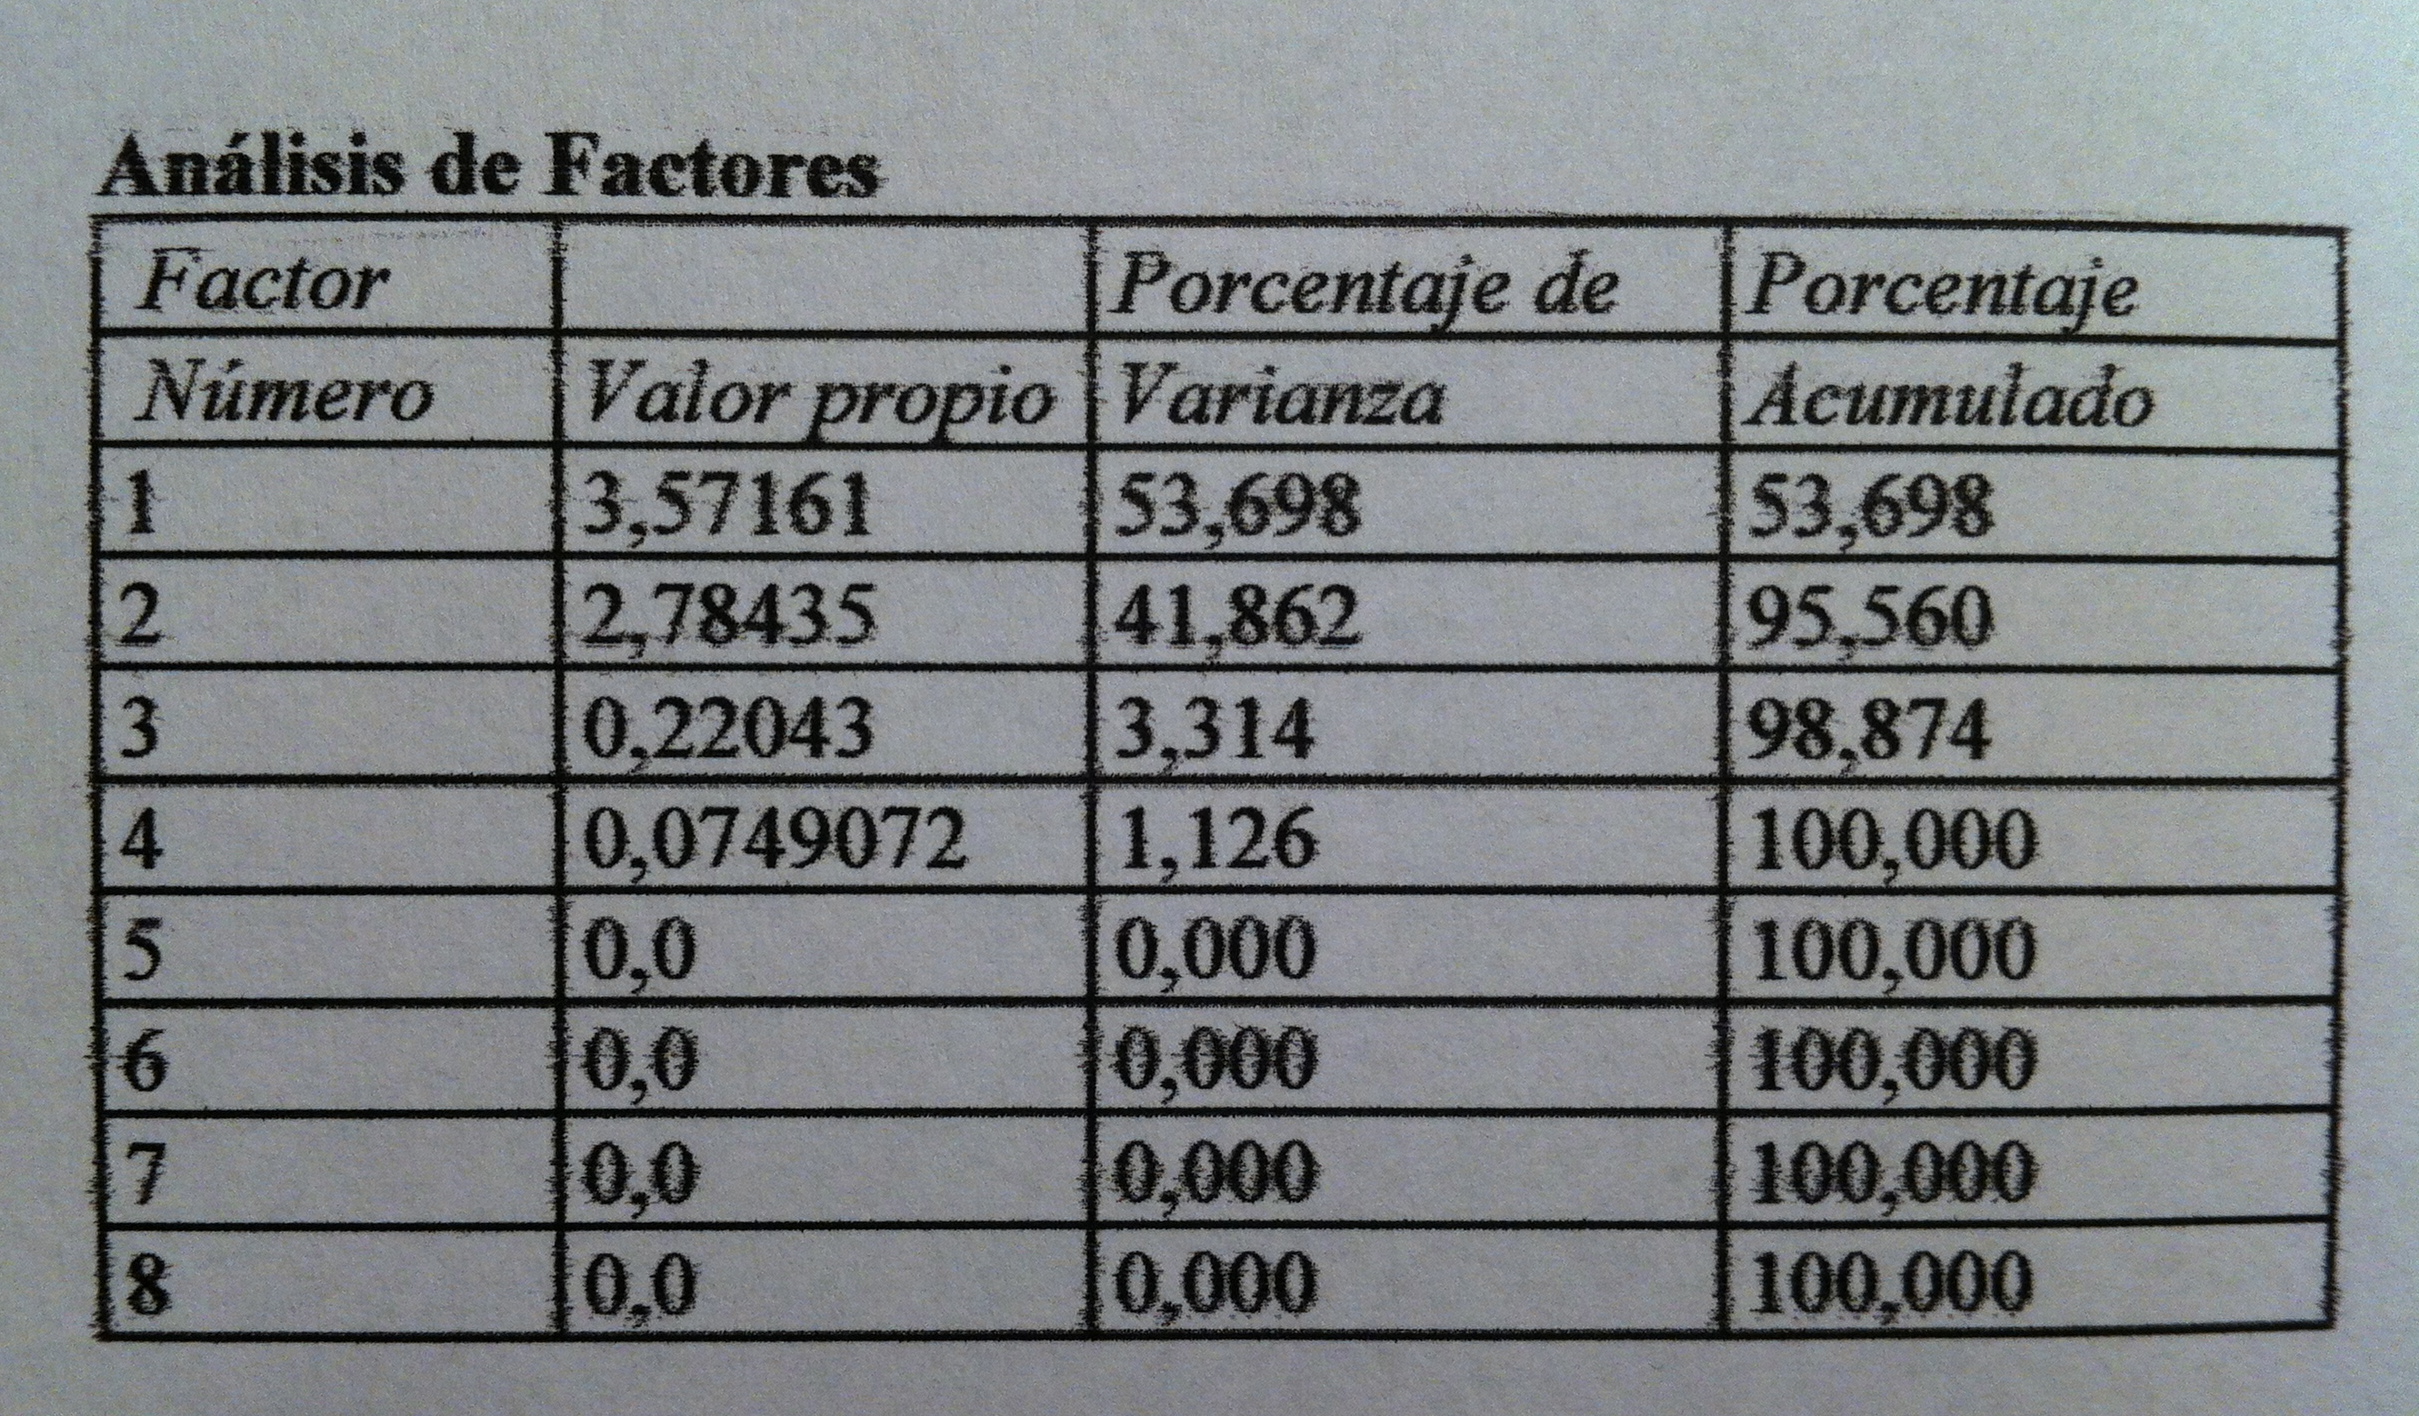
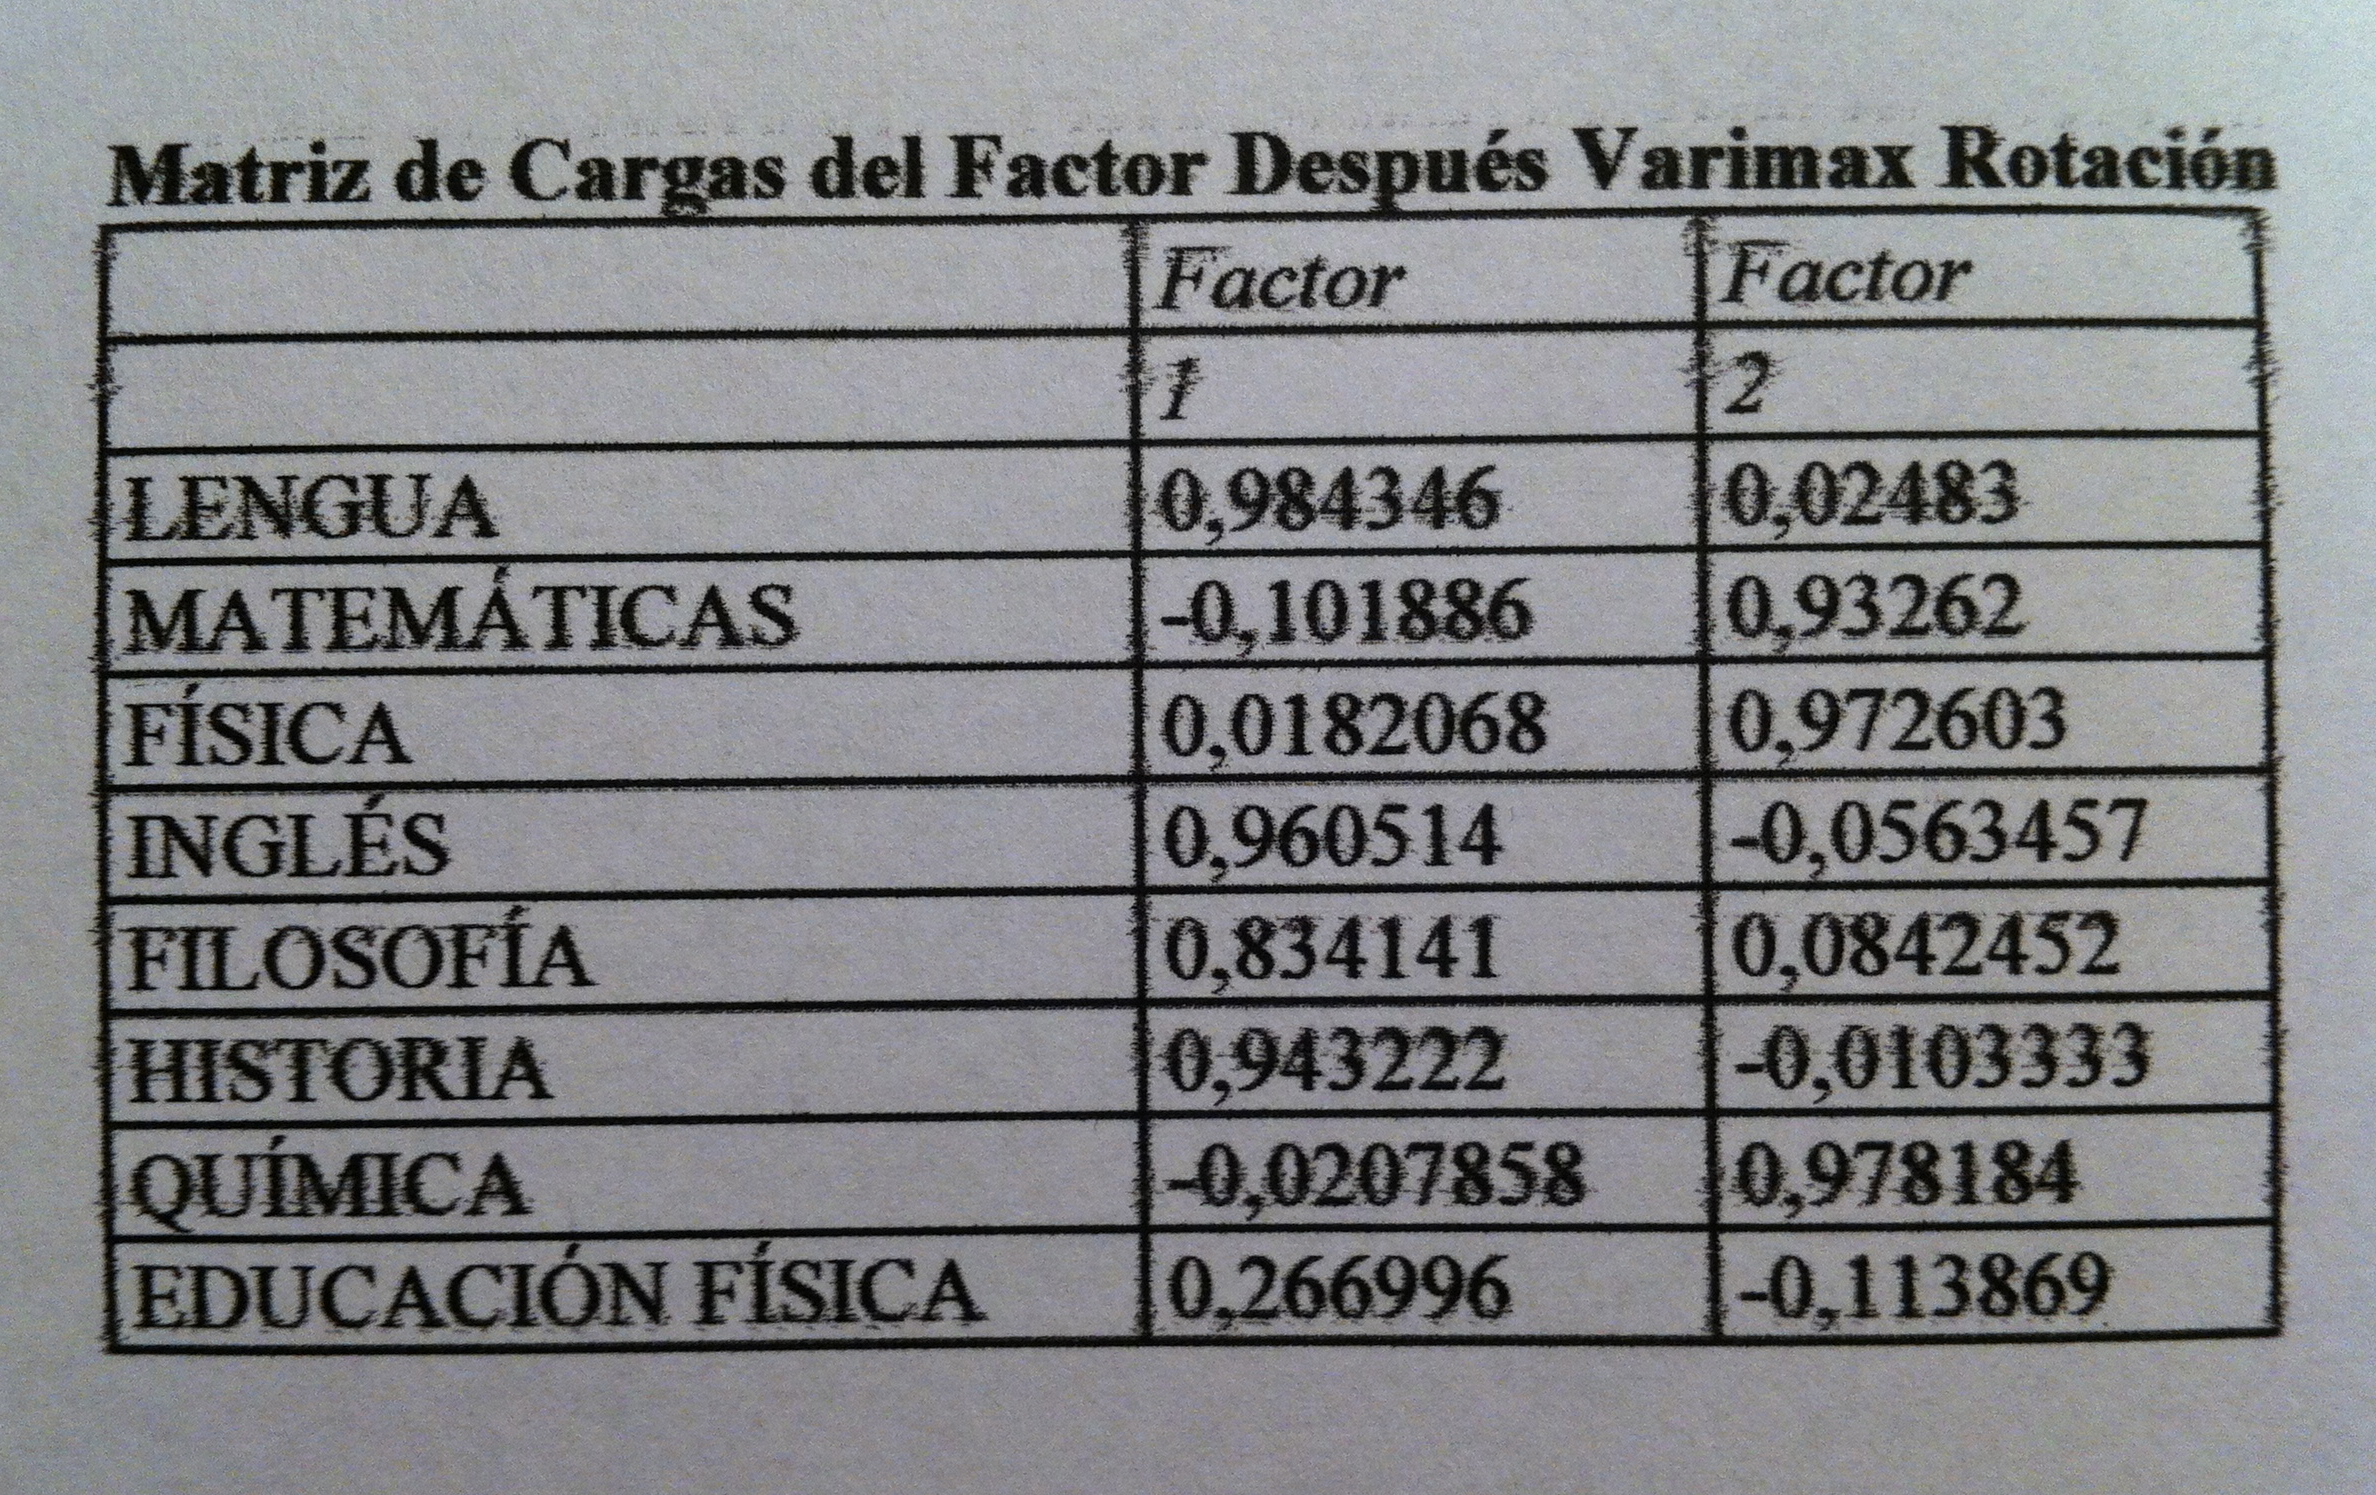
23. Si aplicamos el método de extracción de los mínimos cuadrados y la rotación varimax conseguimos los siguientes valores propios de la matriz de correlaciones:

IMG_4652

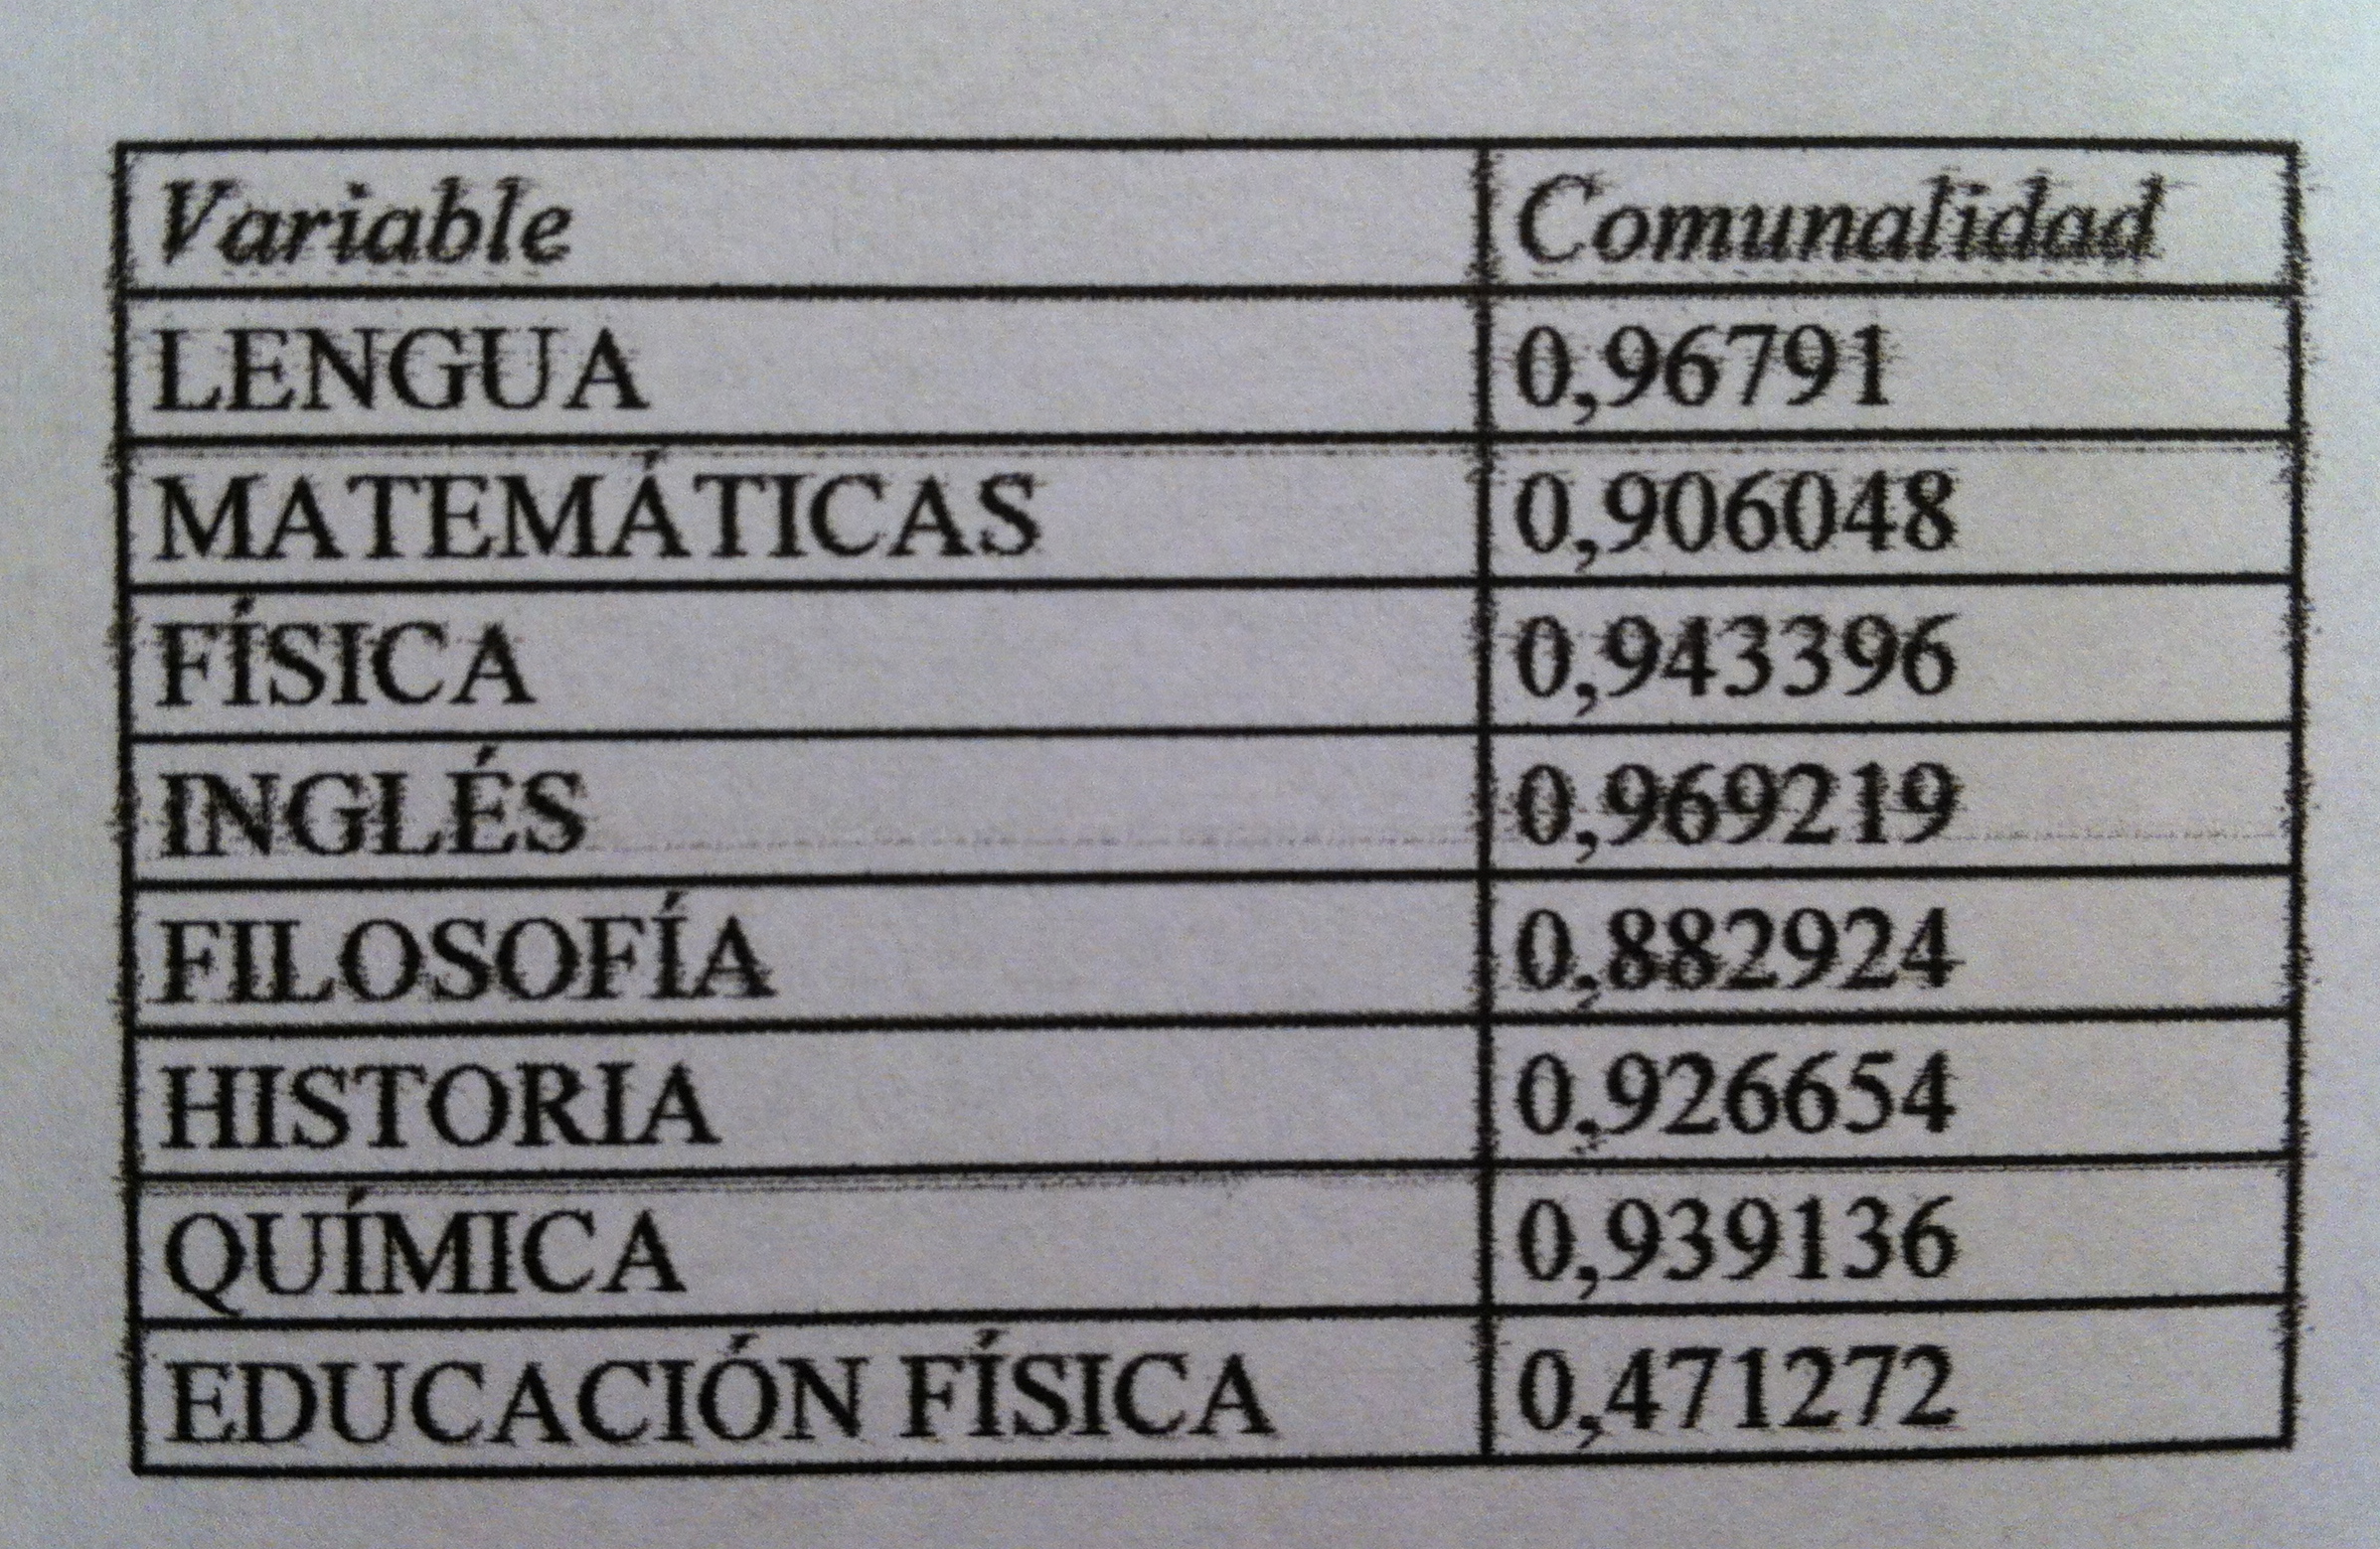
23. Con dos factores explicamos, por lo tanto, el 95.56 de la varianza. La comunalidad es la siguiente:

IMG_4653

24. Esto significa que los dos factores seleccionados explican estos tantos por uno de estas variables originales. Son todos muy altos (suele entenderse por alto a partir de 0.75 ó 0.8). El único que no llega a este nivel es la variable Educación física. Se trata de una variable que si le sumamos los factores combinados de alguna forma sólo conseguimos explicar el 47.12% de su medida, por lo tanto, tiene una elevadísima unicidad no contemplada en los factores. Esto ya lo veíamos en el ACP: la Educación física va un poco por libre, mide un tipo de cosas que no tiene relación con lo que miden las otras materias.

25. El número de factores elegidos será el resultado de valorar dos cosas: 1) Que mediante ellos obtengamos un porcentaje de explicación como mínimo del 75-80% y esto lo veremos mediante los valores propios. 2) Que la comunalidad de las variables originales, o al menos del grupo de ellas que especialmente queremos explicar, sea también, al menos del 75-80%, o de 0.75-0.8, en tanto por uno.

26. Y a continuación vamos a ver cuáles son las fórmulas de los dos factores con la rotación varimax:

IMG_4654

27. Como puede verse el primer factor recoge como coeficientes grandes las materias de letras: Lengua, Inglés Filosofía e Historia. El segundo factor recogen como coeficientes grandes las materias de ciencias: Matemáticas, Física y Química. Como sucedía en el ACP.

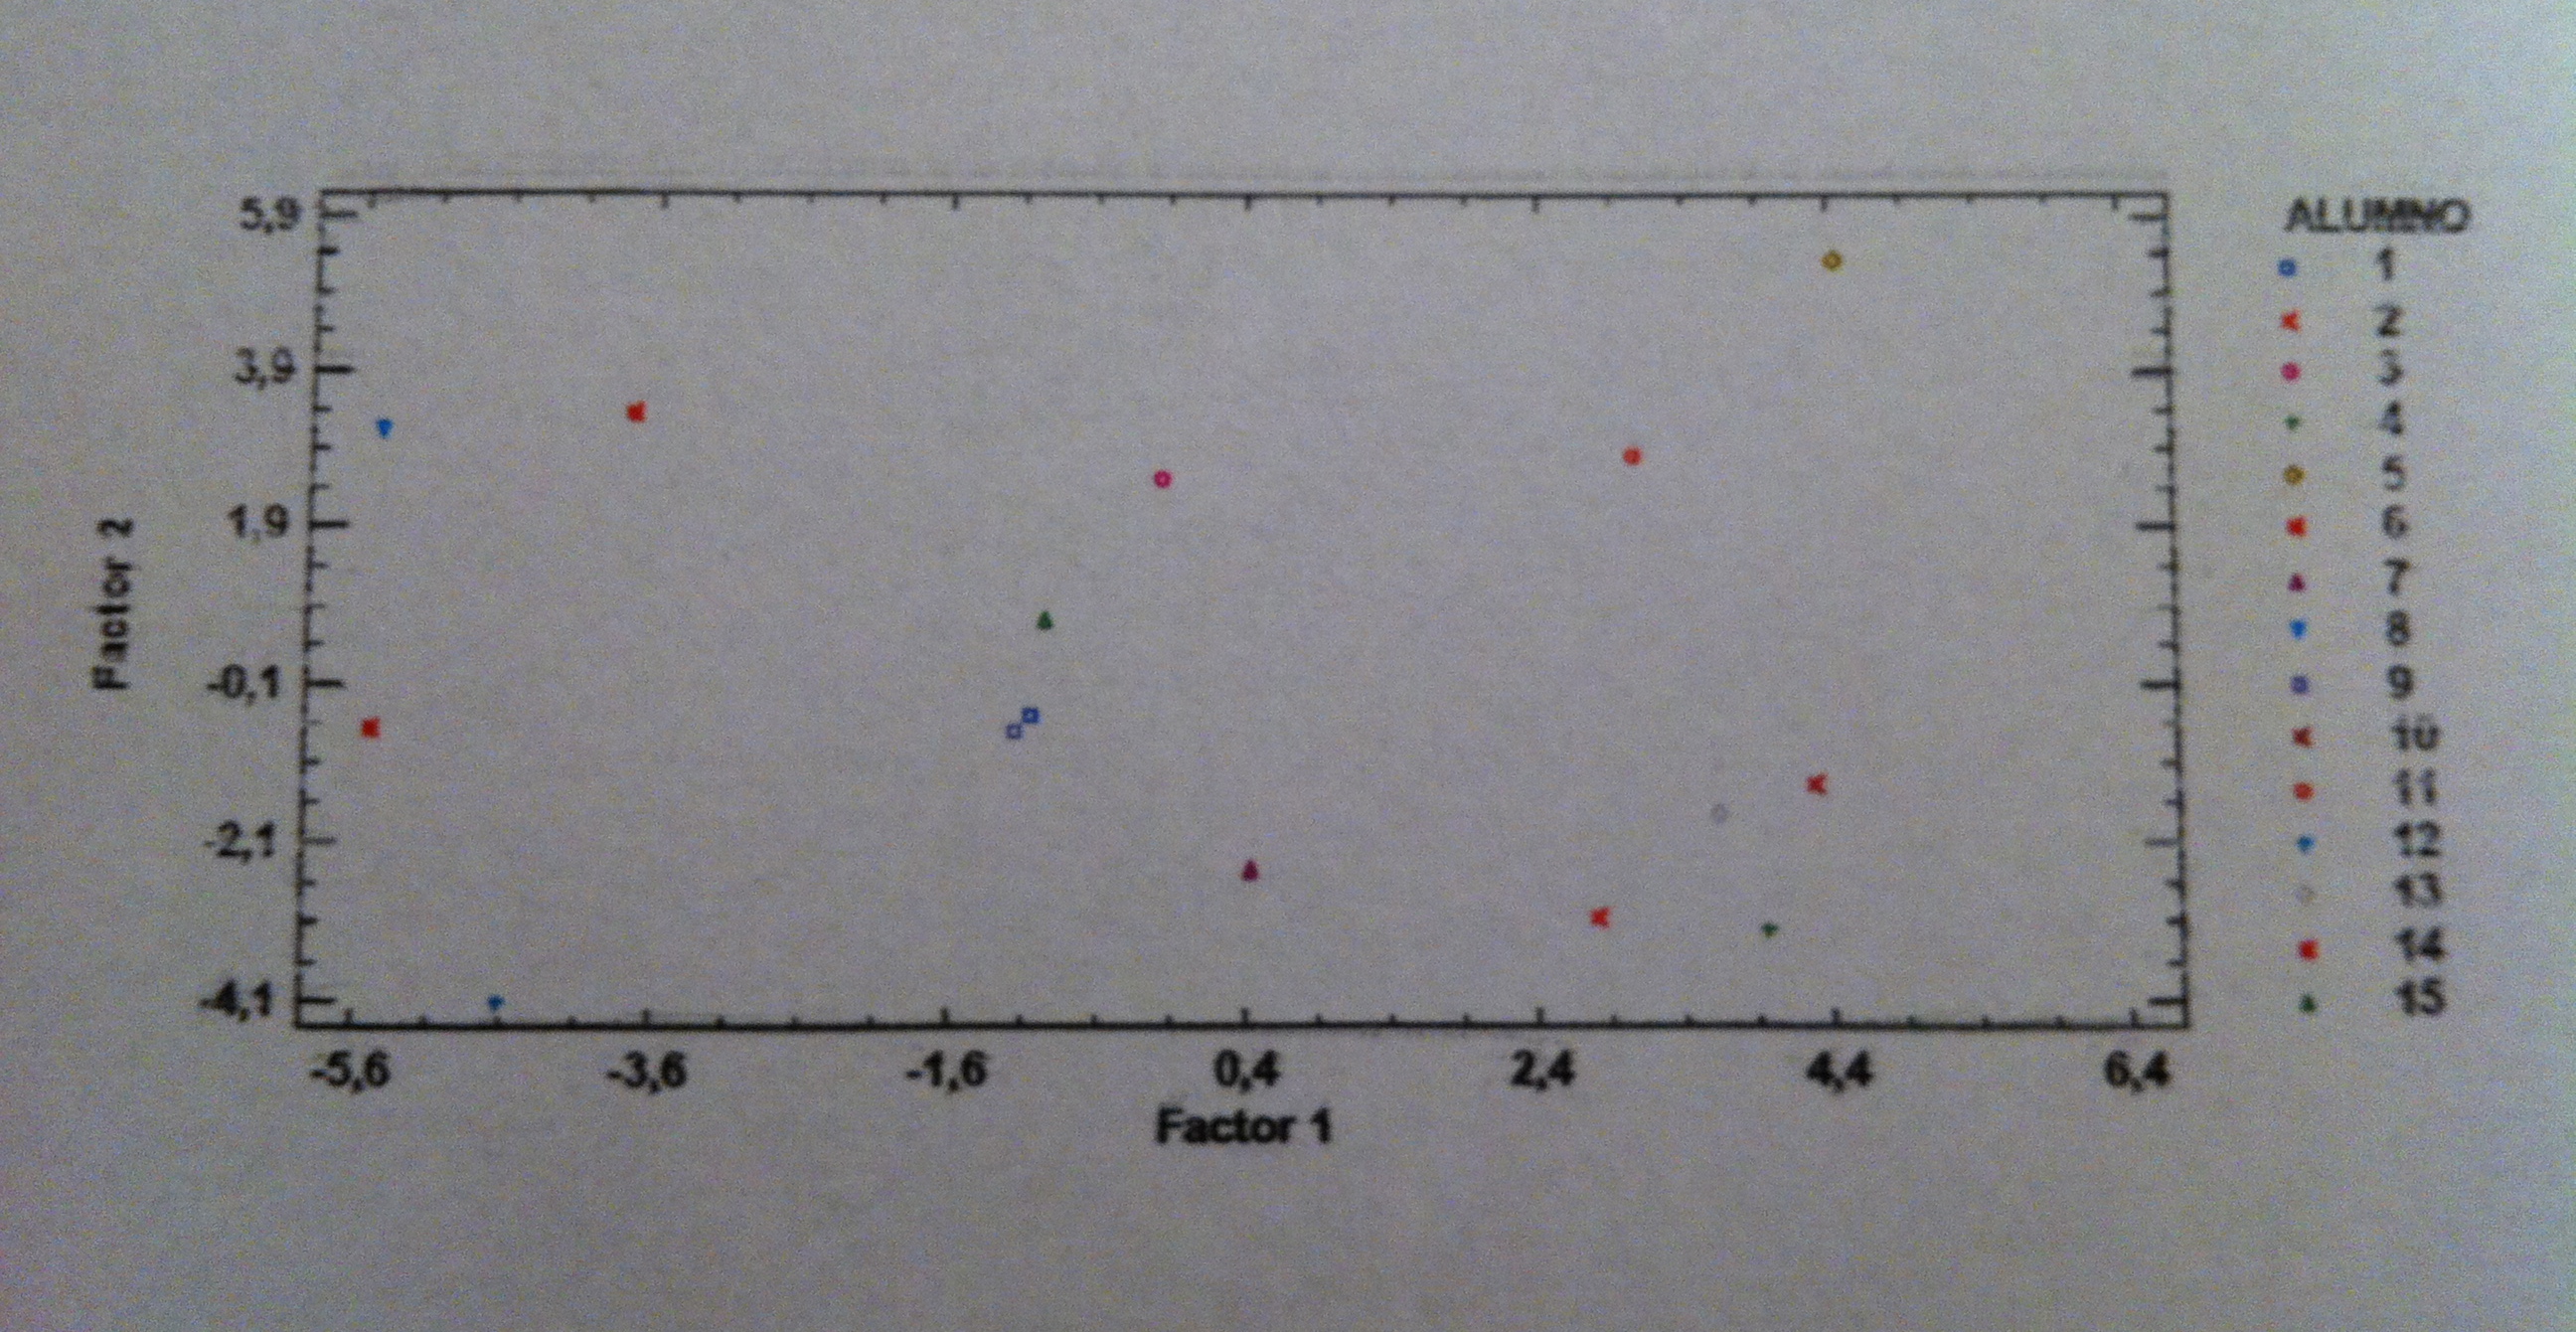
28. El gráfico de los 15 alumnos representados respecto a los dos factores elegidos es:

IMG_4657

29. Realmente si lo comparamos con el obtenido mediante el Análisis de componentes principales es muy similar. Recordemos aquél gráfico:

IMG_4620

30. Comparando ambas técnicas, el AF y el ACP, aplicadas a los mismos datos podemos comprobar que los resultados obtenidos son similares. Los dos factores y las dos componentes principales se interpretan de la misma forma. Las representaciones son prácticamente idénticas. Son dos formas distintas de llegar al mismo sitio, por lo tanto. En este ejemplo, las cosas son muy claras y de ahí la similaridad. La varianza explicada en ambos caso es muy alta lo que favorece la igualdad en los resultados. Si no fuera tan alta esta varianza total explicada podríamos encontrarnos con mayores diferencias.

31. El ejemplo que hemos utilizado es sencillo. Con datos complejos, donde el repertorio de variables es amplio y diverso suele ser muy difícil interpretar el ACP. Especialmente en estos casos el AF puede aportar una luz que no seamos capaces de ver mediante el ACP.

32. Por otra parte, mucha diferencia en las representaciones obtenidas por un método u otro no deben existir, porque, en realidad, estamos intentando, como ya hemos dicho, con ambas técnicas, representar una nube de puntos original, que no visualizamos, mediante una nube de puntos en menos dimensiones. Si un método de este tipo cumple su misión debe llegar a una solución similar a la obtenida por otro método diferente que persigue lo mismo. Únicamente en los casos en los que estemos haciendo representaciones muy poco fieles a la original podemos encontrar profundas diferencias entre estos distintos métodos.

Tema 17: ANÁLISIS DE COMPONENTES PRINCIPALES

Toda la explicación que a continuación tenéis del Análisis de componentes principales la podéis seguir, también, paralalamente, con la explicación de los siguientes vídeos:


1. El Análisis de componentes principales (ACP) es una técnica estadística descriptiva que tiene como punto de partida una matriz de datos con una serie de individuos a los que se les ha medido varias variables. Por eso suele clasificarse como una técnica multivariante. Para guiarnos en esta técnica vamos a manejar unos datos como los que a continuación muestro:

IMG_4596

2. Se trata de unos datos que todos comprendemos perfectamente porque todos hemos sido estudiantes. Se trata de las notas de diferentes materias que obtienen 15 alumnos de bachillerato. Tenemos, pues, 15 individuos en el estudio; o sea, una muestra de tamaño 15 pero con ocho variables, tantas como asignaturas tenemos.

3. Si quisiéramos representar los 15 alumnos de esta muestra en un gráfico lo podríamos hacer tomando dos notas y representando los 15 puntos según sus valores en el eje de abscisas y de ordenadas. Podríamos también, eso sí, hacer una representación de tres de esas ocho variables en un gráfico tridimensional. Pero aquí se acaba. Ya no podríamos visualizar una representación en más dimensiones. Por lo tanto, es imposible ver en un gráfico una representación de los 15 individuos respecto a todas las variables al mismo tiempo.

4. El ACP tiene como objetivo básico inicial suplir este déficit. Pretende, cuando vale la pena hacerlo (ya veremos cuándo vale la pena y cuándo no), realizar una representación de una nube de puntos multidimensional (de más de tres dimensiones), en dos o tres dimensiones. En definitiva, se trata de visualizar lo que no vemos. En nuestro ejemplo de los estudiantes de bachillerato el ACP trataría de hacer una representación de los 15 alumnos en dos o tres dimensiones pero contemplando todas las variables, sin prescindir de ninguna de ellas en el análisis.

5.  Hay que hacer notar que, aunque el objetivo inicial es éste: la representación en dos o tres dimensiones de unos puntos que originariamente están en muchas dimensiones; o sea, visualizar lo que no vemos, la propia técnica, como consecuencia de su propio procedimiento, consigue crear unos objetos matemáticos (las componentes) muy interesantes que, en realidad, también podrían considerarse objetivos de la técnica porque, en muchas ocasiones, nos permiten establecer relaciones entre las variables, ver cómo se asocian, cómo se distancian, etc. De esto, no obstante, hablaré más tarde.

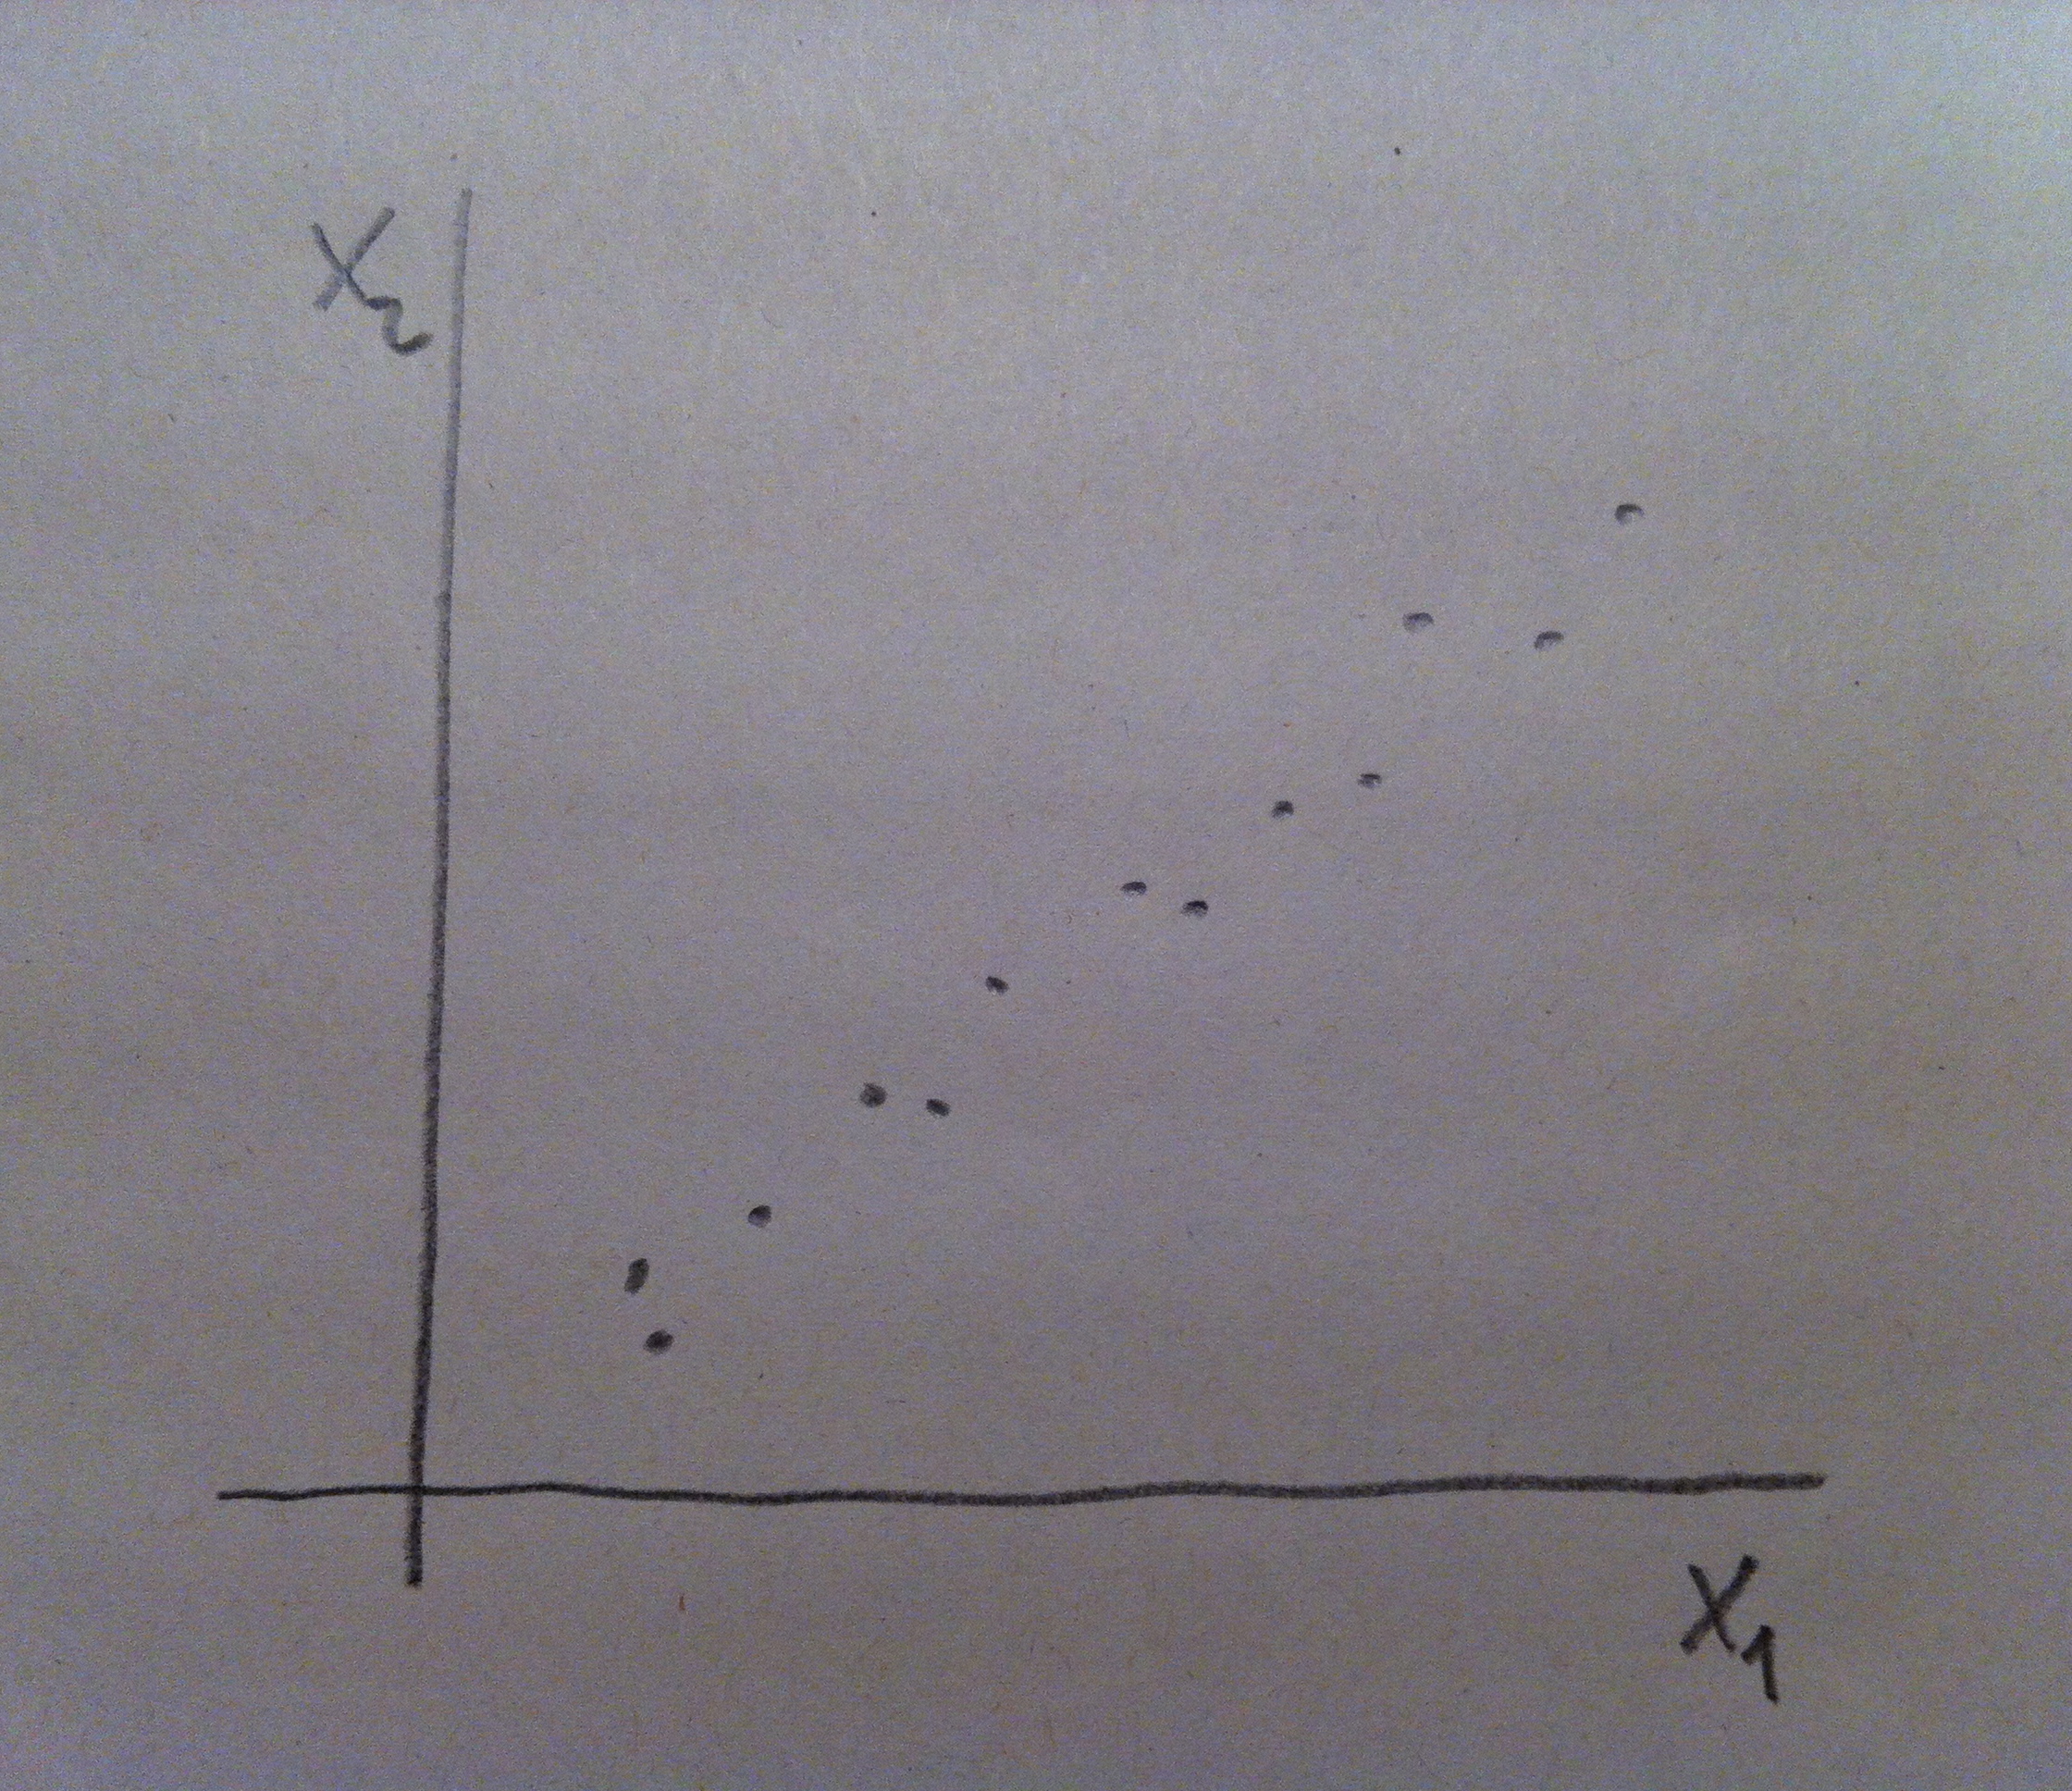
6. Vamos a ver el problema que estoy planteando pero miniaturizado. Así se entenderá mejor la esencia de la técnica. Supongamos que tenemos la siguiente representación bidimensional con dos variables X1 y X2:

IMG_4603

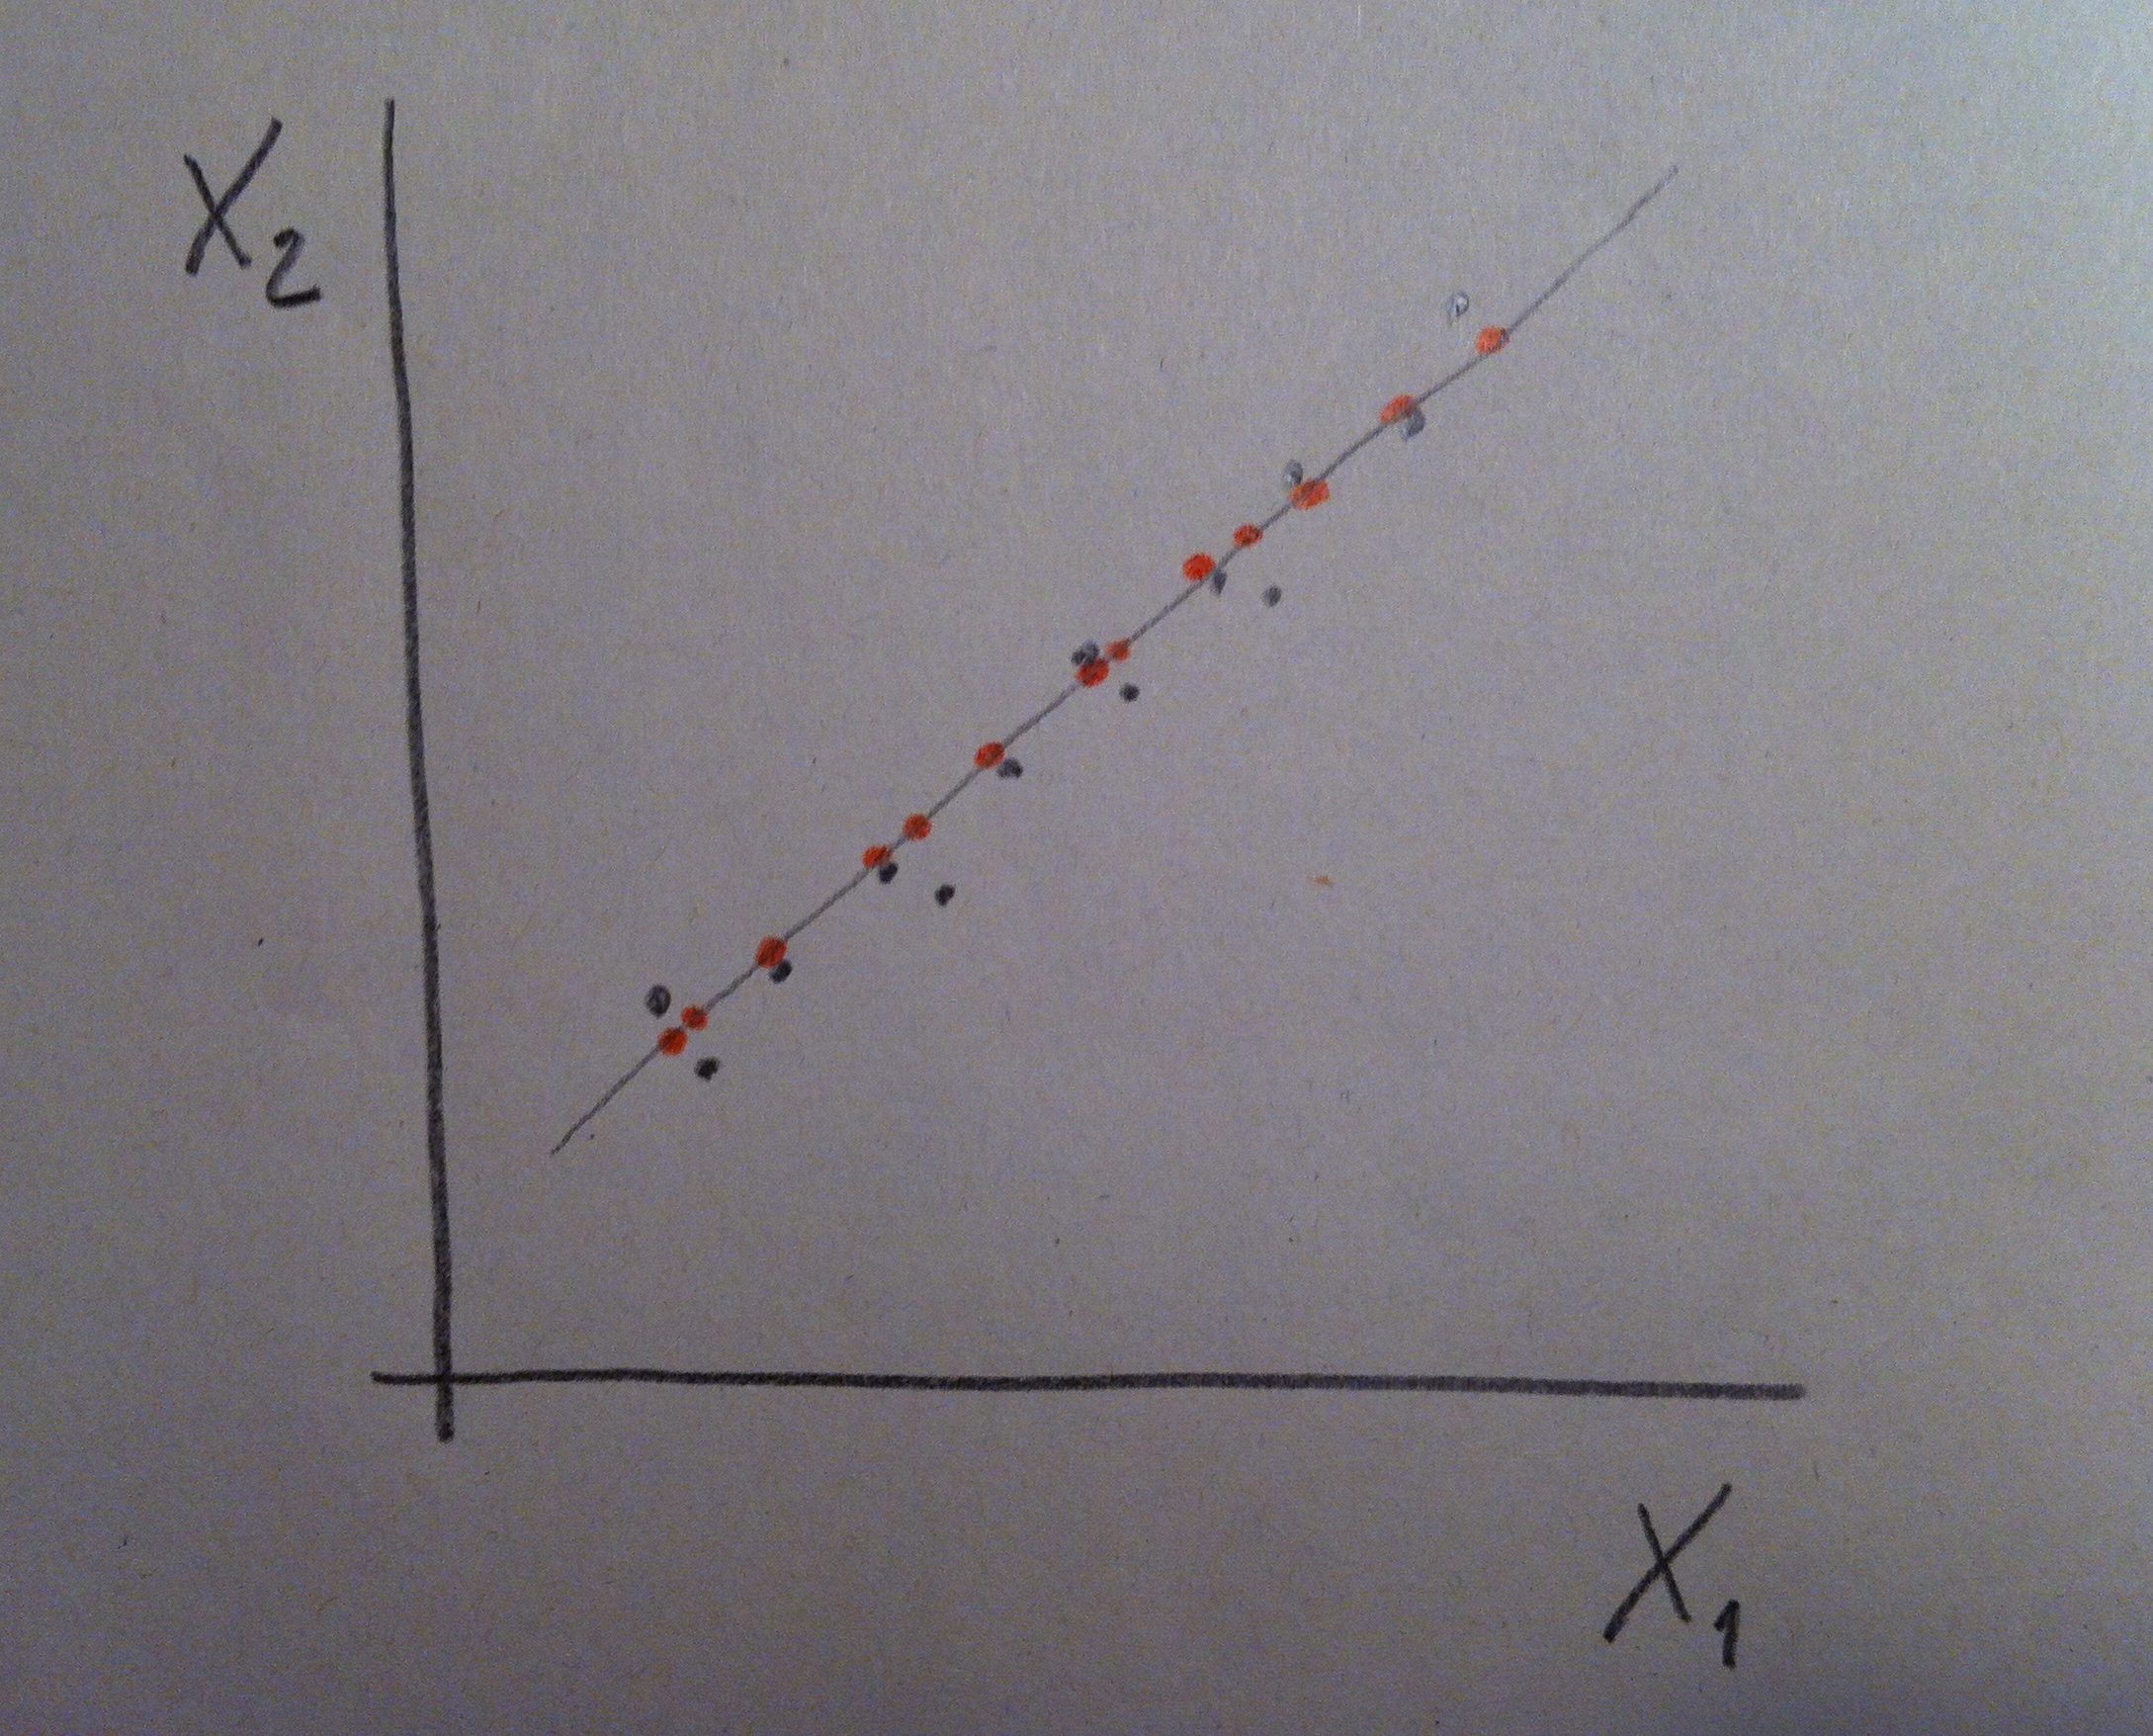
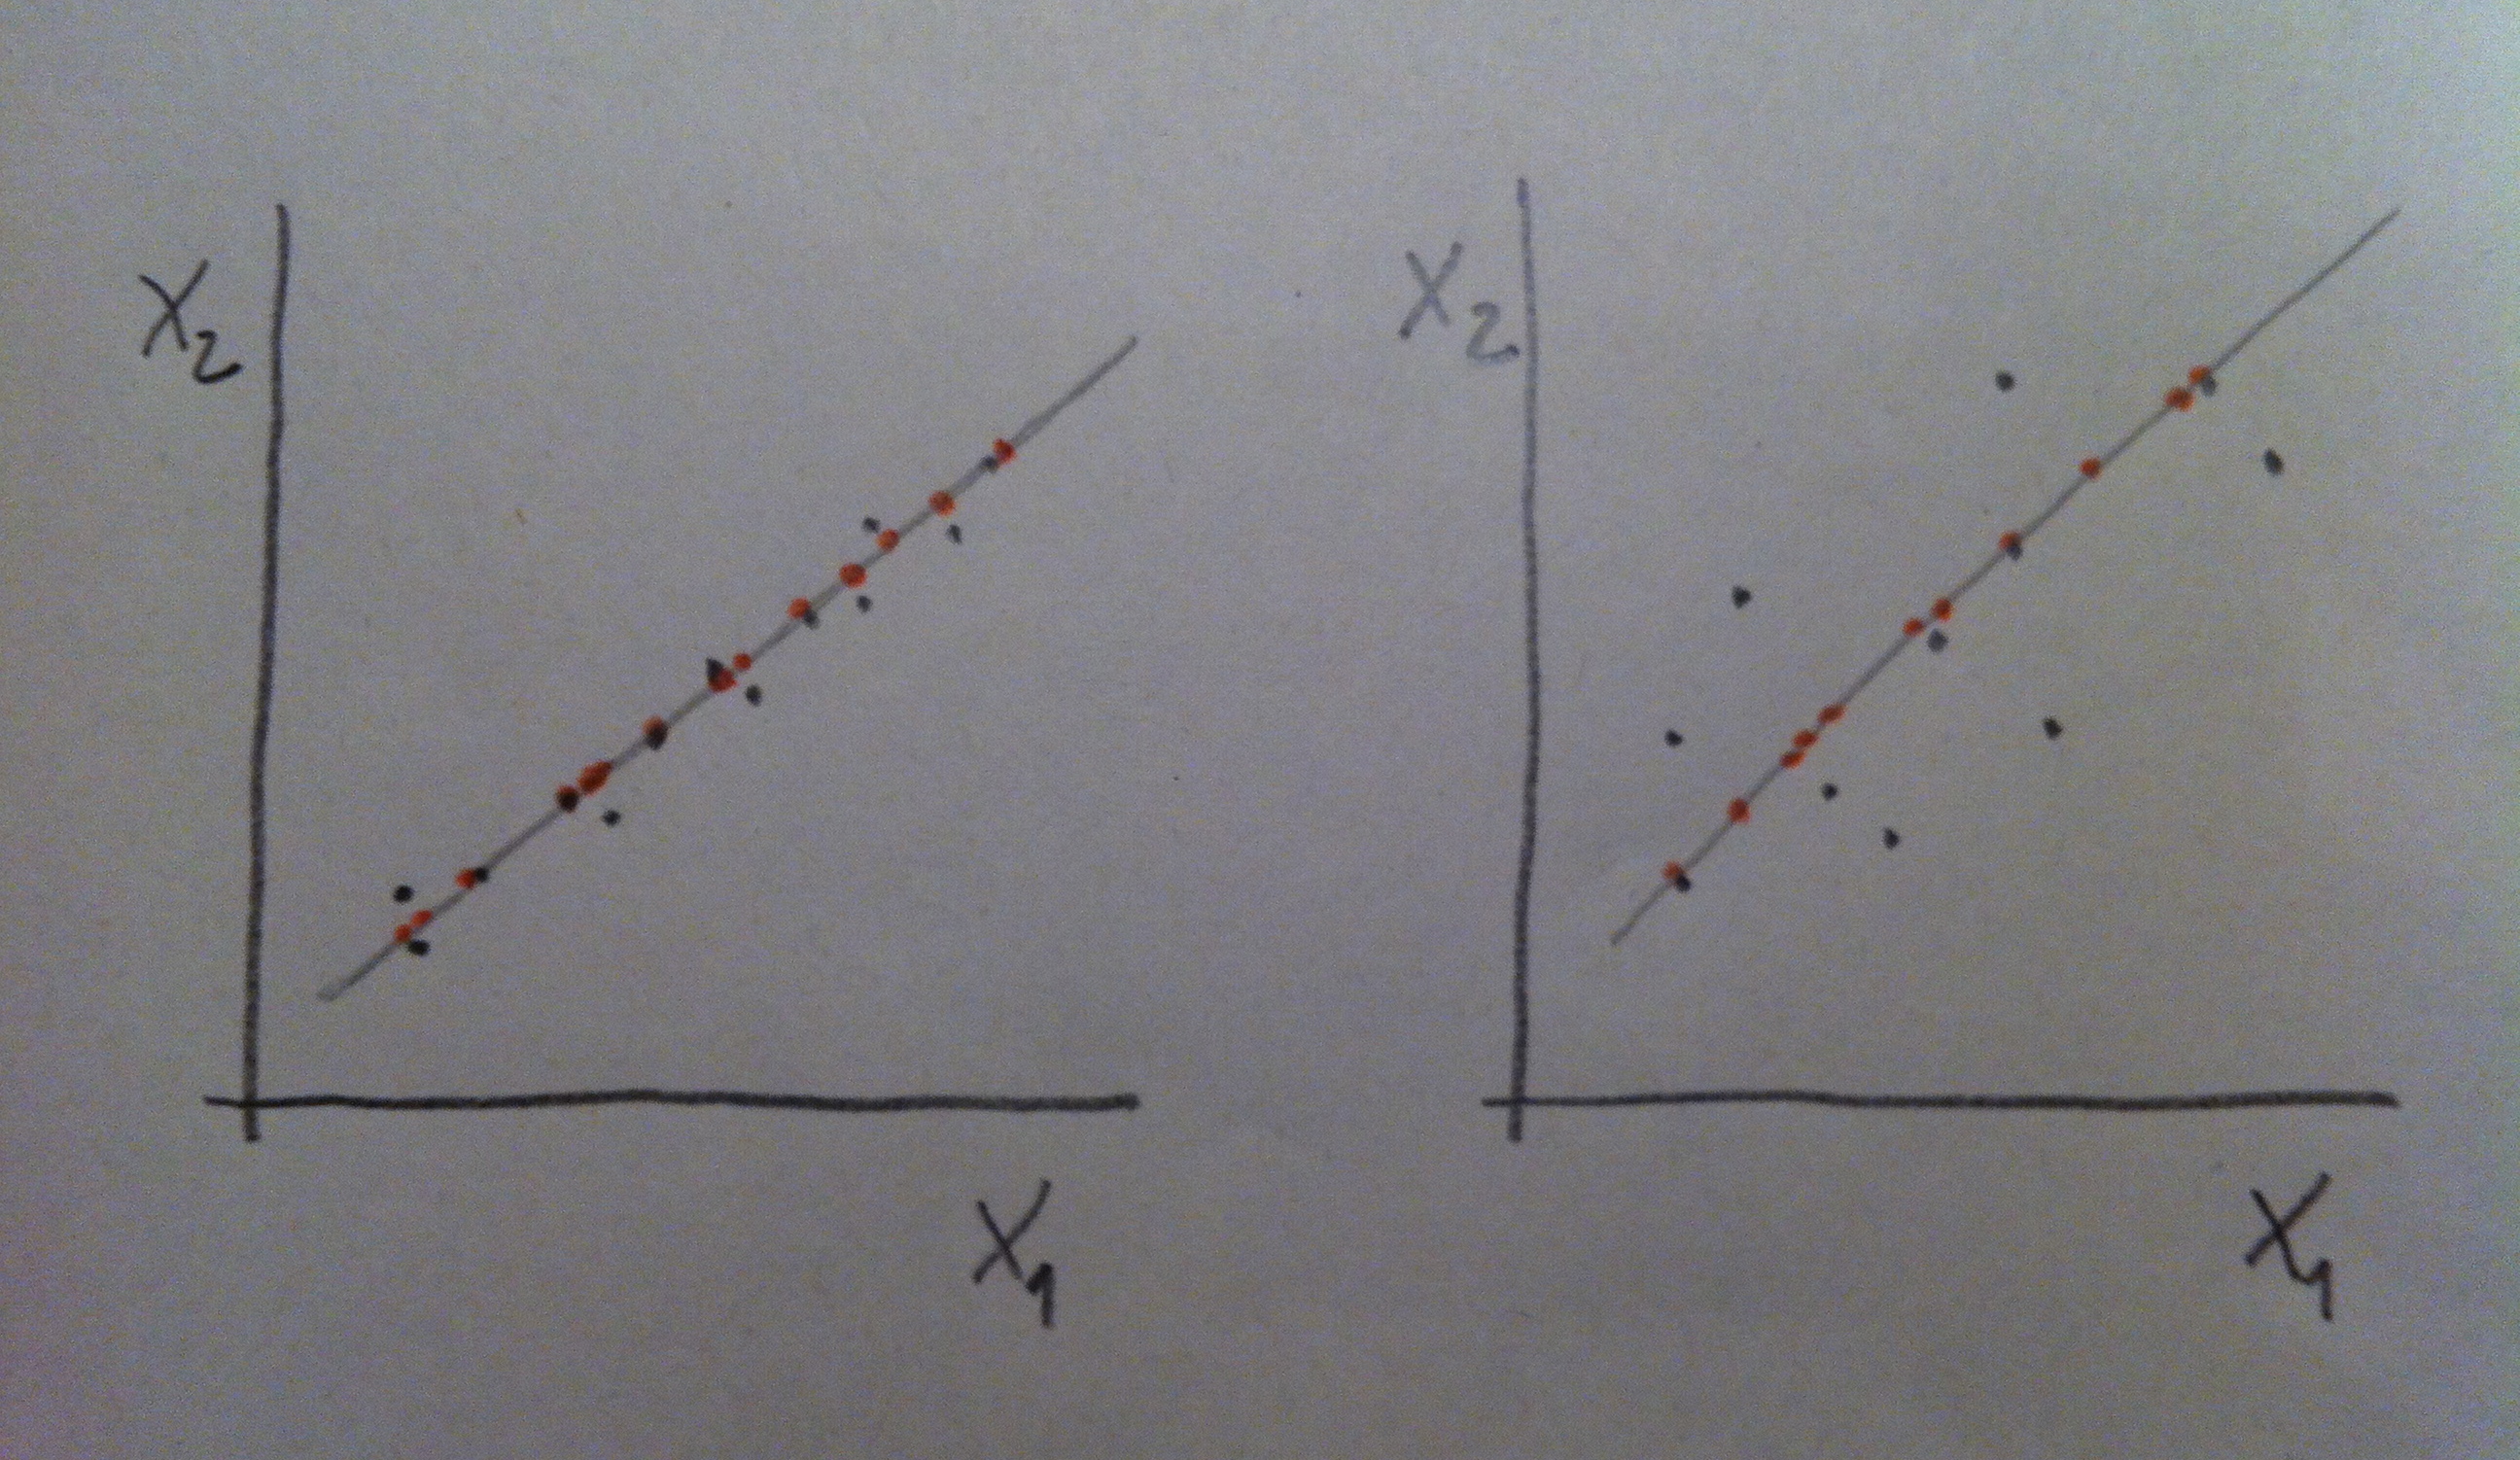
7. Y supongamos que unos seres unidimensionales, que únicamente ven las cosas si están en una dimensión, quieren representar, en una única dimensión, esta nube de puntos que ellos, evidentemente, no pueden ver. Observemos que si lo que quieren es no prescindir de ninguna de las dos variables lo que pueden hacer es representar las proyecciones de los puntos sobre un eje como el dibujado en la siguiente figura:

IMG_4597

8. Observemos que la nube de puntos roja, que está integrada por las proyecciones de los puntos originales sobre el nuevo eje, se parece bastante a la nube de puntos original. Las posiciones relativas de los puntos se respetan bastante. Y ahora los seres que sólo ven en una dimensión lo ven. Están viendo una representación unidimensional de una realidad bidimensional y lo hacen con bastante fidelidad. La nube de puntos roja se parece bastante a la negra. Ellos sólo ven la roja pero realmente es una buena aproximación de la original, que es la negra.

9. La representación en menos dimensiones no siempre tiene la misma calidad. En el gráfico siguiente vemos que a la izquierda la nube de puntos proyectada sobre el nuevo eje (la nube de puntos roja) se parece más a la original de lo que se parecen la roja y la negra en la situación mostrada en el gráfico de la derecha. Por lo tanto, en los datos de la derecha tiene menos valor realizar un ACP:

IMG_4605

10. Y observemos que cuando he dibujado el eje para proyectar los valores sobre él lo he hecho situándolo de una forma, pero lo hubiera podido situar de otra. Observemos en el gráfico siguiente que el eje dispuesto en el ejemplo de la derecha no consigue, mediante la proyección de los puntos sobre ella, una nube de puntos representativa de la nube de puntos original:

IMG_4598

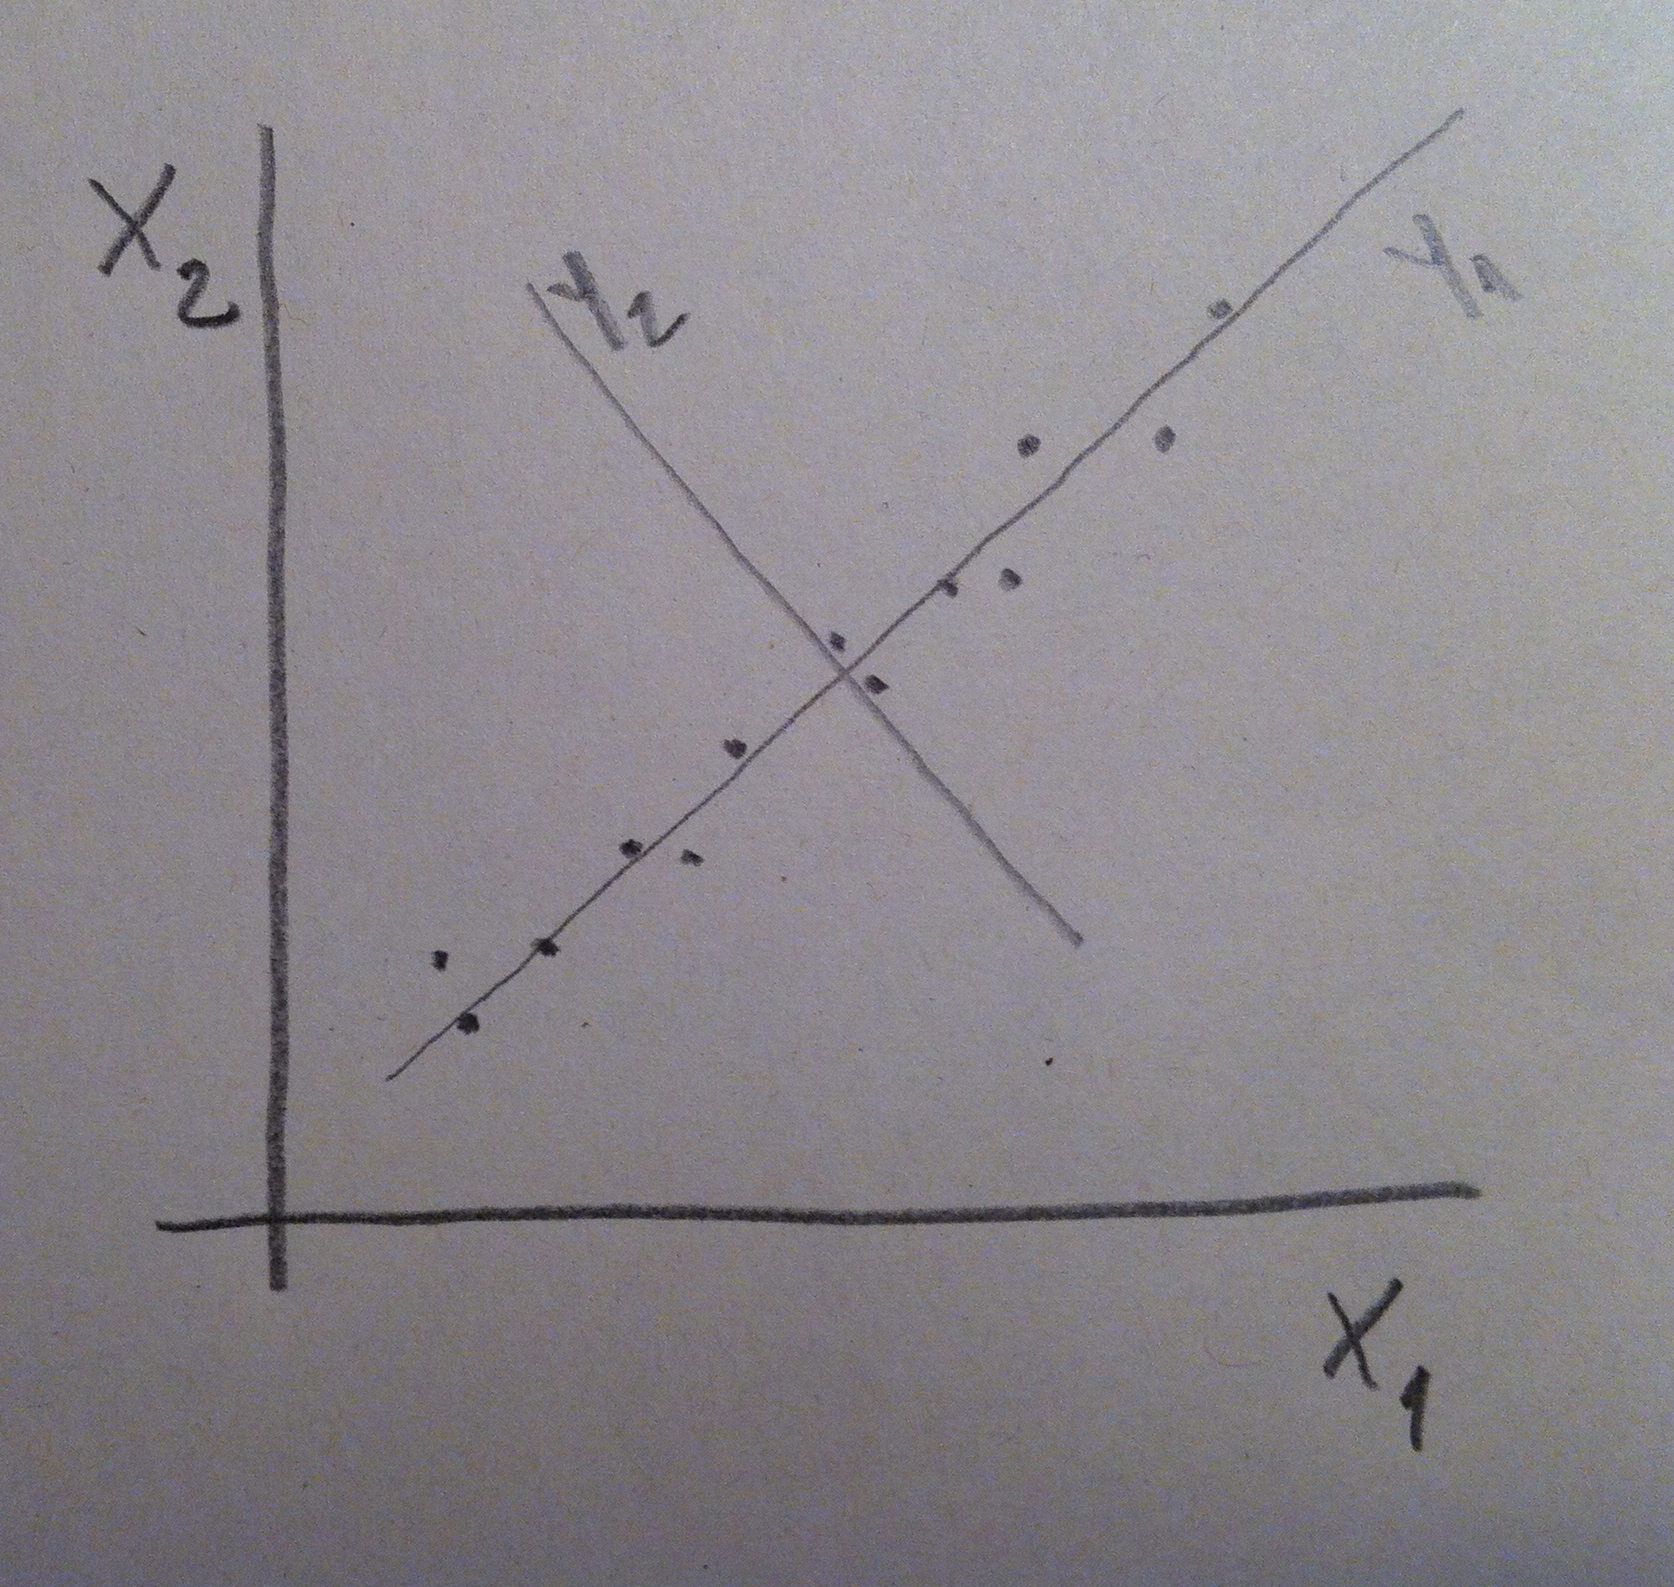
11. Lo que hemos hecho es, en definitiva, un giro de los ejes de coordenadas sin tocar los puntos. Observemos lo que hemos hecho:
IMG_4599

12. Lo importante es que ahora vemos la nube de puntos desde unos ejes donde uno es mucho más importante que el otro. Ahora los ejes son Y1 y Y2. Si X1 y X2  eran dos variables que tenían la misma cantidad de información, ahora Y1 y Y2 no tienen la misma cantidad de información. Y1 tiene mucha más información que Y2. En Estadística información es equivalente a dispersión, a varianza. Una variable que no varía no tiene información. Una variable que varía mucho tener el valor de un individuo es muy informativo.

13. El objetivo de la técnica ACP es, pues, éste: conseguir girar los ejes de tal forma que exista la mayor desigualdad posible entre la varianza de la nube de puntos original en las proyecciones en cada uno de los respectivos nuevos ejes y que, además, estos ejes, estas nuevas variables, sean independientes entre sí; o sea, que tengan correlación cero.

14. La búsqueda de estos nuevos ejes se hace mediante el cálculo de los llamados valores propios y vectores propios de la matriz de correlaciones entre todas las variables del estudio. Puede hacerse también a partir de otra matriz, la de varianzas-covarianzas, pero ésta tiene el problema de que cuando las variables tienen unidades de escala muy diferentes introduce un exceso de influencia por parte de las variables con mayor varianza. Por esto suele trabajarse con la matriz de correlaciones. De esta forma se unifica el peso de las variables iniciales del estudio. Suele hablarse de variables estandarizadas cuando se trabaja con la matriz de correlaciones. Una variable es estandarizada cuando la muestra se transforma a media cero y Desviación estándar uno. Esto se hace restando a cada valor muestral la media muestral y dividiendo por la Desviación estándar. De esta forma todas las variables del estudio tienen la misma media y la misma Desviación estándar y ninguna pesa más que otra. De esta forma la vocalización del estudio se pone en cómo es la forma de la nube de puntos, de cuáles son las relaciones entre las variables que permiten reducir dimensiones perdiendo el mínimo de información.

15. Algo muy importante: ¿Cuál es la relación existente entre las variables originales y las nuevas variables, los nuevos ejes; o sea, cuál es la relación, en el caso que hemos dibujado entre las variables X1 y X2  y las variables Y1 y Y2?

16. En primer lugar decir que a las variables Y1 y Y2, que son, eso, variables, también, como las originales, las llamamos en esta técnica “Componentes”. Y son cada una de ellas una combinación de las variables originales. Observemos la fórmula de esa combinación:

IMG_4600

17. En realidad estos coeficientes que multiplican a las variables originales son los vectores propios de la matriz de correlaciones, es la fórmula de la transformación lineal realizada. Hemos cambiado de ejes y para llegar de los ejes originales a los nuevos ejes hace falta esta transformación. En definitiva, si tenemos un punto representado por las coordenadas originales, éstas son las fórmulas necesarias para conseguir las coordenadas de la nueva representación: la representación mediante los ejes constituidos por las componentes.

18. Si en el lugar de estar trabajando con dos variables originales estuviéramos trabajando con d variables originales la fórmula de las d componentes sería:

IMG_4601

19. Se llama a la técnica Análisis de componentes principales porque transforma a las variables originales en nuevas variables, las componentes, las cuales tiene desigualdad en cuanto a la información explicada, lo que significa que tenemos unas componentes muy informativas y otras que no. Por eso tenemos unas componentes principales, que son las que usaremos para hacer la representación. Esta desigualdad generada al crear las componentes nos permite elegir, entre ellas, las principales y eliminar las poco importantes, cosa que no sucedía con las originales porque ellas eran todas principales, todas eran importantes, no podíamos prescindir de ninguna de ellas.

20. A los datos de los 15 estudiantes que se les ha evaluado en las ocho materias citadas en la matriz de datos mostrada al principio de este tema si se les hace un ACP tenemos la siguiente representación usando las dos primeras componentes principales: PCOMP_1 y PCOMP_2:

IMG_4620

21. Observemos ahora que esta representación se asemeja mucho a la original en ocho dimensiones. Si observamos en el gráfico de dos dimensiones el alumno 1 y el 9 están muy próximos, prácticamente solapados. Miremos qué sucede en la matriz de datos. Observaremos que las notas, excepto Educación física, son prácticamente las mismas. Lo de Educación física tiene una explicación que ahora veremos.
22. Si, por el contrario, elegimos los individuos 5 y 12 vemos que en nuestro gráfico de dos dimensiones están completamente en los extremos, están en dos vértices de la representación. Si ahora miramos la matriz de datos veremos que el alumno 5 lo aprueba todo con buenas notas excepto la Educación física. En cambio el alumno 12 lo suspende todo, incluso la Educación física. Sorprendentemente en este caso son en todo distintos excepto en la Educación física que tienen justo la misma nota.

23. Por lo tanto, con el gráfico de dos dimensiones estamos viendo una muy buena fotografía de las posiciones relativas de los puntos en la representación de ocho dimensiones original que no vemos. Digo fotografía porque la metáfora es apropiada. Pensemos que cuando estamos viendo una fotografía en realidad estamos viendo una representación bidimensional de una realidad tridimensional. En el ACP estamos haciendo algo similar. Miramos de hacer una fotografía bidimensional o tridimensional, para que la podamos visualizar, de una realidad constituida por muchas dimensiones y que no visualizamos. Por lo tanto, en nuestro caso estamos viendo una fotografía bidimensional de una realidad ochodimensional.

24. Pero, algo muy importante: ¿Qué cantidad de información perdemos? Y, ¿qué representan los nuevos ejes?

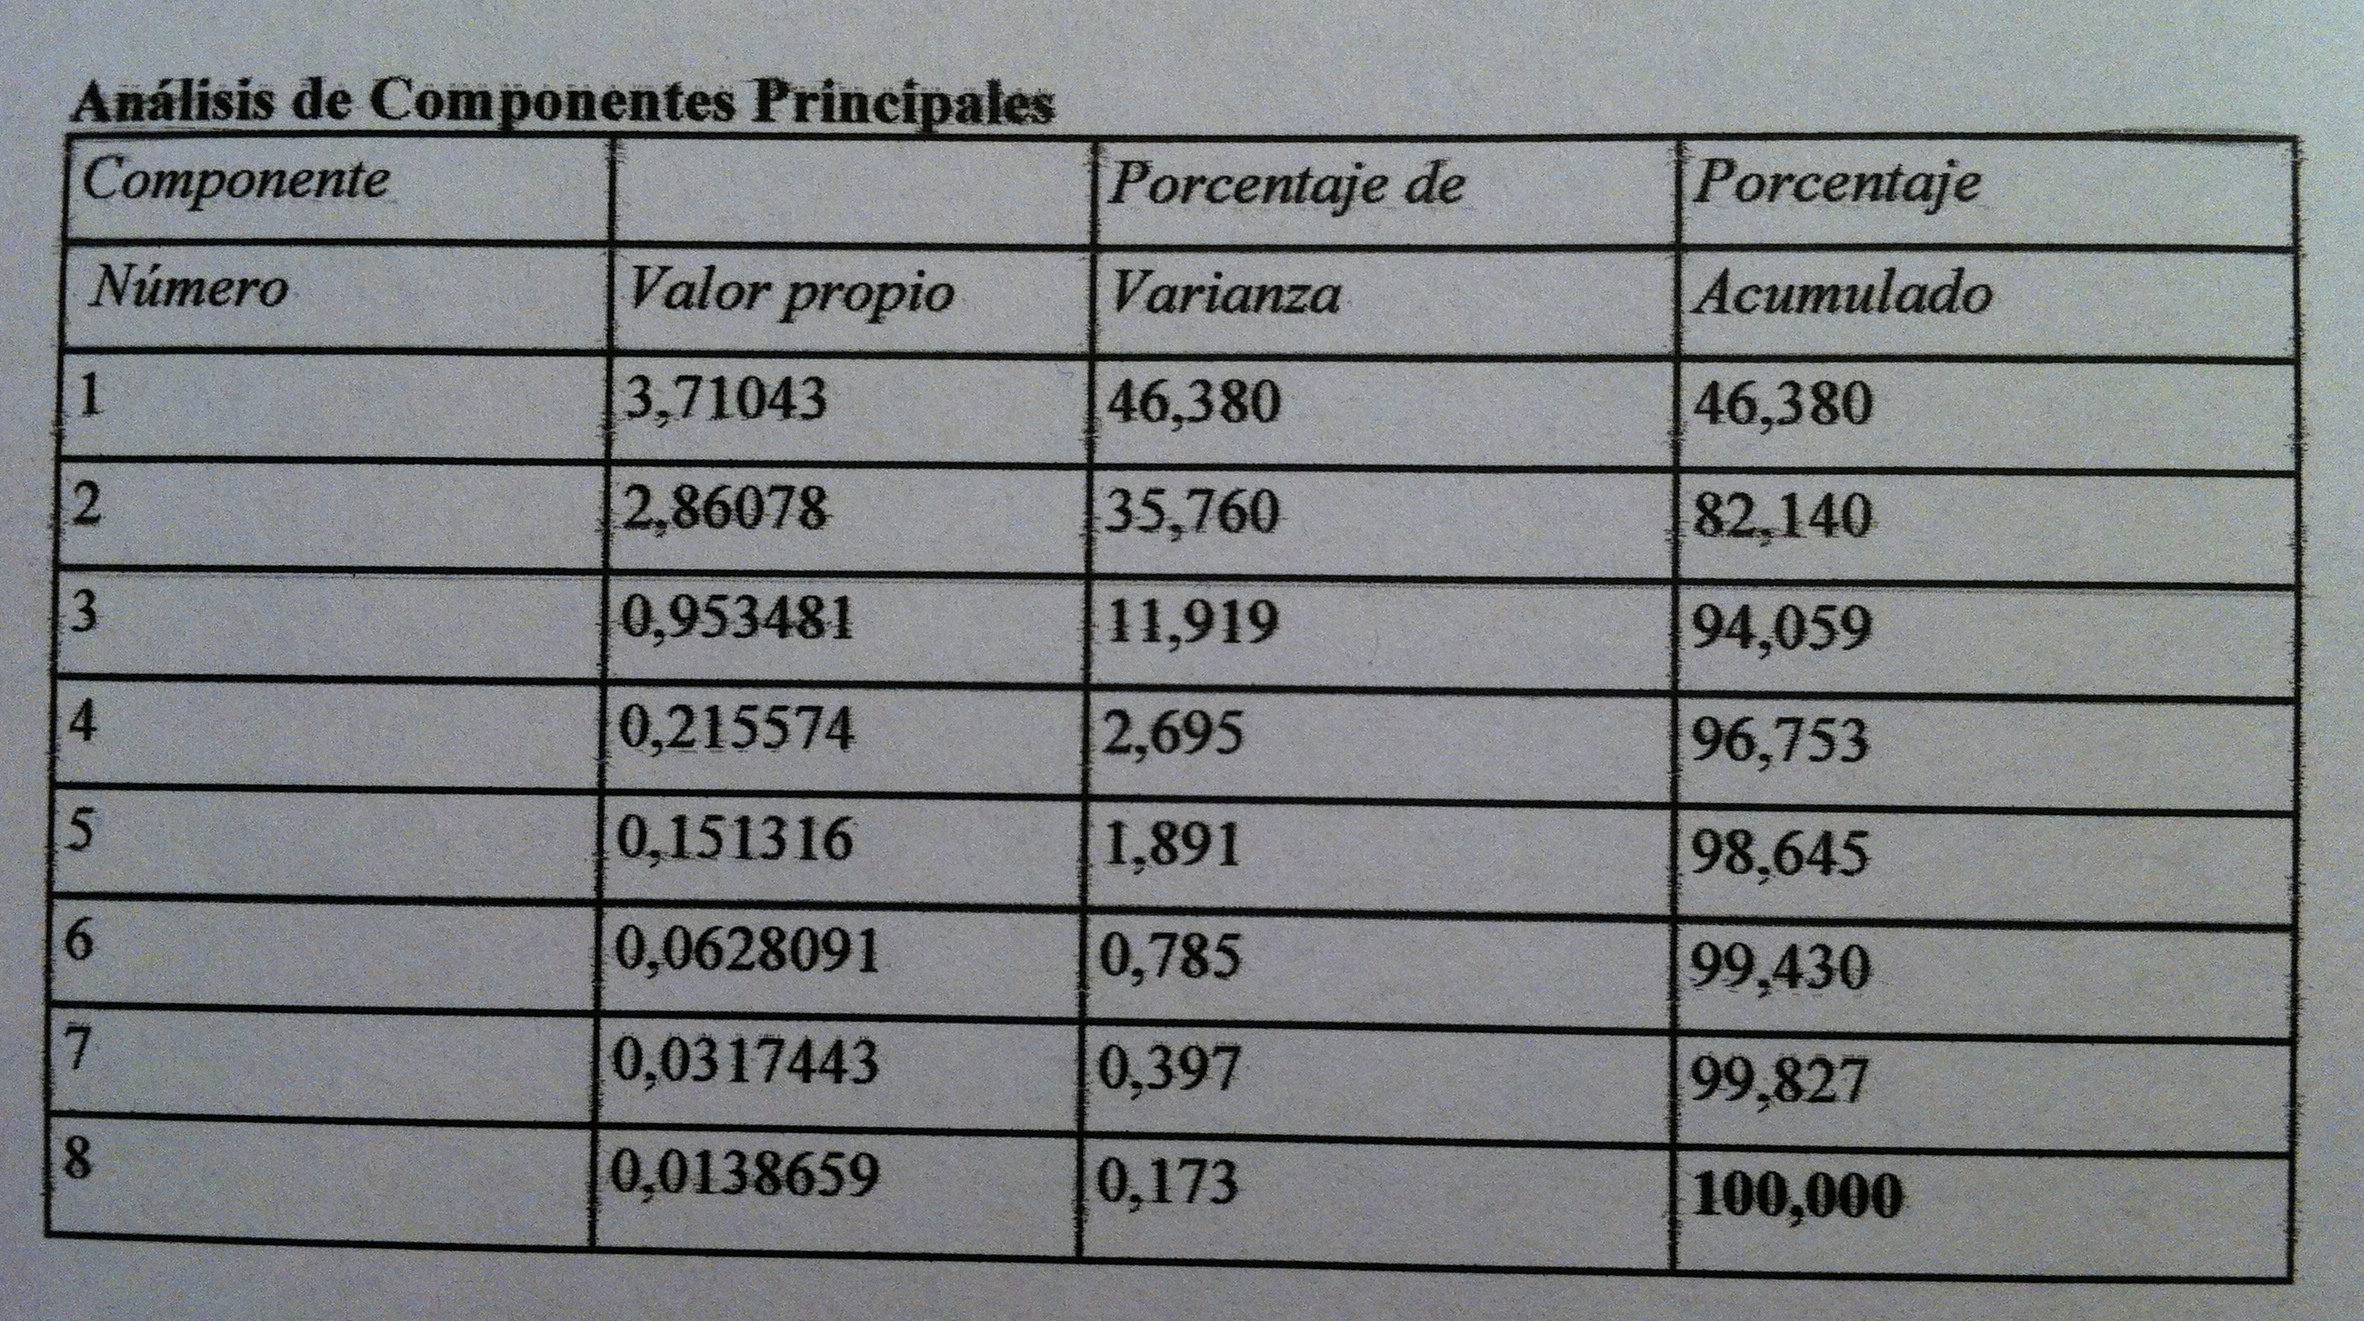
25. Respecto a la cantidad de información observemos la siguiente tabla:

IMG_4618

26. Los valores propios de cada componentes nos indican la cantidad de varianza, la cantidad de información que tiene cada componente. Como podemos ver en esta tabla la primera componente tiene un 46.38% de información y la segunda un 35.76%. Las dos juntas tienen un 82.14. Por lo tanto, haciendo una representación en dos dimensiones con esas dos primeras componentes perdemos un 17.86% de información únicamente.

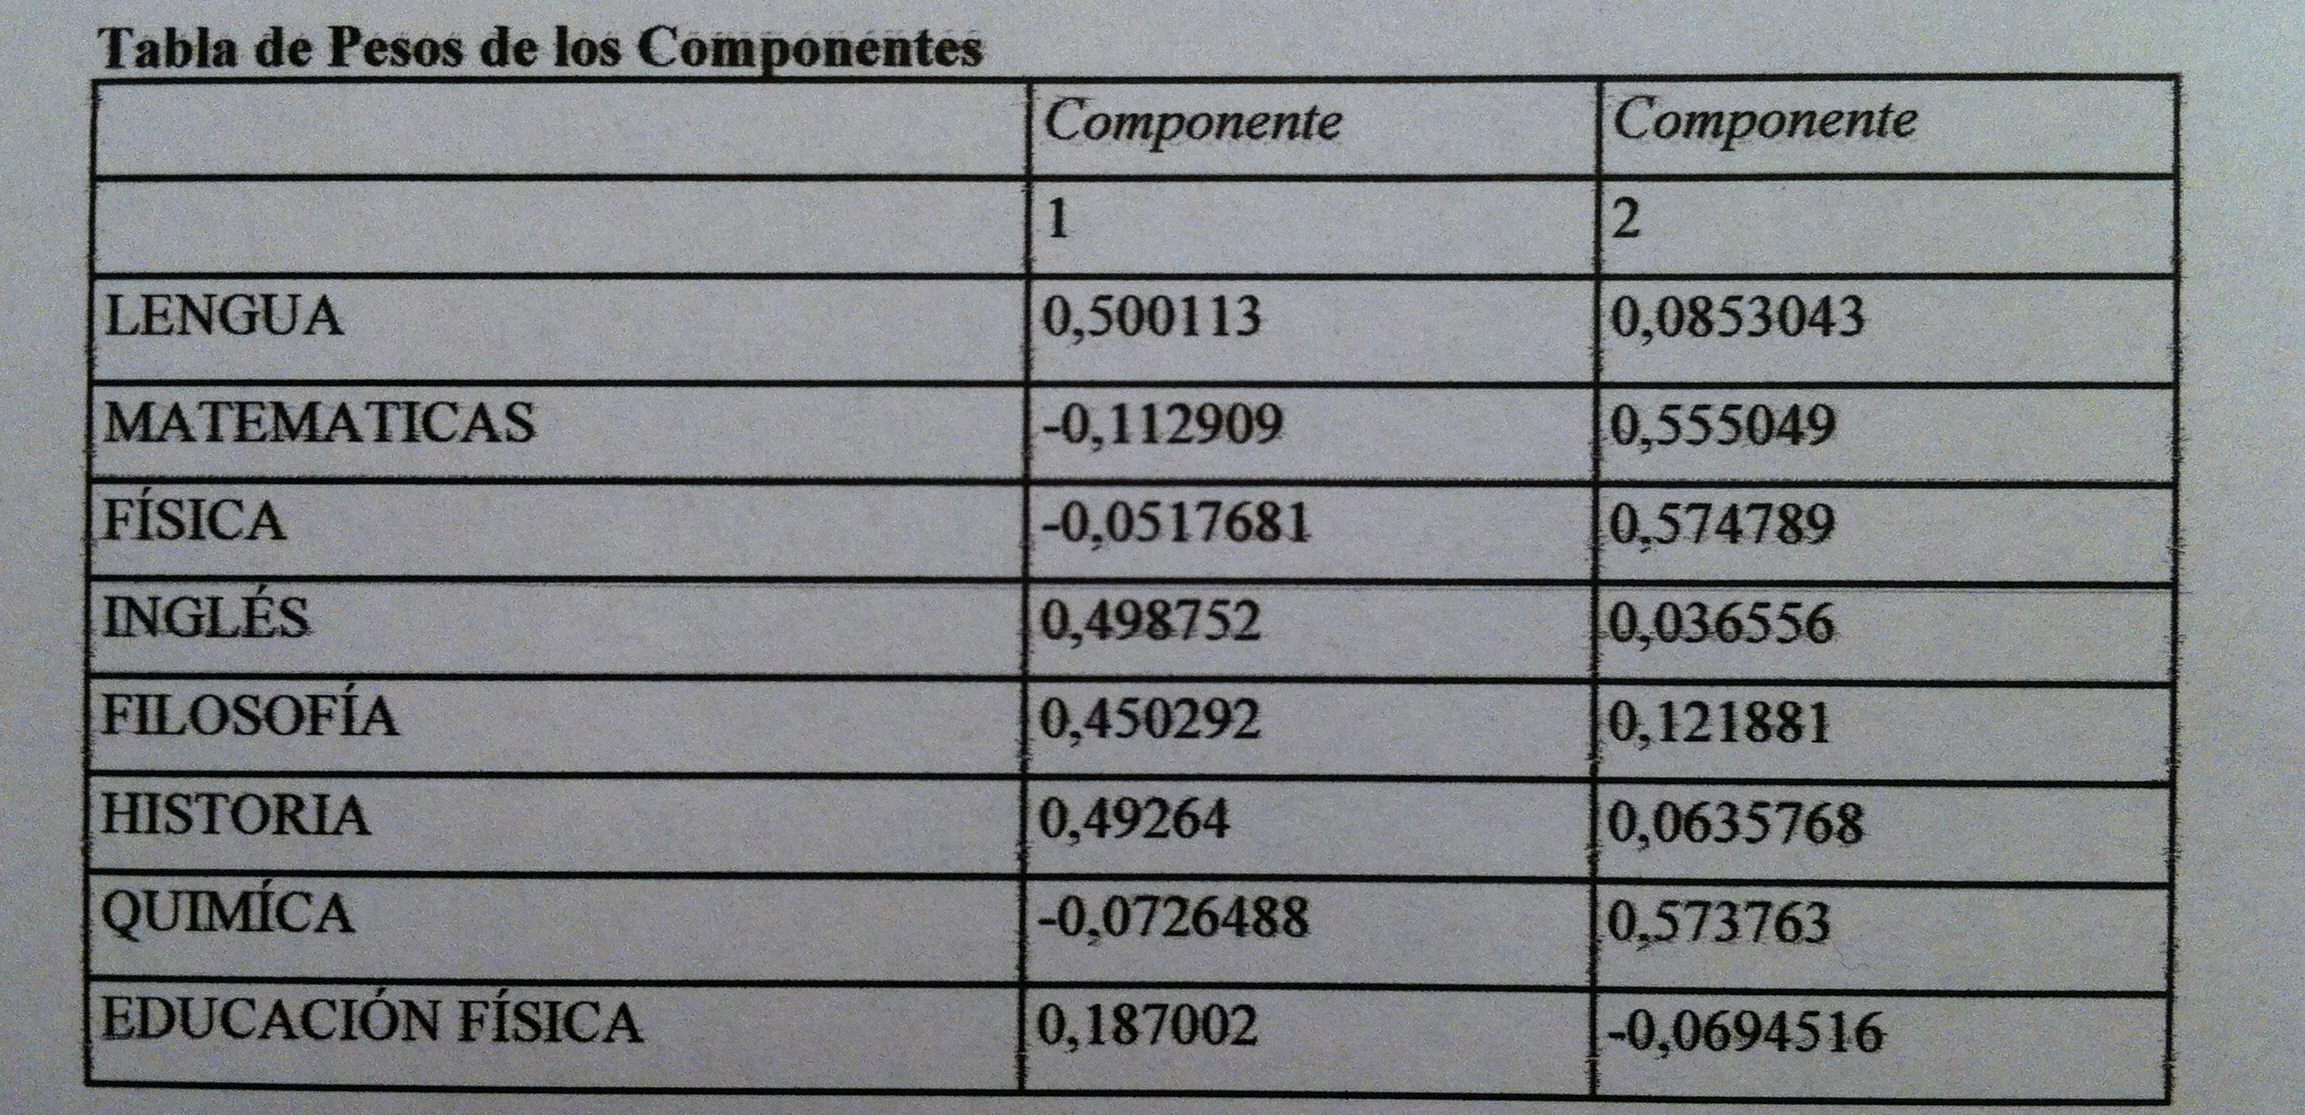
27. Respecto a lo que representan los nuevos ejes observemos la fórmula de las dos primeras componentes principales:

IMG_4619

28. Esto indica que la primera componente principal tiene los coeficientes de la primera columna y la segunda componente tiene los coeficientes de la segunda. O sea, que para conocer las coordenadas que tendrá cada alumno de esas dos componentes hay que multiplicar sus ocho notas por sus coeficientes respectivos. Y así es como obtenemos la representación gráfica bidimensional mostrada antes.

29. Para interpretar una componente hay que seguir el siguiente procedimiento: 1) Mirar el valor absoluto de los coeficientes distinguiendo los que tienen un valor grande y un valor pequeño. En nuestro caso en la primera componente observemos que Lengua, Inglés, Filosofía e Historia tienen coeficientes con valor absoluto grande, cercano en todos los casos a 0.5. Los demás ya son bastante más pequeños, pesan mucho menos en esta componente. En la segunda componente el peso principal se lo llevan Matemáticas, Física y Química, con coeficientes cercanos a 0.57. Las demás asignaturas pesan poco. 2) Mirar entre los coeficientes con valor absoluto grande el juego de signos que hay. En nuestro caso el signo es el mismo, por lo tanto, las variables que pesan en una componente y en la otra todas van en la misma dirección. Pero en otro caso nos podríamos encontrar con valores de signo contrario. Entonces hay que interpretar el juego de fuerzas de los signos.

30. En el ejemplo que venimos usando la interpretación es muy clara. En la primera componente tenemos reunidas las materias de letras. En la segunda componente tenemos reunidas, por el contrario, las materias de ciencias. La educación física no pesa ni en una ni en otra. Porque no tiene ninguna relación ni con las materias de letras ni con las de ciencias.

31. Viendo el gráfico bidimensional donde en el eje de las abscisas tenemos la primera componente y en el eje de las ordenadas tenemos la segunda componente podemos ver que los alumnos buenos en ciencias y letras estarán situados a la derecha y arriba, los alumnos buenos en letras y malos en ciencias se situarán a la derecha y abajo, los buenos en ciencias y malos en letras a la izquierda y arriba y, finalmente, los malos en ciencias y letras se situarán a la izquierda y abajo.

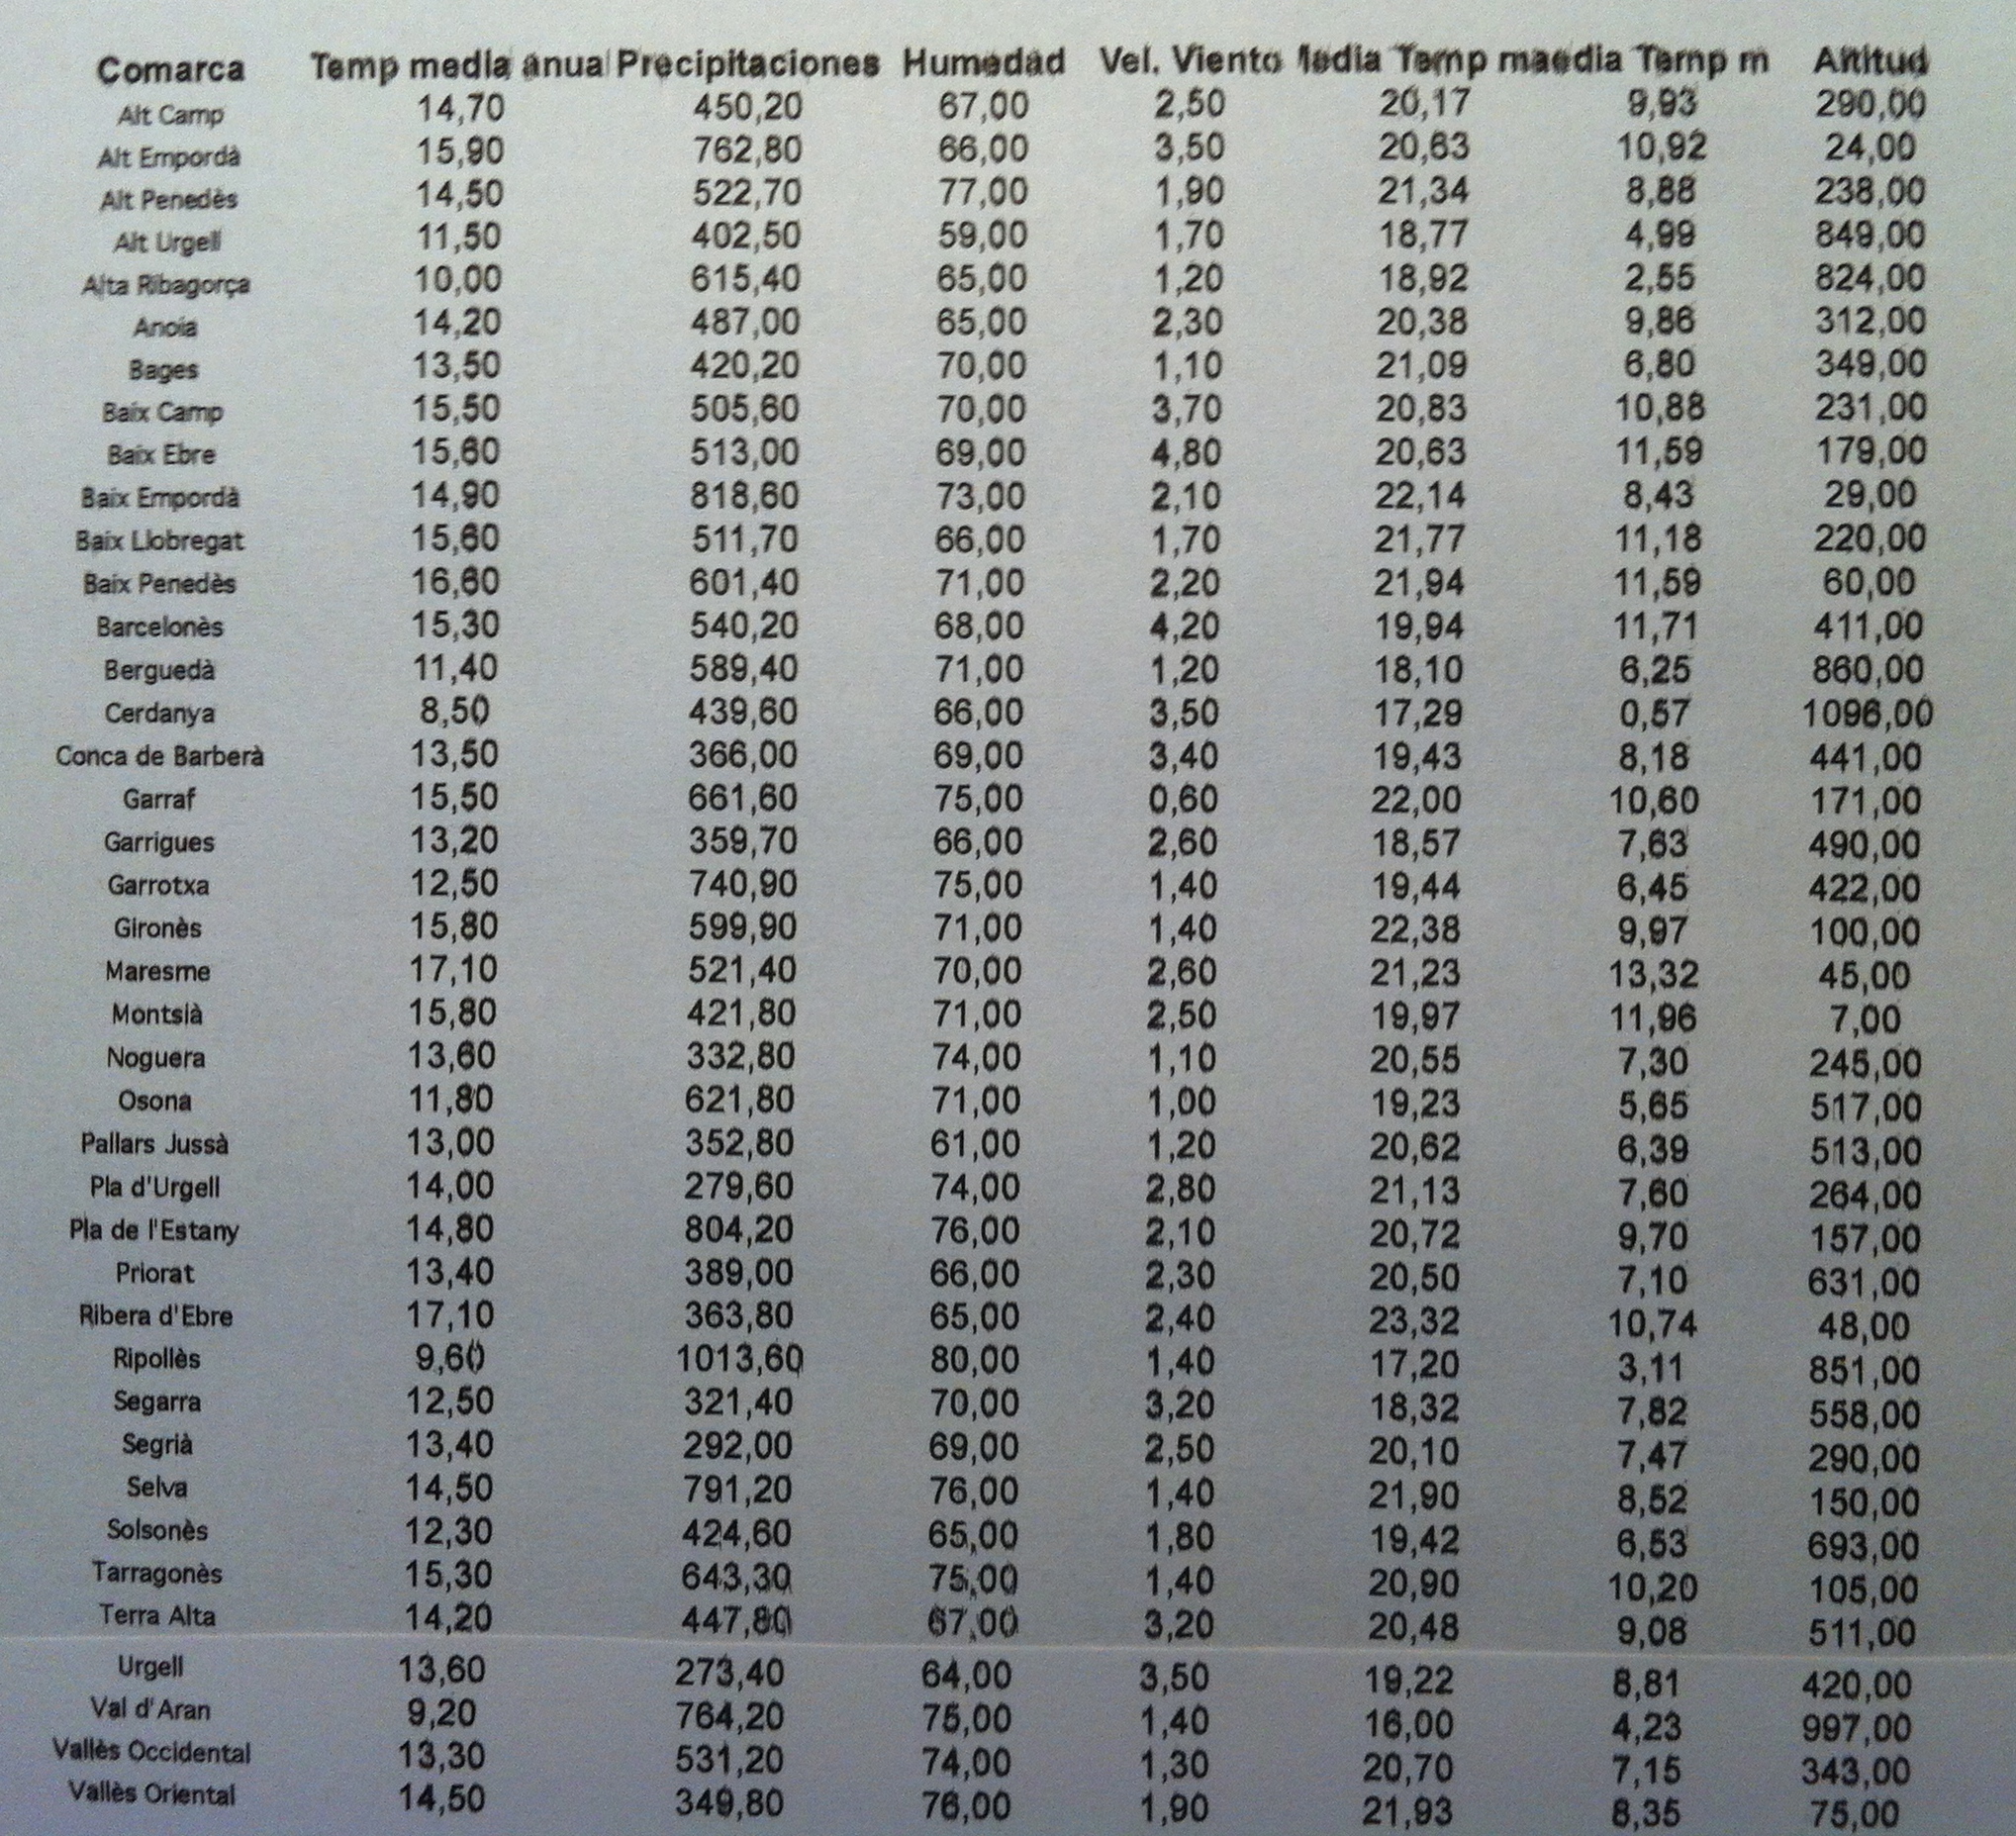
32. Veamos otro ejemplo de ACP. La matriz de datos son variables meteorológicas según comarcas catalanas el año 2005. Los datos son los siguientes:

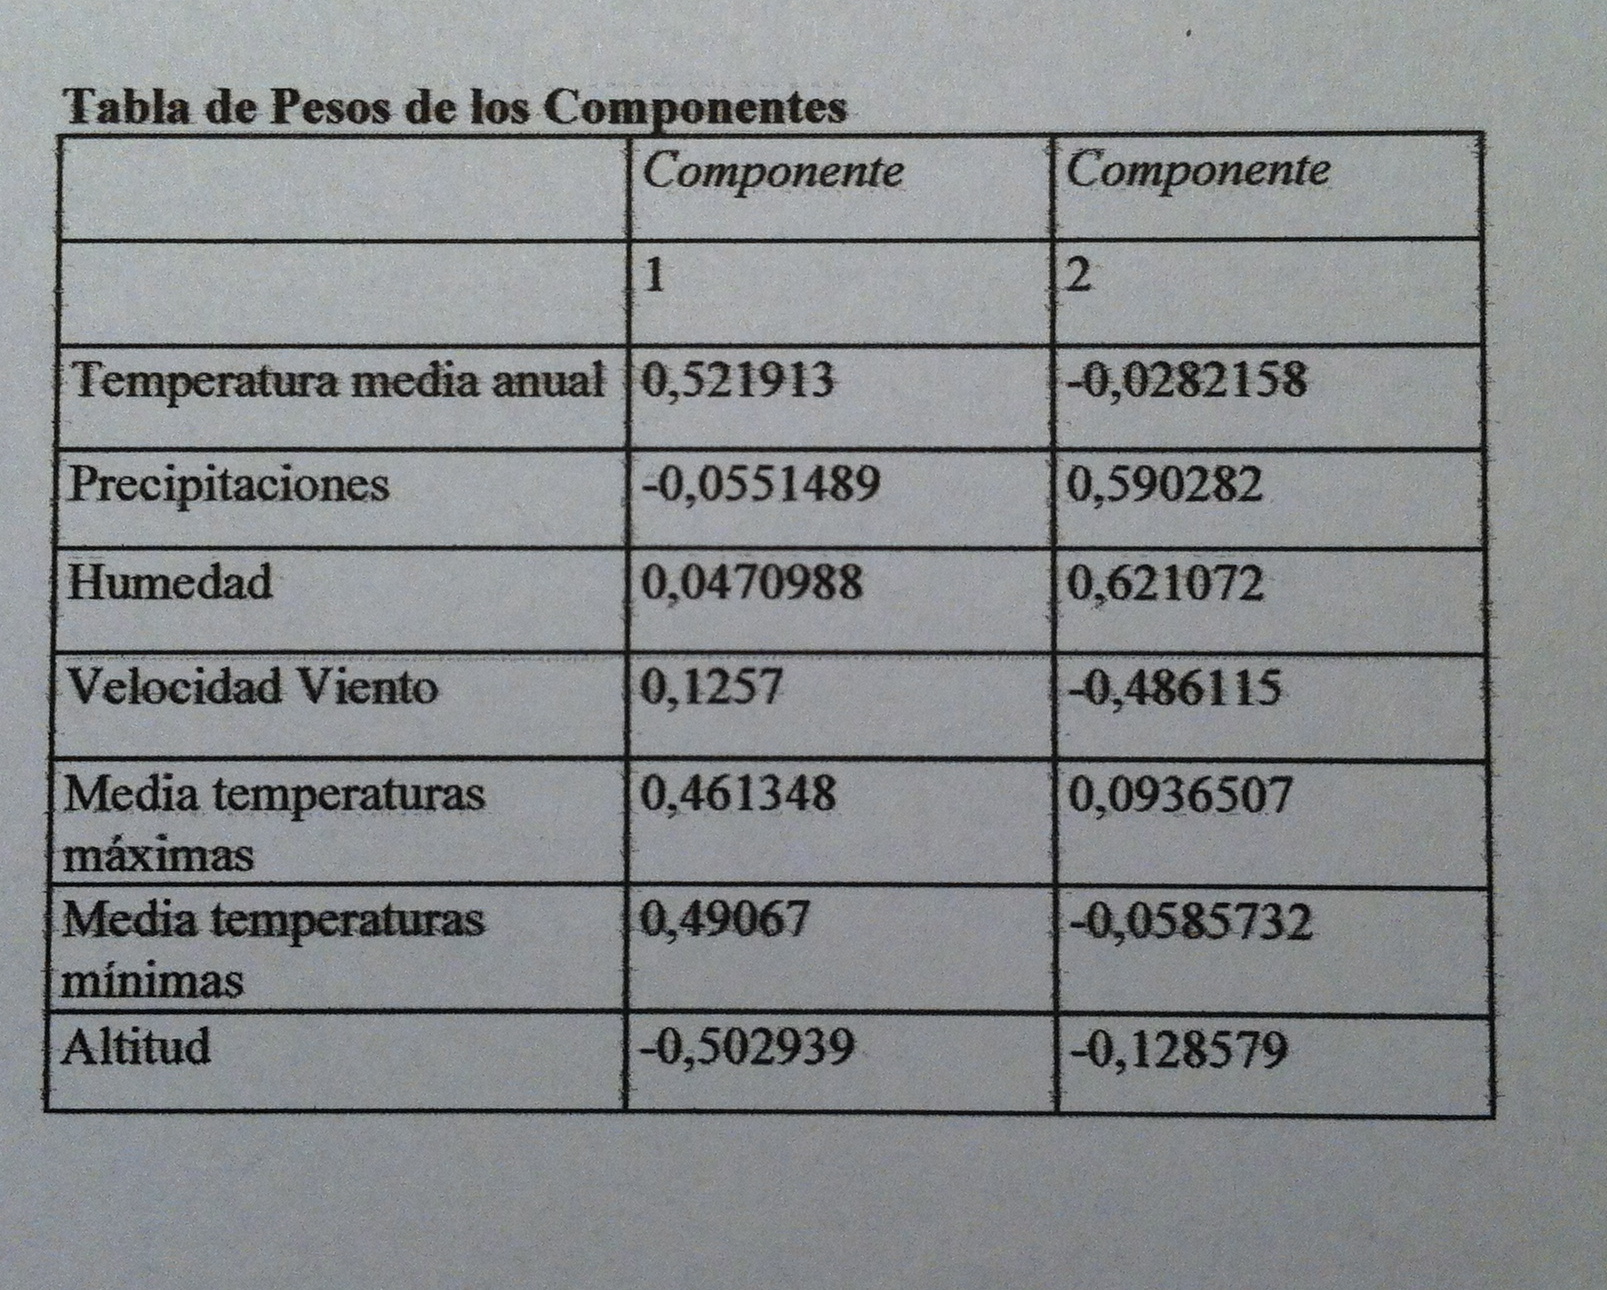
IMG_4623

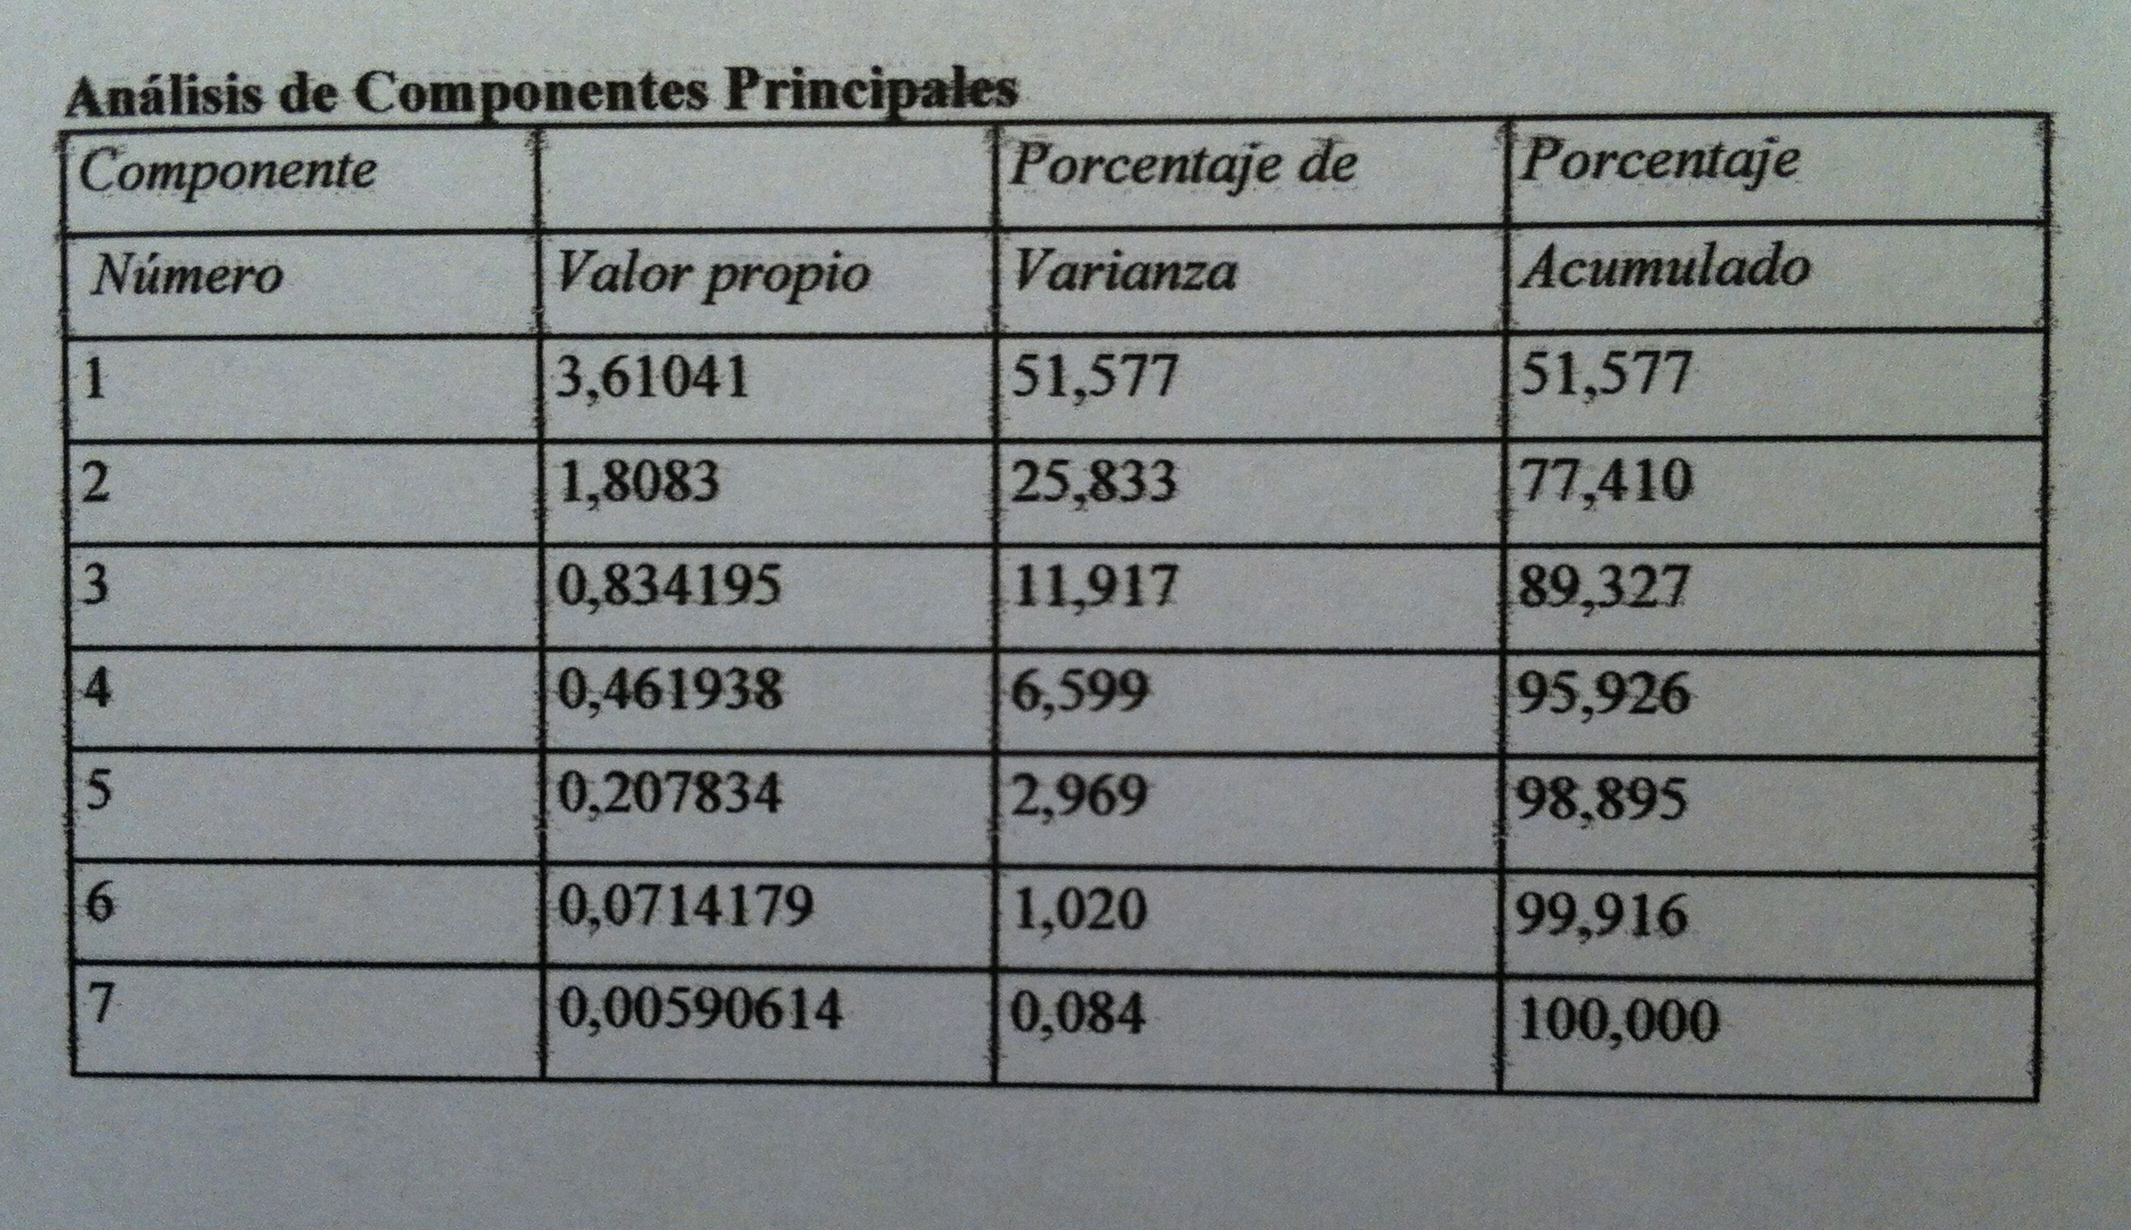
33. Al hacer un ACP, los valores propios de las componentes principales son los siguientes:

IMG_4624

34. Como puede verse con las dos primeras componentes explicamos el 77.41% de la varianza, de la información contenida en la nube de puntos original.

35. Y los vectores propios; o sea, los coeficientes de las dos primeras componentes, son los siguientes valores:

IMG_4625

36. En la primera componente pesan; o sea, tiene valor absoluto grande, las tres variables de temperatura y la altitud media de la comarca. Además lo hacen las temperaturas con signo positivo y la altitud con signo negativo. Lo que indica que valores grandes de la primera componente corresponden a comarcas con temperaturas altas y altitud baja. Altitud baja porque como el coeficiente es negativo para que la componente tenga un valor alto hace falta que la altitud reste poco, sea un valor pequeño. Contrariamente, valores pequeños de esta primera componente indica temperaturas bajas y altitud alta.

37. En la segunda componente pesan especialmente las variables Precipitaciones, Humedad y Velocidad del viento. Las dos primeras con signo positivo y la tercera con signo negativo. Valores grandes de esta componente indicarán zonas con mucha lluvia, mucha humedad y poco viento. Por el contrario, valores bajos de esta segunda componente corresponderán a comarcas de bajas precipitaciones, baja humedad y alta velocidad del viento.

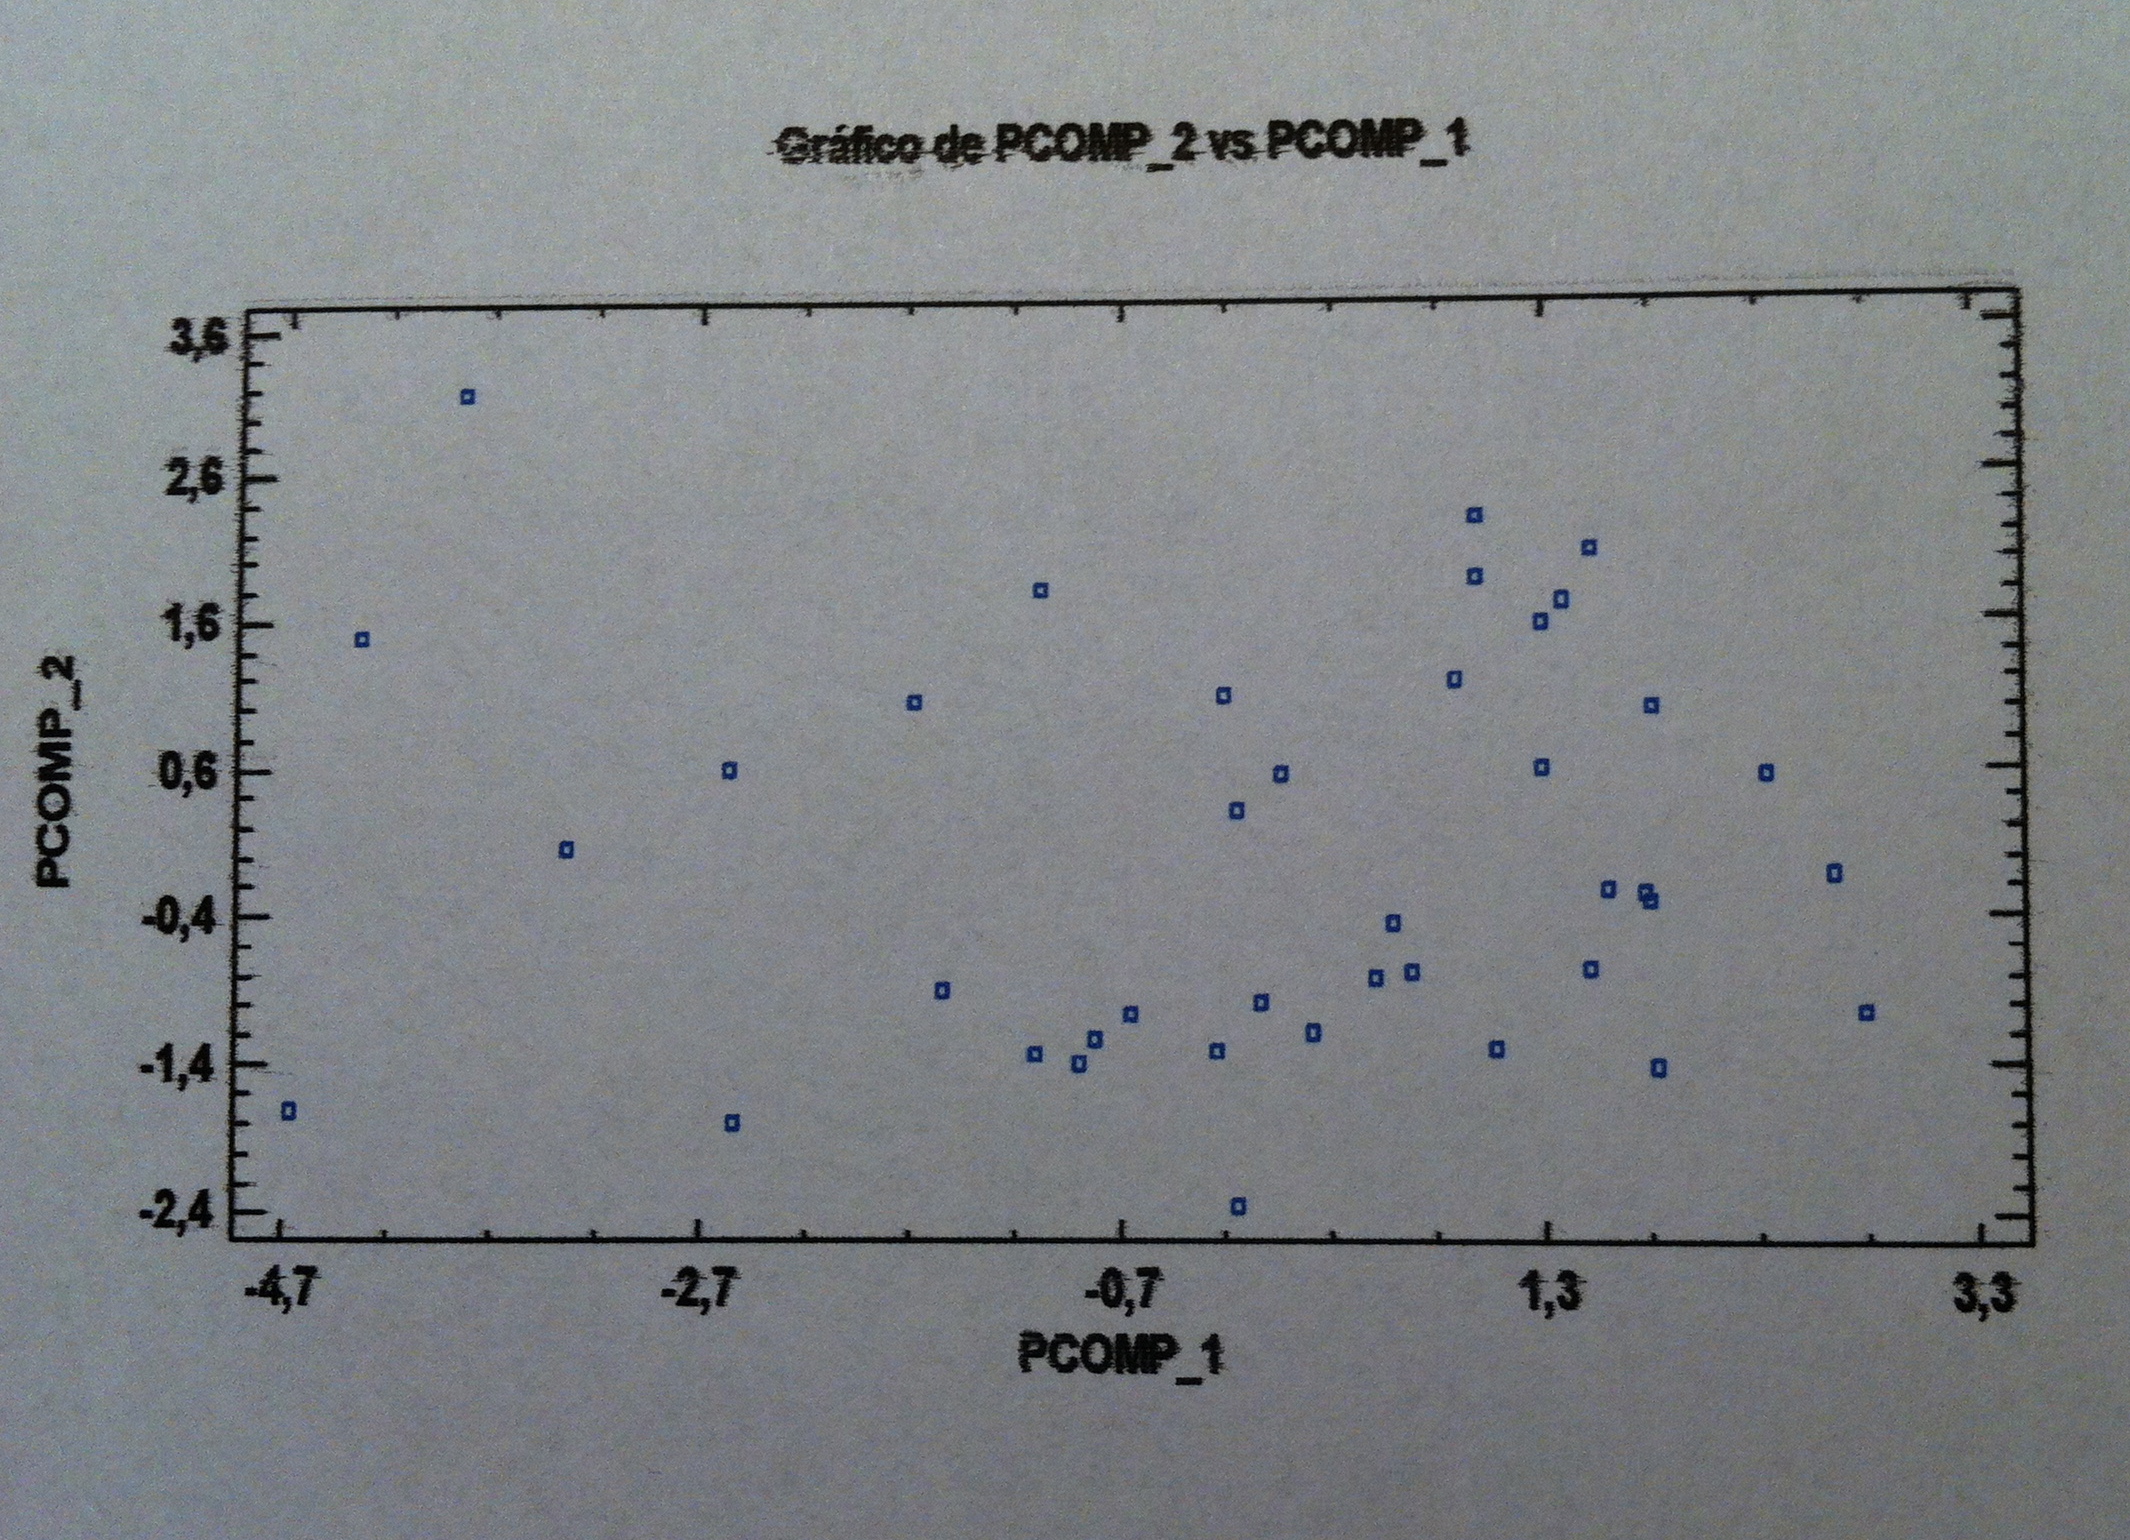
38. La representación de las comarcas según las dos primeras componentes es la siguiente:

IMG_4626

39. Viendo el gráfico y la anterior interpretación de las componentes podemos dividir el gráfico en cuatro cuadrantes y afirmar: 1) Arriba a la derecha: Comarcas calurosas y húmedas. 2) Abajo a la derecha: Comarcas calurosas y secas. 3) Arriba a la izquierda: Comarcas frías y húmedas. 4) Abajo a la izquierda: Comarcas frías y secas.

40. Observemos, pues, que conseguimos con esta técnica representar en pocas dimensiones una realidad multidimensional y, también, crear estas componentes, estas variables de variables, variables que son combinación de las variables originales. Y estas combinaciones son interesantes en sí mismas, porque nos ayudan a crear una especie de conglomerados de variables combinadas de una forma que, en realidad, reflejan la vida interna que tienen ellas entre sí en cuanto a la covariación conjunta.

41. En el primer ejemplo, el caso de las notas, las componentes nos han creado la noción de Letras y la noción de Ciencias, reflejando una idea que todos tenemos en mente: que las capacidades hacia un ámbito u otro son como dos dimensiones independientes que se pueden tener ambas, que se puede tener una y no otra o que se puede, también, no tener ninguna.

42. En el segundo ejemplo, las componentes nos separan dos elementos independientes: aspectos de frío o calor, ligados a la altitud de la zona, por un lado, y aspectos referentes a la humedad climática, por otro. Aspectos que pueden ir asociados entre sí de forma independiente creando cuatro tipos de comarcas o de zonas distintas según la combinación de los valores extremos de estas dos componentes.

43. Otro ejemplo de Análisis de componentes aplicado a datos de jugadores de baloncesto se puede consultar en el fichero Análisis de componentes principales aplicado a datos de jugadores de baloncesto.

44. Otro ejemplo interesante es el planteado en la Situación 66, donde aparecen unos datos de diferentes países y las proporciones que tienen que hay en ellos en cuanto a las distintas formaciones universitarias. El análisis de los datos los podéis ver en la Solución Situación 66.

45. Otro ejemplo, ahora con Pokémons, está planteado en la Situación 47. La solución se puede ver en el fichero Solución Situación 47.

46. Un ejemplo de fútbol lo tenemos en la Situación 46. La solución puede verse en el fichero Solución Situación 46.

47. Como puede verse, en este tema hemos hablado de una técnica esencialmente descriptiva. No hemos hablado, aquí, de otra cosa que de muestras. No hay voluntad inferencial en esta técnica. Es cierto que se ha estudiado y creado técnicas inferenciales relacionadas con el ACP pero no es muy utilizada en la práctica. Es por ello que debemos considerarla una técnica descriptiva, una técnica que intenta buscar la representación de una muestra de individuos de los que tenemos muchas variables de interés. Una técnica donde la muestra es la finalidad.

48. Podéis practicar los conceptos de este tema con ejercicios comentados en el siguiente:

ANOVA de dos factores a efectos aleatorios

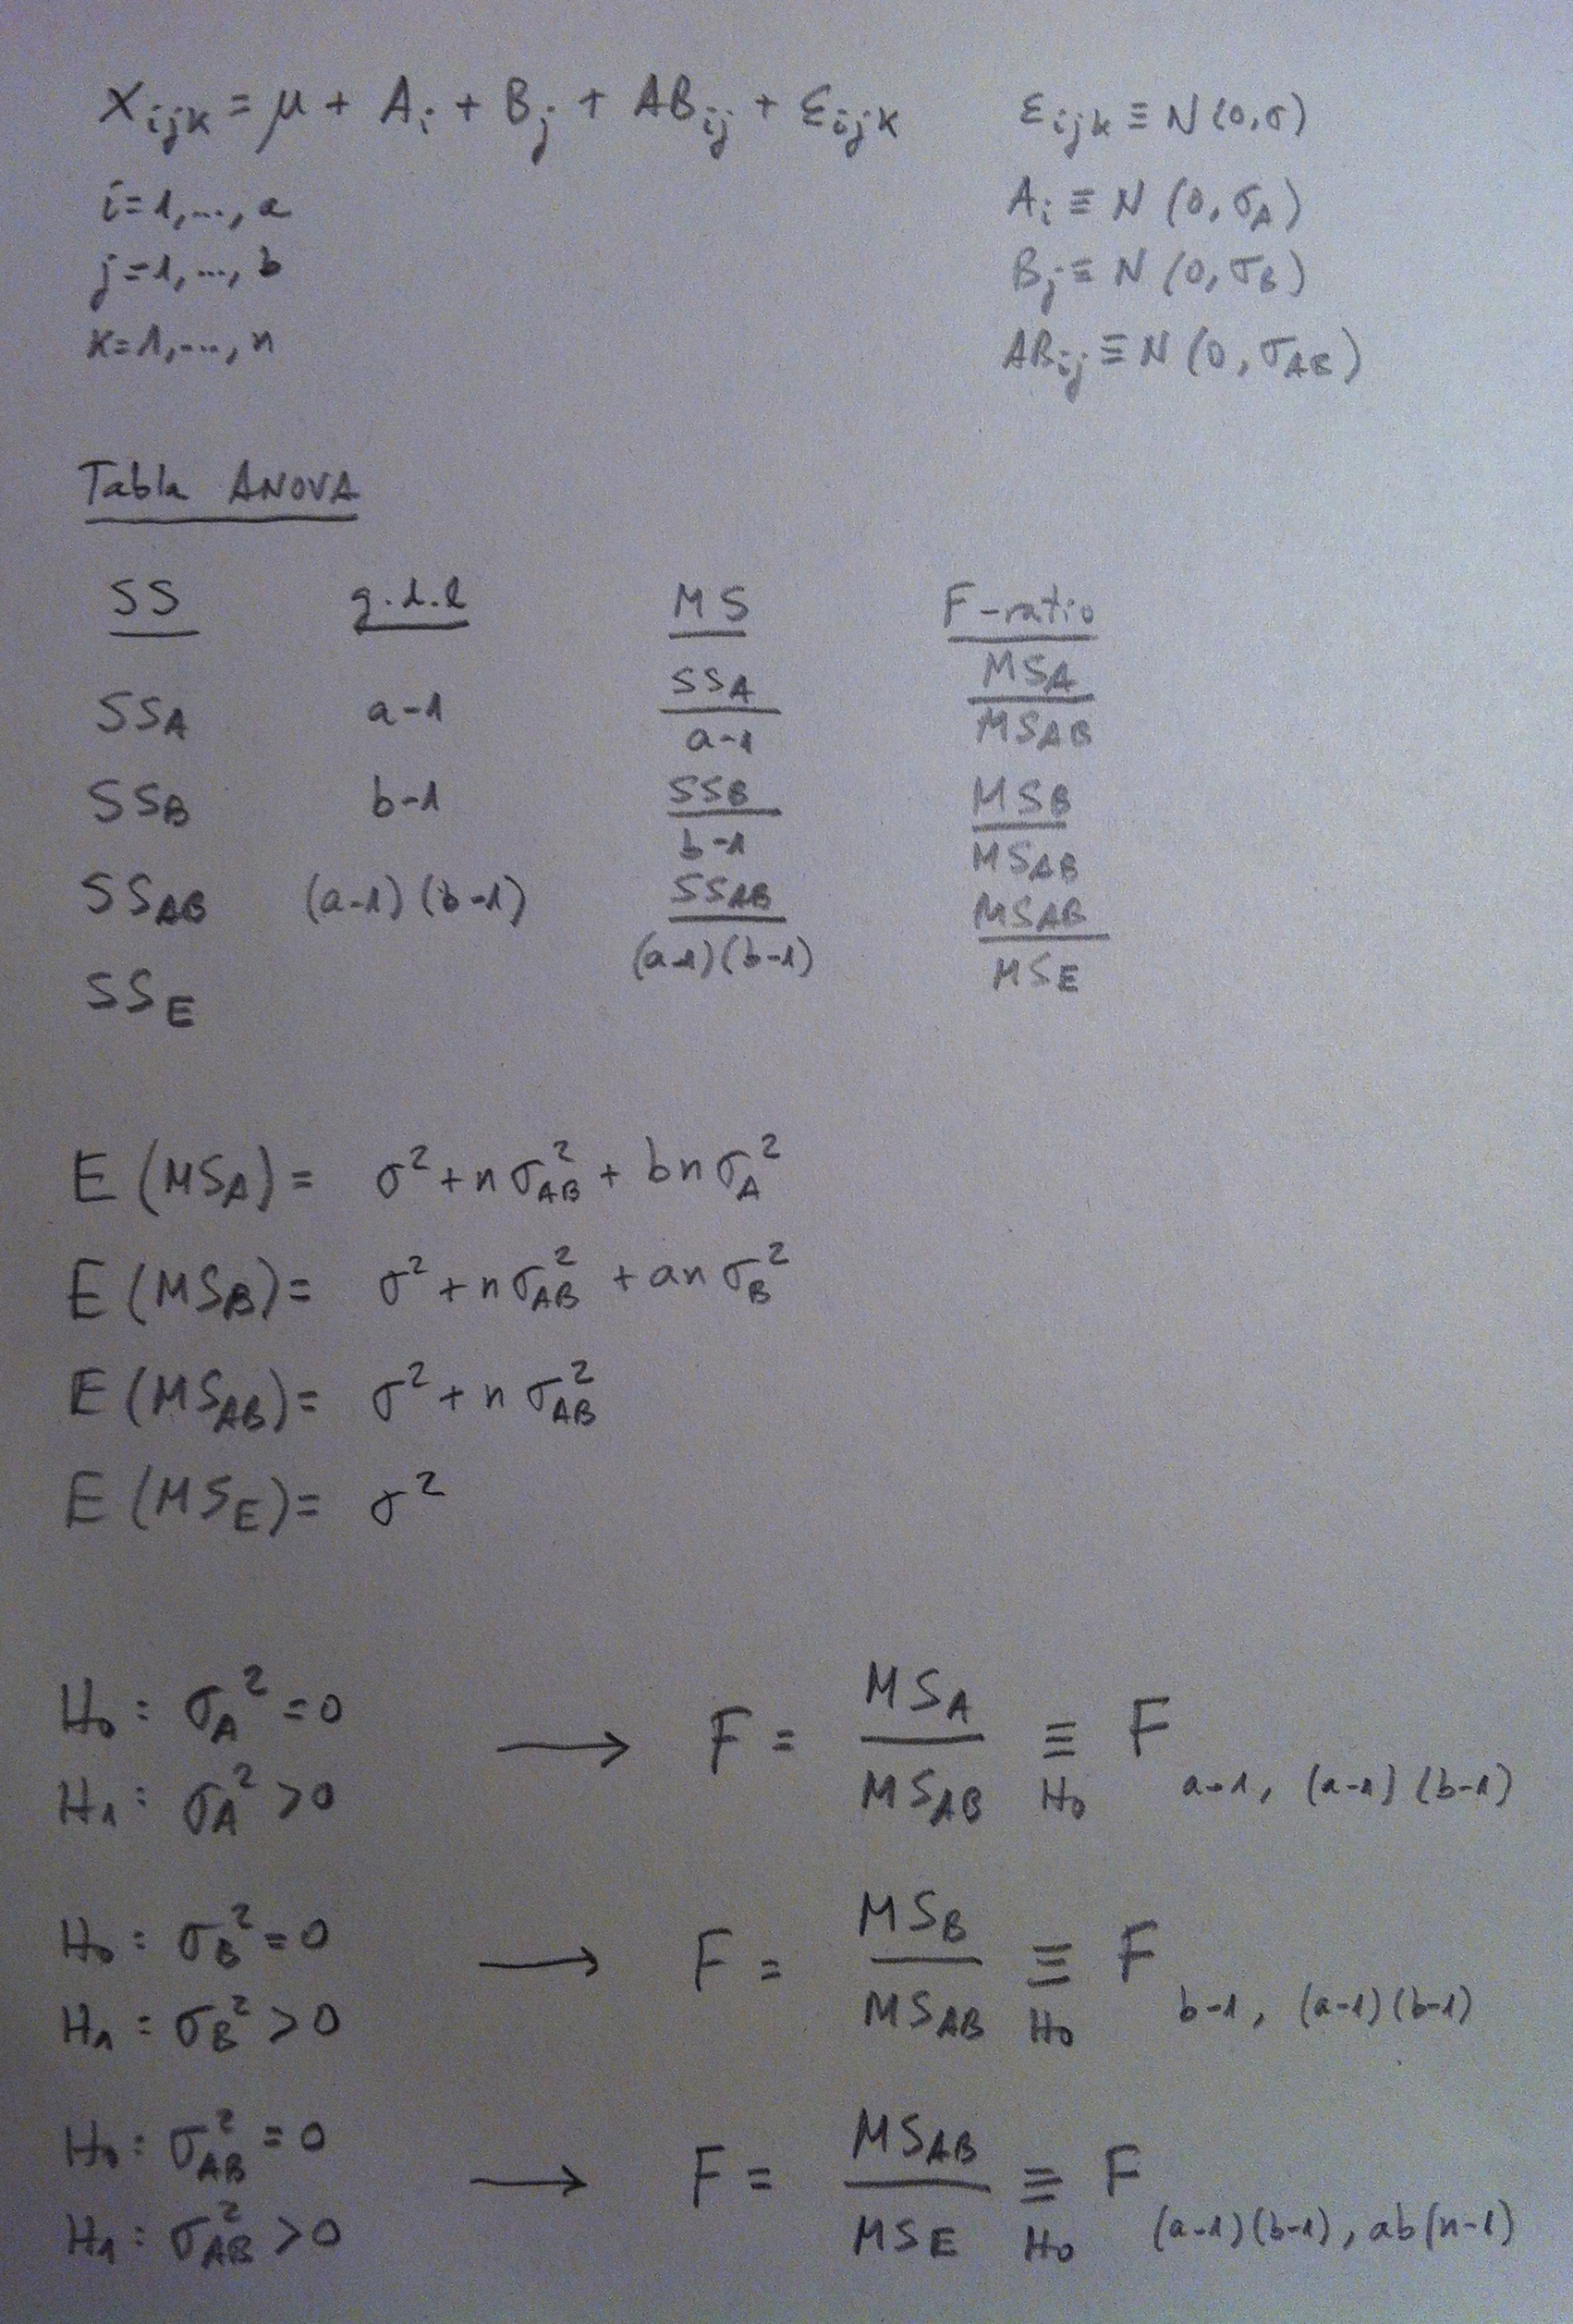
En el ANOVA de dos factores a efectos aleatorios tenemos tres contrastes a realizar, uno por cada factor y otro para la interacción. Pensemos que estamos en factores cruzados. En ANOVA si hay más de un factor si no se dice lo contrario los factores están cruzados.

La clave en estos tres contrastes de hipótesis es qué cocientes hay que hacer a la hora de dividir cuadrados medios (MS) en la F-ratio. Por eso pongo las esperanzas de los cuadrados medios. Viendo esas esperanzas y bajo la Hipótesis nula vemos por qué los cocientes son los que son. Se trata de que los cocientes, bajo la Hipótesis nula tengan la misma esperanza. De esta forma valores pequeños de la F-ratio nos permitirán mantener la Hipótesis nula y, por el contrario,  valores grandes de la F-ratio nos permitirán rechazarla y pasarnos a la Hipótesis alternativa.

IMG_4617

Test de Mann-Whitney

El Test de Mann-Whitney es un test no paramétrico que contrasta la igualdad de medianas de dos poblaciones. A este Test también se le llama, a veces, Test de Mann-Whitney-Wilcoxon o, también, Test de Wilcoxon de la suma de rangos.
Consiste en realizar nxm comparaciones: todos los valores de una muestra se comparan con los de la otra y se cuenta el número de veces que los de una muestra son superiores a los de la otra. El estadístico de test U es ese contador.

IMG_4615

Test de Wilcoxon

El Test de Wilcoxon es similar al Test de los signos pero no sólo tiene en cuenta los signos sino que tiene también en cuenta el valor absoluto de las diferencias de cada valor muestral respecto al valor mo de Mediana poblacional que se quiere contrastar. O sea, tiene en cuenta los rangos, por esto se le conoce, también, como el Test de los rangos con signo de Wilcoxon. No hay que confundirlo con el Test de la suma de rangos de Wilcoxon que es como se llama, a veces, al Test de Mann-Whitney. El Test de los rangos con signo, que es el que estamos viendo ahora, es para muestras relacionadas, apareadas. El Test de la suma de rangos es para muestras independientes.

Se suele utilizar, como el Test de los signos, para contrastar la igualdad de medianas en datos apareados en los que no se cumplen las suposiciones para realizar el Test de la t de Student. En este caso se restan uno a uno los valores apareados de ambas muestras y se contrasta la Hipótesis que la Mediana poblacional es cero.

IMG_4614

Test de los signos

En el Test de los signos se contrasta si la Mediana poblacional tiene un cierto valor mo. El estadístico de test consiste en contar el número de valores muestrales que están por encima de este valor mo. Por esto se cuenta el número de valores positivos.

Un ámbito donde se suele aplicar este Test es para muestras apareadas donde se quiera contrastar la igualdad de medias y no se cumplen las condiciones para realizar un Test de la t de Student de datos apareados. En este caso se restan los valores muestrales, individuo por individuo, y se realiza este contraste con mo=0.

IMG_4613

ANOVA de dos factores a efectos fijos

En el ANOVA de dos factores a efectos fijos tenemos tres contrastes a realizar, uno por cada factor y la interacción. Pensemos que estamos en factores cruzados. En ANOVA si hay más de un factor si no se dice lo contrario los factores están cruzados.

La clave en estos tres contrastes de hipótesis es qué cocientes hay que hacer a la hora de dividir cuadrados medios (MS) en la F-ratio. Por eso pongo las esperanzas de los cuadrados medios. Viendo esas esperanzas y bajo la Hipótesis nula vemos por qué los cocientes son los que son. Se trata de que los cocientes, bajo la Hipótesis nula tengan la misma esperanza. De esta forma valores pequeños de la F-ratio nos permitirán mantener la Hipótesis nula y, por el contrario,  valores grandes de la F-ratio nos permitirán rechazarla y pasarnos a la Hipótesis alternativa.

 IMG_4608

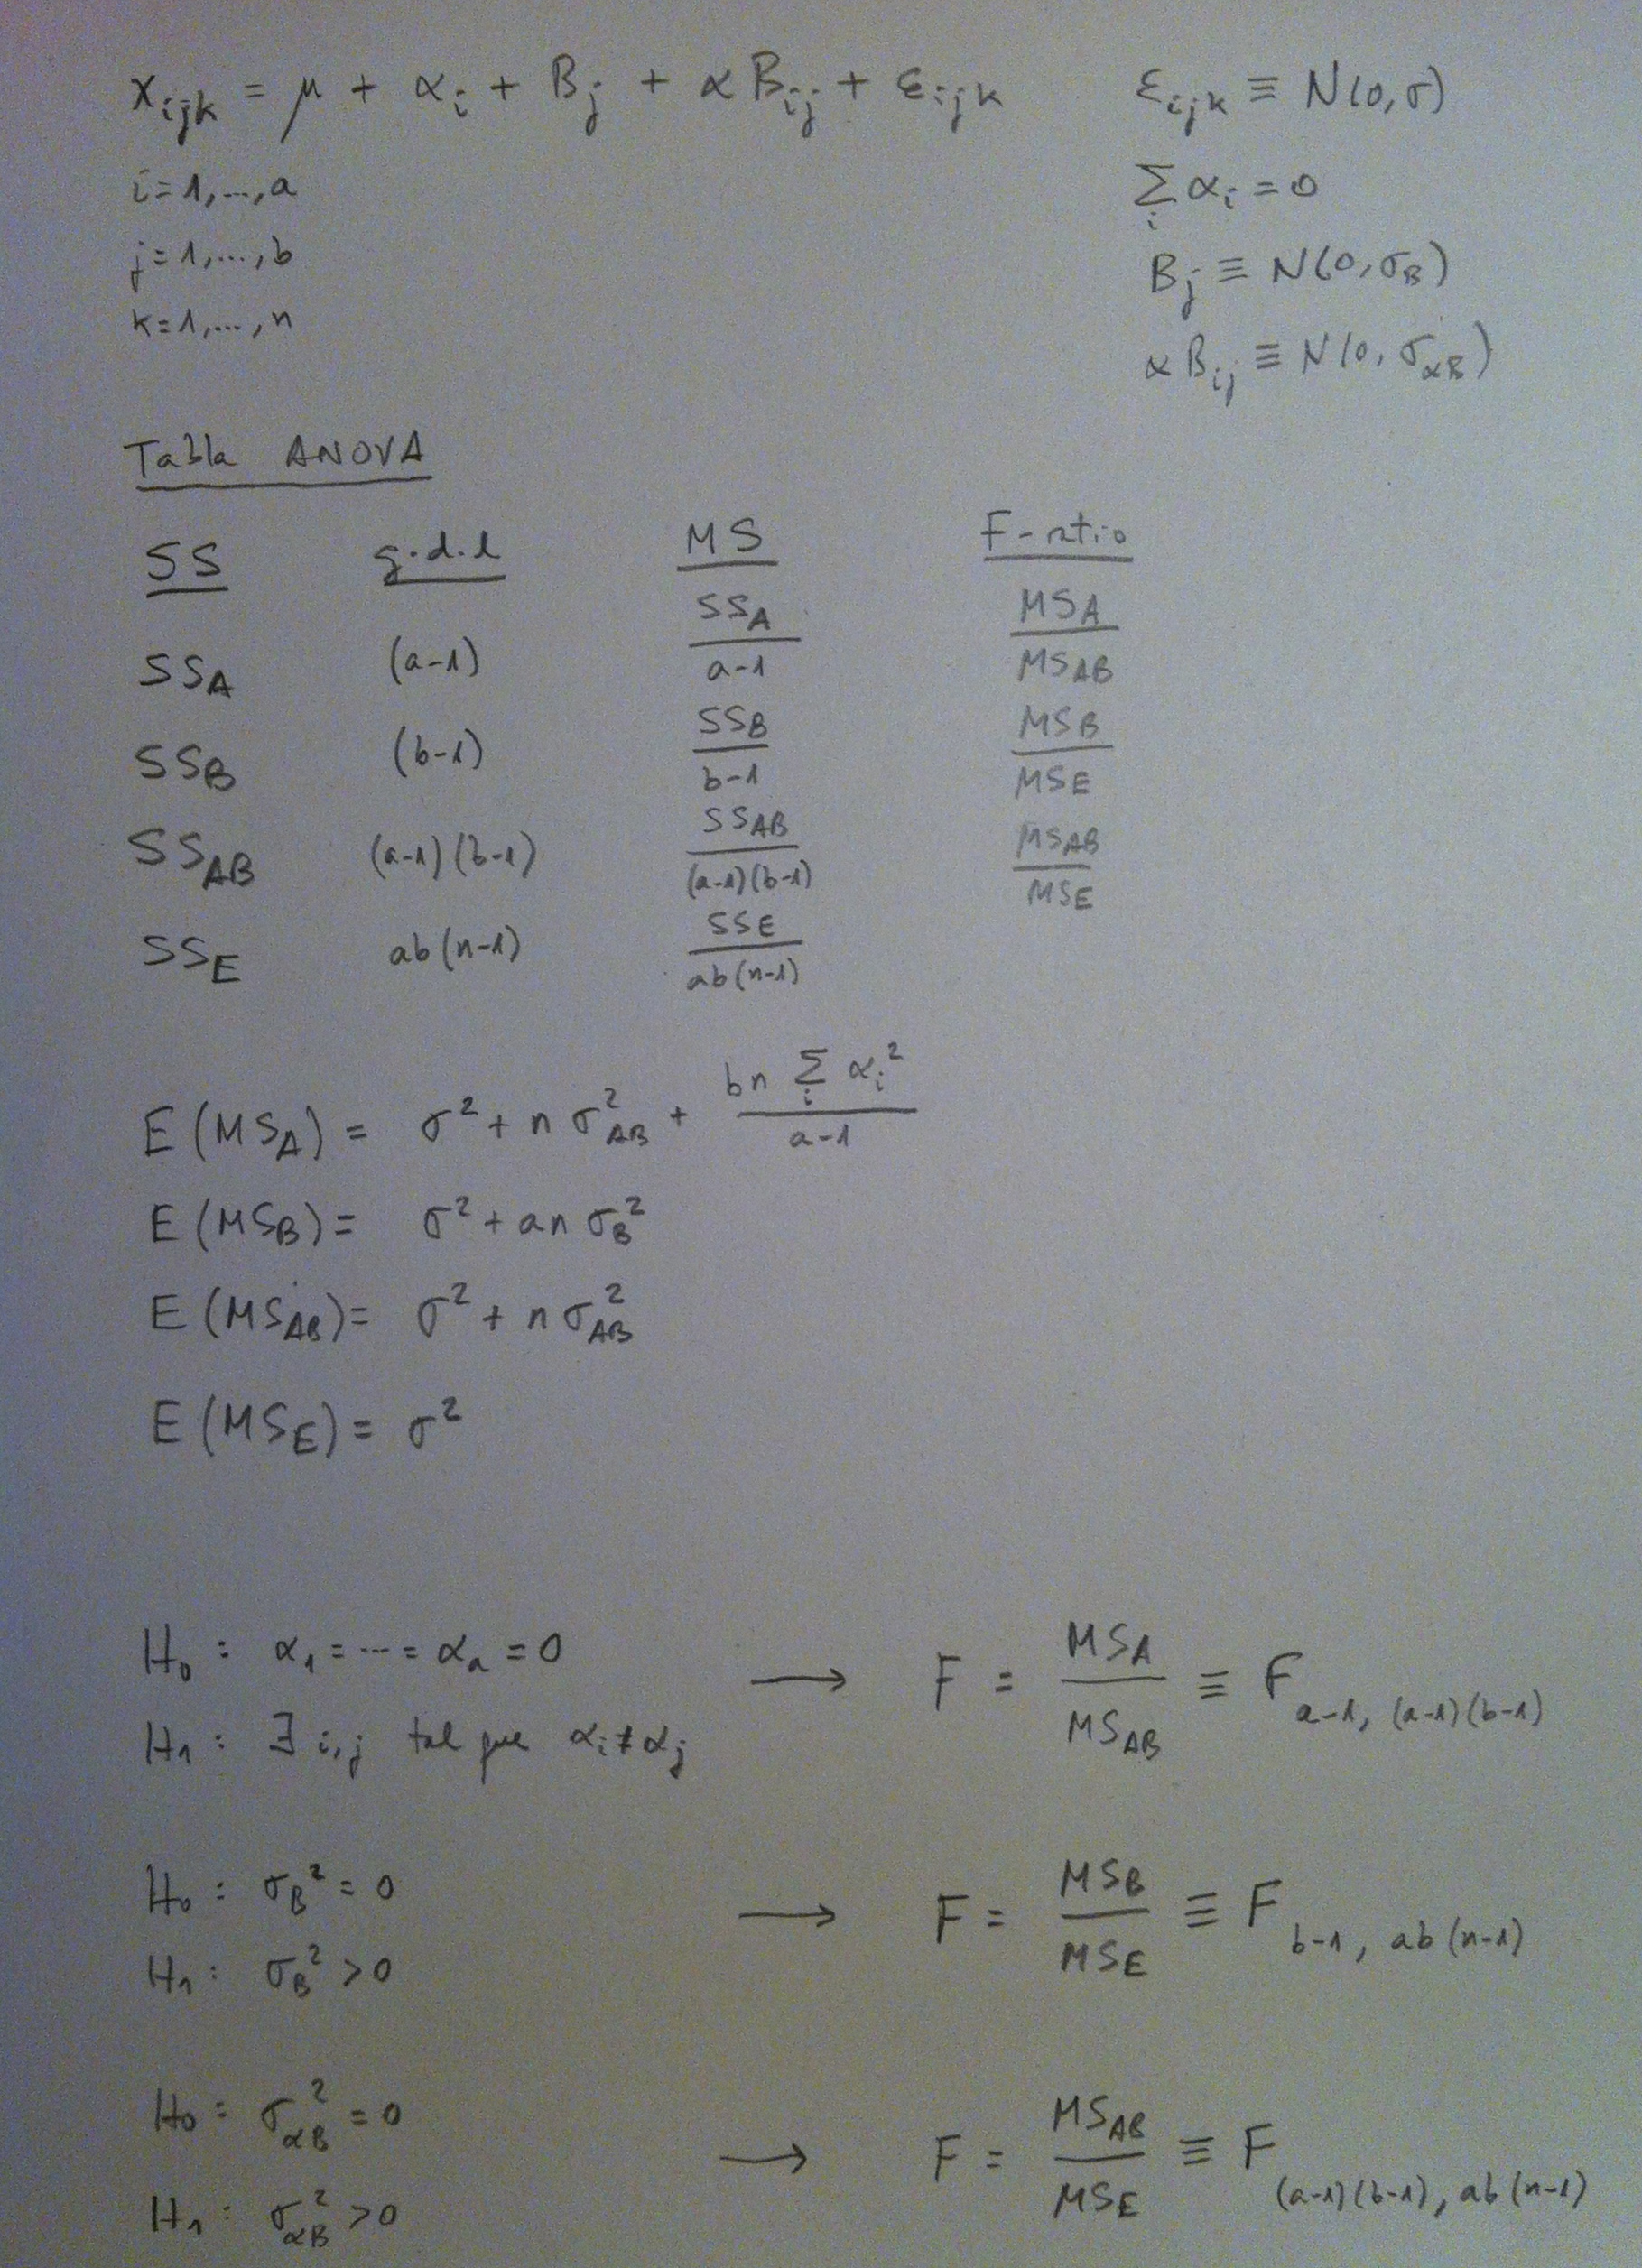
ANOVA de dos factores a efectos mixtos

En el ANOVA de dos factores a efectos mixtos, uno fijo y uno aleatorio, tenemos tres contrastes a realizar, uno por cada factor y otro para la interacción. Pensemos que estamos en factores cruzados. En ANOVA si hay más de un factor si no se dice lo contrario los factores están cruzados.

La clave en estos tres contrastes de hipótesis es qué cocientes hay que hacer a la hora de dividir cuadrados medios (MS) en la F-ratio. Por eso pongo las esperanzas de los cuadrados medios. Viendo esas esperanzas y bajo la Hipótesis nula vemos por qué los cocientes son los que son. Se trata de que los cocientes, bajo la Hipótesis nula tengan la misma esperanza. De esta forma valores pequeños de la F-ratio nos permitirán mantener la Hipótesis nula y, por el contrario,  valores grandes de la F-ratio nos permitirán rechazarla y pasarnos a la Hipótesis alternativa.

IMG_4607

Funciones de distribución

1. Una función matemática es un tipo de relación establecido entre dos o más variables. Cuando escribimos y=f(x) estamos estableciendo una relación entre la variable “x” y la variable “y”.

2. Una de las peculiaridades de la funciones matemáticas es que pueden ser usados como modelos de relaciones entre variables reales.

3. En Estadística las funciones matemáticas más utilizadas como modelos son las llamadas funciones de distribución.

4. Las funciones de distribución son modelos de la variabilidad, modelos de la forma de la variación que tiene una variable. En esas funciones la variable «x», en la típica estructura de una función: y=f(x), son los valores que se pueden dar de la variable estudiada y los valores de la variable «y», son la probabilidad de que se den; o sea, la abundancia relativa de ese valor en la población.

5. Las funciones de distribución, como su nombre indica, son representaciones de cómo, potencialmente, puede distribuirse una variable. Y no lo olvidemos: son funciones matemáticas. No son variables reales como la altura, el peso, el número de hermanos, el ser hombre o mujer, etc. Lo que sucede es que se han construido de tal forma que pueden actuar de maquetas de esas variables reales, porque modelizan bien su variabilidad.

6. Es evidente que no se distribuye de la misma forma una variable como el número de hermanos que tiene una persona, su altura, el sexo o el grado de dolor que tiene una persona tras una cirugía.

7. La normal, la binomial, la Poisson, la Bernouilli, la exponencial, etc., son distintas distribuciones, distintas formas de dibujar, matemáticamente, a través de una función, la variabilidad con la que se nos presentan las variables que estudiamos.

8. La modelización estadística, en general, consiste en la representación de una situación estadística real mediante un modelo matemático.

9. Una de las modelizaciones estadísticas más usuales es la de la variabilidad de una variable mediante una función de distribución.

10. El contraste de hipótesis de la modelización estadística es siempre: H0: El modelo se ajusta a la realidad. H1: El modelo no se ajusta.

11. En el caso concreto de una función de distribución el contraste es: H0: La variable sigue una distribución determinada. H1: No la sigue.

12. Por ejemplo, es muy habitual en Estadística el contraste siguiente: H0: La variable sigue una distribuión normal. H1: No la sigue.

13. Estos contrastes siguen la misma operatividad que siguen todos los contrastes de hipótesis estadísticos: una muestra y una técnica que decide, proporcionando un p-valor, si tiene sentido, a la luz de lo que dice la muestra, mantener la hipótesis nula o si debemos rechazarla y aceptar la alternativa.

14. Todas las técnicas estadísticas cuyos contrastes de hipótesis ajustan una función de distribución a unos datos se denominan técnicas bondad de ajuste a una distribución. En la sección Herbario de técnicas se pueden consultar varias de ellas.

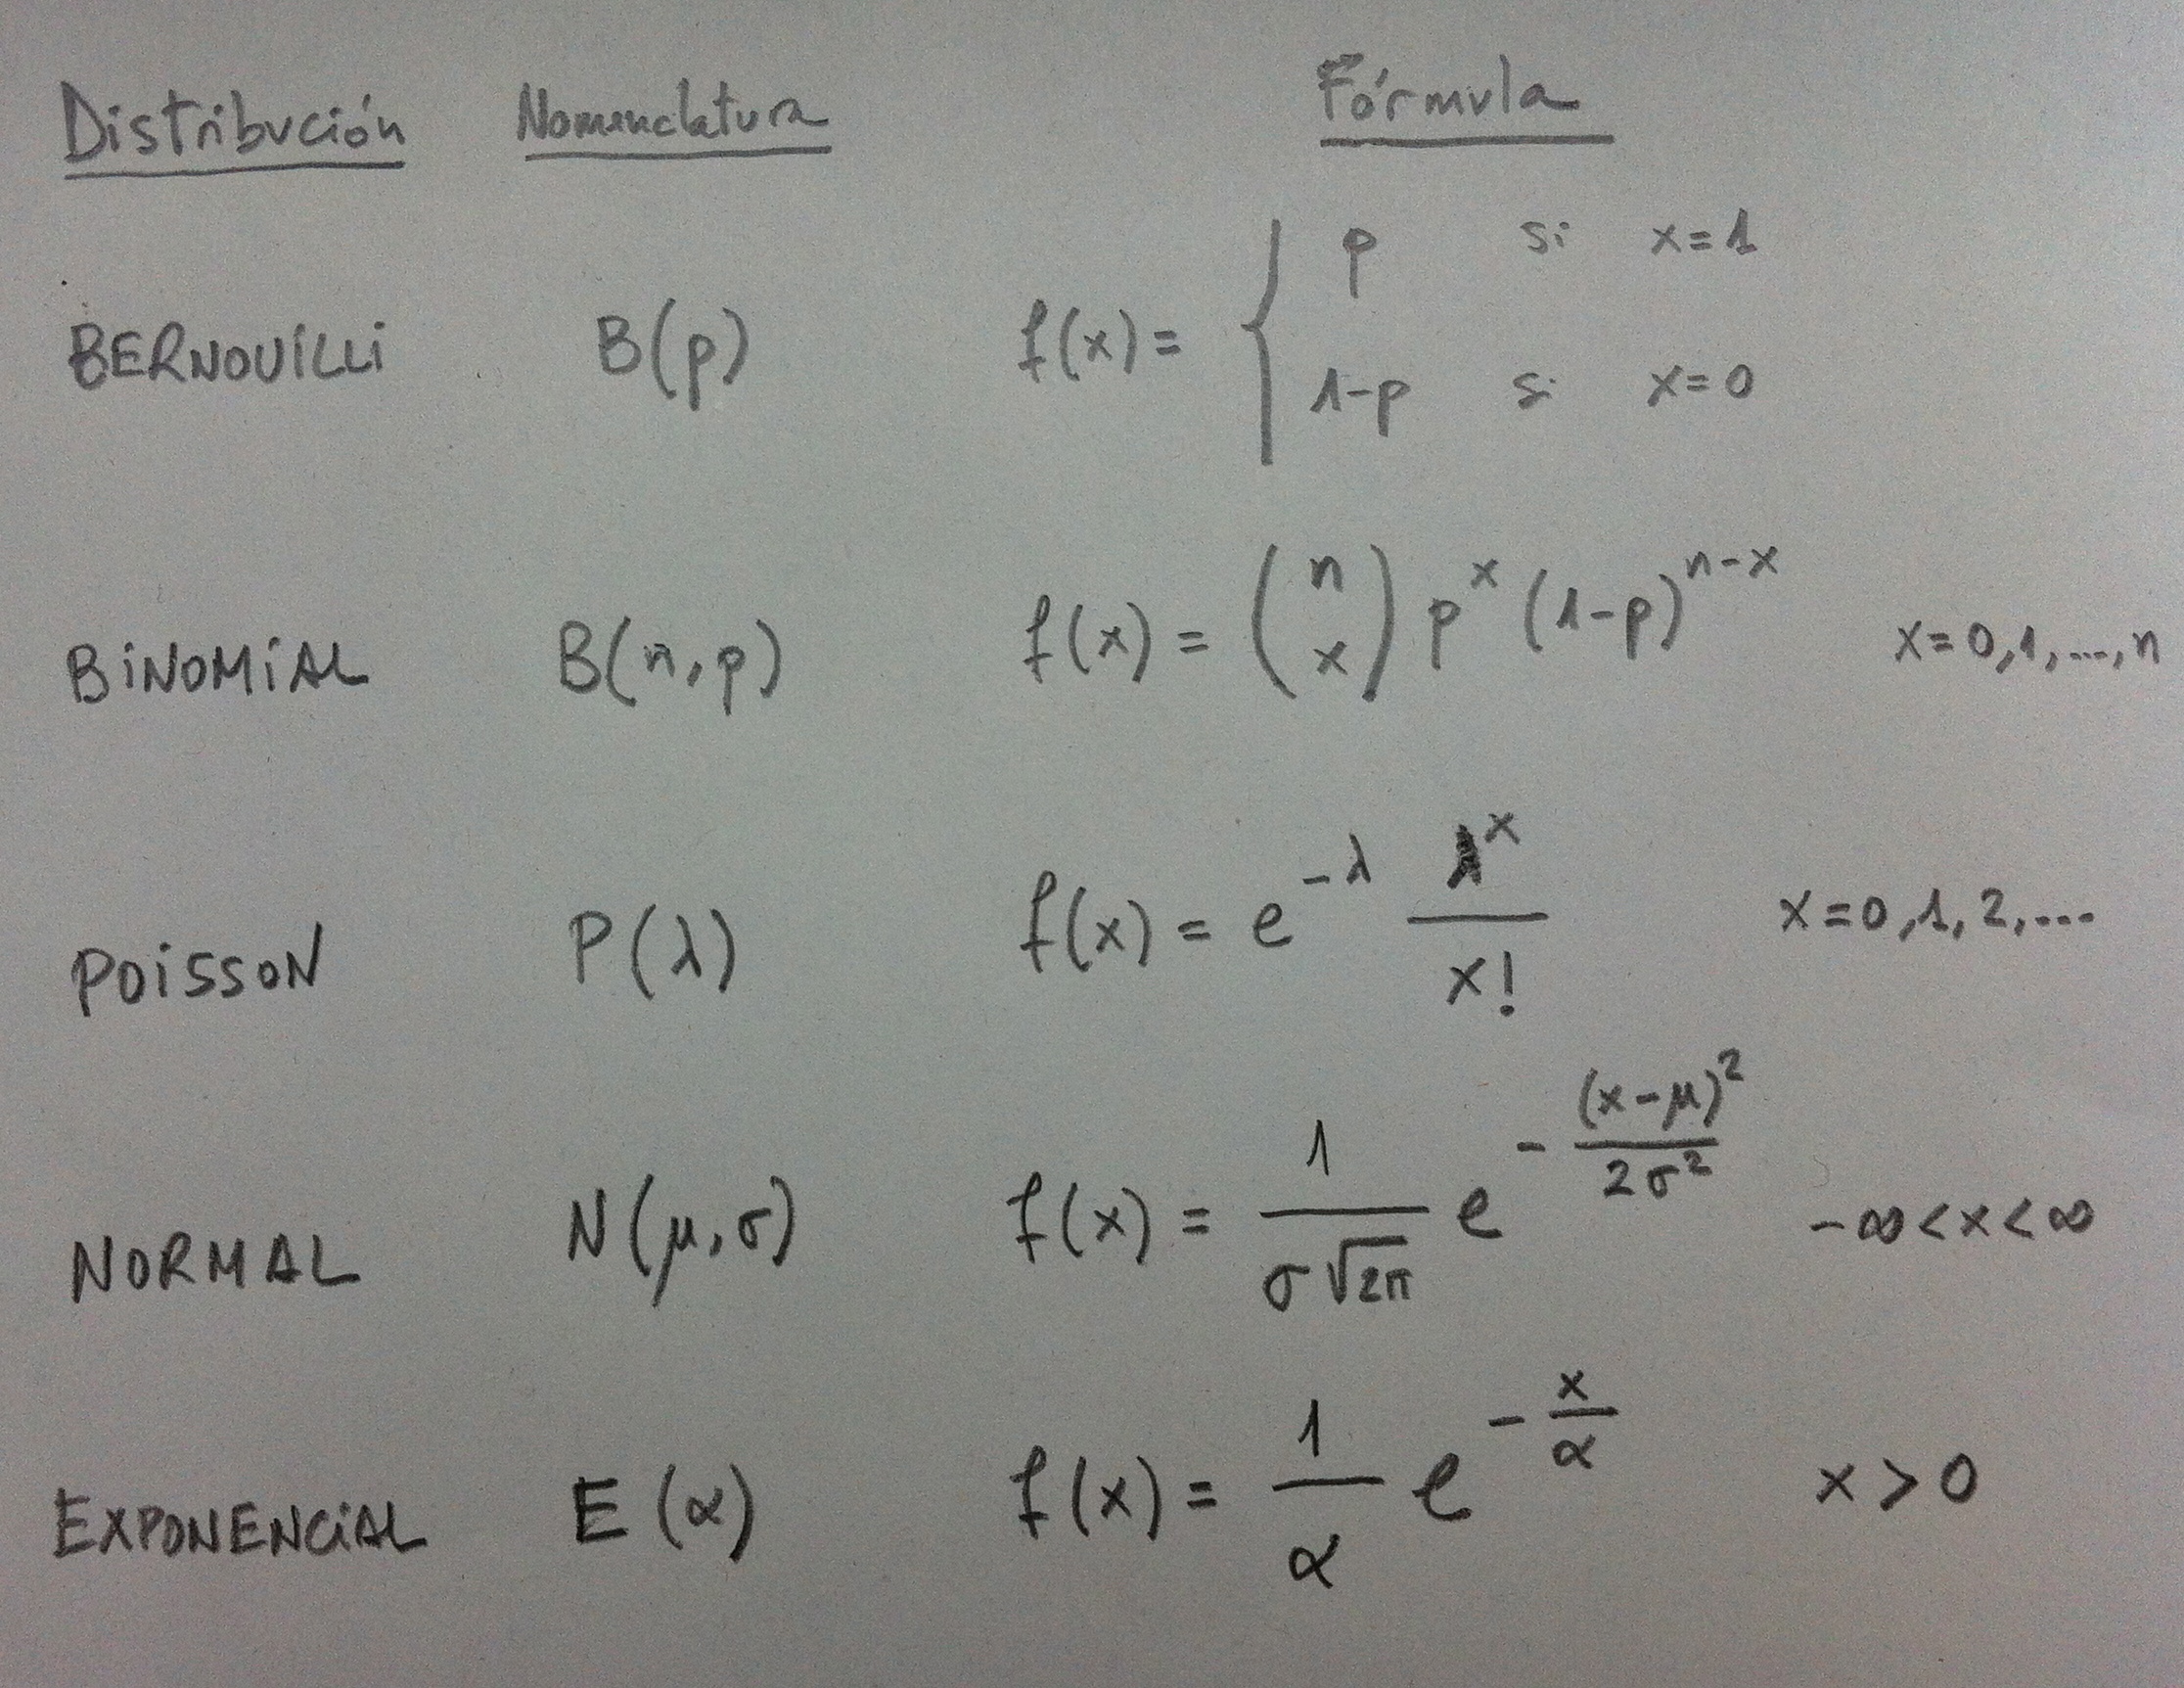
15. Vamos a ver a continuación las distribuciones más usadas como modelos de la variación. En la siguiente tabla podemos ver el nombre de la distribución, la nomenclatura habitualmente usada y su función de densidad:

IMG_4547

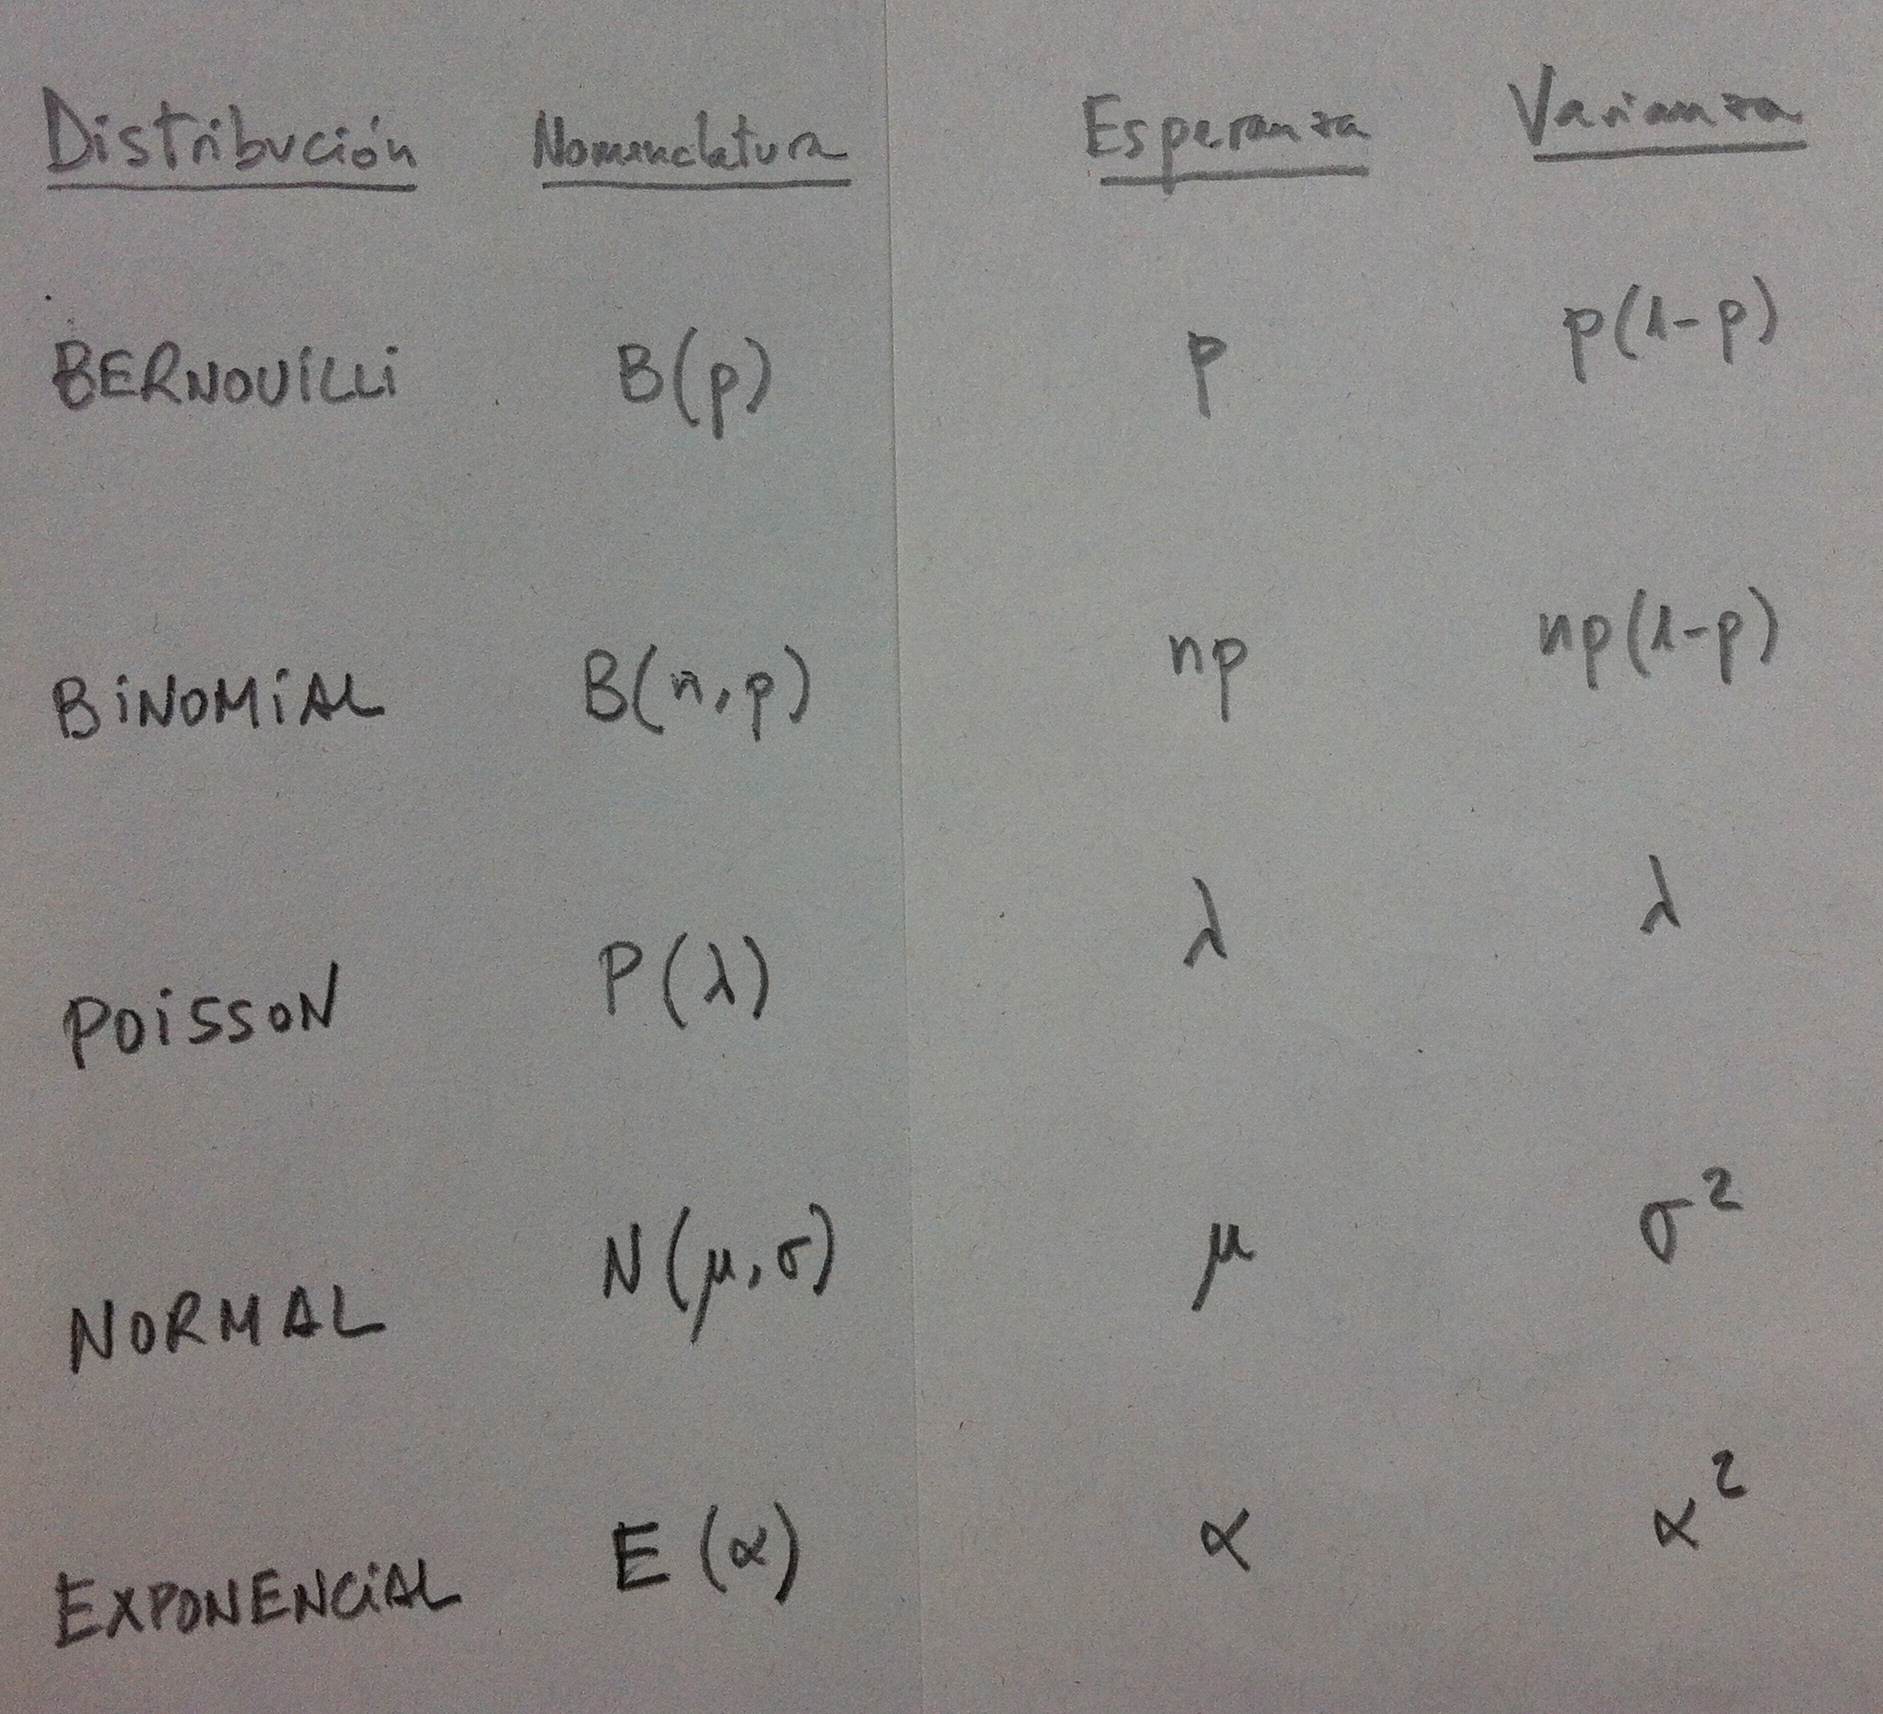
16. Es importante conocer cuál es la esperanza y cuál es la varianza de cada una de estas distribuciones. De esta forma tenemos un valor de referencia de cada una de ellas: el valor promedio y la dispersión de sus valores:

IMG_4548

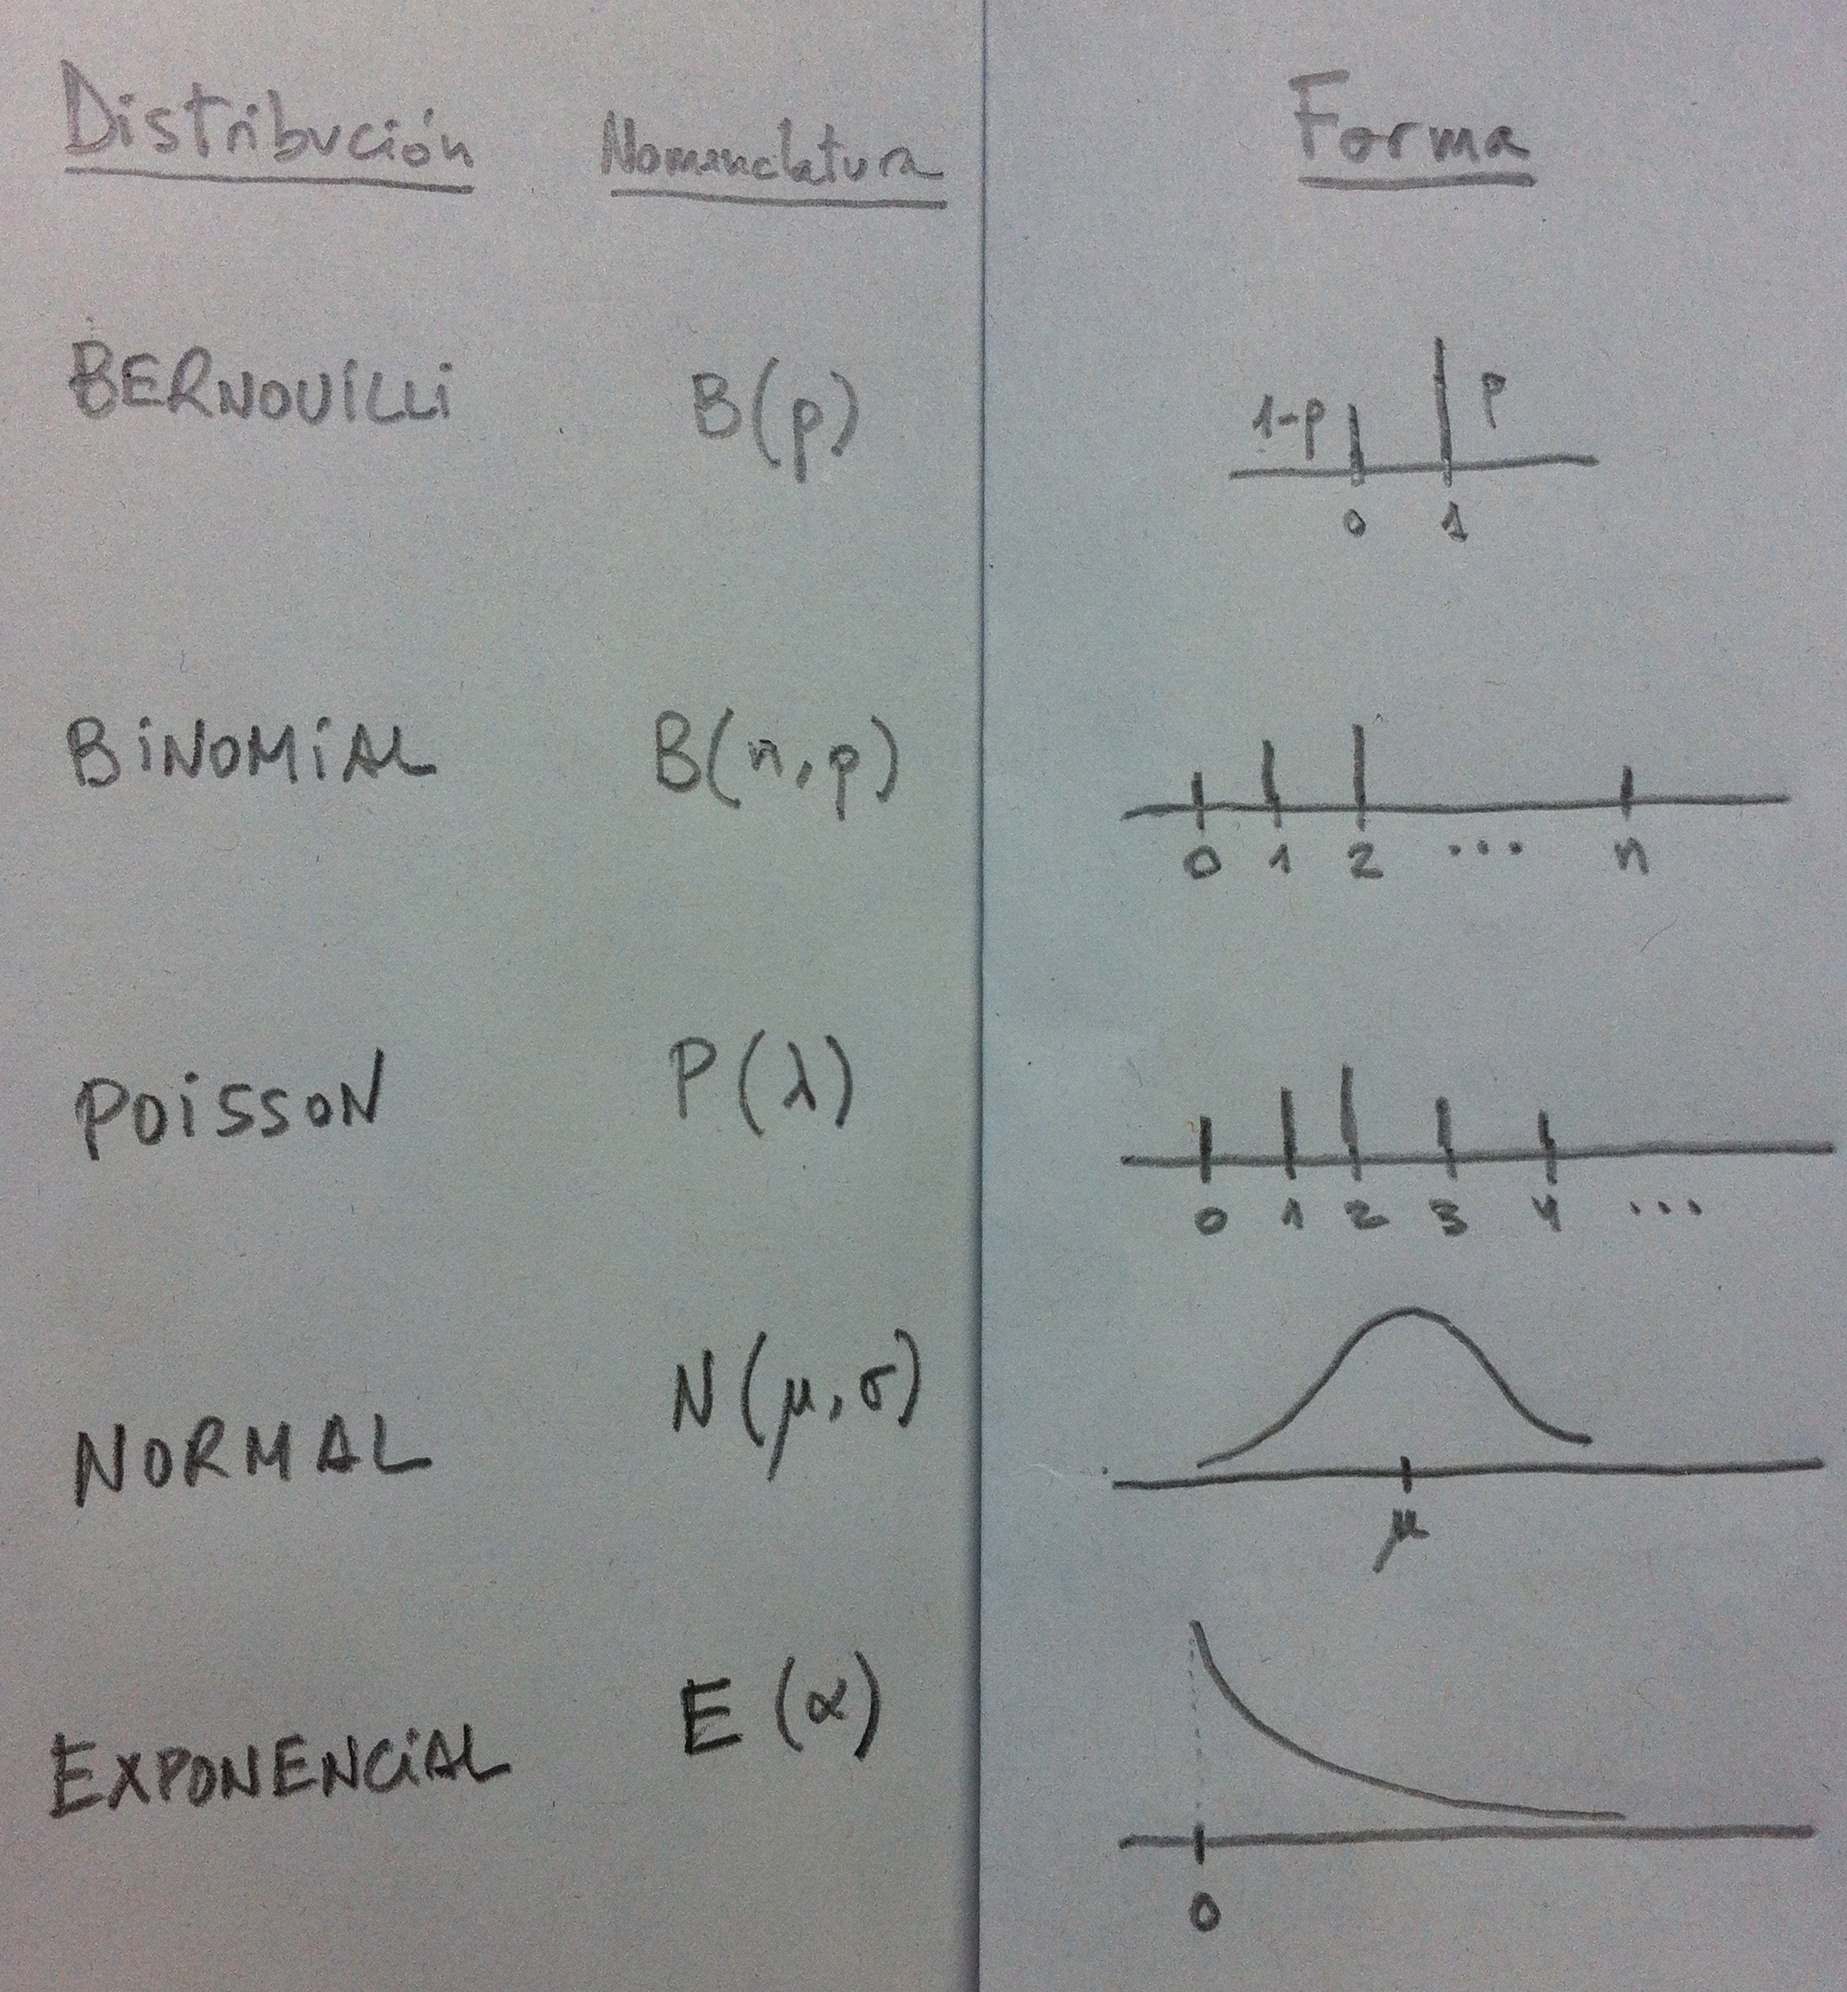
17. Y estas distribuciones tienen, evidentemente, unas formas peculiares. Las tres primeras sólo tienen probabilidad valores enteros (son distribuciones discretas), las otras dos tienen probabilidad intervalos reales (son distribuciones continuas). Las dos primeras además de ser discretas son finitas (sólo tienen probabilidad un número finito de valores: dos la distribución Bernouilli y n+1 la distribución Binomial. Es la peculiar forma de cada una de ellas lo que nos sirve de modelo de la variabilidad. Veamos la forma general de cada una de estas distribuciones:

IMG_4550

18. Los parámetros de cada distribución, que son las letras entre paréntesis en la nomenclatura de la distribución, son como las tallas del modelo. Una vez adaptada (ajustada, solemos decir los estadísticos) una distribución a una variable real conviene seleccionar el valor más adecuado del parámetro, o de los parámetros, a los datos que se tienen de la variable en la muestra. Esto es como cuando compramos unos zapatos, primero elegimos el modelo y luego la talla. Con la talla buscamos un ajuste del zapato a nuestro pie. Pues esto también hacemos con las distribuciones.

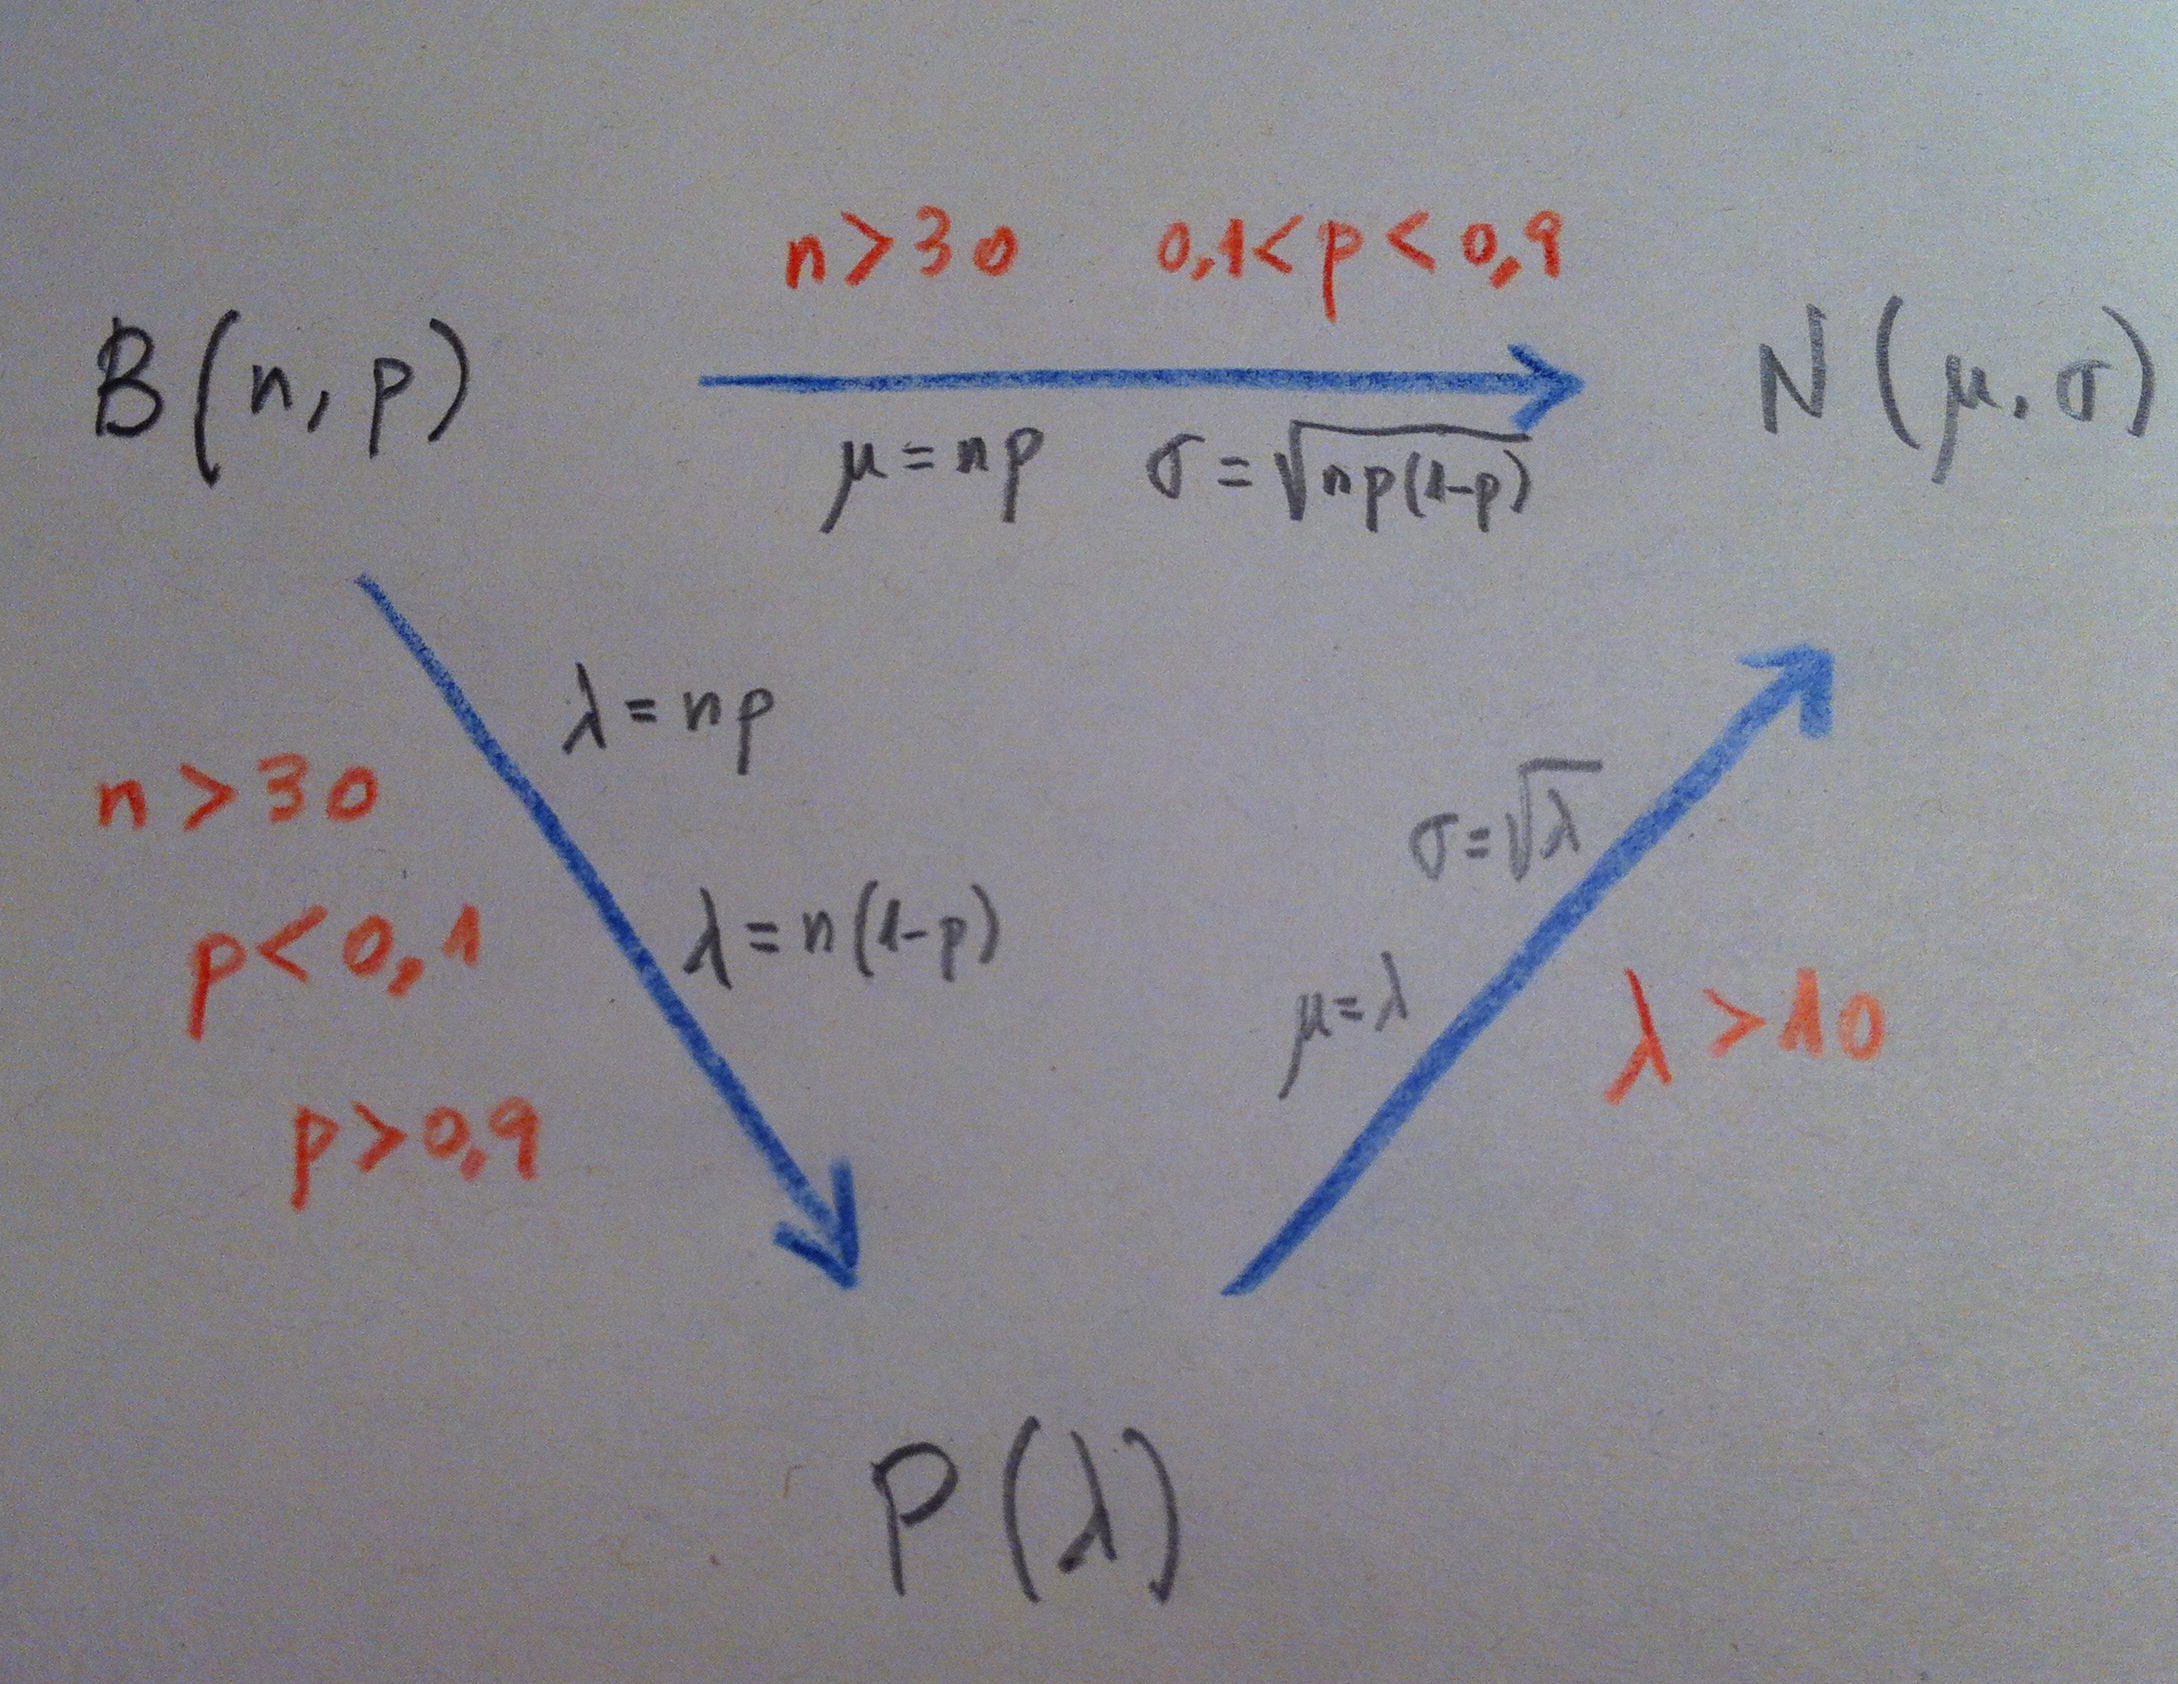
19. Entre la distribución Binomial, la Poisson y la Normal existen posibilidades de usar unas por otras en determinadas circunstancia. Esto se basa en el hecho de que en esas circunstancias en las que es posible la aproximación los contornos, las formas, la distribución de probabilidades, se aproxima mucho entre ellas. Y muchas veces calcular áreas mediante una distribución Binomial o una Poisson es largo y pesado, en cambio pasar a una distribución es muy sencillo y rápido.

20. Veamos a continuación el mapa de estas aproximaciones:

IMG_4553

21. Las aproximaciones son, como puede verse, de la Binomial a la Poisson, de la Binomial a la Normal y de la Poisson a la Normal. En rojo están las condiciones en las que esto es posible. Y en negro están cómo se calcula el parámetro o los parámetros de la nueva distribución a partir del parámetro o de los parámetros de la antigua.

22. Como se puede ver la distribución normal es finalmente una distribución muy utilizada tanto como representación de la variabilidad de una variable en la naturaleza, porque muchas variables tienen un compartamiento de campana de Gauss, y porque muy frecuentemente otras distribuciones (la binomial y la Poisson) se pueden aproximar a una normal y los cálculos en ésta son mucho más sencillos.

23. Para ver con detalle las peculiaridades de la distribución normal puede consultarse el artículo dedicado a ella. Allí se podrá comprobar el uso de las tablas de la normal.

24. Alguien pensará: ¿Y la distribución t de Student? ¿Y la distribución F de Fisher? ¿Y la distribución ji-cuadrado de Pearson? Estas no son distribuciones usadas como modelo de la variación. Pero son muy importantes en Estadística, evidentemente. Son usadas continuamente. Pero son usadas como distribuciones de estadísticos de test en ciertos contrastes.

25. Estas tres distribuciones (la t de Student, la F de Fisher y la ji-cuadrado de Pearson) se les denomina distribuciones derivadas de la normal, porque son las distribuciones de ciertos estadísticos si la variable de estudio es una distribución normal.

26. Veamos un caso de aplicación de una distribución Binomial:

IMG_5206

27. Veamos, ahora, un caso de aplicación de una distribución Poisson:

IMG_4562

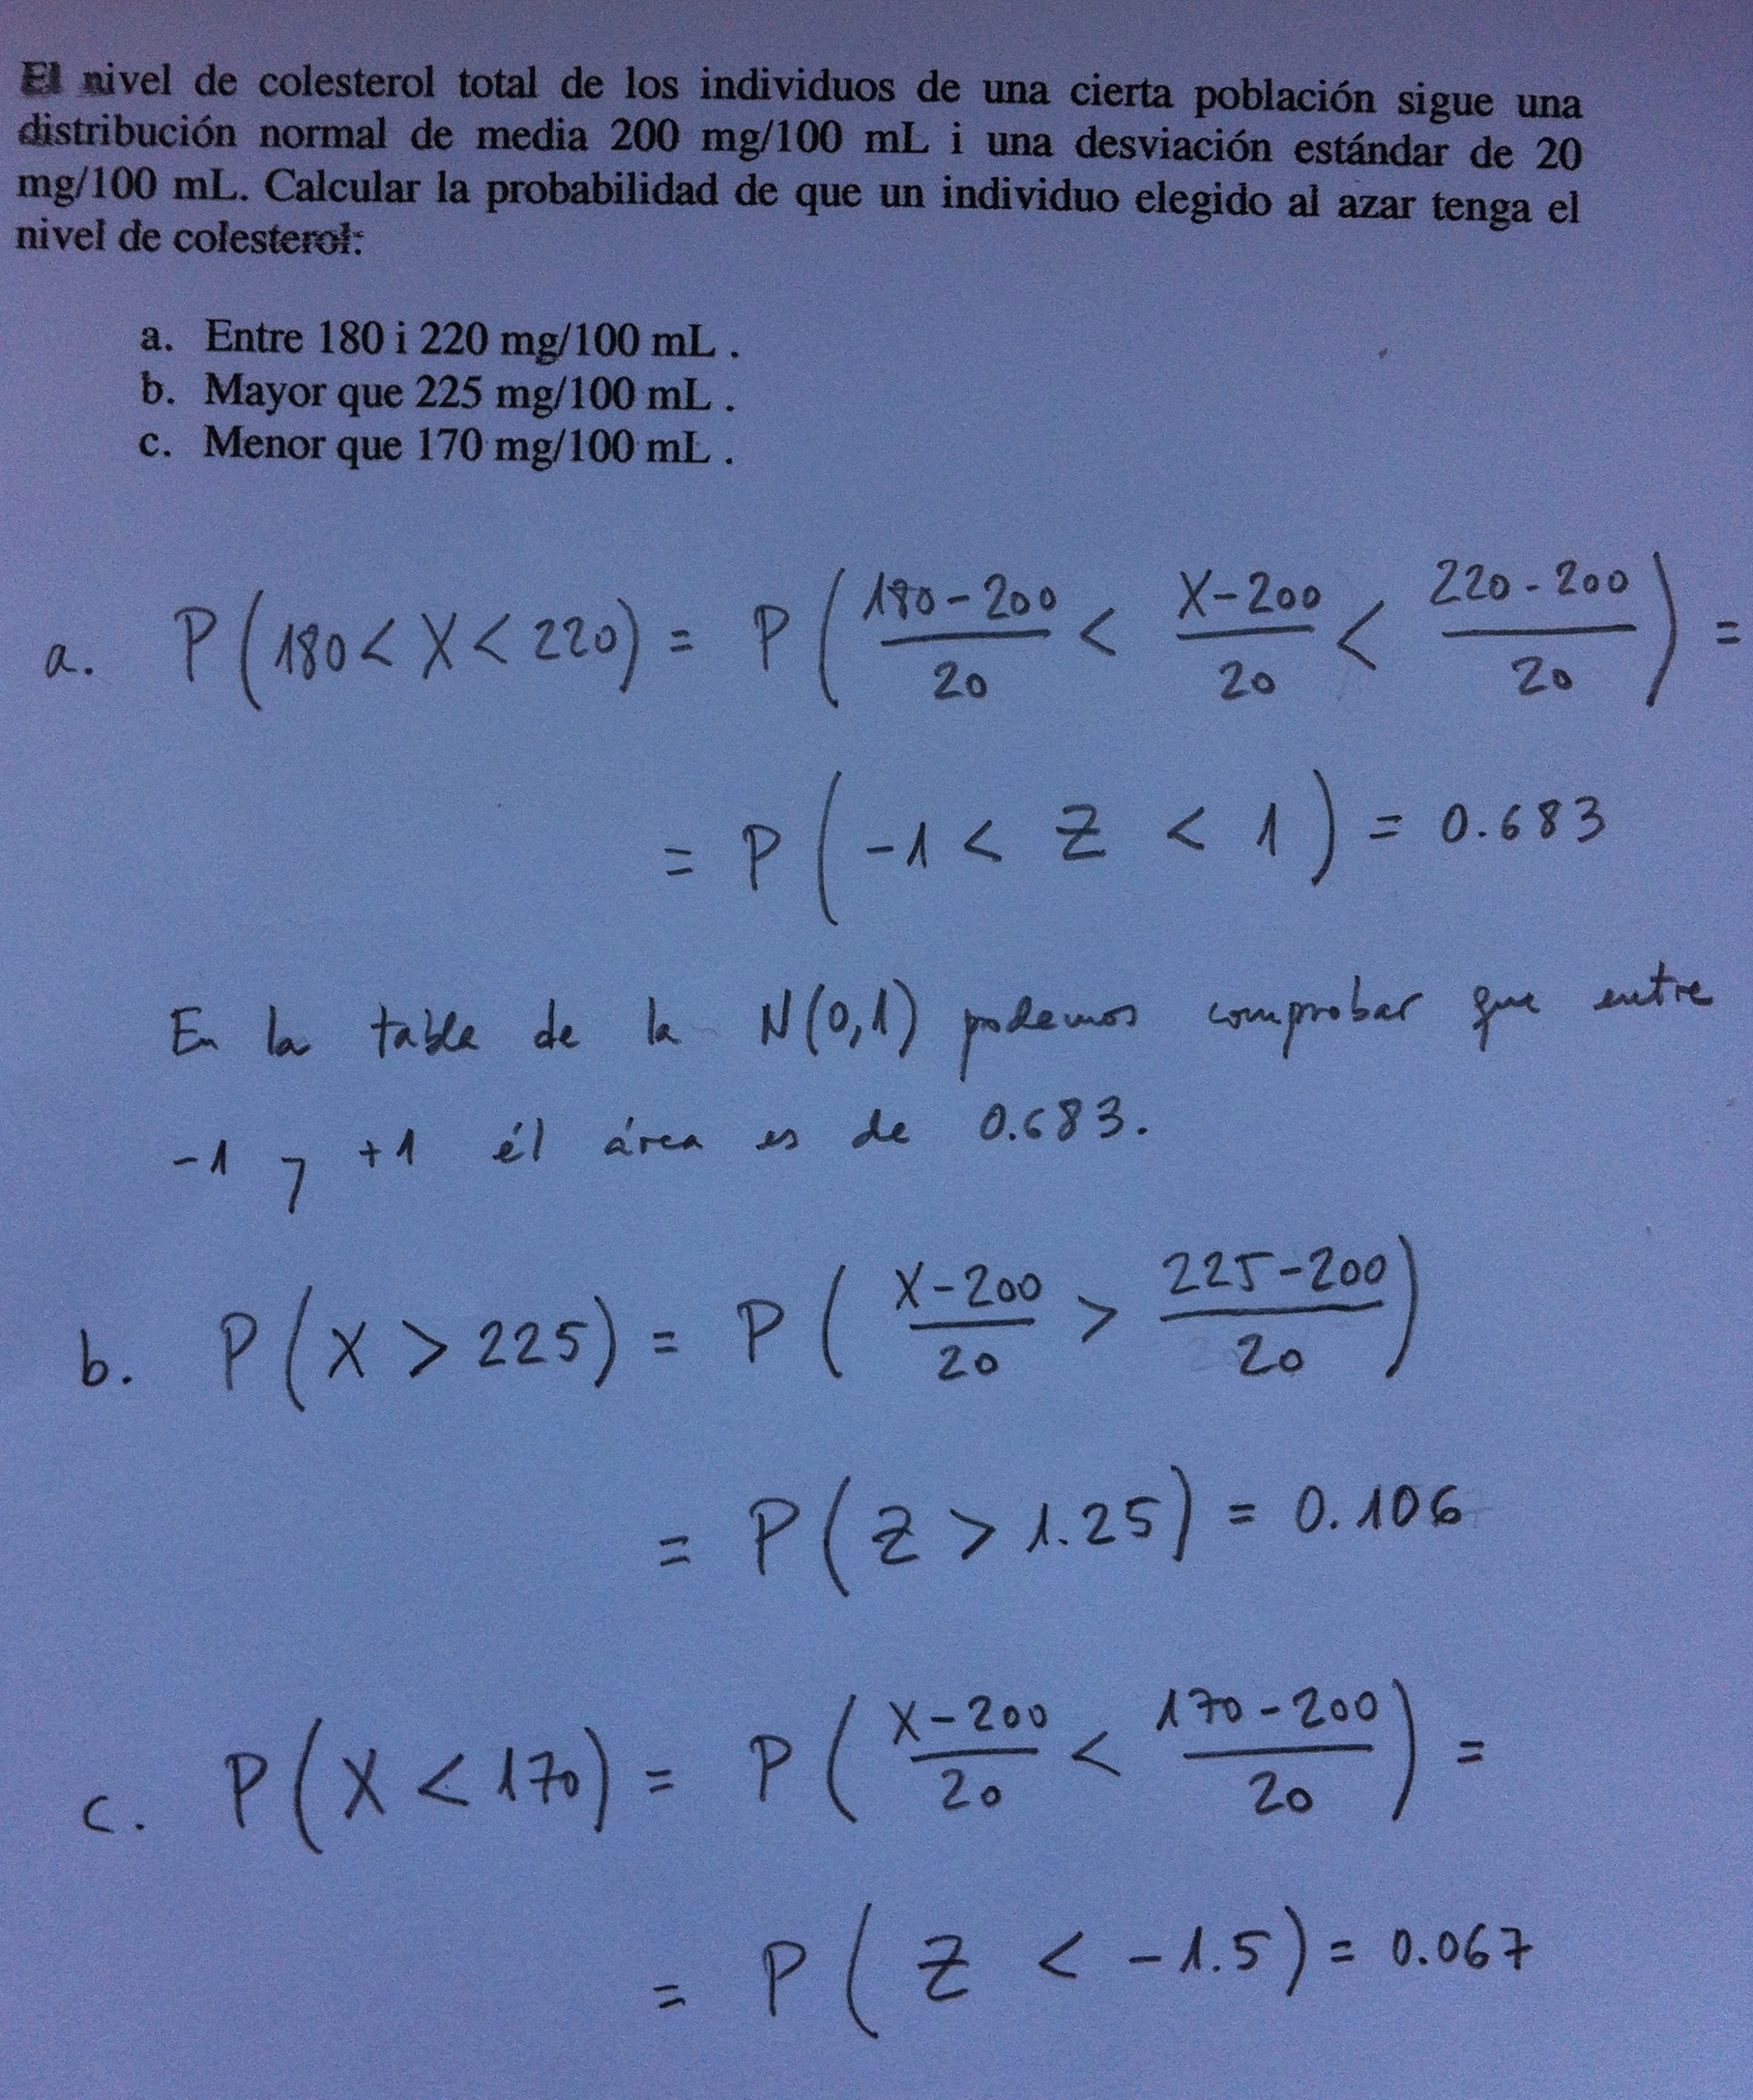
28. Veamos un caso de una distribución Normal (Ver el artículo dedicado a la Distribución normal donde se explican la estandarización y el uso de la tabla de la N(0, 1)):

IMG_4563

29. Para ver cómo se maneja la tabla de la distribución normal para poder calcular esas áreas puede consultarse el artículo dedicado a esa distribución.

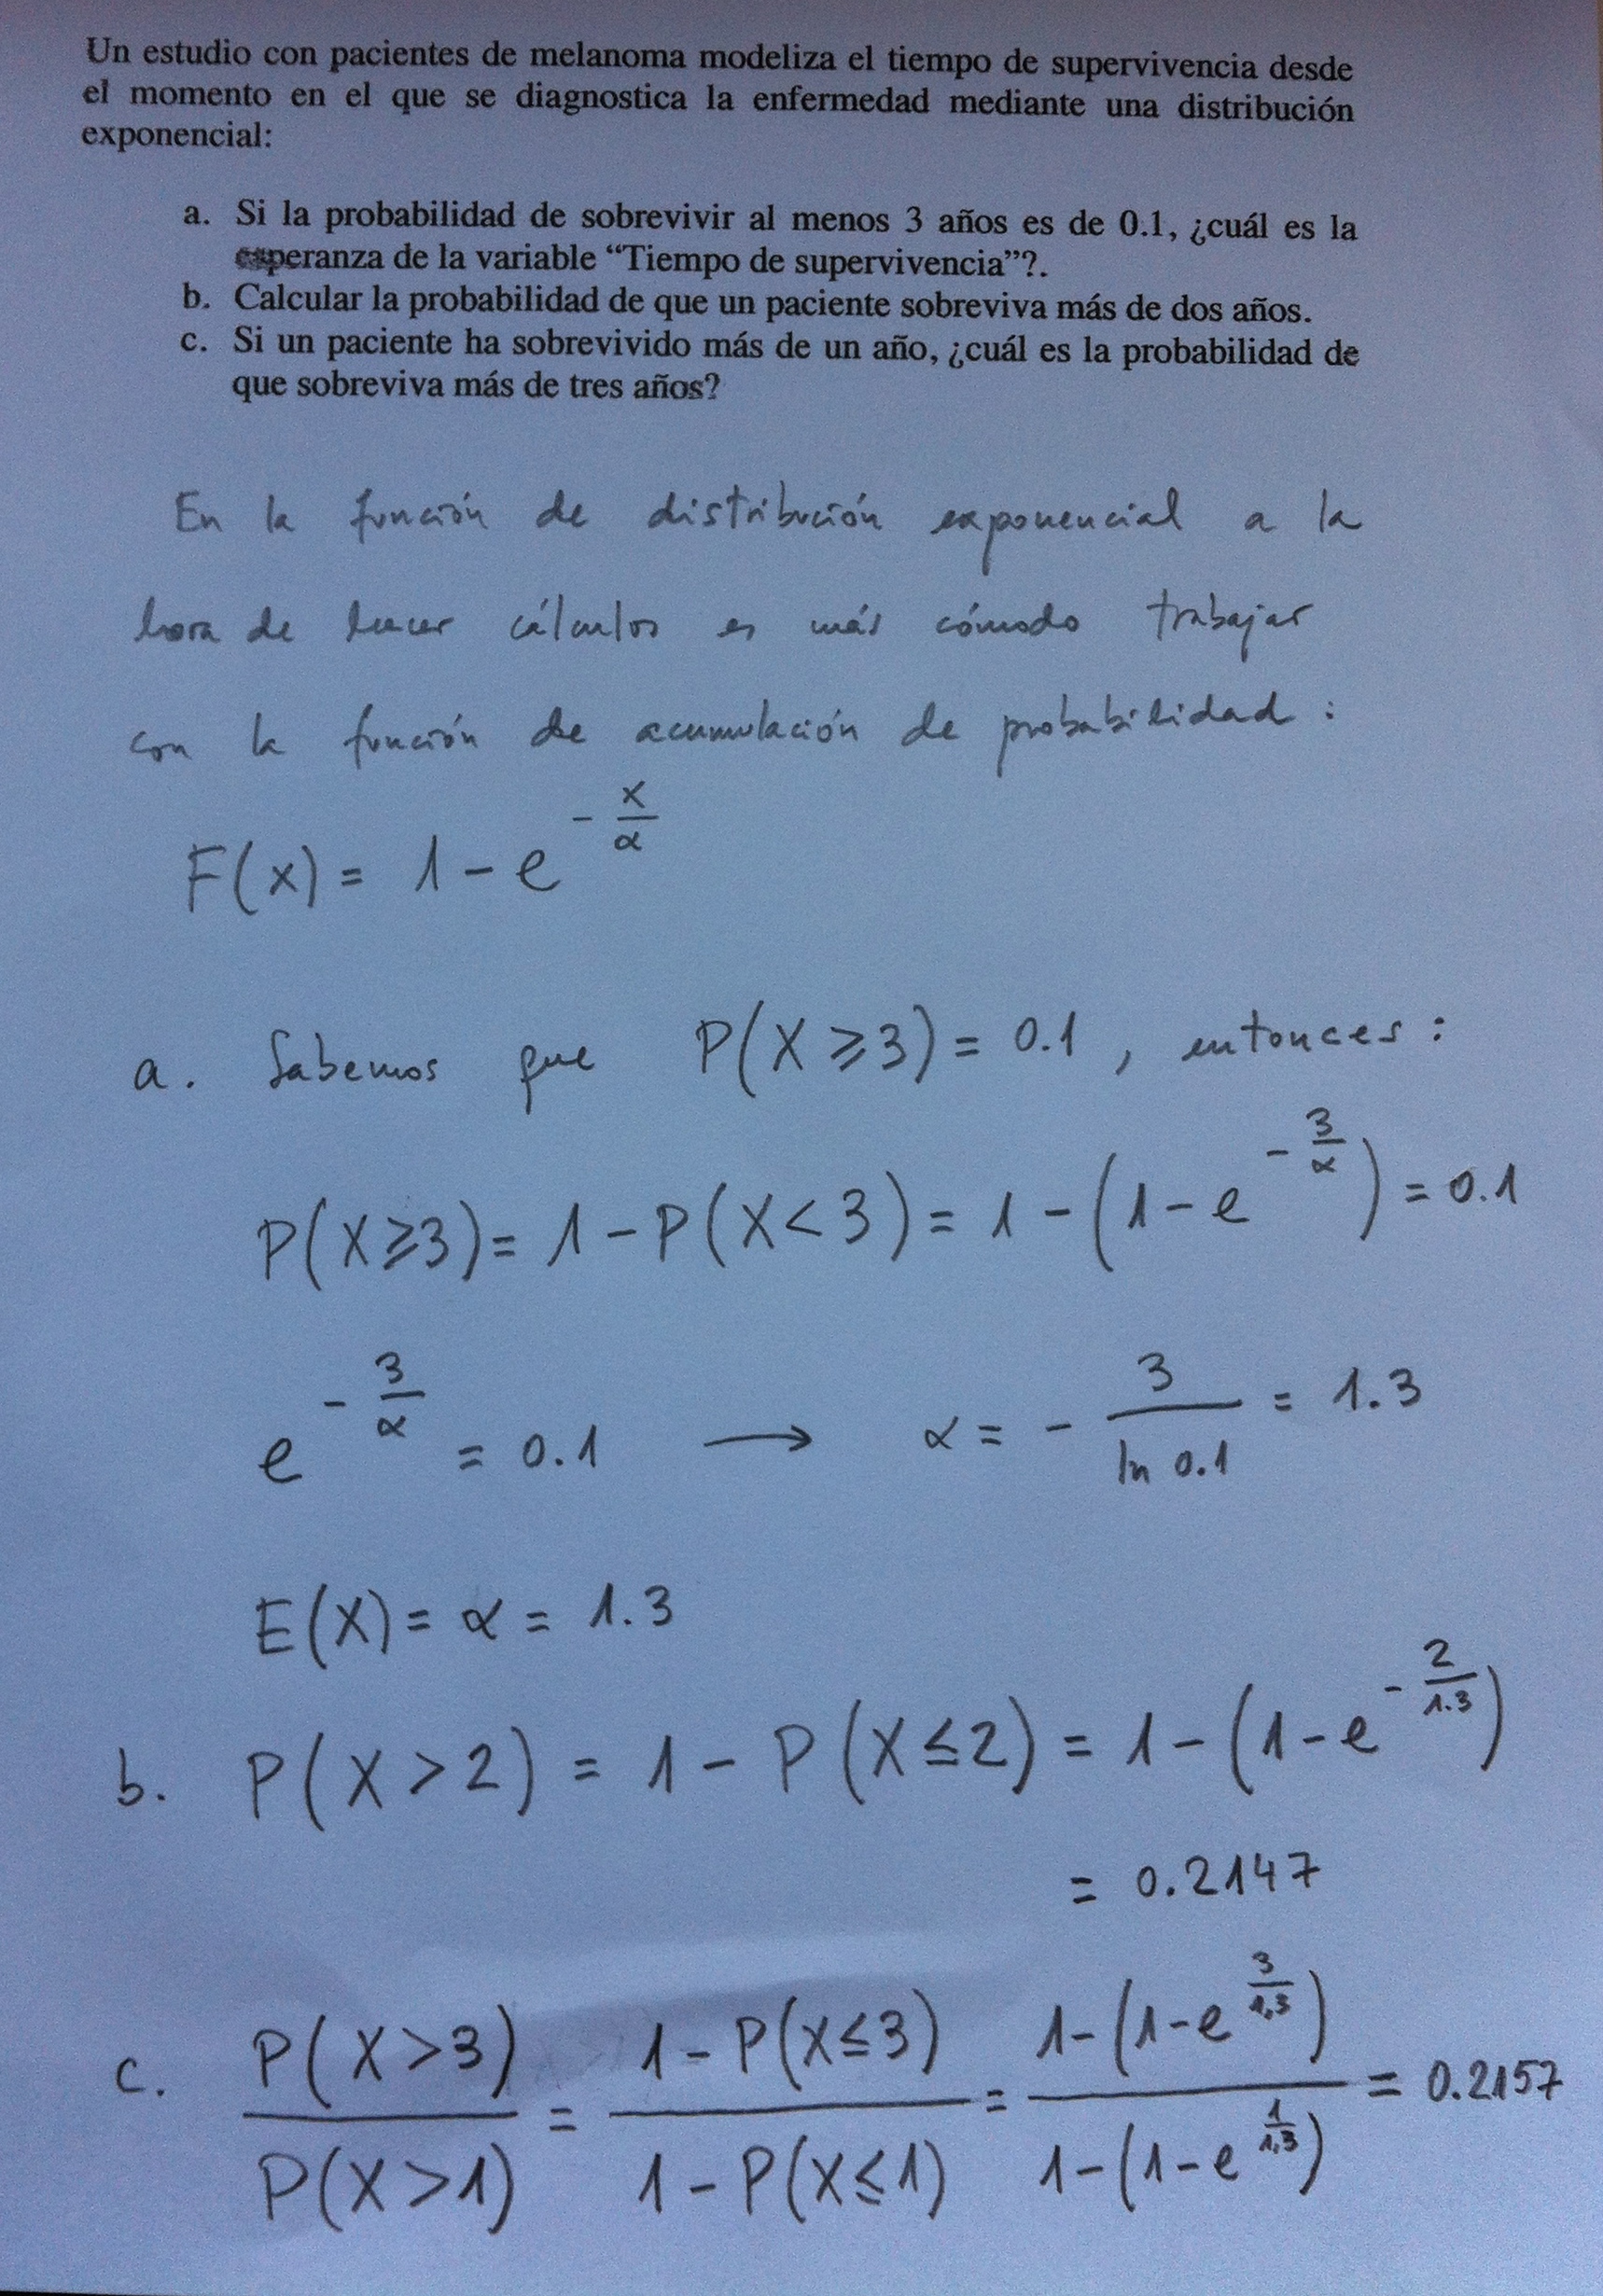
30. Y ahora un caso de aplicación de una distribución Exponencial:

IMG_4565

31. Veamos a continuación dos problemas donde se usa la posibilidad de aproximar una función de distribución por otra función de distribución. Las aproximaciones que usaremos son las vistas en el cuadro descrito en el punto 20. Veremos que en el caso de usar una aproximación de una función Binomial o Poisson mediante una distribución Normal, es recomendable hacer una corrección por aproximación de una distribución discreta por una distribución continua.

IMG_5266

32. Esta corrección por aproximación, como podemos ver en el apartado 2 del problema anterior, es importante. Puede comprobarse, porque esta resuelto sin aplicar y aplicando la corrección, que el resultado cambia sensiblemente. Para entender este concepto pensemos que estamos calculando la probabilidad de que el valor sea igual o superior a 120. Si lo calculamos mediante la distribución Normal calculamos área a partir sólo del 120, dejando el espacio del 119 al 120 como área sin contar. Se suele coger desde la mitad de estos valores para que una mitad vaya a un lado y la otra mitad al otro. Se consiguen así mejores aproximaciones.

33. Veamos el otro problema de aproximaciones de una distribución por otra distribución:

IMG_5267

34. Obsérvese que ahora, como lo que se pide es la probabilidad de ser mayor estricto a 12, la corrección se aplica contando el área a partir de 12, porque en realidad es como si tuviéramos que calcular la probabilidad de que la variable discreta fuera igual o mayor que 13.