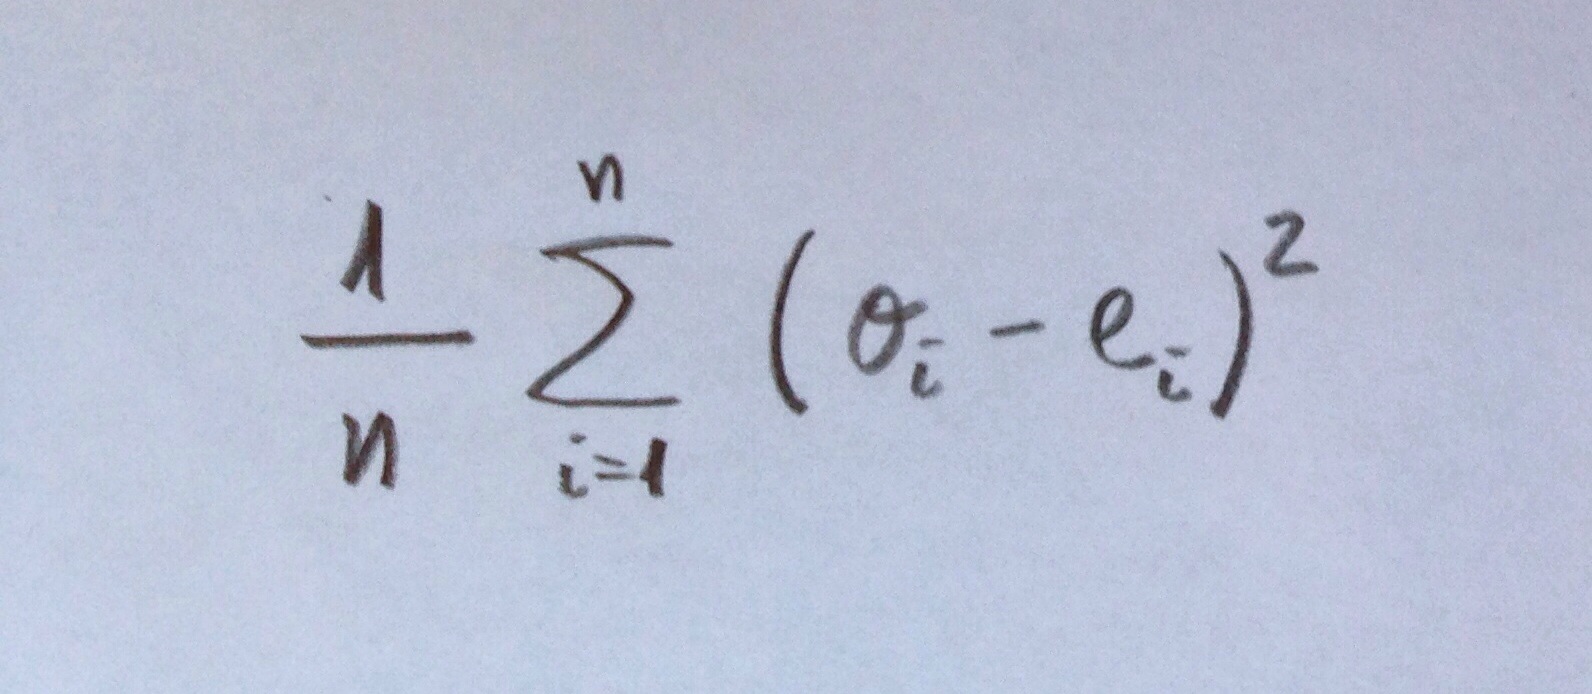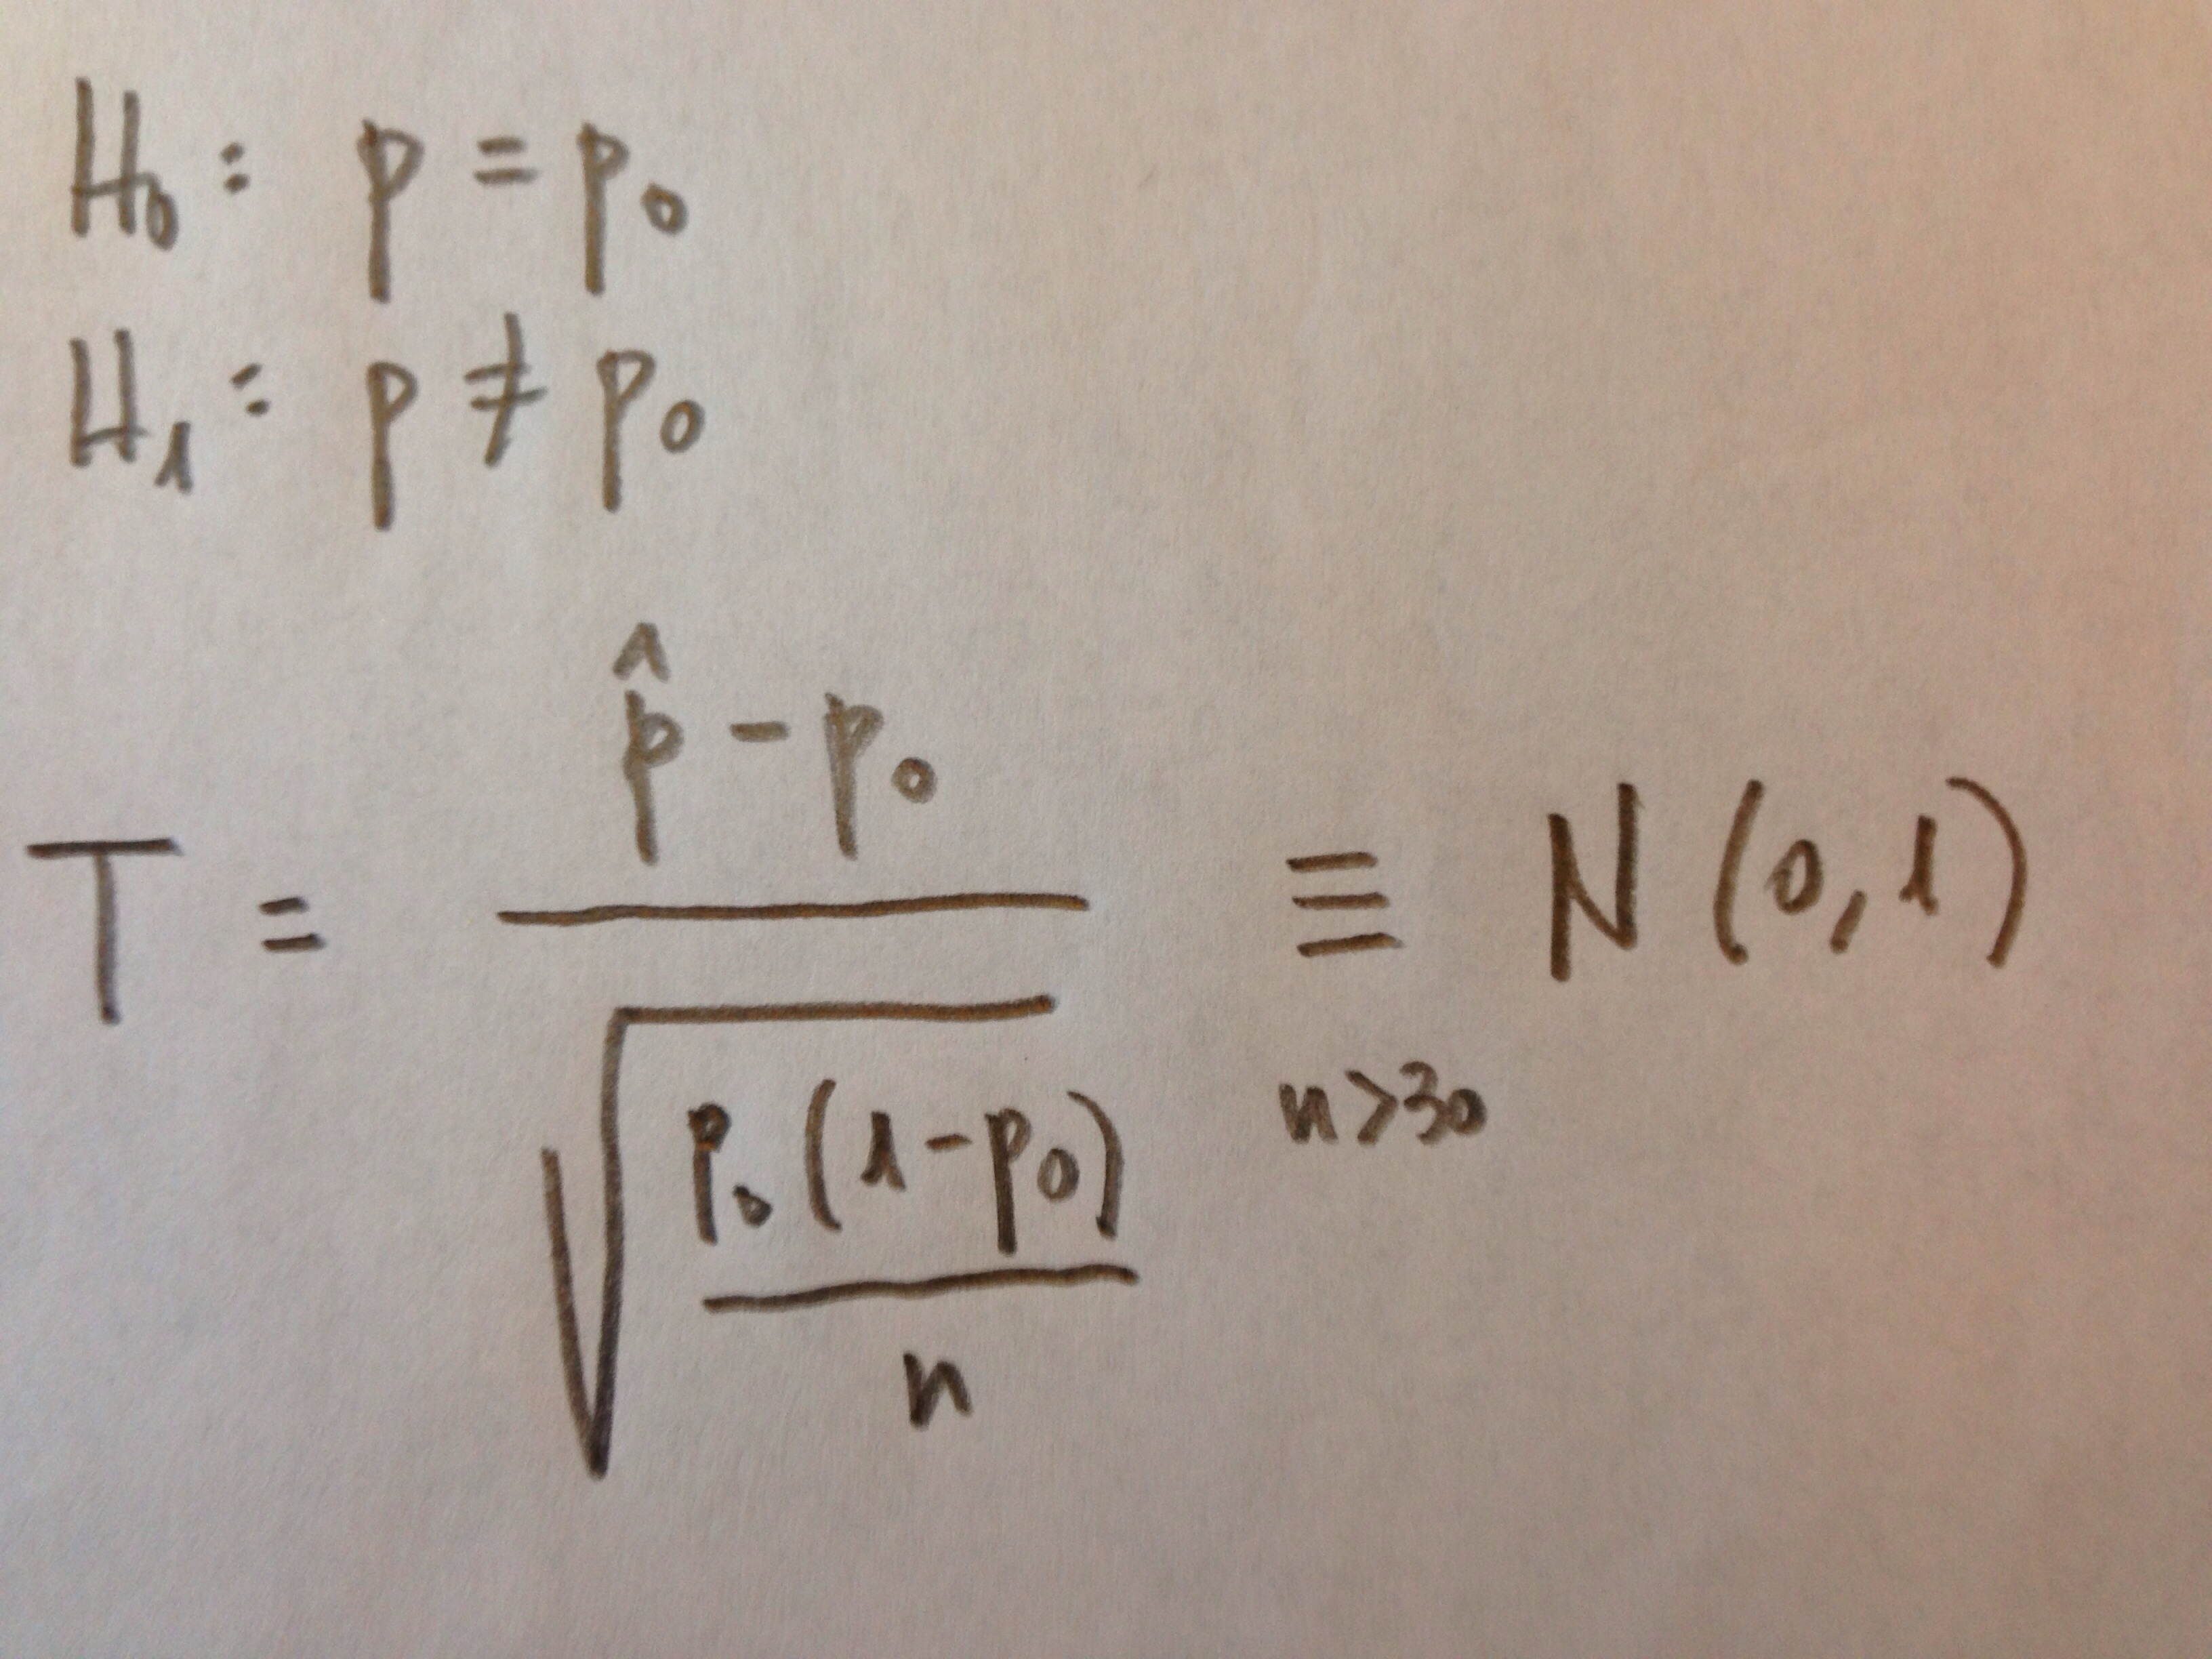Archivo del Autor: estadisticallopis

Solución Situación 63

1c: Como existe ajuste a la distribución normal en ambas muestras, porque el p-valor del Test de Shapiro-Wilk es mayor que 0.05, el siguiente paso será aplicar el Test de Fisher-Snedecor y si éste es menor que 0.05, como dice esta afirmación aplicaríamos el Test de la t de Student de varianzas desiguales.

2a: El tamaño de muestra no necesariamente será menor que 30. Puede ser mayor que 30 y tenerse que aplicar igualmente este Test debido a que el número de valores esperados, por grupo, bajo la Hipótesis nula, sea menor que 5.

Podría plantearse alguna duda sobre la respuesta d: La Hipótesis nula en una comparación de proporciones siempre afirmará, necesariamente, la igualdad de proporciones. Otra cosa será si se aceptará o se rechazará, según los datos muestrales que tengamos, pero esta afirmación estará siempre, necesariamente, presente. En la Hipótesis nula siempre hay igualdad, no relación o ajuste a la distribución normal.

3d: Cuanta mayor dispersión más tamaño de muestra. Porque la Desviación estándar y el tamaño de muestra tienen una relación directa.

Atención con la respuesta c: El radio de un intervalo mantiene una relación inversa con el tamaño de muestra: menor radio precisa más muestra, pero la precisión tiene una relación directa con el tamaño de muestra: más precisión precisa de más muestra. Cuidado con este. El radio de un intervalo es menor cuanta mayor precisión queramos. Por lo tanto, radio y precisión mantienen una relación inversa.

4c: Si un factor en un ANOVA nos ha dado un p-valor superior a 0.05 no tiene sentido hacer unas comparaciones múltiples porque no habremos rechazado la igualdad de los niveles de ese factor. Las comparaciones múltiples únicamente las haremos si hay diferencias, si el p-valor de ese factor es inferior a 0.05.

5b: Si aplicamos la ecuación siguiente:

IMG_4908

el resultado es n=100. Porque DE=10 y r=2. Se pide un intervalo de confianza del 95% que, si la media fuese 50, fuese (48, 52). Esto representa un radio de intervalo de 2.


Situación 63: Examen (Temas 14, 15 y 16)

1. Se está evaluando la satisfacción de pacientes ingresados en un Hospital al ser dados de alta. Se pretende comparar la satisfacción media que muestran los pacientes ingresados en dos departamentos distintos: Medicina interna y Traumatología. Se ha aplicado un Test de Shapiro-Wilk a cada una de las dos muestras. En ambos casos el p-valor es superior a 0.05. ¿Cuál es el siguiente paso a realizar?

a. Debemos aplicar el Test de Fisher-Snedecor para ver si hay que aplicar o no el Test de Mann-Whitney.

b. Debemos aplicar el Test de la t de Student de datos apareados.

c. Debemos aplicar el Test de Fisher-Snedecor y si el p-valor resulta que es inferior a 0.05 aplicar entonces el Test de  la t de Student de varianzas desiguales.

d. Debemos aplicar el Test de Mann-Whitney porque ninguna de las dos poblaciones se ajusta a la distribución normal.

2. En un estudio sabemos que se ha aplicado un Test exacto de Fisher. ¿Qué afirmación no es necesariamente cierta?

a. El tamaño de cada muestra será inferior a 30.

b. Las variables son dicotómicas.

c. Las muestras son independientes.

d. La Hipótesis nula afirma la igualdad de proporciones.

3. ¿Cuál de las siguientes afirmaciones es cierta?

a. En un contraste de hipótesis de comparación de medias lo que diga la Hipótesis nula depende de si nos interesa demostrar la igualdad o la diferencia.

b. Si el p-valor es menor que 0.05 entonces se rechaza la Hipótesis nula excepto en un Test de ajuste a la distribución normal en el que se acepta.

c. Cuanta más precisión queramos tener en un pronóstico, como la precisión es inversamente proporcional al tamaño de muestra necesitaremos menos tamaño de muestra.

d.  Cuanta mayor dispersión tengamos en un estudio de comparación de medias más difícil será rechazar la Hipótesis nula.

4. ¿Cuál de las siguientes afirmaciones no es cierta?

a. El Test de Kruskal-Wallis es apropiado para hacer un ANOVA de un factor cuyos niveles no se ajusten a la distribución normal.

b. La interacción entre dos factores evalúa si los niveles de un factor se comportan  de forma distinta al combinarse con los niveles del otro factor.

c. Las comparaciones múltiples únicamente tiene sentido realizarlas si el p-valor del ANOVA previo es superior a 0.05.

d. En un ANOVA de dos factores anidados no es posible evaluar la interacción entre factores.

5. Se quiere hacer un pronóstico de la media poblacional de la concentración de un determinado neurotransmisor. ¿Qué tamaño de muestra necesitamos tomar para tener un intervalo del 95% que, si la media muestral fuese 50, nos diese un intervalo como el siguiente: (48, 52)?  La Desviación estándar que tenemos en una muestra piloto es de 10:

a. 150.

b. 100.

c. 200.

d. 250.

La modelización matemática en Medicina: Validación, Ajuste, Discriminación, Calibración, Precisión, Reproductibidad, Transportabilidad

La modelización matemática es utilizada con mucha frecuencia en Medicina. Es especialmente usada en Medicina preventiva donde es muy frecuente construir modelos de predicción, modelos para evaluar y cuantificar grados de riesgo.

En todas las revistas médicas vemos con mucha frecuencia modelos matemáticos predictivos. En el día a día, en Medicina, usamos muchos de estos modelos. Por citar sólo unos ejemplos: El Framingham risk score, el EuroSCORE, el APACHE, etc.

Una buena parte de estos modelos, en Medicina, son modelos de Regresión logística. La Regresión logística es, digamos, un modelo matemático extraordinariamente ligado a la Medicina. En Medicina con mucha frecuencia nos preocupa el valor de una variable dicotómica: Muere al año de ser operado el paciente o no. Tiene metástasis a los 5 años o no. Ha tenido un infarto o no. Tiene la presión por encima de 140 ó no. Tiene diabetes o no, etc. Y esta variable dicotómica, digamos variable resultado (en terminología Estadística la solemos denominar «variable dependiente»), queremos ver qué relación, qué asociación tiene con otra u otras variables (variables que en Estadística solemos denominar «variables independientes»).

Relacionar cualquiera de estas variables dicotómicas con alguna o algunas variables es, digamos, consustancial a la labor de la Medicina. Es por esto que el modelo matemático y estadístico más usado en Medicina, de largo, es el de la Regresión logística y los principales usuarios de este tipo de modelos son, evidentemente, también, los médicos.

Ahora bien, un modelo es una maqueta matemática de una realidad. Y como maqueta que es puede ser más o menos próxima a la realidad. Hay buenas modelizaciones y malas modelizaciones. Y, por supuesto, toda una inmensa escala de situaciones intermedias que conviene saber distinguir, evaluar y pesar.

Hay todo un amplio repertorio de conceptos que se manejan habitualmente en la modelización. La intención de este artículo es aclarar un poco este bosque inmenso de conceptos para ver qué significa cada uno de ellos. Nos vamos a centrar, en concreto, a la hora de manejar ejemplos, en la modelización mediante Regresión logística, por ser la más habitual en Medicina, pero todos los conceptos que vamos a ver son extrapolables a la modelización usando cualquier otro modelo y en cualquier campo del conocimiento, evidentemente.

Validación, Validación interna, Validación externa, Ajuste, Discriminación, Calibración, Reproductividad, Transportabilidad son conceptos que aparecen habitualmente en este ámbito generando este bosque conceptual por el que es ciertamente difícil moverse.

Todos estos conceptos conllevan, en definitiva, procedimientos matemáticos y estadísticos distintos con los que evaluar la calidad de una modelización. Vamos a internar ir delimitando, poco a poco, cada uno de estos importantes conceptos.

Como vamos a ver cada uno de estos criterios en un modelo de Regresión logística es importante, en primer lugar, recordar un poco lo que es y representa la modelización mediante este especial tipo de Regresión.

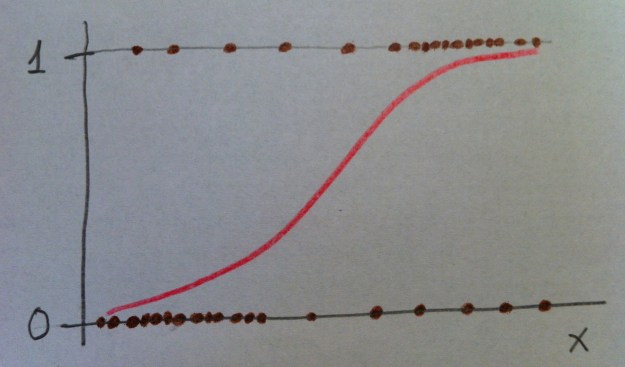
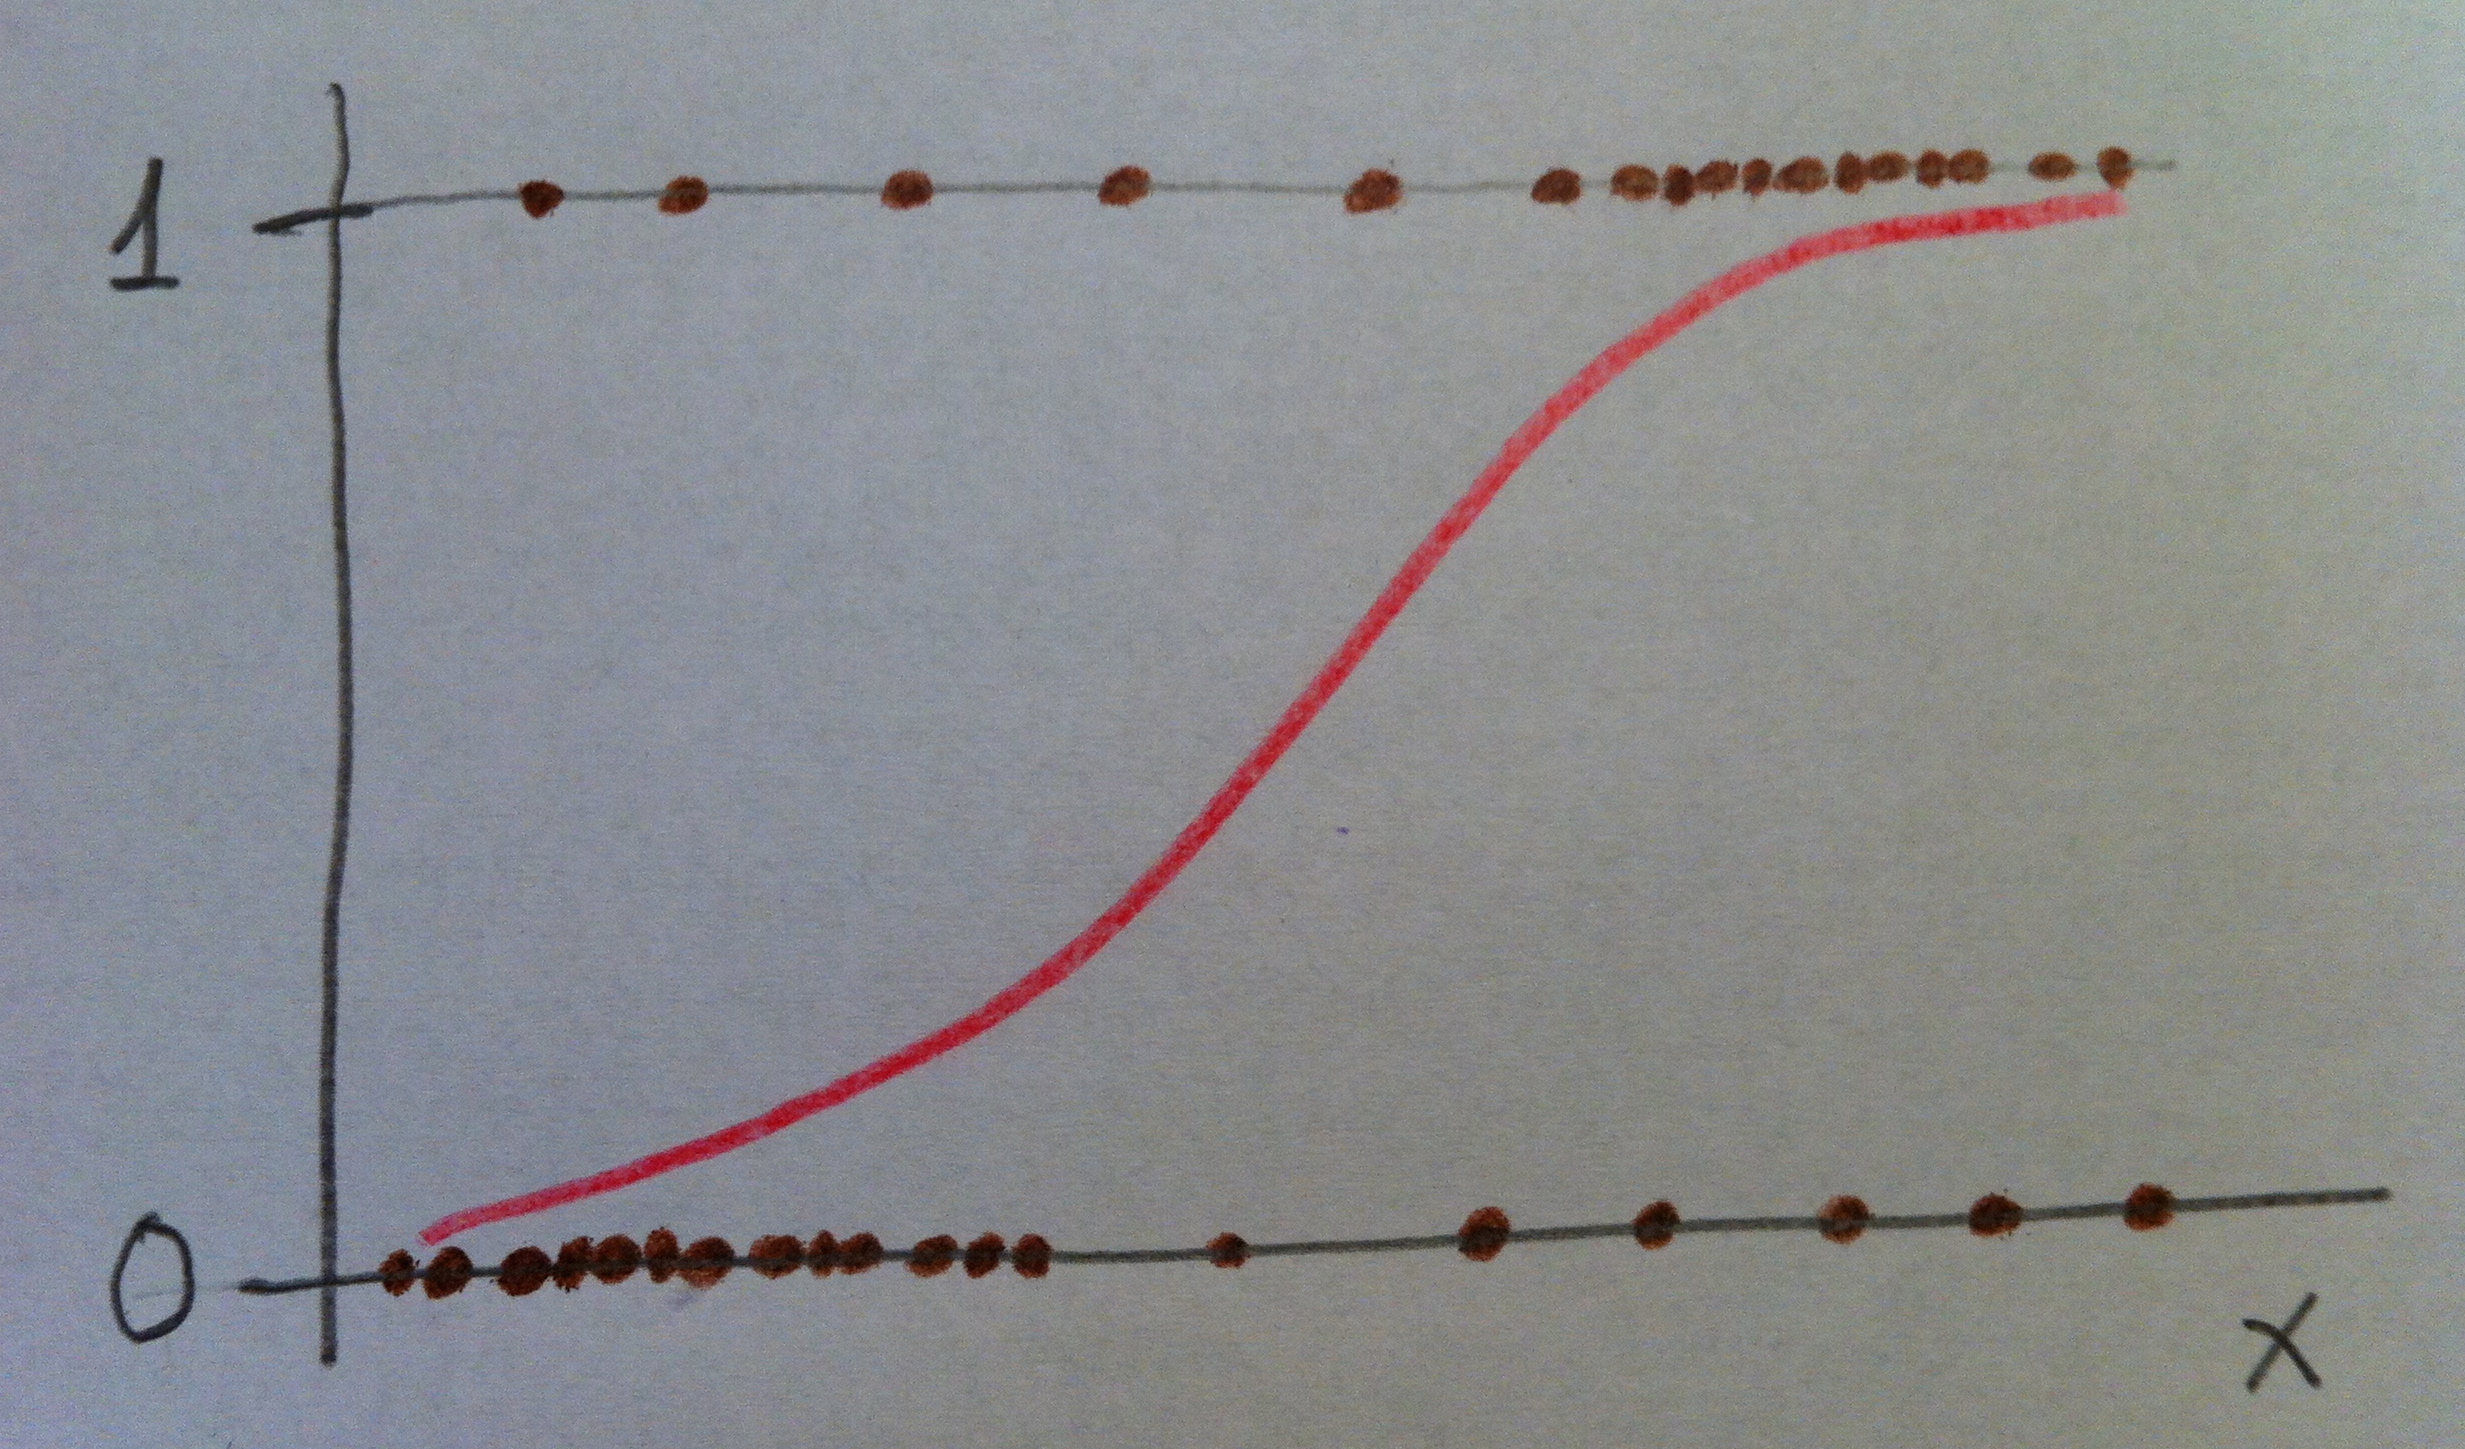
Un modelo de Regresión logística es importante, en primer lugar, que se vea dibujado. Si únicamente tenemos una variable independiente el modelo se dibuja así:
IMG_5243

Observemos que se trata de una variable dependiente codificada con 0 y 1 y una variable independiente x. Los puntos representan los valores concretos de una muestra: lo pacientes. Como la variable dependiente es dicotómica (codificada con 0 y 1), los valores únicamente pueden estar a nivel del 0 ó a nivel del 1.

El modelo construye una curva que se adapte lo más fielmente posible a los datos, que en el dibujo anterior es la curva dibujada en color rojo. Para más detalles puede consultarse, en este blog, el Tema 11: Regresión logística.

Vayamos con los conceptos.

Validación: La validación significa evaluar lo válido, lo correcto, lo firme que es un procedimiento. En el ámbito de la modelización, como estamos dibujando una realidad con materiales tomados de otra realidad (en nuestro caso hablamos de evaluar riesgos en la vida real mediante herramientas tomadas del mundo de las funciones matemáticas), la validación evalúa lo estrecha que es esta representación, lo próximo que es ese dibujo matemático a la realidad que trata de representar.

Validación es, pues, un término muy genérico porque esta evaluación se puede hacer mediante criterios diferentes y mediante procedimientos también muy diferentes. Por lo tanto, como vamos a ver a continuación, la noción de validación va abriéndose a distintos conceptos.

Suele diferenciarse entre Validación interna y Validación externa. Veamos esa importante  distinción:

Validación interna: Cuando esa evaluación se hace con los propios datos de la realidad que te han servido o que has usado para construir el modelo. Se trata, por lo tanto, de ver el grado de conexión que hay entre lo que nos dice el modelo matemático creado y los propios datos usados para construir ese modelo. Por eso se le denomina «interna», porque es respecto a los propios datos usados.

Validación externa: Cuando esa evaluación se hace no con los propios datos usados para construir el modelo sino con otros datos, con otra muestra. Se trata, pues, de una generalización. Aquí no se trata, pues, de evaluar la proximidad del modelo con los datos usados para construirlo, sino, por el contrario, se trata de ensayar, de poner a prueba el modelo para ver si explican también otros valores, si explican una realidad análoga a la representada pero de la que no hemos usado datos a partir de los cuales construir el modelo.

En realidad, estos dos conceptos es en torno a los cuales gira todo lo que estamos explicando aquí, puesto que ahora se trata de ir perfilando los diferentes conceptos que van concretando aspectos diferentes de ese proceso de validación tanto interna como externa.

Ajuste: La noción muy utilizada de Ajuste significa la evaluación de la proximidad de un modelo a una determinada realidad. Por lo tanto, todas las técnicas que evalúan el ajuste de unos datos a un modelo son, en realidad, técnicas de validación. Hemos visto en este blog muchos casos de técnicas de ajuste. Lo hemos visto en distintos momentos y tenemos diferentes ejemplos en el Herbario de técnicas de ese tipo de análisis estadísticos.

Ajustar es ver hasta qué punto hay proximidad entre la realidad y un modelo propuesto. Existen casos en los que basta una técnica de ajuste para poder decir que en gran parte se agota la evaluación de la validez, la evaluación de la proximidad. Esto sucede, por ejemplo, en el ajuste de unos datos a una determinada distribución. Cualquier test de bondad de ajuste a una distribución agota la validación. Al menos la validación interna. El ajuste de la distribución a esos datos. La representatividad, por ejemplo, de la campana de Gauss, como modelo poblacional, a unos datos muestrales concretos, se agota en la misma comprobación. Tiene poca complicación por la sencillez de la situación.

Sin embargo, en modelo más complejos, como el de la Regresión logística, u otro modelo de Regresión en general, la validación, el ajuste, puede evaluarse desde perspectivas distintas. Digamos que existen bastantes dimensiones desde las que abordar el nivel de validez del modelo. Y es aquí, precisamente, donde van surgiendo los diferentes conceptos que vamos a comentar a continuación. Porque una realidad compleja, como la de la modelización de unos datos a un modelo de Regresión logística, puede evaluarse desde perspectivas diferentes, desde ángulos diferentes. Son muchas, por lo tanto, las posibles miradas a hacer.

Tenemos técnicas para evaluar el ajuste. Técnicas como la razón de verosimilitud, el método Wald, etc. Son, éstas, técnicas genéricas, técnicas «todo terreno», que valen para situaciones muy distintas.

Estos métodos de ajuste genéricos son poco finos. Hacen una valoración global. Hacen, digamos, una mirada demasiado desde arriba, desde lejos. Entran poco en detalles. Por eso se han desarrollado nuevos instrumentos en este ámbito que nos han llevado a tener que matizar la noción de Ajuste. En este contexto surgen nociones como las de Discriminación, Calibración y Precisión.

Discriminación: Es una valoración de un aspecto del ajuste. El objetivo básico de una Regresión logística es establecer, dado el valor de una variable independiente, una probabilidad de si aquel individuo tendrá o no tendrá la enfermedad estudiada. Se trata de hacer una previsión en base a la asociación vista en unos datos muestrales.

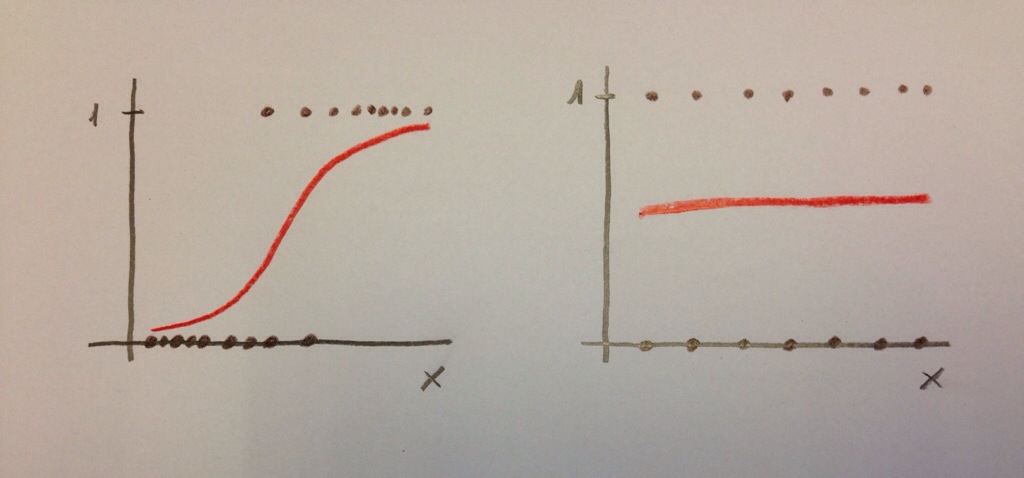
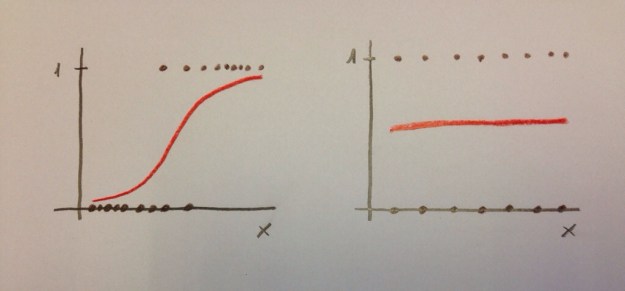
Veamos las dos situaciones extremas siguientes:
20140408-155126.jpg

El modelo de la izquierda nos permite discriminar muy bien. Sin embargo, el modelo de la derecha no nos permite una buena discriminación. En el caso de la izquierda saber el valor de la variable «x» nos permite hacer una buena predicción de la variable dependiente. Ese valor discrimina. En el caso de la derecha el saber el valor de la variable «x» no nos informa. No discrimina.

Es muy habitual evaluar la Discriminación de un modelo de Regresión logística mediante curvas ROC y mediante el Área bajo la curva. Ver el Tema 23: Análisis ROC.

Calibración: Es otra valoración de un aspecto del ajuste. Se trata de evaluar que no haya saltos importantes entre valores observados y valores esperados, entre probabilidades observadas y probabilidades esperadas. Se trata de ver si hay paralelismos entre valores observados y valores esperados en distintos tramos de la variable independiente. Una forma habitual de evaluación de la calibración en Regresión logística es el Test de Hosmer-Lemeshow. Este Test evalúa el equilibrio entre los valores observados y los valores esperados por tramos del modelo. Si en estos diferentes intervalos se mantiene un equilibrio entre el observado y el esperado es que el modelo está calibrado.

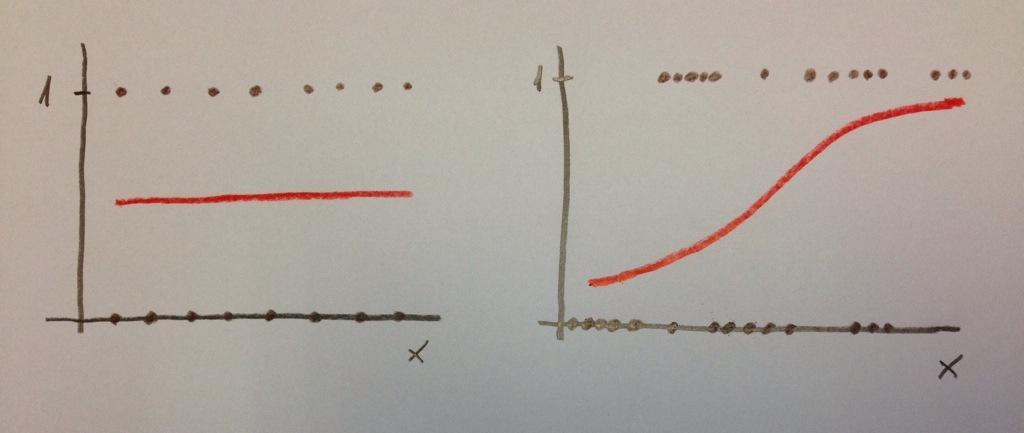
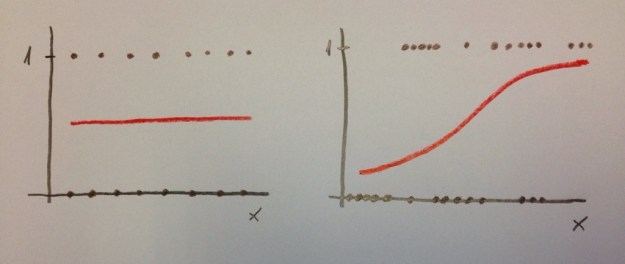
Es importante distinguir entre Discriminación y Calibración. Porque podemos tener un modelo con buena calibración pero mala discriminación y podemos tener, también, por el contrario, un modelo con bastante buena discriminación y muy mala calibración. Veamos las dos siguientes situaciones:
20140408-160245.jpg

En el caso de la izquierda tenemos una muy buena calibración. Los esperados y los esperados van a coincidir perfectamente, pero la discriminación es inexistente. En el caso de la derecha sucede justo lo contrario: tenemos una aceptable discriminación pero la calibración es mala. En distintas zonas de la variable independiente los valores observados y los esperados van a tener amplias diferencias. Lo que indica que el modelo no está bien calibrado.

La Calibración tiene este problema. Que valora digamos el equilibrio en la disposición por un lado de las probabilidades según el modelo y los valores reales, que serán, evidentemente, ó 1 ó 0. La realidad, sólo da esos valores, el modelo da probabilidades. Para penetrar mejor en el ajuste, para mirar con más precisión, con una lente más potente, hay que introducir la noción de Precisión.

Precisión: Es una cuantificación del grado de aproximación de estos observados y esperados en un modelo. Es, de hecho, un complemento a la Calibración ofrecida de forma original por el Test de Hosmer-Lemeshow. El Score de Brier es uno de esos cuantificadores de la Precisión. Es un cálculo que evalúa, no por sectores, por intervalos, sino valor a valor, la distancia entre los valores observados (1 ó 0, evidentemente) y la probabilidad asignada por el modelo. Este Score, por lo tanto, no evalúa el equilibrio de observados y esperados por sectores, por intervalos, sino que evalúa distancias entre valores observados y probabilidades esperadas bajo el modelo.

El Score de Brier es el siguiente cálculo:
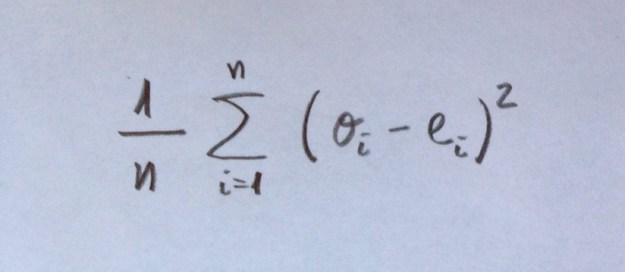
20140409-175330.jpg

En cada uno de los n valores muestrales se resta cada observado (0 ó 1) del valor esperado que es el valor de la función dibujada en rojo para cada punto.

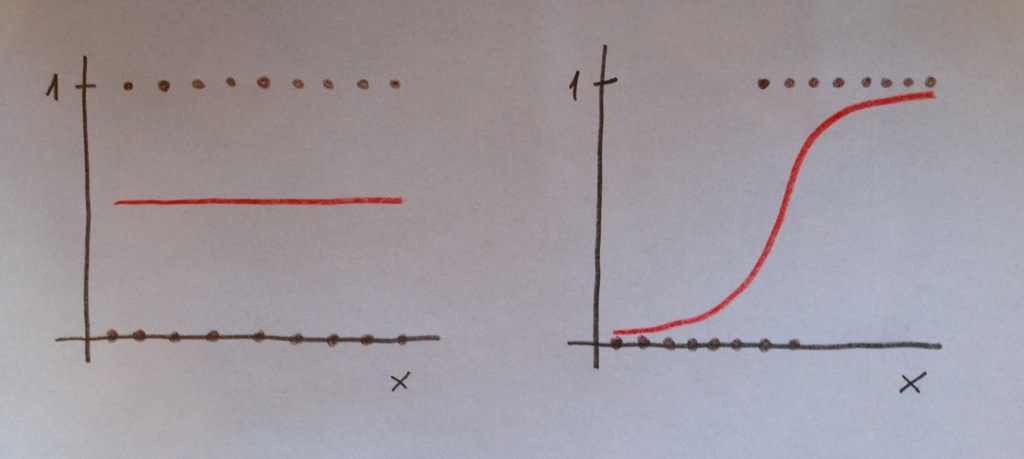
Observemos cómo el cálculo de este Score de Brier nos dará valores bien distintos entre las dos siguientes modelizaciones:

20140409-175247.jpg

Estos dos modelos, si atendemos puramente a la Calibración evaluada mediante, por ejemplo, el Test de Hosmer-Lemeshow, son dos modelos calibrados. Porque si observamos diferentes intervalos de la variable independiente «x», los valores observados y esperados están muy próximos. Sin embargo, para el Score de Brier los valores serían muy diferentes. En el caso de la izquierda todos los valores esperados serían 0.5 y los observados serían 0 ó 1, lo que daría restas muy grandes. Sin embargo, a la derecha veamos que las probabilidades de los puntos con valores bajos de la variable «x» darían probabilidades muy pequeñas (porque el valor de la curva roja, la curva de la Regresión logística, nos da probabilidades de ser 1) y como en este espacio los observados son 0 esas restas darán valores pequeños. Cuando la variable «x» tenga valores grandes las probabilidades serán próximas a 1 y los valores observados serán 1, lo que nos dará, de nuevo, restas pequeñas.

Por lo tanto, el Score de Brier nos mide la precisión, la proximidad entre los pronósticos y los valores reales evaluado puntualmente; o sea, valor a valor, no intervalo a intervalo como hace la Calibración.

La Discriminación, Calibración y Precisión son, como puede verse, distintos criterios de ajuste. Es bueno que se den las tres cosas: Que el modelo discrimine bien, que esté bien calibrado y que sea preciso. Por eso es necesario evaluar cosas diferentes. Con una única evaluación nos podríamos encontrar con una deficiente evaluación.

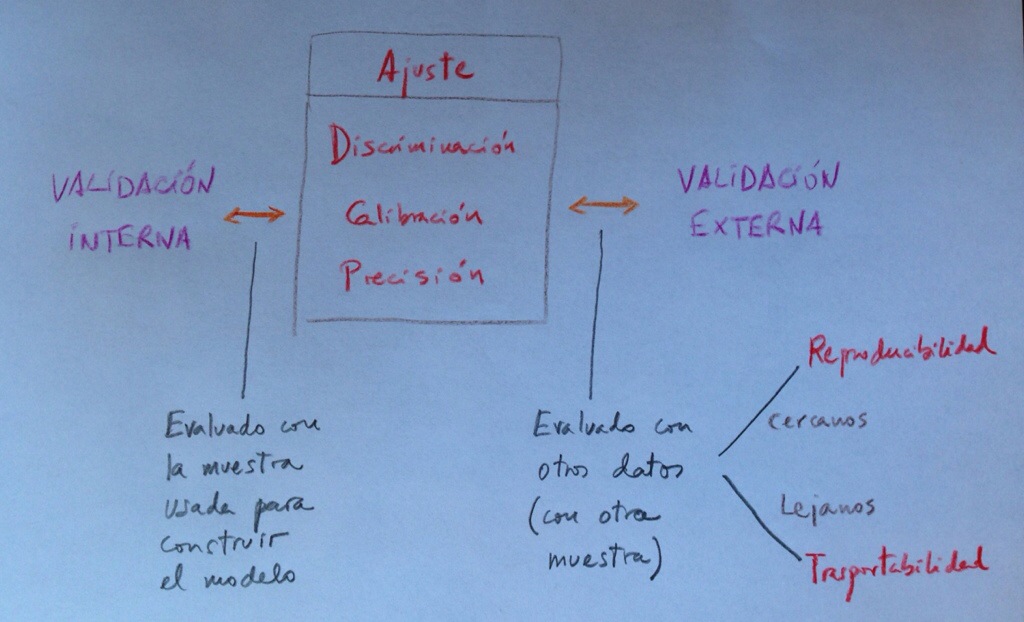
Cuando el Ajuste, la Discriminación, la Calibración o la Precisión la evaluamos con la propia muestra utilizada para construir el modelo estamos haciendo una Validación interna.

Cuando el Ajuste, la Discriminación, la Calibración o la Precisión la evaluamos con una muestra diferente a la utilizada para construir el modelo estamos haciendo una Validación externa. El grado de alejamiento de esta muestra diferente, respecto a la muestra original, nos lleva a dos ámbitos de la Validación externa que ahora vamos a delimitar: la Reproducibilidad y la Transportabilidad.

Reproducibilidad: Con este concepto evaluamos el grado de validez de un modelo a la hora de ser aplicados a una muestra que no es la tomada para construir el modelo. Pero, eso sí, se trata de una muestra tomada en un contexto análogo al de la muestra original. Supongamos, por ejemplo, que la muestra base ha sido tomada entre pacientes de un hospital de una determinada ciudad. Pues, si lo ensayamos con pacientes de otro hospital de un nivel análogo al anterior, y de la misma ciudad, estaremos evaluando el grado de Reproducibilidad de nuestro modelo.

Una forma habitual de Reproducibilidad es hacer lo que suele denominarse una Validación cruzada (Cross-Validation). Consiste en crear, en una muestra, un subgrupo para construir el modelo y otro subgrupo distinto para validar el modelo construido. Suele hacerse diversas veces este procedimiento, en una misma muestra. Suele, entonces, denominarse una Validación cruzada con k iteraciones (k-fold Cross-Validation). Este procedimiento consiste en dividir la muestra en k subgrupos. Entonces se realiza k veces esta operación de construir el modelo con un subgrupo y validarlo con otro subgrupo. Cada una de estas veces es uno de esos k grupos el usado como grupo de validación y el resto de valores de la muestra es usado para construir el modelo.

El bootstrap es una forma habitual de trabajar a este nivel. El bootstrap es un procedimiento que genera submuestras a partir de la muestra. Una muestra es transformada en población y de ella, aleatoriamente se toman muestras del tamaño deseado.

Observemos que en cualquiera de estos procedimientos comentados nos estamos moviendo dentro de un mismo ámbito. Estamos intentando ver si la modelización hechas con una muestra sigue siendo válido con una muestra distinta aunque tomada en el mismo contexto que la muestra con la que se ha construido el modelo.

Transportabilidad: Con este concepto evaluamos, ahora, el grado de validez, el grado de proximidad, de un modelo, con todas las dimensiones vistas (Ajuste, Discriminación, Calibración, Precisión), a la hora de ser aplicado a un grupo de individuos distinto al grupo base del estudio. Ahora es otro país, otro ámbito distinto, la fuente de la muestra. Es, pues, un grado superior de generalización que el ofrecido por la Reproducibilidad.

Ahora estamos buscando el grado de inferencia a distancia: una distancia que puede ser temporal, territorial, etc.

En la Reproducibilidad y la Transportabilidad hay grados diferentes. Es un continuo. Y es de elevada complejidad saber el nivel de generalización en el que podemos situar una determinada Validación externa.

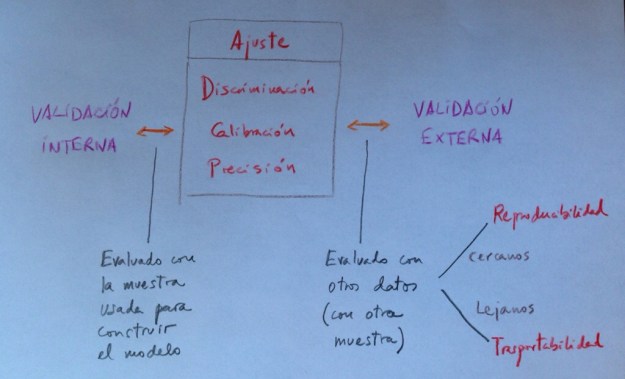
El siguiente cuadro puede constituir un resumen de todo lo visto:
20140409-184404.jpg

Obsérvese que este esquema intenta plantear una visión global de todo lo visto.

Los siguientes puntos resumen, también, todo lo dicho:

1. La Validación es la búsqueda del grado de proximidad entre modelo y realidad.

2. La Validación puede ser interna (si se evalúa la proximidad entre el modelo construido y los propios datos empleados para construir el modelo) o externa (si se evalúa la proximidad entre el modelo y otros datos que no sean los usados para su construcción).

3. Ajuste, Discriminación, Calibración y Precisión son distintas miradas, distintas perspectivas desde donde evaluar la Validación. Por lo tanto, son herramientas con las que valorar el grado de proximidad entre modelo y realidad.

4. Ajuste, Discriminación, Calibración y Precisión son aplicables tanto en la Validación interna como en la Validación externa. La diferencia entre estos dos tipos de Validación está en qué datos son los usados para evaluar la proximidad, pero las técnicas para hacerlo son exactamente las mismas.

5. La Validación interna es una: la evaluación de la proximidad entre realidad y modelo sólo se realiza con la muestra que se ha usado para estimar el modelo. La Validación externa, por el contrario, es mucho más compleja y multidimensional: se han propuesto distintas formas para hacerla, según sea esa otra muestra usada para el ajuste. Es por eso que se habla de la Reproducibilidad y de la Transportabilidad, incluso de distintos tipos dentro de ellos, lo que le dota de un carácter más controvertido y complejo.
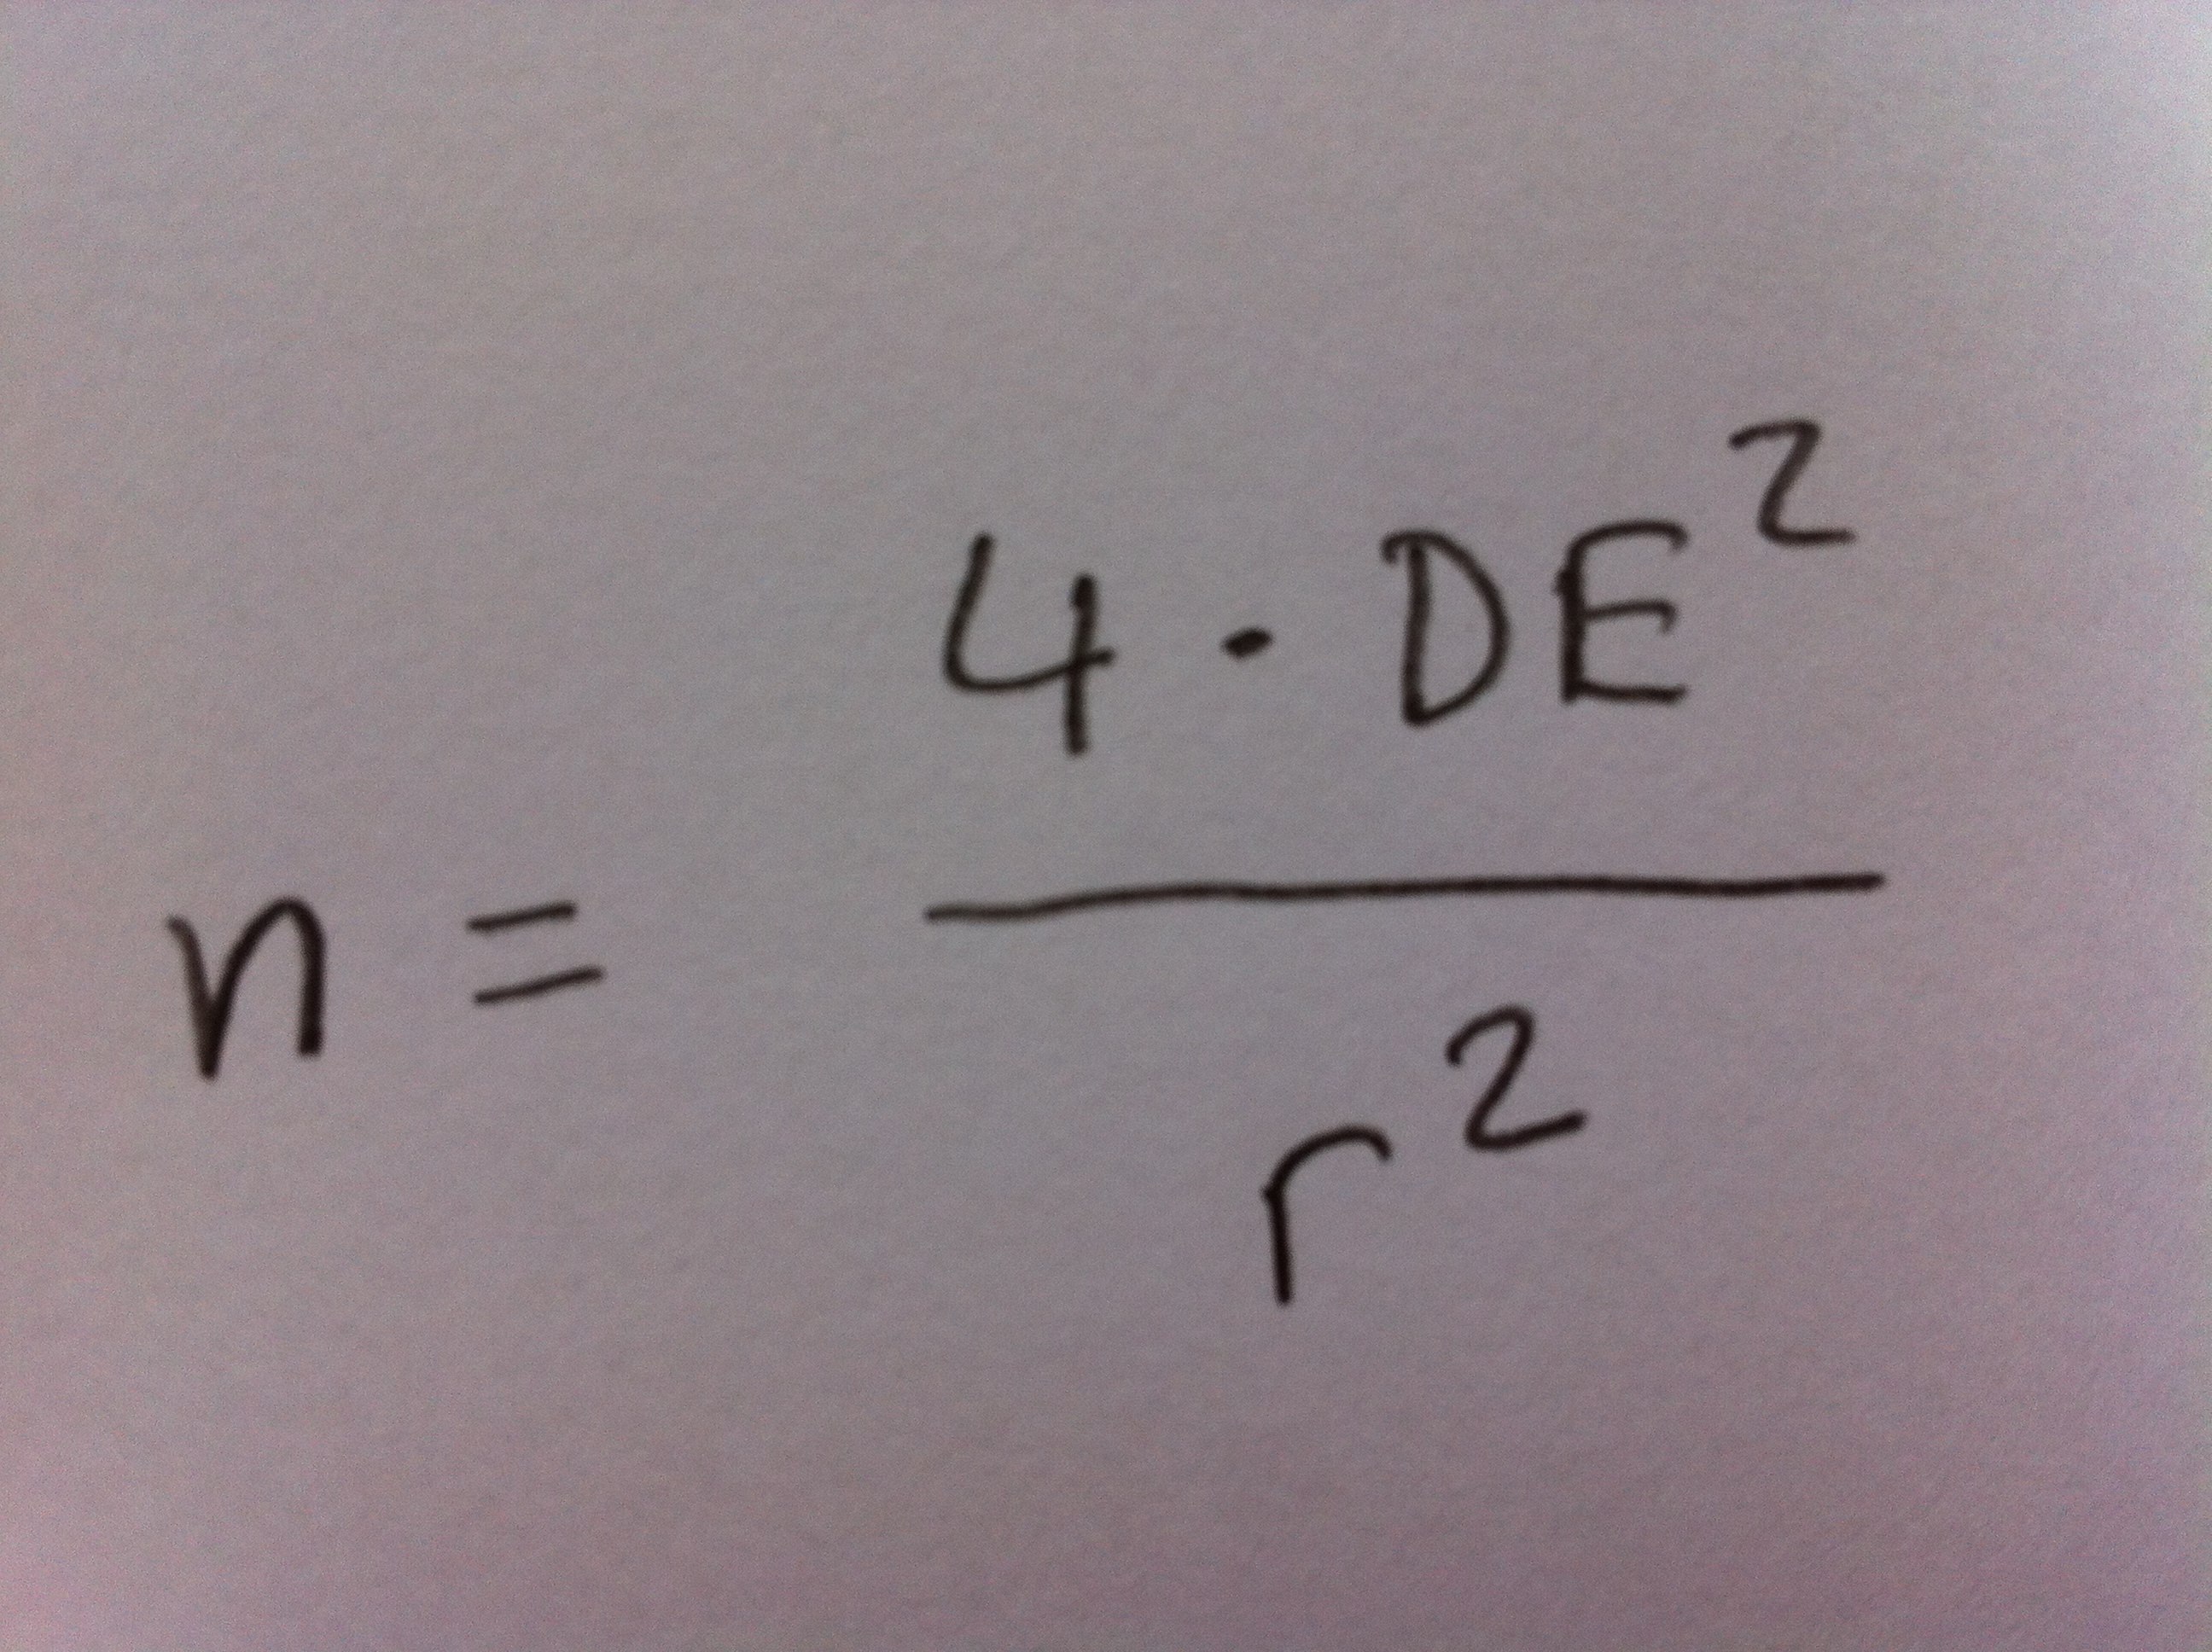
Solución Situación 62

SOLUCIONES:

1. ¿Hay diferencia, estadísticamente significativa, a nivel basal (a los 0 años), en cuanto al nivel de enfermedad entre los dos grupos (el grupo Placebo y el grupo Tratamiento)?

La variable del Mini-Mental es continua, las muestras que debemos comparar aquí (las dos muestras basales de los 0 años) son independientes. Debemos comprobar el ajuste a la normalidad de cada una de las dos muestras. El Test de Shapiro-Wilk nos da un p-valor de 0.0382 para el grupo Placebo a los 0 años y un p-valor de 0.3162 para el grupo Tratamiento a los 0 años. Como no se cumple que ambas muestras se ajustan a la distribución normal debemos aplicar el Test de Mann-Whitney. Este test nos da la siguiente salida de ordenador:

IMG_8963

No hay diferencias entre las medianas (p=0.3139). Aunque tengamos una mediana de 18 y otra de 19 estas diferencias no son estadísticamente significativas. Podemos, aceptar, pues, que estamos ante dos grupos homogéneos.

Este es un test metodológicamente muy importante en muchos estudios en ciencias de la salud. La finalidad es comprobar que partimos de dos grupos homogéneos, de dos grupos con el mismo nivel de demencia.

2. ¿Hay una pérdida, estadísticamente significativa, en el grupo Tratamiento, en los dos años?

De nuevo variables continuas pero ahora muestras relacionadas. Debemos, pues, comprobar la normalidad de la variable Resta del grupo Tratamiento. El Test de Shapiro-Wilk, en este caso, nos da un p-valor de 0.0008, por lo tanto, como no hay ajuste a la distribución normal, debemos aplicar o el Test de Wilcoxon o el Test de los signos para evaluar si hay diferencias estadísticamente significativas. La salida de ordenador del Test de Wilcoxon es la siguiente:

IMG_8961

El p-valor es de 0.000001. Observemos que la salida de ordenador nos da un p-valor de 0.0001E-2 que significa 0.0001 multiplicado por 10 elevado a menos 2 (o sea, multiplicado por 0.01). Hay, pues, diferencias significativas en los dos años.

La salida de ordenador del Test de los signos es:

IMG_8962

El p-valor también nos indica que hay diferencias significativas.

Por lo tanto, en los dos años hay una pérdida significativa de la capacidad cognitiva de estos pacientes del grupo tratamiento. Una pérdida que puede resumirse mediante una mediana de 2, como puede verse en la salida de ordenador.

3. ¿Hay una pérdida, estadísticamente significativa, en el grupo Control, en los dos años?

De nuevo variables continuas y muestras relacionadas. Debemos, pues, comprobar la normalidad de la variable Resta del grupo Placebo. El Test de Shapiro-Wilk, en este caso, nos da un p-valor de 0.0782, por lo tanto, como hay ajuste a la distribución normal, podemos aplicar el Test de la t de Student de datos apareados para evaluar si hay diferencias estadísticamente significativas. La salida de ordenador es la siguiente:

IMG_8960

El p-valor nos indica que hay una pérdida significativa del nivel cognitivo. Una pérdida que puede resumirse mediante la media: 3.9. La media de las pérdidas individuales es de 3.9.

4. ¿Hay diferencia, estadísticamente significativa, entre los dos grupos (Placebo y Tratamiento) en cuanto a la variable Resta; o sea, la variable Mini-Mental a 0 años-Mini-Mental a 2 años?

La variable Resta es continua, y, evidentemente, se trata de muestras independientes, hemos visto, en los apartados 2 y 3, que una no se ajusta a la distribución normal y la otra sí (p-valores del Test de Shapiro-Wilk de 0.0008 y de 0.0782, respectivamente). Esto nos obliga a trabajar con el Test de Mann-Whitney, cuya salida de ordenador, para estos datos, es la siguiente:

IMG_8964


El p-valor del Test de Mann-Whitney es 0.0002, lo que nos indica que hay diferencias significativas entre las pérdidas de Mini-Mental (las variables Resta de cada uno de los dos grupos) en esos dos grupos comparados.

Por lo tanto, estamos ante un tratamiento que, desde el punto de vista estadístico, consigue una reducción significativa en la evolución de la demencia.

5. ¿Hay diferencia, estadísticamente significativa, entre ambos grupos, en cuanto al porcentaje de los pacientes que en los dos años el descenso del valor individual es superior o igual a 6?

Se trata de una variable, ahora, dicotómica y se trata, también, de muestras independientes. La duda está en si aplicar el Test de proporciones o el Test exacto de Fisher.

En el grupo Placebo hay 3 casos, entre los 30, con una pérdida de valor del Mini-Mental igual o superior a 6. En el grupo Tratamiento hay 1 caso únicamente entre los 30. Como el valor esperado bajo la Hipótesis nula es de 2 por grupo, que es menor que 5, conviene aplicar un Test exacto de Fisher. Si se aplica este test el p-valor resulta ser 0.612, lo que nos obliga a mantener la Hipótesis nula de igualdad de proporciones entre los dos grupos. Por lo tanto, las diferencias entre las proporciones muestrales de pacientes que pierden 6 ó más unidades del Mini-Mental en los dos grupos (Placebo y Tratamiento) son diferencias no estadísticamente significativas.

La salida de ordenador del Test exacto de Fisher es la siguiente:

IMG_8983

El p-valor es 0.612, lo que nos indica que no se trata de una diferencia estadísticamente significativa.

Test de una proporción


En ocasiones se requiere contrastar la hipótesis de que la proporción en una población, de una variable dicotómica, es un cierto valor concreto.

El Test de una proporción es el clásico test para esta situación. Es un test que se basa en la aproximación de una distribución binomial a una distribución normal.

El Test es el siguiente:

20140418-185639.jpg

 Veamos el siguiente ejemplo: Supongamos que queremos comprobar si una moneda tiene un desequilibrio. Aplicaríamos este contraste con po =0.5. Por lo tanto, la Hipótesis nula afirma que p=0.5. Supongamos que en un muestreo de 100 lanzamientos de esa moneda han salido 65 caras y 35 cruces. Si calculamos el valor del estadístico T es 3 ó -3 según miremos las caras o las cruces del muestreo. Como en una normal N(0, 1) la zona de rechazo de la hipótesis nula está a la derecha de 1.96 y a la izquierda de -1.96, para un nivel de significación del 0.05, podemos rechazar tal hipótesis. El p-valor es menor que 0.05. Debemos rechazar la hipótesis de equilibrio.

Si, por el contrario, en el muestreo salen 55 caras y 45 cruces el valor del estadístico T es 1 ó -1, lo que nos llevaría a no poder rechazar la hipótesis nula.


Situación 62: Práctica (Tema14)

Se ha realizado un estudio clínico con pacientes diagnosticados de Alzheimer. Se ha ensayado un tratamiento que intenta frenar el proceso de la demencia progresiva. Para ello se han seleccionado un grupo de 60 pacientes con esta enfermedad. De forma aleatoria se reparten estos pacientes en dos grupos de 30 pacientes cada uno. Durante 2 años a uno de los grupos se les da un tratamiento experimental y al otro grupo se les da un placebo. El estudio es a doble ciego. La variable estudiada para evaluar el nivel cognitivo del paciente era el Mini-Mental.

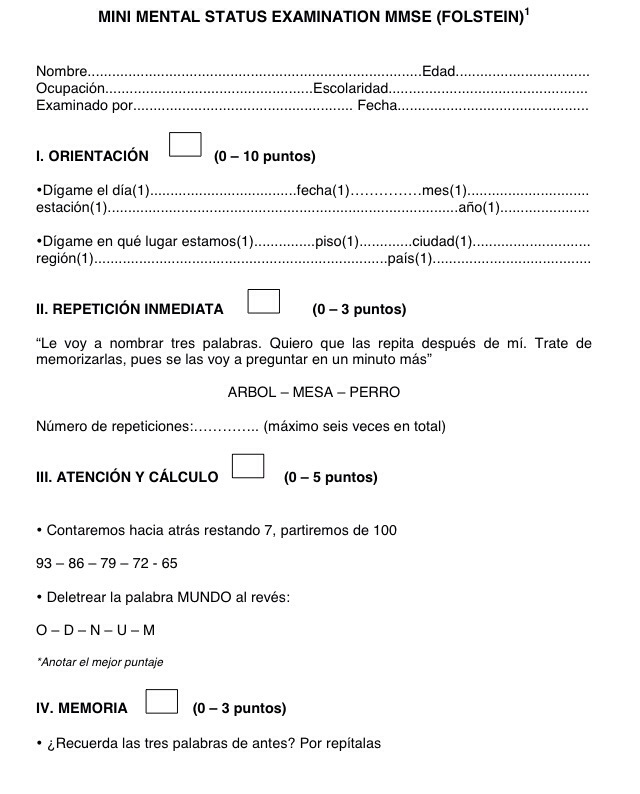
El Mini-Mental es una evaluación numérica del nivel cognitivo obtenido mediante una encuesta validada que es la siguiente:

20140410-233409.jpg

20140410-233419.jpg

A continuación se aporta la base de datos con los valores basales (0 años) y los valores a los 2 años de tratamiento:

GPlacebo0a=Grupo Placebo a nivel basal (a los 0 años).

GPlacebo2a=Grupo Placebo a los 2 años.

RestaP=Resta GPlacebo0a-GPlacebo2a.

GTratamiento0a=Grupo Tratamiento a nivel basal (a los 0 años).

GTratamiento2a=Grupo Tratamiento a los 2 años.

RestaT=Resta GTratamiento0a-GTratamiento2a.

GPlacebo0a GPlacebo2a RestaP GTratamiento0a GTratamiento2a RestaT
18 14 4 17 15 2
21 16 5 20 18 2
17 13 4 21 19 2
15 12 3 23 19 4
18 13 5 22 20 2
15 12 3 19 18 1
16 14 2 19 17 2
18 14 4 18 17 1
21 16 5 20 16 4
23 17 6 15 12 3
22 21 1 16 14 2
21 18 3 18 16 2
19 13 6 21 20 1
18 14 4 20 18 2
18 13 5 16 15 1
16 13 3 16 13 3
18 13 5 23 21 2
18 11 7 24 22 2
16 13 3 22 18 4
19 18 1 19 13 6
20 15 5 18 17 1
15 13 2 17 15 2
16 12 4 17 13 4
18 15 3 19 16 3
21 16 5 17 14 3
23 19 4 16 14 2
15 14 1 19 14 5
16 12 4 20 19 1
18 13 5 15 14 1
19 14 5 19 18 1

Se pide:

1. ¿Hay diferencia, estadísticamente significativa, a nivel basal (a los 0 años), en cuanto al nivel de enfermedad entre los dos grupos (el grupo Placebo y el grupo Tratamiento)?

2. ¿Hay una pérdida, estadísticamente significativa, en el grupo Tratamiento, en los dos años?

3. ¿Hay una pérdida, estadísticamente significativa, en el grupo Control, en los dos años?

4. ¿Hay diferencia, estadísticamente significativa, entre los dos grupos (Placebo y Tratamiento) en cuanto a la variable Resta; o sea, la variable Mini-Mental a 0 años-Mini-Mental a 2 años?

5. ¿Hay diferencia, estadísticamente significativa, entre ambos grupos, en cuanto al porcentaje de los pacientes que en los dos años el descenso del valor individual es superior o igual a 6?

Aplicación del Test de Hosmer-Lemeshow en Medicina

La Regresión logística es uno de los modelos matemáticos más usuales en Medicina. Un modelo no puede aplicarse así, sin más, porque se suela hacer. Un modelo puede usarse siempre y cuando haya un buen ajuste. Usar un modelo sin ajustarlo previamente es actuar a ciegas y esto es grave en ciencia.

El Test de Hosmer y Lemeshow es un test de bondad de ajuste de unos datos a un modelo de Regresión logística. Y como la Regresión logística es muy usual en Medicina este Test es un muy importante Test en Medicina.

Un Test de bondad de ajuste, en general, lo que hace es comprobar si el modelo propuesto puede explicar lo que se observa. Es un Test donde se evalúa la distancia entre lo observado en los datos que tenemos de la realidad y lo esperado bajo el modelo. Para introducirse en la visión general de los tests estadísticos donde se evalúa la distancia entre observado y esperado ver el artículo Tema 8: Relación entre variables cualitativas: Test de la ji-cuadrado.

El Test básicamente consiste en dividir el recorrido de valores de la variable dependiente (0,1) en una serie de intervalos. Intervalos que contengan un número de observaciones suficientemente grande (5 ó más). Se trata, entonces, de contar intervalo por intervalo el esperado y el observado para cada uno de los dos resultados posibles de la variable dependiente dicotómica (tiene la enfermedad o no la tiene, es hombre o mujer, etc). El observado es lo que se tiene y el esperado es el valor esperado teórico calculado mediante el modelo construido. El estadístico es un estadístico de la ji-cuadrado, como el visto en el tema dedicado a la relación entre variables cualitativas.

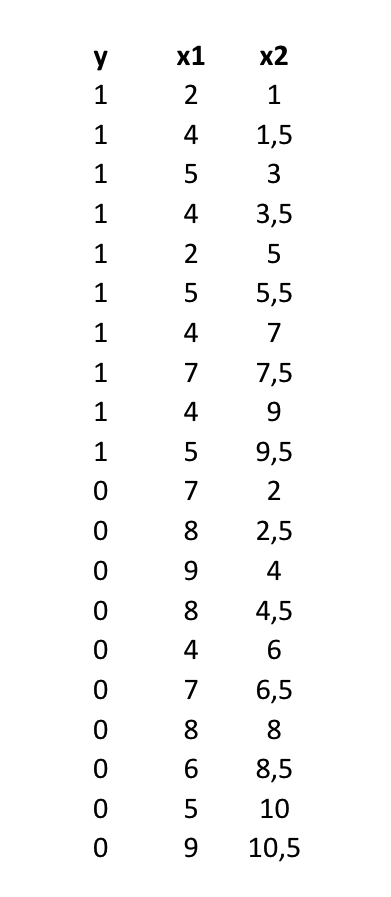
Veamos un par de ejemplos donde podemos comprobar la aplicación del Test a un caso donde hay ajuste y a otro donde no lo hay. El ejemplo es con pocos datos, para que se entienda mejor, lo que fuerza a que el número de observaciones por intervalo sea muy bajo (menos de 5), lo que hace menos fiable el test. Los datos son los siguientes:

IMG_8389

Vemos la variable «y» que es la variable dependiente. Una variable codificada con 1 ó 0. Es la variable dicotómica estudiada: Enfermo-No enfermo, Muere-No muere, Metástasis-No metástasis, etc.

Las otras dos variables son las variables independientes. Haremos una Regresión logística con cada una de las dos variables independientes.

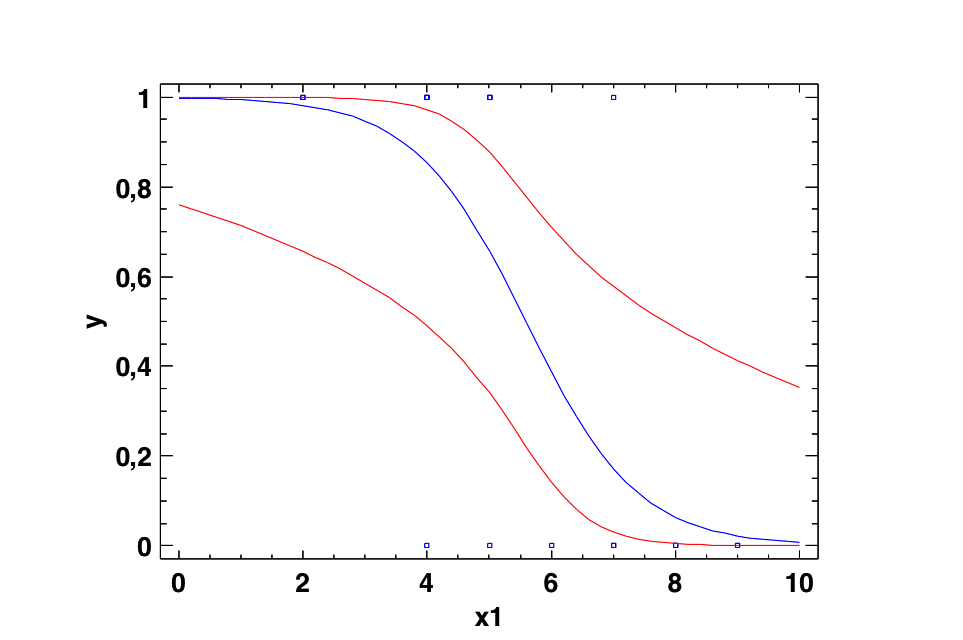
Empezemos con la primera, la variable x1. El dibujo de la Regesión logística es el siguiente:

IMG_8390

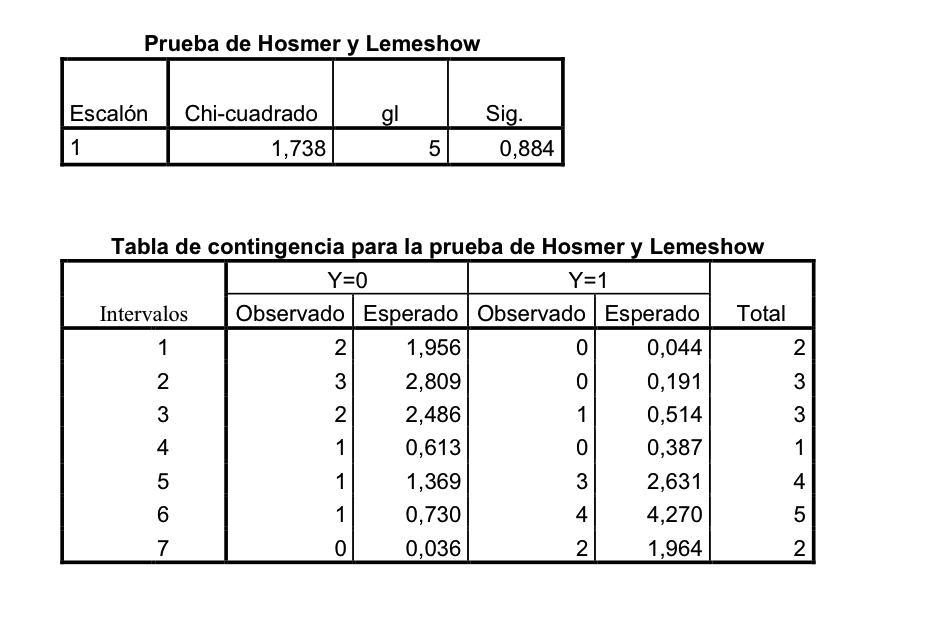
Como puede verse los valores aparecen bien segregados, los valores con variable dependiente 1 ó 0. La aplicación del Test de Hosmer-Lemeshow es la siguiente:

IMG_8392

Observemos que el p-valor es superior a 0.05. Aquí la Hipótesis nula es que el modelo se ajusta a la realidad. En un Test de bondad de ajuste siempre en la Hipótesis nula se afirma que el modelo propuesto se ajusta a lo observado. Por lo tanto, un p-valor superior a 0.05 implica que lo que observamos se ajusta suficientemente a lo que esperado bajo el modelo.

Observemos también que en la tabla de aplicación del Test, en la que se van calculando, en una serie de intervalos, los valores observados y esperados, hay mucha proximidad entre estos valores reales y teóricos. Esto es lo que permite pensar que usar este modelo y calcular predicciones con él es suficientemente correcto. Esto suele considerarse como una Calibración.

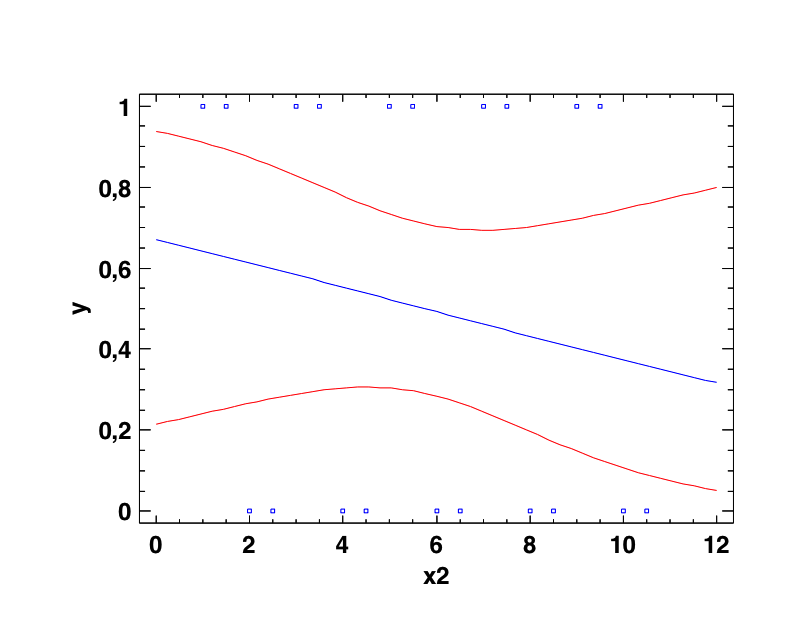
Veamos ahora lo mismo pero con la variable x2:

IMG_8391

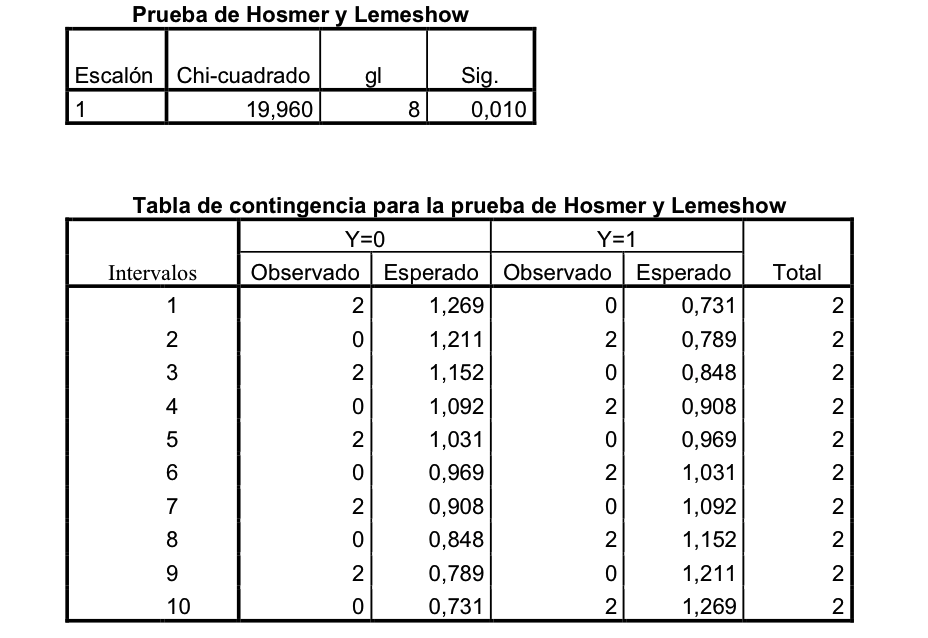
Viendo estos datos vemos que los valores con 1 ó 0 ya no tienen una disposición que haga pensar en un buen ajuste. Veamos la aplicación del Test:

IMG_8393

Ahora el p-valor del Test es menor que 0.05, lo que implica que la Hipótesis nula no parece lógico mantenerla a la luz de lo que vemos en nuestros datos. Si observamos, también, la tabla de los valores observados y esperados, tanto entre los valores con 1 y con 0, vemos que hay mucha distancia entre los valores observados y los valores esperados.

En una situación como esta no sería recomendable el uso del modelo de Regresión logística.

Solución Situación 61

1d: No existen métodos de comparación entre estas tres medidas del grado de relación entre variables. Entre dos medidas significativas del mismo tipo sí que la hay, pero no entre estos distintos tipos de medidas. Cada una tiene un rango de valores posibles distinto y no hay unas pautas de comparación entre los diferentes tipos de medidas del grado de relación que aparecen en esta pregunta; o sea, entre la correlación de Pearson, la Odds ratio y la V de Crámer.

2a: Las únicas OR significativas son 0.1 y 7. Y 0.1 implica un grado de relación de 10 niveles de protección. Y 10 es mayor que 7.

3c: En esta muestra el 26 tiene 8 valores inferiores y 2 superiores. Por eso, sólo en esta muestra ocupa el percentil 80.

4b: Una OR=4 es equivalente a una OR=0.25 porque ambas suponen 4 veces riesgo ó 4 veces protección. Y 0.5 supone únicamente 2 veces protección. Por lo tanto, una OR=4 implica mayor asociación que una OR=0.5.

Una OR mayor que 1 puede ser perfectamente no significativa.

No siempre que el observado y el esperado de una tabla de contingencia no coincidan la V de Crámer valdrá 1. Valdrá 1 sólo si existe el grado máximo posible de diferencia, dado el tipo de tabla que tengamos y el tamaño de muestra que tengamos.

El índice kappa puede tener valores negativos sólo si la discordancia es muy grande.

5b: No parece haber ajuste a una distribución normal, claramente. Luego, los valores de asimetría estandarizada y curtosis estandarizada caerán fuera del intervalo (-2, 2).

6a: Si el intervalo de confianza del 95% de la pendiente no incluye al 0 se trata de una pendiente significativa. No es cierto que no lo sea, de significativa, por incluir al 1.

Las otras afirmaciones son claramente ciertas. El intervalo de confianza de la OR no incluye al 1, por lo tanto: es significativo. La correlación también lo es por tener un p-valor inferior a 0.05. Y el índice kappa indica fuerte asociación porque es casi 1.

7d: El rango es 8. La moda 3. La mediana es 3. Y el rango intercuartílico es, claramente 6 puesto que el primer cuartil es 2 y el tercero es 8.

8d: Una r=-0.6 al hacer su cuadrado tenemos que es 0.36 y al pasarlo a porcentaje se transforma en un 36%.

En una Regresión lineal simple la variable dependiente es cuantitativa, no cualitativa.

El que el p-valor sea mayor que 0.05 no es indicativo de que observado y esperado coinciden. Evidentemente, si estos coinciden el p-valor será mayor que 0.05 (de hecho, será 1), pero el que el p-valor sea mayor que 0.05 no implica que necesariamente observado y esperado coincidan.

Si un intervalo de confianza del 95% de la media es (8, 12) el Error estándar será 1, no 2, puesto que la media muestral será 10 y dos veces el Error estándar nos debe dar 2. Luego el Error estándar debe ser 1.

9d: Una OR=0.2 indica un grado de protección de 5 porque 1/0.2 es igual a 5.

La Regresión lineal simple y=3x+4 tiene pendiente claramente positiva.

La V de Crámer sólo puede tener valores entre 0 y 1.

Una ji-cuadrado no cuantifica el grado de relación que hay entre dos variables cualitativas. Valora si hay o no relación.

10c: Como ni la asimetría estandarizada ni la curtosis estandarizada caen dentro del intervalo (-2, 2) nuestra variable, en este caso, no se ajusta a la distribución normal, por lo tanto a la hora de resumirla brevemente es preferible y recomendable hacerlo mediante la mediana y el rango intercuartílico.

La afirmación «a» seguro que tiene demasiado error por el no ajuste a la distribución normal.

No tienen por qué ser iguales la mediana y la media.

Toda muestra de una variable cuantitativa tiene desviación estándar, se ajuste o no a una distribución normal. Otra cosa es cómo se interprete en función del ajuste a la distribución normal de la variable estudiada.

Situación 61: Examen (Temas 1-9)

1. ¿Qué valor refleja un mayor nivel de relación entre dos variables?

a. r= 0.6 (p<0.05)

b. OR=10 (IC 95%: (4.37, 23.32))

c. V=0.85 (p<0.05)

d. No pueden compararse estos tres tipos de medición del grado de relación entre dos variables.

2. ¿Qué Odds ratio indica mayor relación entre dos variables dicotómicas?

a. 0.1 (p<0.05)

b. 7 (p<0.05)

c. 15 (p>0.05)

d. 0.05 (p>0.05)

3. Tenemos un individuo con un valor de IMC de 26 y nos dicen que, respecto a una muestra, este valor representa un percentil 80. ¿Cuál de las siguientes es la muestra referente?:

a. (19, 21, 21, 22, 23, 24, 24, 24, 25, 31)

b. (19, 21, 21, 22, 24, 24, 25, 27, 28, 31)

c. (20, 21, 21, 22, 24, 24, 24, 25, 27, 29)

d. (18, 21, 21, 22, 24, 24, 27, 29, 31, 38)

4. ¿Qué afirmación entre las siguientes es cierta?

a. Una Odds ratio mayor que 1 siempre es significativa.

b. Una Odds ratio de 4, significativa, es una medida que indica mayor asociación que una Odds ratio de 0.5 que también sea significativa.

c. La V de Crámer toma el valor de 1 si el observado y el esperado son diferentes.

d. El índice kappa puede tener valores negativos si la concordancia entre dos observadores es muy alta.

5. En una muestra como la siguiente: (4, 5, 5, 6, 6, 15, 16, 16, 17, 17, 80), la asimetría estandarizada y la curtosis estandarizada:

a. Deben de ser valores que caen fuera del intervalo (-2, 2) porque sí parece haber ajuste a la distribución normal.

b. Deben de ser valores que caen fuera del intervalo (-2, 2) porque no parece haber ajuste a la distribución normal.

c. Deben de ser valores que caen dentro del intervalo (-2, 2) porque sí parece haber ajuste a la distribución normal.

d. Deben de ser valores que caen dentro del intervalo (-2, 2) porque no parece haber ajuste a la distribución normal.

6. ¿Cuál de las siguientes afirmaciones no es cierta?

a. Un intervalo de confianza del 95% de una pendiente en una Regresión lineal simple que sea (0.75, 1.34) nos indica una pendiente no significativa porque el intervalo incluye al 1.

b. Una Odds ratio con un intervalo de confianza del 95% que sea (3.23, 7.67) indica una asociación significativa.

c. Una correlación r=0.23 (p=0.001) indica que estamos ante una correlación positiva significativa.

d. Un índice kappa de 0.98 indica una fuerte concordancia entre dos observadores.

7. Sea la muestra (9, 9, 1, 1, 3, 3, 3, 7). Podemos afirmar:

a. El rango es 9.

b. La moda es 9.

c. La mediana es 5.

d. El rango intercuartílico es 6.

8. ¿Cuál de las siguientes afirmaciones  es cierta?

a. En una Regresión lineal simple la variable dependiente es cualitativa.

b. En un Test de la ji-cuadrado si el p-valor es mayor que 0.05 indica que la tabla de contingencias observada y la esperada son iguales.

c. Un intervalo de confianza de la media del 95% que sea (8, 12) indica que el Error estándar es igual a 2.

d. Una correlación de Pearson de -0.6 entre dos variables nos indica que si hacemos una Regresión lineal simple entre ambas variables tendremos una Rdel 36%.

9. ¿Cuál de las siguientes afirmaciones es cierta?

a. Un modelo de Regresión lineal simple que sea y=3x+4 tiene una pendiente negativa.

b. Una V de Crámer de -1 indica que la relación entre las variables cualitativas es de tipo inverso.

c. La ji-cuadrado es una técnica que cuantifica el grado de relación que hay entre dos variables cualitativas.

d. Una Odds ratio de 0.2, significativa, nos indica que la exposición estudiada es un factor que nos protege 5 veces más que la no exposición.

10. En una muestra con curtosis estandarizada de 3.45 y asimetría estandarizada de -5.18:

a. Si la media muestral es 5 y la desviación estándar es 3 podremos decir que entre 2 y 8 tenemos el 68.5% de los valores.

b. La media muestral y la mediana serán iguales.

c. Si la queremos resumir brevemente mejor hacerlo mediante la mediana y el rango intercuartílico expresado mediante el primer y tercer cuartil.

d. Esta muestra no tienen desviación estándar porque no se ajusta a una distribución normal.

Solución Situación 60

Las preguntas eran:

1. Comprobar si hay relación significativa entre la variable Grupo (anorexia frente a control) y cada una de las otras variables del estudio.

2. Calcular la V de Crámer para cada una de las relaciones.

3. Calcular la Odds ratio para cada una de las relaciones.

En el siguiente cuadro aparecen todos los resultados:

G respecto a: ji-cuadrado p-valor V de Crámer OR IC 95%
P 10,1764 0,0014 0,3190 4,2051 (1,69, 10,45)
A 14,0359 0,0002 0,3746 6,2469 (2,26, 17,29)
B 5,1975 0,0226 0,2280 2,9531 (1,14, 7,65)
H 23,5200 <0,0001 0,4850 20,4444 (4,47, 93,47)
D 4,5737 0,0325 0,2139 2,8908 (1,07, 7,82)
S1 13,1494 0,0003 0,3626 4,6437 (1,98, 10,88)
S2 15,1744 <0,0001 0,3895 5,5238 (2,26, 13,48)
S3 16,3185 <0,0001 0,4040 10,4444 (2,85, 32,21)

En todos los factores analizados vemos, mediante la ji-cuadrado, una relación significativa entre la variable cualitatitva Anorexia-Control y cada uno de esos factores analizados: P, A, B, H, D y las respectivas sumas de factores: S1, S2 y S3.

La variable H es la que presenta una Odds ratio más elevada. Las mujeres con antecedentes parenterales de trastornos de la alimentación tienen 20 veces más posibilidades de tener anorexia que las que no tienen esos antecedentes, en base a la muestra que tenemos.

Observemos, también, que al ir sumando más de esos factores considerados se va incrementando el riesgo. La Odds ratio va creciendo. Desde S1 a S3 vamos incrementando la Odds ratio.

Es interesante constatar el hecho de que H, individualmente, tenga una Odds ratio superior a cualquiera de las variables que suman riesgos. La suma de riesgos es más general, porque suma cualquier combinación. Tienen, esas sumas, valores de Odds ratio más bajas pero también con intervalos de confianza más estrechos porque reúnen un número superior de casos y esto reduce el intervalo.

Evidentemente en cualquier relación lo preferente es encontrar relaciones significativas, pero una vez tenemos significación cuanto más estrecho sea el intervalo de confianza más perfilado tenemos el nivel de riesgo o de protección de la exposición analizada.