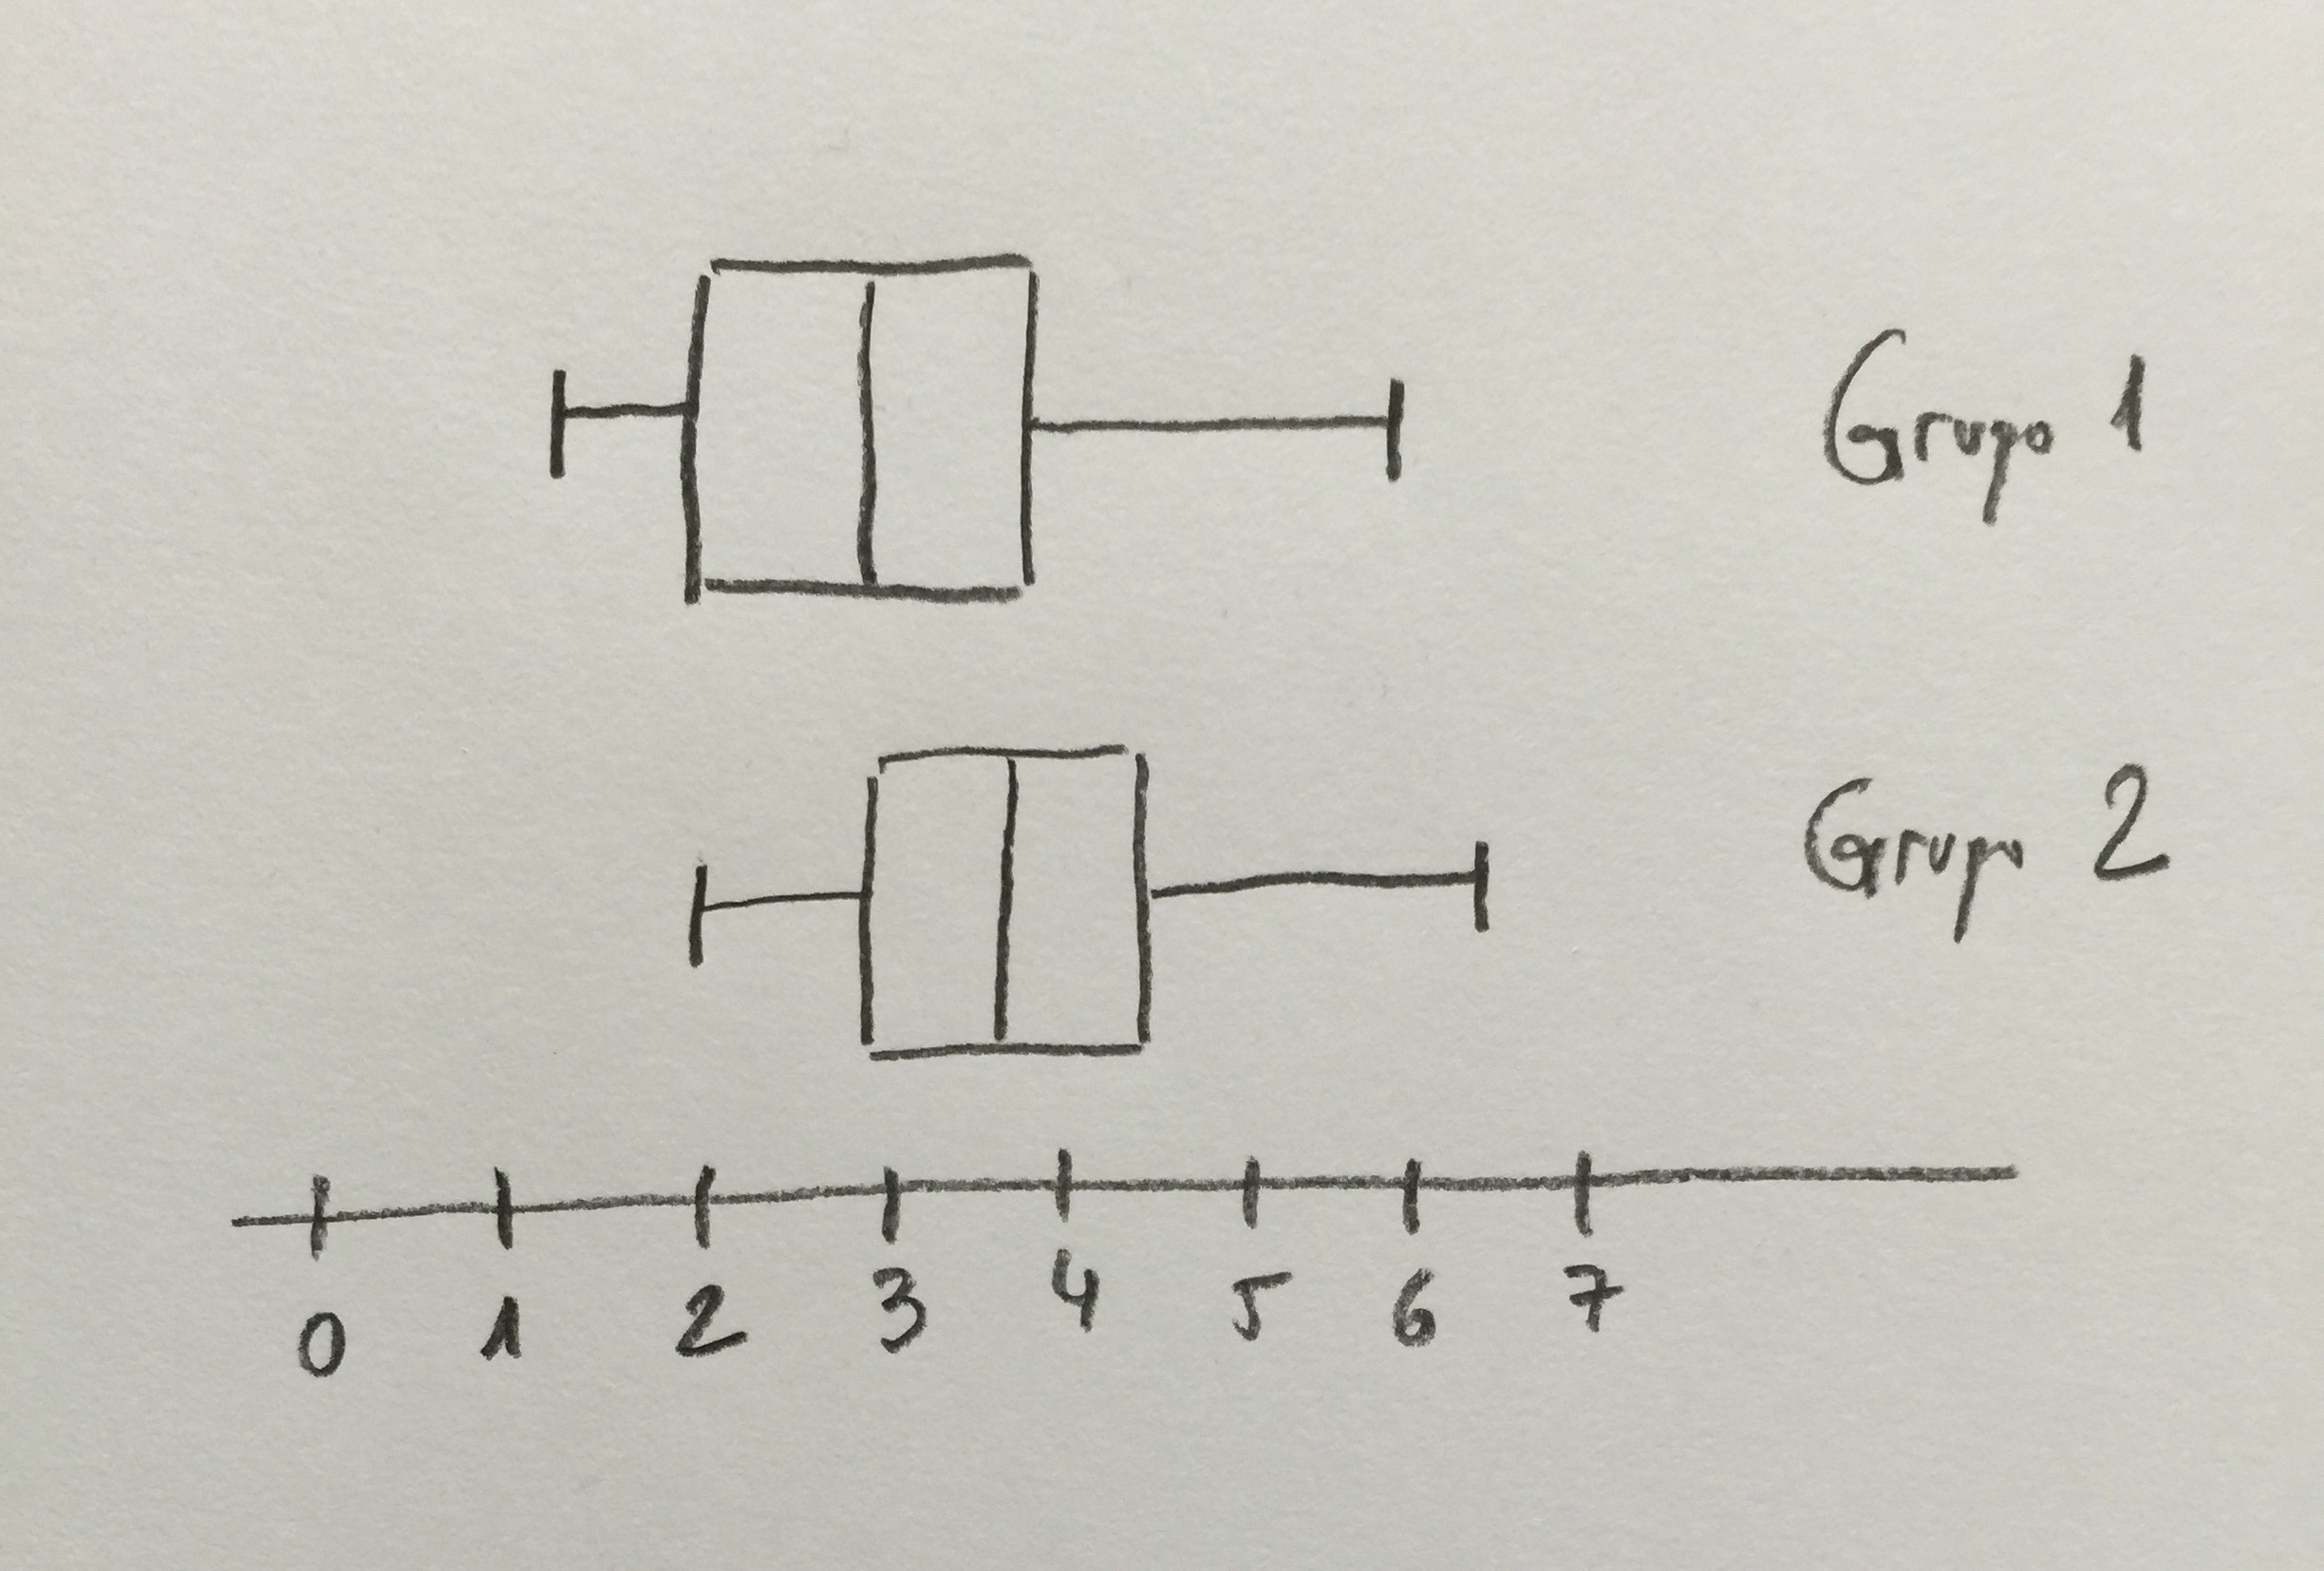Archivo del Autor: estadisticallopis

Curso 0 de Estadística

Este es un curso de Estadística pensado para preparar para el inicio posterior de un curso universitario de Estadística. Por eso lo llamo «Curso 0». Intenta, mediante un lenguaje sencillo, introducir el lenguaje y los problemas fundamentales que aborda la Estadística.

Podéis seguir, también, si queréis, la explicación con los siguientes vídeos:

Empecemos, pues:

La Estadística es una técnica de decisión, una técnica para la toma de decisiones. Una técnica de decisión basada en procedimientos matemáticos. Una técnica que se basa en la utilización de información que tenemos o que podemos obtener.

La Estadística es la ciencia con la que, a partir de MUESTRAS, decimos cosas (tomamos decisiones) sobre POBLACIONES.

Vamos a ver, en primer lugar, pues, qué entendemos por Poblaciones y por Muestras en Estadística.

Una POBLACIÓN es un conjunto, generalmente muy grande, de personas, de seres vivos, de cosas, etc.

Ejemplos:

  1. La población de todos los menores de 14 años en España.
  2. La población de todos los enfermos de Alzheimer de España.
  3. La población de todos los colegios de Barcelona.
  4. La población de todos los estudiantes de sexto de primaria de Cataluña.
  5. La población de todos los pokémons.
  6. La población de todas las ciudades del mundo.
  7. La población de todos los perros de España.

Una MUESTRA es una parte, generalmente pequeña, de una POBLACIÓN.

Ejemplos:

  1. Hemos seleccionado al azar 100 niños menores de 14 años en España.
  2. Hemos seleccionado, también al azar, 50 personas con Alzheimer en España.
  3. Hemos seleccionada al azar 20 colegios de Barcelona.
  4. Hemos seleccionado 70 estudiantes de sexto de primaria de Cataluña.
  5. Hemos seleccionado al azar 20 pokémons.
  6. Hemos seleccionado al azar 1000 ciudades del mundo.
  7. Hemos seleccionado al azar 200 perros de España.

Observa que la estructura de la relación entre POBLACIÓN y MUESTRA es siempre la que se ve en el siguiente dibujo:

img_3824

Siempre una MUESTRA es una parte de una POBLACIÓN. Y el objetivo de la Estadística es, precisamente, a partir de lo que podremos saber de esta MUESTRA, a base de estudiarla, de calcular cosas con ella, intentar decir cosas de cómo es la POBLACIÓN que no tenemos.

Evidentemente, no toda MUESTRA tiene la misma calidad. Hay muestras más representativas de la POBLACIÓN que otras. A la hora de elegir la muestra se trata de hacerlo con el máximo de coherencia para tratar que la MUESTRA sea lo más parecido a la POBLACIÓN  pero en miniatura. De momento, en este curso 0, basta con saber esto, pero, parece claro que la elección de la muestra es un paso fundamental puesto que, como ya hemos dicho, la Estadística pretende decir cosas de las POBLACIONES a partir del estudio de MUESTRAS. Si la elección de ésta es incoherente mala ciencia estaremos haciendo.

Esto es, pues, la Estadística: Intentar saber cómo es un todo (una POBLACIÓN) que no tienes a partir del estudio de una parte (una MUESTRA) que sí que tienes.

Por lo tanto, estos dos conceptos (MUESTRA y POBLACIÓN) están siempre presentes en la Estadística.

A las personas, seres vivos o cosas de las muestras que tenemos las analizamos para obtener de ellos alguna característica. A estas características las llamamos VARIABLES.

Ejemplos (Observa que cada punto está constituido por los elementos de las POBLACIONES y MUESTRAS vistas en la lección anterior):

  1. La presión arterial de niños menores de 14 años.
  2. El valor del Mini-Mental (es una prueba con una serie de preguntas que finalmente da una puntuación que marca el nivel de gravedad de la enfermedad) que tiene un enfermo con Alzheimer.
  3. La cantidad de alumnos matriculados en un colegio.
  4. La nota de matemáticas de estudiantes de sexto de primaria.
  5. La velocidad de un pokémon.
  6. El número de habitantes en una ciudad.
  7. Si un perro lleva o no un chip identificativo.

Observa que hemos definido una VARIABLE en cada caso pero podríamos escoger otras. Para que lo veas puedo tomar una POBLACIÓN de donde podríamos tener una MUESTRA y definir una larga lista de VARIABLES distintas. Un ejemplo, con los alumnos de sexto de primaria:

  1. Nota de sociales.
  2. Días que no han ido al colegio en el curso pasado.
  3. Nota promedio de quinto.
  4. Nota que le pondría él al tutor que ha tenido.
  5. Si prefiere un hombre o una mujer como tutor.
  6. A qué distancia vive de su escuela.
  7. Si ha repetido o no anteriormente un curso.
  8. Deberá o no repetir quinto.

Observemos, pues, que hasta ahora hemos visto tres conceptos en Estadística que son nucleares y que están siempre presentes en cualquier estudio realizado en cualquier ciencia:

  1. POBLACIÓN.
  2. MUESTRA.
  3. VARIABLE.

Es muy importante, siempre, situar bien cada uno de estos tres conceptos cuando se hace un estudio.

Veamos un ejemplo práctico:

Se quiere ver, en personas que tienen una enfermedad, si un nuevo medicamento que se quiere probar consigue más, menos o igual número de curaciones que el medicamento que se utiliza actualmente.

Llamemos al medicamento habitual como A y al nuevo como B.

Tenemos la POBLACIÓN de todos los enfermos de esa patología. Que pueden ser miles y miles.

El medicamento A lo damos a 100 personas con esa enfermedad y a los que seguiremos con detalle para ver si se curan o no. Estas 100 personas son una MUESTRA de la POBLACIÓN de todos los enfermos.

El medicamento B lo damos a otras 100 personas con esa enfermedad. Evidentemente, personas diferentes a las anteriores. Personas que también seguiremos detalladamente para ver si se curan o no con ese tratamiento. Estas 100 personas son una MUESTRA de la misma POBLACIÓN anterior, la POBLACIÓN de todos los enfermos de esa enfermedad.

La VARIABLE en este estudio es si el enfermo se cura o no con el tratamiento.

Veamos todo el planteamiento del estudio con un dibujo:

img_3832

Unos resultados que podríamos obtener finalmente del estudio podrían ser los siguientes:

Medicamento A:

70 se curan.

30 no se curan.

Medicamento B:

90 se curan.

10 no se curan.

Observa que entre las dos MUESTRAS hay diferencias. Con el medicamento B se curan más personas que con el medicamento A. Es muy claro. De las 100 personas tratadas con el medicamento B se han curado 90. Esto lo expresamos así: un 90 por 100 (lo solemos escribir así: 90%). Sin embargo, con el medicamento A se han curado sólo 70: un 70 por 100 (70%).

Pero, algo muy importante: esto que vemos lo vemos en las MUESTRAS. ¿Pasaría lo mismo si estos tratamientos se aplicaran a la POBLACIÓN entera, a todos los enfermos? Observemos que esto no lo podremos decir hasta que no lo apliquemos. Pero sería interesante predecir si las diferencias que vemos en esas MUESTRAS las veríamos también si cada uno de esos medicamentos se aplicara a toda la POBLACIÓN.

Pues éste es el papel de la Estadística. A eso nos dedicamos los estadísticos y para saber hacer este paso de las MUESTRAS a las POBLACIONES todos los científicos estudian Estadística.

Ya veremos que el gran problema de la Estadística será saber cuándo podemos decir que lo que vemos en las MUESTRAS es lo que veríamos, también, en las POBLACIONES. Cuando decimos, en Estadística, que lo que vemos es ESTADÍSTICAMENTE SIGNIFICATIVO es porque, con muchas posibilidades de no equivocarnos, lo que vemos en las MUESTRAS es lo que veríamos, también, en las POBLACIONES. Pero esto ya lo veremos más adelante. Sigamos, poco a poco.

Veamos ahora un poco más en detalle el tercero de esos tres conceptos que estamos viendo como nucleares en Estadística: el concepto de VARIABLE.

Hay dos tipos básicos de VARIABLES (esas características que medimos o evaluamos a las personas, seres vivos o cosas de una muestra o de una población): las variables cuantitativas y las variables cualitativas.

Las variables cuantitativas son variables que miden una cantidad. Nos dan un número a cada individuo de la muestra que tengamos.

Las variables cualitativas, también llamadas variables nominales, nos valoran una cualidad. Por eso se les llama también nominales, porque los valores de cada individuo son nombres.

Observemos las variables que listábamos antes en referencia a alumnos de sexto de primaria:

  1. Nota de sociales.
  2. Días que no han ido al colegio en el curso pasado.
  3. Nota promedio de quinto.
  4. Nota que le pondría él al tutor que ha tenido.
  5. Si prefiere un hombre o una mujer como tutor.
  6. A qué distancia vive de su escuela.
  7. Si ha repetido o no anteriormente un curso.
  8. Deberá o no repetir quinto.

Las variables 1, 2, 3, 4, 6 son variables cuantitativas. Son o una nota (una nota entre 0 y 10, suponemos) o un número de días o una distancia (en metros o kilómetros). Sin embargo, las variables 5, 7 y 8 son cualitativas. No son una cantidad numérica, sino una cualidad: prefiere un hombre o una mujer como tutor, ha repetido o no anteriormente un curso, debe o no repetir quinto.

Observemos que podríamos definir muchas más variables, tanto de cualitativas como de cuantitativas.

Veamos más ejemplos de variables cualitativas, en esa misma muestra de estudiantes de sexto de primaria:

  1. El sexo del alumno: niño o niña.
  2. El grupo sanguíneo: A, B, AB, O.
  3. Ciudad donde nació.
  4. Tiene o no ordenador en la habitación.

Veamos más ejemplos de variables cuantitativas:

  1. Altura.
  2. Peso.
  3. Metros cuadrados del piso donde vive.
  4. Número de hermanos que tiene.

Ya tenemos los elementos básicos con los que se trabaja, siempre, en Estadística: POBLACIONES, MUESTRAS y VARIABLES.

Ahora vamos a empezar a manejarlos.

La Estadística es una ciencia que actúa manejando Técnica analíticas. Con ellas es como hace este proceso de decir cosas de POBLACIONES a partir de las MUESTRAS.

Existen tres tipos de técnicas en Estadística. Técnicas descriptivas, de relación y de comparación. Vamos a dividir el resto de este curso 0 en tres apartados: uno para cada uno de estos tres tipos de técnicas.

  1. Técnicas descriptivas:

Con las técnicas descriptivas pretendemos resumir nuestras muestras. Hacer una síntesis de la inmensa cantidad de información que hay en ellas.

Lo primero que podemos hacer con una muestra es, siempre, hacer una descripción, un resumen de ella, que es lo que llamamos habitualmente: Estadística descriptiva.

Veamos las principales técnicas descriptivas que se engloban en la llamada Estadística descriptiva.

Con estas técnicas descriptivas conseguiremos una serie de valores que nos proporcionan una serie de rasgos característicos de la MUESTRA que podremos generalizar a la POBLACIÓN, si es que esta MUESTRA es representativa de la POBLACIÓN. Ya sabemos que este es el objetivo de la Estadística como ciencia.

Supongamos que tenemos una muestra de 10 alumnos de sexto de primaria y tenemos los siguientes valores de dos variables: Sexo (niño o niña) y nota de matemáticas:

Alumno Sexo Nota
1 h 3
2 m 5
3 m 2
4 m 8
5 h 4
6 h 6
7 h 5
8 m 7
9 m 9
10 h 4

Las técnicas descriptivas que tenemos son distintas según las variables sean cualitativas o cuantitativas.

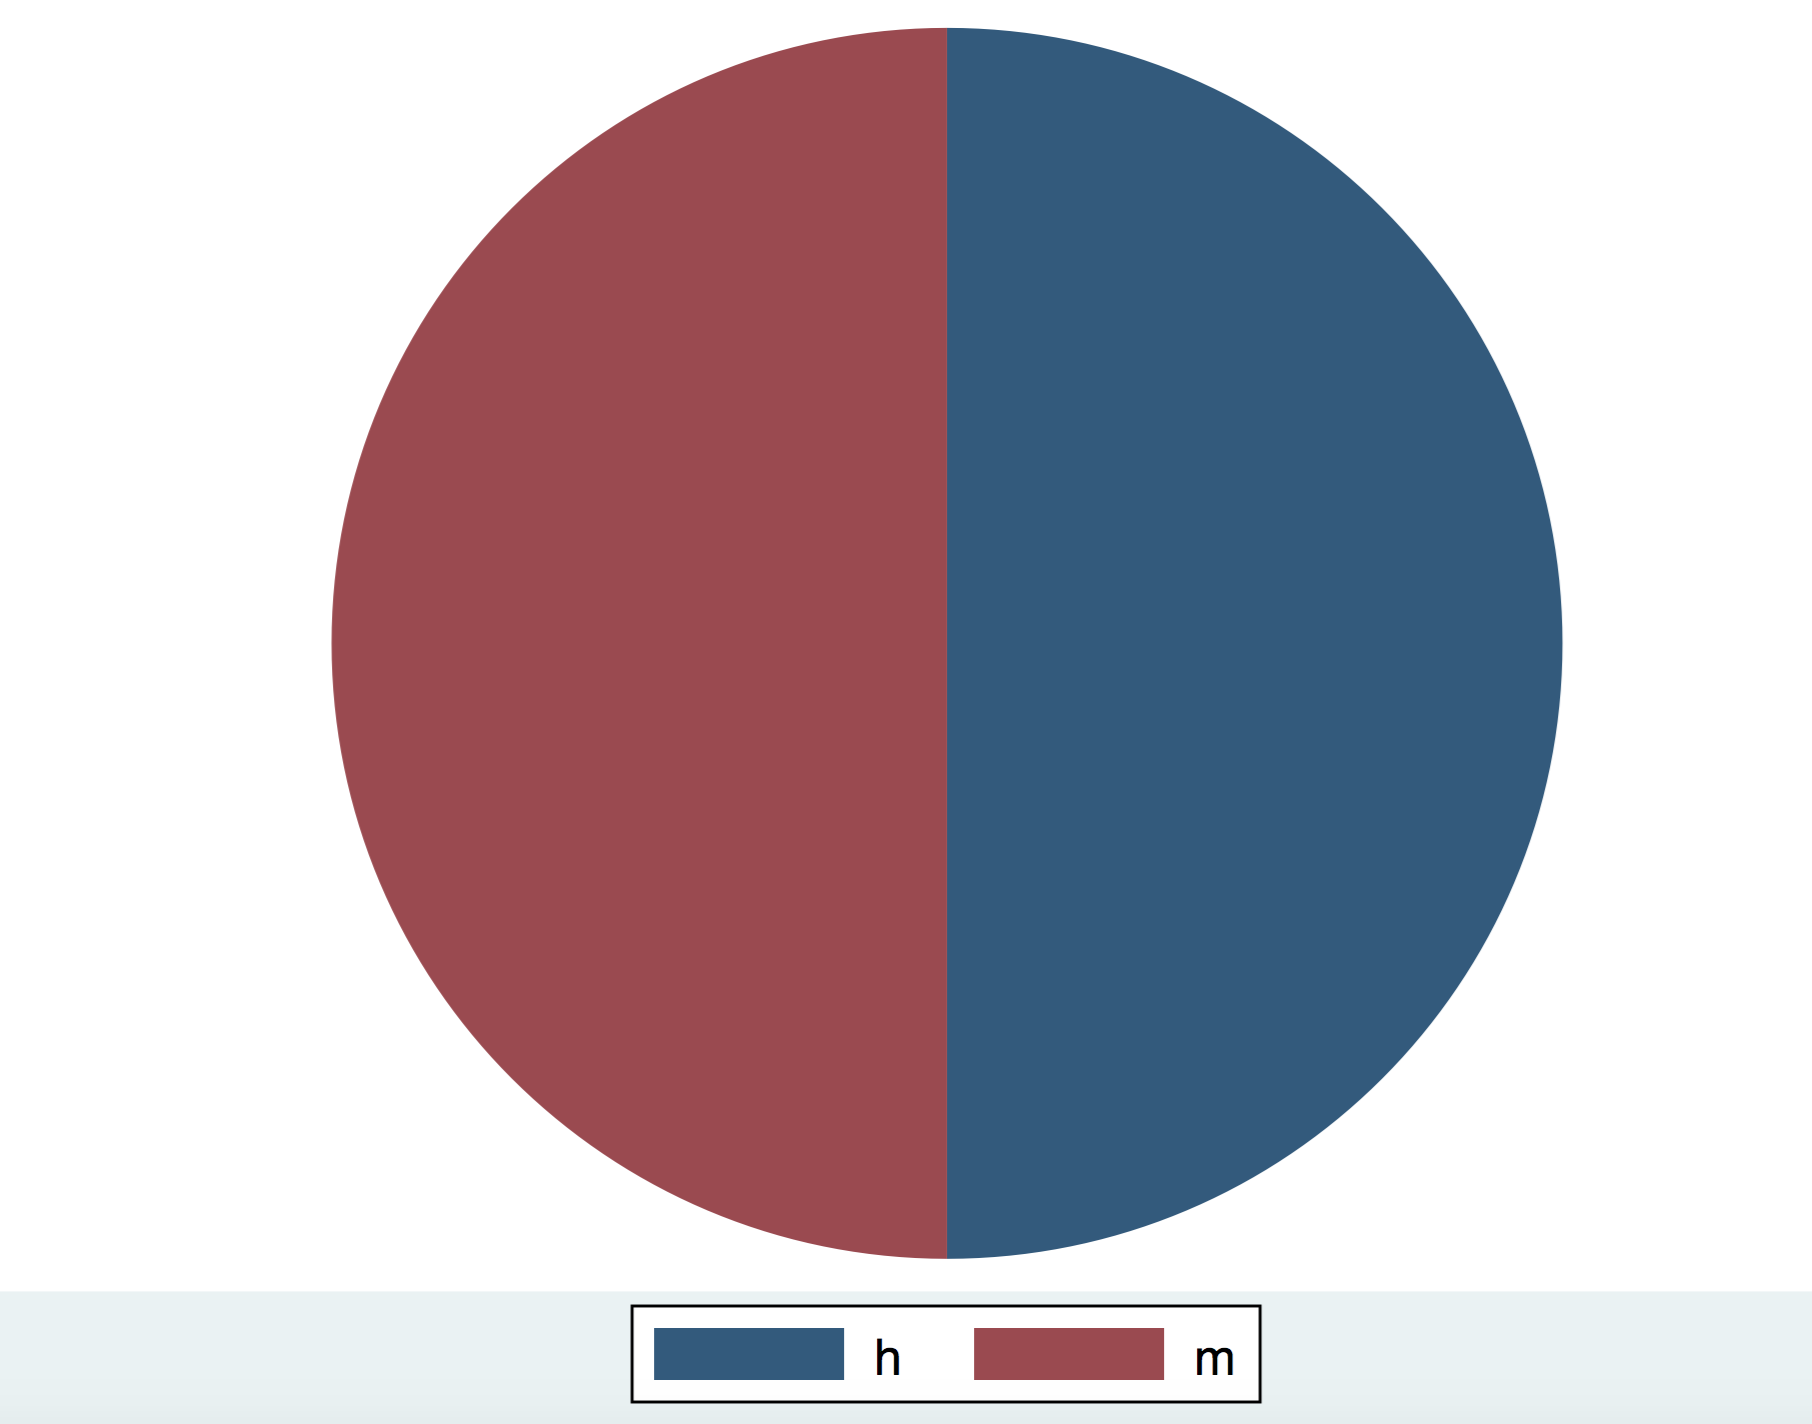
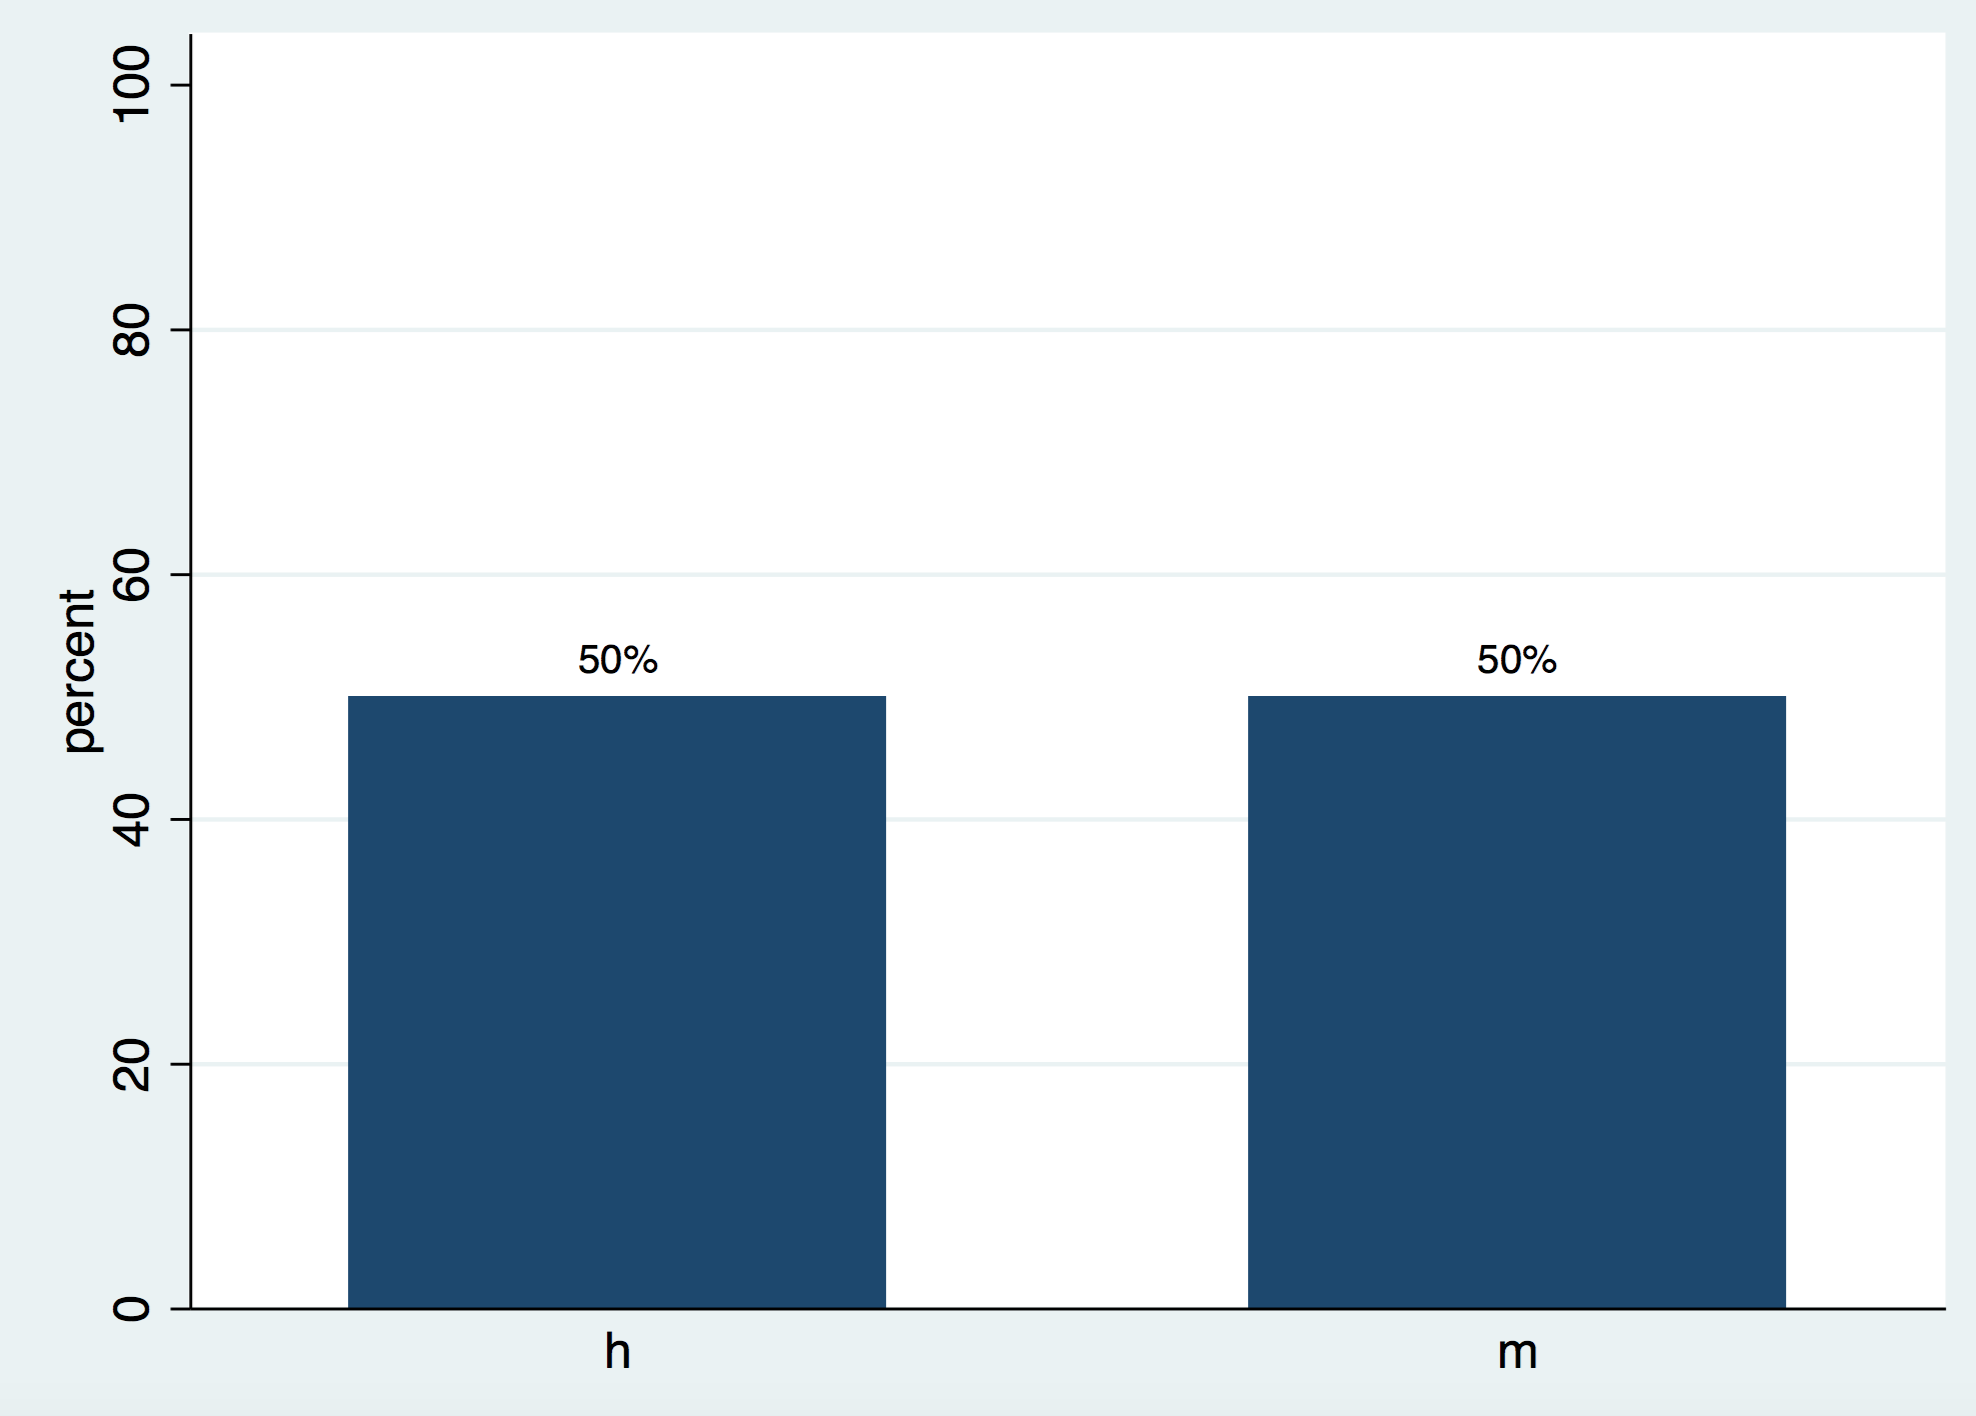
En las cualitativas suele hacerse únicamente un recuento de cada uno de los valores. Consiste, simplemente, en contar cuántos individuos hay de cada una de las diferentes cualidades. En nuestro caso la variable Sexo sólo tiene dos valores posibles: hombres y mujeres. En nuestro caso: 5 hombres y 5 mujeres. Suele también expresarse en porcentaje. En nuestro caso: 50% de hombres y 50% de mujeres. Si se dan los valores sin porcentaje se dice que se dan las frecuencias absolutas, si se dan en porcentaje se dice que se dan las frecuencias relativas.

También se suele acompañar de un gráfico con diagramas de frecuencias o con un diagrama pastel.  A continuación veréis cómo quedarían estos gráficos:
Captura de pantalla 2016-09-01 a las 18.48.06

Captura de pantalla 2016-09-01 a las 18.44.58

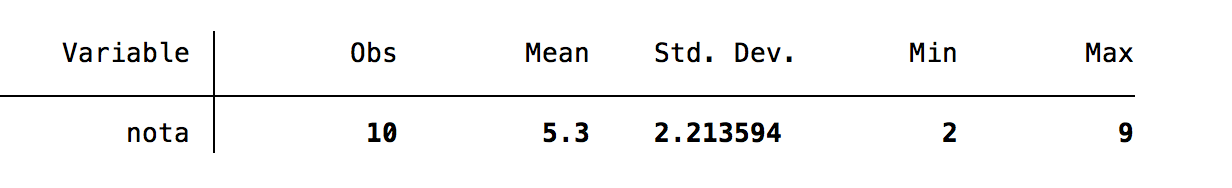
Con las variables cuantitativas las posibilidades son mucho mayores. Suelen calcularse diferentes valores que resuman la muestra, respecto a un determinado aspecto. Es muy habitual dar la media y la desviación estándar. En la variable Nota, de nuestro ejemplo, estos dos valores serían:
Captura de pantalla 2016-09-01 a las 18.50.57

La media (Mean) y la desviación estándar (Std. Dev.) son las que ahora nos interesan. La media es el centro de gravedad de los valores de la muestra. La desviación estándar es una medida de dispersión de los valores de la muestra. Son dos valores muy importantes que se estudian con mucho detalle en un curso de Estadística. Ahora, de momento, nos basta tener en cuenta que son dos valores que se usan con mucha frecuencia para resumir numéricamente una variable cuantitativa.

Basta saber, de momento, que la media es la suma de todos los valores de la muestra dividido por el tamaño muestral, y que la desviación estándar es un valor que va de 0 hacia arriba y que cuanta más dispersión de valores mayor es su valor.

Por ejemplo, la muestra: (5, 5, 5, 5) tiene desviación estándar 0. Y la muestra (0, 5, 5, 10) tiene mayor desviación estándar que la muestra (4, 5, 5, 6). También es bueno saber que la muestra (10, 11, 11, 12) tiene la misma desviación estándar que esta última y que la siguiente: (105, 106, 106, 107). Es muy importante, de momento, tener muy claro todo esto.

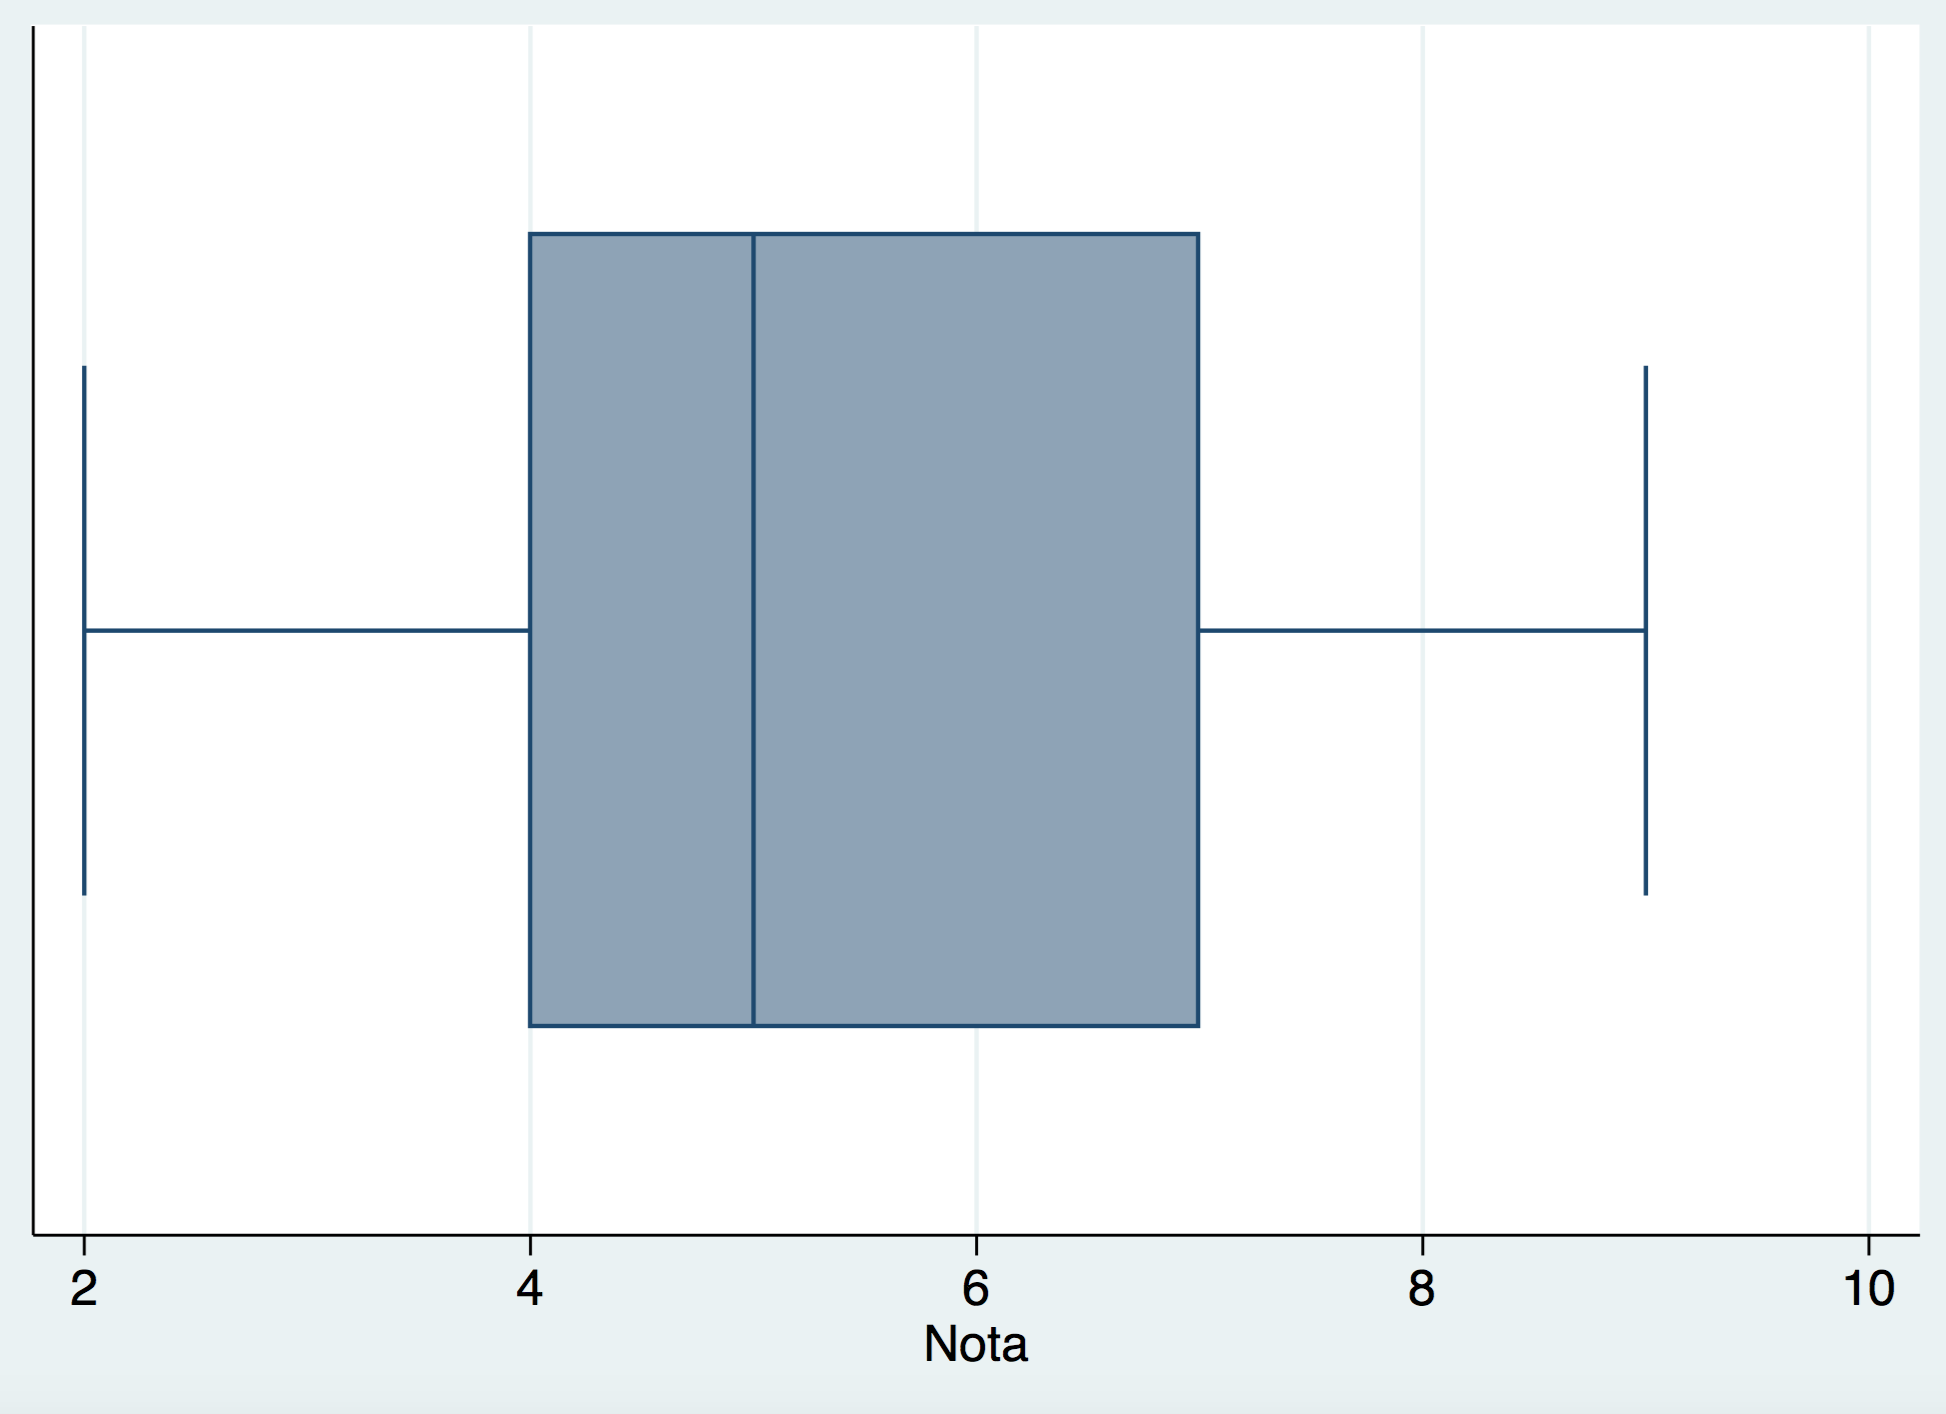
También en las variables cuantitativas es muy importante el denominado Box-Plot. En la variable Nota el Box-Plot es el siguiente:
Captura de pantalla 2016-09-01 a las 18.54.19

Este gráfico es muy importante. Pero para entenderlo bien es mejor verlo en otra muestra.

El valor extremo de la izquierda es el valor mínimo de la muestra, el valor extremo de la derecha es el valor máximo. El punto donde empieza la caja es el primer cuartil o percentil 25. Donde acaba la caja es el tercer cuartil o percentil 75. La línea que fragmenta la caja en dos rectángulos es el segundo cuartil, percentil 50 ó Mediana (esta última denominación es la más habitual).

Para ver cómo se calculan esos importantes valores resumen de la muestra, veamos un caso de una muestra un poco más sencilla de manejar.

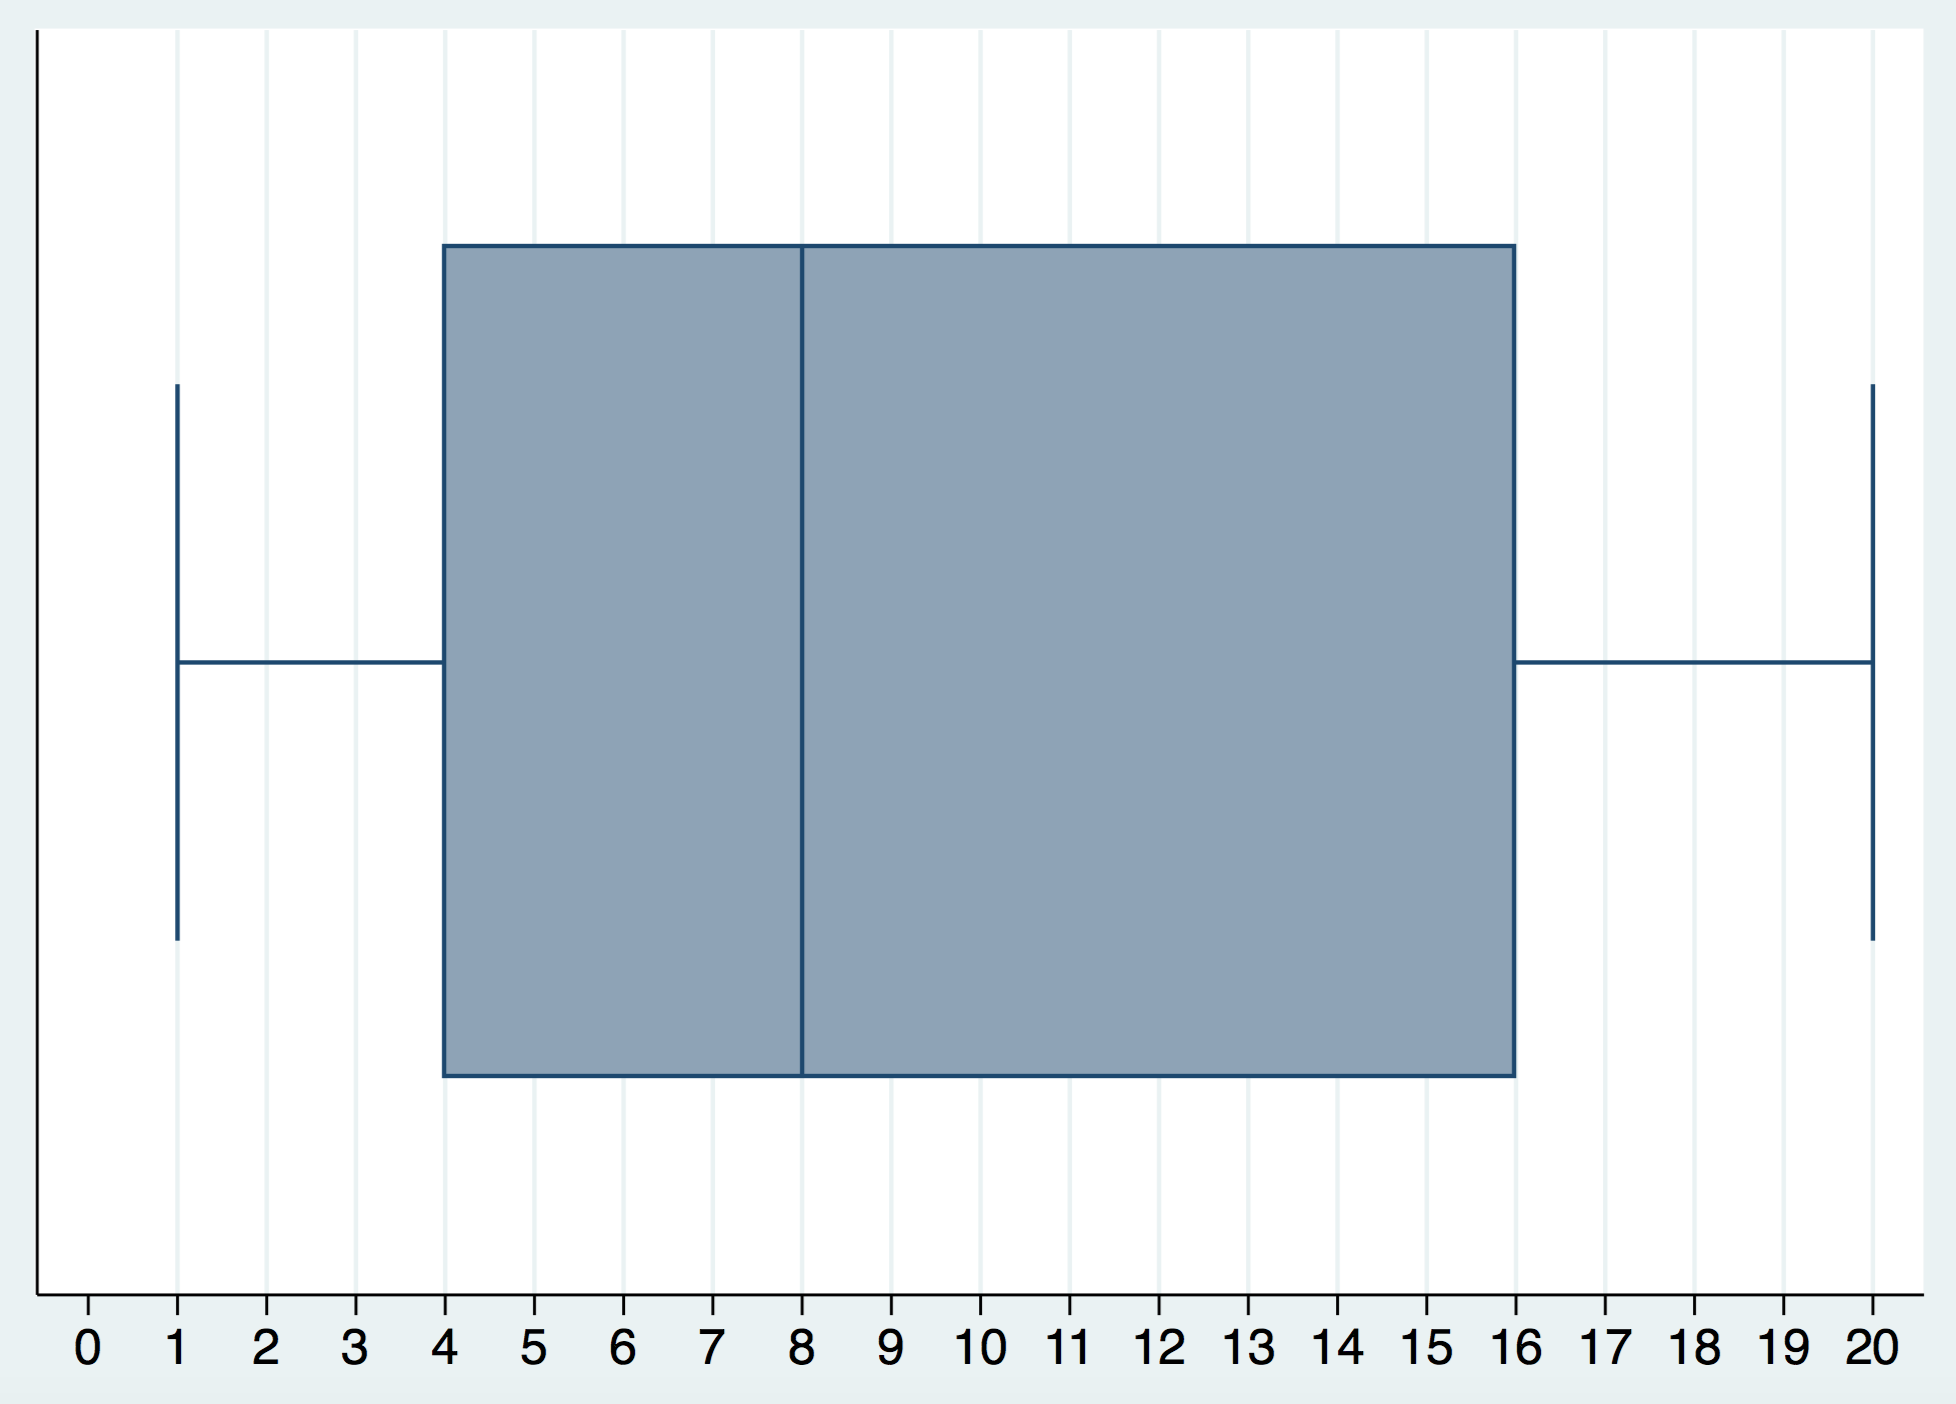
Supongamos la siguiente muestra: (1, 3, 5, 7, 9, 15, 17, 20). El Box-Plot sería el siguiente:
Captura de pantalla 2016-09-01 a las 19.03.37

Lo primero que hay que hacer para realizar estos cálculos es ordenar la muestra de menor a mayor. El mínimo y el máximo de la muestra es claro cómo se obtienen. El primer cuartil o percentil 25 es aquel valor que divide la muestra es un 25% de valores a la izquierda y un 75% de valores a la derecha. El tercer cuartil o percentil 75 es aquel valor que divide la muestra es un 75% de valores a la izquierda y un 25% de valores a la derecha. La mediana es aquel valor que divide la muestra es un 50% de valores a la izquierda y un 50% de valores a la derecha.

Veamos el cálculo del primer cuartil: Si nos situamos entre el 3 y el 5 tenemos un 25% de valores a la izquierda y un 75% de valores a la derecha. En este caso se hace el promedio de estos dos valores para tener el primer cuartil, que es 4.

Veamos el cálculo del tercer cuartil: Si nos situamos entre el 15 y el 17 tenemos un 75% de valores a la izquierda y un 25% de valores a la derecha. En este caso se hace el promedio de estos dos valores para tener el tercer cuartil, que es 16.

Veamos el cálculo de la mediana: Si nos situamos entre el 7 y el 9 tenemos un 50% de valores a la izquierda y un 50% de valores a la derecha. En este caso se hace el promedio de estos dos valores para tener la mediana, que es, en este caso: 8.

A veces el primer o tercer cuartil o la mediana no se sitúa entre dos valores sino que es un valor mismo de la muestra. Un ejemplo: En la muestra (2, 5, 7, 9, 20) la mediana es 7. Observemos que a la izquierda de 7 tenemos el 50% de valores y a su derecha tenemos, también, un 50% de valores.

Encontraréis Box-Plots en muchos artículos de cualquier ciencia, pero mirad a continuación un ejemplo muy sorprendente. Raramente veréis un Box-Plots con los valores muestrales superpuestos:
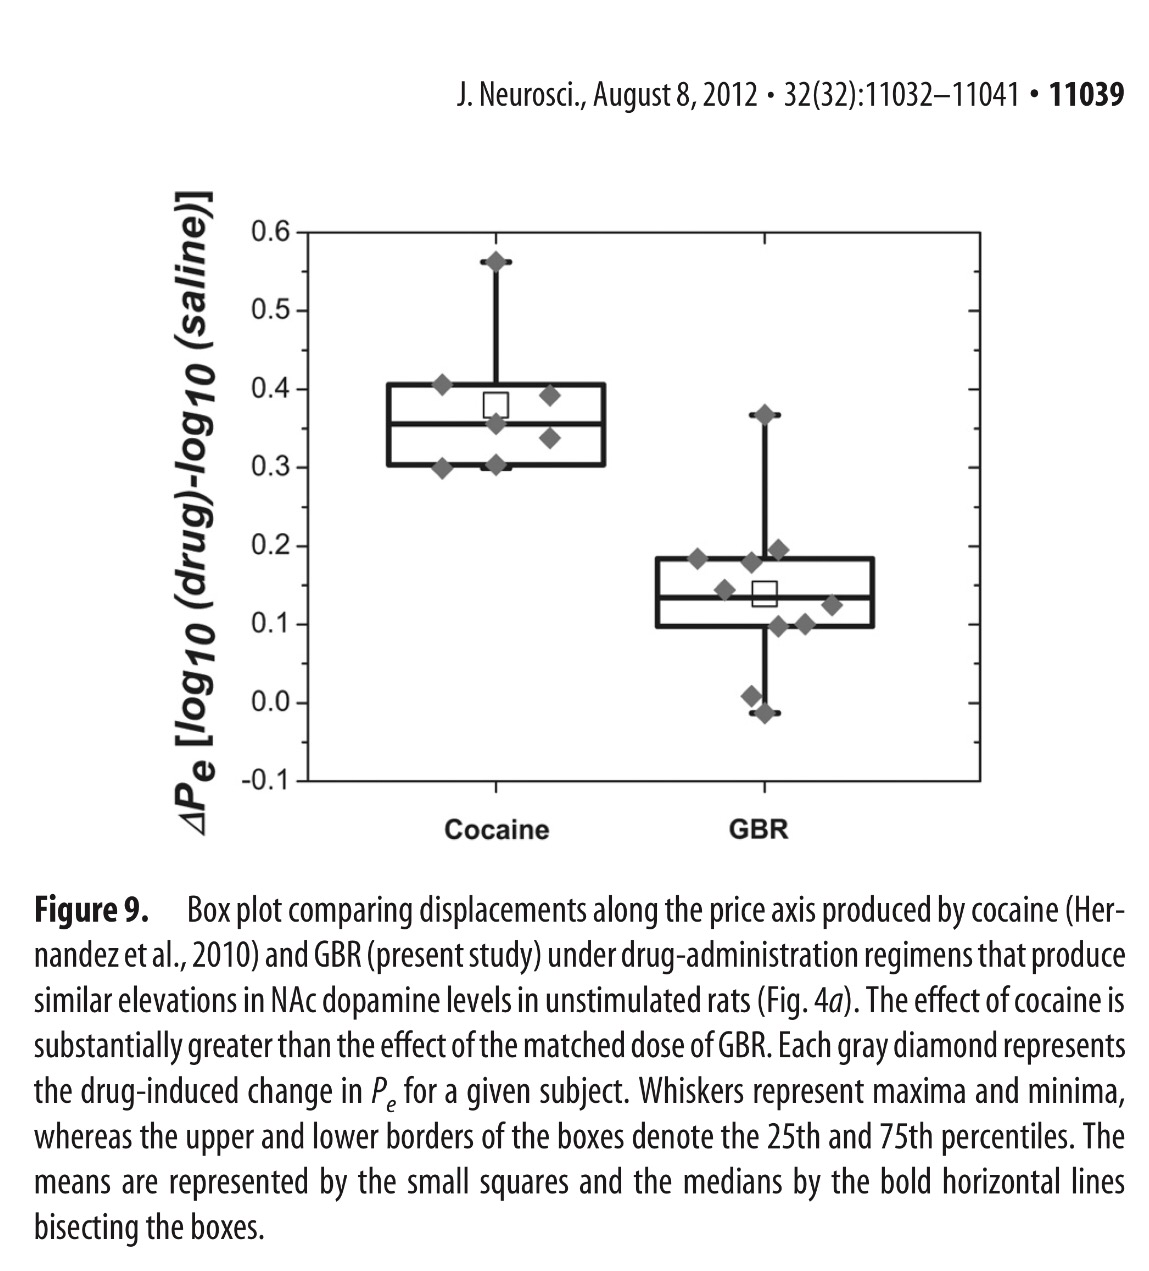
img_4605

2. Técnicas de relación

Con las técnicas de relación, como dice bien su nombre, tratamos de detectar relación entre diferentes variables de nuestra muestra. Como siempre, el objetivo será ver si las relaciones que detectamos en la MUESTRA son generalizables a la POBLACIÓN. Esto siempre está presente porque, como ya hemos dicho desde el principio, este es el objetivo de la Estadística como ciencia.

Detectar relación entre variables es muy importante en cualquier ciencia. Detectar si hay o no relación y, si la hay, mirar de cuantificarla, mirar de ver su intensidad. Porque hay grados distintos de relación.

Un ejemplo sencillo: la variable altura y peso en humanos tiene relación. Personas altas pesan más y personas bajas pesan menos. Esto indica que hay relación entre esas dos variables. Pero entre altura y número de pie hay mucha más relación. Y entre altura y longitud del fémur aún hay más relación. A esto nos referimos al decir que hay que detectar relación, primero, y, después, ver qué cantidad de relación tenemos.

Las dos técnicas más importantes y más usadas para detectar y cuantificar la relación entre dos variables son: la correlación de Pearson y la Odds ratio.

La correlación de Pearson cuantifica la relación entre dos variables cuantitativas.

La Odds ratio cuantifica la relación entre dos variables cualitativas dicotómicas (una variable dicotómica es una variable con sólo dos valores posibles).

En este curso 0 para introducirnos en el mundo de las técnicas de relación vamos a centrarnos en la Odds ratio, que es una medida extraordinariamente importante, especialmente en el ámbito de las ciencias de la salud.

Lo vamos a hacer viendo una serie de artículos de este blog que están pensados especialmente para introducirnos en esta importante técnica estadística. Los artículos son los siguientes:

La Odds ratio para estudiantes de primaria

Introducción a la Odds ratio para estudiantes de ESO (1): Planteamiento de una situación

Introducción a la Odds ratio para estudiantes de ESO (2): Solución de la situación

3. Técnicas de comparación

Con las técnicas de comparación tratamos de comparar los valores de una variable en diferentes muestras. El objetivo será, evidentemente, como siempre, ver si las diferencias que detectamos en las MUESTRAS son generalizables a las POBLACIONES que hay detrás de ellas. Esto siempre está presente porque, no lo olvidemos, de nuevo, este es el objetivo de la Estadística como ciencia.

Hay que distinguir, a la hora de realizar una comparación estadística, varias situaciones distintas muy importantes:

a. Comparación de dos poblaciones/Comparación de más de dos poblaciones.

b. Comparación de una variable dicotómica/Comparación de una variable cuantitativa.

c. Comparación de muestras independientes/Comparación de muestras relacionadas.

d. Comparación de variables cuantitativas normales/Comparación de variables cuantitativas no normales.

e. Comparación de proporciones/Comparación de medias/Comparación de medianas/Comparación de distribuciones/Comparación de correlaciones/Comparación de Odds ratio.

Y todo esto porque así como en las técnicas de relación hay realmente un listado pequeño de técnicas analíticas (la correlación de Pearson y la Odds ratio son muy mayoritarias), en las técnicas de comparación son muchísimas las técnicas de comparación que se aplicar en la realidad. Y es en función de estos conceptos vistos cómo van delimitándose cuáles son las técnica a aplicar en un momento determinado.

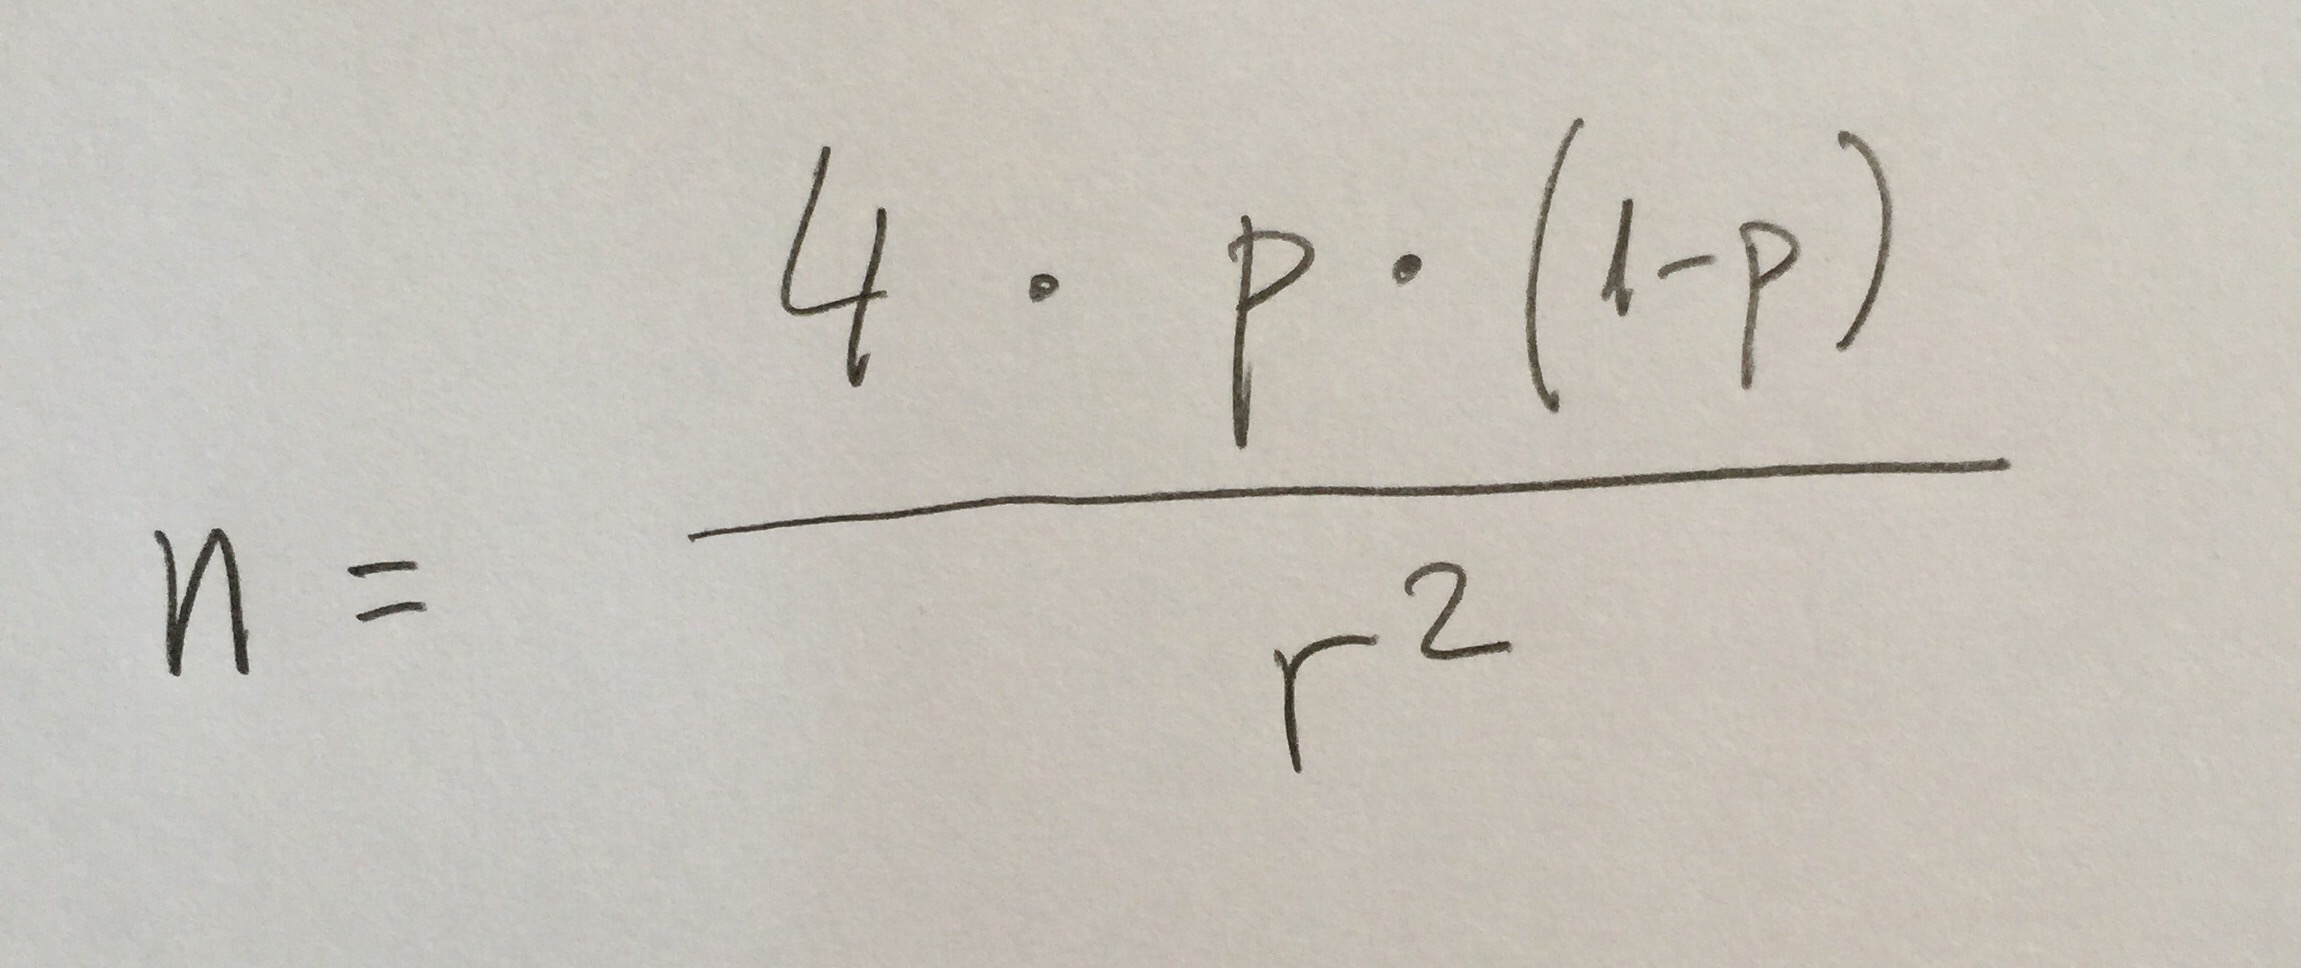
Solución Situación 101

1b:Debe aplicarse la fórmula de la construcción de un intervalo de confianza del 95%. Aquí tenemos las dos fórmulas. La primera para una variable cuantitativa y la segunda para una variable dicotómica. En nuestro caso debemos aplicar la segunda:

IMG_8047

El cálculo es:

0,08±2x(Raíz(0,08×0,92))/Raíz(10000))

en tanto por uno, que da este intervalo de (7.46, 8.54), en tanto por ciento.

2a: El error estándar es 0.25 porque el radio del intervalo es 0.5 y como es un intervalo del 95% se ha cogido dos veces ese error estándar al construir el intervalo.

Entonces: 0.25=DE/Raíz(400). Por lo tanto, la DE es 5.

Si ahora construimos un intervalo de valores individuales del 95% debemos coger dos veces esa DE y nos da el intervalo (40, 60).

3b: El primer cuartil es 5 y el tercero es 8. Por lo que el rango intercuartílico es 3.

4b: Es el único caso donde se dice lo mismo sobre la significación de la correlación y de la pendiente.

5d: Es el único caso donde la relación es significativa y, por lo tanto, el único caso donde tiene sentido hacer una predicción y, por lo tanto, será la mejore de las posibles predicciones.

6c:Este es el único caso en el que las dos afirmaciones van en la misma dirección de la respuesta generada. En este caso si disminuimos la diferencia de medias y aumentamos la desviación estándar el p-valor subirá por las dos causas.

7c:Debemos aplicar la fórmula:

img_3388

pero con una variación: con un 9 en lugar de un 4 porque es un intervalo del 99.5%, lo que implica que hay que construir un intervalo con 3 veces el error estándar. El 9 viene de hacer el cuadrado de 3. Podemos deducirlo de las fórmula del inicio del Tema 16.

Si aplicamos esta fórmula con una p=0.2 y un radio r=0.01 porque se trabaja siempre en tanto por uno, obtenemos n=14400.

8c:El valor de referencia es 12.59 en una tabla 4×3. Como el valor de la ji-cuadrado es mayor que ese valor de referencia el p-valor será menor que 0.05.

9d:Variable dicotómica, muestras relacionadas, la técnica a aplicar es el Test de McNemar.

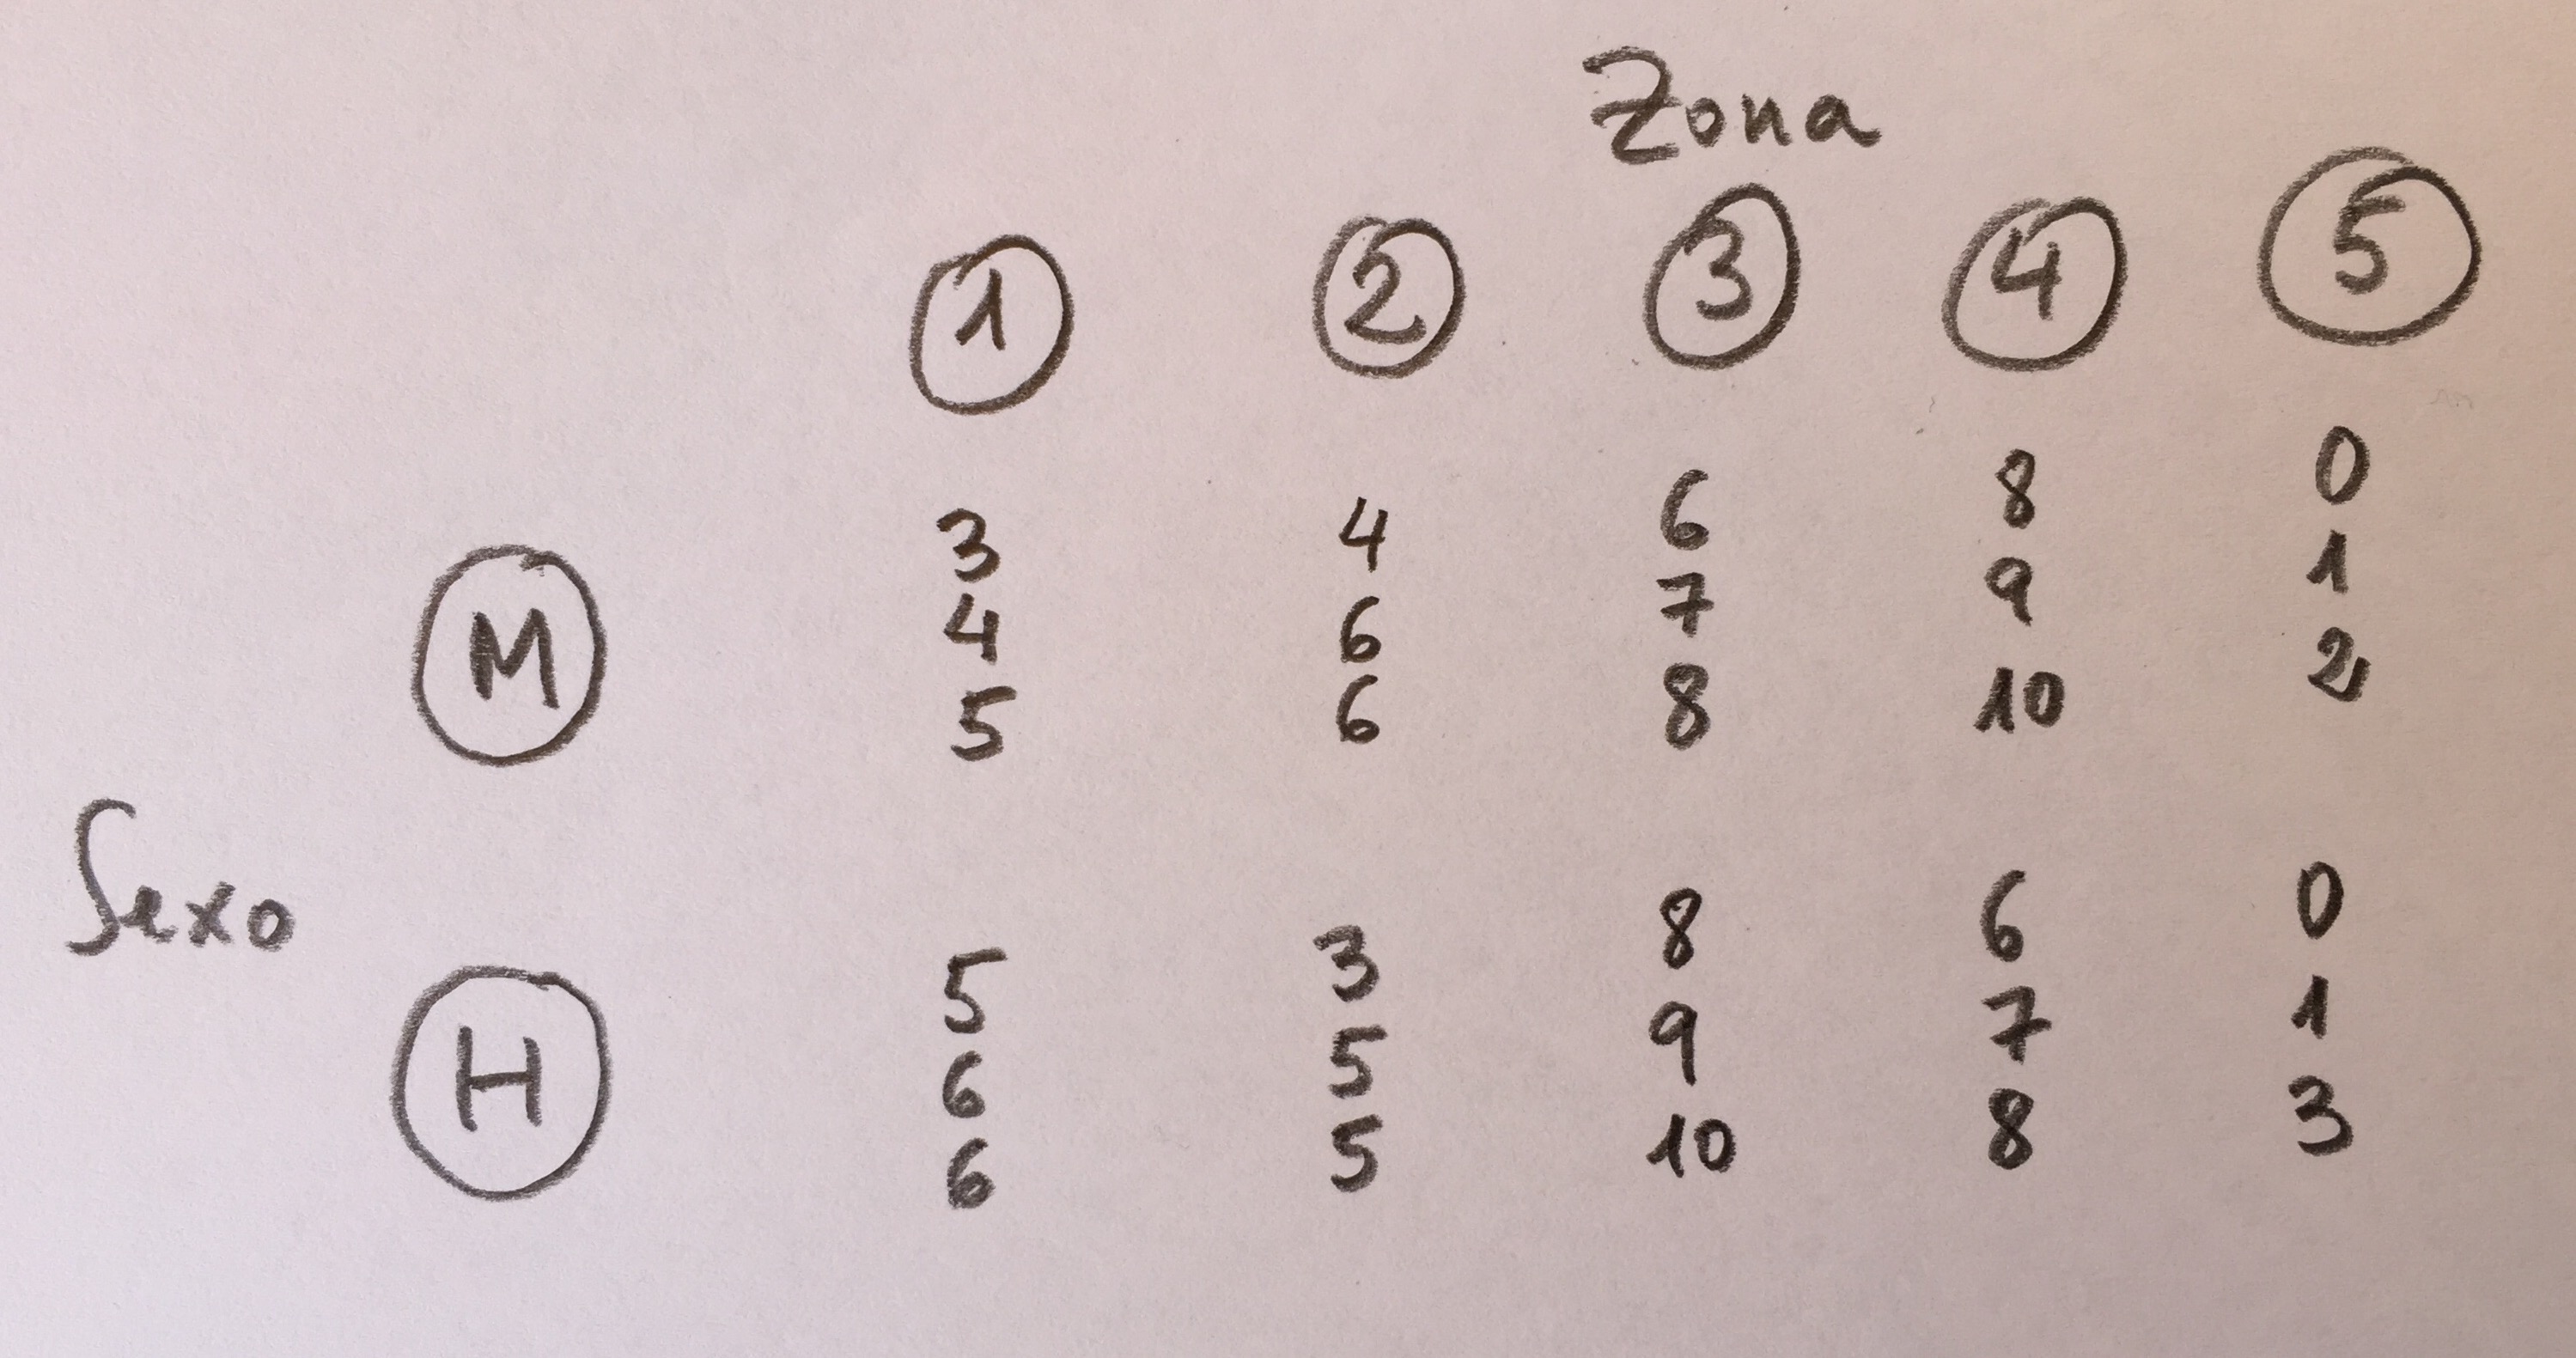
10a: Zona es un factor significativo. Claramente hay tres grupos homogéneos. El sexo no es significativo. Se observa claramente que en promedio no hay diferencias entre ambos sexos. Y hay interacción porque claramente dependiendo de la zona los valores de los sexos cambian.

11d: En un análisis de componentes principales siempre el número de componentes es el mismo que el número de variables originales del estudio.

12a: La Odds ratio estimada siempre debe estar dentro del intervalo de confianza construido.

13c:Es la Odds ratio con mayor relación. Veamos cuál es su equivalente del otro lado: 1/0.6=1.6666, que es mayor que 1.5. Las otras OR no hace falta valorarlas porque no son significativas.

14c: Observemos que intervalo de confianza que nos dan es del 68.5% no del 95%. Además, con lo próximo que está el 0 en este intervalo es evidente que el intervalo del 95% que será bastante mayor contendrá al 0 e indicará que no hay relación.

15c: Observemos que una OR de 5 es equivalente a una de 0.2. Si tener madre anoréxica es un factor de riesgo con OR de 5, obviamente no tenerla es un factor de protección equivalente y, por lo tanto, con OR de 0.2.

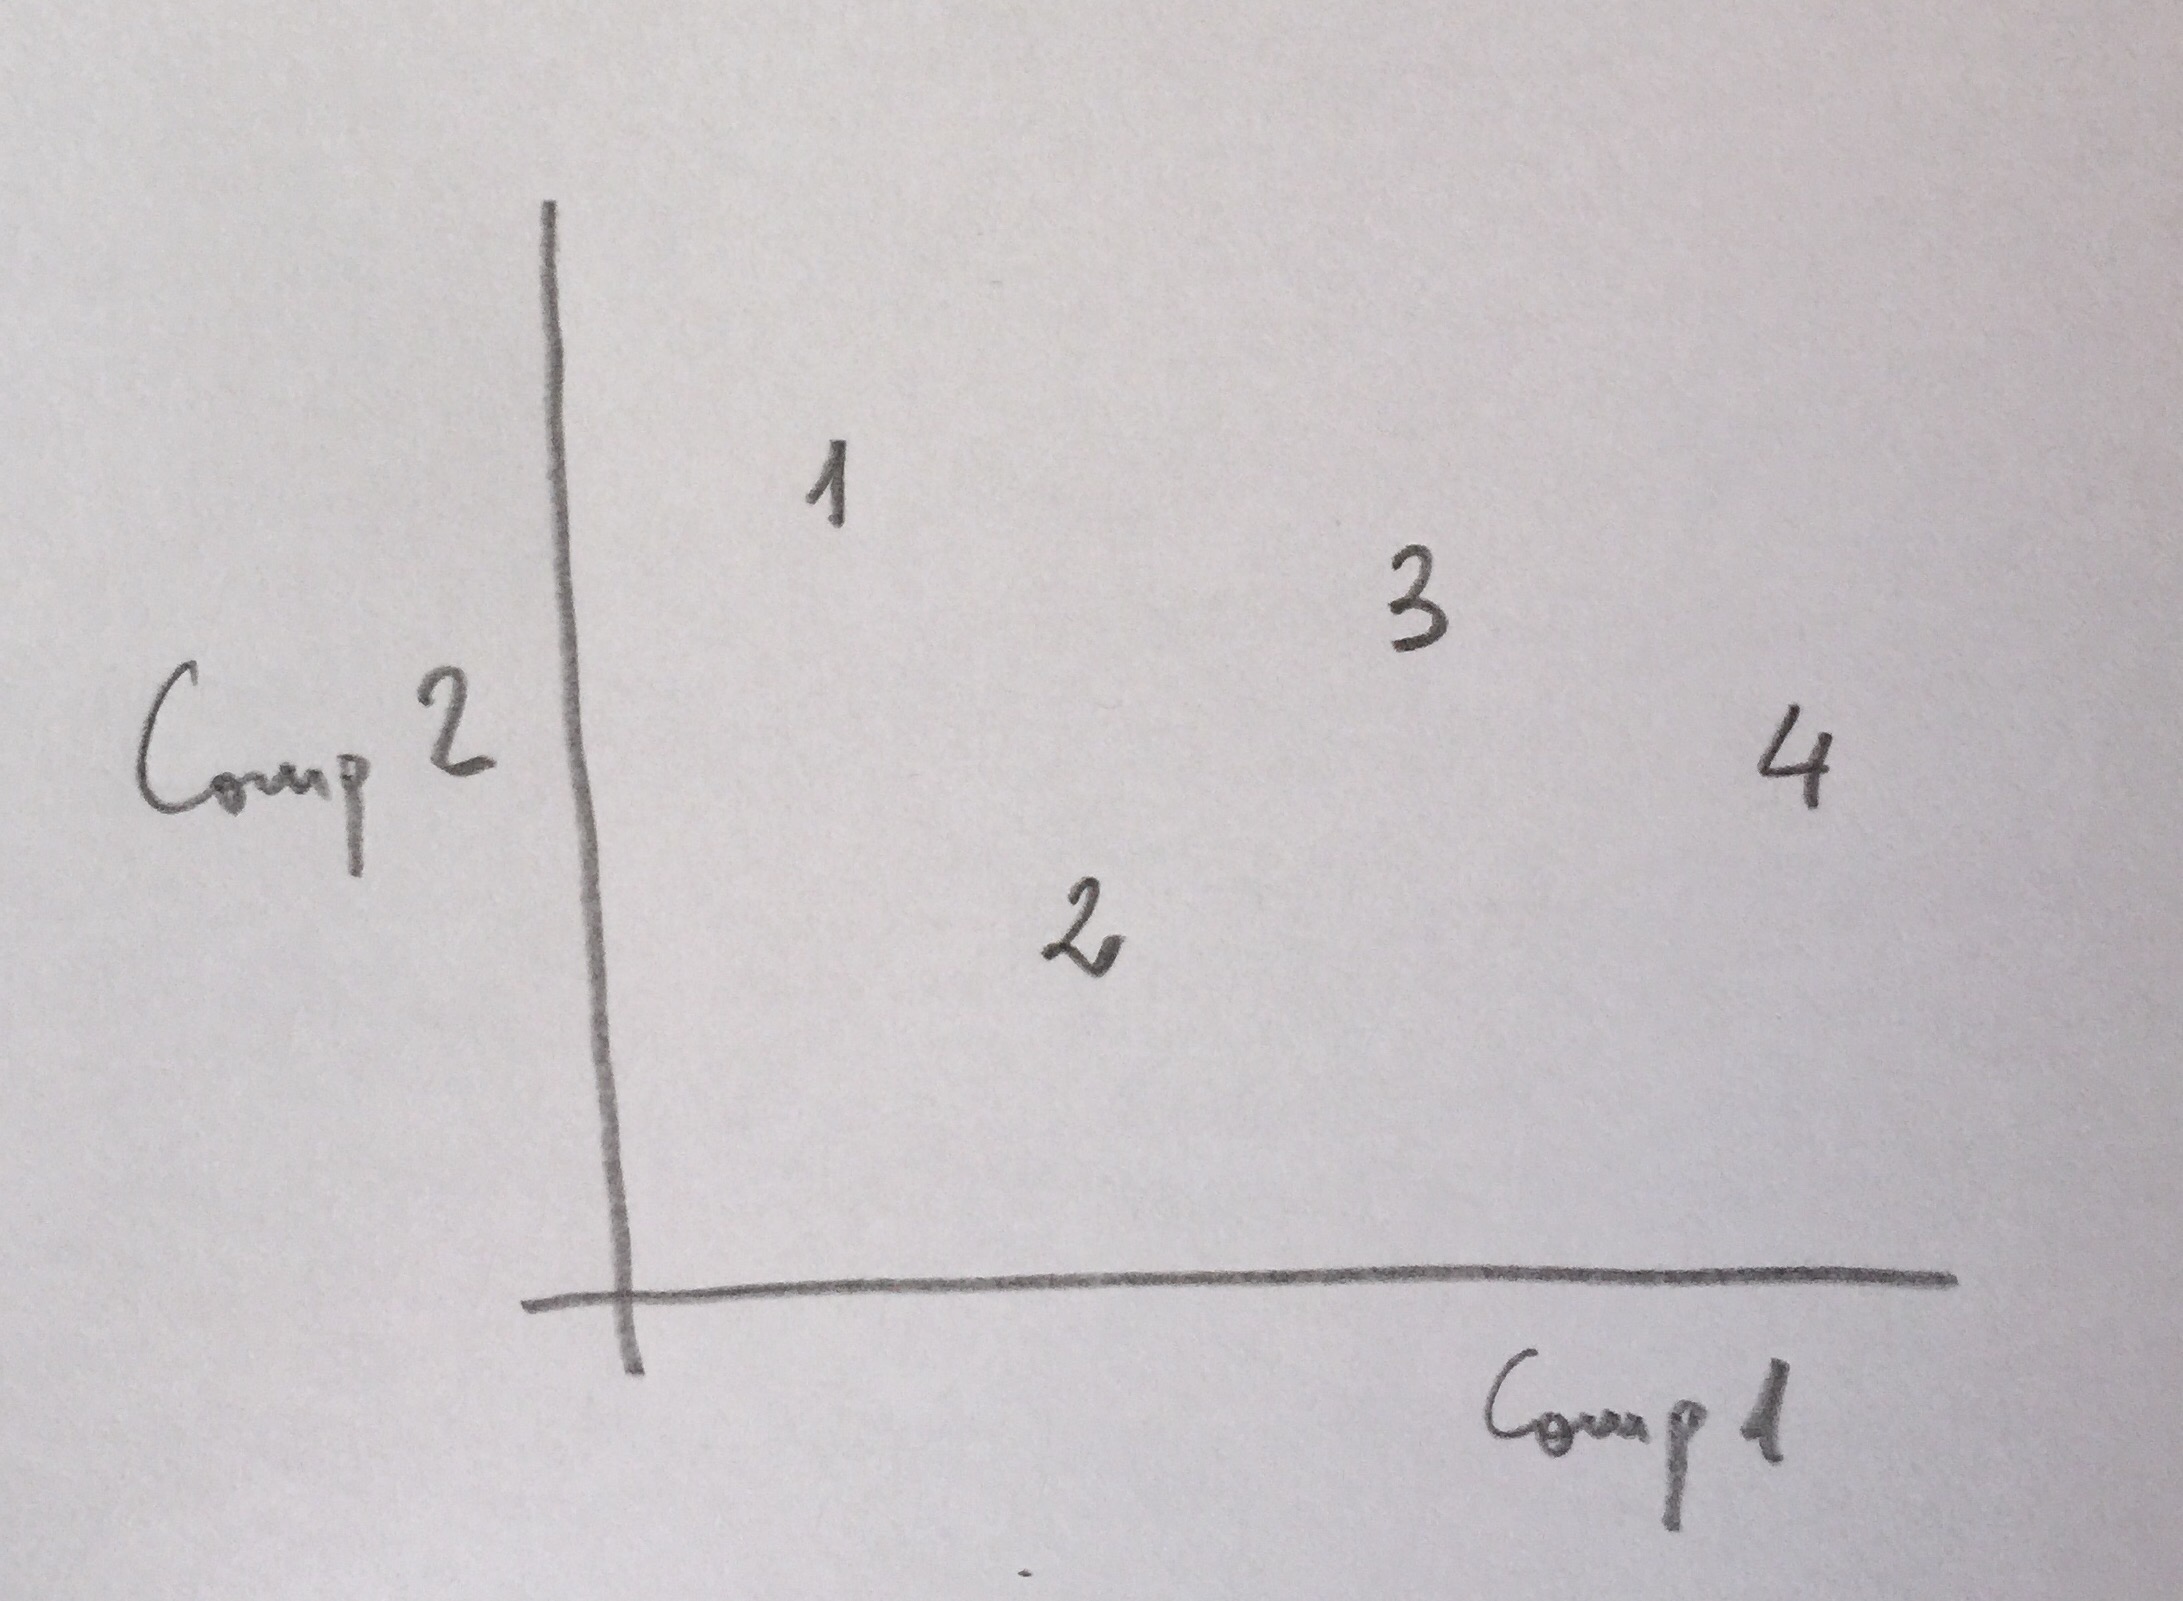
16d: El 2 está a la izquierda para la primera componente y abajo para la segunda. Para estar a la izquierda por la primera componente debe tener valores pequeños de X e Y y grandes de Z. En este caso c y de serían las opciones. Para estar abajo para la segunda componente es necesario que X sea pequeño e Y más grande. Sería el caso, pues, de la opción d.

17c:Es la respuesta incorrecta. Porque claramente no hay relación. Observad que hay un total paralelismo entre las filas. La tabla esperada será exactamente igual que la observada. Por lo tanto, a y b serán ciertas y la d también es cierta: 9.4877 es el valor umbral.

18c: Tenemos dibujados los Box-Plot. Para saber si hay diferencias significativas debemos construir los intervalos de la media y ver si se solapan y, por lo tanto, necesitamos el tamaño de muestra.

19c:La ji-cuadrado no da la significación de una V de Crámer. Como en este caso el p-valor es mayor que 0.05 esta V aunque sea muy grande no es estadísticamente significativa.

20b: En un contraste de hipótesis siempre podemos comenter un error: o el de tipo 1 ó el de tipo 2. Siempre. En este caso, debido al p-valor mantendríamos la Hipótesis nula, por lo que podríamos cometer el error de tipo 2.

Situación 101: Examen (Temas 1-17 y 19)

1.Si en un estudio sobre la prevalencia de una enfermedad psiquiátrica tenemos una muestra de tamaño 10000 de los cuales 800 tienen esa patología, un intervalo de confianza del 95% del porcentaje poblacional será:

a)(7.20, 8.80)

b)(7.46, 8.54)

c)(7.16, 8.84)

d)(7.50, 8.50)

2.En un estudio vemos que nos dan el siguiente intervalo de confianza del 95% de la media: (49.5, 50.5). Leemos que el tamaño de muestra ha sido 400. ¿Cuál es el intervalo de confianza del 95% descriptivo de la variable o, también denominado, intervalo de valores individuales de esa variable?

a)(40, 60)

b)(35, 65)

c)(30, 70)

d)(45, 55)

3.¿En cuál de las siguientes muestras el rango intercuartílico es 3?

a)(1, 3, 6, 10)

b)(1, 5, 5, 8, 12)

c)(1, 3, 3, 3, 7)

d)(1, 1, 3, 6)

4.De las siguientes afirmaciones cuál es cierta:

a)En una Regresión es compatible una pendiente con p=0.45 con un IC de confianza del 95% de la correlación de (-0.7, -0.1)

b) En una Regresión es compatible un intervalo de confianza del 95% de la pendiente (-2.1, 3.8) con una correlación con p=0.28

c) En una Regresión es compatible una pendiente con un p-valor de 0.01 con una de la correlación  con un intervalo de confianza del 95% (-0.2, 0.3)

d) En una Regresión es compatible un intervalo de confianza del 95% de la pendiente (1.7, 3.8) con uno de la correlación de (-0.35, -0.15)

5.En cuál de las siguientes regresiones lineales simples podremos hacer mejores predicciones:

a) y=5x-5; IC del 95% de la pendiente (-1, 11)

b) y=10x-3; IC del 95% de la correlación (-0.2, 0.2)

c) y=x-2; IC del 95% de la pendiente (-1, 2)

d) y= 4x+1; IC del 95% de la correlación (0.1, 0.4)

6.Si en una comparación de dos poblaciones al aplicar el test adecuado al caso el p-valor final es 0.01 es cierto lo siguiente:

a)Si aumentamos el tamaño de muestra y disminuimos la desviación estándar el p-valor subirá.

b)Si aumentamos la desviación estándar y aumentamos la diferencia de medias el p-valor bajará.

c)Si disminuimos la diferencias de medias y aumentamos la desviación estándar el p-valor subirá.

d)Si disminuimos el tamaño de muestra y aumentamos la diferencia de medias el p-valor bajará.

7.Se quiere hacer un pronóstico del porcentaje de consumidores que tendría un producto y se quiere tener una muy buena precisión: que el radio del intervalo sea del 1% en un intervalo del 99.5%. Sabemos que un producto similar en países muy parecidos al nuestro tiene un porcentaje de consumo alrededor del 20%. ¿Cuál es el tamaño de muestra recomendable en base a esta información:

a)6400.

b)11500.

c)14400.

d)8800.

8.Si en una tabla de contingencias 4×3 en la que relacionamos dos variables cualitativas tenemos que el valor de la ji-cuadrado es 14.55 podemos afirmar:

a)Que el p-valor es superior a 0.05 porque 14.55 es menor que el umbral que es 21.02.

b)Que el p-valor es inferior a 0.05 porque 14.55 es mayor que el umbral que es 3.84.

c)Que el p-valor es inferior a 0.05 porque 14.55 es mayor que el umbral que es 12.59.

d)Que el p-valor es superior a 0.05 porque 14.55 es menor que el umbral que es 24.99.

9.Se ensayan dos medicamentos (A y B) en 50 pacientes con Alzhéimer, en dos épocas distintas. Cada paciente recibe, pues, ambos tratamientos en épocas diferentes. El objetivo es evaluar si durante medio año el valor del Mini-Mental ha bajado o no respecto al valor basal. Con el A un 5% no baja y con el B no baja sólo un 2%. Para analizar los datos deberemos aplicar:

a)El Test de proporciones.

b)El Test exacto de Fisher.

c)El Test de Mann-Whitney.

d)El Test de McNemar.

10.Se ha hecho un estudio de valoración de la atención psicológica en pediatría entre el 1 y el 10 en cinco zonas del país y en los dos sexos (padres y madres). Los resultados obtenidos son los siguientes:

IMG_3467

a)Zona: p<0.05 con tres grupos homogéneos. Sexo: p>0.05. Interacción: p<0.05.

b)Zona: p<0.05 con tres grupos homogéneos. Sexo: p<0.05. Interacción: p<0.05.

c)Zona: p>0.05. Sexo: p>0.05. Interacción: p<0.05.

d)Zona: p<0.05 con dos grupos homogéneos. Sexo: p<0.05. Interacción: p>0.05.

  1. ¿Cuál de las siguientes afirmaciones es cierta?

a)Un intervalo de confianza de la media del 95% es siempre más amplio que un intervalo de confianza del 99.5% también de la media.

b)En una muestra con Asimetría estandarizada entre -2 y +2 la Curtosis estandarizada también cae entre -2 y +2.

c)En el Análisis clúster la hipótesis nula afirma que hay un único grupo y la hipótesis alternativa afirma, por el contrario, que hay más de un grupo.

d)En un Análisis de componentes principales hecho a diez variables originales obtenemos diez componentes.

12.¿Cuál de estas cuatro informaciones es incoherente?

a) OR=3.1; IC 95% (0.2, 0.45); p=0.001

b) OR=2.5; IC 95% (2.1, 3.2); p=0.0001

c) OR=2.8; IC 95% (1.24, 4.95); p=0.01

d) OR=0.6; IC 95% (0.12, 1.83); p=0.34

13.¿Qué Odds ratio indica una mayor relación?

a)OR=1.5; IC 95% (1.1, 2.45)

b)OR=2; IC 95% (0.91, 5.2)

c)OR=0.6; IC 95% (0.35, 0.87)

d)OR=0.3; IC 95% (0.02, 1.34)

14.En una Regresión lineal simple es cierto:

a)Si la pendiente tiene un intervalo de confianza del 95% de (0.55, 1.5) no es estadísticamente significativa por contener al 1.

b)Si la R2 es inferior al 5% tenemos una relación que no es estadísticamente significativa entre las variables de la regresión.

c)Con una correlación r=0.3 con un intervalo de confianza del 68.5% de (0.03, 0.68) podemos decir que se trata de una correlación que no es estadísticamente significativa.

d)Una pendiente positiva o negativa pero estadísticamente significativa no puede tener una R2 menor del 50%.

15.¿Cuál de las siguientes afirmaciones es cierta?

a)Una correlación r=-0.75 (p<0.05) tendrá una pendiente de regresión negativa pero no necesariamente significativa.

b)Si en una muestra no hay normalidad, con una Asimetría estandarizada que desplaza mayoritariamente los valores hacia el lado izquierdo, por debajo del primer cuartil hay más valores que por encima del tercer cuartil.

c)Si tener madre anoréxica es un factor de riesgo para que una chica sea anoréxica con una OR=5, tener una madre sin anorexia es un factor de protección para la anorexia, con una OR=0.2.

d)El valor del percentil 75 es siempre mayor que el valor del percentil 25.

16.En un Análisis de componentes principales la primera componente principal es V=0.5X+0.5Y-0.5Z y la segunda es W=0.5X-0.5Y+0.01Z ¿Cuál de los siguientes puntos es el que está en la posición del 2?:

img_3462

a)(1, 0, 1)

b)(1, 2, 1)

c)(2, 1, 5)

d)(0, 2, 5)

17.En la tabla de contingencias siguiente:

Captura de pantalla 2016-05-29 a las 19.11.50

¿Cuál de las siguientes afirmaciones no es cierta?

a)El valor de la ji-cuadrado será 0.

b)El p-valor será 1.

c)El p-valor no será 1 porque la tabla de contingencia esperada no coincide con esta tabla observada.

d)El valor umbral a partir del cual rechazaríamos la hipótesis nula es 9.4877.

18.Hemos hecho una comparación de dos tratamientos en dos grupos diferentes. Los valores de la muestra que tenemos quedan representados de la siguiente forma mediante un Box-Plot:

IMG_3479

Si queremos hacer una comparación de medias de ambos grupos, ¿cuál de las siguientes afirmaciones es cierta?

a)Estos dos grupos constituyen un único grupo homogéneo puesto que se solapan los intervalos de confianza.

b)Las medias serán significativamente diferentes porque ya se observa que el grupo 2 tiene una media superior a la del grupo 1.

c)Necesitamos saber el tamaño de muestra para construir los intervalos de confianza de la media del 95% de cada grupo y ver si esos intervalos se solapan o no.

d)El test que deberíamos aplicar aquí es el test de proporciones.

19.¿Cuál de las siguientes afirmaciones es cierta?

a)Una Odds ratio de 0.5 con un intervalo de confianza del 95% que no contenga al cero es estadísticamente significativa.

b)Una correlación de Pearson de 0.9 con un intervalo de confianza del 95% que no contenga al uno es estadísticamente significativa.

c)Una V de Crámer de 0.9 con una ji-cuadrado con un p-valor de 0.15 implica que no hay relación significativa entre las variables cualitativas relacionadas.

d)Una R2 superior al 50% implica que la regresión lineal simple es estadísticamente significativa.

20.¿Qué error podríamos estar cometiendo si al comparar dos tratamientos el p-valor que obtenemos es de 0.25?

a)El error de tipo I.

b)El error de tipo II.

c)Ambos errores: El error de tipo I y el error de tipo II.

d)No podemos cometer error en este caso porque aceptaríamos la Hipótesis nula por ser el p-valor superior a 0.05.

Solución Situación 100

1c:Debe aplicarse la fórmula de la construcción de un intervalo de confianza del 95%. Aquí tenemos las dos fórmulas. La primera para una variable cuantitativa y la segunda para una variable dicotómica. En nuestro caso debemos aplicar la segunda:

IMG_8047

El cálculo es:

0,1±2x(Raíz(0,1×0,9))/Raíz(10000))

en tanto por uno, que da este intervalo de (9.4, 10.6), en tanto por ciento.

2c:El error estándar es 0.5 porque el radio del intervalo es 1 (porque la distancia que hay desde la media, que es 50 a cualquiera de los dos extremos del intervalo es 1) y como para construir  un intervalo del 95% de la media siempre se coge dos veces el valor de error estándar, éste error debe ser 0.5, porque dos veces 0.5 da 1.

Entonces aplicamos la fórmula del error estándar vista en el tema 3: EE=DE/Raíz(n); o sea, en nuestro caso: 0.5=DE/Raíz(400). Por lo tanto, la DE es 10.

Si ahora construimos un intervalo de valores individuales del 95% debemos coger dos veces esa DE y nos da el intervalo (30, 70). No olvidemos que los intervalos de confianza descriptivos, individuales (que significa individuo a individuo), se construyen con la DE y, en cambio, los intervalos de confianza de la media se construyen con el error estándar (EE).

3c:Con los valores (1, 2) la muestra es la que tendrá un índice de Gini mayor; o sea, será cuando tendremos un muestra con más desigualdad económica. Pensemos que se nos pide con qué dos valores aumentará el índice de Gini; o sea, con qué dos valores habrá más diferencia entre los ricos y los pobres. Añadiendo el 1 y el 2 estamos añadiendo dos personas con ganancias muy bajas. En este momento el individuo que gana 10 unidades monetarias es aún más rico respecto al resto de la muestra. Se crea más desigualdad. Esto se reflejará en un aumento del valor del índice de Gini. Evidentemente se puede calcular para comprobarlo. Pero intuitivamente debe comprenderse qué supone que se añadan dos individuos nuevos con ganancias bajas o, por el contrario, con ganancias altas.

4b: Este caso es el única en el que es coherente lo dicho en de la correlación y de la pendiente. En ambos casos se está diciendo que no hay significación.

5c: De las cuatro respuestas únicamente una presenta una relación significativa y, por lo tanto, es la única predicción posible y, por lo tanto, la mejor. Es la única que tiene un intervalo de confianza o de la pendiente o de la correlación que no tiene al 0 en su interior.

6c: Este es el único caso en el que las dos afirmaciones van en la misma dirección de la respuesta generada. En este caso si disminuimos la diferencia de medias y aumentamos la desviación estándar el p-valor subirá por las dos causas. Si disminuimos la diferencia de medias es evidente que el p-valor subirá, porque habrá más igualdad y si aumentamos la desviación estándar lo que estamos haciendo es mezclar más las muestras y esto se reflejará también en un mayor aumento del p-valor porque será aún más razonable la hipótesis nula.

En los otros casos no sucede así. O en ambos casos no se cumple el resultado dicho o en un caso sí y en otro no, lo que implica que no puede decirse en general que se obtenga en resultado argumentado. Por ejemplo, cojamos la respuesta d: Es verdad que si aumentamos la diferencia de medias el p-valor bajará, porque será más razonable rechazar la hipótesis nula, pero si disminuimos el tamaño de muestra sucederá justo lo contrario: el p-valor subirá porque será más razonable mantener la hipótesis nula. Esta contradicción entre ambas afirmaciones es lo que impide que podamos seleccionar esta opción d.

7c:Debemos aplicar la fórmula:

img_3388

pero con una variación: con un 9 en lugar de un 4 porque es un intervalo del 99.5%, lo que implica que hay que construir un intervalo con 3 veces el error estándar. El 9 viene de hacer el cuadrado de 3. Podemos deducirlo de las fórmula del inicio del Tema 16.

Si aplicamos esta fórmula con una p=0.2 y un radio r=0.01 porque se trabaja siempre en tanto por uno, obtenemos n=14400.

8c:El valor de referencia es 12.59 en una tabla 4×3. Como el valor de la ji-cuadrado es mayor que ese valor de referencia el p-valor será menor que 0.05.

9d:Variable dicotómica, muestras relacionadas, la técnica a aplicar es el Test de McNemar.

10a: Zona es un factor significativo. Claramente hay tres grupos homogéneos. El sexo no es significativo. Se observa claramente que en promedio no hay diferencias entre ambos sexos. Y hay interacción porque claramente dependiendo de la zona los valores de los sexos cambian.


Situación 100: Examen (Temas 1-16)

1.Si en un estudio sobre la estimación poblacional de posibles consumidores de un nuevo producto tenemos una muestra de tamaño 10000 de los cuales 1000 serían consumidores de ese producto, un intervalo de confianza del 95% del porcentaje poblacional será:

a)(9.2, 10.8)

b)(9.5, 10.5)

c)(9.4, 10.6)

d)(9.0, 11.0)

2.En un estudio vemos que nos dan el siguiente intervalo de confianza del 95% de la media: (49, 51). Leemos que el tamaño de muestra ha sido 400. ¿Cuál es el intervalo de confianza del 95% descriptivo de la variable o, también denominado, intervalo de valores individuales de esa variable?

a)(40, 60)

b)(35, 65)

c)(30, 70)

d)(45, 55)

3)Tenemos un grupo con los siguientes sueldos en unidades monetarias: (1, 5, 6, 7, 10). Si llegan al grupo dos nuevos individuos, con cuáles aumentará más el índice de Gini:

a)(1, 10)

b)(10, 12)

c)(1, 2)

d)(5, 7)

4.De las siguientes afirmaciones cuál es cierta:

a) En una Regresión es compatible una pendiente con p=0.34 con un IC de confianza del 95% de la correlación de (-0.5, -0.2)

b) En una Regresión es compatible un intervalo de confianza del 95% de la pendiente (-2.8, 5.7) con una correlación con p=0.21

c) En una Regresión es compatible una pendiente con un p-valor de 0.001 con una de la correlación  con un intervalo de confianza del 95% (-0.3, 0.5)

d) En una Regresión es compatible un intervalo de confianza del 95% de la pendiente (2.7, 5.7) con uno de la correlación de (-0.4, -0.1)

5.En cuál de las siguientes regresiones lineales simples podremos hacer mejores predicciones:

a) y=3x-2; IC del 95% de la pendiente (-1, 7).

b) y=2x-3; IC del 95% de la correlación (-0.1, 0.99)

c) y=x-2; IC del 95% de la pendiente (0.3, 2)

d) y= -4x+2; IC del 95% de la correlación (-0.7, 0.1).

6.Si en una comparación de dos poblaciones al aplicar el test adecuado al caso el p-valor final es 0.01 es cierto lo siguiente:

a)Si aumentamos el tamaño de muestra y disminuimos la desviación estándar el p-valor subirá.

b)Si aumentamos la desviación estándar y aumentamos la diferencia de medias el p-valor bajará.

c)Si disminuimos la diferencias de medias y aumentamos la desviación estándar el p-valor subirá.

d)Si disminuimos el tamaño de muestra y aumentamos la diferencia de medias el p-valor bajará.

7.Se quiere hacer un pronóstico del porcentaje de consumidores que tendría un producto y se quiere tener una muy buena precisión: que el radio del intervalo sea del 1% en un intervalo del 99.5%. Sabemos que un producto similar en países muy parecidos al nuestro tiene un porcentaje de consumo alrededor del 20%. ¿Cuál es el tamaño de muestra recomendable en base a esta información:

a)6400.

b)11500.

c)14400.

d)8800.

8.Si en una tabla de contingencias 4×3 en la que relacionamos dos variables cualitativas tenemos que el valor de la ji-cuadrado es 14.55 podemos afirmar:

a)Que el p-valor es superior a 0.05 porque 14.55 es menor que el umbral que es 21.02.

b)Que el p-valor es inferior a 0.05 porque 14.55 es mayor que el umbral que es 3.84.

c)Que el p-valor es inferior a 0.05 porque 14.55 es mayor que el umbral que es 12.59.

d)Que el p-valor es superior a 0.05 porque 14.55 es menor que el umbral que es 24.99.

9.Se comparan dos productos distintos y para ello se toma un grupo de 40 personas. Todos degustan los dos productos. La variable estudiada es si se consumiría el producto o no. Un producto lo consumiría un 10% y el otro un 5%. Para ver si esa diferencia es estadísticamente significativa debemos aplicar:

a)El Test de proporciones.

b)El Test exacto de Fisher.

c)El Test de Mann-Whitney.

d)El Test de McNemar.

10.Se ha hecho un estudio de valoración de un producto entre el 1 y el 10 en cinco zonas y en los dos sexos. Los resultados obtenidos son los siguientes:

IMG_3467

a)Zona: p<0.05 con tres grupos homogéneos. Sexo: p>0.05. Interacción: p<0.05.

b)Zona: p<0.05 con tres grupos homogéneos. Sexo: p<0.05. Interacción: p<0.05.

c)Zona: p>0.05. Sexo: p>0.05. Interacción: p<0.05.

d)Zona: p<0.05 con dos grupos homogéneos. Sexo: p<0.05. Interacción: p>0.05.

Solución Situación 99

1d: Variable continua, muestras relacionadas. La resta se ajusta a la distribución normal (Test de Shapiro-Wilk con p>0.05), por lo que debemos aplicar un test de la t de Student de datos apareados.

2a: Si disminuimos el tamaño de muestra nos fiaremos menos aún de las diferencias de medias que tengamos, por lo que el p-valor subirá. En este caso es más incoherente, aún, rechazar la hipótesis nula de igualdad de medias.

3b: Variable dicotómica, muestras independientes, tamaño de muestra superior a 30 pero valor esperado por grupo inferior a 5 porque en una muestra tenemos 6 (el 12% de 50) y en la otra 2 (el 4% de 50). Esto no proporciona un valor esperado por grupo, bajo la hipótesis nula, de 4, que es inferior a 5. Debemos aplicar, pues, un test exacto de Fisher.

4d: Si en ambas muestras tenemos los mismos individuos las muestras son relacionadas y, por lo tanto, nunca aplicaríamos un test exacto de Fisher.

5b: En un test de ajuste a la normal la hipótesis nula es que hay normalidad por lo que si el p-valor es inferior a 0.05 debemos rechazarla y admitir que no hay ajuste a la normal.

6d: Si un factor no es significativa en un ANOVA evidentemente las comparaciones múltiples nos mostrarían un único grupo homogéneo.

7b: Claramente el ANOVA nos dará un p-valor inferior a 0.05. Y claramente también se observan tres grupos homogéneos: El 1 y 2, por un lado, el 3, por otro, y el 4 y 5 por otro.

8c: Basta aplicar la fórmula n=(4*100*100)/(10*10)=400

9c: Mirando la tabla para determinar el tamaño de muestra en poblaciones finitas se observa claramente que para ese nivel de error y para ese tamaño poblacional el tamaño de muestra es 385.

10a: Los dos factores no son significativos. No hay diferencias en las medias de las dos columnas o entre las dos filas. Sin embargo, hay claramente interacción: dependiendo de la combinación de niveles de un factor con otro los resultados son muy diferentes.


Situación 99: Examen (Temas 13-16)

1.En un estudio donde se quiere comparar dos productos distintos tenemos 100 voluntarios. A cada voluntario le hacemos probar los dos productos. La variable respuesta analizada es una escala del 0 al 100. El test de Shapiro-Wilk de la variable resta nos da un p-valor mayor que 0.05. El test de Fisher-Snedecor nos proporciona una p=0.001. Es cierto lo siguiente:

a)Debemos aplicar el test de la t de Student para varianzas desiguales y si tenemos un p-valor inferior a 0.05 debemos concluir que las medias son diferentes.

b)Debemos aplicar el test de la t de Student para varianzas desiguales y si tenemos un p-valor inferior a 0.05 debemos concluir que las medias no son diferentes.

c)Debemos aplicar el Test de Wilcoxon.

d)Debemos aplicar el Test de la t de Student de datos apareados.

2.Si en una comparación de dos poblaciones al aplicar el test adecuado al caso el p-valor final es 0.3 es cierto lo siguiente:

a)Si disminuimos el tamaño de muestra el p-valor subirá.

b)Si aumentamos la desviación estándar de ambas muestras el p-valor bajará.

c)Si disminuimos la diferencias de medias entre ambas muestras el p-valor bajará.

d)Ninguna de las respuestas anteriores es cierta.

3.Se comparan dos zonas distintas para ver el nivel de consumo de un producto. Tomamos 50 personas en cada zona. La variable estudiada es si se consume el producto o no. En una zona el consumo es del 12% y en la otra es del 4%. Para ver si esa diferencia es estadísticamente significativa debemos aplicar:

a)El Test de proporciones.

b)El Test exacto de Fisher.

c)El Test de Mann-Whitney.

d)El Test de McNemar.

4.Si se ha aplicado en Test exacto de Fisher no puede ser cierto:

a) El tamaño de muestra es de 100 por muestra.

b)Las muestras son independientes.

c)La variable respuesta es una variable cuantitativa dicotomizada.

d) Los individuos que tenemos son los mismos en ambas muestras.

5.¿Cuál de las siguientes afirmaciones es cierta?

a)Si en una comparación de dos poblaciones aplicamos un Test de McNemar es que la variable estudiada no se ajusta bien a una distribución normal.

b)En un contraste de hipótesis para evaluar el ajuste a la distribución normal un p-valor inferior a 0.05 indica que no hay suficiente ajuste de los datos a la distribución normal.

c)Con una potencia inferior al 80% nos podemos fiar del p-valor que tengamos.

d)En un ANOVA de dos factores con interacción sólo miraremos el p-valor de la interacción si el p-valor de alguno de los dos factores es significativo.

6.¿Cuál de las siguientes afirmaciones es cierta?

a)Una potencia superior al 50% indica que tenemos buena capacidad predictiva.

b)Si se aplica un Test de McNemar es que las muestras no son apareadas.

c)En un ANOVA de un factor si el p-valor es menor que 0.05 ya hemos acabado el análisis.

d)Si realizamos en un ANOVA unas comparaciones múltiples en un factor no significativo encontraremos una única población homogénea.

7.En una ANOVA de un factor como el siguiente:

img_3461

a)El p-valor será menor que 0.05 y tenemos dos grupos homogéneos.

b)El p-valor será menor que 0.05 y tenemos tres grupos homogéneos.

c)El p-valor será mayor que 0.05 y tenemos dos grupos homogéneos.

d)El p-valor será menor que 0.05 y tenemos cuatro grupos homogéneos.

8.Se quiere hacer un pronóstico de la media poblacional de la concentración de un determinado neurotransmisor. ¿Qué tamaño de muestra necesitamos tomar para tener un intervalo del 95% de radio 10 si la Desviación estándar que tenemos en una muestra piloto es de 100?:

a)250.

b)1000.

c)400.

d)25.

9.Queremos saber cuánto tamaño de muestra necesitamos para estimar el porcentaje de consumo que hay en una población de 10000 habitantes sin poder realizar una muestra piloto. Y queremos hacerlo con un radio del intervalo del 5%. El tamaño será:

a)222

b)1000

c)385

d)400

10.Tenemos los siguientes datos en un estudio donde vamos a aplicar un ANOVA de dos factores:

img_3460

¿Cuál es la afirmación más razonable?:

a)Factor A: p>0.05. Factor B: p>0.05. Interacción: p<0.05.

b)Factor A: p<0.05. Factor B: p<0.05. Interacción: p<0.05.

c)Factor A: p<0.05. Factor B: p<0.05. Interacción: p>0.05.

d)Factor A: p<0.05. Factor B: p>0.05. Interacción: p>0.05.

Solución Situación 98

1d: Los tres p-valores de un ANOVA de dos factores son independientes. Puede darse cualquiera de las posibles combinaciones en ellos. Ninguno depende de ningún otro.

2a: Variables continuas, muestras independientes, normalidad porque ambas muestras nos dan un p-valor en el Shapiro-Wilk superior a 0.05. El test de Fisher-Snedecor nos da un p-valor inferior a 0.05 por lo que son diferentes las varianzas. Habrá que aplicar un test de la t de Student de varianzas desiguales. El p-valor de este último test es inferior a 0.05 por lo tanto debemos concluir que las medias son diferentes.

3d: Ninguna de las tres primeras opciones es cierta. Por lo tanto, la cierta es la cuarta.

4a: Variable dicotómica, muestras independientes. Tamaño de muestras mayor que 30 y el valor esperado por grupo es superior a 5, por lo tanto debemos aplicar el test de proporciones.

5a: Ni el factor A ni el B son significativas. Pero, claramente hay interacción.

6c: Con unos datos como los que se dan claramente la distribución no es normal. Por lo tanto, debe aplicarse el test de Mann-Whitney.

7d: Hagamos los cálculos de la primera componente para cada individuo:

x y z w
3 4 4 -2,22
1 2 5 -2,8
4 5 1 -0,73
5 1 1 1,57

El valor superior es el del tercer individuo, el d. Es el que estará más a la derecha.

8b: El test de McNemar es claramente un test para datos apareados que es sinónimo de muestras relacionadas.

9c: Podemos aplicar un ANOVA de un factor con estos datos. Más en concreto: un factor con cinco niveles.

10c: Basta aplicar la fórmula n=(4*20*20)/(4*4)=100


Situación 98: Examen (Temas 13-17 y 19)

1.¿Cuál de las siguientes afirmaciones es cierta?

a)Si en una comparación de dos poblaciones aplicamos un Test de McNemar es que las muestras son independientes.

b)En un contraste de hipótesis para evaluar el ajuste a la distribución normal un p-valor inferior a 0.05 indica que hay suficiente ajuste de los datos a la distribución normal.

c)Con una potencia superior al 50% nos podemos fiar del p-valor que tengamos.

d)En un ANOVA de dos factores con interacción el p-valor de la interacción no depende de cuál sea el p-valor de los dos factores.

2.En un estudio donde se quiere comparar dos psicoterapias distintas tenemos 100 pacientes que repartimos en dos grupos de igual tamaño. A cada grupo le aplicamos uno de los dos tratamientos a comparar. La variable respuesta analizada es una escala del 0 al 100. El test de Shapiro-Wilk de ambas muestras nos proporciona un p-valor mayor que 0.05. El test de Fisher-Snedecor nos proporciona una p=0.001. Es cierto lo siguiente:

a)Debemos aplicar el test de la t de Student para varianzas desiguales y si tenemos un p-valor inferior a 0.05 debemos concluir que las medias son diferentes.

b)Debemos aplicar el test de la t de Student para varianzas desiguales y si tenemos un p-valor inferior a 0.05 debemos concluir que las medias no son diferentes.

c)Debemos aplicar el Test de Mann-Whitney.

d)Debemos aplicar el Test de la t de Student de datos apareados.

3.Si en una comparación de dos poblaciones al aplicar el test adecuado al caso el p-valor final es 0.8 es cierto lo siguiente:

a)Si aumentamos el tamaño de muestra el p-valor subirá.

b)Si aumentamos la desviación estándar de ambas muestras el p-valor bajará.

c)Si disminuimos la diferencias de medias entre ambas muestras el p-valor bajará.

d)Ninguna de las respuestas anteriores es cierta.

4.Se comparan dos tratamientos distintos para pacientes con demencia. Tomamos 200 pacientes y los repartimos al azar en dos grupos de 100 cada uno. A cada grupo le aplicamos únicamente un tratamiento. La variable elegida para evaluar ambos tratamientos es si el Mini-Mental ha bajado después de un año más de dos puntos o no, respecto al valor basal. En un grupo baja más de dos puntos el valor del Mini-Mental en un 10% de pacientes y en el otro en un 6% de pacientes. Para ver si esa diferencia es estadísticamente significativa debemos aplicar:

a)El Test de proporciones.

b)El Test exacto de Fisher.

c)El Test de Wilcoxon.

d)El Test de McNemar.

5.Tenemos los siguientes datos en un estudio clínico donde se va a aplicar un ANOVA de dos factores:

img_3460

¿Cuál es la afirmación más razonable?:

a)Factor A: p>0.05. Factor B: p>0.05. Interacción: p<0.05.

b)Factor A: p<0.05. Factor B: p<0.05. Interacción: p<0.05.

c)Factor A: p<0.05. Factor B: p<0.05. Interacción: p>0.05.

d)Factor A: p<0.05. Factor B: p>0.05. Interacción: p>0.05.

6.Hemos comparado dos tratamientos antidepresivos. La variable analizada es, después de un año, el número de los 14 efectos secundarios que pueden generar ese tipo de tratamiento. Se ha trabajado con 400 pacientes. 200 en cada grupo. Cada paciente recibe un único tratamiento. La primera muestra tiene una media muestral de 1 y una desviación estándar de 5. La segunda muestra tiene una media de 2 y una desviación estándar de 6. En base a estos datos, ¿cuál es la técnica más adecuada al caso para realizar la comparación estadística?:

a)El Test de la t de Student de varianzas iguales.

b)El Test de la t de Student de varianzas diferentes.

c)El Test de Mann-Whitney.

d)El Test de la t de Student de datos apareados.

7.En un Análisis de componentes principales la primera componente principal es W=0.5X-0.45Y-0.48Z. ¿Cuál de los siguientes puntos es el que está en la posición del 4?:

img_3462

a)(3, 4, 4)

b)(1, 2, 5)

c)(4, 5, 1)

d)(5, 1, 1)

8.¿Cuál de las siguientes afirmaciones es cierta?

a)Una potencia del 85% se corresponden con un error de tipo II del 0.25.

b)En un Test de McNemar es un test para datos apareados.

c)En un ANOVA la variable respuesta estudiada debe ser dicotómica.

d)Después de un Test de la t de Student de varianzas distintas significativo debemos aplicar unas Comparaciones múltiples para ver cuántos grupos homogéneos tenemos.

9.En unos datos como los siguientes:

img_3461

a)Podemos aplicar un ANOVA con cinco factores.

b)Podemos aplicar un test de la t de Student.

c)Podemos aplicar un ANOVA de un factor.

d)Podemos aplicar un test de la t de Student de datos apareados.

10.Se quiere hacer un pronóstico de la media poblacional de la concentración de un determinado neurotransmisor. ¿Qué tamaño de muestra necesitamos tomar para tener un intervalo del 95% de radio 4 si la Desviación estándar que tenemos en una muestra piloto es de 20?:

a)20.

b)50.

c)100.

d)200.

Solución Situación 97

1c: Si el test de Shapiro-Wilk nos da un p-valor inferior a 0.05 es que no hay normalidad. Hay que hacer, entonces, un test de Mann-Whitney. El test de Fisher-Snedecor no es necesario.

2b: Si aumentamos la desviación estándar las muestras estarán más solapadas aún y, por lo tanto, el p-valor subirá. Será más incoherente rechazar la hipótesis nula.

3b: Variable dicotómica. Muestras independientes. Tamaño de muestra superior a 30 pero valor esperado por grupo menor que 5 porque en una muestra tenemos 5 casos (un 10% de 50) y en la otra 3 casos (un 6% de 50). El valor esperado por grupo, bajo la hipótesis nula, es 4. Por lo tanto, hemos de aplicar un test exacto de Fisher.

4b: Variable dicotómica. Muestras independientes. Tamaño de muestra superior a 30 y el valor esperado por grupo mayor que 5 porque en una muestra tenemos 4 casos (un 2% de 200) y en la otra 10 casos (un 5% de 200). El valor esperado por grupo, bajo la hipótesis nula, es 7. Por lo tanto, hemos de aplicar un test de proporciones.

5b: En un test de ajuste a la normal la hipótesis nula es que hay normalidad. Por lo que si el p-valor es menor que 0.05 debemos rechazarla.

6c: Un ANOVA se aplica únicamente a variables cuantitativas y, más en concreto, que se ajusten a la distribución normal.

7b: Claramente hay diferencias significativas entre los cinco niveles. Por lo tanto, el p-valor del ANOVA será menor que 0.05. Y se ve claramente que hay tres grupos homogéneos: El formado por los niveles 1 y 2, el formado por el nivel 3 y el formado por los niveles 4 y 5.

8d: Si aplicamos la fórmula nos da n=(4*100*100)/(40*40)=25.

9c: Hagamos los cálculos de la primera componente W para cada uno de los valores:

x y z w
3 4 4 1,38
1 2 5 -1
4 5 1 3,77
1 5 4 0,83

Por lo tanto, el que está más a la derecha es el tercer valor, el c, porque tiene el valor mayor de la primera componente.

10a: Los dos factores no son significativos. No hay diferencias en las medias de las dos columnas o entre las dos filas. Sin embargo, hay claramente interacción: dependiendo de la combinación de niveles de un factor con otro los resultados son muy diferentes.