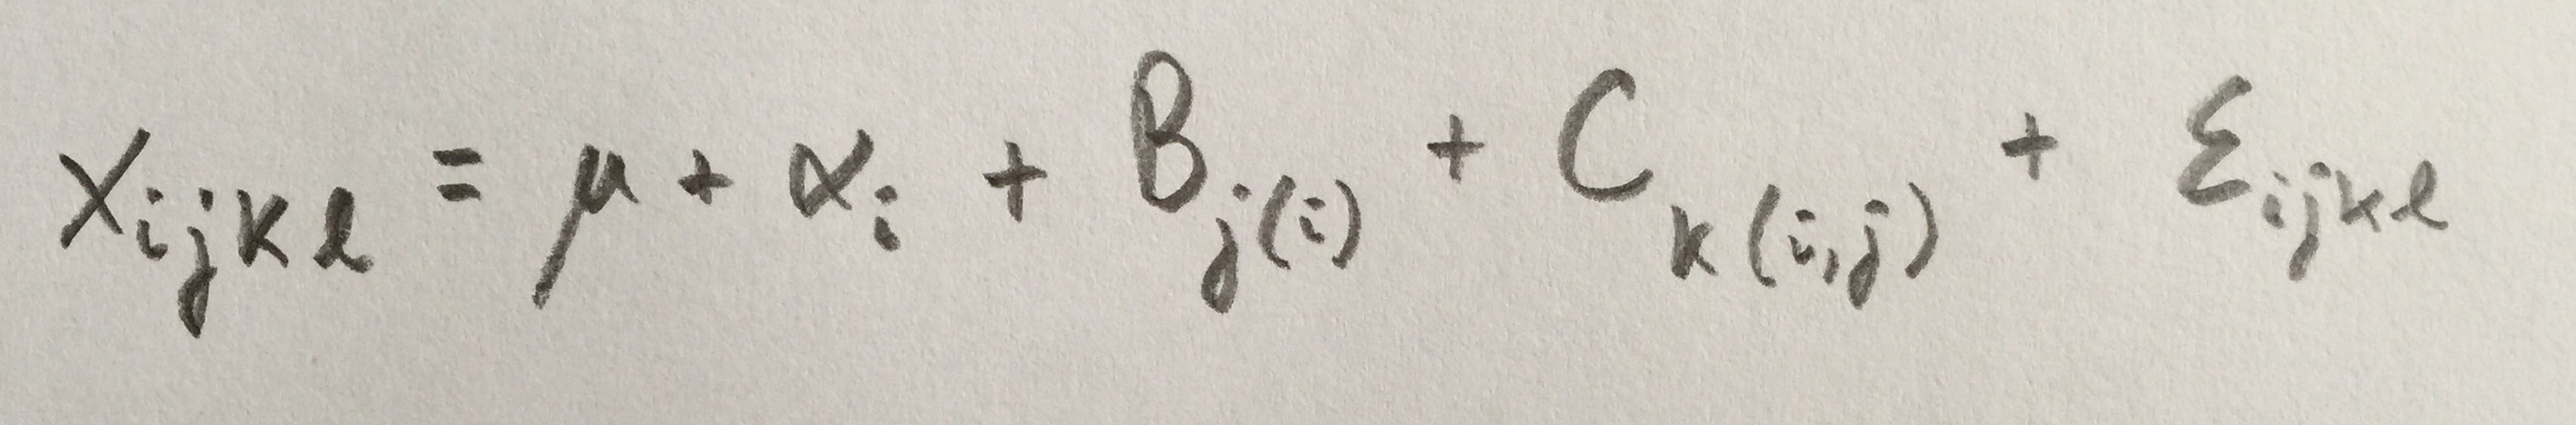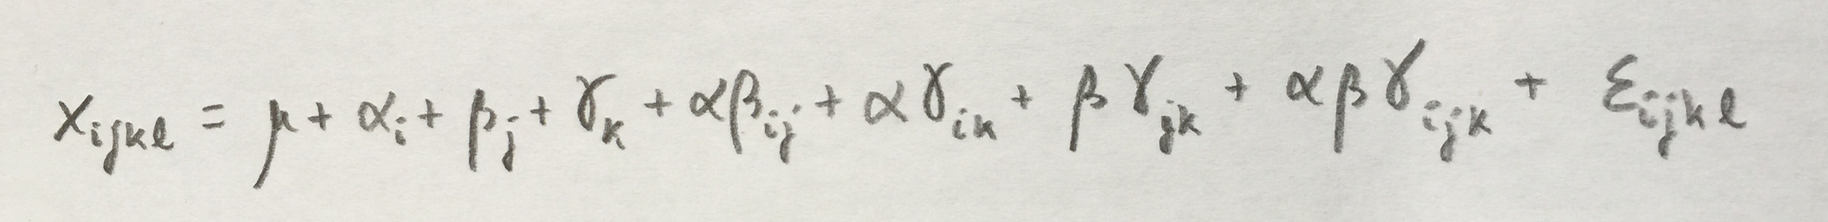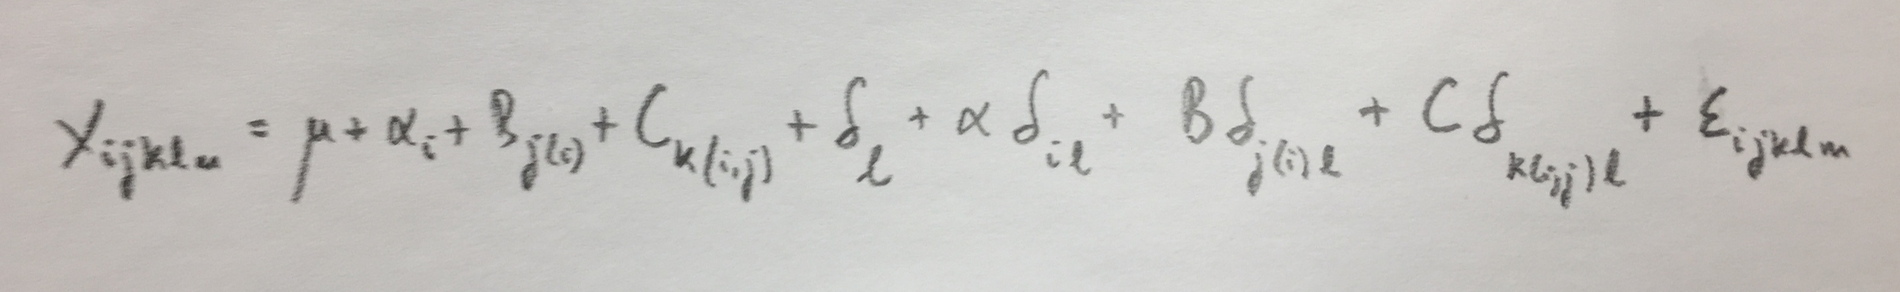Archivo del Autor: estadisticallopis

Situación 105: Examen práctico (Temas 1-15)

Se pretende estudiar la relación entre la biomasa del alga Spartina alterniflora y cinco variables ambientales en muestras obtenidas en tres zonas marinas distintas y a tres profundidades diferentes. Las variables son las siguientes:

Z=Zona

P=Profundidad

S=Salinidad en tanto por mil.

A=Acidez (pH)

K=Potasio (ppm)

Na=Sodio (ppm)

Zn=Zinc (ppm)

B=Biomasa (g/m2)

Z P S A K Na Zn B
1 1 33 5,00 1441,67 35184,50 16,45 676
1 1 35 4,75 1299,19 28170,40 13,99 516
1 1 32 4,20 1154,27 26455,00 15,33 1052
1 1 30 4,40 1045,15 25072,90 17,31 868
1 1 33 5,55 521,62 31664,20 22,33 1008
1 2 33 5,05 1273,02 25491,70 12,28 436
1 2 36 4,25 1346,35 20877,30 17,82 544
1 2 30 4,45 1253,88 25621,30 14,35 680
1 2 38 4,75 1242,65 27587,30 13,68 640
1 2 30 4,60 1282,95 26511,70 11,76 492
1 3 30 4,10 553,69 7886,50 9,88 984
1 3 37 3,45 494,74 14596,00 16,68 1400
1 3 33 3,45 526,97 9826,80 12,37 1276
1 3 36 4,10 571,14 11978,40 9,41 1736
1 3 30 3,50 408,64 10368,60 14,93 1004
2 1 30 3,25 646,65 17307,40 31,29 396
2 1 27 3,35 514,03 12822,00 30,17 352
2 1 29 3,20 350,73 8582,60 28,59 328
2 1 34 3,35 496,29 12369,50 19,88 392
2 1 36 3,30 580,92 14731,90 18,51 236
2 2 30 3,25 535,82 15060,60 22,13 392
2 2 28 3,25 490,34 11056,30 28,61 268
2 2 31 3,20 552,39 8118,90 23,19 252
2 2 31 3,20 661,32 13009,50 24,69 236
2 2 35 3,35 672,15 15003,70 22,68 340
2 3 29 7,10 525,65 10225,00 0,37 2436
2 3 35 7,35 563,13 8024,20 0,27 2216
2 3 35 7,45 497,96 10393,00 0,32 2096
2 3 30 7,45 458,38 8711,60 0,26 1660
2 3 30 7,40 498,25 10239,60 0,21 2272
3 1 26 4,85 936,26 20436,00 18,99 824
3 1 29 4,60 894,79 12519,90 20,97 1196
3 1 25 5,20 941,36 18979,00 23,98 1960
3 1 26 4,75 1038,79 22986,10 19,97 2080
3 1 26 5,20 898,05 11704,50 31,39 1764
3 2 25 4,55 989,87 17721,00 23,71 412
3 2 26 3,95 951,28 16485,20 30,56 416
3 2 26 3,70 939,83 17101,30 26,84 504
3 2 27 3,75 925,42 17849,00 27,73 492
3 2 27 4,15 954,11 16949,60 21,57 636
3 3 24 5,60 720,72 11344,60 19,65 1756
3 3 27 5,35 782,09 14752,40 20,33 1232
3 3 26 5,50 773,30 13649,80 19,59 1400
3 3 28 5,50 829,26 14533,00 20,13 1620
3 3 28 5,40 856,96 16892,20 19,24 1560
  1. Hacer una estadística descriptiva de la variable Biomasa en cada una de las tres zonas.
  2. Calcular la correlación entre las seis variables cuantitativas del estudio.
  3. Estudiar si hay relación entre un pH superior o inferior a 5 y una biomasa superior o inferior a 1000. Si tuvieras que cuantificar esa relación, ¿cómo lo harías y cuál sería su valor?
  4. Buscar un modelo que prediga la biomasa a partir del conocimiento de las variables físico-químicas y evaluar la calidad predictiva de dicho modelo.
  5. Comparar si hay una diferencia estadísticamente significativa, en cuanto a la variable Biomasa, entre los dos grupos siguientes: los niveles de pH superior o igual a 5 y los niveles de pH inferior a 5.
  6. Comparar si hay una diferencia, estadísticamente significativa, en cuanto a la variable Biomasa, entre los dos grupos siguientes: los niveles de salinidad superior o igual a 30 y los niveles de salinidad inferior a 30.
  7. Estudiar si hay diferencias entre estas tres zonas y entre estas tres profundidades estudiadas en cuanto a la variable Biomasa. Evaluar, también, si hay interacción entre el factor zona y el factor profundidad.


Situación 104: Examen (Temas 13-16)

1.¿Cuál de las siguientes afirmaciones no es cierta?

a)Si en una comparación de dos poblaciones debemos aplicar un Test de Fisher es que las muestras son independientes y que ambas se ajustan a la distribución normal.

b)En un contraste de hipótesis para evaluar el ajuste a la distribución normal un p-valor inferior a 0.05 indica que hay suficiente ajuste de los datos a la distribución normal.

c)Con una potencia superior al 80% nos podemos fiar del p-valor que tengamos.

d)Podemos tener en un ANOVA de dos factores no significativos (p-valor>0.05) y una interacción significativa (p-valor<0.05).

2.En un estudio donde se quiere comparar la cantidad de un contaminante en las playas de dos poblaciones distintas tenemos 50 observaciones en cada una de las dos playas. El test de Shapiro-Wilk de ambas muestras nos proporciona un p-valor mayor que 0.05. El test de Fisher-Snedecor nos proporciona una p=0.001. Es cierto lo siguiente:

a)Debemos aplicar el test de la t de Student para varianzas desiguales y si tenemos un p-valor inferior a 0.05 debemos concluir que las medias son diferentes.

b)Debemos aplicar el test de la t de Student para varianzas desiguales y si tenemos un p-valor inferior a 0.05 debemos concluir que las medias no son diferentes.

c)Debemos aplicar el Test de Mann-Whitney.

d)Debemos aplicar el Test de la t de Student de datos apareados.

3.Si en una comparación de dos poblaciones al aplicar el test adecuado al caso el p-valor final es 0.1 es cierto lo siguiente:

a)Si aumentamos el tamaño de muestra y disminuimos la desviación estándar el p-valor subirá.

b)Si aumentamos la desviación estándar de ambas muestras sin modificar el tamaño de muestra el p-valor bajará.

c)Si aumentamos las diferencias de medias entre ambas muestras y disminuimos la desviación estándar el p-valor bajará.

d)Si aumentamos el tamaño de muestra y disminuimos la diferencia de medias el p-valor bajará.

4.Se analiza el porcentaje de una especie en el fitoplancton en 40 puntos del océano pacífico y 40 puntos del océano atlántico. Después de un año se hace lo mismo en los mismos puntos y se vuelve a calcular el porcentaje de esa misma especie. En el pacífico en el 10% de puntos ha disminuido el porcentaje de esta especie y en el atlántico en el 5%. Queremos comparar si esa diferencia es estadísticamente significativa. Debemos aplicar:

a)El Test de proporciones.

b)El Test exacto de Fisher.

c)El Test de Wilcoxon.

d)El Test de McNemar.

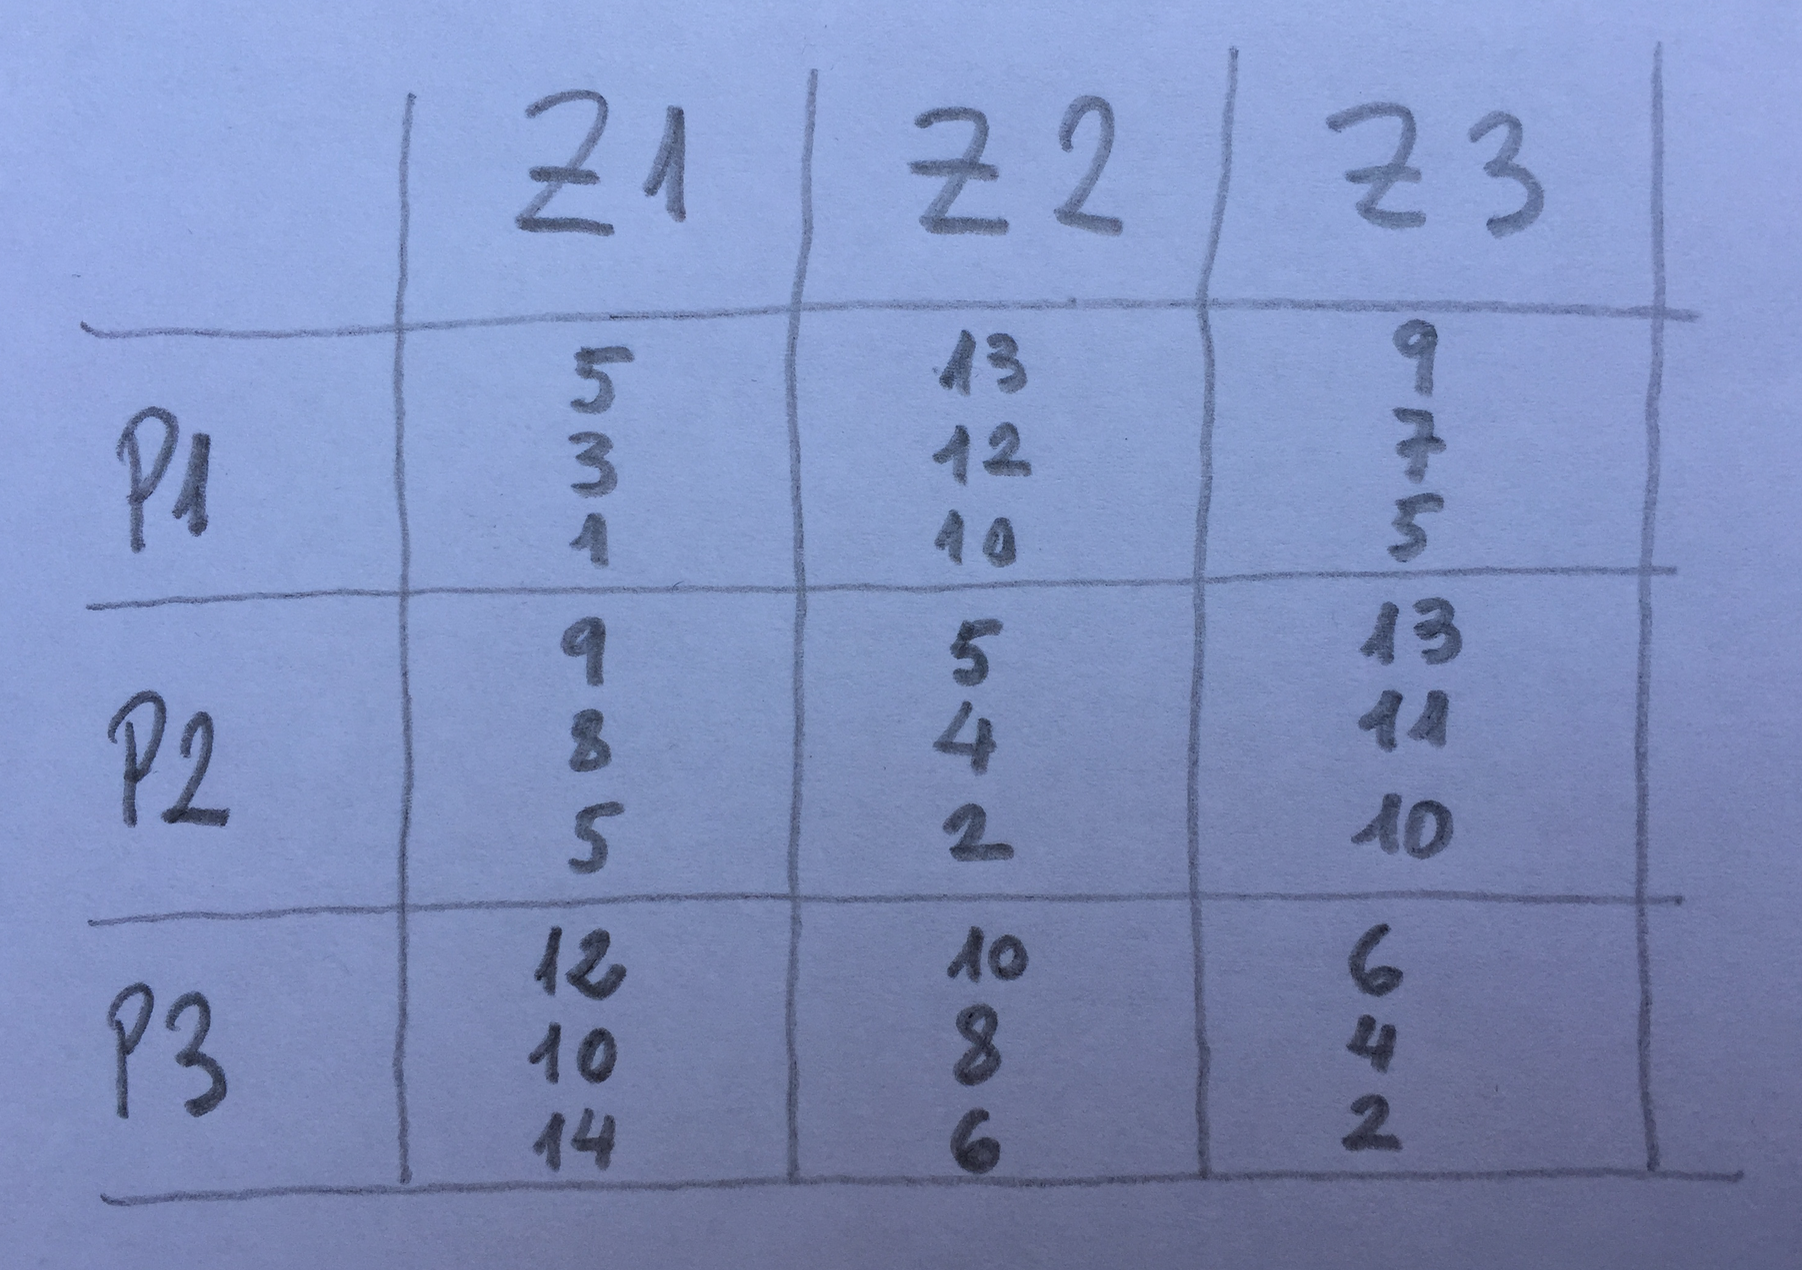
5.Hemos analizado la cantidad de biomasa en tres profundidades determinadas en tres zonas del mar distintas. En cada zona y profundidad hemos tomado tres muestras en tres botellas. Los resultados son los siguientes:

captura-de-pantalla-2016-12-15-a-las-10-36-46

¿Cuál es la afirmación más razonable?:

a)Factor Z: p>0.05. Factor P: p>0.05. Interacción: p>0.05.

b)Factor Z: p<0.05. Factor P: p>0.05. Interacción: p<0.05.

c)Factor Z p>0.05. Factor P: p>0.05. Interacción: p<0.05.

d)Factor Z: p>0.05. Factor P: p<0.05. Interacción: p>0.05.

6.Queremos comparar dos políticas medio-ambientales distintas que pretenden reducir el nivel de contaminación en playas. Se han escogido dos playas piloto muy similares entre sí. En cada una de ellas se eligen 30 puntos fijos detectables perfectamente por la posición de una bolla. Tenemos dos datos del contaminante: antes de la acción medio-ambiental aplicada y un mes después de la constante aplicación de la medida. La variable estudiada es una variable cuantitativa. ¿Cuáles son los pasos a seguir?:

a)Se comprueba la normalidad del antes y del después, en cada playa, y se aplica el test de datos apareados adecuado (si hay normalidad el test de la t de Student de datos apareados y si no hay normalidad el test de Wilcoxon o el test de los signos).

b)Se comprueba la normalidad de la resta del antes menos el después, en cada playa, y se aplica el test de datos apareados adecuado (si hay normalidad el test de la t de Student de datos apareados y si no hay normalidad el test de Wilcoxon o el test de los signos).

c).Se comprueba la normalidad de la resta del antes menos el después, en cada playa, y se aplica el test de muestras independientes adecuado (si hay normalidad el test de la t de Student de muestras independientes que corresponda y si no hay normalidad el test de Mann-Whitney).

d)Se comprueba la normalidad del antes y del después, en cada playa, y se aplica el test de muestras independientes adecuado (si hay normalidad el test de la t de Student de muestras independientes que corresponda y si no hay normalidad el test de Mann-Whitney).

7.¿Qué error podríamos estar cometiendo si al comparar dos tratamientos tenemos una potencia del 50% y el p-valor que obtenemos es de 0.45?

a)El error de tipo I.

b)El error de tipo II.

c)Ambos errores: El error de tipo I y el error de tipo II.

d)No podemos cometer error en este caso porque el p-valor es claramente superior a 0.05.

8.¿Cuál de las siguientes afirmaciones no es cierta?

a)Una potencia del 85% se corresponde con un error de tipo I de 0.15.

b)Si dos muestras relacionadas de una variable cuantitativa su resta no se ajusta bien a la distribución normal debemos aplicar o el test de los signos o el test de Wilcoxon.

c)En un ANOVA de dos factores anidados no puede evaluarse la interacción entre factores.

d)Un test de Mann-Whitney puede hacerse aunque haya diferencia de varianzas significativa entre los dos grupos comparados.

9.Hemos hecho un estudio en tres playas del litoral. En cada una de ellas se ha elegido, al azar, dos subzonas. Se han tomado muestras a 0, 10 y 20 metros. Se han tomado tres botellas en cada punto de muestreo. Se ha cualificado la cantidad de un contaminante. Los resultados son los siguientes:

captura-de-pantalla-2016-12-15-a-las-10-37-00

¿Cuál es la afirmación más razonable?:

a)Estamos ante un estudio con tres factores cruzados. El factor profundidad será significativo y tendrá dos grupos homogéneos.

b)El factor profundidad será significativo y tendrá tres grupos homogéneos en las comparaciones múltiples

c)El factor subzona está anidado dentro de zona y tanto el factor zona como el factor subzona están cruzados con el factor profundidad. El factor profundidad es significativo y el factor subzona también.

d)El factor subzona está anidado dentro de zona y el factor profundidad está anidado dentro de subzona. El factor profundidad es significativo y el factor zona no.

10.Se quiere hacer un pronóstico de la media poblacional de la cantidad de un contaminante en aguas marinas. ¿Qué tamaño de muestra necesitamos tomar para tener un intervalo del 95% de radio 2 si la Desviación estándar que tenemos en una muestra piloto es de 5?:

a)20.

b)25.

c)30.

d)50.
Solución Situación 104

1b: Si el p-valor es menor que 0.05 debemos rechazar la hipótesis nula. Y en un test de ajuste a la normal la hipótesis nula es normalidad.

2a: Hay normalidad, no hay igualdad de varianzas y por lo tanto hay que aplicar un test de la t de Student de varianzas diferentes. Si el p-valor es inferior a 0.05 en este último test debemos concluir que las medias poblacionales son distintas.

3c: Aumentar el tamaño de muestra y disminuir la desviación estándar van en la misma dirección de reducir el p-valor. Por lo tanto, esta es la opción correcta.

4b: El tamaño muestral es mayor que 30 pero el valor esperado por grupo, bajo la hipótesis nula es menor que 5. El valor esperado es 3, puesto que hay 4 (10% de 40) casos en una muestra y 2 (5% de 40) en la otra.

5c: Ninguno de los dos factores será significativo y claramente hay interacción puesto que las profundidades se comportan de forma muy distinta según las zonas.

6c: Se pretende comparar dos muestras independientes, aunque hay dos valores por cada punto muestral. Deberá trabajarse con la variable resta y comprobar la normalidad de cada muestra. En función de ello se aplicará uno de los dos test de la t de Student de muestras independientes o el Test de Mann-Whitney.

7b: Como el p-valor es mayor que 0.05 mantendremos la hipótesis nula por lo que podremos estar cometiendo el error de tipo II.

8a: Si la potencia es del 85% es el error de tipo II el que será de 0.15, no el de tipo I.

9c: Subzona está anidado en zona y profundidad está cruzado con zona y subzona. Profundidad y subzona son claramente significativos.

10b: Aplicando la fórmula para el cálculo del tamaño de muestra en variables cuantitativas obtenemos este resultado.


Solución Situación 103

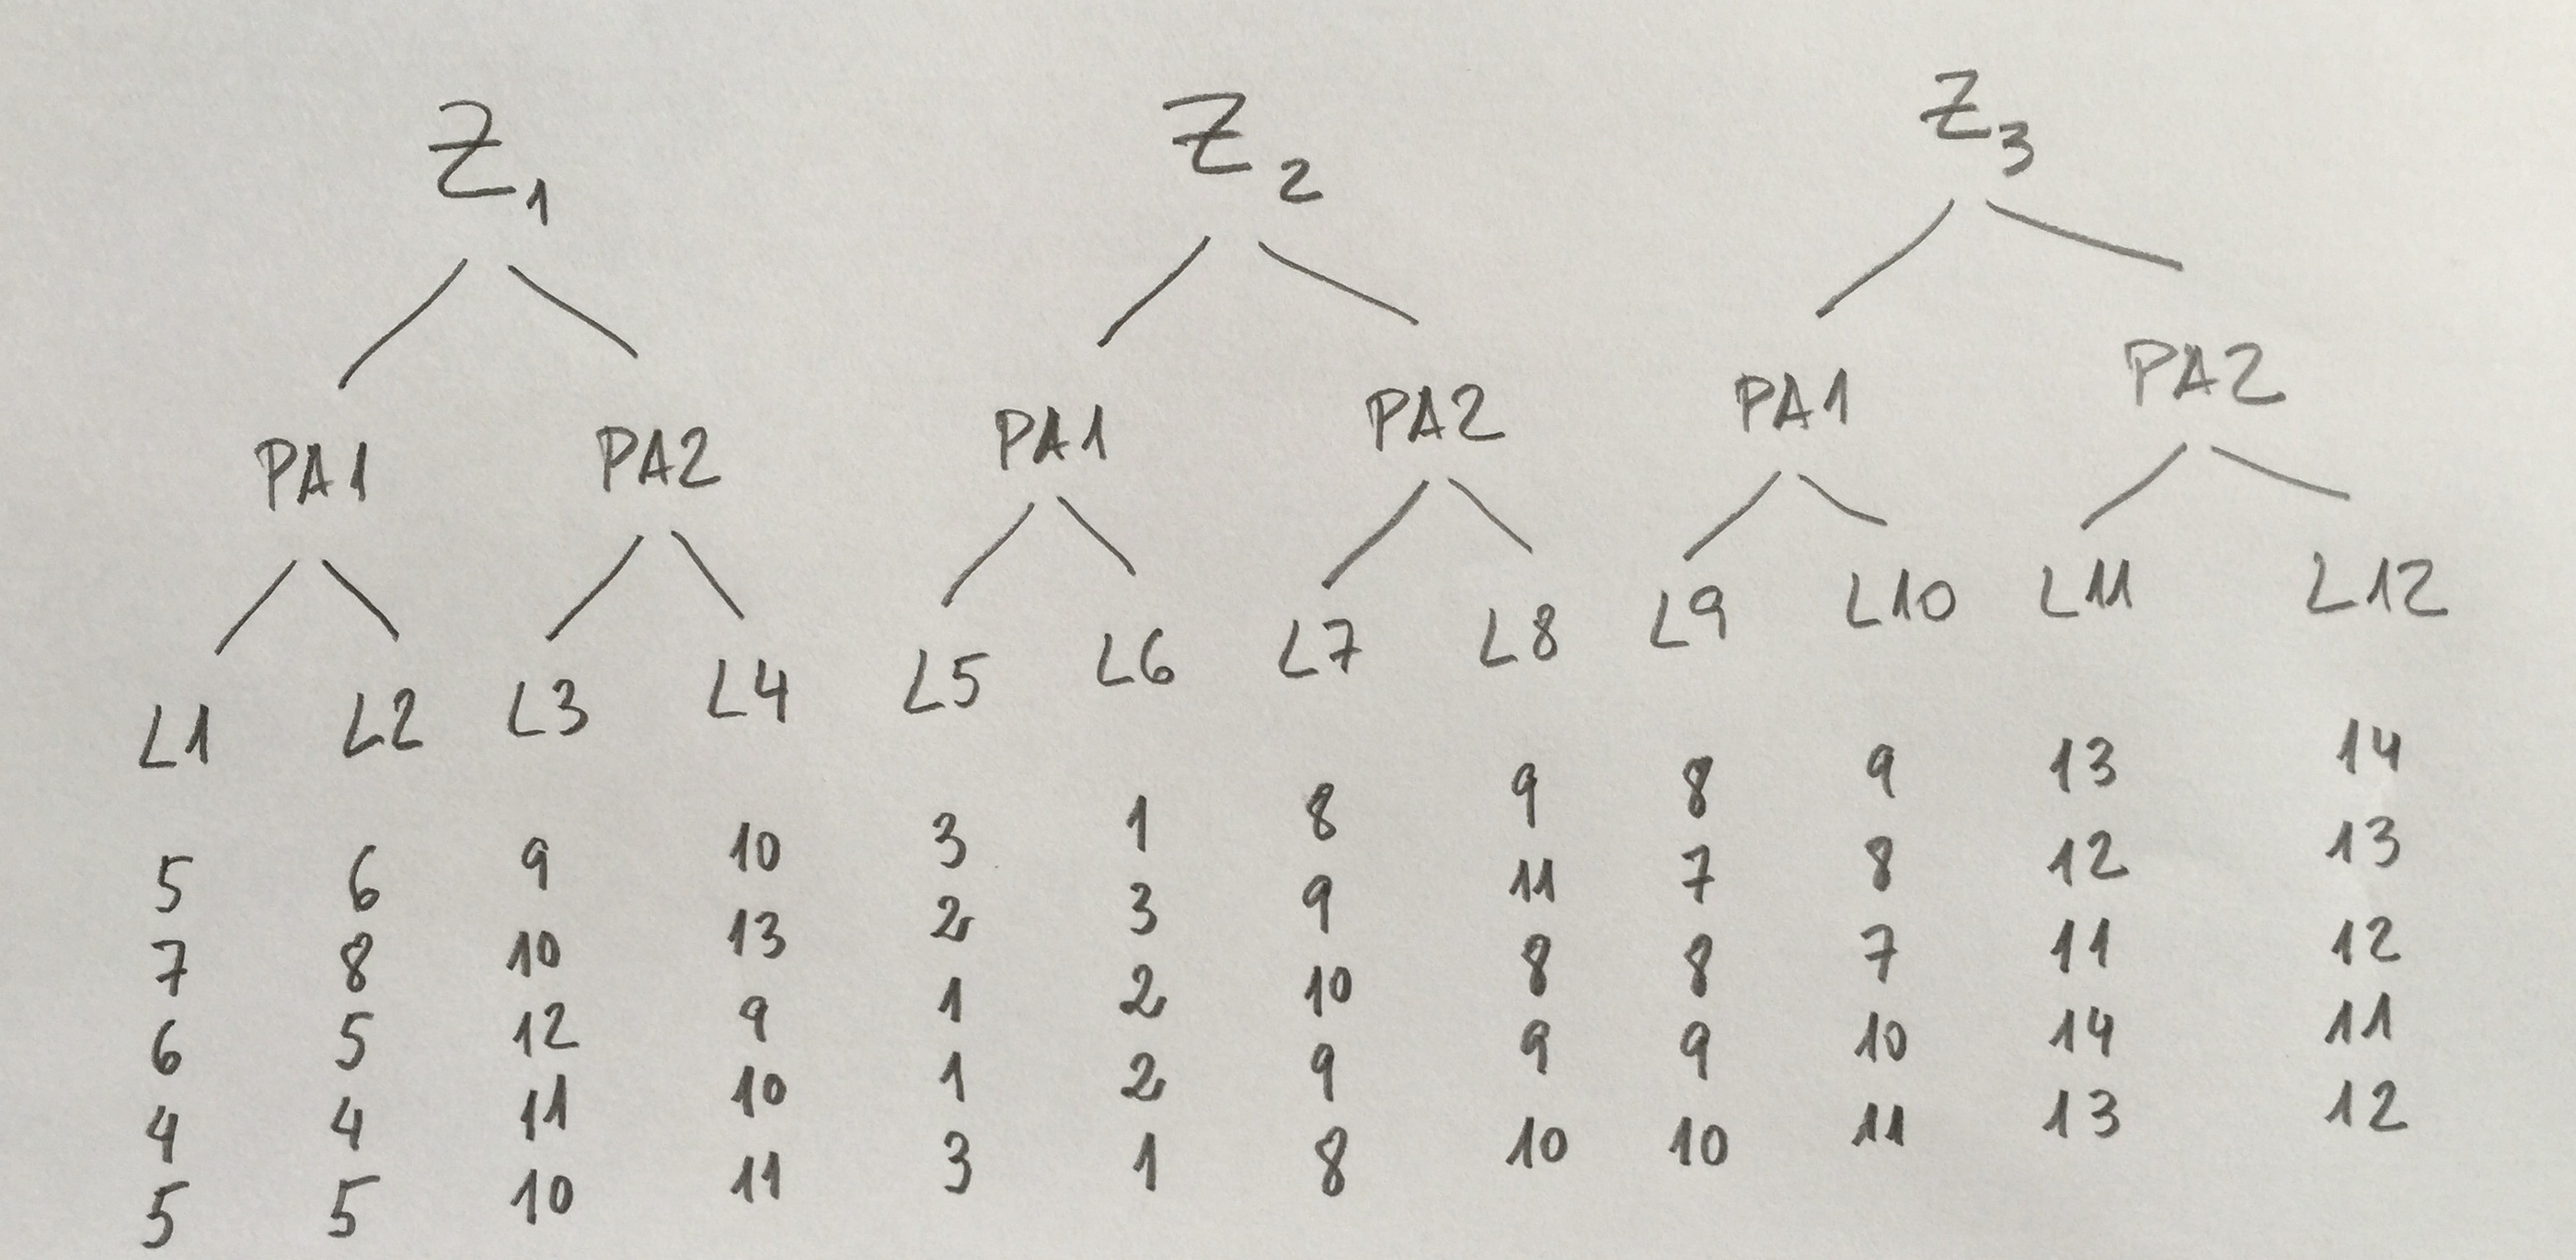
1.Se trata de un diseño con tres factores. Zona es un factor fijo, Subzona es un factor aleatorio anidado en el factor Zona. Profundidad es un factor fijo cruzado con los dos factores restantes. El modelo sería el mismo que el visto en la Situación 41.

Los factores Profundidad y Subzona parecen, viendo los datos, significativos. El factor zona, no.

2.Se trata de un diseño con tres factores. Zona es un factor fijo, Política ambiental es un factor también fijo y cruzado con el factor Zona. Laboratorio sería un factor aleatorio anidado en la interacción de los otros dos factores. El modelo sería el mismo que el visto en la Situación 45.

Los factores Zona y Política ambiental parecen significativos, viendo los datos. El factor Laboratorio, no.

3. Se trata de un diseño de tres factores. Zona es un factor fijo, Subzona es un factor aleatorio anidado en el factor Zona. Operario es también un factor aleatorio anidado en el factor Subzona. El modelo es el siguiente:

captura-de-pantalla-2016-12-16-a-las-10-14-12

El algoritmo de Bennet-Franklin nos proporciona las esperanzas de los cuadrados medios y n los cocientes que hay que hacer en la tabla ANOVA para encontrar los efectos significativos del modelo:

captura-de-pantalla-2016-12-16-a-las-10-14-24

Los factores Zona y Operario parecen significativos. Pero Subzona, no.

4.Tenemos tres factores fijos y cruzados. El modelo es:

captura-de-pantalla-2016-12-19-a-las-12-34-07

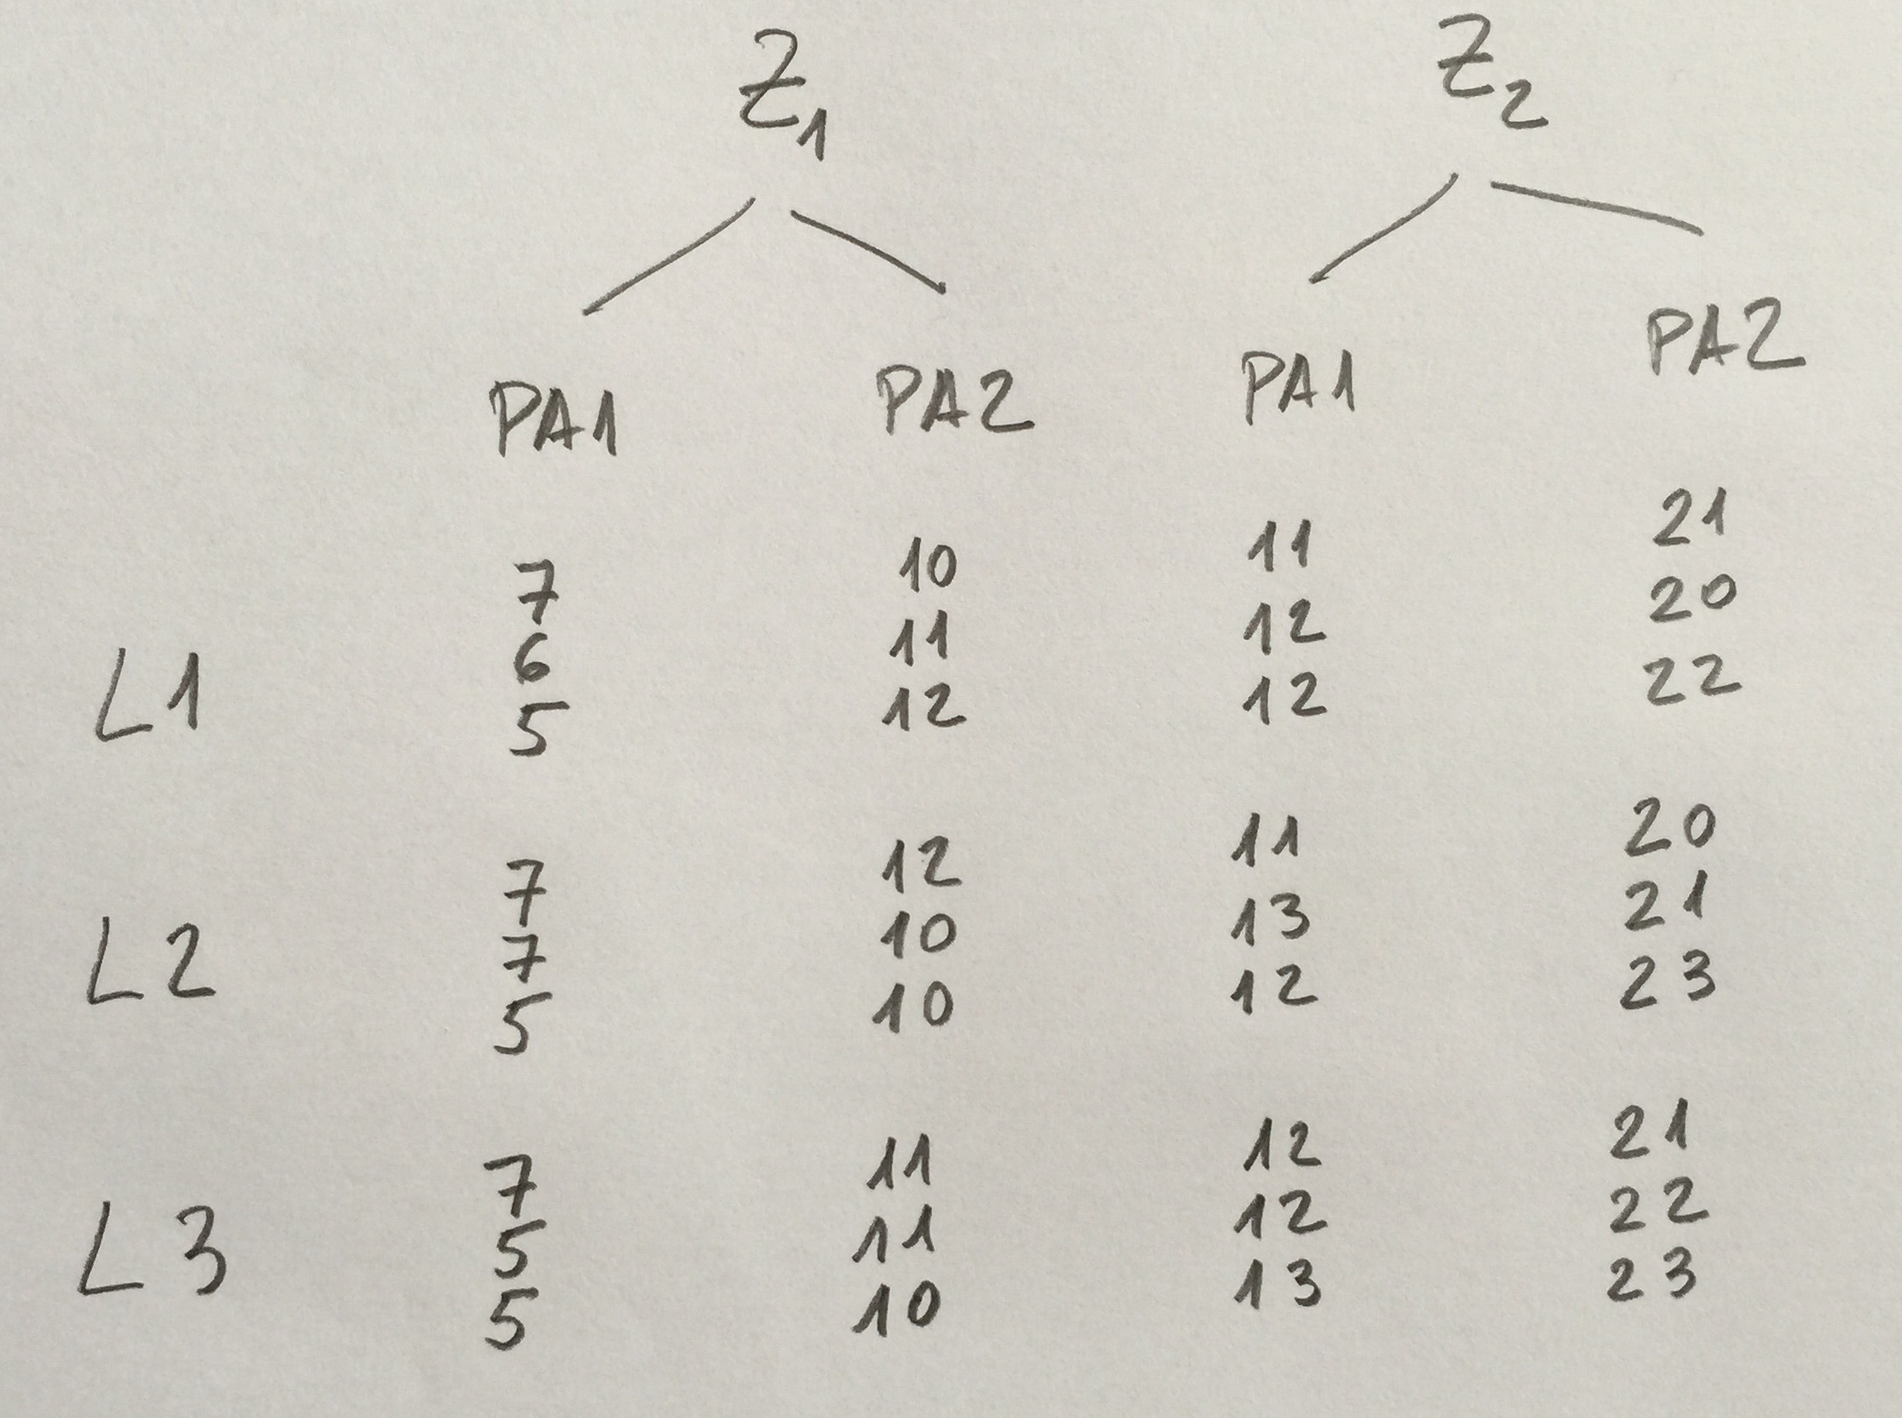
La resolución de este modelo no presenta ninguna dificultad por tratarse de factores fijos y cruzados. Todos los cocientes se realizan respecto del residuo.

Viendo los datos parece que los únicos efectos significativos serán los producidos por el factor Zona y el factor Política ambiental.

5.Estamos ante un diseño con cuatro factores. El factor zona es fijo. El factor subzona es aleatorio y anidado en el factor zona. El factor operario es también aleatorio y anidado en subzona. El factor técnica es fijo y cruzado con los otros tres factores. El modelo sería:

captura-de-pantalla-2016-12-19-a-las-12-22-28

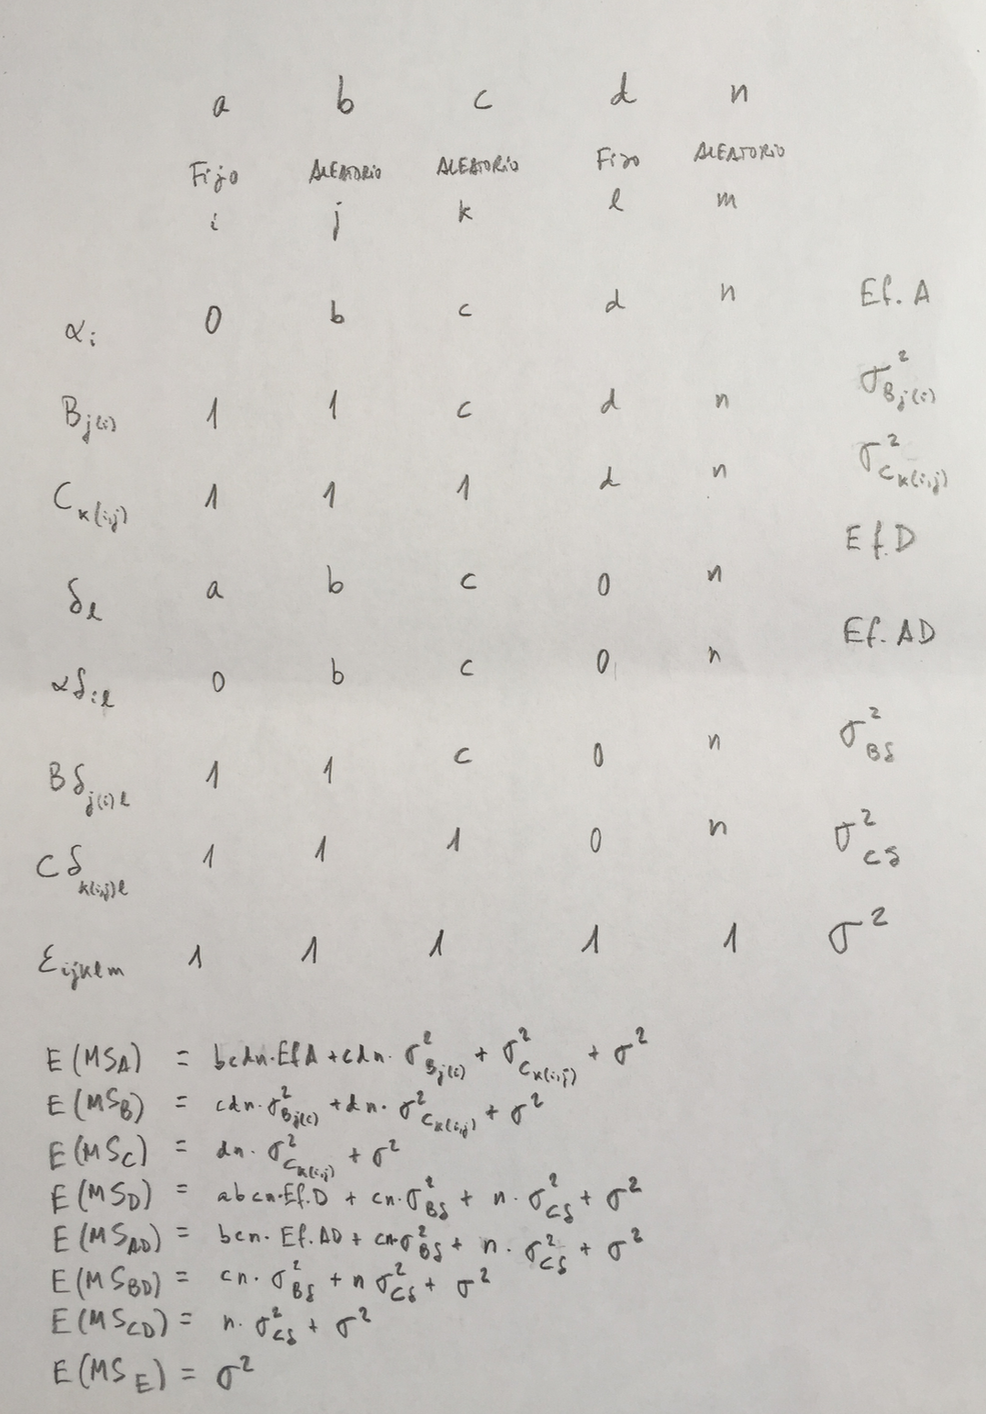
El algoritmo de Bennet-Franklin nos proporciona las esperanzas de los cuadrados medios y n los cocientes que hay que hacer en la tabla ANOVA para encontrar los efectos significativos del modelo:

captura-de-pantalla-2016-12-19-a-las-12-22-41

Viendo los datos parecen significativos los cuatro factores.


Situación 103: Ejemplos de ANOVA

1. Supongamos que hemos estudiado la cantidad de un contaminante en tres zonas del litoral concretos que queremos comparar. En cada uno de ellos hemos elegido al azar dos subzonas porque queremos ver la homogeneidad que hay en cada zona. Hemos estudiado el agua a tres profundidades: 0, 10 y 20 metros. En cada punto hemos efectuado tres réplicas. Los resultados son los siguientes:

captura-de-pantalla-2016-12-15-a-las-10-37-00

¿Cuántos factores tenemos? ¿Son fijos, aleatorios? ¿Cómo están estructurados unos respecto de otros (cruzados, anidados)? ¿Cuál es el modelo? ¿Únicamente visualizando los datos cuáles serán los resultados que obtendremos mediante el ANOVA oportuno?

2. Supongamos que en tres zonas que expresamente queremos comparar hemos aplicado a dos subzonas de cada una de ellas, completamente equivalentes, dos políticas medio-ambientales distintas que pretendemos también comparar. Los resultados los hemos encargado a doce laboratorios elegidos al azar con la finalidad, también, de medir el grado de fiabilidad que nos pueden aportar ellos. Cada laboratorio hace cinco réplicas de la muestra recibida. Los resultados son los siguientes:

captura-de-pantalla-2016-12-16-a-las-10-21-13

¿Cuántos factores tenemos? ¿Son fijos, aleatorios? ¿Cómo están estructurados unos respecto de otros (cruzados, anidados)? ¿Cuál es el modelo? ¿Únicamente visualizando los datos cuáles serán los resultados que obtendremos mediante el ANOVA oportuno?

3. Supongamos que en tres zonas que expresamente queremos comparar hemos elegido dos subzonas al azar con la finalidad de evaluar la homogeneidad que haya dentro de las zonas. Hemos evaluado la concentración de un determinado contaminante. Hemos tomado una muestra de cada subzona y hemos encargado a diferentes estudiantes para que realicen los análisis. Cada alumno, cada operario, realizaba cuatro réplicas de una única muestra. Queríamos ver, también, el grado de dispersión que hay entre los análisis hechos por estudiantes de ciencias ambientales. Los resultados son los siguientes:

captura-de-pantalla-2016-12-16-a-las-10-33-25

¿Cuántos factores tenemos? ¿Son fijos, aleatorios? ¿Cómo están estructurados unos respecto de otros (cruzados, anidados)? ¿Cuál es el modelo? ¿Únicamente visualizando los datos cuáles serán los resultados que obtendremos mediante el ANOVA oportuno?

4. Supongamos que en dos zonas que expresamente queremos comparar hemos aplicado a dos subzonas de cada una de ellas, completamente equivalentes, dos políticas medio-ambientales distintas que pretendemos también comparar. Los resultados los hemos encargado a tres laboratorios que expresamente también queremos comparar. Cada laboratorio realizaba tres réplicas de cada una de las muestras recibidas. Los resultados son los siguientes:

captura-de-pantalla-2016-12-16-a-las-10-35-47

¿Cuántos factores tenemos? ¿Son fijos, aleatorios? ¿Cómo están estructurados unos respecto de otros (cruzados, anidados)? ¿Cuál es el modelo? ¿Únicamente visualizando los datos cuáles serán los resultados que obtendremos mediante el ANOVA oportuno?

5. Supongamos que en dos zonas que expresamente queremos comparar hemos elegido dos subzonas al azar con la finalidad de evaluar la homogeneidad que haya dentro de las zonas. Hemos evaluado la concentración de un determinado contaminante. Hemos tomado una muestra de cada subzona y hemos encargado a diferentes estudiantes para que realicen los análisis. Hemos evaluado, con la finalidad de compararlas, dos técnicas analíticas que existen para evaluar la concentración de ese contaminante. Cada alumno, cada operario, realizaba tres réplicas de una única muestra en cada uno de las dos técnicas. Queríamos ver, pues, también, el grado de dispersión que hay entre los análisis hechos por estudiantes de ciencias ambientales. Los resultados son los siguientes:

captura-de-pantalla-2016-12-19-a-las-12-00-10

¿Cuántos factores tenemos? ¿Son fijos, aleatorios? ¿Cómo están estructurados unos respecto de otros (cruzados, anidados)? ¿Cuál es el modelo? ¿Únicamente visualizando los datos cuáles serán los resultados que obtendremos mediante el ANOVA oportuno?

Base de datos de Oceanografía

Variables del estudio:

Z=Zona

P=Profundidad

T00=Temperatura el año 2000

S00=Salinidad el año 2000

C00=Clorofila el año 2000

B00=Biomasa el año 2000

T15=Temperatura el año 2015

S15=Salinidad el año 2015

C15=Clorofila el año 2015

B15=Biomasa el año 2015

Base de datos:

Z P T00 S00 C00 B00 T15 S15 C15 B15
1 0 16,3 33,3 5,3 10,7 16,4 33,3 6,2 9,7
1 0 16,2 33,4 5,5 11,1 16,2 33,4 6,3 10,2
1 0 16,1 33,3 5,4 11,1 16,1 33,3 6,2 10,1
1 0 16,3 33,3 5,0 10,4 16,3 33,3 5,9 9,4
1 0 16,3 33,3 5,0 10,5 16,4 33,3 5,8 9,5
1 0 16,4 33,3 5,1 10,3 16,5 33,4 6,0 9,4
1 0 16,3 33,4 5,0 10,3 16,4 33,4 5,9 9,4
1 0 16,5 33,4 5,4 10,9 16,5 33,4 6,3 10,0
1 0 16,3 33,3 5,1 10,3 16,4 33,3 6,0 9,3
1 0 16,2 33,4 5,3 10,7 16,2 33,4 6,1 9,7
1 10 15,6 33,4 3,1 6,6 15,7 33,4 3,9 5,6
1 10 15,3 33,3 3,3 6,9 15,4 33,3 4,2 6,0
1 10 15,9 33,4 3,2 6,5 16,0 33,4 4,0 5,5
1 10 15,1 33,4 3,4 6,8 15,2 33,4 4,2 5,8
1 10 15,2 33,3 3,5 7,0 15,2 33,4 4,3 6,1
1 10 15,9 33,3 3,4 7,1 16,0 33,4 4,2 6,1
1 10 15,8 33,3 3,2 6,8 15,9 33,4 4,0 5,9
1 10 15,1 33,3 3,0 6,6 15,2 33,4 3,9 5,6
1 10 15,3 33,3 3,5 7,3 15,4 33,3 4,3 6,3
1 10 15,3 33,3 3,3 6,6 15,3 33,4 4,1 5,6
1 20 14,2 33,4 1,1 2,2 14,3 33,4 1,9 1,3
1 20 14,2 33,4 1,1 2,7 14,2 33,4 2,0 1,7
1 20 14,1 33,4 1,2 2,5 14,2 33,4 2,0 1,5
1 20 14,2 33,4 1,1 2,5 14,2 33,4 1,9 1,5
1 20 14,2 33,3 1,0 2,2 14,2 33,4 1,9 1,2
1 20 14,1 33,4 1,2 2,8 14,1 33,4 2,0 1,9
1 20 14,2 33,3 1,1 2,4 14,2 33,4 1,9 1,5
1 20 14,3 33,4 1,0 2,1 14,3 33,4 1,9 1,1
1 20 14,2 33,3 1,1 2,5 14,3 33,3 2,0 1,5
1 20 14,3 33,3 1,1 2,4 14,3 33,4 1,9 1,4
2 0 16,8 34,1 5,3 10,7 16,8 34,2 6,1 9,8
2 0 16,7 34,1 5,3 10,6 16,8 34,2 6,1 9,6
2 0 16,6 34,2 5,1 10,2 16,7 34,2 5,9 9,2
2 0 16,8 34,2 5,2 10,9 16,8 34,2 6,0 9,9
2 0 16,8 34,2 5,3 11,0 16,8 34,2 6,2 10,1
2 0 16,9 34,2 5,5 11,0 17,0 34,2 6,3 10,0
2 0 16,8 34,1 5,3 10,6 16,9 34,2 6,2 9,7
2 0 17,0 34,2 5,1 10,4 17,0 34,2 5,9 9,4
2 0 16,8 34,2 5,5 11,2 16,9 34,2 6,3 10,2
2 0 16,7 34,2 5,0 10,3 16,7 34,2 5,9 9,3
2 10 16,1 34,2 3,4 6,9 16,1 34,2 4,2 6,0
2 10 15,8 34,1 3,0 6,4 15,9 34,2 3,9 5,5
2 10 16,4 34,1 3,2 6,5 16,4 34,1 4,1 5,5
2 10 15,6 34,1 3,1 6,4 15,7 34,2 4,0 5,5
2 10 15,7 34,2 3,4 6,9 15,7 34,2 4,2 5,9
2 10 16,4 34,1 3,0 6,3 16,4 34,2 3,8 5,3
2 10 15,8 34,2 3,5 7,4 15,9 34,2 4,3 6,5
2 10 16,4 34,1 3,1 6,6 16,5 34,2 4,0 5,7
2 10 15,6 34,2 3,2 6,4 15,6 34,3 4,0 5,4
2 10 15,3 34,2 3,5 7,4 15,4 34,2 4,3 6,4
2 20 14,7 34,2 1,2 2,8 14,7 34,2 2,0 1,8
2 20 14,7 34,2 1,0 2,4 14,7 34,2 1,9 1,4
2 20 14,6 34,1 1,0 2,4 14,7 34,1 1,9 1,4
2 20 14,7 34,1 1,1 2,5 14,7 34,2 1,9 1,6
2 20 14,8 34,2 1,1 2,4 14,9 34,2 1,9 1,5
2 20 14,7 34,2 1,2 2,5 14,7 34,2 2,0 1,5
2 20 14,7 34,1 1,0 2,4 14,8 34,2 1,8 1,4
2 20 14,6 34,1 1,1 2,5 14,6 34,2 2,0 1,5
2 20 14,7 34,2 1,1 2,4 14,8 34,2 1,9 1,4
2 20 14,6 34,1 1,1 2,6 14,7 34,2 1,9 1,6
3 0 16,1 35,0 8,0 16,4 16,2 35,1 7,8 14,5
3 0 16,3 35,0 8,4 17,0 16,3 35,0 8,2 15,0
3 0 15,9 35,1 8,0 16,4 16,0 35,1 7,8 14,5
3 0 16,1 35,0 8,3 16,9 16,2 35,1 8,0 15,0
3 0 16,1 35,1 8,0 16,5 16,2 35,1 7,8 14,6
3 0 16,2 35,0 8,5 17,3 16,3 35,1 8,2 15,3
3 0 16,1 35,1 8,1 16,5 16,1 35,1 7,9 14,5
3 0 16,2 35,0 8,1 16,6 16,2 35,0 7,8 14,6
3 0 16,1 35,0 8,3 16,6 16,2 35,1 8,0 14,6
3 0 16,1 35,0 8,5 17,3 16,1 35,0 8,2 15,3
3 10 15,4 35,0 1,1 2,3 15,5 35,1 0,8 0,3
3 10 15,1 35,0 1,1 2,2 15,2 35,1 0,8 0,3
3 10 15,7 35,0 1,1 2,4 15,7 35,0 0,8 0,4
3 10 14,8 35,1 1,2 2,6 14,9 35,1 0,9 0,7
3 10 15,0 35,0 1,0 2,4 15,1 35,1 0,7 0,5
3 10 15,7 35,1 1,1 2,5 15,8 35,1 0,9 0,6
3 10 15,6 35,0 1,1 2,4 15,7 35,0 0,9 0,4
3 10 14,9 35,0 1,1 2,5 15,0 35,0 0,8 0,6
3 10 15,1 35,0 1,1 2,6 15,2 35,1 0,9 0,7
3 10 15,1 35,1 1,0 2,1 15,2 35,1 0,8 0,1
3 20 14,0 35,0 1,1 2,5 14,0 35,1 0,9 0,6
3 20 14,0 35,0 1,1 2,5 14,0 35,1 0,8 0,5
3 20 13,9 35,0 1,0 2,3 13,9 35,0 0,7 0,4
3 20 14,1 35,1 1,0 2,2 14,2 35,1 0,8 0,3
3 20 14,0 35,0 1,1 2,2 14,0 35,1 0,8 0,2
3 20 13,9 35,0 1,1 2,3 14,0 35,1 0,8 0,4
3 20 14,0 35,0 1,2 2,7 14,1 35,1 0,9 0,7
3 20 14,1 35,0 1,1 2,2 14,1 35,1 0,8 0,3
3 20 14,0 35,0 1,1 2,5 14,0 35,1 0,9 0,6
3 20 14,2 35,0 1,0 2,2 14,2 35,1 0,8 0,2

Solución Situación 102

1c: El primer cuartil es 5 y el tercero es 27, por lo que el rango intercuartílico es 22.

2c: La relación es significativa porque el p-valor es inferior a 0.05, pero la capacidad predictiva es muy mala: es sólo del 4%.

3a: Si aplicamos la fórmula de los intervalos de confianza modificándola para que haya tres errores estándares sumados y restados el intervalo es el a.

4d: Si la tabla observada y la esperada coinciden el valor de la ji-cuadrado es 0 y por lo tanto la V de Crámer es también 0.

5c: Obviamente en este caso c la correlación será de mayor magnitud y, por lo tanto, el coeficiente de determinación será el mayor de los cuatro.

6c: Obviamente estamos usando una técnica inadecuada. La correlación de Pearson es para relacionar variables cuantitativas. Deberíamos usar una ji-cuadrado.

7d: Como no sabemos qué tabla de contingencias tenemos sólo podemos afirmar lo que dice la d, porque el 3.84 es el umbral más pequeño de los que podemos tener.

8c: Cualquier pendiente que no sea 0 potencialmente puede ser estadísticamente significativa. Dependerá del intervalo de confianza del 95% que construyamos o del p-valor que tengamos.

9c: El valor de ji-cuadrado 23.33 está por encima del umbral de nivel de significación del 0.05 (21.02) pero está por debajo del umbral de nivel de significación del 0.01 (26.21).

10d: El error estándar es 1, por lo tanto el intervalos de confianza del 95% de la media es el d.


Situación 102: Examen (Temas 1-9)

1.En la muestra (1, 3, 5, 8, 8, 21, 27, 30, 35):

a.La mediana es 14.5.

b.El primer cuartil es 4.

c.El rango intercuartílico es 22.

d.El tercer cuartil es 30.


2.De una correlación r=0.2 (p=0.0001), podemos decir:

a.El tamaño muestral es pequeño porque la correlación es pequeña.

b.Hay una relación significativa entre las variables comparadas porque el coeficiente de determinación es mayor del 5%.

c.No tenemos una buena capacidad predictiva a pesar de que tenemos una correlación significativa.

d.El coeficiente de determinación es del 20%.


3.Estamos interesado en saber en cuántos lugares a lo largo de un río se supera un cierto nivel de un contaminante. Para ello se toman al azar 100 muestras a lo largo del río. En 15 de ellas se supera ese nivel. Un intervalo de confianza del 99.5% del porcentaje de puntos del río donde se supera dicho nivel es:

a.(4.29, 25.71).

b.(7.86, 22.14).

c.(11.43, 18.57).

d.(10.25, 14.75).


4.¿Cuál de las siguientes afirmaciones es cierta?

a.La ji-cuadrado mide bien la cantidad de relación que hay entre dos variables cualitativas.

b.Una correlación de Pearson es significativa si el coeficiente de determinación es superior al 50%.

c.Si la V de Crámer si es negativa indica una relación de tipo inverso entre las variables.

d.Si la tabla de contingencias observada y la tabla de contingencias esperada son iguales entonces la V de Crámer es 0.


5.En cuál de las siguientes regresiones lineales simples podremos hacer mejores predicciones:

a)y=-6x-10; IC del 95% de la correlación (-0.3, -0.1).

b)y=3x+3; IC del 95% de la correlación (0.3, 0.5)

c)y=-x-2; IC del 95% de la correlación (-0.8, -0.7)

d)y= 8x+2; IC del 95% de la correlación (-0.1, 0.9).


6.Estamos tratando de asociar la presencia o la ausencia de una especie fitoplanctónica con la presencia o ausencia de una especie zooplanctónica en muestras marinas de distintas zonas del mediterráneo. Hemos codificado la ausencia con un 0 y la presencia con un 1. Hemos calculado una correlación de Pearson y tenemos una r=0.35 (p=0.035), podemos decir:

a.Que hay una relación significativa entre esas dos variables.

b.Que relación tiene buena capacidad predictiva porque la relación es significativa.

c.Que estamos usando una técnica estadística no apropiada al caso.

d.Que necesitamos saber el tamaño de muestra para saber si esta relación es estadísticamente significativa.


7.Si se realiza una ji-cuadrado para analizar la relación entre dos variables cualitativas es cierto:

a.Si el valor del cálculo de la ji-cuadrado es mayor que 50 se puede considerar ya una relación estadísticamente significativa.

b.Si el p-valor es menor que 0.05 el valor del cálculo de la ji-cuadrado es menor que 3.84.

c.Si el p-valor es mayor que 0.05 el valor del cálculo de la ji-cuadrado es menor que 3.84.

d.Si el valor del cálculo de la ji-cuadrado es menor que 3.84 el p-valor será mayor que 0.05.


8.En una Regresión lineal simple es cierto:

a.Si la R2 es superior al 50% tenemos una relación estadísticamente significativa entre las variables de la regresión.

b.Si el p-valor de la correlación y de la pendiente es inferior a 0.05 tendremos una aceptable capacidad predictiva.

c.La ecuación de la recta y=0.0001x+20 puede ser estadísticamente significativa.

d.Si la ecuación de la recta es y=2x+3, y sabemos que es significativa, la recta y=20x+3 lo será también de significativa porque la pendiente es aún mayor.


9.Estamos relacionando en cuatro zonas distintas la presencia de cinco especies de peces distintos. Hemos aplicado una ji-cuadrado y el valor es 23.33. Entonces:

a.No podemos decir que hay relación porque 23.33 es mayor que 21.02.

b.No podemos decir que hay relación porque 23.33 es menor que 31.41.

c.Si el nivel de significación fuese 0.05 diríamos que hay relación pero si fuese 0.01 diríamos que no hay relación.

d.Podemos decir que hay relación estadísticamente significativa porque 23.33 es mayor que 3.84.


10.Un intervalo de confianza del 95% de la media en una muestra con media muestral 20, desviación estándar 20 y tamaño muestral de 400 es:

a.(-20, 60).

b.(19.5, 20.5).

c.(19, 21).

d.(18, 22).

Viaje en autobús turístico por el mundo ANOVA

Un viaje amplio por el mundo ANOVA (Análisis de la varianza), como un viaje por una compleja ciudad como Nueva York, París o Londres, merece un previo recorrido global en autobús turístico para conocer, de entrada, cuál es la estructura global, la textura, de lo que nos encontraremos, en días sucesivos.

Vamos a hacerlo introduciendo unos conceptos que constituyen la columna vertebral de la inmensa urbe ANOVA. Se trata de los siguientes conceptos:

  1. Factor
  2. Nivel
  3. Factor fijo/Factor aleatorio
  4. Comparaciones múltiples/Componentes de la varianza
  5. Factores cruzados/Factores anidados
  6. Interacción entre factores
  7. Factor intersujeto/Factor intrasujeto
  8. Variable respuesta/Vector respuesta
  9. Variable/Covariable
  10. Efectos

Vayamos paso a paso con este corto viaje en autobús turístico:

1. Un factor en ANOVA es una variable cualitativa que genera o que contempla una serie de poblaciones a comparar. Por ejemplo, se ensayan tres tipos de fertilizantes en unos campos de cultivo para evaluar la productividad, se ensayan cuatro medicamentos distintos para ver si aumentan los niveles de hemoglobina en pacientes con anemia. En estos casos tenemos, en primer lugar el factor tipo de fertilizante. En el segundo, el factor fármaco.

2. Los niveles de un factor son los grupos o poblaciones que tenemos de un factor. En el primer ejemplo anterior tenemos tres niveles. En el segundo ejemplo tenemos cuatro niveles.

3. Un factor es fijo si los niveles que tenemos de él en el estudio son realmente todos los que nos interesa comparar. Un factor es aleatorio si los niveles que tenemos en nuestro estudio es una muestra de niveles tomados de una población de niveles que son los que, en realidad, queremos comparar. Los dos ejemplos anteriores si los tres fertilizantes o los cuatro fármacos son nuestro objeto de comparación, estamos ante factores fijos. Pero, observemos lo siguiente: si en otro ejemplo, estoy comparando si hay diferencias en la calidad de un producto fabricado por 100 operarios trabajando en una industria y, para hacerlo, elijo al azar a 5 de esos 100 operarios y analizo 3 productos elaborados por cada uno de ellos, pero lo que me interesa es ver si hay diferencias entre los 100, no entre esos 5, estoy ante el factor operario con 5 niveles, pero ese factor es, ahora, no fijo, sino aleatorio.

4. Si tenemos un factor fijo y detectamos que hay diferencias entre esas poblaciones, nos interesará decir cuáles son esas diferencias concretas. Las comparaciones múltiples hacen esa labor, comparan, dos a dos, de una forma muy especial, todas las poblaciones para dibujar un mapa de las diferencias. Si tenemos un factor aleatorio, el planteamiento es ahora muy diferente: debemos pasar de la muestra de muestras de poblaciones que tenemos a una población de poblaciones y eso lo haremos estimando la varianza, la dispersión que debe haber dentro de esa población de poblaciones.

5. Cuando hay más de un factor en un estudio, los factores, dos a dos, pueden estar cruzados o anidados. Tenemos factores cruzados cuando todos los niveles de un factor están combinados con todos los niveles del otro factor. Tenemos factores anidados cuando los niveles de un factor están jerarquizados entre los niveles del otro factor.

6. Cuando los factores están cruzados podemos estudiar algo muy importante en ANOVA: la interacción entre esos factores. Hay interacción cuando la respuesta, el efecto conseguido con la presencia de un nivel de un factor, depende de con qué nivel del otro factor esté combinado.

7. Un factor es intersujeto cuando cada sujeto pertenece a un único nivel del factor. Un factor es intrasujeto cuando cada sujeto está presente en cada uno de los niveles del factor.

8. Tenemos una variable respuesta, cuando la variable estudiada en la combinación de factores estudiados que tengamos es una variable cuantitativa única. Tenemos un vector respuesta cuando lo que se estudia es un vector de variables; o sea, varias variables al mismo tiempo. Se pretende buscar las diferencias en bloque, no variable a variable.

9. Una variable en ANOVA significa la respuesta en una variable cuantitativa que estamos estudiando. Una covariable es una variable cuantitativa complementaria que puede estar asociada a la variable respuesta estudiada y puede explicar las diferencias que estamos viendo en la variable respuesta estudiada. Viene a ser como un factor pero cuantititivo, no cualitativo.

10. En el lenguaje ANOVA hablamos de efectos cuando vemos diferencias. En este contexto vamos a realizar distintas comparaciones. La hipótesis de partida (la llamada hipótesis nula) es igualdad y la alternativa es diferencia. Si rechazamos la hipótesis nula y nos quedamos la alternativa decimos que estsmos viendo efectos. Por lo tanto, en ANOVA, efectos es sinónimo de diferencias y no efectos sinónimo de igualdad.

Veamos un ejemplo práctico dende ver todos estos conceptos. Se hace el siguiente estudio experimental: Se toma una muestra de 30 alumnos durante toda la ESO. Se dividen en tres clases distintas, en tres líneas distintas. Cada una va a seguir, durante los cuatro años, un plan distinto de enseñanza del inglés. Se sabe el nivel escrito y el nivel oral de esos alumnos al final de la primaria. Se han diferenciado dos niveles dentro de cada grupo, según el promedio de notas globales de esos alumnos ha sido alto o bajo, en el global de las materias. Durante los cuatro cursos de la ESO se ha hecho un seguimiento, alumno por alumno, del nivel de inglés oral de esos alumnos. Los resultados son los siguientes:

captura-de-pantalla-2016-09-18-a-las-11-30-29

Hay dos factores fijos: Grupo y Nivel. Grupo a tres niveles y Nivel a dos niveles. Los dos factores son fijos y están cruzados. Pero hay un tercer factor: el factor ESO, con cuatro niveles fijos. La variable estudiada es el nivel de inglés oral. Los factores Grupo y Nivel son intersujetos. El factor ESO es intrasujetos. Las variables InglésEscrito e InglésOral a finales de primaria podría tratarse como covariable.

Ejemplos de presentación de la Estadística en Oceanografía

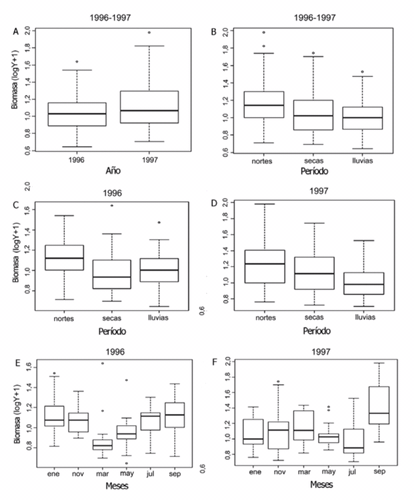
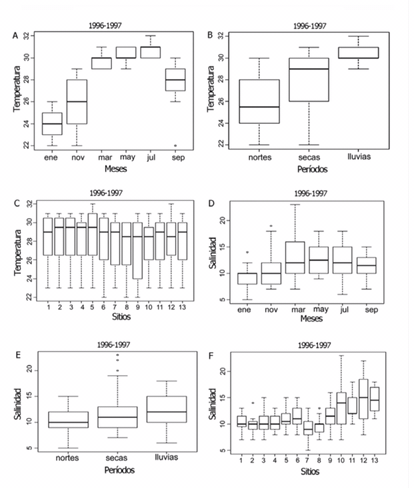
Vamos a ver aquí diferentes tablas y gráficos donde se usa la Estadística en Oceanografía:

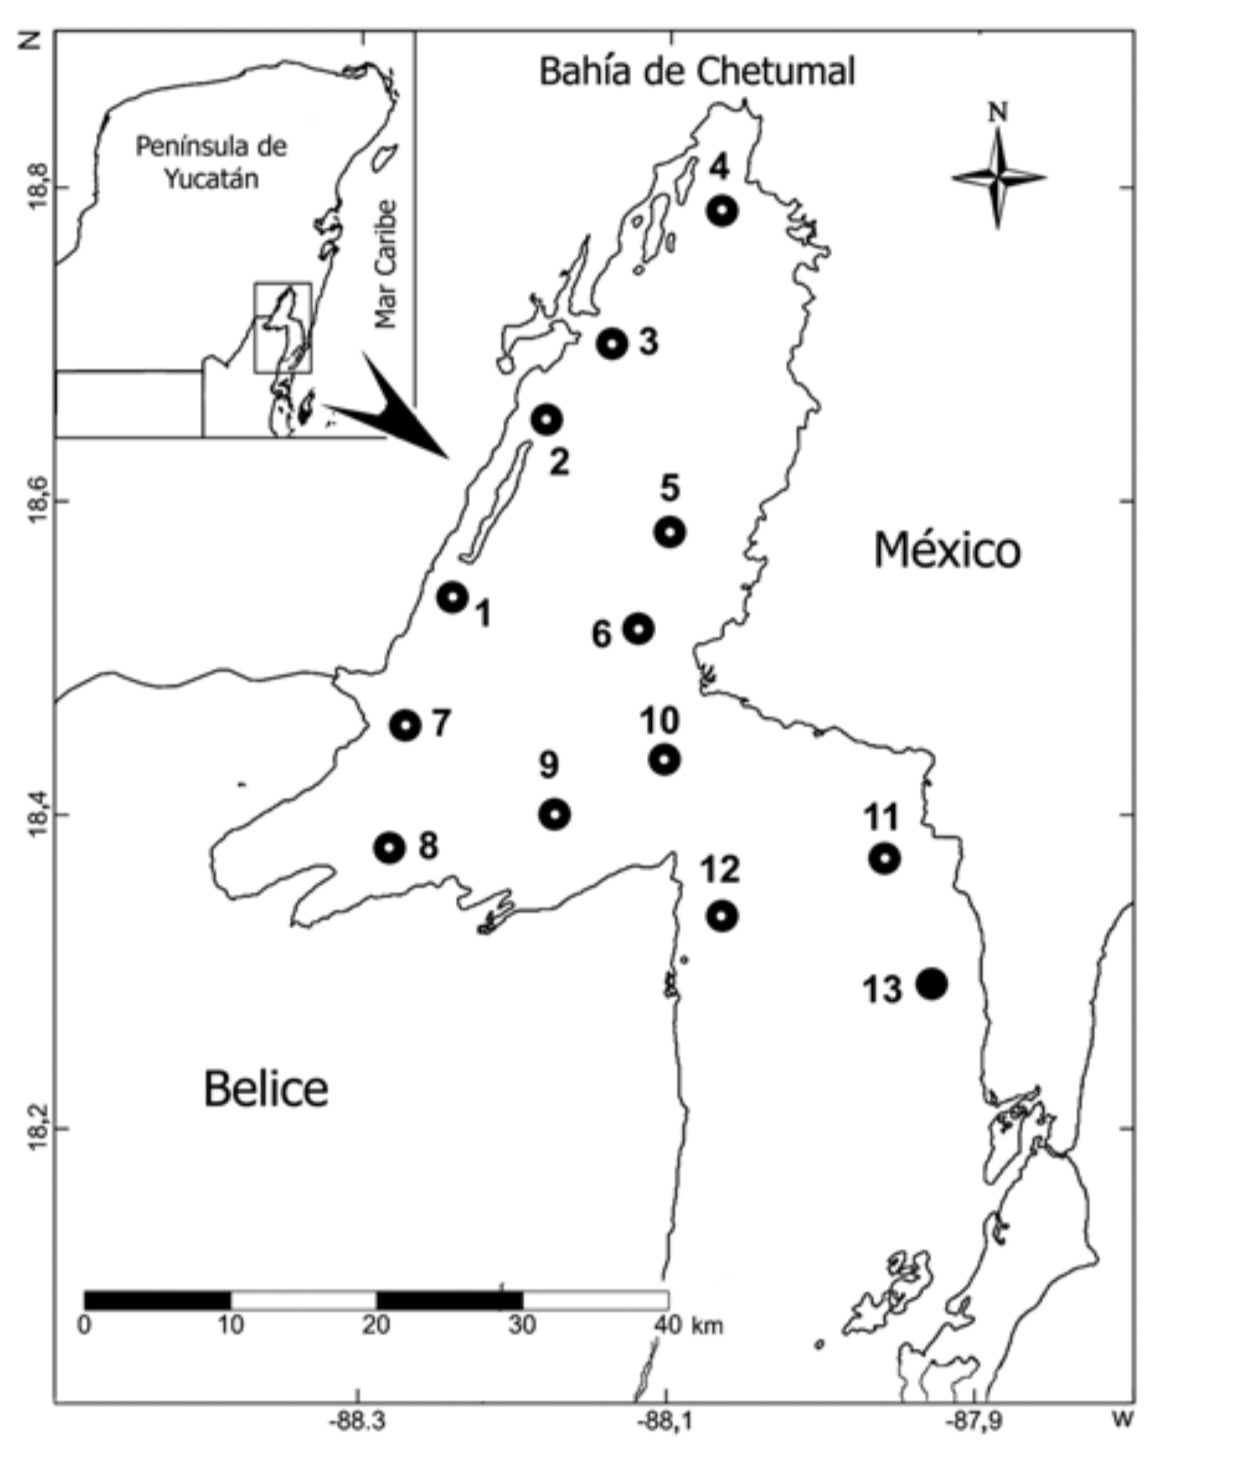
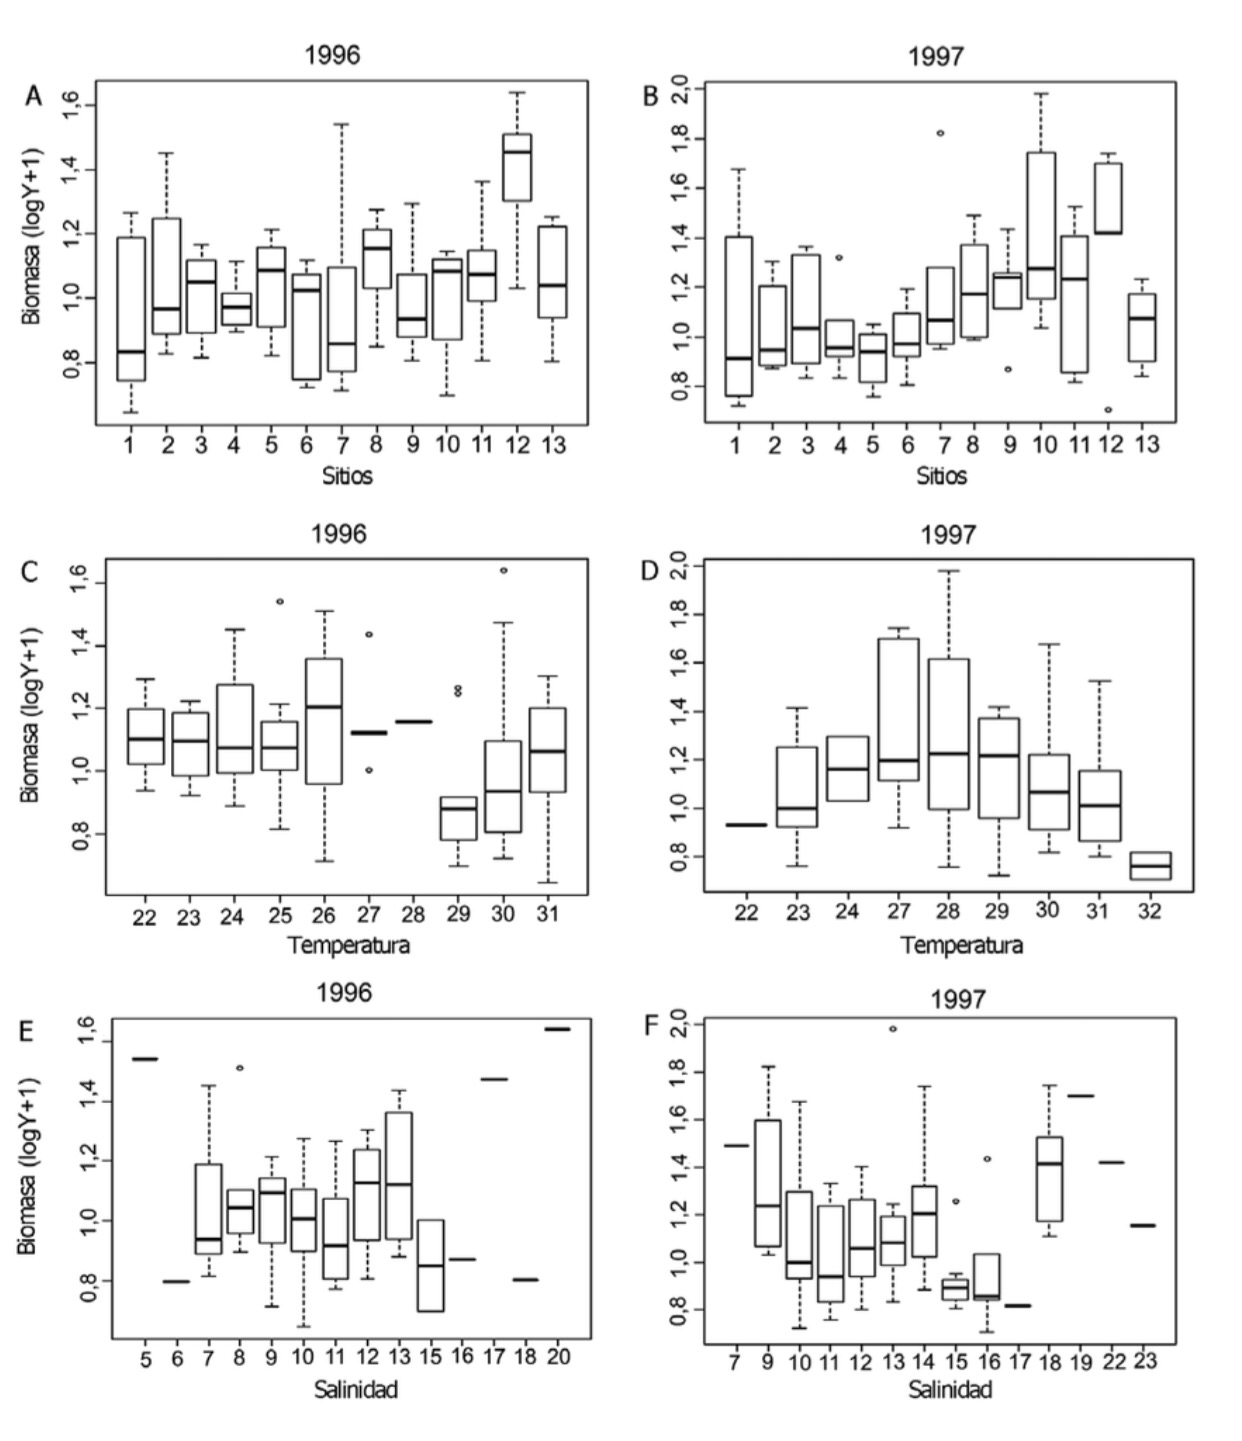
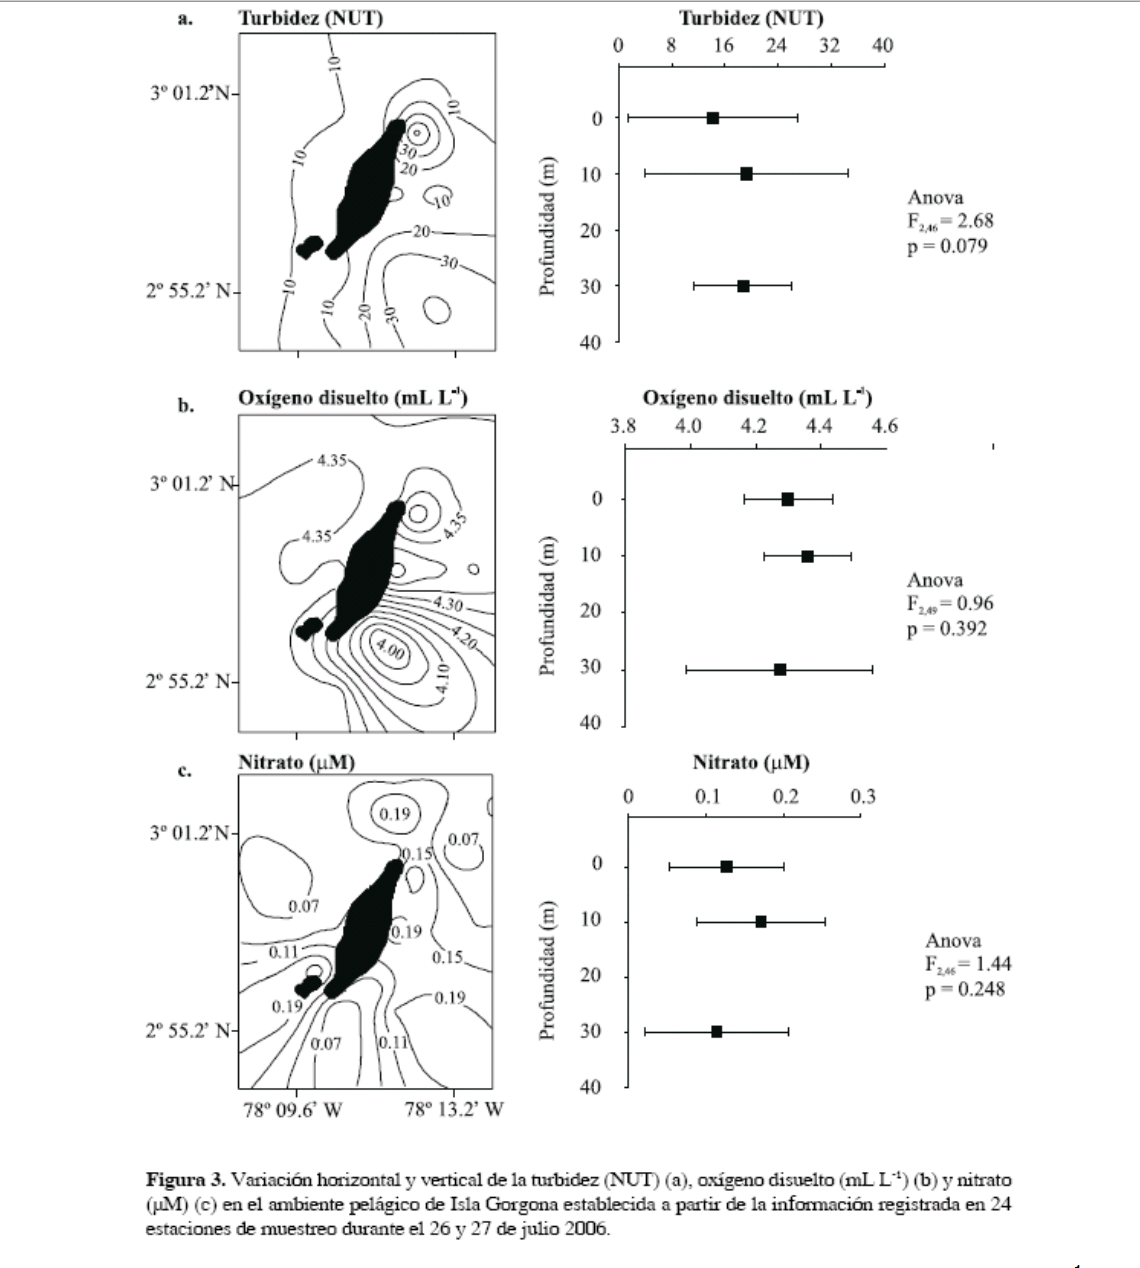
1. Veamos un ejemplo característico de uso del gráfico Box-Plot en oceanografía, donde se eligen una serie de puntos de muestreo y se evalúan en ellos una serie de variables típicas:

img_4693-1

img_4695-1

img_4694-1

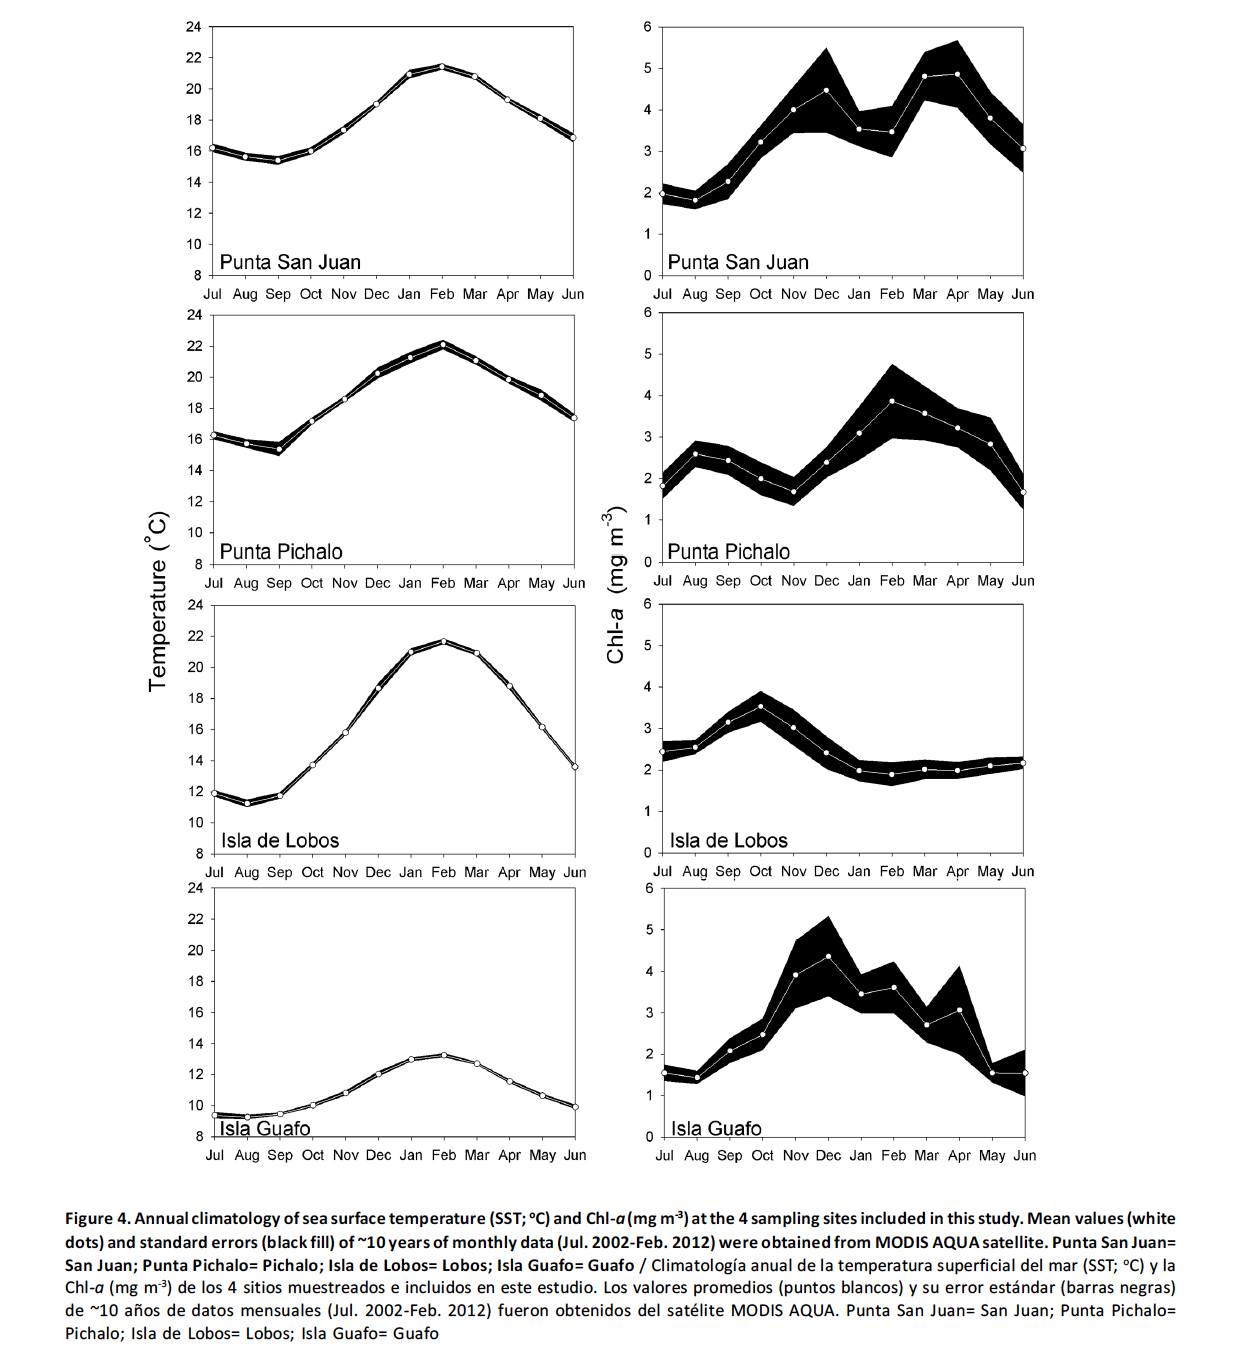
2. Veamos a continuación diferentes usos de la media, la desviación típica y el error estándar. El gran problema con el uso de esos dos conceptos (desviación estándar y error estándar) es que, en muchas ocasiones, no queda claro cuál se ha usado y el problema es que el que escribe el artículo tampoco tiene claro cuál le interesa usar en un momento determinado.

captura-de-pantalla-2016-09-22-a-las-23-24-43

captura-de-pantalla-2016-09-22-a-las-23-18-44

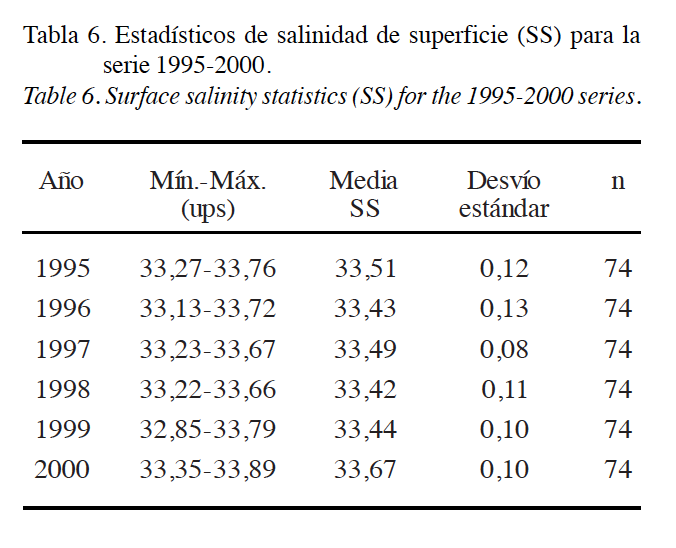
A continuación puede verse un redactado de una información descriptiva:

captura-de-pantalla-2016-09-22-a-las-23-40-38

captura-de-pantalla-2016-10-12-a-las-13-09-42

captura-de-pantalla-2016-10-12-a-las-13-12-16

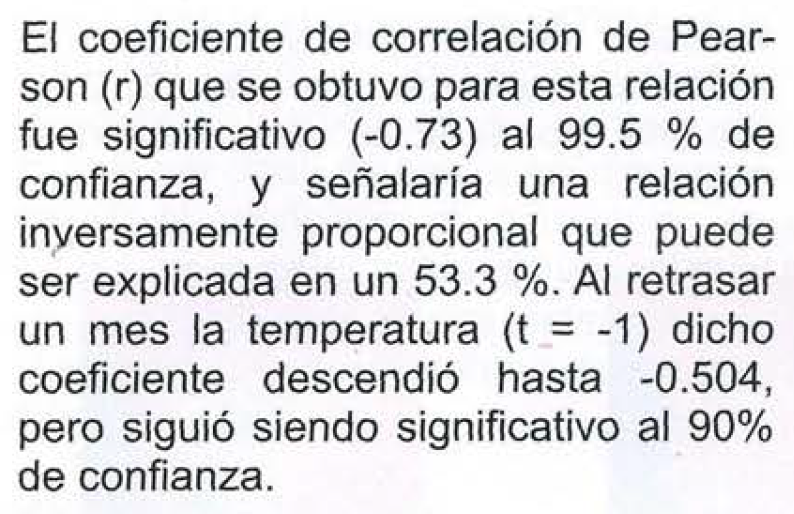
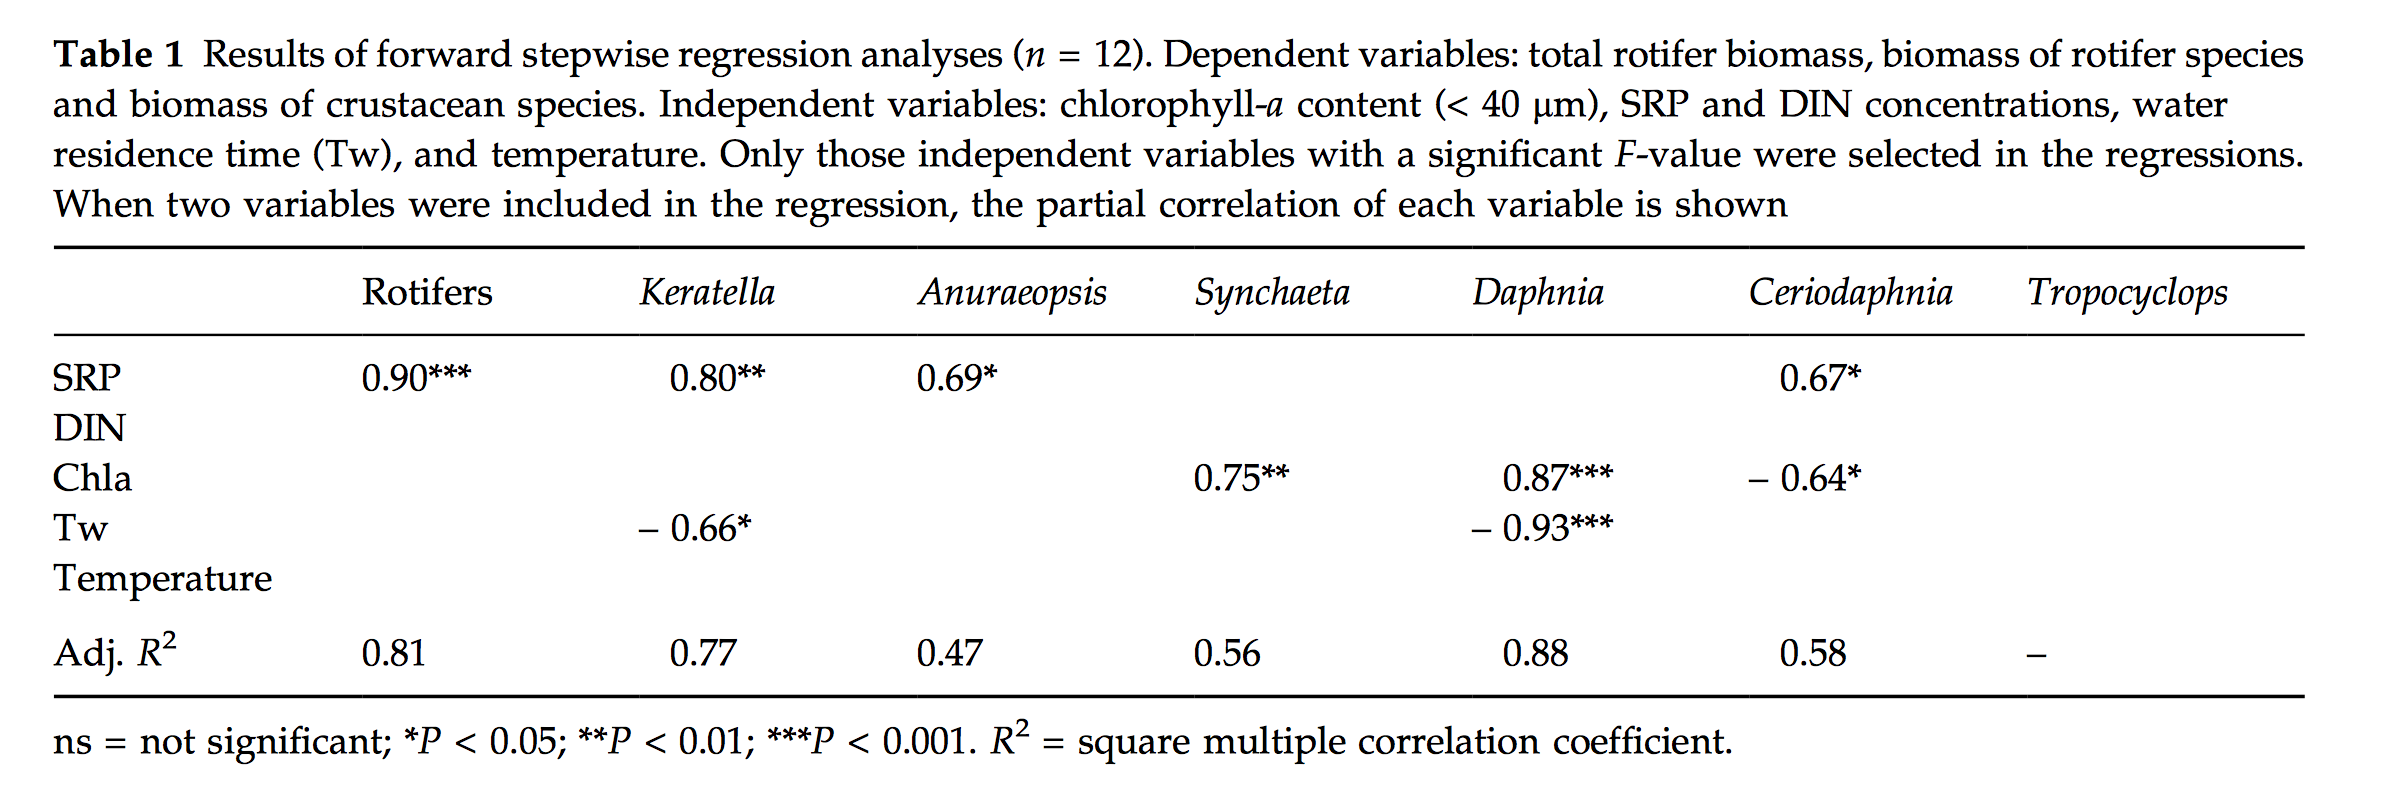
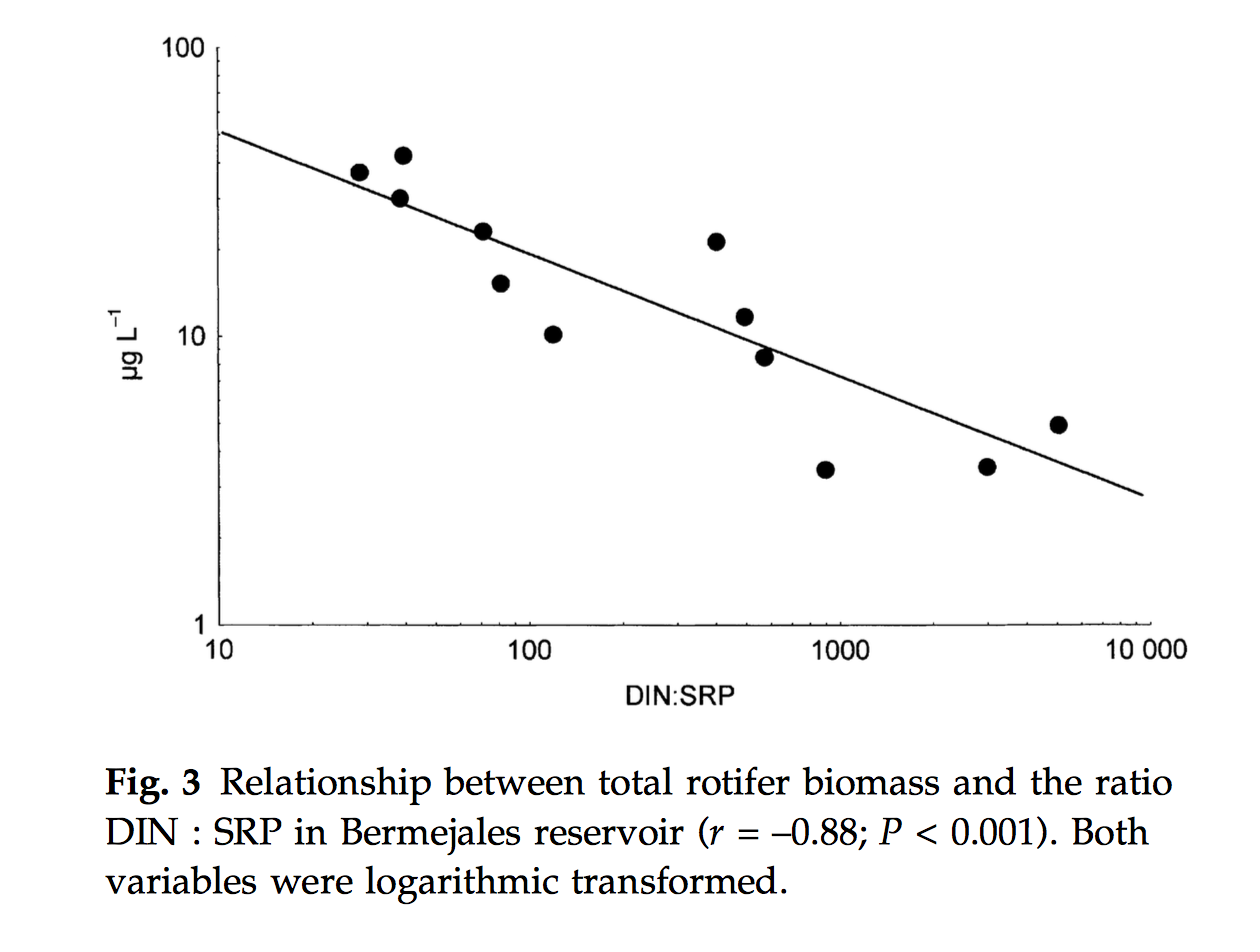
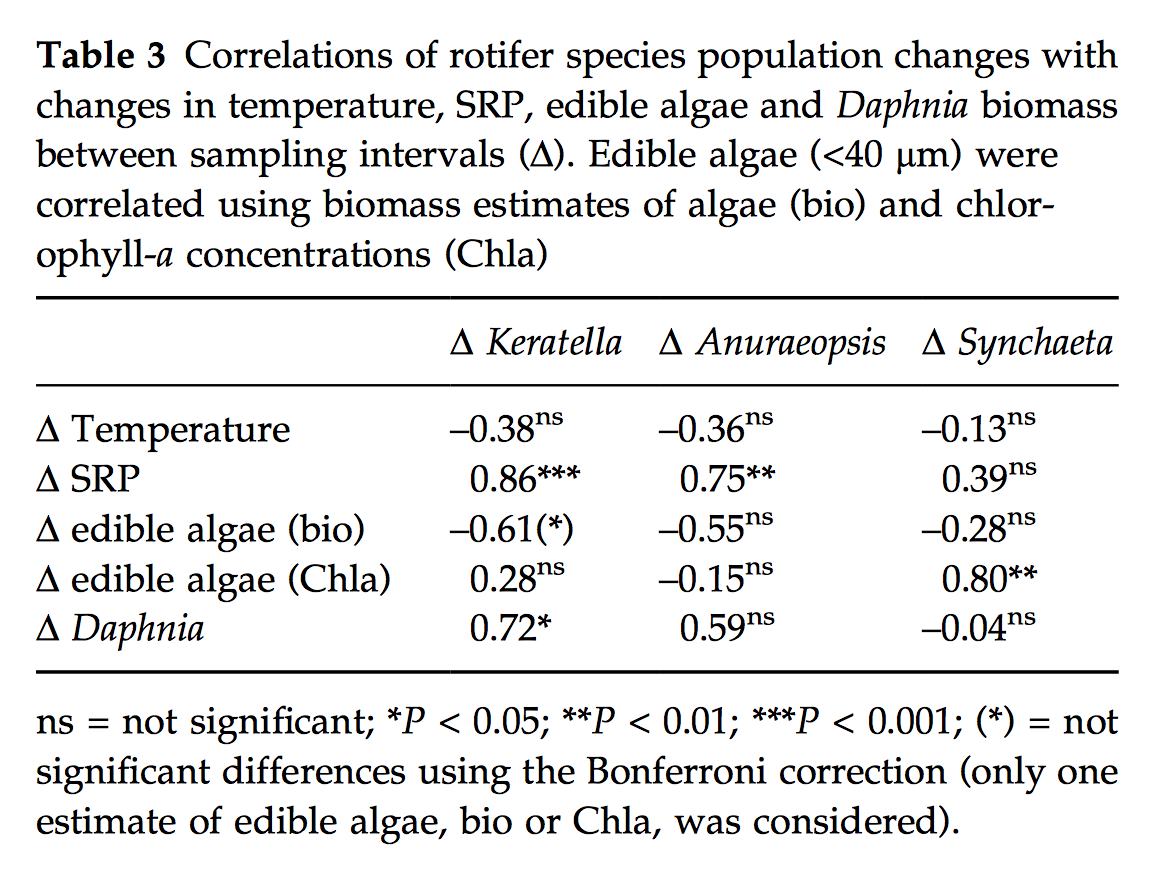
3. Veamos ahora diferentes usos del concepto de correlación:

captura-de-pantalla-2016-10-07-a-las-11-23-11

captura-de-pantalla-2016-10-07-a-las-11-30-36

captura-de-pantalla-2016-10-07-a-las-11-31-41

captura-de-pantalla-2016-10-07-a-las-11-32-10

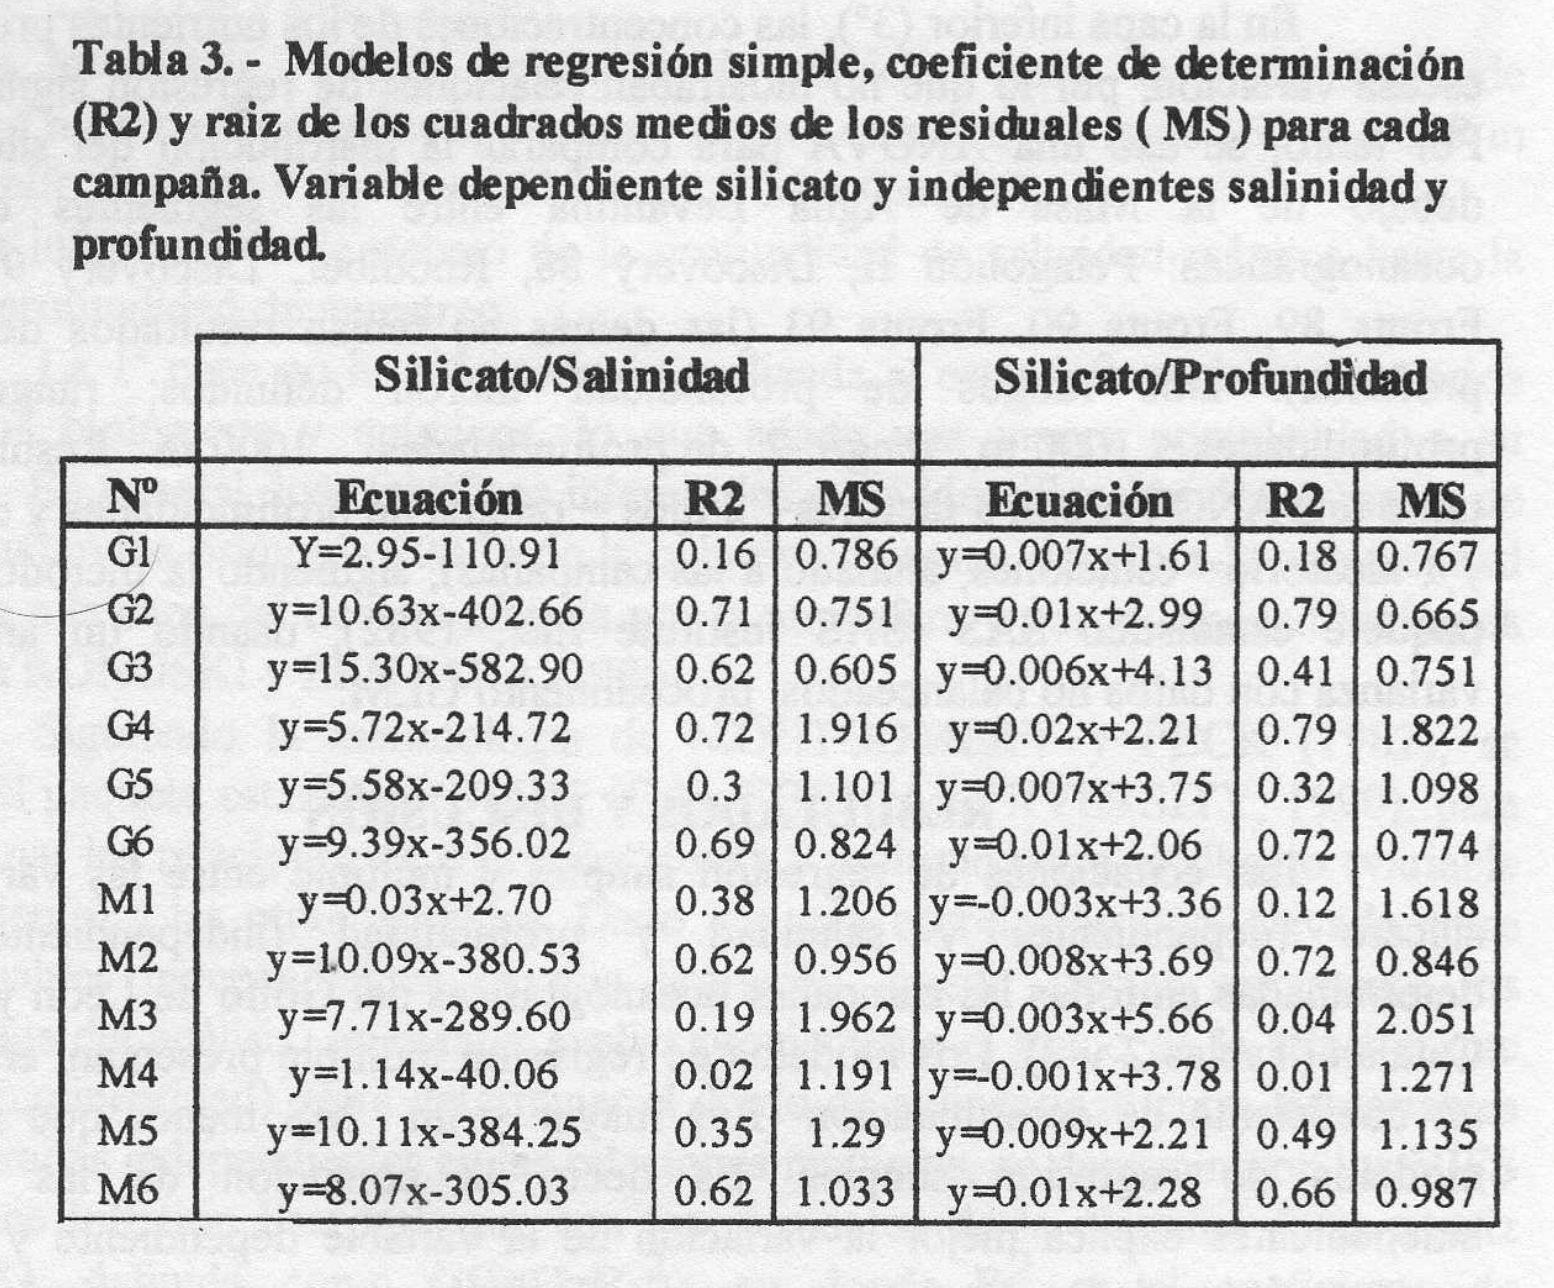
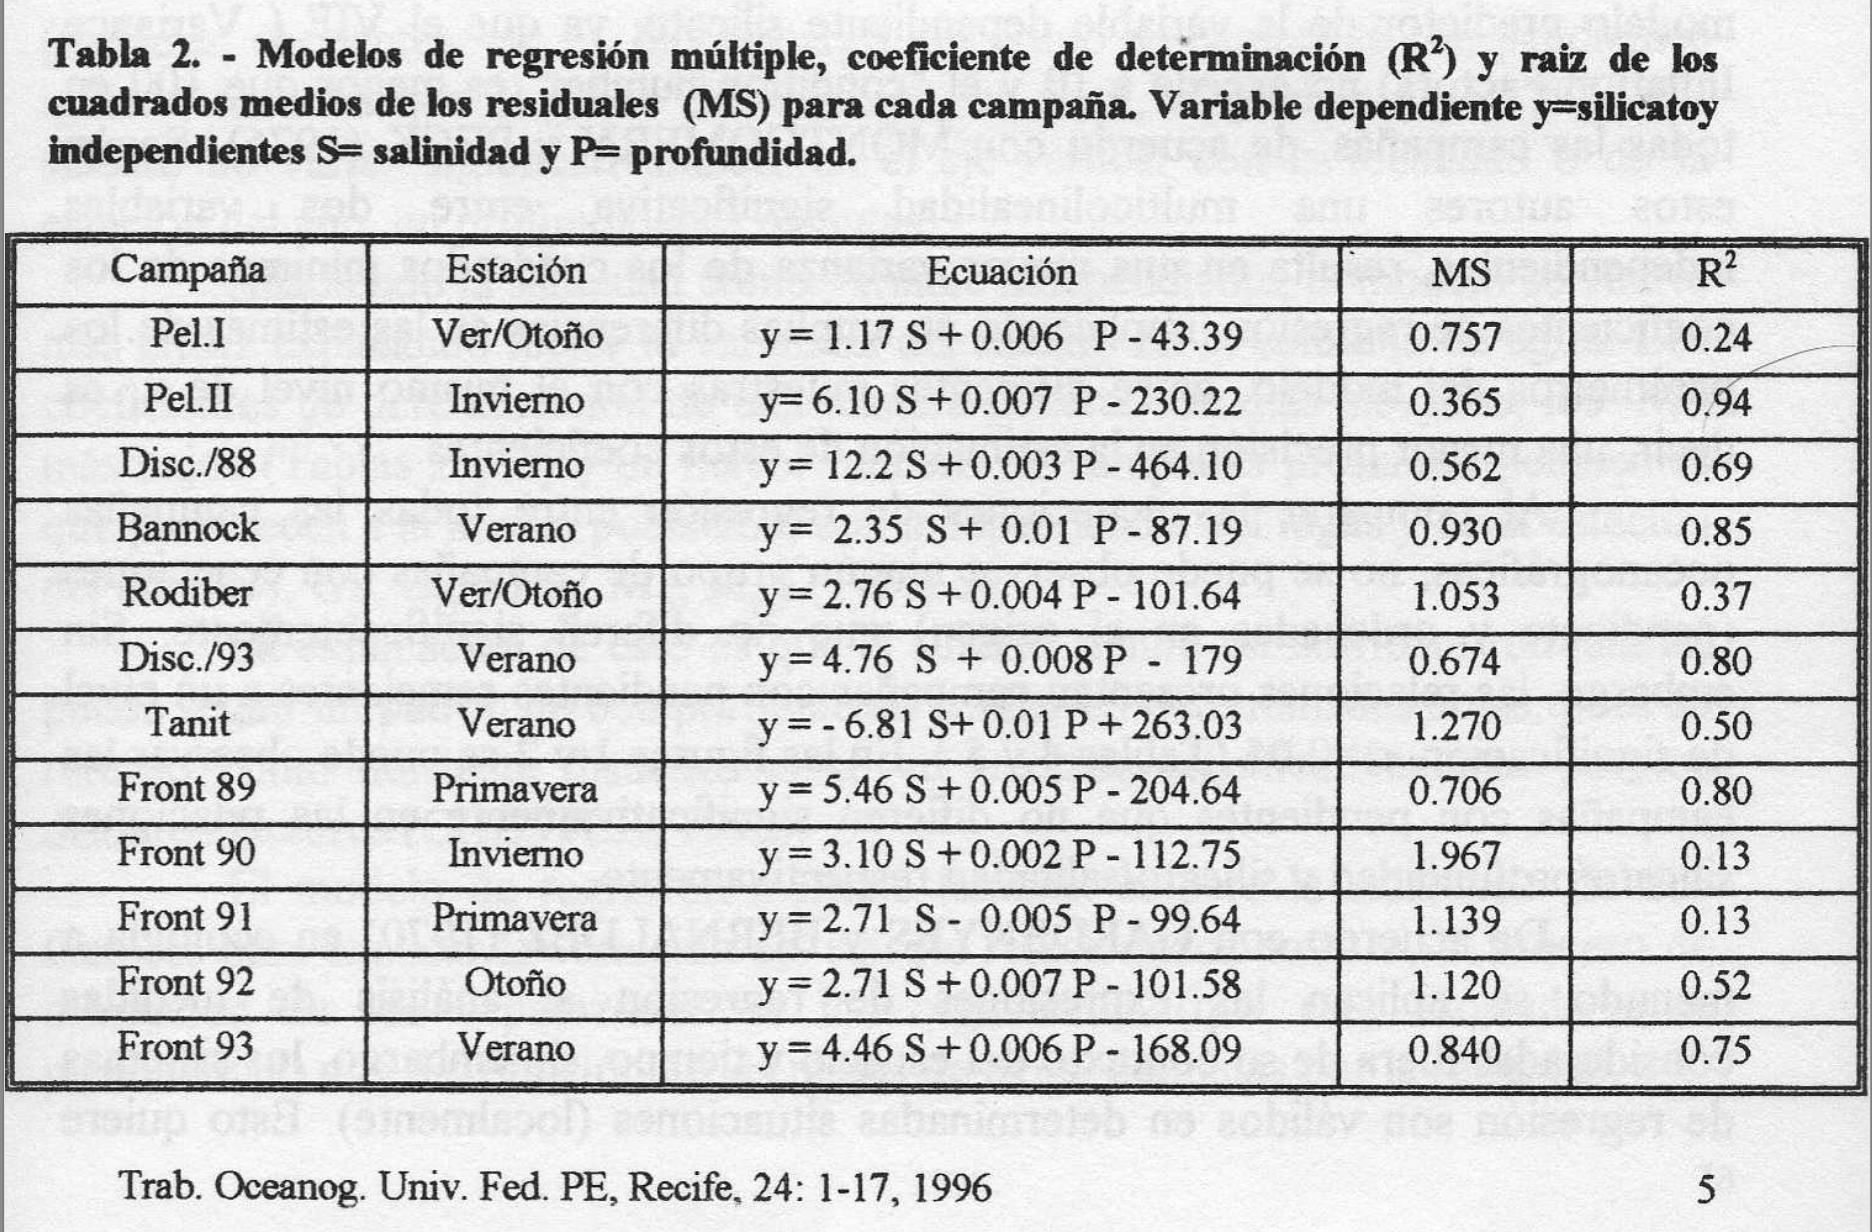
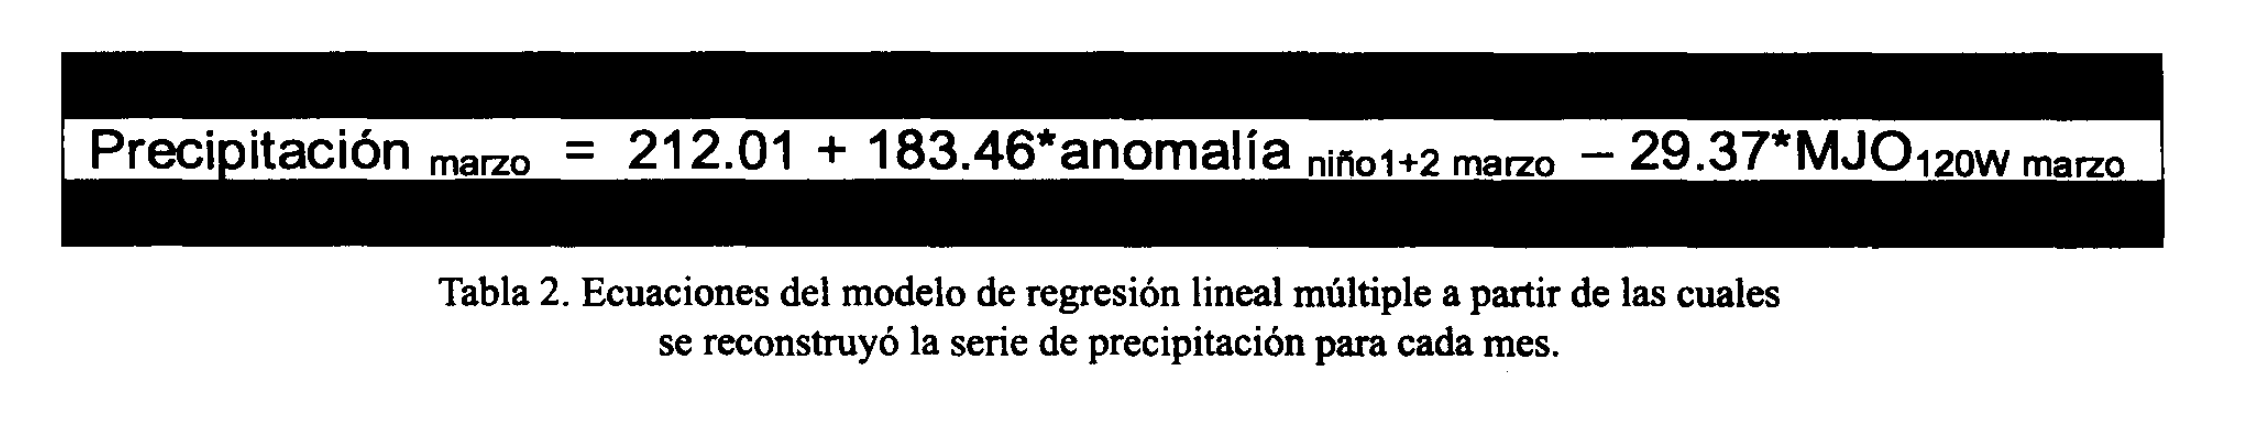
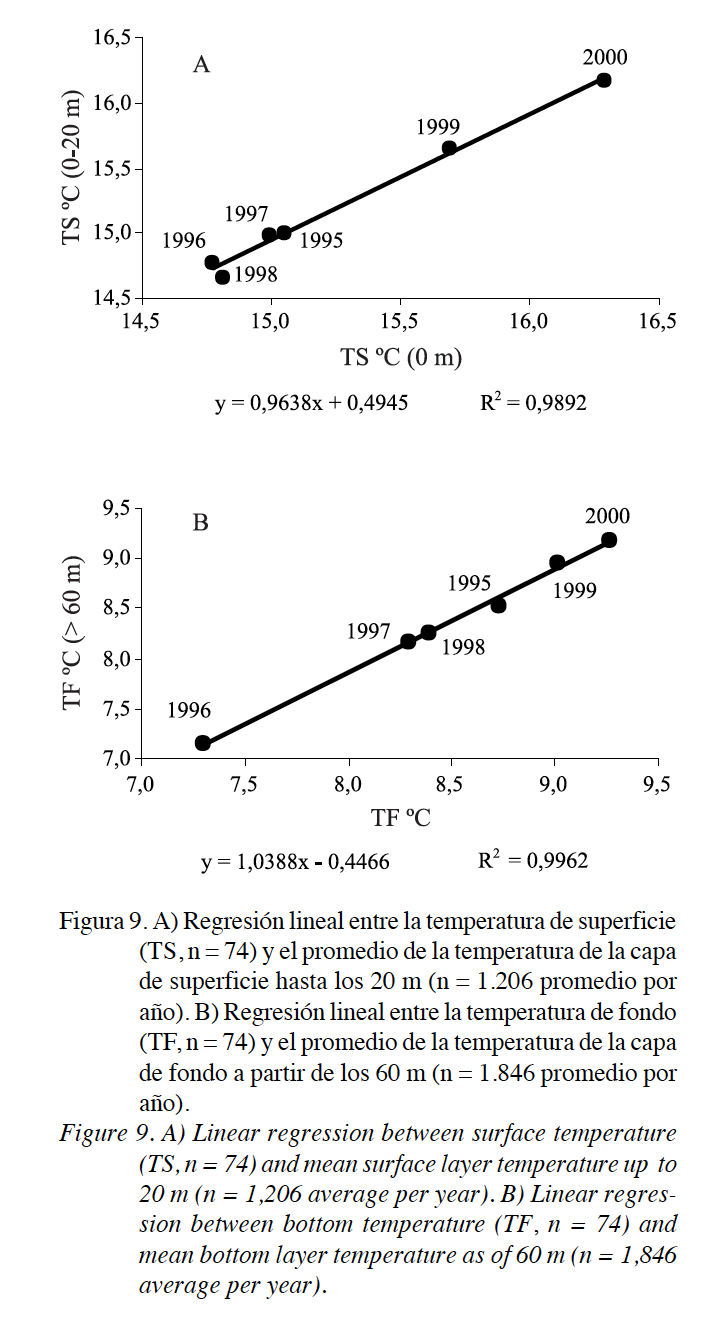
4. Veamos ahora diferentes ejemplos donde aparece la regresión:

captura-de-pantalla-2016-10-09-a-las-11-06-38


captura-de-pantalla-2016-10-09-a-las-11-06-22


captura-de-pantalla-2016-10-09-a-las-11-02-52

captura-de-pantalla-2016-10-12-a-las-13-12-50

5.Técnicas de comparación:

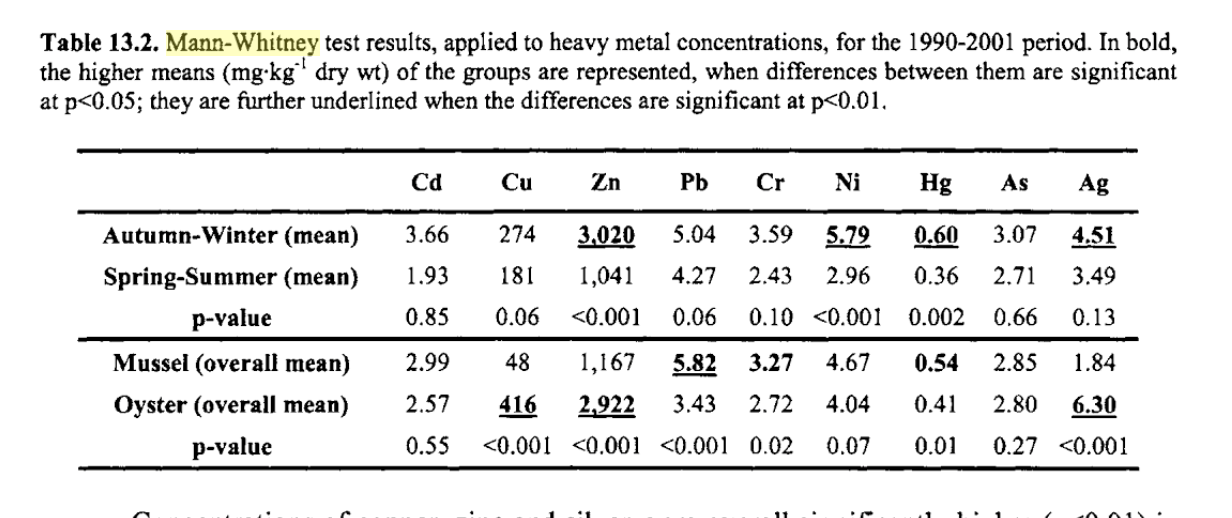
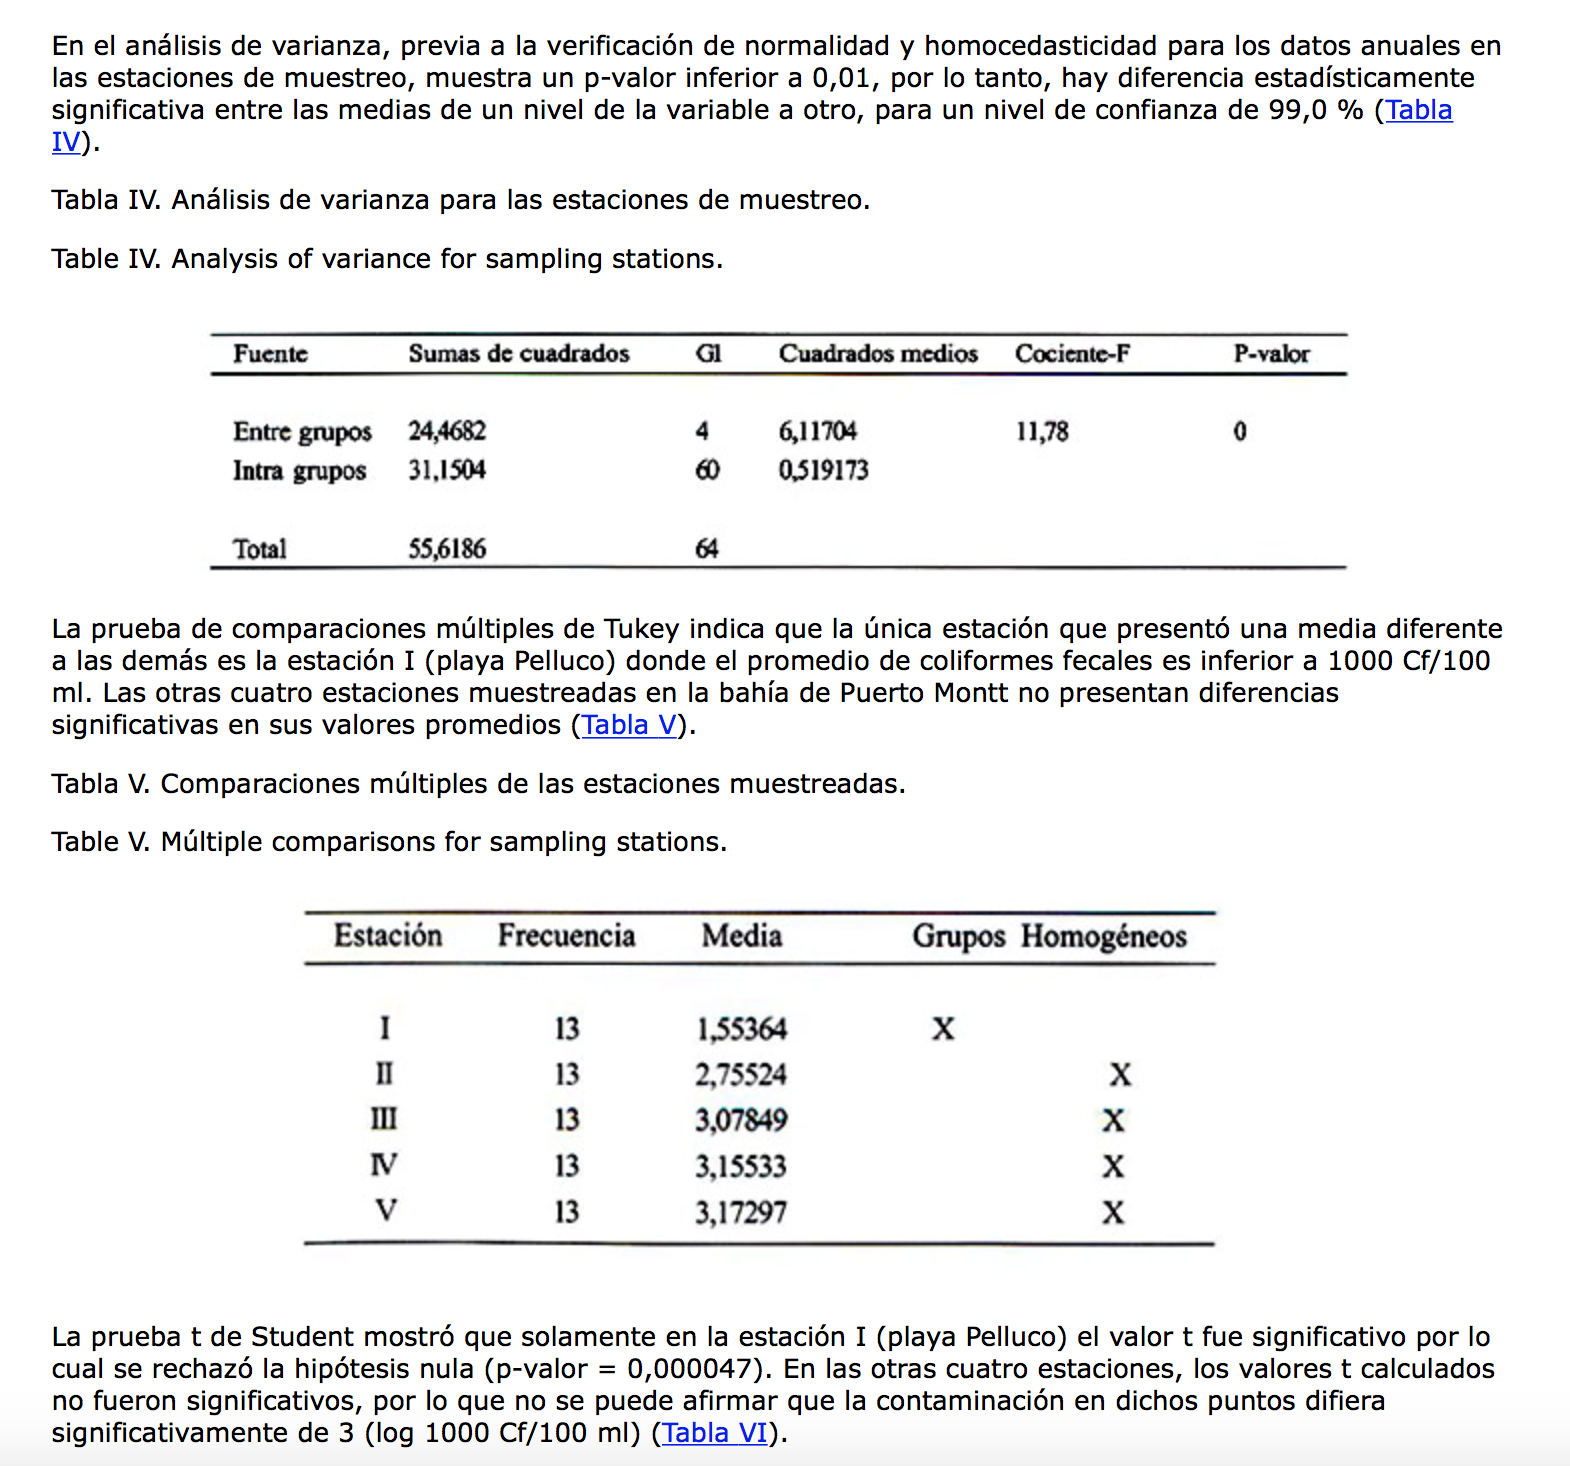
captura-de-pantalla-2016-11-23-a-las-16-39-05

captura-de-pantalla-2016-11-23-a-las-16-40-54

captura-de-pantalla-2016-11-20-a-las-10-38-55