1b
2c
3c
4c
5c
1b
2c
3c
4c
5c
1.Se quiere ver la relación entre el nivel de un contaminante ambiental y la viabilidad o no viabilidad al cabo de un año en ejemplares de una especie determinada. ¿Cuál de las siguientes curvas de regresión logística indicarían un mayor efecto de los niveles progresivamente altos de contaminación sobre la no viabilidad? (Viabilidad=0; No viabilidad=1):

a.a
b.b
c.c
d.d
2.En un estudio nos dicen que la relación entre el porcentaje de abundancia de una determina especie de insecto y el que se produzca reproducción (1) o no (0) de una determinada especie de pájaro se puede expresar mediante la siguiente expresión: OR=1.53; IR 95%: (1.23, 2.33). ¿Cuál de las siguientes afirmaciones es cierta?
a.No podemos decir si hay o no relación significativa porque no tenemos un p-valor.
b.Hay una relación significativa. Cuanto mayor porcentaje de esa especie de insecto menos posibilidad de reproducción del ave.
c.Hay una relación significativa. Cuanto mayor porcentaje de esa especie de insecto tengamos mayor posibilidad de reproducción del ave.
d.Un estudio como este precisa de una Regresión logística múltiple.
3.¿Cuál de las siguientes afirmaciones es cierta?
a.Una OR mayor que 1 es automáticamente significativa.
b.Una OR=0.5 (p<0.05) indica que al aumentar el valor de la variable cuantitativa la probabilidad del fenómeno dicotómico estudiado, y marcado con un 1, aumenta.
c.Una OR=2, con IC95%: (1.5, 2.3) es mayor que un OR=4 con IC95%: (0.8, 10.3).
d.Una regresión logística es una relación entre dos variables cuantitativas.
4.En un estudio de susceptibilidad a la erosión en una cuenca hidrográfica (https://www.revistas.una.ac.cr/index.php/ambientales/article/view/10110/12576) se han buscado los elementos que condicionan esa susceptibilidad mediante un análisis de regresión logística múltiple. Los resultados de esta análisis son los siguientes:

¿Cuál de las siguientes afirmaciones es cierta?
a.Ninguna de las cuatro variables estudiadas (Geomorfología, Uso, Pendiente y Distancia a cauces) guarda una relación con la erosión de forma significativa.
b.La OR de Distancia a cauces es 0.448.
c.La OR de Pendiente es 2,859.
d.El intervalo de confianza del 95% de Geomorfología nos indica que esa variable no guarda relación con la Erosión.
5.Tenemos, en el estudio referido anteriormente, el siguiente mapa:

¿Cuál de las siguientes afirmaciones es cierta?
a.Las zonas rojas están más cerca de cauces.
b.Las zonas verdes son las más susceptibles a la erosión.
c.Las zonas rojas son donde se presenta más pendiente.
d.Los puntos negros son los únicos donde tenemos muestras.
1.
a.

b. Cinco efectos.
c. Una posible solución es la siguiente:

Puede apreciarse cómo hay diferencias claras entre las dos especies, entre las dos zonas, pero no las hay entre subzonas.
2.

Para ver cuáles son los cocientes adecuados hay que buscar el modelo:

Los cocientes F serán, pues:

Pero, cuidado, porque, en este modelo, los factores aleatorios son el A y el B, pero en nuestro problema son el B y el C. Lo que le sucede, pues, al A y al B en este modelo es lo que les sucede al B y al C en nuestro problema. Y lo que le sucede al C en el modelo es lo que le sucede al A en nuestro problema. Por lo tanto, los cocientes son los que veis en la solución.
El umbral es el valor de F(1,1) en los cinco primeros contrastes y es el valor de F(1,8) en los dos últimos contrastes.
1. Se quiere estudiar el grado de crecimiento vegetal de un proceso de reforestación de zonas que previamente han sufrido incendios. Se quiere comparar, en primer lugar, dos zonas muy concretas (de unas 50 hectáreas, cada una) que están a distintas alturas del nivel del mar (50 y 500 metros) y que sufrieron incendios con destrucción total de la vegetación. Para ver la homogenización de esta viabilidad en cada zona se toman, al azar, tres subzonas en cada zona para hacer el ensayo. Cada subzona es de una hectárea. En cada una de estas subzonas se plantan dos variedades de plantas que expresamente se quieren evaluar. La variable estudiada es el nivel de crecimiento de cada planta en biomasa. En cada subzona elegida se plantan 10 ejemplares de cada una de las dos especies vegetales.
a. Escribe el modelo.
b. ¿Cuántos efectos podremos evaluar?
c. Construye unos datos factibles con el resultado en el que sean significativos tanto el factor zona como el factor especie pero que el factor subzona no sea significativo.
2. Tenemos un modelo de tres factores (A, B y C). El factor A es fijo y los factores B y C son aleatorios. Los tres factores están cruzados. Completar la tabla:

El Análisis multivariante es un conjunto de técnicas estadísticas que tienen en común el hecho de que se trabaja con más de dos variables. Son técnicas con el mismo lenguaje del empleado en las técnicas donde se trabaja con una variable o con dos variables en las técnicas de relación (Correlación o Regresión simple).
Hay técnicas multivariante descriptivas, de relación y de comparación, que es una importante clasificación de las técnicas estadísticas que ya hemos visto.
Un esquema posible de todas las técnicas estadísticas sería la siguiente:

Veremos, pues, en este curso de Análisis multivariante:
El elemento clave en ANOVA, y de aquí su nombre, es la descomposición de la variabilidad global o total, en diferentes fuentes de variabilidad. Análisis de la varianza viene de ahí, analizar es descomponer una unidad en sus diferentes elementos constitutivos.
En todo modelo ANOVA hay siempre una descomposición de la variabilidad.
En un ANOVA de un factor es:
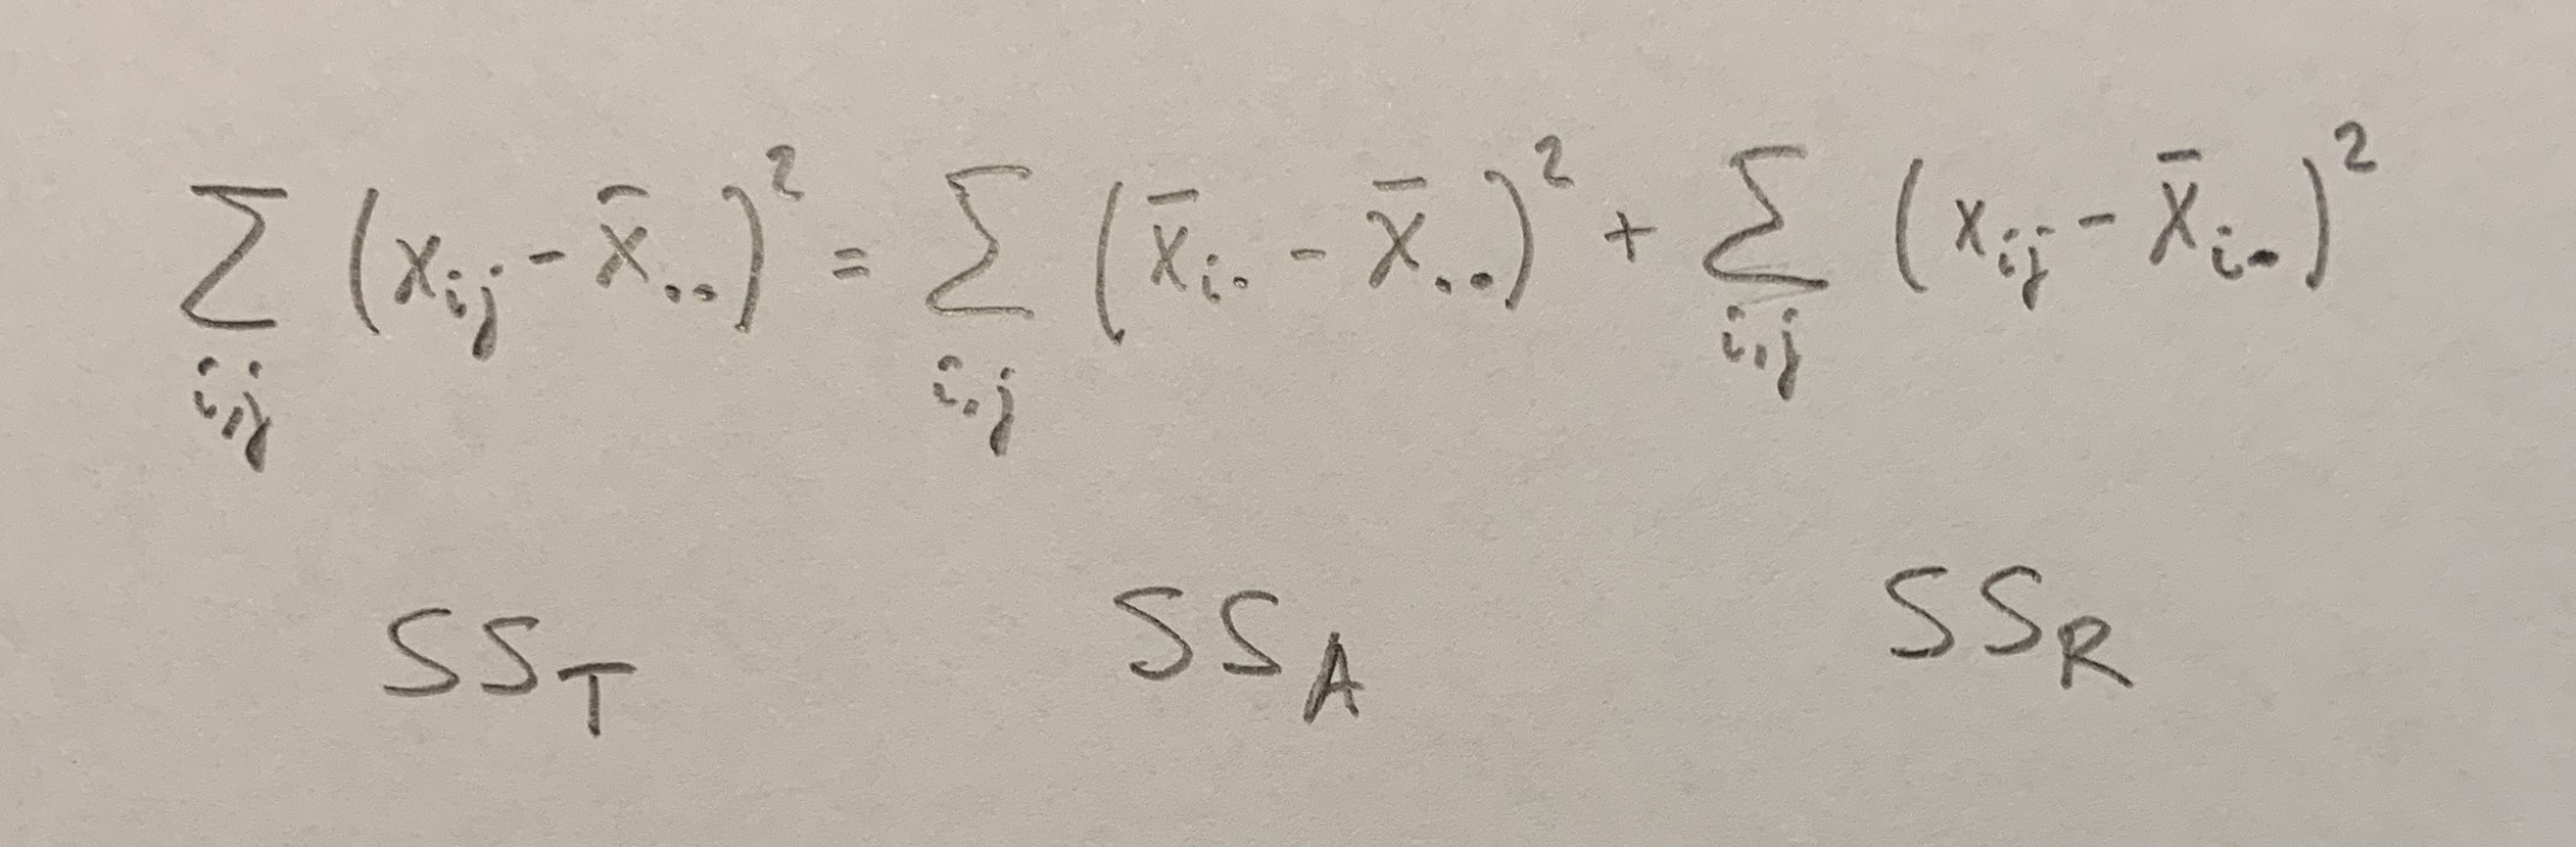
En una ANOVA de dos factores cruzados la descomposición es:
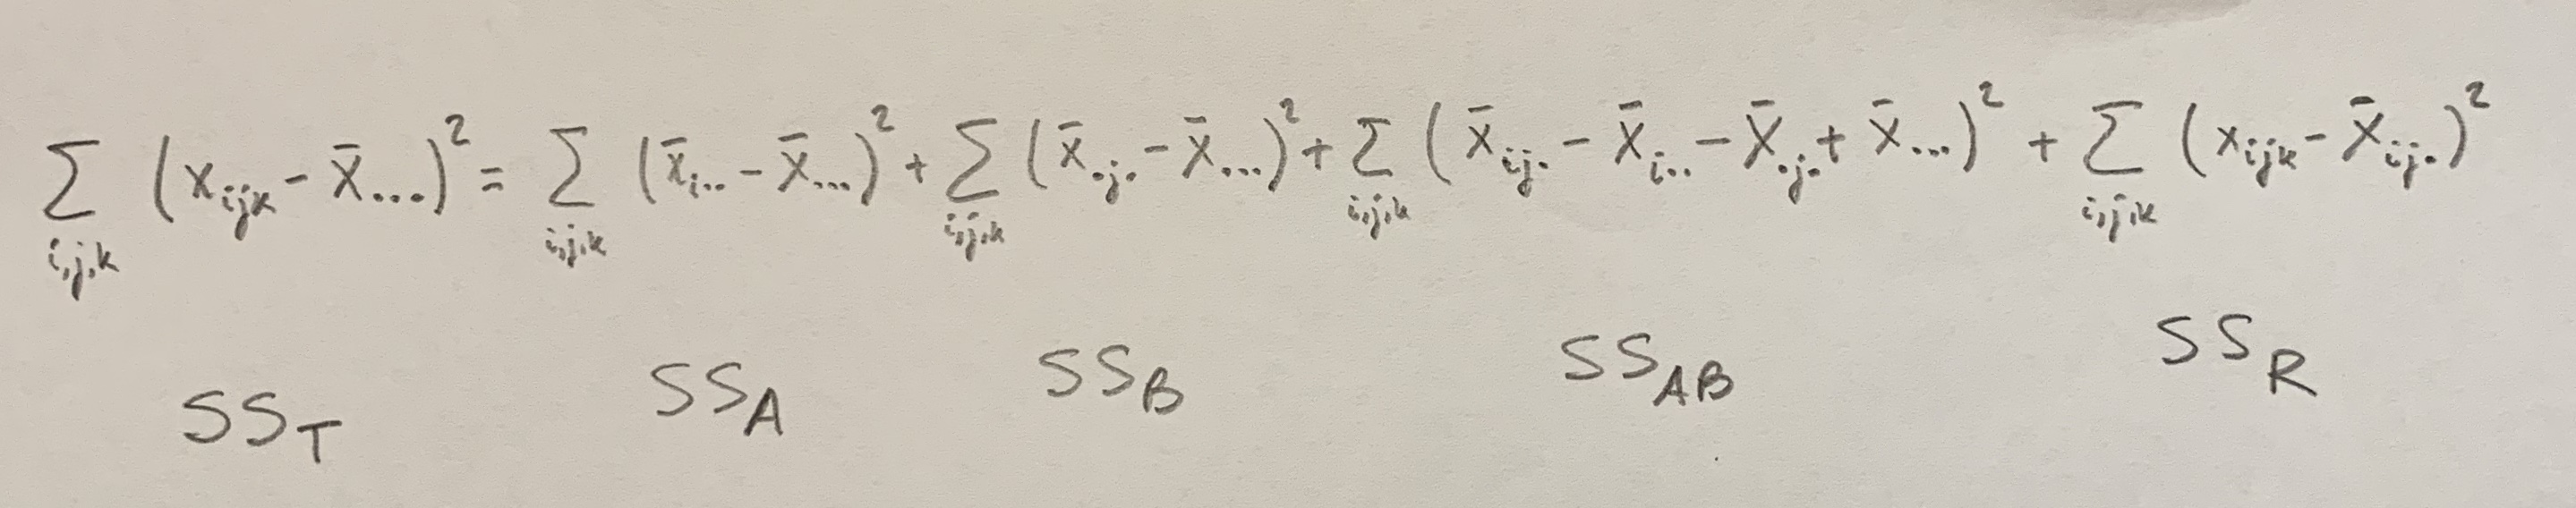
Las diferentes medias las podemo ver en el siguiente esquema:

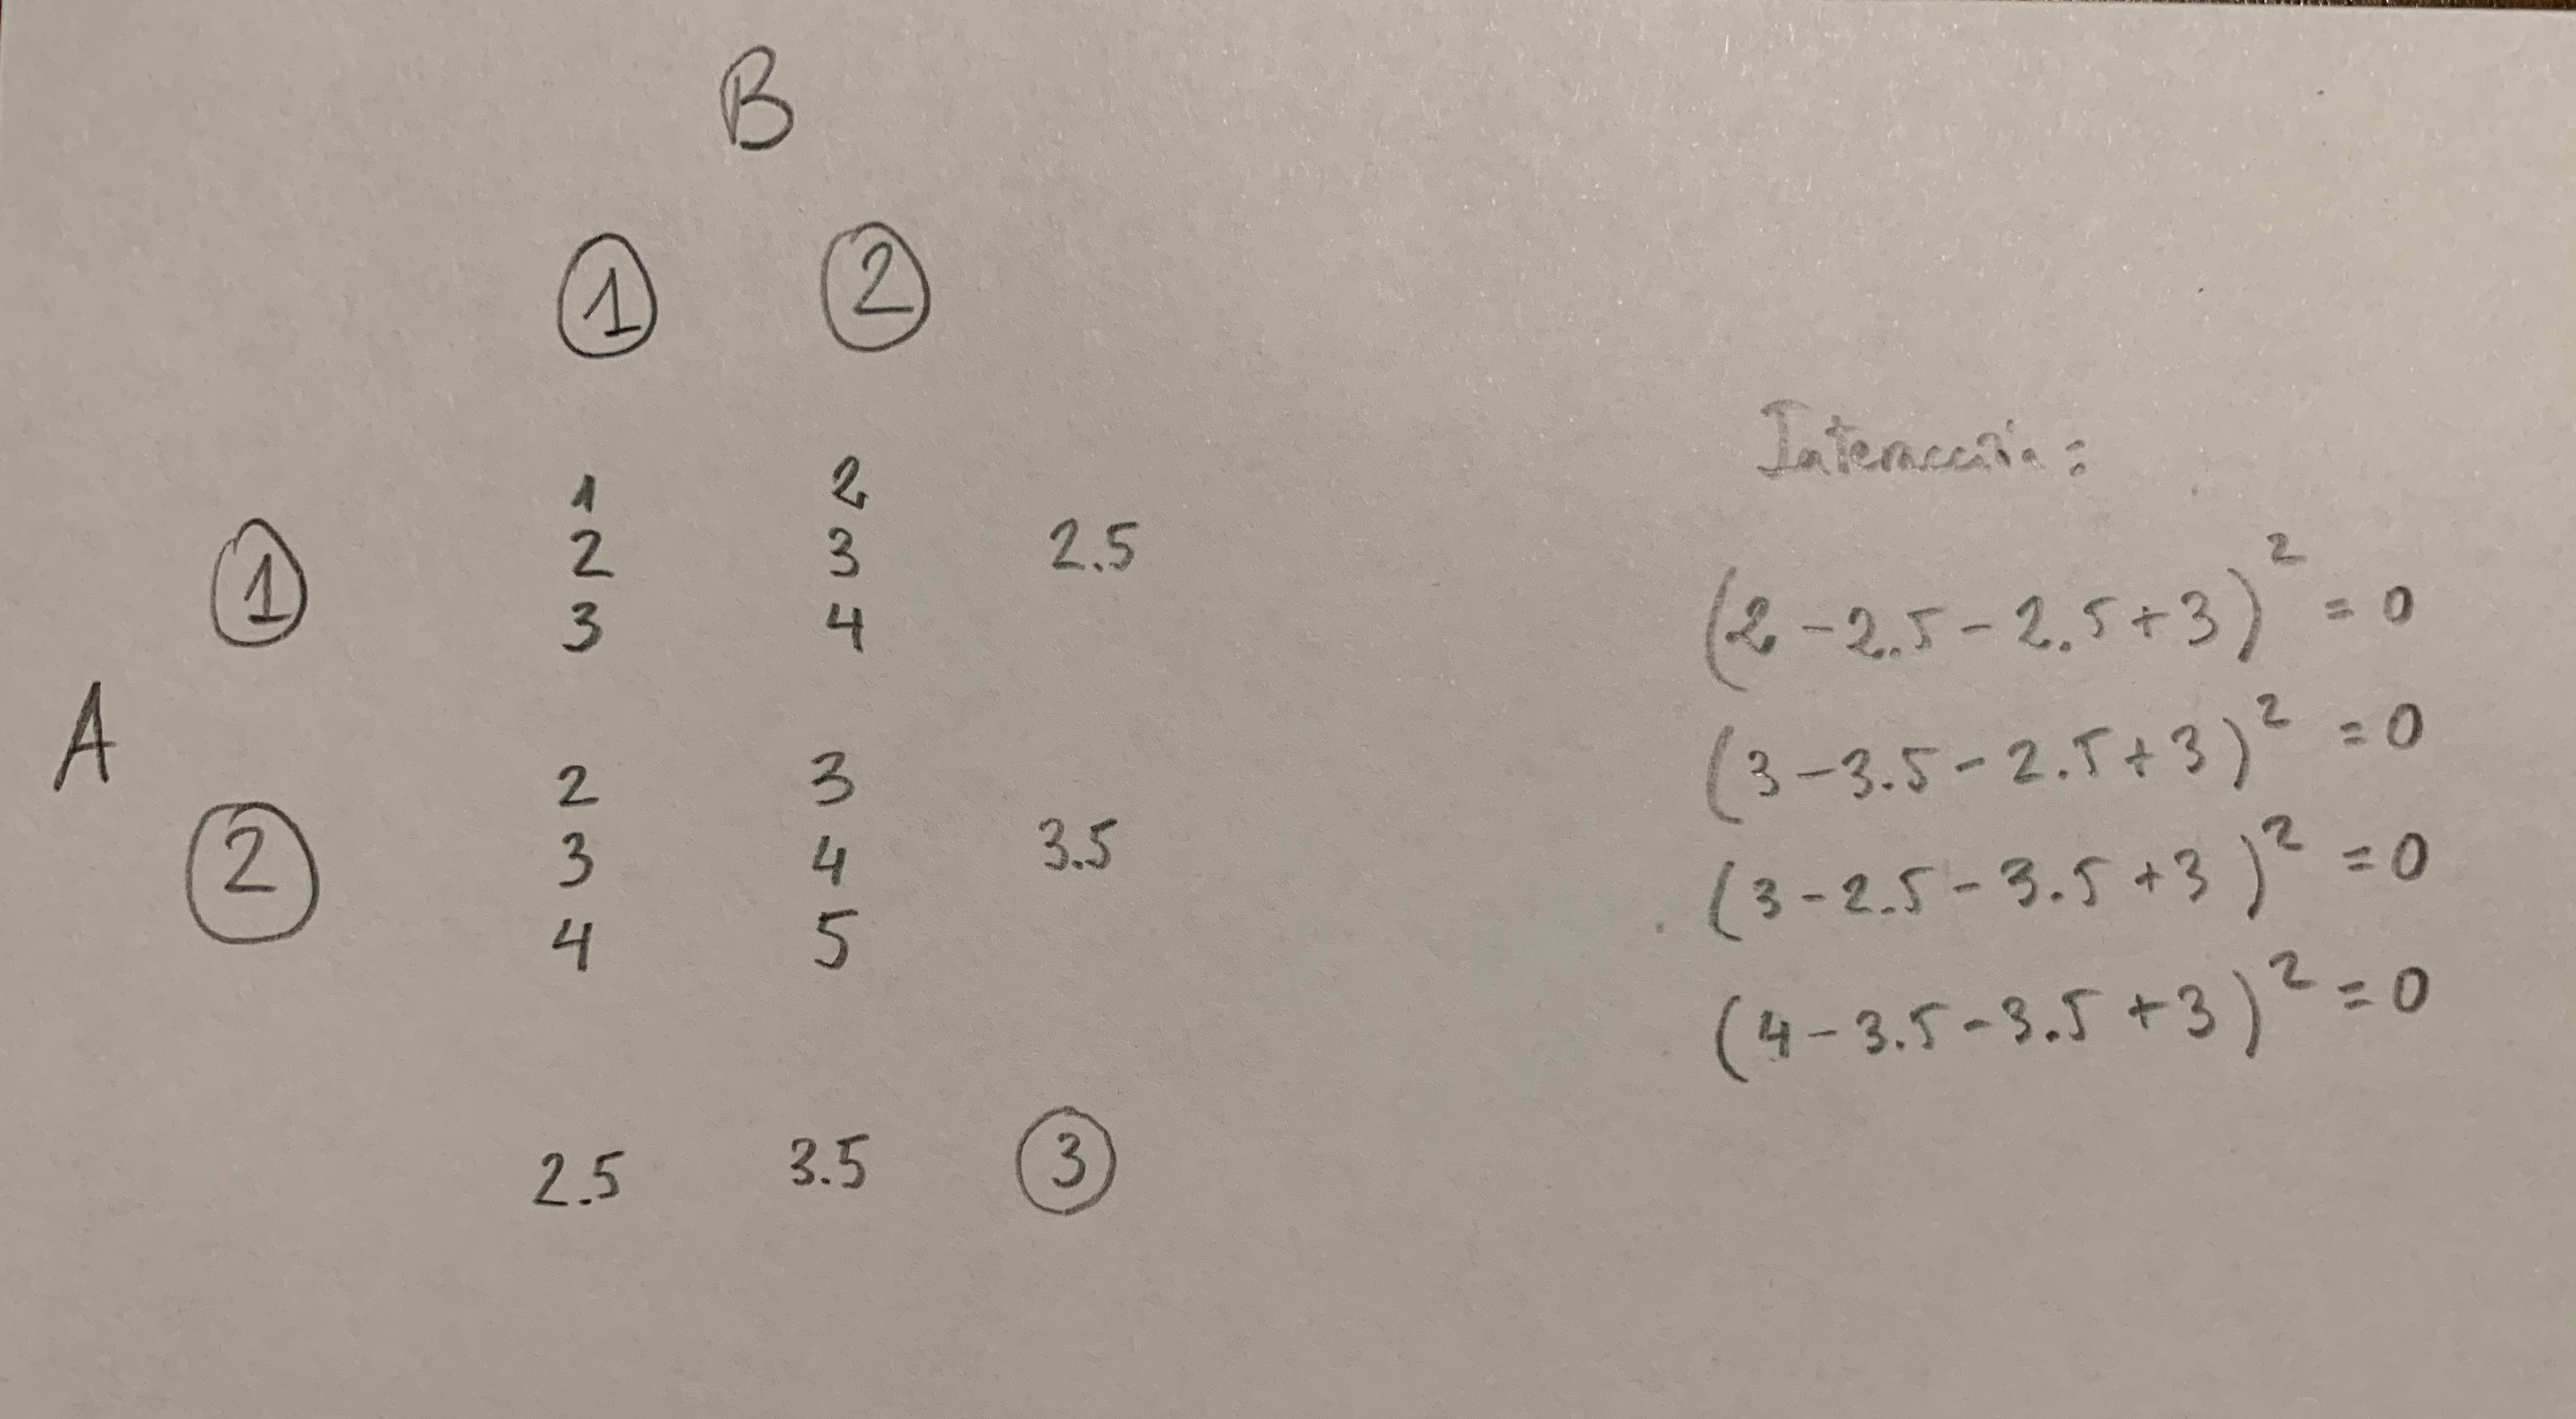
Veamos el papel de la interacción en los dos ejemplos siguientes:
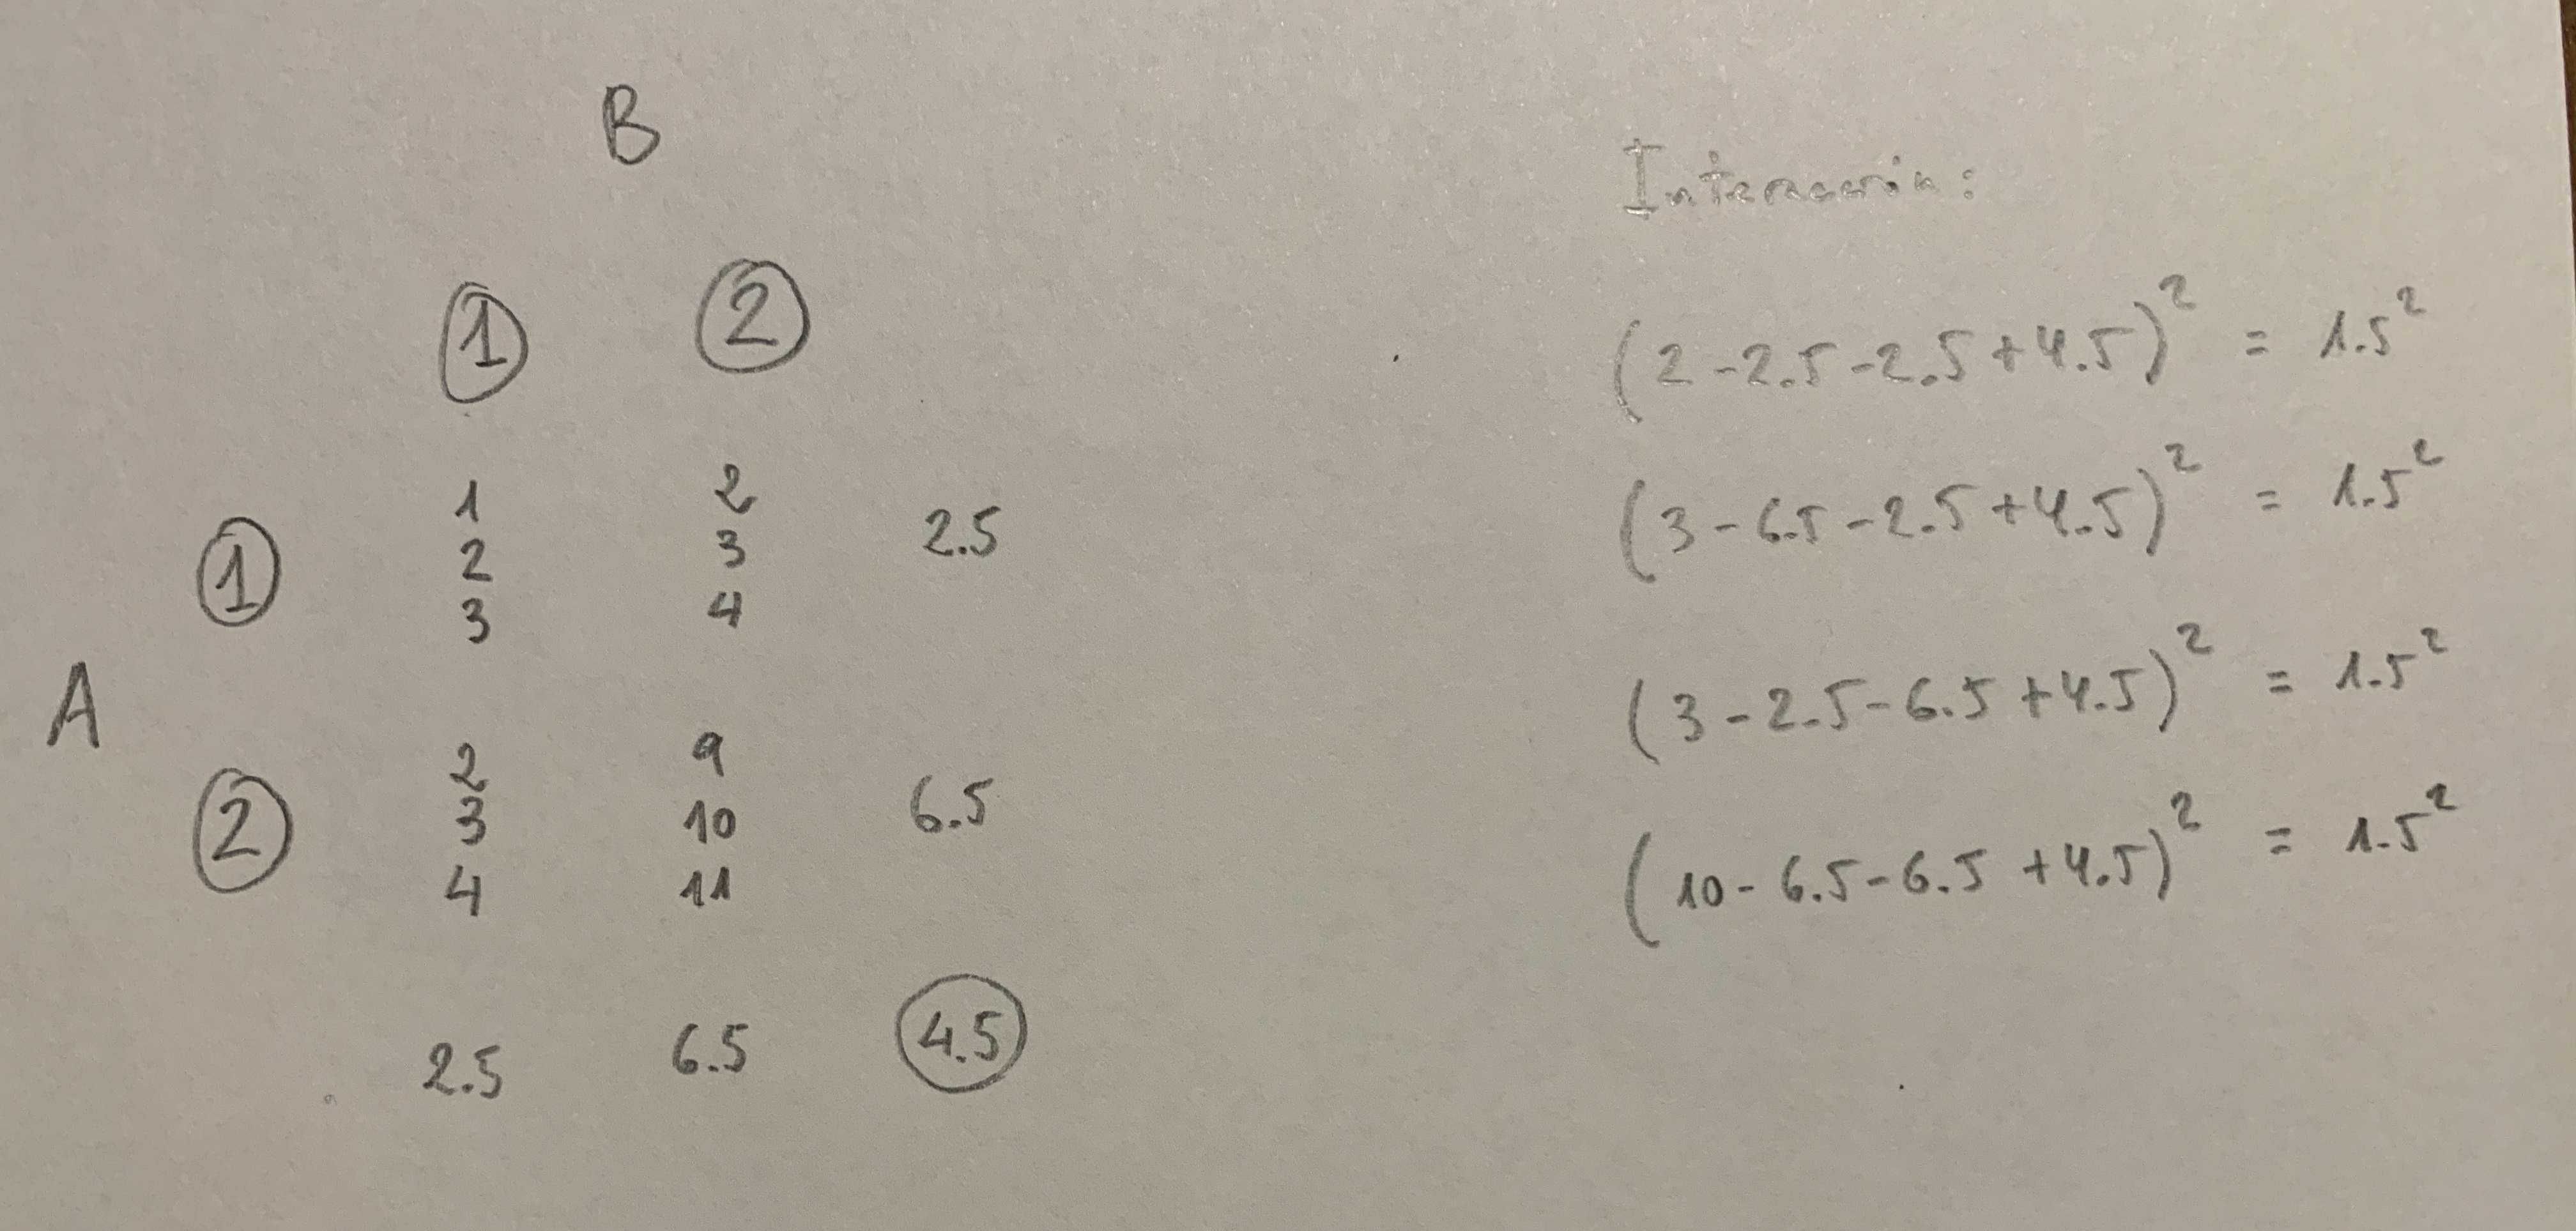
Veamos en una imagen las tres situaciones en las que nos podemos encontrar en un ANOVA de dos factores cruzados:
Comparemos los tres modelos con su parametrización, tabla ANOVA, esperanzas de los cuadrados medios, contrastes de hipótesis:

Es importante ver los elementos comunes y los elementos distintos en los tres modelos. El siguiente vídeo explica estos elementos:
Supongamos un experimento en el que tenemos un único factor y muchos niveles. Decidimos coger una muestra de niveles y en cada uno de esos niveles elegidos tomamos una muestra. Por ejemplo, queremos ver si la contaminación en diferentes cincuenta ríos de España es diferente significativamente. Otro ejemplo, queremos ver, en una empresa donde trabajan cien empleador elaborando un producto, si hay diferencia entre ellos.
Supongamos que cogemos una muestra de tres niveles y los valores obtenidos son los siguientes:
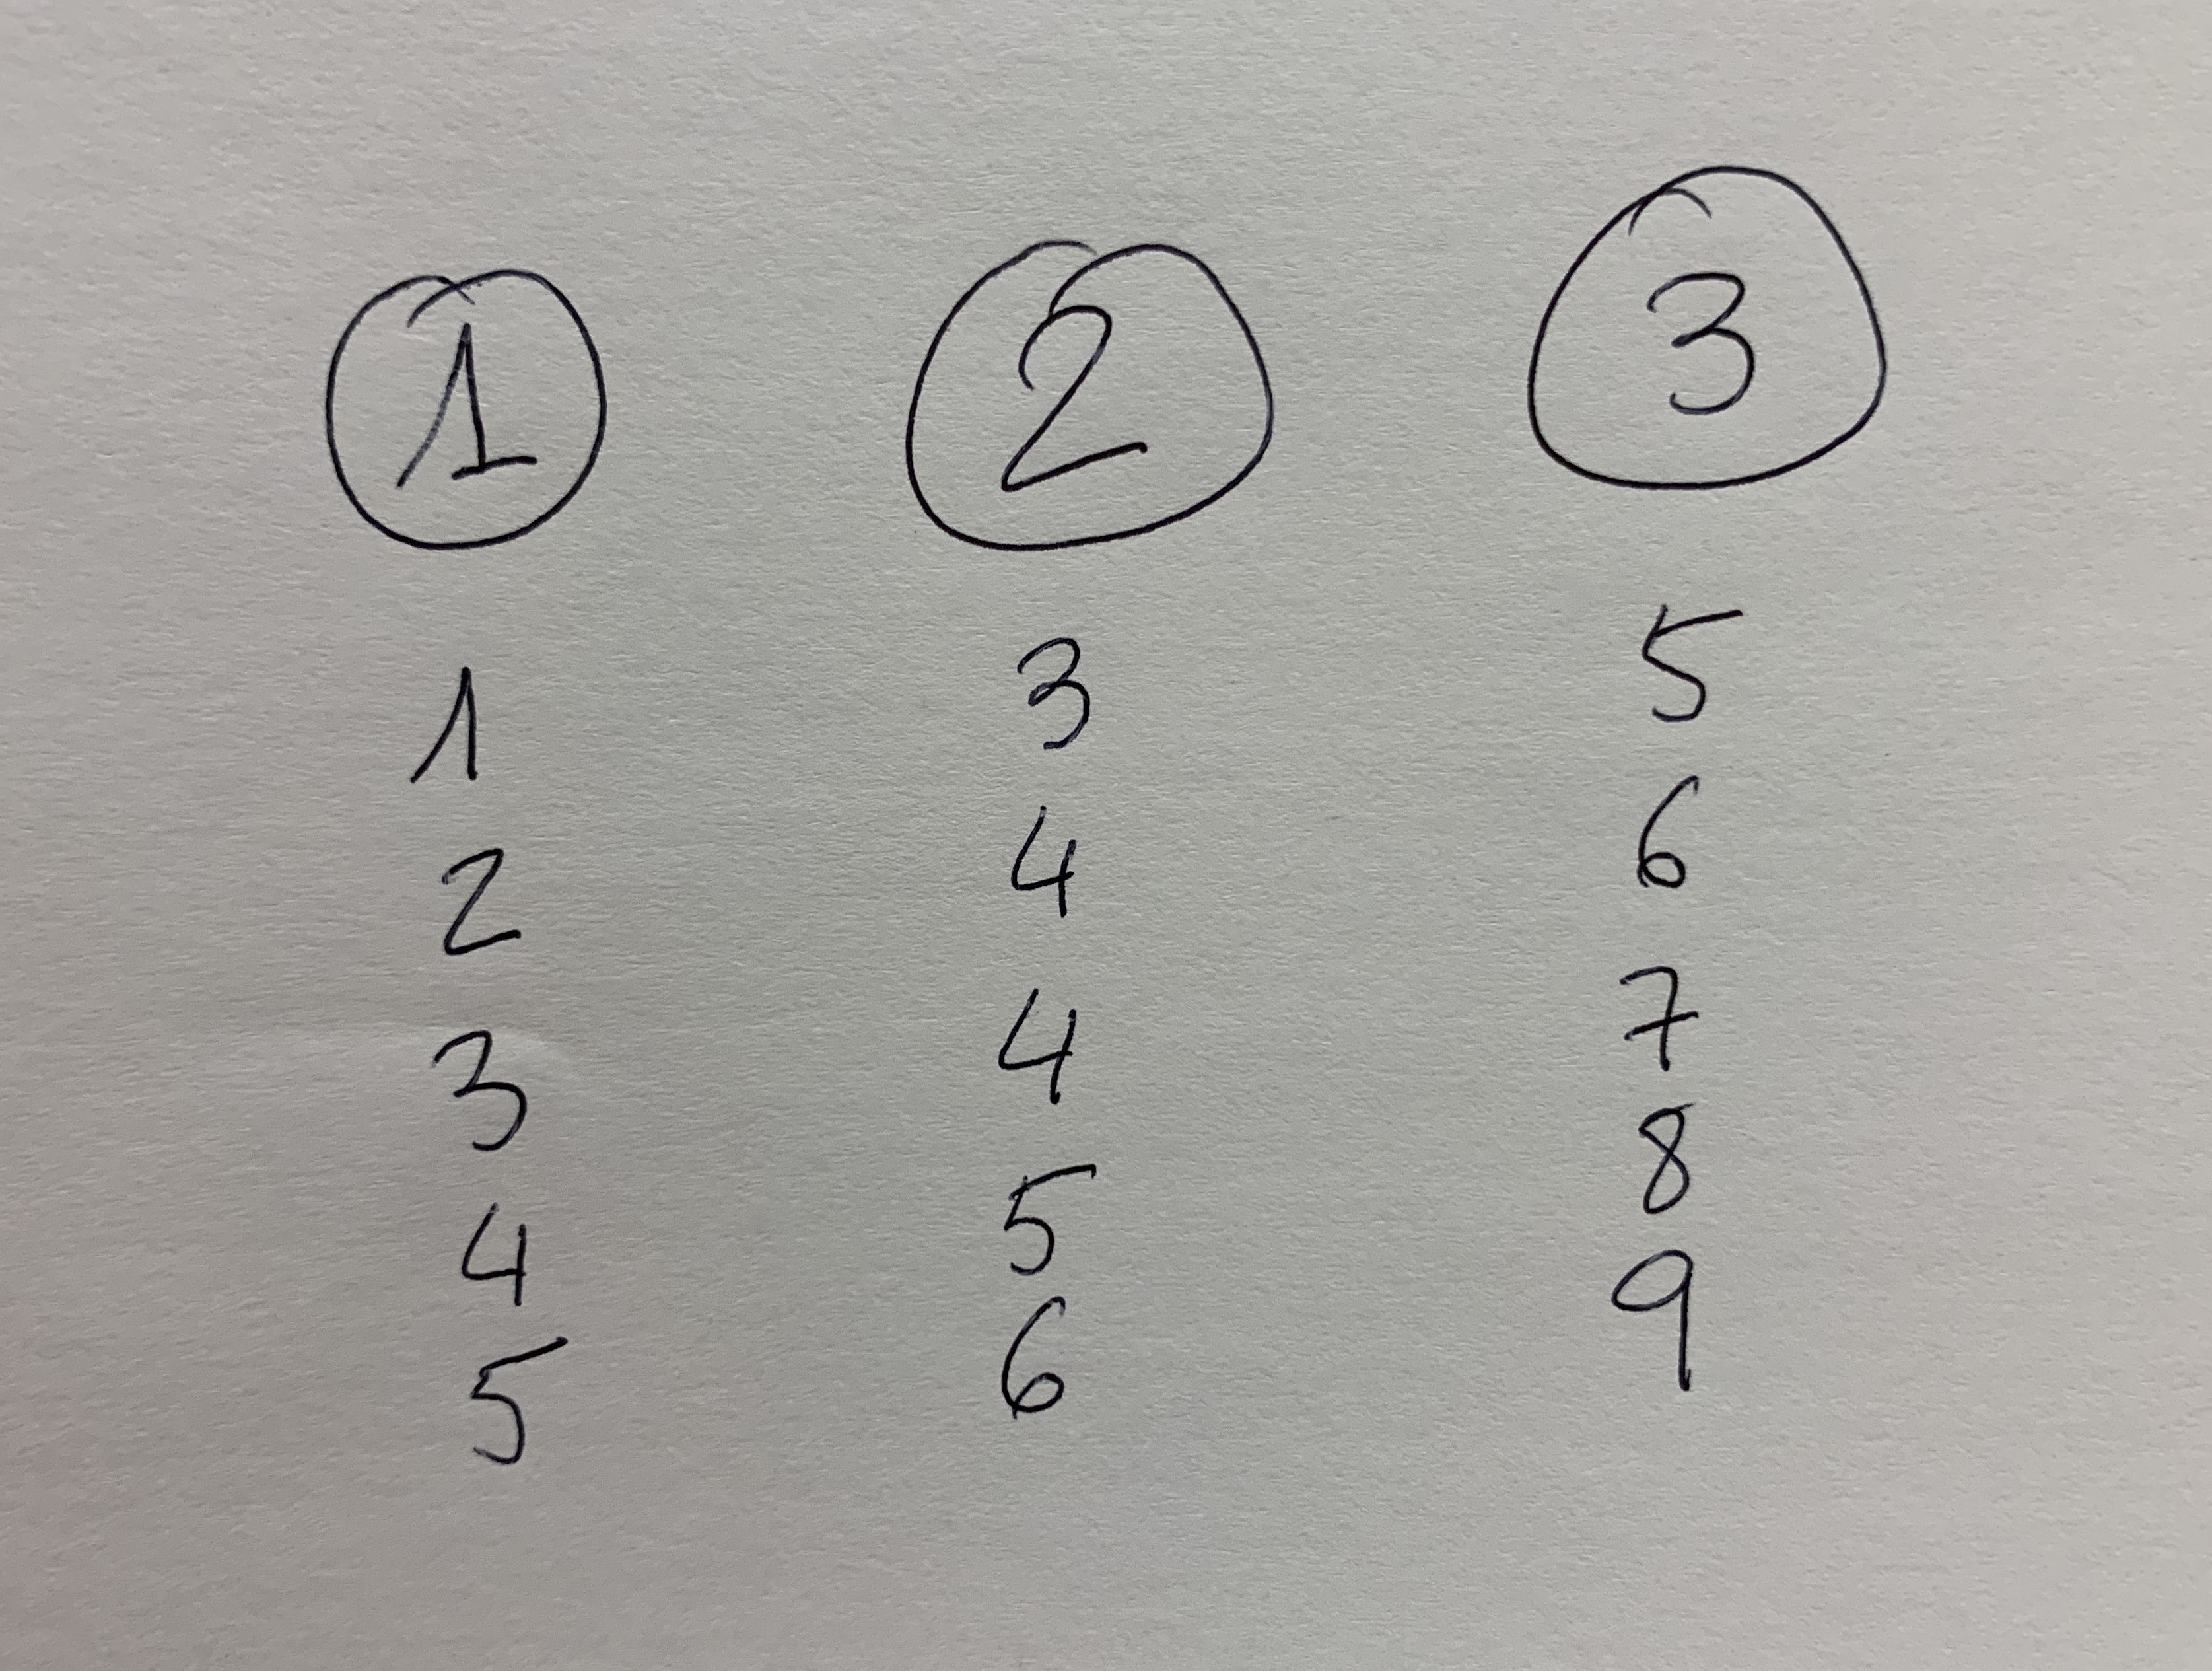
Si aplicamos un modelo de ANOVA de un factor a efectos aleatorios la tabla ANOVA y las componentes de la varianza son:
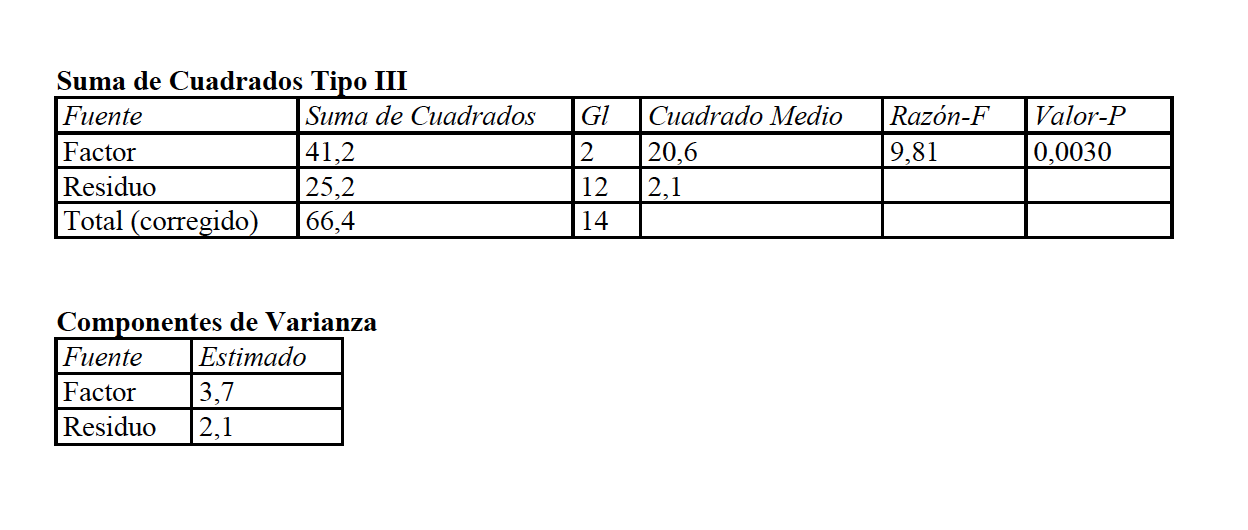
Hay diferencias estadísticamente significativas. El p-valor es 0.003. Aquí no tiene sentido aplicar unas comparaciones múltiples porque no son esos tres niveles los que nos interesan, sino toda la población de niveles (los cincuenta ríos en el primer estudio y los cien trabajadores en el segundo). Por eso evaluamos la componente de la varianza de nuestro factor, que es 3,7. Este valor sale del siguiente cálculo:
El estadístico Cuadrado Medio del factor tiene un promedio, como variable que es. Es la denominada Esperanza del cuadrado medio. Esto lo veremos con más detalle en modelos más complejos. A partir de este valor promedio construimos una estimación de la componente de la varianza de nuestro factor aletorio:
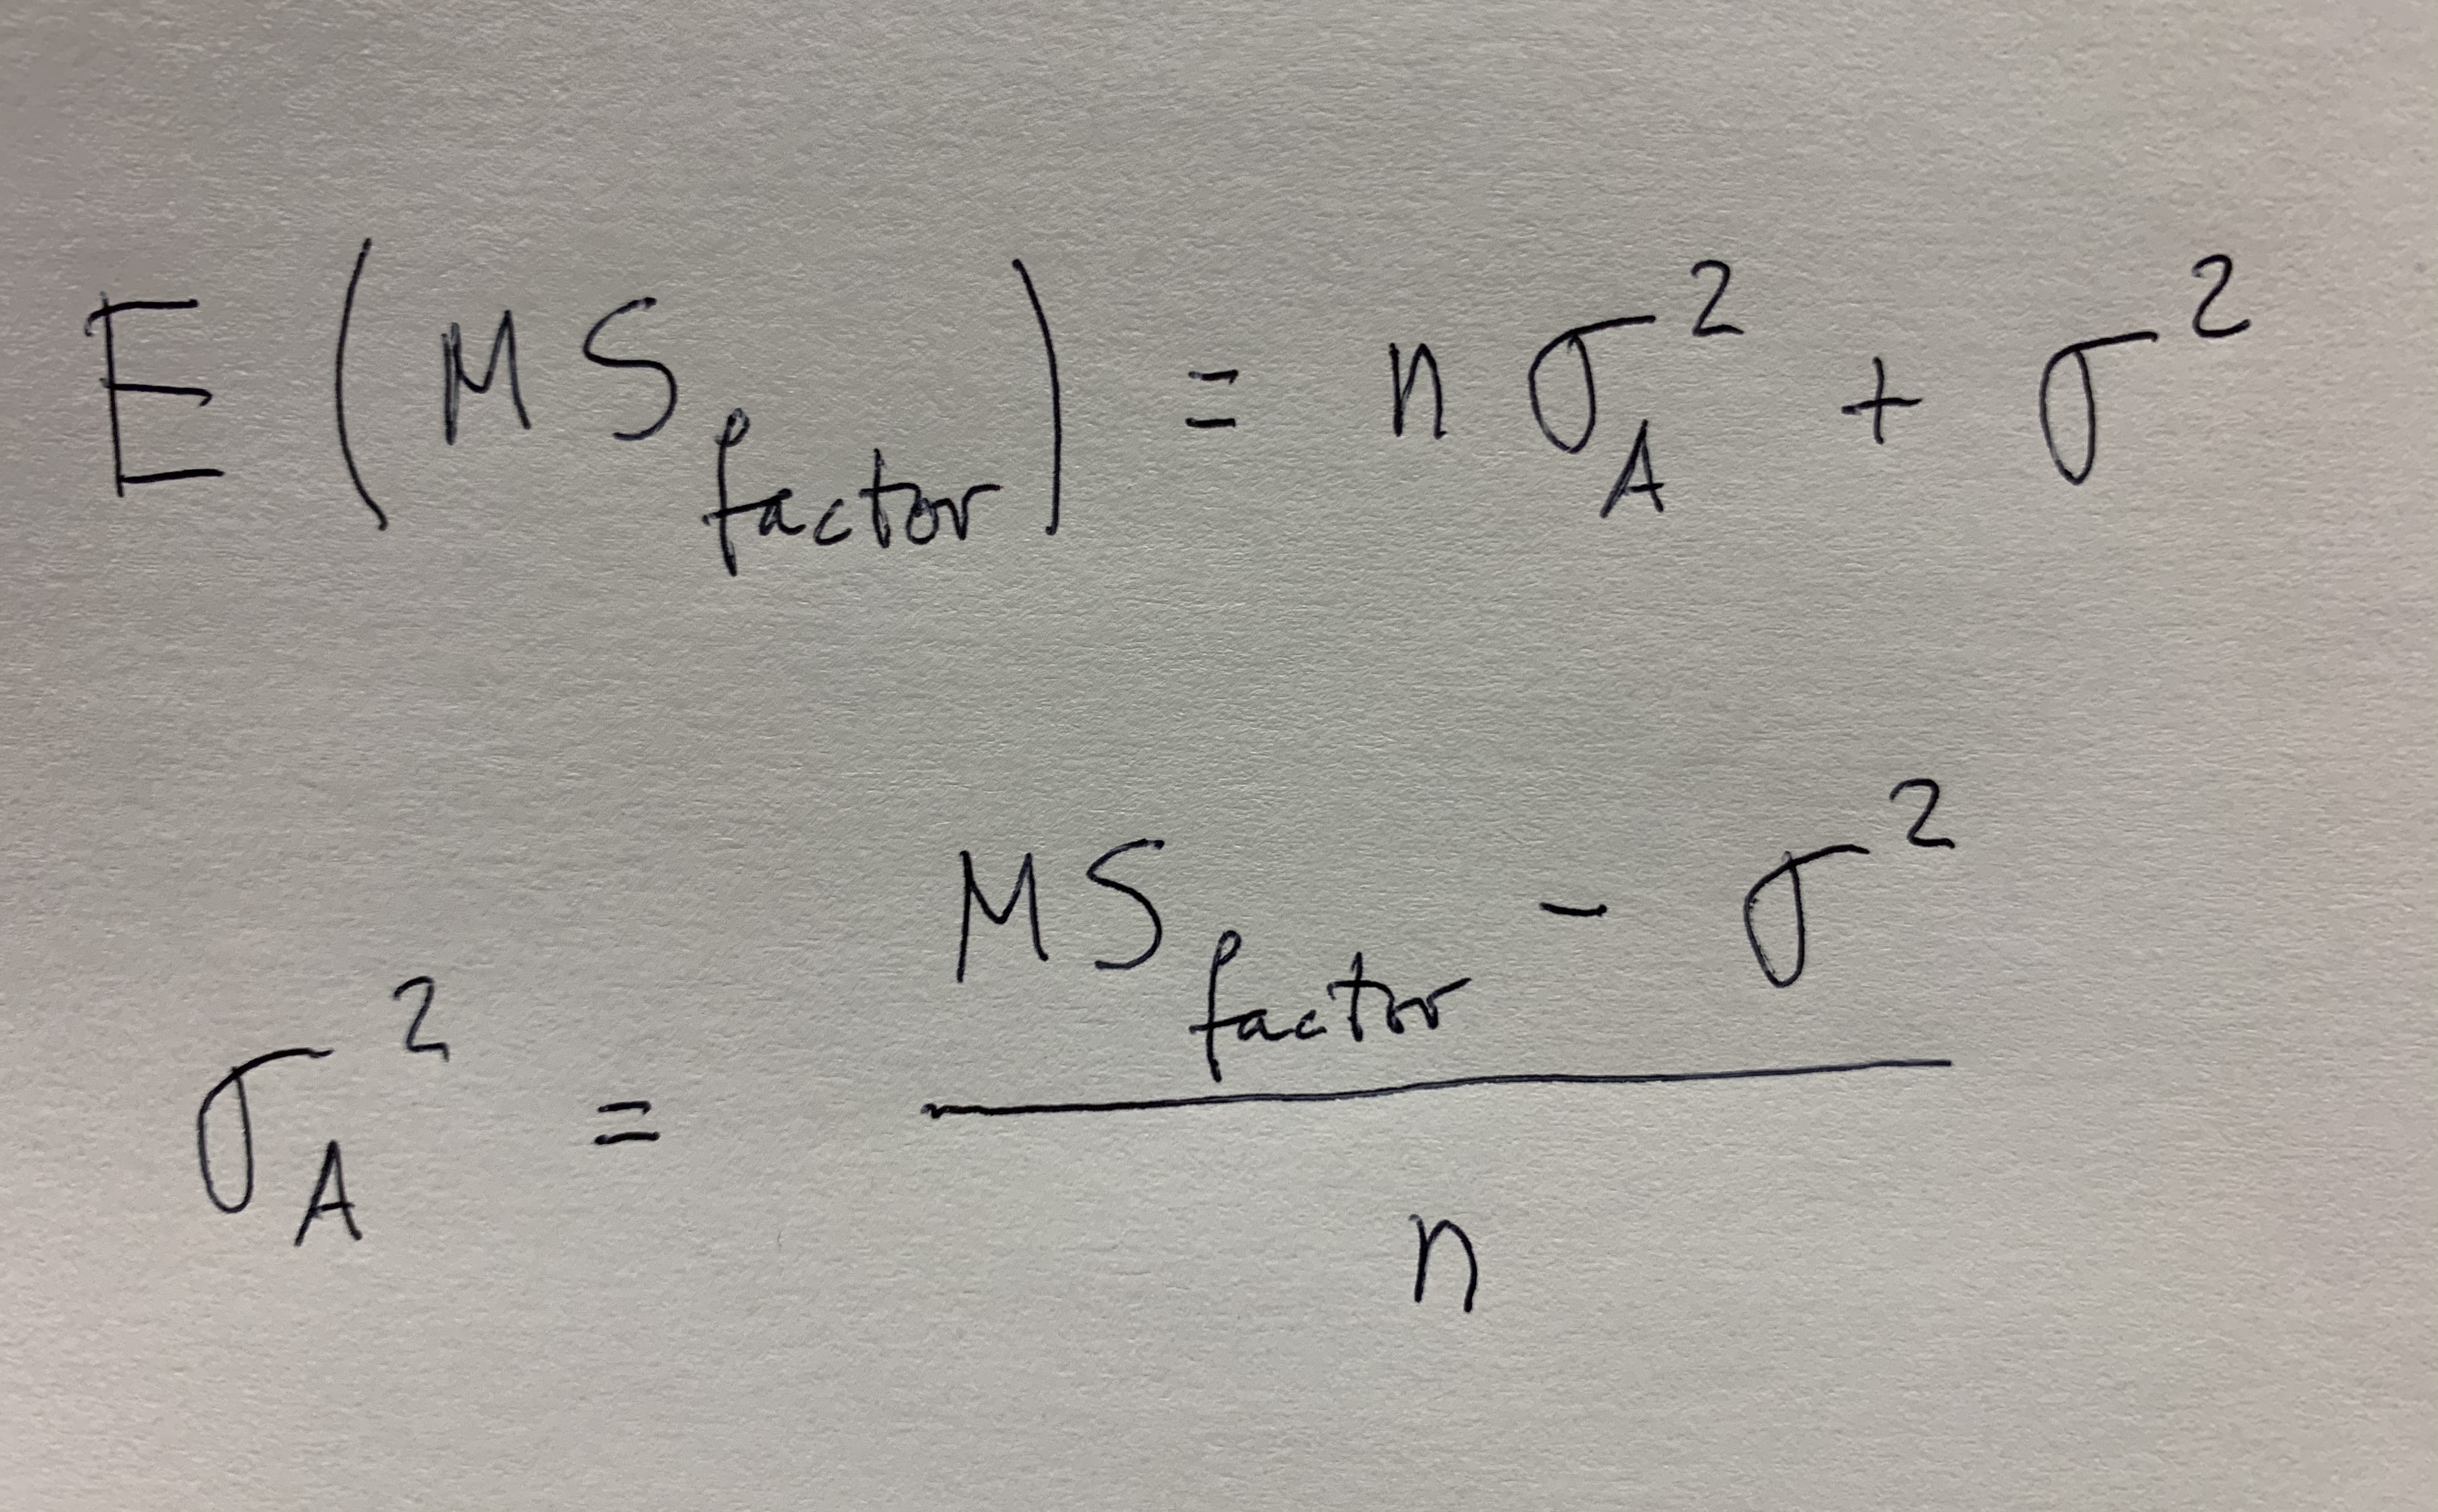
Observemos que el valor de 3.7 para la componente de la varianza se obtiene de restar 20.6 y 2.1 y dividir luego por 5, que es el tamaño de cada muestra.
Todo modelo tiene siempre una componente de la varianza, que es la residual. Que se puede obtener del valor de Cuadrado medio residual, como se puede ver en la Tabla ANOVA.
El Análisis de la varianza (ANOVA) es una familia de técnicas estadísticas de comparación. El objetivo de esas técnicas es decidir si hay igualdad o diferencia entre poblaciones a partir del análisis de muestras de esas poblaciones.
Nos podemos encontrar con cosas como las siguientes. Veremos a continuación tres situaciones distintas donde se están comparando, en cada una de ellas, tres muestras de tres poblaciones. Si observamos un poco atentamente nos encontraremos con situaciones bien distintas que llevan a intuiciones muy distintas acerca de cómo deben ser las poblaciones que hay detrás de esas muestras:

En el primer caso parece claro que la muestra tres presenta valores superiores y la muestra segunda valores inferiores.
En el segundo caso parece que estas tres muestras se solapan mucho. Lo que hace pensar que, con la información que tenemos, no podemos decir con fiabilidad que las poblaciones que hay detrás son distintas.
En el tercer caso parece que la muestra tres tiene valores superiores y, sin embargo, la uno y la dos son muy similares.
De esto va el ANOVA, de tomar decisiones sobre situaciones de este tipo.
El problema es que a la hora de tomar esa decisión debemos analizar siempre, como veremos, tres dimensiones fundamentales. Tres dimensiones que se solapan, que se entremezclan. Son las siguientes: las distancias entre las medias de esas muestras, las dispersiones internas de cada muestra y el tamaño de muestra.
Veamos esas tres dimensiones individualmente.
Primero: La posición relativa de esas medias. Miremos estas tres distintas situaciones, donde representamos los valores de las muestras con una cruz en la posición que ocupan en la recta numérica:

Cuanto más alejados estén los valores medios (señalados con una línea perpendicular a la recta de números) de las muestras a comparar más posibilidades tenemos de que podamos decir que hay diferencias entre las poblaciones.
En el primer caso vemos que la muestra roja y azul están muy solapadas y la verde se aleja considerablemente. En el segundo caso hay un grado de solapamiento muy grande, las medias están muy cerca. En el tercer caso hay una clara distancia entre medias.
Pero observemos que en estos tres casos, a la hora de evaluar las distancias entre las medias vemos inevitablemente cuál es el grado de solapamiento de las muestras de las poblaciones que comparamos. Esto nos lleva a la segunda dimensión:

Vemos en estos dos casos que las distancias entre las medias de estas tres muestras son las mismas en el primer estudio y en el segundo pero, sin embargo, lo que podamos decir de las poblaciones que hay detrás, es completamente distinto. En el primero no podemos decir que hay diferencias, en el segundo parece fiable que podemos decir que hay diferencias.
La dispersión de los valores es, pues, esencial a la hora de evaluar las diferencias.
Y, como tercera dimensión, en ANOVA, tenemos el tamaño de muestra:

De nuevo en estos dos casos las distancias entre medias son las mismas, el grado de solapamiento equivalente. Lo que es distinto es claramente el tamaño de muestra. Cuanto más tamaño de muestra tengamos más fiables son las distancias muestrales que estemos viendo.
En un caso concreto, cualquiera de las técnicas ANOVA debe evaluar esas tres dimensiones (distancia entre medias, dispersión interna de las muestras y tamaño de muestra) para poder tomar una decisión sobre si las poblaciones son iguales o son distintas.
Veamos un caso concreto:

Aquí tenemos cinco muestras, con un tamaño muestral determinado, unas dispersiones determinadas, unas distancias entre medias. Aquí parece que habrá diferencias y que habra como tres grupos de poblaciones: la roja y la azul por un lado, la verde y marrón por otro y la de color granate, a la derecha, como tercer grupo.
El el Herbario de técnicas de este blog tenemos diferentes modelos ANOVA. Todos ellos muestran su parametrización. Vamos a ver aquí el concepto de parametrización. Veamos el ejemplo más sencillo: ANOVA de un factor a efectos fijos:

Un valor cualquiera de un experimento lo podemos descomponer en tres. En los modelos ANOVA más complejos esta descomposición se hará en muchos más elementos.
Veamos por qué se hace esto y qué representa. Se hace para ver diferentes fuentes de variación y así poder realizar los contrastes de hipótesis oportunos. Qué representa. Veamos el siguiente caso: Un experimento con un factor a tres niveles con tres valores muestrales en cada nivel:
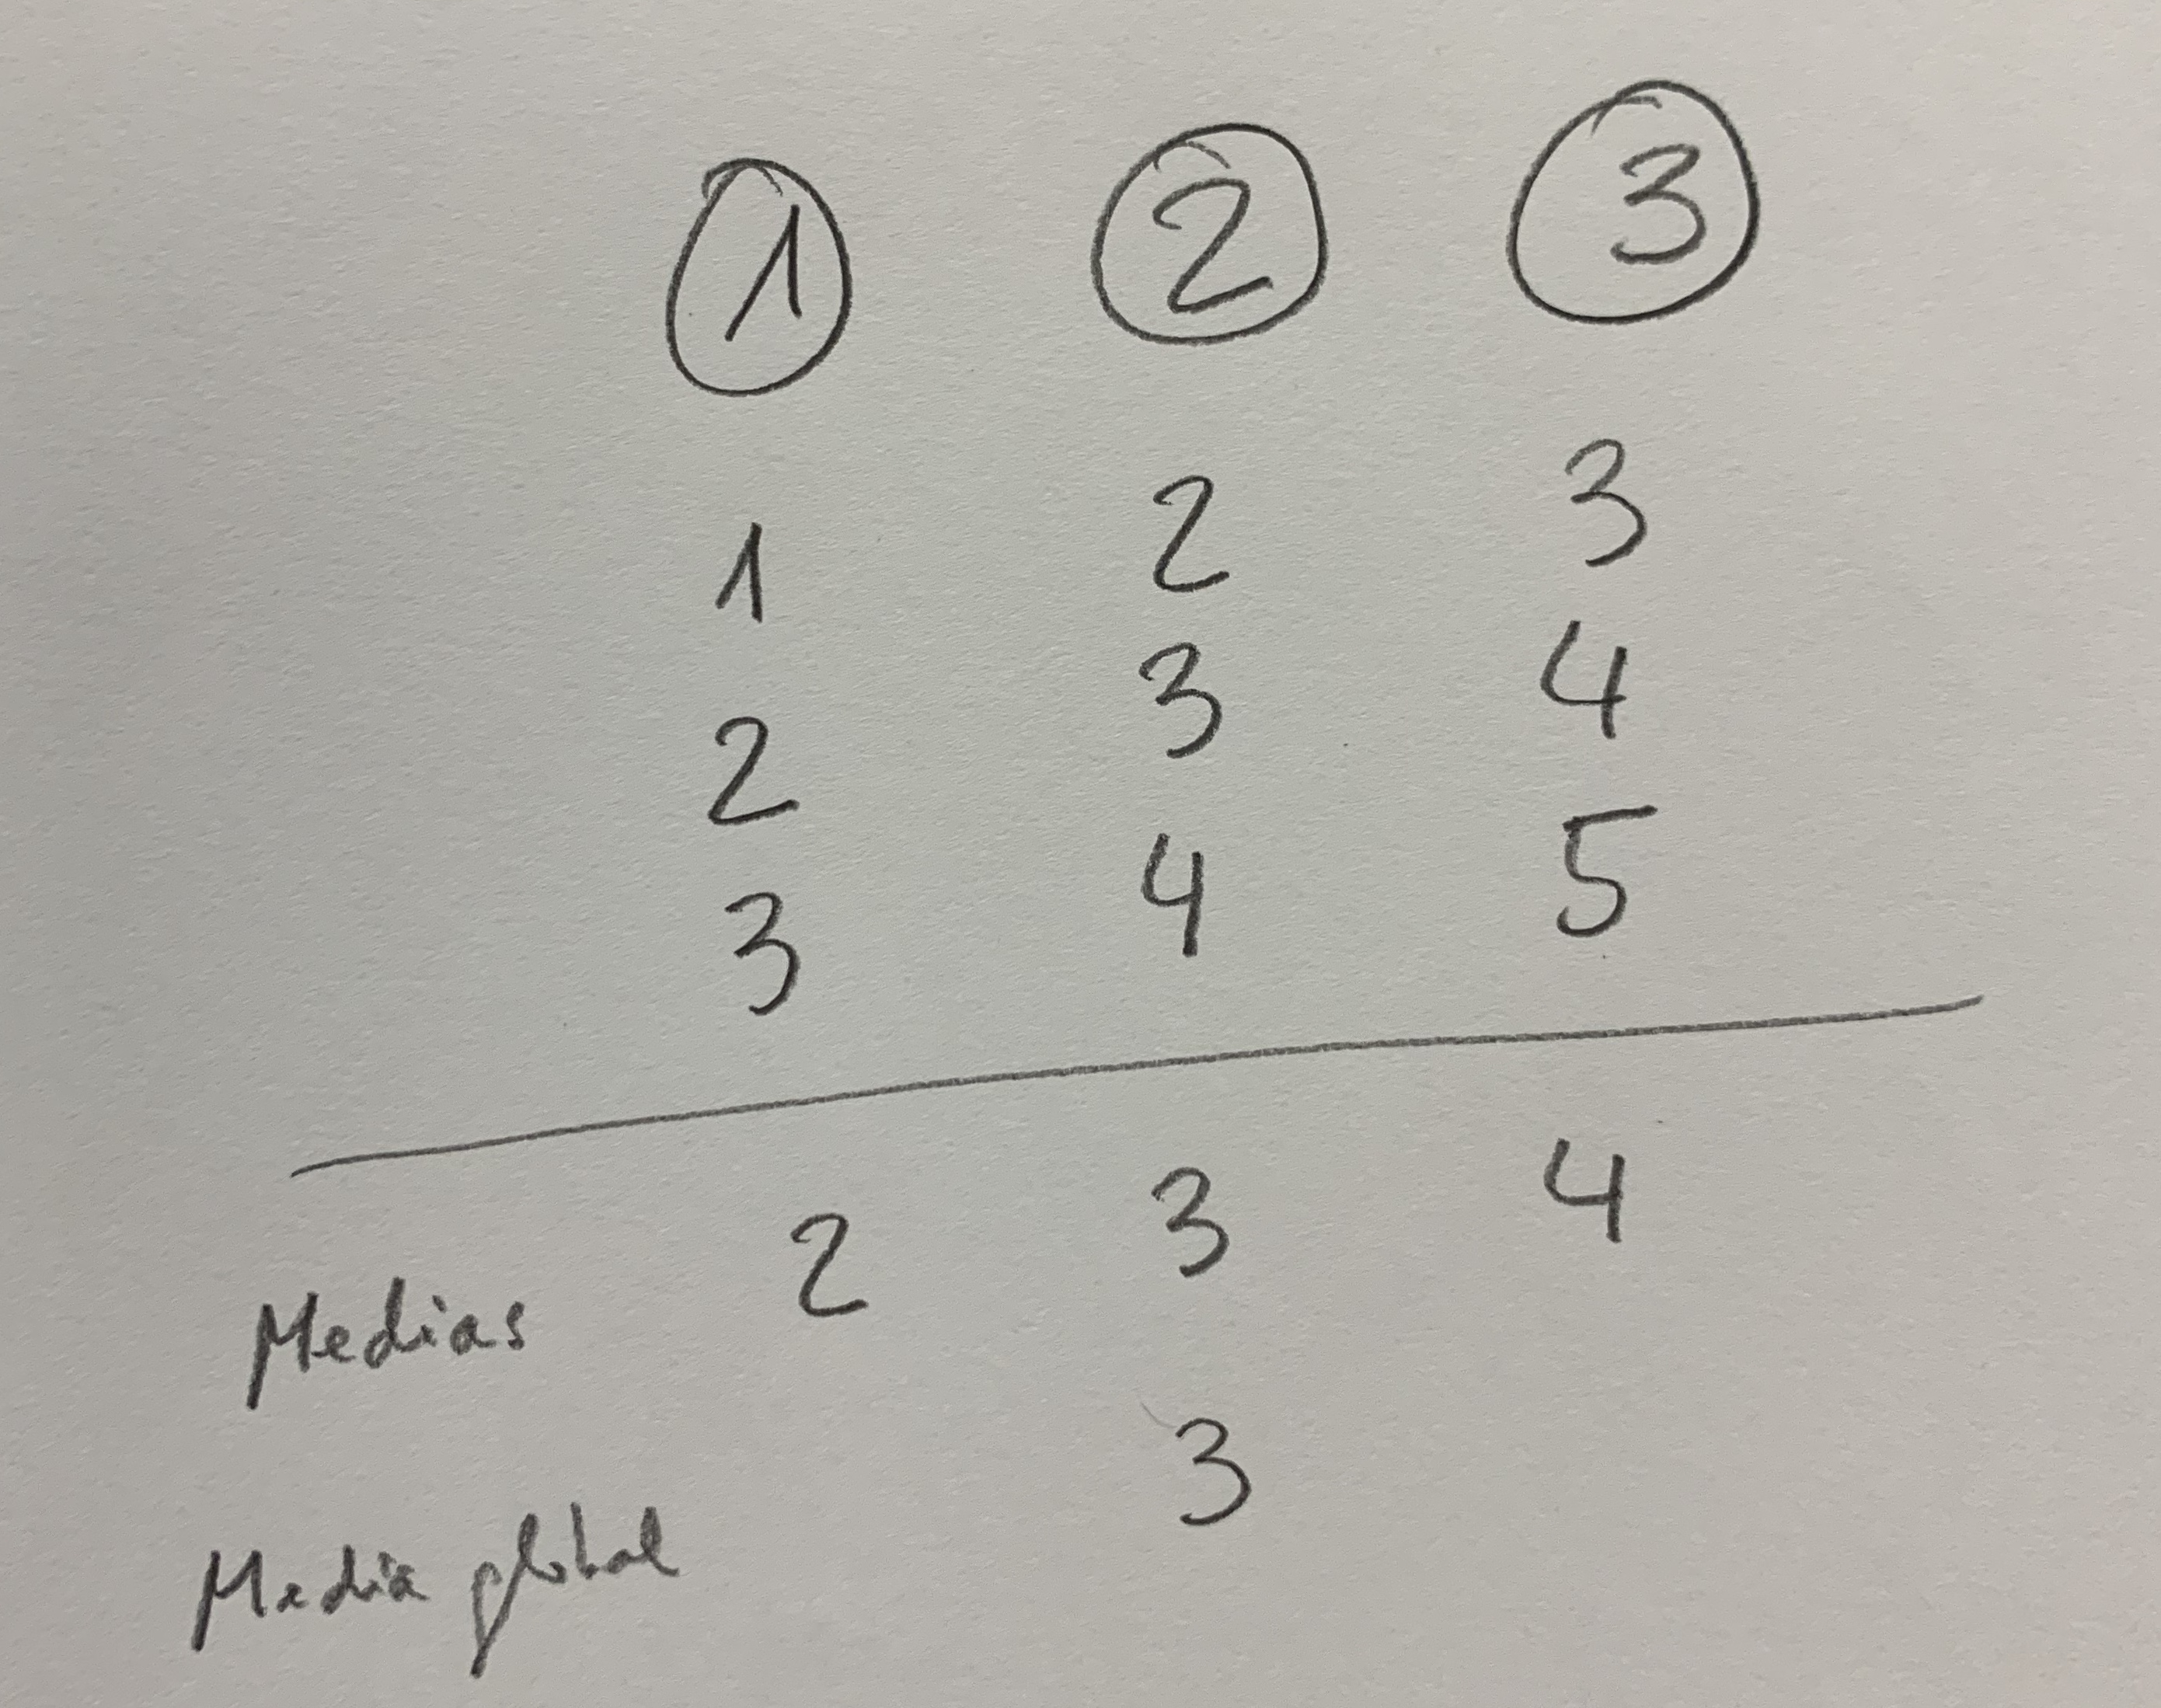
La media global es 3 y la media de cada uno de los tres niveles es: 2, 3, y 4, respectivamente.
Vamos a ver cómo hacemos la descomposición:
Primer paso:
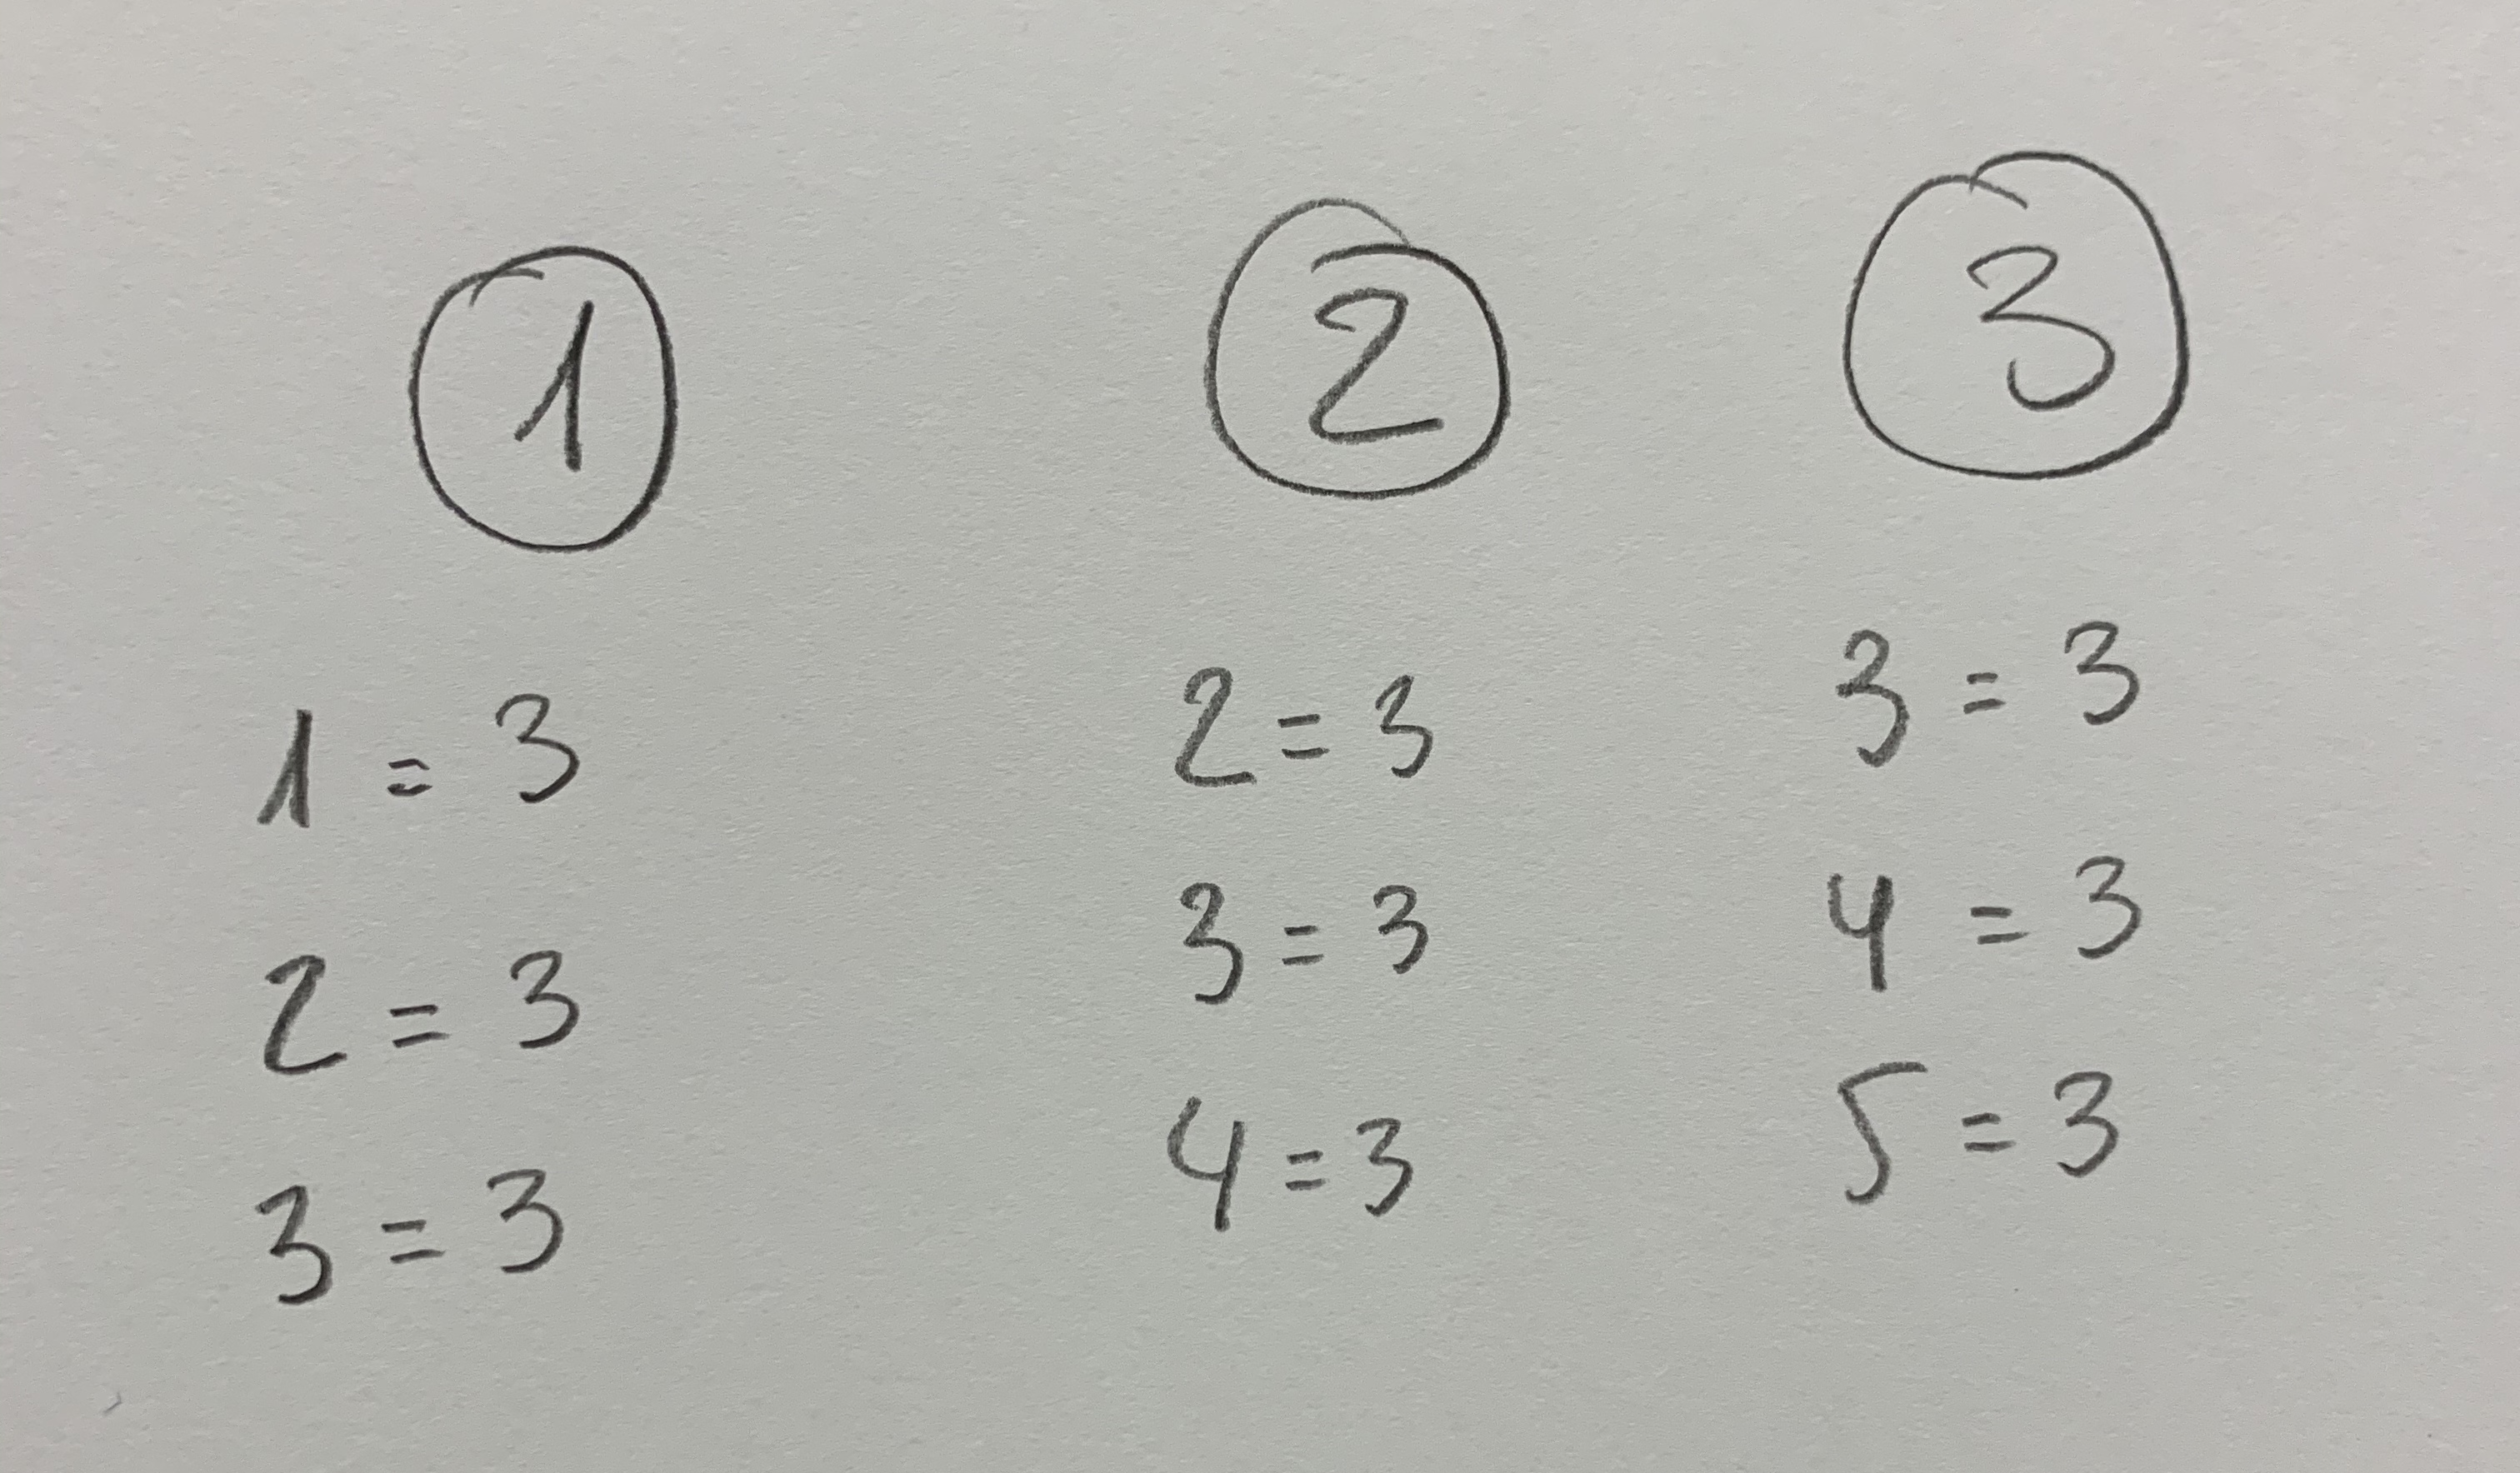
Hemos expresado cada uno de los nueve valores muestrales como iguales a la media global, que es la letra griega mu de la parametrización. Pero con esto no tenemos una verdadera igualdad.
Segundo paso:
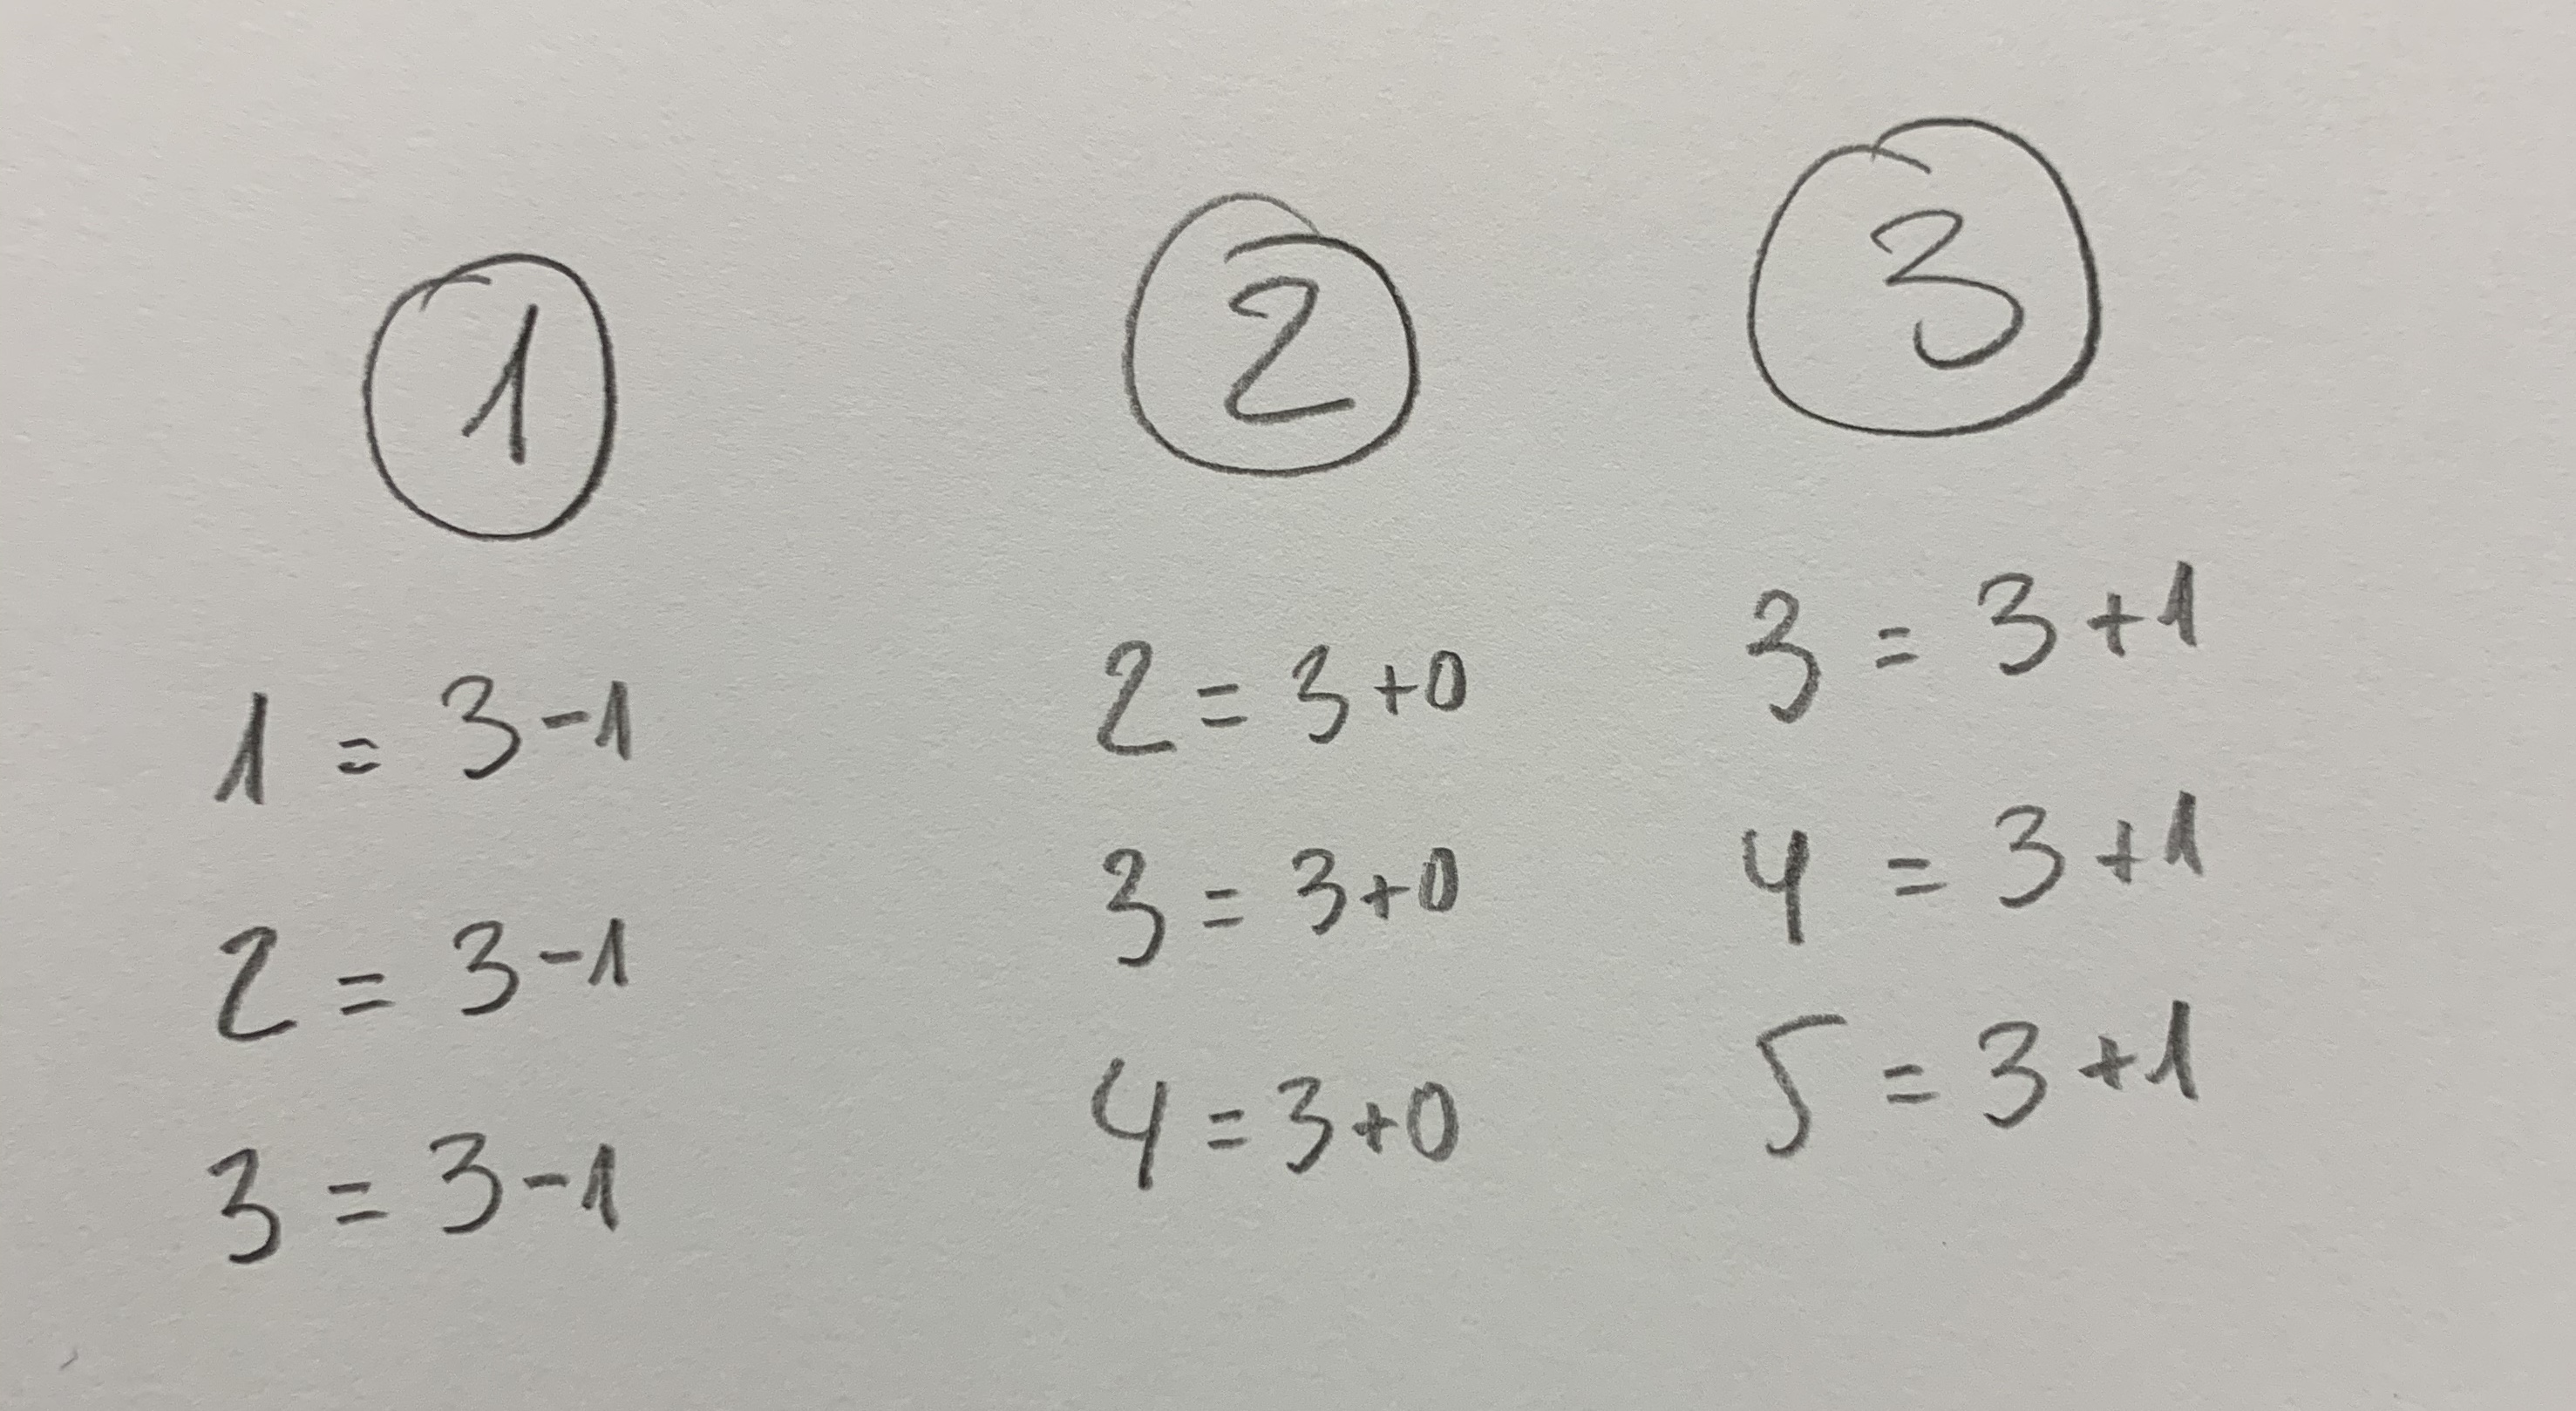
Hemos añadido para cada valor un valor característica del grupo, de aquella muestra a la que pertenece. Que es la alfa de la parametrización. Pero las alfas son diferentes según el grupo. La alfa es de hecho la diferencia de la media del grupo respecto a la media global. Es, pues, un valor de alejamiento promedio de los diferentes miembros de aquel grupo, de aquella muestra, respecto del valor promedio global. En este casos son: -1, 0 y 1. Pero veamos que todavía no tenemos igualdades ciertas.
Tercer paso:

Ahora hemos añadido el elemento que falta para satisfacer la igualdad. Con ello aportamos un valor individual. Es la épsilon del modelo.
En nuestro caso estas épsilons, estos valores individuales son siempre valores repetidos, pero porque se trata de un ejemplo artificial hecho con mucha simetría de valores para que se pueda entender bien pero en general estos valores individuales serán números distintos para cada caso.
Este es el sentido de la parametrización. Descomponer cada valor muestral de nuestro estudios en distintos valores. De esta forma conseguimos crear distintas fuentes de variación que serán claves a la hora de realizar los contrastes de hipótesis; o sea, a la hora de evaluar efectos, a la hora de tomar decisiones en ANOVA.
 LA MATEMÁTICA Y LA ESTADÍSTICA: UNA ORQUESTA HECHA INSTRUMENTO
