Archivo del Autor: estadisticallopis

Test de Wald

El Test de Wald es un contraste de hipótesis donde se trata de ver la coherencia de afirmar un valor concreto de un parámetro de un modelo probabilístico una vez tenemos ya un modelo previamente seleccionado y ajustado.

Se trata de un Test generalista, aplicable en muchos ámbitos. Esta es su característica principal.

Se aplica siempre tras elegir un modelo (una distribución cualquiera, una regresión simple, una regresión logística, etc) y a continuación se hace algún contraste de hipótesis sobre uno o varios parámetros: Por ejemplo, la media de la normal es 5, la pendiente de la recta es 0, el coeficiente principal de una regresión logística es 0, etc.

La fórmula del contraste es muy sencilla:

IMG_5500

En realidad, si se mira con detalle se observa que no deja de ser un valorar la distancia entre Observado y Esperado. Esta idea de distancia entre Observado y Esperado es nuclear en Estadística. Siempre en un contraste de hipótesis estamos valorando si lo que vemos es o no muy distante de lo que esperamos, en el caso de ser cierta la hipótesis nula.

Es un contraste que se usa mucho en la mayor parte de softwares.

Suele usarse especialmente para contrastar si es cero o no un determinado coeficiente que multiplica a una variable independiente en una regresión. Si el p-valor, como siempre, es menor que 0.05, se rechaza esa hipótesis nula que afirma que ese coeficiente es cero, y se entiende entonces que ese coeficiente no es cero y que, por lo tanto, el modelo es útil para representar una determinada relación. Si, por el contrario, el p-valor es mayor que 0.05 eso significa que el valor del coeficiente podría ser perfectamente cero y estar viendo lo que vemos, por lo tanto, esa variable no influye a la hora de determinar la variable dependiente (o también denominada, a veces, variable respuesta) del modelo de regresión.

Ejemplo de inferencia de dos muestras relacionadas

Se ha realizado un estudio para ver el efecto del ejercicio físico sobre el nivel de colesterol en sangre. Han participado 11 individuos en el estudio. Se analizó el nivel de colesterol de cada uno de ellos antes y después de ser sometidos, durante un tiempo, a un reglado proceso de ejercicios físicos.

Los datos obtenidos antes y después han sido los siguientes:

1 182 198

2 232 210

3 191 194

4 200 220

5 148 138

6 249 220

7 276 219

8 213 161

9 241 210

10 480 313

11 262 226

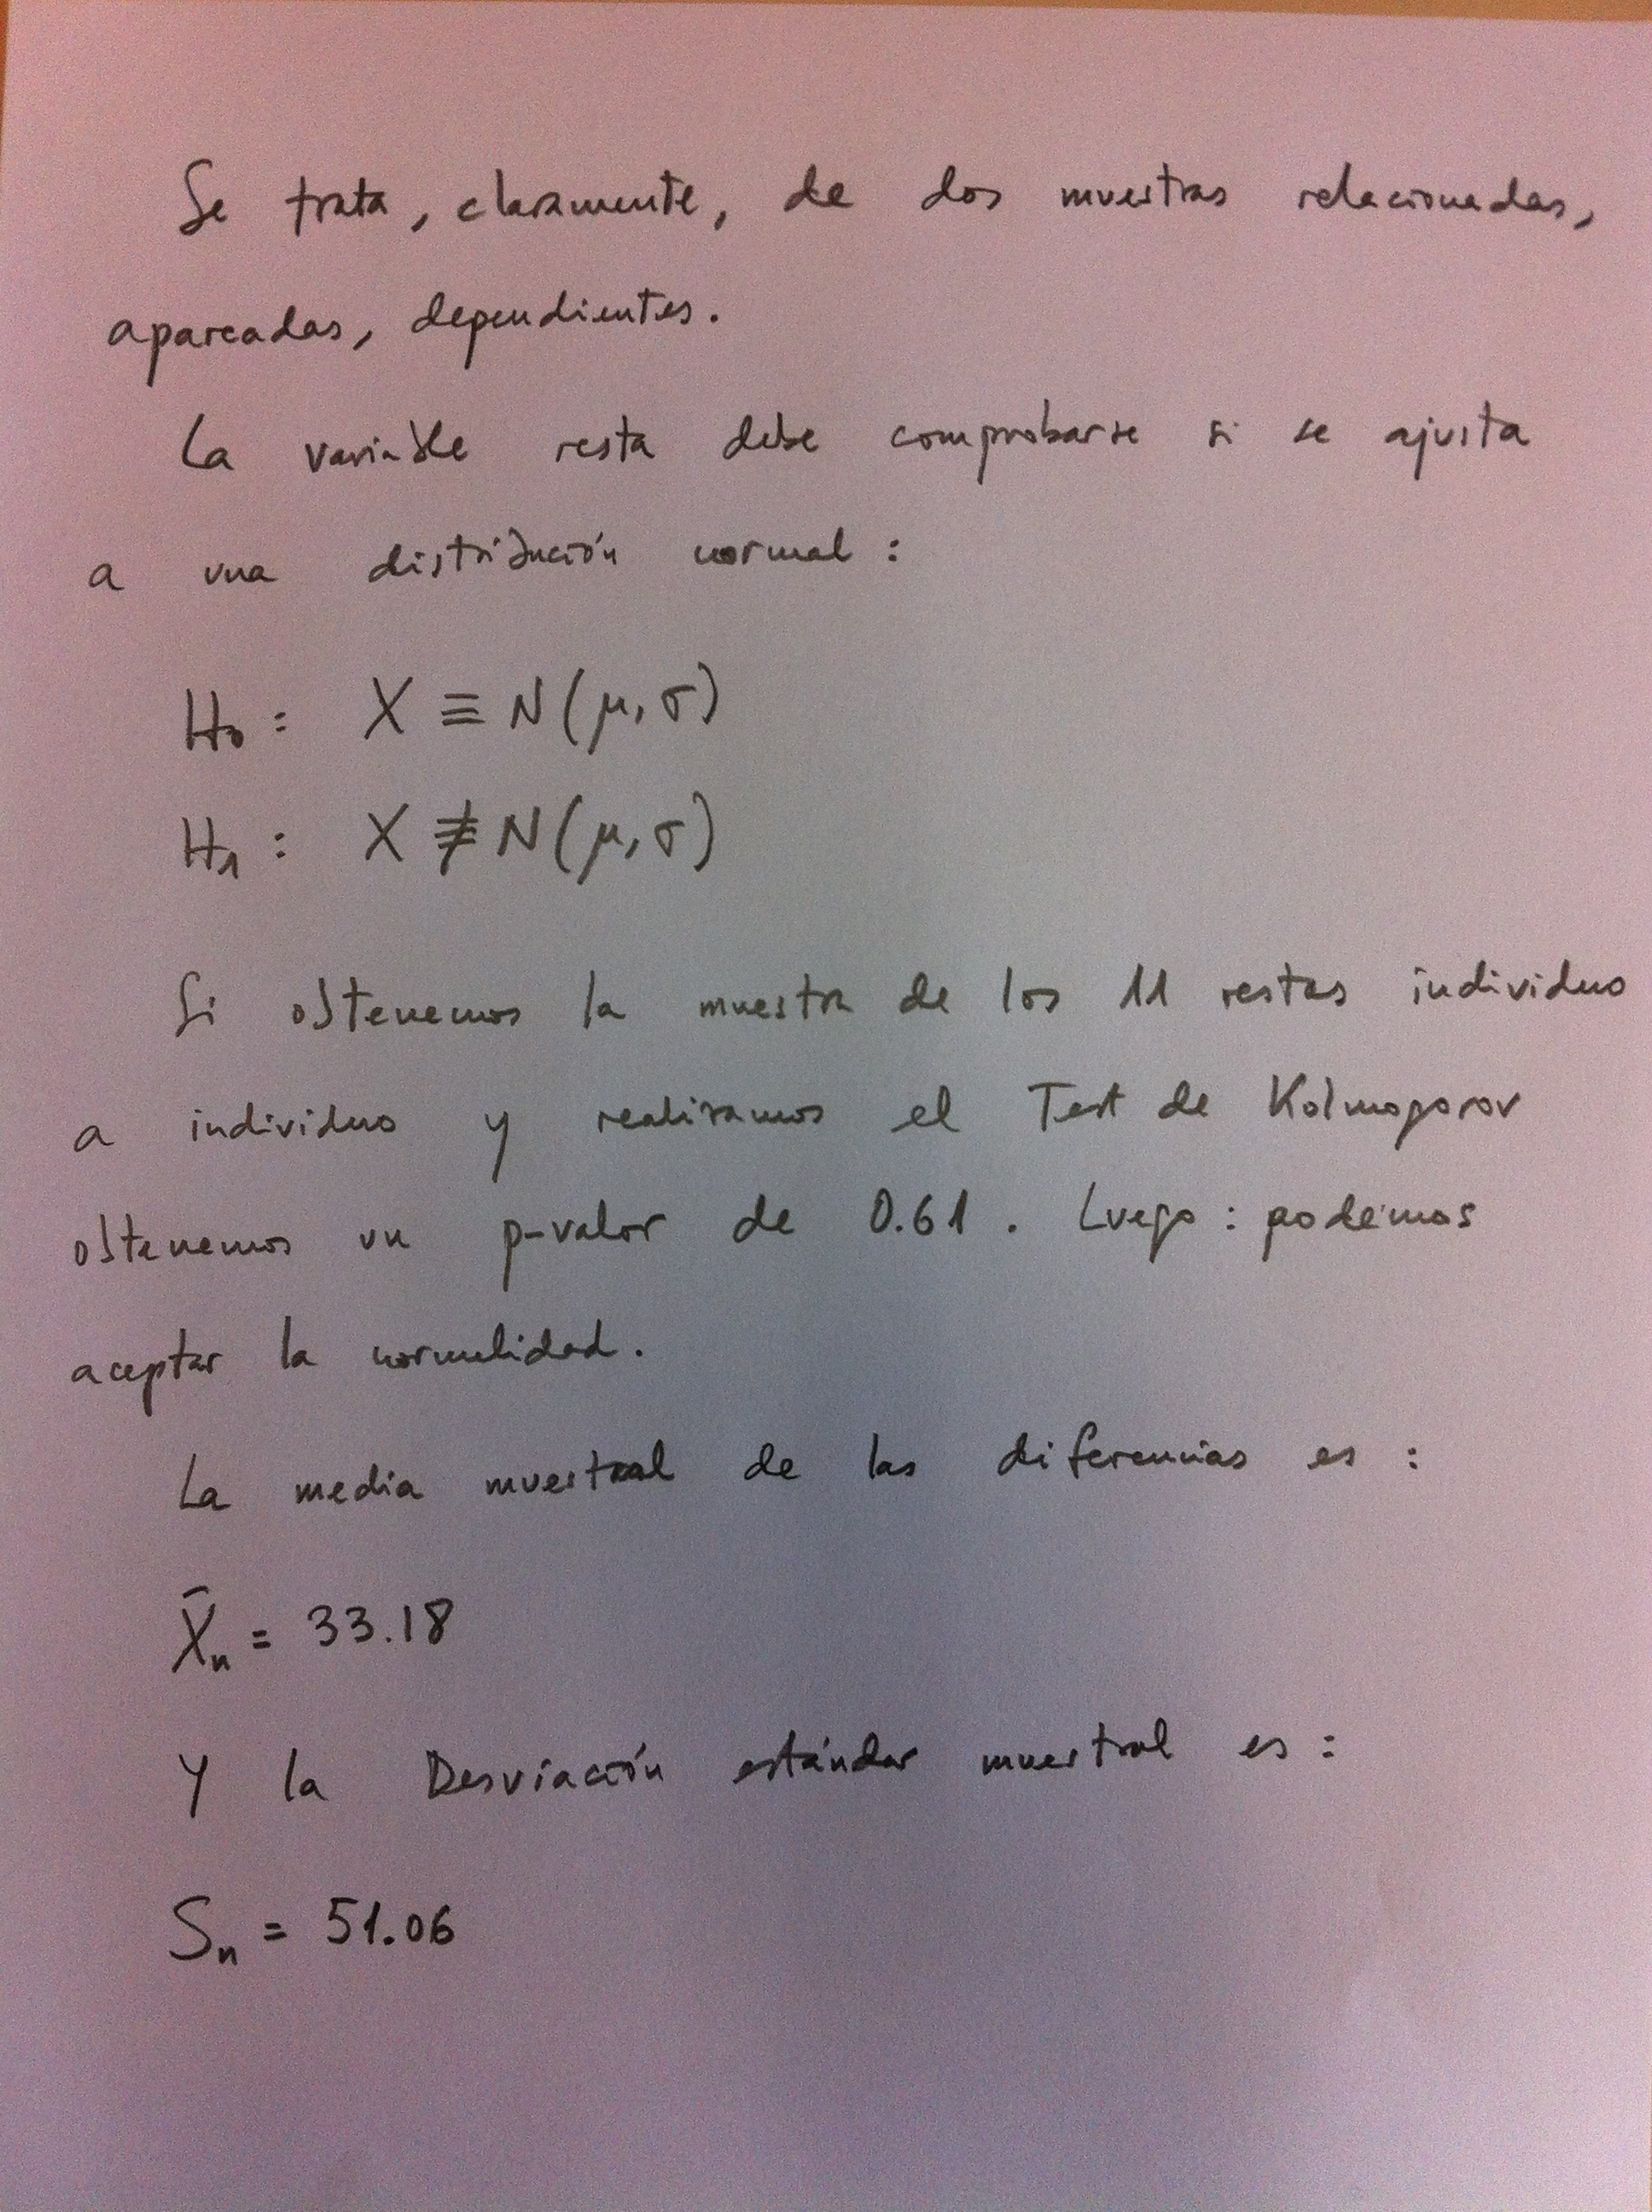
¿Podemos aceptar, con un nivel de significación del 5%, que el programa de ejercicios ha conseguido disminuir el nivel de colesterol?

Solución:

IMG_5439

IMG_5440

Ejemplo de inferencia en dos muestras independientes

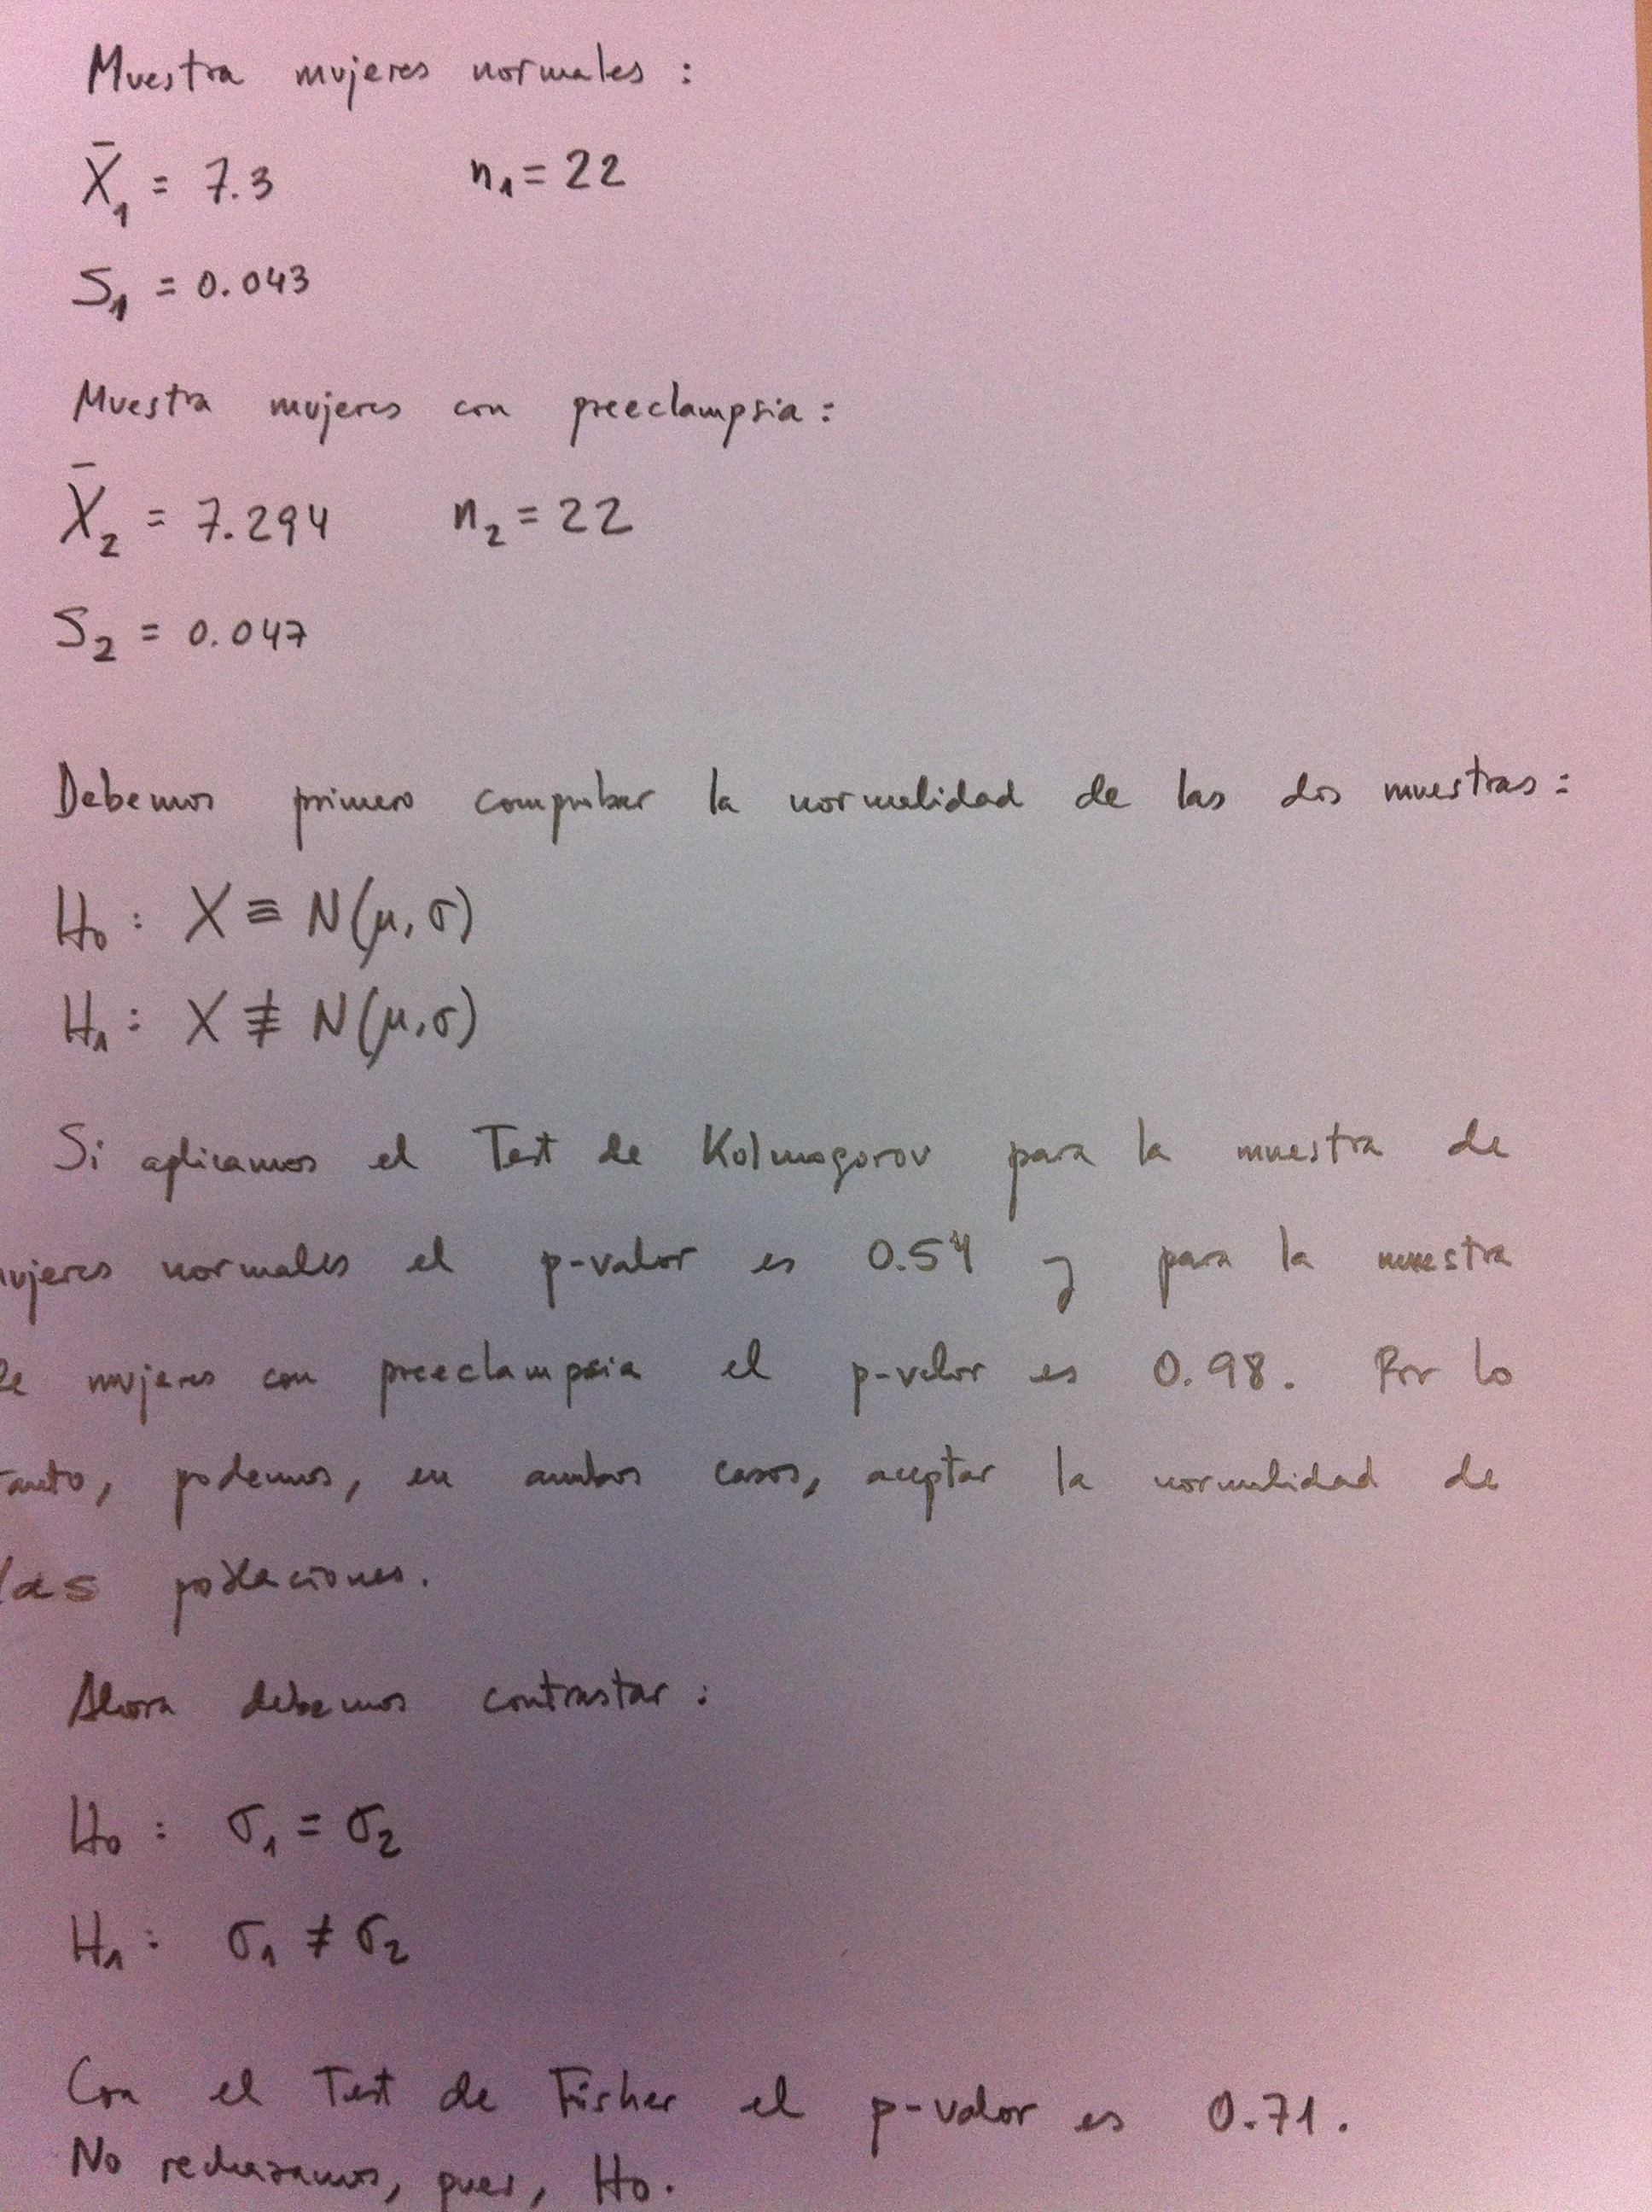
Se ha medido el pH del cordón umbilical de 22 recién nacidos de mujeres normales y de mujeres con preeclampsia, obteniéndose los siguientes valores:

Recién nacios de mujeres normales:

7.28 7.31 7.34 7.34 7.32 7.23 7.31 7.32 7.29 7.35 7.32 7.34 7.35 7.26 7.18 7.34 7.27 7.34 7.29 7.26 7.32 7.26

Recién nacidos de mujeres con preeclampsia:

7.26 7.27 7.27 7.35 7.29 7.28 7.31 7.29 7.34 7.21 7.39 7.28 7.30 7.24 7.20 7.28 7.30 7.35 7.31 7.32 7.37 7.26

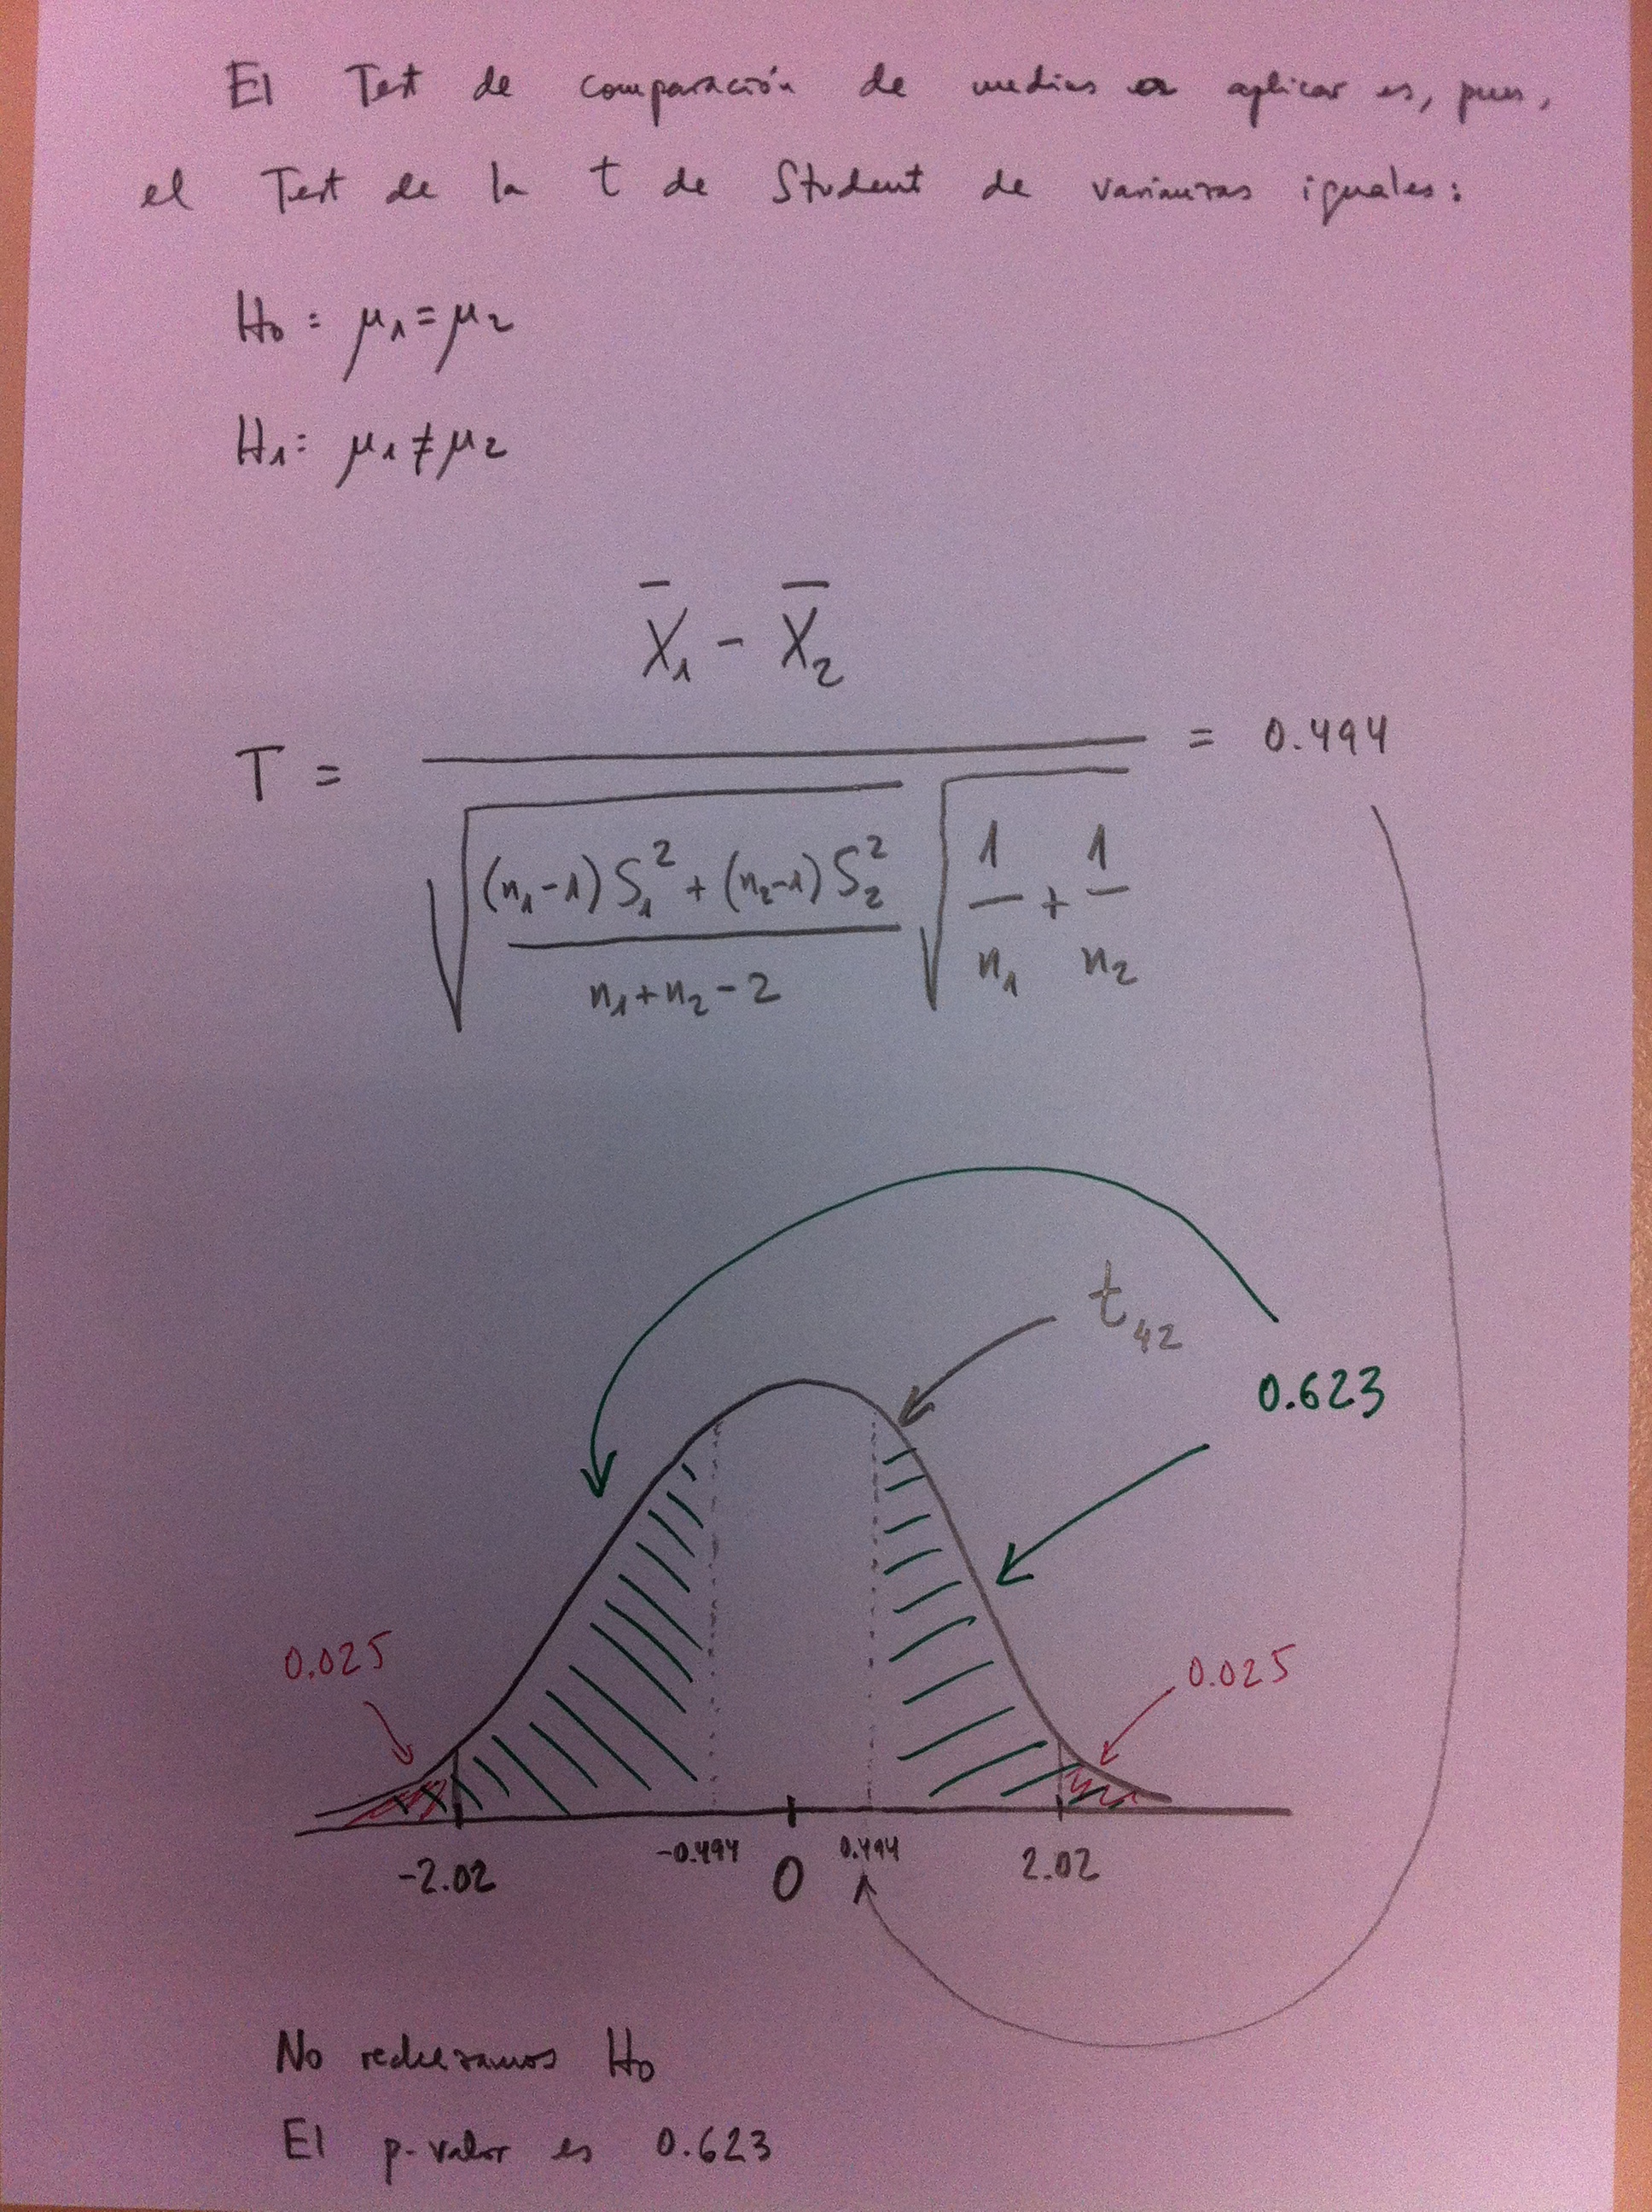
Con un nivel de significación del 0.05, ¿existe diferencia significativa entre el pH de los recién nacidos de las dos poblaciones de mujeres?

Solución:

IMG_5434

IMG_5442

Ejemplo de inferencia en una población

Veamos en el siguiente ejemplo un problema donde se ve al mismo tiempo la construcción de un intervalo de confianza, el contraste de hipótesis y la determinación del tamaño de muestra:

Las autoridades sanitarias fijan la cantidad de 14 UFP/100mL (UFP = unidades formadoras de placas) como la concentración máxima de un determinado virus entérico en aguas residuales de cualquier punto del estado. Se realiza un control en aguas depuradas de 10 granjas que generan purines.  La variable cantidad de UFP/100mL por granja supongamos que se ajusta bien a una distribución Normal. Por otro lado, las granjas están suficientemente alejadas para asumir que los resultados individuales son mutuamente independientes.

La muestra de valores obtenidos ha sido:

(14.3, 15.3, 13.8, 15.4, 15.5, 14.6, 13.9, 15.0, 14.6, 13.8)

1. Calcular un intervalo de confianza del 95% de la concentración media del virus en las aguas que vierten a las granjas.

2. Interpretar el resultado en función del valor fijado por la administración.

3. Con un nivel de significación α = 0.05, ¿se puede aceptar que la concentración del virus supera las 14 UFP/100mL?

4. Con un nivel de significación α = 0.05, ¿se puede aceptar que la desviación estándar de la concentración del virus es de 0.7?

5. ¿Cuáles son los cambios en las diferentes cantidades que intervienen en el problema (media y desviación estándar muestral, estadístico de test, p-valor) si se mide la concentración en litros en lugar de 100ml?

6. Si la muestra se interpreta como un ensayo piloto, qué tamaño de muestra sería necesario para garantizar un nivel de significación del 5%, una potencia del 90% y una diferencia mínima significativa respecto de la media (o una diferencia mínima a detectar) de 0.5 unidades?.

Veamos ahora la solución paso a paso:

IMG_5425

IMG_5426

IMG_5821

Para calcular el tamaño de muestra utilizamos la fórmula expuesta en el tema de dedicado a la Determinación del tamaño de muestra.

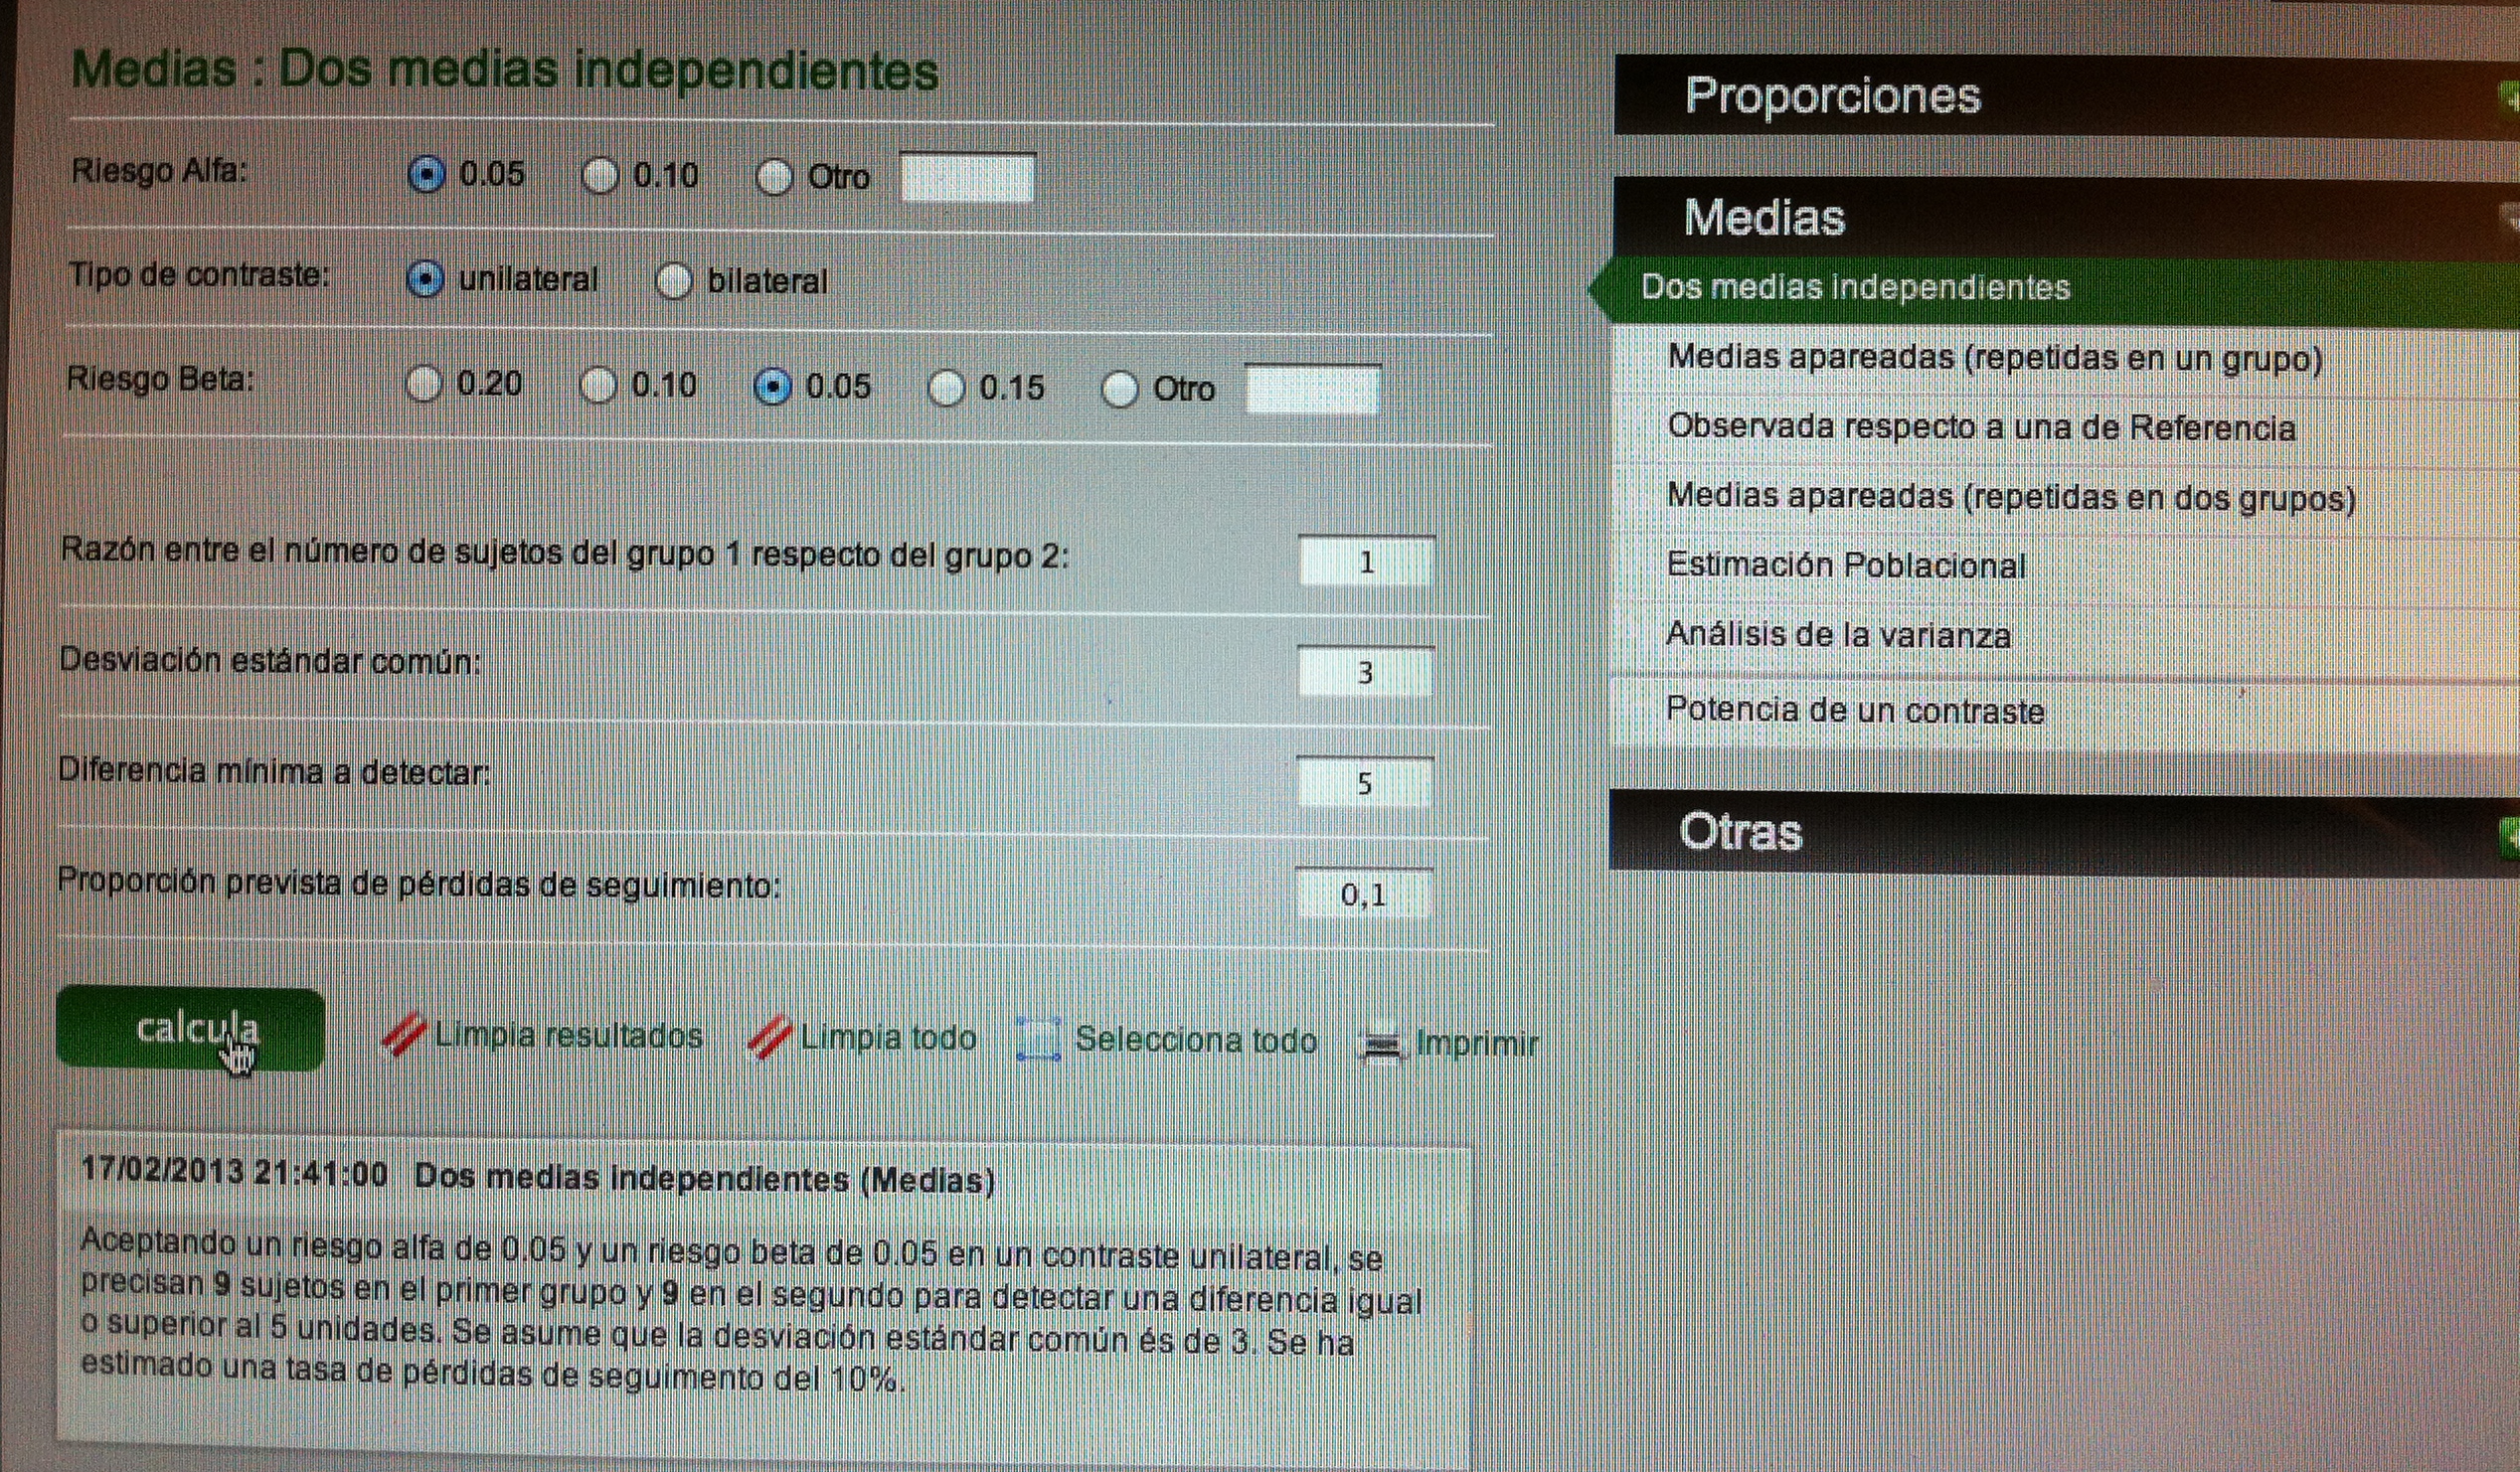
Observemos que la determinación de este tamaño de muestra está hecho como si fuera el test bilateral. Si el test es unilateral, que es como parece que debe plantearse este problema, en realidad, la solución sería la siguiente:

IMG_8917

Es interesante ver la comparación entre estos dos procedimientos para ver cómo se aplicaría la fórmula para un test bilateral y para un test unilateral.

Solución Situación 17

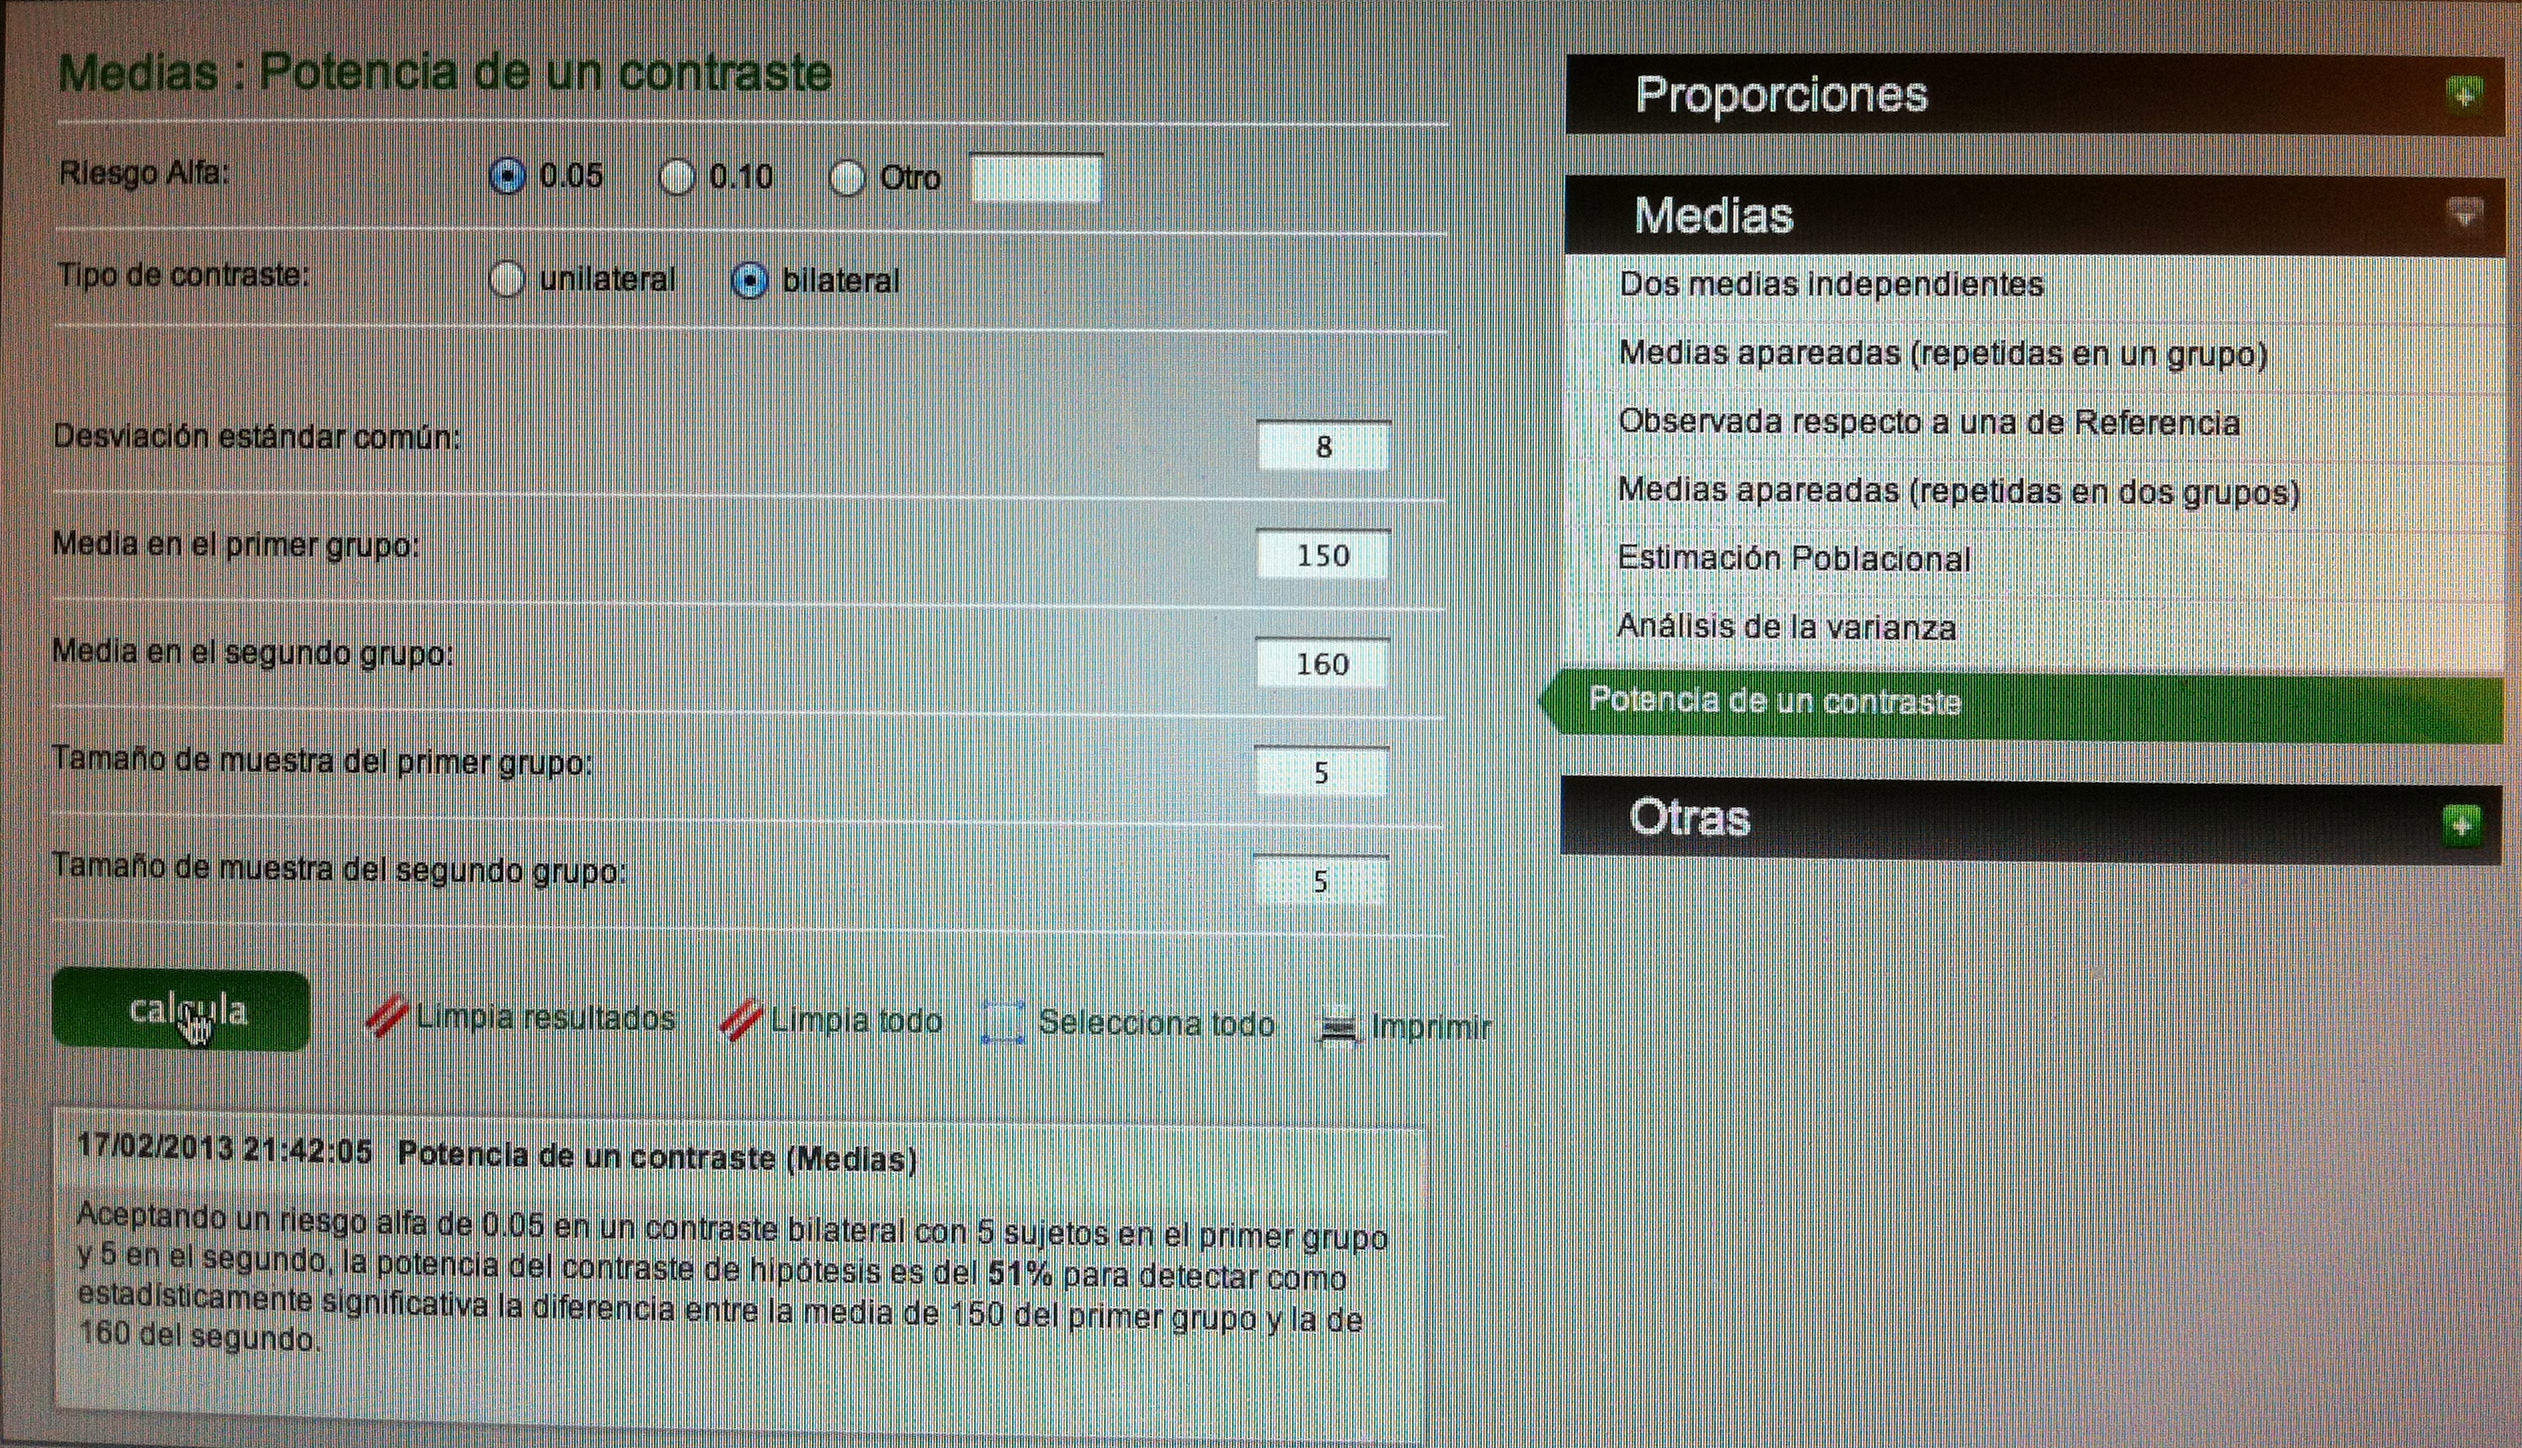
Saber la potencia es importante porque nos sitúa en la calidad de unas conclusiones. Si la potencia es baja y no rechazamos la Hipótesis nula podría ser perfectamente porque tenemos baja potencia.

Apliquemos con el calculador GRANMO cuyo link está en el tema 15 y podremos calcular la potencia:

IMG_5108

Solución Situación 25

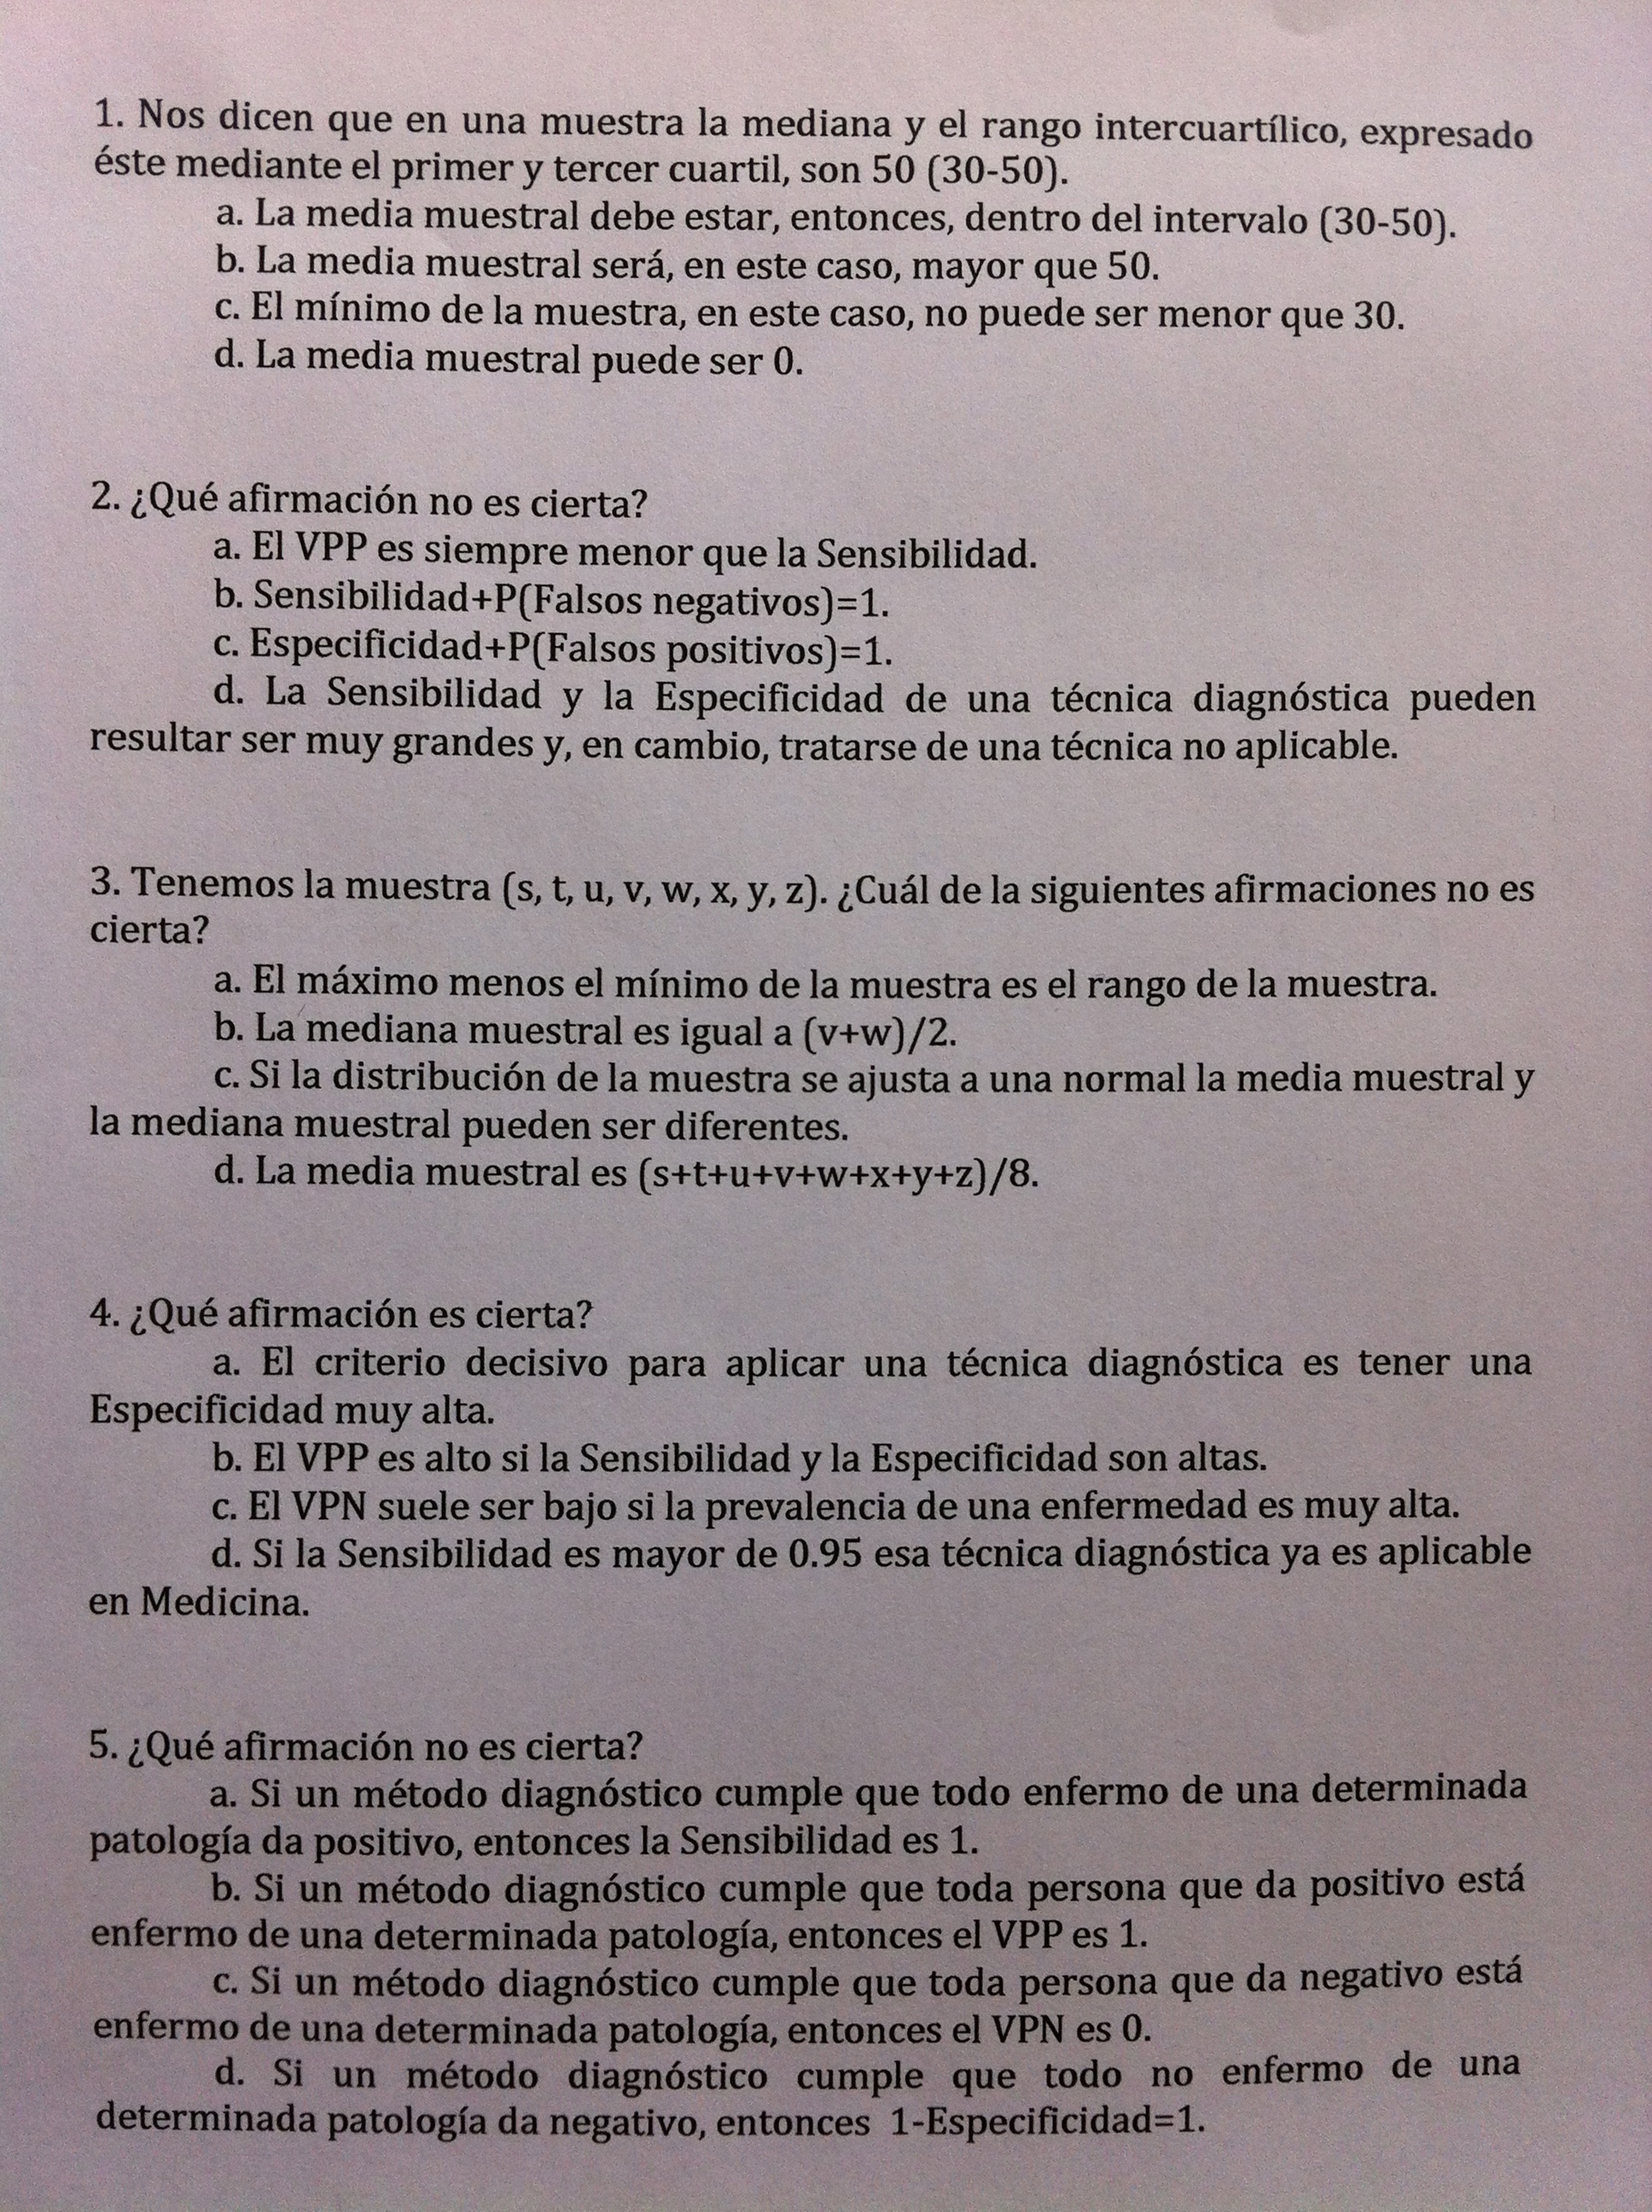
1d:

No tiene por qué ser la media muestral un valor dentro de ese intervalo. Por ejemplo, en la muestra (30, 30, 30, 50, 50, 50, 50, 1000), la media muestral sale de ese intervalo claramente.

No tiene por qué ser mayor que 50 la media muestral. En esta muestra, por ejemplo, no lo es: (0, 20, 40, 50, 50, 50, 50, 50).

El mínimo de la muestra, evidentemente, no tiene por qué ser 30. La muestra anterior es, de nuevo, un ejemplo.

La media muestral puede ser igual a cero, claramente. Observemos la siguiente muestra: (-310, 20, 40, 50, 50, 50, 50, 50). En ella tenemos una media muestral igual a 0.

2a:

La Sensibilidad es la probabilidad de que la prueba diagnóstica dé positiva si la persona está enferma de la patología que se pretende diagnosticar; o sea, P(+/E). Sabemos que P(-/E) es la probabilidad de tener un falso negativo. Sabemos también, claro, que P(+/E)+P(-/E)=1. Por lo tanto, Sensibilidad+P(Falsos negativos)=1.

La Especificidad es la probabilidad de que la prueba diagnóstica dé negativa si la persona no está enferma de la patología que se pretende diagnosticar; o sea, P(-/NE). Sabemos que P(+/NE) es la probabilidad de tener un falso positivo. Sabemos también, claro, que P(-/NE)+P(+/NE)=1. Por lo tanto, Especificidad+P(Falsos positivos)=1.

La Sensibilidad y la Especificidad pueden ser muy grandes y, sin embargo, tratarse de una técnica no aplicable. Por ejemplo, si la VPP es muy baja. ¿De qué sirve tener mucha Sensibilidad y Especificidad si casi siempre que una persona dé positivo no será enfermo?

El VPP no tiene por qué ser menor que la Sensibilidad. Puede ser mayor, perfectamente. Son conceptos independientes.

3b:

El máximo menos el mínimo de una muestra siempre es el rango de la muestra, por definición.

Si la distribución de la muestra se ajusta a una normal la media muestral y la mediana muestral pueden ser diferentes. Perfectamente. Se parecerán, pero no tienen por qué ser iguales.

Y la media muestral, por definición, es la suma de todos los valores muestrales dividido por el tamaño de la muestra.

Pero la mediana muestral es igual, efectivamente, a (v+w)/2, si la muestra está ordenada. Pero, en general, no. Y en el planteamiento del problema en ningún momento se nos dice que la muestra esté ordenada.

4c:

El criterio decisivo es tener valores altos de Sensibilidad, de Especificidad, de VPP y de VPN. Tener sólo valores altos de uno de esos criterios nos sirve de poco si no va acompañado de valores altos de los demás. Todos los criterios son, pues, decisivos, porque todos nos proporcionan una dimensión distinta del método diagnóstico.

El VPP es independiente de la Sensibilidad y de la Especificidad.

La Sensibilidad, como los demás conceptos, no es un criterio único para evaluar la calidad de un método diagnóstico.

Efectivamente el VPN suele ser bajo si la prevalencia de la enfermedad a diagnosticar es muy alta. En estos casos, aunque la Sensibilidad sea muy alta, por el enorme volumen de enfermos que hay los falsos negativos que haya pesarán mucho respecto a los verdaderos negativos que pueda haber, lo que nos llevará a una P(NE/-) baja.

5d:

Si un método diagnóstico cumple que todo enfermo de una determinada patología da positivo, entonces la Sensibilidad es 1. Se desprende de la definición. No hay falsos negativos, luego Sensibilidad=1.

Si un método diagnóstico cumple que toda persona que da positivo está enfermo de una determinada patología, entonces el VPP es 1. También se desprende de la definición. P(E/+)=1.

Si un método diagnóstico cumple que toda persona que da negativo está enfermo de una determinada patología, entonces el VPN es 0. Estamos diciendo que P(E/-)=1. Y sabemos que P(E/-)+P(NE/-)=1. Luego P(NE/-)=0; o sea: VPN=0.

Sin embargo, si un método diagnóstico cumple que todo no enfermo de una determinada patología da negativo, entonces  P(-/NE) =1; o sea, la Especificidad es igual a 1. Entonces 1-Especificidad=0, no igual a 1, por supuesto.

La estimación mediante el método de la máxima verosimilitud

En Estadística se manejan diferentes tipos de modelos para representar una determinada situación real: funciones de distribución, modelos de regresión lineal simple, regresión lineal múltiple, regresión logística, regresión de Cox, anova de un factor, de dos factores, etc. Estos modelos tienen parámetros.

Los parámetros son valores abstractos, por eso se representan mediante letras. Sin embargo, cuando nos enfrentamos a un caso concreto y tenemos una muestra concreta de una realidad, interesa estimar unos valores concretos de esos parámetros. Porque de esta forma el modelo sustituye a la realidad, el modelo se convierte en una maquinaria matemática, en una maqueta matemática de esa realidad.

Los parámetros son como las tallas de camisas o zapatos. Debemos elegir un valor concreto que nos vaya bien a nosotros.

Una vez tenemos un modelo con valores concretos de los parámetros tenemos la realidad representada matemáticamente. Si es, por ejemplo, una función de distribución normal, al calcular la media y la desviación estándar de la muestra y elegir una normal con sus dos parámetros esos dos valores, tenemos entonces una normal concreta que se convierte en una maqueta matemática de la distribución poblacional de la variable estudiada. Si es, por ejemplo, una recta de regresión ocurre lo mismo pero con otros parámetros. Así sucesivamente. Podemos tener modelos con muchos parámetros y necesitaremos muchas estimaciones. Pero el procedimiento siempre es el mismo. Necesitamos estimar los parámetros del modelo, las medidas del modelo que se ajusten a lo que vemos.

El método de estimación de la máxima verosimilitud (en inglés se denomina el maximum-likelihood estimation) es un método universal (universal porque es una filosofía, una forma de hacer aplicable a todos los modelos) de estimar parámetros en un modelo matemático. Es el más utilizado y cotizado.

Es cierto que en muchas ocasiones el estudiante se desmoraliza viendo la complejidad de la nomenclatura del método. Pero la idea es muy sencilla y trivial.

La idea del método es muy sencilla y básica. Es la siguiente: Tenemos una muestra y tenemos que elegir unos valores de los parámetros del modelo. Pues elijamos aquellos valores que hacen máxima la probabilidad de ver lo que estamos viendo en la muestra. Tan sencillo como esto. Ni más ni menos.

Supongamos un caso muy sencillo. Supongamos que queremos ver la prevalencia de una determinada enfermedad en una determinada población. Tomamos una muestra de tamaño 100 y vemos que tenemos 7 personas con tal enfermedad. Un modelo matemático para representar la prevalencia de esa enfermedad en esa población es una distribución Bernouilli que suele escribirse como B(p) (Ver el artículo Funciones de distribución en el apartado de Complementos).

Tomar como modelo concreto la distribución Bernouilli B(0.07) es aplicar, de hecho, el método de la máxima verosimilitud. Porque observemos que si tomamos una muestra de tamaño 100 y observamos 7 enfermos, estamos haciendo, en realidad, una observación de una distribución Binomial y podemos crear, así, la siguiente función de p:

IMG_5380

Y esta es una función de una variable, la variable p. Parece coherente elegir como estimación de p el valor que haga máximo ese valor. Si representáramos esta función veríamos curiosamente que donde se produce el máximo es justo encima del valor 0.07:

IMG_5381

Es por esto que 0.07 es la estimación de máxima verosimilitud en este caso y, en general, en una muestra de una variable dicotómica siempre que calculamos, como estimación del parámetro p, el tanto por uno de observaciones vistas de uno de los dos resultados posibles de la variable, estamos aplicando el estimador de máxima verosimilitud.

Así sucede en todos los modelos. Siempre tenemos un estimador máximo verosímil. Y este método de estimación, esta filosofía de estimación, es la más usual en Estadística.