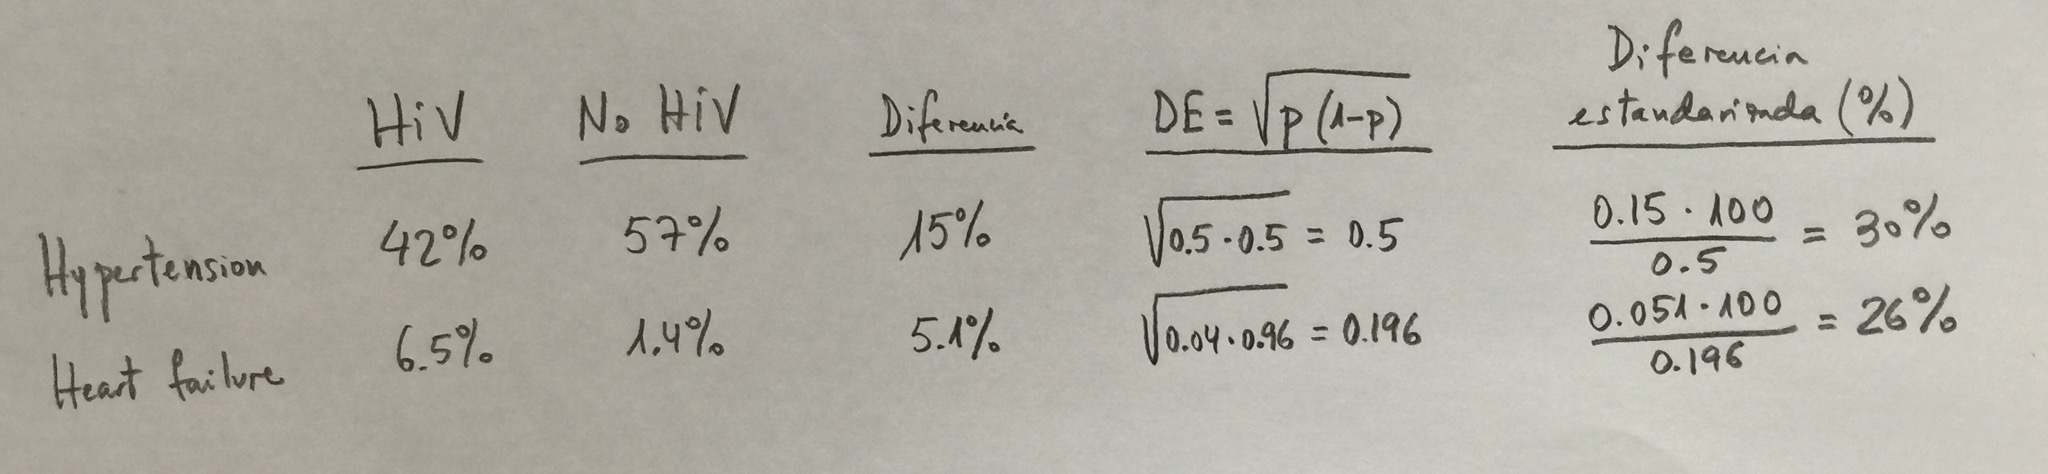Archivo del Autor: estadisticallopis

Artículo 4: Principal component analysis of socioeconomic factors and their association with malaria in children from the Ashanti Region, Ghana

Este interesante artículo fue publicado en la revista Malaria Journal en el 2010.

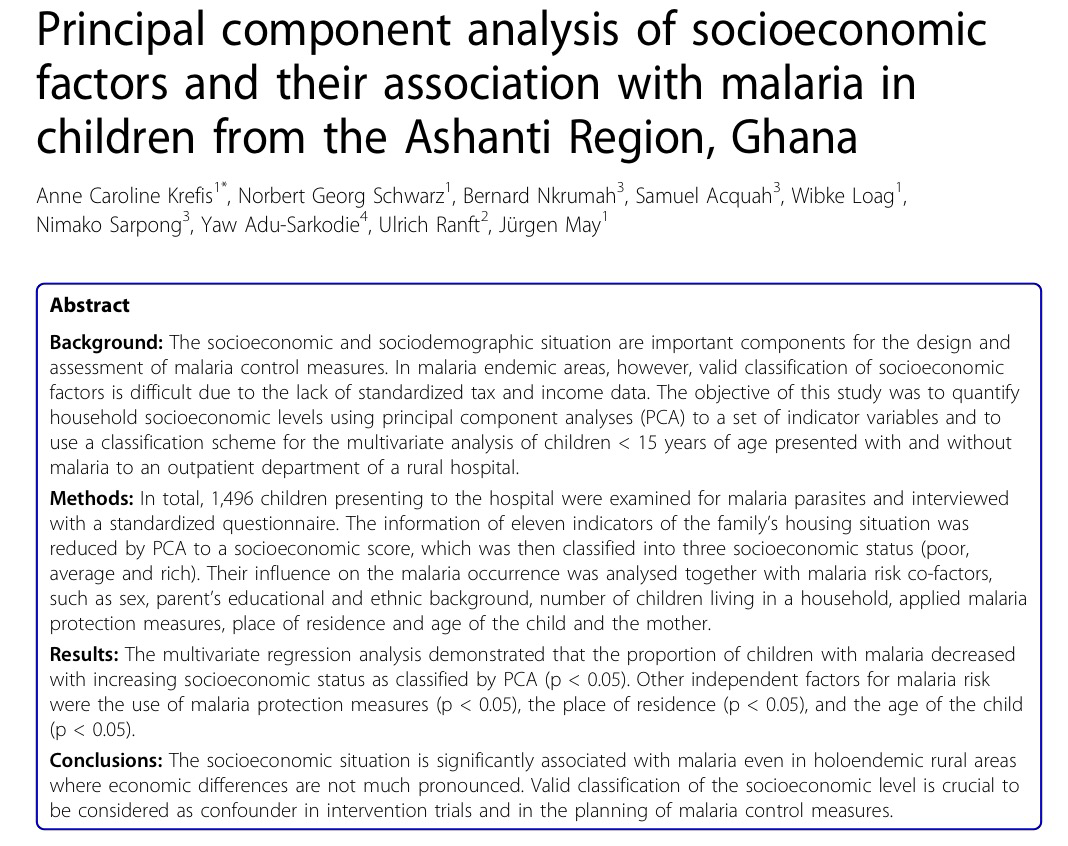
El Abstract es el siguiente:

IMG_0247

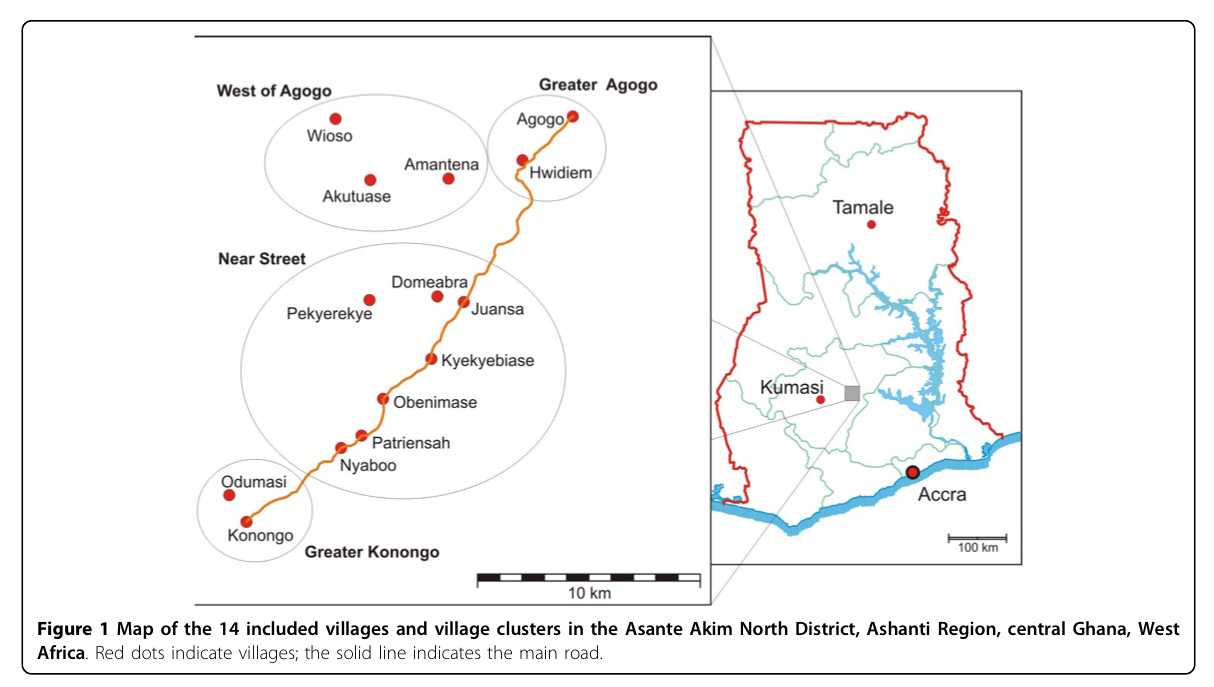
La región donde se realiza el estudio es la siguiente:

IMG_0248

He elegido el artículo para comentar por el uso que hace de un análisis estadístico muy interesante: el Análisis de componentes principales. Es una técnica multivariante que combina las variables originales creando unas macrovariables (Componentes) que son diferentes combinaciones, con distintos pesos, de esas variables originales, y que explican (las primeras de esas componentes: por eso se llaman principales) la mayor parte de la variabilidad que hay entre los datos que tenemos.

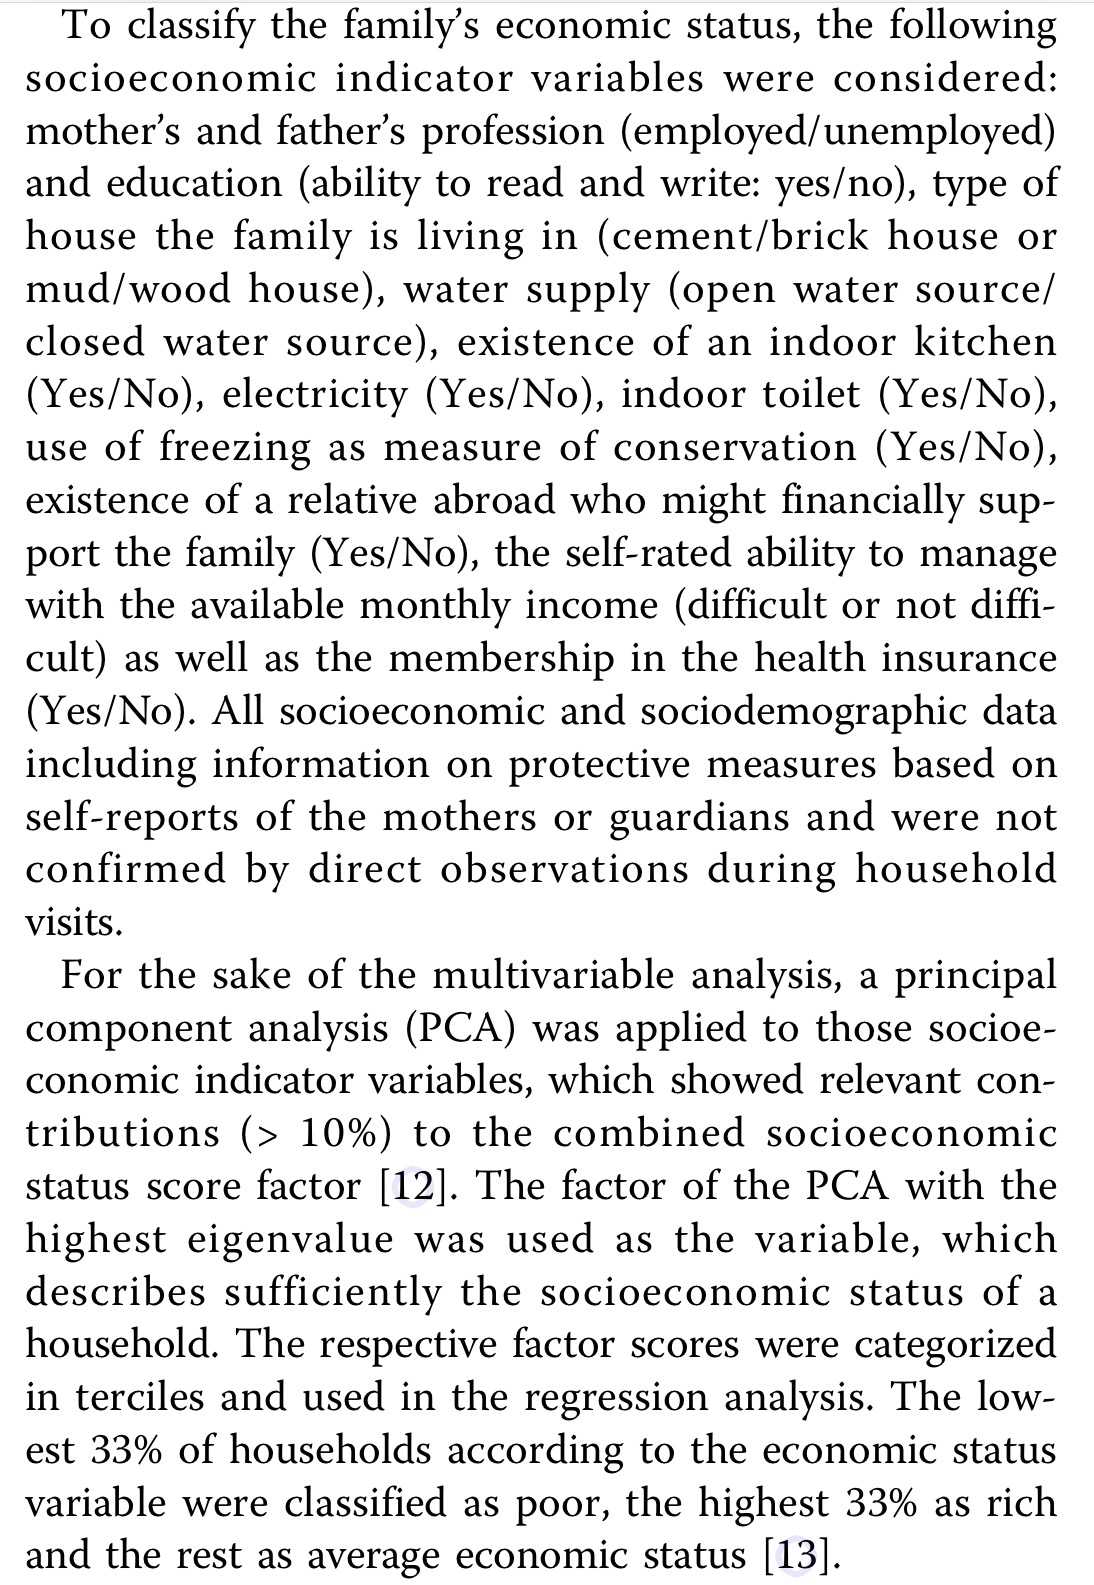
Observemos, a través de la redacción de los métodos, cuáles han sido las variables utilizadas en el análisis, en este estudio. Como podemos ver variables socioeconómicas, como nos indica el título del artículo:

IMG_0249

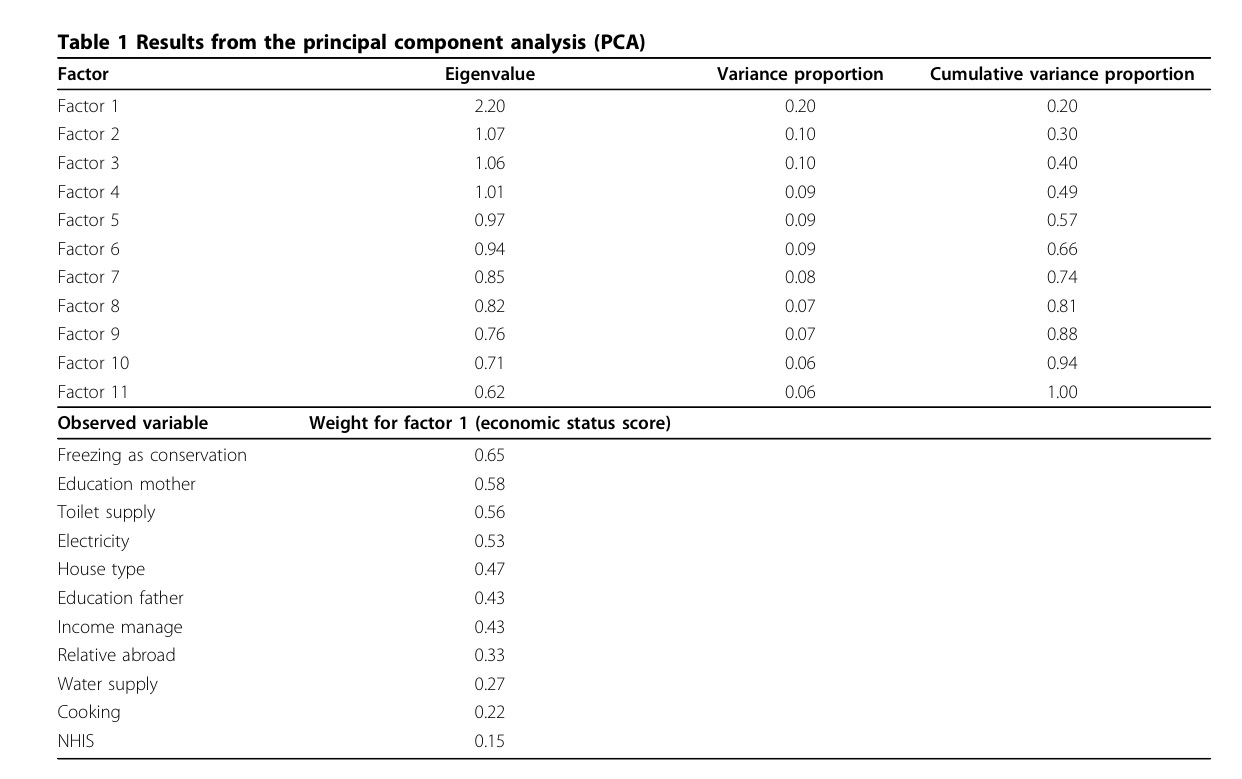
El Análisis de componentes principales que realizan a una muestra de tamaño 1496, da los siguientes resultados básicos:

IMG_0250

La primera componente no explica mucho. Pero es la que explica más varianza. Explica el 20% de la variabilidad. Observemos que se ha trabajado con 11 variables originales y se obtiene 11 componentes. Lo que sucede es que son 11 componentes (11 combinaciones distintas de las variables originales) con una capacidad muy desigual de explicar la variabilidad intrínseca en los datos, como puede verse en la columna donde está la proporción de la varianza explicada por cada componente (las denomina «factores»).

Ellos han trabajado con esta primera componente, que es la que explica más varianza y que, además, tiene gran interés para lo que persigue el estudio. Suma todas las variables originales. Con pesos un poco diferentes, es cierto, pero siempre con el coeficiente positivo. Lo que nos separa las personas con buen o con mas nivel socioeconómico evaluado por esas 11 variables originales. Quien tiene más comunidades de las enunciadas en las diferentes variables es el que puntúa más en la componente. Por lo tanto, esta componente evalúa el nivel socioeconómico pesando mediante esos coeficientes las 11 variables originales.

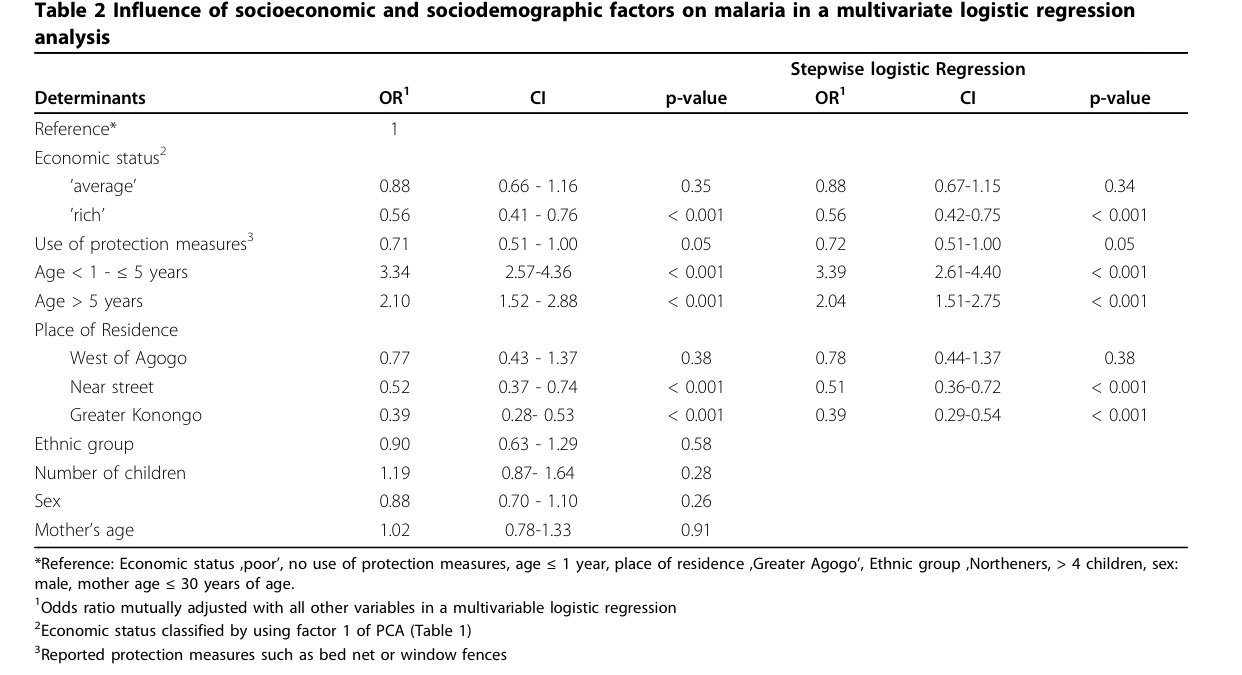
La utilización de las componentes a partir de un estudio así puede tener muchas direcciones. Ellos exponen el uso que le han dado a la principal de esas componentes, a la primera:

IMG_0251

Es interesante ver ese uso. Están haciendo una Regresión logística relacionando esa primera componente principal con el tener o no malaria y obtienen esas Odds ratio.

Artículo 3: Survival and long-term outcomes following bioprosthetic vs mechanical aortic valve replacement in patients aged 50 to 69 years

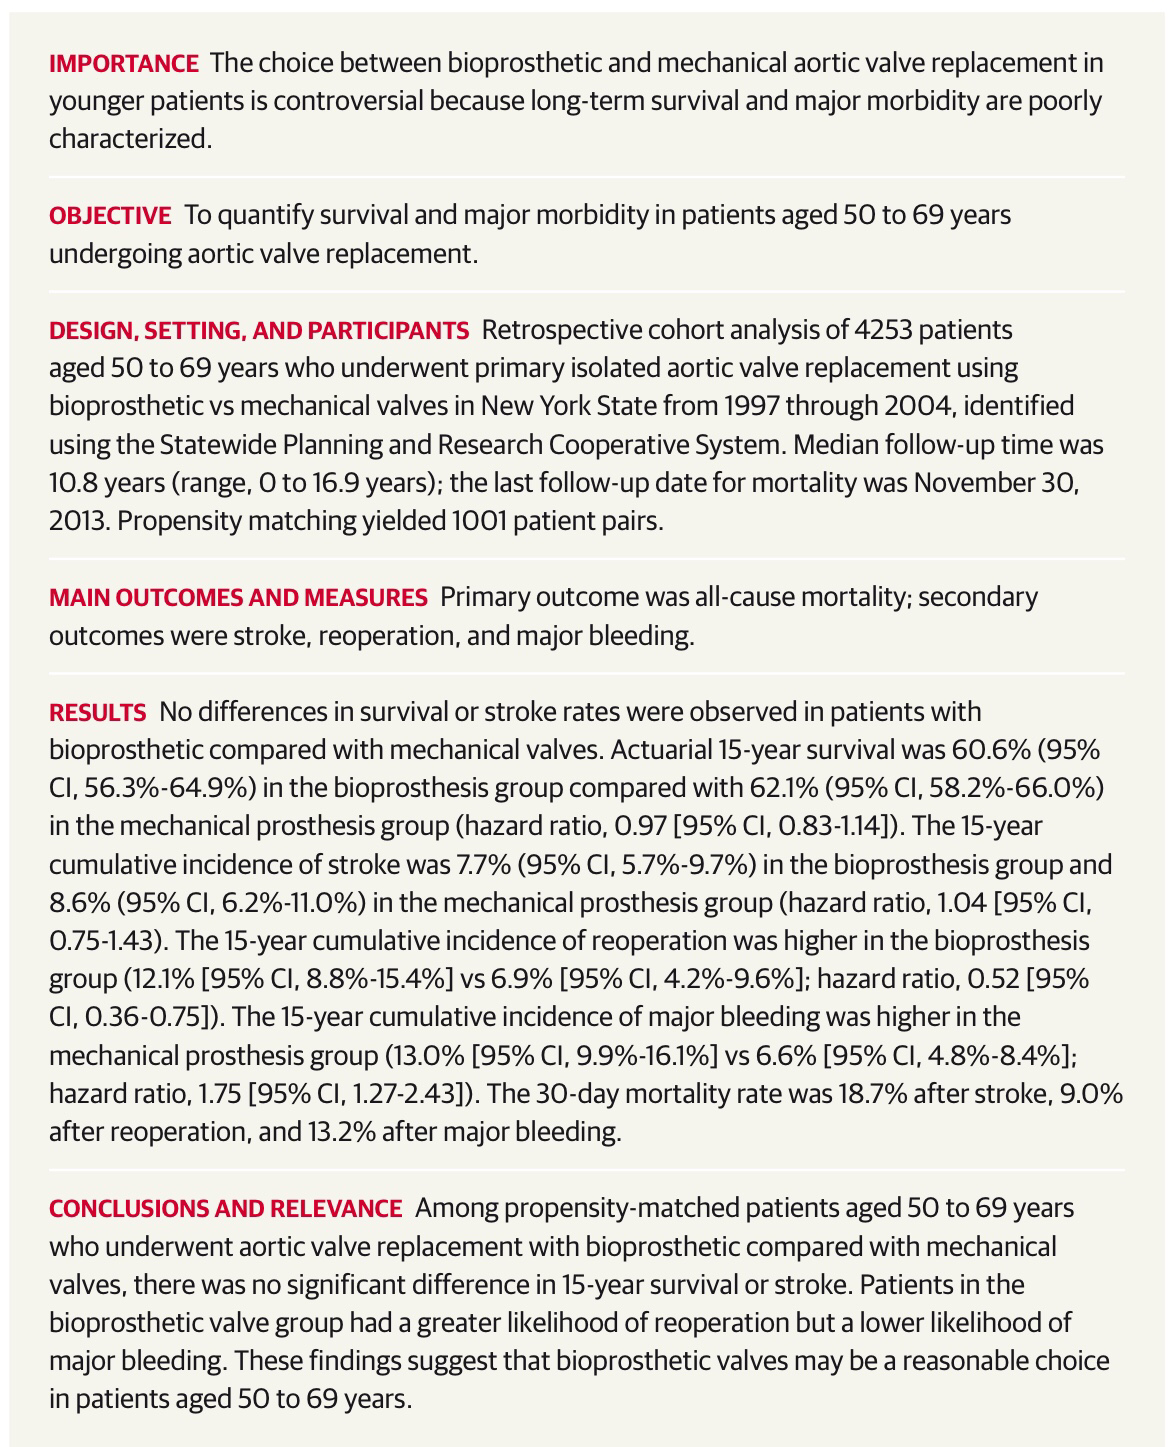
Este es un artículo del JAMA de 2014 donde se comparan dos tipos de próstesis de válvulas aórticas: biológicas y mecánicas, en pacientes de una edad intermedia donde hay controversia acerca de cuál de las dos es la mejor opción.

El estudio es interesante, desde el punto de vista estadístico, como un ejemplo de Propensity Score Analysis.

El Abstract del estudio es el siguiente:

IMG_0228

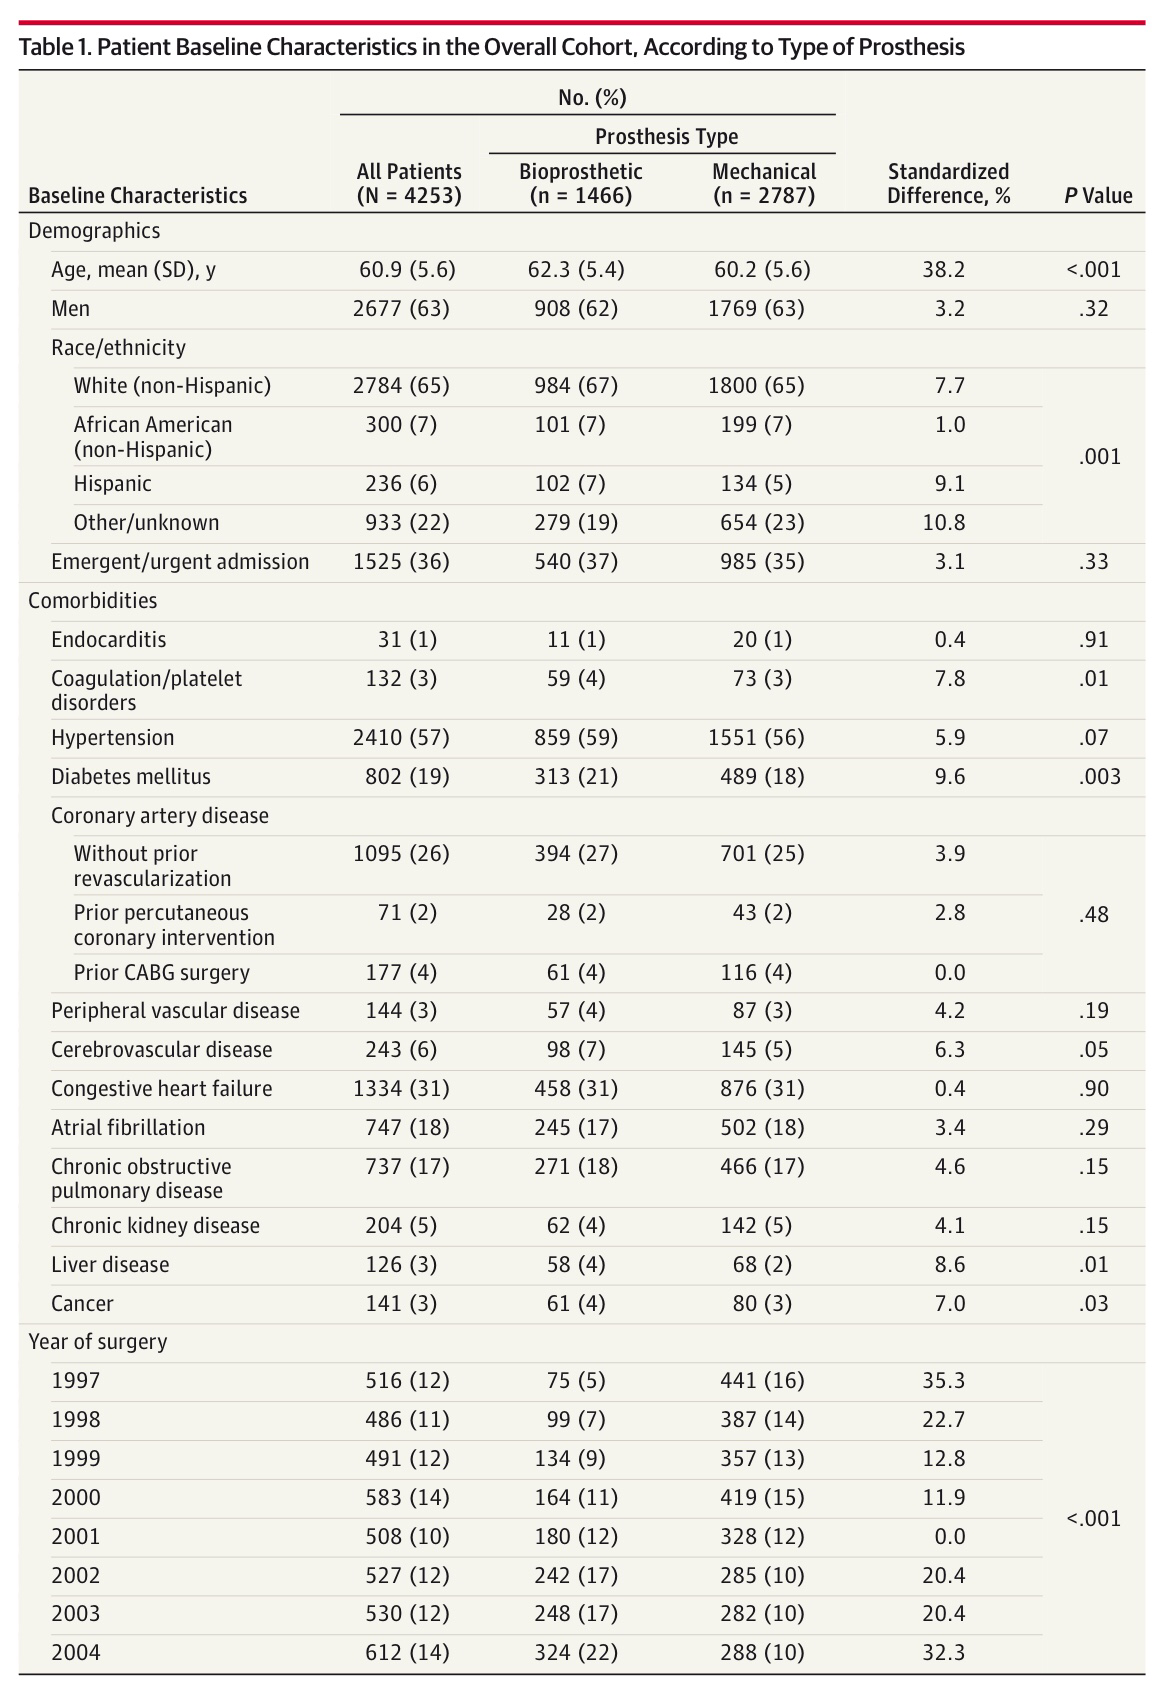
En la siguiente tabla se muestra una descriptiva y un análisis comparativo de los dos grupos observacionales que se quiere comparar. Tenemos también el valor de diferencia estandarizada en tanto por ciento. Esto es interesante para hacer una visión unitaria de las diferencias entres ambos grupos. Pensemos que cada variable tiene escalas diferentes. Estandarizando igualamos las escalas y por lo tanto podemos ver en qué variables relativamente encontramos más o menos diferencias entre los dos grupos.

IMG_0229

 Como puede observarse entre los dos grupos hay importantes diferencias. Diferencias que podrían generar confusión a la hora de interpretar las variables resultado. Por eso se aplica un Propensity Score Analysis. Para ver el mecanismo de esta interesante técnica puede leerse el Tema 24: Análisis de propensiones (Propensity Score Analysis).

Observemos la significación de la diferencia en primer lugar, y, después, el peso de esta diferencia, observando la diferencia estandarizada. En la edad y en la distribución por años de cirugía es donde se produce más diferencias.

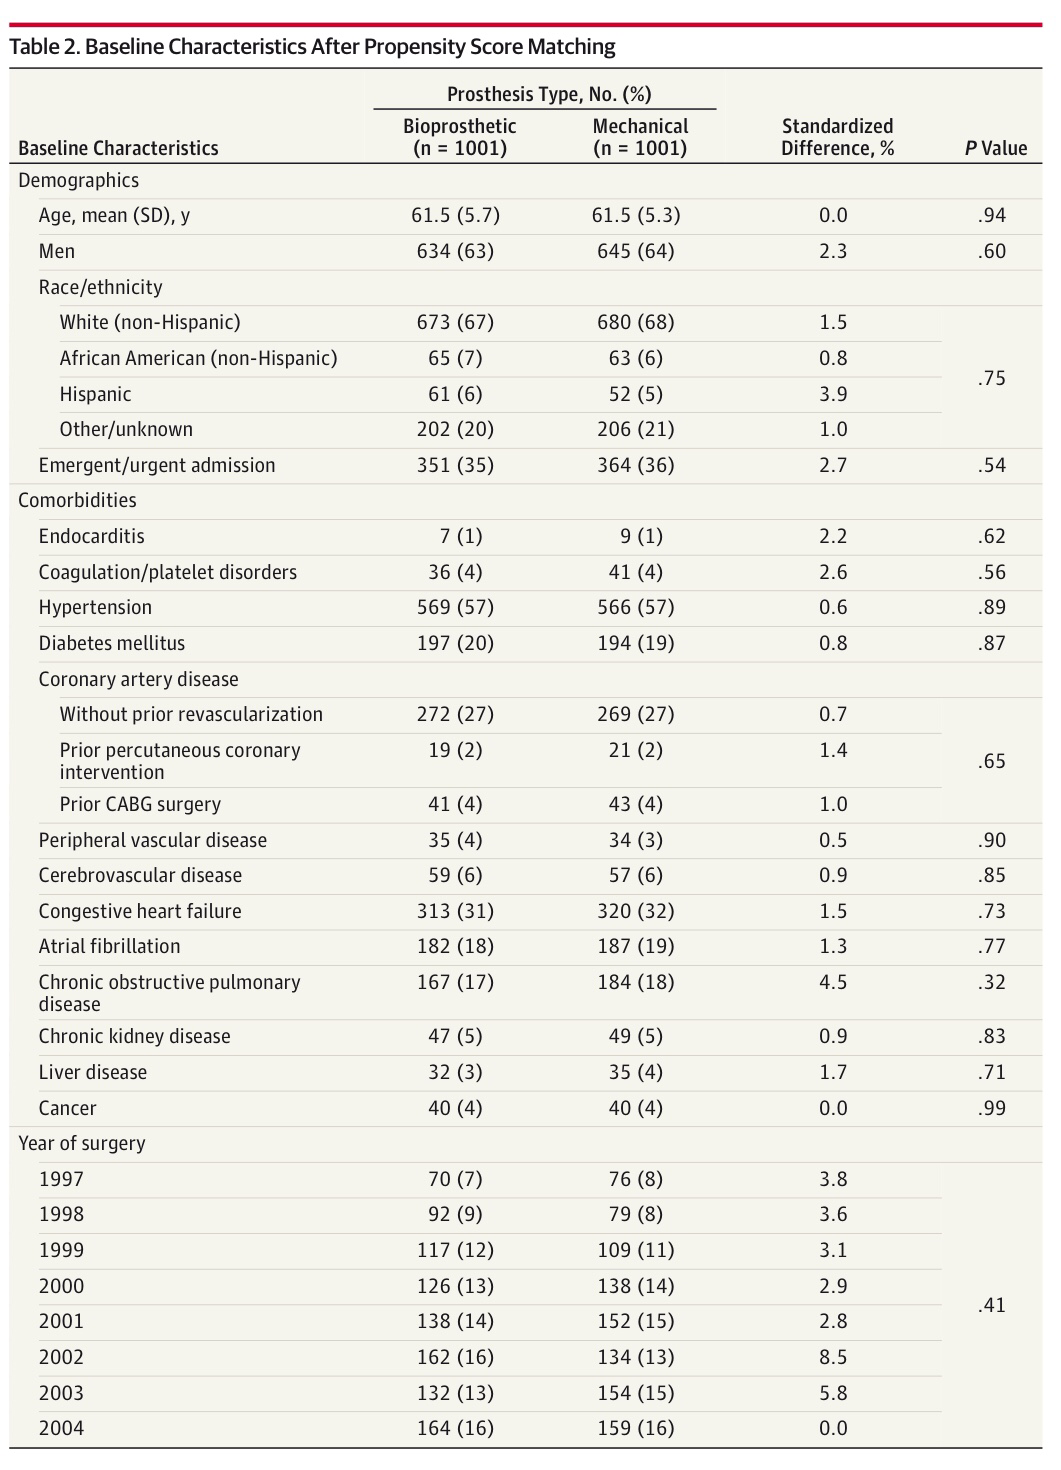
Después de hacer el Propensity la tabla obtenida ahora es, con la estadística descriptiva, el p-valor de la comparación y la diferencia estandarizada es bien diferente:

IMG_0231

Observemos ahora la enorme homogeneidad que hay entre los dos grupos a comparar. La muestra se ha reducido. Es verdad. Esto es habitual en el Propensity Score Analysis. Suele fijarse un mínimo de semejanza para incluirse y esto provoca que algunos casos no tengan un control lo suficientemente próximo.

Un aspecto técnico a destacar en esta comparación entre los dos grupos es que estos autores han llevado al extremos máximo posible la idea de matching, la idea de apareamiento, del Propensity Score Analysis, porque las dos muestras obtenidas de tamaño 1001 no las trabajan como muestras independientes sino como muestras apareadas, como si en lugar de tener 2002 individuos tuviéramos 1001 a los que se les ha puesto dos prótesis al mismo tiempo. Esto es discutible. En principio este análisis sirve para homogeneizar grupos pero no para hacer este salto metodológico tan importante.

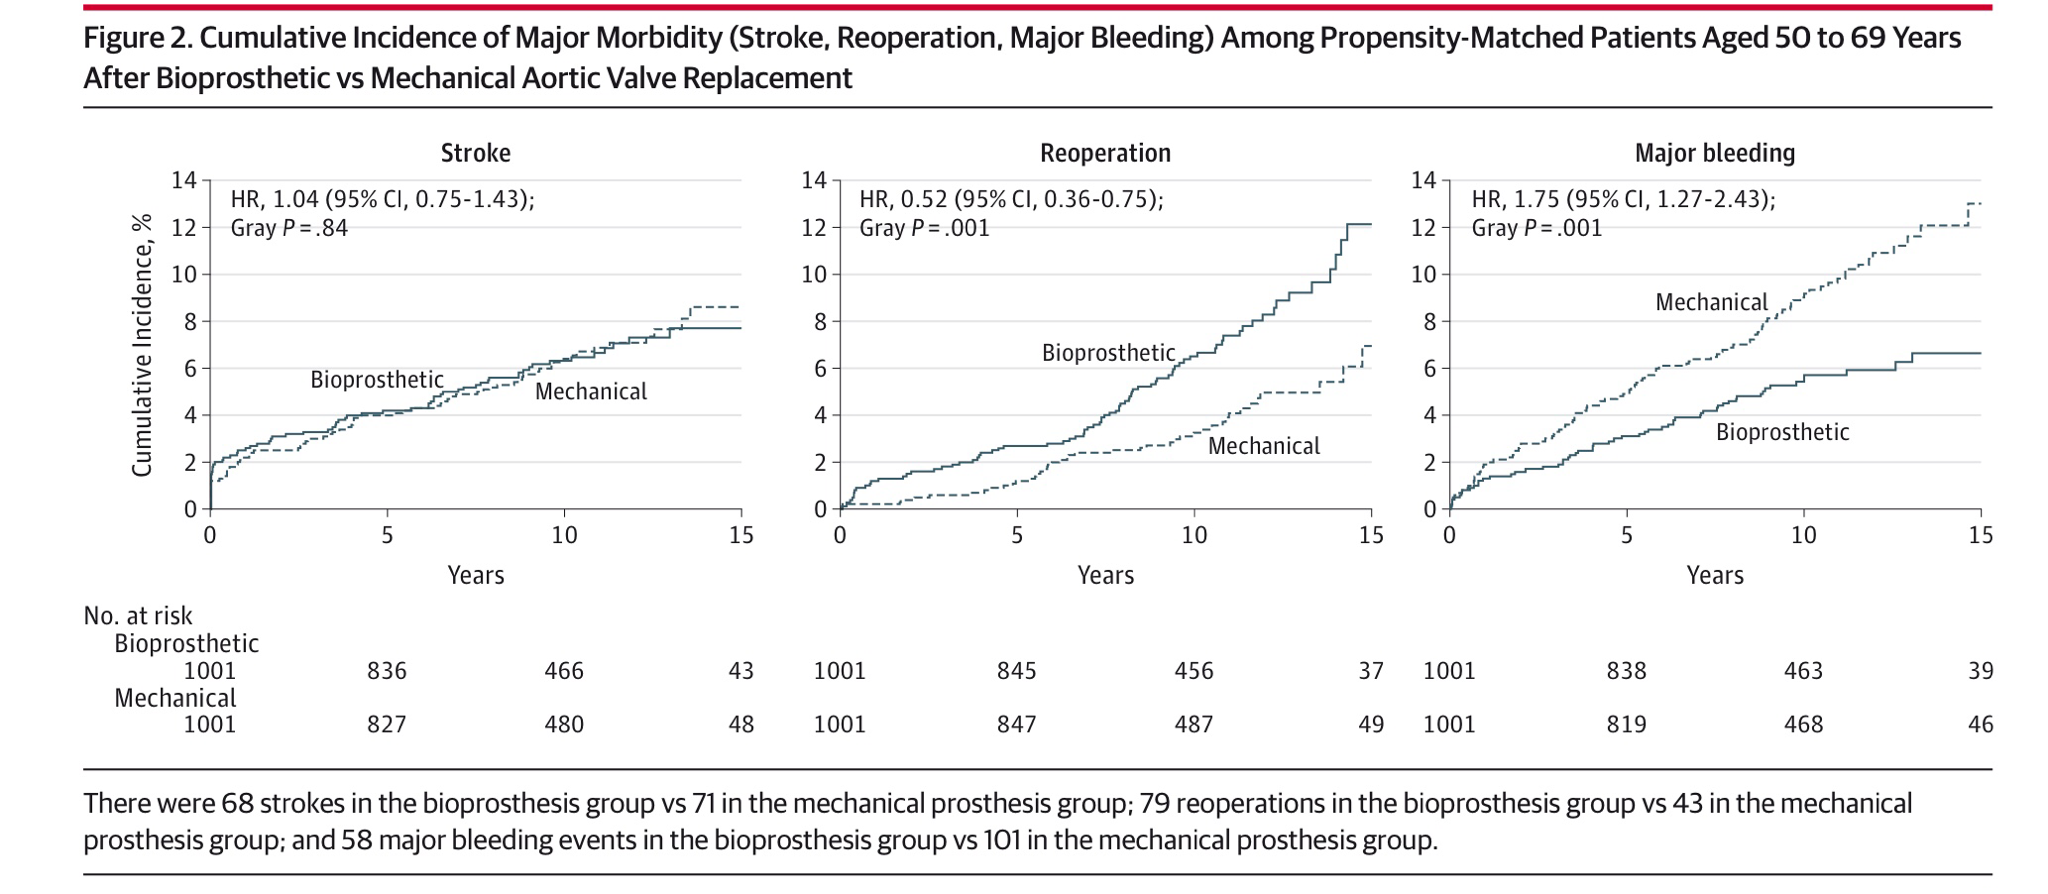
Una vez se tiene esos dos grupos ahora ya es cuestión de compararlos. Con toda la tecnología habitual en este tipo de estudios en Medicina: Curvas de supervivencia. Número de incidencias. Etc. Como puede verse a continuación:

IMG_0226IMG_0227


Como puede verse en estos gráficos y en las conclusiones del estudio en 15 años de seguimiento de estos pacientes no hay diferencias en la mortalidad ni el la incidencia de ictus y la única diferencia es que las prótesis biológicas tienen una mayor incidencia de reoperaciones y las mecánicas una mayor incidencia de hemorragias mayores.

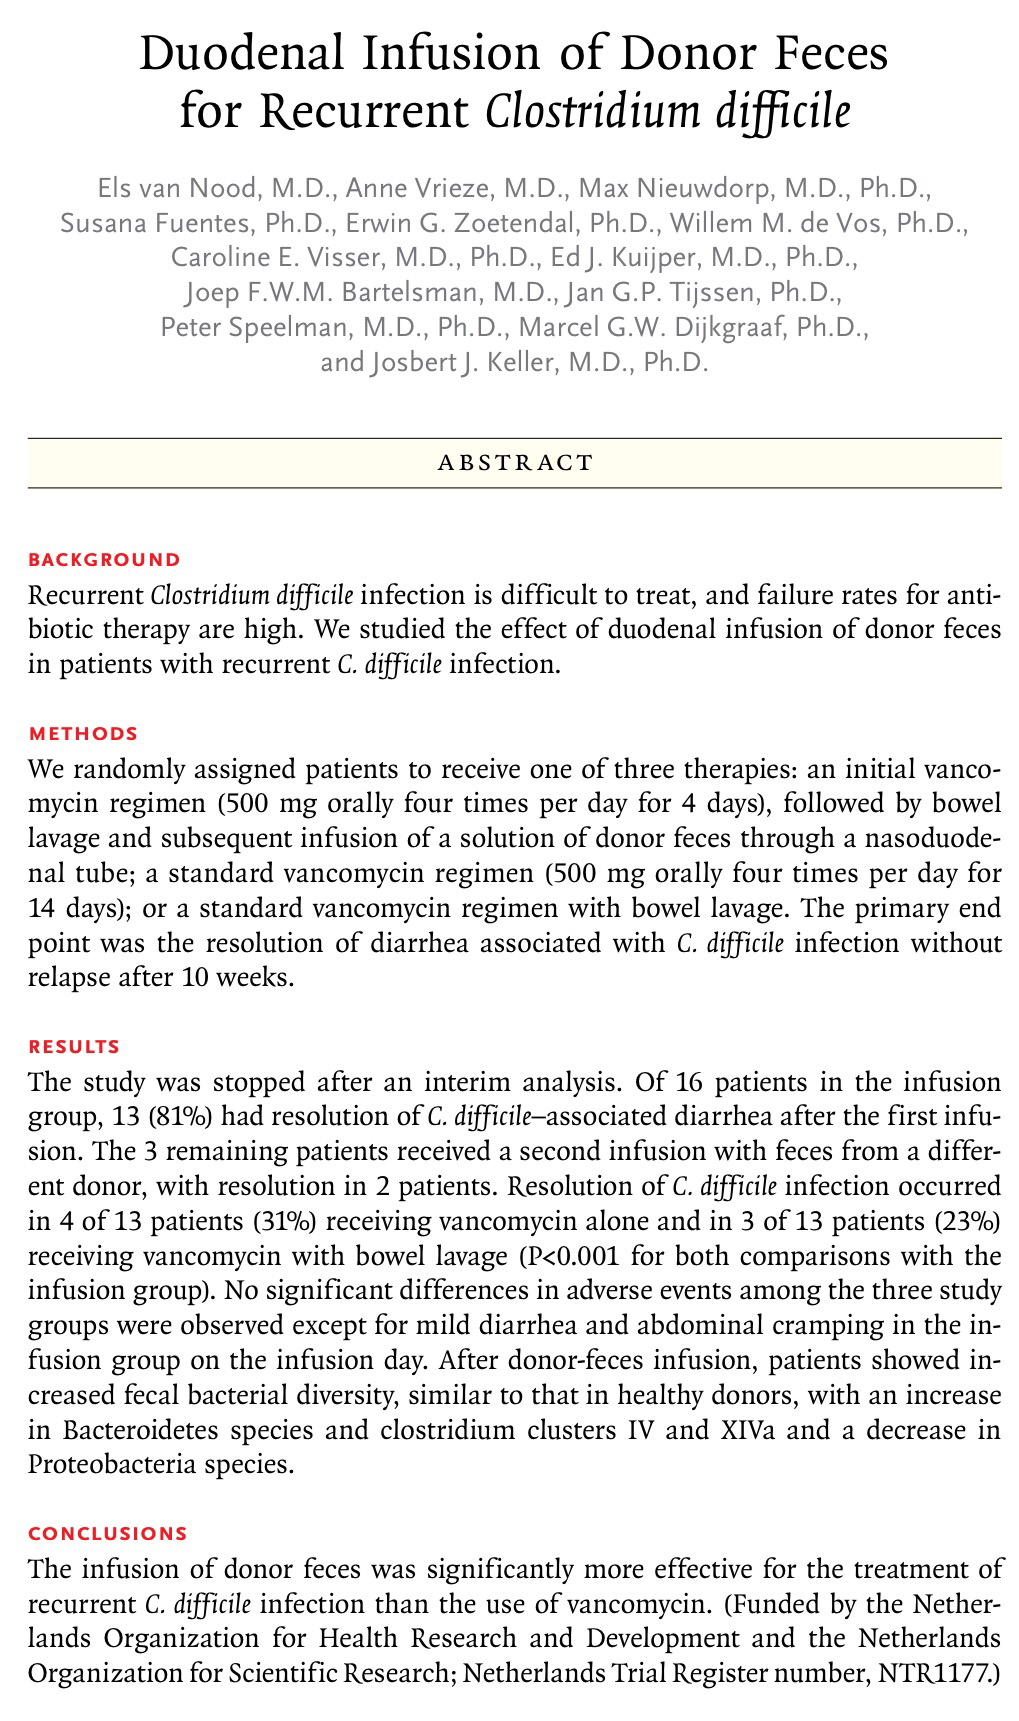
Artículo 2: Duodenal infusion of donor feces for recurrent Clostridium difficile

Este es un artículo importante publicado en el New England Journal of Medicine.

El Abstract es el siguiente:

IMG_0242

Interesa destacarlo por la técnica adecuada al caso que utilizan para analizar los datos.

Como puede verse el objetivo es ensayar un nuevo y revolucionario método para enfrentarse a la infección digestiva de Clostridium difficile: mediante infusiones duodenales de donantes con infección cronificada por esa especie bacteriana.

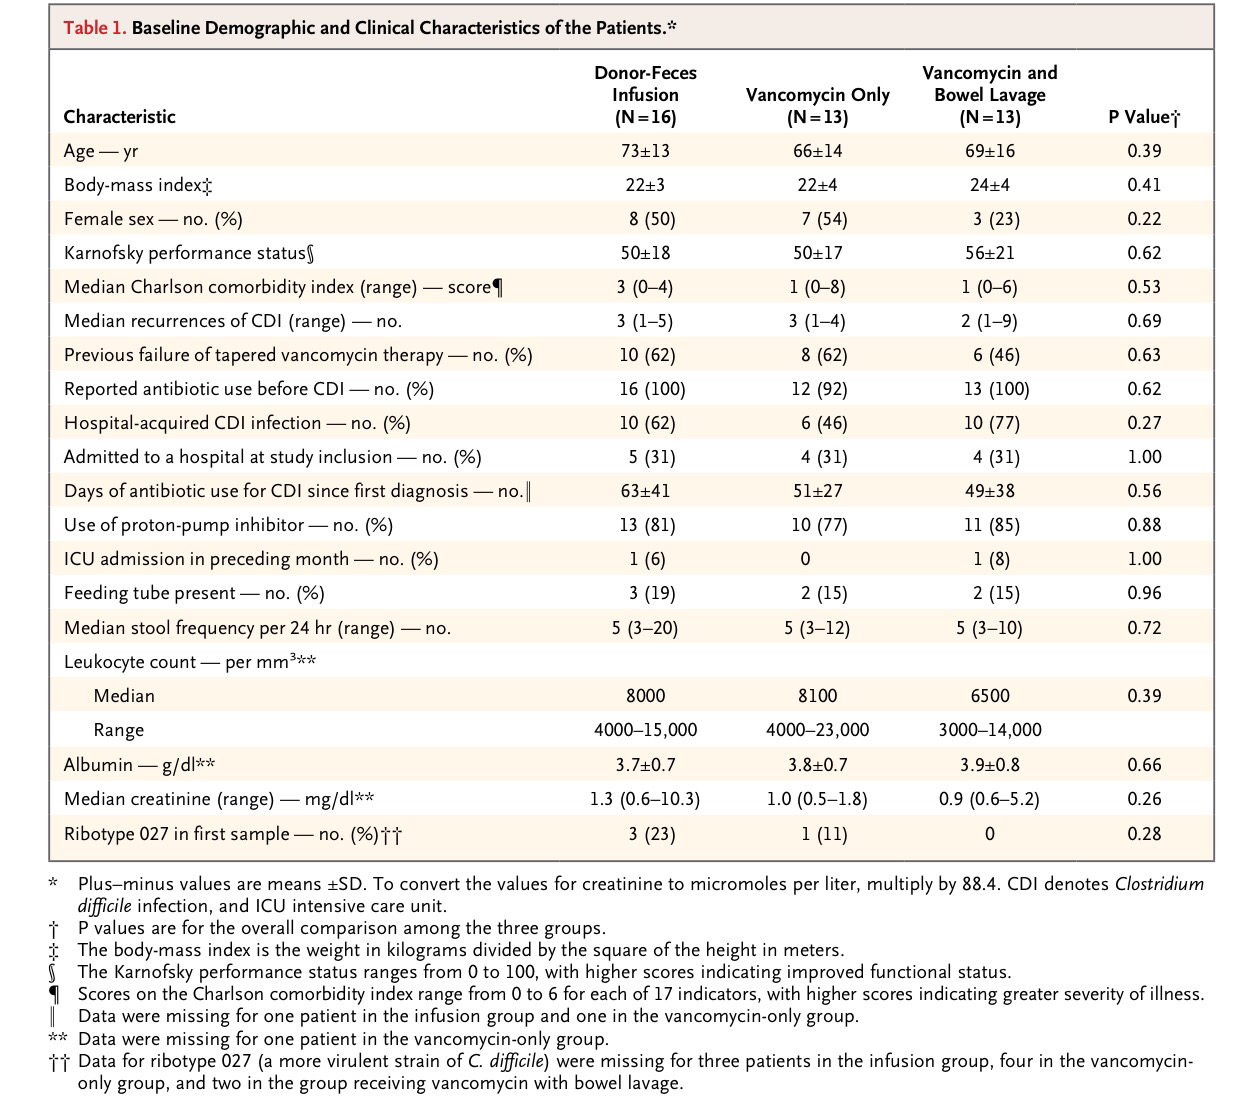
Una descriptiva de los grupos a comparar es la siguiente:

IMG_0243

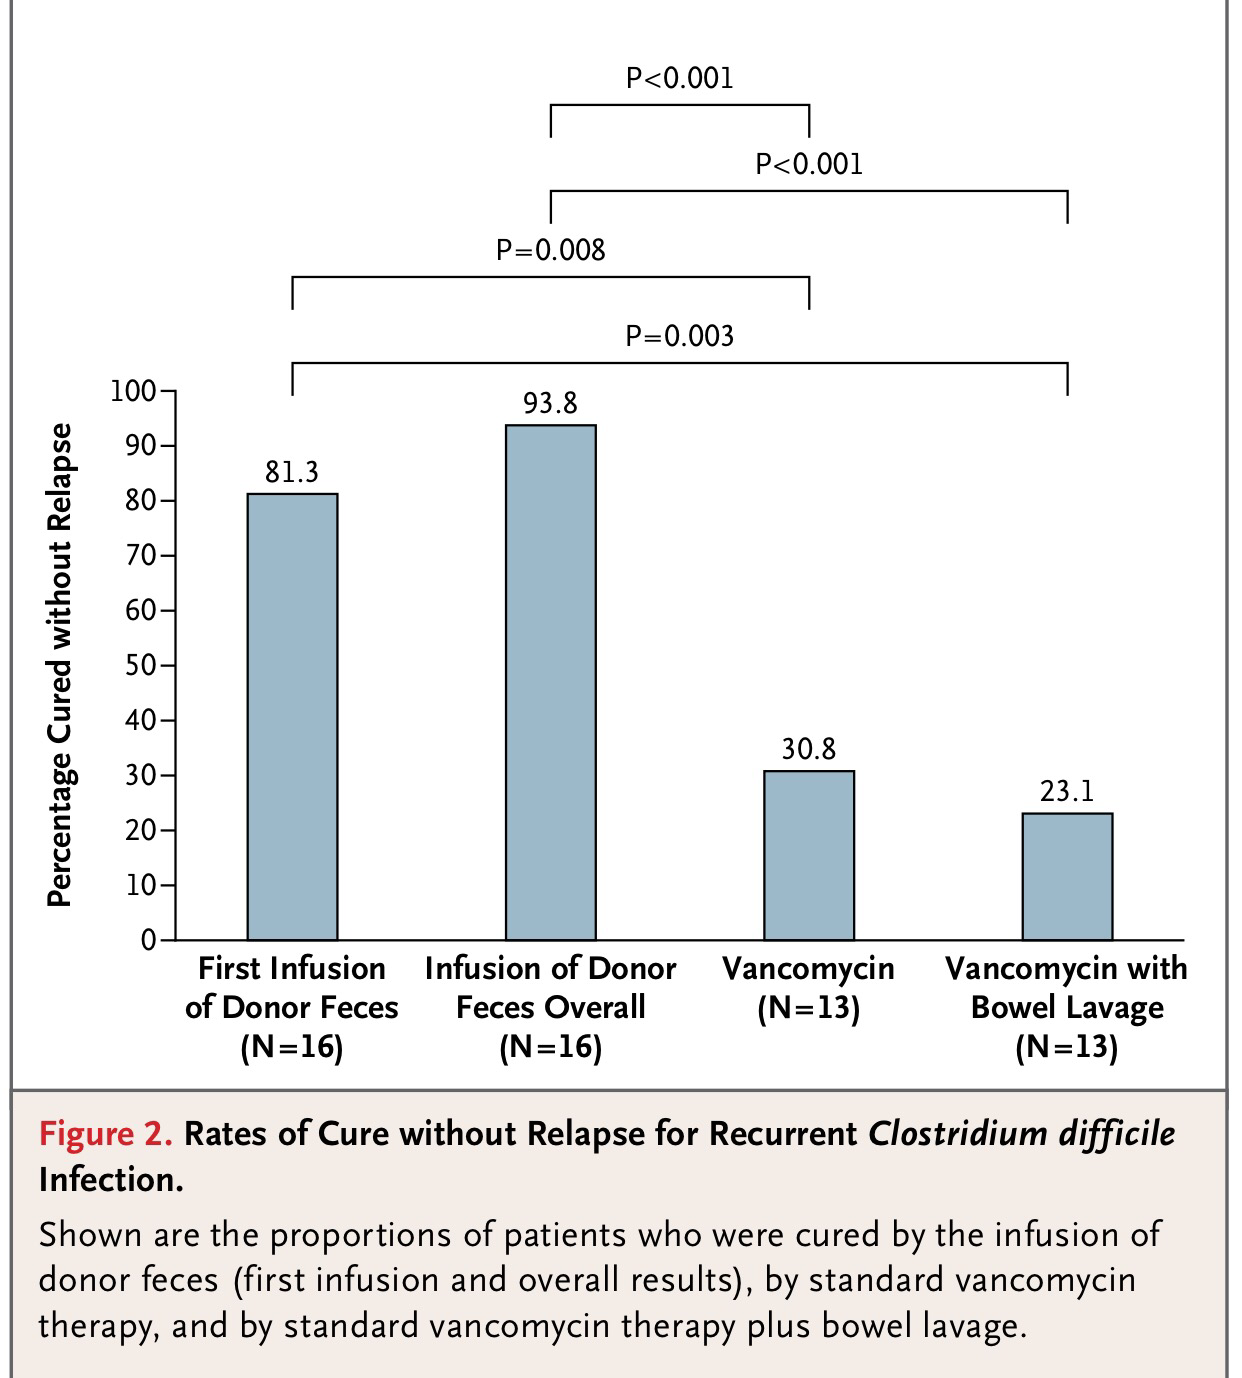
Los tamaños de muestra empleados son bajos, ciertamente. Sin embargo, los resultados son muy espectaculares, como puede verse a continuación:

IMG_0244


La técnica adecuada al caso, en este estudio, como puede verse en el cuadro del Tema 14, es el Test exacto de Fisher. Son dos poblaciones, porque las comparaciones se hacen dos a dos, como puede observarse, la variable estudiada es dicotómica (Hay o no curación sin recaída) y el tamaño de muestra por grupo es menor de 30 en todos los casos. En el cuadro importante comentado en el Tema 14 podrá verse que siguiendo estos pasos llegamos al Test exacto de Fisher. Es la técnica adecuada al caso, la que optimiza la decisión de si rechazar la Hipótesis nula de Igualdad de proporciones o, por el contrario, rechazarla y pasar a la Hipótesis alternativa que afirma que hay diferencia entre las proporciones.

El gráfico anterior nos muestra cuáles son las diferencias significativas, nos marca los p-valores que son menores que 0.05 y a través de los cuales, por lo tanto, podemos decir que las diferencias de proporciones muestrales obtenidas son diferencias significativas; o sea, son diferencias que pueden generalizarse a nivel poblacional. En este caso, esta generalización poblacional es de futuro. Se está diciendo, en realidad, que si se aplicara entonces los pacientes tratados con esas infusiones conseguirían índices de curación sin recaída superiores a los obtenidos con el tratamiento antibiótico convencional, con una probabilidad de equivocarse menor del 5%.

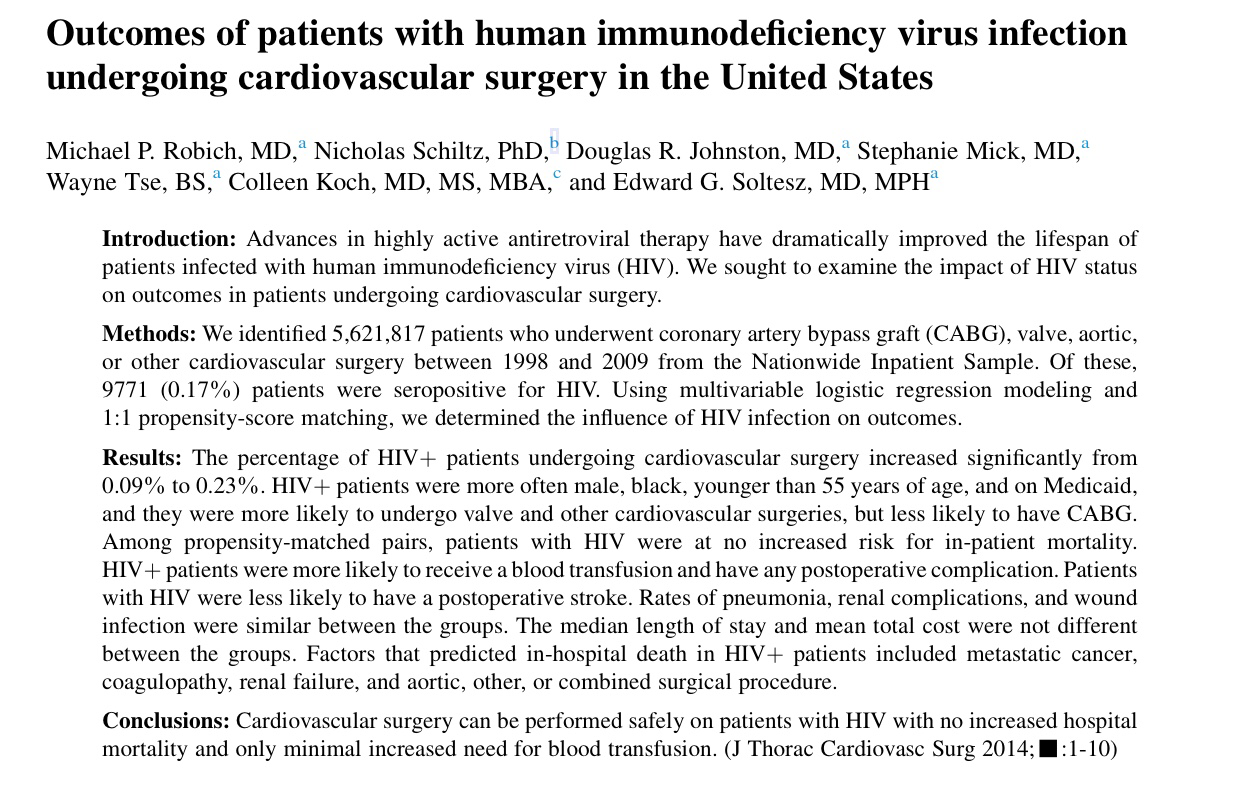
Artículo 5: Outcomes of patients with human immunodeficiency virus infection undergoing cardiovascular surgery in the United States

Este es un artículo muy interesante para ver una aplicación del Propensity Score Analysis en Medicina.

En este artículo se comparan los resultados obtenidos por cirugías cardiovasculares en pacientes HIV respecto a pacientes no HIV.

Comparaciones de este tipo constituyen retos muy habituales en Medicina. Se trata de estudios llamados observacionales, estudios donde se comparan dos grupos que han sido configurados de forma natural y espontánea, previamente al análisis estadístico que se efectúa. No se trata, por lo tanto, de estudios experimentales donde, de una forma organizada, se van repartiendo tratamientos diferentes a un conjunto de pacientes, dentro de unos parámetros previamente prefijados.

Los estudios observacionales son mucho más sencillos de hacer porque representa aprovecharse del esfuerzo clínico previo de mucha gente. Los resultados los tienes ya, sólo hace falta ponerte a analizarlos. Sin embargo, son más débiles en cuanto a nivel de evidencia de las conclusiones que se obtienen de ellos. Son muchos los posibles factores que pueden estar enmascarando, confundiendo e introduciendo sesgos en los resultados obtenidos mediante este tipo de estudios.

Los llamados estudios de Casos y Controles son un tipo muy frecuente de estos estudios observacionales. De hecho, el estudio presentado en este artículo podría ser llamado perfectamente así, aunque no es un arquetipo de lo que sería un estudio de Casos y Controles en Medicina, evidentemente. En los estudios de Casos y Controles se estudia la asociación de esos dos resultados con diferentes factores, con diferentes exposiciones a un riesgo o a un factor de protección. En este estudio, de hecho, los Casos y los Controles son las variables resultado: mortalidad y diferentes complicaciones. Y, fundamentalmente, el ser HIV positivo o negativo es el factor de exposición estudiado. Se quiere ver si ser HIV positivo es un factor de riesgo en los pacientes que han sido sometidos a una intervención quirúrgica cardiovascular.

Además, en este estudio, como se verá a continuación, se intenta evitar todos estos problemas presentes habitualmente en los estudios observacionales mediante la aplicación del Propensity Score Analysis. Esta técnica trata de evitar confusiones externas homogeneizando lo más posible los dos grupos a comparar.

El Abstract del artículo es el siguiente:

IMG_0202

Suele ser habitual en este tipo de estudios que haya una elevada desproporción de Controles respecto a los Casos que se tienen registrados en la muestra. Es justo lo que sucede en la muestra con la que se trabaja inicialmente en este estudio, como puede apreciarse perfectamente en las tablas siguientes.

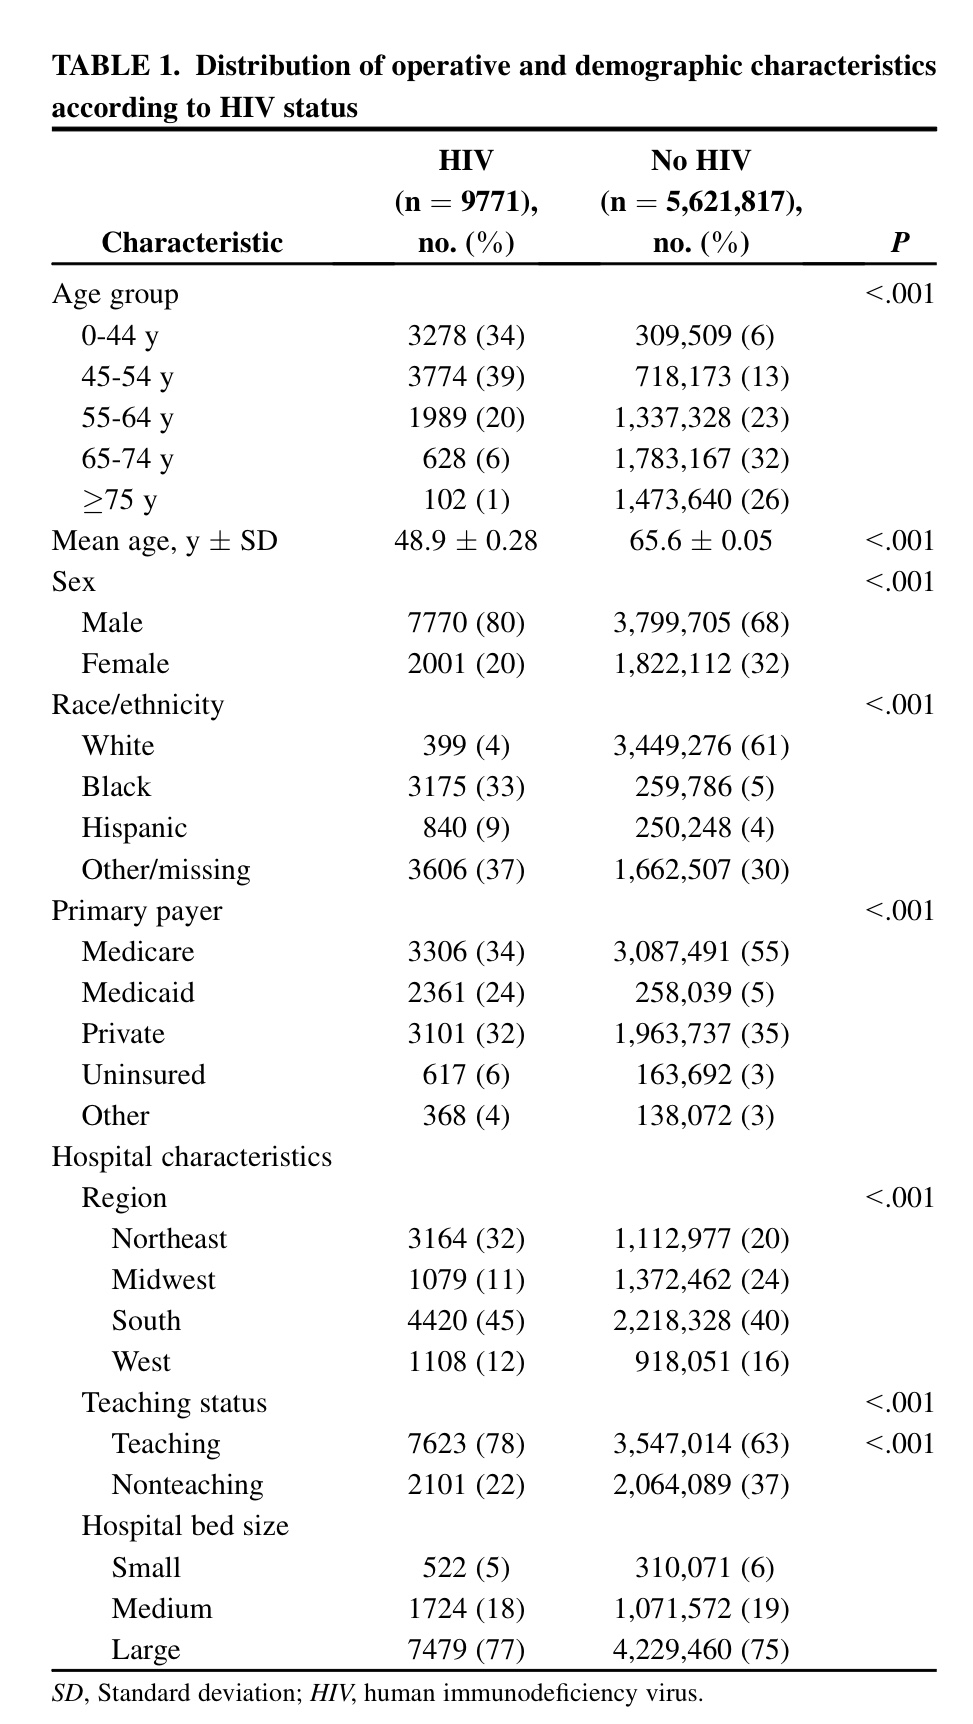
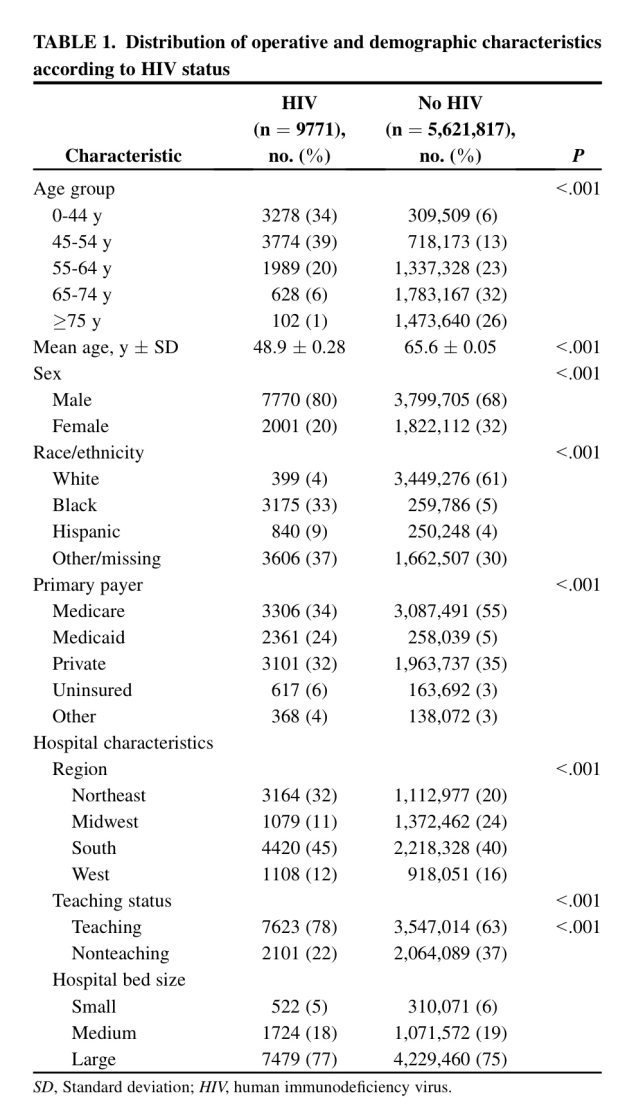
Veamos, en primer lugar, la comparación de los dos grupos del estudio en una serie de variables demográficas:
IMG_0203

Como puede verse hay enormes diferencias entre ambos grupos en cuanto a esas variables demográficas. Todas las variables excepto la Edad se comparan mediante un Test de la ji-cuadrado. La variable edad se compara con un Test de la t de Student de muestras independientes y varianzas iguales. Son las técnicas adecuadas al caso según puede verse a partir del cuadro comentado con detalle en el Tema 14: Comparación de dos poblaciones.

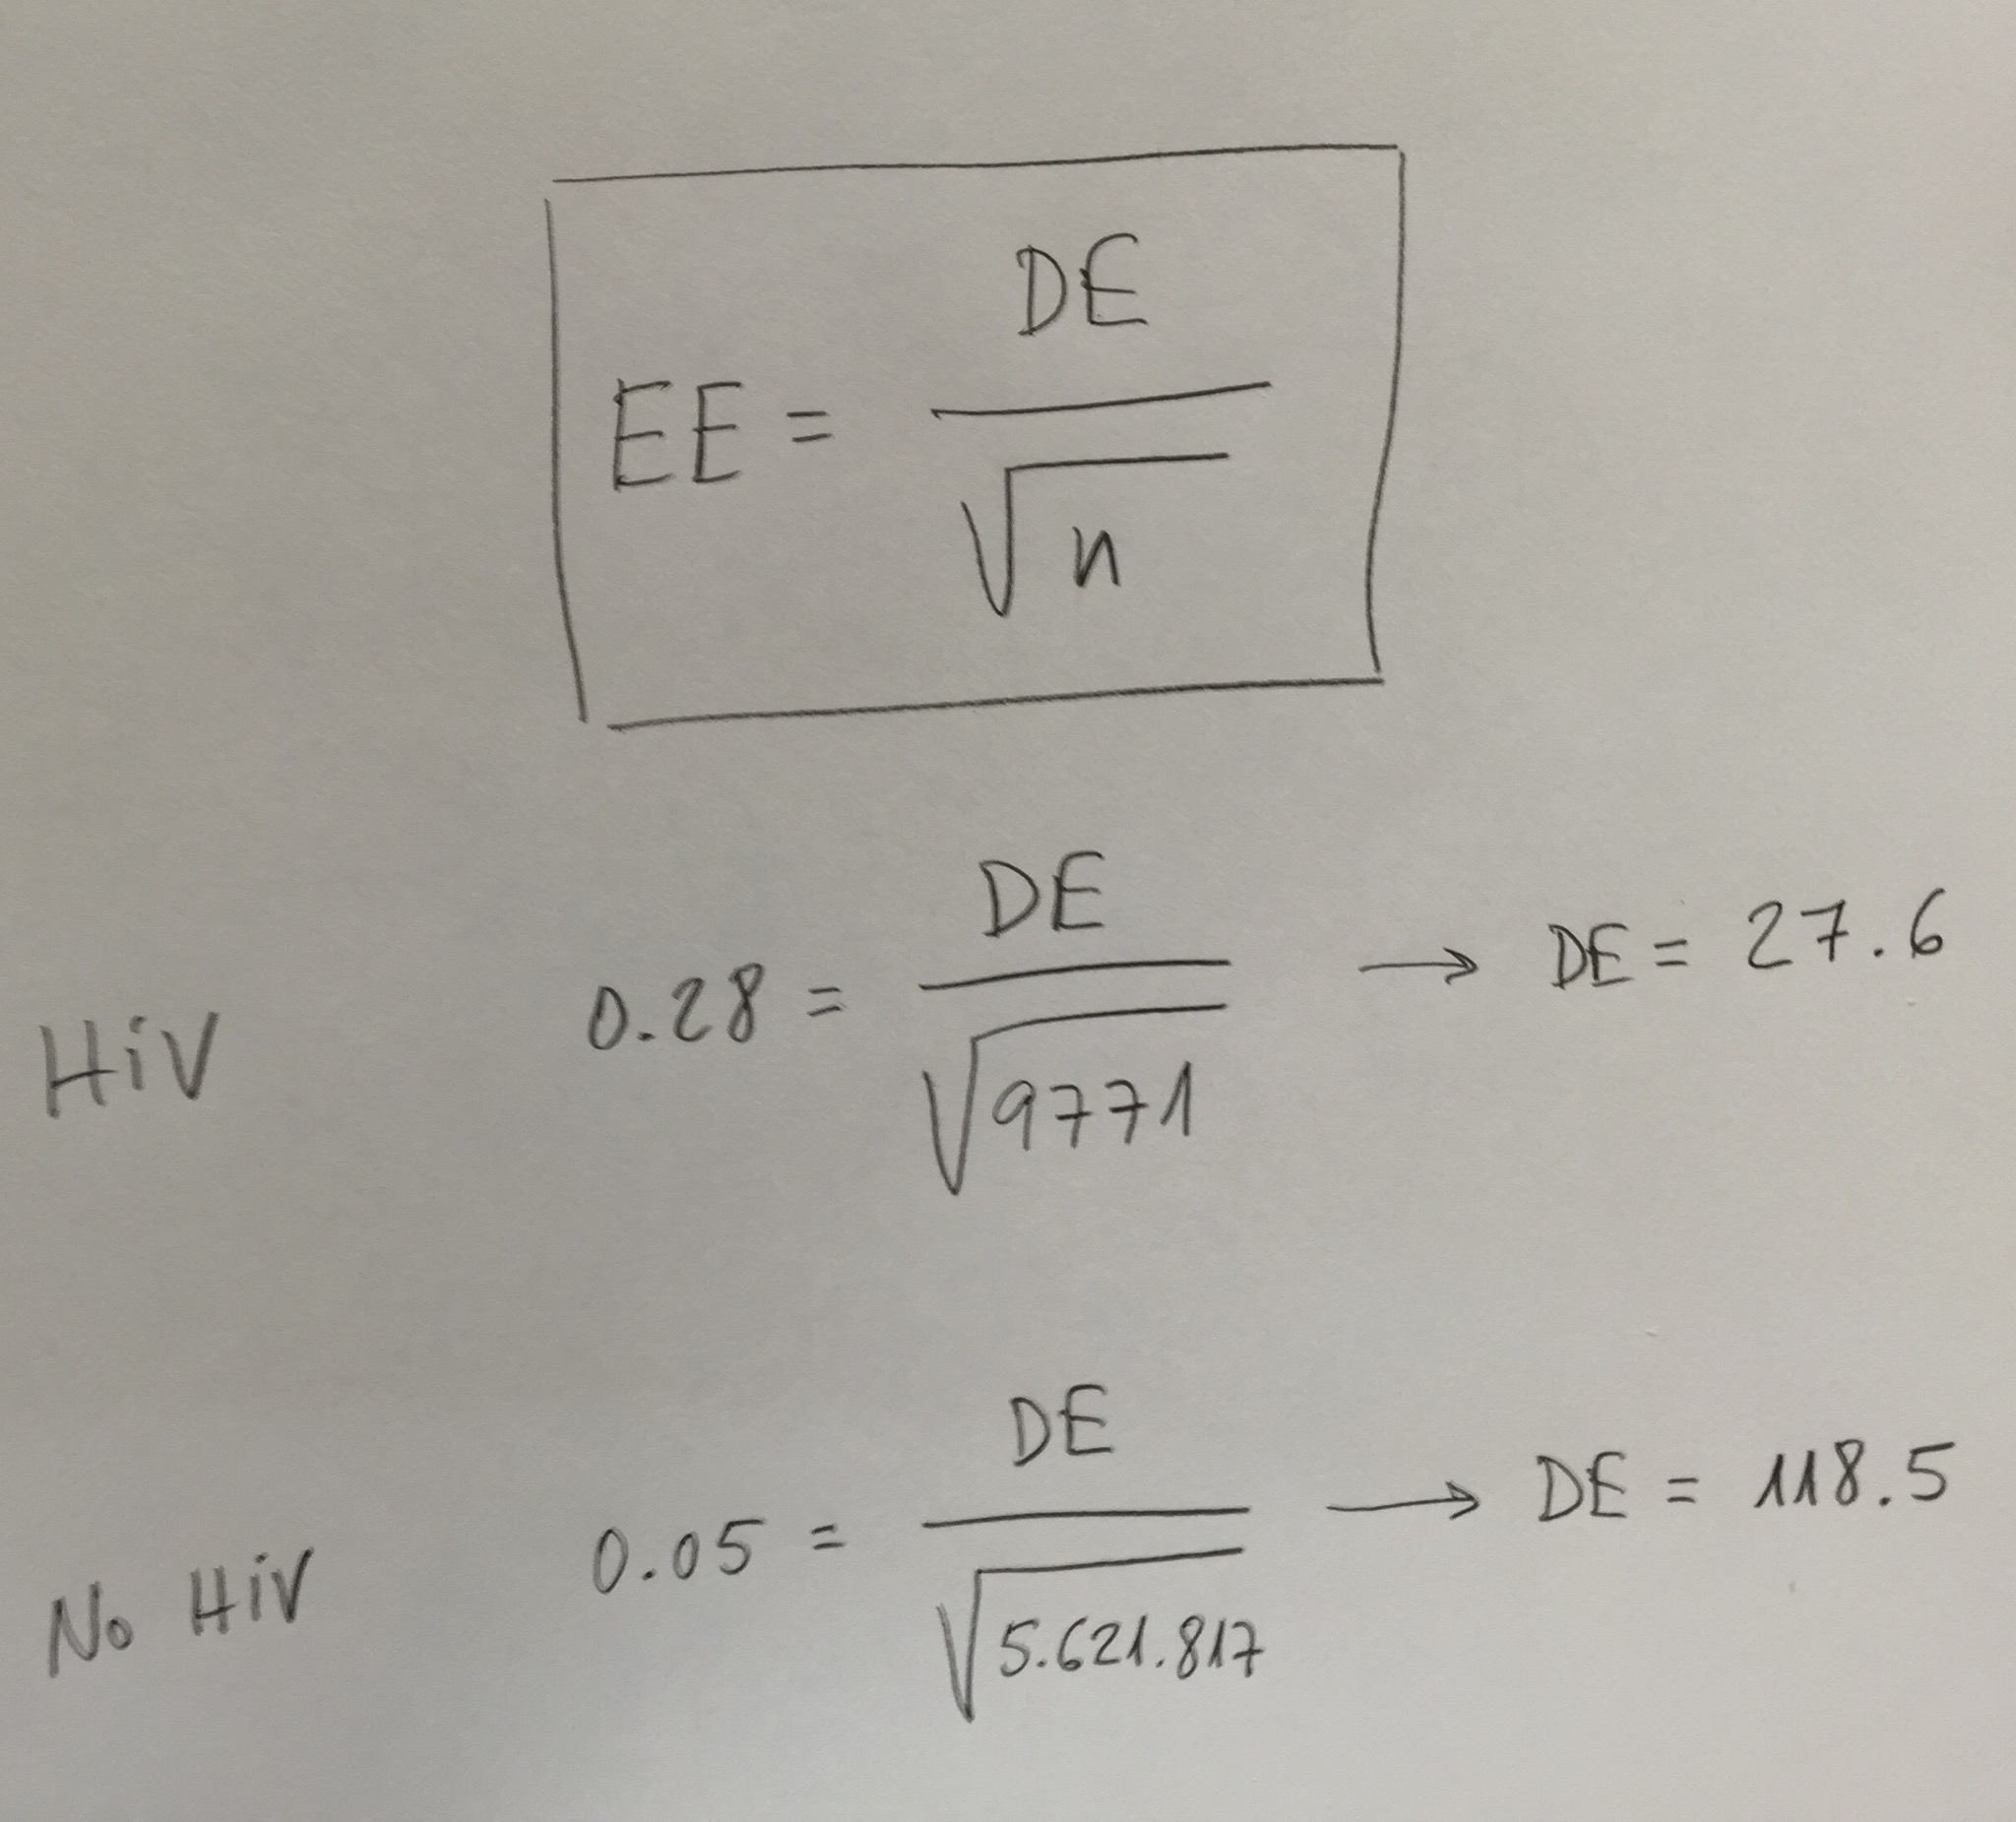
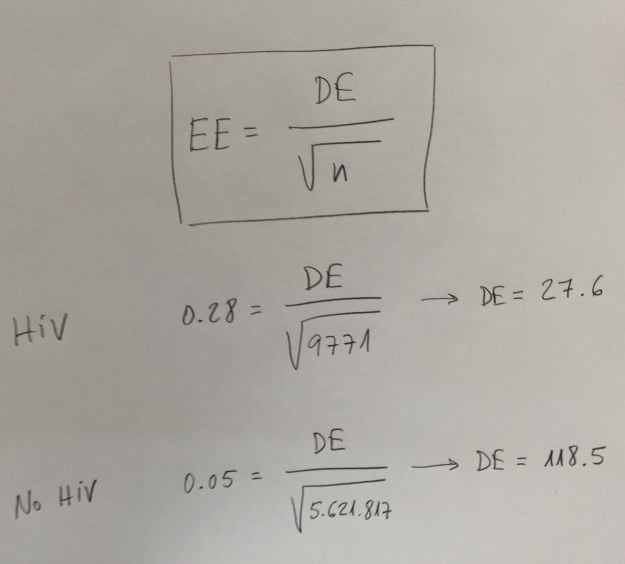
Sin embargo, observemos un error que hay en la variable Edad. Nos dicen que se da la media y la Desviación estándar (SD). Es como se suele presentar la descriptiva de una variable continua que se ajuste suficientemente bien a la distribución normal (Ver el artículo La Estadística descriptiva en Medicina).  Evidentemente no puede ser. Es imposible que se trate de la Desviación estándar. Las edades serían muy similares, demasiado similares, dentro de cada grupo. Pensemos que si hay ajuste a la normal sumar y restar dos veces la desviación estándar nos cubriría el 95% de los valores. En el caso de los No HIV deberían tener, prácticamente todos, los 5.621.817 de la muestra, 65 años. Podemos pensar, entonces, que se trata del Error estándar. Suele ser habitual confundir Desviación estándar con Error estándar. Pero, tampoco. Sabiendo el Error estándar y el tamaño de muestra podemos calcular la Desviación estándar, a partir de la relación que conocemos entre esos dos cálculos muestrales (Ver el Tema dedicado a los Intervalos de confianza):
IMG_0232

El Error estándar (EE) es igual a la Desviación estándar (DE) dividido por la raíz cuadrada del tamaño de muestra n. El Error estándar es la Desviación estándar de una predicción. La Desviación estándar es una medida de dispersión de las variables y el Error estándar es una medida de dispersión de predicciones.

En todo caso, lo que es también claro es que estas desviaciones estándar de las variable Edad en el grupo HIV y en el grupo No HIV tampoco pueden ser. Serían excesivas. En todo caso, si admitimos que son correctas debemos admitir, entonces, que en absoluto se ajustan a una distribución normal.

Bueno, a efectos del estudio, lo que parece evidente, y es lógico que sea así, es que hay una enorme diferencia en cuanto a edades de los dos grupos que estamos comparando.

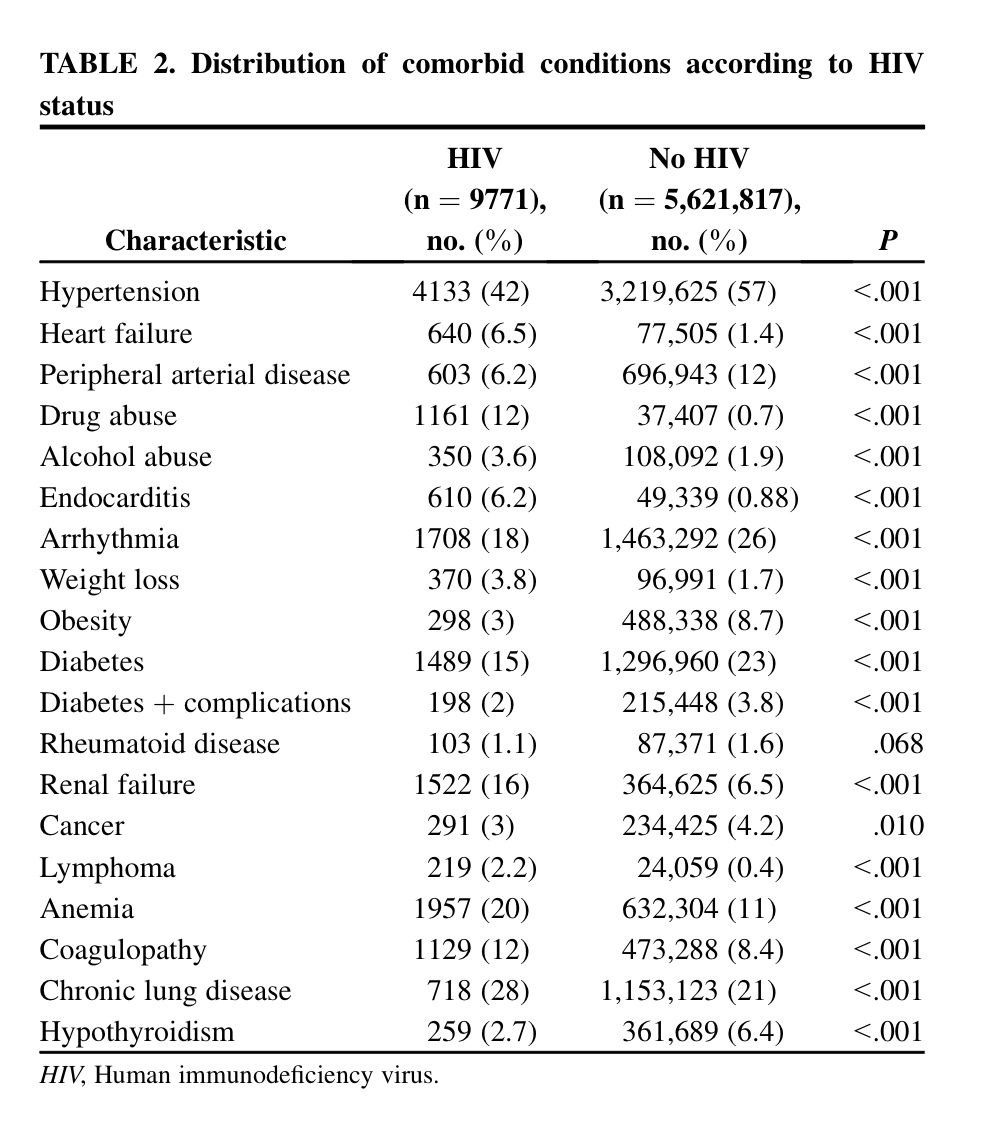
En la tabla siguiente se analizan más diferencias entre ambos grupos. Ahora son variables que evalúan las comorbilidades que presentan ambos grupos de pacientes:

IMG_0204

Diferencias muy importantes, pues, en cuanto a las comorbilidades. Se trata, pues, como es lógico, de perfiles de pacientes muy diferentes, en cuanto a la clínica, los que estamos comparando en este estudio.

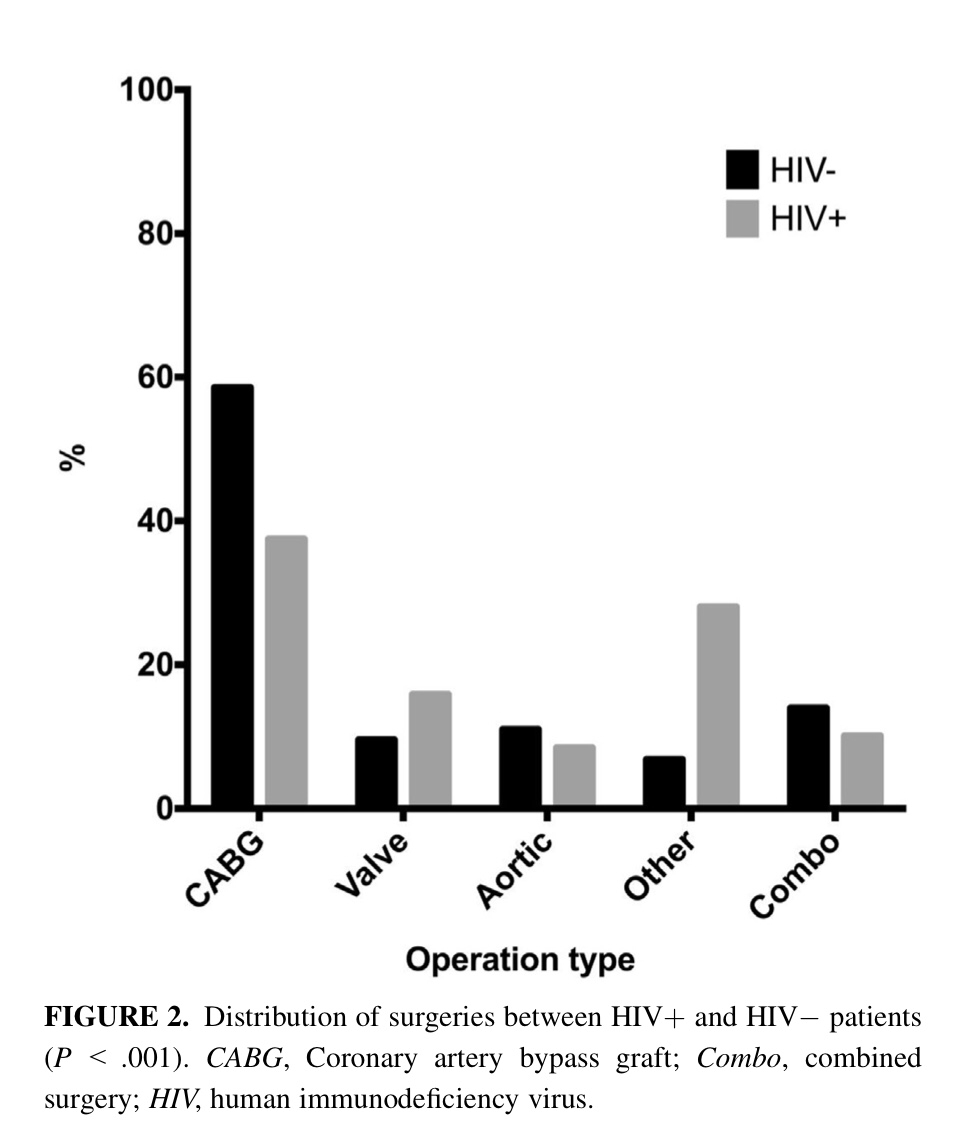
Más diferencias, aún, nos muestran los autores de este artículo. Ahora en cuanto al tipo de cirugías cardiovasculares practicadas en ambos grupos:

IMG_0205

Por lo tanto, comparar el éxito o fracaso de la cirugía cardiovascular, en ambos grupos, puede quedar perfectamente confundido por algunas de esas variables que presentan estas enormes diferencias entre ambos grupos. Este es un problema evidente en este tipo de estudios.

No podríamos ahora dedicarnos a evaluar variables resultado, variables que evalúen los resultados de las cirugías cardiovasculares entre estos dos grupos porque son dos grupos, tal como los tenemos ahora, y como lo hemos podido apreciar perfectamente en las tablas anteriores, muy diferentes y difícilmente comparables. Las diferencias que viéramos podrían ser atribuibles no al elemento que queremos comparar (ser o no HIV) sino a otros elementos que harían sesgar nuestras conclusiones.

Observemos una comparación de unas variables resultado en estos dos grupos tal cual, sin intervenir tratando de homogeneizarlos:

IMG_0208-2

Estas diferencias pueden ser, repito, explicadas no únicamente por el hecho de ser o no HIV los pacientes, sino por la gran diferencia que hay en otras variables que actuarían confundiéndose con las variables resultado y, por lo tanto, confundiéndonos, haciéndonos pensar que las diferencias son por ser pacientes con y sin HIV y, en realidad, ser atribuibles a otras causas. Este es el significado que habitualmente damos a las llamadas variables confusoras en un estudio.

Pues bien, necesitamos intervenir para evitar estas confusiones. El Propensity Score Analysis es una técnica que intenta evitar este problema. Trata de igualar los grupos a comparar. Y lo hace generando lo que se llama un Propensity Score a cada paciente del estudio. Tanto a los casos como a los controles. Este Score se calcula mediante una Regresión logística múltiple. Una Regresión logística donde la variable dependiente dicotómica es la variable ser Caso o ser Control. Por lo tanto, como en toda Regresión logística se obtiene una probabilidad de ser Caso o de ser Control en función de unos valores de las variables independientes utilizadas. La técnica lo que hace entonces es asociar puntos por Score próximo (Lo que suele denominarse un Matching, un apareamiento). Puede fijarse una ventana, un umbral a no superar. Los Casos que no tengan un Control lo suficientemente cercano serán rechazados para el estudio. Paciente con un Propensity Score próximo será porque serán próximos los valores de las variables que habremos utilizado como variables independientes. Esta es la forma automatizada de buscar pacientes que aunque son de los dos grupos presentan perfiles muy similares de las variables elegidas para la homogeneización.

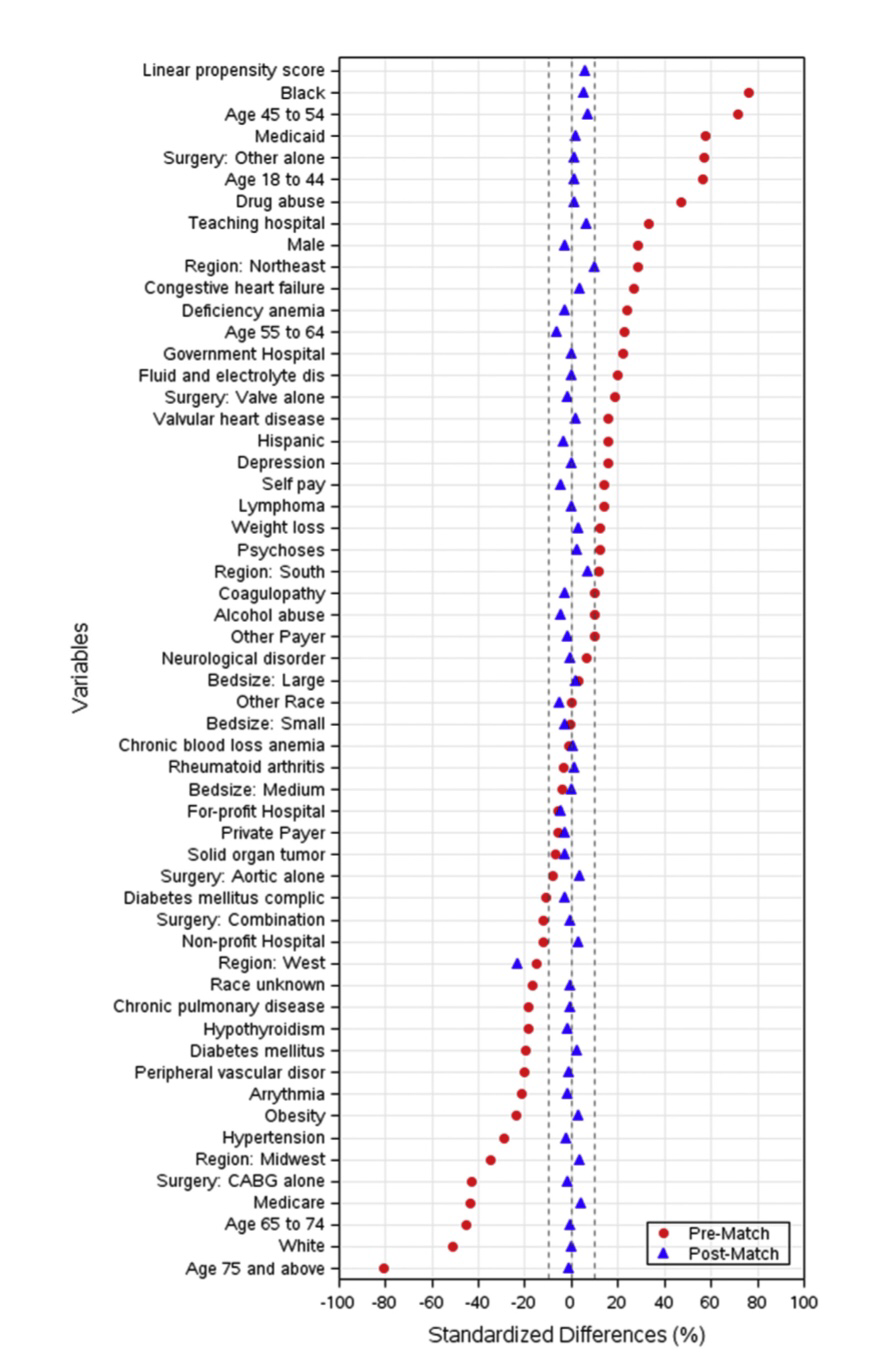
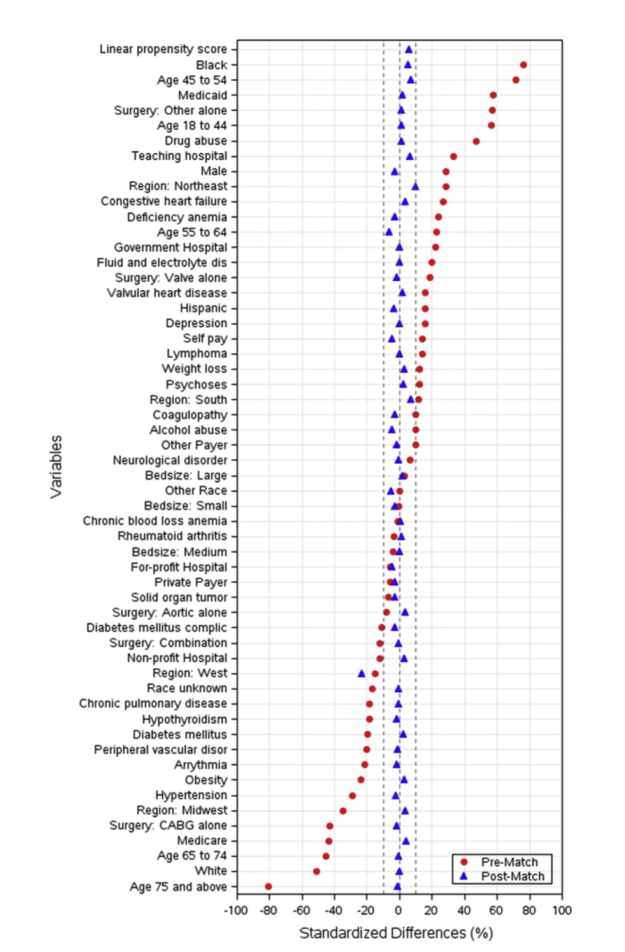
El gráfico que aportan los autores de este estudio y que a continuación se muestra es genial. Observemos una medida, variable por variable contemplada en el Propensity Score Analysis, de una diferencia estandarizada, entre ambos grupos, antes y después del Propensity.

¿Qué es y por qué se usa una diferencia estandarizada? Se hace para evitar deformaciones posibles debidas a la escala. No es lo mismo trabajar, por ejemplo, con hematíes que con creatinina. De forma absoluta no son comparables las diferencias de medias de ambas variables en ambos grupos. Lo mismo sucede al comparar porcentajes. Estandarizar una variable en Estadística significa transformarla para que tenga media 0 y desviación estándar 1. Así todas las variables estandarizadas son comparables. En nuestro caso, si la diferencia de medias o de porcentajes entre los dos grupos lo dividimos por la desviación estándar que tenemos también lo estamos estandarizando. Que es lo que, en realidad, se hace aquí. Así todas las variables son más comparables en cuanto a la diferencia que hay entre los dos grupos:
IMG_0209-2

Veamos un ejemplo de esto que acabamos de ver. Tomemos las dos primeras variables de la Tabla 2: La hipertensión y el fallo cardíaco: Si restamos los porcentajes vemos que en la hipertensión tenemos una diferencia de un 15% entre ambos grupos (Un 42% en HIV y un 57% en No HIV). En fallo cardíaco la diferencia es sólo de un 5.1% (Un 6.5% en HIV y un 1.4% en No HIV). Es obvio que un 15% es mucho mayor, en valor absoluto, a 5.1%, pero si lo relativizamos respecto a la dispersión que tenemos al movernos en torno a un porcentaje de 42 al 57% o respecto a la dispersión que tenemos en torno al 6.5% y el 1.4%, la cosa cambia. Hay mucha más dispersión en una variable que está próxima al 50% que en una que está próxima al 4%. Hay más saltos de un valor a otro en la primera y, por el contrario, más monotonía en la segunda. Esto debe ponderarse. Miremos cómo quedaría:

IMG_0235

En valor absoluto tenemos una diferencia del 15% en hipertensión y un 5.1% en fallo cardíaco. Sin embargo, al estandarizar la diferencia, estamos hablando de un 30% y un 26%, valores mucho más igualados.

En el gráfico anterior podemos ver cómo han cambiado las diferencias estandarizadas entre ambos grupos al realizar el Propensity Score Analysis. Nunca había visto hasta ahora un gráfico que lo ilustrara tan bien. Antes del Propensity hay grandes diferencias, a veces a favor de un grupo, a veces en contra. Después del Propensity se ha conseguido homogeneizar los grupos. Se están comparando grupos más homogéneos, se está eliminando confusión, sesgos.

Una vez se han encontrado los dos grupos ahora se trata, pues, de compararlos.

Observemos, no obstante, antes, que los dos grupos son de 1633. No están todos los HIV. Seguramente porque ha habido muchos casos que no han tenido un buen control apareado lo suficientemente próximo.

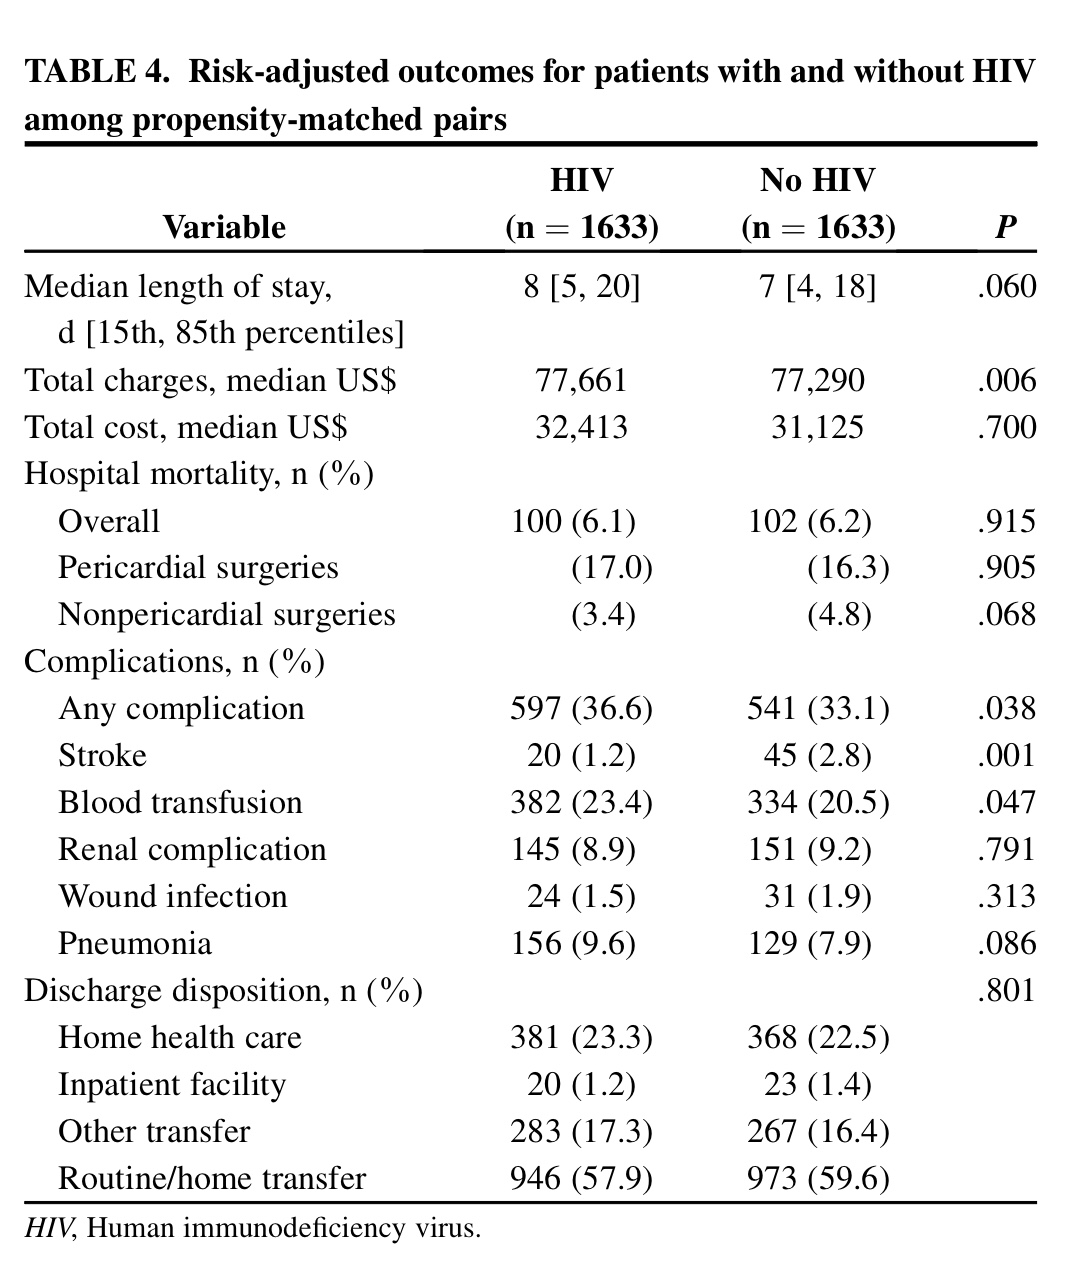
En las tablas siguientes se comparan esos dos grupos, ahora ya homogeneizados. Se ha seleccionado, pues, entre los No HIV un grupo homogéneo al grupo HIV. Y esto nos permite ver que en cuanto a las variables resultado estudiadas estos dos grupos homogenizados ya no presentan diferencias significativas, excepto en cuanto a la necesidad de transfusiones, donde hay un leve aumento de riesgo en los pacientes HIV, como se comenta en las conclusiones del Abstract.

IMG_0210-2

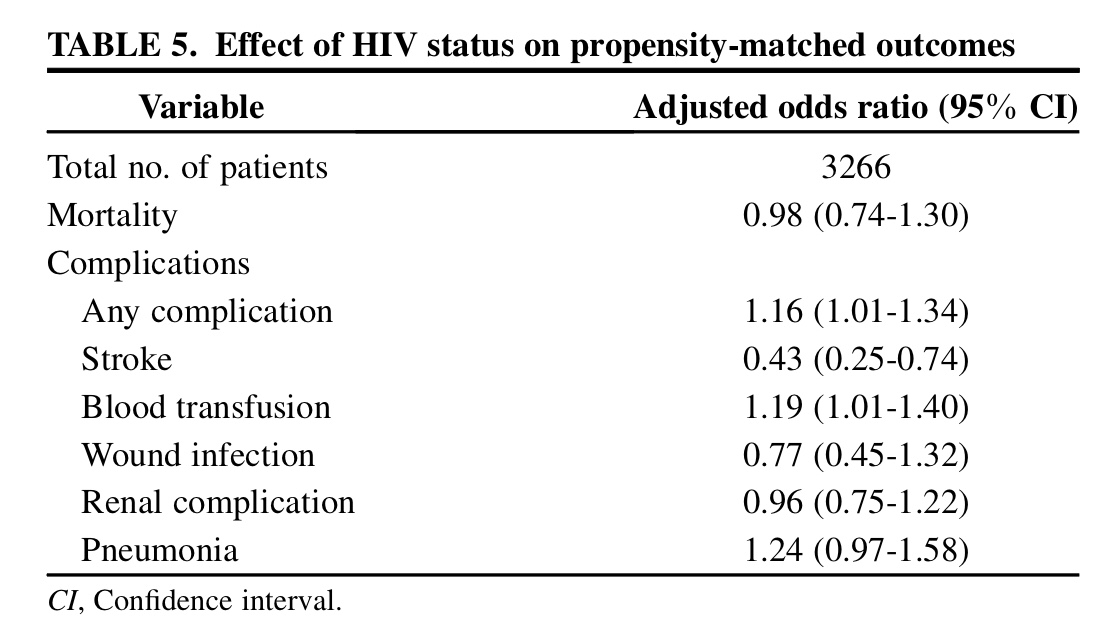
En la siguiente tabla se calculan las Odds ratio ajustadas (Ajustadas por la homogeneización que supone el Propensity) para unas variables resultado donde se mide la cantidad de asociación, si es que la hay significativa, con el ser o no HIV:

IMG_0212

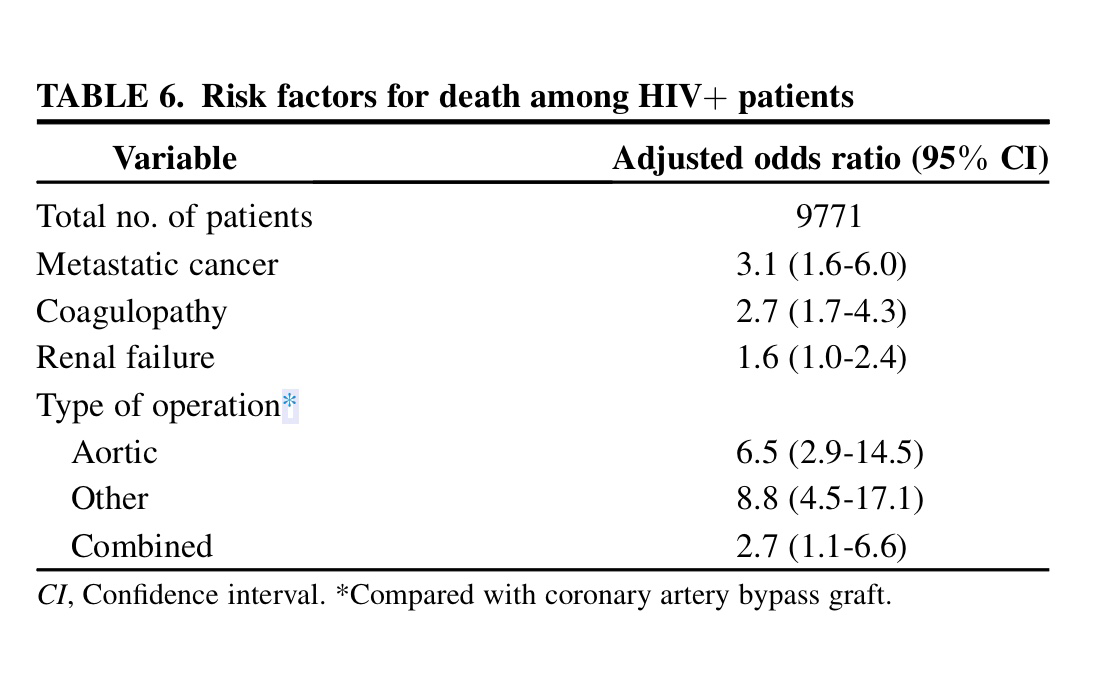
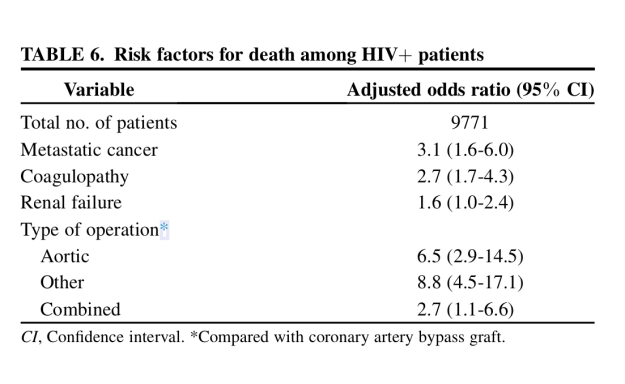
En la tabla siguiente también aportada por los autores de este artículo se aprovecha la información de todos los casos que se tiene de pacientes con HIV operados para analizar factores asociados con la mortalidad:
IMG_0211-2

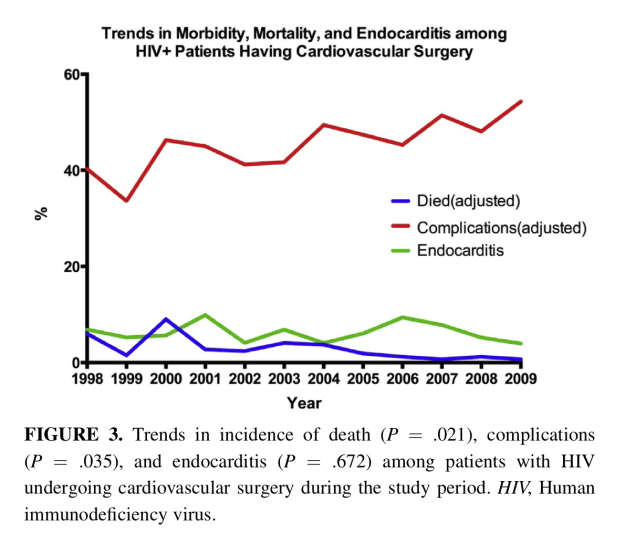
Finalmente el estudio nos aporta un gráfico de la evolución a lo largo del tiempo de una serie de variables de interés (Mortalidad, Complicaciones y Endocarditis) detectando si hay una pendiente estadísticamente significativa. Como puede verse, y el p-valor así lo certifica, hay una pendiente significativa y negativa en la Mortalidad, significativa y positiva en las Complicaciones y no hay pendiente significativa en la incidencia de Endocarditis.
IMG_0240


Artículo 1: Osteoporosis in women with Anorexia nervosa

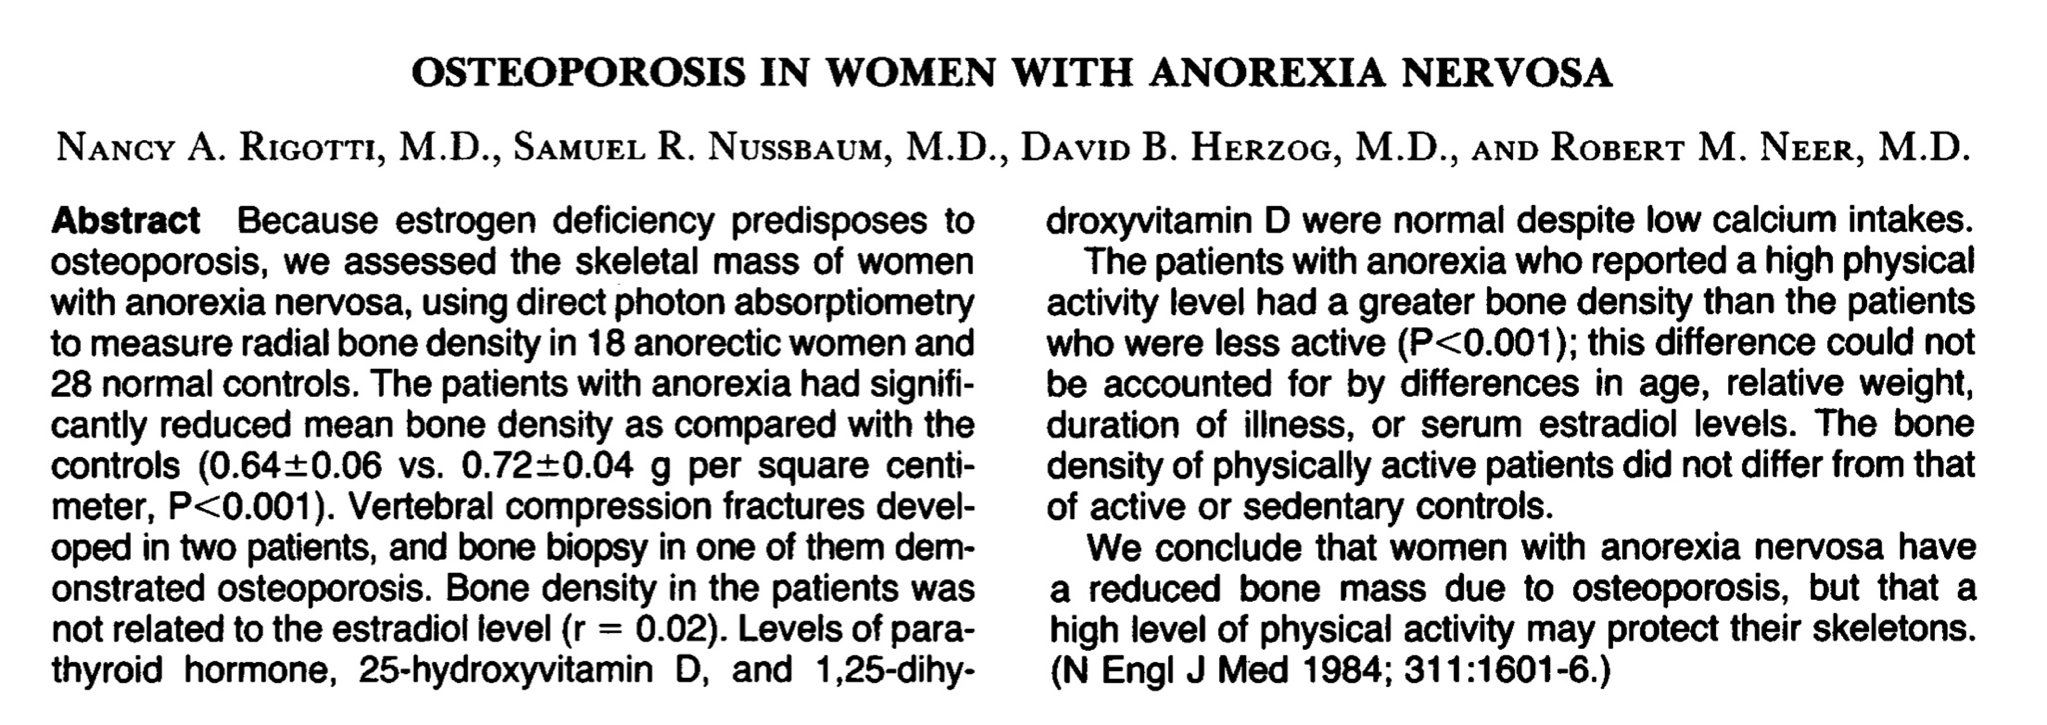
Este es un artículo clásico en Medicina, aparecido en 1984 en el New England Journal of Medicine.

El Abstract es el siguiente:

IMG_0219

Es un artículo sencillo pero excelente para establecer un primer contacto con la Estadística aplicada a las ciencias de la salud.

El objetivo básico es comparar el nivel de densidad ósea entre un grupo de mujeres diagnosticadas de Anorexia nervosa y un grupo control; o sea, un grupo equivalente de mujeres que no tienen el diagnóstico de ese trastorno de la alimentación.

Al diseñar esos dos grupos el estudio también clasifica a las mujeres, de ambos grupos (anoréxicas y controles), en dos nuevos grupos: según su tipo de vida pueda considerarse de bajo o de alto nivel de actividad. Es verdad que el nivel de actividad no es una variable dicotómica, hay muchos niveles distintos de grado de actividad, sin embargo, los autores del estudio lo acaban transformando en esos dos grupos, estableciendo presumiblemente un determinado nivel umbral.

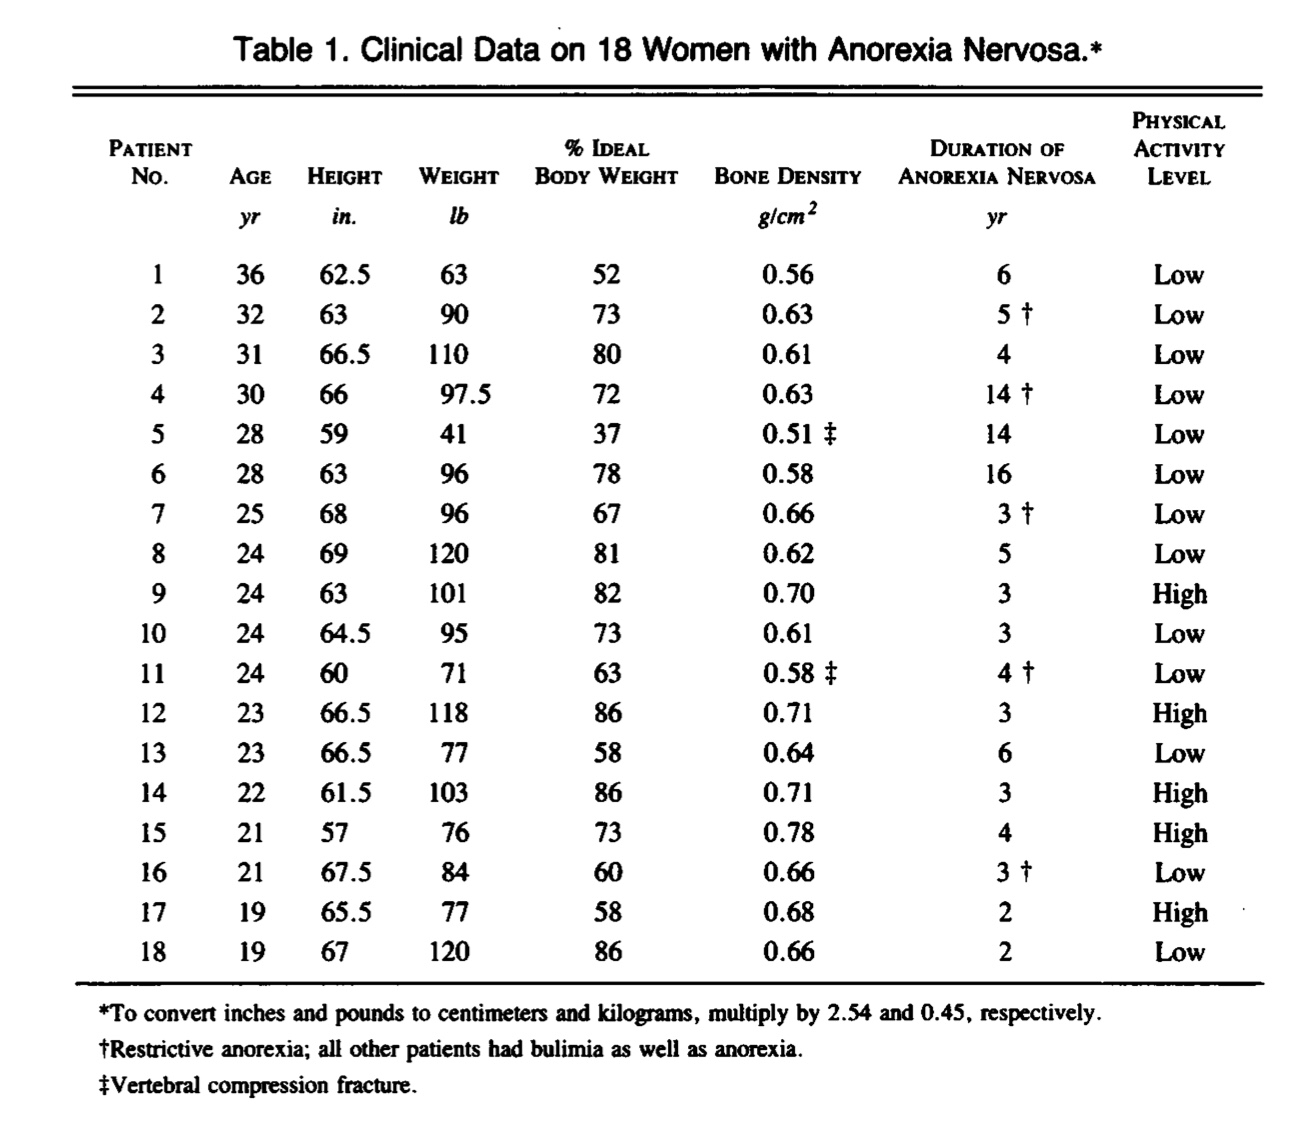
En una tabla del artículo se describen las características de las 18 pacientes con Anorexia nervosa. Esto es interesante como introducción a lo que una base de datos en estudios de este tipo. Es una matriz donde las filas son los pacientes y las columnas las distintas variables estudiadas:

IMG_0220

Como puede verse ya en el Abstract, se nos proporciona resúmenes descriptivos por grupo: se nos da la media y la desviación estándar de la densidad ósea en cada uno de los dos grupos principales del estudio (anoréxicas y controles), expresado como es habitual con el más/menos.

En este artículo aparece también la noción de p-valor, como medida de la significación. Concepto nuclear en Estadística y en cualquier Ciencia, por supuesto.
La finalidad del estudio, como ya hemos dicho, es comparar esos cuatro grupos comentados. Para comparar los cuatro grupos aplican un Test de Kruskal-Wallis y obtienen un p-valor inferior a 0.05. Por lo tanto, hablan de diferencias estadísticamente significativas entre esos cuatro grupos. Lo que significa que podemos inferir, con poca probabilidad de error de equivocarnos, que esas diferencias deben existir a nivel poblacional, no únicamente a nivel muestral.

A continuación hacen comparaciones dos a dos entre los cuatro grupos, que es lo más trascendente del estudio. Explicando, por cierto, muy bien qué técnica de comparación aplican en cada momento. Lo hacen siguiendo los conceptos que están presentes en el Tema 14: Comparación de dos poblaciones.

La presentación de los resultados se hace, desde el punto de vista de un profesor de Estadística, de forma genial. Es una auténtica clase de Estadística, como se puede ver a continuación:

IMG_0221

Viendo esta tabla poco le queda para decir a un profesor de Estadística. De hecho, lo que consigue hacer visualizar un artículo como éste es extraordinario. Artículos como éste se encuentran a faltar cuando uno ve actualmente algunos artículos que los resultados cuestan ser interpretados incluso para los que nos dedicamos desde hace muchos años a la Estadística.

Observemos que viendo las cuatro muestras parece muy claro que a la hora de compararlas podremos usar técnicas paramétricas. Ninguna de ellas es claramente anormal (en Estadística anormal significa que no se ajusta a la campana de Gauss). Por lo tanto, podremos aplicar el Test de la t de Student, que es lo que hacen. Y las varianzas son también del mismo orden, por lo tanto, parece lógico aplicar el Test de la t de Student para varianzas iguales.

Observemos que marcan dos comparaciones como diferentes significativamente. La que hay entre mujeres anoréxicas y controles a bajo nivel de actividad. Y la que hay en mujeres anoréxicas entre las de bajo y alto nivel de actividad. Esto es lo que les lleva a la conclusión del estudio que aparece en el Abstract del artículo.

El artículo también comenta que no se ha encontrado relación entre el nivel de estradiol de la paciente y la densidad ósea. Habla de la r, que es la correlación de Pearson. No encuentra relación.

Es importante este artículo, pues, como se puede ver, porque en él vemos integrados las tres familias de técnicas estadística: descriptivas, de relación y de comparación, comentadas en el Tema 1. Hay descripción, hay inferencia. Hay evaluación de posibles relaciones. Hay comparación entre grupos.

Repito: un magnífico ejercicio para introducirse en el mundo apasionante de la Estadística y su relación con las ciencias de la salud.

Solución Situación 70

1. Estamos ante una situación que podemos modelizar mediante un ANOVA de dos factores fijos y cruzados. Cada factor con dos niveles. El modelo puede verse en el artículo ANOVA de dos factores a efectos fijos.

El Test de Shapiro-Wilk aplicado a los residuos del modelo proporcionan un p-valor de 0.4535 lo que permite no rechazar la hipótesis nula de ajuste a la distribución normal. Si se aplica el Test de Levene para comprobar la igualdad de varianzas el p-valor es 0.84 y si se aplica el Test de Bartlett el p-valor es 0.74. Por lo que podemos aceptar la igualdad de varianzas.

La tabla ANOVA es la siguiente:

IMG_0190


Son significativos los tres contrastes. Los tres p-valores son menores que 0.05.

Observemos el gráfico de interacciones.IMG_0191

Los coeficientes del modelo son los siguientes:

IMG_0192

Observemos que los coeficientes del modelo serán la constante 13.56, los parámetros del factor mucolítico: 9.08 y -9.08, los del factor corticoide: -3.75 y 3.75 y los cuatro de la interacción: 4.36, -4.36, 4.36 y -4.36. La componente de la varianza residual es 10.94.


2. La situación se puede modelizar mediante un ANOVA de dos factores cruzados uno fijo y el otro aleatorio. Puede verse la estructura del modelo en el artículo ANOVA de dos factores mixtos.

La tabla ANOVA y las estimaciones de las componentes de la varianza son los siguientes:

IMG_0196-0

El cálculo de las componentes de la varianza, en base a las ecuaciones de las esperanzas de los cuadrados medios, es el siguiente:

IMG_0197

Los dos parámetros para el factor fijo «método» pueden obtenerse de la media de cada uno de los dos grupos restándoles, respectivamente, la media general:

IMG_0198

Para el cálculo que nos piden debemos suponer que hay un ajuste a la normal con la media la del método M1, que es 28.39, y como desviación estándar la raíz cuadrada de la suma de las tres componentes de la varianza del modelo (puede discutirse si tomar la de la interacción porque no es significativa); o sea, la raíz cuadrada de 10.2288+1.08435+5.79969, que es 4.13. Por lo tanto, debemos calcular el área que hay por debajo de 29 en la normal: N(28.39, 4.13).

Este área es 0,5587. O sea, un 55.87%.


3. Se trata de un diseño que se puede modernizar con tres factores fijos cruzados. La tabla ANOVA es la siguiente:

IMG_0193

Hay dos factores significativos: el fondo y la estación. Las comparaciones múltiples para estación dan el siguiente resultado:

IMG_0194

La tabla de medias es la siguiente:

IMG_0195

Situación 70: Examen (Tema 15) Problemas ANOVA

1. Se ensayan dos tipos diferentes de fármacos mucolíticos concretos (a y b) y dos tipos distintos de corticoides (1 y 2), también concretos, para ver el cambio que se produce en una variable que marca el nivel de la situación inflamatoria de un paciente. La variable respuesta analizada es el valor de esa variable «Después menos Antes». Los resultados son los siguientes:

Mucolít   Cortic      Después menos Antes

a              1              24,1

a              1              18,4

a              1              27,3

a              2              21,7

a              2              24

a              2              20,4

b             1              -0,2

b             1              -5,8

b             1              -4,9

b             2              16,4

b             2              11,2

b             2              10,2


Elegir el modelo ANOVA que se ajustaría a esta situación experimental y comprobar las condiciones del modelo.

Resolver el diseño.

2. Un laboratorio de análisis clínicos realiza el siguiente experimento respecto a la medida de una variable bioquímica sanguínea: Le interesa comparar dos procedimientos analíticos diferentes concretos (M1 y M2) y la variabilidad existente entre diferentes operarios. Se toma, para ello, una muestra homogénea de sangre y se escogen tres operarios al azar entre el grupo amplio de operarios que trabajan en ese laboratorio. Cada uno de los tres operarios realiza tres mediciones de la muestra con un método de análisis y otras tres con el otro método. Los resultados obtenidos son los siguientes:

Mètodo      Operario         Medida

M1                         1              27,46

M1                         1              26,33

M1                         1              32,78

M1                         2              25,05

M1                         2              22,92

M1                         2              22,93

M1                         3              31,5

M1                         3              36,1

M1                         3              30,48

M2                         1              16,66

M2                         1              20,89

M2                         1              19,52

M2                         2              12,98

M2                         2              17,99

M2                         2              16,62

M2                         3              19,28

M2                         3              21,23

M2                         3              19,58

Plantear el modelo y resolverlo.

Calcular la probabilidad de que con el método M1 el valor obtenido sea menor que 29.

3. Se quiere estudiar el efecto de la granulometria del fondo marino (Fina/Granítica), de la estación del año y del nivel de contaminación orgànica (Alto/Bajo) en la diversidad de una sèrie de organismos marinos. Se ha elegido ocho zones, dos con fondo fino y contaminación alta, dos con fondo fino y contaminación baja, dos con fondo granítico y contaminación alta, dos con fondo granítico y contaminación baja. Se ha evaluado el nivel de diversidad en las cuatro estaciones con el índice de Shannon-Weaver.

Los resultados son los siguientes:

FONDO     CONTAMINACIÓN          ESTACIÓN             DIVERSIDAD

FINA                       ALTA                      PRIMAVERA         0,5685

FINA                       ALTA                      PRIMAVERA         0,4971

FINA                       ALTA                      VERANO                0,7296

FINA                       ALTA                      VERANO                0,9903

FINA                       ALTA                      OTOÑO                  0,5543

FINA                       ALTA                      OTOÑO                  0,3388

FINA                       ALTA                      INVIERNO             0,1315

FINA                       ALTA                      INVIERNO             0,0032

FINA                       BAJA                      PRIMAVERA         0,7185

FINA                       BAJA                      PRIMAVERA         0,4172

FINA                       BAJA                      VERANO                0,6768

FINA                       BAJA                      VERANO                0,5912

FINA                       BAJA                      OTOÑO                  0,0956

FINA                       BAJA                      OTOÑO                  0,718

FINA                       BAJA                      INVIERNO             0,076

FINA                       BAJA                      INVIERNO             0,1861

GRANÍTICA          ALTA                      PRIMAVERA         0,6264

GRANÍTICA          ALTA                      PRIMAVERA         0,657

GRANÍTICA          ALTA                      VERANO                0,7061

GRANÍTICA          ALTA                      VERANO                0,944

GRANÍTICA          ALTA                      OTOÑO                  0,7574

GRANÍTICA          ALTA                      OTOÑO                  0,6267

GRANÍTICA          ALTA                      INVIERNO             0,3857

GRANÍTICA          ALTA                      INVIERNO             0,7496

GRANÍTICA          BAJA                      PRIMAVERA         0,6805

GRANÍTICA          BAJA                      PRIMAVERA         0,9141

GRANÍTICA          BAJA                      VERANO                0,8809

GRANÍTICA          BAJA                      VERANO                0,9628

GRANÍTICA          BAJA                      OTOÑO                  0,5621

GRANÍTICA          BAJA                      OTOÑO                  0,7111

GRANÍTICA          BAJA                      INVIERNO             0,6584

GRANÍTICA          BAJA                      INVIERNO             0,2386

Resolver el diseño.

Valoración de políticos

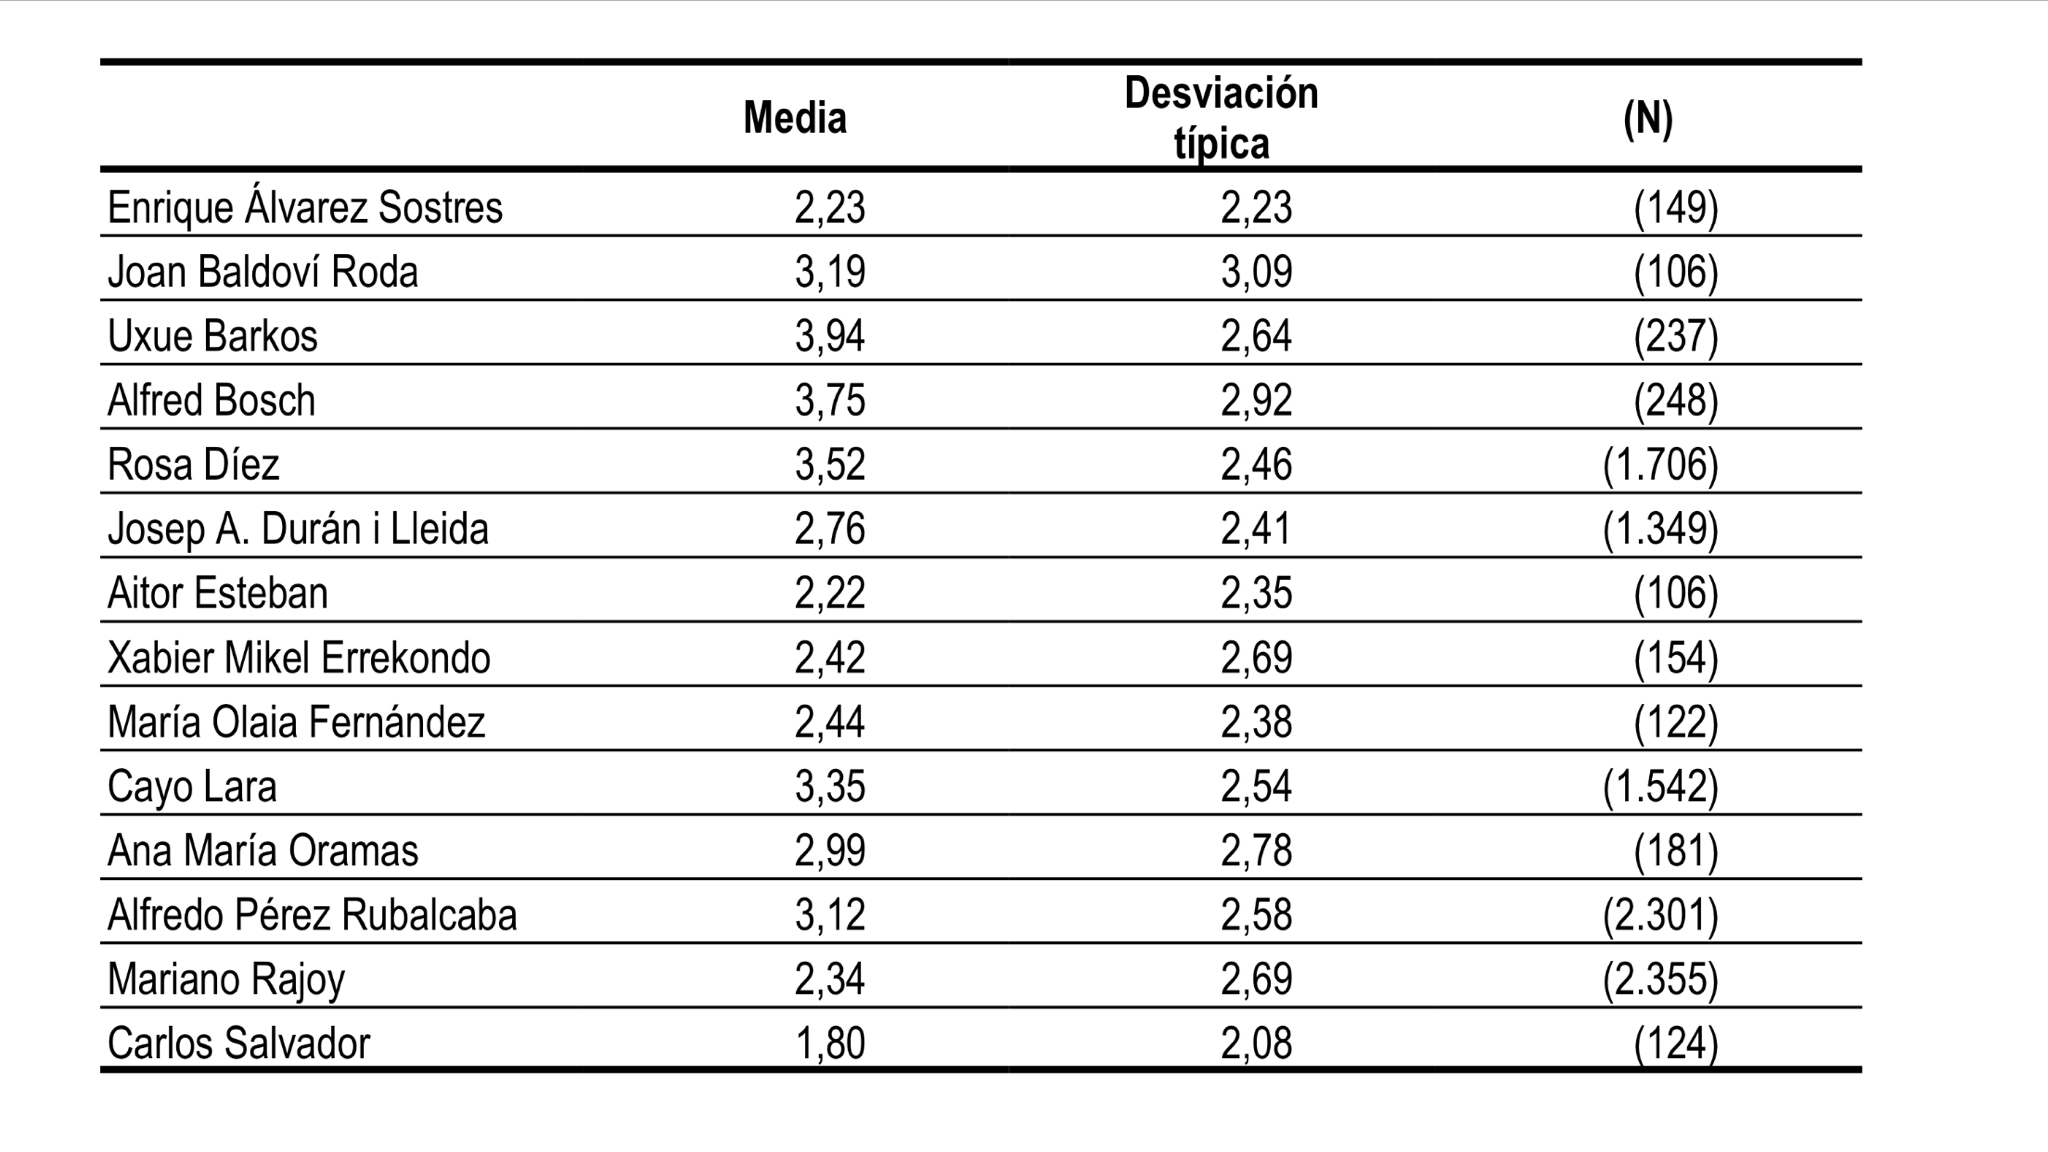
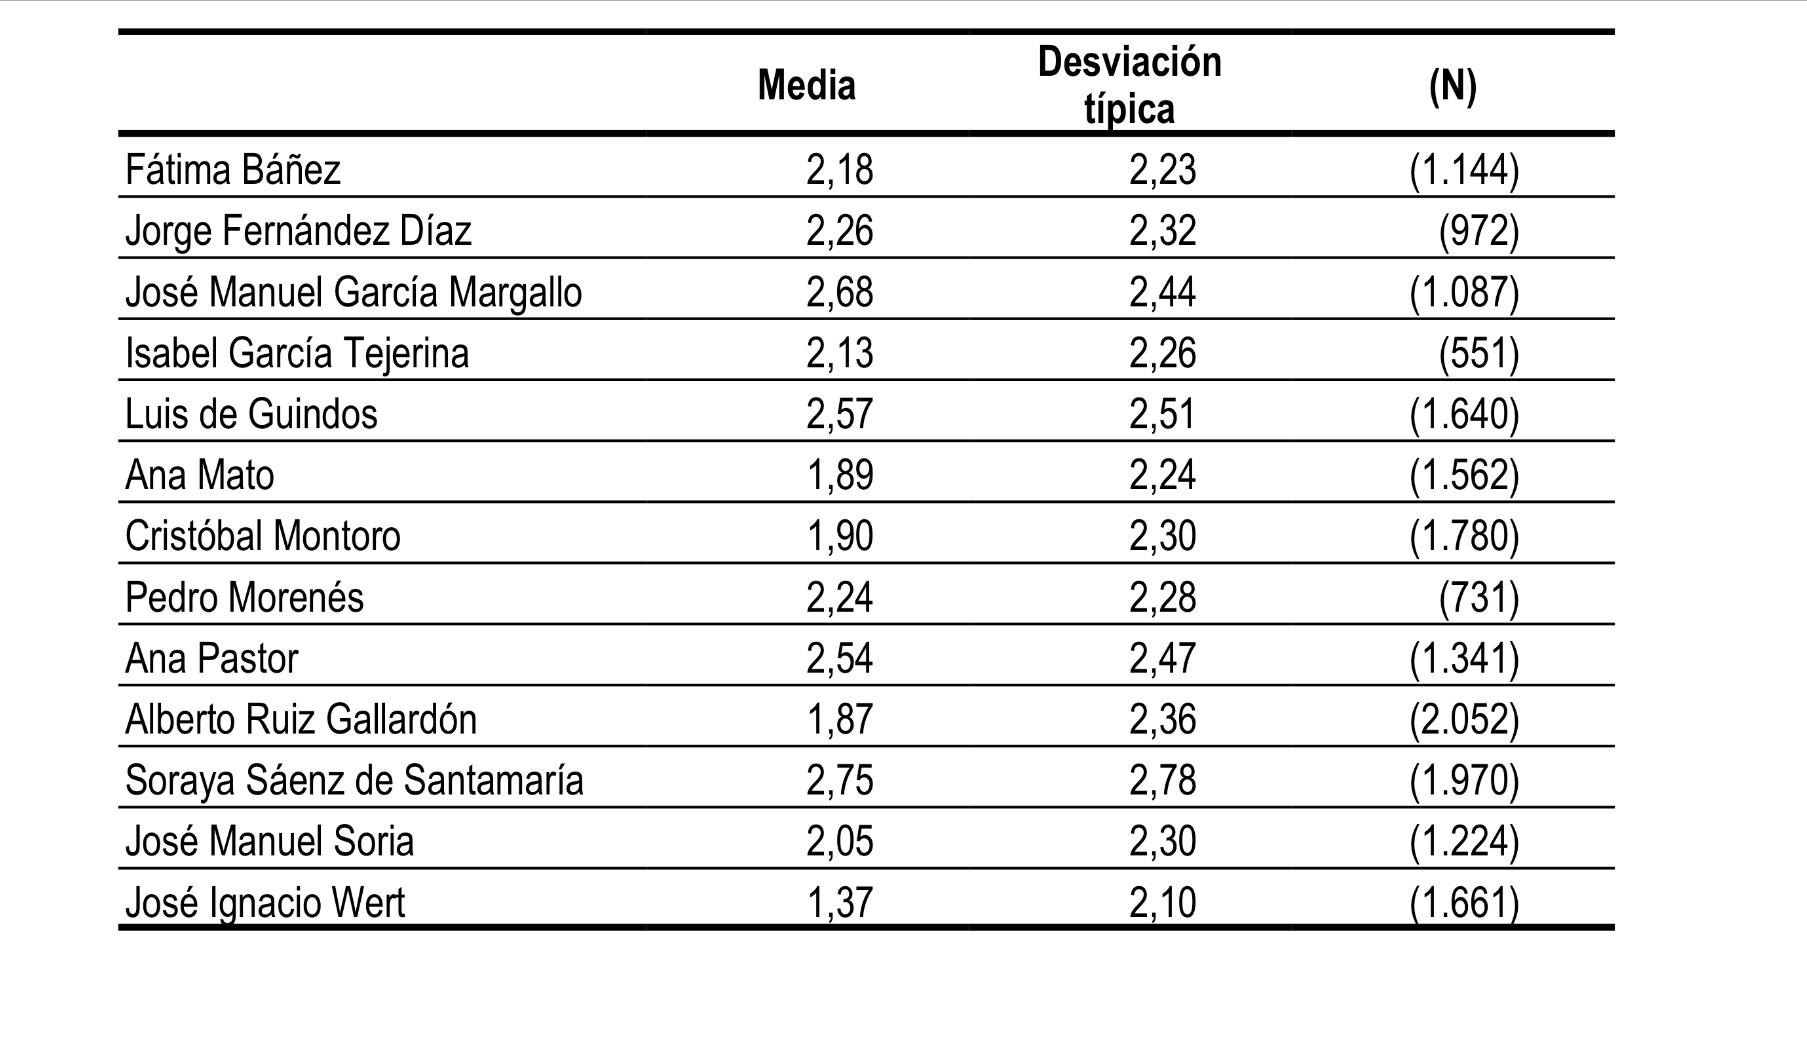
A continuación pueden verse los resultados de valoración de políticos en España extraídos del Barómetro del CIS de julio de 2014.

Puede verse que el valor aquí de la desviación típica (Desviación estándar) no puede ser el que le podríamos dar si las valoraciones se ajustaran a la distribución normal. Es evidente que no se produce tal ajuste en estos datos. Observemos que la Desviación estándar es del mismo orden que la media. Es evidente que si aplicáramos la inferencia de sumar y restar una vez y dos veces la desviación estándar a la media (asignando el 68.5% y el 95% de los valores poblacionales) estaríamos haciendo un evidente error.

IMG_0156.PNG

IMG_0157.PNG

Solución Situación 69

1a: Si se ordena la muestra es: (-4, -1, 0, 0, 5, 18, 23). Como el tamaño de muestra es impar la mediana es el valor del medio: 0.

2b: Si se ordena la muestra es: (-18, -4, -2, 0, 0, 5, 7, 123). El primer cuartil es -3 porque es el promedio de -4 y -2. El tercer cuartil es 6 porque es el promedio de 5 y 7. El rango intercuartílico es 6-(-3)=9.

3: Box-Plot 2: Porque el mínimo es 2, el primer cuartil es 3, la mediana 6, el tercer cuartil es 8 y el máximo es 12.

4: Curva 4.

5d.


Situación 69: Examen (Tema 2)

1. ¿Cuál es la mediana de la muestra (-1, 5, -4, 18, 0, 0, 23)?

a. 0.

b. 18.

c. -1.

d. 24.

2. ¿Cuál es rango intercuartílico de la muestra (-2, 5, -4, -18, 0, 0, 123, 7)?

a. 141.

b. 9.

c. 5.

d. 18.

3. ¿Cuál de los siguientes Box-Plot es el correspondiente a la muestra (2, 2, 4, 6, 6, 7, 9, 12)?

IMG_0073

4. ¿Cuál de las siguientes curvas de Lorenz es la correspondiente a la muestra (5, 5, 15, 25, 50)?

IMG_0074

5. ¿Cuál de las siguientes afirmaciones es cierta?

a. El índice de Gini es más grande cuanta menor dispersión haya entre los valores de una muestra.

b. Si la desviación estándar de una muestra es 0 el índice de Gini es 1.

c. Si la desviación estándar de una muestra es muy grande el índice de Gini puede ser mayor que 1.

d. La relación que hay, en una muestra, entre el índice de Gini y la desviación estándar es una relación directa: o sea, valores grandes del índice en una muestra van asociados a valores grandes de la desviación estándar en esa misma muestra, y, paralelamente, valores pequeños del índice van asociados a valores pequeños de desviación estándar.