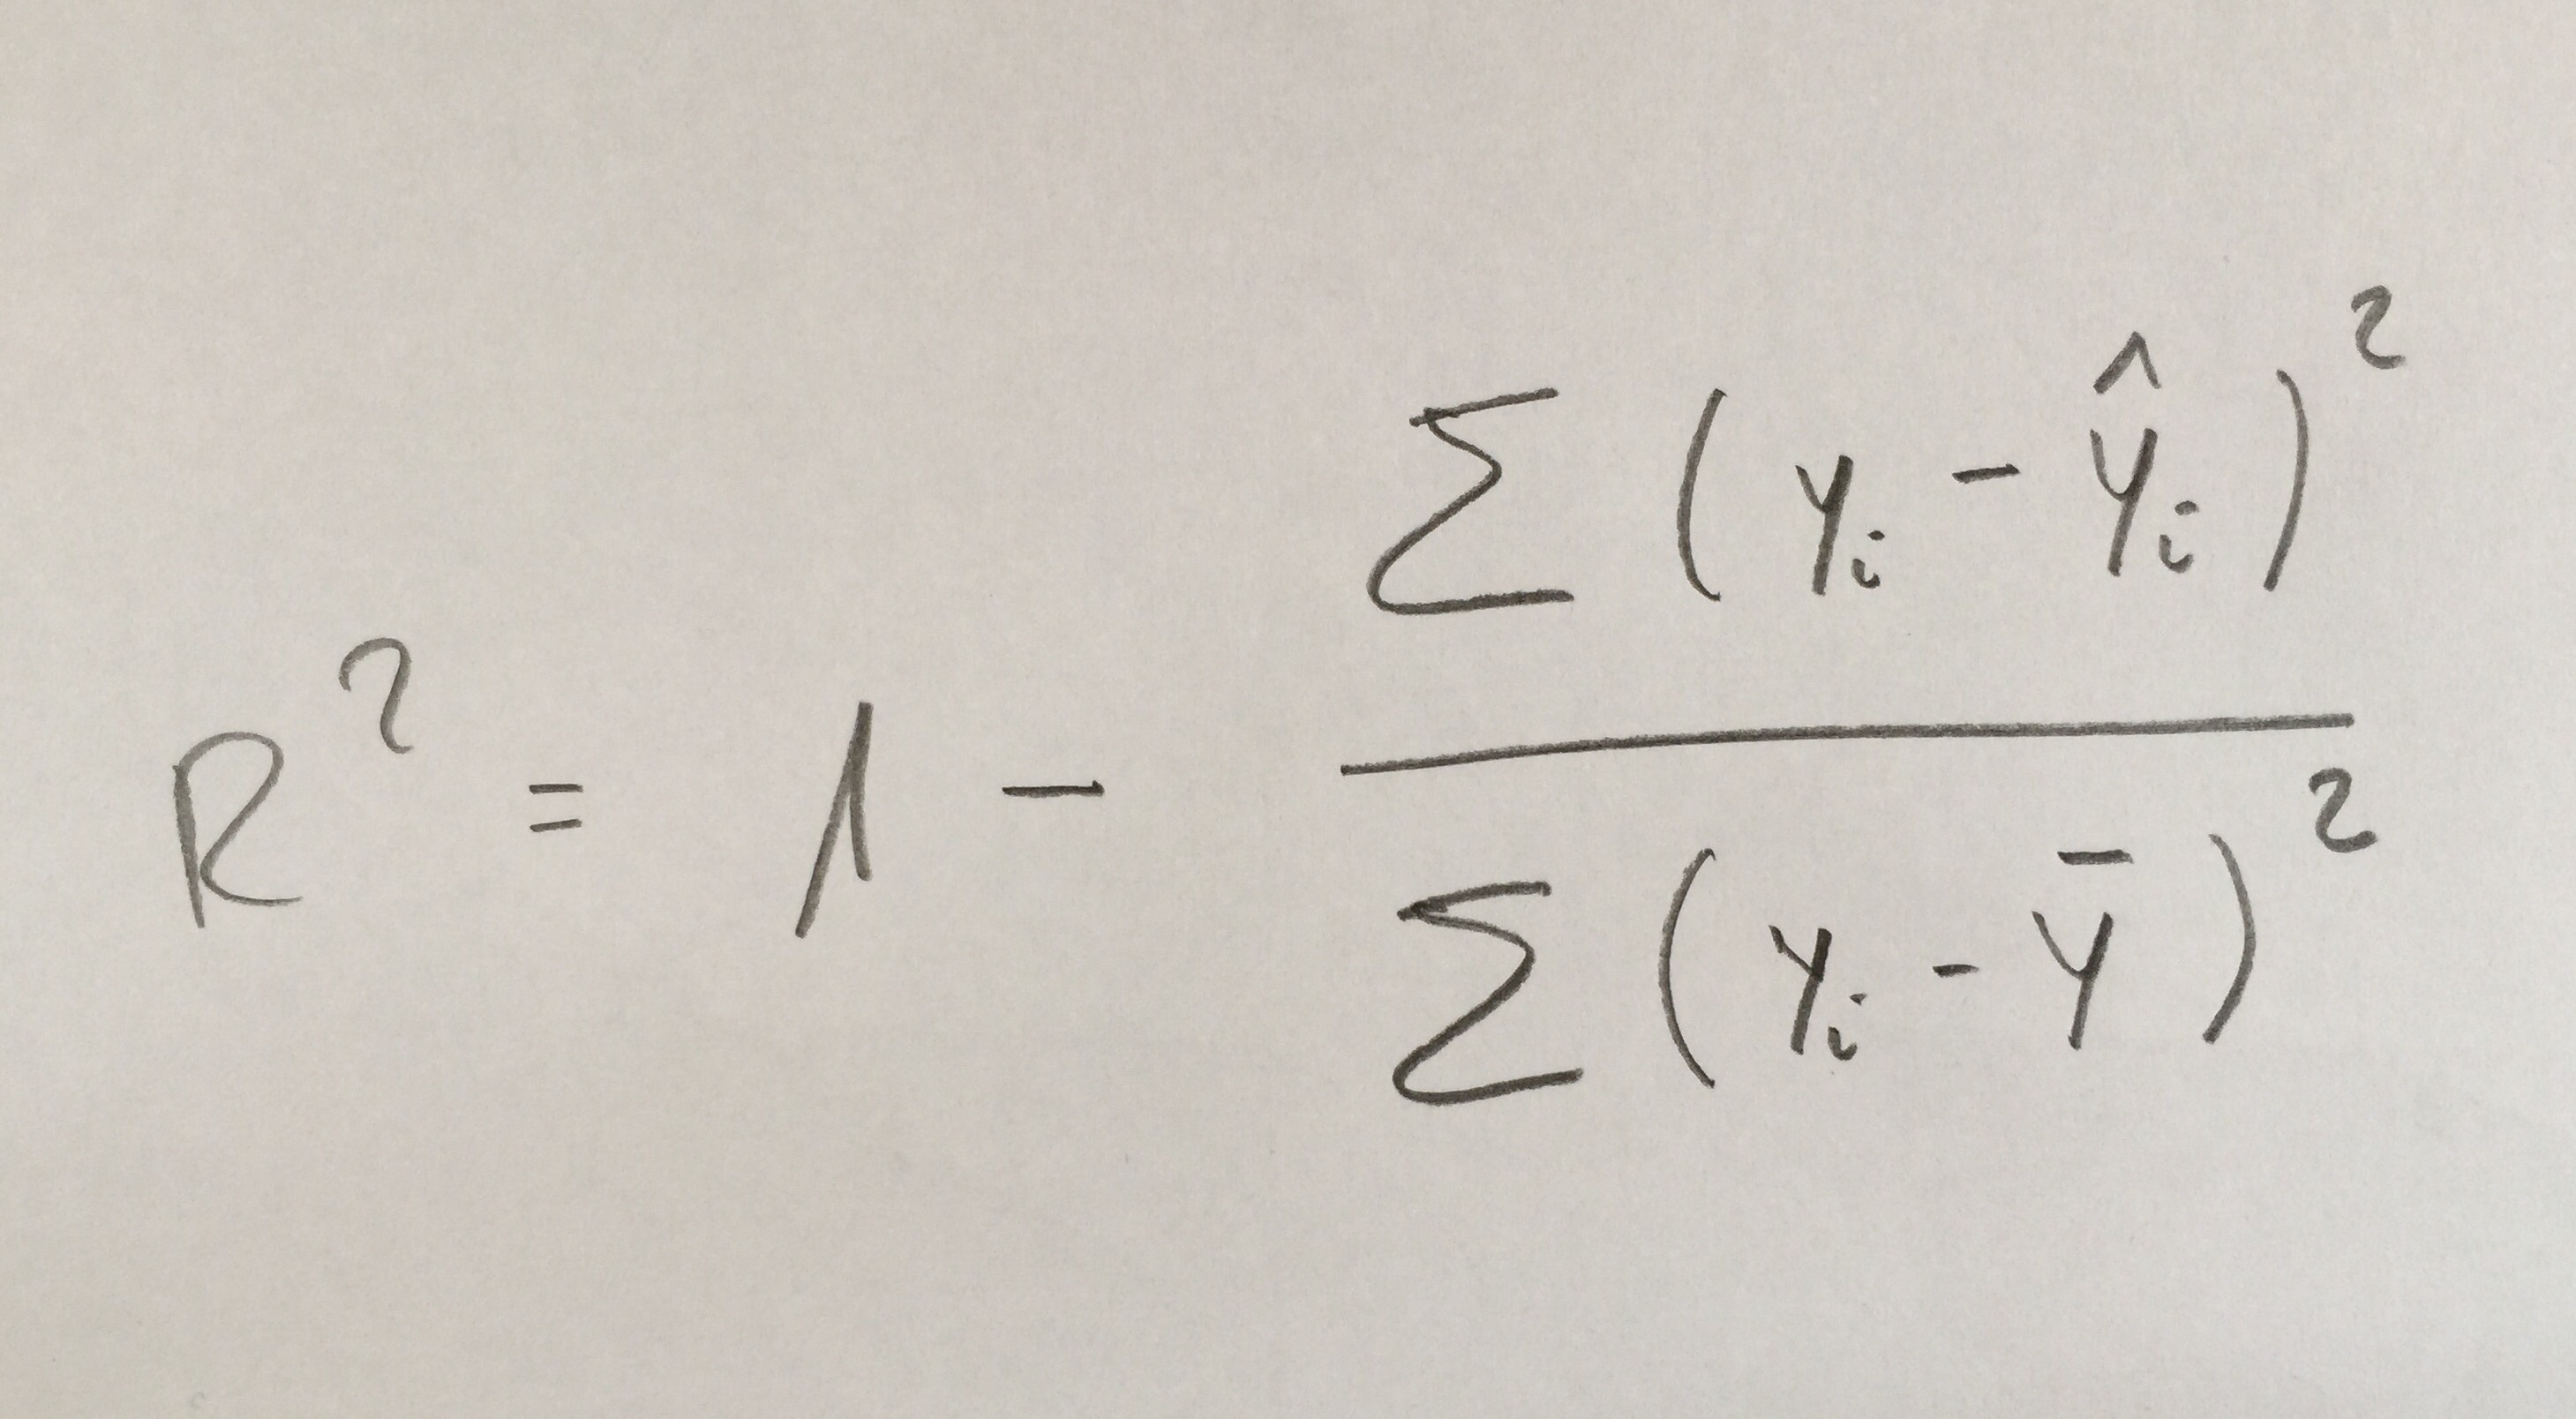Archivo del Autor: estadisticallopis

Coeficiente de determinación

Es un importante estadístico en la Regresión. Es una medida del grado de relación existente entre la variable dependiente y las variables independientes (si es una regresión simple, entonces «la variable independiente»). Mide cuánto está determinada la variable dependiente respecto a la variable o variables independientes.
Aunque es un valor que va del 0 al 1, suele darse en porcentaje.
Puede observarse el cálculo y, también, un caso de valor alto y otro de valor bajo de este coeficiente:

IMG_4452

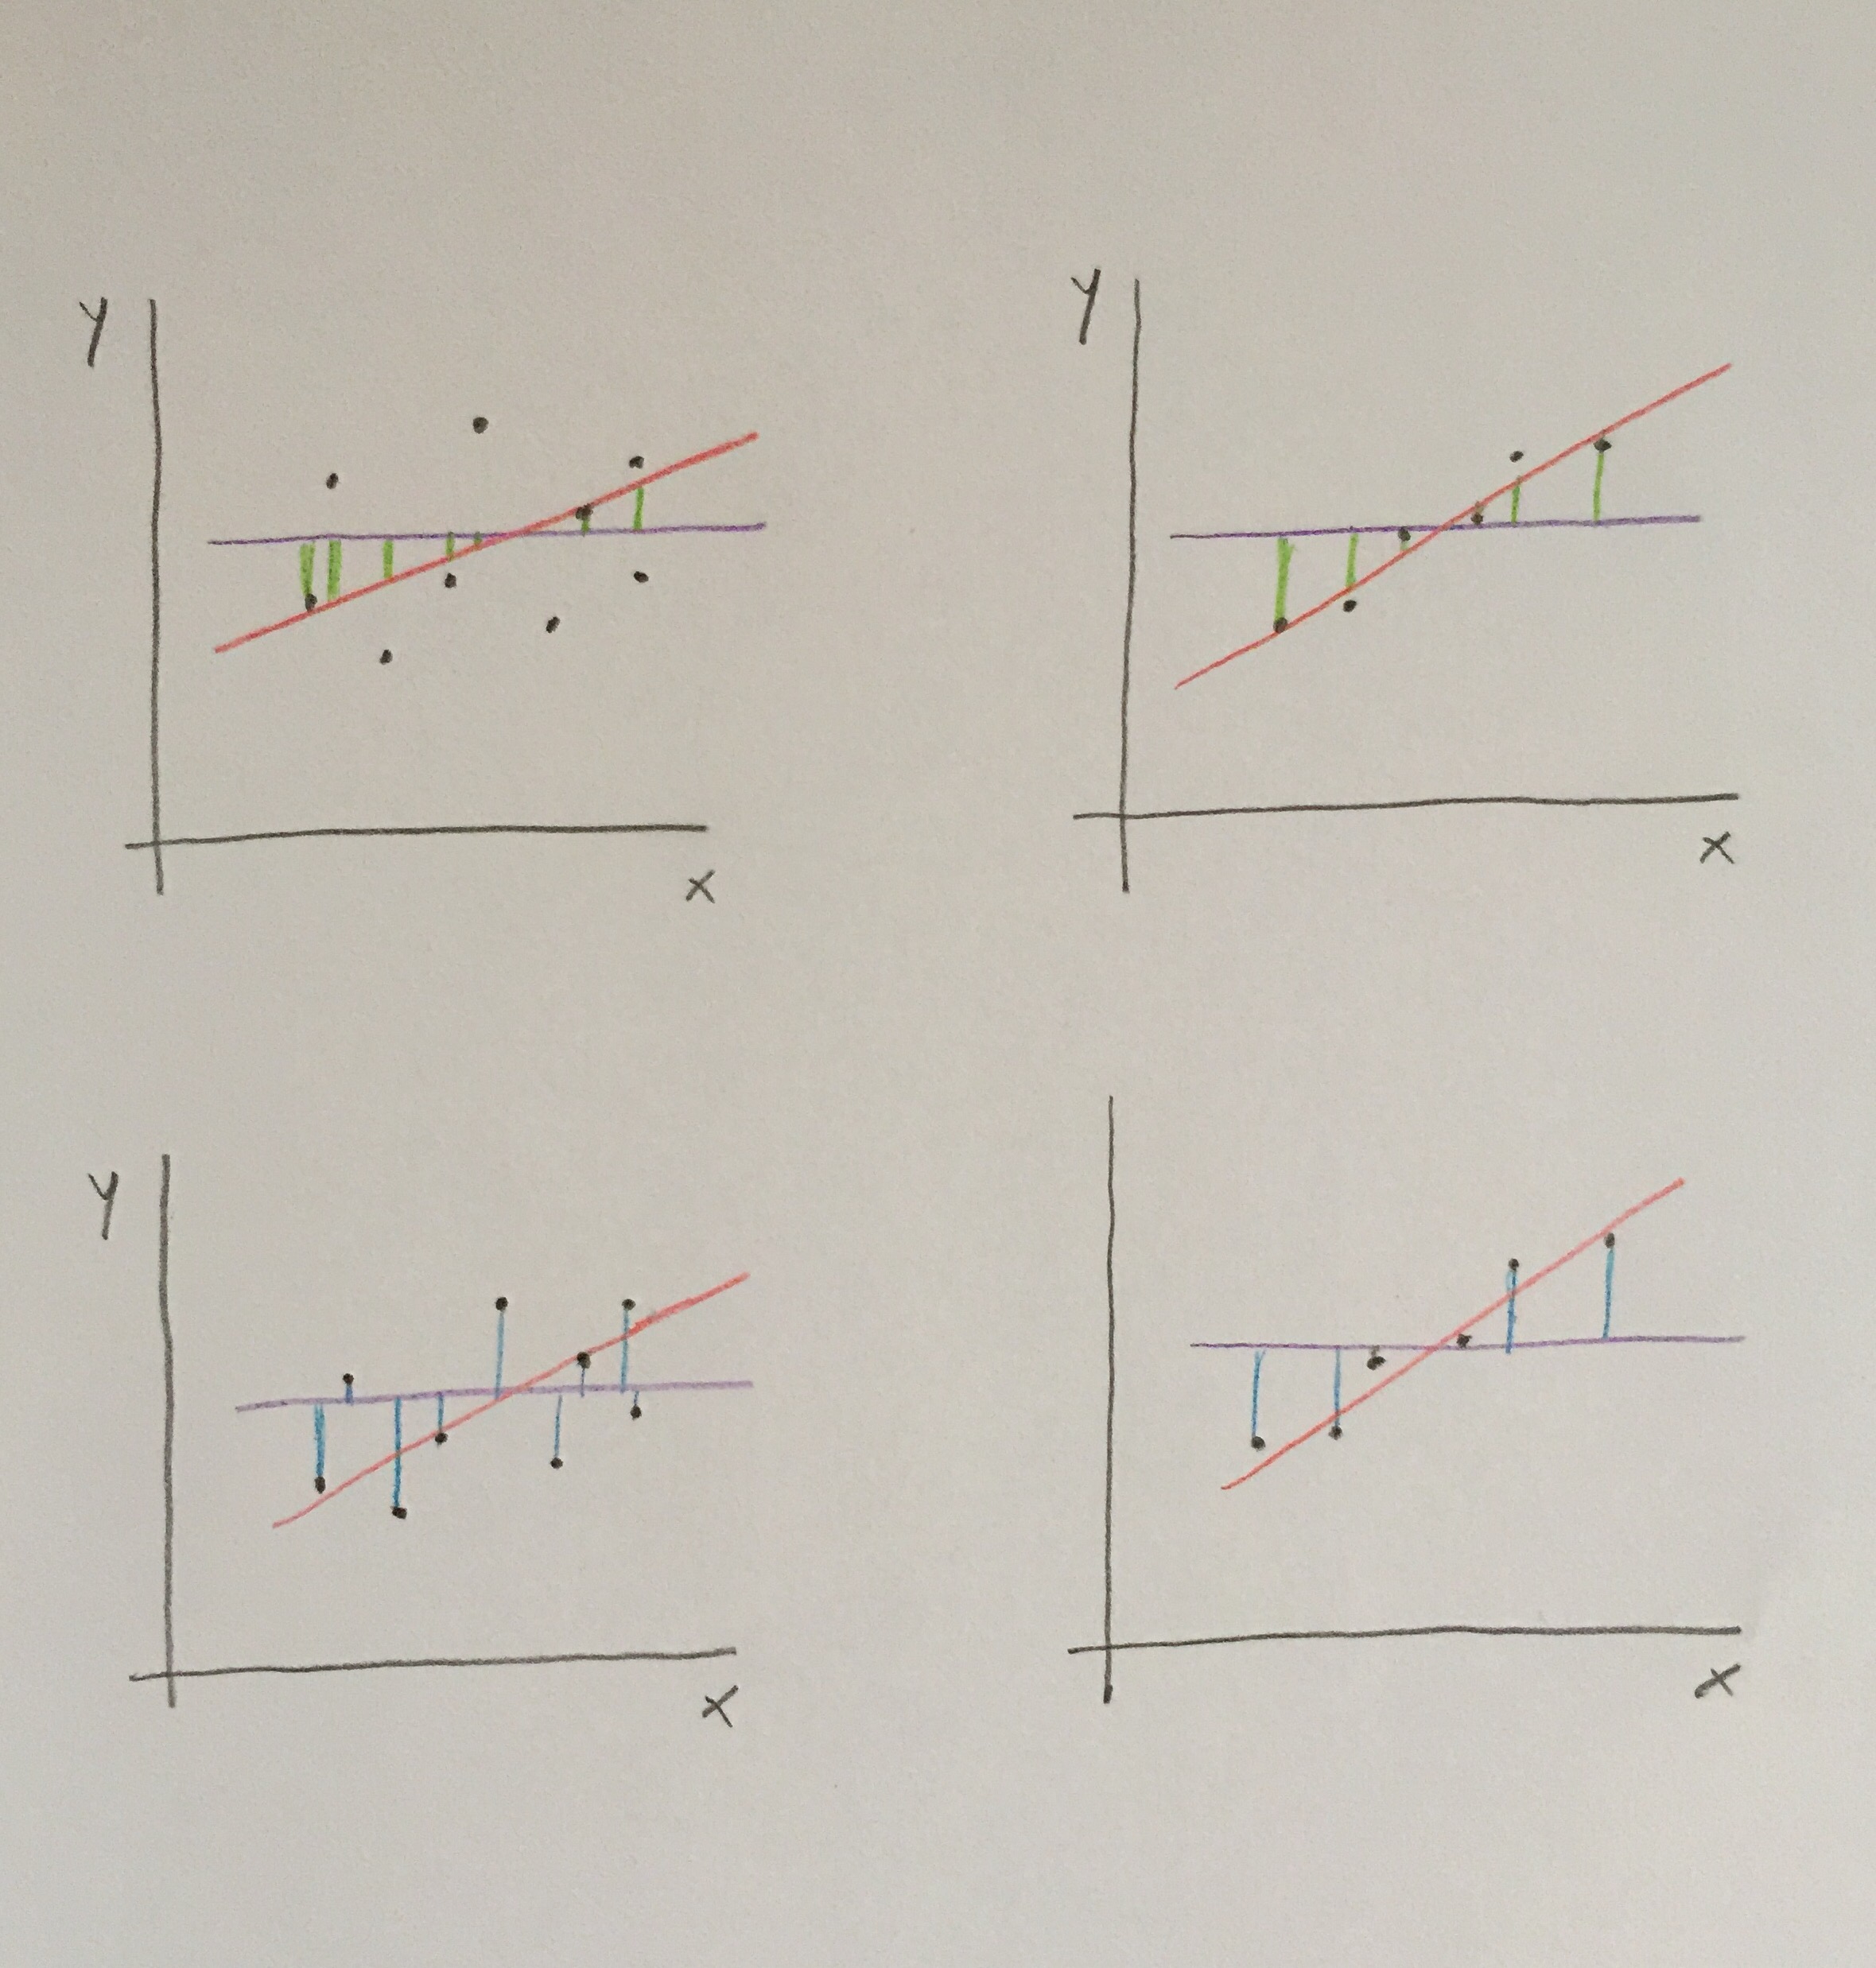
Observemos el siguiente gráfico que tal vez aclare mejor los dos ejemplos:
img_4818

A la izquierda tenemos el caso con coeficiente bajo y a la derecha el caso con coeficiente de determinación alto.

En cada uno de los casos tenemos arriba el numerador del cálculo del coeficiente y abajo el denominador del cálculo. Líneas verdes para el numerador y azules para el denominador.

Observemos que en el caso de la izquierda las líneas azules son mucho más largas que las verdes. Esto indica que nuestra recta de regresión no explica mucho la posición de los valores en la relación dibujada entre las dos variables.

En cambio, en el caso de la derecha hay una gran aproximación de las líneas verdes a las azules.  Esto indica que realmente nuestra recta de regresión consigue situarse muy próxima a la realidad posicional de los puntos en el diagrama de dispersión.

Observemos qué pasaría si los puntos se adaptaran totalmente a la línea recta:
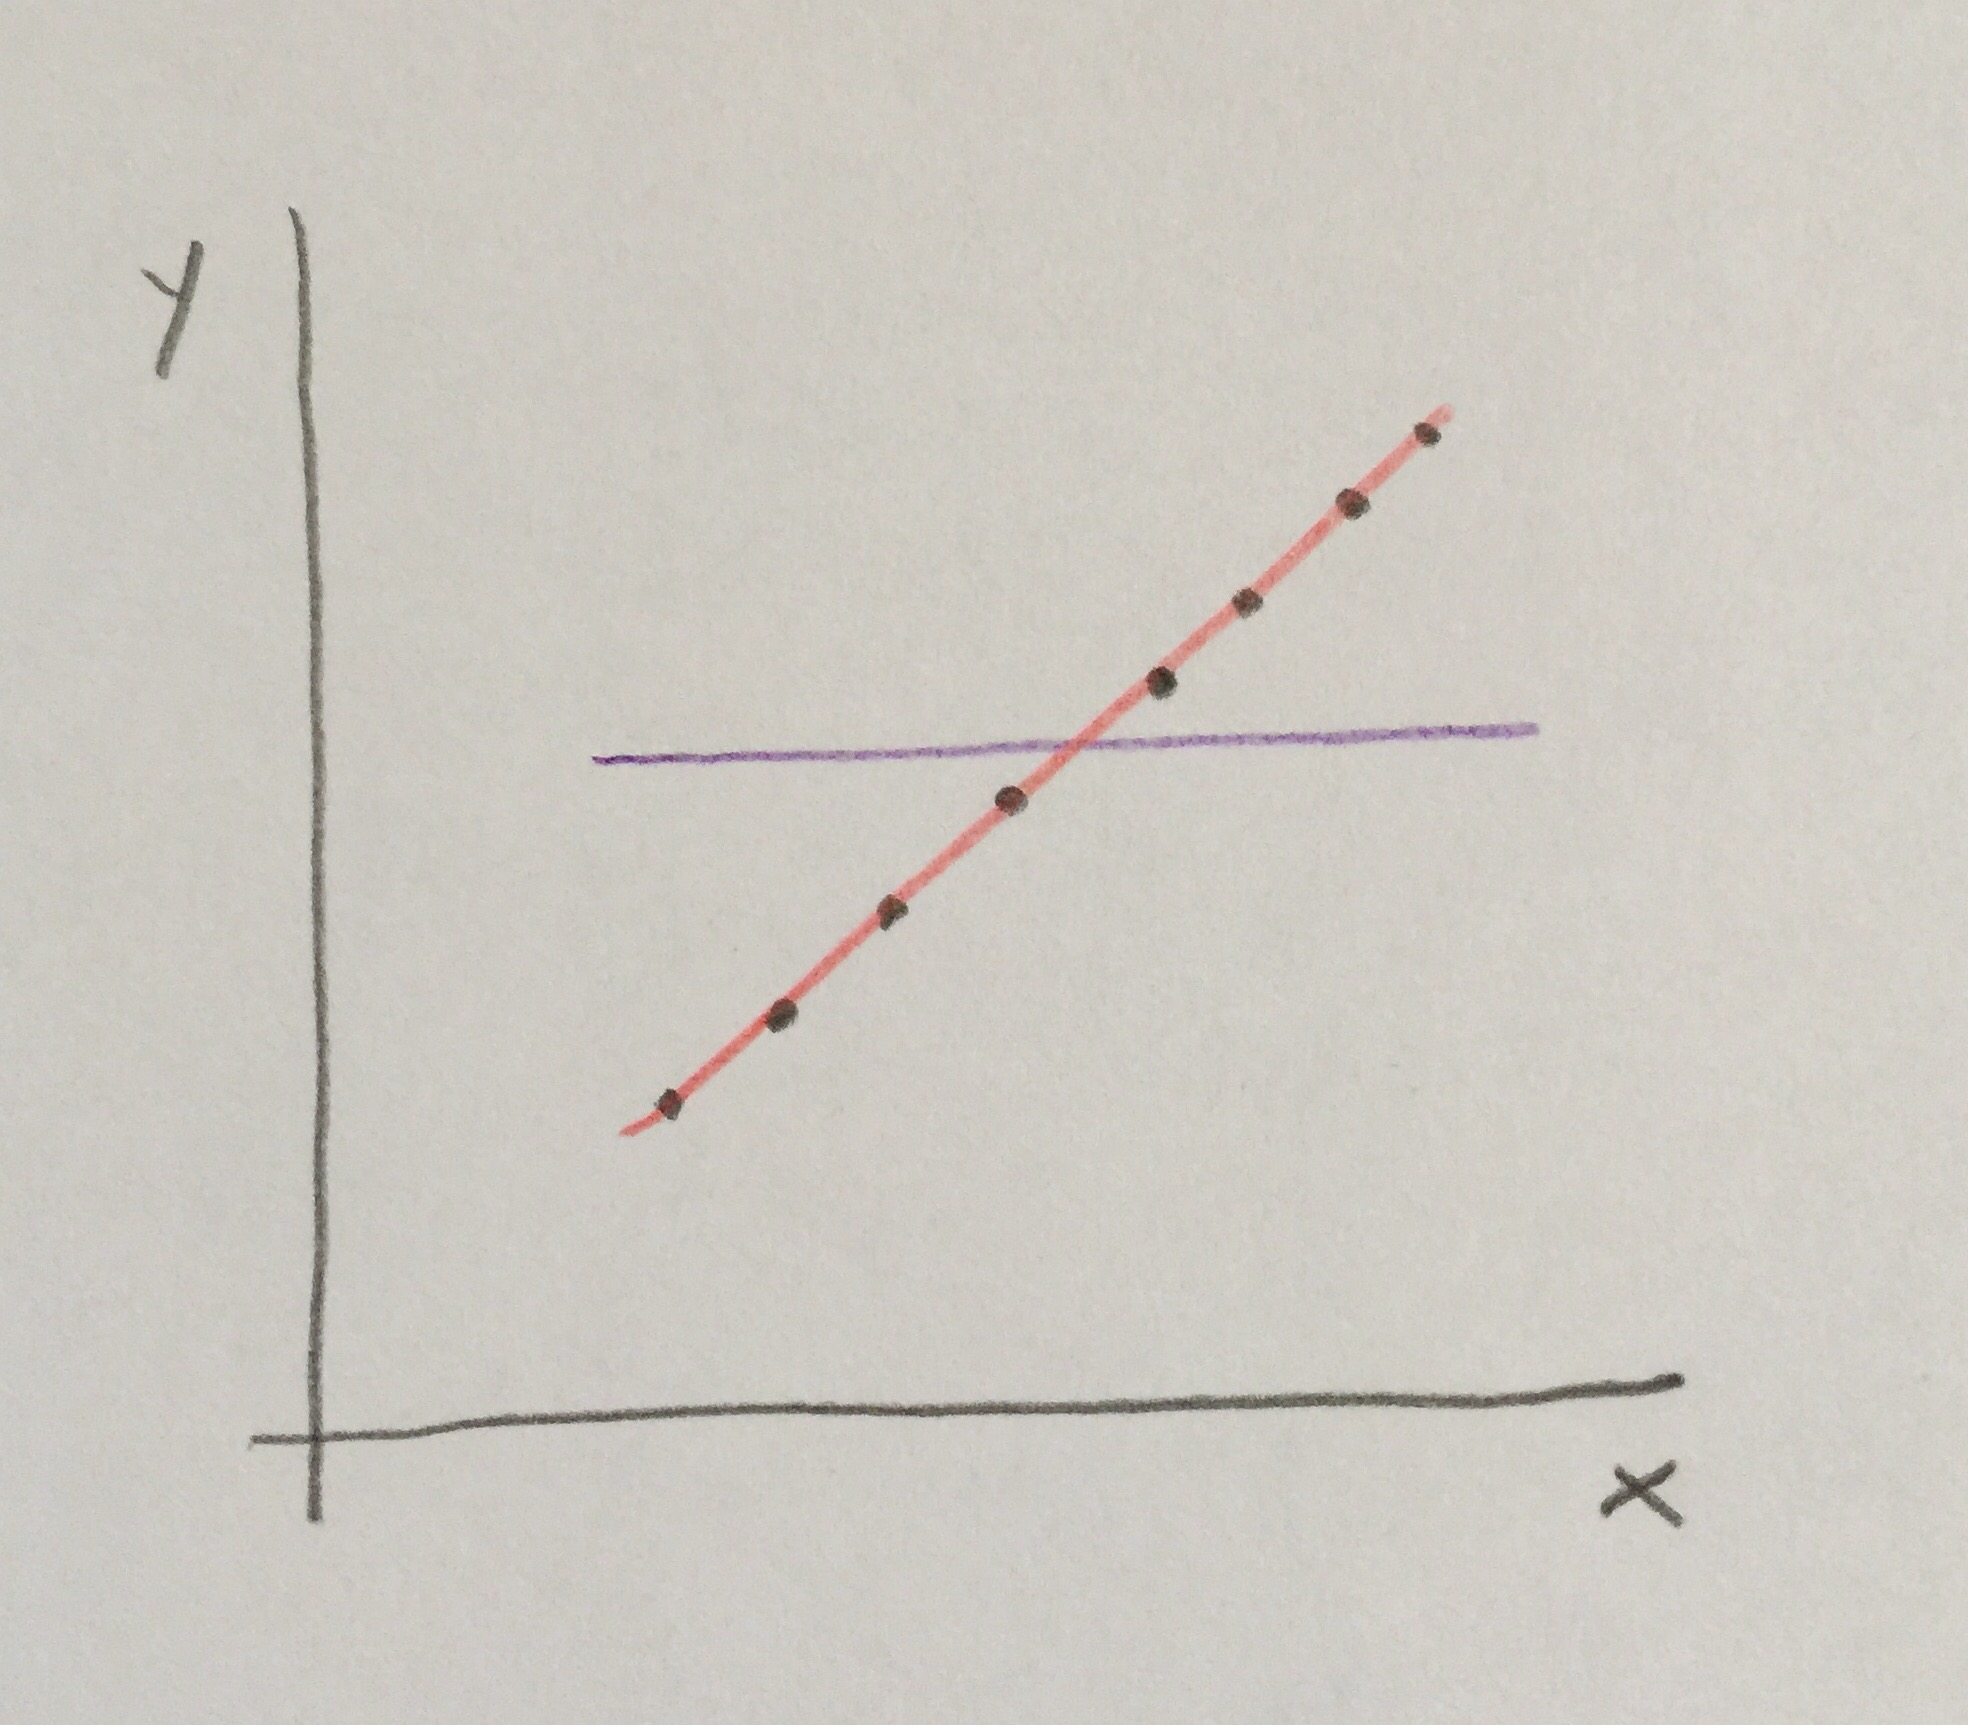
img_4819

En este casos las distancias verdes y azules son exactamente las mismas. No las dibujo porque se superpondrían, evidentemente. En este caso el coeficiente de determinación valdría 1.

En una regresión lineal simple el coeficiente de determinación coincide con la correlación de Pearson elevada al cuadrado.

Sin embargo, este coeficiente es utilizado en cualquier modelo de regresión.

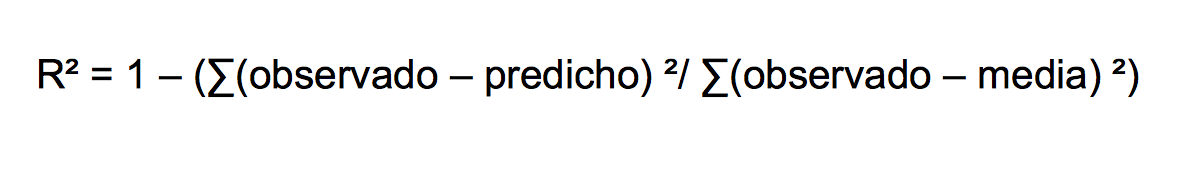
A veces, este coeficiente de determinación se plantea de otra forma, aunque equivalente, de esta forma:
captura-de-pantalla-2016-10-09-a-las-11-09-51

En forma más explícita:

img_4821

Puede comprobarse en los dos ejemplos extremos expuestos cómo se trata de una formulación equivalente a la anterior.

Contraste de Hipótesis de la pendiente de Regresión

Este constraste de hipótesis es conceptualmente muy importante. Implica un entrar en profundidad en lo que supone en sí la construcción de un modelo de Regresión. También, como siempre en Estadística, implica un analizar los datos desde una serie de perspectivas siempre presentes, y por lo tanto recurrentes: Tamaño de muestra, dispersión de los valores.

Obsérvese que en este caso acabamos descomponiendo la dispersión de los valores de la variable dependiente en dos fuentes de variabilidad y que es, precisamente, el cociente de esas dos fuentes el que nos dará la pauta de si debemos o no seguir manteniendo la Hipótesis nula, a la luz de los datos que tenemos.

Observemos muy bien lo que hay en el numerador y lo que hay en el denominador del conciente F. Veamos que cuando este cociente sea pequeño deberemos mantener la Hipótesis nula y, en cambio, cuando sea grande deberemos rechazarla. En el numerador está presente lo que explica la pendiente de la variabilidad de los datos y en el denominador está presente la dispersión no explicada, está lo que no somos capaces de explicar: el residuo.

IMG_4469

Criterio de Cook de influencia en Regresión

El criterio de Cook consiste en construir un intervalo de confianza de los coeficientes de regresión del 50%. Estimar de nuevo estos coeficientes sin el valor que se quiere ver su influencia. Si el nuevo valor estimado queda dentro del intervalo de confianza anterior se considera una influencia aceptable. Si, por el contrario, se sale de este intervalo, estamos ante un exceso de influencia que conviene replantearse. Una opción clara es eliminar el valor del análisis.

IMG_4445

Estimador de Nadaraya-Watson

El estimador de Nadaraya-Watson es uno de los mecanismos de Regresión no paramétrica más prestigiosos. Usa un método Kernel de estimación de funciones de densidad. Un Kernel muy usual es la distribución Normal. Por ejemplo una N(0, 1). Al parámetro h se le denomina ventana y, en realidad, modifica la dispersión de la Normal, si es ésta la que actúa de Kernel. Es una forma original de construir una estimación de la variable dependiente «y» a partir de un valor de una variable independiente «x», basándose exclusivamente en la posición de los valores de la muestra que tenemos.
Se trata de un mecanismo de construcción de la variable «y» ponderando los valores muestrales de esta variable según la distancia que haya desde el valor de «x» a los valores muestrales de la variable independiente. La ponderació se materializa mediante el numerador del Kernel. Supongamos que éste sea la N(0, 1), entonces si el valor de «x» está cerca de un valor muestral de la variable independiente la resta será un valor próximo a cero y tendrá en la Normal un valor grande. Sin embargo, los valores alejados darán restas grandes en valor absoluto y en la Normal tendrá un valor próximo a cero. Observemos, pues, que el valor de «y» para esa «x» estará muy influido por los valores muestrales cercanos.

IMG_4441

La Estadística es un diálogo entre el indicativo y el subjuntivo

La Estadística es la ciencia que utiliza más el subjuntivo. Tiene su razón de ser. Y, además, esta razón de ser está en la propia esencia de lo que es la Estadística.

Observemos las siguientes frases:

“… el promedio teórico de los cálculos que pudiésemos hacer si tuviésemos todas las muestras posibles”

“… el p-valor, que es una medida objetiva de la posición de los que vemos respecto a lo que podríamos ver si tuviésemos todas las muestras posibles en el caso de que fuese cierta la H0.

Estas frases son el día a día en un curso de Estadística. Porque en Estadística siempre estamos estableciendo comparaciones entre lo que tenemos y lo que pudiésemos tener. Pensemos que muchas técnicas estadística en su proceso de decisión comparan el llamado “Observado” (la muestra que se tiene) con el llamado “Esperado” (lo que deberíamos ver si fuera cierta la Hipótesis nula.

El mismo p-valor, columna vertebral de las decisiones estadísticas, está fundamentado en este diálogo. De hecho, se puede decir que el p-valor es la traducción numérica de este diálogo entre lo que tenemos (Indicativo) y lo que pudiésemos (Subjuntivo) tener en el caso de que fuese (Subjuntivo) cierta la Hipótesis nula.

En realidad, en Estadística, y, por lo tanto, en Ciencia, las decisiones se toman a partir de una muestra, pero siempre tratándola de situar en relación a las muestras que hubiésemos podido tener en el caso que fuese cierta la Hipótesis nula, que es lo que podemos decir antes de hacer cualquier estudio de una realidad determinada.

En Estadística, por lo tanto, siempre estamos estableciendo un diálogo entre lo que vemos (el Indicativo) y lo que hubiésemos (el Subjuntivo) podido ver en unas circunstancias determinadas que nos interesa evaluar.

Correlación de Kendall

Recordemos los siguiente: Cuando en Estadística se escriben tres líneas paralelas horizontales a la derecha de un cálculo, de un estadístico, y a continuación se escribe una determinada distribución nos referimos a que tal estadístico sigue esa distribución. Si se pone encima de esas tres líneas algún símbolo significa que esa distribución se cumple si lo que se escribe allí es cierto. En este caso se escriben dos cosas: 1) Ho, lo que nos indica que este estadístico sigue esa distribución si es cierta la Ho. 2) Mayor o igual a 8, lo que significa que este estadístico sigue esa distribución si el tamaño de muestra es mayor o igual a 8.

IMG_4433

Correlación de Pearson

La correlación de Pearson es la medida del grado de relación entre variables cuantitativas más usado. Es especialmente apropiado usarlo en variables con distribución normal porque el contraste de hipótesis a través del cual se valora su significación tiene un estadístico de test que sigue la distribución que sigue en condiciones de normalidad de las variables. Por eso si no se cumple la normalidad o si las variables son ordinales es más apropiado o usar la correlación de Spearman o la correlación de Kendall.

El cálculo de la correlación en una muestra se suele representar con una r, y es el cociente de la covarianza muestral respecto al producto de las desviaciones muestrales de cada una de las dos variables, como puede observarse a continuación.

En el dibujo adjunto se plantea, además del cálculo de la correlación r, el contraste de hipótesis sobre la correlación poblacional, con el estadístico de test que se usa y la distribución que ese estadístico sigue bajo la Hipótesis nula.


IMG_4430