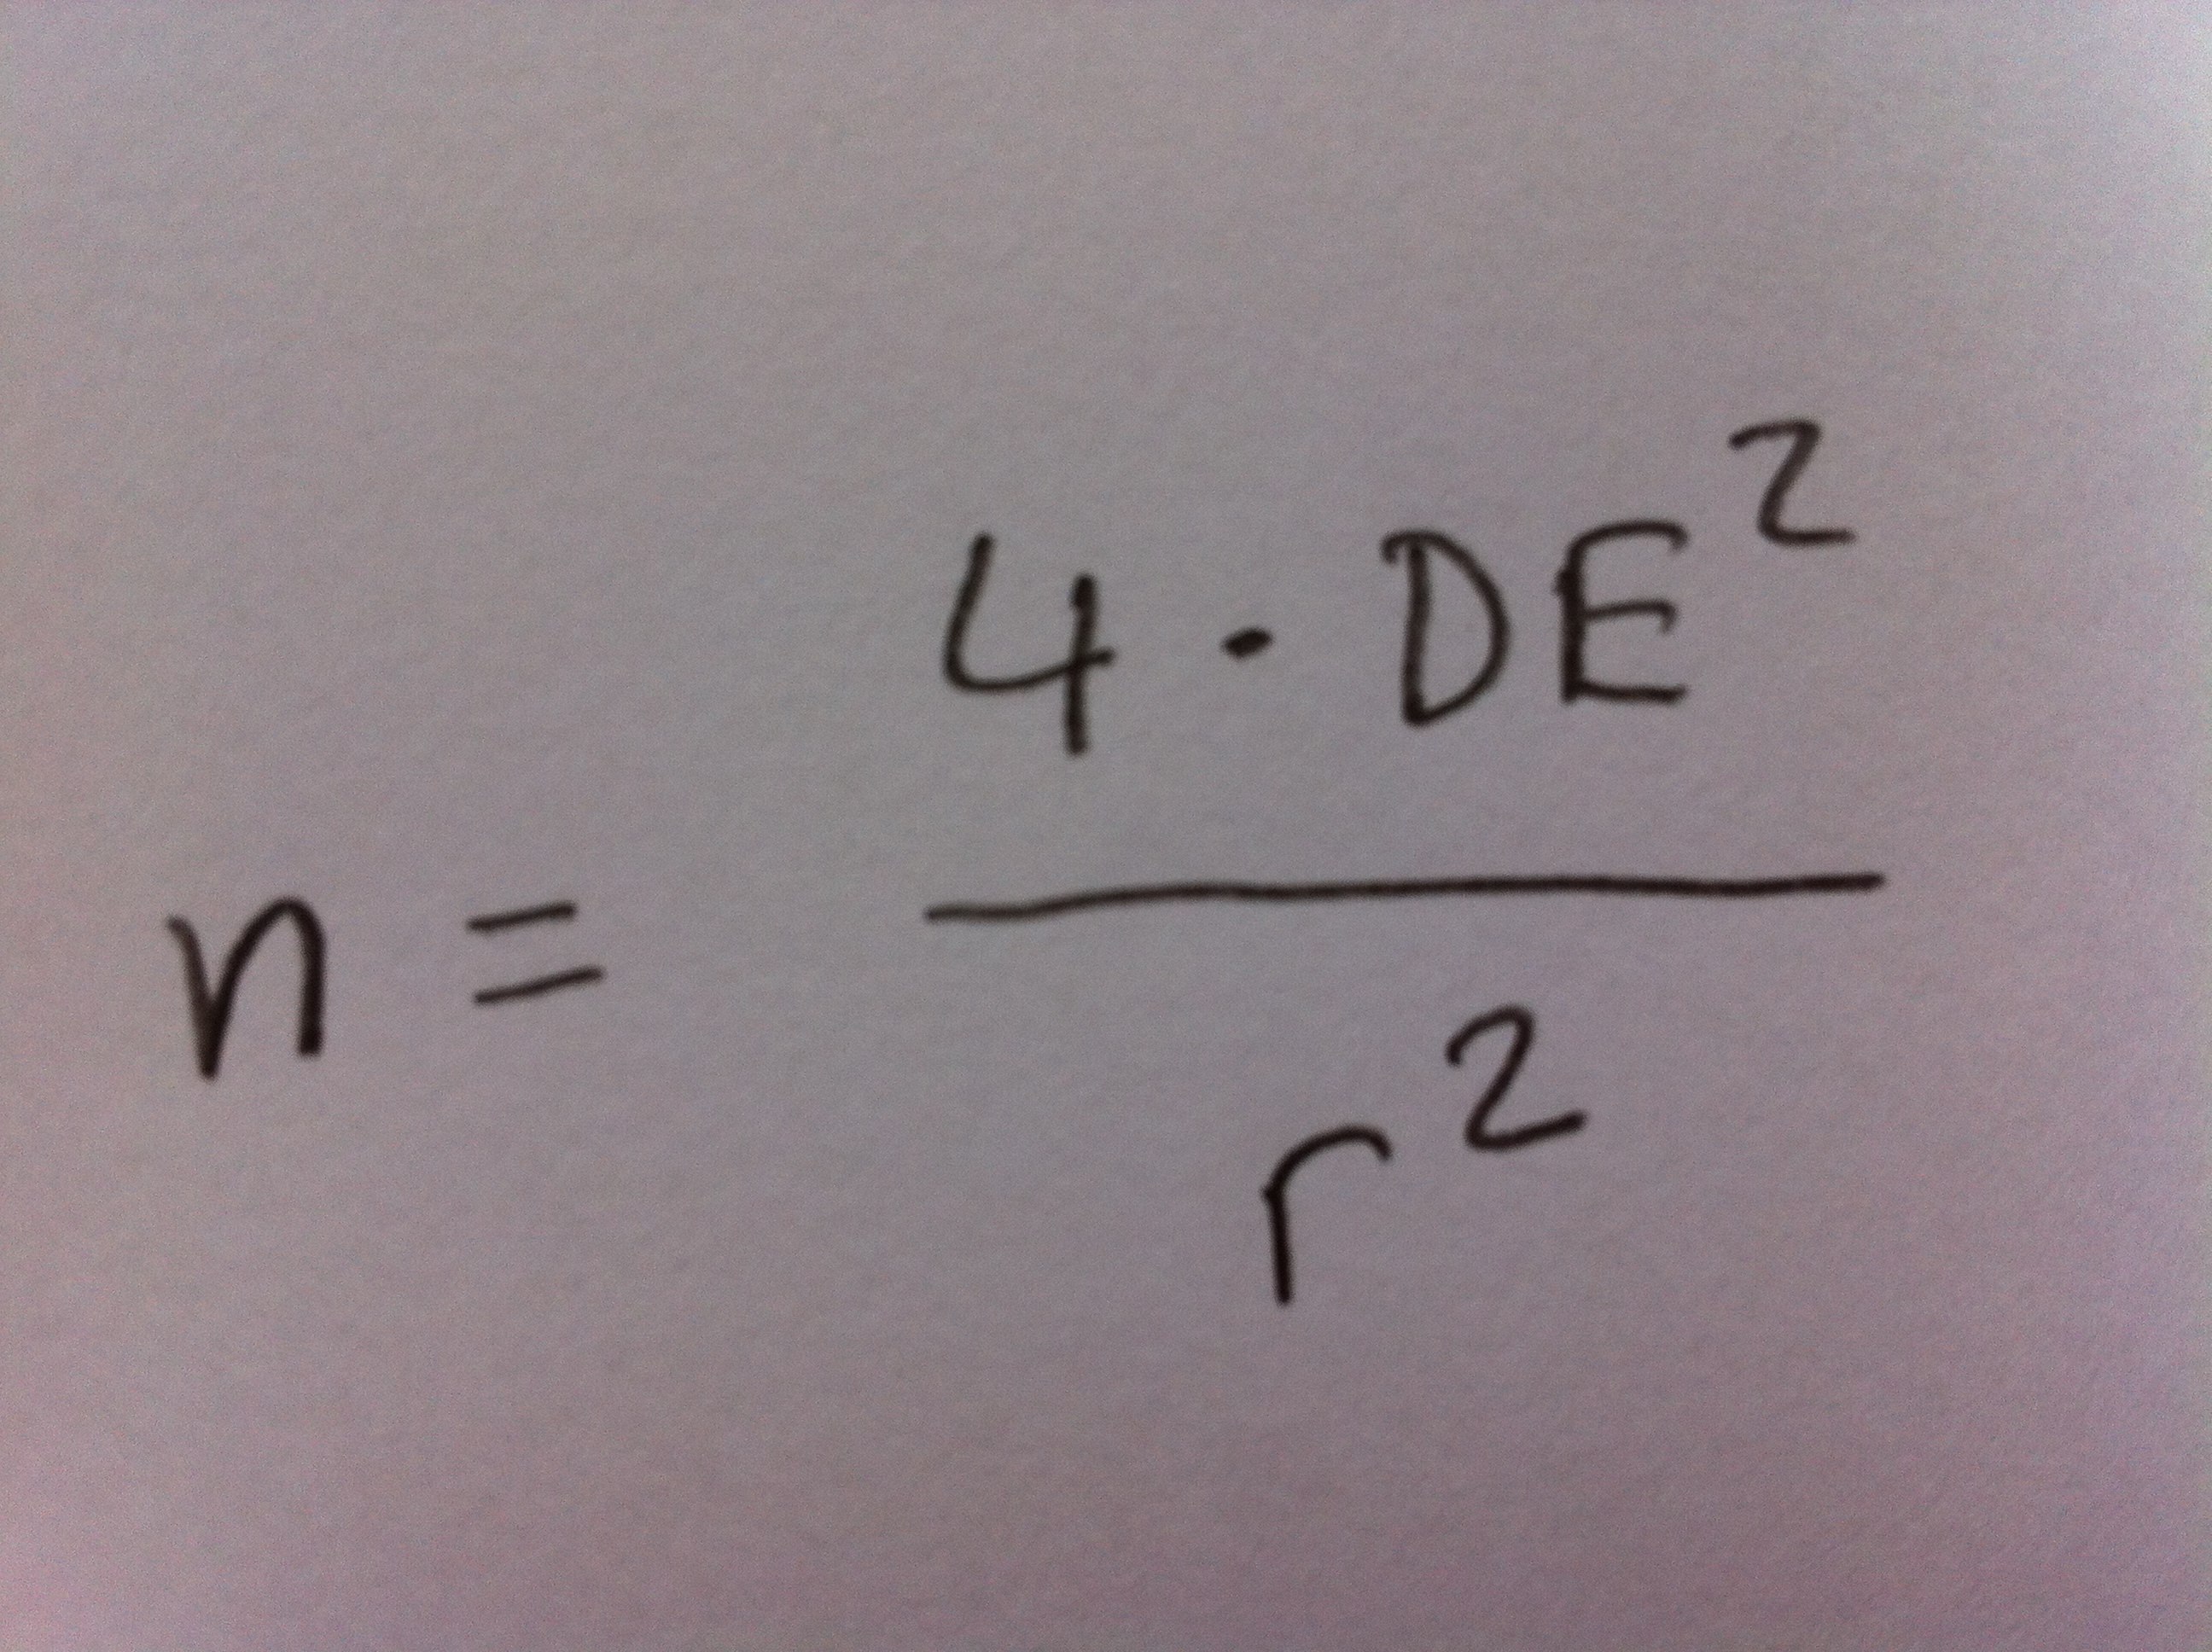Archivo del Autor: estadisticallopis

Estructuras definidas en conjuntos

Un conjunto cualquiera, en matemáticas, sin más, es simplemente una colección de elementos, una reunión desconectada de entidades, un listado de entidades. Si ese conjunto es, por ejemplo, el de los números enteros, si no especificamos nada más es una mera colección de números, como hemos visto en el HERBARIO de conjuntos.

En matemáticas a esos conjuntos se les suele ver desde una estructura definida en ellos. Una estructura en un conjunto es como una forma de mirada al interior de ese conjunto. Una forma de darle un orden. Una forma de verlo en una estructura. Es, por lo tanto, una forma de organizar el contenido de un conjunto. Es muy importante, para entender las matemáticas, tener muy claro este concepto complejo: el concepto de estructura definida en un conjunto.

En un mismo conjunto se pueden definir muchos tipos de estructuras. Por eso, dependiendo de qué estructura hayamos definido en un conjunto, en un momento determinado, ese conjunto se presentará como una realidad muy diferente.

En un conjunto se pueden definir muchos tipos de estructuras diferentes: operaciones, topologías, conjuntos de subconjuntos de ese conjunto, medidas, probabilidades, distancias, normas, etc. Ya lo iremos viendo. Según la estructura que definamos en un conjunto lo estaremos visualizando desde un determinado punto de vista. Y, por lo tanto, dependiendo de cuál sea esta estructura, la mirada a ese conjunto será ciertamente muy distinta, una  mirada que nos facilitará propiedades muy diferentes de ese conjunto.

En matemáticas un determinado conjunto A puede ir acompañado de símbolos como los siguientes:


Cada uno de ellos apunta a una estructura, a una mirada distinta a ese mismo conjunto A. Aparecen operaciones (+, •). A veces una operación, a veces dos operaciones. Aparecen topologías (T), clases de subconjuntos (a), medidas (μ), probabilidades (P), distancias (d), normas (⎢•⎢).

Un mismo conjunto visto desde una estructura u otra cambia completamente la mirada que hagamos a él. Mirémoslo desde la siguiente metáfora: Supongamos un grupo de 20 personas. Si lo miráramos desde la noción pura de conjunto simplemente especificaríamos el listado de nombres de esas 20 personas. Sin más. Pero esas 20 personas pueden ponerse a hablar de política y, por lo tanto, en aquel momento empiezan a crearse una serie de asociaciones entre esas personas: afinidades, distancias pequeñas entre ellos, distancias grandes entre ellos, etc. Si hablan de fútbol, las asociaciones, los subgrupos, las distancias que se establecen entre ellos son muy posiblemente completamente otras. Si se ponen a hablar de música, las posiciones relativas de esos 20 componentes del grupo pueden cambiar, y mucho, de nuevo. Pues diríamos que cada uno de estos ámbitos: la política, el fútbol, la música, etc., genera una mirada diferente a ese grupo de personas, genera una estructura diferente, una organización interna diferente dentro del grupo. Eso es lo que hace una operación, una topología, una distancia, una norma, una medida, una probabilidad, etc., en un conjunto: generar una mirada diferente a una misma realidad, generar una estructura interna distinta de sus elementos, los posiciona, relativamente, a unos respecto de otros, de forma muy diferente.

Esto es, sin ninguna duda, fundamental para entender las peculiaridades del complejo lenguaje de las matemáticas: saber qué conjunto tenemos entre manos y desde qué estructura lo estamos analizando. Ya iremos desarrollando esta noción poco a poco, pero es muy importante tener estas ideas expuestas aquí siempre presentes al hacer matemáticas. Es trascendental.

Además, una cosa muy importante: en función de esas estructuras definidas en los conjuntos se generan diferentes ramas de las matemáticas. Por ejemplo, el Álgebra es el estudio de los conjuntos vistos siempre estructurados según operaciones definidas en ellos. El Análisis funcional es el estudio de conjuntos de funciones a los que se ha definido una distancia o una norma. La teoría de la medida es el estudio de conjuntos a los que se ha definido, en primer lugar, una estructuración en base a agrupaciones de subconjuntos de esos conjuntos (a las que llamamos anillos de conjuntos) y en una medida definida en cada uno de esos subconjuntos. La teoría de la probabilidad es, igualmente, una estructuración en base a agrupaciones de subconjuntos de esos conjuntos (a los que llamamos álgebras de conjuntos (a)) y a una probabilidad definida en cada uno de esos subconjuntos.

Solución Situación 84

Una advertencia previa: la pregunta 15 tenía un error, como algunos de vosotros habéis detectado. La media debía ser 100 y el tamaño de muestra 9. En las preguntas de la Situación está ya bien formulada. A todos os he contado como si estuviera bien respuesta, la hayáis contestado o no.

Mucha suerte.

1d: El primer p-valor no es significativa y el segundo y tercero sí lo son. Luego, el primer factor no es significativa, el segundo sí lo es y hay interacción.

2b: Porque el intervalo de confianza no contiene al 1 y, en cambio, el p-valor nos dice que no es significativa la Odds ratio. Esto está en contradicción. Obsérvese que en los demás apartados hay coherencia entre el intervalo y el p-valor.

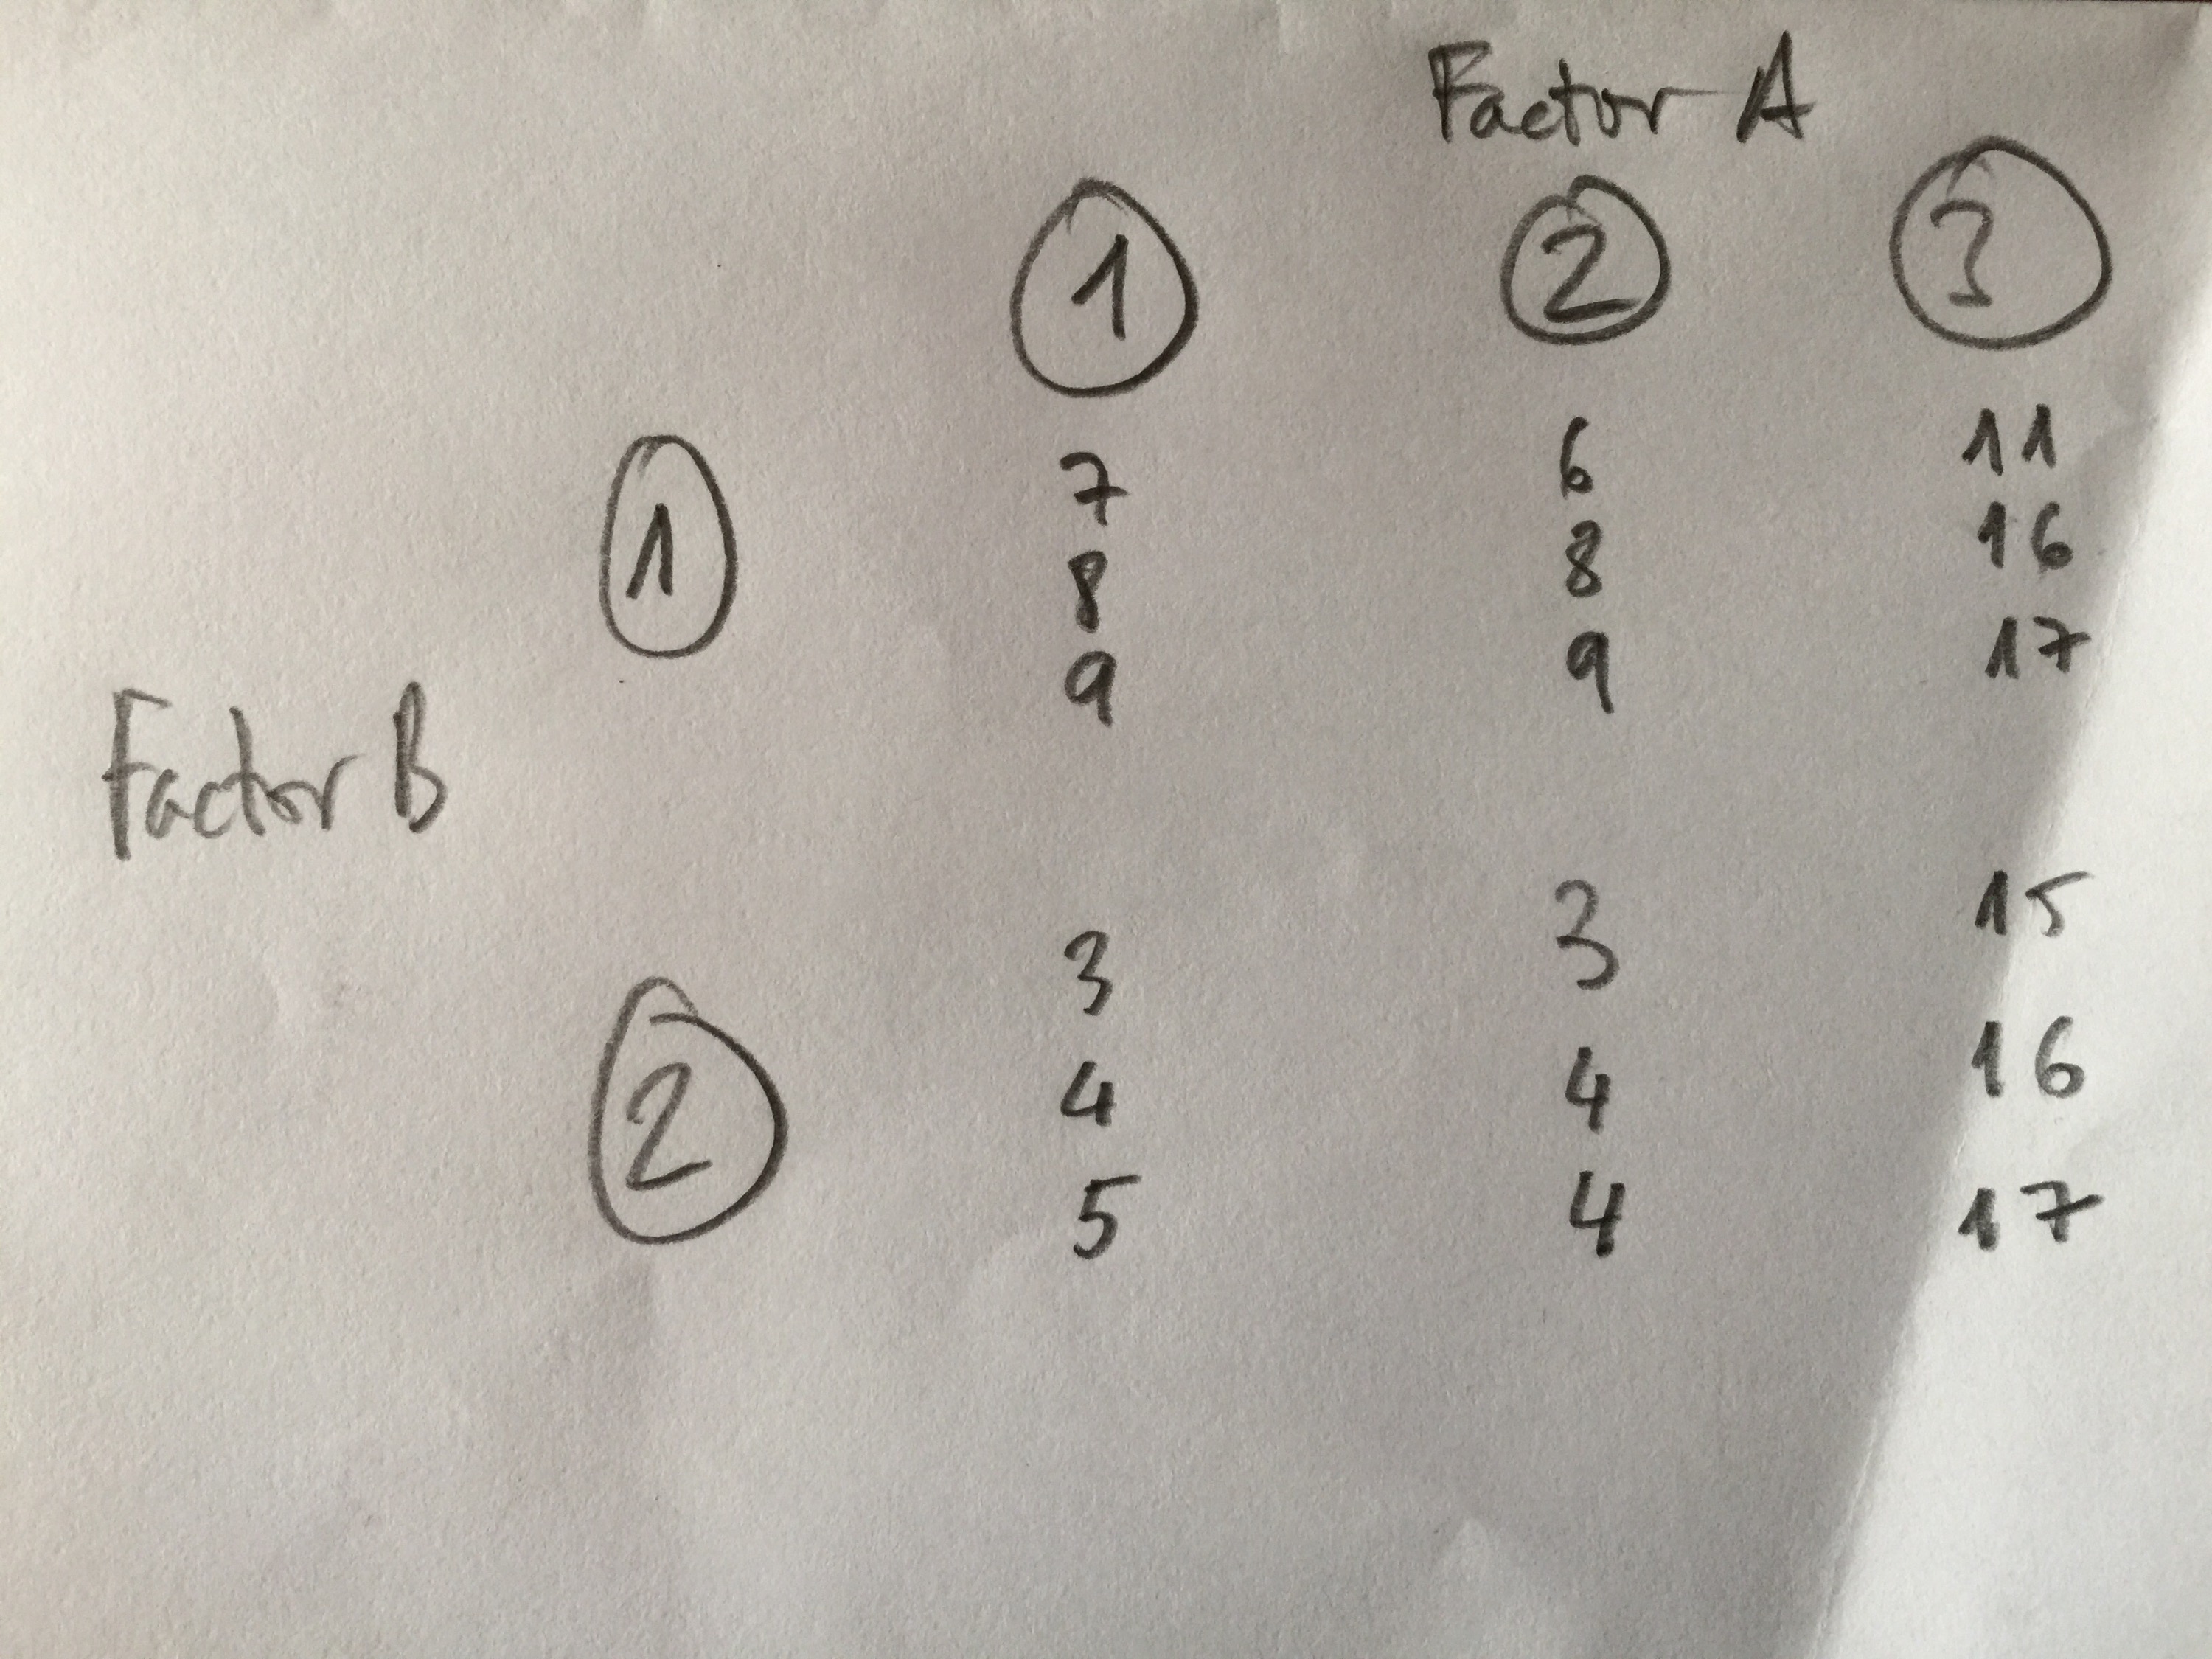
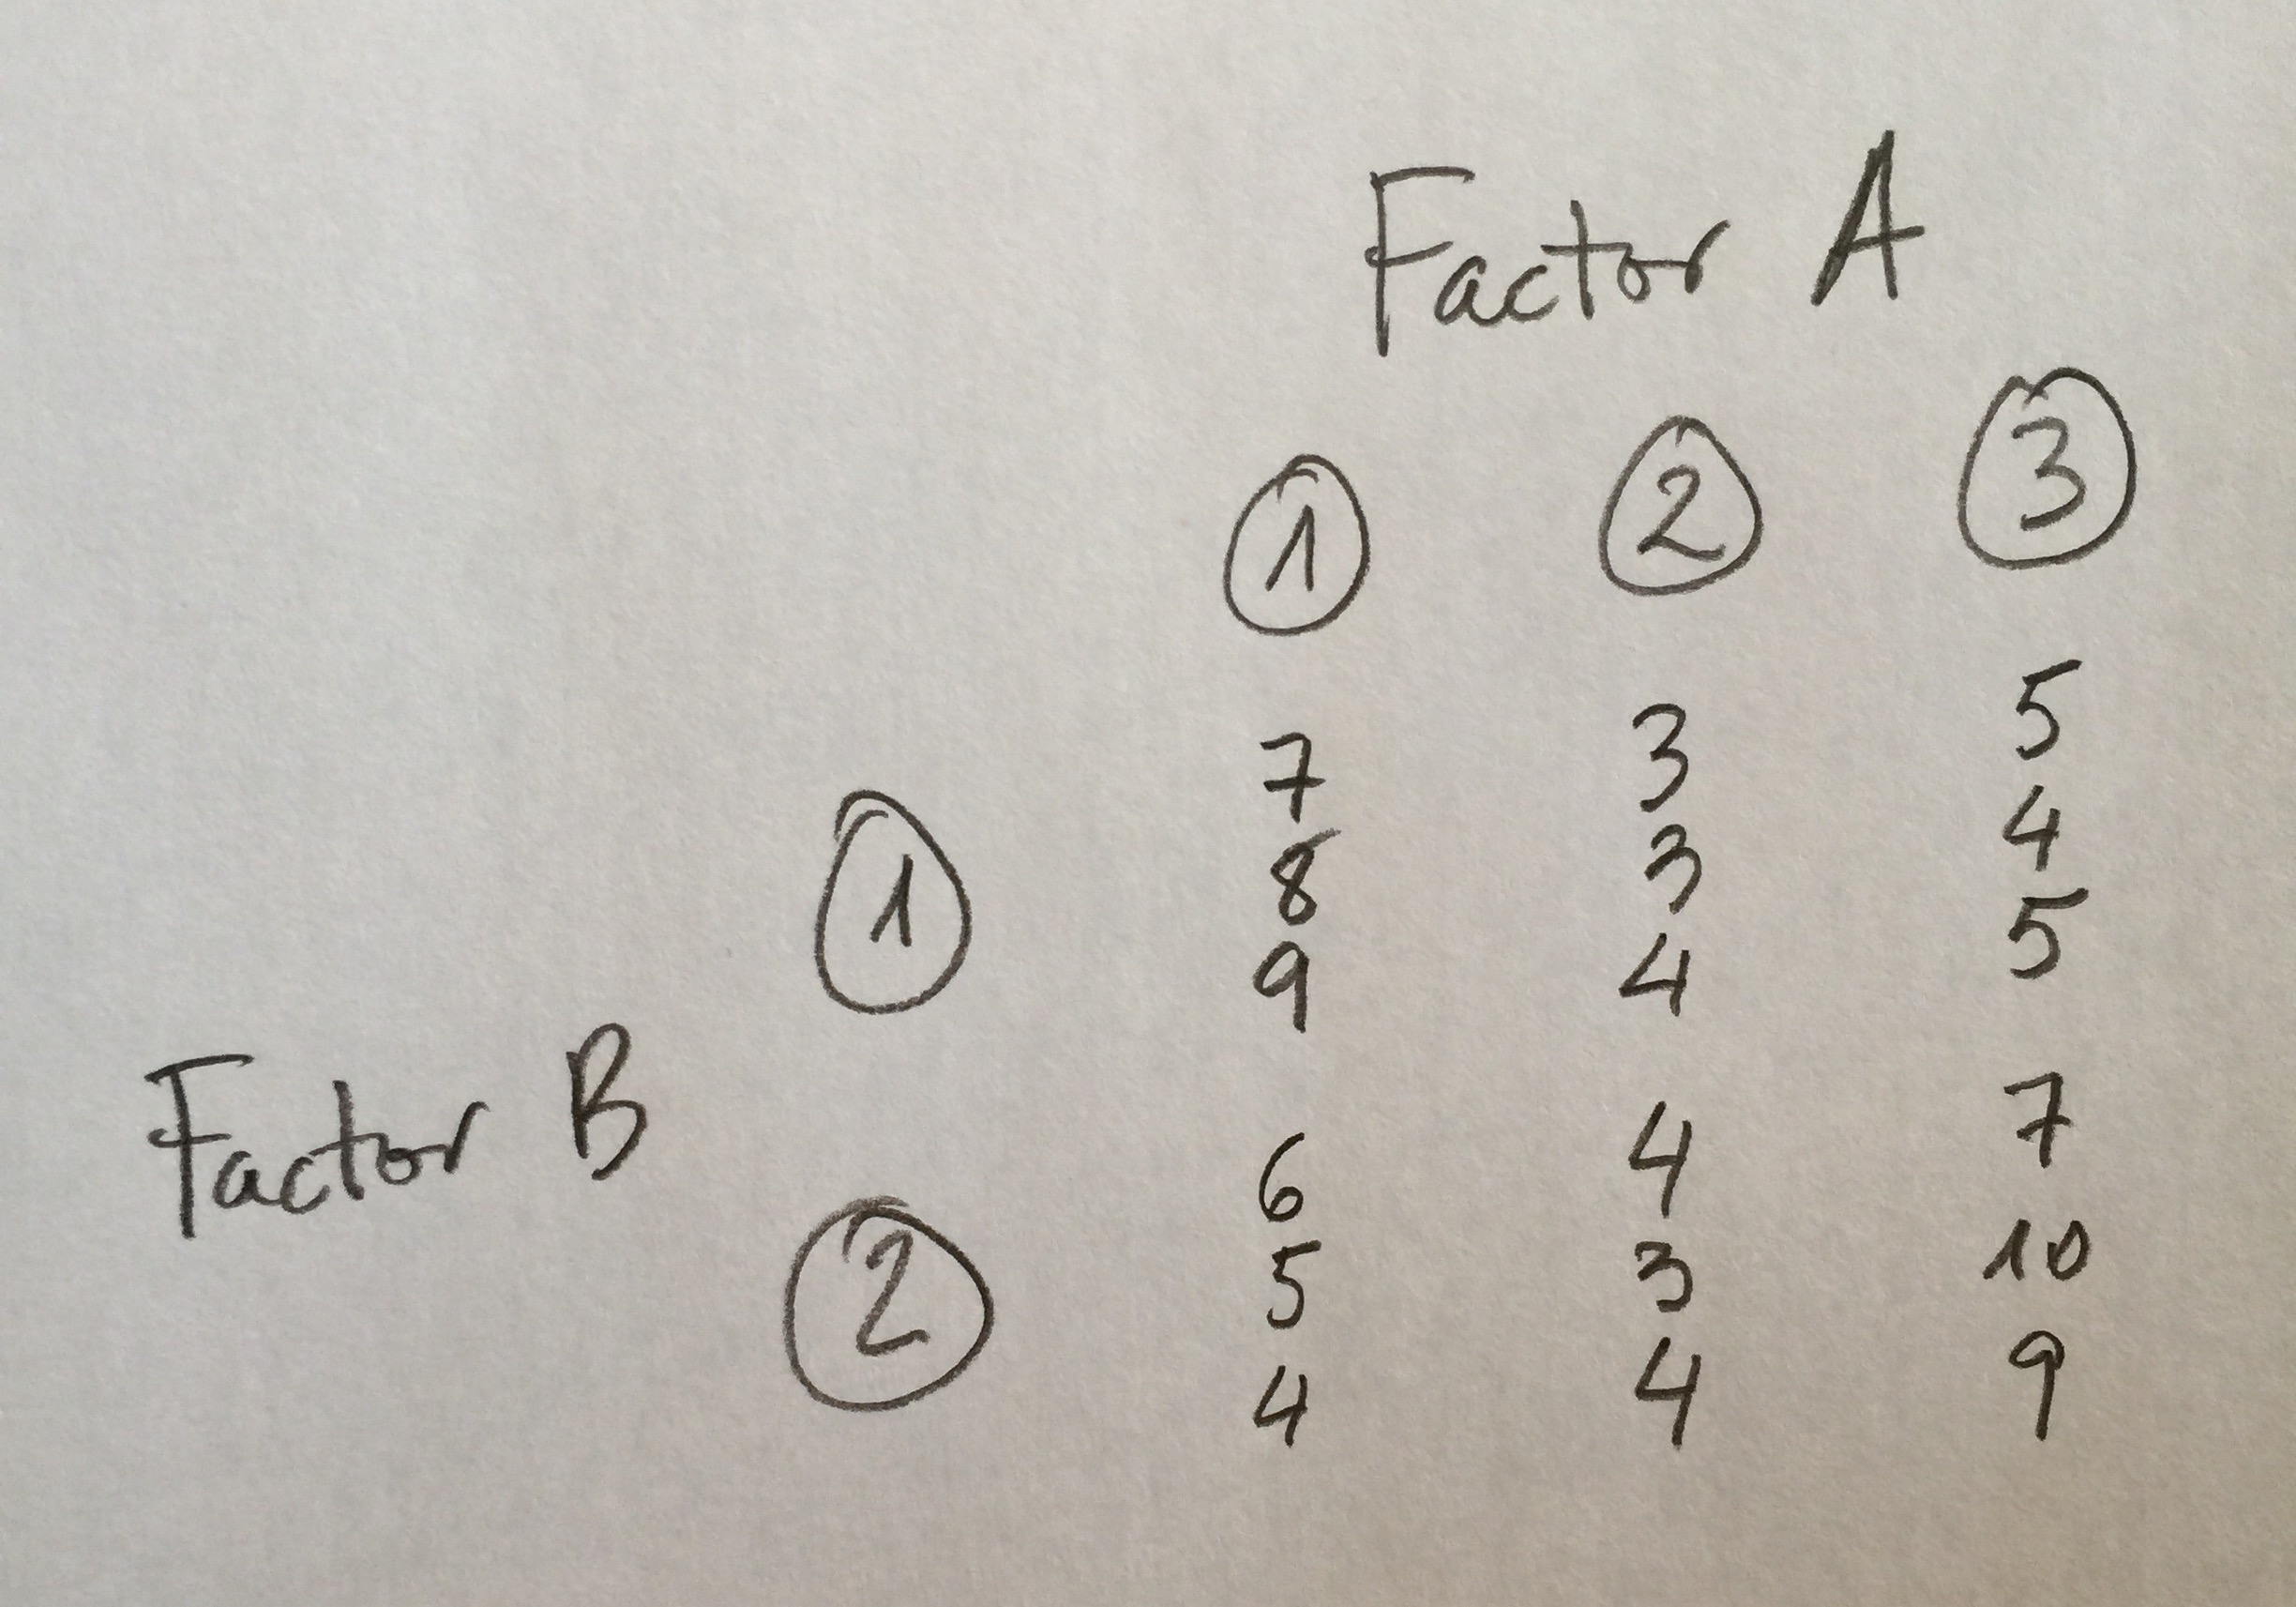
3a: El factor A es claramente significativo. El B no porque obsérvese que los valores en promedio son muy iguales. Y habrá interacción porque es evidente que no hay paralelismo en estos datos.

4d: Se trata de una variable cuantitativa. Es evidente que ninguno de los tres tests propuestos puede ser aplicable porque funcionan únicamente para variables dicotómicas.

5b: En esta muestra a la izquierda de 9 hay seis valores y cuatro a la derecha. Por lo tanto, el presentir 60 será el promedio de 9 y 11 que es 10.

6b. Si la correlación es 0.9 el coeficiente de determinación será, claramente, el 81%.

7c: Sustituyendo los valores de ese individuo en la fórmula de la primera componente obtenemos el valor de 2.5.

8c: Observemos que el error estándar es 0.5 porque el centro del intervalo es 21 y dos veces 0.5 no proporciona un radio del intervalo de 1, porque es un IC del 95%. Por lo tanto, si la DE es 10 y el tamaño de muestra 400, el error estándar será 0.5.

9c: Si se aplica la fórmula de la determinación del tamaño de muestra con estos datos observamos que nos da 16.

10b: Variables cuantitativas, muestras relacionadas y no hay normalidad. Por lo tanto, hay que aplicar el Test de los signos o el de Wilcoxon.

11d: Variables continuas, muestras independientes, hay normalidad en las dos muestras y no hay igualdad de varianzas.

12c: Es evidente que la potencia, al ser mayor del 80%, es suficiente. Por lo tanto, podemos afirmar lo que dice el apartado c.

13c: La V de Crámer en sí no nos da un p-valor, necesitamos hacer un contraste de hipótesis. Como la V sólo la podemos calcular a tablas de contingencias, para ver si hay relación significativa debemos aplicar un test de la ji-cuadrado.

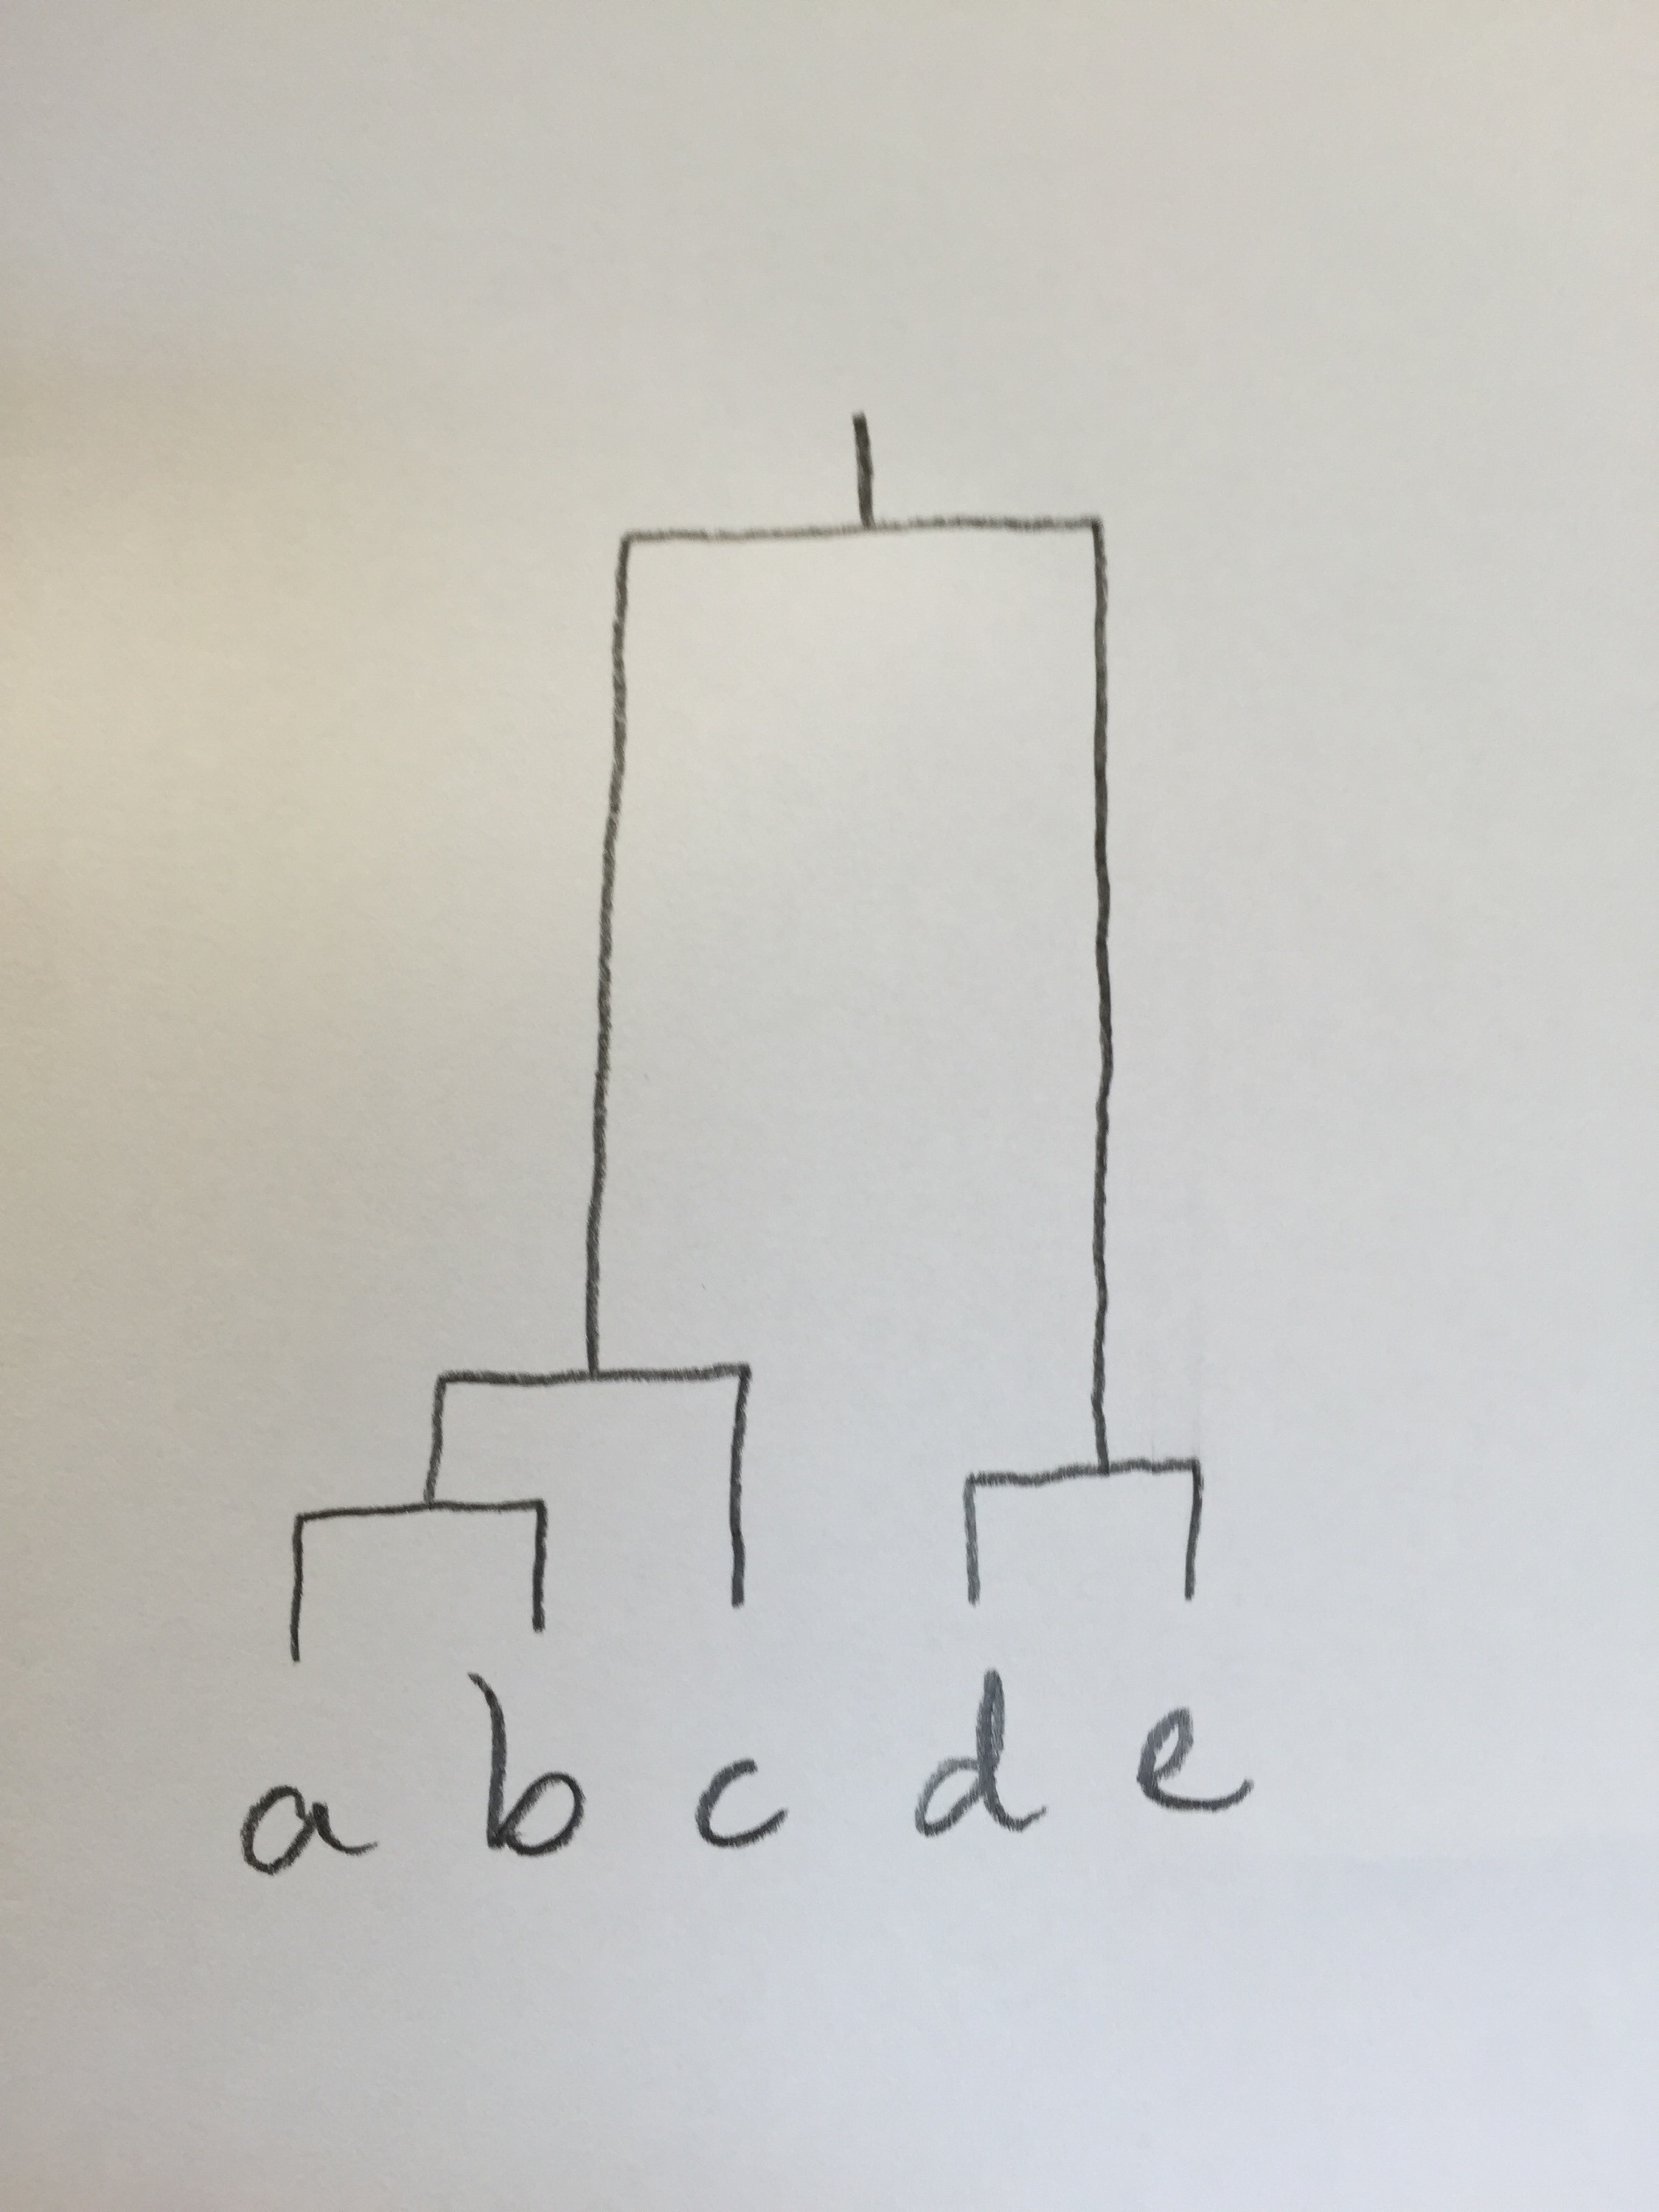
14d: Es la única que no encaja con ese esquema: a y b, por un lado, y d y e por otro, a una distancia corta y c a una distancia más próxima al primer subgrupo que al segundo. Cosa que no sucede en la muestra d.

15d: El error estándar es 15 porque 45/raiz(9) es ese valor. Como el intervalo es del 95% debemos tomar dos errores estándar para construir el intervalo.

16a: El valor de referencia en tablas 2×2 es de 3.84. Como 2.6 es menor que 3.84 podemos decir que no estamos ante una relación significativa. Lo afirmado en el punto d lleva al mismo resultado: la no significación, pero mediante una afirmación que no es cierta. No es por ser suficientemente próxima a 0, sino por estar por debajo del valor de referencia.

17c: Sólo tiene sentido calcularla cuando tenemos un p<0.05.

18d: Una ji-cuadrado nunca será negativa.

19d: El signo de la correlación y de la pendiente siempre coinciden.

20a: No es la significación de la interacción lo que hay que mirar para hacer las comparaciones múltiples sino la significación del factor estudiado. Si es significativo se harán comparaciones. Si no lo es de significativa entonces no se hacen tales comparaciones múltiples.


Situación 84: Examen (Temas 1-17 y 19)

1. ¿Cuál de las siguientes afirmaciones es cierta si hemos realizado un ANOVA de dos factores cruzados y tenemos una p=0.1 para el primer factor, una p=0.03 para el segundo factor y una p=0.01 para la interacción?

a. Hay diferencias significativas entre los niveles del primer factor, hay diferencias significativas entre los niveles del segundo factor y no hay interacción entre los dos factores.

b. Hay diferencias significativas entre los niveles del primer factor, hay diferencias significativas entre los niveles del segundo factor y hay interacción entre los dos factores.

c. No hay diferencias significativas entre los niveles del primer factor, no hay diferencias significativas entre los niveles del segundo factor y no hay interacción entre los dos factores.

d. No hay diferencias significativas entre los niveles del primer factor, hay diferencias significativas entre los niveles del segundo factor y hay interacción entre los dos factores.


2. ¿Cuál de las siguientes presentaciones de la Odds ratio es incoherente?

a. OR=0.33 IC 95% (0.01, 0.6) p=0.001

b. OR=0.1 IC 95% (0.01, 0.6) p=0.13

c. OR=4.2 IC 95% (1.5, 15.3) p=0.02

d. OR=0.5 IC 95% (0.3, 1.7) p=0.53


3. En un estudio clínico con los siguientes datos, ¿cuál es la afirmación cierta?

FullSizeRender

a. El p-valor del Factor A en un ANOVA de dos factores será menor de 0.05, el del Factor B será mayor que 0.05 y el p-valor de la interacción será menor que 0.05.

b. El p-valor del Factor A en un ANOVA de dos factores será mayor de 0.05, el del Factor B será menor que 0.05 y el p-valor de la interacción será mayor que 0.05.

c. El p-valor del Factor A en un ANOVA de dos factores será menor de 0.05, el del Factor B será menor que 0.05 y el p-valor de la interacción será mayor que 0.05.

d. El p-valor del Factor A en un ANOVA de dos factores será mayor de 0.05, el del Factor B será mayor que 0.05 y el p-valor de la interacción será mayor que 0.05.


4. Se están comparando dos tratamientos a pacientes con trastorno bipolar. La variable analizada es la concentración de un determinado neurotransmisor. El tamaño de muestra es de 50 personas. Todas ellas toman ambos tratamientos en distintas épocas pero siempre durante un periodo depresivo. La técnica adecuada al caso es:

a. Un test de proporciones.

b. Un test de McNemar.

c. Un test exacto de Fisher.

d. Ninguna de estas tres anteriores.


5. ¿Cuál de las siguientes muestras tiene un percentil 60 igual a 10?

a. (0, 0, 9, 9, 9, 9, 10, 20, 20, 20)

b. (0, 9, 9, 9, 9, 9, 11, 11, 11, 20)

c. (0, 0, 0, 9, 9, 10, 12, 13, 14, 20)

d. (9, 9, 9, 10, 10, 10, 11, 11, 13, 29)


6. Si la relación entre dos variables la podemos representar mediante una regresión lineal simpe con una R2=81%, ¿cuál de las siguientes afirmaciones es cierta?

a. Existe una correlación significativa entre las variables.

b. La correlación de Pearson es de 0.9.

c. Si la relación es significativa, cosa que no podemos afirmar con la información que tenemos, se trata de una muy débil determinación la que hay entre una y otra variable.

d. La regresión no sabemos si es o no significativa pero sí sabemos que la correlación es negativa entre las dos variables.


7. Si en un Análisis de componentes principales tenemos como primer componente la variable Y1=0.5X1+0.5X2+0.5X3+0.5X4+0.5X5, ¿qué afirmación cierta?:

a. Un individuo con los valores (0, 1, 1, 1, 1) de las cinco variables originales tendrá un valor de 1 para la primera componente.

b. Existe una débil correlación entre las cinco variables originales del estudio.

c. Un individuo con los valores (1, 1, 1, 1, 1) de las cinco variables originales tendrá un valor de 2.5 para la primera componente.

d. Un individuo con los valores (1, 1, 1, 1, 0) de las cinco variables originales tendrá un valor de 1 para la primera componente.


8. Tenemos un IC del 95% de la media que es (20, 22), ¿qué afirmación es cierta?

a. El tamaño de muestra es 200.

b. La desviación estándar es 1.

c. Si la desviación estándar es 10 el tamaño de muestra es 400.

d. Un intervalo de confianza del 99.5% sería (19, 23)


9. ¿Qué tamaño de muestra necesitamos tener para estimar la media poblacional del Mini-Mental en el diagnóstico de pacientes con Alzhéimer si sabemos, a partir de una muestra piloto, que la Desviación estándar es, aproximadamente, 0.2 y queremos tener un intervalo de confianza de una precisión establecida con un radio de 0.1?

a. 160

b. 1600

c. 16

d. 16000


10. Si comparamos el Mini-Mental al año y a los dos años del diagnóstico en 100 pacientes con Alzhéimer para comprobar si ha habido un descenso significativo en el nivel de esta variable y aplicamos un test de Shapiro-Wilk a las restas de los valores, paciente a paciente, obteniendo un p-valor de 0.001, debemos aplicar:

a. El test de la t de Student de varianzas iguales.

b. El test de los signos o el test de Wilcoxon. Cualquiera de los dos es aceptable en este caso.

c. El test de la t de Student de datos apareados.

d. Debemos comprobar la igualdad de varianzas con el test de Fisher-Snedecor. Si el p-valor de este test es mayor que 0.05 debemos aplicar el test de la t de Student de varianzas iguales, si el p-valor es menor que 0.05 debemos aplicar el test de la t de Student de varianzas desiguales.


11. Queremos comparar el nivel de conocimientos de estudiantes de Psicología de dos universidades distintas justo al final de sus estudios. Para ello realizamos un test a 40 alumnos de cada una de esas dos universidades. Las medias muestrales son 6 y 7, respectivamente. Las desviaciones estándar son 1.5 y 1.65, respectivamente. Aplicamos un test de Shapiro-Wilk a cada una de las dos muestras y tenemos los siguientes p-valores: 0.3 y 0.1, respectivamente. El test de Fisher-Snedecor de comparación de varianzas tiene un p-valor de 0.007. La técnica adecuada al caso será:

a. El test de la t de Student de datos apareados.

b. El test de Mann-Whitney.

c. El test de la t de Student de varianzas iguales.

d. El test de la t de Student de varianzas desiguales.

12. Si tenemos dos muestras independientes de dos poblaciones a las que hemos aplicado correctamente un test de la t de Student de varianzas iguales con un p-valor de 0.04 y una potencia del 90%, ¿cuál de las siguientes afirmaciones es cierta?:

a. No tenemos suficiente potencia.

b. Para afirmar que hay diferencias a nivel poblacional, con máximo nivel de fiabilidad, necesitamos tener una potencia del 99%.

c. Podemos afirmar ya, a partir del p-valor y de la potencia, que hay diferencias entre ambas poblaciones comparadas.

d. Debemos aumentar el tamaño de muestra hasta que el p-valor sea mayor que 0.05.


13. Si hemos calculado la V de Crámer entre dos variables cualitativas y resulta ser un valor de 0.5 podemos afirmar:

a. Es una relación estadísticamente significativa.

b. Podemos crear una regresión lineal simple entre estas dos variables.

c. Para evaluar la significación de la relación necesitamos hacer un test de la ji-cuadrado.

d. Se trata de una relación directa por ser un valor positivo el de la V de Crámer.


14. Si tenemos una muestra de cinco pacientes (a, b, c, d, e) a los que les hemos medido una única variable cuantitativa y de la cual tenemos el siguiente dendrograma, obtenido mediante un Análisis clúster:

IMG_1510

¿Cuál de las siguientes muestras no está razonablemente asociada a este análisis?:

a. (5, 6, 8, 50, 51)

b. (500, 503, 490, 150, 151)

c. (50, 51, 53, 5, 6)

d. (50, 51, 70, 80, 90)


15. Un intervalo de confianza del 95% de la media con media muestral de 100, con desviación estándar de 45 y tamaño muestral de 9 es el siguiente:

a. (97, 103).

b. (94, 106).

c. (85, 115).

d. (70, 130).


16. Si en una tabla de contingencias 2×2 en la que relacionamos dos variables cualitativas tenemos que el valor de la ji-cuadrado es 2.6 podemos afirmar:

a. Que estamos ante una relación no significativa porque el valor 2.6 es inferior al valor de referencia máximo aceptable para mantener la hipótesis nula en las tablas 2×2.

b. Que es imposible saber la significación porque no podemos saber si el p-valor es mayor o menor que 0.05.

c. Que el valor de la ji-cuadrado no nos dice nada sobre la significación de esa relación.

d. No es una relación significativa porque el valor 2.6 es un valor suficientemente próximo a cero.


17. ¿Cuál de las siguientes afirmaciones no es cierta respecto a la V de Crámer?

a. Es una medida del grado de relación entre dos variables cualitativas.

b. Es un valor que está entre 0 y +1.

c. Tiene sentido calcularla tras una ji-cuadrado con p>0.05.

d. Puede calcularse a cualquier tabla de contingencias.


18. ¿Cuál de las siguientes afirmaciones no es cierta?:

a. El error estándar siempre es menor o igual a la desviación estándar en el estudio de una variable.

b. Una correlación de Pearson no puede aplicarse a la relación entre variables cualitativas.

c. Una V de Crámer nunca puede ser negativa.

d. Un valor de ji-cuadrado negativo implica una relación inversa entre las variables estudiadas.


19. ¿Cuál de las siguientes afirmaciones es cierta?

a. La mediana de una muestra siempre es igual al primer cuartil.

b. Una Odds ratio de 2.5 con un intervalo de confianza del 95%: (0.45, 7.18) indica que estamos ante un factor de riesgo significativo porque el intervalo no incluye al 0.

c. Si en una muestra de una variable cuantitativa la asimetría estandarizada está dentro del intervalo -2 y 2, entonces podemos describirla perfectamente mediante la media y la desviación estándar.

d. Una correlación negativa irá acompañada de una regresión lineal simple con pendiente negativa.


20. ¿Cuál de las siguientes afirmaciones no es cierta?

a. En un ANOVA de dos factores las comparaciones múltiples de un factor se hacen únicamente si la interacción es significativa.

b. El rango y el rango intercuartílico, en una muestra, pueden ser iguales.

c. Una Odds ratio de 1.75 con un intervalo de confianza del 95%: (1.05, 3.18) indica que se trata de un factor de riesgo estadísticamente significativo.

d. Si en una tabla de contingencias calculamos un valor de ji-cuadrado y es 5.67, la significación de ese valor dependerá del número de filas y columnas de esa tabla.



Solución Situación 83

1c: El p-valor de los dos factores es superior a 0.05 y el de la interacción es inferior a 0.05. Por lo tanto, los dos factores no son significativos y la interacción sí.
2c: Es evidente que no hay igualdad entre los cuatro niveles. Y si se observa con detenimiento los tres primeros niveles son muy similares y el cuarto es el que se aparta de los demás. Por lo tanto, el ANOVA tendrá un p-valor inferior a 0.05 y que en las comparaciones múltiples tendremos dos grupos homogéneos en este estudio: el formado por los niveles 1, 2 y 3 y el formado por el nivel 4.

3a: Las Odds ratio significativas son la a, c y d. La duda está entre la a y la c, entre 0.3 y 3. Es mayor 0.3 porque si dividimos 1/0.3 obtenemos 3.333333 que es mayor que 3. Si hacemos lo contrario, 1/3 es 0.33333. Y 0.3 está más alejado del 1 que 0.3333333.

4b: La variable es dicotómica porque se mira si la diferencia es positiva o no. Las muestras son relacionadas porque los dos tratamientos se ensayan con cada paciente. Por lo tanto, se debe aplicar el test de McNemar.

5c: Es la única muestra que cumple todas las propiedades exigidas.

6c: Se trata de un coeficiente de determinación muy grande, pero con la información que tenemos no sabemos si se trata de una relación significativa. Ese coeficiente no marca significación sino magnitud de relación.

7c: Un individuo con los cinco valores de 1 tendría un valor de 1.5 no de 2.5 de la primera componente.

8d: El error estándar es 0.5 por lo que un intervalo de confianza del 99.5% de la media será el resultado de restar y sumar tres veces ese error estándar a la media. Por lo tanto, ese intervalo es correcto.

9b: Si se aplica la fórmula del Tema 16 para obtener el tamaño se obtiene de forma directa, pero hay otra forma de razonarlo. El error estándar que se pretende tener es de 0.05 porque se pretende un radio de intervalo de 0.1 en un intervalo de confianza del 95%. Si la DE es 2 para obtener un error estándar de 0.05 debemos dividir 2 por 40 (2/40=0.05). Por lo tanto, 40 es igual a la raíz cuadrada del tamaño de muestra que necesitamos; o sea, 1600.

10c: Variable continua, muestras relacionadas, ajuste a la normal. Por lo tanto, el test adecuado es el de Student de datos apareados.

11b: Son muestras independientes de una variable continua. Una se ajusta a la distribución normal (p>0.05) y la otra no (p<0.05) por lo que debemos aplicar un test de Mann-Whitney. Para aplicar algunos de los dos test de la t de Student hace falta que las dos distribuciones sean normales.

12b: El p-valor es un criterio que debe ir acompañada de otro mecanismo de control, de la potencia. Si en una comparación tenemos un p-valor de 0.55 si no hay suficiente potencia, que lo marcará un determinado tamaño de muestra, no podremos decir que no haya diferencia entre los dos grupos comparados. Se precisa una potencia al menos del 80%.

13d: Se trata de una correlación significativa, como es positiva la pendiente de la recta de regresión también será positiva. Y como es una correlación significativa también lo será la pendiente. Siempre lo que le sucede a la correlación, en materia de significación, y en materia de signo, es lo mismo que le sucede a la pendiente.

14c: Observemos que a y b están a la misma distancia que d y e. Por eso empiezan igual en el dendrograma. Pero, al mismo tiempo el grupo de a y b está muy alejado del grupo formado por d y e. A continuación, el siguiente en unirse es c al grupo formado por a y b, porque está muy próximo a ellos. Entre el grupo formado, ahora, por a, b y c y el grupo formado por d y e sí que hay mucha distancia.

15a: Como es un intervalo de la media debemos fijarnos en el error estándar, que es 1.5 (15/raiz(100)). Por lo tanto, si el intervalo es del 95% debemos sumar y restar dos veces ese error estándar. El intervalo es, pues, (97, 103).

16a: Sabemos que en toda tabla 2×2 el valor de referencia para la significación es 3.84. Como 4.6 es mayor que ese valor sabemos que se trata de una relación significativa. Siempre, una tabla de contingencias, con un número de filas y columnas determinado, tiene un valor de referencia a partir del cual el valor de la ji-cuadrado que obtengamos marcará que no podemos mantener la hipótesis nula de no relación entre las variables cualitativas estudiadas. En general,  no sabemos cuál es ese valor, pero en el tema 8 donde todos los ejemplos se ponen en tablas 2×2, se puede observar que el 3.84 es el valor de referencia para todas las tablas que tengan 2 filas y 2 columnas. Revisar la importante tabla del final del tema 8.

17d: La V de Crámer tiene la enorme ventaja que es calculable para cualquier tabla de contingencias, tenga el número de filas que tenga y el número de columnas que tenga.

18d: Si r=0.9 es evidente que el coeficiente de determinación será del 81%, y ese coeficiente marca la cantidad que una variable determina a la otra. Las otras respuestas no son correctas. Las otras tres respuestas serían únicamente correctas si la correlación fuera r=1, que no es el caso. Hay, por lo tanto, un error, lo que no garantiza que ni en la muestra ni en futuras observaciones cuando tengamos un valor de x=5 tendremos un valor de y=15.

19d: Toda variable tiene desviación estándar, aunque sea dicotómica. En concreto, en una dicotómica DE=raiz(p(1-p)), siendo p la proporción de unos que tengamos.

20d: La significación de cualquier tabla de contingencias depende de un valor de referencia. Valor de referencia que, como hemos visto en el tema 8, depende del número de filas y de columnas, pero no del tamaño de muestra. Observad, de nuevo, el gráfico final del tema 8. Podéis ver que el valor de 3.84 es el mismo para un caso de tabla con mucho tamaño de muestra y para otro con menor tamaño de muestra. Sólo depende de que sea una tabla con dos filas y dos columnas. Otra tabla, por ejemplo, una tabla 4×3 tiene otro valor de referencia que depende, de nuevo, de las filas y columnas que tengamos, no de la cantidad de muestra que tengamos.


Solución Situación 82

1c: El rango es 100-2=98.

2a: El percentiel 60 en esta muestra es el promedio de 5 y 15 que es 10. En las otras muestras el percentil 60 no es 10.

3b: En la segunda muestra el valor de 2000 hace que casi todo esté en manos de una persona. Esto es lo que genera un índice muy grande, próximo a 1.

4a: El error estándar es 2 porque 10 dividido por la raíz cuadrada de 25 es 2. Como el intervalo de la media es del 95% debemos coger dos errores estándar, por lo tanto, el intervalo será (96, 104).

5a: Como la variable es continua, las muestras son independientes y no hay normalidad debemos aplicar el Test de Mann-Whitney directamente sin comprobar igualdad de desviaciones estándar.

6d: Porque si el tamaño de muestra es grande y la diferencia de medias también lo es, esto va a favor de tener muchas posibilidades de rechazar la hipótesis nula de igualdad de medias, no menos posibilidades como dice la afirmación «d».

7a: Si en lugar de 43 es 73 el índice de Gini será mayor porque introducimos más diferencias entre las personas de la muestra.

8c: Rango y rango intercuartílico pueden ser iguales. Por ejemplo, la siguiente muestra: (0, 0, 10, 10) tienen el mismo rango y rango intercuartílico: 10. La «d» no es correcta, no siempre la mediana es menor que el tercer cuartil. Por ejemplo, en la muestra (0,5, 5, 5) la mediana y el tercer cuartil son iguales. Valen 5 ambos estadísticos.

9d: Falta la información acerca de si la variable resta se ajusta o no a la distribución normal. En función de eso sabremos si hace falta aplicar el test de la t de Student de datos apareados o el de los signos o Wilcoxon.

10c: Si es un intervalo de confianza de la media ese intervalo se construye con el error estándar y, como es un intervalo del 95%, se construye con dos errores estándares. Como el intervalo tiene un radio de 1 y ese radio es dos veces el error estándar, el error estándar debe ser 0.5.

Situación 82: Examen (Temas 1-4 y 13-14)

1. Si tenemos la muestra siguiente: (8, 8, 4, 4, 2, 2, 10, 100) no es cierto lo siguiente:

a. La mediana es 6.

b. El rango intercuartílico es 6.

c. El rango es 102.

d. El tercer cuartil es 9.

2. ¿Cuál de las siguientes muestras tiene un percentil 60 igual a 10?

a. (2, 3, 3, 4, 5, 5, 15, 15, 20, 20).

b. (2, 3, 3, 4, 5, 10, 15, 15, 20, 20).

c. (2, 3, 3, 4, 5, 10, 12, 15, 20, 20).

d. (2, 3, 3, 4, 5, 8, 10, 15, 20, 20).

3. ¿Cuál de las siguientes muestras tiene un índice de Gini mayor?

a. (0, 0, 1, 1, 5, 15, 15, 20, 20, 20).

b. (0, 0, 1, 1, 5, 15, 15, 20, 20, 2000).

c. (0, 0, 1, 1, 5, 15, 15, 20, 20, 200).

d. (10, 10, 10, 10, 15, 15, 15, 20, 20, 20).

4. Si la valoración media de un activo financiero a lo largo del tiempo tiene media 100 y desviación estándar 10 y la muestra con la que hemos trabajado es de tamaño 25, ¿cuál es un intervalo de confianza del 95% de la media?

a. (96, 104).

b. (90, 110).

c. (80, 120).

d. (98, 102).

5. Queremos comparar el nivel de conocimientos de estudiantes de Economía de dos universidades distintas justo al final de sus estudios. Para ello realizamos un test a 30 alumnos de cada una de esas dos universidades. Las medias muestrales son 5 y 6.5, respectivamente. Las desviaciones estándar son 1.5 y 1.65, respectivamente. Aplicamos un test de Shapiro-Wilk a cada una de las dos muestras y tenemos los siguientes p-valores: 0.001 y 0.01, respectivamente. La técnica adecuada al caso será:

a. El test de Mann-Whitney.

b. El test de la t de Student de varianzas iguales.

c. El test de la t de Student de vaianzas desiguales.

d. Hace falta hacer el test de Fisher-Snedecor para comprobar la igualdad de varianzas y saber, así, si debemos aplicar el test de la t de Student de varianzas iguales o el test de la t de Student de varianzas distintas.

6. ¿Cuál de las siguientes afirmaciones no es cierta en la comparación de la media de dos poblaciones?

a. Cuanto mayor tamaño de muestra y menor desviación estándar más posibilidades de rechazar la Hipótesis nula.

b. Cuanta mayor desviación estándar y menor diferencia de medias menos posibilidades de rechazar la Hipótesis nula.

c. Cuanta mayor diferencia de medias y mayor tamaño de muestra más posibilidades de rechazar la Hipótesis nula.

d. Cuanto mayor tamaño de muestra y mayor diferencia de medias menos posibilidades de rechazar la Hipótesis nula.

7. Si tenemos la siguiente muestra de rentas (1, 3, 5, 34, 43) y hemos calculado el índice de Gini, si, de repente, nos damos cuenta que el valor 43 era erróneo, que debía ser 73, ¿qué sucederá al recalcular el índice de Gini con el valor correcto?:

a. Será mayor.

b. Será menor.

c. No cambiará.

d. Falta información para poder responder a esa pregunta.

8. ¿Cuál de las siguientes afirmaciones es cierta?

a. La media y la mediana son iguales si el rango es igual al rango intercuartílico.

b. La desviación estándar y el rango intercuartílico son sinónimos.

c. En una muestra el rango intercuartílico puede ser igual al rango.

d. La mediana siempre es un valor menor que el tercer cuartil.

9. Se están comparando dos fórmulas distintas de un producto entre consumidores habituales. La variable analizada es la valoración entre el 0 y el 10. El tamaño de muestra es de 50 personas. Cada persona prueba y puntúa cada una de las dos fórmulas. La técnica adecuada al caso es:

a. Un test de los signos.

b. El test de Mann-Withney.

c. Un test de la t de Student de datos apareados.

d. Falta información para precisar qué técnica es la adecuada al caso.

10. Tenemos un IC del 95% de la media que es (200, 202), ¿qué afirmación es cierta?

a. El tamaño de muestra es 100.

b. La desviación estándar es 1.

c. El error estándar es 0.5

d. Ninguna de las tres anteriores respuestas es cierta.


Una introducción a la Estadística inferencial para estudiantes de ESO

La Estadística que se estudia en la enseñanza secundaria es la Estadística descriptiva, la Estadística que se limita a describir lo que se tiene: una muestra. De ella se hacen gráficos que la resumen (histogramas, diagramas de frecuencias, diagramas de cajas (Box-Plot), etc), se calculan valores que detectan ciertas características (la media, la mediana, la desviación estándar, el rango, etc).

Esta introducción a la Estadística inferencial es un primer paso desde esa Estadística, la Estadística descriptiva, a la Estadística inferencial, que es la que con mayor frecuencia se van a encontrar esos alumnos cuando lleguen a la universidad o la acaben aplicando, en la vida real, como profesionales de la Economía, de la Medicina, de la Psicología, etc.

La Estadística inferencial es la que va más allá de la muestra, la que intenta decir cosas no de la muestra, sino de toda la población de donde se ha tomado la muestra. Es la Estadística que, apoyándose en la información muestral, pretende decir cosas de la población global. Por eso es inferencial, porque inferir significa ir más allá de lo que vemos, usar lo que tenemos para hablar de lo que no tenemos.

Supongamos la siguiente situación: dos grupos de investigación estudian cada uno de ellos una determinada enfermedad. Quieren saber si es una enfermedad asociada al sexo; o sea, más frecuente en un sexo que en otro.

El grupo que estudia la enfermedad A ha tomado una muestra de pacientes de esa enfermedad y 2 son hombres y 8 son mujeres.

El grupo que estudia la enfermedad B ha tomado una muestra de pacientes de esa enfermedad y 450 son hombres y 550 son mujeres.

Tenemos, por lo tanto, la siguiente situación:

IMG_1470

La Estadística descriptiva de estas dos muestras es muy sencilla de hacer. De la enfermedad A en la muestra el 20% son hombres y el 80% son mujeres. De la enfermedad B en la muestra el 45% son hombres y el 55% son mujeres.

La Estadística descriptiva aquí acaba su recorrido, no pretende más que eso: describir lo que tenemos, la muestra.

La Estadística inferencial, de hecho, empieza donde ha acabado la Estadística descriptiva. A partir de esos porcentajes muestrales incuestionables se plantea: Esa diferencia, ¿es SIGNIFICATIVA? Y aquí aparece la gran palabra de la Estadística: la palabra SIGNIFICATIVO.

Si ahora aplicáramos técnica estadísticas inferenciales acabaríamos viendo que la información que tenemos de la enfermedad A no es significativa y, sin embargo, la que tenemos de la enfermedad B sí lo es. Lo que implica que podemos decir que es mayor la diferencia que hay entre el 45% y el 55% de la enfermedad B que entre el 20% y el 80% de la enfermedad A.

Quien quiera profundizar más en las razones puede consultar el artículo titulado Introducción al contraste de hipótesis. Allí podrá ver la razón fundamental de por qué la diferencia entre 2 y 8 no es significativa y sí lo es la diferencia entre 450 y 550. Evidentemente, como puede suponerse, aquí la clave es el tamaño de muestra. Si en Estadística inferencial queremos decir cosas de todos a partir de una parte (de una muestra) el tamaño de esa muestra para hacer este salto va a ser, evidentemente, fundamental.

Una metáfora puede ayudar a entender todo esto, una metáfora tomada del mundo del baloncesto:

Si un equipo de baloncesto está ganando de 10 puntos en la media parte del partido, ningún aficionado al baloncesto diría que este partido ya está ganado. Si miráramos en una base de datos cientos de miles de partidos de baloncesto y buscáramos todos los partidos en los que un equipo ganaba de 10 faltando todavía 20 minutos de partido por jugar seguro que veríamos que más del 5% de veces ese equipo ha acabado perdiendo. En términos estadísticos diríamos que se trata de un resultado estadísticamente NO SIGNIFICATIVO.

Este número, el 5%, es muy importante en Estadística. Es un valor frontera muy importante. Es el error máximo que se ha establecido para poder afirmar algo en ciencias.

Por el contrario, si faltando un minuto un equipo está ganando de 10 puntos. Ahora  si buscásemos en esa misma base de datos partidos que un equipo, faltando un minuto para acabar el partido, iba ganando de 10 puntos, seguramente veríamos que menos del 5% de veces ese equipo ha acabado perdiendo. Si fuera así, diríamos, en términos estadísticos, que este resultado es estadísticamente SIGNIFICATIVO.

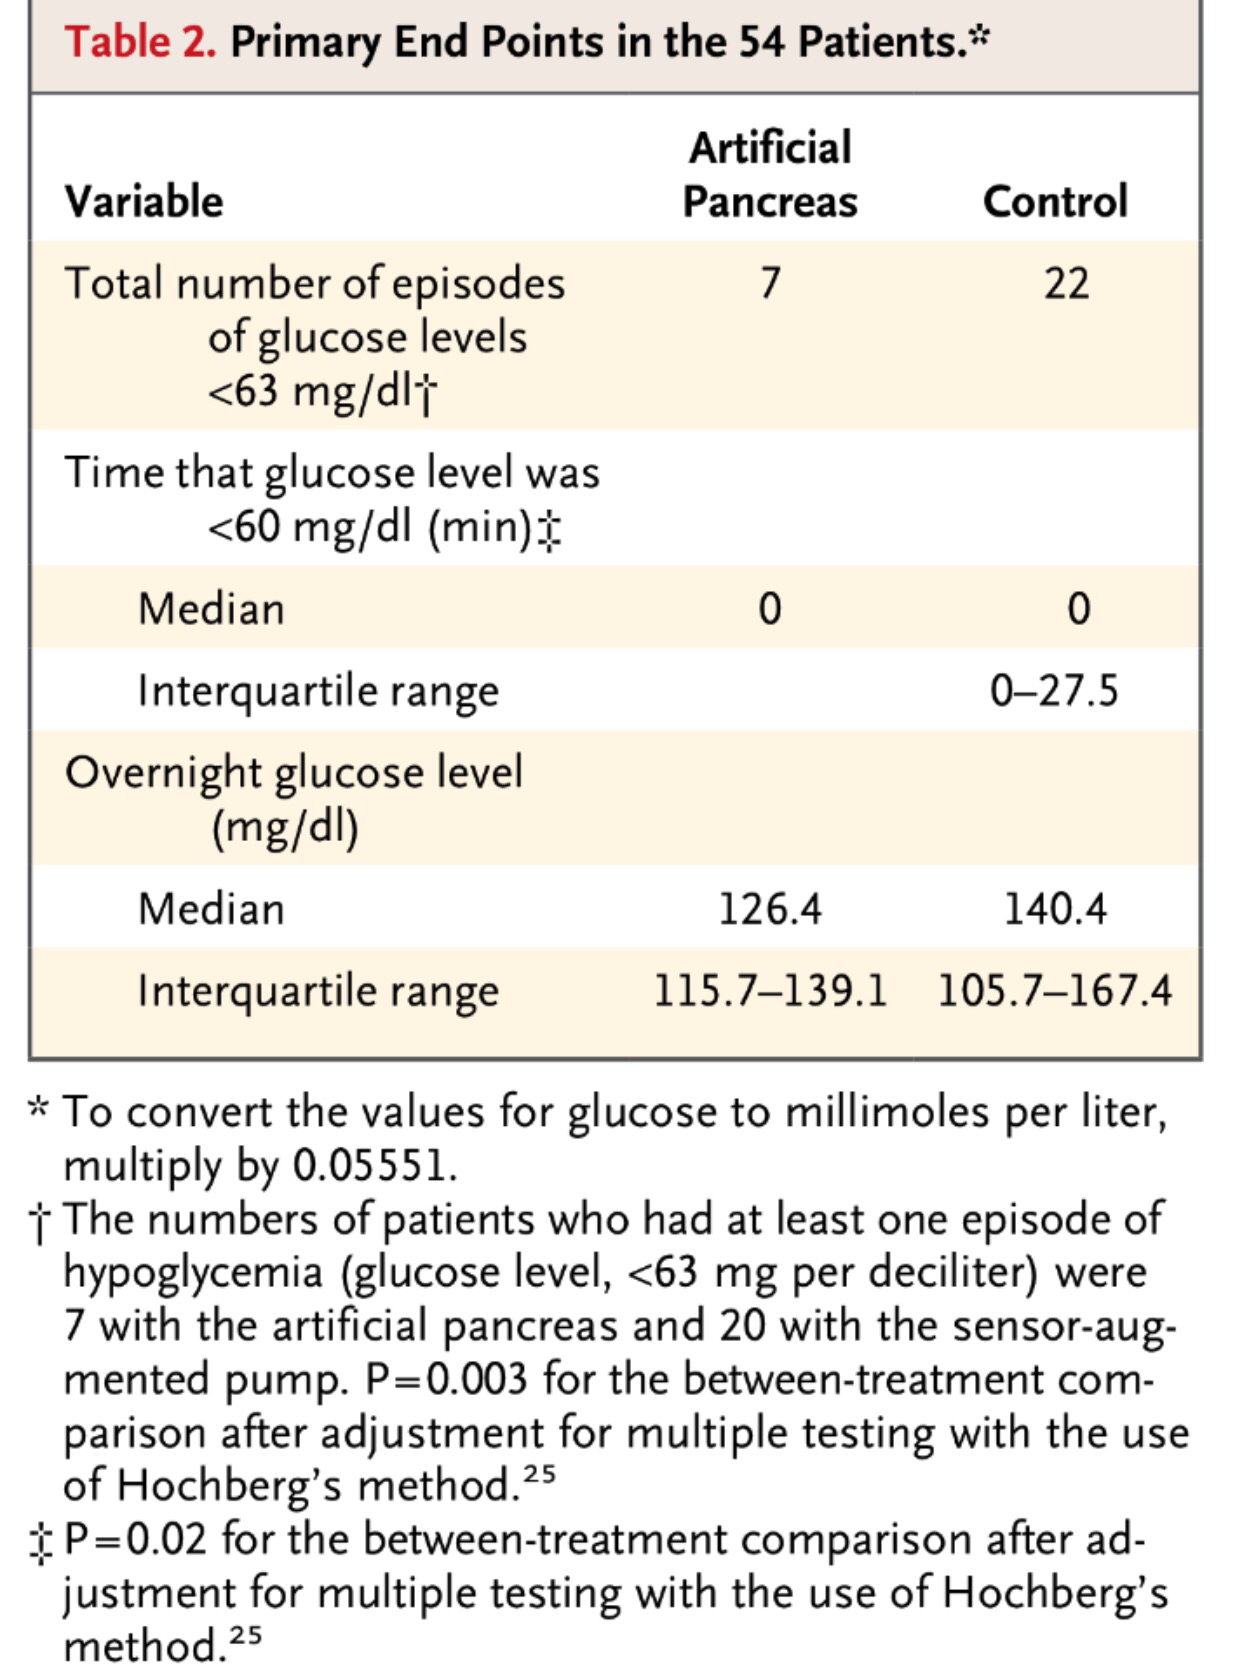
Observemos, ahora, los siguientes datos tomados de un importante y reciente estudio publicado en la revista médica más importante, el New England Journal of Medicine:


Se trata de un estudio donde se ensaya la implantación de un páncreas artificial. Para ello se toman 54 niños en un campamento para diabéticos y en dos noches se les trata de dos formas distintas. Una noche mediante el tratamiento habitual mediante insulina y otra noche mediante el páncreas artificial. Se analiza si durante la noche han tenido o no una hipoglucemia, que es la situación más grave que puede padecer un diabético. Como puede verse, con el páncreas artificial 7 de los 54 han padecido una hipoglucemia. Sin embargo, cuando estaban siendo tratados con la insulina, el tratamiento control, se produjeron 22 hipoglucemias. Es evidente que es distinto 7 de 22. Matemáticamente distinto. Pero lo que hace falta es ver si es una diferencia significativa, si es una diferencia estadísticamente significativa.

El valor p=0.02 es el que nos dice si se trata de un resultado significativo. Ser un resultado significativo implica decir que es extrapolable a la población. Que esta diferencia se mantendría si en lugar de tener sólo 54 pacientes tuviéramos millones y millones de pacientes.

Pues esto, esta operación de detectar la significación es la finalidad más importante de la Estadística. Se podría decir perfectamente que la Estadística inferencial es la técnica científica que permite afirmar si un resultado es o no SIGNIFICATIVO. Poca cosa, tal vez, pero de una trascendencia extraordinaria. Fijaos en otro paralelismo: Un juez es una persona encargada de decir, en un juicio, si un acusado es o no inocente. Básicamente es esa su labor. Poca cosa si se quiere, pero se trata de una labor muy trascendental en la sociedad. Pues un estadístico es en la ciencia como un juez en la sociedad. Dicta la sentencia de si un resultado es o no significativo.

Solución Situación 81

1c: El Test de la t de Student a aplicar será el de varianzas diferentes porque el test de Fisher-Snedecor nos da un p-valor inferior a 0.05. Y el test de la t de Student contrasta la igualdad de medias, no la de varianzas (la igualdad de varianzas la contrasta el Test de Fisher-Snedecor). Y si el p-valor de este test, el de la t de Student, es inferior a 0.05 debemos concluir que hay diferencia de medias estadísticamente significativa.

2d: Diferencia de medias grandes, tamaños de muestra grandes y desviaciones estándar pequeñas van a favor de rechazar la hipótesis nula de igualdad de medias, por lo tanto tienden a hacer bajar el p-valor. Por el contrario, diferencia de medias pequeñas, tamaños de muestra pequeños y desviaciones estándar grandes van a en contra de rechazar la hipótesis nula de igualdad de medias, por lo tanto tienden a hacer subir el p-valor. Visto esto la única respuesta cierta es la «d».

3c: Como el Test de Shapiro-Wilk es en ambas muestras menor que 0.05 no hay ajuste a la distribución normal y, por lo tanto, debemos aplicar el test de Mann-Whitney. La información del test de Fisher-Snedecor no nos hace falta en este estudio porque si no hay normalidad vamos directamente al test de Mann-Whitney haya o no haya igualdad de varianzas.

4b: La variable es dicotómica, las muestras independientes, el tamaño de muestra por grupo es mayor que 30 y el valor esperado por grupo es 9 por grupo. Por lo tanto, hemos de aplicar el test de proporciones. En un grupo hay 12 casos (4% de 300) y en el otro 6 (3% de 300), en total 18 casos, repartidos en dos grupos son 9. Esperamos, si fuera cierta la hipótesis nula tener 9 en cada grupo.

5c: Cuanta menor dispersión (medida mediante la desviación estándar) tengamos esto favorece encontrar diferencias, como ya hemos visto en la pregunta 2. La «a» no es cierta porque podría ser que una muestra se ajustara a la normal y la otra no. No necesariamente las dos deben ser no normales. La «b» no es cierta porque es justo lo contrario, un p-valor inferior a 0.05 indica que no hay normalidad. La «d» no es cierta porque si el p-valor del ANOVA es menor que 0.05 indica que no son iguales las poblaciones (los niveles del factor) pero no que son diferentes todos los niveles. De hecho, por eso se hace, cuando el p-valor del ANOVA es menor que 0.05, las comparaciones múltiples.

6c: El p-valor de la interacción es mayor que 0.05, por lo tanto, no hay interacción porque la hipótesis nula es que no hay interacción. Sólo si el p-valor es menor que 0.05 hay interacción significativa.

7b: La «b» es evidentemente cierta porque si hay más de un grupo homogéneo (dos o más) en las comparaciones el ANOVA nos debe dar que no hay igualdad, por lo que el p-valor será menor de 0.05.

8d: Si el radio es 40 y el intervalo de confianza es del 95% ese radio se constituirá mediante dos errores estándares, por lo que el error estándar será 20. Si la desviación estándar es 100 tengo que buscar un cociente del error estándar para que me de 20 y ese valor es 5, evidentemente. Por lo que el tamaño de muestra será 25.

Podemos llegar al mismo resultado de otra forma paralela, aplicando también la fórmula:

IMG_4908

y sustituyendo DE por 100 y r por 40 obtenemos que n debe ser 25.

9c: Como los coeficientes de la variable X e Y en la primera componente son positivos y el coeficiente de la variable Z es negativo y los tres son grandes, en valor absoluto, para que un individuo tenga un valor grande de esa primera componente y esté, por lo tanto, muy a la derecha del gráfico debe tener valores grandes de X e Y y pequeños de Z.

10c: Si observamos las tres columnas de datos (Factor A) podemos ver perfectamente que el nivel 1 y el 2 se parecen pero que el nivel 3 presenta valores mucho más altos. Por lo tanto, el Factor A debe ser significativo (p<0.05). Si miramos las dos filas (Factor B) podemos apreciar perfectamente que el nivel 1 siempre tiene valores más grandes que el nivel 2, por lo tanto, no habrá igualdad y el p-valor será también menor que 0.05. Respecto a la interacción podemos apreciar que no la hay. Si observamos las tres columnas de datos podemos ver un claro paralelismo. El nivel 3 del Factor A presenta valores más grandes pero en proporción a los valores que tenemos en las dos filas de la columnas del nivel 1 y del nivel 2. Por lo tanto, la interacción no es significativa (p>0.05).

Si los datos en lugar de ser los del examen fueran los siguientes:

IMG_1396

Ahora sí habría interacción. Observad que he cambiado de posición, en la columna 3, los dos niveles del Factor B. Ahora hay interacción. Ahora los valores relativos de los niveles del Factor B son unos cuando tenemos el nivel 1 y el nivel 2 del Factor A, y son justo lo opuesto cuando estamos en el nivel 3 de ese Factor A.

Por cierto, ahora el que no sería significativo sería el factor B.

El concepto de influencia estadística

En la imagen que se adjunta a continuación:

IMG_1325

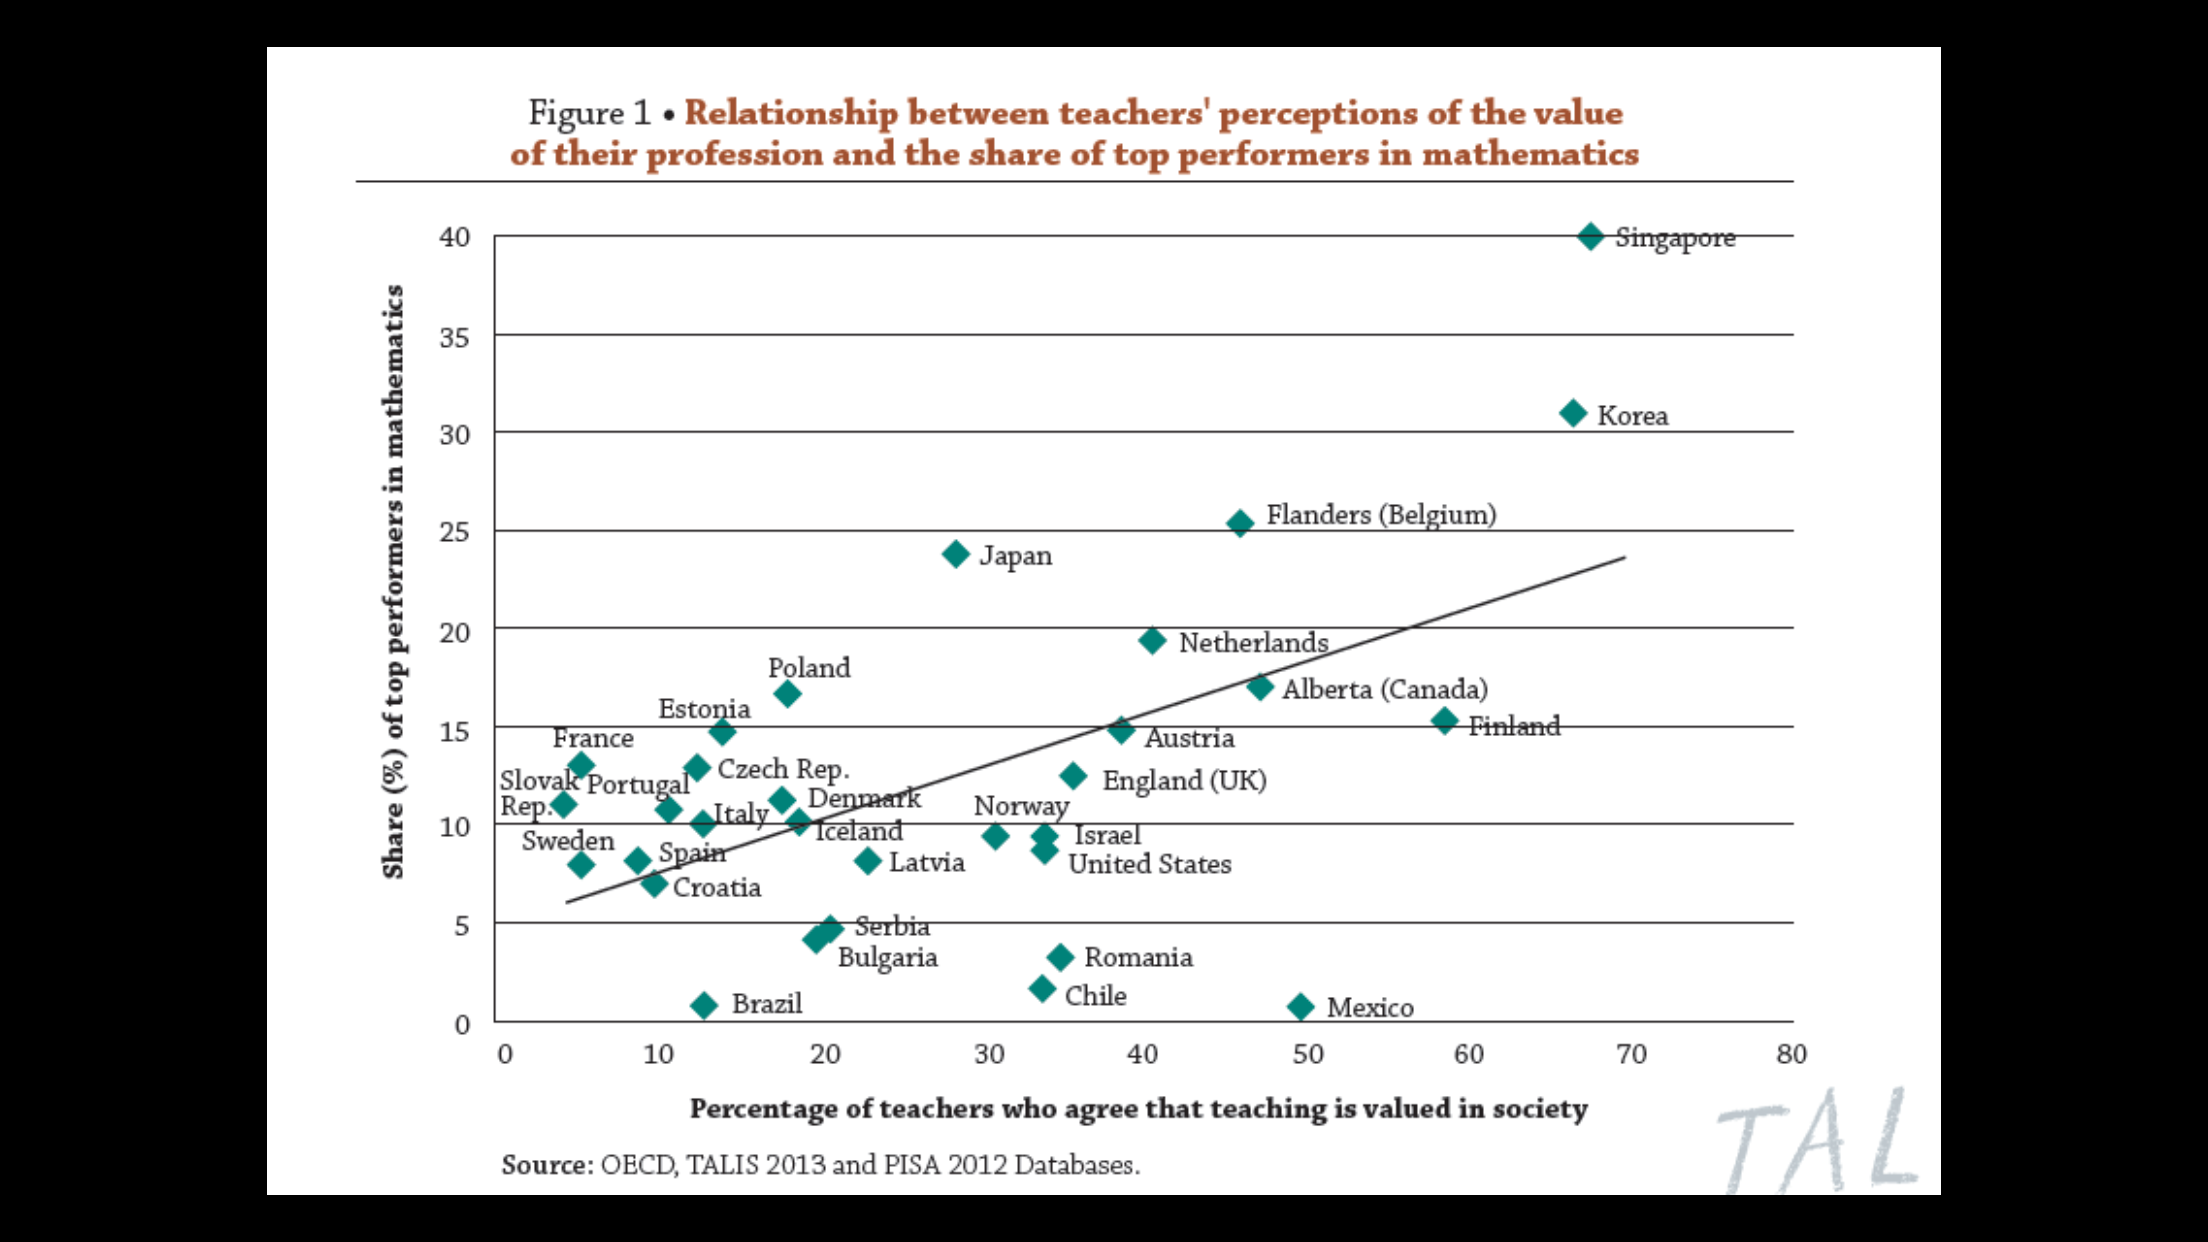
se puede ver un extraordinario ejemplo del concepto de INFLUENCIA en Estadística. Observad cómo hay una enorme infuencia en la recta de Regresión por parte de los países Korea y Singapore. Cualquier otro punto (país) lo podemos quitar y la recta no cambiaría, por lo que son puntos con poca influencia. Sin embargo, si quitáramos esos dos puntos, especialmente el de Singapore la recta cambiaría muchísimo. Tanto cambiaría que pasaría a no tener pendiente y tendríamos que decir que no hay relación entre estas dos variables estudiadas. Eso es la influencia estadística. En una muestra no todos los puntos tienen la misma influencia. En ocasiones, algunos valores tiene una elevadísima influencia. Por otro lado, esto ocurre en muchos otros ámbitos: Por ejemplo, en el Barça la influencia de Messi es como la de Singapore en ese gráfico. Sin él el Barça no sería lo mismo.

Otro caso de influencia es la siguiente muestra: (0, 1, 2, 3, 94). Para la media muestral de esta muestra, que es 20, no tienen la misma influencia los cinco valores. Es evidente que el 94 tiene una mucho mayor influencia.

Detectar influencias es muy importante en estadística. Existen diferentes mecanimos para detectar influencias. Un ejemplo es el Criterio de Cook para detectar influencia estadística en regresión.

Solución Situación 47

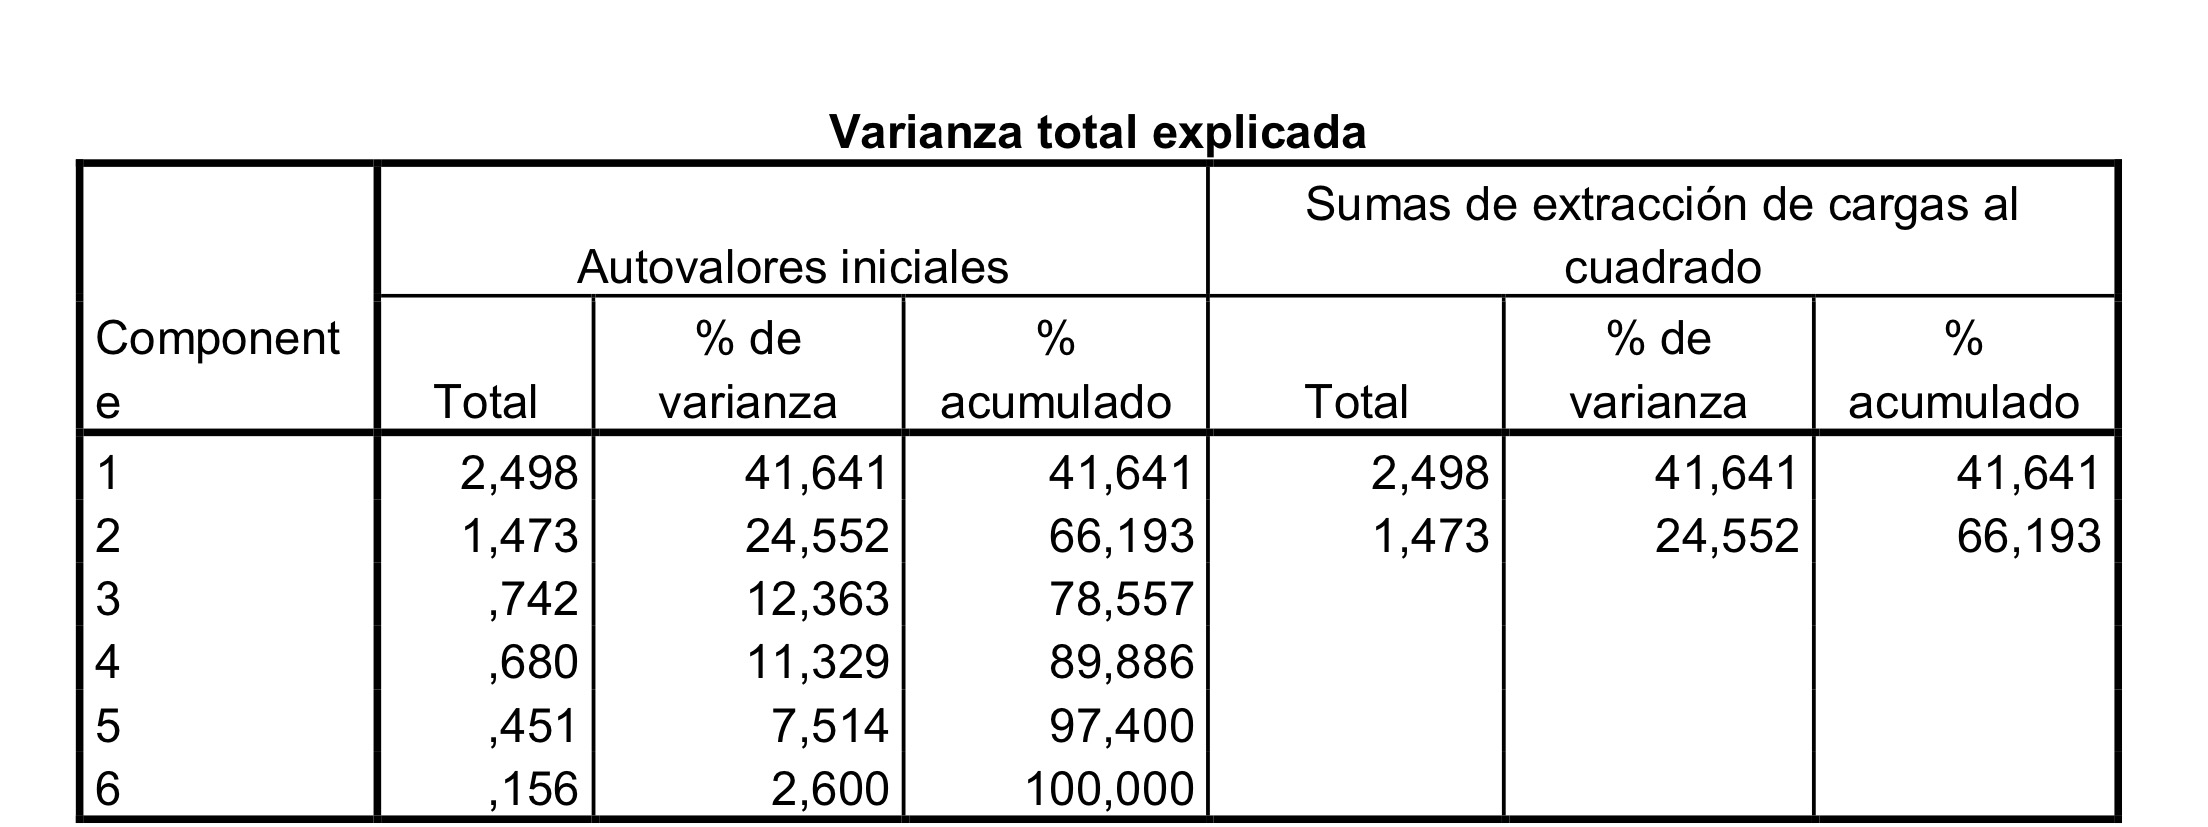
Un Análisis de componentes principales de estos datos nos proporciona la siguiente tabla de cantidad de información de cada componente:

IMG_1283

Con dos componentes explicamos el 66.19%.

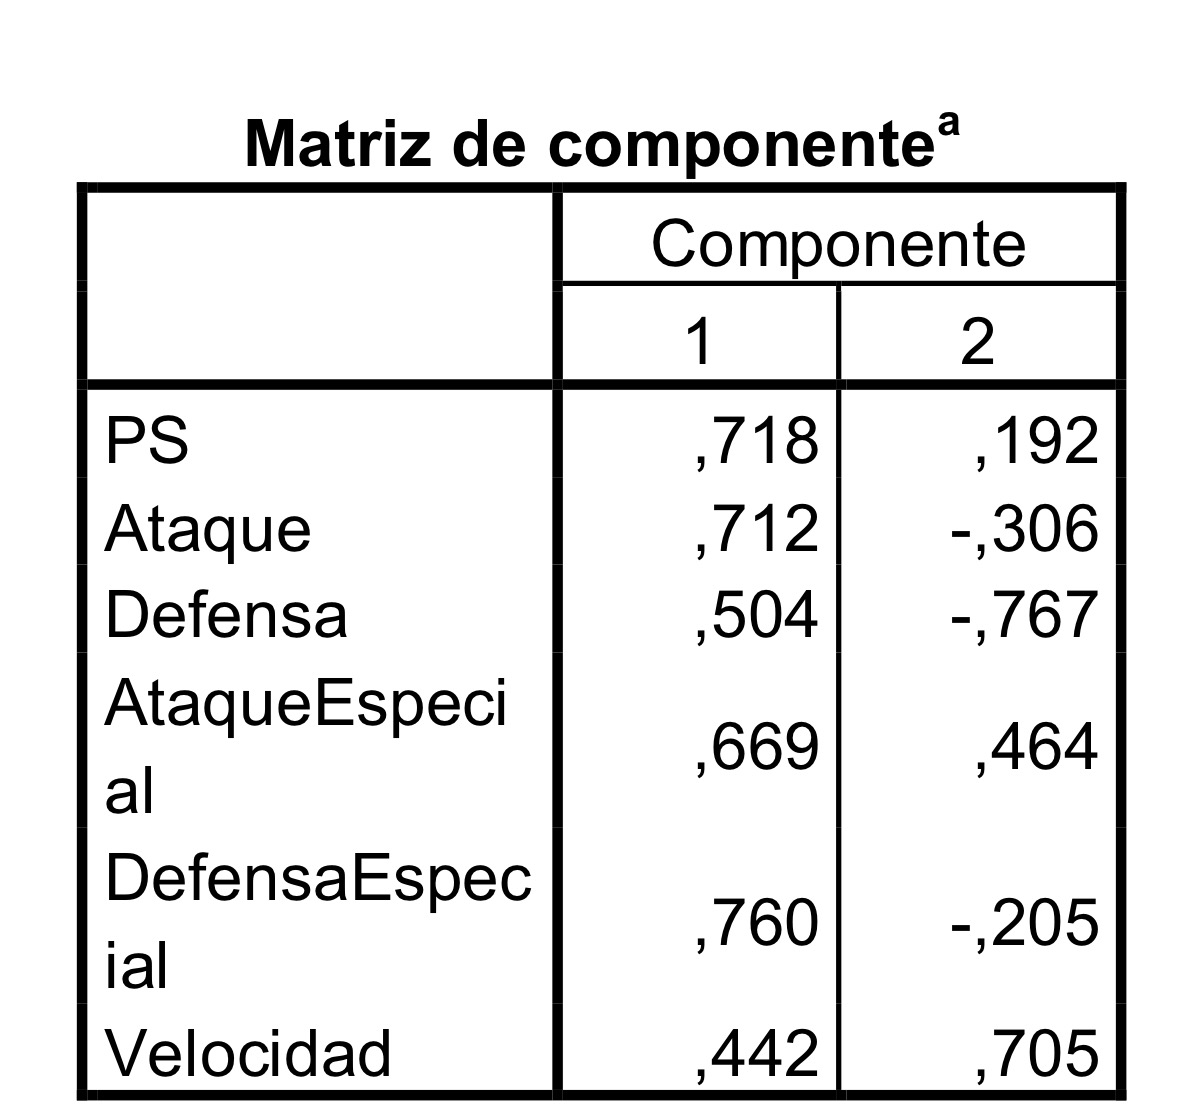
Los coeficientes de las dos primeras componentes principales son los siguientes:

IMG_1284

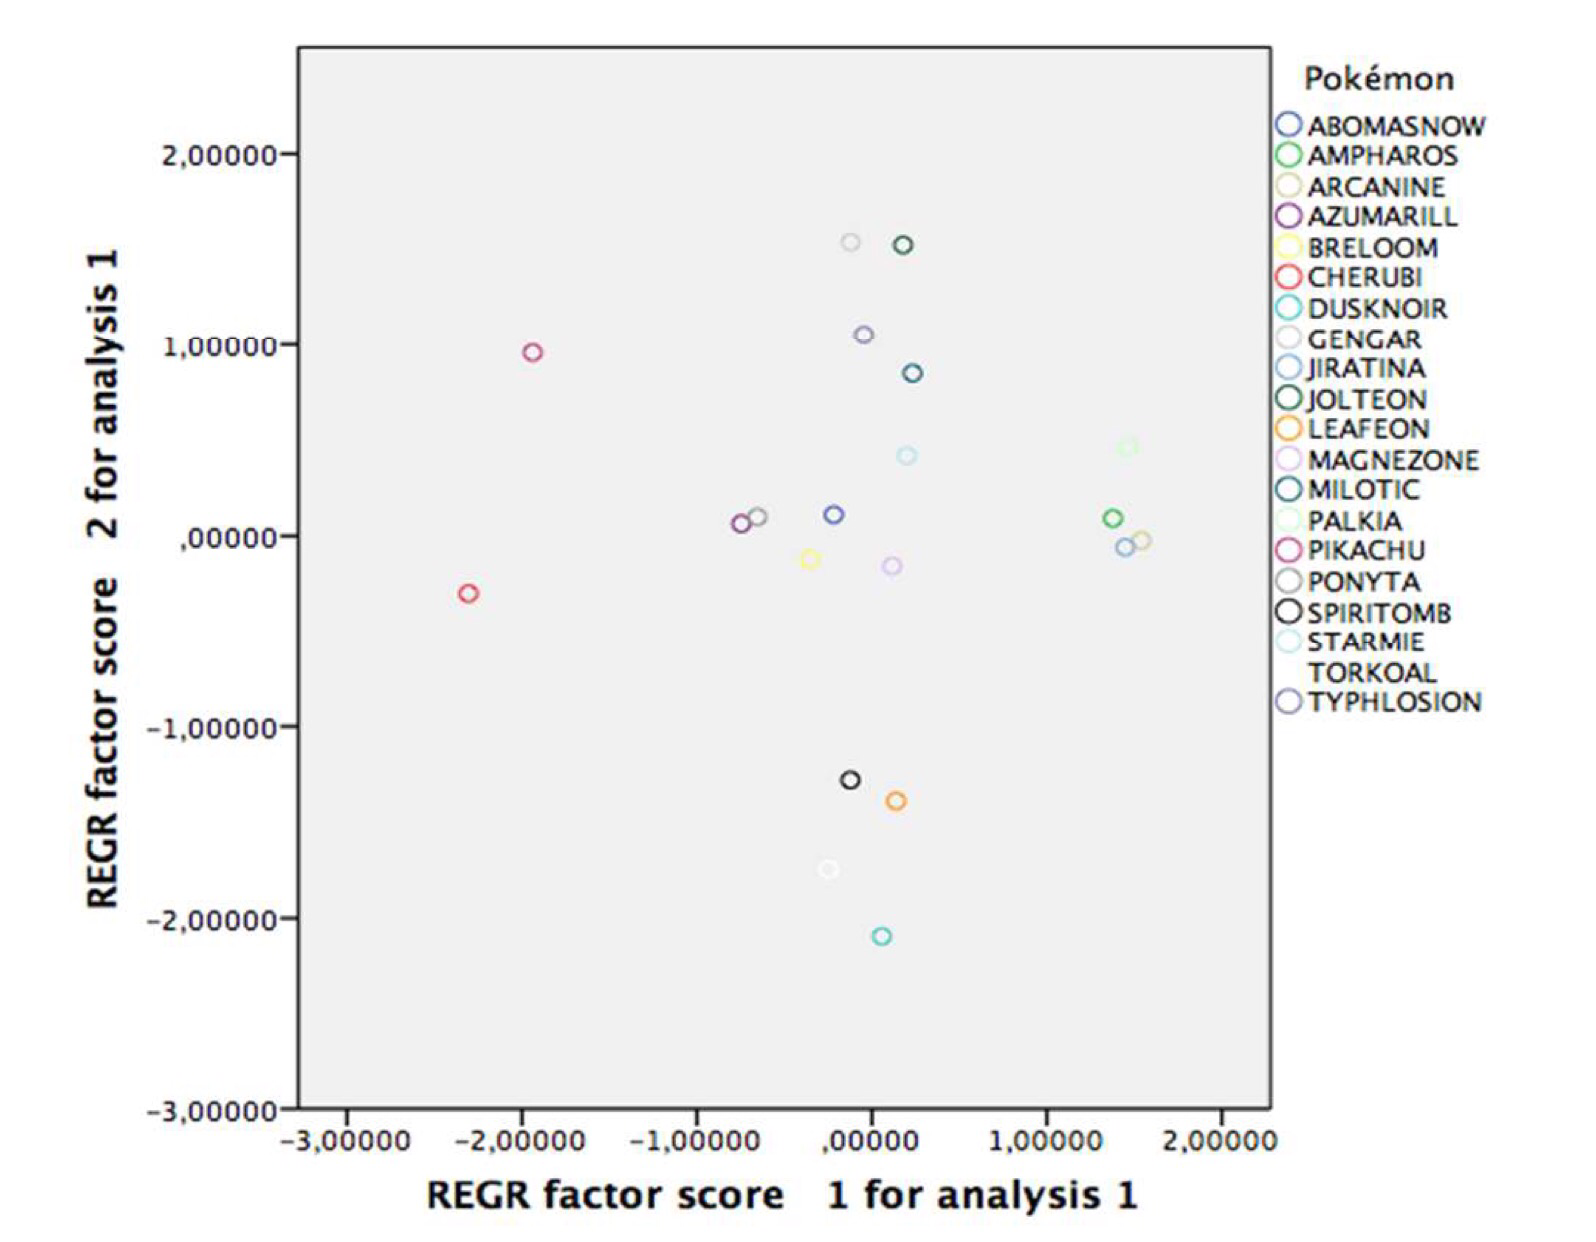
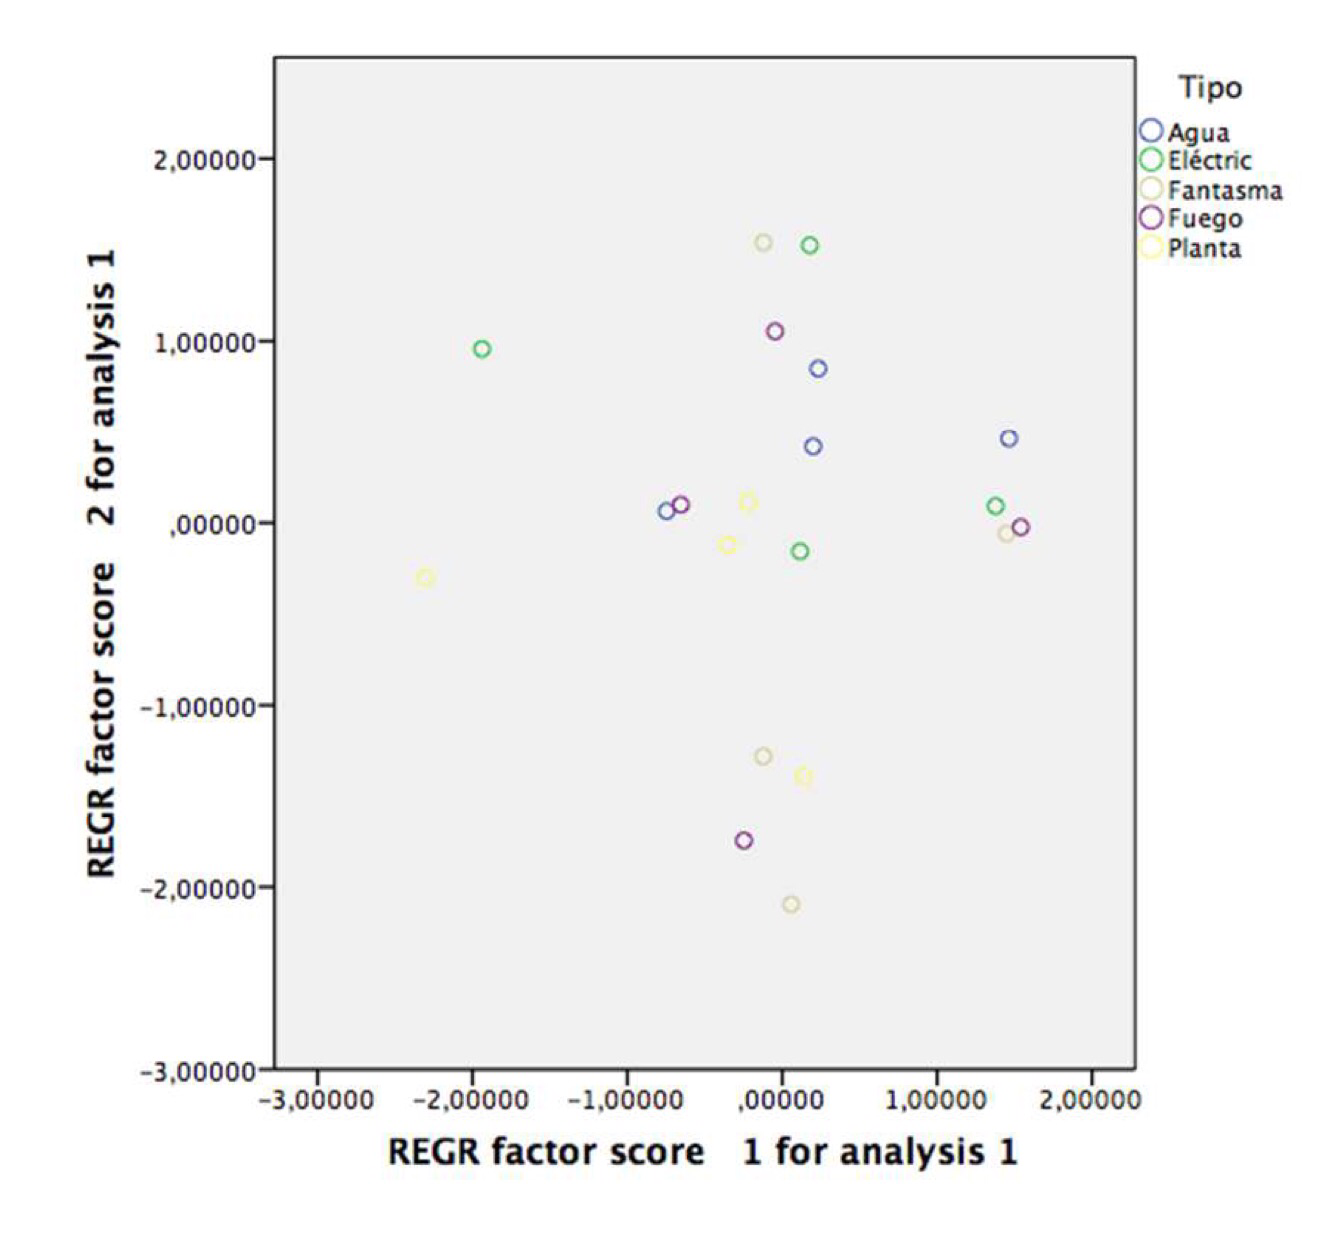
Los gráficos de los esas dos componentes dibujando los pokémons y los tipos de pokémons son los siguientes:

IMG_1285

IMG_1286