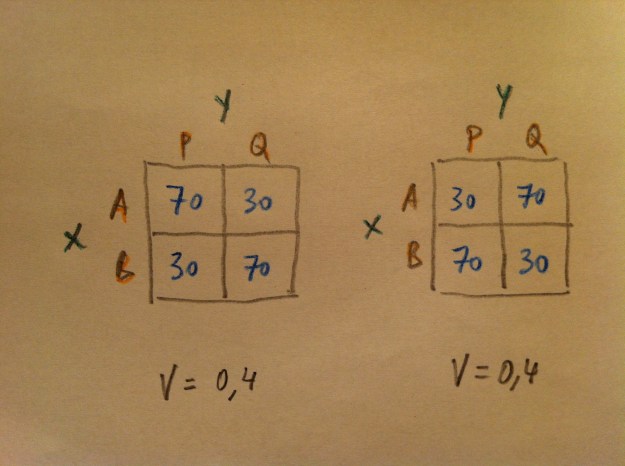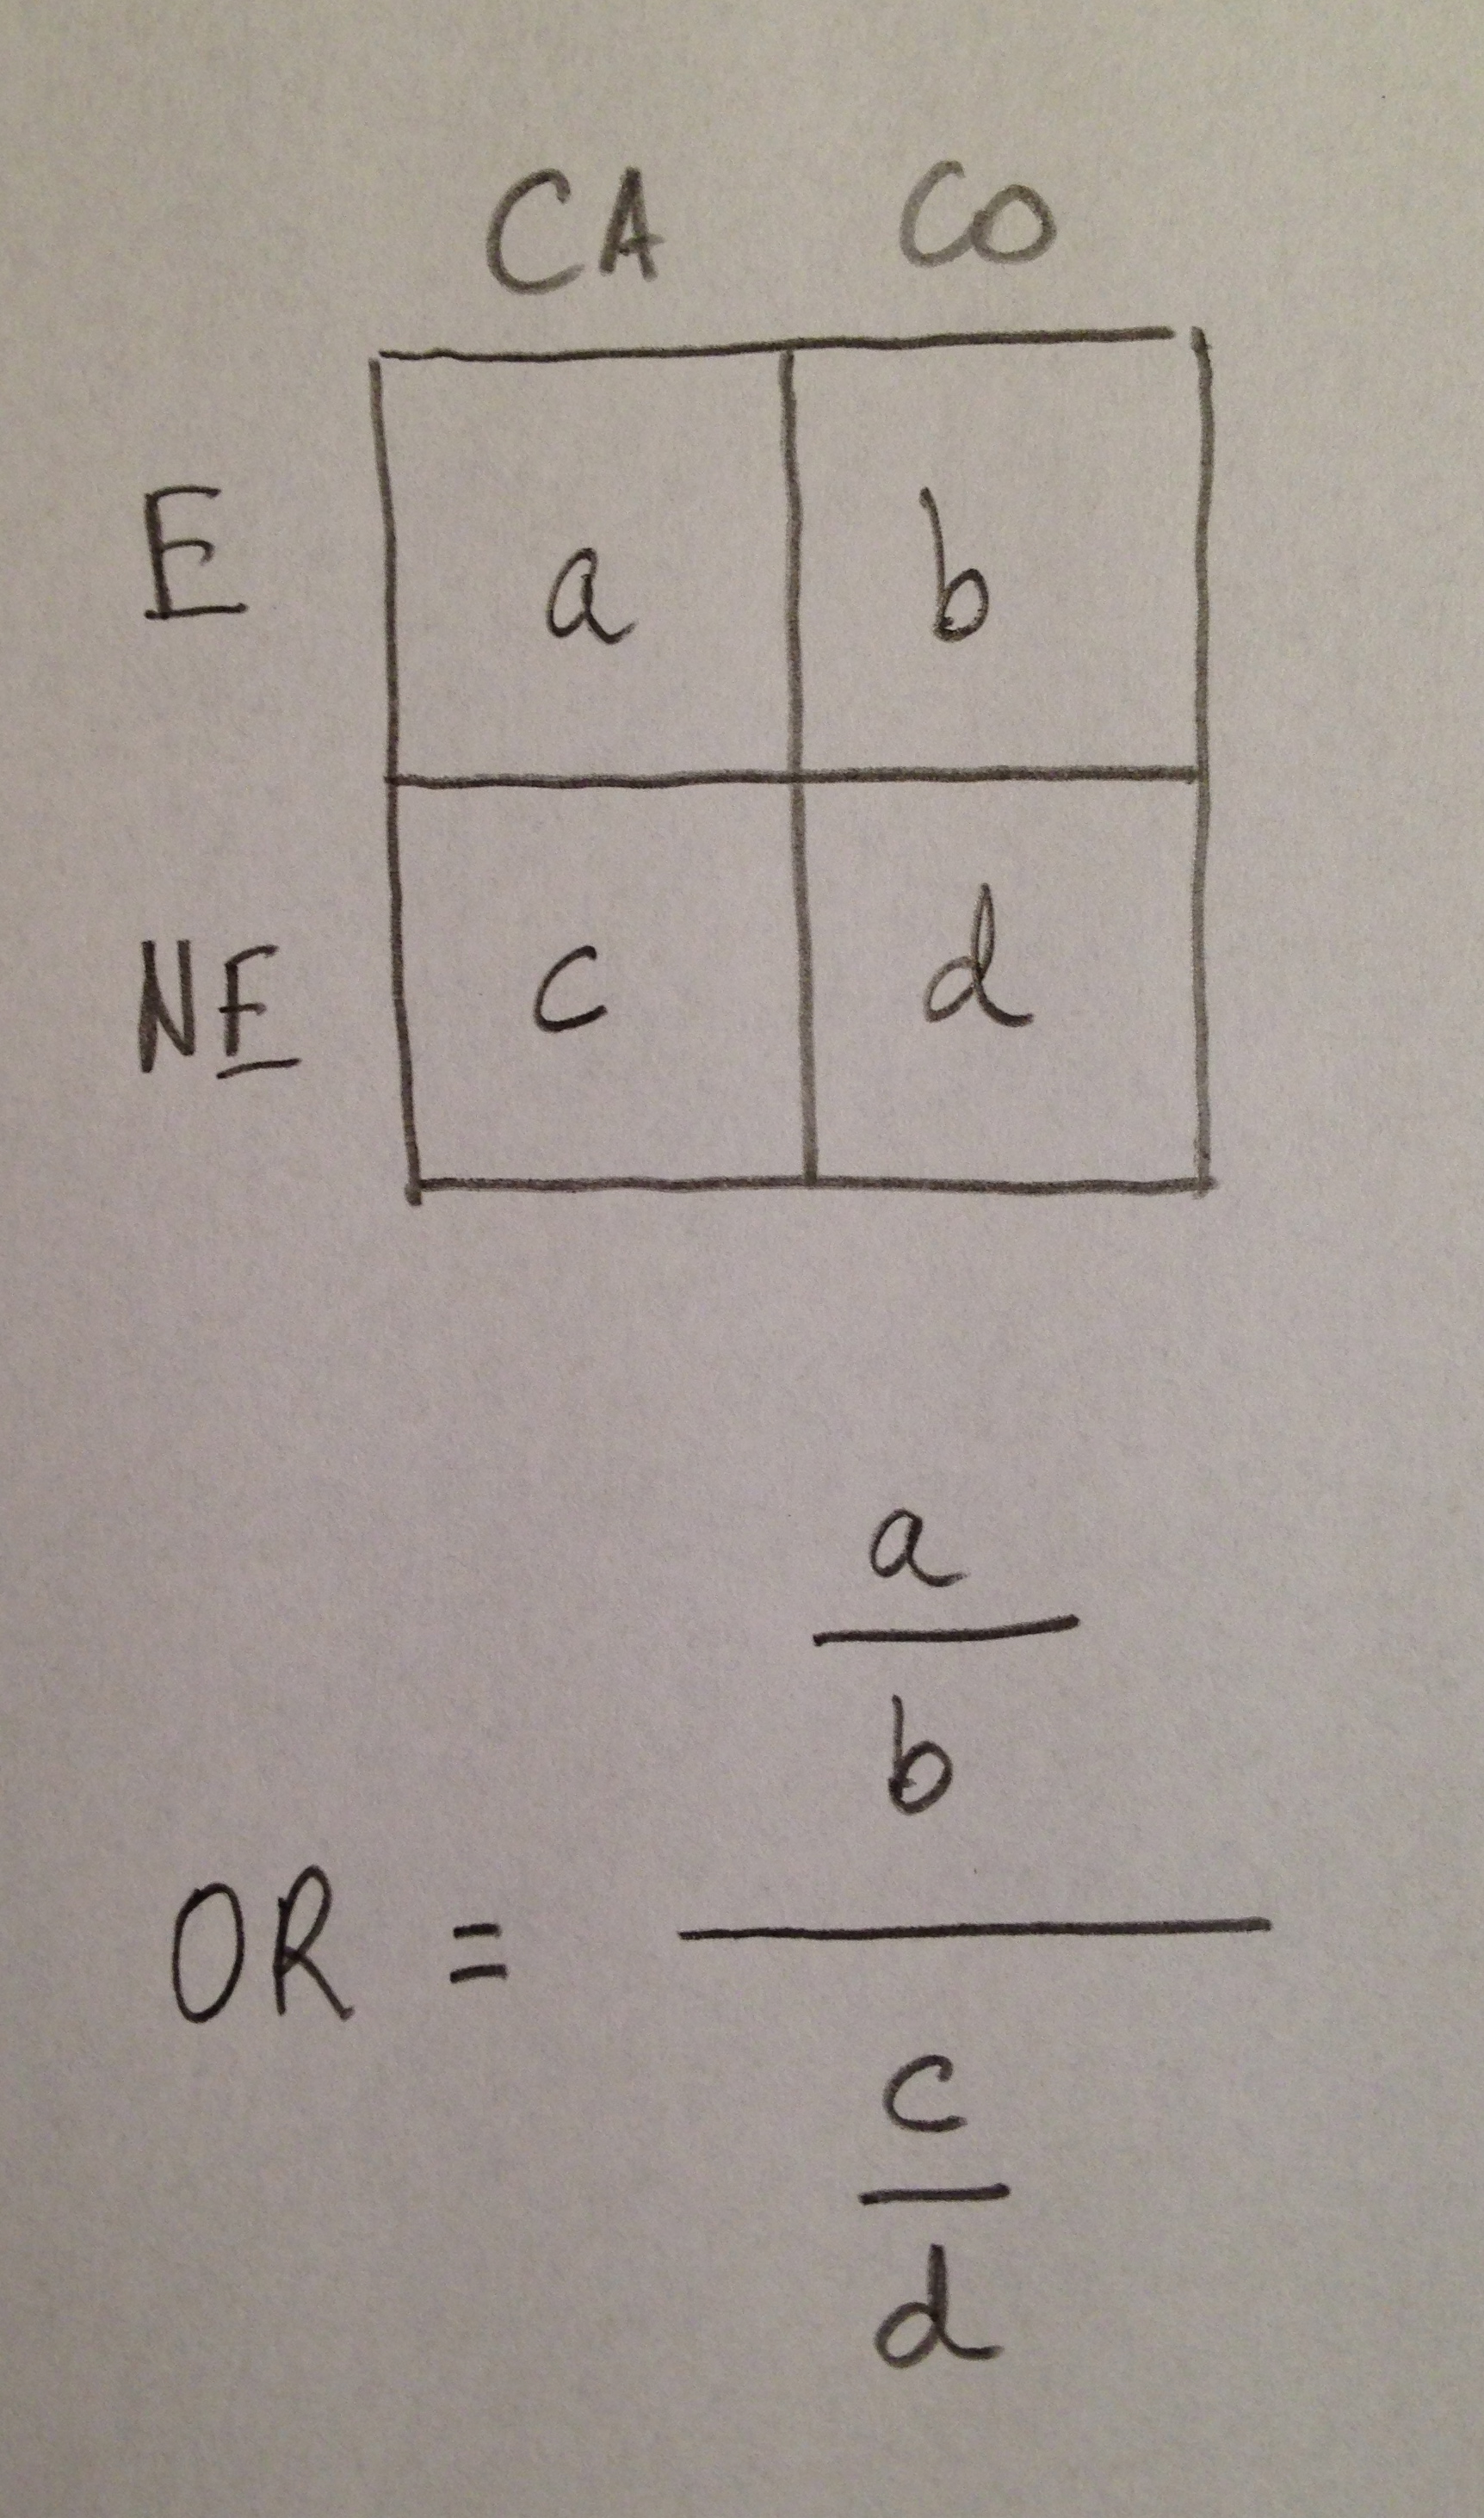En una población de un millón de habitantes se toma una muestra de tamaño 100 para estudiar la variable altura. La muestra se comprueba que sigue bien una distribución normal. La media de la muestra es 170 y la Desviación estándar es 7. ¿Cuántos, del millón de habitantes, miden más de 184 cm?
Si nos dicen que tenemos una muestra con media igual a 7 y Desviación estándar igual a 5 y que a partir de ella se ha construido un intervalo de confianza del 95% de la media poblacional que es (5, 9), ¿cuál es el tamaño de la muestra?
Se toma una muestra de tamaño 4, se miden en ella dos variables y al calcular una correlación de Pearson entre ellas obtenemos el siguiente resultado: r=0,85(p=0,42). Se amplía, entonces, el tamaño de muestra a n=100 obteniéndose ahora una p=0,0001. ¿Seguirá siendo la correlación r positiva?
1. Cuando hablábamos de la correlación entre variables cuantitativas decíamos que en una correlación hay siempre tres elementos a considerar: el signo, la magnitud y la significación.
2. Al hablar de la relación entre variables cuantitativas poníamos inmediatamente sobre la mesa una medida del grado de esta relación entre esas variables: la correlación. Desde esa medida del grado de relación construíamos toda la visión de esa relación.
3. Sin embargo, al abordar la relación entre variables cualitativas, únicamente hemos hablado de significación. En ningún momento hemos hablado de una medida, de una cuantificación del grado de esa relación.
4. Con las variables cualitativas hemos planteado la técnica de la ji-cuadrado, que es una técnica para valorar la significación de la relación, pero no para medirla, no para cuantificarla. La ji-cuadrado nos dice si hay relación o no, no nos mide la cantidad de relación.
5. En realidad, la ji-cuadrado sí que mide la cantidad de relación entre variables cualitativas, lo que sucede es que lo hace de forma no estandarizada. De una forma que no nos es útil.
6. El cálculo de la ji-cuadrado es un número que es tanto mayor cuanta más relación haya entre las variables y tanto menor, más próximo a cero, cuanto más cerca estemos de la no relación (de la independencia) entre esas variables. Por lo tanto, en este sentido, sí es una medida.
7. Lo que sucede, y esto es importante entenderlo, es que esta medición de la relación no la hace de forma estandarizada. Cada tabla de contingencias tiene, en definitiva, su escala. Cada tabla tiene un ámbito distinto de valores posibles del cálculo de la ji-cuadrado. Y, por lo tanto, nos faltan unas referencias globales que nos valgan para todas las situaciones.
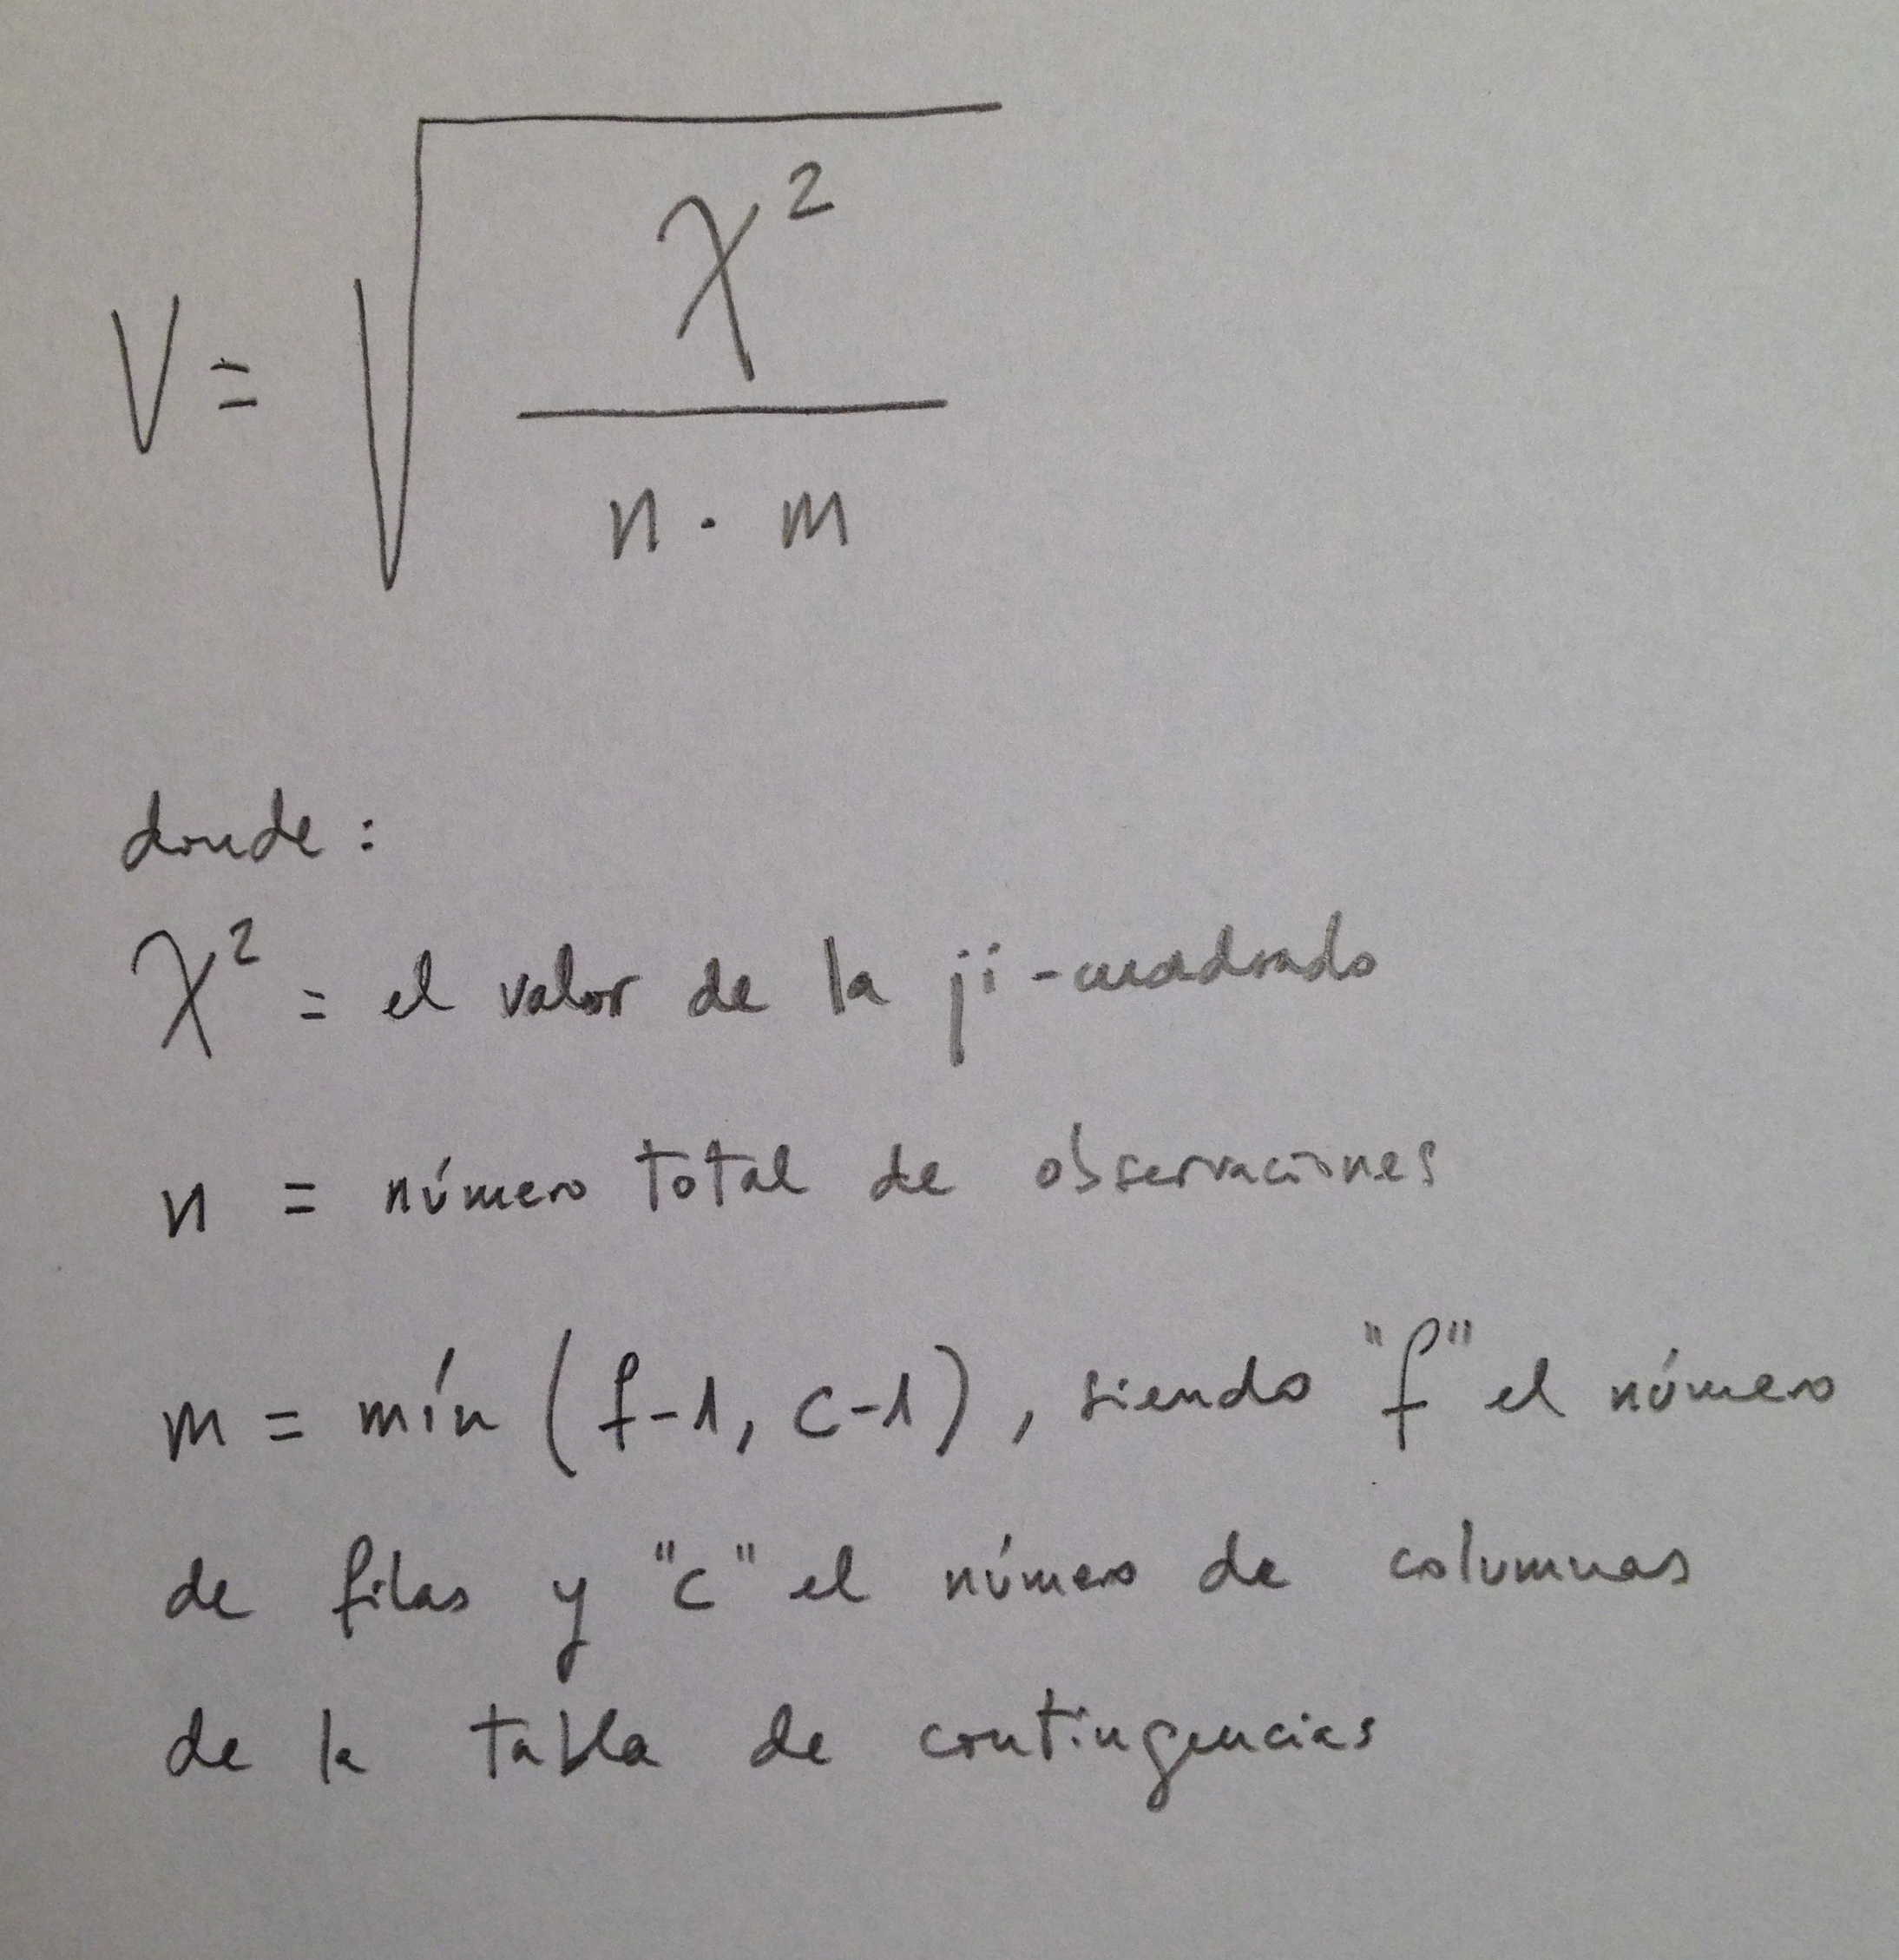
8. El valor del cálculo de la ji-cuadrado en una tabla de contingencias puede oscilar entre 0 y nm, donde “n” es el número total de observaciones en la tabla de contingencias y m = mín (f-1, c-1), siendo “f” el número de filas y “c” el número de columnas y la expresión mín (f-1, c-1) significa que se toma el valor mínimo de los dos incluidos en el intervalo.
9. Por lo tanto, el 0 siempre es el valor mínimo pero el máximo depende tanto del número de observaciones que tengamos como del tipo de tabla de contingencias que tengamos. En una tabla de contingencias de dos filas y dos columnas (2×2) el máximo será, pues, n, porque aquí m vale 1.
10. Usar el valor de la ji-cuadrado, pues, como medidor del grado de relación es como si atendiéramos a la calificación que un profesor pudiera hacer de los puntos que computa a la hora de valorar a un alumno. Un profesor podría valorar en un examen del 0 al 20, otro del 0 al 120, otro del 0 al 78. Según las preguntas que pudiera hacer en un examen.
11. La posible situación planteada nos va bien para entender lo que vamos a explicar a partir de ahora. Porque a pesar de que diferentes profesores puedan puntuar interiormente entre los dos valores que quieran, al final, todos lo transforman a un número del 0 al 10, que es como nos entendemos todos a la hora de valorar las notas.
12. Pues por esto se han introducido diferentes índice que midan de forma estandarizada el grado de relación. Y esto es lo que vamos a explicar a partir de ahora: algunos de los índices propuestos y los criterios seguidos, por cada uno de ellos, para esta estandarización.
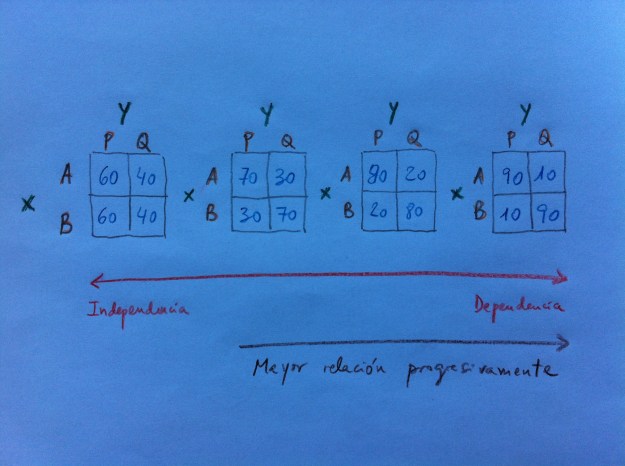
13. Observemos, en primer lugar, cómo en las siguientes tablas de contingencias podemos ver cómo de izquierda a derecha va aumentando el grado de relación entre ambas variables cualitativas. Pasamos de una no relación, a la izquierda, a una relación cada vez mayor, hacia la derecha:
14. Para cuantificar el distinto grado de relación entre variables cualitativas se manejan distintos índices. Pero ninguno ha conseguido alcanzar el nivel de universalidad que ha obtenido el coeficiente de correlación de las variables cuantitativas.
15. Vamos a ver tres de esos índices: la V de Crámer, el Kappa y la Odds ratio. Podríamos ver otros pero estos son los más usados.
16. La V de Crámer:
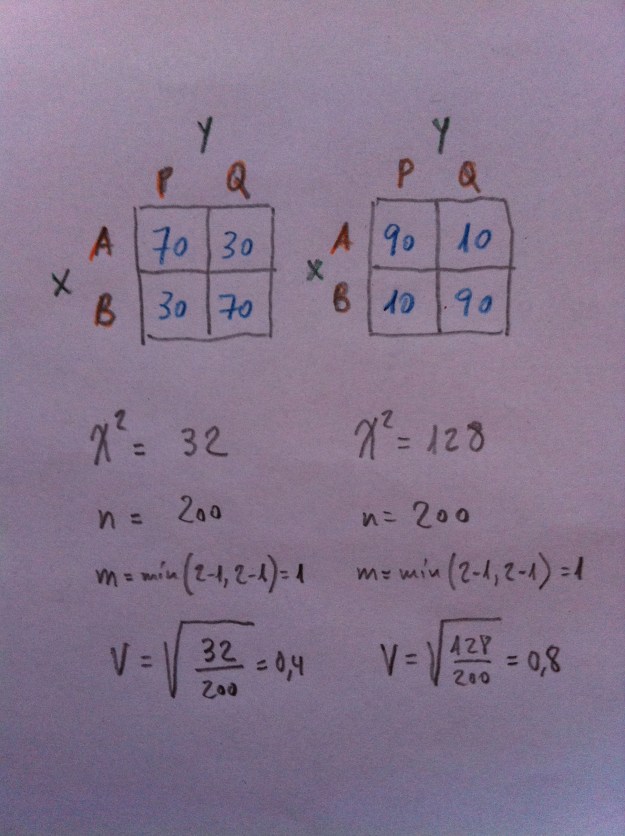
17. La V de Crámer cuantifica entre 0 y 1 el grado de relación. Desde la posición de la total independencia entre las variables y la total dependencia, nos movemos entre estos dos números. Observemos, en el gráfico siguiente, cómo es su cálculo, en dos tablas distintas:
18. Sin embargo, observemos que la V de Crámer no proporciona valores distintos en dos tablas diferentes como las siguientes:
19. La V de Crámer no distingue estas situaciones. No distingue algo así como un signo en la relación (usando como elemento comparativo el signo de la correlación: el positivo y el negativo, que marca relación directa o inversa entre variables cuantitativas). Cosa que sí hace la Odds ratio, como veremos después extensamente.
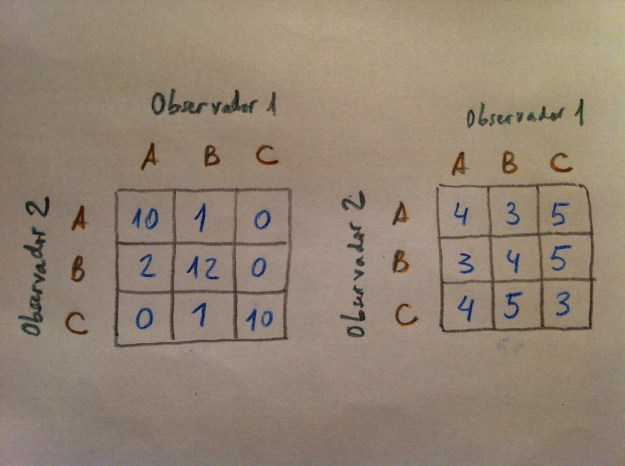
20. El índice Kappa es otra medida del grado de relación entre variables cualitativas. Es utilizado para cuantificar el grado de concordancia que hay entre dos observadores. Puede también evaluarse la concordancia de un observador consigo mismo en pruebas denominada Test-retest.
21. Las tablas de contingencias que se dan en estos casos son tablas cuadradas; o sea, con el mismo número de filas y columnas, donde las categorías fila y las categorías columna son las mismas y donde lo que interesa es evaluar que los valores estén lo más articulados en la diagonal donde coinciden las valoraciones de un y otro observador.
22. Veamos en el siguiente gráfico las peculiaridades de este índice. Pensemos que aquí tenemos una única variable con tres categorías, en este caso (A, B y C), y dos observadores. Los valores de las celdas son las frecuencias de las combinaciones de las categorías de uno y otro observador a la hora de asignar valores a la variable cualitativa estudiada a ejemplares distintos:
23. El índice Kappa calcula el grado de concordancia. Cuanto mayor concordancia más próximo a 1 y cuanta menor concordancia mayor cercanía a 0. En el cálculo usado si la discordancia es muy grande puede dar un índice incluso negativo. En el gráfico anterior es evidente que la tabla de la izquierda muestra dos observadores muy concordados y la de la derecha, por el contrario, muestra dos observadores muy mal concordados. La tabla de la derecha muestra independencia entre los dos observadores. La de la izquierda además de mostrar dependencia marca una buena concordancia. Lo ideal es que todos los valores estén en la diagonal que va de arriba a abajo.
24. Vamos ahora a centrarnos en otro índice para cuantificar la relación entre variables cualitativas. Se trata de un índice muy usado especialmente en Medicina: la Odds ratio (OR). A pesar de ser un índice muy usado en Medicina, en realidad, se trata de un concepto matemático exportable a cualquier ámbito.
25. Vamos a verlo aplicándolo a un tipo de estudios llamados Caso-Control, los cuales analizan individuos que tienen una determinada patología (Casos) y otros que no la tienen (Controles).
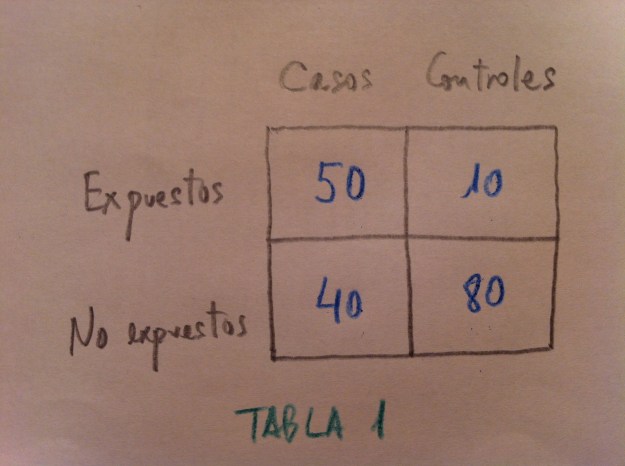
26. Supongamos que queremos ver la relación de esa patología con un factor concreto o con la exposición a un determinado riesgo. Para ello se separan cuántos de los casos y de los controles han estado expuestos y cuántos no. Por ejemplo: cáncer de pulmón y exposición al tabaco (fumador).
27. Utilizaré el siguiente código: casos (CA), controles (CO), expuestos (E) y no expuestos (NE).
28. Veamos la siguiente tabla de contingencias:
29. Observemos primero que si aplicáramos una ji-cuadrado tendríamos un caso de relación significativa: hay relación entre la exposición o no y el ser caso o control.
30. Entre los expuestos tenemos un cociente CA/CO de 50/10; o sea, un cociente de 5. Entre los no expuestos este cociente es (40/80) = 0,5.
31. Esto significa que entre los expuestos hay cinco veces más CA que CO y entre los no expuestos hay la mitad de CA que de CO ó 0,5 veces.
32. Vamos a hacer, ahora, el cociente CA/CO de los expuestos respecto al CA/CO de los no expuestos; o sea: ((CA/CO) de E) / ((CA/CO) de NE). Es posible que nos ayude a ver mejor el cociente de la OR el siguiente gráfico:
33. Estaremos estimando, así, cuántas veces la relación CA/CO entre los expuestos (a/b, en este esquema) está contenida en la relación CA/CO entre los no expuestos (c/d, en este esquema.
34. La OR es justo este cociente. Si OR = 1 significa que numerador y denominador son iguales y, por lo tanto, el cociente CA/CO es igual entre los expuestos y los no expuestos.
35. Cuanto más distinto de 1 sea la OR querrá decir que hay más relación; o sea, que el cociente CA/CO es distinto entre expuestos y no expuestos al factor estudiado.
36. Si es mayor que 1 querrá decir que la exposición al riesgo acarrea más proporción de enfermos.
37. Por el contrario, si la OR es menor que 1 tendremos que pensar que esta exposición más bien protege de la adquisición de tal patología. Por lo tanto, como vemos perfectamente, la OR distingue situaciones donde hay inclinación hacia un lado u otro de la tabla de contingencias, cosa que, como hemos visto antes, no distinguía la V de Crámer.
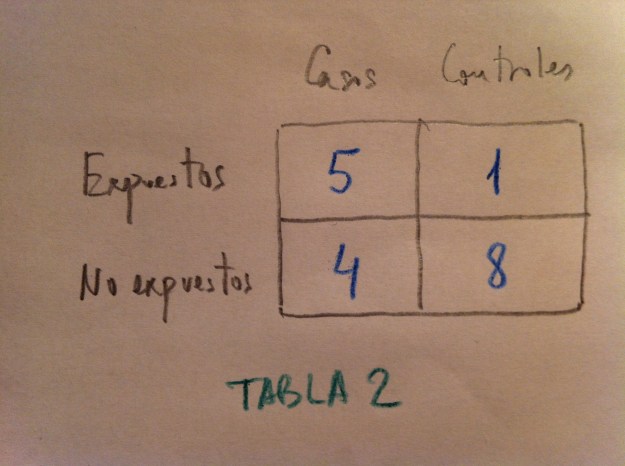
38. Pero observemos esta otra situación:
39. Observemos que es como la tabla de contingencias anterior pero eliminando un cero en las cuatro situaciones posibles. O sea, tenemos la misma relación entre numerador y denominador del índice OR, pero con una muestra mucho más pequeña.
40. Por lo tanto, la OR será la misma. Calculémosla en ambos casos: En la tabla 1 es (5/0,5)=10. Y ahora, en la tabla 2, es la misma: 10.
41. Pero, ¿cuál es la diferencia? La significación, por supuesto. En la tabla 1 la OR es significativa, en la tabla 2 no es significativa.
42. Si hacemos un contraste de hipótesis lo comprobamos. El contraste es ahora: H0: OR=1, H1: OR<>1. En la muestra de la tabla 1 el p-valor es 0,0005. Por lo tanto, rechazamos la H0 y aceptamos H1, por lo tanto podemos decir que esta OR de 10 es significativa, es fiable, es estable.
43. En la muestra de la tabla 2 el p-valor es 0,067. Ahora la OR a pesar de ser la misma que antes; o sea, 10, no es una OR significativa, con la información de que disponemos se trata de una OR no es fiable, no es un valor estable, está demasiado abierto todavía.
44. El tamaño de muestra es decisivo, como siempre. El tamaño de muestra en Estadística es clave. Es muy importante, es clave a la hora de tomar decisiones en Ciencia.
45. Vamos a recuperar ahora la noción de intervalo de confianza. Una noción muy usada a la hora de hacer predicciones.
46. Recordemos que al hacer una estimación de un valor poblacional a través de un cálculo muestral podemos construir un intervalo de confianza de la estimación.
47. En general, esta estimación, dependerá de dos cosas: de la dispersión y del tamaño de muestra.
48. La dispersión alta crea intervalos amplios y el mayor tamaño muestral crea intervalos más estrechos.
49. La dispersión de una estimación depende siempre de un cociente donde en el numerador tenemos la dispersión de la variable con la que estamos trabajando y en el denominador tenemos, en alguna forma, el tamaño de muestra. Es, recordemos, la noción de Error estándar, siempre presente en la estimación de algún valor poblacional.
50. Recordemos que en el Tema 3 vimos que la Desviación estándar (DE) de la media muestral de una variable normal con una Desviación estándar DE, era DE/raíz(n).
51. En el numerador tenemos la DE de la variable de trabajo y en el denominador una forma del tamaño muestral: su raíz cuadrada.
52. Pues bien, la OR que calculamos a través de una muestra expresada en una tabla de contingencias también tiene su intervalo de confianza.
53. Intervalo que será más estrecho cuanto mayor sea el tamaño muestral. Vamos a calcular un intervalo de confianza de la OR en las dos tablas que estamos manejando.
54. Retomemos la tabla 1. Decíamos que OR=10 y que el p-valor era 0,0005, por lo tanto significativa.
55. En esta tabla un intervalo de confianza del 95% de la OR es el siguiente: (4.59, 21.76).
56. Tenemos una confianza del 95% de acertar. El verdadero valor poblacional de OR está entre 4.59 y 21.76. En cualquier caso, por encima de 1.
57. Por eso es significativa esa OR porque la probabilidad de que el verdadero valor sea 1 o menor que 1 es muy pequeña.
58. Hay, por lo tanto, una sintonía entre el p-valor del contraste de hipótesis y mirar si intervalo de confianza del 95% contiene al 1.
59. Es lógico: si el intervalo contiene al 1 es que este valor es posible que sea el real, luego no es significativa la OR calculada.
60. Tomemos ahora, de nuevo, la tabla 2. La OR era también 10, el p-valor era, recordémoslo, 0,067.
61. O sea, este p-valor nos dice que este valor de 10 de OR no es significativo. Recordemos que la frontera de la significación está en el 0,05 y 0,069>0,05.
62. El intervalo de confianza del 95% de la OR es, ahora, (0.85, 117.02). Muy amplio, claro, porque el tamaño de muestra es muy pequeño.
63. Pero, además, observemos que el intervalo contiene al 1. El valor de OR=1 es posible perfectamente.
64. Por esto, ante una tabla así, aunque la OR sea grande (10 en este caso), se trata de un valor no fiable, que puede ser atribuible al azar del muestreo.
65. De nuevo hay coherencia entre lo que nos dice el p-valor del contraste de hipótesis y lo que nos dice mirar si el 1 está en el intervalo.
66. Obsérvese que la OR funciona un poco como la correlación.
67. Decíamos que de una correlación interesaban tres cosas de ella: signo, magnitud y significación.
68. Pues en la OR, de forma paralela, interesa si es mayor o menor que 1 (porque ya hemos visto que una cosa y la otra tienen significados completamente opuestos), interesa también la magnitud y la significación.
69. Un apunte final: A veces, ante situaciones de este tipo, en lugar de la OR se calcula el Riesgo relativo (RR). Es un cálculo bastante similar, especialmente es muy similar si hablamos de patología con baja prevalencia, con bajo porcentaje de afectados. En todo caso, a continuación incluyo el cálculo de ese RR para poderlo comparar con la OR:
70. Observemos que ahora lo que se hace es comparar los Casos no respecto a los Controles sino respecto a la suma de los Casos+Controles.
Gauss, que era un matemático genial, tuvo una extraordinaria intuición: en la naturaleza muchas cosas se distribuyen de forma simétrica respecto a un valor central y cuanto más se alejan de ese centro menos densidad de valores hay. Y creó una función de las más importantes de la historia de las matemáticas: la Distribución normal, o también conocida como campana de Gauss. (Si se quiere ver la situación de la Distribución normal dentro del contexto de otras funciones de distribución consultar el artículo Funciones de distribución).
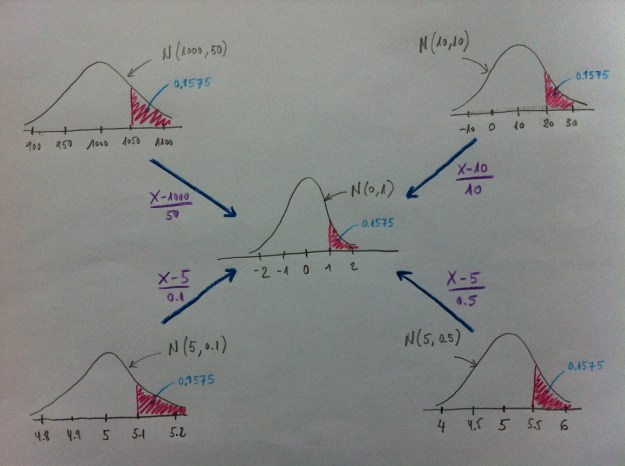
La Distribución normal tiene una propiedad muy importante: Si a una variable con una Distribución normal cualquiera se le resta su media y se la divide por su desviación estándar se transforma en una Distribución normal con media 0 y con Desviación estándar igual a 1. Es la llamada Distribución normal estándar. Y a este procedimiento, a esta transformación de una normal cualquiera en una única y común distribución, la N(0, 1), se le denomina “estandarización” o “tipificación”.
Al restar por su media la normal se desplaza, rígidamente, sin cambiar su forma, sin cambiar su dispersión, hasta situarse sobre el cero. Al dividir por la Desviación estándar (DE) lo que hacemos es comprimirla (si la DE de partida es mayor que 1) o expandirla (si la DE de partida es menor que 1). En el gráfico adjunto se pueden ver estos dos actos: el de desplazamiento y el de compresión.
Esta propiedad de la Distribución normal nos permite calcular el área de cualquier de una de ellas mediante una única tabla, la de la Normal N(0, 1).
¿Y cómo funciona la tabla de N(0, 1)?
Hay de muchos tipos de estas tablas. Todas deben usarse sabiendo dos cosas básicas: Que el área que hay debajo de la campana es 1 y que la distribución de áreas es simétrica respecto al valor donde está el punto medio.
Voy a explicar cómo se utiliza una de estas tablas. La tabla adjunta tiene unos valores referencia en la primera columna y en la primera fila. En la primera columna los valores son 0.0, 0.1, 0.2, y así sucesivamente. En la primera fila son 0.00, 0.01, 0.02, y así sucesivamente. Las áreas en esta tabla se dan siempre hacia la izquierda del número de referencia elegido. Cuando en una N(0, 1) se quiere buscar un número para encontrar el área debe elegirse la combinación de un número de la primera columna con un número de la primera fila, sumándolos.
Practiquemos: Si quiero calcular el área que hay, bajo la campana, a la izquierda de 1.43, debo buscar en la primera columna el 1.4 y en la primera fila el 0.03. De esta forma sumo estos dos valores tengo 1.43. En la celdilla intersección de tal columna con tal fila encontramos el valor de tal área: 0.9236. Esta es el área a la izquierda de 1.43, el área desde menos infinito hasta 1.43 bajo la distribución N(0, 1).
Si quiero calcular, ahora, el área a la izquierda de 0.82 debo buscar en la primera columna el 0.8 y en la primera fila el 0.02, así al sumar tengo 0.82. En la celdilla intersección de tal columna con tal fila encontramos el valor de tal área: 0.7939.
Observemos que los valores empiezan en el punto 0.0. Esto es con finalidad de ahorrar espacio. Porque al ser el área bajo la campana de 1 y a partir de la propiedad de simetría podemos calcular cualquier área. Veámoslo: Supongamos que queremos calcular el área a la izquierda del valor -1.13, debemos buscar el área a la derecha de 1.13 porque es la misma. Y para encontrarla hay que buscar el área a la izquierda de 1.13 y calcular 1 menos esa área. Jugando con esta idea se puede calcular cualquier área.
Si se quiere encontrar el área dentro de un intervalo, por ejemplo entre 0.23 y 1.12, buscamos el área a la izquierda de 1.12, el área a la izquierda de 0.23 y las restamos. Las restamos porque al área a la izquierda de 1.12 hay que restarle el área a la izquierda de 0.23, de esta forma estaremos calculando el área que hay desde 0.23 a 1.12.
Y, así, sabiendo utilizar las propiedades de la Distribución normal comentadas: área 1 y simetría, puede calcularse cualquier área.
Hay un detalle que es importante destacar. Ahora que ya sabemos manejar la tabla de la Normal hemos de decir que cuando decimos aquello de media más menos una Desviación estándar (DE), más menos dos DE o más menos tres DE, cubren el 68.5, 95 y 99.5% podemos comprobar que estos valores son aproximados, no son exactos. Se fijan estos tres números porque son muy próximos y son más fáciles de retener en la memoria. En realidad, si lo calculamos exacto desde -1 hasta +1 en la N(0, 1) sería exactamente: 0.8413-0.1587=0.6826; por lo tanto media más menos una DE es exactamente un 68.26%. Si miramos la tabla podremos comprobar que desde -2 hasta 2 hay un área un poco superior al 95%, y que si queremos crear un intervalo exactamente del 95% deberíamos crearlo mediante la media más menos 1.96 Desviaciones estándar porque desde -1.96 hasta 1.96 se da exactamente un área de 0.95. Respecto al intervalo formado por la media más menos tres DE el área es: 0.99865-0.00135=0.99730; o sea, del 99.7%.
Para ver problemas de aplicación de la distribución normal y ver su relación con otras distribuciones puede consultarse el artículo Funciones de distribución. Allí se verá, entre otras cosas, cómo la distribución normal se puede usar para aproximar a distribuciones como la Binomial o la Poisson.
La noción de significación, en Estadística, significa algo así como fiabilidad. Un resultado significativo es un resultado por el que podemos apostar. Ante una afirmación estadísticamente significativa podemos pensar que si volviésemos a hacer lo mismo, si volviésemos a empezar todo lo que habíamos hecho y que nos ha llevado a tales afirmaciones, y lo hiciésemos en las mismas circunstancias, pero con otra muestra, acabaríamos diciendo algo similar, algo equivalente.
Podemos pensar, pues, que estamos ante una muestra tipo, ante una buena muestra de muestras, una muestra representativa del conjunto de muestras que hubiéramos podido tener.
Una afirmación si es estadísticamente significativa representa que la Estadística cree en este resultado, cree que es muy poco probable que sea fruto del azar del muestreo. Si una técnica estadística duda de la representatividad de un muestreo dice: «esto no significativo».
La significación estadística se mide mediante el p-valor. Éste es un valor que va del 0 al 1, con dos sectores bien diferenciados: del 0 al 0,05 y del 0,05 al 1. Una metáfora posible, en esta situación, es la de las notas: En nuestro sistema educativo las notas van del 0 al 10, y es bien distinto el sector de notas que va del 0 al 5 que el que va del 5 al 10. Esto mismo sucede con el p-valor. La frontera del 0,05 en el p-valor es, en cierto modo, equivalente al 5 en las notas. Pero cuidado: 0,05, no 0,5.
Por ejemplo: Una correlación será significativa si su p-valor es inferior a 0,05. Si no es significativa hemos de presuponer que r = 0. Siguiendo la metáfora de las notas, es como si se examinara la afirmación r = 0: si el p-valor es igual o superior a 0,05 aprueba, si el p-valor es inferior a 0,05 suspende, decidimos, entonces, que la r no es 0 y nos quedamos con el signo y la magnitud de la r calculada. De esta forma podemos decir que una r = 0,8 con un p-valor de 0,26 es, en realidad, una correlación más baja que una r = 0,4 con p = 0,001. Porque, en este caso, la r = 0,8, al no ser significativa, no podemos fiarnos de ella. Puede ser un efecto del azar del muestreo. Esto quiere decir que de la misma forma que en esta muestra hemos calculado una r = 0,8 en otra muestra tomada en las mismas condiciones podríamos tener r = -0,8. Por eso ante esta posibilidad la técnica estadística nos dice: “Ante la duda mejor afirmar que no hay relación; o sea, que r es igual a 0”.
Al basarse la decisión en un número entre 0 y 1 y en una frontera (0,05), el paralelismo con la enseñanza es claro: En la enseñanza, en España, las notas son un número del 0 al 10, con una frontera muy clara en el 5. Como puede verse la frontera en el p-valor está relativamente mucho más a favor del aprobado. Esto es para que cuando suspenda r = 0 tengamos muy pocas posibilidades de errar. Observemos que el margen de la afirmación r = 0 es muy amplio (0,95). Esto es lo que permite hablar de «significativo» cuando suspende. Por eso, entonces, hablamos de correlación significativa. Porque le hemos dado mucho margen a r = 0 y acabamos viendo que no es coherente mantener esta afirmación a la luz de lo que estamos viendo en la muestra que tenemos.
La significación tiene mucho que ver con el tamaño de muestra. Si ese tamaño es pequeño es difícil que la Estadística se fíe de ella. Las muestras de tamaño pequeño son muy imprevisibles porque las diferentes muestras posibles son muy diversas entre ellas. En muestras grandes hay mucha homogeneidad entre las diferentes muestras posibles. Por eso será más fiable lo que una de ellas diga.
Entender este razonamiento es fundamental en Estadística. Estamos abordando, con esto, en realidad, el núcleo básico de la Estadística.
En Estadística a todo esto que estamos viendo le denominamos «Contraste de hipótesis». Vamos a ver, ahora, la terminología que usamos. En Contraste de hipótesis se habla de Hipótesis nula: H0, y de Hipótesis alternativa: H1. Y de que hemos de decidirnos por una u otra. La decisión no es como cuando compramos una camisa poniendo una al lado de la otra para ver cuál nos gusta más. La H0 parte como cierta y sólo nos decantaremos por la H1 si la H0 es absurdo mantenerla viendo lo que vemos en la muestra. Por eso H1 se le denomina alternativa, porque es la alternativa de la nula cuando no es lógico mantenerla tras analizar la muestra. En todo lo visto con la correlación podemos ahora conectar: H0 es r = 0 y H1 es r distinta de 0. El p-valor es el criterio objetivo basado en el análisis de la muestra que nos permite decidirnos por mantener H0 o pasarnos a la alternativa, a H1.
Esta lógica de funcionamiento es el tema nuclear de casi todas las técnicas estadísticas.
Siempre digo que la estructura de la Estadística es como la del Bolero de Ravel: un mismo tema que va repitiéndose machaconamente. El tema machacón del Bolero de Ravel de la Estadística es esta noción de contraste de hipótesis y el p-valor como criterio de decisión.
Tanto en las técnicas de relación como en las técnicas de comparación las decisiones se acaban tomando planteando un Contraste de hipótesis y decidiéndose en base a un p-valor obtenido valorando la información que tenemos en la muestra. Son afirmaciones muy distintas las que se hacen en los diferentes contrastes de hipótesis pero el procedimiento de decisión se basa siempre en el mismo formalismo. Se analiza la muestra, o las muestras, y en base a una serie de criterios (tamaño muestral, dispersión y magnitud de una serie de cálculos) se mantiene la H0 o se pasa a aceptar la alternativa, la H1.
El paralelismo de la Estadística con el mundo judicial es sorprendente. En un juicio también hay dos hipótesis a contrastar: inocencia y culpabilidad. Y las dos no parten paralelas. Una parte como cierta: la inocencia («presunción de inocencia»), y sólo si durante el juicio, mediante las pruebas y testigos, se ve que la inocencia no se puede mantener se pasará a la culpabilidad.
En Estadística podemos decir que existe la presunción de no relación entre las variables. Presunción de r = 0, de a = 0, de b = 0. Y más tarde, cuando veamos las técnicas de comparación hablaremos de la presunción de igualdad de medias, de proporciones, de varianzas, etc. Únicamente si es incoherente mantener esas presunciones, a la luz de la muestra (nuestras pruebas y testigos), diremos que hay relación. Pero cuando lo hagamos, cuando digamos que hay relación, o que hay diferencias de medias o de proporciones, como lo habremos hecho tras darle mucho margen de confianza a la presunción de no relación, o a la de igualdad, podemos decir que aquella relación es significativa, es fiable, que existen pocas posibilidades de que no sea así.
En el fondo los estadísticos somos un poco como el Tribunal constitucional. El Tribunal constitucional tiene como objetivo básico analizar las leyes y acabar dictaminando si se adaptan o no a la constitución. Al final sus sentencias son, en esencia, decir «constitucional» o «no constitucional». Y lo que dice este tribunal es la última palabra. Con la Estadística sucede un poco lo mismo. Analiza unos datos y acaba dando un veredicto: «significativo» o «no significativo». Y la comunidad científica está muy pendiente de estos veredictos, por su fundamental trascendencia. Podemos decir algo así como que la Estadística es el Tribunal de la significación de la ciencia.
Un ejemplo extraordinario para ver cómo los conceptos estadísticos pueden impregnar a otras materias lo encontramos, en Medicina, en el diagnóstico de la Osteoporosis.
Para el diagnóstico de esta importante enfermedad ósea se usa la densitometría ósea. Esta prueba suele hacerse en la región lumbar y en el cuello del fémur. Los resultados de tal prueba se suelen presentar mediante dos valores: La T y la Z. Se trata de dos valores que miden, mediante un mecanismo conceptual estadístico, la posición relativa de la densidad ósea de una persona respecto a una determinada población de referencia.
La T mide la posición relativa de los valores de una persona determinada respecto a los de una población de personas jóvenes (20 a 29 años) del mismo sexo.
La Z mide lo mismo que la T pero la población de referencia es, ahora, la formada por una población de la misma edad y del mismo sexo que la persona analizada.
Pero, ¿cómo se mide esta posición relativa? Porque podría hacerse de formas distintas. Por ejemplo, en Pediatría, la altura, el peso o el perímetro craneal de un niño también se expresa como posición relativa respecto a una población de referencia, pero en este caso se expresa siempre en forma de percentiles.
En Osteoporosis esta posición relativa se mide de una forma sorprendente, se mide en unas unidades un tanto especiales: en desviaciones estándar. En desviaciones estándar respecto a la media. Distinguiendo no sólo la distancia a la media en estas unidades sino mediante el signo positivo o negativo según ocupe una persona una posición por encima o por debajo de la media del grupo de referencia.
Por ejemplo, si la variable de densidad ósea estudiada sigue, en la población de referencia, una distribución N(0.6, 0.1), entonces si una persona tiene un valor de 0.4 de densidad ósea, tiene -2 desviaciones estándar (DE), porque como la DE de la población es 0.1, esta persona respecto a la población está en una posición por debajo de la media, que es 0.6, y en concreto a su valor (0.4) se llega restándole a la media 2 DE. Una persona que tuviera un valor de 0.7 estaría en una posición de +1DE. Porque de 0.6 a 0.7 se llega sumando 1 DE.
Por lo tanto, la T y la Z es justo esto: la posición de la persona respecto a la población de referencia expresado en estas unidades tan especiales: en desviaciones estándar por encima de la media (positivas, entonces) o en desviaciones estándar por debajo de la media (negativas, entonces).
La diferencia entre la T y la Z está únicamente en cuál es la población de referencia. Lógicamente una persona mayor tendrá una T más baja (más negativa o menos positiva) que la Z, porque en la T se la compara con jóvenes y en cambio en la Z se la compara con personas de su misma edad. Y con la edad se tiende a perder densidad ósea. En cambio, en una persona joven, entre 20 y 29 años, la T y la Z deben coincidir porque la población de referencia es la misma.
Tomando la T, como valor de diagnóstico fundamental, suele decirse que una persona tiene Osteopenia si su valor está entre -1 y -2.5, y que tiene Osteoporosis si su T es menor que -2.5.
Reproduzco un fragmento y un gráfico de una revista médica muy prestigiosa (The New England Journal of Medicine): “There was a close, significant linear correlation (r=0.791, P<0.0001) between chocolate consumption per capita and the number of Nobel laureates per 10 million persons in a total of 23 countries”.
La solución es la que se ve en el esquema adjunto. Se añade también, ahora, una curva de Lorenz hipotética de cada país. El reparto de la riqueza es bien distinto en cada uno de estos tres países. Más igualitario Suecia y muy desigual Etiopía. Grecia está en una posición intermedia. Es importante ver cómo el Box-Plot y la curva de Lorenz, cada uno a su manera, dibuja esta distinta distribución de la riqueza que hay en los tres países: